数组
数组的基本性质、排序、二分搜索、前缀和、差分等常用技巧
随机数
// #include <cstdlib>
// #include <ctime>
// srand(time(0));
// int x = rand() % 100;
// // 生成 [a, b] 之间的随机数
// int a = 10, b = 20;
// int r = a + rand() % (b - a + 1);
// C++11 及以上版本推荐使用 <random> 库来生成随机数
// #include <random>
// #include <chrono>
// mt19937 rng(chrono::steady_clock::now().time_since_epoch().count());
// int r = uniform_int_distribution<int>(1, 100)(rng);数组的基本性质
- 数组是存放在连续内存空间上的相同类型数据的集合
- 数组下标都是从0开始的
- 数组内存空间的地址是连续的
- 正是因为数组在内存空间的地址是连续的,所以在删除或者增添元素的时候,就必须要移动其他元素的地址——注意,数组的元素是不能直接删除的,只能覆盖
- 在 C++ 中,二维数组在内存的空间地址是连续的
排序
冒泡排序
-
冒泡排序是最基础的交换排序,核心思想是:
- 重复遍历待排序的数组,两两比较相邻元素,如果顺序错误(如升序要求下前大后小)就交换它们
- 每一轮遍历都会将当前未排序部分的最大元素 “冒泡” 到末尾
- 当某一轮遍历中没有发生任何交换时,说明数组已完全有序,可提前终止,优化效率
-
升序排序
#include <iostream> #include <vector> using namespace std; // 冒泡排序(升序) void bubbleSort(vector<int>& nums) { int n = nums.size(); // 外层循环:控制排序轮数(最多n-1轮,因为最后一个元素无需再比较) for (int i = 0; i < n - 1; ++i) { bool swapped = false; // 标记本轮是否发生交换,优化 // 内层循环:每轮比较到未排序的最后一个元素(已排序的在末尾,无需比较) for (int j = 0; j < n - 1 - i; ++j) { if (nums[j] > nums[j + 1]) { // 前大后小,交换 swap(nums[j], nums[j + 1]); swapped = true; } } // 本轮无交换,说明数组已有序,直接退出 if (!swapped) { break; } } } // 测试函数 int main() { vector<int> nums = {5, 2, 9, 1, 5, 6}; bubbleSort(nums); // 输出:1 2 5 5 6 9 for (int num : nums) { cout << num << " "; } return 0; } -
最好的情况(数组已有序):优化后 ,未优化
-
最好的情况(数组逆序):
-
空间复杂度:,原地排序,只使用常数级额外空间
快速排序
-
快速排序是分治思想的经典应用,核心思想是:
- 选基准(pivot):从数组中选一个元素作为 “基准值”(常见选法:首元素、尾元素、中间元素、随机元素);
- 分区(partition):遍历数组,将小于基准的元素放到基准左边,大于基准的放到右边,基准最终落在 “正确位置”(排序后它应在的位置);
- 递归处理:对基准左边和右边的子数组重复上述步骤,直到子数组长度为 1(天然有序)
-
升序,以首元素为基准
#include <iostream> #include <vector> using namespace std; // 分区函数:返回基准元素的最终索引 int partition(vector<int>& nums, int left, int right) { // 选左边界为基准(也可优化为随机选,避免最坏情况) int pivot = nums[left]; int i = left, j = right; while (i < j) { // 从右往左找第一个小于基准的元素 while (i < j && nums[j] >= pivot) { j--; } // 从左往右找第一个大于基准的元素 while (i < j && nums[i] <= pivot) { i++; } // 交换这两个元素 if (i < j) { swap(nums[i], nums[j]); } } // 将基准元素放到正确位置(i/j重合的位置) swap(nums[left], nums[i]); return i; // 返回基准索引 } // 快速排序递归函数 void quickSort(vector<int>& nums, int left, int right) { // 递归终止条件:子数组长度<=1 if (left >= right) { return; } // 分区,得到基准索引 int pivotIdx = partition(nums, left, right); // 递归排序左子数组 quickSort(nums, left, pivotIdx - 1); // 递归排序右子数组 quickSort(nums, pivotIdx + 1, right); } // 对外封装(简化调用) void quickSort(vector<int>& nums) { if (nums.empty()) return; quickSort(nums, 0, nums.size() - 1); } // 测试函数 int main() { vector<int> nums = {5, 2, 9, 1, 5, 6}; quickSort(nums); // 输出:1 2 5 5 6 9 for (int num : nums) { cout << num << " "; } return 0; } -
最好/平均情况:
-
最坏情况(数组已有序 / 逆序,且选首 / 尾为基准):(可以通过随机选基准避免最坏情况)
-
空间复杂度:(递归调用栈的空间),原地排序(无额外数组空间)
-
不稳定排序(相等元素的相对顺序可能改变)
-
基准选择:随机选基准(
swap(nums[left], nums[left + rand() % (right - left + 1)])),避免最坏情况 -
简单实现
void quickSort(vector<int> &arr, int low, int high) { // 终止条件 if (l >= r) return; // 选择基准元素 int mid = low + (high - low) / 2; int pivot = arr[mid]; int i = low, j = high; // 分区 while (i <= j) { while (arr[i] < pivot) i++; while (arr[j] > pivot) j--; if (i <= j) { swap(arr[i], arr[j]); i++; j--; } } // 递归排序左右子数组 quickSort(arr, low, j); quickSort(arr, i, high); } -
快速排序链表
struct ListNode { int val; ListNode *next; ListNode(int x) : val(x), next(NULL) {} }; ListNode *quickSortList(ListNode *head) { // 终止条件: 链表为空或只有一个节点 if (!head || !head->next) return head; // 选择基准元素 ListNode *pivot = head; ListNode *leftDummy = new ListNode(0); ListNode *rightDummy = new ListNode(0); ListNode *leftTail = leftDummy; ListNode *rightTail = rightDummy; ListNode *current = head->next; // 分区 while (current) { if (current->val < pivot->val) { leftTail->next = current; leftTail = leftTail->next; } else { rightTail->next = current; rightTail = rightTail->next; } current = current->next; } // 递归排序左右子链表 leftTail->next = nullptr; // 断开左链表 rightTail->next = nullptr; // 断开右链表 ListNode *sortedLeft = quickSortList(leftDummy->next); ListNode *sortedRight = quickSortList(rightDummy->next); // 合并结果 if (sortedLeft) { ListNode *tail = sortedLeft; while (tail->next) tail = tail->next; // 找到左链表的尾部 tail->next = pivot; // 将基准元素连接到左链表的尾部 pivot->next = sortedRight; // 将右链表连接到基准元素的后面 return sortedLeft; // 返回排序后的链表头部 } else { pivot->next = sortedRight; // 将右链表连接到基准元素的后面 return pivot; // 返回基准元素作为排序后的链表头部 } } -
快速选择
void quickSelect(vector<int> &arr, int low, int high, int k) { // 终止条件 if (l >= r) return; // 选择基准元素 int mid = low + (high - low) / 2; int pivot = arr[mid]; int i = low, j = high; // 分区 while (i <= j) { while (arr[i] < pivot) i++; while (arr[j] > pivot) j--; if (i <= j) { swap(arr[i], arr[j]); i++; j--; } } // 根据 k 的位置递归选择 if (k <= j) quickSelect(arr, low, j, k); else if (k >= i) quickSelect(arr, i, high, k); }
插入排序
-
把数组分为两个区域:
- 已排序区:初始时只有数组第一个元素(下标 0);
- 未排序区:从下标 1 开始的所有元素
-
排序过程(以升序为例):
-
从未排序区取出第一个元素(记为
current),作为 “待插入元素”; -
从已排序区的末尾向前遍历,依次比较
current和已排序区的元素:
- 如果已排序区的元素 >
current,则将该元素后移一位(为current腾出位置); - 如果已排序区的元素 ≤
current,停止遍历(找到插入位置);
- 如果已排序区的元素 >
-
将
current插入到找到的位置; -
重复步骤 1-3,直到未排序区为空
-
-
代码实现
#include <iostream> #include <vector> using namespace std; /** * 插入排序(升序) * @param nums 待排序的数组(引用传递,直接修改原数组) */ void insertionSort(vector<int>& nums) { // 获取数组长度,空数组或单元素数组无需排序 int n = nums.size(); if (n <= 1) return; // 外层循环:遍历未排序区(从第2个元素开始,下标1) for (int i = 1; i < n; ++i) { // 1. 取出未排序区的第一个元素作为待插入元素 int current = nums[i]; // j:已排序区的末尾索引,初始为i-1 int j = i - 1; // 2. 向前遍历已排序区,找插入位置 // 条件:j>=0(不越界)且 已排序元素>待插入元素(需要后移) while (j >= 0 && nums[j] > current) { // 将nums[j]后移一位,覆盖nums[j+1](即原current的位置) nums[j + 1] = nums[j]; // j向前移动,继续比较 j--; } // 3. 插入待插入元素到正确位置(j+1是最终插入位置) nums[j + 1] = current; // 可选:打印每一步的排序结果,便于理解 cout << "第" << i << "轮排序后:"; for (int num : nums) cout << num << " "; cout << endl; } } // 测试函数 int main() { vector<int> nums = {5, 2, 9, 1, 5, 6}; cout << "原始数组:"; for (int num : nums) cout << num << " "; cout << endl; insertionSort(nums); cout << "最终排序结果:"; for (int num : nums) cout << num << " "; cout << endl; return 0; } -
最好情况:,只需遍历一次,无需移动元素
-
最坏情况:,每个元素都要移动到最前面
-
空间复杂度为 ,原地排序,仅使用常数级额外空间
-
稳定排序:当待插入元素等于已排序区的元素时,会插入到其后方,不会改变相等元素的相对顺序
-
折半插入排序:在找插入位置时,用二分查找替代顺序遍历,减少比较次数(但移动次数不变,时间复杂度仍为 )
归并排序
-
归并排序分为两个核心阶段:分(Divide) 和治(Conquer)
-
阶段 1:分(拆分)
- 将数组从中间拆分为左右两个子数组;
- 递归拆分左右子数组,直到每个子数组的长度为 1(长度为 1 的数组天然有序)
-
阶段 2:治(合并)
- 从最小的有序子数组开始,两两合并为一个更大的有序数组;
- 逐层向上合并,最终得到完整的有序数组
-
代码实现
#include <iostream> #include <vector> using namespace std; /** * 合并两个有序子数组 * @param nums 原数组 * @param left 左子数组起始索引 * @param mid 中间索引(左子数组末尾=mid,右子数组起始=mid+1) * @param right 右子数组末尾索引 */ void merge(vector<int>& nums, int left, int mid, int right) { // 1. 创建临时数组,存储合并后的结果(长度=右-左+1) vector<int> temp(right - left + 1); // i:左子数组的指针(起始=left) // j:右子数组的指针(起始=mid+1) // k:临时数组的指针(起始=0) int i = left, j = mid + 1, k = 0; // 2. 合并两个有序子数组到临时数组 while (i <= mid && j <= right) { // 升序规则:取较小的元素放入临时数组 if (nums[i] <= nums[j]) { temp[k++] = nums[i++]; } else { temp[k++] = nums[j++]; } } // 3. 处理左子数组的剩余元素(如果有) while (i <= mid) { temp[k++] = nums[i++]; } // 4. 处理右子数组的剩余元素(如果有) while (j <= right) { temp[k++] = nums[j++]; } // 5. 将临时数组的结果复制回原数组的对应位置 for (int p = 0; p < temp.size(); ++p) { nums[left + p] = temp[p]; } } /** * 归并排序递归函数 * @param nums 待排序数组 * @param left 子数组起始索引 * @param right 子数组末尾索引 */ void mergeSortRecursive(vector<int>& nums, int left, int right) { // 递归终止条件:子数组长度<=1(无需排序) if (left >= right) { return; } // 1. 计算中间索引(避免溢出:left + (right-left)/2 替代 (left+right)/2) int mid = left + (right - left) / 2; // 2. 递归拆分左子数组 [left, mid] mergeSortRecursive(nums, left, mid); // 3. 递归拆分右子数组 [mid+1, right] mergeSortRecursive(nums, mid + 1, right); // 4. 合并两个有序子数组 merge(nums, left, mid, right); } /** * 归并排序对外封装(简化调用) * @param nums 待排序数组 */ void mergeSort(vector<int>& nums) { if (nums.empty()) return; mergeSortRecursive(nums, 0, nums.size() - 1); } // 测试函数 int main() { vector<int> nums = {5, 2, 9, 1, 5, 6}; cout << "原始数组:"; for (int num : nums) cout << num << " "; cout << endl; mergeSort(nums); cout << "最终排序结果:"; for (int num : nums) cout << num << " "; cout << endl; return 0; } -
最好 / 最坏 / 平均情况:
-
空间复杂度:,需要临时数组存储合并结果(非原地排序)
-
递归调用栈空间:
-
稳定排序:合并时当
nums[i] <= nums[j]时取左子数组的元素,保证相等元素的相对顺序不变 -
适合要求稳定排序的场景:比如排序对象是 “键值对”(如按成绩排序,成绩相同保持原顺序)
-
算法题中的经典应用:
- 求逆序对(归并排序的核心变种题,合并时统计逆序对数量)
- 外部排序(数据量超过内存时,分块排序后合并)
选择排序
-
将数组分为 “已排序区” 和 “未排序区”:
- 遍历未排序区,找到其中的最小值(升序);
- 将最小值与未排序区的第一个元素交换位置,此时该元素加入 “已排序区”;
- 重复步骤 1-2,直到未排序区为空
-
代码实现
#include <iostream> #include <vector> using namespace std; void selectionSort(vector<int>& nums) { int n = nums.size(); if (n <= 1) return; // 外层循环:控制已排序区的末尾(i是未排序区的第一个元素索引) for (int i = 0; i < n - 1; ++i) { // 1. 找未排序区 [i, n-1] 的最小值索引 int minIdx = i; // 初始假设第一个元素是最小值 for (int j = i + 1; j < n; ++j) { if (nums[j] < nums[minIdx]) { minIdx = j; // 更新最小值索引 } } // 2. 交换最小值和未排序区第一个元素 if (minIdx != i) { // 避免自我交换 swap(nums[i], nums[minIdx]); } // 可选:打印每轮结果 cout << "第" << i+1 << "轮:"; for (int num : nums) cout << num << " "; cout << endl; } } int main() { vector<int> nums = {5,2,9,1,5,6}; selectionSort(nums); return 0; } -
时间复杂度:最好 / 最坏 / 平均都是 (无论数组是否有序,都要遍历找最值)
-
空间复杂度:(原地排序);
-
不稳定:交换会破坏相等元素的相对顺序,比如 [2, 3, 2] 排序时,第一个 2 会和第三个 2 交换)
-
仅适合小规模数据
堆排序
-
堆是完全二叉树,分为大顶堆(父节点≥子节点)和小顶堆(父节点≤子节点)
-
堆排序(升序)步骤:
- 建堆:将原数组构建为大顶堆(堆顶是最大值);
- 排序:
- 交换堆顶元素和堆的最后一个元素(最大值 “沉” 到数组末尾,加入已排序区);
- 缩小堆的范围(排除已排序的末尾元素),对新堆顶执行 “堆化”(恢复大顶堆结构);
- 重复上述步骤,直到堆的大小为 1
-
代码实现
#include <iostream> #include <vector> using namespace std; /** * 堆化函数(维护大顶堆结构) * @param nums 待堆化的数组 * @param n 堆的总大小 * @param i 要堆化的节点索引 */ void heapify(vector<int>& nums, int n, int i) { int largest = i; // 初始化最大值为当前节点 int left = 2 * i + 1; // 左子节点索引 int right = 2 * i + 2; // 右子节点索引 // 如果左子节点比当前节点大,更新最大值索引 if (left < n && nums[left] > nums[largest]) { largest = left; } // 如果右子节点比最大值大,更新最大值索引 if (right < n && nums[right] > nums[largest]) { largest = right; } // 如果最大值不是当前节点,交换并递归堆化受影响的子树 if (largest != i) { swap(nums[i], nums[largest]); heapify(nums, n, largest); } } void heapSort(vector<int>& nums) { int n = nums.size(); if (n <= 1) return; // 1. 构建大顶堆(从最后一个非叶子节点开始堆化) // 最后一个非叶子节点索引:n/2 - 1 for (int i = n / 2 - 1; i >= 0; --i) { heapify(nums, n, i); } // 2. 逐个取出堆顶元素(最大值),放到数组末尾 for (int i = n - 1; i > 0; --i) { swap(nums[0], nums[i]); // 交换堆顶和当前堆的最后一个元素 heapify(nums, i, 0); // 堆化剩余的i个元素(缩小堆范围) } } int main() { vector<int> nums = {5,2,9,1,5,6}; heapSort(nums); for (int num : nums) cout << num << " "; // 输出:1 2 5 5 6 9 return 0; } -
时间复杂度:建堆 ,排序 ,整体 (最好 / 最坏 / 平均一致)
-
空间复杂度:(原地排序,递归堆化的栈空间可忽略)
-
稳定性:不稳定(堆化交换会破坏相等元素的相对顺序)
-
适用场景:
- 算法题中 “TopK 问题”(找前 k 大 / 小元素)的最优解(无需全排序)
- 大规模数据排序(效率接近快排,且无快排的最坏情况)
希尔排序
-
希尔排序是插入排序的优化版,又称 “缩小增量排序”,属于比较类排序
-
核心是 “分组插入排序”,通过增量(步长)将数组分组,对每组执行插入排序,逐步缩小增量直到为 1(此时退化为普通插入排序,但数组已近乎有序):
- 选择一个增量序列(如 );
- 按当前增量将数组分为若干组(索引差为增量的元素为一组);
- 对每组执行插入排序;
- 缩小增量,重复步骤 2-3,直到增量为 1
-
代码实现
#include <iostream> #include <vector> using namespace std; void shellSort(vector<int>& nums) { int n = nums.size(); if (n <= 1) return; // 1. 初始化增量为数组长度的一半,逐步缩小增量 for (int gap = n / 2; gap > 0; gap /= 2) { // 2. 对每组执行插入排序(从gap开始遍历,每组的第一个元素是nums[0], nums[gap], nums[2gap]...) for (int i = gap; i < n; ++i) { int current = nums[i]; // 待插入元素 int j = i; // 向前遍历同组元素,大于current则后移 while (j >= gap && nums[j - gap] > current) { nums[j] = nums[j - gap]; j -= gap; } nums[j] = current; // 插入到正确位置 } } } int main() { vector<int> nums = {5,2,9,1,5,6}; shellSort(nums); for (int num : nums) cout << num << " "; // 输出:1 2 5 5 6 9 return 0; } -
时间复杂度:依赖增量序列,最优 ,最坏 ,平均
-
空间复杂度:(原地排序)
-
稳定性:不稳定(分组插入会破坏相等元素的相对顺序)
-
适用场景:中等规模数据排序,效率高于插入 / 冒泡 / 选择排序,实现简单
计数排序
-
计数排序是非比较类排序(不通过比较元素大小排序),核心是 “统计频率、还原数组”,适用于数值范围有限的整数排序
- 确定范围:找到数组中的最大值和最小值,确定计数数组的长度;
- 统计频率:创建计数数组,统计原数组中每个元素出现的次数;
- 还原有序数组:遍历计数数组,按频率将元素填充回原数组
-
代码实现
#include <iostream> #include <vector> #include <climits> // 用于INT_MIN/INT_MAX using namespace std; void countingSort(vector<int>& nums) { int n = nums.size(); if (n <= 1) return; // 1. 找数组的最大值和最小值,确定计数范围 int minVal = INT_MAX, maxVal = INT_MIN; for (int num : nums) { minVal = min(minVal, num); maxVal = max(maxVal, num); } // 2. 创建计数数组,长度=maxVal - minVal + 1,初始化为0 vector<int> count(maxVal - minVal + 1, 0); // 统计每个元素的出现次数 for (int num : nums) { count[num - minVal]++; // 偏移minVal,避免负数索引 } // 3. 还原有序数组 int idx = 0; // 原数组的填充索引 for (int i = 0; i < count.size(); ++i) { while (count[i] > 0) { nums[idx++] = i + minVal; // 还原真实值 count[i]--; } } } int main() { vector<int> nums = {5,2,9,1,5,6}; countingSort(nums); for (int num : nums) cout << num << " "; // 输出:1 2 5 5 6 9 return 0; } -
时间复杂度:(n 是数组长度,k 是数值范围),线性时间
-
空间复杂度:(计数数组的空间)
-
稳定性:可实现稳定排序(优化计数数组为前缀和形式)
-
适用场景:
- 数值范围小的整数排序(如成绩排序、年龄排序)
- 算法题中 “基数排序” 的子步骤;
- 限制:仅支持整数,且数值范围不能过大(否则计数数组空间爆炸)
基数排序
-
基数排序是非比较类排序,核心是 “按位排序”(从低位到高位 / 高位到低位),基于计数排序 / 桶排序实现
-
算法原理(以十进制、低位优先为例)
- 确定最大位数:找到数组中的最大值,确定需要排序的位数(如 999 是 3 位)
- 按位排序:从最低位(个位)到最高位,对每一位执行计数排序(保证稳定性)
- 每一轮排序后,数组按当前位有序,最终整体有序
-
代码实现
#include <iostream> #include <vector> #include <climits> using namespace std; // 获取数字的第d位(个位d=1,十位d=10,百位d=100...) int getDigit(int num, int d) { return (num / d) % 10; } void radixSort(vector<int>& nums) { int n = nums.size(); if (n <= 1) return; // 1. 找最大值,确定最大位数 int maxVal = INT_MIN; for (int num : nums) { if (num < 0) { // 简化处理:假设数组无负数(有负数可偏移) cerr << "暂不支持负数排序" << endl; return; } maxVal = max(maxVal, num); } // 2. 按位排序(d=1:个位,d=10:十位,d=100:百位...) for (int d = 1; maxVal / d > 0; d *= 10) { // 计数数组:0-9共10个数字 vector<int> count(10, 0); vector<int> temp(n); // 临时数组存储当前位排序结果 // 统计当前位的数字频率 for (int num : nums) { int digit = getDigit(num, d); count[digit]++; } // 优化计数数组为前缀和(实现稳定排序) for (int i = 1; i < 10; ++i) { count[i] += count[i - 1]; } // 从后往前遍历,保证稳定性 for (int i = n - 1; i >= 0; --i) { int digit = getDigit(nums[i], d); temp[--count[digit]] = nums[i]; } // 复制回原数组 nums = temp; } } int main() { vector<int> nums = {53, 3, 542, 748, 14, 214}; radixSort(nums); for (int num : nums) cout << num << " "; // 输出:3 14 53 214 542 748 return 0; } -
时间复杂度:(d 是最大位数,k 是基数,十进制 k=10),接近线性
-
空间复杂度:(临时数组 + 计数数组)
-
稳定性:稳定(关键:从后往前遍历填充临时数组)
-
适用场景:
- 整数 / 字符串排序(如手机号、身份证号)
- 数值范围大但位数少的场景(如 1-100000 的整数,位数仅 6 位)
- 限制:需要按位拆分,不适合浮点数 / 自定义对象排序
排序算法对比
-
两大类型
- 比较类排序(冒泡 / 快排 / 插入 / 归并 / 选择 / 堆 / 希尔):通用但时间复杂度最低为
- 非比较类排序(计数 / 基数):线性时间,但有适用范围限制(如仅整数、数值范围小)
-
算法题中优先选择:
- 通用场景:快排 / 归并 / 堆排
- 数值范围小:计数排序
- TopK 问题:堆排序(最优)
- 近乎有序数据:插入排序 / 希尔排序
-
表格对比
排序算法 核心思想 时间复杂度(最好) 时间复杂度(平均) 时间复杂度(最坏) 空间复杂度 稳定性 关键适用场景 核心特点/注意事项 冒泡排序 两两交换,最值冒泡到末尾 稳定 小规模数据、原理理解 可提前终止(无交换时),实际效率低 选择排序 找最值,交换到已排序区末尾 不稳定 小规模数据、原理理解 交换次数少,比较次数多,效率低于插入排序 插入排序 插牌式,逐个插入已排序区 稳定 小规模/近乎有序数据、链表排序 实际效率高于冒泡/选择,STL sort小数组优化 希尔排序 分组插入排序,缩小增量 不稳定 中等规模数据 插入排序的优化版,效率提升显著 快速排序 分治,基准分区 不稳定 通用场景、大规模数据 STL sort底层核心,随机基准避免最坏情况 归并排序 分治,先拆后合 稳定 稳定排序、逆序对统计、外部排序 时间复杂度稳定,需额外空间 堆排序 大顶堆,堆顶交换到末尾 不稳定 TopK问题、大规模数据 无最坏情况,适合内存受限场景 计数排序 统计频率,还原数组 稳定 数值范围小的整数排序(如成绩) 非比较排序,仅支持整数,k为数值范围 基数排序 按位排序,基于计数排序 稳定 位数少的整数/字符串(如手机号) 非比较排序,d为最大位数,k为基数(10)
数组基本应用
数组的扩容
-
普通数组长度固定,扩容 / 缩容需要手动复制元素(O (n) 时间)
-
核心思路:预分配超额空间(capacity),扩容时按倍数(比如 2 倍)增长,减少扩容次数
-
关键操作:
- 插入:尾部插入 O (1)(均摊),中间插入仍 O (n)(但减少了频繁扩容的开销);
- 扩容:当
size == capacity时,分配 2 倍新空间,复制旧元素,释放旧空间
-
代码实现
template <typename T> class DynamicArray { private: T* data; int size; // 实际元素数 int capacity; // 总容量 // 扩容:2 倍增长 void resize() { capacity = capacity == 0 ? 4 : capacity * 2; T* new_data = new T[capacity]; for (int i = 0; i < size; i++) { new_data[i] = data[i]; } delete[] data; data = new_data; } public: DynamicArray() : size(0), capacity(0), data(nullptr) {} // 尾部添加(均摊 O(1)) void push_back(const T& val) { if (size == capacity) resize(); data[size++] = val; } // 随机访问(O(1)) T& operator[](int idx) { if (idx < 0 || idx >= size) throw out_of_range("Index out of bounds"); return data[idx]; } };
移除数组元素
-
给定一个数组和指定数字,原地删除数组中所有指定数字,并返回移除后数组的新长度;要求不使用额外的数组空间,必须仅使用 O(1) 额外空间并原地修改输入数组
-
暴力解法
-
两层 for 循环,外循环遍历数组元素,内循环更新数组
-
示例代码
class Solution { public: int removeElement(vector<int>& nums, int val) { int size = nums.size(); for (int i = 0; i < size; i++) { if (nums[i] == val) { // 发现需要移除的元素,就将数组集体向前移动一位 for (int j = i + 1; j < size; j++) { nums[j - 1] = nums[j]; } i--; // 因为下标i以后的数值都向前移动了一位,所以i也向前移动一位 size--; // 此时数组的大小-1 } } return size; } }; -
上述实现的时间复杂度为 ,空间复杂度为
-
-
双指针法(快慢指针法)
-
通过一个快指针,一个慢指针,在一个 for 循环下完成
-
快指针:寻找新的数组元素,即不包含待删除数字的新数组
-
满指针:指向更新新数组下标的位置,每次填入了非待删除数字之后自增
-
示例代码
class Solution { public: int removeElement(vector<int>& nums, int val) { int slowIndex = 0; for (int fastIndex = 0; fastIndex < nums.size(); fastIndex++) { if (val != nums[fastIndex]) { nums[slowIndex++] = nums[fastIndex]; } } return slowIndex; } }; -
上述实现的时间复杂度为 ,空间复杂度为
-
-
相关题目
对有序数组的平方排序
-
给定一个有序数组,对其每一位平方,并保证输出仍旧有序
-
暴力排序
-
先求平方,再排序
-
示例代码
class Solution { public: vector<int> sortedSquares(vector<int>& A) { for (int i = 0; i < A.size(); i++) { A[i] *= A[i]; } sort(A.begin(), A.end()); // 快速排序 return A; } }; -
上述实现的时间复杂度为 ,空间复杂度为
-
-
双指针法
-
核心观察:数组平方的最大值始终在数组的两端出现,因此可以在数组的两端放置两个指针,哪个大就哪个就放入结果数组中,并移动该指针
-
示例代码
class Solution { public: vector<int> sortedSquares(vector<int>& A) { int k = A.size() - 1; vector<int> result(A.size(), 0); for (int i = 0, j = A.size() - 1; i <= j;) { // 注意这里要i <= j,因为最后要处理两个元素 if (A[i] * A[i] < A[j] * A[j]) { result[k--] = A[j] * A[j]; j--; } else { result[k--] = A[i] * A[i]; i++; } } return result; } }; -
上述实现的时间复杂度为 ,空间复杂度为
-
特判情况优化
- 如果首元素非负,那么所有元素都非负,此时直接按顺序平方即可
- 如果最后一个元素非正,那么所有元素都非正,此时直接按顺序平方并倒序即可
- 头尾平方的大小比较直接将头尾相加与 0 相比较即可,如果大于 0 说明应该移动尾指针,否则移动头指针
-
-
相关题目
长度最小子数组
-
给定一个正整数数组和正整数,找出满足其和大于等于该整数的长度最小的连续子数组
-
暴力解法
-
外层遍历数组的每个元素,内层遍历以该元素为起始的所有子数组,寻找所有符合条件的子数组
-
示例代码
class Solution { public: int minSubArrayLen(int s, vector<int>& nums) { int result = INT32_MAX; // 最终的结果 int sum = 0; // 子序列的数值之和 int subLength = 0; // 子序列的长度 for (int i = 0; i < nums.size(); i++) { // 设置子序列起点为i sum = 0; for (int j = i; j < nums.size(); j++) { // 设置子序列终止位置为j sum += nums[j]; if (sum >= s) { // 一旦发现子序列和超过了s,更新result subLength = j - i + 1; // 取子序列的长度 result = result < subLength ? result : subLength; break; // 因为我们是找符合条件最短的子序列,所以一旦符合条件就break } } } // 如果result没有被赋值的话,就返回0,说明没有符合条件的子序列 return result == INT32_MAX ? 0 : result; } }; -
上述实现的时间复杂度为 ,空间复杂度为
-
-
滑动窗口法
-
滑动窗口,即不断调节子序列的起始位置和终止位置
-
以两个指针表示滑动窗口的起始和终止位置,终止指针不断右移,当窗口符合条件时,记录子序列长度,并向右移动起始指针直至窗口不再符合条件,继续重复刚刚的过程,直到最后找到符合条件的最短的子数组
-
事实上,滑动窗口也可以看作是双指针法的一种应用
-
这种实现方法需要关注三点:窗口内是什么?如何移动起始位置?如何移动结束位置?
-
在本题中
- 窗口即满足其和大于等于 s 的长度最小的连续子数组
- 窗口的起始位置如何移动:如果当前窗口的值大于等于 s,窗口就向右进行移动,缩小窗口
- 窗口的终止位置如何移动:即不断地遍历数组,for 循环中的索引
-
具体实现
class Solution { public: int minSubArrayLen(int s, vector<int>& nums) { int result = INT32_MAX; int sum = 0; // 滑动窗口数值之和 int i = 0; // 滑动窗口起始位置 int subLength = 0; // 滑动窗口的长度 for (int j = 0; j < nums.size(); j++) { sum += nums[j]; // 注意这里使用while,每次更新 i(起始位置),并不断比较子序列是否符合条件 // 因为可能 nums[j] 是一个很大的数字,此时仅仅向右移动一次 i,可能还不是最短的子数组 while (sum >= s) { subLength = (j - i + 1); // 取子序列的长度 result = result < subLength ? result : subLength; sum -= nums[i++]; // 这里体现出滑动窗口的精髓之处,不断变更i(子序列的起始位置) } } // 如果result没有被赋值的话,就返回0,说明没有符合条件的子序列 return result == INT32_MAX ? 0 : result; } }; -
上述实现的时间复杂度为 ,空间复杂度为
-
-
时间复杂度的计算,主要看每一个元素被操作的次数,而在滑动窗口法中,每个元素在滑动窗口进来操作一次,出去操作一次,即被操作两次,也即
-
相关题目
螺旋矩阵
-
给定一个正整数 n,生成一个包含 1 到 n^2 所有元素,且元素按顺时针顺序螺旋排列的正方形矩阵
-
模拟方法
-
模拟顺时针画矩阵的过程:
- 填充上行从左到右
- 填充右列从上到下
- 填充下行从右到左
- 填充左列从下到上
-
类似二分法,需要维持遍历区间的循环不变量原则,比如保持都是左闭右开,模拟转一圈过程中的四个方向的填充过程
-
转的圈数就是 n/2,对于 n 为奇数,需要最后填充中心位置的元素
-
示例代码
class Solution { public: vector<vector<int>> generateMatrix(int n) { vector<vector<int>> res(n, vector<int>(n, 0)); // 使用vector定义一个二维数组 int startx = 0, starty = 0; // 定义每循环一个圈的起始位置 int loop = n / 2; // 每个圈循环几次,例如n为奇数3,那么loop = 1 只是循环一圈,矩阵中间的值需要单独处理 int mid = n / 2; // 矩阵中间的位置,例如:n为3, 中间的位置就是(1,1),n为5,中间位置为(2, 2) int count = 1; // 用来给矩阵中每一个空格赋值 int offset = 1; // 需要控制每一条边遍历的长度,每次循环右边界收缩一位 int i,j; while (loop --) { i = startx; j = starty; // 下面开始的四个for就是模拟转了一圈 // 模拟填充上行从左到右(左闭右开) for (j; j < n - offset; j++) { res[i][j] = count++; } // 模拟填充右列从上到下(左闭右开) for (i; i < n - offset; i++) { res[i][j] = count++; } // 模拟填充下行从右到左(左闭右开) for (; j > starty; j--) { res[i][j] = count++; } // 模拟填充左列从下到上(左闭右开) for (; i > startx; i--) { res[i][j] = count++; } // 第二圈开始的时候,起始位置要各自加1, 例如:第一圈起始位置是(0, 0),第二圈起始位置是(1, 1) startx++; starty++; // offset 控制每一圈里每一条边遍历的长度 offset += 1; } // 如果n为奇数的话,需要单独给矩阵最中间的位置赋值 if (n % 2) { res[mid][mid] = count; } return res; } }; -
上述实现的时间复杂度为 ,空间复杂度为
-
-
第二种模拟方法
-
第一种方法围绕圈数而确定循环次数,每一圈定义四个方向的循环过程
-
而更方便的方法是,以数字最大大小 为循环条件,示例代码如下
class Solution { public int[][] generateMatrix(int n) { int i = 0, j = 0, m = 0; int[][] ints = new int[n][n]; while (m < n * n) { for (; j < n - i - 1; j++) ints[i][j] = ++m; for (; i < j; i++) ints[i][j] = ++m; for (; j > n - i - 1; j--) ints[i][j] = ++m; for (; i > j + 1 || m == n*n-1; i--) ints[i][j] = ++m; } return ints; } }
-
-
第三种模拟方法
-
上述方法中,每次循环依旧定义了四个方向的循环过程,对每个方向的边界条件进行判定
-
而可以在每次达到边界条件后,就调整方向,示例代码如下
class Solution { public: vector<vector<int>> generateMatrix(int n) { vector<vector<int>> res(n, vector<int>(n, 0)); int dx = 0, dy = 1; int x = 0, y = 0; for (int i = 1; i <= n * n; ++i) { res[x][y] = i; if (res[(x + dx) % n][(y + dy) % n] != 0) { int tmp = dy; dy = -dx; dx = tmp; } x += dx; y += dy; } return res; } }; -
进一步的,可以定义一个方向数组,示例代码如下
class Solution { public int[][] generateMatrix(int n) { // 定义四个方向,按顺时针方向 int[][] directions = new int[][]{{0, 1}, {1, 0}, {0, -1}, {-1, 0}}; int directionIndex = 0; // 初始化矩阵和起始位置 int[][] matrix = new int[n][n]; int y = 0; int x = 0; int step = 1; while (step <= n * n) { matrix[y][x] = step++; if (step > n * n) { break; } // 先尝试往之前的方向继续走 int[] direction = directions[directionIndex]; int nextY = y + direction[0]; int nextX = x + direction[1]; // 不能走(超过边界或走过)再试其它方向 while (nextX < 0 || n <= nextX || nextY < 0 || n <= nextY || matrix[nextY][nextX] != 0) { directionIndex = (directionIndex + 1) % directions.length; direction = directions[directionIndex]; nextY = y + direction[0]; nextX = x + direction[1]; } y = nextY; x = nextX; } return matrix; } }
-
-
相关题目
- 54. 螺旋矩阵:非方阵
- 59. 螺旋矩阵 II:方阵
- 885. 螺旋矩阵 III:任意位置开始,且可以越界
- 2326. 螺旋矩阵 IV:链表+非方阵
- LCR 146. 螺旋遍历二维数组
二分查找
二分查找模板
-
二分查找的前提:数组必须有序,且没有重复元素
-
二分查找的关键:对边界条件的处理
- 最重要的是先弄清楚二分查找的区间定义
- 在二分查找的过程中,需要保持区间的定义为不变量,在 while 查找中每一次对边界的处理都要坚持根据区间的定义来操作——循环不变量原则
-
二分法的区间定义一般为两种,左闭右闭即 [left, right],或者左闭右开即 [left, right)
-
在左闭右闭的类型中
-
while(left <= right):因为右边是闭区间,left==right是有意义的 -
if(nums[middle] > target)) right = middle - 1:因为要保持左闭右闭的不变量,而nums[middle]一定不是 target,因此接下来要查找的区间的下标位置就是middle - 1 -
代码示例
class Solution { public: int search(vector<int>& nums, int target) { int left = 0; int right = nums.size() - 1; // 定义target在左闭右闭的区间里,[left, right] while (left <= right) { // 当left==right,区间[left, right]依然有效,所以用 <= int middle = left + ((right - left) / 2);// 防止溢出 等同于(left + right)/2 if (nums[middle] > target) { right = middle - 1; // target 在左区间,所以[left, middle - 1] } else if (nums[middle] < target) { left = middle + 1; // target 在右区间,所以[middle + 1, right] } else { // nums[middle] == target return middle; // 数组中找到目标值,直接返回下标 } } // 未找到目标值 return -1; } }; -
上述实现的时间复杂度为 ,空间复杂度为
-
-
在左闭右开的类型中
-
while(left < right):因为右边是开区间,left==right是无法取到的 -
if(nums[middle] > target)) right = middle:因为要保持左闭右开的不变量,而nums[middle]不等于 target,因此接下来要查找的区间的下标位置就是middle -
代码示例
class Solution { public: int search(vector<int>& nums, int target) { int left = 0; int right = nums.size(); // 定义target在左闭右开的区间里,即:[left, right) while (left < right) { // 因为left == right的时候,在[left, right)是无效的空间,所以使用 < int middle = left + ((right - left) >> 1); if (nums[middle] > target) { right = middle; // target 在左区间,在[left, middle)中 } else if (nums[middle] < target) { left = middle + 1; // target 在右区间,在[middle + 1, right)中 } else { // nums[middle] == target return middle; // 数组中找到目标值,直接返回下标 } } // 未找到目标值 return -1; } }; -
上述实现的时间复杂度为 ,空间复杂度为
-
-
找最后一个或第一个目标值的索引
// 找第一个等于target的索引 int binarySearchFirst(const vector<int>& nums, int target) { int left = 0, right = nums.size() - 1; int res = -1; // 初始化为未找到 while (left <= right) { int mid = left + (right - left) / 2; if (nums[mid] == target) { res = mid; // 记录找到的索引 right = mid - 1; // 继续找左边的相同元素 } else if (nums[mid] > target) { right = mid - 1; } else { left = mid + 1; } } return res; } // 找最后一个等于target的索引 int binarySearchLast(const vector<int>& nums, int target) { int left = 0, right = nums.size() - 1; int res = -1; while (left <= right) { int mid = left + (right - left) / 2; if (nums[mid] == target) { res = mid; // 记录找到的索引 left = mid + 1; // 继续找右边的相同元素 } else if (nums[mid] > target) { right = mid - 1; } else { left = mid + 1; } } return res; } -
相关题目
二分查找变形
-
设
nums为递增(非递减)数组,长为 -
常用转化
需求 写法 如果不存在 的第一个元素的下标 lowerBound(nums, x)结果为 的第一个元素的下标 lowerBound(nums, x + 1)结果为 的最后一个元素的下标 lowerBound(nums, x) - 1结果为 的最后一个元素的下标 lowerBound(nums, x + 1) - 1结果为 -
求个数
需求 写法 的元素个数 lowerBound(nums, x)的元素个数 lowerBound(nums, x + 1)的元素个数 的元素个数 -
注意: 和 互为补集,元素个数之和为 ; 和 同理
-
实现 lowerBound 函数
// lower_bound 返回最小的满足 nums[i] >= target 的下标 i // 如果数组为空,或者所有数都 < target,则返回 nums.size() // 要求 nums 是非递减的,即 nums[i] <= nums[i + 1] int lower_bound(vector<int>& nums, int target) { int left = 0, right = (int) nums.size() - 1; // 闭区间 [left, right] while (left <= right) { // 区间不为空 // 循环不变量: // nums[left-1] < target // nums[right+1] >= target int mid = left + (right - left) / 2; if (nums[mid] >= target) { right = mid - 1; // 范围缩小到 [left, mid-1] } else { left = mid + 1; // 范围缩小到 [mid+1, right] } } // 循环结束后 left = right+1 // 此时 nums[left-1] < target 而 nums[left] = nums[right+1] >= target // 所以 left 就是第一个 >= target 的元素下标 return left; } -
为何二分查找中找到 target 不立即返回?
-
在二分查找过程中,若找到等于
target的元素就立即返回下标,这种实现方式的适用场景会非常有限,核心原因如下: -
无法保证返回首个匹配元素的下标:当数组中存在多个等于
target的元素时(如有序数组[1,1,3,3,3,3,5]),中途找到target就返回,得到的下标可能是任意一个匹配元素的位置,而非第一个等于target的元素下标 -
首个匹配下标具备更强的通用性:返回第一个等于
target的元素下标,能够解决更复杂的问题场景。例如,要计算上述数组中 “小于 3 的元素个数”:- 若通过二分找到第一个等于 3 的元素下标(即 2),则下标小于 2 的所有元素均为小于 3 的数,可直接得出个数为 2;
- 若二分中途找到 3 就返回(可能返回下标 3、4、5 等),则无法准确计算出 “小于 3 的元素个数”,导致答案错误
-
综上,二分查找中不急于返回匹配到的
target下标,而是持续收缩区间直至找到首个匹配项,是为了保证逻辑的通用性,满足更多实际问题的求解需求
-
-
实现 upperBound 函数
// upper_bound 返回最小的满足 nums[i] > target 的下标 i // 如果数组为空,或者所有数都 <= target,则返回 nums.size() // 要求 nums 是非递减的,即 nums[i] <= nums[i + 1] int upper_bound(vector<int>& nums, int target) { int left = 0, right = (int) nums.size() - 1; // 闭区间 [left, right] while (left <= right) { // 区间不为空 // 循环不变量: // nums[left-1] <= target // nums[right+1] > target int mid = left + (right - left) / 2; // 避免整数溢出,等价于 (left+right)/2 if (nums[mid] > target) { right = mid - 1; // 范围缩小到 [left, mid-1] } else { left = mid + 1; // 范围缩小到 [mid+1, right] } } // 循环结束后 left = right+1 // 此时 nums[left-1] <= target 而 nums[left] = nums[right+1] > target // 所以 left 就是第一个 > target 的元素下标 return left; } -
需求的实现
// 1. 找到 >= x 的第一个元素的下标(等价于直接调用 lower_bound) int find_first_ge(vector<int>& nums, int x) { return lower_bound(nums, x); } // 2. 找到 > x 的第一个元素的下标(等价于找 >= x+1 的第一个下标) int find_first_gt(vector<int>& nums, int x) { return lower_bound(nums, x + 1); } // 3. 找到 < x 的最后一个元素的下标(不存在则返回 -1) int find_last_lt(vector<int>& nums, int x) { int idx = lower_bound(nums, x) - 1; return idx; // 若所有元素 >=x,idx 会是 -1,符合要求 } // 4. 找到 <= x 的最后一个元素的下标(不存在则返回 -1) int find_last_le(vector<int>& nums, int x) { int idx = lower_bound(nums, x + 1) - 1; return idx; } // 5. 统计 < x 的元素个数(等价于 >=x 的第一个下标) int count_less(vector<int>& nums, int x) { return lower_bound(nums, x); } // 6. 统计 <= x 的元素个数(等价于 >x 的第一个下标) int count_le(vector<int>& nums, int x) { return lower_bound(nums, x + 1); } // 7. 统计 >= x 的元素个数 int count_ge(vector<int>& nums, int x) { int n = nums.size(); return n - lower_bound(nums, x); } // 8. 统计 > x 的元素个数 int count_gt(vector<int>& nums, int x) { int n = nums.size(); return n - lower_bound(nums, x + 1); }
在排序数组中查找元素的第一个和最后一个位置
-
给你一个按照非递减顺序排列的整数数组
nums,和一个目标值target。请你找出给定目标值在数组中的开始位置和结束位置 -
如果数组中不存在目标值
target,返回[-1, -1] -
你必须设计并实现时间复杂度为
O(log n)的算法解决此问题 -
代码实现
class Solution { public: vector<int> searchRange(vector<int>& nums, int target) { int left = 0, right = nums.size() - 1, mid = 0; while (left <= right) { mid = left + (right - left) / 2; if (nums[mid] < target) { left = mid + 1; } else if (nums[mid] > target) { right = mid - 1; } else { int leftRange = mid, rightRange = mid; while (leftRange > 0 && nums[leftRange - 1] == target) leftRange--; while (rightRange < nums.size() - 1 && nums[rightRange + 1] == target) rightRange++; return {leftRange, rightRange}; } } return {-1, -1}; } }; -
使用 lowerBound 函数实现
class Solution { public: vector<int> searchRange(vector<int>& nums, int target) { int start = lower_bound(nums, target); if (start == nums.size() || nums[start] != target) { return {-1, -1}; // nums 中没有 target } // 如果 start 存在,那么 end 必定存在 int end = lower_bound(nums, target + 1) - 1; return {start, end}; } }; -
库函数实现
class Solution { public: vector<int> searchRange(vector<int>& nums, int target) { int start = ranges::lower_bound(nums, target) - nums.begin(); if (start == nums.size() || nums[start] != target) { return {-1, -1}; } int end = ranges::lower_bound(nums, target+1) - nums.begin() - 1; return {start, end}; } }; -
关于
end = lowerBound(nums, target + 1) - 1的逻辑解析- 若要查找数组中小于等于 target 的最后一个元素的下标,无需单独编写新的二分查找逻辑,可复用已实现的
lowerBound函数(用于查找大于等于目标值的第一个元素下标):- 核心思路是先定位到该目标元素的右侧相邻元素,即大于 target 的第一个元素的下标;
- 在数组元素均为整数的前提下,“大于 target” 等价于 “大于等于 target + 1”,因此可直接调用
lowerBound(nums, target + 1)得到该右侧相邻元素的下标; - 将该下标减 1,即可得到数组中小于等于 target 的最后一个元素的下标,即
end = lowerBound(nums, target + 1) - 1。
- 关于
lowerBound(nums, target + 1)返回值不存在的情况(即无大于等于 target + 1 的元素):- 此情况表明数组中所有元素均小于等于 target;
- 由于数组是递增排列的,若数组中存在 target,则最后一个元素(下标为 n−1,n 为数组长度)即为 target;
- 此时
lowerBound(nums, target + 1)会返回数组长度 n,将其减 1 后得到 n−1,恰好是数组最后一个元素的下标,与我们需要查找的结果一致
- 若要查找数组中小于等于 target 的最后一个元素的下标,无需单独编写新的二分查找逻辑,可复用已实现的
搜索二维矩阵
- 参考题目
二分答案
二分答案模板
-
二分区间的本质是「待验证区间」
- 初始二分区间
[left, right]只是我们 “猜” 的需要验证的范围; - 那些不在这个区间里的数,要么是「已经确定不满足条件」(比如 <10 的数),要么是「已经确定满足条件」(比如 > 32 的数);
- 二分的过程只是缩小待验证范围,直到待验证范围为空,此时
left自然指向「第一个满足条件的数」(哪怕这个数不在初始区间里)
- 初始二分区间
-
二分答案的核心是利用单调性(除数越大,求和结果越小):
- 确定判断条件:给定一个除数
m,计算sum(ceil(nums[i]/m)),判断是否 ≤ threshold - 二分查找框架:在一个范围内找最小的
m,满足上述条件。 - 边界收缩:
- 如果当前
m满足条件 → 尝试找更小的,收缩右边界; - 如果不满足 → 必须增大
m,收缩左边界
- 优化初始范围的上下界可以减少二分查找次数
- 确定判断条件:给定一个除数
-
二分答案的一个难点是
check函数怎么写,这会涉及到贪心等技巧 -
代码模板
class Solution { public: // 计算满足 check(x) == true 的最小整数 x int binarySearchMin(vector<int>& nums) { // 二分猜答案:判断 mid 是否满足题目要求 auto check = [&](int mid) -> bool { }; int left = ; // 循环不变量:check(left) 恒为 false int right = ; // 循环不变量:check(right) 恒为 true // 闭区间写法:[left, right] 不为空时继续循环 while (left <= right) { int mid = left + (right - left) / 2; if (check(mid)) { // 说明 check(>= mid 的数) 均为 true right = mid - 1; // 收缩右边界,在 [left, mid-1] 中找更小的解 } else { // 说明 check(<= mid 的数) 均为 false left = mid + 1; // 收缩左边界,在 [mid+1, right] 中找解 } } // 循环结束后 left > right // 此时 check(right) == false 而 check(left) == true // 所以 left 就是最小的满足 check 的值 return left; } };
求最小
使结果不超过阈值的最小除数
-
给你一个整数数组
nums和一个正整数threshold,你需要选择一个正整数作为除数,然后将数组里每个数都除以它,并对除法结果求和 -
请你找出能够使上述结果小于等于阈值
threshold的除数中 最小 的那个 -
每个数除以除数后都向上取整
-
关于向上取整
-
关于上取整的计算,当 和 均为正整数时,有
-
证明见 上取整下取整转换公式的证明
-
对于任意除数 ,有两个关键不等式(向上取整的数学性质):
- (向上取整结果 ≥ 原除法结果)
- (向上取整的等价公式)
-
-
满足二分答案性质
-
假设除数为 ,根据题意,每个数除以 再上取整,元素和为
-
由于 越大,上式越小,有单调性,可以二分答案
-
最小的满足 的 就是答案
-
-
边界条件
- 闭区间左端点初始值:
- 闭区间右端点初始值:,此时 一定成立
- 注意题目数据范围保证
-
左边界条件的优化
-
利用向上取整的下界性质:
-
因为目标是让求和结果 ≤ threshold,所以:
-
变形得:
-
但这是理论下界,结合题目中“每个数向上取整”的特性,可以进一步收紧下界:
-
已知 (因为 是正整数, 是正整数),所以
-
如果假设求和结果的“宽松上限”是 (用于缩小左边界范围),则:
-
变形得
-
由于 是正整数,取整后就是:
-
这就是优化后的 left,用 是为了处理整除的情况,比如 时,,而 ,更贴合整数取整逻辑
-
-
右边界条件的优化
-
利用向上取整的上界公式 ,对数组求和:
-
要让求和结果 ≤ threshold,因此:
-
变形:
-
但这不是上界,换个思路:要找“一定满足条件”的最大 作为上界
-
已知当 时,(题目保证 )
-
但可以更精确:回到向上取整的核心,若 满足 ,则:
-
因为单个元素的向上取整结果 ≤ 总和
-
变形得:
-
结合总和的上界推导,要找“足够大的 使得求和结果一定 ≤ threshold”,取最宽松的上界:
-
当 时,必然满足条件
-
同样转为整数取整:
-
这就是优化后的 right, 是为了确保上界覆盖所有可能的解
-
-
此时 变成
-
即
-
时间复杂度:,其中 是 的长度,;二分 次,每次 遍历
-
空间复杂度:
-
注意「求最小」和「求最大」的二分写法上的区别
- 「求最小」和二分查找求「排序数组中某元素的第一个位置」是类似的,按照红蓝染色法,左边是不满足要求的(红色),右边则是满足要求的(蓝色)
- 「求最大」的题目则相反,左边是满足要求的(蓝色),右边是不满足要求的(红色)。这会导致二分写法和上面的「求最小」有一些区别
-
代码实现
class Solution { public: // 题目:找到最小的除数 m,使得数组中每个数除以 m 的向上取整之和 ≤ threshold int smallestDivisor(vector<int>& nums, int threshold) { // 验证函数:判断除数 m 是否满足「所有数除以 m 的向上取整之和 ≤ threshold」 auto check = [&](int m) -> bool { int sum = 0; // 存储所有数除以 m 向上取整的和 for (int x : nums) { // (x + m - 1) / m 是整数除法实现向上取整的经典写法(等价于 ceil(x/m)) sum += (x + m - 1) / m; if (sum > threshold) { // 提前退出:和已超过阈值,无需继续计算 return false; } } return true; // 所有数计算完后和仍≤阈值,m 是可行解 }; // ========== 闭区间二分 ========== // 初始左边界设为1(除数不能为0,1是最小有效除数) int left = 1; // 初始右边界仍为数组最大值(保证 check(right) 恒为 true) int right = ranges::max(nums); // 闭区间循环条件:[left, right] 不为空时继续 while (left <= right) { int mid = left + (right - left) / 2; // 计算中间值,避免溢出 if (check(mid)) { // mid 是可行解,尝试找更小的除数 → 收缩右边界 right = mid - 1; } else { // mid 不可行,需要更大的除数 → 收缩左边界 left = mid + 1; } } // 循环结束后 left > right,left 是第一个满足 check 的最小除数 return left; } };
完成旅途的最少时间
-
给你一个数组
time,其中time[i]表示第i辆公交车完成 一趟旅途 所需要花费的时间。 -
每辆公交车可以 连续 完成多趟旅途,也就是说,一辆公交车当前旅途完成后,可以 立马开始 下一趟旅途。每辆公交车 独立 运行,也就是说可以同时有多辆公交车在运行且互不影响。
-
给你一个整数
totalTrips,表示所有公交车 总共 需要完成的旅途数目。请你返回完成 至少totalTrips趟旅途需要花费的 最少 时间 -
设所求时间为 m,则有
-
下界怎么取?可以为 ,即如果最慢的一辆车还没有完成一次旅途,就不可能达成条件
-
同时
-
因此可以推导下界
-
可以取下界
-
那么上界怎么取?显然,上界可以为 ,即考虑只让最快的车跑完所有旅途,一定满足条件
-
假设所有车的速度都是 mx,那么有
-
显然,大于这个值的 m 一定能满足要求,则可以取
-
代码实现
class Solution { public: bool check(vector<int>& time, int totalTrips, long long target) { long long trueTrips = 0; for (int num : time) { trueTrips += target / num; } return trueTrips >= totalTrips; } long long minimumTime(vector<int>& time, int totalTrips) { int mx = 0, mn = INT_MAX, n = time.size(); for (int num : time) { mx = max(mx, num); mn = min(mn, num); } long long left = 1LL * ((totalTrips - 1) / n + 1) * mn, right = min(1LL * ((totalTrips - 1) / n + 1) * mx, 1LL * mn * totalTrips); while (left <= right) { long long mid = left + (right - left) / 2; if (check(time, totalTrips, mid)) { right = mid - 1; } else { left = mid + 1; } } return left; } };
减小数组使其满足条件的最小 K 值
-
给你一个 正 整数数组
nums -
对于一个正整数
k,定义nonPositive(nums, k)为使nums的每个元素都变为 非正数 所需的 最小 操作 次数。在一次操作中,你可以选择一个下标i并将nums[i]减少k -
返回一个整数,表示满足
nonPositive(nums, k) <= k2的k的 最小 值 -
对于不等式
-
当 逐渐增大时,操作次数会变小(或者不变),所以 会变小(或者不变);另一方面, 会随着 的增大而增大
-
所以当 较小时,不等式不成立;当 较大时,不等式成立
-
据此,可以二分猜答案
-
现在问题转化成一个判定性问题:给定 ,计算每个数的操作次数,判断不等式是否成立;如果成立,说明答案 ,否则答案
-
对于 ,设需要操作 次,那么有
-
解得
-
由于 是整数,所以最小操作次数为
-
所以有
-
闭区间初始值
-
闭区间左端点初始值:,无法满足题目要求。
-
闭区间左端点初始值(优化):
- 由于 中的元素都是正数,每个数都至少要操作一次,所以 ,所以 必须满足 ,即
-
闭区间右端点初始值:
- 其中 ,此时
- 如果 ,那么满足题目要求
- 这引出了一个特殊情况:如果 ,那么答案就是理论最小值 ,此时 为 ,一定成立,可以提前返回 ,无需二分
-
-
所以
-
这样做可以避免浮点运算,避免浮点数的舍入误差导致计算错误
-
上下界优化
-
由于
-
解得
-
其中
-
所以答案的下界,可以改进为
-
设
-
如果 ,根据 的单调性,我们有
-
所以 是答案的上界
-
如果 呢?此时 ,得 ,所以答案就是
求最大
H 指数 II
-
题目:275. H 指数 II
-
给你一个整数数组
citations,其中citations[i]表示研究者的第i篇论文被引用的次数,citations已经按照 非降序排列 。计算并返回该研究者的 h 指数 -
h 指数的定义:h 代表“高引用次数”(high citations),一名科研人员的
h指数是指他(她)的 (n篇论文中)至少 有h篇论文分别被引用了至少h次 -
请你设计并实现对数时间复杂度的算法解决此问题
-
这是二分答案求最大的问题
-
显然,left 一定是满足条件的,而 right 一定不满足条件
- left 可以取数组长度与最少引用数的最小值
- right 可以取数组长度与最多引用数的最小值,因为至少被引用最大值次的论文一定有最大值篇
-
代码实现
class Solution { public: bool check(vector<int>& citations, int h) { int total = 0; for (int num : citations) { total += (num >= h); if (total >= h) return true; } return false; } int hIndex(vector<int>& citations) { int mx = 0, mn = 1001; for (int num : citations) { mx = max(mx, num); mn = min(mn, num); } int left = min((int)citations.size(), mn), right = min((int)citations.size(), mx); while (left <= right) { int mid = left + (right - left) / 2; if (check(citations, mid)) { left = mid + 1; } else { right = mid - 1; } } return right; } };
每个小孩最多能分到多少糖果
-
给你一个 下标从 0 开始 的整数数组
candies。数组中的每个元素表示大小为candies[i]的一堆糖果。你可以将每堆糖果分成任意数量的 子堆 ,但 无法 再将两堆合并到一起 -
另给你一个整数
k。你需要将这些糖果分配给k个小孩,使每个小孩分到 相同 数量的糖果。每个小孩可以拿走 至多一堆 糖果,有些糖果可能会不被分配 -
返回每个小孩可以拿走的 最大糖果数目
-
如果选择 m 个糖果可以满足,那么选少于 m 个糖果一定也能满足,因此具有单调性
- 左边界可选为 0
- 右边界为 sum/k 的上界,一定无法满足
-
代码实现
class Solution { public: bool check(vector<int>& candies, long long k, long long cnt) { if (cnt == 0) return true; long long total = 0; for (int num : candies) { total += 1LL * num / cnt; if (total >= k) return true; } return false; } int maximumCandies(vector<int>& candies, long long k) { int mx = 0, mn = 1001; long long sum = 0; for (int num : candies) { sum += num; mx = max(mx, num); mn = min(mn, num); } long long left = 0; long long right = (sum - 1) / k + 1; while (left <= right) { int mid = left + (right - left) / 2; if (check(candies, k, mid)) { left = mid + 1; } else { right = mid - 1; } } return right; } };
找出出现至少三次的最长特殊子字符串 II
-
给你一个仅由小写英文字母组成的字符串
s -
如果一个字符串仅由单一字符组成,那么它被称为 特殊 字符串。例如,字符串
"abc"不是特殊字符串,而字符串"ddd"、"zz"和"f"是特殊字符串 -
返回在
s中出现 至少三次 的 最长特殊子字符串 的长度,如果不存在出现至少三次的特殊子字符串,则返回-1 -
实际上,可以存储每个字母对应的不同长度的连续序列所出现的次数,当遍历到一个更长的连续字符串时,就更新前面的短长度的连续字符串所出现的次数
class Solution { public: int maximumLength(string s) { int ans = -1; unordered_map<char, unordered_map<int, int>> charLengthCnt; for (int i = 0; i < s.size(); i++) { int pre = i; int curLength = i - pre + 1; while (i + 1 < s.size() && s[i + 1] == s[i]) i++; curLength = i - pre + 1; for (int k = 1; k <= curLength; k++) { charLengthCnt[s[i]][k] += curLength - k + 1; if (charLengthCnt[s[i]][k] >= 3) { ans = max(ans, k); } } } return ans; } }; -
以上算法的时间复杂度为 ,因为每次遇到更长的连续字符串就去更新短连续字符串的次数
-
实际上,只需要先存储各个字符对应的连续字符串的长度,然后遍历将每个字符的连续字符串的长度排序
-
对于单个字符,其 k 的最大可能值是其最长连续段长度,对于每个 k,遍历满足长度大于 k 的连续段个数,大于 3 个就提前终止,遍历下一个 k
-
代码实现
class Solution { public: int maximumLength(string s) { int ans = -1; // 只存储每个字符对应的所有连续段长度(比如 "aaabbbba" 中 'a' 对应 [3,1],'b' 对应 [4]) unordered_map<char, vector<int>> charSegments; // 第一步:拆分所有连续相同字符的段,记录长度 int n = s.size(); int i = 0; while (i < n) { char c = s[i]; int j = i; // 找到当前连续段的结束位置 while (j < n && s[j] == c) { j++; } // 记录当前段的长度 charSegments[c].push_back(j - i); i = j; } // 第二步:对每个字符,检查其所有段能组成的最长满足条件的长度 for (auto& [c, lengths] : charSegments) { // 降序排序,方便从最长的开始检查 sort(lengths.rbegin(), lengths.rend()); int maxPossible = lengths[0]; // 当前字符最长的连续段长度 // 从最长的可能长度往下找,找到第一个满足条件的 for (int k = maxPossible; k >= 1; k--) { int cnt = 0; // 计算所有段能贡献的长度为k的子串数量 for (int len : lengths) { if (len >= k) { cnt += len - k + 1; // 提前终止,避免不必要的计算 if (cnt >= 3) break; } } // 找到满足条件的长度,更新答案 if (cnt >= 3) { ans = max(ans, k); break; // 因为是从大到小找,找到就不用继续了 } } } return ans; } }; -
如果是至少出现 m 次的连续序列呢?可以使用二分查找
- 左边界
left = 1(最短的特殊子串长度) - 右边界
right = 字符串中最长的连续相同字符段长度(最长的可能特殊子串长度)
- 左边界
-
代码实现
class Solution { public: int maximumLength(string s, int m) { // 合法性校验 if (m <= 0) return -1; int n = s.size(); if (n == 0) return -1; // 步骤1:拆分连续段,并确定二分的右边界(最长连续段长度) unordered_map<char, vector<int>> charSegments; int maxSegLen = 0; // 二分的右边界 int i = 0; while (i < n) { char c = s[i]; int j = i; while (j < n && s[j] == c) j++; int segLen = j - i; charSegments[c].push_back(segLen); maxSegLen = max(maxSegLen, segLen); i = j; } // 特殊优化:m=1时直接返回最长连续段长度 if (m == 1) return maxSegLen; // 步骤2:二分查找最长满足条件的长度 int left = 1, right = maxSegLen; int ans = -1; while (left <= right) { int mid = left + (right - left) / 2; // 避免溢出 // 验证:是否存在字符,其长度为mid的特殊子串数量≥m if (isValid(mid, charSegments, m)) { ans = mid; // 记录当前满足条件的长度 left = mid + 1; // 尝试更长的长度 } else { right = mid - 1; // 尝试更短的长度 } } return ans; } private: // 验证函数:检查是否存在字符,其长度为len的特殊子串数量≥m bool isValid(int len, const unordered_map<char, vector<int>>& charSegments, int m) { for (const auto& [c, lengths] : charSegments) { int cnt = 0; for (int segLen : lengths) { if (segLen >= len) { cnt += segLen - len + 1; // 提前终止:计数已满足m次,无需继续计算 if (cnt >= m) break; } } // 找到满足条件的字符,直接返回true if (cnt >= m) return true; } return false; } };
二分间接值
正方形中的最多点数
-
给你一个二维数组
points和一个字符串s,其中points[i]表示第i个点的坐标,s[i]表示第i个点的 标签 -
如果一个正方形的中心在
(0, 0),所有边都平行于坐标轴,且正方形内 不 存在标签相同的两个点,那么我们称这个正方形是 合法 的 -
请你返回 合法 正方形中可以包含的 最多 点数
-
注意:
- 如果一个点位于正方形的边上或者在边以内,则认为该点位于正方形内
- 正方形的边长可以为零
-
首先统计每个字符所出现的所有边界,然后统计每个字符所能对应的最小边界,得到全局最小边界后,判断各个字符的第一个位置是否在边界内即可
class Solution { public: int maxPointsInsideSquare(vector<vector<int>>& points, string s) { unordered_map<char, vector<int>> radius; for (int i = 0; i < points.size(); i++) { int circle = max(abs(points[i][0]), abs(points[i][1])); radius[s[i]].push_back(circle); } int minRadius = INT_MAX; for (auto& pair : radius) { sort(pair.second.begin(), pair.second.end()); if (pair.second.size() > 1) { minRadius = min(minRadius, pair.second[1] - 1); } } int ans = 0; for (auto& pair : radius) { if (pair.second[0] <= minRadius) { ans++; } } return ans; } }; -
上述算法的时间复杂度为 ,因为有一个排序过程
-
实际上,可以在统计边界的过程中维护最小的两个边界即可
-
代码实现
class Solution { public: int maxPointsInsideSquare(vector<vector<int>>& points, string s) { unordered_map<char, pair<int, int>> radius; for (int i = 0; i < points.size(); i++) { char ch = s[i]; int circle = max(abs(points[i][0]), abs(points[i][1])); if (radius.contains(ch)) { if (circle <= radius[ch].first) { radius[ch].second = radius[ch].first; radius[ch].first = circle; } else if (circle > radius[ch].first && radius[ch].second == -1) { radius[ch].second = circle; } else if (circle < radius[ch].second) { radius[ch].second = circle; } } else { radius[ch] = make_pair(circle, -1); } } int minRadius = INT_MAX; for (auto& p : radius) { if (p.second.second != -1) { minRadius = min(minRadius, p.second.second - 1); } } int ans = 0; for (auto& pair : radius) { if (pair.second.first <= minRadius) { ans++; } } return ans; } }; -
用二分法怎么解决?
- 由于正方形边长越大,越不合法,有单调性,所以可以二分边长的一半
- 在二分中统计遇到的字符,如果没有遇到重复的字符,说明正方形合法,用字符个数更新答案的最大值
-
代码实现
class Solution { public: int maxPointsInsideSquare(vector<vector<int>>& points, string s) { int ans = 0; // 替换__builtin_popcount,提升兼容性 auto count_bits = [](int x) -> int { int cnt = 0; while (x) { cnt++; x &= x - 1; // 消除最低位的1 } return cnt; }; auto check = [&](int size) -> bool { int vis = 0; for (int i = 0; i < points.size(); i++) { int x = points[i][0], y = points[i][1]; if (abs(x) <= size && abs(y) <= size) { int c = s[i] - 'a'; if ((vis >> c) & 1) { // 标签已存在,重复 return false; } vis |= 1 << c; // 加入标签 } } ans = count_bits(vis); return true; }; // 优化右边界:取所有点的最大坐标+1,减少二分次数 int max_coord = 0; for (auto& p : points) { max_coord = max({max_coord, abs(p[0]), abs(p[1])}); } int left = -1, right = max_coord + 1; while (left + 1 < right) { int mid = left + (right - left) / 2; // 避免溢出 if (check(mid)) { left = mid; } else { right = mid; } } return ans; } };
销售价值减少的颜色球
-
你有一些球的库存
inventory,里面包含着不同颜色的球。一个顾客想要 任意颜色 总数为orders的球 -
这位顾客有一种特殊的方式衡量球的价值:每个球的价值是目前剩下的 同色球 的数目。比方说还剩下
6个黄球,那么顾客买第一个黄球的时候该黄球的价值为6。这笔交易以后,只剩下5个黄球了,所以下一个黄球的价值为5(也就是球的价值随着顾客购买同色球是递减的 -
给你整数数组
inventory,其中inventory[i]表示第i种颜色球一开始的数目。同时给你整数orders,表示顾客总共想买的球数目。你可以按照 任意顺序 卖球 -
请你返回卖了
orders个球以后 最大 总价值之和。由于答案可能会很大,请你返回答案对10^9 + 7取余数 的结果 -
可以通过模拟实现
- 要最大化总价值,核心策略是每次都优先卖出当前数量最多的那种颜色的球。直接模拟每次卖一个球的过程会超时,因此我们需要用数学方法批量计算:
- 将库存数组降序排序,方便每次取数量最多的球
- 逐层计算:每次计算当前 “最高层” 的球能卖出多少个,批量计算这一层的总价值
- 当剩余订单数不足以覆盖当前层时,计算剩余订单数对应的价值即可
class Solution { public: const int MOD = 1e9 + 7; long long calculate(int mx, int diff, int cnt) { long long sum = 1LL * (mx + mx - diff + 1); if (diff % 2 == 0) { return (sum * diff / 2) * cnt; } else { return ((sum * (diff / 2)) + sum / 2) * cnt; } } int maxProfit(vector<int>& inventory, int orders) { int n = inventory.size(); sort(inventory.begin(), inventory.end()); long long ans = 0; int cnt = 1; while (orders > 0) { if (cnt == n || (orders < (inventory[n - cnt] - inventory[n - cnt - 1]) * cnt)) { int diff = orders / cnt; ans += calculate(inventory[n - cnt], diff, cnt); for (int i = n - 1; i > n - 1 - cnt; i--) { inventory[i] -= diff; } if (orders % cnt != 0) { ans += 1LL * (orders % cnt) * inventory[n - cnt]; } orders = 0; ans %= MOD; } else { int diff = inventory[n - cnt] - inventory[n - cnt - 1]; orders -= diff * cnt; ans += calculate(inventory[n - cnt], diff, cnt); ans %= MOD; for (int i = n - 1; i > n - 1 - cnt; i--) { inventory[i] -= diff; } while (cnt < n && inventory[n - cnt] == inventory[n - cnt - 1]) { cnt++; } } } return ans % MOD; } }; - 要最大化总价值,核心策略是每次都优先卖出当前数量最多的那种颜色的球。直接模拟每次卖一个球的过程会超时,因此我们需要用数学方法批量计算:
-
时间复杂度为
-
也可以进行二分查找
-
要最大化总价值,本质是优先卖高价球(即数量多的球)。我们可以通过二分查找找到一个临界值
mid:- 所有数量 >
mid的球,都可以按mid+1, mid+2, ..., 当前数量的价格卖出; - 数量 ≤
mid的球,仅在订单还有剩余时,按mid的价格卖出(但最多卖完所有数量)
- 所有数量 >
-
实现步骤
- 二分查找确定临界价格
mid(范围:1 ~ 库存最大值) - 计算所有数量 >
mid的球能卖出的总数和总价值 - 若订单还有剩余,从数量 =
mid的球中补充卖出,计算剩余价值
- 二分查找确定临界价格
-
代码实现
class Solution { public: const int MOD = 1e9 + 7; // 计算所有数量大于mid的球能卖出的总数 long long countBalls(vector<int>& inventory, int mid) { long long total = 0; for (int num : inventory) { if (num > mid) { total += num - mid; // 提前终止,避免数值溢出 if (total > LLONG_MAX) break; } } return total; } // 计算等差数列的和:(start + end) * len / 2 long long calculateSum(int start, int end) { if (start > end) return 0; return 1LL * (start + end) * (end - start + 1) / 2; } int maxProfit(vector<int>& inventory, int orders) { // 二分查找的左右边界 int left = 1; int right = *max_element(inventory.begin(), inventory.end()); int target_price = 0; // 第一步:二分查找确定临界价格 while (left <= right) { int mid = left + (right - left) / 2; // 避免溢出 long long total = countBalls(inventory, mid); if (total > orders) { // 能卖出的数量超过订单,临界价格可以更高 target_price = mid; left = mid + 1; } else { // 能卖出的数量不足订单,临界价格需要降低 right = mid - 1; } } // 第二步:计算所有价格>target_price的球的总价值和总卖出数量 long long ans = 0; long long total_sold = 0; for (int num : inventory) { if (num > target_price) { // 计算从target_price+1到num的和 long long sum_part = calculateSum(target_price + 1, num); ans = (ans + sum_part) % MOD; total_sold += num - target_price; } } // 第三步:处理剩余订单(按target_price价格卖出) long long remaining_orders = orders - total_sold; if (remaining_orders > 0) { ans = (ans + 1LL * remaining_orders * target_price) % MOD; } return ans % MOD; } };
最小化最大值
- 本质上二分答案求最小,二分的 mid 表示上界
分割数组的最大值
-
给定一个非负整数数组
nums和一个整数m,你要将数组分割成m个连续的非空子数组 -
设这
m个子数组各自和的最大值为S -
请你找出所有可能的分割方案中,S 的最小值
-
这为什么是「二分答案」?
- 我们不是在数组里找数,而是在答案可能的范围里二分
- 对每个候选答案,判断:能不能做到?
-
第一步,确定答案范围
- 最小可能答案:
max(nums)(因为每个子数组至少包含一个元素,所以最大值不可能比这个数更小)- 可以优化为
sum(nums)/m,因为把总和为total的数组分成m份,平均每份的和是total/m,而最终的最小最大值S一定不会小于这个平均值(否则所有子数组的和加起来会小于总和)
- 可以优化为
- 最大可能答案:
sum(nums)(整个数组一组)
- 最小可能答案:
-
第二步,二分答案
- 取中间值
mid,判断能否把数组分成 ≤m 段,每段和都 ≤mid? - 如果能:说明
mid是一个可行解,尝试更小的值 → 收缩右边界 - 如果不能:说明
mid太小,满足所有子数组的和都小于等于 mid 时,已经划分出了多于 m 段,因此该最大值必须变大 → 收缩左边界
- 取中间值
-
最后收敛的值就是最小的最大和
-
代码实现
class Solution { public: int splitArray(vector<int>& nums, int m) { // 验证函数:判断 mid 是否满足「能将数组分割成 ≤m 段,且每段和 ≤mid」 auto check = [&](int mid) -> bool { int cnt = 1; // 至少分割为1段 int sum = 0; // 当前段的和 for (int x : nums) { if (sum + x > mid) { cnt++; // 超出mid,需新增一段 sum = x; // 新段从当前数开始 if (cnt > m) { // 分段数超过m,不满足条件 return false; } } else { sum += x; // 加入当前段 } } return cnt <= m; // 分段数≤m则满足条件 }; // 确定二分边界 int left = 0; // 循环不变量:check(left) 恒为 false(初始为0,一定不满足) // 右边界初始化为数组和(整个数组为1段,一定满足check(right)=true) int right = accumulate(nums.begin(), nums.end(), 0); // 修正左边界为数组最大值(更小的值不可能满足条件,缩小二分范围) for (int x : nums) { left = max(left, x); } // 闭区间写法:[left, right] 不为空时继续循环 while (left <= right) { int mid = left + (right - left) / 2; // 避免溢出 if (check(mid)) { // 说明 check(>= mid 的数) 均为 true right = mid - 1; // 收缩右边界,在 [left, mid-1] 中找更小的解 } else { // 说明 check(<= mid 的数) 均为 false left = mid + 1; // 收缩左边界,在 [mid+1, right] 中找解 } } // 循环结束后 left > right // 此时 check(right) == false 而 check(left) == true // 所以 left 就是最小的满足 check 的值 return left; } };
分配给商店的最多商品的最小值
-
给你一个整数
n,表示有n间零售商店。总共有m种商品,每种商品的数目用一个下标从 0 开始的整数数组quantities表示,其中quantities[i]表示第i种商品的数目 -
你需要将 所有商品 分配到零售商店,并遵守这些规则:
- 一间商店 至多 只能有 一种商品 ,但一间商店拥有的商品数目可以为 任意 件
- 分配后,每间商店都会被分配一定数目的商品(可能为
0件)。用x表示所有商店中分配商品数目的最大值,你希望x越小越好。也就是说,你想 最小化 分配给任意商店商品数目的 最大值
-
请你返回最小的可能的
x -
显然,这个最大值的边界为
- 最小不可能小于
sum(quantities)/n,否则没有分配完商品 - 最大不可能超过
max(quantities),因为最多分配给一间商店一种商品
- 最小不可能小于
-
如何判断是否遵守分配的规则
- 给定一个商品数目的最大值 mid ,如果某种商品的数量大于 mid,那么将这种商品按照 mid 依次分配给商店,直到分配完这种商品;如果某种商品的数量小于等于 mid,那么只需分配给一家商店
- 如果在分配的过程中,商店数目已经大于等于了 n,说明这个 mid 太小,以致于商品还没分配完,商店就不够用了
- 如果能够分配完成,即使被分配的商店数小于 n,也说明 mid 是合法的
-
代码实现
class Solution { public: bool check(int n, vector<int>& quantities, int target) { int total = 0; for (int num : quantities) { total += (num - 1) / target + 1; if (total > n) return false; } return true; } int minimizedMaximum(int n, vector<int>& quantities) { int mx = 0; long long sum = 0; for (int num : quantities) { sum += num; mx = max(mx, num); } int left = (sum - 1) / n + 1, right = mx; while (left <= right) { int mid = left + (right - left) / 2; if (check(n, quantities, mid)) { right = mid - 1; } else { left = mid + 1; } } return left; } };
最小化连通分量的最大成本
-
给你一个无向连通图,包含
n个节点,节点编号从 0 到n - 1,以及一个二维整数数组edges,其中edges[i] = [ui, vi, wi]表示一条连接节点ui和节点vi的无向边,边权为wi,另有一个整数k -
你可以从图中移除任意数量的边,使得最终的图中 最多 只包含
k个连通分量 -
连通分量的 成本 定义为该分量中边权的 最大值 。如果一个连通分量没有边,则其代价为 0
-
请返回在移除这些边之后,在所有连通分量之中的 最大成本 的 最小可能值
-
边界条件
- 连通分量的最大成本不可能小于边权的最小值
- 连通分量的最大成本不可能超过边权的最大值
- 因为连通分量的 成本 定义为该分量中边权的 最大值,因此单个连通分量的成本不可能超过图中任意一条边的权重
- 即使保留所有边,整个图只有 1 个连通分量,其成本也只是
max_w - 移除任意边后,连通分量的成本只会≤
max_w,不可能更大
-
如何判断是否遵守分配的规则
- 给定一个连通分量的最大成本 mid,如何判断能否将图划分为至多 k 个连通分量,且每个连通分量的成本小于等于 mid?
- 要判断给定 mid 是否可行,核心思路是:只保留边权≤mid 的边,然后看此时图的连通分量数量是否≤k
- 筛选边:先过滤掉所有边权 > mid 的边,因为这些边如果保留,会导致所在连通分量的成本超过 mid,违反规则
- 计算连通分量数:用并查集(Union-Find/Disjoint Set Union,DSU)结构,对筛选后的边进行合并操作,统计最终的连通分量数量
- 判断可行性:如果最终连通分量数≤k,说明 mid 是一个可行的候选值;否则不可行
-
代码实现
class Solution { private: // 并查集核心结构 vector<int> parent; int count; // 记录连通分量数量 // 查找根节点(带路径压缩) int find(int x) { if (parent[x] != x) { parent[x] = find(parent[x]); } return parent[x]; } // 合并两个节点 void unite(int x, int y) { int rootX = find(x); int rootY = find(y); if (rootX != rootY) { parent[rootY] = rootX; count--; // 连通分量数减1 } } public: // 核心判断函数:检查target是否是可行的最大成本 bool check(int n, vector<vector<int>>& edges, int k, long long target) { // 初始化并查集 parent.resize(n); count = n; // 初始时每个节点都是独立的连通分量 for (int i = 0; i < n; i++) { parent[i] = i; } // 只保留边权 ≤ target 的边,合并对应节点 for (auto& edge : edges) { int u = edge[0]; int v = edge[1]; int w = edge[2]; if (w <= target) { unite(u, v); } } // 连通分量数 ≤ k 则可行 return count <= k; } int minCost(int n, vector<vector<int>>& edges, int k) { // 特殊情况:k ≥ n 时,可移除所有边,成本为0 if (k >= n) { return 0; } int mn = INT_MAX, mx = 0; for (vector<int> edge : edges) { int num = edge[2]; mx = max(mx, num); mn = min(mn, num); } long long left = mn; long long right = mx; while (left <= right) { int mid = left + (right - left) / 2; // 防止溢出 if (check(n, edges, k, mid)) { // 可行,尝试找更小的target right = mid - 1; } else { // 不可行,需要更大的target left = mid + 1; } } return left; } }; -
但更简单的是,直接用贪心 + 并查集从小到大合并边,直到连通块数≤k,此时最后合并的边权就是答案
- 排序:将所有边按权值从小到大排序
- 合并:用并查集依次合并这些边,每合并一条边,连通块数就可能减少 1
- 终止条件:当连通块数≤k 时,停止合并,此时当前边的权值就是答案(因为我们从小到大合并,这是满足条件的最小最大成本)
- 特殊情况:如果初始连通块数(n)已经≤k,直接返回 0(无需合并任何边)
-
代码实现
#include <vector> #include <algorithm> using namespace std; class Solution { private: vector<int> parent; int count; // 连通分量数量 // 查找根节点(路径压缩) int find(int x) { if (parent[x] != x) { parent[x] = find(parent[x]); } return parent[x]; } // 初始化并查集 void init(int n) { parent.resize(n); count = n; // 初始连通分量数为n for (int i = 0; i < n; i++) { parent[i] = i; } } // 合并两个节点,返回是否真的合并(属于不同连通块) bool unite(int x, int y) { int rootX = find(x); int rootY = find(y); if (rootX == rootY) { return false; // 已在同一连通块,无需合并 } parent[rootY] = rootX; count--; // 连通分量数减1 return true; } public: int minCost(int n, vector<vector<int>>& edges, int k) { // 特殊情况:初始连通块数≤k,直接返回0 if (k >= n) { return 0; } // 1. 初始化并查集 init(n); // 2. 将边按权值从小到大排序 sort(edges.begin(), edges.end(), [](const vector<int>& a, const vector<int>& b) { return a[2] < b[2]; }); // 3. 贪心合并:从小到大合并边,直到连通块数≤k for (auto& edge : edges) { int u = edge[0], v = edge[1], w = edge[2]; // 合并当前边 if (unite(u, v)) { // 合并后检查连通块数 if (count <= k) { return w; // 此时w是满足条件的最小最大成本 } } } // 理论上不会走到这里(题目保证是连通图,最终能合并到1个连通块) return 0; } };
最大化最小值
- 本质是二分答案求最大,二分的 mid 表示下界
范围内整数的最大得分
-
给你一个整数数组
start和一个整数d,代表n个区间[start[i], start[i] + d] -
你需要选择
n个整数,其中第i个整数必须属于第i个区间。所选整数的 得分 定义为所选整数两两之间的 最小 绝对差 -
返回所选整数的 最大可能得分
-
边界条件
- 最小绝对差最小也要大于等于 0
- 最小绝对差最大不超过
max(nums)-min(nums)+d,即最大的绝对差,一定是最大值和最小值之间尽可能扩大差距得到的值
-
如何检查是否满足条件
-
给定一个最小绝对差 mid,判断能否选择 n 个整数,使得这 n 个整数之间的两两绝对差都大于等于 mid?
-
假设得分为 ,把区间按照左端点排序,这样只需考虑相邻区间所选数字之差
-
设从第一个区间选了数字 ,那么第二个区间所选的数字至少为 ,否则不满足得分的定义
-
由于得分越大,所选数字越可能不在区间内,有单调性,可以二分答案
-
现在问题变成:给定 ,能否从每个区间各选一个数,使得任意两数之差的最小值至少为
-
注意:这里是至少,不是恰好,两数之差的最小值可以不等于
-
由于二分会不断缩小范围,最终一定会缩小到任意两数之差的最小值恰好等于 的位置上
-
把区间按照左端点排序。第一个数选谁?
-
贪心地想,第一个数越小,第二个数就越能在区间内,所以第一个数要选
-
如果第二个数 超过了区间右端点 ,那么 太大了,应当减小二分的右边界
-
如果 ,我们还需要保证 大于等于区间左端点 ,所以最终
-
依此类推,第 个区间所选的数为
-
必须满足
-
如果所有选的数都满足上式,那么增大二分的左边界
-
-
代码实现
class Solution { public: bool check(vector<int>& start, int d, int mid) { long long x = LLONG_MIN; for (int s : start) { x = max(x + mid, (long long)s); // x 必须 >= 区间左端点 s if (x > s + d) { return false; } } return true; } int maxPossibleScore(vector<int>& start, int d) { sort(start.begin(), start.end()); int mx = 0, mn = INT_MAX; for (int num : start) { mx = max(num, mx); mn = min(num, mn); } int left = 0, right = mx - mn + d; while (left <= right) { int mid = left + (right - left) / 2; if (check(start, d, mid)) { left = mid + 1; } else { right = mid - 1; } } return right; } };
第 K 小/大
- 例如数组 [1,1,1,2,2],其中第 1 小、第 2 小和第 3 小的数都是 1,第 4 小和第 5 小的数都是 2
- 第 k 小等价于:求最小的 x,满足 ≤x 的数至少有 k 个
- 第 k 大等价于:求最大的 x,满足 ≥x 的数至少有 k 个
乘法表中第 K 小的数
-
几乎每一个人都用 乘法表。但是你能在乘法表中快速找到第
k小的数字吗 -
乘法表是大小为
m x n的一个整数矩阵,其中mat[i][j] == i * j(下标从1开始) -
给你三个整数
m、n和k,请你在大小为m x n的乘法表中,找出并返回第k小的数字 -
问题转化为,给定一个 x,判断在乘法表中是否存在 k 个小于等于 x 的数
-
对于第 i 行,小于等于 x 的数存在
min(x/i,n)个数 -
因此可以统计小于等于 x 的数有多少个,来构造 check 函数
-
如果 ,那么,即
-
因此当 时,
-
如果 ,等价于 ,此时
-
令 ,有
-
-
x 的边界
- 左边界为 1
- 右边界为 m*n
-
代码实现
class Solution { public: int findKthNumber(int m, int n, int k) { auto check = [&](int x) -> bool { int cnt = 0; for (int i = 1; i <= m; i++) { cnt += min(x / i, n); } return cnt >= k; }; int left = 0, right = m * n; while (left + 1 < right) { int mid = left + (right - left) / 2; (check(mid) ? right : left) = mid; } return right; } };
有序矩阵中第 K 小的元素
-
给你一个
n x n矩阵matrix,其中每行和每列元素均按升序排序,找到矩阵中第k小的元素。 请注意,它是 排序后 的第k小元素,而不是第k个 不同 的元素 -
你必须找到一个内存复杂度优于
O(n^2)的解决方案 -
代码实现
class Solution { public: int kthSmallest(vector<vector<int>>& matrix, int k) { int n = matrix.size(); auto check = [&](int x) -> bool { int cnt = 0; for (int i = 0; i < n; i++) { for (int j = 0; j < n; j++) { if (matrix[i][j] <= x) { cnt++; } else { break; } } } return cnt >= k; }; int left = matrix[0][0], right = matrix[n - 1][n - 1]; while (left <= right) { int mid = left + (right - left) / 2; if (check(mid)) { right = mid - 1; } else { left = mid + 1; } } return left; } }; -
时间复杂度为 ,空间复杂度为
-
可以进一步优化 check 函数的逻辑吗?
-
原
check函数逐行逐列遍历统计 ≤x 的元素数量,效率较低 -
利用矩阵每行递增、每列也递增的特性,可以从矩阵左下角开始遍历:
- 初始位置:第 n-1 行、第 0 列
- 如果当前元素 ≤x:说明这一列从当前行往上的所有元素都 ≤x(计数 += 当前行号 + 1),然后向右移动一列
- 如果当前元素 >x:向上移动一行
- 遍历结束时统计的总数就是 ≤x 的元素个数
-
这种方式只需要遍历 n 个元素(最多移动 n 次行 + n 次列),时间复杂度从 O (n²) 降到 O (n)
-
代码实现
#include <vector> using namespace std; class Solution { public: int kthSmallest(vector<vector<int>>& matrix, int k) { int n = matrix.size(); // 优化后的check函数,时间复杂度O(n) auto check = [&](int x) -> bool { int cnt = 0; int i = n - 1; // 从左下角开始 int j = 0; while (i >= 0 && j < n) { if (matrix[i][j] <= x) { // 当前列从上到下i+1个元素都<=x cnt += i + 1; // 向右移动一列 j++; } else { // 向上移动一行 i--; } } return cnt >= k; }; int left = matrix[0][0], right = matrix[n-1][n-1]; // 二分查找核心逻辑不变 while (left <= right) { int mid = left + (right - left) / 2; if (check(mid)) { right = mid - 1; } else { left = mid + 1; } } return left; } };
两个有序数组的第 K 小乘积
-
给你两个 从小到大排好序 且下标从 0 开始的整数数组
nums1和nums2以及一个整数k,请你返回第k(从1开始编号)小的nums1[i] * nums2[j]的乘积,其中0 <= i < nums1.length且0 <= j < nums2.length -
这个题目与上一题很相似,只不过由于数组存在负数,因此要单独分为四块进行处理
-
代码实现
#include <algorithm> #include <vector> using namespace std; class Solution { public: // 判断乘积 <= x 的数量是否 >= k bool check(vector<int>& a, vector<int>& b, long long k, long long mx) { int n = a.size(); int m = b.size(); int i0 = lower_bound(a.begin(), a.end(), 0) - a.begin(); int j0 = lower_bound(b.begin(), b.end(), 0) - b.begin(); long long cnt = 0; if (mx < 0) { // 右上:负 × 正 int i = 0, j = j0; while (i < i0 && j < m) { if (1LL * a[i] * b[j] > mx) { j++; } else { cnt += m - j; i++; } } // 左下:正 × 负 i = i0; j = 0; while (i < n && j < j0) { if (1LL * a[i] * b[j] > mx) { i++; } else { cnt += n - i; j++; } } } else { // 异号区域全部 <= 0 <= mx cnt = 1LL * i0 * (m - j0) + 1LL * (n - i0) * j0; // 左上:负 × 负 int i = 0, j = j0 - 1; while (i < i0 && j >= 0) { if (1LL * a[i] * b[j] > mx) { i++; } else { cnt += i0 - i; j--; } } // 右下:正 × 正 i = i0; j = m - 1; while (i < n && j >= j0) { if (1LL * a[i] * b[j] > mx) { j--; } else { cnt += j - j0 + 1; i++; } } } return cnt >= k; } long long kthSmallestProduct(vector<int>& nums1, vector<int>& nums2, long long k) { long long a = 1LL * nums1.front() * nums2.front(); long long b = 1LL * nums1.front() * nums2.back(); long long c = 1LL * nums1.back() * nums2.front(); long long d = 1LL * nums1.back() * nums2.back(); long long left = min(min(a, b), min(c, d)); long long right = max(max(a, b), max(c, d)); // 标准二分模板 while (left <= right) { long long mid = left + (right - left) / 2; if (check(nums1, nums2, k, mid)) { right = mid - 1; } else { left = mid + 1; } } return left; } }; -
可以进一步优化
#include <algorithm> #include <vector> using namespace std; class Solution { public: // 统计乘积 <= mx 的数量是否 >= k bool check(const vector<int>& a, const vector<int>& b, int i0, int j0, long long k, long long mx) { int n = a.size(); int m = b.size(); long long cnt = 0; if (mx < 0) { // 负 × 正 int i = 0, j = j0; while (i < i0 && j < m) { if (1LL * a[i] * b[j] > mx) { j++; } else { cnt += m - j; i++; } } // 正 × 负 i = i0; j = 0; while (i < n && j < j0) { if (1LL * a[i] * b[j] > mx) { i++; } else { cnt += n - i; j++; } } } else { // 异号区域全部 <= 0 cnt = 1LL * i0 * (m - j0) + 1LL * (n - i0) * j0; // 负 × 负 int i = 0, j = j0 - 1; while (i < i0 && j >= 0) { if (1LL * a[i] * b[j] > mx) { i++; } else { cnt += i0 - i; j--; } } // 正 × 正 i = i0; j = m - 1; while (i < n && j >= j0) { if (1LL * a[i] * b[j] > mx) { j--; } else { cnt += j - j0 + 1; i++; } } } return cnt >= k; } long long kthSmallestProduct(vector<int>& nums1, vector<int>& nums2, long long k) { int n = nums1.size(); int m = nums2.size(); // 提前计算 0 分界点 int i0 = lower_bound(nums1.begin(), nums1.end(), 0) - nums1.begin(); int j0 = lower_bound(nums2.begin(), nums2.end(), 0) - nums2.begin(); // 计算二分边界 long long a = 1LL * nums1.front() * nums2.front(); long long b = 1LL * nums1.front() * nums2.back(); long long c = 1LL * nums1.back() * nums2.front(); long long d = 1LL * nums1.back() * nums2.back(); long long left = min(min(a, b), min(c, d)); long long right = max(max(a, b), max(c, d)); // lower_bound 风格二分 while (left < right) { long long mid = left + (right - left) / 2; if (check(nums1, nums2, i0, j0, k, mid)) { right = mid; } else { left = mid + 1; } } return left; } };
枚举技巧
枚举右,维护左
数组列表中的最大距离
-
代码实现
class Solution { public: int maxDistance(vector<vector<int>>& arrays) { int ans = 0; int mn = INT_MAX / 2, mx = INT_MIN / 2; // 防止减法溢出 for (auto& a : arrays) { ans = max({ans, a.back() - mn, mx - a[0]}); mn = min(mn, a[0]); mx = max(mx, a.back()); } return ans; } };
存在重复元素 II
-
枚举
class Solution { public: bool containsNearbyDuplicate(vector<int>& nums, int k) { unordered_map<int, int> last; for (int i = 0; i < nums.size(); i++) { int x = nums[i]; if (last.contains(x) && i - last[x] <= k) { return true; } last[x] = i; } return false; } }; -
滑动窗口:判断 nums 是否存在一个长为 min(k+1,n) 的连续子数组,包含相同元素
class Solution { public: bool containsNearbyDuplicate(vector<int>& nums, int k) { unordered_set<int> st; for (int i = 0; i < nums.size(); i++) { if (!st.insert(nums[i]).second) { // st 中有 nums[i] return true; } if (i >= k) { st.erase(nums[i - k]); } } return false; } };
统计梯形的数目 I
-
代码实现
class Solution { public: const int MOD = 1e9 + 7; // 优化:k固定为2时,直接公式计算C(n,2),无需循环 long long combination2(int n) { if (n < 2) return 0; // 用long long避免溢出,公式:n*(n-1)/2 return (1LL * n * (n - 1) / 2) % MOD; } int countTrapezoids(vector<vector<int>>& points) { unordered_map<int, unordered_set<int>> y2p; for (const auto& p : points) { // 用const&避免拷贝 y2p[p[1]].insert(p[0]); } vector<long long> c2_list; // 存储每个y层的C(n,2)值 for (const auto& pair : y2p) { int cnt = pair.second.size(); if (cnt >= 2) { c2_list.push_back(combination2(cnt)); } } if (c2_list.size() < 2) { return 0; } // 核心优化:O(m)计算总和,替代O(m²)双重循环 long long sum = 0, sum_sq = 0; for (long long c : c2_list) { sum = (sum + c) % MOD; sum_sq = (sum_sq + c * c % MOD) % MOD; } // 公式:(sum² - sum_sq) / 2 mod MOD // 除以2等价于乘以2在MOD下的逆元(MOD是质数,逆元为500000004) long long ans = (sum * sum % MOD - sum_sq + MOD) % MOD; // +MOD避免负数 ans = ans * 500000004LL % MOD; // 2的逆元:(1e9+7+1)/2 = 500000004 return static_cast<int>(ans); } }; -
可以不再重复计算组合数
- 对于某个y层,有 个点 → 从这层选2个点的组合数是 (记为 );
- 统计所有“两层组合”的总数量:即「层A的 × 层B的 」(A≠B);
- 若直接双重循环遍历所有层对,时间复杂度是 (m是不同y层的数量);
- 用累加和优化:遍历到第 i 层时,
s是前 i-1 层所有 的和,当前层贡献为s × k_i,累加所有层的贡献就是总梯形数
class Solution { public: int countTrapezoids(vector<vector<int>>& points) { const int MOD = 1'000'000'007; unordered_map<int, int> cnt; for (auto& p : points) { cnt[p[1]]++; // 第一步:统计每个y坐标有多少个点(按y层分组) } long long ans = 0, s = 0; // s是「之前所有层的组合数之和」 for (auto& [_, c] : cnt) { // 1. 计算当前层选2个点的组合数C(c,2) long long k = 1LL * c * (c - 1) / 2; // 2. 核心:当前层和之前所有层的组合数乘积,累加到总答案 ans += s * k; // 3. 把当前层的组合数加入累加和s,供后续层使用 s += k; } return ans % MOD; } };
识别数组中的最大异常值
-
枚举异常值
class Solution { public: int getLargestOutlier(vector<int>& nums) { int sum = 0, ans = INT_MIN; unordered_map<int, int> cnt; for (int num : nums) { sum += num; cnt[num]++; } for (int i = 0; i < nums.size(); i++) { if ((sum - nums[i]) % 2 != 0) continue; int half = (sum - nums[i]) / 2; if ((nums[i] == half && cnt[half] > 1) || (nums[i] != half && cnt[half] > 0)) { ans = max(ans, nums[i]); } } return ans; } }; -
枚举元素和
class Solution { public: int getLargestOutlier(vector<int>& nums) { unordered_map<int, int> cnt; int total = 0; for (int x : nums) { cnt[x]++; total += x; } int ans = INT_MIN; for (int y : nums) { int t = total - y * 2; auto it = cnt.find(t); if (it != cnt.end() && (t != y || it->second > 1)) { ans = max(ans, t); } } return ans; } };
最佳观光组合
-
拆分为 ,因此只需遍历 j,并维护
v_i+i的最大值,以此来更新结果的最大值class Solution { public: int maxScoreSightseeingPair(vector<int>& values) { int n = values.size(); int ans = 0; int mx = 0; for (int i = 0; i < n; i++) { ans = max(ans, mx + values[i] - i); mx = max(mx, values[i] + i); } return ans; } }; -
如何计算所有 的和?
-
总和 =
- 对于第一部分 :每个 会被后面所有的 j(j > i)累加,也就是第 i 个元素会被加 次(n是数组长度)
- 对于第二部分 :每个 会被前面所有的 i(i < j)累加,也就是第 j 个元素会被加 次
class Solution { public: // 计算所有 i<j 的 (v_i+i)+(v_j-j) 之和 long long sumScoreSightseeingPair(vector<int>& values) { int n = values.size(); if (n < 2) return 0; // 没有配对,和为0 long long total = 0; // 用long long防止溢出 // 第一部分:sum (v_i+i) * (n-1-i) (i从0到n-2) for (int i = 0; i < n; i++) { total += (long long)(values[i] + i) * (n - 1 - i); } // 第二部分:sum (v_j-j) * j (j从1到n-1) for (int j = 0; j < n; j++) { total += (long long)(values[j] - j) * j; } return total; } }; -
对于数组中第k个元素(下标从0开始),它既会参与A的计算,也会参与B的计算,因此可以在一次遍历中同时计算该元素对A和B的贡献,无需分两次循环
class Solution { public: long long sumScoreSightseeingPair(vector<int>& values) { int n = values.size(); if (n < 2) return 0; // 没有i<j的配对,和为0 long long total = 0; // 用long long防止溢出 // 一次遍历:遍历每个元素k,计算其总贡献并累加 for (int k = 0; k < n; k++) { // 1. 计算元素k对A的贡献:(v_k + k) * 后面元素的个数 long long contributionA = (long long)(values[k] + k) * (n - 1 - k); // 2. 计算元素k对B的贡献:(v_k - k) * 前面元素的个数 long long contributionB = (long long)(values[k] - k) * k; // 3. 累加当前元素的总贡献到总和 total += contributionA + contributionB; } return total; } }; -
然而,这是我们想要的吗?
pre:代表「前i个元素(0~i-1)的 之和」(即前缀和的压缩版,不用数组,用变量累加)(values[i] - i) * i:对应第二部分 中,第i个元素作为j时的贡献(被前面i个元素累加,即乘以i)pre:对应第一部分 中,前i个元素对第i个元素的总贡献(所有i<j的 之和)ans:累加每一步的贡献,最终得到总和
int n = values.size(); int ans = 0; int pre = values[0]; for (int i = 1; i < n; i++) { ans += (values[i] - i) * i + pre; // i之前所有元素跟i共形成i对运算 pre += values[i] + i; }
枚举右,维护左的降维技巧
-
从统计梯形的数目 I 到最佳观光组合,都是两两组合计算等问题,如果用两层循环遍历求解,往往时间复杂度过高,可以通过数学推导 / 数据结构,将高维循环降低为一维运算,只要满足以下特征就可以考虑降维:
-
问题目标是所有 i<j 的两两组合的运算和
- 运算可以是:求和、乘积、拼接、条件判断(如统计满足 nums [i]+nums [j]>10 的数对)
- 关键:i 和 j 的顺序不影响结果(i<j 即可,无需考虑 j<i)
-
两两组合的运算可以拆分为 “当前项” 和 “前面所有项的累计值”
- 比如: → 可拆分为“前面所有a_i的和” + “b_j×前面的项数”
- 比如: → 可拆分为“前面所有a_i的和” × “当前a_j”
-
通用拆解步骤
步骤 操作 核心目的 举例(梯形统计) 1 数学拆解目标公式 把两两组合的运算拆成“单变量项” 总梯形数 = (C_i是第i层的组合数) 2 分析“当前项”的贡献 遍历到第j项时,计算它和前面所有i<j项的运算和 第j层的贡献 = 前j-1层的C_i总和 × C_j 3 维护“累计值变量” 用一个变量记录“前面所有项的运算累计值”,避免重复计算 变量s = 前j-1层的C_i总和,遍历中动态更新 4 遍历累加当前贡献 每一步只计算当前项的贡献,累加到总结果 ans += s × C_j,然后s += C_j
-
-
例如梯形统计(两两乘积和)
-
原始二维思路:
// 时间O(m²),m是层数 long long ans = 0; vector<long long> cs; // 存储各层的C(c,2) for (auto& [_, c] : cnt) cs.push_back(1LL*c*(c-1)/2); for (int i = 0; i < cs.size(); i++) { for (int j = i+1; j < cs.size(); j++) { ans += cs[i] * cs[j]; } } -
降维推导
- 总乘积和 =
- 遍历到 C*j 时,前面所有 C_i 的和是 ,则当前贡献是
-
降维后代码(O(m)):
long long ans=0, s=0; for (auto& [_, c] : cnt) { long long k = 1LL*c*(c-1)/2; ans += s * k; // 当前贡献 s += k; // 更新累计值 }
-
-
观光配对求和(拆分后的两两和)
-
原始二维思路:
// 时间O(n²) long long ans = 0; for (int i = 0; i < n; i++) { for (int j = i+1; j < n; j++) { ans += (values[i]+i) + (values[j]-j); } } -
降维推导:A_i=values[i]+i,B_j=values[j]-j
-
降维后代码(O(n)):
long long ans=0, pre=values[0]; for (int i=1; i<n; i++) { ans += (long long)(values[i]-i)*i + pre; pre += values[i]+i; }
-
-
其他场景
- 子数组和问题:比如 “统计和为 k 的子数组个数”,用前缀和 + 哈希表把 O (n²) 降到 O (n)
- 二维数组的行 / 列优化:比如 “计算二维数组的子矩阵和”,用二维前缀和把 O (n²m²) 降到 O (nm)
- 图论中的邻接表优化:比如 “统计图中所有路径和”,用动态规划把 O (2^n) 降到 O (n²)
子序列首尾元素的最大乘积
-
相似问题:2905. 找出满足差值条件的下标 II
-
从 m-1 开始遍历,此时数组的第一个元素开始可以与当前元素匹配构成一个 m 长度的子序列的首尾,维护左边元素的最小值和最大值即可
-
代码实现
#define LONGLONG_MIN (-9223372036854775807LL - 1) #define LONGLONG_MAX 9223372036854775807LL class Solution { public: long long maximumProduct(vector<int>& nums, int m) { long long mx = LONGLONG_MIN, mn = LONGLONG_MAX; long long ans = LONGLONG_MIN; for (int i = m - 1; i < nums.size(); i++) { mx = max(mx, (long long)nums[i - m + 1]); mn = min(mn, (long long)nums[i - m + 1]); ans = max({ans, 1LL * mx * nums[i], 1LL * mn * nums[i]}); } return ans; } }; -
改成任意非空子序列的最大乘积:即排除 0,选择所有正数,如果负数为偶数个全部选择,如果为奇数个则不选择最大的负数
-
改成长为 m 的子序列的最大乘积:按照绝对值大小排序,优先选大的正数 + 偶数个大的负数
-
改成长为 m 的子数组的最大乘积
- 滑动窗口维护 m 大小,然后从 m 开始,每次移除窗口左端,加入右端,更新最大值
- 如果窗口左端是 0,那么重新计算当前窗口乘积
-
改成任意非空子数组的最大乘积
dp_max[i]表示以 i 结尾的任意子数组的最大乘积,dp_min[i]表示最小乘积- 那么如果当前元素为负数,其最大乘积为当前元素乘以前一个最小乘积;否则为当前元素乘以前一个最大乘积
class Solution { public: long long maxProductSubarray(vector<int>& nums) { if (nums.empty()) return 0; long long cur_max = nums[0]; long long cur_min = nums[0]; long long max_prod = nums[0]; for (int i = 1; i < nums.size(); i++) { long long num = nums[i]; // 保存当前max,因为更新min时需要原始值 long long temp = cur_max; // 关键:当前max = max(当前数, 前max×当前数, 前min×当前数) cur_max = max({num, cur_max * num, cur_min * num}); // 当前min = min(当前数, 前max×当前数, 前min×当前数) cur_min = min({num, temp * num, cur_min * num}); // 更新全局最大值 max_prod = max(max_prod, cur_max); } return max_prod; } };
统计特殊三元组
-
枚举中间,需要维护两侧的 cur*2 的数目
class Solution { public: const int MOD = 1e9 + 7; int specialTriplets(vector<int>& nums) { int n = nums.size(); long long ans = 0; unordered_map<int, int> pre; unordered_map<int, int> suf; for (int j = n - 1; j >= 1; j--) { suf[nums[j]]++; } pre[nums[0]]++; for (int j = 1; j < n - 1; j++) { int cur = nums[j]; suf[cur]--; int mul = cur * 2; ans += 1LL * pre[mul] * suf[mul]; pre[cur]++; } return ans % MOD; } }; -
一次遍历:将三元组 (i,j,k) 的匹配拆解为三步,在遍历数组的过程中,把每个元素依次当作
k、j、i来处理,通过两个哈希表记录中间状态,最终累加得到结果cnt1:统计已经遍历过的元素中,作为nums[i]的各数值出现次数(即 “候选 i” 的数量)。cnt12:统计已经遍历过的元素中,能组成 (i,j) 对的数量(即满足nums[i]=2*nums[j]的 (i,j) 对数)。cnt123:最终的三元组总数,每次遍历到元素 x 时,若 x 能作为nums[k](即存在对应的 j),就累加对应的 (i,j) 对数
-
代码实现
class Solution { public: int specialTriplets(vector<int>& nums) { // 定义取模的常量,题目要求结果对1e9+7取余 const int MOD = 1'000'000'007; // cnt1:键=数值,值=该数值作为nums[i]出现的次数(i是三元组的第一个位置) unordered_map<int, int> cnt1; // cnt12:键=数值(nums[j]),值=能和该j组成有效(i,j)对的数量 unordered_map<int, long long> cnt12; // cnt123:最终的特殊三元组总数,用long long避免溢出 long long cnt123 = 0; // 遍历数组中的每个元素x,依次把x当作k、j、i处理 for (int x : nums) { // 第一步:把当前x当作nums[k] // 要满足nums[k] = 2*nums[j] → nums[j] = x/2 // 所以如果x是偶数,说明存在可能的j,此时累加cnt12[x/2](即能和这个j组成(i,j)的数量) if (x % 2 == 0) { cnt123 += cnt12[x / 2]; } // 第二步:把当前x当作nums[j] // 要满足nums[i] = 2*nums[j] → nums[i] = x*2 // 所以cnt12[x](以x为j的有效(i,j)对数量)需要加上cnt1[x*2](能作为i的数量) cnt12[x] += cnt1[x * 2]; // 第三步:把当前x当作nums[i] // 只需要统计该数值出现的次数即可 cnt1[x]++; } // 最终结果对MOD取余后返回 return cnt123 % MOD; } };
环形数组
-
这类题核心是「处理环形的首尾衔接」,思路相对直接
题目(LeetCode编号/名称) 核心考点 解题关键 189. 旋转数组 环形数组的元素平移(原地修改) 1. 三次反转法(线性思维模拟环形);2. 模运算处理下标越界( (i+k)%n)。457. 环形数组是否存在循环 环形数组的单指针遍历(判断循环合法性) 1. 快慢指针检测循环;2. 标记已访问节点避免重复遍历;3. 模运算处理环形下标。 剑指 Offer II 021. 删除链表的倒数第 n 个结点(环形变种) 环形链表/数组的倒数节点定位 双指针(快指针先走n步,快慢指针同步走,快指针到尾时慢指针指向目标)。 -
环形区间最值/求和:这类题是环形数组的核心考法,难点是「环形区间的最优解」(需比较「不跨边界」和「跨边界」两种情况)
题目(LeetCode编号/名称) 核心考点 解题关键 53. 最大子数组和(环形变种:918. 环形子数组的最大和) 环形子数组的最大和 1. 线性最大和(Kadane算法);2. 环形最大和 = 总和 - 线性最小和;3. 特殊处理全负数情况。 1423. 可获得的最大点数 环形数组的固定长度区间最大和(取首尾k个元素) 1. 转化为「线性数组的n-k长度最小和」;2. 前缀和快速计算区间和。 213. 打家劫舍 II 环形数组的不相邻元素最大和 拆分为两个线性问题:① 不偷第一个元素(nums[1:]);② 不偷最后一个元素(nums[:n-1]),取两者最大值。 -
环形前缀和/动态规划:这类题结合「环形前缀和」「动态规划」
题目(LeetCode编号/名称) 核心考点 解题关键 769. 最多能完成排序的块(环形变种) 环形数组的分段排序验证 1. 扩展数组为2倍长度(模拟环形);2. 遍历所有可能的分段点,验证排序合法性。 1014. 最佳观光组合(环形变种) 环形数组的双元素最优解(A[i]+A[j]+i-j) 1. 扩展数组为2倍长度;2. 线性遍历维护「A[i]+i」的最大值,计算最优解。 你做的「字符切换距离」 环形字母表的最小代价计算 1. 构建2倍长度的环形前缀和;2. 模运算计算环形步长;3. 统一公式计算跨/不跨边界代价。 -
环形数组通用解题思路
-
环形数组的解题核心都是「把环形问题转化为线性问题」,主要有 3 种套路:
-
模运算直接处理环形下标
-
适用场景:需要遍历环形数组的下标(如旋转、循环检测)
-
核心公式:
新下标 = (当前下标 ± 偏移量 + 数组长度) % 数组长度(加长度避免负数) -
例子:旋转数组中,
nums[(i+k)%n]直接定位旋转后的元素位置
-
-
扩展数组为2倍长度(环形转线性)
- 适用场景:需要处理「跨首尾」的区间(如环形子数组、环形前缀和)
- 核心逻辑:将数组
nums扩展为nums + nums,这样「跨首尾的区间」就变成了扩展数组中「长度≤n」的线性区间 - 例子:环形子数组的最大和,扩展后用滑动窗口找长度≤n的最大子数组和
-
拆分环形为两个线性问题
- 适用场景:环形的「最优解」只能是「不跨边界」或「跨边界」两种情况之一
- 核心逻辑:
- 情况1:最优解不跨边界 → 直接按线性数组求解;
- 情况2:最优解跨边界 → 转化为「总和 - 线性数组的相反最优解」(如环形最大和 = 总和 - 线性最小和);
- 例子:打家劫舍II拆分为「不偷首」和「不偷尾」两个线性问题
-
前缀和数组
-
左闭右开公式:子数组 [left,right) 的元素和为 sum[right]−sum[left];把下标区间定义成左闭右开,就不需要对下标加一减一
-
前缀和数组
preSum是对原数组的预处理,preSum[i]表示原数组前i-1个元素的和:(preSum[0]=0,preSum[i] = nums[0]+...+nums[i-1]):区间和[l, r](闭区间)=preSum[r+1] - preSum[l]; -
前缀和数组用于快速计算静态数组的任意区间和(O(1) 查询),无法高效处理动态更新
-
定义 1 的代码实现
#include <iostream> #include <vector> using namespace std; // 构建前缀和数组 vector<int> buildPrefixSum(const vector<int>& nums) { int n = nums.size(); vector<int> preSum(n + 1, 0); // preSum[0]=0 for (int i = 0; i < n; ++i) { preSum[i + 1] = preSum[i] + nums[i]; } return preSum; } // 查询区间 [l, r] 的和(l,r从0开始,闭区间) int queryRangeSum(const vector<int>& preSum, int l, int r) { return preSum[r + 1] - preSum[l]; } int main() { vector<int> nums = {1, 2, 3, 4, 5}; vector<int> preSum = buildPrefixSum(nums); cout << queryRangeSum(preSum, 1, 3) << endl; // 2+3+4=9 return 0; } -
时间复杂度:构建 O(n),查询 O(1)
-
空间复杂度:O(n)
-
适用场景:静态数组的区间和查询(如子数组和、和为k的子数组)
-
局限性:原数组更新时,前缀和需重新构建(O(n)),不适合动态更新场景
变长子数组求和
-
给你一个长度为
n的整数数组nums。对于 每个 下标i(0 <= i < n),定义对应的子数组nums[start ... i](start = max(0, i - nums[i])) -
返回为数组中每个下标定义的子数组中所有元素的总和
-
显然,可以先求出前缀和数组,然后再遍历一遍,求出区间和的总和
-
代码实现
class Solution { public: int subarraySum(vector<int>& nums) { vector<int> presum = vector(nums.size() + 1, 0); int sum = 0; for (int i = 0; i < nums.size(); i++) { presum[i + 1] = presum[i] + nums[i]; sum += (presum[i + 1] - presum[max(0, i - nums[i])]); } return sum; } }; -
实际上,也可以使用差分数组,其核心是区间增量标记
- 需要统计每个元素
nums[j]会被多少个下标i的子数组包含(即j落在[start_i, i]范围内)
- 对每个
i,其覆盖区间是[L, i](L = max(0, i - nums[i])),我们可以用差分数组diff标记:diff[L] += 1(区间起点加1),diff[i+1] -= 1(区间终点后一位减1) - 对差分数组求前缀和,得到每个位置
j被覆盖的次数cnt[j] - 最终总和 = (每个元素乘以它被覆盖的次数,累加即为所有子数组和的总和)
- 需要统计每个元素
-
代码实现
class Solution { public: long long sumOfSubarrayRanges(vector<int>& nums) { // 函数名可根据需要调整,核心逻辑不变 int n = nums.size(); // 差分数组,长度为n+1(处理i+1可能越界的情况) vector<long long> diff(n + 1, 0); // 第一步:遍历每个i,标记覆盖区间[L, i]的增量 for (int i = 0; i < n; ++i) { int L = max(0, i - nums[i]); // 区间[L, i]内的元素,被覆盖次数+1 diff[L] += 1; if (i + 1 <= n) { diff[i + 1] -= 1; } } // 第二步:计算差分数组的前缀和,得到每个位置的覆盖次数 vector<long long> cnt(n, 0); cnt[0] = diff[0]; for (int j = 1; j < n; ++j) { cnt[j] = cnt[j - 1] + diff[j]; } // 第三步:计算最终总和(每个元素 * 覆盖次数) long long total = 0; for (int j = 0; j < n; ++j) { total += nums[j] * cnt[j]; } return total; } };
统计范围内的元音字符串数
-
代码实现
class Solution { public: vector<int> vowelStrings(vector<string>& words, vector<vector<int>>& queries) { // 定义元音判断的辅助函数(内联简化) auto isVowel = [](char c) { return c == 'a' || c == 'e' || c == 'i' || c == 'o' || c == 'u'; }; // 构建前缀和数组(简化初始化和命名) vector<int> preSum(words.size() + 1, 0); for (int i = 0; i < words.size(); ++i) { const string& word = words[i]; // 简化当前值的判断逻辑,直接赋值 preSum[i+1] = preSum[i] + (isVowel(word.front()) && isVowel(word.back())); } // 处理查询(简化循环和结果生成) vector<int> res; res.reserve(queries.size()); // 预分配空间提升性能 for (auto& q : queries) { res.push_back(preSum[q[1]+1] - preSum[q[0]]); } return res; } };
特殊数组 II
-
如果数组的每一对相邻元素都是两个奇偶性不同的数字,则该数组被认为是一个 特殊数组
-
你有一个整数数组
nums和一个二维整数矩阵queries,对于queries[i] = [fromi, toi],请你帮助你检查 子数组nums[fromi..toi]是不是一个 特殊数组 -
返回布尔数组
answer,如果nums[fromi..toi]是特殊数组,则answer[i]为true,否则,answer[i]为false -
如果子数组存在一对相邻元素,它们的奇偶性相同,那么这个子数组就不是特殊数组
-
怎么快速知道是否有奇偶性相同的相邻元素?
-
考虑这样一个问题:给你一个只包含 0 和 1 的数组,如何快速判断一个子数组是否全为 0?
-
解答:如果子数组的元素和等于 0,那么子数组一定全为 0;如果子数组的元素和大于 0,那么子数组一定包含 1。如何快速计算子数组元素和?这可以用前缀和解决
-
对于本题,定义长为 的数组 ,其中
-
如果 的下标从 到 的子数组和等于 0,就说明 的下标从 到 的这个子数组,其所有相邻元素的奇偶性都不同,该子数组为特殊数组
-
计算 的前缀和 ,可以快速判断子数组和是否为 0,也就是判断
-
即
-
代码实现
class Solution { public: vector<bool> isArraySpecial(vector<int>& nums, vector<vector<int>>& queries) { vector<int> s(nums.size()); for (int i = 1; i < nums.size(); i++) { s[i] = s[i - 1] + (nums[i - 1] % 2 == nums[i] % 2); } vector<bool> ans(queries.size()); for (int i = 0; i < queries.size(); i++) { auto& q = queries[i]; ans[i] = s[q[0]] == s[q[1]]; } return ans; } };
任意子数组和的绝对值的最大值
-
求出前缀和后,即找到最大和最小的前缀和,相减就是绝对值的最大值
class Solution { public: int maxAbsoluteSum(vector<int>& nums) { int presum = 0, mx = 0, mn = 0; for (int i = 0; i < nums.size(); i++) { presum += nums[i]; mx = max(mx, presum); mn = min(mn, presum); } return mx - mn; } }; -
也可以使用动态规划,dp 数组表示以 i 为结尾的最大子数组和
class Solution { public: int maxAbsoluteSum(vector<int>& nums) { int ans = 0, f_max = 0, f_min = 0; for (int x: nums) { f_max = max(f_max, 0) + x; f_min = min(f_min, 0) + x; ans = max({ans, f_max, -f_min}); } return ans; } };
按策略买卖股票的最佳时机
-
实际上,就是将旧利润值的一部分,替换为新的利润值,因此需要计算区间内旧利润的基础值,然后计算区间的后一半的利润值,维护这个差值的最大值
-
计算两个前缀和数组:
- 价格前缀和数组
pPresum:pPresum[i]表示前i个元素(prices[0]到prices[i-1])的价格总和,即: - 策略利润前缀和数组
sPresum:sPresum[i]表示前i个元素按原策略计算的利润总和(strategy[i] * prices[i]),即:
- 价格前缀和数组
-
如果不修改,答案为
-
需要枚举所有长度为
k的连续子数组(区间为[i, i+k-1],对应前缀和下标i到i+k),计算修改该子数组后的利润变化:- 原策略利润(base):该子数组按原策略计算的利润总和,即区间
[i, i+k-1]的strategy[i]*prices[i]之和,通过前缀和快速计算: - 修改后利润(after):该子数组修改后的利润,仅保留后
k/2个元素的价格总和(区间[i + k/2, i+k-1]),即: - 利润增量:修改该子数组带来的利润变化(增量)为
after - base,需要枚举所有可能的子数组,找到最大增量(ans)
- 原策略利润(base):该子数组按原策略计算的利润总和,即区间
-
代码中最终结果的等价推导:
-
代码实现
class Solution { public: long long maxProfit(vector<int>& prices, vector<int>& strategy, int k) { int n = prices.size(); vector<long long> pPresum = vector(n + 1, 0LL); vector<long long> sPresum = vector(n + 1, 0LL); long long ans = INT_MIN; for (int i = 0; i < prices.size(); i++) { pPresum[i + 1] = pPresum[i] + 1LL * prices[i]; sPresum[i + 1] = sPresum[i] + 1LL * strategy[i] * prices[i]; } for (int i = 0; i <= n - k; i++) { long long base = sPresum[i + k] - sPresum[i]; long long after = pPresum[i + k] - pPresum[i + k / 2]; ans = max(ans, after - base); } return max(ans, 0LL) + sPresum[n]; } };
两个字符串的切换距离
-
给你两个长度相同的字符串
s和t,以及两个整数数组nextCost和previousCost -
一次操作中,你可以选择
s中的一个下标i,执行以下操作 之一 :- 将
s[i]切换为字母表中的下一个字母,如果s[i] == 'z',切换后得到'a'。操作的代价为nextCost[j],其中j表示s[i]在字母表中的下标。 - 将
s[i]切换为字母表中的上一个字母,如果s[i] == 'a',切换后得到'z'。操作的代价为previousCost[j],其中j是s[i]在字母表中的下标。
- 将
-
切换距离指的是将字符串
s变为字符串t的 最少 操作代价总和 -
请你返回从
s到t的 切换距离 -
显然,给定两个字符,可以计算前向转换和后向转换所需要的代价,而计算这个代价,可以通过前缀和数组来实现
-
代码实现
#include <vector> #include <string> #include <algorithm> #include <climits> using namespace std; class Solution { public: long long switchDistance(string s, string t, vector<int>& nextCost, vector<int>& previousCost) { int n = s.size(); long long totalCost = 0; const int CHAR_COUNT = 26; // 1. 预处理nextCost的前缀和数组(下标0~26,nextPresum[0]=0,nextPresum[1]=nextCost[0],...) vector<long long> nextPresum(CHAR_COUNT + 1, 0); for (int i = 0; i < CHAR_COUNT; ++i) { nextPresum[i+1] = nextPresum[i] + nextCost[i]; } // 2. 预处理previousCost的前缀和数组 vector<long long> prevPresum(CHAR_COUNT + 1, 0); for (int i = 0; i < CHAR_COUNT; ++i) { prevPresum[i+1] = prevPresum[i] + previousCost[i]; } for (int i = 0; i < n; ++i) { char s_char = s[i]; char t_char = t[i]; if (s_char == t_char) continue; int s_idx = s_char - 'a'; int t_idx = t_char - 'a'; long long cost_next = 0, cost_prev = 0; // 3. 计算正向(next)代价:s_idx → t_idx(往后走) if (t_idx > s_idx) { // 不跨z:直接取[s_idx, t_idx-1]的区间和 cost_next = nextPresum[t_idx] - nextPresum[s_idx]; } else { // 跨z:[s_idx, 25] + [0, t_idx-1] cost_next = (nextPresum[CHAR_COUNT] - nextPresum[s_idx]) + nextPresum[t_idx]; } // 4. 计算反向(previous)代价:s_idx → t_idx(往前走) if (t_idx < s_idx) { // 不跨a:直接取[t_idx, s_idx-1]的区间和(往前等价于反向遍历) cost_prev = prevPresum[s_idx] - prevPresum[t_idx]; } else { // 跨a:[t_idx, 25] + [0, s_idx-1] cost_prev = (prevPresum[CHAR_COUNT] - prevPresum[t_idx]) + prevPresum[s_idx]; } // 5. 累加最小代价 totalCost += min(cost_next, cost_prev); } return totalCost; } }; -
也可以看作是环形数组,来简化两部分的计算逻辑
- 环形数组扩展:将
nextCost和previousCost数组各扩展一倍(从 26 位扩展到 52 位),模拟环形的循环特性(如 z 之后接 a,a 之前接 z) - 统一前缀和计算:基于扩展后的数组构建前缀和,这样无论目标字符是否跨边界,都可以用单一的区间和公式计算代价,无需分情况判断
- 环形区间
[a, b)(a > b)的和 = 前缀和 [26] - 前缀和 [a] + 前缀和 [b] - 环形区间
[a, b)(a ≤ b)的和 = 前缀和 [b] - 前缀和 [a]
- 环形区间
- 最短路径选取:对每个字符,只需计算「正向最短步长」和「反向最短步长」对应的区间和,取最小值即可
- 环形数组扩展:将
-
代码实现
#include <vector> #include <string> #include <algorithm> using namespace std; class Solution { public: long long switchDistance(string s, string t, vector<int>& nextCost, vector<int>& previousCost) { int n = s.size(); long long totalCost = 0; const int CHAR_COUNT = 26; const int RING_LEN = CHAR_COUNT * 2; // 环形前缀和的总长度(覆盖2圈) // ========== 1. 构建环形前缀和(nextCost):直接复用原数组,无需扩展 ========== vector<long long> nextPrefix(RING_LEN + 1, 0); for (int i = 0; i < RING_LEN; ++i) { // 用i%26直接访问原数组,模拟环形扩展 nextPrefix[i+1] = nextPrefix[i] + nextCost[i % CHAR_COUNT]; } // ========== 2. 构建环形前缀和(previousCost):同理 ========== vector<long long> prevPrefix(RING_LEN + 1, 0); for (int i = 0; i < RING_LEN; ++i) { prevPrefix[i+1] = prevPrefix[i] + previousCost[i % CHAR_COUNT]; } // ========== 3. 逐字符计算最小代价 ========== for (int i = 0; i < n; ++i) { if (s[i] == t[i]) continue; int s_idx = s[i] - 'a'; int t_idx = t[i] - 'a'; // 正向步长:环形中从s_idx到t_idx的最短正向步数 int step_next = (t_idx - s_idx + CHAR_COUNT) % CHAR_COUNT; // 直接用前缀和区间和计算,无需扩展数组(i%26已处理环形) long long cost_next = nextPrefix[s_idx + step_next] - nextPrefix[s_idx]; // 反向步长:环形中从s_idx到t_idx的最短反向步数 int step_prev = (s_idx - t_idx + CHAR_COUNT) % CHAR_COUNT; // 反向代价:从t_idx往后走step_prev步的previousCost总和 long long cost_prev = prevPrefix[t_idx + step_prev] - prevPrefix[t_idx]; totalCost += min(cost_next, cost_prev); } return totalCost; } };
区间和
-
给定一个整数数组,请计算该数组在每个指定区间内元素的总和
-
对于上述问题,最朴素的想法是,遍历每个指定区间,累加一遍即可,但是实际上,测试样例中设计了大数据量,暴力解法的时间复杂度无法承受
-
假如指定区间有 m 个,每次的计算范围都是从 0 到 n-1,那么总的时间复杂度就是
-
而前缀和的思想是重复利用计算过的子数组之和,从而降低区间查询需要累加计算的次数
-
核心观察是:
-
那么可以先遍历数组,计算每个元素 的前缀和 ,之后再利用前缀和数组去求解每个指定区间内元素的求和,可以看到,前缀和在涉及计算区间和的问题时非常有用
-
示例代码
#include <iostream> #include <vector> using namespace std; int main() { int n, a, b; cin >> n; vector<int> vec(n); vector<int> p(n); int presum = 0; for (int i = 0; i < n; i++) { scanf("%d", &vec[i]); presum += vec[i]; p[i] = presum; } while (~scanf("%d%d", &a, &b)) { int sum; if (a == 0) sum = p[b]; else sum = p[b] - p[a - 1]; printf("%d\n", sum); } } -
参考题目
开发商购买土地
-
题目描述
- 在一个城市区域内,被划分成了n * m个连续的区块,每个区块都拥有不同的权值,代表着其土地价值。目前,有两家开发公司,A 公司和 B 公司,希望购买这个城市区域的土地。现在,需要将这个城市区域的所有区块分配给 A 公司和 B 公司
- 然而,由于城市规划的限制,只允许将区域按横向或纵向划分成两个子区域,而且每个子区域都必须包含一个或多个区块
- 为了确保公平竞争,你需要找到一种分配方式,使得 A 公司和 B 公司各自的子区域内的土地总价值之差最小
-
暴力方法:由于只允许划分为 2 个子区域,那么可以遍历所有划分方法,对于 n*m 的区域,需要遍历 n+m-2 次,并在每次都需要计算被划分的两块区域的总价值大小,这显然是不可取的
-
实际上,可以先将行方向和列方向的前缀和求出来,这样当进行列/行划分时,只需要计算每一行/列被划分出来的两块区域的和
-
示例代码如下
#include <iostream> #include <vector> #include <climits> using namespace std; int main () { int n, m; cin >> n >> m; int sum = 0; vector<vector<int>> vec(n, vector<int>(m, 0)) ; for (int i = 0; i < n; i++) { for (int j = 0; j < m; j++) { cin >> vec[i][j]; sum += vec[i][j]; } } // 统计横向 vector<int> horizontal(n, 0); for (int i = 0; i < n; i++) { for (int j = 0 ; j < m; j++) { horizontal[i] += vec[i][j]; } } // 统计纵向 vector<int> vertical(m , 0); for (int j = 0; j < m; j++) { for (int i = 0 ; i < n; i++) { vertical[j] += vec[i][j]; } } int result = INT_MAX; int horizontalCut = 0; for (int i = 0 ; i < n; i++) { horizontalCut += horizontal[i]; result = min(result, abs(sum - horizontalCut - horizontalCut)); } int verticalCut = 0; for (int j = 0; j < m; j++) { verticalCut += vertical[j]; result = min(result, abs(sum - verticalCut - verticalCut)); } cout << result << endl; } -
参考题目
二维前缀和
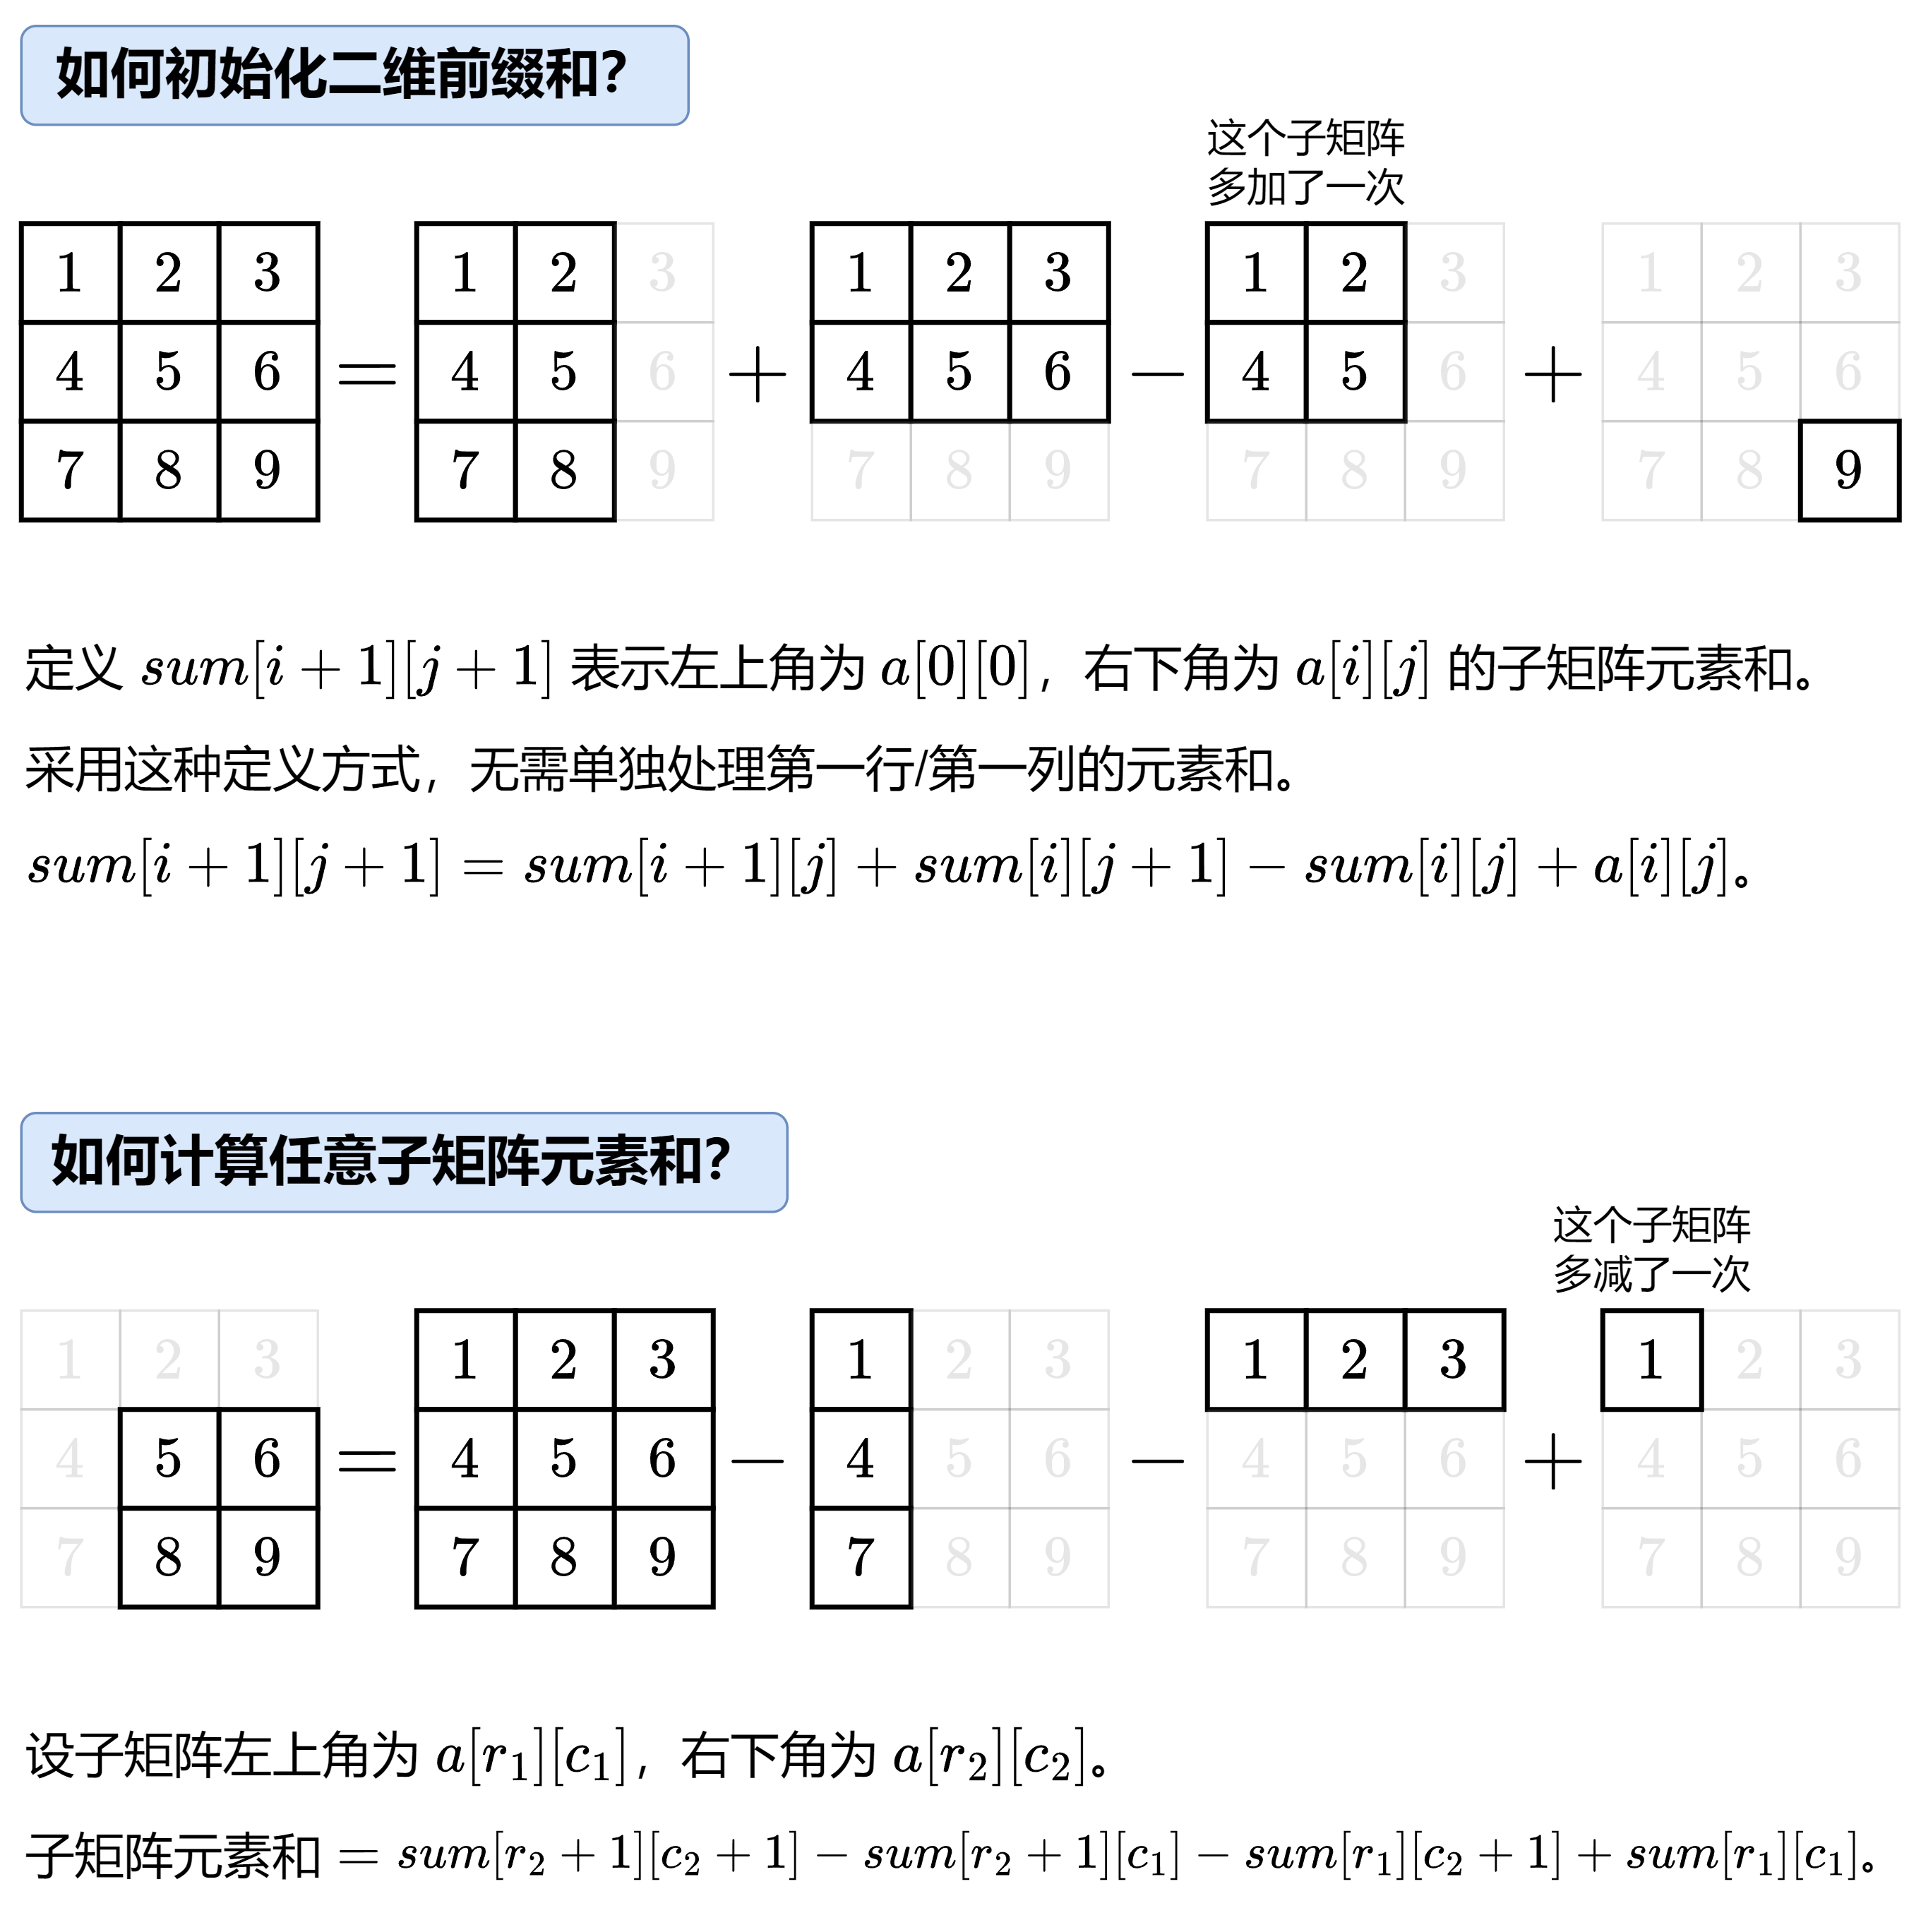
-
代码实现
class NumMatrix { public: vector<vector<int>> presum; NumMatrix(vector<vector<int>>& matrix) { int m = matrix.size(), n = matrix[0].size(); presum = vector(m + 1, vector(n + 1, 0)); for (int i = 0; i < m; i++) { for (int j = 0; j < n; j++) { presum[i + 1][j + 1] = presum[i][j + 1] + presum[i + 1][j] - presum[i][j] + matrix[i][j]; } } } int sumRegion(int row1, int col1, int row2, int col2) { return presum[row2 + 1][col2 + 1] - presum[row1][col2 + 1] - presum[row2 + 1][col1] + presum[row1][col1]; } }; /** * Your NumMatrix object will be instantiated and called as such: * NumMatrix* obj = new NumMatrix(matrix); * int param_1 = obj->sumRegion(row1,col1,row2,col2); */
矩阵区域和
-
题目:1314. 矩阵区域和
-
给你一个
m x n的矩阵mat和一个整数k,请你返回一个矩阵answer,其中每个answer[i][j]是所有满足下述条件的元素mat[r][c]的和:i - k <= r <= i + k,j - k <= c <= j + k且(r, c)在矩阵内
-
代码实现
class Solution { public: vector<vector<int>> matrixBlockSum(vector<vector<int>>& mat, int k) { int m = mat.size(), n = mat[0].size(); vector<vector<int>> presum(m + 1, vector(n + 1, 0)); for (int i = 0; i < m; i++) { for (int j = 0; j < n; j++) { presum[i + 1][j + 1] = presum[i][j + 1] + presum[i + 1][j] - presum[i][j] + mat[i][j]; } } vector<vector<int>> res(m, vector(n, 0)); for (int i = 0; i < m; i++) { for (int j = 0; j < n; j++) { int r1 = max(i - k, 0), c1 = max(j - k, 0); int r2 = min(i + k, m - 1), c2 = min(j + k, n - 1); res[i][j] = presum[r2 + 1][c2 + 1] - presum[r2 + 1][c1] - presum[r1][c2 + 1] + presum[r1][c1]; } } return res; } };
元素和小于等于 k 的子矩阵的数目
-
给你一个下标从0开始的整数矩阵
grid和一个整数k -
返回包含
grid左上角元素、元素和小于或等于k的子矩阵的数目 -
代码实现
class Solution { public: int countSubmatrices(vector<vector<int>>& mat, int k) { int m = mat.size(), n = mat[0].size(); vector<vector<int>> presum(m + 1, vector(n + 1, 0)); for (int i = 0; i < m; i++) { for (int j = 0; j < n; j++) { presum[i + 1][j + 1] = presum[i][j + 1] + presum[i + 1][j] - presum[i][j] + mat[i][j]; } } int ans = 0; for (int i = 0; i < m; i++) { for (int j = 0; j < n; j++) { int r1 = 0, c1 = 0; int r2 = i, c2 = j; int sum = presum[r2 + 1][c2 + 1] - presum[r2 + 1][c1] - presum[r1][c2 + 1] + presum[r1][c1]; if (sum <= k) ans++; else break; } } return ans; } };
差分数组
-
差分数组
diff是前缀和的逆运算,用于高效处理区间更新,核心公式:- 构建:
diff[0] = nums[0],diff[i] = nums[i] - nums[i-1](i≥1) - 区间更新:对
[l, r]所有元素加val→diff[l] += val,diff[r+1] -= val(r+1 < n) - 还原原数组:
nums[0] = diff[0],nums[i] = nums[i-1] + diff[i]
- 构建:
-
快速对静态/动态数组进行区间加减更新(O(1) 更新),最后还原数组
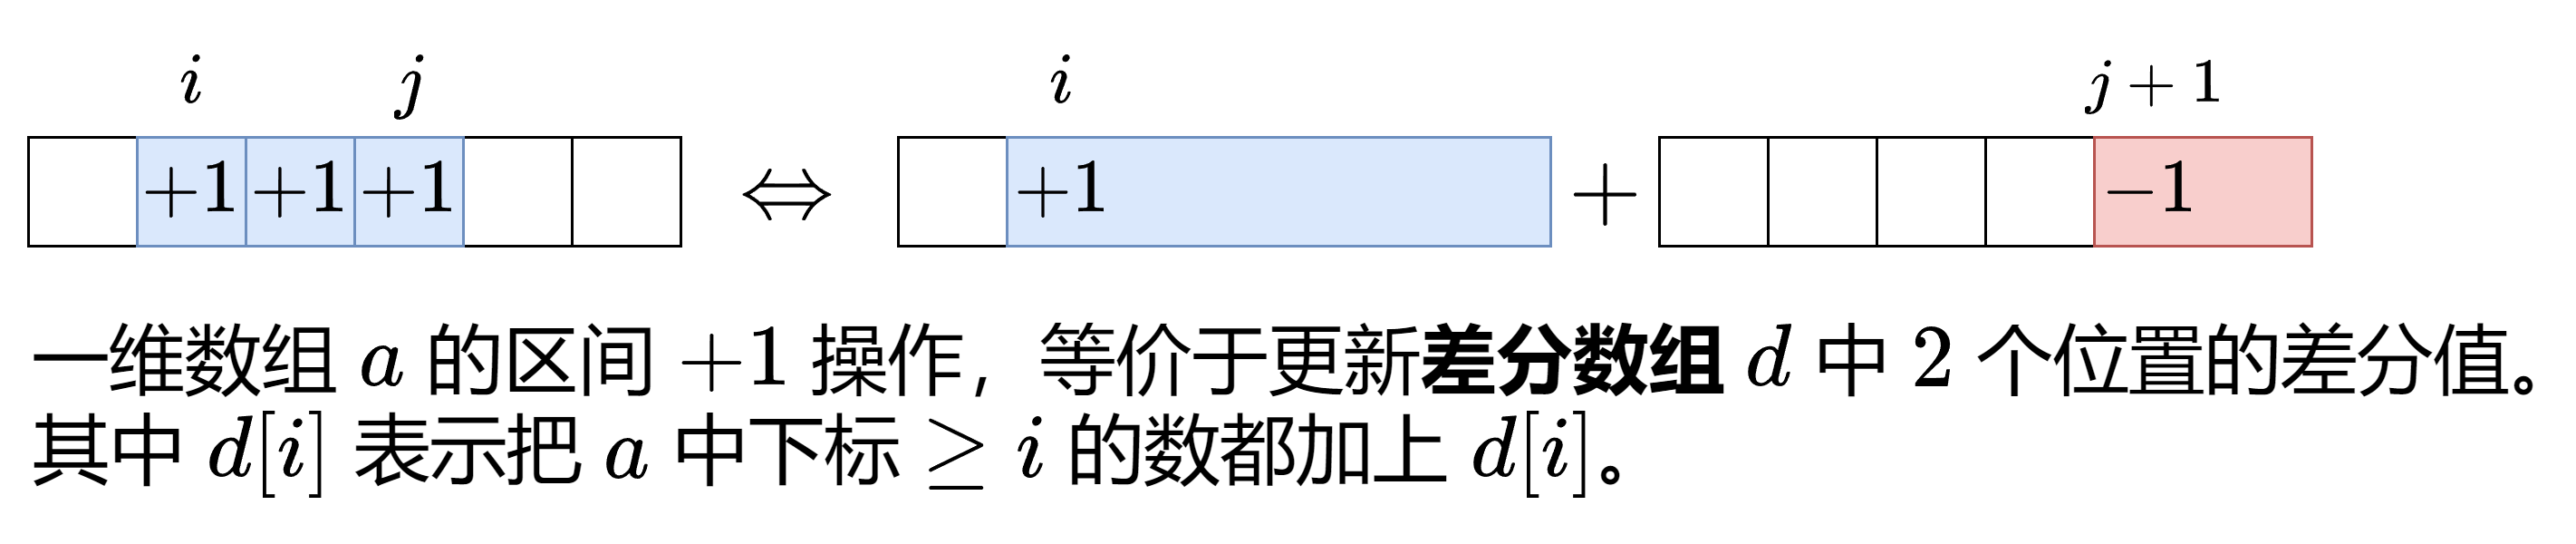
-
代码实现
#include <iostream> #include <vector> using namespace std; // 构建差分数组 vector<int> buildDiffArray(const vector<int>& nums) { int n = nums.size(); vector<int> diff(n, 0); diff[0] = nums[0]; for (int i = 1; i < n; ++i) { diff[i] = nums[i] - nums[i - 1]; } return diff; } // 对区间 [l, r] 所有元素加 val void updateRange(vector<int>& diff, int l, int r, int val) { diff[l] += val; if (r + 1 < diff.size()) { diff[r + 1] -= val; } } // 从差分数组还原原数组 vector<int> restoreArray(const vector<int>& diff) { int n = diff.size(); vector<int> nums(n, 0); nums[0] = diff[0]; for (int i = 1; i < n; ++i) { nums[i] = nums[i - 1] + diff[i]; } return nums; } int main() { vector<int> nums = {1, 2, 3, 4, 5}; vector<int> diff = buildDiffArray(nums); updateRange(diff, 1, 3, 2); // [1,3]加2 → 原数组变为 [1,4,5,6,5] vector<int> res = restoreArray(diff); for (int num : res) cout << num << " "; // 1 4 5 6 5 return 0; } -
时间复杂度:构建 O(n),区间更新 O(1),还原 O(n)
-
空间复杂度:O(n)
-
适用场景:多次区间加减更新(如航班预订统计、拼车问题)
-
局限性:仅支持区间加减,不支持复杂更新(如区间乘),查询需还原数组后处理
航班预定统计
-
有
n个航班,它们分别从1到n进行编号 -
有一份航班预订表
bookings,表中第i条预订记录bookings[i] = [firsti, lasti, seatsi]意味着在从firsti到lasti(包含firsti和lasti)的每个航班上预订了seatsi个座位 -
请你返回一个长度为
n的数组answer,里面的元素是每个航班预定的座位总数 -
如果暴力对区间每个数加一遍:O (n * m),运行大数据会超时
-
这是典型的区间加,最后求结果数组,直接用差分数组:
- 建立差分数组
diff - 对每条记录
[l, r, val]:diff[l] += valdiff[r+1] -= val(如果不越界)
- 最后对
diff求前缀和,得到答案
- 建立差分数组
-
代码实现
#include <iostream> #include <vector> using namespace std; vector<int> corpFlightBookings(vector<vector<int>>& bookings, int n) { vector<int> diff(n + 2, 0); // 多开2位防止越界 for (auto& book : bookings) { int l = book[0]; int r = book[1]; int val = book[2]; diff[l] += val; diff[r + 1] -= val; } // 求前缀和,得到答案 vector<int> res(n); res[0] = diff[1]; for (int i = 1; i < n; ++i) { res[i] = res[i - 1] + diff[i + 1]; } return res; } int main() { vector<vector<int>> bookings = { {1,2,10}, {2,3,20}, {2,5,25} }; int n = 5; vector<int> ans = corpFlightBookings(bookings, n); for (int x : ans) cout << x << " "; return 0; } -
参考题目
与车相交的点
-
题目:2848. 与车相交的点
-
给你一个下标从 0 开始的二维整数数组
nums表示汽车停放在数轴上的坐标。对于任意下标i,nums[i] = [starti, endi],其中starti是第i辆车的起点,endi是第i辆车的终点 -
返回数轴上被车 任意部分 覆盖的整数点的数目
-
本质是区间和并问题,先按照左边界排序,时间复杂度为
class Solution { public: int numberOfPoints(vector<vector<int>>& nums) { sort(nums.begin(), nums.end()); int ans = 0; int l = -1, r = -1; for (vector<int> vec : nums) { if (l == -1 || r == -1) { l = vec[0]; r = vec[1]; } if (vec[0] <= r) { r = max(r, vec[1]); } else { ans += r - l + 1; l = vec[0]; r = vec[1]; } } ans += r - l + 1; return ans; } }; -
差分数组也是处理区间覆盖计数问题的另一种高效方法,可以在 O(N+M) 时间复杂度内解决问题(N 是车辆数,M 是数轴的最大范围),无需排序
- 差分数组定义:创建一个数组
diff,其中diff[i]表示数轴上第i个点的覆盖次数变化量 - 区间标记:对于每辆车的区间
[start, end],执行:diff[start] += 1(起点开始覆盖,次数 + 1)diff[end + 1] -= 1(终点下一个点结束覆盖,次数 - 1)
- 前缀和计算:遍历差分数组,计算前缀和(即每个点的实际覆盖次数),只要前缀和 > 0,说明该点被覆盖,计数 + 1
- 差分数组定义:创建一个数组
-
代码实现
int countCoveredPoints(vector<vector<int>>& nums) { if (nums.empty()) return 0; // 步骤1:找到数轴的最大范围(确定差分数组的大小) int max_point = 0; for (auto& car : nums) { max_point = max(max_point, car[1]); } // 步骤2:初始化差分数组(大小为max_point + 2,避免end+1越界) vector<int> diff(max_point + 2, 0); // 步骤3:遍历所有车辆,更新差分数组 for (auto& car : nums) { int start = car[0]; int end = car[1]; diff[start]++; // 起点覆盖次数+1 diff[end + 1]--; // 终点下一个位置覆盖次数-1 } // 步骤4:计算前缀和,统计被覆盖的整数点数量 int count = 0; int current_coverage = 0; // 当前点的覆盖次数 for (int i = 0; i <= max_point; ++i) { current_coverage += diff[i]; // 前缀和 = 实际覆盖次数 if (current_coverage > 0) { // 覆盖次数>0,说明该点被覆盖 count++; } } return count; }
检查是否区域内都被覆盖
-
代码实现
class Solution { public: bool isCovered(vector<vector<int>>& ranges, int left, int right) { int max_end = 0; for (vector<int> range : ranges) { max_end = max(range[1], max_end); } if (right > max_end) return false; vector<int> diff(max_end + 2, 0); for (vector<int> range : ranges) { diff[range[0]]++; diff[range[1] + 1]--; } int current_coverage = 0; for (int i = 0; i <= max_end; ++i) { current_coverage += diff[i]; if (i >= left && i <= right && current_coverage <= 0) { return false; } } return true; } };
统计已测试设备
-
代码实现
class Solution { public: int countTestedDevices(vector<int>& batteryPercentages) { vector<int> diff(102, 0); int n = batteryPercentages.size(); int ans = 0; int sum = 0; for (int i = 0; i < n; i++) { int device = batteryPercentages[i]; sum += diff[i]; if (device + sum > 0) { ans++; diff[i + 1]--; diff[n]++; } else { continue; } } return ans; } }; -
实际上,只需要用到差分思想
class Solution { public: int countTestedDevices(vector<int>& batteryPercentages) { int dec = 0; for (int x : batteryPercentages) { dec += x > dec; } return dec; } };
提莫攻击
-
提莫攻击英雄,时间数组
timeSeries[i]表示攻击时间,每次攻击使英雄中毒duration秒(若中毒未结束又被攻击,中毒时间延长),求英雄总中毒时间 -
基本思路
#include <iostream> #include <vector> #include <algorithm> // 用于min函数 using namespace std; class Solution { public: int findPoisonedDuration(vector<int>& timeSeries, int duration) { // 边界条件:没有攻击,中毒时间为0 if (timeSeries.empty()) { return 0; } int cnt = 0; // 遍历相邻攻击的时间间隔 for (int i = 1; i < timeSeries.size(); ++i) { // 取间隔和duration的较小值,累加到总时间 cnt += min(duration, timeSeries[i] - timeSeries[i-1]); } // 加上最后一次攻击的完整中毒时长 return cnt + duration; } }; -
差分思路
- 把 “中毒时间段
[t, t+duration-1]” 视为区间加 1 - 差分统计每个时间点的中毒状态(0/1),最后求和
- 把 “中毒时间段
-
代码实现
int findPoisonedDuration(vector<int>& timeSeries, int duration) { if (timeSeries.empty()) return 0; unordered_map<int, int> diff; for (int t : timeSeries) { diff[t]++; diff[t + duration]--; } vector<int> pos; for (auto& p : diff) pos.push_back(p.first); sort(pos.begin(), pos.end()); int res = 0, cur = 0, pre = pos[0]; for (int p : pos) { if (cur > 0) res += p - pre; // 中毒时间段累加 cur += diff[p]; pre = p; } return res; } -
参考题目
拼车
-
车上最初有
capacity个空座位。车只能向一个方向行驶(也就是说,不允许掉头或改变方向) -
给定整数
capacity和一个数组trips,trips[i] = [numPassengersi, fromi, toi]表示第i次旅行有numPassengersi乘客,接他们和放他们的位置分别是fromi和toi。这些位置是从汽车的初始位置向东的公里数 -
当且仅当你可以在所有给定的行程中接送所有乘客时,返回
true,否则请返回false -
差分是处理 “区间增减” 问题的高效技巧,核心是:
- 构建差分数组
diff,diff[i]表示 “第i个位置相对于前一个位置的乘客数变化量”; - 对区间
[from, to)(注意:to 站下车,所以实际影响到 to-1 站),执行:diff[from] += numPassengers(上车,人数增加);diff[to] -= numPassengers(下车,人数减少); - 遍历差分数组,计算前缀和(即当前车上的乘客数),判断是否超过
capacity
- 构建差分数组
-
如果暴力模拟每个站点的乘客数,时间复杂度是 O(max_to×n)(n 是行程数);而差分 + 前缀和的时间复杂度是 O(n+max_to),效率大幅提升
-
步骤
-
确定差分数组的最大长度:找到所有行程中最大的
to值(即最远下车点) -
初始化差分数组
diff(初始全 0) -
遍历所有行程,更新差分数组:
-
diff[from] += num(上车); -
diff[to] -= num(下车);
-
-
计算前缀和(当前乘客数),遍历过程中判断是否超过
capacity; -
若全程未超载,返回
true,否则返回false
-
-
代码实现
#include <iostream> #include <vector> #include <algorithm> // 用于max_element using namespace std; bool carPooling(vector<vector<int>>& trips, int capacity) { // 步骤1:找到最大的下车点,确定差分数组长度 int maxTo = 0; for (auto& trip : trips) { maxTo = max(maxTo, trip[2]); } // 步骤2:初始化差分数组(长度为maxTo,初始全0) vector<int> diff(maxTo + 1, 0); // 多开一位避免越界 // 步骤3:更新差分数组 for (auto& trip : trips) { int num = trip[0]; int from = trip[1]; int to = trip[2]; diff[from] += num; // 上车:人数增加 diff[to] -= num; // 下车:人数减少 } // 步骤4:计算前缀和,判断是否超载 int currentPassengers = 0; for (int i = 0; i <= maxTo; ++i) { currentPassengers += diff[i]; // 只要某一时刻超过容量,直接返回false if (currentPassengers > capacity) { return false; } } // 全程未超载 return true; } // 测试函数 int main() { // 测试用例1:超载 vector<vector<int>> trips1 = {{2,1,5},{3,3,7}}; int capacity1 = 4; cout << (carPooling(trips1, capacity1) ? "true" : "false") << endl; // 输出false // 测试用例2:未超载 vector<vector<int>> trips2 = {{2,1,5},{3,5,7}}; int capacity2 = 3; cout << (carPooling(trips2, capacity2) ? "true" : "false") << endl; // 输出true return 0; } -
如果
maxTo非常大(如 1e9),差分数组会超出内存,此时可:- 收集所有
from和to的位置,排序去重; - 用哈希表(
unordered_map)代替差分数组,仅记录有变化的位置; - 按排序后的位置遍历,计算前缀和
- 收集所有
-
代码实现
#include <iostream> #include <vector> #include <unordered_map> #include <algorithm> using namespace std; bool carPoolingBigMaxTo(vector<vector<int>>& trips, int capacity) { // 步骤1:用哈希表存储差分事件(位置 → 增量) unordered_map<int, int> diffMap; for (auto& trip : trips) { int num = trip[0], from = trip[1], to = trip[2]; diffMap[from] += num; // 上车:增量+num diffMap[to] -= num; // 下车:增量-num } // 步骤2:提取所有关键位置,排序(保证按位置顺序遍历) vector<int> positions; for (auto& pair : diffMap) { positions.push_back(pair.first); } sort(positions.begin(), positions.end()); // 步骤3:遍历关键位置,计算实时乘客数 int curPassengers = 0; for (int pos : positions) { curPassengers += diffMap[pos]; if (curPassengers > capacity) { return false; } } return true; } int main() { // 测试用例:to=1e9,超大值域 vector<vector<int>> trips = {{2,1,1000000000},{3,3,700000000}}; int capacity = 4; cout << (carPoolingBigMaxTo(trips, capacity) ? "true" : "false") << endl; // false return 0; } -
差分的本质是 “记录区间的起点和终点的增量变化”,而非 “每个位置都要存储”
-
超大值域下,绝大多数位置的增量是 0,无需存储,只需关注有增量变化的 “关键位置”
-
排序保证了按位置顺序遍历,计算前缀和的逻辑与普通差分数组完全一致
-
参考题目
区间重叠计数
-
给定多个区间
[start, end],统计每个位置被覆盖的次数(end可能是 1e9 级别),找出被覆盖次数最多的位置的次数 -
哈希表差分
int maxOverlapCount(vector<vector<int>>& intervals) { unordered_map<int, int> diffMap; for (auto& interval : intervals) { int s = interval[0], e = interval[1]; diffMap[s] += 1; // 区间开始,计数+1 diffMap[e] -= 1; // 区间结束,计数-1 } vector<int> positions; for (auto& pair : diffMap) positions.push_back(pair.first); sort(positions.begin(), positions.end()); int maxCount = 0, curCount = 0; for (int pos : positions) { curCount += diffMap[pos]; maxCount = max(maxCount, curCount); } return maxCount; }
二维差分
-
给定二维矩阵,多次执行 “对矩形区域
(x1,y1)到(x2,y2)的所有元素加 val”,最终返回修改后的矩阵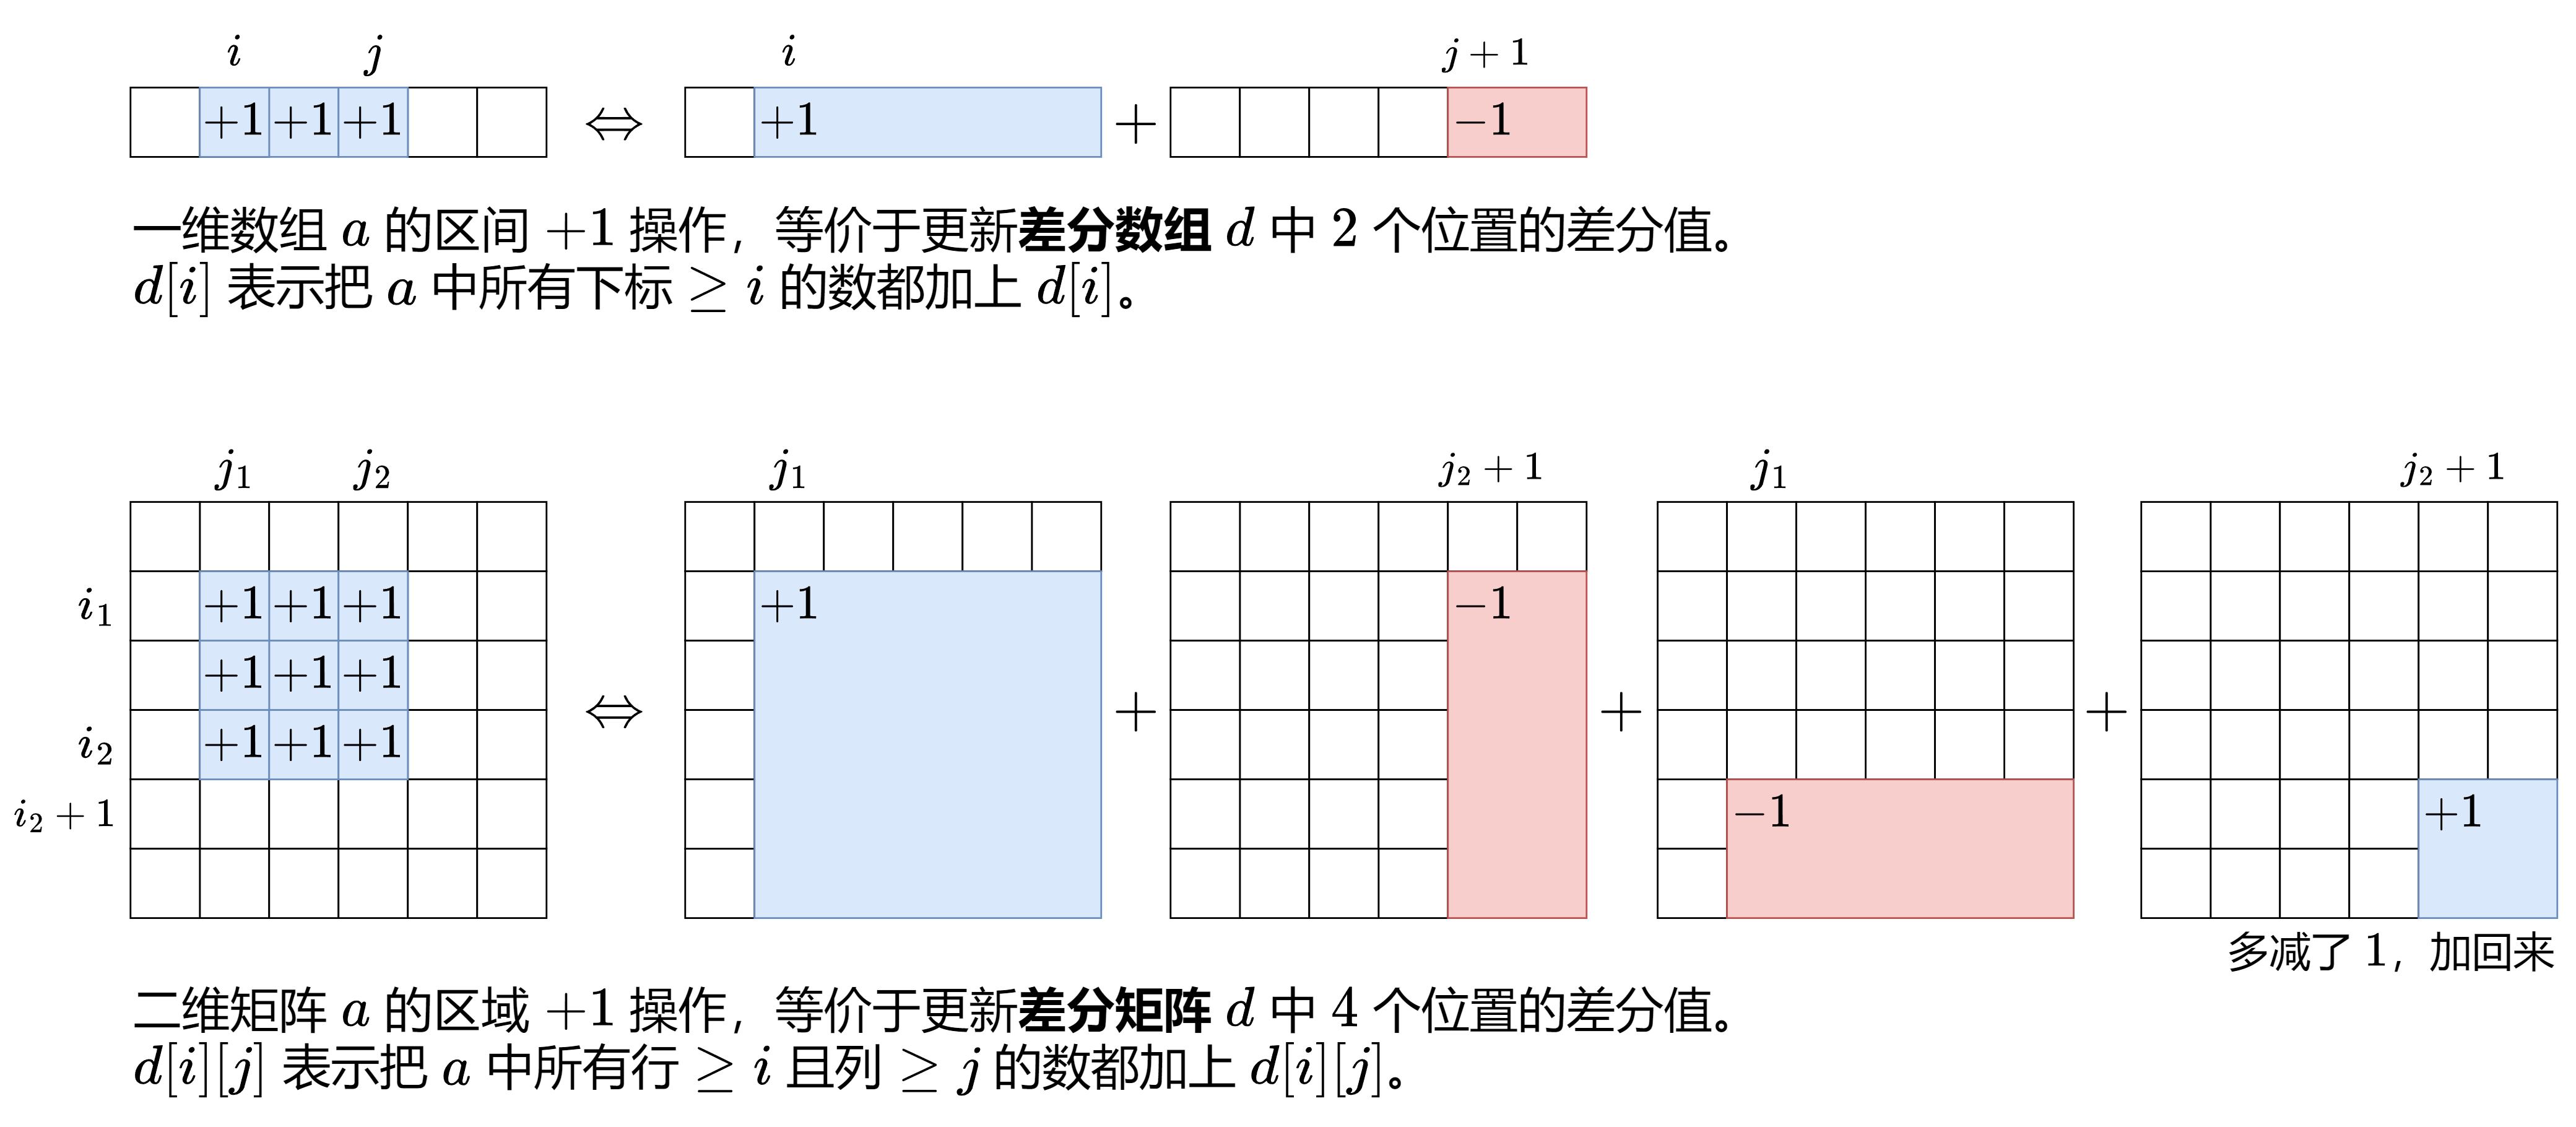
-
二维差分数组的核心公式
diff[x1][y1] += val; diff[x1][y2+1] -= val; diff[x2+1][y1] -= val; diff[x2+1][y2+1] += val; -
先按行求前缀和,再按列求前缀和,还原矩阵
-
代码实现
vector<vector<int>> rangeAddQueries(int n, vector<vector<int>>& queries) { vector<vector<int>> diff(n+2, vector<int>(n+2, 0)); for (auto& q : queries) { int x1 = q[0], y1 = q[1], x2 = q[2], y2 = q[3], val = 1; diff[x1+1][y1+1] += val; // 索引从1开始避免越界 diff[x1+1][y2+2] -= val; diff[x2+2][y1+1] -= val; diff[x2+2][y2+2] += val; } // 前缀和还原 vector<vector<int>> res(n, vector<int>(n)); for (int i=1; i<=n; i++) { for (int j=1; j<=n; j++) { diff[i][j] += diff[i-1][j] + diff[i][j-1] - diff[i-1][j-1]; res[i-1][j-1] = diff[i][j]; } } return res; } -
区间加法二是这个思想的基本应用
- 给你一个
m x n的矩阵M和一个操作数组op。矩阵初始化时所有的单元格都为0。ops[i] = [ai, bi]意味着当所有的0 <= x < ai和0 <= y < bi时,M[x][y]应该加 1 - 在执行完所有操作后,计算并返回矩阵中最大整数的个数
- 显然,可以使用二位差分来解决,但实际上,由于左上角的格子一定会被覆盖,其实统计最小的 a 和 最小的 b 即可
- 在做算法题目时,不要被高级的算法思想蒙蔽了双眼,要观察到问题的本质
- 给你一个
-
参考题目
子矩阵加一
-
典型的二维差分
class Solution { public: vector<vector<int>> rangeAddQueries(int n, vector<vector<int>>& queries) { // 初始化(n+2)x(n+2)的差分矩阵,避免边界越界判断 vector<vector<int>> diff(n + 2, vector<int>(n + 2, 0)); // 1. 处理所有查询,更新差分矩阵 for (auto& q : queries) { int r1 = q[0], c1 = q[1], r2 = q[2], c2 = q[3]; diff[r1][c1]++; // 左上角 +1 diff[r1][c2 + 1]--; // 右上角右侧 -1 diff[r2 + 1][c1]--; // 左下角下侧 -1 diff[r2 + 1][c2 + 1]++; // 右下角右下侧 +1 } // 2. 对差分矩阵做前缀和还原(先按行,再按列) vector<vector<int>> res(n, vector<int>(n, 0)); for (int i = 0; i < n; ++i) { // 行前缀和:处理当前行的列方向累加 int row_sum = 0; for (int j = 0; j < n; ++j) { row_sum += diff[i][j]; res[i][j] = row_sum; } // 列前缀和:处理当前列的行方向累加(i>0时才需要) if (i > 0) { for (int j = 0; j < n; ++j) { res[i][j] += res[i-1][j]; } } } return res; } }; -
另一种写法——利用二维前缀和
class Solution { public: vector<vector<int>> rangeAddQueries(int n, vector<vector<int>>& queries) { // 1. 初始化二维差分矩阵(n+2大小,避免边界越界) vector<vector<int>> diff(n + 2, vector<int>(n + 2, 0)); // 2. 遍历所有查询,更新差分矩阵 for (auto& q : queries) { int r1 = q[0], c1 = q[1], r2 = q[2], c2 = q[3]; // 差分核心操作:给(r1,c1)到(r2,c2)的区域整体+1 diff[r1 + 1][c1 + 1]++; // 区域左上角标记+1 diff[r1 + 1][c2 + 2]--; // 区域右边界外侧标记-1 diff[r2 + 2][c1 + 1]--; // 区域下边界外侧标记-1 diff[r2 + 2][c2 + 2]++; // 区域右下角外侧标记+1 } // 3. 计算二维前缀和,直接生成结果矩阵 vector<vector<int>> ans(n, vector<int>(n)); for (int i = 0; i < n; i++) { for (int j = 0; j < n; j++) { // 二维前缀和公式:当前值 = 左 + 上 - 左上 + 自身原始值 diff[i + 1][j + 1] += diff[i + 1][j] + diff[i][j + 1] - diff[i][j]; ans[i][j] = diff[i + 1][j + 1]; // 直接赋值到结果数组 } } return ans; } };
会议室
-
给定多个活动的开始 / 结束时间,求需要的最少会议室数量(本质是统计同一时间的最大活动数)
-
差分思路
- 对每个活动
[s, e]:diff[s] += 1,diff[e] -= 1; - 前缀和遍历得到实时活动数,最大值即为最少会议室数
- 对每个活动
-
代码实现
int minMeetingRooms(vector<vector<int>>& intervals) { map<int, int> diff; // 有序map,无需手动排序 for (auto& intv : intervals) { diff[intv[0]]++; diff[intv[1]]--; } int cur = 0, res = 0; for (auto& p : diff) { cur += p.second; res = max(res, cur); } return res; } -
参考题目
前缀和与差分的区别
-
核心对比
- 前缀和:解决「已知原数组,快速查区间和」的问题(从整体到局部)——提前缓存累加结果,避免重复计算
- 差分:解决「已知区间操作,快速还原原数组」的问题(从局部到整体)——把区间操作拆成两个点的操作,避免遍历区间
- 两者是互逆操作:前缀和的逆运算就是差分,差分的逆运算就是前缀和
-
用同一个例子验证二者是互逆操作
- 原数组:
[a0, a1, a2] = [1,2,3] - 求差分:
diff = [1, 2-1=1, 3-2=1] - 对 diff 求前缀和:
[1, 1+1=2, 2+1=3]→ 还原原数组; - 求前缀和:
preSum = [0,1,3,6] - 对 preSum 求差分:
[0-0=0(无意义), 1-0=1, 3-1=2, 6-3=3]→ 去掉第一个 0 就是原数组 - 结论:对差分数组做前缀和 = 还原原数组;对前缀和数组做差分 = 还原原数组
- 原数组:
-
用前缀和的场景(关键词:查区间和)
- 求子数组的和(比如和为 k 的子数组个数)
- 静态数组的任意区间和查询(比如统计成绩区间总分)
- 二维矩阵的子矩阵和查询
-
用差分的场景(关键词:区间加减)
- 多次给区间加 / 减一个值,最后求数组(比如航班预订、拼车)
- 统计区间覆盖次数(比如多个时间段的重叠次数)
- 二维矩阵的区间加减修改
-
对比表格
维度 前缀和 差分 核心定义 preSum[i] = 原数组[0..i-1]的和diff[i] = 原数组[i] - 原数组[i-1](i≥1),diff[0] = 原数组[0]核心用途 快速查询静态数组的区间和 快速执行多次区间加减,最后还原数组 操作方向 「合并」:把原数组元素累加 「拆分」:把区间操作拆成两个端点操作 时间复杂度 构建O(n),查询区间和O(1) 区间更新O(1),还原数组O(n) 适用场景 查得多、改得少(静态数组) 改得多、查得少(多次区间修改) 核心公式 区间和 [l,r] = preSum[r+1]-preSum[l]区间加 [l,r,val]→diff[l]+=val,diff[r+1]-=val逆运算 差分(对前缀和数组做差分=原数组) 前缀和(对差分数组做前缀和=原数组)
树状数组(Fenwick Tree/二叉索引树)
-
树状数组是一种高效的动态前缀和数据结构,通过二进制分解索引,实现:
- 单点更新(O(logn))
- 前缀和查询(O(logn))
- 区间和查询:
query(r) - query(l-1)
-
核心操作:
lowbit(x):返回 x 的二进制最低位 1 对应的值(如 lowbit(6)=2,6=110)update(i, val):第 i 个位置加 valquery(i):查询前 i 个位置的和
-
一般用于动态数组的单点更新+区间和查询(比线段树实现简单,效率略高)
-
树状数组的核心是
lowbit操作,仅支持单点更新 + 前缀和查询,所有扩展功能(区间更新、区间查询)都需结合差分数组实现 -
处理大数值范围(如 1e9)时,必须先离散化,将数值映射到小范围(1~m);
-
负数前缀和需通过偏移量映射到正数区间,避免树状数组索引为负
-
代码实现(索引从 1 开始)
#include <iostream> #include <vector> using namespace std; class FenwickTree { private: vector<int> tree; // 树状数组 int n; // 核心函数:lowbit int lowbit(int x) { return x & -x; } public: // 构造函数:初始化树状数组 FenwickTree(int size) : n(size), tree(size + 1, 0) {} // 单点更新:第idx个位置加val(idx从1开始) void update(int idx, int val) { while (idx <= n) { tree[idx] += val; idx += lowbit(idx); } } // 查询前缀和:前idx个位置的和(idx从1开始) int query(int idx) { int res = 0; while (idx > 0) { res += tree[idx]; idx -= lowbit(idx); } return res; } // 查询区间和 [l, r](l,r从1开始) int queryRange(int l, int r) { return query(r) - query(l - 1); } }; int main() { vector<int> nums = {1, 2, 3, 4, 5}; FenwickTree ft(nums.size()); // 初始化:逐个单点更新 for (int i = 0; i < nums.size(); ++i) { ft.update(i + 1, nums[i]); // 索引从1开始 } cout << ft.queryRange(2, 4) << endl; // 2+3+4=9 ft.update(3, 2); // 第3个位置加2 → 原数组变为 [1,2,5,4,5] cout << ft.queryRange(2, 4) << endl; // 2+5+4=11 return 0; } -
时间复杂度:单点更新 O (logn),前缀和 / 区间和查询 O (logn)
-
空间复杂度:O (n)
-
适用场景:动态数组的单点更新 + 区间和查询(如逆序对统计、频率统计)
-
局限性:不支持高效的区间更新(需结合差分数组),不支持区间最值查询
-
树状数组的底层是 “二进制分解的前缀和”,只能处理可加性的聚合操作(和、频次统计);而 “最大值 / 最小值” 不满足 “可加性”(比如前缀最大值无法推导出区间最大值),树状数组无法高效实现,线段树则可以通过维护每个区间的最值,递归合并左右子区间的最值来实现
区域和检索 - 数组可修改
-
给你一个数组
nums,请你完成两类查询- 其中一类查询要求更新数组
nums下标对应的值 - 另一类查询要求返回数组
nums中索引left和索引right之间(包含)的nums元素的和,其中left <= right
- 其中一类查询要求更新数组
-
实现
NumArray类:NumArray(int[] nums)用整数数组nums初始化对象void update(int index, int val)将nums[index]的值更新为valint sumRange(int left, int right)返回数组nums中索引left和索引right之间(包含)的nums元素的和(即,nums[left] + nums[left + 1], ..., nums[right])
-
核心思路
- 树状数组默认索引从 1 开始,需将题目中的 0 索引转换为 1 索引
update:计算当前值与目标值的差值,执行单点更新sumRange:区间和 = 前缀和 (right+1) - 前缀和 (left)(转换为 1 索引后)
-
代码实现
#include <iostream> #include <vector> using namespace std; class NumArray { private: vector<int> tree; // 树状数组 vector<int> nums; // 原数组(保存当前值,用于计算更新差值) int n; int lowbit(int x) { return x & -x; } // 单点更新:第idx位(1索引)加val void add(int idx, int val) { while (idx <= n) { tree[idx] += val; idx += lowbit(idx); } } // 查询前缀和:前idx位(1索引)的和 int query(int idx) { int res = 0; while (idx > 0) { res += tree[idx]; idx -= lowbit(idx); } return res; } public: NumArray(vector<int>& nums) { this->n = nums.size(); this->nums = nums; tree.resize(n + 1, 0); // 初始化树状数组 for (int i = 0; i < n; ++i) { add(i + 1, nums[i]); // 转换为1索引 } } void update(int index, int val) { // 计算差值:新值 - 旧值 int diff = val - nums[index]; nums[index] = val; // 更新原数组 add(index + 1, diff); // 1索引更新 } int sumRange(int left, int right) { // 转换为1索引:left+1 到 right+1 return query(right + 1) - query(left); } }; // 测试 int main() { vector<int> nums = {1, 3, 5}; NumArray obj(nums); cout << obj.sumRange(0, 2) << endl; // 1+3+5=9 obj.update(1, 2); // 数组变为[1,2,5] cout << obj.sumRange(0, 2) << endl; // 1+2+5=8 return 0; } -
参考题目
子数组和的个数
-
给定数组
nums和目标值k,求子数组和等于k的个数 -
核心思路
- 前缀和公式:子数组
[l,r]和 =preSum[r] - preSum[l-1] = k→preSum[l-1] = preSum[r] - k - 用树状数组统计
preSum出现的频次,遍历过程中查询preSum[r]-k的频次,累加得到结果 - 需处理前缀和为负数的情况,通过 “偏移量” 将所有前缀和映射到正数区间
- 前缀和公式:子数组
-
代码实现
class FenwickTree { private: vector<int> tree; int n; public: FenwickTree(int size) : n(size), tree(size + 1, 0) {} void add(int idx, int val) { while (idx <= n) { tree[idx] += val; idx += idx & -idx; } } int query(int idx) { int res = 0; while (idx > 0) { res += tree[idx]; idx -= idx & -idx; } return res; } }; int subarraySum(vector<int>& nums, int k) { int preSum = 0, res = 0; // 偏移量:处理负数前缀和(假设前缀和范围在[-1e9,1e9]) int offset = 1e9; FenwickTree ft(2e9 + 1); ft.add(offset, 1); // 初始preSum=0,频次为1 for (int num : nums) { preSum += num; // 查询preSum - k的频次(需加偏移量) int target = preSum - k + offset; if (target >= 1 && target <= 2e9 + 1) { res += ft.query(target); } // 插入当前preSum ft.add(preSum + offset, 1); } return res; } -
参考题目
逆序对计数
-
给定数组,统计逆序对数量(逆序对:
i < j且nums[i] > nums[j]) -
暴力解法
int reversePairs(vector<int>& nums) { int cnt = 0, n = nums.size(); for (int i = 0; i < n; ++i) { for (int j = i + 1; j < n; ++j) { if (nums[i] > nums[j]) cnt++; } } return cnt; } -
归并排序(算法题最优解,)
-
归并排序的 “合并阶段”,统计左右两个有序子数组的逆序对数量:
- 拆分:将数组拆分为左右两部分,递归求左右部分的逆序对
- 合并:用双指针遍历左右有序数组,若左元素 > 右元素,则左数组剩余所有元素都与右元素构成逆序对(统计数量)
- 累加:左右部分的逆序对 + 合并阶段的逆序对 = 总逆序对
-
代码实现
int mergeSort(vector<int>& nums, int l, int r, vector<int>& temp) { if (l >= r) return 0; int mid = l + (r - l) / 2; // 递归拆分,统计左右逆序对 int cnt = mergeSort(nums, l, mid, temp) + mergeSort(nums, mid+1, r, temp); // 合并阶段统计跨区间逆序对 int i = l, j = mid + 1, k = l; while (i <= mid && j <= r) { if (nums[i] <= nums[j]) { temp[k++] = nums[i++]; } else { temp[k++] = nums[j++]; cnt += mid - i + 1; // 左数组剩余元素都>当前右元素,统计逆序对 } } // 处理剩余元素 while (i <= mid) temp[k++] = nums[i++]; while (j <= r) temp[k++] = nums[j++]; // 拷贝回原数组 copy(temp.begin()+l, temp.begin()+r+1, nums.begin()+l); return cnt; } int reversePairs(vector<int>& nums) { vector<int> temp(nums.size()); return mergeSort(nums, 0, nums.size()-1, temp); } -
树状数组的底层是一个数组
tree,其长度等于数据的索引 / 值域上限(比如处理 0~n-1 的数组,tree 长度需设为 n+1)。这种设计是为了通过lowbit操作快速定位父 / 子节点,实现高效的更新和查询 —— 但代价是:如果数据值域极大(如 1e9),直接创建树状数组会内存溢出,需结合离散化解决 -
树状数组核心思路
- 离散化:将数组值映射到
[1, m](m 为去重后元素个数),避免数值范围过大 - 从后往前遍历数组,对每个元素
x,查询树状数组中[1, x-1]的元素个数(即已遍历的、比 x 小的元素数),累加得到逆序对 - 遍历后将
x插入树状数组(单点更新) - 时间复杂度为 ,空间复杂度为
- 比归并排序多一步离散化,但代码更简洁,适合值域大的场景
- 离散化:将数组值映射到
-
代码实现
class FenwickTree { private: vector<int> tree; int n; public: FenwickTree(int size) : n(size), tree(size + 1, 0) {} void update(int idx, int val) { while (idx <= n) { tree[idx] += val; idx += idx & -idx; } } int query(int idx) { int res = 0; while (idx > 0) { res += tree[idx]; idx -= idx & -idx; } return res; } }; int reversePairs(vector<int>& nums) { // 步骤1:离散化(去重+排序) vector<long long> temp(nums.begin(), nums.end()); sort(temp.begin(), temp.end()); temp.erase(unique(temp.begin(), temp.end()), temp.end()); int m = temp.size(); // 步骤2:树状数组统计逆序对 FenwickTree ft(m); int res = 0; // 从后往前遍历 for (int i = nums.size() - 1; i >= 0; --i) { // 找到nums[i]的离散化索引 int idx = lower_bound(temp.begin(), temp.end(), nums[i]) - temp.begin() + 1; // 查询[1, idx-1]的元素数(比nums[i]小的元素数) res += ft.query(idx - 1); // 插入当前元素 ft.update(idx, 1); } return res; } // 测试 int main() { vector<int> nums = {7,5,6,4}; cout << reversePairs(nums) << endl; // 输出5(逆序对:(7,5),(7,6),(7,4),(5,4),(6,4)) return 0; } -
参考题目
区间和个数
- 给定数组
nums和范围[lower, upper],统计子数组和在[lower, upper]之间的个数 - 核心思路
- 前缀和转化:子数组
[l,r]和 ∈[lower, upper]→preSum[r] - preSum[l-1] ∈ [lower, upper]→preSum[l-1] ∈ [preSum[r]-upper, preSum[r]-lower] - 离散化所有可能的前缀和(包括
preSum、preSum-lower、preSum-upper) - 用树状数组统计
preSum[l-1]的频次,遍历过程中查询[preSum[r]-upper, preSum[r]-lower]的频次,累加结果
- 前缀和转化:子数组
- 参考题目
线段树
-
一种分治思想的树形数据结构,将数组划分为多个不重叠的区间(节点、线段),每个节点存储该区间的聚合信息(和、最值、乘积等),支持:
- 单点更新/区间更新(O(logn))
- 区间查询(和、最值等,O(logn))
-
核心结构:
- 叶子节点:原数组元素
- 非叶子节点:对应数组的一个连续区间,其值 = 左子节点值 + 右子节点值(以和为例)
- 树的高度 ,因此查询 / 更新的复杂度都是
-
核心操作
- 构建(build):递归拆分数组为区间,初始化每个节点的聚合信息
- 更新(update):修改某个位置 / 区间的值,递归更新相关节点的聚合信息
- 查询(query):查询某个区间的聚合信息(和、最值等),递归合并子区间的结果
-
懒标记(延迟更新):区间更新的关键
- 处理 “区间更新”(如给 [L,R] 所有元素加 val)时,为避免逐层更新到叶子节点(时间复杂度退化),引入 “懒标记”——标记当前节点的区间需要更新,但暂时不更新子节点
- 当后续操作需要访问该节点的子节点时,再把标记 “下放”(传递给子节点),完成延迟更新
- 核心作用:保证区间更新的时间复杂度仍为
-
代码实现
#include <iostream> #include <vector> #include <climits> using namespace std; class SegmentTree { private: vector<int> tree; // 存储线段树节点(大小通常设为4*n) vector<int> lazy; // 懒标记数组,记录区间需要延迟更新的值 int n; // 原数组长度 // 构建线段树:node是当前节点索引,l/r是当前节点对应区间 void build(const vector<int>& nums, int node, int l, int r) { if (l == r) { tree[node] = nums[l]; // 叶子节点,赋值为原数组元素 return; } int mid = l + (r - l) / 2; int leftNode = 2 * node + 1; // 左子节点索引 int rightNode = 2 * node + 2; // 右子节点索引 // 递归构建左右子树 build(nums, leftNode, l, mid); build(nums, rightNode, mid + 1, r); // 合并左右子树的信息(和) tree[node] = tree[leftNode] + tree[rightNode]; } // 懒标记下放:将当前节点的标记传递给子节点 void pushDown(int node, int l, int r) { if (lazy[node] == 0) return; // 无标记,无需下放 int mid = l + (r - l) / 2; int leftNode = 2 * node + 1; int rightNode = 2 * node + 2; // 更新左子节点的和 + 标记 tree[leftNode] += lazy[node] * (mid - l + 1); lazy[leftNode] += lazy[node]; // 更新右子节点的和 + 标记 tree[rightNode] += lazy[node] * (r - mid); lazy[rightNode] += lazy[node]; // 清空当前节点的标记 lazy[node] = 0; } // 区间更新:给[ql, qr]所有元素加val,node/l/r是当前节点的区间 void updateRange(int node, int l, int r, int ql, int qr, int val) { // 当前区间完全在更新区间外,直接返回 if (qr < l || ql > r) return; // 当前区间完全在更新区间内,更新当前节点+标记懒标记 if (ql <= l && r <= qr) { tree[node] += val * (r - l + 1); lazy[node] += val; return; } // 有部分重叠,先下放懒标记,再递归更新子树 pushDown(node, l, r); int mid = l + (r - l) / 2; int leftNode = 2 * node + 1; int rightNode = 2 * node + 2; updateRange(leftNode, l, mid, ql, qr, val); updateRange(rightNode, mid + 1, r, ql, qr, val); // 合并子树更新后的信息 tree[node] = tree[leftNode] + tree[rightNode]; } // 区间查询:查询[ql, qr]的和,node/l/r是当前节点的区间 int queryRange(int node, int l, int r, int ql, int qr) { // 当前区间完全在查询区间外,返回0(和的单位元) if (qr < l || ql > r) return 0; // 当前区间完全在查询区间内,返回当前节点值 if (ql <= l && r <= qr) return tree[node]; // 有部分重叠,先下放懒标记,再递归查询子树 pushDown(node, l, r); int mid = l + (r - l) / 2; int leftSum = queryRange(2*node+1, l, mid, ql, qr); int rightSum = queryRange(2*node+2, mid+1, r, ql, qr); // 合并子树查询结果 return leftSum + rightSum; } public: // 构造函数:初始化线段树 SegmentTree(const vector<int>& nums) { n = nums.size(); if (n == 0) return; tree.resize(4 * n, 0); // 线段树大小设为4*n,避免越界 lazy.resize(4 * n, 0); // 懒标记数组初始化 build(nums, 0, 0, n - 1); // 根节点索引0,对应区间[0, n-1] } // 对外接口:区间加更新 void update(int l, int r, int val) { updateRange(0, 0, n - 1, l, r, val); } // 对外接口:区间和查询 int query(int l, int r) { return queryRange(0, 0, n - 1, l, r); } }; // 测试用例 int main() { vector<int> nums = {1, 2, 3, 4, 5}; SegmentTree st(nums); // 查询[1,3]的和:2+3+4=9 cout << st.query(1, 3) << endl; // 给[1,3]所有元素加2 → 数组变为[1,4,5,6,5] st.update(1, 3, 2); // 再次查询[1,3]的和:4+5+6=15 cout << st.query(1, 3) << endl; return 0; } -
时间复杂度:构建 O(n),更新/查询 O(logn)
-
空间复杂度:O(4n)
-
适用场景:动态数组的区间更新、区间最值/和查询(如区间最大值、区间加、区间乘)
-
特点:功能全面,实现比树状数组复杂,是算法题中处理区间问题的“万能工具”
-
主要场景
- 区间最值查询 + 单点 / 区间更新
- 区间赋值 / 区间乘除(非加减类区间更新)
- 二维区间操作(二维线段树 / 树套树)
- 复杂聚合操作(非和 / 最值类)
数据流的中位数
掉落的方块
区域内查询数字的频率
- 参考题目
我的日程安排表
前缀和、差分、树状数组与线段树的对比
| 工具 | 核心定位 | 核心能力(核心操作) | 动态性(边改边查) | 时间复杂度(单次操作) | 典型适用场景 | 核心局限 |
|---|---|---|---|---|---|---|
| 前缀和 | 静态区间和查询 “专用工具” | 静态数组的区间和查询(preSum[r]-preSum[l]) | 静态(不可改) | 查询 O (1),更新 O (n)(重构) | 静态数组的区间和、子数组和问题(如 560 题) | 无法动态更新,仅支持和查询 |
| 差分 | 批量区间加减 “专用工具” | 批量区间加减([l,r]+val → 两点操作),最后前缀和还原 | 伪动态(改后需全还原) | 区间修改 O (1),查询 O (n)(还原) | 拼车、航班预订、区间覆盖计数(改多查少) | 无法边改边查,仅支持加减操作 |
| 树状数组 | 动态区间和 “轻量工具” | 单点更新 + 前缀和 / 区间和查询;(拓展:区间加 + 区间和) | 全动态 | 更新 / 查询 O (logn) | 逆序对、动态区间和、频次统计(查改都频繁) | 仅支持加性操作(和 / 频次),不支持最值 / 区间赋值 |
| 线段树 | 区间操作 “万能引擎” | 单点 / 区间更新 + 区间和 / 最值 / GCD / 异或等聚合查询;支持区间赋值 / 乘除 | 全动态 | 更新 / 查询 O (logn) | 区间最值、区间赋值、二维区间统计、复杂聚合操作 | 实现稍复杂,空间占用略大(4*n) |
扫描线
-
将二维区间问题转化为一维区间操作,核心思想:
- 提取所有关键事件点(如矩形的左边界/右边界)
- 按事件点排序,遍历过程中维护当前有效区间的信息(如长度、面积)
- 累加每一段的贡献,得到最终结果
-
一般用于解决二维区间统计问题(如矩形面积并、矩形周长并、天际线问题)
-
代码实现
// 核心步骤: // 1. 定义事件点:(x, y1, y2, type),type=1(左边界,加)/ -1(右边界,减); // 2. 按x排序事件点; // 3. 遍历事件点,用线段树/差分数组维护y轴的有效长度; // 4. 面积 = 累加 (当前x - 上一个x) * 当前有效y长度。 -
时间复杂度:(排序+线段树操作)
-
适用场景:二维区间统计(矩形面积并、天际线、停车场车辆数)
-
特点:将高维问题降维,是处理几何/区间统计的核心技巧
矩阵面积并
- 给你一个轴对齐的二维数组
rectangles。对于rectangle[i] = [x1, y1, x2, y2],其中(xi1, yi1)是该矩形 左下角 的坐标,(xi2, yi2)是该矩形右上角的坐标、 - 计算平面中所有
rectangles所覆盖的 总面积 。任何被两个或多个矩形覆盖的区域应只计算一次 - 返回总面积 。因为答案可能太大,返回
10^9 + 7的模 - 参考题目
块状数组(分块)
-
“分而治之”的折中方案,将数组分为若干块(如块大小 ),实现:
- 块内暴力操作,块间批量操作
- 平衡“暴力”和“高效数据结构”的实现复杂度
-
核心步骤:
- 分块:将数组分为size=√n的块,记录每个元素所属块、块的左右边界
- 操作:
-
区间更新:完整块批量标记(懒标记),不完整块暴力更新
-
区间查询:完整块批量查询,不完整块暴力查询
-
-
一般用于处理“无法用树状数组/线段树高效实现,但暴力又超时”的区间问题(如区间开方、区间众数)
-
时间复杂度:O() 单次操作
-
空间复杂度:O(n)
-
适用场景:复杂区间操作(如区间开方、区间赋值+区间求和)
-
特点:实现简单,效率介于暴力(O(n))和线段树(O(logn))之间,是“暴力优化”的首选
珂朵莉树(Chtholly Tree)
-
基于区间合并的暴力数据结构,核心依赖:
- 数据随机(区间赋值操作多,查询少)
- 用
set存储连续的相同值区间,每个区间表示为[l, r, val]
-
核心操作:
split(pos):将包含pos的区间拆分为[l, pos-1, val]和[pos, r, val]assign(l, r, val):删除[l, r]内的所有区间,插入新区间[l, r, val]- 查询:遍历
[l, r]内的区间,累加/统计信息
-
用于随机数据下的区间赋值+区间查询(如区间求和、区间最值),实现极简
-
代码实现
#include <iostream> #include <set> using namespace std; // 定义区间结构体 struct Node { int l, r; mutable int val; // mutable允许在set中修改val Node(int l, int r, int val) : l(l), r(r), val(val) {} bool operator<(const Node& other) const { return l < other.l; // 按左边界排序 } }; set<Node> tree; // 拆分区间:返回包含pos的区间的迭代器 auto split(int pos) { auto it = tree.lower_bound(Node(pos, 0, 0)); if (it != tree.end() && it->l == pos) return it; --it; int l = it->l, r = it->r, val = it->val; tree.erase(it); tree.insert(Node(l, pos - 1, val)); return tree.insert(Node(pos, r, val)).first; } // 区间赋值:[l, r] 赋值为val void assign(int l, int r, int val) { auto itr = split(r + 1); auto itl = split(l); tree.erase(itl, itr); tree.insert(Node(l, r, val)); } // 区间求和:[l, r] long long querySum(int l, int r) { long long res = 0; auto itr = split(r + 1); for (auto it = split(l); it != itr; ++it) { res += (long long)(it->r - it->l + 1) * it->val; } return res; } int main() { // 初始化:插入 [1,5,1] tree.insert(Node(1, 5, 1)); assign(2, 4, 2); // [2,4]赋值为2 → 区间变为 [1,1,1], [2,4,2], [5,5,1] cout << querySum(1, 5) << endl; // 1 + 3*2 + 1 = 8 return 0; } -
时间复杂度:随机数据下 ,非随机数据下
-
适用场景:随机数据、区间赋值操作多的场景(如 CF 比赛中的特定题目)
-
局限性:数据不随机时效率极低,仅适用于特定场景,通用性差