强化学习
整理各种面试中常见的八股问题,涵盖 Python 基础、PyTorch 基础、算法与数据结构等内容
强化学习
基本理论
-
简单说明下你对强化学习的理解,在大模型中的应用
- 强化学习就是让智能体在环境里不断尝试,根据奖励信号逐步优化行为策略,最终学到长期收益最大的决策方式
- 强化学习在大模型中的应用,最早的就是对齐人类偏好(RLHF),而随着 DeepSpeek R1 范式的出现,大规模强化学习被应用于提高基础模型思考推理、调用工具、规划步骤的能力,而现在,RL 还被应用于提升 Agent 层面的能力,专注于提高模型在多步复杂任务中的能力
-
强化学习基本要素(马尔可夫决策过程 MDP / 部分可观测 POMDP、状态 / 动作 / 奖励 / 策略 / 价值函数)
-
详细介绍一下从 MC、TD、SARSA、Q-Learning、DQN、策略梯度、Actor-Critic、TRPO、PPO、GRPO 这一系列的演变过程
-
从无模型、表格型方法,到深度价值学习,再到策略梯度,最后进化到稳定可扩展的现代策略优化,一路都在解决收敛难、方差大、不稳定、不连续动作、难训练、难规模化的问题
-
强化学习的基础框架就是解决同一个问题,即在马尔可夫决策过程中,学习策略 π,最大化长期累积奖励
-
MC:通过跑完一个完整的 episode,用实际收获的回报 G 作为价值的估计,简单无偏,但是学习延迟较高,效率太低而且方差比较大
-
TD:不跑完整个 episode,而是用当前价值函数对下一个状态的估计值自举,它可以进行在线更新,但是有偏,而且只有价值函数,没有策略
-
SARSA:学习动作价值函数,用当前策略实际会选的动作来更新,必须用 ϵ-greedy 探索,样本效率低,策略更新比较慢
-
Q-Learning:off-policy 方法,直接学习最优 Q 值,更新时用 max Q (s',a'),不关心实际动作;样本可复用,效率较高;无法处理高维状态,存在过估计
-
DQN(Deep Q-Network):把 Q-Learning 神经网络化,加入经验回放打破相关性,并引入目标网络防止训练震荡;能够处理高维状态,但是只能离散动作,过估计严重
-
策略梯度 Policy Gradient:不再学习 Q 值,而是直接参数化策略 πθ(a|s),通过梯度上升最大化期望奖励;天然支持连续动作空间,输出是随机策略,探索更自然;方差较大,容易更新过猛,策略直接崩溃
-
Actor-Critic(AC):引入 Critic 网络来评价 Actor 网络输出的动作的好坏,并以此计算优势函数替代 Q 函数,降低方差;仍然容易更新过大,训练不够稳定,对超参数敏感
-
TRPO(Trust Region Policy Optimization):通过加入 KL 约束条件,强制更新幅度可控,实现单调改进;但是需要引入二阶优化,计算昂贵,无法大规模工程应用
-
PPO(Proximal Policy Optimization):用裁剪目标来近似 TRPO 的信赖域,限制新旧策略概率比值,不让更新太猛
-
GRPO(Group Relative Policy Optimization):不再单样本对比,而是同一 Group 内相对比较,用分组归一化优势,减少奖励噪声,更适合大模型这种奖励噪声极大、长序列生成场景
-
-
on-policy vs off-policy 区别?on-policy 为什么训练效率低?有什么改进思路?
- 改进思路
- 延长数据 “有效期”—— 小步更新策略:类似 PPO 限制策略更新幅度,并通过重要性采样实现伪 on-policy
- 改进思路
-
偏差和方差是什么
- 偏差:模型预测的期望,和真实函数的差,衡量了模型本身的假设,离真实规律有多远
- 方差:同一个模型,在不同训练数据上得到的预测结果的波动程度,衡量了模型对训练数据的微小变化有多敏感
-
什么是重要性采样?
-
利用两个概率分布的比值,把从源分布采样的数据,折算等价目标分布的期望
-
在 RL/PPO 中:
-
p:旧策略 (采样轨迹)
-
q:新策略 (待优化)
-
比率:
-
-
-
偏差和方差在强化学习中 trade-off 怎么理解?GAE 的 如何权衡?
- 偏差 Bias:估计值与真实期望的系统误差,来自 bootstrap、近似拟合、不完整观测
- 方差 Variance:不同轨迹、不同采样带来的估计抖动、梯度噪声
- Tradeoff:减小偏差通常会放大方差,压低方差一般会引入系统偏差
- :趋近 MC,偏差极小、方差极大,不依赖价值模型 bootstrap
- :趋近 1-step TD,方差极小、偏差变大,强依赖 Critic 估值
- 工程标配:,平衡两者
-
蒙特卡洛 MC、时序差分 TD、GAE 三者的优劣对比?
方法 偏差 方差 是否需要 V 网络 长稀疏奖励适配 蒙特卡洛 MC 低 极高 不需要 差,全程依赖真实轨迹 单步 TD (0) 高 低 需要 一般,仅一步回溯 GAE (λ) 中 中 需要 优,多步平滑折扣 -
重要性采样为什么可以把旧策略轨迹用于新策略训练?有什么固有缺陷?
- 通过概率比值矫正分布差异,数学上将旧策略样本期望映射为新策略期望,实现 on-policy 数据复用更新
- 新旧分布差距大时,重要性比率极端爆炸 / 趋近 0,梯度畸变
- 方差随比值放大,训练极易不稳定
- 多轮迭代后分布漂移,校正失效,必须限制更新幅度(Clip/KL)
-
什么是 Reward Scaling、Normalization?为什么要做奖励归一化
- Reward Scaling:全局线性缩放奖励,压缩 / 放大值域
- Reward Normalization:逐 batch / 全局做奖励归零、方差标准化
- 消除不同 Prompt、不同任务、不同难度的奖励尺度不一致,稳定优势分布
-
什么是探索与利用?
- Exploitation(利用):选已知最优的动作,最大化当前收益
- Exploration(探索):主动选未知 / 不确定的动作,收集更多信息,为了长期收益
- 模型本身生成时的探索(采样温度):设置温度、top-p、top-k
- 强化学习的 Exploitation:朝着奖励更高的方向更新策略,让模型更倾向于生成已经被验证 “好” 的回答
- Exploration:不让模型迅速塌缩到单一模式,保持策略一定熵(Entropy)
-
在线 RL 和离线 RL 的边界,大模型为什么主流偏好离线类算法?
- 在线 Online RL
- 模型实时 rollout 采样新轨迹,即时打分即时更新(PPO/GRPO)
- 可自探索、持续进化;代价高、噪声大、易不稳
- 离线 Offline RL
- 使用固定静态偏好数据集,不实时生成(DPO/KTO)
- 低成本、超稳、易复现;上限受数据集约束
- online 实时 rollout 太慢
- 在线 Online RL
值函数方法
-
介绍一下 MC,有什么优缺点?
-
介绍一下 TD,有什么优缺点?TD (λ) 呢?
-
你是如何理解 TD(Temporal Difference)的时序差分的概念的?
- TD = 用 “当前一步的奖励 + 对未来的估计” 来更新当前价值,不用等整局结束
- 就是时序差分目标:用当前即时奖励 + 对下一个状态的估计值,来替代真实的最终回报
-
怎么理解 bootstrap?
- Bootstrap = 用自己当前的估计值,去更新自己的估计值
- 不用等到轨迹走完、不用纯粹靠真实瞬时奖励,用下一步的预估价值来兜底当前步的价值
-
介绍一下 SARSA,有什么优缺点?SARSA (λ) 呢?
-
SARSA 为什么是 On-Policy 的?样本效率为什么低?存在什么问题?
- SARSA 更新所采用的 是当前策略实际会执行的下一个动作,也就是说它更新的 Q 值,是针对当前正在执行的策略
- 而 On-Policy 要求采集数据的策略 == 被更新的目标策略,一旦策略更新了一点点,之前存的经验就 “过时” 了,不能重复用,只能不断采集新数据,不能复用旧经验 → 样本效率低
- 存在的问题:必须跟着当前策略走,无法复用历史数据;探索只能靠 ε-greedy,效率不高;学到的是近似最优的保守策略,不是严格最优;收敛速度慢
-
介绍一下 Q-Learning
- Q-Learning 是基于价值的 off-policy 强化学习算法,主要是为了解决离散状态、离散动作的马尔科夫决策问题
- 它的核心思想是利用贝尔曼方程去迭代更新 Q 值,而策略由动作价值函数贪心得到
- 缺点是只能处理离散低维状态,无法泛化,易过估计
-
Q-Learning 为什么是 Off-Policy 的?为什么可以复用样本?
- Q-Learning 不关心下一个动作 到底是什么,而是直接取最大 Q 值,相当于在学最优策略
- 采集经验用的行为策略(比如 ε-greedy)和学习的目标策略(贪心策略)可以不一样,所以是 Off-Policy 学习
- Q-Learning 学的是全局最优动作价值 ,它不依赖于当前策略是什么,只要是从同一个 MDP 采出来的经验,都能用来更新
- 所以旧经验、别人的经验、不同策略采的数据都能用 → 样本可以反复复用
-
介绍一下 DQN
-
DQN 主要是为了解决 Q-Learning 无法处理高维连续状态的问题,仅支持离散动作
-
用神经网络拟合 Q 函数,并引入两个关键 trick 保证稳定:
- 经验回放(Experience Replay):打破样本时序相关,提高数据利用率,稳定训练
- 目标网络(Target Network):固定优化目标,防止训练发散
-
DQN 只有两个结构相同、参数不同的卷积 / 全连接网络
- 当前 Q 网络(Q Network / Online Network)
- 目标 Q 网络(Target Network):参数是 Q 网络参数的旧副本,固定一段时间不变,用于计算 TD 目标 ,每隔 N 步更新一次
-
训练流程
-
与环境交互,存入经验回放池(Replay Buffer)
-
从 buffer 随机采样一批
-
用 Target Network 计算目标:
-
用 Q 网络预测
-
用 MSE 损失更新 Q 网络:
-
每隔 N 步,把 Q 网络参数复制给 Target Network
-
-
为什么要引入目标网络
- 因为如果不引入 Target Network,优化目标会跟着网络一起变,导致训练不稳定、不收敛
- 在普通 Q-Learning 里,TD 目标是:
- 如果放到深度网络中,不分开 Target Network:
- 预测值 在更新
- 目标值 也在用同一套 更新
- 结果导致你在一边追着一个移动的目标跑,目标还在跟着你跑,梯度波动巨大,Q 值容易发散、训练崩溃
- 而引入 Target Network 之后,目标网络参数一段时间固定不变,TD 目标 变得稳定、可信赖,网络只需要拟合一个固定目标,训练大幅稳定
-
DQN 的 Q 值过估计问题
- 首先,Q 网络对 Q 值的估计本身有误差,无论是由于欠拟合、过拟合、探索噪声,Q (s,a) 总会偏高或偏低
- 而 DQN 的目标使用 ,在存在误差的情况下,对于每个动作,误差可正可负,但是 max 操作天然会选中误差偏正的那个动作,导致计算出的 TD 目标 系统性偏大
- 这样,一直用偏大的 去训练 Q 网络,Q 网络进一步被高估,如此进行训练,误差会不断传递
-
-
DQN 中经验回放的作用?
- 打破数据间的时序相关性:连续样本高度相关,会导致训练震荡、不收敛;随机打乱后更接近独立同分布
- 提高样本效率:同一段经验可以被多次重复学习,不用每次都重新和环境交互
- 发挥 Off-Policy 特性:把历史经验存起来,实现高效异策略学习
-
介绍 Double DQN?怎么解决过估计?
- 在 DQN 基础上的改进,结构几乎不变,只改了目标计算方式,其核心是专门解决 DQN 的 Q 值过估计问题
- 把原来 DQN 的一步
max拆成两步独立操作:- 用当前 Q 网络选动作:
- 用 Target 网络评估这个动作的 Q 值:
- 目标公式变成:
- DQN 的过估计来源是同一个网络既选 max 动作,又评 max 价值 → 误差被放大
- 选动作和评价值用两套不同参数,解耦误差
- 选动作:在线网络
- 评价值:目标网络
- 即使某个动作在在线网络里被高估、被选中,到目标网络里评估时,误差不会同步同向被放大,从而大幅抑制系统性过估计
-
介绍 Dueling DQN?怎么解决过估计?
-
同样是 DQN 改进版,不改学习目标,只改网络结构
-
把 Q 网络的输出层拆成两部分:
- 状态价值 V (s):只和状态有关,和动作无关
- 动作优势 A (s,a):衡量 “这个动作比平均好多少”
-
最终 Q 值由两者组合得到(后面减去均值是为了保证唯一性)
-
很多时候状态本身就很好 / 很坏,和做什么动作关系不大,Dueling 结构让网络:
- 专门学状态有多好:
- 再学每个动作相对优势:
-
Dueling DQN 不直接从公式上消除过估计,而是从表示学习层面间接抑制过估计:
- 原来 DQN 每个动作 Q 值独立估计,误差容易各自飘、互相放大
- Dueling 把共同的状态价值 抽出来,让 只学相对差异
- 网络不需要对每个动作都从头估一遍 Q,估计更稳定、误差更小
- 误差小了,max 带来的过增幅度自然就弱了
-
-
介绍 PER(Prioritized Experience Replay)?做了什么改进?
-
对 DQN 中 Experience Replay 的改进,不改动网络结构,只改采样方式,属于 Off-Policy 强化学习的数据利用优化
-
其核心思想是不再均匀采样,而是优先采样更 “有用” 的经验
-
普通 DQN 的经验回放机制是从 Buffer 里随机均匀采样,但很多经验是简单、重复、信息很少的(比如走平路、无奖励)
-
然而,有些经验 TD 误差很大,说明网络对它预测很不准,学这些提升最大
-
因此,PER 的直觉是按重要性优先采样,让模型多学不会的、少学已经会的
-
优先级指标 —— 用 TD 误差 衡量经验重要性:
- 越大 → 预测越不准 → 优先级越高
- 越小 → 已经学得差不多 → 优先级越低
-
采样策略
-
贪心优先:永远采样 最大的,缺点是容易过拟合少数几条经验,缺乏多样性
-
随机优先采样:把优先级转成采样概率
- (避免 0)
- 控制优先程度:0 = 均匀采样,1 = 完全贪心,从而兼顾优先性与多样性
-
-
重要性采样校正 IS weights
- 优先采样会导致数据分布与真实策略分布不一致,引入偏差
- 训练时加权重,抵消优先采样带来的分布偏移:
- 从低到高退火,最后接近 1
- 用于修正梯度,保证无偏更新
-
PER 通过以上步骤,提升了样本效率,收敛更快,也间接缓解了部分过估计,对稀疏奖励环境比较友好
-
策略梯度方法
-
推导一下策略梯度函数?
-
整体流程
- 首先,策略的优化目标是最大化轨迹的期望累积回报
- 直接对期望求梯度不行,因为回报不依赖参数,轨迹分布也无法直接求导
- 所以我们交换梯度与积分,用对数导数技巧把梯度转移到 上
- 把轨迹概率展开后,环境动态和初始分布梯度都消失,只剩下策略对数概率的梯度
- 再利用因果性,把总回报拆成每个时刻的未来回报,最终得到策略梯度定理
- 最后引入基线可以在不改变期望的前提下降低方差,这也是所有在线策略算法的基础
-
定义策略目标函数
-
最大化的期望累积回报:
-
是一条轨迹
-
是轨迹折扣回报
-
是轨迹的概率
-
-
目标就是
-
策略目标函数不能直接求梯度
-
直接对期望求梯度:
-
问题有两个:
- 本身不显式依赖 ,梯度无法穿过它
- 积分内部是轨迹分布 ,它是高维、不可解析积分的
-
所以不能直接求导,必须用概率技巧把梯度转移到 上
-
不直接求 的梯度,而是用 当做权重,给采样到的序列加权,让奖励高的序列概率上升,奖励低的下降
-
-
交换梯度与积分(合法,因为满足莱布尼茨条件)
-
使用对数导数恒等式
-
对任意可微概率密度,恒成立:
-
代入:
-
写成期望形式:
-
-
化简 的梯度
-
轨迹概率展开:
-
对 求梯度后:
- 环境动态 与 无关 → 梯度为 0
- 初始状态分布 也无关 → 梯度为 0
-
只剩下:
-
-
代入得到最原始策略梯度
-
未来动作不影响过去奖励,因此可以把回报替换成从 t 时刻开始的未来累计回报(也叫 Q 或回报 - to-go)
-
最终得到标准策略梯度定理:
-
可以选择以下任意一种
- :整条轨迹的总回报(对应 REINFORCE 算法的 vanilla 版本)
- :动作 之后的累积回报(从当前时刻 到终止的回报和)
- :上式的带基线版本( 为只依赖状态的基线函数,用于降低方差)
- :状态 - 动作价值函数(Q 函数,衡量在状态 执行动作 的期望总回报)
- :优势函数(,衡量动作 优于状态平均动作的程度,PPO 等算法的核心)
- :TD 残差(TD error)(时序差分误差,是单步版本的优势函数近似)
-
为了稳定,可以减去一个与动作无关的 baseline :
-
期望不变,但方差大幅下降,这就是 REINFORCE with baseline / A2C / GAE / PPO 的统一源头
-
-
什么是策略梯度定理?原生策略梯度为什么方差极大?
-
性能指标梯度 = 对数似然梯度 × 动作价值
-
上述公式中,使用原始 Q 函数,没有减去状态基线 V,包含大量无关状态公共噪声
-
Q 依赖全程未来累积奖励,采样随机性极强
-
没有多步平滑、没有归一、没有优势提纯
-
-
什么是优势函数?为什么用优势比用 Q/V 更好?优势函数的作用?
- 优势函数 A (s,a) = 这个动作有多 “比平均水平更好”
- 用优势函数可以大幅降低策略梯度的方差,同时保持梯度无偏
- 去掉了与动作无关的 “基线” V (s),减少噪声
- 梯度方向不变,仍然无偏,但是方差变小了
- V (s) 只描述状态好坏,不区分动作好坏,使用优势函数能够让训练更稳定
-
讲一下 GAE 是什么?为什么要引入 λ?GAE 为什么能降低方差?
-
回到策略梯度的本质
-
其中,Rt 是 Monte Carlo return,包含从 t 到 T 的所有随机性,对 long-horizon 来说越早的 step,看到的 future 越长 → variance 越大
-
TD 方法:第一步降 variance
-
用 value function 来预测未来,而不是等真实 reward,这样只用一步 reward + 一步预测,把 “长时间随机性” 变成 “短期 + 估计值”
-
但是 TD 引入了 bias(因为 V 不准),这是一个经典 trade-off:
- MC:无 bias,高 variance
- TD:低 variance,有 bias
-
GAE(Generalized Advantage Estimation)是:
-
GAE 不是只用一步 TD,也不是用完整回报,而是对多个时间尺度的 TD 误差做指数加权,从而在 bias 和 variance 之间取得平衡
-
指数加权平滑未来多步残差,平均化单点瞬时扰动
-
-
策略梯度算法的优缺点?
- 缺点
- 方差极大,训练非常不稳定 —— 引入基线
- 容易一步更新过猛 ——PPO Clip
- 样本效率极低 —— 通过 PPO Clip,一条样本可以小步幅更新多次
- 容易陷入局部最优
- 对超参极其敏感
- 缺点
-
策略优化三大流派(基于价值 / 基于策略 / 演员 - 评论家 AC)的核心区别、优缺点,为何 LLM 后训练更偏向策略梯度类算法
- 动作空间巨大,价值方法无法建模
- 生成是序列决策,需要长期奖励优化
- 需可控分布更新,防止模型能力崩塌
- 天然适配人类 / AI 反馈类黑盒奖励
- 支持随机采样与多样性生成
-
策略梯度为什么方差大?谈一下怎么减小方差?
- 在 RL 里,variance 的来源主要是 reward 本身 noisy,trajectory 很长(误差累积),policy sampling(随机性)
- 引入基线 baseline 计算优势函数,削减方差
- 利用 GAE 广义优势估计,在 MC 和 TD 之间做 trade-off,折中偏差和方差
- 奖励归一化:把 reward 做 mean/std normalize,防止 scale 过大,提高训练稳定性
- KL 散度约束 / 更新幅度裁剪
- 组内优势对比,并对优势进行标准化
REINFORCE
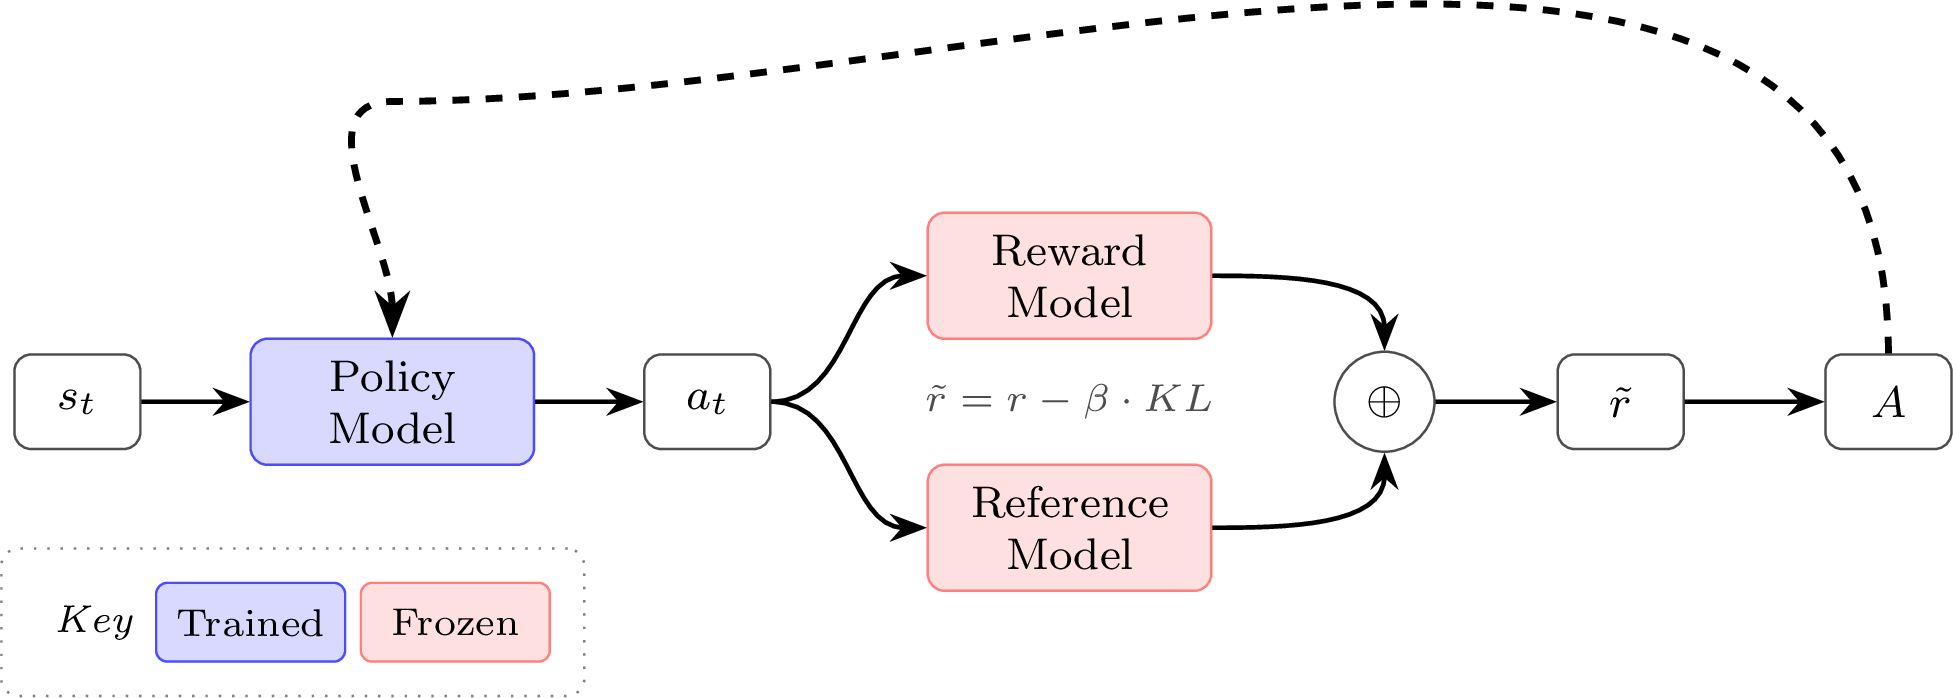
-
REINFORCE 算法名称来源于短语 “REward Increment = Nonnegative Factor × Offset Reinforcement × Characteristic Eligibility”,即 “奖励增量 = 非负因子 × 偏移强化 × 特征资格迹” 的首字母缩写
-
这三个组成部分描述了单次策略梯度更新的构成方式:
- 非负因子:对应学习率或步长,必须为正,例如公式中的
- 偏移强化:对应基线 或其他奖励归一化项,用于降低梯度方差,提高训练稳定性
- 特征资格迹:描述奖励如何归因到各个参数或 token 上,在早期形式中,它是每个参数的通用资格迹 ,在现代策略梯度中通常采用策略对数概率的梯度
-
REINFORCE 的参数更新形式可以写为:
-
引入广义回报 G 后,其梯度形式为:
-
其中, 可视为策略在状态 下采取动作 的优势,因此策略梯度也可写成优势函数形式:
-
从这个角度看,REINFORCE 是普通策略梯度的一种具体实现,其核心特点是使用蒙特卡洛方法估计回报,从而得到无偏但高方差的梯度估计
-
如果选择批次平均奖励作为基线:
-
在实际 RLHF 中,为了对同一个提示生成多个可能的补全(即多条轨迹),通常会采样多条轨迹并对梯度取平均:
RLOO
-
RLOO(Leave-One-Out)是一种改进的基线设计,主要区别在于每条样本的基线不包含自身奖励
-
给定同一个提示 下采样得到的 K 条轨迹(动作),RLOO 为第 个样本定义的基线为其他 条的平均奖励:
-
相应的优势定义为:
-
该优势形式可以等价地写为标准批次平均奖励形式的变体:
-
与普通 REINFORCE 的批次平均基线相比,RLOO 使得每条样本的基线不包括自身奖励,从而在样本数量较少的情况下进一步降低梯度方差
- REINFORCE 的基线是每个输入采样一次,然后进行批次内平均,其基线是跨状态平均的,对某个具体状态 sk 来说,基线不是它的真实平均回报,因此减去基线后,仍然包含大量状态本身价值差异带来的波动
- RLOO 则对同一个输入 s,采样 K 条轨迹,基线来自 “同状态、同策略的其他轨迹”,所以 bk 是当前状态 s 下真实期望回报的极佳近似;减去基线后,几乎只保留动作好坏带来的差异,把状态本身价值、环境随机波动全部滤掉
- 设单个轨迹的方差是 ,则 K 条轨迹留一平均后,方差变为 ,K 越大,方差越接近 0
-
RLOO 是一种低方差的 per-prompt 优势估计方法,与 GRPO(群组相对策略优化)的群组相对优势在形式和直觉上高度相似,两者主要区别体现在:
- KL 惩罚的处理方式:RLOO 通常将 KL 项折叠进序列级奖励中,而 GRPO 通常在损失函数中显式加入 KL 惩罚
- 是否使用 PPO 风格的重要性比率裁剪(importance ratio clipping)
-
随着 RLHF 训练的发展,KL 惩罚的使用频率整体下降,部分现代 Reasoning 版本中已完全移除 KL
-
KL 的类型
-
序列级 KL
-
直接对整个生成序列计算 KL:
-
得到一个标量 KL,将它折叠进整个序列的奖励中:
-
这种方式下,所有 token 都共享同一个序列级 KL 惩罚,类似 RLOO
-
-
token 级 KL
-
保留每个 token 的 KL:
-
PPO 中通常将 计算时直接减去 token 的 KL:
-
这样,每个 token 的奖励都独立考虑 KL,进一步实现 token 级信用分配和约束
-
-
GRPO 通常保留序列级优势,同时在损失函数中额外加入 token 级 KL,而不是将 KL 加入到奖励中
-
损失函数
-
是每个 token 的 KL
-
损失函数中 KL 与策略梯度项是并列的,而不是直接从奖励中减掉
-
-
-
奖励分配策略:
- RLOO 和其他不使用价值网络的方法,会将同一序列级优势(或奖励)广播给该序列中的所有 token
- PPO 则显式训练价值网络,为每个 token 分配不同价值,并将 EOS token 的最终奖励按时间步折扣,实现更精细的信用分配
TRPO
-
介绍一下 TRPO 算法
-
在新旧策略差异不超限(KL 散度约束)的前提下,最大化策略性能提升,实现单调非递减优化:
- 目标:替代损失(Surrogate Loss),用重要性采样比 πθπold 加权优势函数 A
- 约束:平均 KL 散度 ,限制策略更新幅度
- 优势函数 ,用 GAE(广义优势估计)计算以降低方差
-
算法流程(On-Policy)
- 数据收集:用旧策略 πold 与环境交互,收集轨迹
- 优势计算:用 Critic 网络估计价值 V (s),通过 GAE 计算优势
- 构建目标:计算替代损失与策略梯度
- 约束求解:用共轭梯度法(CG) 求解自然梯度方向 (H 为 Fisher 信息矩阵)
- 线搜索:沿自然梯度方向回溯搜索,满足 KL 约束后更新参数
-
-
TRPO 的共轭梯度法 CG 是在做什么?为什么工程上很少直接用?
-
TRPO 最终转化为求解自然梯度:
- H:Fisher 信息矩阵(Hessian 近似),刻画策略空间曲率
- :自然梯度方向(黎曼流形上的最优方向)
-
共轭梯度法的任务:求解线性方程组 ,得到 (自然梯度),不直接构造 / 求逆 H(百万级参数下 H 无法存储)
-
共轭梯度法的原理:
- 迭代构造共轭方向(关于 H 正交),避免梯度下降的 “之字形” 收敛
- 仅需计算 Hessian - 向量积(HVP):Hv,无需存储 H
- n 维问题理论上 n 步收敛,实际 10~20 步即可近似
-
-
TRPO 算法存在的问题是什么?
- 计算昂贵:每步更新需 500
1000 次 HVP,百万参数网络单次更新需 35 分钟(A100),内存占用是普通策略梯度的 2~3 倍 - 实现复杂:需手动实现 HVP、CG 迭代、回溯线搜索,细节极易出错
- 数值稳定性差:HVP 计算易溢出 / 欠精度,约束满足度难控制
- 超参数敏感:CG 步数、信赖域 、线搜索参数需精细调参,否则不收敛
- On-Policy:必须全量新样本,数据利用率低,大模型训练成本极高
- 计算昂贵:每步更新需 500
PPO
-
介绍一下 PPO 算法
- PPO(Proximal Policy Optimization,近端策略优化)是在线、on-policy、一阶优化的经典强化学习算法,解决原生 Policy Gradient、TRPO 的痛点
- 原生策略梯度:更新步长无约束,容易一步更新垮掉策略、训练不稳定、梯度爆炸
- TRPO:用硬 KL 约束限制新旧策略更新幅度,保证单调提升,但求解共轭梯度、运算复杂、工程落地难、无法用 Adam 等优化器
- 设计思想
- 沿用优势函数 + 重要性采样复用轨迹数据
- 放弃 TRPO 复杂硬约束,用两种轻量化约束方案:
- PPO-Clip:直接对新旧策略概率比做截断,限制单次更新幅度;
- PPO-Penalty:额外加 KL 散度惩罚项,软约束策略偏移;
- 支持多轮小 batch 迭代、采样一次轨迹多次更新参数,样本效率更高;
- Actor 负责决策采样,Critic 负责估值算优势,交替优化,是工业界 & LLM RLHF 基线算法
- PPO(Proximal Policy Optimization,近端策略优化)是在线、on-policy、一阶优化的经典强化学习算法,解决原生 Policy Gradient、TRPO 的痛点
-
PPO 的核心设计动机是什么?
- 解决原始策略梯度的步长敏感、更新不稳定问题
- 抛弃 TRPO 的复杂工程实现
- 兼顾样本效率与易用性
-
PPO 的损失函数如何计算?
-
PPO 在 RLHF 里通常是:
-
Policy Loss
-
Value Loss
-
Entropy 防止过早收敛
-
损失就是目标函数的负值,最大化目标函数就等于最小化损失;上式中,Value Loss 本身就是 MSE 损失,越小越好,因此不需要添加符号
-
Value Loss 通常也会进行裁剪,通常会取
-
这里取最大值,是因为价值网络本身要最小化预测误差,但是需要限制更新幅度;
-
当新预测
new_v偏离旧值old_v超过阈值时,保留更大的损失,等效于减小更新步长,从而避免因单次 batch 的异常样本导致价值网络剧烈波动,这与策略 Clip 用min约束更新方向类似,只是目标相反
-
-
PPO 的策略损失中,为什么要取一个 min 最小值?
- min 的作用是在两种更新里,永远选更保守(更新幅度最小)、更安全的那一个梯度方向,从而把策略更新限制在信赖域内,保证训练稳定性
- 当 A > 0(这个动作是好的),希望提高这个动作的概率,此时原始项为 rA,r 越大,loss 越大,但太大更新策略会太快,容易训练不稳定,因此需要 clip 限制在 1+ϵ 中
- 当 A < 0(这个动作是坏的),希望降低这个动作的概率,此时原始项为 rA,r 越小,loss 越大,更新策略会越快,容易训练不稳定,因此需要 clip 限制在 1-ϵ 中
- 通过 min 取更保守的更新,PPO 能够在不需要复杂二阶优化的前提下,近似实现 TRPO 的单调提升效果
-
KL 惩罚的作用?为什么不是 L2 正则,而是 KL 散度?
- 限制更新后 Actor 策略 与基准参考策略 的分布偏移,防止大步更新模型坍塌、生成无意义文本、偏离人类语言分布
- 实现隐式约束,保证策略优化单调提升,稳定训练
- PPO 中把 KL 惩罚加入到奖励中,来压制奖励过拟合问题
- KL 与 L2 的不同
- L2 是参数空间的欧氏距离,衡量模型权重数值差异
- KL 是概率分布空间差异,强化学习 / 生成模型关心的是动作 /token 采样分布,不是参数本身;参数微小变化可能导致概率分布剧烈剧变,L2 无法表征
- 在 LLM 训练中,更关心的是生成分布是否变化过大,而不是权重变化是否变化过大,因为权重分布和生成分布之间的关系是非线性的,一个很小的参数变化也可能会导致生成分布的剧烈变化
-
KL 散度的计算公式
-
对于两个离散概率分布 :
-
在 LLM 逐 token 场景中
- P:当前 Actor 策略
- Q:冻结参考模型
-
性质:恒 ≥0;等于 0 当且仅当两分布完全一致
-
直觉是:如果新模型在某些 token 上给了远高于 reference 的概率,那么这个比值就会变大,从而产生惩罚,从而使得模型不要过度自信地偏离原来的语言习惯
-
-
PPO 里用的是哪种 KL 散度?forward KL vs reverse KL 有什么区别?
- forward KL():约束当前策略贴近基线 SFT 模型,防止生成异常 token,RLHF 默认正向 KL
- reverse KL():P 会 “压缩” 匹配 Q,倾向模态坍缩、单一输出,容易 collapse 到高概率的区域
- RLHF 中通常使用 forward KL,因为我们更希望模型 “不要漏掉合理表达”,而不是 “只输出一种最安全答案”
-
KL 散度的系数 β 太大 / 太小会发生什么?
- KL 权重太大意味着模型几乎不更新,reward 提升非常有限,相当于 RL 没起作用
- 而 KL 权重太小则意味着模型严重偏离 reference,这通常表现为生成质量下降、语言变得奇怪甚至出现 reward hacking,本质是模型在 “钻 reward 的漏洞”
- 这是一个 exploration 和 stability 的平衡问题:KL 权重太大限制探索,KL 权重太小破坏稳定
-
自适应 KL 惩罚(动态调整 β)的原理是什么?
- 让真实平均 KL 维持在目标值 (LLM 常用 0.01~0.05),避免固定 β 太僵
- 控制逻辑:
- 每迭代统计当前真实 ,与目标 比较
- 若 :说明偏移过大,增大 β,加强 KL 惩罚,限制更新
- 若 :说明约束过强更新不足,减小 β,放松限制,让模型继续学奖励
- 通常乘系数(如 1.5)、除系数(如 0.8)阶梯式平滑调节,防止 β 剧烈抖动
- 作用:兼顾训练稳定性与对齐收益,解决固定 KL 权重一刀切问题
-
PPO 的两种实现方式(PPO-Clip vs PPO-Penalty)的原理、区别、适用场景?
- PPO-Penalty
- PPO-Penalty 近似地解决了类似于于 TRPO 的 KL 约束更新,但是不是将 KL 散度作为一个硬约束,而是作为一个惩罚函数加在优化函数上,并在训练过程中自动调整惩罚系数,以便对其进行适当的缩放
- 使用多轮小批量随机梯度下降(minibatch SGD),优化 KL 惩罚目标函数
- PPO-Clip
- 无显式 KL 项,通过截断概率比硬限制单步更新,工程最简、无需调 KL 系数
- 两者本质都是限制新旧策略更新幅度,避免大步更新崩坏,而 Clip 是样本层面的硬截断,KL-Penalty 是分布层面的软约束
- 在 RLHF 中,两者通常是同时使用的:clipping 保证每一步更新稳定,KL penalty 保证整体分布不漂移太远
- PPO-Penalty
-
PPO-Clip 的裁剪系数 一般取多少?调大 / 调小分别会有什么问题?
- 标准取值:(绝大多数离线 / 在线 PPO、LLM RLHF 基线标配)
- 调大 (如 0.3、0.5)裁剪区间变宽,策略更新约束变松;单步更新幅度大、训练提速、探索变强,更容易大步偏离旧策略、分布漂移、训练震荡、梯度爆炸、模型坍缩 / 崩坏
- 调小 (如 0.1、0.05)更新更保守、训练更稳、方差更低,参数更新极慢、收敛慢、欠优化,无法有效利用奖励信号做偏好提升
-
Value Model 的作用?一般在 RLHF 中需要额外维护一个模型副本吗?还是只用训练 value head?
- Value Model 用来估计状态价值函数,估计未来累积的折扣奖励
- Value Model 提供了一个 baseline 计算优势函数,以区分 “好动作 / 坏动作”,指导 Actor 梯度更新;同时降低了梯度的方差,稳定策略梯度
- Value Model 具有一定的奖励归因作用,能够补偿长序列生成时的远程稀疏奖励
- 主流设计上一般不会维护独立完整的 Transformer 副本,而是复用 Actor 的模型主干,冻结或共享底层,仅额外新增训练 value head 线性投影层
-
Value Model 的损失函数是什么?
- 在 PPO 里,Value Model 学的是:给定一个 state(在 LLM 里就是当前 prefix),预测未来能拿到的期望 reward
- target 是什么?target 不是 reward 本身,而是 return(累计回报):
-
在 LLM 里通常 reward 是 sequence-level(比如 RM 给整句打分),所以常见做法是所有 token 共享同一个 reward(或者做简单分配)
-
Value Loss 也就是一个标准的 MSE loss
-
类似 policy clipping,value 也会 clip:
-
最终 loss:
-
如果没有 Value Model 会怎样?
- 只能用蒙特卡洛(MC)真实轨迹回报计算优势,方差爆炸、训练剧烈震荡
- 无法做时序差分 TD、无法用 GAE,稀疏长程奖励学习几乎不收敛
- 无法估计状态基线,策略梯度噪声极大,容易梯度爆炸 / 消失
-
相比 TRPO,PPO 为什么能用一批 rollout 重复更新多次?
- TRPO 依赖全局约束整个策略分布(KL),必须保证整体分布变化很小,所以不能多次更新
- PPO 不依赖严格的重要性采样理论,而是用 clip 暴力裁剪
- 虽然同一批数据反复用几轮, 慢慢偏离 ,但是通过 clip 能够避免危险的梯度,能够用安全的小步长更新策略
-
PPO 为什么不能像 DQN 一样无限复用历史数据?
- DQN 学的是 动作价值 ,只要是 经验,不管来自哪个策略,都能用来拟合 Bellman 方程,它不关心动作是谁选的,只关心这个动作的价值
- PPO 的核心是重要性采样比,成立的前提是旧策略 与新策略 不能差太远,否则这个概率比会很大 / 很小,从而使得梯度方差很大,训练不稳定
- 同时,PPO 的整个优化目标建立在新旧策略分布近似上,一旦偏移过大,clip 也无法有效约束,梯度不稳定
-
为什么 PPO 要用新旧策略重要性采样?离线策略和在线策略 PPO 区别?
-
原始策略梯度:
-
on-policy 要求样本必须来自当前最新 ,用完即弃,样本效率极低
-
用旧策略 采轨迹,通过重要性比率修正分布差异:
-
用旧轨迹训练新策略,复用样本、提升效率,是 PPO 的核心基石
-
On-policy:每轮用当前 policy 采样 rollout,采样后固定 ,多 epoch 更新,更新完毕丢弃轨迹
-
Off-policy:引入 replay buffer,混合旧批次历史轨迹训练,样本利用率高,但是分布偏移严重,训练不稳定
-
-
在线 PPO 为什么一个 batch 要迭代多次 epoch?会不会引入偏差?
- 为什么多 epoch 迭代
- rollout 采样成本高(尤其 LLM 生成),单次采样多次梯度更新,提升样本利用率
- 用小 batch mini-batch 迭代,降低单次显存开销、平滑梯度
- 最大化优势函数拟合,充分优化 actor/critic
- 会不会引入偏差
- 会引入轻微偏差,但是可控的,因为多次迭代后, 不断变化,和采样时的 分布差距变大,重要性比率偏离真实分布,产生分布漂移偏差
- PPO 通过两项约束压制:clip 截断限制比率范围、固定 不参与梯度更新
- 工程上一般 epoch 取 3~10,平衡效率与偏差
- 为什么多 epoch 迭代
-
PPO 里优势函数 Advantage 如何计算?为什么不用原始 Q 值?
-
标准 GAE 计算
-
先定义一步 TD 误差:
-
GAE 加权累积:
-
-
为什么不用原始 Q 值
- Q (s,a) 真实回报方差极大(MC 采样),梯度噪声爆炸
- 优势 A=Q−V,减去状态基线 V,消除状态固有价值,只保留 “动作相对好坏”
- 剥离全局收益,让梯度更聚焦当前动作增量,降低方差、稳定更新
- Q 依赖远期累积 reward,稀疏场景难以学习,GAE 做了折扣平滑
-
-
Actor 和 Critic 是否共享 backbone?共享和不共享的优劣?
- 主流做法一般是共享 backbone,额外训练 value head
- 缺点是梯度互相干扰,actor 更新影响 critic 表征
-
PPO 有什么缺点?
- 仍然是 On-policy 算法,样本效率极低
- 超参数敏感,很难调整
- 容易发生奖励坍塌 / 奖励黑客
- 优势函数估计本身方差大,训练不稳定
- PPO 的信赖域思想本质是保守更新,探索能力弱,容易卡在中等水平不再提升
-
PPO 训练中为什么会出现模型坍缩、奖励过拟合?如何缓解?
- 模型坍缩:KL 约束太弱,每一步更新步长过大,导致 policy 严重偏离参考模型
- 奖励过拟合:RM 本身有偏见 / 噪声,没有进行强的 KL 分布约束
- 缓解方式
- 自适应动态调整 KL 惩罚的 参数
- 合理 clip 、限制更新幅度
-
在 PPO 算法中,PPO 是如何平衡探索和利用的?
- 利用
- 通过 clip 使得策略向更优的动作更新幅度更大,但也不会过于大
- 用同一批旧轨迹数据多次更新策略,既充分利用样本(提升利用效率),又通过旧策略的约束避免更新跑偏,平衡探索
- 探索
- 通过 clip 限制策略的更新幅度,防止策略过度拟合旧轨迹,保留对其他动作的探索空间
- 通过加入熵正则化,鼓励策略保持随机性,避免过早收敛到局部最优,主动提升探索性
- 利用
SAC
-
介绍一下 SAC(Soft Actor-Critic)
-
off-policy 的 actor-critic 算法,最大熵强化学习,当前连续控制样本效率最高的主流算法之一
-
在最大化回报的同时最大化策略熵,鼓励探索:
-
包含一个 actor 策略网络,两个 critic Q1 和 Q2
-
使用双 Q 网络缓解过估计,自动调整温度系数,完全 off-policy,可以复用经验
-
样本效率极高、探索强、连续控制超强,但是比 PPO 更难调参、训练略不稳定
-
更适合高维连续控制、机器人、仿真环境、样本昂贵场景
-
-
为什么要使用两个 Critic 网络?
-
熵是怎么设置的?
- 鼓励策略保持随机性,提升探索能力,避免过早收敛到局部最优
- 让策略在保证奖励的同时,尽可能覆盖更多动作,提升鲁棒性
- 温度系数 是熵的权重, 越大,探索性越强; 越小,越偏向利用
-
熵的两种实现方法
- 固定温度系数,手动调整,无法自适应不同任务,泛化性较差
- 动态调整温度系数
-
约束策略的最小熵,让熵保持在目标值附近,动态调整
-
目标约束:,其中 是目标熵(通常设为动作维度的经验值,如连续动作空间取 )
-
目标函数:
-
对 求梯度,用 Adam 优化,自动更新
-
SPIN
MBRL
- MBRL(Model-Based Reinforcement Learning)是显式学习环境动力学模型的 RL 范式,与无模型 RL(Model-Free RL,如 PPO、SAC)相对
- 无模型 RL:把环境当黑盒,直接从真实交互数据学策略 / 价值
- MBRL:先学环境模型 和 ,再用模型做规划 / 模拟来优化策略
- 基本流程
- 模型学习(Model Learning)
- 用真实交互数据 训练动力学模型(通常是神经网络)
- 目标:最小化模型预测与真实转移的误差
- 规划 / 模拟(Planning / Simulation)
- 用训练好的模型生成大量虚拟轨迹(无需真实交互)
- 用模型做前向搜索(如 MPC、CEM、树搜索)找最优动作
- 策略优化(Policy Optimization)
- 用真实 + 虚拟数据训练策略 / 价值网络(可结合无模型算法,如 SAC、TD3)
- 真实交互(Real Interaction)
- 用当前策略与真实环境交互,收集新数据,更新模型与策略
- 模型学习(Model Learning)
- 核心优势
- 样本效率极高:少量真实交互 → 模型生成海量虚拟数据 → 大幅减少真实环境交互成本(机器人、自动驾驶等场景关键)
- 可规划、可解释:模型可用于前向推理、长 horizon 规划
- 数据复用强:离线数据也可用于模型学习与策略优化
- 核心挑战
- 模型偏差(Model Bias):模型不完美 → 模拟数据有误差 → 长期规划误差累积(复合误差)
- 模型复杂度:高维连续 / 离散环境建模难度大
- 计算开销:在线规划(如 MPC)计算量大
- 经典 MBRL 算法
- PETS:概率集成模型 + 交叉熵方法(CEM)规划
- MBPO:模型生成数据 + 无模型离线算法(SAC)训练,平衡模型与无模型优势
- DreamerV2/V3:世界模型 + 策略 / 价值端到端学习,在连续控制表现极强
- Dyna:经典架构,真实交互 + 模型模拟双轨更新
直接偏好优化
DPO
-
DPO 的算法原理和推导过程
-
DPO(Direct Preference Optimization,直接偏好优化)是单阶段、无强化学习、无显式奖励模型的大模型对齐算法
-
核心是:将 RLHF 带 KL 约束的奖励最大化目标,通过数学变换,转化为直接在偏好数据 上优化策略概率比的分类问题,全程仅需策略模型 与参考模型 ,无需训练 Value Model、Reward Model,也无需在线 Rollout
-
原始的 RLHF 目标
-
其闭式最优策略为
-
:配分函数,保证概率和为 1
-
对最优策略取对数并整理,奖励 可由策略与参考模型的对数比表示
-
奖励被隐式编码在策略相对参考模型的概率偏移中,无需独立训练 Reward Model
-
人类偏好用 Bradley-Terry 模型建模:
-
将奖励模型的公式代入,并消去配分函数,得到仅含 与 的损失
-
本质是二元交叉熵损失,目标是让优选响应的 “策略 / 参考” 对数比,显著大于非优选响应
-
-
DPO 为什么不需要 Value Model?为什么不需要 rollout?为什么不需要 reward model?
- 为什么不需要 Value Model
- DPO 没有强化学习的策略梯度、优势函数、时序差分环节,全程是监督式概率匹配
- PPO 在优化的是 ,但 reward 是随机变量,且每个 sample 都是有噪声的,因此 PPO 用 Value Model 计算优势 A=Q-V 来降低方差,而 DPO 直接用偏好数据的相对概率比作为优化信号,无需估计状态价值 V 或动作价值 Q
- DPO 把一个 “高方差的回报优化问题”,转化成了一个 “低方差的对比学习问题”,因此不再需要 Value Model
- 为什么不需要 rollout
- DPO 是纯离线算法,全程使用固定的人类偏好数据集 训练,因此不需要进行在线 rollout
- PPO 需在线 Rollout 生成轨迹、计算奖励与优势;DPO 直接用已标注的优选 / 非优选对作为训练样本,无需模型生成新数据
- 为什么不需要 reward model
- DPO 通过数学变换,将奖励函数隐式嵌入策略与参考模型的概率比中
- RLHF 需先训练 Reward Model 拟合人类偏好,再用 PPO 最大化奖励;DPO 直接用偏好数据的相对概率作为优化目标,奖励由 隐式给出
- 为什么不需要 Value Model
-
DPO 的参考模型(Ref Model)为什么必须冻结?解冻会发生什么?
- DPO 所有推导依赖: 是固定基准分布,用来定义相对对数比、隐式 KL、隐式奖励
- 一旦 更新,基准漂移,前述等价数学关系全部失效
- DPO 的正则来自固定 ref 的相对熵;ref 解冻一起训练,无法稳定约束更新幅度,出现分布塌缩
-
DPO 的温度系数 作用是什么? 过大 / 过小的影响?
- 等价原生 RLHF 里 KL 正则强度倒数,控制策略偏离参考模型的最大幅度
- 越大:模型更努力去区分 chosen /rejected,但是更容易过拟合偏好数据
- 越小:更贴近 SFT 模型,保留推理、知识、通用能力
- 常见默认:0.1 或 0.2
- 想对齐更强:调大到 0.3~0.5
- 想更稳、保留能力:调小到 0.05~0.1
-
DPO 为什么相比 PPO 更省显存、训练更快?
- DPO 不需要任何强化学习组件
- PPO-RLHF 维护:SFT-ref + Actor + Critic + Reward Model;
- DPO 仅维护:训练 Actor + 冻结 SFT-ref,无 Critic、无 RM、无 GAE、无 Advantage
- DPO 无需 online rollout 生成
- DPO 的计算图简单,仅做 token-level logprob 比对 + sigmoid 交叉熵,无复杂 RL 累积、折扣、方差消减
- DPO 不需要任何强化学习组件
-
为什么 DPO 不需要显式奖励,还能拟合偏好数据?
- 通过将最优奖励函数用策略进行表示,真实标量 被消去,但优劣样本之间的奖励差被保留在概率比中
- 冻结 SFT ref 提供通用语言基准,训练 拉大优质答案相对概率、压低劣质答案,等价于隐式最大化偏好奖励
- DPO 是隐式 Reward 的成对极大似然排序,用相对概率替代显式打分
-
离线 DPO 和在线 DPO 的区别?大模型对齐一般用哪种?
- 离线 DPO:训练数据是固定的静态人类偏好数据集,不实时生成,训练稳定但是无法探索新生成
- 在线 DPO:实时用当前模型 rollout 生成回答,自动构造优劣对自我提升,训练不稳定
-
DPO 有什么问题?
- 长度偏见:DPO 用序列级 KL 对数比优化,长序列天然有更高的对数和,模型倾向生成更长文本以提升概率比,导致冗余、啰嗦
- 偏好数据过拟合:DPO 直接拟合偏好对,无奖励模型的泛化能力,对标注噪声、错误偏好极度敏感,模型可能只会记住偏好数据的表面模式
- 优选响应退化(DCR 问题):降低非优选响应 的概率,比提升优选响应 的概率更容易(只需抑制任意 token),模型倾向打压 而非提升 ,从而导致 的生成质量不升反降,模型更关注避免坏输出,而非生成好输出
- 对参考模型强依赖:DPO 损失完全依赖 的比值,参考模型质量差、初始化不当,会导致优化方向错误
- 无法处理复杂偏好与多目标:仅支持二元成对偏好,无法建模偏好强度、列表式排序、多维度奖励
- exploration 能力弱,因为完全是 offline learning,不会生成新策略再学习
-
DPO 的损失函数中存在什么潜在问题?
- 错误指定估计
- DPO 假设奖励可表示为策略与参考的对数比,但真实 LLM 参数化能力有限,无法覆盖所有奖励流形,导致投影偏差
- 训练集表现好但 OOD 泛化差,奖励与偏好不匹配
- 过拟合与标签噪声
- 训练 loss 极低但测试集效果很差,对误标样本强更新
- 偏好数据质量差、标注不一致,DPO 对硬标签敏感,易过度拟合噪声
- 优选响应退化(DCR 问题)
- 降低非优选响应 的概率,比提升优选响应 的概率更容易(只需抑制任意 token),模型倾向 “打压 ” 而非 “提升 ”
- 从而导致 的生成质量不升反降,模型更关注避免坏输出,而非生成好输出
- 长度偏见
- DPO 用序列级 KL 对数比优化,长序列天然有更高的对数和,模型倾向生成更长文本以提升概率比,导致冗余、啰嗦
- 正则化效果差
- 错误指定估计
-
DPO 训练中出现偏好遗忘、退化的原因和解决方案?
ODPO
-
ODPO(DPO with an offset)
-
DPO 的损失基于 Bradley-Terry 模型对偏好进行建模,该模型仅能建模「一个回答比另一个好的概率」,无法建模偏好的程度:
- 它只利用了「」的排序信息,忽略了「 比 好多少」的具体分数信息
- 对于「轻微偏好」和「强烈偏好」的样本,DPO 会一视同仁地优化,无法针对性地加大惩罚力度
-
ODPO(DPO with an Offset,带偏移的直接偏好优化)是 DPO 的泛化版本,核心是在偏好建模中引入「偏移量(offset)」,让模型不仅要保证 的奖励高于 ,还要保证差距大于指定的 offset,从而利用偏好的程度信息
-
步骤 1:Gumbel 噪声建模
-
给估计奖励加上 Gumbel 噪声,得到带噪声的奖励:
-
论文证明了:
-
其中 为偏移量
-
-
步骤 2:ODPO 损失函数
-
基于上述结论,ODPO 的损失为:
-
当 时,ODPO 损失等价于 DPO 损失,因此 DPO 是 ODPO 的特例
-
该损失要求: 的估计奖励必须比 大至少 ,否则会被惩罚
-
-
步骤 3:Offset 的定义
-
偏移量 是两个回答真实奖励差的递增缩放函数:
- :超参,控制偏移的整体强度
- :单调递增函数(如恒等函数、sigmoid 等)
- :人类标注的真实分数(如 RLHF 中的奖励模型分数、人工评分)
-
-
优势
- 充分利用偏好数据:挖掘了「偏好程度」的信息,而非仅用排序,提升数据利用率
- 针对性惩罚:对「强烈偏好」的样本(如 远优于 ),设置更大的 offset,加大模型的优化力度;对「轻微偏好」的样本,设置较小的 offset,避免过度优化
- 理论兼容:基于 Gumbel 分布的严格推导,保持了 DPO 无需显式奖励模型、直接优化策略的优势
- 工程友好:仅在 DPO 损失中增加 offset 项,无需修改训练流程,易实现
-
ODPO 的思想和 softmax margin loss /marginal loss 高度相似:
- 都是在原损失基础上增加 margin(offset),加大对「奖励差距小」样本的惩罚
- 核心目标都是让正负样本的差距超过阈值,提升模型的区分度
SimPO
-
相比 DPO,SimPO 不需要 reference model,并且有更好的效果;SimPO 的另一个好处是能够保持生成结果在较短长度下的质量
-
DPO 的局限
-
依赖参考模型(Reference Model):需要额外保存 SFT 后的参考模型,增加内存与计算开销
-
训练 - 推理目标不对齐:
-
推理时,模型的目标是最大化平均对数似然:
-
DPO 的奖励中包含参考模型,导致 并不等价于
-
统计显示,DPO 中训练奖励与推理指标的对齐比例仅约 50%,大量样本出现训练与推理目标矛盾的情况
-
-
训练时,DPO 优化的是「相对参考模型的相对优势」,推理时,模型实际优化的是「自身的绝对概率」
-
原始 SFT 模型很难生成 pair 数据中的 chosen 数据,相比来说,更容易生成 rejected
-
chosen 往往来自更强的模型,原模型对它的初始概率很低,rejected 是原模型自己生成的 bad case,初始概率很高,导致 DPO 的优化方向和推理目标产生了偏差
-
-
SimPO(Simple Preference Optimization)针对 DPO 的两大缺陷,做了两个关键改进:
- 移除参考模型:直接用模型自身的对数似然计算奖励,彻底摆脱对参考模型的依赖
- 对齐训练 - 推理目标:引入长度归一化,让训练奖励与推理时的平均对数似然完全对齐
- 引入奖励 Margin:类似 ODPO/IPO,要求偏好回答与非偏好回答的奖励差距大于固定阈值 ,提升泛化能力
-
SimPO 奖励函数
- :长度归一化项,避免模型倾向于生成更长但质量低的回答
- :温度超参,控制优化强度
-
SimPO 损失函数
- :奖励 Margin 超参,要求 的奖励比 大至少 ,提升模型区分度
- 当 且移除长度归一化时,SimPO 退化为无参考模型的 DPO 变体
-
SimPO 通过奖励设计,完全保证了训练奖励的排序与推理平均对数似然的排序一致,彻底解决了 DPO 的目标不对齐问题
-
SimPO 梯度:
-
DPO 梯度:
-
其中:
-
梯度权重:
- SimPO 的权重 不依赖参考模型,当模型给非偏好回答更高奖励时,权重会自动变大,加强对错误样本的修正力度
- DPO 的权重 依赖参考模型,无法动态调整修正力度
-
长度归一化:
- SimPO 的梯度自带长度归一化,彻底解决了 DPO 中长文本梯度主导训练、模型倾向生成长文本的问题
- DPO 的梯度无长度归一化,长 token 序列的梯度值更大,会主导训练过程
-
SimPO 存在的问题
- 隐式 KL 惩罚消失,模型极易发生 “分布漂移”
- 极易出现严重的 Reward Hacking,SimPO 只是最大化 chosen 的生成概率,不管内容是否合理
- 对数据质量极度敏感,小数据集上极易过拟合
-
Simpo 中没有 KL 散度约束,通过降低 lr 进行简单约束模型偏差
IPO
-
DPO 的缺点
- 过拟合偏好数据:偏好数据有限 / 有噪声时,模型会过度放大偏好权重,导致通用能力退化(数学、代码、事实性下降)
- 置信度过高(over-confident):Sigmoid 会将偏好对数几率推向 ,模型对偏好对的预测概率趋近 1/0,输出多样性大幅下降(Distinct-n 指标暴跌)
-
ΨPO 是一个统一框架,将 RLHF、DPO 都纳入其中,而 IPO(Identity Preference Optimization) 是 ΨPO 框架下针对 DPO 缺陷提出的改进算法
-
ΨPO 目标函数
-
设 为任意非递减函数,ΨPO 的优化目标为:
- :人类偏好的「优胜」回答,:被淘汰的「劣势」回答
- :模型认为 优于 的概率
- :参考策略(通常是 SFT 后的初始模型)
- :KL 散度正则项系数,控制与参考模型的偏离程度
-
-
与 RLHF、DPO 的等价性
-
当选择 ,并使用 Bradley-Terry 模型 建模偏好(, 为奖励函数)时:
-
除常数项外,该目标与 RLHF 完全一致;而 DPO 已被证明等价于 RLHF,因此 RLHF、DPO 都是 ΨPO 的特例,三者最优策略相同 ΨPO 最优策略的解析解为:
-
-
DPO 的核心缺陷:弱正则化与过拟合
-
DPO 继承了 ΨPO 中 的非线性变换,这会导致严重的正则化失效
-
若 绝对优于 (即 ),根据 Bradley-Terry 模型,需要奖励差 ;
-
将该条件代入最优策略,可得:
-
即无论 取何值,,模型会完全禁止 生成
-
结论:偏好越确定,KL 正则化效果越弱,有限数据下极易过拟合到训练集偏好,泛化能力差
-
-
IPO:解决 DPO 缺陷的改进算法
-
用恒等映射替代非线性 Ψ
-
DPO 的弱正则化根源是 的非线性,IPO 直接选择恒等映射 ,保留 KL 正则化的有效性
-
此时 ΨPO 目标简化为:
-
-
最优策略与损失函数推导
-
令 (恒等映射下),最优策略仍满足:
-
对任意 ,有:
-
定义 ,则目标等价于最小化损失:
-
其中 为指示函数: 优于 时取 1,否则取 0
-
-
完整 IPO 算法流程
-
给定偏好数据集 (满足 )和参考策略
-
定义偏好对数比:
-
初始化与优化,从 开始,最小化损失函数:
-
最终损失中 是恒等映射下的简化形式,等价于指示函数 时的目标
-
-
ORPO
-
ORPO(Odds Ratio Preference Optimization,优势比偏好优化)是 2024 年提出的大模型对齐算法,核心是把 SFT + 偏好对齐 合并为一步,不需要参考模型
-
核心思想是在 SFT 目标上,加入一个 odds ratio 对比项,让模型在学习 “好回答” 的同时,主动拉开与 “坏回答” 的概率差距
-
目标函数:
-
:标准监督微调损失(最大化好回答 的似然)
-
:优势比损失,对比好 / 坏回答的对数几率比
-
:偏好对齐强度超参
-
-
ORPO 以 “单阶段训练” 的计算效率,换取了 “必须大量昂贵偏好配对数据” 的代价,在数据稀缺场景完全不如 SFT+DPO
KTO
- KTO (Kernel Tuned Optimization / Kahneman-Tversky Optimization)
- 不需要严格成对 (yw,yl),支持单样本标注(好 / 坏二分类),数据利用率暴涨
- 引入独立基线正则,分离 “有用性” 和 “拒绝退化” 约束
- 修正 DPO 固有的长度偏置、梯度不对称
- 减轻对冻结 ref 的强依赖,训练更稳、低资源场景更强
总结
-
统一符号约定
- (策略相对参考模型,chosen 与 rejected 的对数概率差)
- (好回答),(差回答)
-
DPO(Direct Preference Optimization)
-
IPO(Identity Preference Optimization)
-
KTO(Kahneman-Tversky Optimization / Odds Ratio Preference Optimization)
-
SimPO(Simple Preference Optimization)
-
ODPO (Direct Preference Optimization with an Offset)
-
Reference-Free Alignment(无参考模型对齐)
- 完全去掉 ,只用当前模型 做对齐,不再和 “参考模型” 比,只在 自身输出之间比偏好
- 代表:SimPO、ORPO、KTO(变种)、IPO、REFA
- 核心思想:偏好学习本质是相对排序 比 好,不需要知道 “标准答案 / 参考”,只要模型自己更偏好 即可
-
去掉 Reference Model 会有什么问题?
- 知识遗忘 / 能力退化:KL 约束保留 SFT 知识,去掉可能会导致灾难性遗忘
组内相对优势
GRPO
-
介绍一下 GRPO
- 摒弃 PPO 的价值模型(Critic),对同一 prompt 采样一组输出(Group,通常 4–32 个)
- 用组内奖励的相对统计量(均值 / 标准差) 直接构造优势函数,结合 PPO-Clip 与 KL 约束更新策略,全程仅需策略模型(Actor)+ 冻结参考模型(Ref)
-
GRPO 的算法流程
-
群组采样:对每个 prompt ,用旧策略 采样 G 个输出序列
-
奖励打分:用奖励模型(RM)或自动规则计算每个序列的标量奖励
-
组内归一化(优势计算):
-
用组均值替代价值模型的基线 ,组标准差做归一化,消除奖励尺度影响
-
GRPO 目标函数
-
KL 散度的无偏估计
-
优势函数
-
最核心的改进是
- 无需价值模型
- 依赖组相对优势而非绝对奖励,对奖励模型噪声、尺度漂移鲁棒性更强
- 直接 KL 约束:显式正则化策略与参考模型的距离,比 PPO 更可控
-
-
GRPO 为什么不需要 Value Model?为什么比 PPO 更稳定?
-
PPO 中 Critic(Value Model)用于估计状态价值 V (s),将绝对奖励 r 转化为优势:
-
目的是减去基线、降低梯度方差,避免奖励尺度干扰策略更新
-
而 GRPO 用同一 prompt 下的组奖励均值 直接替代 ,数学等价性:
- 同一 prompt 下,所有输出共享同一 “状态”,组均值是该状态下无偏的期望奖励估计(大数定律)
- 优势 直接实现 “去基线、降方差”,无需训练额外网络
- 组标准差归一化进一步消除奖励尺度影响,优势更稳定
-
优势估计更鲁棒(方差更低)
- PPO:优势依赖 Critic 对 的近似,Critic 偏差 / 噪声会直接传导至策略梯度
- GRPO:优势来自组内相对比较,对单样本噪声、RM 打分漂移、奖励尺度不敏感
- 组归一化()天然降低方差,梯度更平滑
-
策略更新更可控
- 保留 PPO-Clip 限制概率比 ,同时显式加入 KL 惩罚,双重约束策略更新幅度
- 组内更新是 “局部对比”,比 PPO 的全局优势更保守,不易出现策略崩塌
-
-
GRPO 为什么把 kl 作为损失的一部分?
- 规避组归一化 (Group Normalization) 对正则化的破坏、保证训练稳定、防止 Reward Hacking
- Clip 约束单步,KL 散度约束分布
-
GRPO 与 PPO 中优势函数的区别
- PPO 中每个 token 的优势不同,通过广义优势估计(GAE)计算,依赖 Critic 的 预测,优势值受 Critic 质量影响较大
- GRPO 中同一响应的所有 token 共享同一优势值 ,优势来自组内相对比较,独立于 Critic,对奖励噪声、尺度漂移更鲁棒
-
GRPO 存在什么问题
- 组大小敏感(样本偏差)
- 组 G 过小(如 G=2)
- 组内差异小,相对奖励(优势函数)噪声极大
- 容易把偶然好的样本过度强化,训练震荡、不稳定
- 学到的偏好很片面,泛化差
- 组 G 过大
- 显存 / 采样成本飙升,工程不可行
- 训练变慢,每步前向次数翻倍
- 收益边际递减:从 8→16 提升有限
- 工程折中:G 通常取 4–8,RM 噪声大时升至 10–12
- 组 G 过小(如 G=2)
- 奖励信号塌陷
- GRPO 先求和再组内归一化,把绝对质量差异压缩成纯相对排名,导致「部分对」和「完全对」训练信号完全一样,这就是奖励塌陷
- 这在多目标维度奖励中尤为严重,如结果奖励和格式奖励同时存在时,模型很难区分「完全对」和「部分对」,导致训练停滞
- 信号坍缩(梯度消失)
- 当组内奖励全同(如简单题全对、难题全错),,优势 变为 0/NaN,梯度消失
- 模型能力提升后,零优势组比例攀升,导致训练停滞、学习率误降
- 问题难度级别偏差
- GRPO 采用问题级(prompt 级)归一化计算优势:对同一个 prompt 生成的 G 个响应,单独做均值 - 标准差归一化,这会导致不同难度的问题,在目标函数中的权重完全不同
- 简单 / 极难问题:奖励几乎全为 1(全对)或 0(全错),标准差 std 极低 → 归一化后,优势值被大幅放大,在梯度更新中被赋予极高权重
- 中等难度问题:奖励分布分散,标准差 std 较高 → 归一化后,优势值被压缩,在梯度更新中权重极低
- 模型会过度拟合简单 / 极难问题,而忽略中等难度的核心训练样本
- 训练分布严重失衡,模型泛化能力下降,在真实场景中表现不稳定
- 响应级别长度偏差
- GRPO 做了两个看似无害的操作,却埋下了致命的长度偏差:
- 优势 是序列级的:基于完整响应的奖励 计算,同一响应的所有 token 共享同一个优势值
- 损失做了 token 级平均:,把序列级优势摊到每个 token 上
- 对于高优势(正确)响应:短响应的 token 数量少,每个 token 分到的梯度更新更强;长响应的 token 多,梯度被摊薄,更新更弱 → 模型会优先选择更简洁的短答案,哪怕长答案逻辑更完整
- 对于低优势(错误)响应:短响应的每个 token 惩罚力度更大,模型会快速抑制短错误答案;长响应的梯度被摊薄,惩罚力度不足,模型难以抑制长错误答案 → 最终导致:正确答案越来越短,错误答案越来越长,严重影响生成质量
- 乍一看, 做了平均,长短响应的总梯度贡献一致,似乎公平,但核心矛盾在于:优势是序列级的,不是 token 级的,长短响应的优势值是同一量级,但短响应的 token 少,单位 token 的梯度权重远高于长响应,最终导致策略向短答案倾斜
- 序列级奖励与长度正相关,长序列更易获得高 ,模型倾向生成冗长、冗余文本
- 本质:GRPO 未对长度做归一化,组内相对优势天然鼓励长输出,而经过标准差归一化之后,优势分布更加扭曲,进一步偏袒长样本
- GRPO 做了两个看似无害的操作,却埋下了致命的长度偏差:
- 组大小敏感(样本偏差)
-
GRPO 训练超参(组数、采样数)如何调优?
- 主要超参数是组大小,通用最优基线:8(对话) / 12~16(数学推理)
- 标准差加极小平滑常数 1e−6,防止除零梯度消失
- 奖励全局 clip,压制极端离群值
- KL β:对话 0.1
0.3,数学 0.050.2(推理需要更大探索) - 过滤组内奖励方差接近 0 的全优 / 全劣样本,避免无效梯度
- 学习率小于 SFT,防止组对比下快速过拟合
-
在 GRPO 中,如果主动用质量更高、奖励更高的外部轨迹(traj),去替换本轮 rollout 生成的部分 / 全部数据,训练会发生什么?
- 短期加速、中期震荡、长期可能过拟合或策略坍塌
- 短期(前几轮):奖励暴涨、收敛极快、看起来很完美
- 中期(10~50 轮):训练震荡、梯度冲突、KL 暴涨 —— 数据分布不匹配 + 重要性权重失效
- 长期(>100 轮):过拟合强轨迹、策略坍塌、泛化暴跌
-
GRPO 为什么更适合 Agent?
- Agent 场景是长轨迹 + delayed reward,credit assignment 非常困难 + variance 极高
- PPO 依赖价值函数估计,并以此计算优势函数,但在 Agent 场景 state 是 “长上下文 + 工具状态”,分布非常复杂,value 很难学准,从而导致 advantage 噪声很大,训练极不稳定
- 而 GRPO 可以在同一任务的多条轨迹之间做相对比较,从而更好地进行 credit assignment
-
为什么 GRPO 更适合你这个场景?为什么不选择 PPO
- 我的场景是多步决策 + 工具调用 + 结果驱动优化,reward 主要来自最终任务结果,同时还包含效率指标(如 tool 调用次数)
- 考虑到 PPO 在这个场景下的难点
- Value Model 很难学:在我的系统中,state 包含多轮对话、工具调用结果以及中间推理信息,状态空间非常复杂;训练一个准确的 Value Model 成本高且不稳定,容易导致 advantage 估计误差,从而影响策略更新
- 训练成本高:PPO 需要同时训练 policy 和 Value Model,并且需要频繁 rollout,在多 Agent + 长轨迹场景下,rollout 成本本身就很高,再叠加 Value Model 的训练,会显著增加整体训练开销
- 延迟奖励下 variance 太大:reward 主要在任务结束时才给出,这使得 PPO 中基于 token-level 的 advantage 估计噪声很大,训练不稳定
-
GRPO 面对多目标奖励 / 多阶段奖励的弊端
- GRPO 先求和再组内归一化,把绝对质量差异压缩成纯相对排名,导致「部分对」和「完全对」训练信号完全一样,这就是奖励塌陷
- 相应地解决方案包括 GDPO:先对每一个奖励维度独立地进行归一化,然后再将这些归一化后的优势值相加
- 同时,如果简单地将多个维度的奖励加权求和,会导致奖励黑客问题
- 当不同任务的难度差异巨大时,单纯调整权重往往会失效
- 举例:数学推理任务中,「让回复变短(长度奖励)」通常比「做对难题(正确性奖励)」容易得多
- 后果:即使正确性奖励的权重 w_correct 设得很高,模型也可能倾向于生成极短但错误的回答,通过轻松获取长度奖励来稳定得分,而放弃更难的正确性目标
- 为解决难度不平衡导致的 Reward Hacking,可以引入条件奖励机制:简单任务的奖励,只有在困难任务达成时才发放
KL 散度的选择
-
KL 散度定义:
-
这里的 y 是整个词表上所有可能 token,所以理论上必须遍历全部词汇,但是对 LLM 来说词表通常 3w~30w+,直接全量计算极其昂贵
-
实际训练中采用 MC 估计
-
从当前策略 采样一批 token 序列 ,然后只在这些采样到的 token 上计算 KL 散度
-
只在这些采样到的 token 上计算
-
只有采样到的 token 有 权重,没采样到的 token 贡献近似为 0
-
计算量从 O (V) 降到 O (B),B 是 batch 大小
-
-
人类反馈强化学习(RLHF)可以建模为如下优化问题:
-
三种 KL 散度的估计
Dr.GRPO
-
Dr.GRPO (Distributionally Robust GRPO) 的主要改进是移除组内标准差除法与长度归一化,改用全局批次均值做基线
-
损失函数
-
优势函数修正为:
-
修正点
- 移除 token 级平均 ,彻底解决长度偏差
- 移除标准差归一化 ,消除了 GRPO 中 导致的梯度消失,同时标准差较低的问题,在策略更新时权重过高
- 虽然优势归一化是强化学习中常见的技巧,但通常是在整个批次中计算的;相比之下,问题级归一化会导致不同问题的目标权重变化,导致优化难度偏向
- 因此 Dr.GRPO 还用跨 prompt 的全局 batch 均值替代纯局部组均值,彻底解决难度偏差
DAPO
-
DAPO(Decoupled Clip and Dynamic sAmpling Policy Optimization) 是 2024 年提出的针对 GRPO 的改进算法,核心是引入 Token-Level Policy Gradient Loss 和非对称裁剪 Clip-Higher 设计,解决 GRPO 中的长度偏见和熵坍缩问题
-
在实际训练中,GRPO 往往因 clip 范围设置不合理、采样冗余以及长序列梯度被稀释等问题,导致大量训练信号被浪费
-
损失函数
-
熵坍缩
- 随着训练推进,策略的熵会快速下降:模型生成的回答逐渐同质化,某些群体的样本几乎完全一致;探索能力严重受限,策略过早进入确定性状态,阻碍模型规模扩展与性能提升
- 传统 PPO-Clip 采用对称裁剪,而上界裁剪会严重限制策略的探索性
- 高概率的 “利用型 token”(如 ):很容易被进一步放大(上限 0.9×1.2=1.08,甚至能到 0.999)
- 低概率的 “探索型 token”(如 ):概率提升空间被严格限制(上限仅 0.01×1.2=0.012),难以实现有效提升
- 实验验证:被裁剪的 token 平均概率极低(),上界裁剪直接限制了低概率探索 token 的概率增长,最终导致熵坍缩
- 对称 clip 天然打压低概率探索、偏袒高概率利用 → 策略越来越集中 → 熵崩溃
-
非对称裁剪 Clip-Higher 设计
- 解耦上下裁剪阈值,打破传统对称裁剪的限制
- 保留下界 (默认 ),抑制高概率 token 的过度利用,保证训练稳定性
- 放宽上界 (默认 ,如 0.28),为低概率探索 token 提供更大的提升空间
- 当 (需要提升概率):低概率探索 token 的概率比 可以突破传统 1.2 的限制,获得更大的更新幅度
- 当 (需要降低概率):下界保持不变,避免高概率 token 过度膨胀,维持训练稳定
- 解耦上下裁剪阈值,打破传统对称裁剪的限制
-
长度偏见
- GRPO 采用样本级(Sample-Level)损失聚合:先对每个样本内的 token 损失做平均,再对所有样本做等权重聚合,即每个样本在最终损失中权重完全相等,与长度无关
- 在长 CoT 场景下,长回答(token 数更多)中的 token,对总损失的贡献被严重稀释,引发两个负面效应:
- 高质量长样本学习受阻:长回答中的推理相关模式,因权重被摊薄,模型无法有效学习
- 低质量长样本失控:过长的回答常出现胡言乱语、重复等问题,但样本级损失无法有效惩罚这些模式 → 最终导致生成熵爆炸、回答长度失控
-
Token-Level Policy Gradient Loss
- 按 token 维度聚合损失,而非按样本维度,让长序列的 token 对梯度更新有更大的影响力,实现公平的 token 级权重分配
- 归一化项: 按总 token 数做全局归一化
- 聚合方式:直接对所有 token 的损失求和,而非先按样本平均
- 约束:保持等价样本约束,保证梯度多样性
-
梯度消失问题
- 在训练过程中,部分 Prompt(问题)的输出准确率迅速达到 1(完全正确)
- 例如某类 Prompt 的所有 G 个输出 都是完美的,这些样本获得的奖励相同,导致该组样本的优势值 变为 0
- 梯度消失:优势为 0,这部分样本对梯度更新没有贡献,等于被 “弃用”
- 有效样本减少:随着训练进行,准确率为 1 的样本数量越来越多,导致每批次中真正参与梯度更新的有效 Prompt 持续减少
- 训练退化:有效样本变少导致梯度方差增大,模型训练的信号变弱,效率大幅下降
-
动态采样(Dynamic Sampling)
-
主动采集更多样本,然后过滤掉准确率为 1(完美) 和 0(完全错误) 的样本,强制保证批次内的所有样本都是有效样本(拥有非 0 优势,能产生有效梯度)
-
采样阶段:在填充每个批次(Batch)时,持续采样,直到批次中包含的样本都是准确率既非 0 也非 1 的有效样本
-
成本控制:虽然增加了采样量,但如果系统未流水线化(Generation 阶段串行),生成时间主要被长尾样本(Long-tail samples)消耗,因此该策略不一定会降低训练效率
-
以上约束条件确保每个 Prompt 采样的回答集合 中,既要有与参考答案 a 等价的(有效正样本),也不能全是等价的(避免单一同质化),保证梯度的多样性
-
动态采样策略不仅解决了梯度递减问题,还实现了更快的训练收敛速度
-
通过增加有效样本的占比,保证梯度信号的强度,让模型在有限的步数内学到更多信息
-
-
截断样本的奖励噪声
- RL 训练中通常会设置最大生成长度,超过长度的样本会被截断,默认做法是给截断样本分配惩罚性奖励
- 致命缺陷:合理的长推理链会因长度超标被无差别惩罚,引入严重奖励噪声
- 模型对推理过程的有效性产生混淆:明明逻辑正确,却因太长被惩罚,从而导致训练过程被严重干扰,性能波动大,甚至出现熵爆炸
-
Overlong Reward Shaping
- 直接屏蔽截断样本的损失,不参与梯度更新,从源头消除奖励噪声
- 对超长截断样本:不计算损失、不更新梯度,这样仅用完整生成的样本训练,保证奖励信号纯净
-
Soft Overlong Punishment(软超长惩罚)
-
Overlong Filtering是硬过滤(直接屏蔽截断样本),但在实际场景中,我们既不想惩罚合理的长推理,又想避免模型无限生成超长回答,因此 DAPO 还提出了软惩罚方案,实现长度感知的梯度引导- :回答 y 的长度(token 数)
- :预设的最大生成长度
- :缓冲区间长度(可配置超参)
-
公式含义
长度区间 惩罚值 含义 0 正常长度,无惩罚 线性递减(0 → -1) 缓冲区间,长度越长,惩罚越大 −1 超长截断,最大惩罚
-
-
DAPO 的完整步骤
步骤 操作 对应改进 作用 1-2 从数据集 D 采样一个批次 - 初始化训练批次 3 更新旧策略模型 - 固定旧策略,用于重要性采样 4 对每个问题 q,用旧策略采样 G 个输出 - 生成候选回答 5 用奖励模型 R 计算每个输出的奖励 - 评估回答质量 6 过滤 ,将剩余样本加入动态采样 buffer Dynamic Sampling 过滤全对 / 全错样本,保证有效梯度 7-8 若 buffer 大小 ,继续采样 Dynamic Sampling 动态填充批次,直到满足样本数 9 对 buffer 中每个 ,计算每个 token 的优势 - 计算策略更新的核心信号 10-11 迭代 次,最大化 DAPO 目标函数更新 Clip-Higher + Token-Level Loss + Overlong Filtering 执行策略更新,融合所有改进 -
GRPO 更新公式逐 token 更新和 DAPO 的 batch 内更新有什么区别?为什么 DAPO 要按照 batch 设计?
GSPO
-
GSPO(Group Sequence Policy Optimization) 是 2024 年提出的针对 GRPO 的改进算法,核心是引入序列级重要性权重,彻底解决 GRPO 中 token 级重要性权重失效导致的模型坍缩问题
-
GRPO 中重要性采样的应用目标和奖励不匹配
-
随着模型规模、稀疏性(如混合专家模型)和响应长度的增长,强化学习训练中需要大的 rollout 批次来最大化硬件利用率
-
为提升样本效率,标准做法是将大的 rollout 数据批次划分为多个小批次进行梯度更新
-
这一过程不可避免地引入了 off-policy 学习场景:响应 y 由旧策略 πθold 采样生成,而非当前正在优化的策略 ,这也解释了 PPO 和 GRPO 中裁剪机制的必要性 —— 其作用是防止过度 “离策略” 的样本参与梯度估计
-
尽管裁剪等机制旨在管理这种离策略偏差,但作者在 GRPO 中发现了一个更根本的问题:其优化目标本身是病态的,在大模型长响应任务的训练中,该问题会变得尤为尖锐,最终导致灾难性的模型坍缩 ——GRPO 目标的病态性源于对重要性采样权重的错误应用
-
重要性采样的核心原理是:通过对从行为分布 中抽取的样本重新加权,来估计目标分布 下函数 f 的期望:
-
关键在于,该公式依赖于从行为分布 中采集大量样本(N≫1),才能让重要性权重 和 有效校正分布不匹配
-
相比之下,GRPO 在每个 token 位置 t 都应用了重要性权重 和 ,由于该权重仅基于 next-token 分布 中的单个样本 ,完全无法实现预期的分布校正功能
-
相反,它会向训练梯度中引入高方差噪声,这种噪声会在长序列中不断累积,并被裁剪机制进一步放大
-
作者通过实验观察到,这会导致不可逆的模型坍缩;一旦坍缩发生,即使回退到之前的 checkpoint、精细调优超参数(如裁剪范围)、延长生成长度或更换 RL 查询,也无法恢复训练
-
上述观察揭示了 GRPO 设计中的根本性缺陷,token 级重要性权重的失效,印证了一个核心原则:优化目标的单位必须与奖励的单位相匹配
-
由于奖励是针对整个序列授予的,在 token 级别进行离策略校正是存在本质问题的,这促使作者放弃 token 级目标,转而探索直接在序列级别应用重要性权重并执行优化
-
-
针对 GRPO token 级重要性权重的原理性缺陷,GSPO 采用序列级重要性权重 和 ,其物理意义是衡量旧策略 生成的响应 y 与当前策略 的偏离程度,天然匹配序列级奖励,同时为裁剪机制提供合理依据
-
GSPO 序列级优化目标
-
输入:输入 prompt x,旧策略生成的 G 个响应
-
:序列级重要性比
-
通过几何平均,把连乘的结果压缩到单个 token 比率的平均水平,防止长序列连乘变得很小,使得其重要性比直接归零 → 梯度消失 → 训练崩溃
-
长度归一化:对序列似然开 次方根,将不同长度响应的重要性比统一到相同数值范围,避免少数 token 似然变化导致比值剧烈波动
-
等价形式:指数形式等价于 token 级对数似然的平均值,直观体现 “序列级平均权重” 的核心思想
-
这个公式也有利于工程实现,因为模型输出的是 logits,取 log_softmax 得到 log probabilities,此时就可以很简洁地实现
# log_probs: [Batch, Seq_len] (当前策略的对数似然) # old_log_probs: [Batch, Seq_len] (旧策略的对数似然) # 1. 计算序列平均对数似然 mean_logp = torch.mean(log_probs, dim=-1) # [Batch] mean_old_logp = torch.mean(old_log_probs, dim=-1) # [Batch] # 2. 计算差值并指数还原 = GSPO 重要性比 ratio = torch.exp(mean_logp - mean_old_logp)
-
-
:组相对优势估计
- 对同一 prompt 生成的 G 个响应做归一化,消除不同任务奖励尺度差异,保证训练稳定性
- 与 GRPO 优势计算逻辑一致,但作用于序列级奖励,而非 token 级
-
:序列级裁剪,限制新旧策略差异,过滤过度离策略样本
-
-
GRPO 中的 token 级重要性采样是有偏的
-
优化目标是最大化序列级奖励:
-
用旧策略 采样时,严格无偏的重要性采样权重必须是完整序列的概率比:
-
这是唯一满足「无偏估计」的权重形式,数学上没有任何替代方案
-
GRPO 为了避免连乘导致的数值极端问题(长序列乘积趋近于 0,梯度消失;短序列乘积爆炸,梯度震荡),做了一个致命妥协 —— 用 token 级比率的算术平均替代完整序列比:
- 本质问题:算术平均 序列连乘,根据均值不等式 ,这个估计是系统性有偏的,偏差会随序列长度放大
- 为了抵消偏差,GRPO 只能用极严格的 token 级裁剪(0.13%),导致样本利用率极低,长序列训练极易坍缩
-
GSPO 没有放弃无偏的序列比,而是对它做了长度归一化的几何平均:
- 数学本质:保留了序列比的完整信息(无偏),同时通过开 次方,把长 / 短序列的权重压缩到同一数量级,彻底解决了「长序列梯度消失、短序列梯度爆炸」的问题
- 数值优势:对数空间求和,避免了连乘下溢,工程上直接用
log_probs计算,一行代码实现,数值稳定
-
-
GSPO 的重要性采样方差更低
-
在强化学习的重要性采样分析中,我们通常假设 token 级对数比率 在对数空间服从正态分布
- :对数比率的平均偏差(通常很小)
- :单个 token 比率预测的方差(代表不稳定的源头)
-
GSPO 的方差推导
-
GSPO 的重要性比 是几何平均:
-
我们要求的是梯度 的方差,而 ( 是优势,视作常数),所以计算方差 等价于计算 ,其中
-
计算 的分布
-
因为每个 ,根据正态分布性质:
-
除以 T 后:
-
计算对数正态分布的方差。若 ,则 服从对数正态分布,其方差公式为:
-
代入 GSPO 的 :
-
泰勒展开近似 —— 对于长序列 T, 是一个很小的数,利用泰勒展开 (当 ):
-
因此:
-
结论:GSPO 的方差与序列长度 T 成反比,序列越长,方差越小,训练越稳定
-
-
GRPO 的方差推导
-
GRPO 用的是 算术平均:
-
在对数空间,GRPO 直接对 求平均,而不是对 求平均,它的方差计算是:
-
,直接对比率求方差,会得到一个包含 的指数项:
-
代入 GRPO 的方差公式:
-
-
对比
算法 方差公式 稳定性 GSPO 极佳(方差随序列长度 T 增加而减小) GRPO 差(多了 指数项,方差巨大)
-
-
GSPO 梯度推导
- GSPO 对响应中所有 token 的对数似然梯度做等权加权,权重仅由序列级重要性比 和优势 决定,同一响应内所有 token 权重完全一致
-
GRPO 梯度推导
- GRPO 对每个 token 应用独立的 token 级重要性权重 ,同一响应内不同 token 权重差异极大
- 权重随序列长度累积,被裁剪机制放大,最终导致不可逆模型坍缩
-
GSPO-token
-
在多轮 RL 等场景中,需要细粒度的 token 级优势调整,因此提出 GSPO-token 变体,在保留 GSPO 稳定性的同时,支持 token 级优势自定义
-
GSPO-token 优化目标,支持 token 级优势 自定义,适配多轮 RL、细粒度奖励等场景
-
token 级重要性比定义
- :停止梯度算子(PyTorch 中
detach()),仅保留数值,不参与梯度传播 - ,因此 数值上完全等于序列级重要性比
- :停止梯度算子(PyTorch 中
-
GSPO-token 梯度推导
-
-
实验证明
- GRPO 的 token 级梯度本质是 “噪声”:GRPO 的 token 级重要性权重违反重要性采样原理,引入极高梯度噪声,绝大多数 token 的梯度都是无效噪声,仅极少数有效;因此即使只裁剪 0.13% 的 token,也只是过滤了极少量噪声,大部分噪声仍参与训练,导致样本利用效率极低
- GSPO 的序列级裁剪是 “精准过滤”:GSPO 对完整响应做裁剪,仅过滤过度离策略、完全无效的响应,保留的响应中所有 token 的梯度都是高质量、低噪声的有效信号;因此即使裁剪 15% 的 token,剩余 85% 的 token 都是高价值样本,样本利用效率远高于 GRPO
- 裁剪比例不是 “越多越好 / 越少越好”,关键看梯度信号质量
- 算法设计的核心是 “信号质量”,而非 “样本数量”:大模型 RL 训练中,1 个高质量梯度信号 > 100 个带噪声的无效信号
-
GRPO 在训练 MoE 模型的时候,出现 rollout 和训练的专家路由不一样的原因是什么?这个问题有什么解决方案?
- MoE 只激活 Top-K 专家(如 8 选 2),路由概率微小偏移 → 选中专家集合完全不同
- Rollout(旧策略 )选专家 A/C,训练(新策略 )选专家 B/D → 两个前向是不同子网络在计算,概率比 混入结构差异,重要性权重剧烈波动、方差爆炸
- 解决方法是 Rollout Routing Replay:rollout 时缓存每一层路由掩码(选中专家),训练强制重放,保证路径完全一致
-
GSPO 在 MoE 架构上的改进
- 在 MoE 架构上应用 GRPO 算法时,MoE 模型的专家激活波动性会阻碍训练正常收敛
- 例如,对于 48 层的 Qwen3-30B-A3B-Base 模型,在每次 RL 梯度更新后,对于相同的样本采样,新策略 下激活的专家与旧策略 下激活的专家存在显著差异,平均而言,约有 10% 的专家在新旧策略下被激活的模式是不同的
- 这种现象在更深层的 MoE 模型中更为突出,它使得 token 级重要性比率 发生剧烈波动,这种波动会使重要性比率失效,从而导致 RL 训练无法正常收敛
- 为了应对这一挑战,需要采用 Routing Replay(路由重放) 训练策略,也就是在旧策略 下缓存激活的专家路径,并在计算重要性比率 时,将这些路由路径 “重放” 到当前策略 中
- 这样,对于每个 token yi,t, 和 共享相同的激活网络模式,由此可以恢复 token 级重要性比率的稳定性,并确保梯度更新过程中激活网络的一致性,实验证明 Routing Replay 策略是 GRPO 训练 MoE 模型正常收敛的关键技术
- 尽管 Routing Replay 策略能让 GRPO 训练的 MoE 模型正常收敛,但它重用路由路径的做法会带来额外的内存和通信开销,同时也可能限制 MoE 模型的实际容量
- 先比之下,GSPO 完全消除了对 Routing Replay 策略的依赖,且具备全容量的计算能力
- GSPO 的关键在于:它仅关注序列似然(sequence likelihood, 即 ),而对单个 token 的似然(即 )不敏感
- 因此,MoE 模型始终保持其语言建模能力,序列似然不会发生剧烈波动
- 总而言之,GSPO 从根本上解决了 MoE 模型中的专家激活波动性问题,无需依赖 Routing Replay 等复杂的变通方案,这不仅简化并稳定了训练过程,还允许模型在无人工约束的情况下充分利用其全部容量
-
GSPO 对 RL Infra 的益处
- 在实际工程中,由于训练引擎(如 Megatron)与推理引擎(如 SGLang、vLLM)之间存在精度差异(precision discrepancies),通常需要借助训练引擎,在旧策略 下重新计算采样响应的似然值,以确保梯度计算的准确性
- 然而,GSPO 仅使用序列级(sequence-level)而非 token 级的似然值进行优化,从直觉上看序列级似然对精度差异具有更高的容忍度。
- 因此,GSPO 支持直接使用推理引擎返回的似然值进行优化,从而避免了在训练引擎中重新计算的需求
- 这一特性在以下场景中尤为有益:部分 rollout(部分滚动)、多轮 RL,以及在训推分离(disaggregated)的框架架构中
ReMax
REINFORCE++
-
REINFORCE++ 证明 GRPO 的组内归一化作为优势估计是有偏的
-
主要原因是由于样本标准差是 的函数, 会影响组内方差,因此 1/D 与 不独立,导致期望无法拆分,最终产生偏差
-
在大样本 时,样本均值 ,样本标准差 ,因此
-
此时估计器渐近无偏,但有限样本下仍存在偏差
-
PPO 使用单独的价值网络估计基线,优势为 ,本质是无偏估计(在价值网络准确时)
-
而 GRPO 用组内统计量做标准化,牺牲了无偏性换取了无需价值网络的效率,这是 GRPO 的核心 trade-off
-
-
REINFORCE++ 使用批次级别标准差进行归一化
-
REINFORCE++-baseline 使用组级别均值和批次级别标准差进行归一化
-
相比 PPO,REINFORCE++
- 去掉了 critic 网络
- GAE 中的参数设置为 ,即不使用时间折扣和优势衰减
- 引入两步全局批次归一化作为 baseline
-
REINFORCE++ 和 REINFORCE 的关系
- REINFORCE++ 是 REINFORCE 的改进版本,核心区别在于引入了批次级别的归一化来稳定训练
- REINFORCE 的优势估计直接使用原始奖励 ,没有任何归一化,这在奖励尺度不稳定的环境中会导致训练不稳定甚至崩溃
- REINFORCE++ 通过对优势进行批次级别的均值和标准差归一化,确保了不同批次之间的奖励尺度一致性,从而显著提升了训练的稳定性和收敛速度
Lite PPO
- Lite PPO 论文系统研究了 RL 训练的相关 trick,并按照不同的类别讨论了选用什么策略
- 组级别 vs. 批次级别归一化
- 组级别(Group-level)归一化表现出更强的鲁棒性
- 批次级别(Batch-level)归一化对奖励尺度敏感:如果一个批次中存在奖励分布严重不均的情况(例如,少数样本的奖励远高于其他样本),批次级别的均值和标准差会被这些「离群点」主导,导致优势估计出现偏差,甚至性能崩溃
- 归一化中标准差项的作用
- 在简单任务中,模型生成的多个回答质量可能非常接近(例如,几乎全对或全错),导致奖励的组内方差极小,标准差 趋近于零;此时,用一个极小的 做除法,会导致优势值被过度放大,引发梯度爆炸,破坏训练稳定性
- 在奖励分布高度集中的数据集(
Easy Data)上,移除标准差项(即只进行中心化:)可以显著提升训练的稳定性和最终性能 - 在奖励分布较为分散的困难数据集(
Hard Data)上,标准差本身较大,保留或移除它对最终结果影响不大
- 更鲁棒的归一化技术
- 「组级别均值 + 批次级别标准差」 的组合在实验中表现出最佳的鲁棒性和性能提升 —— 它兼顾了比较的针对性和缩放的稳定性,是一种值得推广的最佳实践
- 组级别均值保证了优势比较的局部相关性,一个回答的好坏是相对于同一问题的其他回答而言的,这使得比较更有意义
- 批次级别标准差提供了更全局和稳定的尺度信息,由于批次大小远大于组大小,其标准差估计更为稳定,不易受到单个组内奖励分布极端情况的影响
- Clip-Higher 的适用场景
Clip-Higher主要对对齐后(Aligned)的模型有效- 对于
Aligned模型,提高裁剪上限可以显著减缓训练过程中的熵下降,并带来持续的性能提升 - 对于基础(Base)模型,
Clip-Higher效果不明显,甚至可能损害性能 Aligned模型已经具备了较强的基础能力,其瓶颈在于如何跳出已有的高质量模式去探索更优的解,Clip-Higher为其提供了更大的探索空间- 而
Base模型本身能力较弱,策略尚不稳定,过大的更新步长反而容易破坏其初步建立的认知结构
Clip-Higher在微观层面是如何影响模型生成文本的?- 在标准裁剪( 较小)下,被裁剪(即更新被抑制)最频繁的是逻辑连接词,如「therefore」、「if」、「but」等;这些词往往是开启新推理步骤或转换论证角度的关键,限制它们可能会固化模型的推理模式
- 在
Clip-Higher( 较大)下,裁剪的压力从逻辑连接词转移到高频功能词上,如「is」、「the」和逗号等;这些词对句子结构至关重要,但对逻辑流的影响较小 Clip-Higher通过选择性地「放手」,允许模型更自由地探索不同的话语和推理结构,同时通过对核心功能词的隐性约束来维持句法稳定性,从而促进了生成内容的多样性和创新性
- 损失聚合粒度
- 序列级别聚合:先计算每个序列(回答)的平均损失,再对所有序列的平均损失求平均;这种方法给予每个序列相同的权重,但可能会导致长序列中每个 token 的梯度贡献被稀释,即存在长度偏见
- Token 级别聚合:将一个批次中所有序列的所有 token 损失直接相加,再除以总 token 数;公式形式为 ,这种方法保证每个 token 对总损失的贡献是均等的
- 对于
Base模型,Token 级别聚合显著优于序列级别聚合,它能确保模型从长而复杂的正确推理链中充分学习,克服了序列级别聚合的长度偏见问题 - 对于
Aligned模型,序列级别聚合反而表现更优 Base模型需要从 token 层面学习如何构建有效的推理步骤,因此均等的 token 权重至关重要- 而
Aligned模型已经具备了生成结构良好序列的能力,序列级别的损失能够更好地保持其生成内容的整体连贯性和结构完整性,避免因过度关注局部 token 而破坏整体语义
- 过滤策略
- 在训练中,为节省资源,通常会设定一个最大生成长度,超过该长度的序列会被截断
- 这可能导致一个原本正确的推理过程因未完成而被错误地标记为失败样本,引入训练噪声,而
Overlong Filtering技术通过在计算损失时屏蔽这些被截断的样本来解决此问题 Overlong Filtering在中短长度推理任务中能有效提升准确率和回答的简洁性,当任务需要极长的推理链(long-tail reasoning)时,该技术带来的收益有限,甚至可能因过滤掉潜在的有效长答案而限制模型的上限- 在长文本生成中,许多被过滤的「过长」样本实际上是由于模型无法正确生成结束符(EOS)而导致的退化性重复(degenerate repetition)
Overlong Filtering通过屏蔽这些无效样本,间接帮助模型更好地学习何时终止生成
- Lite PPO 提出了一个针对
Base模型的极简技术组合- 鲁棒的优势归一化:采用组级别均值 + 批次级别标准差的策略
- Token 级别损失聚合:确保每个 token 得到平等的学习机会
CISPO
-
裁剪重要性采样策略优化(Clipped Importance Sampling Policy Optimization, CISPO)采用了一种与 PPO / GRPO 本质不同的稳定化思路
-
如前所述,PPO 和 GRPO 通过裁剪目标函数来稳定训练,这样当 token 的重要性比率 超出裁剪区间时,对应 token 的梯度会完全置零,对于稀有但关键的 token(如重要推理步骤),梯度丢失会影响学习
- 关键 token 被误伤:那些表示反思行为的 token(比如 "However"、"Recheck"、"Wait"、"Aha" 等)在基础模型中概率很低
- 推理路径中断:这些 token 往往是推理路径的 "分叉点",但在策略更新时会产生很高的 值
- 梯度贡献丢失:经过第一次策略更新后,这些 token 就被裁剪掉了,无法在后续的离线策略梯度更新中发挥作用
-
而 CISPO 裁剪重要性权重本身,而不是目标函数,所有 token 始终保留梯度贡献(即使重要性权重被限制,token 仍然应该根据其优势函数获得梯度信号,而不是被完全 “丢弃”)
-
裁剪后的 token 级重要性权重
-
在目标形式上,CISPO 放弃了 PPO 式的双边裁剪代理目标,而更接近 REINFORCE 风格:
- 表示停止梯度(stop-gradient)
- 前向计算时使用这个值,但在反向传播时不计算它的梯度,从而保证每个 token 都保留梯度信号,重要性权重裁剪只起 “限制梯度幅度” 的作用,而不会影响优化器的梯度计算
- 不参与求导,仅作为固定的权重,只对 求导,从而回归标准策略梯度
- 即使 被裁剪,梯度方向依然保留,不会归零,模型仍能朝优势方向更新,仅幅度被保守约束
- 是裁剪后的 token 级重要性权重
- 移除 min 操作,纯 clip 保守约束:确保 被限制在安全区,防止策略突变,同时梯度平滑,没有突变点
- 为保证在非裁剪区(r≈1)与原始 GRPO/PPO 梯度一致,CISPO 加入配平项,确保数学等价,不改变正常样本的更新方向
- 表示停止梯度(stop-gradient)
-
CISPO 裁剪的是重要性权重本身,这是一种明确的偏差–方差权衡 —— 裁剪权重不可避免地引入偏差,但显著降低了重要性采样带来的方差
-
CISPO 支持不对称裁剪边界 和 ,这一设计类似于 DAPO 中的 “clip-higher” 思路:允许模型在增加某些 token 概率时执行更大幅度的更新以鼓励探索,同时对降低概率的更新保持更严格的约束
-
CISPO 与 GSPO
- CISPO 与 GSPO 都源自将强化学习扩展到超大规模模型(尤其是 MoE 模型)的研究实践,这类模型通常存在显著的数值不稳定性
- 研究发现,token 级重要性采样比率容易出现极端值,既可能导致梯度过度放大,也会引入大量方差,严重阻碍学习
- 这也是 CISPO 与 GSPO 在工业级大模型中具有实际价值,而在小规模学术实验中应用较少的原因
Attention-Based RL
TOPR
- 与 CISPO 思路密切相关的工作还包括 Tapered Off-Policy REINFORCE (TOPR),其核心特点包括:
- 直接裁剪重要性权重,而非裁剪代理目标
- 在序列级别应用裁剪(类似 GSPO),保证奖励粒度与重要性采样校正粒度一致
- 使用基于奖励符号的不对称裁剪策略:
- 对正奖励样本不进行重要性采样校正
- 对负奖励样本将比率裁剪至 [0,1]
- 这种设计在实践中显著提升了离策略学习的稳定性
总结
- 各种算法都是怎么解决 Off-Policy 问题的
- 梯度裁断:对重要性采样(IS)比率超出信任域的 token 进行梯度截断,例如 Decoupled PPO
- 重要性采样优化:保留所有样本的梯度,但对重要性采样权重进行裁剪以稳定训练,例如 CISPO、TOPR
- 损失函数对比
-
PPO (Standard)
-
Decoupled PPO
-
Truncated IS
-
CISPO
-
TOPR
-
Agentic RL
LLM+RL
-
预训练、SFT、GRPO 在优化目标上的区别
-
预训练
-
下一个词预测损失(Next Token Prediction, NTP)
-
无标注数据,目标是自回归
-
-
SFT
-
最小化模型输出与标注标准答案(Golden Answer)之间的交叉熵损失,学习逐 token 的条件概率匹配
-
本质上就是极大似然估计(MLE,Maximum Likelihood Estimation),逐 token 独立优化,只关心每个位置预测的 token 是否与标准答案一致
-
有监督,目的是让模型学会遵循指令,模仿人类示范回答
-
-
GRPO
-
最大化同一 prompt 下,模型生成的多个回答中,“相对更优” 回答的概率,并通过 KL 散度约束策略更新幅度
-
让模型回答更简洁、有用、安全、逻辑性强,更符合人类偏好
-
-
-
探索与利用(Exploration-Exploitation)的平衡策略?在 LLM 工具调用 / 多步决策中如何实现有效探索?
-
大模型做 RL 时常见不稳定性原因?大模型 RL 训练中常见 NaN /loss 爆炸原因有哪些?
-
大模型 RL 对齐中,Prompt 限流、长度惩罚、拒绝采样的原理?
-
为什么 LLM 对齐优先用随机策略,而不是贪心?
- LLM 对齐本质上是在训练一个概率分布 ,而不是训练一个 “确定性函数”
- 如果用贪心生成,是确定性、不可微、没有梯度的操作,而策略梯度定理的基础是,必须对分布采样,才能拿到 的梯度
- 随机采样才能提供 “探索”,对齐需要探索 - 利用平衡
-
大模型的推理能力与 RL 的融合:CoT(思维链)、CoA(动作链)的核心思想,如何通过 RL 优化思维链(引导模型生成有效推理步骤、减少错误链)
- CoT:把复杂问题拆解成文本化、分步、逻辑连贯的推理步骤,让模型 “说清楚思考过程”,提升可解释性与复杂问题正确率
- CoA:在 CoT 基础上,加入可执行的外部动作 / 工具调用,形成 “思考 + 行动” 闭环,解决纯文本推理解决不了的问题
- SFT 只是 “模仿正确步骤”,但不会判断推理质量、不会纠错、不会择优;而 RL 可以直接奖励有效推理,惩罚错误推理
-
如何用 RL 优化 CoT 推理与工具调用?
- 把推理链建模为 “序列决策过程”
- 每一步 token / 步骤 = 动作(action)
- 推理状态 = 当前上下文(问题 + 已生成步骤)
- 策略 = 模型生成下一个 token / 步骤的概率
- 目标:最大化整条推理链的期望奖励
- 奖励函数设计
- ORM
- PRM
- Constraint Reward:长度、格式
- DeepSeek R1 的经验
- 冷启动 SFT:利用数千条高质量人工 CoT 数据,让模型学会规范格式、基本推理逻辑
- 第一阶段 RL:正确性(60%)、格式规范(20%)、语言一致性(20%)
- 拒绝采样 + 蒸馏 SFT:RL 生成 600k 高质量链 → 过滤(拒绝率 32%)→ 再 SFT
- 全场景 RL
- 把推理链建模为 “序列决策过程”
-
LLM+RL 后训练阶段(PPO/DPO/GRPO/ORPO)核心偏差 / 不稳定性问题及解决
- PPO 训练震荡 / 模式崩溃(最经典问题):策略更新步长过大;奖励函数设计不合理;价值网络与策略网络训练不同步;大模型中动作空间过大(词汇表量级)
- DPO/ORPO 的分布偏移(Distribution Shift):偏好对数据的分布与模型实际生成的分布不一致;训练时仅优化偏好对,忽略模型的泛化能力;线上推理的输入与训练数据分布差异大
- GRPO / 自定义 RL 算法的策略约束偏差:策略正则化强度设置不合理;多目标奖励的权重失衡;梯度正则导致策略更新过慢(你项目中 GRPO 的核心优化点)
- 多目标平衡偏差:多目标(如准确率 / 效率 / 合规性 / 流畅度)之间存在冲突;单一奖励函数无法兼顾所有目标;各目标的评估指标维度不同
- Agentic RL 的工具调用偏差:工具调用的触发条件模糊;奖励模型对工具调用的 “必要性” 打分不准确;多步工具调用中步骤选择错误
-
如果有一个对话任务,没有固定答案,该怎么选择 RL 训练策略?
- 没有固定答案,就需要使用基于偏好排序的 RL
- 可以选择 SimPO/DPO,这两者不需要奖励模型,不需要在线采样,不需要价值网络
- 而对于多轮对话
训推不一致
研究现状
-
本文使用以下记号:
- 行为策略 : 实际负责生成 rollout 的策略,即 "数据是在什么分布下采样的"。在现代 LLM-RL 系统中,它对应推理引擎的实现(vLLM / SGLang 等);在异步框架下,它往往还可以近似看作多个 worker 策略诱导分布的混合
- 近端 / 参考策略 : 训练目标中用于重要性采样、clipping 或 trust-region 约束的策略,典型的就是 PPO / GRPO 里的 "旧策略"(old policy);为了避免和固定 KL 参考模型混淆,把它称为近端策略或参考策略;而固定的 SFT 参考模型单独写成
- 目标策略 : 训练目标中要优化的策略,即 "希望模型变成什么样",典型的就是 PPO / GRPO 里的 "新策略"(new policy)
-
具体对比
理论对象 在分析中的角色 常见工程量 真实采样分布,决定数据来自哪里 behavior log-prob、policy version、sampling config、routing trace 近端锚点,决定 ratio 分母与 trust region 参照 old log-prob、clip anchor、proximal checkpoint 被优化的目标策略,决定更新方向 new log-prob、当前 actor、当前 router 若存在固定 KL 参考模型,只负责 KL 正则 ref log-prob、SFT/reference checkpoint -
在最理想化的设定里,通常默认 但在真实系统里,由于异步更新、推理和训练后端不同、MoE 路由由波动甚至硬件件差异,二者往往会偏离,程度视系统而定
-
算法层:如何写 trust region 目标、如何在样本层面处理” 行为 vs 参考” 偏移
- Decoupled PPO 较早明确指出在信赖域策略优化(TRPO/PPO)方法中,"旧策略"(old policy)实际上同时承担两种角色
- 其一,作为行为策略(behavior policy),用于重要性采样的异策略修正,代表数据采样所服从的分布;
- 其二,作为近端策略(proximal policy,即本文所指的 "参考策略"),用于限制新策略的更新幅度,约束新旧策略的变化范围
- 该工作提出 Decoupled PPO 更新目标,将 "采样所用策略" 与 "信任域约束所用策略" 在形式上解耦,打破了两者必须为同一策略的传统假设
- GSPO
- 针对 GRPO 在长序列与 MoE 模型上的训练稳定性问题展开研究,指出 token-level 的 PPO/GRPO 会因新旧策略间专家路由的剧烈波动,引入极高方差与训练不稳定
- 为此,GSPO 提出在序列级别(sequence-level)定义 PPO 式目标与比率约束,以整条序列的比率约束策略更新,显著缓解了 MoE 场景下路由不一致导致的训练崩溃问题
- Your Efficient RL Framework Secretly Brings You Off-Policy RL Training 聚焦现有大模型 RL 训练框架(如 VeRL)中推理与训练实现不一致的问题
- 推理框架(如 vLLM)与训练框架(如 FSDP/Megatron)的算子差异,会导致行为策略 与参考策略 分布偏移,使原本的同策略(on-policy)训练退化为带有显著偏差的异策略(off-policy)训练
- 文章梳理了 PPO-IS、vanilla-IS 两种现有解决方案,并提出 token-level 截断重要性采样(truncated IS, TIS),通过限制高偏差样本的权重,降低训推不一致对训练的负面影响
- Small Leak Can Sink a Great Ship–Boost RL Training on MoE with IcePop! 进一步指出,训推不一致问题在 MoE 模型上会被放大
- MoE 路由对微小扰动高度敏感,叠加推理 / 训练实现差异与异步采样后,偏差极易失控
- 为此,该工作提出 IcePop 方法:在 token-level 计算重要性采样比率,对比率过大或过小的样本进行双侧掩码(masking),从梯度计算中剔除噪声样本,有效稳定了 MoE 模型上的 RL 训练
- When Speed Kills Stability: Demystifying RL Collapse from the Training-Inference Mismatch
- 系统性剖析了训推不一致的成因,包括智能体工作流引入的分布外 / 低概率 token、硬件与 kernel 实现带来的计算不确定性等,并深入分析了 token-level 重要性采样在长序列任务中引入严重偏差的根本原因
- 文章进一步提出序列级别重要性采样掩码(sequence-level masked IS, sequence-level MIS),仅丢弃重要性比率异常的完整序列,在控制偏差的同时,显著抑制了极端样本引发的训练崩溃,且提供了完整的理论推导与实验验证
- verl Rollout Importance Sampling 在其 rollout correction 模块中引入 “Token Veto(一票否决)” 机制:
- 在 token-level 计算重要性比率 ,若轨迹中任意 token 的比率低于阈值 ,则直接剔除整条序列
- 该 “token 粒度检测、序列粒度否决” 的设计,体现了保守的风险控制策略
- INTELLECT-3 Technical Report 提出的异步分布式 RL 训练框架,采用了类似的拒绝采样策略:对每条 rollout 计算 token-level 重要性比率,若任意 token 的比率低于设定阈值(文中取 ),则对整条轨迹进行掩码(masking)处理
- Decoupled PPO 较早明确指出在信赖域策略优化(TRPO/PPO)方法中,"旧策略"(old policy)实际上同时承担两种角色
-
系统层:如何在算法外部让行为策略与参考策略保持接近
- AReaL 聚焦异步训练框架下,行为策略与参考策略不一致的核心问题:rollout 数据通常由滞后的参数版本或不同 worker 生成,导致数据分布与训练策略存在天然偏移。该工作在异步框架中采用 Decoupled PPO 风格目标,显式区分 “行为策略分布” 与 “参考策略”,在异步场景下仍维持了近似 PPO 的优化稳定性
- Defeating Nondeterminism in LLM Inference 指出,批处理大小不变性(batch-size invariance)的缺失,是大模型推理框架随机性的重要来源:同一输入在不同 batch 组合、不同 kernel 路径下,输出的概率分布会出现显著差异。这意味着,即使名义上使用同一套参数,真实运行时的行为策略 也会因系统负载、调度策略的变化而波动,进一步放大训推不一致问题
- RL 老训崩?训推差异是基石 从工程实践角度,分享了实现 “训推一致” 的关键方案:包括选用与推理端完全对齐的算子与精度配置、监控并约束训练端与推理端的 log-prob 偏差等,重点从训推框架底层入手,从源头缓解训推差异
-
模型层:MoE 路由带来的特殊问题
- Stabilizing MoE Reinforcement Learning by Aligning Training and Inference Routers 聚焦 MoE 架构特有的路由不一致(Routing Inconsistency)问题
- 研究发现,即便输入完全相同,推理端与训练端也可能因算子实现、并行策略的微小差异,导致 Router 选择不同的专家
- 这种 “物理路径” 上的不一致,会使行为策略 与参考策略 的差异远超预期,极易触发训练崩溃
- 为此,文章提出 Rollout Routing Replay (R3):在推理阶段记录每个 token 实际命中的专家索引,训练阶段强制回放这些路由决策,不再重新计算
- R3 通过这种方式,在 MoE 拓扑上强制对齐了训推两端的计算路径
- Stabilizing MoE Reinforcement Learning by Aligning Training and Inference Routers 聚焦 MoE 架构特有的路由不一致(Routing Inconsistency)问题
-
序列级比率与 “误差放大效应”
-
行为策略到目标策略的序列级重要性采样比率,可以分解为 token 级比率的乘积:
-
对应的对数比率,就是 token 级对数比率的求和:
-
这直接揭示了 LLM-RL 中长回复的 “误差放大效应”:
- 即使每个 token 上,行为策略与目标策略的分布偏移很小(比如比率只有 0.99),在长序列中,这种微小偏移会通过乘积形式不断累积
- 当序列长度 T 很大时,序列级比率可能会急剧偏离 1,导致重要性采样的方差爆炸、信任域约束失效,最终引发训练崩溃
-
TRPO 理论推导
-
TRPO 的理论推导
-
性能差分引理(Performance Difference Lemma)
-
对任意策略 和 ,有:
-
含义:两个策略的回报差,等于 “新策略访问的状态分布下,行为策略优势函数的期望”
-
-
代理目标的引入
-
TRPO 的核心难点是无法在新策略分布 上采样,只能用行为策略分布 的数据,因此定义代理目标:
-
含义:用行为策略的样本,近似估计新策略的优势期望,作为真实目标的替代
-
-
代理目标与真实目标的 Gap
-
真实目标和代理目标的差为:
-
定义 (优势函数的上界),可以得到:
-
这里的 是状态分布偏移,即 “新策略和行为策略看到的世界差异”
-
-
策略 TV 到状态分布偏移的传播界
-
定义状态 s 下策略间的总变差距离(Total Variation):
-
假设对所有 s,行为策略和目标策略的 TV 被 上界:
-
则有经典传播界:
-
含义:每一步动作分布的差异 ,会通过折扣累积,放大为状态分布的差异
-
-
两策略 TRPO 的最终下界
-
把传播界代入 Gap 上界,得到:
-
含义:只要约束住行为策略和目标策略的动作分布差异 ,就能保证代理目标和真实目标的 Gap 可控,维持 TRPO 的单调性
-
-
-
三策略 TRPO:引入参考策略后的分解
-
现实中,无法直接控制行为策略 和目标策略 的差异,只能控制两个量:
- 参考策略 vs 目标策略(信任域约束)
- 行为策略 vs 参考策略(训推 / 异步偏差)
-
两个偏差来源的定义
-
定义两个关键的 TV 上界:
-
偏差源 A(参考 vs 目标):
-
含义:新策略和参考策略的动作分布差异,对应 PPO 的 clip/trust-region 控制
-
偏差源 B(行为 vs 参考):
-
含义:行为策略和参考策略的动作分布差异,对应训推不一致 / 异步采样偏差
-
-
三角不等式分解
-
利用 TV 距离的三角不等式:
-
对所有状态取上界,得到:
-
-
三策略 TRPO 的最终定理
-
记常数 ,代入两策略 TRPO 的下界,得到:
-
-
-
三策略偏差的共同影响:真实目标和代理目标的 Gap,由参考 - 目标偏差 和行为 - 参考偏差 共同决定
- 可以通过 PPO 的 clip、KL penalty 直接控制;
- 来自训推不一致、异步采样、MoE 路由差异,是 LLM-RL 训练崩溃的核心诱因
-
为什么训推不一致会导致训练不稳定?
- 当 很大时,即使你把 压得很小,Gap 上界 依然会很大,代理目标 和真实目标 严重脱节,导致 “优化了代理目标,真实回报却下降”,即训练崩溃
-
综上,现在主要有两个偏差的主要来源
- (参考 vs 目标):目标策略 与参考策略 的分布偏移,是 PPO/GRPO 的传统信任域问题,一般通过 clip / KL penalty / GSPO 的序列级约束来控制
- (行为 vs 参考):行为策略 与参考策略 的分布偏移,是训推不一致 / 异步采样 / 系统差异带来的工程问题,也是真实场景中训练崩溃的更主要诱因
控制训推不一致的方法
-
(行为 vs 参考)的控制方法
- 系统层面:直接压低
- 从算法外部让行为策略 与参考策略 尽量接近,直接降低原始的行为 - 参考分布偏移
- 异步框架版本控制:给每个 rollout 样本打上策略版本号,只使用与当前参考策略版本相差不大的数据,避免使用过旧版本生成的数据
- 训推对齐:让训练框架(如 Megatron/FSDP)和推理框架(如 vLLM/SGLang)在精度、算子、内核实现上保持一致,减少因实现差异导致的策略分布偏移
- 算法层面:样本修正,不直接压低
- 这类方法不改变原始行为分布 ,而是通过样本筛选 / 重加权,改变实际参与训练的有效分布 ,让训练过程更少受极端偏移样本的影响
- 系统层面:直接压低
-
TIS:Token-Level 截断重要性采样:对 token 级的参考 - 行为比率做单向截断,削弱极端大比率样本的权重
-
权重定义:
-
损失形式:
-
完整损失
-
特点:
- 仅对过大的比率做截断,保留过小的比率;
- 从三策略 TRPO 角度看,是 “软削弱” 行为与参考策略严重不一致的 token
- 注意: 处理的是行为→参考的偏移, 里的 clip 处理的是参考→目标的偏移,两者是独立的两步
-
PPO-IS 变体
-
Vanilla IS 变体
-
在 Vanilla-IS 中,当 IS 比率过大时,它会被直接乘进梯度中,导致方差被平方级放大;高方差的梯度会让训练极不稳定,步长震荡、loss 波动剧烈,甚至难以收敛
-
在 PPO-IS 中,破坏了 PPO 的设计前提,引入了系统偏差
- 标准 PPO 中,clip 机制的前提是:新旧策略都是 learner 策略,当 时,clip 的输入比率为 1,保证了 clip 的正确性,梯度可以真实反映策略更新方向
- 而在 PPO-IS 中,clip 机制的前提被破坏了:当 时,clip 的输入比率不再是 1,而是 ,这个值可能远离 1,导致 clip 的行为异常,梯度不再正确反映策略更新方向,从而引入了系统偏差
- 这会导致,系统噪声让 clip 提前触发,梯度还没来得及反映 “真实策略更新方向”,就被错误地 clip 掉了,最终 policy 更新被抑制,优化效率低下,效果变差
-
TIS 的因式分解把 off-policy 修正和 trust region 分开
- off-policy correction(系统偏差项):修正 learner 和 sampler 之间的系统分布偏差,同时对它进行截断,控制训推不一致引入的高方差样本对训练的负面影响
- trust region(策略更新项):保持 PPO 的 clip 机制的正确性,确保在新旧 learner 策略之间正确地约束更新幅度,维持 PPO 的优化稳定性
-
-
IcePop:Token-Level 双侧掩码,对 token 级比率做双侧过滤,直接丢弃比率过大或过小的 token
-
掩码定义:
-
损失形式:
-
完整损失:
-
其中,,并且 mask 函数如下
-
特点:
- 比 TIS 更激进,直接 “硬裁掉” 极端不一致的 token;
- 只在比率适中的区域优化,从样本层面更强地压缩有效不一致;
- 特别针对 MoE 模型中路由不一致导致的极端偏移
-
IcePop 和 TIS 的对比
- 当 IS <α 时, 倾向于给 action 较小的 value, 输出较高的概率。如果比率足够小,意味着训推引擎存在巨大差异,TIS 引入一个小的系数来缓解梯度更新中的噪声;但 IcePop 发现,随着训练进行,这种微小扰动会逐渐放大,最终导致平台期
- 当 IS > β 时,TIS 会乘以一个适中的系数持续更新 policy;而 IcePop 梯度为零,这意味着放弃所有噪声更新,只保留那些健康的策略梯度
-
-
MIS:Sequence-Level 掩码重要性采样,直接在序列级过滤,只保留序列级比率不超过阈值的轨迹,同时保留序列级 IS 修正
-
核心操作:
-
损失形式:
-
特点:
- 序列级处理,避免了 token 级权重被长序列极端值支配的问题;
- 同时做了 off-policy 修正(保留 )和序列级筛选;
- 从三策略 TRPO 角度看,是在轨迹级的有效训练分布上更保守地应对行为 - 参考偏移
-
-
WTRS(Token Veto 类机制):Token 级检测、序列级否决,轨迹中只要存在任意 token 的比率低于阈值,就剔除整条序列,是最保守的拒绝采样
-
掩码定义:
-
损失形式:
-
特点:
- 典型实现包括 verl 的 Token Veto、INTELLECT-3 的 token masking;
- “一票否决” 机制,系统噪声高时比 token 级局部修补更稳定;
- 代价是样本利用率低,容易出现数据浪费
-
MoE 路由不一致的特殊问题
-
在 MoE(Mixture-of-Experts)模型上,训推不一致往往首先表现为路由不一致(routing inconsistency):即便参数相同,推理端和训练端也可能因为算子、并行或数值细节的微小差异而路由到不同的专家
-
一个很自然的工程应对是路由回放(routing replay):在 rollout(推理)时记录实际命中的专家路径,训练时强制复用这些路由决策
-
为了便于分析,这里把路由选择 z 视为扩展动作空间的一部分,也就是把 “选专家” 和 “生成 token” 一起看作策略的联合决策
,这类方法经常被直觉性地理解为 “在样本层面修正行为 vs 参考的偏移,甚至直接压小 ”
-
但从三策略 TRPO 的视角看,更准确的说法是:路由回放并不是在原 surrogate objective 上直接缩小原定义下的策略距离项,而是把 surrogate objective 改写成另一个 “带路由条件 / 替换” 的目标;它让路由不一致在 loss 里 “不可见”,但通常并不会直接让原定义下的 或 变小
-
问题建模
-
把 MoE 抽象成两阶段随机决策:“先选专家 z,再在该专家条件下生成 token a”,目标策略可分解为
-
是路由器(router)的分布;
-
是在专家 z 条件下的 token 分布
-
在三策略 TRPO 中,真正想优化的 surrogate objective 为
-
把专家层的优势聚合写为
-
这里的 把 “选择专家 z 并生成 token a” 视为联合决策的优势函数;在原始的 里,路由分布就是当前要更新的
-
换言之,MoE 的 RL 训练不仅在更新 token 生成分布,也在更新路由器本身
-
-
回放行为策略的路由(behavior-router replay / R3 类)
-
R3 的做法是:rollout 时记录推理端实际命中的专家集合 ,训练时强制当前策略只在该集合内路由,可以把它写成对路由分布的 “条件化投影”:
-
从而训练时实际优化的 surrogate objective 变为
-
和原始 对比可以看到,R3 并没有让 逼近 或 ;它做的是:
- 把对 的期望改成了对 的条件期望;
- 等价地说,把路由的可行 support 缩到了
-
因此 R3 训练的是一个 “被行为路由集合条件化后的 surrogate objective”,而不是原来的
-
好处是显著降方差、提升稳定性;代价是在每个状态上都压缩了路由器探索 / 更新的自由度
-
-
回放参考策略的路由(reference-router replay)
-
另一类 routing replay 复用参考策略(old policy)的路由器 ωold,这等价于训练一个混合策略
-
对应 surrogate objective 为
-
这意味着:
- 在 surrogate objective 中,路由器被固定为旧路由器,路由相关的 “参考 vs 目标” 差异在 loss 里被直接抹掉;
- 训练对 “新路由器 是否偏离 ” 不再敏感,由此绕开了路由不一致带来的不稳定
-
但注意这同样是换目标:
- 真实策略空间里的 并没有因此变小,只是被 “用旧路由器重定义目标” 而在 loss 中不可见;
- 路由器的学习被强行冻结或大幅削弱
-
-
把两类 replay 放在一起看,它们的共同点是:
- 优化的都不是原始的 ,而是某个 “路由被条件化 / 替换后的 surrogate objective”
- 它们通常不会直接收缩三策略 TRPO 下界里的 ,replay 让路由不匹配不再显式出现在 loss 中,但不匹配在真实策略距离里仍然存在
- 实践上是在用 “偏差换方差”:回放往往显著降低方差、提升稳定性,代价是可能限制 MoE 在 RL 目标下学到更优的路由模式
-
所以,从三策略 TRPO 的视角,更准确的理解是 routing replay 更适合被理解为一种被行为路由条件化的 surrogate objective,而不宜直接理解为对 或 的直接约束
-
这和 R3 类方法报告的 training-inference mismatch 或 measured policy KL 下降并不矛盾:那些指标衡量的是引入路由回放后的条件化训练路径与推理路径是否更一致;而本文这里讨论的是原始联合策略空间中的 token-routing 分布距离 —— 两个说法的度量对象不同
Decoupled PPO
-
全异步架构引入了两个算法层面的挑战
- 数据过时(Data Staleness):训练 batch 中的样本可能来自好几个版本之前的模型,与当前策略存在分布偏移
- 策略版本不一致(Inconsistent Policy Versions):由于可中断生成,同一条轨迹的不同 token 可能由不同版本的模型产出,违反了标准 PPO "所有 action 来自同一策略 " 的假设
-
标准 PPO 目标函数
-
目标函数
-
其中:
-
各参数含义:
符号 含义 当前正在训练的策略(即我们要优化的模型参数) 采样轨迹时使用的策略(同时充当行为策略和近端约束基准) 重要性比率(importance ratio):衡量当前策略与采样策略在 token 上的概率之比 优势函数估计值(advantage estimate):衡量动作 相对于平均水平好多少 裁剪范围(clipping range),通常取 0.2,限制策略更新的幅度 轨迹长度(horizon),即生成序列的 token 数 -
标准 PPO 的核心思想是: 一人分饰两角 —— 既是采样数据的行为策略,又是 clip 约束的信任域中心
-
在同步训练中这没有问题,因为采样完立即训练, 就是最新的模型,但在异步训练中, 可能已经过时了好几个版本,导致:
- 重要性比率 偏差过大,梯度估计方差增大
- clip 约束的信任域中心是旧策略,无法有效防止模型跑偏
-
-
Decoupled PPO 目标函数
-
Decoupled PPO 的核心改进就是把 的两个角色拆开,引入两个独立的策略:
-
等价简化形式:
-
其中:
-
各参数含义:
符号 含义 来源 行为策略:实际生成轨迹时的策略(可能很旧,版本滞后多步) 生成时记录 近端策略:用于约束更新幅度的信任域中心(始终取训练前的最新模型参数) 每次 PPO 更新前刷新 当前正在优化的策略 训练中的模型 重要性采样修正系数:将旧策略采样的数据修正到以 为基准的分布上 自动计算 相对于近端策略的重要性比率,clip 约束作用于此比率上 自动计算
-
-
Decoupled PPO 还有一个关键的理论保证 —— 它能兼容可中断生成产生的多版本混合轨迹
-
由于可中断生成机制,同一条轨迹的不同片段可能由不同版本的模型生成(如 token 1-150 由 生成,token 151-420 由 生成)。这看起来违反了 PPO “所有 action 来自同一策略” 的假设
-
但 Proposition 1 证明了这并不是问题:
- 对于任意序列 ,由策略序列 生成,其中 生成 token ,满足
- 必然存在一个行为策略 ,使得这种被中断的生成方式等价于完全从 采样
-
证明的核心洞察是:在自回归语言模型中,不同时间步的状态空间天然不重叠
-
设 为给定问题 时,在第 步由策略序列经过的所有可能状态
-
由于状态 包含了所有历史 token,不同时间步的状态空间不会交叉,即对任意 ,
-
因此,可以构造一个分段定义的行为策略:
-
也就是说:在第 段被中断的区间内, 就等于当时实际生成的策略
-
由于不同区间的状态不重叠,这个定义不会产生矛盾
-
-
为什么这个性质很重要?
- 算法正确性保证:它证明了即使轨迹由多个策略版本拼接而成,Decoupled PPO 的重要性采样修正仍然数学上正确 —— 因为总存在一个等价的单一行为策略
- 系统设计自由度:有了这个保证,系统层面可以放心地在任意时刻中断生成、切换模型版本,而不需要担心破坏算法的理论基础
-
Asymmetric PPO
GiGPO
-
GRPO 在 Agentic RL 任务中,无法实现更细粒度的 step-level 的 advantage,那么如何在保证 GRPO 等算法的 critic-free、低显存、稳定的优点的前提下,实现这一点呢?
-
纯 group-based RL(如 GRPO)→ 只有 episode-level 信号,粒度太粗,收敛慢且易抖动
-
基于组的强化学习(group-based RL)要求在完全相同任务下进行 N 次 rollout,在环境初始状态一致、策略不成熟时,LLM Agent 会重复访问相同状态(如 WebShop 的同一搜索结果页、ALFWorld 的同一房间),这类状态被称为锚状态(anchor state)
-
通过事后聚合这些重复状态下的不同动作,构建步骤级(step-level)分组,在轨迹级(trajectory-level)比较之外,新增局部状态的优势估计,且几乎无额外计算开销
-
回合级优势(Episode-level Advantage)
- 与 GRPO 完全一致,在每个 rollout group 内比较完整轨迹的总回报,做组内归一化
- 评估整条轨迹的整体优劣,保留全局优化信号
-
步骤级优势(Step-level Advantage)
-
将同一锚状态 下的所有 action-reward 对用 hash 聚合为步骤级分组
-
计算每一步的折扣回报:
-
对步骤级分组做组内归一化,得到细粒度优势:
-
评估同一状态下不同动作的局部优劣,捕捉 GRPO 无法感知的细微差异
-
-
将两层优势加权融合,得到最终 GiGPO 优势:
- 默认 ,即轨迹级与步骤级优势权重相等,可根据任务信用分布调节
- 融合后的优势用于常规 clipped PPO + 目标函数,同时优化全局轨迹与局部动作
-
以 WebShop 任务为例,两条轨迹 (成功)和 (失败)共享同一锚状态(搜索结果页):
-
:先选错误商品(2nd Item)→ 返回上一页 → 选正确商品(1st Item)→ 任务成功。因折扣奖励,错误动作的折现回报低于后续正确动作。
-
:点击下一页(Next Page)→ 未找到目标 → 任务失败,无奖励
-
将三个动作按锚状态聚合后,GiGPO 计算相对优势,得到明确偏好排序:
-
该排序精准捕捉了动作在长期回报上的细微差异,而这类差异是 GRPO 等仅做轨迹级比较的方法无法感知的
-
该方法在稀疏奖励场景(如 WebShop)效果显著,也可自然扩展到密集奖励任务,充分利用逐步奖励评估动作质量
-
StarPO
Rollback-based Curriculum Learning
Agentic RL
-
什么是课程学习?
- 让模型从简单样本先学,再慢慢学难样本,而不是一上来就乱序全学
- 先学会基础,再学复杂,更容易收敛,避免一开始被难样本带偏,收敛更快、精度更高、更稳定,尤其对大模型、RL、Agent 非常有用
-
你所理解的 Agentic RL 是什么意思?和 RLHF、RLVR 有什么区别?什么场景下用 Agentic RL?
- RLHF 和 RLVR 本质上是单步上下文老虎机(in-context bandit),不是真正的马尔可夫决策过程(MDP)/ 序贯强化学习
- 传统 RLHF:退化单步 MDP(状态 = prompt,生成即结束)
- RLVR:推理 / 正确性优化,也是单步,每步内有多个推理步骤
- Agentic RL 更接近多步交互式 MDP 的设定:模型需要采取行动、观察环境反馈,并在稀疏且延迟的奖励信号下,对长程轨迹进行优化
- 这意味着模型不再只是 “给出一个答案”,而是要在不断变化的环境中持续决策和修正行为,并为最终结果负责
- 这也让应用场景从封闭、可验证的任务,扩展到诸如旅游规划、复杂数据分析等更为复杂的真实任务
- Agentic RL:多步 POMDP(状态动态转移、部分可观测、长期回报)
- 输入:历史 + 环境 + 记忆(部分可观测 POMDP)
- 动作空间:文本 + 工具调用 + 规划 + 记忆操作
- 奖励来源:环境反馈 + 任务成功 + 过程指标
- 优化目标:完成长期目标、规划、工具使用效率、稳定性
- RLHF 和 RLVR 本质上是单步上下文老虎机(in-context bandit),不是真正的马尔可夫决策过程(MDP)/ 序贯强化学习
-
Agentic RL 的训练 pipeline 是怎么样的?
-
环境构建 → 轨迹收集(Rollout)→ 轨迹打分与过滤 → 策略优化(PPO/GRPO)→ 反思 / 自修正增强 → 迭代蒸馏固化
-
环境与任务定义:把任务封装成一个可交互、可自动打分的环境(类似 Gym)
- 状态 state:对话历史 + 工具返回结果 + 记忆
- 动作 action:LLM 输出的文本 + 工具调用(如
Search(...)、Code(...)) - 环境 step:执行工具 → 返回新观测
- 奖励 reward:任务是否成功 + 步骤效率 + 合法性
-
策略初始化:Agent SFT
- 先用示范轨迹做监督微调,让 Agent 学会基本格式与流程
- 学会什么时候调用工具、调用什么、怎么解析返回
- 对应普通 LLM 的 SFT,但训练的是动作序列,不是单轮回答
-
轨迹 Rollout:多步交互采样
-
用当前 Agent 策略在环境里完整跑完一个任务,收集整条轨迹
s0: 用户问题 a0: LLM 决定搜索 → 调用 Search("xxx") o0: 环境返回搜索结果 s1: s0 + a0 + o0 a1: LLM 决定计算 → 调用 Calculator(1+1) o1: 返回 2 s2: s1 + a1 + o1 a2: LLM 给出最终答案 Done: 任务结束 -
收集一批轨迹
{τ₁, τ₂, ..., τ_N}
-
-
轨迹 Reward 设计与打分
- 任务成功奖励、中间过程奖励、效率奖励
-
策略优化
- 轨迹级 GRPO 训练
-
反思增强 + 迭代蒸馏
- 让 LLM 自己看失败轨迹,生成修正后的思考步骤 → 构造高质量修正轨迹
- 用 RL 策略生成大量轨迹 → 按奖励筛选 Top 20% → 再做一次 SFT,把优秀策略 “固化”
-
-
RL 训练的核心问题
- 如何从弱监督 reward 中得到样本权重?
- PPO:价值函数 value function
- GRPO:批次内估计优势函数 advantage
- 如何高效、准确获得 reward 信号?
- RLHF:可学习 RM
- DeepSeek 等:rule-based / 测试集通过率
- 生成与更新的交互节奏
- on-policy /off-policy
- 生成 N 条再更新 K 轮
- clip、ratio、batch size、epoch 本质都是控制节奏
- 数据分布和课程学习:何选题、排难度,决定学习效率
- Based 模型的能力:基础能力不够,RL 无法起效甚至直接崩
- 如何从弱监督 reward 中得到样本权重?
-
RL 训练不稳定的原因是什么?
- 训推不一致、分布式 rollout 等问题导致
- logprob 计算没对齐 temperature /top_p/top_k
- reward 从 0/1 变连续值后,过滤全零 / 全一样本不兼容
- rollout 出现多 `` 等特殊 token 未处理
- Megatron /vLLM/ SGLang 底层行为不一致、采样逻辑差异
- 数据干净程度差距极大
- SFT:多层规则过滤 + 模型打分 + 人工精修,数据分布可控
- RL:只靠 Reward Model 打分,复杂场景(数学 / COT)准确率通常 <90%,噪声大、信号弱、分布不可控
- 优化目标的问题
- 正样本:让模型强化高概率 token → 容易过拟合、模式崩塌
- 负样本:把概率分给其他 token → 破坏原有语言分布,极易训崩
- 训推不一致、分布式 rollout 等问题导致
-
有什么办法可以去稳定 RL 训练?
- Entropy loss:控制熵崩,但效果黑盒
- KL loss:约束与 SFT 模型距离
- Clip 策略:PPO/GRPO 核心,但实际效果一般
- Token mask:对高低熵 token 做掩码 / 加权
- Off-policy 修正:解决分布偏移
- Reward Shaping 实用手段
- 控制 reward 0/1 分布比例
- pass@K 替代 pass@1
- 用 test case 通过率做 reward
- length penalty 等规则
- 训推一致性(Tis、IcePop)
- logprob、采样、分布式、流水并行必须完全对齐
- 所有技巧的本质都是调整数据分布,优先分析 rollout 的数据分布大于堆叠技巧
- 很多时候,技巧反而会掩盖问题,而不是解决根源;如果某种技巧起了作用,可以反推哪种分布对学习友好 / 有害
- 引入训练技巧必然会引起训练数据分布的变化,有些分布的变化是在预期之内的,有些分布的变化则是预期之外且不知情的
- 例如,CISPO 提出被 clip 的 token 可能概率低但对 COT 关键,只看概率会得出错误结论
-
什么是熵崩溃(entropy collapse)?为什么会有熵崩溃?如何避免熵崩溃?为什么 Policy entropy 是一个很重要的因素?
- 什么是熵崩溃
- 策略熵 快速下降趋近于 0,模型变得几乎确定性、单一化、无多样性
- 在熵崩溃时,模型放弃探索,只输出 “最安全、最高奖励” 的固定模板
- 为什么会有熵崩溃
- 策略梯度天然就是倾向于变得更确定,长期下来,分布自然越来越尖锐、熵越来越低
- 奖励模型(RM)或工具奖励不是全局完美的,模型可能会发现这种漏洞,迅速收敛到单一模式,熵直接塌缩
- 没有足够强的探索约束,如果没有熵正则或者 KL 约束太弱,也很容易坍缩
- 如何避免熵崩溃
- 熵正则:鼓励分布更均匀,保持探索
- clamped entropy:不让熵低于阈值,强制保留随机性
- 增加训练的多样性和奖励函数的无偏性质
- Clip Higher:提升所有 token 的裁剪上限,鼓励关键低概率 token 的概率提升
- 什么是熵崩溃
-
熵崩溃和 reward hacking 有什么关系?
- 熵崩溃几乎必然导致 reward hacking,reward hacking 也会进一步加速熵崩溃
- 模型坍缩之后,只学 “看起来奖励高” 的表面模式,不学真正的任务逻辑
- 而一旦模型发现 “作弊句式奖励极高”,会更极端地集中概率,熵进一步下降
- 两者都是模型放弃学习真实任务,转而利用捷径最大化表面奖励,熵崩溃是分布层面的,而 reward hacking 是行为层面的
-
什么是 clamped entropy,一般怎么设置?
- clamped entropy = 带截断 / 下限的策略熵
- 不让熵低于某个最小值,防止模型变得过于 “贪心、确定、没多样性”
-
Agentic RL 中怎么控制探索参数?
- 模型的能力提升程度与熵的大小成正比,随着训练过程的推进,熵越来越小,此时模型的性能提升也越来越小
- 随着模型趋向高质量模式,将提高采样温度以鼓励进一步探索
- 衰减 temperature:初期高探索 → 中期线性衰减 → 后期低探索
- 前期: Agent 策略很差,必须高探索试错
- 后期:策略基本成型,需要低温度稳定输出、稳定工具调用
- 根据 loss 曲线,loss 不再降低 / 指标不再提升,就临时提高探索
- 监控平均轨迹奖励、任务成功率、验证集轨迹表现
- 只要连续 N 个 epoch 不再提升,就判定进入平台期
-
Agentic RL 怎么做更细粒度的信用分配与奖励建模
- 与 RLVR 相比,Agentic RL 天然具备更细粒度的信用分配与奖励建模能力
- 在工具调用、多步推理与环境交互中,模型可获得丰富的中间监督信号,包括工具执行成败、子任务完成度、中间状态合法性、环境转移一致性等 —— 这些时序信号为逐步决策与长期 credit assignment 提供了 RLVR 所不具备的监督基础
- 但这并不意味着依赖人工设计的稠密奖励规则(如对工具执行失败固定惩罚 −0.5、对子任务设置硬阈值奖励)是一种可扩展、可泛化的解决方案
- 奖励函数易出现 reward hacking 与分布偏移
- 跨任务泛化性差,需要针对领域重新设计
- 难以覆盖复杂推理链中的隐性因果关系
- 本质仍是启发式,而非从数据与交互中自动学习目标
- Agentic RL 的核心挑战并非 “增加更多中间奖励”,而是在不依赖人工稠密奖励的前提下,从交互轨迹中自动学习细粒度价值与信用分配
项目细节
-
为什么 workflow 不好,为什么不用监督微调,为什么必须要用 agentic rl?
- 静态 Workflow 就是固定流程、固定工具调用顺序、硬编码判断条件
- 泛化性差:只能处理预设场景,海况、设备状态、任务目标一变就失效
- 鲁棒性差:多跳复杂任务(故障→定位→分析→决策)容易中断
- 比如:困难多跳问题准确率只有 71.69%,就是静态 Workflow 的瓶颈
- SFT 是学 “标准答案”,不是学 “决策能力”
- 没有完美标注数据:深远海船舶任务没有统一 “最优步骤”,只有更优策略,SFT 学不到最优决策
- SFT 只会模仿,不会推理:只能复现见过的轨迹,不会动态修正、不会重试、不会权衡
- 无法优化效率指标:SFT 不能控制模型的工具调用次数,成功率与成本的 trade-off
- 为什么必须用 Agentic RL?
- 这里变成了一个序列决策问题,会根据环境反馈实时调整步骤,自适应强
- 通过设计的奖励函数,RL 会自动学习最少步骤、最高成功率的路径
- 在多跳困难任务上,Agentic RL 效果更好
- 静态 Workflow 就是固定流程、固定工具调用顺序、硬编码判断条件
-
你这个微调后的 Qwen3 8B 相比 GLM-4.5 这么厉害吗?有没有测试过没有微调过的 Qwen3-8B 效果怎么样?
- 做过消融实验 Qwen3-8B,在简单任务上准确率还可以,但是在很多步的任务上效果就不好了;而且有时候工具调用的格式很容易出错,甚至我们之前的 workflow 方案调用 GLM 的时候也会出现调用格式出错的问题
-
计算 logprob 时,是否要把 rollout 用的 temperature、top_p、top_k 作用到 logits 上?
- temperature /top_p/top_k 是采样策略,只决定选哪个 token,不改变模型真实概率分布
- logprob 必须严格对应模型原始分布,否则会出现 policy 偏离真实分布
-
GRPO 的 Rollout 采样温度设置?
- Polaris 的经验
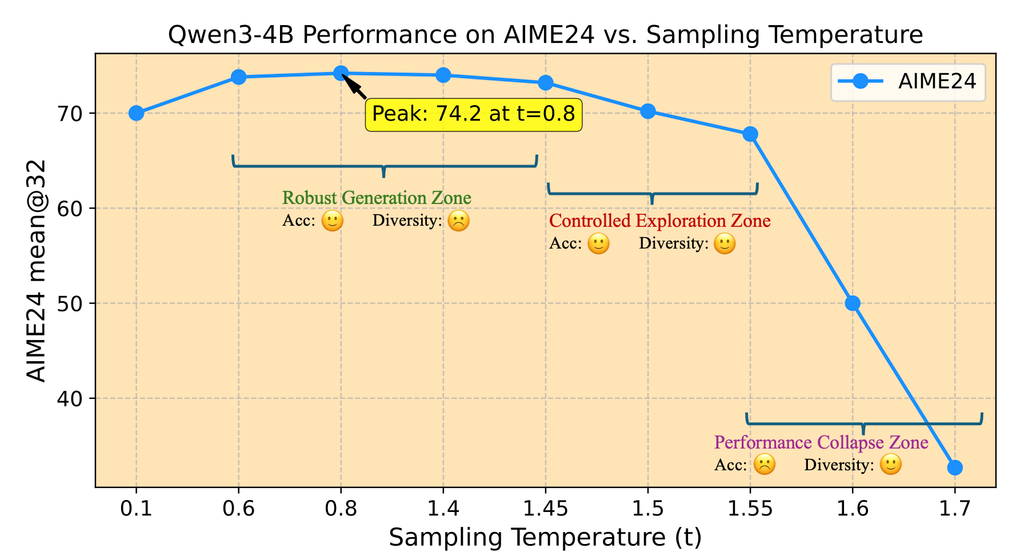
- 训练初期,从 CEZ 区域初始化,并随着训练阶段的进行,逐步提升温度,以保证一定的探索
-
数据飞轮和 agentic rl 怎么结合起来,怎么处理这种 off-policy 的数据?
-
训练中一般监控什么指标
- reward:episode reward, mean reward, clipped reward
- advantage:mean, std, normalize 情况
- loss:policy loss, value loss, total loss
- entropy 熵:policy entropy(判断探索是否足够)
- kl 散度:
kl(current, old)或kl(ref, current) - gradient:gradient、clipped gradient、梯度范数、NAN/INF 次数
- 学习率:lr 衰减曲线
- clip:clip threshold 触发次数; 健康指标应在 0.5–2.0 之间,偏离太大 = 训练崩溃;clip fraction(被 clip 条件触发的样本比例)
- GRPO:每组正确的占比、错误的占比
- 业务相关:任务完成率、答案正确率、工具调用成功率、任务执行步数(Episode Length)
- response 相关:response 长度,正误比例,组内 response 差距,
-
训练中的一些超参数怎么设置的
- 学习率
- RL 梯度通常比监督学习噪声更大,因此更小的学习率,配合更强的约束、退火或自适应机制,往往更稳定
- 训练时采用 cosine 余弦退火策略,warmup_steps 设置为 200,最小学习率为 1e-7,lr 初始为 1e-6
- 温度
- top_p=1,top_k=-1:不做采样限制,完全按照原始概率分布采样
- 熵正则系数
- rollout
- rollout_batch_size
- num_return_sequences_in_group
- response_length:8192
- KL 散度系数
- init_kl_coef:KL 惩罚的初始系数
- target_kl:自适应 KL 控制的目标 KL 值
- lora 的 rank
- rank 越大 → 参数量越大 → 拟合能力越强 → 但越容易过拟合、训练越慢
- rank 越小 → 越轻量 → 越稳定 → 但表达能力有限
- rank 越大,梯度累积越大,lr 必须降,否则训练震荡
- 具体使用的是 16,而对应的 alpha 控制 LoRA 对原模型的修改强度,我按照默认设置等于 rank
- alpha 是对 LoRA 矩阵做固定缩放,会缩放模型输出,决定每一步训练,LoRA 能修改原模型多少,是结构系数,和梯度无关
- 学习率则控制梯度更新幅度,与模型结构无关,可以随着 scheduler bian'h
- 学习率
-
如果 loss 一直不下降怎么办?
- loss 不下降就说明模型没有学习到有效的东西,
-
如果 loss 突然出现尖峰怎么办?
- 说明发生了梯度爆炸或者 batch 中有脏数据,对于 RL 而言,则还可能是 logprob 比值很大
- grad_norm 一般指所有参数梯度的 L2 范数,用来衡量梯度整体大小,监控是否梯度消失或爆炸。LLM 和 RL 训练中通常控制在 1~10 比较健康
- 降低学习率或者进行梯度裁剪
-
如果梯度出现了 NAN 问题怎么办?
- NaN 三大来源:log (0)、除 0、梯度炸
-
训练中遇到过了什么问题?
- 训练初期
- 模型不能很好地调用工具,而且没有办法完整的跑出来一个 rollout —— SFT 微调
- 初期学习率太高,模型很快就达到高概率模式,熵快速下降,收敛到了局部最优模式 —— 调低学习率
- 课程学习:先让模型学习单跳问题,再逐步扩展至多步复杂问题
- 信用分配问题
- GRPO 在面对多目标奖励时,最简单地做法是把奖励加和作为整个轨迹的奖励,无法区分局部正确和全局正确,也无法识别关键的步骤
- 引入 GiGPO
- 训练稳定性问题
- reward
- nan 问题
- 工程问题
- OOM
- 训练效率问题
- 训练初期
-
你怎么判断是否出现了 reward hacking,如何解决?
- reward hacking 的本质是:模型优化的是奖励函数,而不是我们真正想要的目标,当奖励函数与真实目标不完全一致时,模型会利用其中的漏洞最大化 reward,而不是完成真实任务
- 在我的场景中,如果只奖励 “少调用工具”,模型可能会选择不调用工具但输出错误答案,从而获得更高的 efficiency reward,这就是典型的 reward hacking
- 本质上是 objective mismatch(目标错位)问题
- 相关现象
- 平均 reward 持续上升,但是任务成功率(success rate)停滞 / 下降
- 策略与参考模型 KL 急剧上升,或者熵越来越低
- 工具过度使用:反复调用工具完成一些简单或琐碎的操作,本质上是在进行暴力重试
- 工具行为异常,调用正确,但是工具调用完全无关
- 跟踪训练信号
- 不同任务的成功率趋势
- 不同工具的成功 / 失败率
- 重复或循环的工具调用模式
- 不同工具使用频率
- 不同命令使用频率
- 相应地,可以加强 KL 惩罚;重构奖励函数(削弱过程奖励,给无效行为加惩罚,限制轨迹长度)
-
GRPO 在 Agentic RL 场景下,如何设计针对过程打分(从 Reasoning 过程和 Action 一起分析)
-
针对 Agent 行为打分,在反向传播的时候,具体到 token 的分数是怎么计算的?
-
rollout 数据和训练数据分布不一致怎么办?
-
on-policy vs off-policy 在你系统里如何体现?
RL Infra
- RL 训练中,为什么要做异步训练推理?
- 训练集群更依赖算力、高带宽、强通信;而 Rollout 更依赖显存、低算力、高延迟
- 如果串行等待
生成 → 奖励 → 训练 → 等待 → 再生产则训练必须等生成完,生成必须等训练更新权重,两个集群都产生大量气泡 - 对于大规模训练而言,模型越大(70B+/400B+),单步越久,只有异步流水线 + 多集群 rollout 才能撑起样本吞吐量
- 异步训练为什么会导致 policy collapse?
- 最核心的原因是 Off-policy 数据分布偏移,因为 rollout 用的是旧策略,而训练已经更新成新策略,导致数据分布不一致,重要性采样失真
- 此外,推理和训练两侧框架不同,算子精度不同,也会导致一定的分布偏移
- 为了缓解这个问题
- 控制 staleness(滞后步数),限制 rollout 权重版本与训练版本差距 ≤ 1~3 步
- 降低更新步长 / 学习率,从而让 policy 变化更平缓,使得 off-policy 能够被容忍
- Decoupled PPO 实现 True On-Policy PPO 训练
- GRPO 中 rollout 过程的长尾问题,导致 GPU 利用率低,有什么工程上的解决方案?
- Agentic RL 具有明显的长尾延迟(long-tail latency)特性,即同一个 batch 中,大多数 rollout 能够快速完成,但少数 rollout 由于生成文本较长或缓慢的环境交互而耗时较长,从而导致大量 GPU 空转
- 主要原因是
- 同步机制限制:受严格 on-policy 要求约束,需等所有 rollout 请求全部完成,才能进入后续训练阶段,单个慢任务会阻塞整个流程
- 长尾任务拖累:不同任务、同一任务内的 decode length 差异显著,部分 worker 完成短任务后空等,GPU 资源无法充分利用,且多任务数据量越大,阻塞越明显
- 任务调度隔离:现有 data parallelism 架构下,rollout worker 各自处理分配到的请求,无跨 worker 调度机制,任务分配后无法调整,进一步加剧阻塞
- 路由策略缺陷:主流 prefix maximum 路由策略,为节省 prefill 开销,将相似前缀任务分配至同一 worker,而相似前缀任务更易同为长解码任务,导致长解码任务集中,加重长尾阻塞问题
- 在 ROLL 的实现中,构建了一套完全异步的训练管线
- 环境级异步 rollout:将 rollout 中的 LLM 生成、环境交互与奖励计算拆解独立,互不阻塞,实现更细粒度的执行调度
- 冗余并行环境:通过增加环境组数量与组大小,避免 fail-slow 或 fail-stop 环境成为系统瓶颈
- 异步训练机制:在不同设备上解耦 rollout 与训练阶段,使其并行推进
- Train–rollout 复用机制:根据当前瓶颈在 Rollout 与训练间动态重分配 GPU,优先保障关键路径
- kimi 的 partial rollout 原理
- Partial Rollout 是解决多任务 PPO Rollout 阶段长尾阻塞、GPU 空转、资源利用率低的关键优化方案
- 适度放宽严格 on-policy 约束,不再等待全部请求完成,优先使用已完成样本进行训练,未完成样本延后处理
- 流程
- 超发采样:每次启动多于实际训练所需的请求(如需要 128 个样本,同时启动 512 路推理)
- 早停训练:收集到足够完成样本后立即进入训练,不等待全部
- 未完成样本处理:
- 继续用旧 policy 异步生成,后续迭代加入训练;
- 或中止缓存,后续迭代恢复 / 重跑
- Partial Rollout 必然引入 off-policy 数据:
- 未完成样本若沿用旧 policy 生成 → 数据跨多个 policy 版本,策略不一致
- 若丢弃未完成样本、用新 policy 重跑 → 保证 on-policy,但浪费算力
- 与 Gradient Accumulation 的区别
- Gradient Accumulation 只解决 batch 太大 OOM 的问题,不解决等待样本生成太慢的问题
- 它仍需等待当前迭代全部样本完成,无法消除长尾阻塞,且频繁切 Rollout/Training 会增加额外开销,对长尾问题意义有限
On-Policy Distillation
-
知识蒸馏的目标是让学生策略 学习教师策略 的行为分布
-
蒸馏目标中采用的 KL 散度形式与采样分布,会显著影响学生的最终表现和 exposure bias
-
监督微调(Forward KL)
-
在教师模型生成的数据上最大化对数似然,即 SFT,这等价于最小化二者之间的 Forward KL
-
倾向于模仿教师的平均行为,可能导致学生过于保守,缺乏探索性,且在训练过程中暴露于教师分布之外的状态时表现不佳
-
在 Off-Policy 数据上训练会产生 exposure bias:训练时是教师前缀,推理时是学生自回归前缀,导致分布不匹配,性能下降;对于长推理模型这个问题有位明显
-
-
On-Policy Distillation(Reverse KL)
-
在学生自采样的数据上最大化对数似然,即在学生生成的前缀上模仿教师的行为,这等价于最小化二者之间的 Reverse KL
-
最小化 Reverse KL 可视为一种 REINFORCE:奖励是教师与学生概率的对数比,在采用 GRPO 框架时优化目标可以写成
-
其中,奖励为 ;这会提升教师偏好 token 的概率,并抑制教师认为不合理的 token
-