RAG
介绍检索增强生成(RAG,Retrieval-Augmented Generation)的基本原理及其在大规模语言模型中的应用方法
- 参考资料
- 帖子
- Next-Gen Large Language Models: The Retrieval-Augmented Generation (RAG) Handbook
- Andrew-Jang/RAGHub: A community-driven collection of RAG (Retrieval-Augmented Generation) frameworks, projects, and resources. Contribute and explore the evolving RAG ecosystem.
- A Practical Approach to Retrieval Augmented Generation Systems
- 论文
- 帖子
什么是 RAG
-
RAG(Retrieval-Augmented Generation)首次由 Meta 团队在论文 Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks 提出,此后成为解决知识密集型 NLP 任务的关键方案
-
RAG 结合生成式 AI 与检索技术,在生成响应前新增 “从外部源(数据库、文档、网页)检索信息” 的步骤,突破传统 LLM 依赖静态训练数据的局限,可获取实时、精准信息
-
RAG 核心价值:解决幻觉、知识更新、领域适配、可追溯性问题
-
RAG 的组件构成:
组件名称 核心功能 关键技术 / 作用 数据处理(Data Process) 分块(Chunking) 嵌入(Embedding) 检索(Retrieval) 从文档库 / 数据库中搜索、筛选与用户查询相关的信息 文档索引、查询扩展、结果排序 生成(Generation) 基于检索到的信息,生成连贯、准确的类人文本 依赖 GPT-3 等 LLM,将检索事实转化为可读答案 交互循环(Interaction Loop) 实现检索与生成的迭代优化 若初始响应不完整,生成组件可基于检索结果二次查询,优化答案 微调(Fine-Tuning) 适配特定领域需求 用领域数据微调 LLM,提升领域内响应质量(如法律、医疗场景) -
RAG 的总体框架
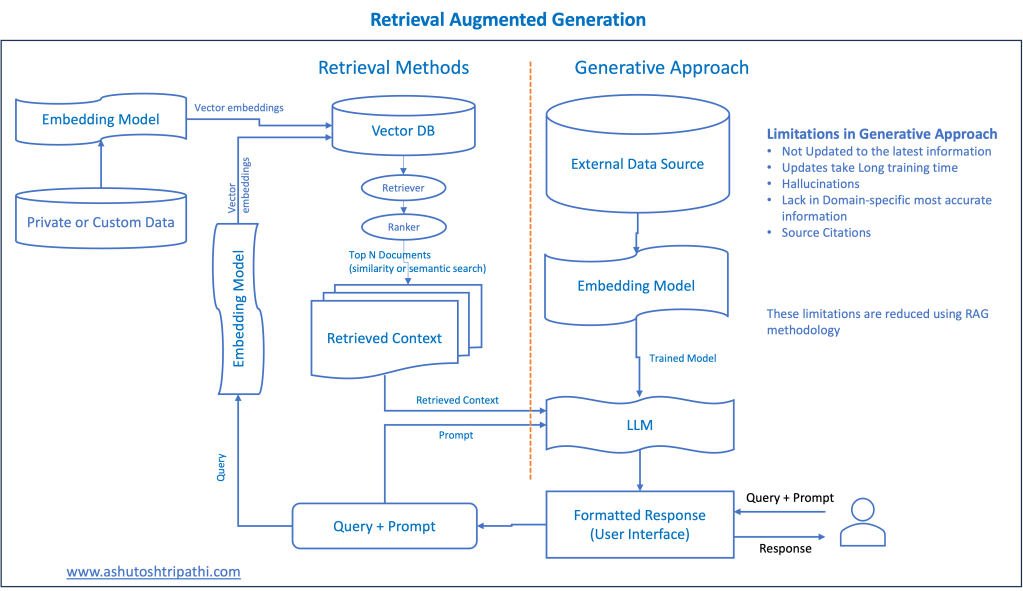
-
下图展示了检索和生成两大模块
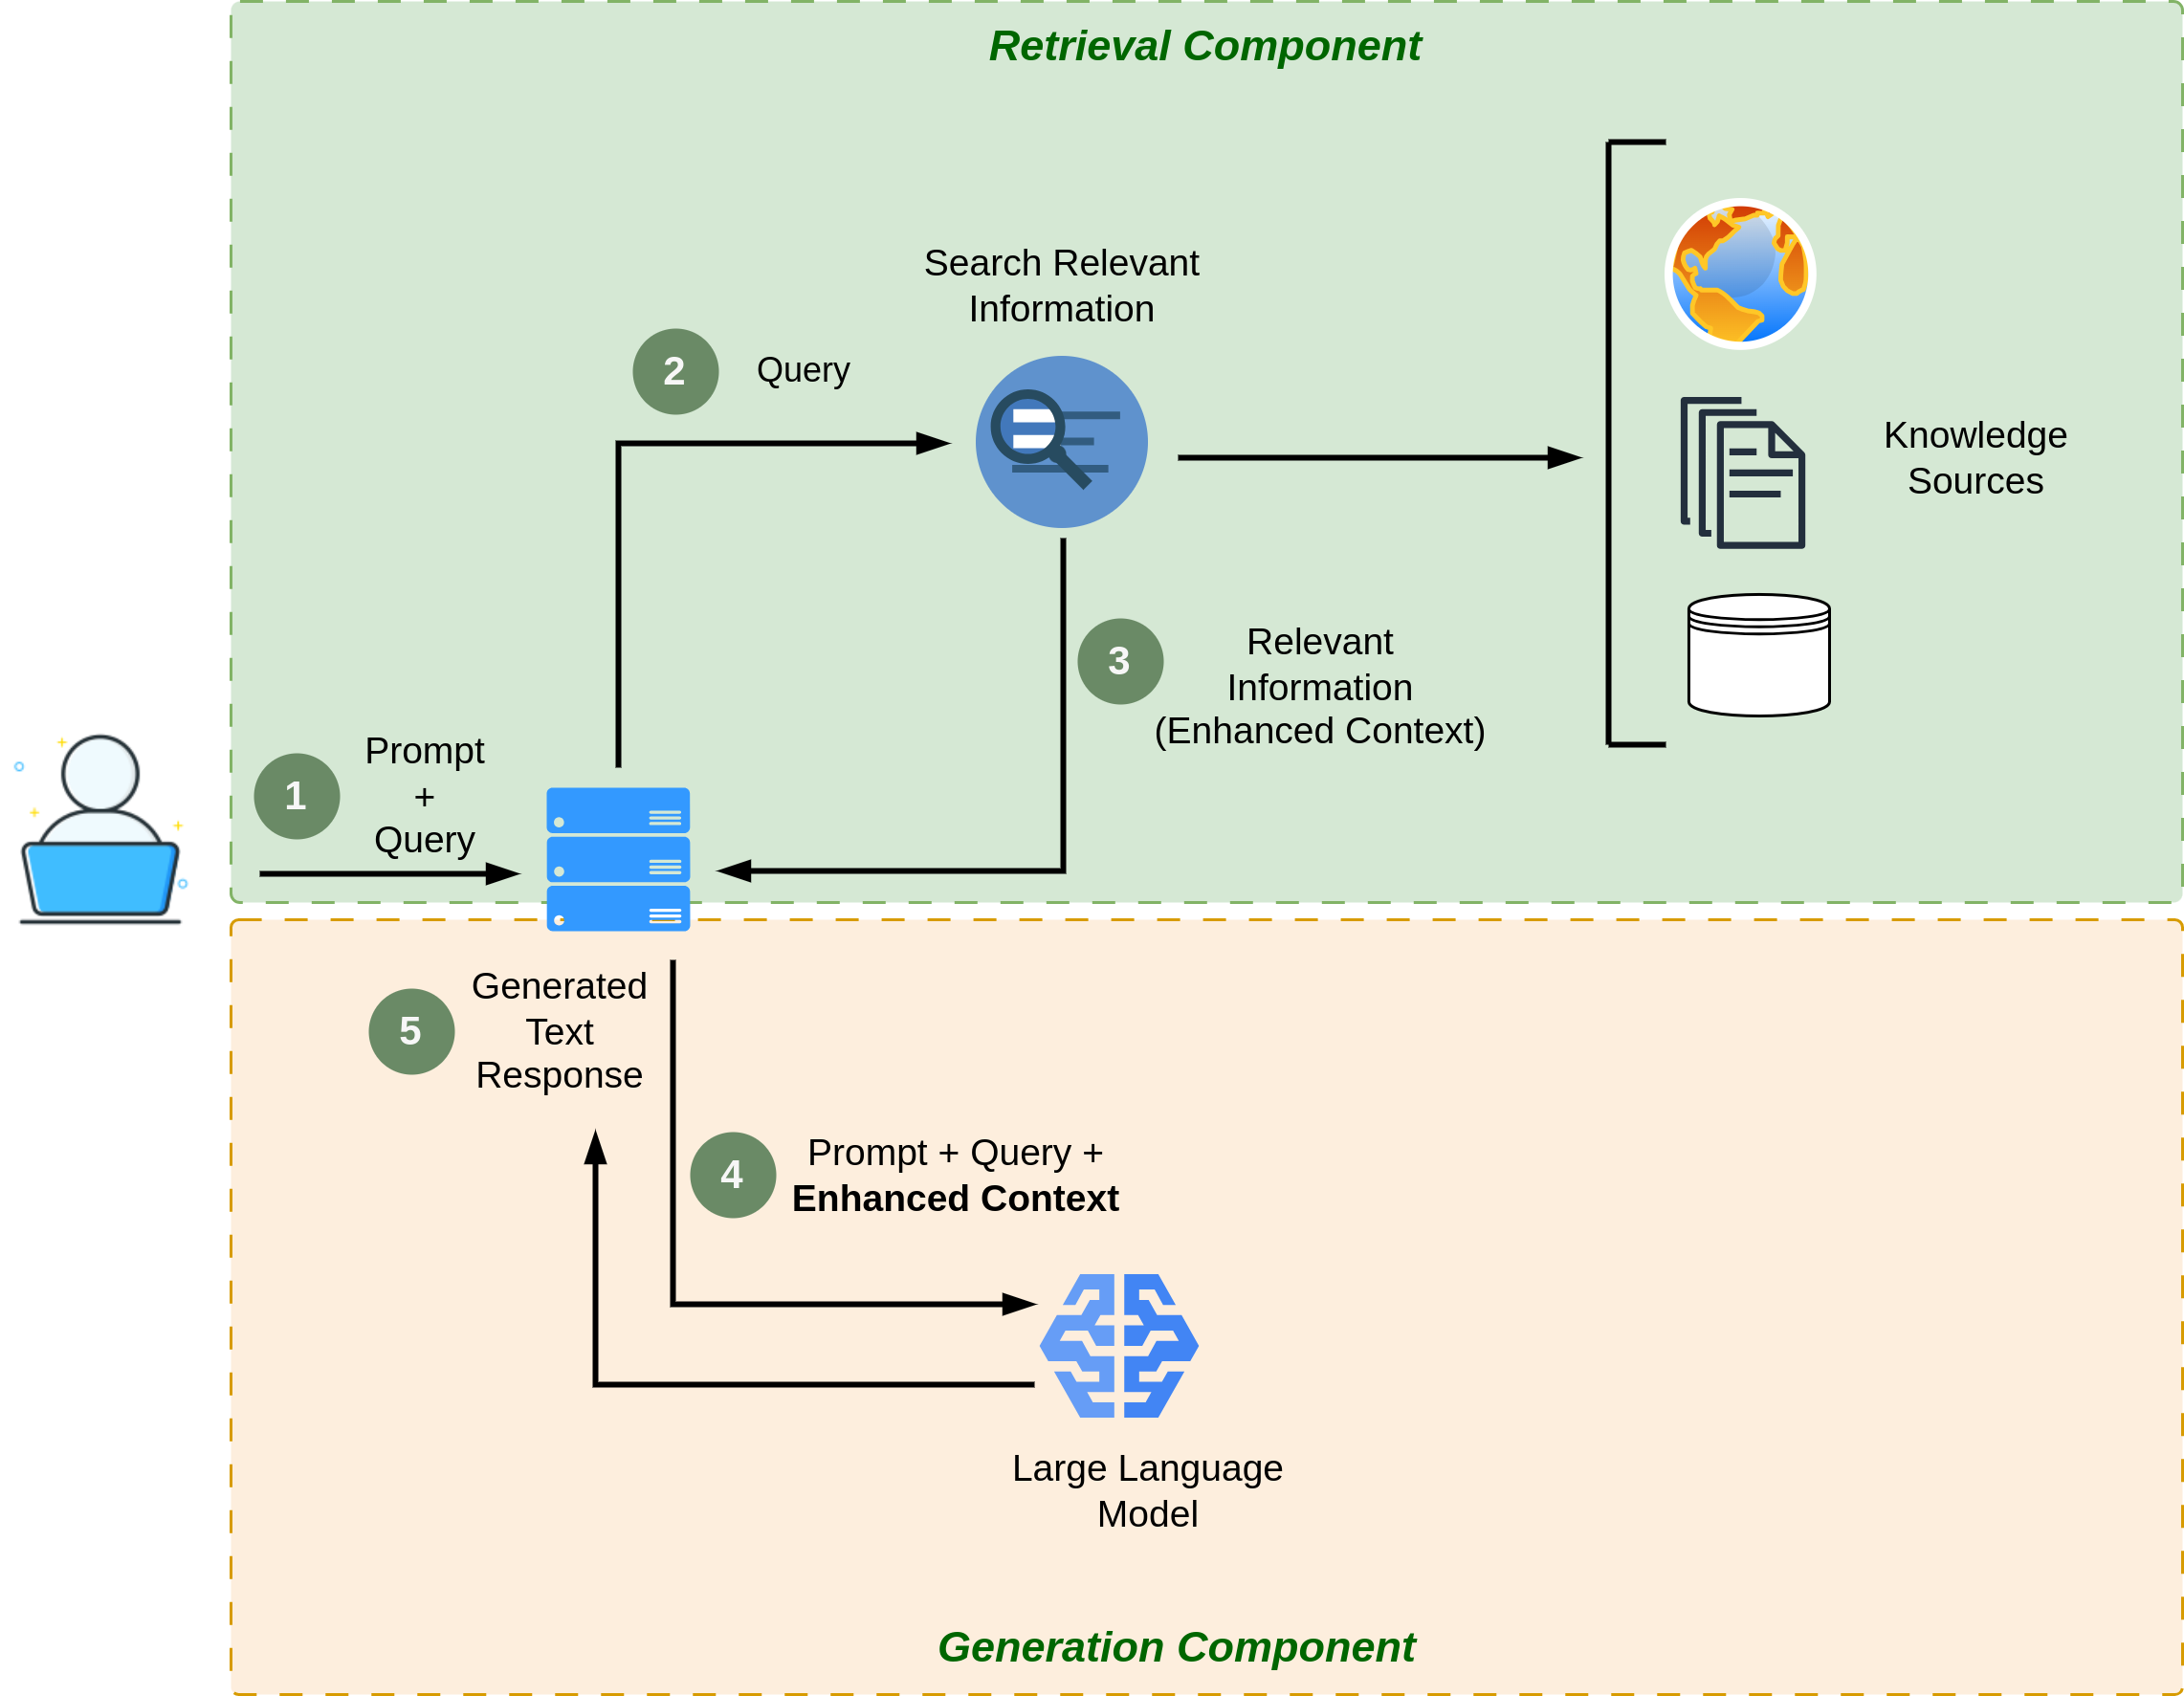
- 检索模型:从海量数据(文档、数据库、文章)中识别与查询相关的段落或文档,是信息获取的核心
- 生成模型:基于检索到的信息生成上下文丰富的响应,通常以 GPT 等 LLM 为基础
-
嵌入与向量数据库
- 向量嵌入:文本的数值化表示,将文本(单词、句子、文档)转化为高维向量,使语义相似的文本在向量空间中距离更近
- 单词嵌入(Word2Vec、GloVe):适用于单个单词的语义匹配
- 文档嵌入(Doc2Vec、BERT):适用于 PDF 等整文档的检索,可匹配主题相似的文档
- 向量数据库:高效检索的关键,专门存储向量嵌入,通过高效相似度搜索(如近似最近邻 ANN 算法)快速定位相关信息
- 主流向量数据库:Qdrant、Weaviate、Pinecone、pgvector、Milvus、Chroma
- 在选择向量数据库时,应关注检索速度、可扩展性、成本
- 向量嵌入:文本的数值化表示,将文本(单词、句子、文档)转化为高维向量,使语义相似的文本在向量空间中距离更近
-
RAG 数据处理流程
- 核心目标:对 PDF 等原始文档进行预处理,构建结构化、可搜索的索引,为检索提供高质量数据基础
- 关键步骤:文档预处理(如 PDF 文本提取、清洗)、向量嵌入生成、向量存储(存入向量数据库)
Naive RAG
Naive RAG 工作流程:Query->Retriever->Context->Generator (LLM)
- 主要缺点
- 嵌入向量可能无法精准反映语义
- 检索到的低质量分块可能与上下文脱节,导致回答不可靠
- 单一类型数据库难以捕捉复杂关联的相关上下文
- 顶级检索文档信息多样性不足
- 多检索段落中难以定位准确信息,增加对增强信息的依赖风险
Chunking
文档处理
- 文档解析:将 TXT、PDF、Markdown、HTML 以及多模态文档统一解析为可处理的文本或结构化表示
- 结构恢复:尽量保留章节、标题和层级信息,为后续分块与检索提供语义线索
分块策略
-
分块(Chunking)并不只是为了应对模型上下文长度受限而采取的权宜之计,它本身是一种提升 RAG 系统整体质量与准确性的基础手段
-
通过将文档拆解为语义相对完整、规模适中的片段,可以显著提高检索阶段命中关键信息的概率,使召回的内容更贴近回答 Query 所真正需要的上下文
-
固定大小分块
- 按字符切割:实现简单,但容易打断单词或句子,破坏边界处的语义连续性
- 按 token 切割:需要配合分词器(通常与嵌入模型或下游 LLM 一致),虽然避免了单词被拆分,但仍可能在句子或逻辑边界处中断语义
-
分块重叠(overlap)—— 滑动窗口分块
- 完全不重叠的分块容易丢失跨边界的上下文信息
- 通过在相邻分块之间引入重叠,可以让边界附近的语义至少在一个分块中完整保留
- 例如,分块大小为 512 token,重叠 50 token,相邻分块在边界处共享一小段内容,从而提升检索命中相关信息的概率
-
分块大小(chunk_size)与重叠量(chunk_overlap)的选择
- 分块过小,上下文不足,嵌入表示和生成效果都会受限;分块过大,则可能稀释关键信息,并增加超出 LLM 上下文窗口的风险
- 重叠过小难以保留连续语义,过大会带来明显的数据冗余和额外计算开销
- 实践中常见的分块大小在 256–1024 token 之间,重叠量通常取分块大小的 10%–20%,具体仍需结合文档特性和模型能力调优
-
语义感知分块
-
按段落或章节切分
-
通常是一个不错的起点,因为它遵循了作者原本的结构和主题组织方式
-
但现实中的段落长度差异很大:有些段落仍然可能过长,超出嵌入模型或 LLM 的合理输入范围;也有些段落非常短,单独作为分块时信息密度不足
-
-
句子级切分
-
在语义上最为完整,每个分块内部高度连贯
-
不过,单个句子往往缺少足够的上下文,单独检索时信息可能不够充分
-
实践中常见的做法是将若干相邻句子合并为一个分块,或在句子级切分的基础上引入重叠,以兼顾连贯性和上下文完整性
-
-
递归分割策略
- 通过一组按优先级排序的分隔符逐步细化分块
- 首先尝试使用高层级分隔符(如段落分隔符)进行切分;如果得到的分块仍然过大,再对这些分块应用次一级分隔符(如句子边界),以此递进,常见的分隔符列表包括
["\n\n", "\n", ". ", " ", ""] - 这种方法的目标是在满足长度约束的前提下,尽量保留较大的语义单元
- LangChain 等框架中已经提供了现成实现,例如
RecursiveCharacterTextSplitter
-
-
基于嵌入的分块
- 先通过其他分块技术拆分文本,再将每个块输入嵌入模型生成密集向量,计算相邻块的语义相似度(如余弦相似度);如果相似度超过阈值,则将块合并
- 基于语义拆分,能够捕捉文本中复杂关联,优于简单固定长度或标点分块,能提升问答、摘要、情感分析等任务的性能
- 依赖嵌入模型,计算复杂度高(尤其处理大规模文本时),效果受嵌入模型训练数据质量影响显著
- 适用场景:对语义关联性要求高的任务,如深度问答、语义检索
-
基于 NSP 的分块
- NSP(Next Sentence Prediction,下一句预测)并非直接分块技术,而是通过训练 NSP 模型(或使用预训练 BERT 模型)预测句子间拆分是否为 “自然延续点”,以辅助分块决策
- 考虑句子间语义流,上下文感知能力强,可基于不同文本数据训练,适配不同写作风格和领域知识
- 训练高质量 NSP 模型需大量文本数据,资源消耗大;每个候选拆分均需运行 NSP 模型,增加计算开销,存在 “精度 — 效率” 权衡(复杂模型精度高但耗资源)
- 适用场景:对文本语义连贯性要求极高的场景,如专业文档(论文、报告)分块
-
可选的细粒度策略
- 在对事实精度要求极高的场景下,可以进一步拆解为命题或原子事实级别的分块
- 实际系统中,分块策略往往需要结合真实查询效果不断调整,而不是一次性定型
- 理想值取决于具体文档(平均句子长度、段落结构)、所用的嵌入模型(其合适的输入长度)以及 LLM 的上下文窗口大小
文档增强
-
元数据提取:为每个文本片段补充标题、章节层级路径、来源文件等信息,这些结构化元数据有助于后续的检索过滤、结果解释与来源追溯
-
文档内容增强:自动生成摘要,压缩长文档或章节的核心信息;提取关键词或关键短语,强化语义信号;在必要时补全定义或背景说明,降低片段被单独使用时的理解成本
-
多模态处理:将图像、表格、公式等多模态内容转换为文本描述或直接生成多模态 embedding,使其能够参与统一的相似度检索流程
元数据关联
-
在完成文档加载和分块之后,每个文本块本身往往已经脱离了原始语境。如果只看到一个孤立的句子,却不知道它来自哪份文档、哪一页或哪一章节,其价值会大打折扣。因此,在 RAG 场景中,为每个数据块关联元数据几乎是必不可少的一步
-
在这里,元数据指的是附加在数据块上的结构化信息,它不属于核心文本内容,而是用于描述 “这个文本从哪里来、具有什么属性”。可以将其理解为给每个文本片段打上的标签,为后续检索和使用提供必要的背景
-
在分块阶段附加元数据,直接支撑了 RAG 系统的多项关键能力:
- 来源归属:检索到的数据块可以被准确追溯到原始文档,这对于核实生成结果、增强用户信任,以及在需要引用来源的场景中尤为重要,例如明确指出答案来自哪份文档、哪一页
- 检索过滤与增强:虽然检索的核心仍然是向量相似度,但元数据可以作为强有力的辅助条件,用于预过滤或后过滤搜索空间。例如,只在最近一年更新的文档中检索,或仅关注某一类文档中的内容,从而提高相关性与效率
- 调试与系统分析:当 RAG 系统给出错误或无关的回答时,元数据是定位问题的重要线索。通过查看检索到的数据块来源,可以判断是否命中了不相关或过期的文档,从而帮助分析检索阶段的问题
- 上下文补充:即便 LLM 主要依赖文本本身,知道一个分块来自 “文档 A 的引言部分” 还是 “文档 B 的高级示例章节”,有时也能为理解和使用结果提供额外背景
-
实践中常见且有价值的元数据字段包括:
source或file_path:原始文件名或路径,用于明确来源document_id:原始文档的唯一标识,适用于文件名可能变化的情况page_number:页码信息,尤其适合 PDF 等强依赖页结构的文档chunk_id或chunk_seq_num:数据块在文档中的顺序位置,有助于理解上下文连续性section或header:章节或标题信息,依赖于文档结构解析creation_date或last_modified:时间戳字段,便于按时效性筛选
-
在存储层面,元数据通常不会直接混入文本内容中,否则会干扰嵌入模型对语义的建模;而更常见的做法是在生成向量嵌入的同时,将元数据作为独立字段,与向量一同写入向量数据库
-
大多数向量数据库都支持这种设计:每条向量记录除了高维向量本身,还可以附带一个元数据字典;在进行相似度搜索时,距离计算只基于向量,而元数据则用于过滤、排序或结果解释
-
一个典型的、写入向量数据库前的数据结构示例如下:
# 插入向量数据库前的数据结构示例 chunk_data = { "vector_id": "chunk_abc_doc1_p3_001", # 数据块的唯一 ID "embedding": [0.123, -0.045, ..., 0.912], # 文本嵌入向量 "text_content": "The core component responsible for finding relevant information is the retriever...", "metadata": { "source": "internal_docs/rag_architecture_v1.pdf", "page_number": 3, "document_id": "doc_rag_arch_v1", "chunk_seq_num": 1, "last_modified": "2023-10-26T10:00:00Z" } } -
当检索器基于查询向量执行相似度搜索时,向量数据库会同时返回匹配的数据块及其元数据。这种 “文本内容 + 来源上下文” 的组合,随后被送入 RAG 流程的下一阶段,用于生成更加可靠、可追溯的回答
Embedding 模型
- 将完成处理、分块与增强的内容进一步向量化,是构建高质量检索系统的核心阶段之一
- 这一阶段的目标,并不仅是 “把文本变成向量”,而是为同一份内容建立多种互补的表示与索引方式,使系统能够同时应对语义型查询、精确型查询以及结构化约束条件
- 索引与表示形式
- 向量索引(Embedding)
- 基于语义相似度进行检索,是 RAG 系统中最关键的召回机制
- 通过向量距离度量(如余弦相似度、点积)判断查询与文档片段的语义相关性
- 通常配合 ANN 索引结构,在大规模语料下实现低延迟检索
- 关键词索引(如 BM25)
- 基于词项匹配和统计权重的传统信息检索方法
- 对专有名词、代码标识符、数字、精确短语等非常敏感
- 常作为向量检索的补充,用于提高精确命中率和可控性
- 可选的结构化表示
- 例如图结构或知识图谱,用于显式表达实体、属性与关系
- 更适合需要逻辑推理、关系约束或可解释性的场景
- 向量索引(Embedding)
- 向量嵌入的基本原理
- 向量嵌入是一种将离散的自然语言文本映射到连续高维向量空间的表示方法
- 嵌入模型通过训练,使语义相近的文本在向量空间中距离更近,语义无关的文本距离更远
- 检索时,查询文本和文档片段被映射到同一向量空间,通过距离或相似度函数进行匹配
- 这种表示方式摆脱了对词面重叠的强依赖,使系统能够处理同义表达、语义改写等复杂情况
- 不同粒度的嵌入方式
- 单词级嵌入(Word2Vec、GloVe、FastText)
- 为每个词学习一个静态向量表示
- 能捕捉一定的词汇语义和类比关系
- 无法建模上下文变化,对多义词支持有限
- 在现代 RAG 系统中更多作为理论基础或辅助工具
- 句子、段落或片段嵌入(ELMo、Doc2Vec、BERT 类模型)
- 直接对一段文本进行整体建模
- 能利用上下文信息表达完整语义
- 非常适合分块后的文档片段检索
- 当前主流 RAG 系统几乎都采用这一粒度作为最小检索单元
- 单词级嵌入(Word2Vec、GloVe、FastText)
- 现代 Embedding 模型的工作机制
- 大多数模型基于 Transformer 架构,利用自注意力机制建模上下文关系,这时其训练目标通常不是语言生成,而是语义对齐
- 常见训练范式包括:
- 对比学习:拉近语义相关文本的向量距离,拉远不相关文本
- 检索式训练:以 query–document 或 query–passage 作为正样本对
- 多任务训练:同时优化检索、相似度判断、分类等目标
- 训练完成后,模型可以作为通用编码器,对任意输入文本生成可比较的向量表示
- Embedding 模型的选择考量
- BGE(BAAI General Embedding)
- 面向通用语义检索和 RAG 场景设计
- 中英文表现均衡,在多种检索任务上具有较强鲁棒性
- 工程生态成熟,适合生产环境使用
- M3E
- 强调多语言、多任务语义一致性
- 对跨语言检索、多语种知识库友好
- 实际选型时通常需要综合考虑:
- 目标语种和领域覆盖情况
- 支持的最大输入长度,是否适配分块策略
- 向量维度对存储成本和检索延迟的影响
- 是否针对检索任务进行过专门微调,而非仅用于生成或分类
- BGE(BAAI General Embedding)
- Embedding 模型的评估方法
- 常用的公开评测基准是 MTEB(Massive Text Embedding Benchmark)
- 覆盖语义检索、聚类、相似度计算、分类等多种任务
- 评估指标通常包括:
- 检索类指标,如 Recall@K、nDCG
- 不同领域、不同语言下的稳定性表现
- 与真实业务数据分布的匹配程度
- 在工程实践中,离线基准只是参考,最终效果仍需通过线上检索质量和下游回答表现验证
- 实践中的常见策略
- 同时构建向量索引与 BM25 索引,形成混合检索体系
- 向量检索负责高召回的语义匹配,BM25 提供精确约束与补充
- 对初步召回结果使用重排序模型进行精排,进一步提升相关性
- 在复杂系统中,可引入结构化知识或规则,与向量检索形成互补,提高整体鲁棒性与可解释性
向量数据库与索引
什么是向量数据库
- 传统数据库的局限
- 通过 Embedding 模型,文本可以被映射为能够表达语义的数值向量(嵌入),再借助余弦相似度、欧几里得距离等度量,判断不同文本之间的相似程度
- 真正的挑战在于规模:当知识库包含成千上万、数百万,甚至数十亿级别的文档时,分块和嵌入之后会产生同样数量级的向量
- 在如此庞大的向量集合中,如果对每个查询都进行暴力相似度计算,与所有向量逐一比较,计算开销和延迟都会迅速失控
- 对 RAG 系统而言,检索阶段等待数分钟显然不可接受,响应速度往往是硬性要求
- 传统数据库(如关系型 SQL 数据库或多数 NoSQL 数据库)主要面向精确匹配、范围查询或关键词搜索设计,并未针对高维向量空间中的 “相似度最近邻” 问题进行优化
- 引入向量数据库
- 向量数据库是一类专门用于存储、管理和查询大规模高维向量的数据系统,其核心目标是高效、可扩展的相似度搜索
- 与基于关键词或字段值的精确匹配不同,向量数据库接收一个查询向量,并基于选定的距离度量(如余弦相似度、欧几里得距离、点积),在索引中快速找到 “最相似” 的向量
- 这种检索方式天然契合语义搜索和 RAG 场景,对文本、图像等嵌入表示都同样适用
- 向量数据库:高效检索的关键,专门存储向量嵌入,通过高效相似度搜索(如近似最近邻 ANN 算法)快速定位相关信息
- 主流向量数据库:Qdrant、Weaviate、Pinecone、pgvector、Milvus、Chroma、FAISS
- 在选择向量数据库时,应关注检索速度、可扩展性、成本
- 针对近似最近邻(ANN)搜索的优化
- 向量数据库之所以高效,关键在于其对近似最近邻(ANN)搜索算法的系统性支持
- 精确的 K 最近邻(KNN)搜索需要保证找到全局距离最近的 K 个向量,在高维空间和大规模数据集下,往往意味着接近全量扫描,成本极高
- ANN 方法通过牺牲极少量精度,换取数量级上的速度提升:借助索引结构快速缩小候选范围,只在最有可能包含最近邻的区域中搜索
- 虽然不再提供严格的最优性保证,但在实际应用中,尤其是 RAG 场景下,ANN 返回的结果通常已经足够相关
- 可以将其理解为:几乎瞬间找到一组高度相关的文档,即便最优的那个分块有极小概率未被命中,整体效果依然非常理想
- 为了实现高效的 ANN 搜索,向量数据库依赖专门设计的索引结构,常见策略包括:
- 基于树(Annoy):构建多棵随机投影树,对向量空间进行递归划分
- 基于哈希(LSH):通过局部敏感哈希函数,将相似向量映射到相同或相近的桶中
- 基于图(HNSW):构建分层的小世界图结构,搜索时从稀疏的长距离连接逐步导航到密集的短距离邻居,是当前应用非常广泛的一种方案
- 基于量化(IVF、ScaNN):对向量进行压缩或先将空间聚类(如 k-means),查询时只在相关簇或分区内搜索
- 向量与元数据的联合存储
- 在 RAG 系统中,仅有向量本身通常不够,还需要保留其来源信息
- 向量数据库允许为每个向量记录关联元数据,例如原始文档名、页码、URL、时间戳或文档类型
- 检索时可以结合元数据过滤,在满足特定条件的子集中执行相似度搜索
- 例如:只在 2023 年 1 月之后发布的文档中查找相似分块,或仅检索来源为 “技术规范” PDF 的内容
- 这种能力对于构建更精准、可控的 RAG 应用尤为重要
- 向量数据库的典型检索流程(以用户 Query 为例)
- 使用与文档一致的嵌入模型,将 Query 转换为查询向量
- 将查询向量发送至向量数据库
- 数据库基于 ANN 索引执行相似度搜索,并按需应用元数据过滤条件
- 返回最相似的若干向量对应的文档分块及其元数据
- 这些检索到的分块被组织为上下文,随后输入到大型语言模型(LLM)中,完成最终的生成或推理
ANN 算法
- 参考资料:Comprehensive Guide To Approximate Nearest Neighbors Algorithms | by Eyal Trabelsi | TDS Archive | Medium
- ANN(Approximate Nearest Neighbor)的目标,是在高维向量空间中,以可接受的近似误差换取数量级上的性能提升
- 与精确 KNN 不同,ANN 算法通常牺牲部分召回率,以显著降低时间复杂度和内存访问成本
- 在 RAG 和向量数据库中,ANN 是实现 “毫秒级语义检索” 的基础设施
- ANN 算法通过数据预处理构建高效索引加速搜索,主要包含三个阶段:
- 向量变换(Vector Transformation):在索引前对向量进行处理,如降维、向量旋转
- 向量编码(Vector Encoding):构建搜索索引的核心阶段,涵盖基于树、LSH(局部敏感哈希)、量化等多种技术
- 非穷举搜索组件(None Exhaustive Search Component):避免全量搜索,常用倒排索引(Inverted Files)和邻域图(Neighborhood Graphs)等技术
KNN(精确最近邻)
-
KNN 并不是 ANN,但它是理解所有近似方法的参照系
-
给定查询向量 ,KNN 直接计算其与数据库中每个向量 的距离,例如欧氏距离
-
或余弦距离
-
然后选出距离最小的 个
-
这种方法的结果是严格正确的,但查询复杂度是 ,当 达到百万级、 在几百维时,计算和内存访问都会成为瓶颈
-
因此,KNN 更多用于小规模数据或作为 ANN 算法的评测上界,而不是实际生产方案
Annoy
-
参考资料:Nearest neighbors and vector models – part 2 – algorithms and data structures・Erik Bernhardsson
-
Annoy 的核心思想是用 “多棵随机投影二叉树” 来近似刻画高维空间中的邻近关系:它并不试图构建一个全局最优的空间划分结构,而是通过大量随机性的叠加,让真正相近的向量在至少一棵树中被划分到相同或相邻的叶子节点中
-
索引构建
-
在索引构建阶段,Annoy 会独立构建多棵二叉树。每棵树的构建过程都是递归的:在当前节点中,从已有的数据点里随机选取两个向量 和 ,并以这两个向量的中垂超平面作为划分边界
-
更具体地说,可以将分割方向理解为向量
-
然后通过比较任意向量 在该方向上的投影,判断它更接近 还是 ,从而决定它被分配到左子树还是右子树。这个过程会不断递归,直到叶子节点中的向量数量小于某个阈值
-
由于每一次分割的方向和基准点都是随机选择的,单棵树本身只是一个非常粗糙的近似结构,容易因为随机性而 “切坏” 局部的邻域关系
-
Annoy 的关键在于:它不会只依赖一棵树,而是同时构建大量相互独立的随机二叉树。直觉上,只要两条向量在空间中足够接近,那么在足够多次随机投影中,它们总会有几次被分到同一个或相邻的区域里
-
-
查询阶段同样体现了这种 “多视角” 的思想
- 对于一个查询向量 ,Annoy 会先将每一棵树的根节点放入一个优先队列中。队列中的优先级通常由查询向量到当前节点分割超平面的距离或启发式估计给出,表示 “继续往这个方向搜索,可能更有希望找到近邻”
- 搜索过程会在优先队列中不断弹出当前最有希望的节点,并沿着树结构向下探索其子节点。这个过程会在多棵树之间交错进行,直到收集到预设数量的候选向量(通常由参数
search_k控制) - 随后,Annoy 会对所有候选向量进行去重,并计算查询向量与这些候选向量之间的真实距离,最后按距离排序,返回最近的 个结果
-
时间复杂度
- Annoy 的预处理成本主要来自于多棵树的构建,构建时间与树的数量和数据规模近似成线性关系
- 查询时则只在极小的一部分节点和候选向量上进行精确距离计算,性能远优于全量 KNN
- 精度与性能之间的权衡主要由两个参数控制:树的数量决定了空间覆盖的充分性,而
search_k决定了查询时探索的深度
-
在工程特性上,Annoy 有一个非常鲜明的取舍:索引一旦构建完成,基本上就是不可变的;这使得它非常适合 “离线构建索引 + 在线只读查询” 的场景,例如推荐系统中的 embedding 检索或静态内容库搜索;但如果应用场景需要频繁插入、删除或更新向量,Annoy 的重建成本就会成为明显劣势
-
总体来看,Annoy 的优势在于实现简单、行为直观、查询速度快,并且在中等规模数据下具有很好的性价比;而它的局限也同样清晰:对动态更新支持较弱,且在极高召回率要求下,往往需要构建大量树,从而增加内存占用。这也是后来基于图结构的 HNSW 在很多通用向量数据库中逐渐成为主流的原因之一
LSH(Locality-Sensitive Hashing)
-
参考资料
-
LSH 的核心思想并不是 “更快地计算距离”,而是尽量避免对全量数据进行距离计算
-
LSH 并不保证一定找到真实的最近邻,而是在概率意义上保证 “相近的点更容易被找出来”,这也是它被归类为 ANN(Approximate Nearest Neighbor)算法的根本原因
-
它通过一类特殊设计的哈希函数,将 “相似性判断” 转化为 “是否发生哈希碰撞” 的概率问题:
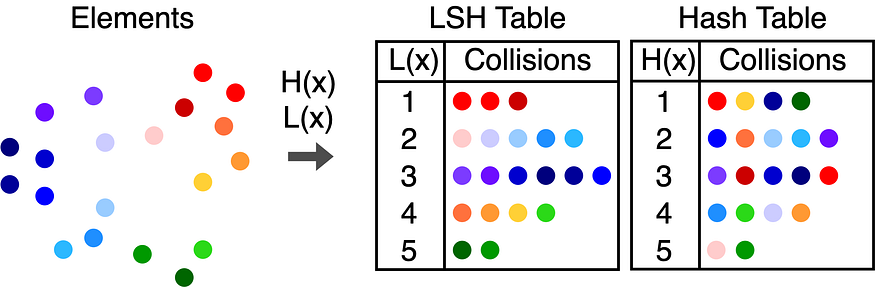
- 在原空间中距离较近的向量,更容易被映射到同一个桶中
- 距离较远的向量,发生碰撞的概率显著降低
- 这种 “在概率意义上保持局部性” 的特性,正是 Locality-Sensitive Hashing 名称的来源
-
从形式化角度看,一族哈希函数 被称为局部敏感的,当且仅当对任意向量 :
- 当 较大时, 较高
- 当 较小时,该概率显著降低
-
在实际系统中,LSH 几乎不会只使用一个哈希函数,而是通过多哈希函数 + 多哈希表来平衡召回率与效率:
- 单个哈希函数:区分能力有限,桶内噪声较多
- 多个哈希函数拼接:桶更小、更精确,但更容易漏召回
- 多张哈希表:为相似向量提供多次 “相遇机会”,缓解漏召回问题
-
基于随机超平面的 LSH(Cosine Similarity LSH)
- 这是最经典、也最常用于文本和语义 embedding 的 LSH 形式,适用于余弦相似度
- 基本做法是随机采样一个向量 ,并定义哈希函数:
- 该哈希函数等价于在向量空间中放置一个过原点的随机超平面,并判断向量 位于该超平面的哪一侧
- 对于两个向量 ,可以证明:
- 其中 是两者之间的夹角。这表明:夹角越小(余弦相似度越高),发生哈希碰撞的概率越大
- 为提高区分度,通常会选取 个随机超平面,得到一个 位的二进制签名:
- 每一个不同的二进制签名对应一个桶;再通过构建 张独立的哈希表,使相似向量至少在某一张表中落入同一桶
- 可以将这一过程理解为:同一批点被多次 “随机切分空间”,相近的点在某次切分中更可能被保留下来
-
Euclidean LSH(基于 距离)
- 当目标距离为欧氏距离时,常用的是基于随机投影与量化的 LSH,其典型形式为:
- 为随机采样的投影方向
- 为随机偏移
- 为桶宽(bucket width)
- 直观上,这是先将高维向量投影到一条随机直线,再按固定区间长度进行分桶
- 距离较近的点更容易落入同一个区间,而距离较远的点更可能被分配到不同区间
- 在理论上对 距离具有良好的近似保证,但在高维、语义 embedding 分布复杂的场景下,往往需要大量哈希表才能维持可接受的召回率
- 当目标距离为欧氏距离时,常用的是基于随机投影与量化的 LSH,其典型形式为:
-
多哈希函数与多哈希表的权衡是 LSH 实际效果的关键:
- 每个哈希签名中的函数数 越大,桶越小,误召回越少,但漏召回风险越高
- 哈希表数量 越多,找回近邻的概率越大,但内存占用和查询成本也随之上升
- 少量哈希函数 → 桶较大,远距离点也可能混入
- 过多哈希函数 → 桶过于稀疏,近邻可能完全错过
- 多表结构 → 为 “近点” 提供多次命中机会,是实践中的常见折中方案
-
查询阶段,对查询向量 :
- 使用与建索引时相同的哈希函数计算其哈希签名
- 在每一张哈希表中,取出与 落在同一桶(或相邻桶)的向量作为候选集
- 对候选集计算真实距离(如余弦距离或 距离)
- 对结果排序并返回最近的 个向量
- 整个过程中避免了对全量数据的扫描,真实距离计算仅发生在远小于全集的候选集合上
-
总体来看,LSH 的优势在于理论基础清晰、可扩展性强,在超大规模数据下仍可工作
-
但在现代语义检索和 RAG 场景中,由于 embedding 维度高、分布复杂,LSH 往往面临哈希冲突严重、内存开销大的问题,检索效果和稳定性通常不如基于图结构的方法(如 HNSW),因此在新一代向量数据库中逐渐被边缘化
HNSW(Hierarchical Navigable Small World)
-
Hierarchical Navigable Small World(HNSW)是一种目前在向量数据库中极为流行且性能优异的图结构 ANN(近似最近邻)算法
-
它结合了 “小世界图”(Small World Graph)和 “分层结构”,在近似搜索效率和召回率之间取得了优秀平衡,特别适合大规模、高维语义向量的检索场景
-
HNSW 的设计灵感来源于两类经典结构:
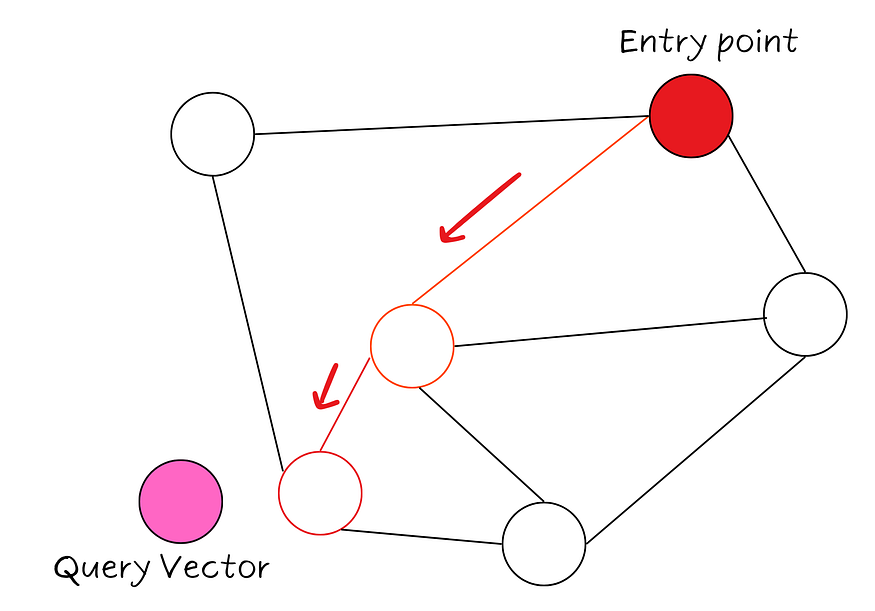
- 小世界图(NSW):构建一个近邻图,使得任意两个点之间的路径相对较短,具有高聚类系数和低平均最短路径长度,从而支持高效导航搜索
- 概率跳表(Skip List):通过多层随机层级结构加速搜索路径
- 将这两者结合起来,就得到了 HNSW 的基本结构:分层的、可导航的小世界图
-
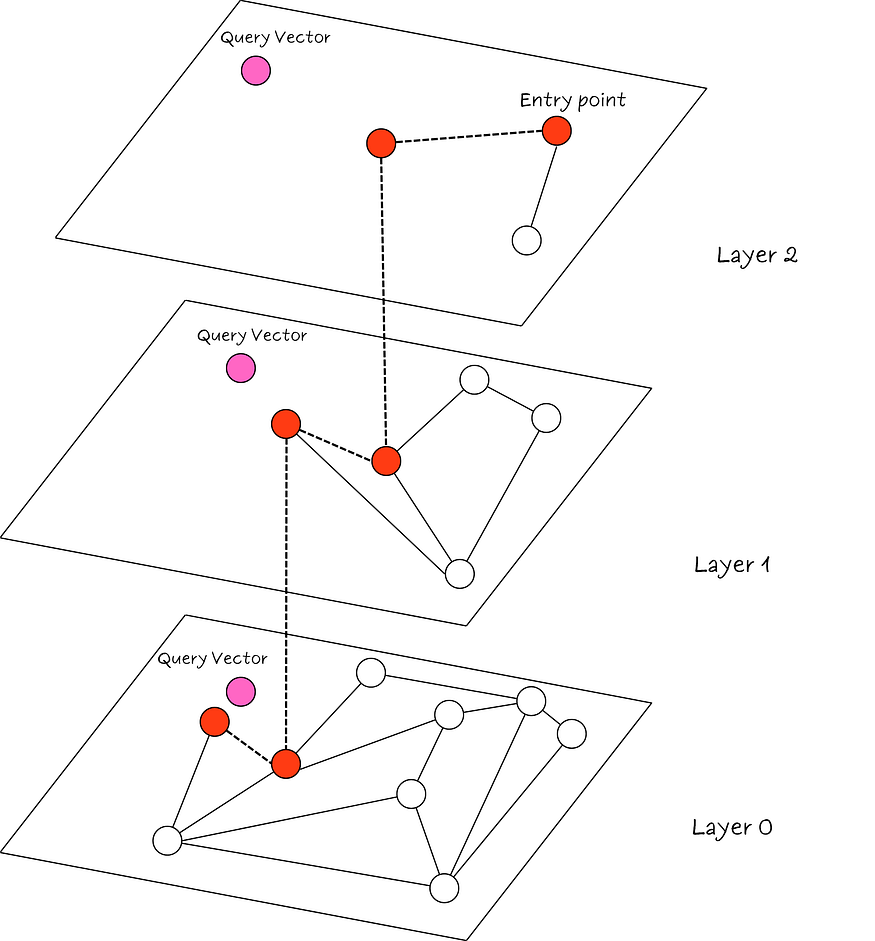
多层图结构:HNSW 并不是简单的一层图,而是由多层组成的递减密度图:
-
顶层(Layer L):节点最少、连接最稀疏、边的长度最长
-
底层(Layer 0):包含全部节点、连接最密集、边的长度最短
-
这个分层结构允许检索过程先在高层做粗略快速定位,然后逐层下降到更密集的底层做精细搜索,从而避免了只在底层做大量无效计算
-
与概率跳表类似,每个节点根据概率被分配到不同的层级,层级越高的节点越少(指数衰减)
-
-
构建 HNSW 索引的过程可以分为以下几个步骤:
-
插入新向量:每个新向量在插入时都会被随机分配一个最大层级,这个分配服从指数分布(概率层级越高概率越低)
-
在每一层建立连接
- 从顶层开始,用贪心搜索方法找到当前层最相近的节点
- 基于候选项集,将当前节点与最近的邻居建立双向连接
- 每层链接数受参数 M(最大邻居数)控制
- efConstruction 参数控制索引构建时动态候选列表大小(影响图的质量)
-
递归下降至底层:最终在底层建立密集连接,使所有点都可以快速通过邻居访问到彼此
-
-
HNSW 的查询过程是逐层迭代的:
-
从顶层入口点开始:在最高层随机选一个节点作为入口,以该节点为当前中心
-
逐层执行贪心搜索:在当前层中,遍历当前节点的邻居列表,一直向距离查询向量更近的邻居移动,直到局部最优(没有更近邻居)
-
下降一层:将当前最优节点作为下一层的入口点,在下一层继续重复上述搜索
-
在底层展开更全面搜索:在底层可以使用宽度优先或候选池扩展(由 efSearch 参数控制)来提升召回精度
-
整个过程中,大部分计算发生在与查询最相关的小子集,而不是整个图中,搜索复杂度近似对数级,从而实现高效检索
-
-
HNSW 提供多个可调参数,以在检索速度与准确性之间做取舍:
- M(最大邻接数):控制每个节点在各层的边数。M 越大,图越稠密,召回率越高,但内存与构建成本也更高
- efConstruction:构建阶段的候选列表大小。值越大,构建的图更 “优质”,但构建开销更大
- efSearch:查询阶段的候选列表大小。值越大,搜索精度越高,但延迟也随之增加
-
HNSW 的优势与适用场景
-
高召回率 + 低延迟:通过层次化搜索,有效缩小搜索空间,是目前许多向量数据库默认的 ANN 索引策略
-
动态插入支持:可以在构建后继续插入新向量,无需重建整个索引
-
适应高维与大规模场景:不受维度诅咒影响明显,广泛应用于语义搜索、推荐系统等
-
代价是索引结构较复杂,内存占用相对较高,但在现代硬件条件下通常是可接受的
-
-
如图示所示,HNSW 由多层小世界图构成:顶部稀疏连接、底部密集连接;搜索通过层级和近邻传播实现快速定位
IVF(Inverted File Index)
-
为什么需要量化(Quantization Motivation)
- 在 ANN 里,索引结构(如树、图)主要解决的是 “少算距离” 的问题,而量化解决的是 “少存向量” 的问题,两者关注的是不同瓶颈
- 现实中的核心约束主要来自三方面:
- 向量是线性存储的,空间复杂度为 ,当 和 同时变大时,内存占用不可控
- 现代语义 embedding 通常是高维的(如 ),导致内存占用、内存带宽、cache miss 成本都很高
- 许多 ANN 算法在查询阶段需要把向量加载进 RAM,而不是仅存放在对象存储中
- 即使有 S3 等廉价存储,ANN 实际上消耗的是内存带宽和本地内存容量;在 “存储 / 计算不分离” 的系统中,线性存储的成本会迅速放大
- 因此核心目标是:不再存储原始向量,而是用一个紧凑、近似的编码来代替它,并且搜索阶段只在近似空间中计算距离
- 这正是 Quantization 的出发点
-
量化的基本形式化定义
- 量化可以被看作一个映射函数 ,把连续空间中的向量映射到一个有限集合中:
- 是一个有限集合,通常称为码本(codebook)或质心集合
- 数据库中实际存储的不是向量本身,而是指向码本元素的索引 / ID
- 目标是在显著降低存储成本的同时,接受一定程度的相似度误差
-
最直观的量化方式:K-means Quantization(向量级)
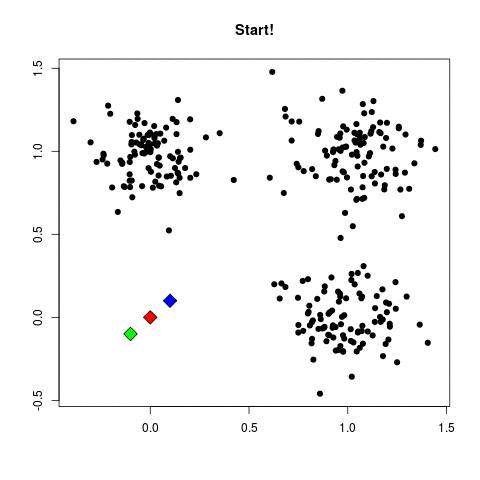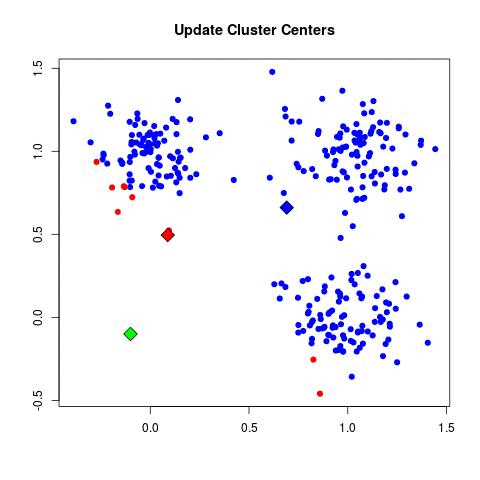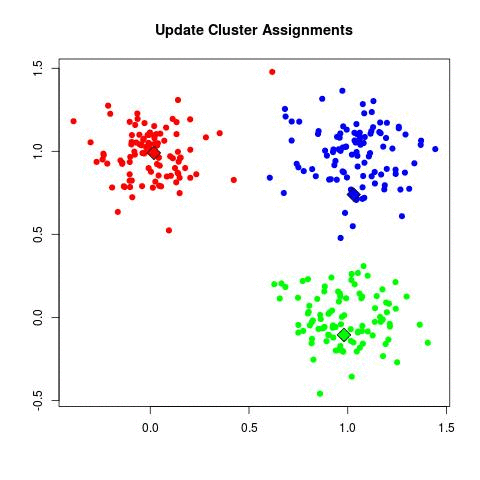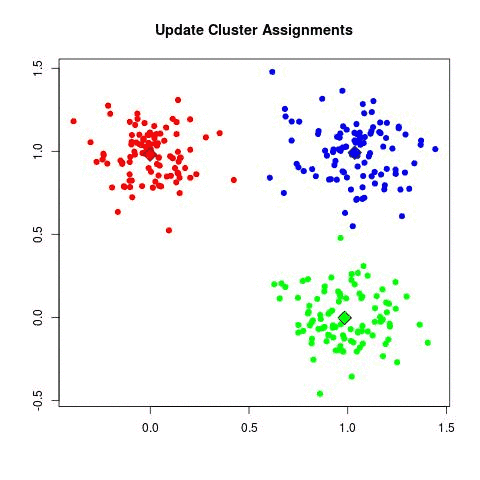
- 做法是对整个向量集合运行一次 -means 聚类,得到 个质心 ,每个向量只用 “最接近的质心 ID” 来表示:
-
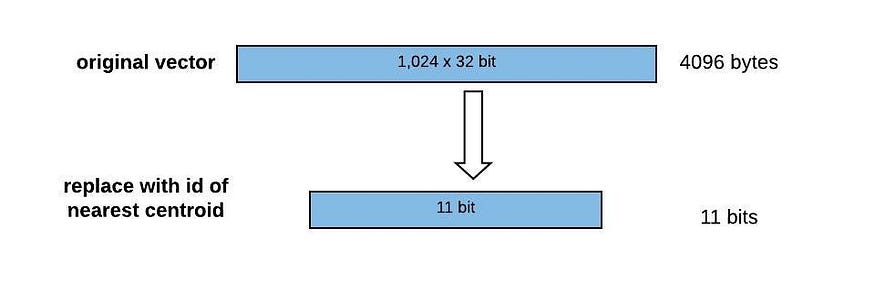
存储收益非常明显:每个向量只需要 bit
-
例如 时仅需 11 bit,而原始 维 float32 向量需要 bit
-
但代价也非常大:所有落在同一个簇内的向量在表示层面完全不可区分,向量内部的细粒度结构全部丢失
-
因此这是 “压缩极强,但精度灾难性下降” 的方法
-
Product Quantization(PQ)—— 量化方法的关键突破
-
PQ 的核心思想是:不要整体量化一个 维向量,而是把向量拆分成多个低维子向量分别量化
-
每个子空间都有自己独立的码本:
-
在实践中,常见配置是每个子码本大小为 (正好 1 byte),因此整个向量只需要 bytes
-
例如:,拆成 个子向量,每段 维,存储从原来的 4096 bit 降到 8 byte
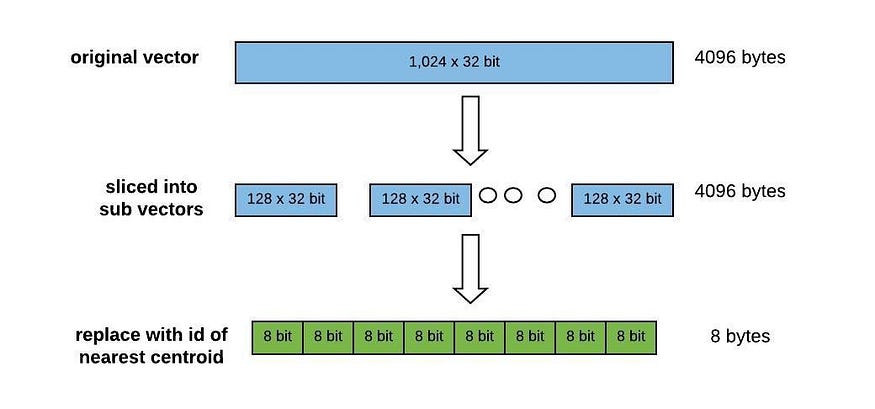
- 相比 “整向量 k-means”,PQ 用指数级增加的组合空间换取了显著更高的表达能力
-
-
PQ 的搜索方式:查表近似距离(Asymmetric Distance Computation)
-
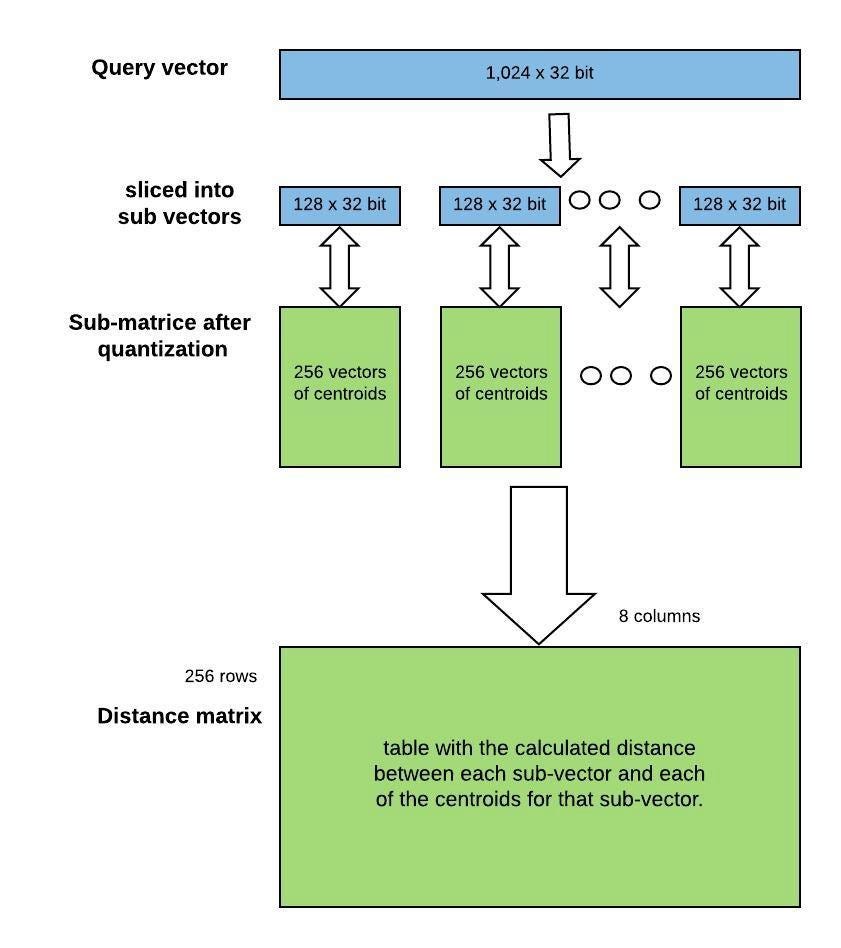
PQ 不会重建近似向量,而是直接在编码空间中近似计算距离
-
对查询向量 ,将其同样拆分为 ,预先计算每个子向量到对应子码本中所有质心的距离,得到一个距离查找表
-
对数据库向量,它只是一个 ID 序列 ,与查询向量的近似距离为:
-
-
这种方式的特点是没有向量乘法,只有查表 + 加法,计算速度极快
-
但问题仍然存在:需要对所有数据库向量做一次扫描
-
Inverted File Index(IVF)—— 避免全表扫描
- PQ 的组织结构
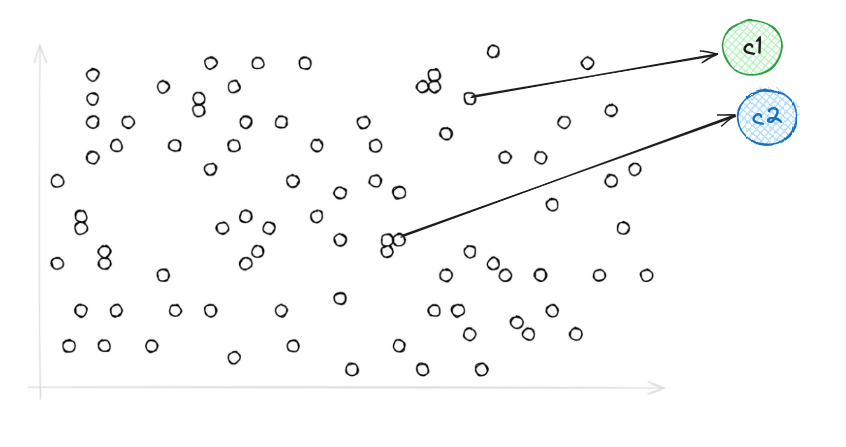
- IVF 的出发点很直接:既然全量扫描 PQ 编码仍然慢,那就先把数据集粗粒度地分区,只在 “可能相关” 的分区中做 PQ 搜索
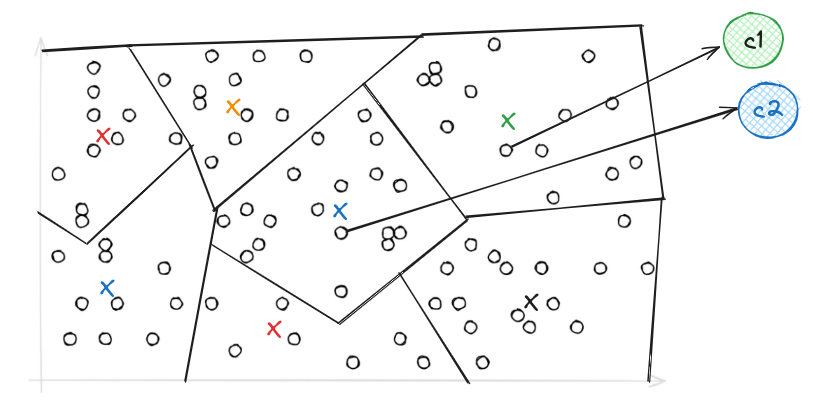
-
具体做法是先运行一次 coarse k-means:
- 使用较小的 (如几千)
- 得到一组粗粒度质心(coarse centroids)
- 每个向量只被分配到最近的一个 coarse centroid,这个 centroid 对应一个 Voronoi cell
-
从结构上看,这一步类似于为向量空间构建一个 “聚类级倒排索引”:centroid → 向量 ID 列表
-
查询时流程为:
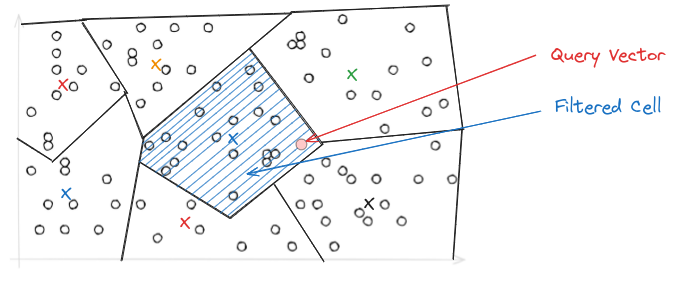
- 先计算查询向量与所有 coarse centroids 的距离
- 只选择距离最近的 个 centroid
- 仅在这些 centroid 对应的倒排列表中进行搜索
-
这样可以避免扫描整个数据库,但也引入了新的问题 —— 如果查询点位于某个簇的边界附近,真实最近邻可能位于相邻簇,只搜索一个 partition 会导致漏召回
-
解决方式是 multi-probe—— 搜索多个相邻 partition,用时间换召回率
-
IVF 的优势在于结构直观,易于实现,非常容易与 PQ 等编码方法结合,这也是 FAISS 中大量索引结构基于 IVF 的原因
-
Residual Quantization(编码残差)
-
在 IVF + PQ 中,一个重要改进是不要直接对原始向量做 PQ,而是对它相对于 coarse centroid 的残差做 PQ
-
直觉上,这是因为残差向量的分布范围更小、更集中,在相同码本规模下,PQ 对残差的表达能力更强,因此整体近似误差显著下降
-
代价是:
- 每 probe 一个 partition,就要基于该 partition 的 centroid 重新计算查询残差
- 每个 partition 都需要独立的距离表
- 查询时间进一步增加
-
但在实践中,这种精度提升通常是值得的
-
-
FAISS 中的经典结构:IVFPQ
-
构建阶段:
- 使用 coarse k-means 对向量空间进行分区(IVF)
- 对每个 partition,计算向量相对于 coarse centroid 的残差,对残差进行 Product Quantization
-
查询阶段:
-
找到最近的 个 coarse partition
-
对每个 partition,构建对应的 residual distance table,使用 PQ 查表计算近似距离
-
合并所有候选并排序,返回最终结果
-
-
不同方法的对比
| 方法 | 内存占用 | 构建成本 | 插入能力 | 查询延迟 | 召回稳定性 | 典型适用场景 |
|---|---|---|---|---|---|---|
| LSH | 高 | 低–中 | 强 | 中 | 低 | 超大规模、近似去重、理论可解释性优先 |
| Annoy | 中 | 高 | 弱 | 低 | 中 | 只读向量库、离线构建、CPU 友好 |
| IVFPQ | 极低 | 高 | 中 | 低 | 中–低 | 超大规模、GPU/CPU 混合、内存受限 |
| HNSW | 高 | 高 | 强 | 极低 | 高 | 高质量语义检索、在线系统主力 |
- 内存占用为什么差异这么大
- LSH 的内存高,根本原因是 “多表 + 稀疏命中”—— 为了保证相似点至少在某一张表中相遇,需要维护多张哈希表,每个向量会被复制多次;而且哈希桶本身并不压缩向量
- Annoy 的内存中等,因为它存的是原始向量 + 多棵随机投影树,树结构相对轻,但向量是全量保存的,没有压缩
- IVFPQ 内存极低,原因在于两层压缩:IVF 只在倒排桶里存向量,PQ 把一个 维向量拆成 个子空间,每个子空间只存一个 code(通常 8 bit),最终内存近似是 ,而不是
- HNSW 内存高,是因为图结构本身 “很贵”,每个节点需要存多层邻居指针(通常每层 条边),再加上原始向量或至少高精度向量用于精排,内存自然较高
- 构建成本从哪来
- LSH 构建成本低,因为几乎不需要全局结构优化,只是做随机投影 + 哈希
- Annoy 构建慢,是因为它要反复做随机划分并构建多棵树,而且是离线一次性构建,不能增量优化
- IVFPQ 构建成本高,用 k-means 训练 IVF 的 coarse centroids,用 k-means 训练 PQ 的 codebook,这步是标准的 “训练型索引”
- HNSW 构建也慢,但原因不同 —— 它是一个在线贪心过程,每插入一个点,都要做一次近邻搜索,然后在多层图中维护连接关系,复杂度接近 次 ANN 查询
- 插入能力的本质区别
- LSH 插入最友好,几乎是 :算哈希,放桶里
- HNSW 插入也强,但 “强在工程复杂度高”,它能动态插入,但每次插入都要付出一次完整的图搜索与局部重连成本
- IVFPQ 插入能力一般,向量可以直接分配到最近的 coarse centroid 并编码,但如果数据分布发生变化,原先训练好的 codebook 会逐渐失效,长期来看需要重新训练
- Annoy 插入最弱,几乎不支持在线插入,本质上是一个只读索引
- 查询延迟为什么 HNSW 能做到最低
- HNSW 的低延迟来自 “对数级导航”,搜索过程从高层稀疏图开始,快速逼近目标区域,然后在底层密集图中做局部搜索,访问节点数非常稳定
- IVFPQ 查询快,是因为只扫描少量倒排桶,距离计算用查表(LUT)代替真实向量距离,但如果桶选得不好,延迟可能突然抖动
- Annoy 查询是树遍历 + 回溯,延迟低但方差偏大
- LSH 查询延迟不算低,因为需要访问多个桶、合并候选集,再算真实距离
- 召回稳定性是 “图 vs 哈希 vs 量化” 的差异
- LSH 召回不稳定,是概率碰撞机制决定的。只能调高概率,但不能保证 “近的一定找到”
- IVFPQ 的召回瓶颈来自量化误差。即使倒排桶选对了,PQ 近似距离也可能把真实近邻排序错
- Annoy 的召回依赖树数量和随机性,本质上是 Monte Carlo
- HNSW 的召回最稳定,因为它近似 “局部 Delaunay 图”,只要图连通性维护得好,近邻几乎总能被导航到
主流向量数据库
-
评估不同向量数据库时,需要综合权衡以下几个方面:
-
可扩展性
- 数据规模:能够支持的数据规模上限,包括向量数量和维度大小
- 查询吞吐能力(QPS):在高并发场景下,往往需要分布式架构或高度优化的索引与执行引擎
- 随着数据量增长,性能是否能够平滑扩展,而不是出现明显退化
-
查询性能
- 索引构建:索引构建与更新的速度,尤其是在频繁写入或增量更新的场景下
- 查询延迟:单次检索的响应时间是否满足业务需求
- 召回率与速度之间的权衡:是否允许通过参数调节,在更高精度和更低延迟之间灵活取舍
-
扩展功能
- 是否支持向量与元数据的联合存储,以及高效的元数据过滤
- 是否提供完整的 CRUD 操作能力,便于数据的插入、更新和删除
- 是否支持混合检索(如向量相似度 + 关键词或结构化条件)
- 安全与运维相关能力,例如访问控制、认证鉴权、多租户支持等
-
兼容性
- 与主流 Embedding 模型的适配程度,以及对向量维度和距离度量的支持情况
- 与常用编程语言和框架的集成体验,例如 Python、Java、Go 及其生态
- 是否易于融入现有的数据基础设施和应用架构中
-
-
主流向量数据库对比
数据库 存储方式 支持索引类型 部署模式 特点与优势 典型使用场景 Qdrant 本地 + 持久化 HNSW 自托管 / Docker 高性能近邻搜索,支持向量 + 元数据过滤,Python/REST SDK 较成熟 实时搜索、推荐系统、动态数据 Weaviate 本地 / 云 + 模块化 HNSW, ANN 自托管 / SaaS 支持多模态、GraphQL 查询,带原生向量 + 元数据搜索 多模态搜索、知识库 Pinecone 云服务 HNSW, IVF-PQ SaaS 完全托管,无需运维,自动扩展,API 简单 低运维成本、快速部署 pgvector PostgreSQL 插件 L2 / Cosine / Inner Product 自托管 利用现有 PostgreSQL,支持 SQL 查询向量,适合小规模或已有 PostgreSQL 用户 小型项目、原型开发 Milvus 本地 / 云 HNSW, IVF, IVF-PQ, SQ8 自托管 / 云 高性能,支持大规模向量数据,丰富索引策略,多语言 SDK 企业级大数据检索、图像 / 文本搜索 Chroma 本地轻量 HNSW 自托管 Python 原生,适合 LLM 本地应用,嵌入式知识库 LLM 增强检索、个人知识库 FAISS 本地库(C++/Python) Flat, IVF, HNSW, PQ, OPQ 自托管 底层索引库,高性能,灵活,可自定义索引与量化策略 高性能批量检索、科研或深度定制
向量数据库分片
-
在大规模 RAG 系统中,单实例向量数据库很快会因高维嵌入数据量过大而失效。主要限制包括:
-
内存 (RAM):高性能 ANN 索引(如 HNSW 或 IVF_FLAT)通常要求向量和索引驻留内存。例如,1 亿个 768 维
float32向量约占 286 GB,不含索引开销,远超单机容量 -
CPU:查询需要计算大量向量间的相似度,即使 ANN 缩小了搜索范围,节点数据量过大时仍可能导致查询延迟增加
-
I/O 吞吐:当索引或部分向量存储在磁盘时,I/O 成为瓶颈,尤其是写密集型或读密集型场景
-
单点故障 (SPOF):非分布式系统若出现节点故障,整个检索可能不可用
-
-
有效扩展向量搜索需通过分布式架构应对这些问题,核心方法包括分片与复制
分片(Sharding)
-
分片是将向量索引水平划分到多台机器或节点,每个分片管理数据子集并独立搜索
-
分片的主要作用是分担存储负载和并行化查询执行,提高吞吐量和可扩展性
-
分片策略
-
ID 哈希分片:对唯一向量 ID 进行一致性哈希,均匀分配向量:
shard_id = hash(vector_id) % num_shards -
范围分片:按连续 ID 或自然顺序划分范围,可能导致热点
-
元数据分片:根据租户 ID 或其他特征划分,可提升数据局部性,但需防止负载不均
-
-
分片目标是让向量和查询负载在分片间均衡分布,必要时可采用再平衡策略
-
查询路由
-
散射 - 收集:查询广播到所有分片,每个分片返回局部 Top-k,协调节点汇总结果。简单但可能增加网络和聚合成本
-
路由查询:根据查询可确定目标分片(如租户 ID),直接发送到相关分片,提高效率
-
混合策略:利用元数据缩小分片范围,再在子集内使用散射 - 收集
-
-
分片结构示意
flowchart TB %% 节点样式 classDef client fill:#ffec99,stroke:#495057,stroke-width:1px classDef router fill:#ffd8a8,stroke:#495057,stroke-width:1px classDef shard fill:#a5d8ff,stroke:#495057,stroke-width:1px %% 客户端与路由器 Client["RAG 应用"]:::client QueryRouter["查询路由器 / 负载均衡器"]:::router %% 向量数据库分片 subgraph "向量数据库分片(节点/Pod)" Shard1["分片 1<br/>(本地索引,数据子集 A)"]:::shard Shard2["分片 2<br/>(本地索引,数据子集 B)"]:::shard ShardN["分片 N<br/>(本地索引,数据子集 N)"]:::shard end %% 查询流程 Client -->|用户查询(向量 + TopK)| QueryRouter QueryRouter -->|分发查询| Shard1 QueryRouter -->|分发查询| Shard2 QueryRouter -->|分发查询| ShardN Shard1 -.部分结果 TopK.-> QueryRouter Shard2 -.部分结果 TopK.-> QueryRouter ShardN -.部分结果 TopK.-> QueryRouter QueryRouter -->|全局 TopK 结果| Client -
工作流程:
-
查询广播到分片或路由到子集
-
每个分片独立搜索本地索引,返回局部 Top-k
-
协调器汇总、排序并返回全局 Top-k 结果
-
-
分片数量、数据分布、复制策略和每个分片的资源分配直接影响吞吐量、延迟和可用性
-
为了进一步提高每个分片的容量和查询效率,通常使用以下方法:
-
乘积量化 (Product Quantization, PQ):将向量拆分为 M 个子向量,每个子向量用 k 个质心进行近似表示,大幅降低内存占用。例如,768 维
float32向量使用 PQ 后约 96 字节存储,相比原始 3072 字节节省 8 倍 -
优化 PQ (OPQ):通过线性变换使向量更适合 PQ 分割,提高压缩下的准确性
-
基于图的索引 (HNSW):每个分片维护自己的 HNSW 图,支持高召回率和低延迟搜索
-
磁盘感知索引:当集群内存仍不足时,可将倒排列表或部分向量存储在 SSD 等磁盘上,减少内存成本,但增加查询延迟
-
复制(Replication)
-
复制是为每个分片创建多个副本,以保证高可用性和提高读取吞吐量
-
高可用性:节点故障时,其他副本继续提供服务
-
读取扩展:并发查询可分发到副本,提升整体吞吐量
-
-
常见复制模型:
-
主从复制:写入到主副本,再同步到从副本。读取可由从副本提供,可能是最终一致性
-
多主 / 对等:多个副本接受写入,需要冲突解决,写入延迟低但复杂度高
-
-
分片与复制结合使用可以同时实现可扩展性和高可用性。例如,3 个分片、每个分片 3 个副本,总节点数 9 个
-
分片与复制结合
flowchart LR
    %% 查询路径
    subgraph 查询路径
        style 查询路径 fill:#e9ecef
        user_query((用户查询)):::userQuery
        query_router[查询路由器/<br/>负载均衡器]:::router
    end

    %% 分布式向量索引分片
    subgraph 分布式向量索引分片
        style 分布式向量索引分片 fill:#dee2e6

        subgraph 分片1
            style 分片1 fill:#ffec99
            s1_leader["分区 1<br/>(主节点)"]
            s1_replica1["索引分区 1<br/>(副本)"]
        end

        subgraph 分片2
            style 分片2 fill:#ffec99
            s2_leader["索引分区 2<br/>(主节点)"]
            s2_replica1["索引分区 2<br/>(副本)"]
        end

        subgraph 分片N
            style 分片N fill:#ffec99
            sN_leader["索引分区 N<br/>(主节点)"]
            sN_replica1["索引分区 N<br/>(副本)"]
        end
    end

    %% 样式
    classDef router fill:#a5d8ff,stroke:#000,stroke-width:1px
    classDef userQuery fill:#b2f2bb,stroke:#000,stroke-width:1px

    %% 查询流
    user_query -->|用户请求| query_router
    query_router -->|路由/散射| s1_leader
    query_router -->|路由/散射| s2_leader
    query_router -->|路由/散射| sN_leader

    query_router -.读取.-> s1_replica1
    query_router -.读取.-> s2_replica1
    query_router -.读取.-> sN_replica1

    s1_leader -.结果.-> query_router
    s2_leader -.结果.-> query_router
    sN_leader -.结果.-> query_router
Pre-Retrieval
-
查询清洗与标准化
- 去除多余符号、纠正拼写、统一格式
- 规范化时间、单位、命名实体等
- 基础的拼写更正和文本规范化对于生产环境极为重要,可以避免检索失败
-
查询改写(Query Rewrite)
- 将自然语言问题转换为更适合检索的形式,调整措辞或结构,使查询更贴近文档集合的用语
- 原始查询:“我的 RAG 太慢了,该怎么办?”
- 改写后:“RAG 系统中降低延迟的方法” / “优化检索增强生成管道的性能”
- 可结合多个改写版本进行检索,提升召回
-
查询扩展(Query Expansion)
-
通过添加新词或短语丰富查询,提高匹配相关文档的概率
-
同义词与缩写词扩展
-
根据通用词典(如 WordNet)或领域词典(如医疗术语),进行基于嵌入的相似词查找
-
“LLM” -> “大型语言模型”
-
“AWS RAG 设置” -> “Amazon Web Services 检索增强生成设置”
-
-
相关术语扩展
- 分析文档共现、知识图谱关系、LLM 生成相关关键词
- “可持续能源” -> “太阳能、风力涡轮机、地热能、可再生资源”
-
查询分解—— 多路召回 (Multi-query Retriever)
- 将复杂查询分解为多个更简单的子查询
- 原始查询:“比较混合搜索与密集检索在医疗 RAG 系统中的准确性和延迟”
- 子查询生成:“医疗 RAG 系统中混合搜索的准确性”、“医疗 RAG 系统中混合搜索的延迟”、“医疗 RAG 系统中密集检索的准确性”、“医疗 RAG 系统中密集检索的延迟”
-
-
HyDE(Hypothetical Document Embedding)
- 使用 LLM 生成假设性文档作为查询的语义桥梁,即生成内容更丰富的文档嵌入后再做检索,提高召回和相关性
- 在获得用户查询后,由 LLM 生成解释性段落或答案文档,然后嵌入生成文档向量,最后在向量数据库中进行相似性检索
- 特别适合抽象查询或查询与文档词汇不匹配的情况
-
问题类型判断(事实 / 总结 / 推理)
- 对问题进行分类,选择最合适的检索策略或生成策略
- 示例:事实类问题使用精确检索,总结类问题使用多文档聚合,推理类问题可能需要链式检索
-
RAG gating:判断当前问题是否必须通过检索获得信息,对于模型已知的事实或开放式生成问题,可跳过检索降低延迟
-
实施考量
问题 描述 解决方案 查询漂移 扩展或改写过度可能偏离原始意图 加权原始查询词、选择性扩展、重排序 延迟 尤其是基于 LLM 的查询增强步骤 使用小型高效 LLM、缓存、并行化 复杂性与成本 多种增强策略增加系统复杂度和 API 成本 从简单策略起步,逐步升级 领域特定性 根据具体场景微调词典、相关术语和 LLM 提示 评估 通过指标(准确率、召回率、nDCG 等)和 A/B 测试评估增强策略效果
Retrieval
-
常见检索方法
搜索方法 核心原理 优势 不足 关键词检索 基于查询中的特定关键词匹配文档 简单、高效 难以处理同义词、改写表达及复杂信息需求 向量检索 将文档和查询表示为高维空间中的向量,语义相似的文本向量距离更近 适用于大规模数据集,能更好捕捉语义关系 依赖高质量的向量嵌入模型 混合检索 结合多种搜索方法(如先用关键词搜索初筛,再用向量搜索重排序,或反之) 融合不同方法优势,平衡效率与语义相关性 实现复杂度高于单一搜索方法 图检索 / 多跳检索(Graph RAG) 将文档节点与知识图或文档关系图连接,通过图遍历或多跳路径检索相关信息 可处理复杂关系、多步推理、增强上下文关联 构建图成本高,查询复杂度较高 多模态检索(图文 / 表格) 将不同模态(文本、图像、表格等)嵌入到共享向量空间,实现跨模态检索 支持丰富信息源、语义跨模态搜索 嵌入训练复杂,对模态间一致性要求高 邻近块 / 上下文检索(Parent / Sibling chunk) 利用文档分块或层次结构,检索时引入上下文或邻近分块,减少信息被孤立使用的风险 提升局部上下文匹配精度,减少无关信息干扰 对块划分和上下文关系依赖较强
Post-Retrieval
- 去重与合并(Chunk Merge):将重复或高度相似的文档块合并,减少冗余信息干扰,确保同一知识点不会被重复计入 LLM 输入
- 重排序(Rerank, Cross-Encoder / LLM)
- 对初步检索结果进行语义层面的精细排序
- 可使用训练好的 Cross-Encoder 或直接用 LLM 对查询与文档进行评分
- 提升最相关文档的优先级,改善召回的质量
- 相关段落与句子级抽取
- 将文档细化到段落或句子级别,提取最相关片段
- 避免整篇文档冗长,提升 LLM 消化效率
- 基于查询的证据过滤
- 根据查询意图和关键实体对文档或段落进行筛选
- 剔除不符合条件或弱相关信息,保证输入内容高质量
- Top-k 动态调整
- 根据上下文长度、查询复杂度、召回分布动态调整最终输入的 Top-k 文档数量
- 平衡覆盖率与效率,确保 LLM 输入既精简又包含关键信息
重排序 Reranking
-
重排序的重要性
- 初始检索结果可能仅 “大致相关”,缺乏 LLM 生成准确响应所需的针对性,需进一步优化
- 避免信息冗余:若两个检索片段信息相似,虽相似度高但会造成冗余,重排序可提升结果多样性
- 提升 LLM 输入质量:确保最相关、信息最丰富的文档被输入 LLM,减少误导性或无关信息,最终提升 LLM 输出质量
-
学习排序(Learning to Rank, LTR)
- 核心概念:利用机器学习,根据带相关性标签的 “查询 - 文档” 对训练模型,自动区分高 / 低相关文档
- 训练数据包括查询 - 文档对及其相关性评分(如二分类标签或分级评分)
- 三大类别:
- 点式方法(Pointwise Methods):独立处理每个查询 - 文档对,根据文档特征预测相关性评分,代表模型有线性回归、随机森林、梯度提升机
- 对式方法(Pairwise Methods):比较文档对的相关性,学习 “哪篇文档更相关”,代表模型有 RankSVM、ListNet
- 列表式方法(Listwise Methods):整体优化文档排序列表,如 MAP、NDCG 等指标,代表模型有 LambdaMART、RankSVM(列表式)
-
交叉编码重排序器(Cross-Encoding ReRanker)
- 核心概念:训练神经网络,将查询与文档同时编码到同一向量空间,向量距离越近表示语义越相关
- 训练流程:
- 数据准备:收集带相关性标签的 “查询 - 文档” 对
- 模型架构:包含查询编码器和文档编码器两个子网络
- 相似度学习:调整参数,使查询向量与相关文档向量距离小于无关文档向量,捕捉语义相似性
- 重排序步骤:编码查询与初检文档 → 计算余弦相似度 → 按得分排序生成最终列表。常用模型:Sbert、MiniLM、ColBERT
-
最大边际相关性(Maximum Marginal Relevance, MMR)
- 核心目标:平衡 “查询相关性” 与 “信息多样性”,避免冗余
- 执行步骤:
- 初始检索:关键词或向量搜索获取文档集合
- 迭代选择:逐一选择文档,同时满足 “与查询相关” 且 “与已选文档相似度低”
- 相似度衡量:使用余弦相似度评估 “文档 - 查询”“文档 - 文档” 相关性
- 平衡权重:参数 λ 控制相关性 vs 多样性优先级
- 生成最终列表:整合迭代选择结果,得到兼具相关性与多样性的排序
-
BM25
-
核心概念:经典关键词相关性评分算法,通过词频、逆文档频率及文档长度计算文档相关性
-
评分因素:
- 词频(TF):衡量查询词在文档中出现次数,避免高频词偏差
- 逆文档频率(IDF):稀有词权重高,更易区分文档
- 文档长度:倾向于短且精炼文档,避免长文档累加虚高
-
计算公式:
-
其中 为词 t 在文档 d 中词频, 为逆文档频率, 为长度调节参数
-
-
LLM 重排序器(LLM ReRanker)
- 核心概念:利用 LLM 的语言理解能力重排序,无需独立训练或特征工程
- 实现方式:
- 生成式排序:LLM 输入查询与检索文档,直接生成文档相关性评分或标签
- 带反馈抽取式排序:LLM 分析查询生成关键信息摘要,再以此优先选择包含重要信息的文档
- 示例:Cohere 等公司已有易用 LLM 重排序算法
-
重排序算法选择依据
- 数据可用性:监督学习模型(如 LTR)需要标签,若数据稀缺则选择无需大量标注的方法
- 任务复杂度:若需深度语义理解,交叉编码或 LLM 重排序更适合
上下文构建
-
在 Token 限制下,最大化信息密度
-
Query-aware 上下文压缩
- 根据用户查询意图优先保留相关信息
- 剔除与查询无关的内容,提高每 token 的有效信息量
-
抽取式 / 摘要式压缩
- 抽取:选取原文中最相关的句子或段落
- 摘要:生成紧凑的文本摘要,保留核心信息
- 可结合抽取 + 生成式摘要,进一步提高信息密度
-
命题级证据拼装
- 将多条相关证据按命题 / 事实单元整合
- 避免冗余,保证逻辑连贯性
-
证据分组与结构化(按问题子目标)
- 将上下文按查询子问题或知识维度进行分组
- 形成结构化输入,使 LLM 更容易理解和推理
-
引用与来源标注
- 为每条证据保留来源信息
- 支持可追溯性、增强输出可信度
反馈与自适应
-
用户显式反馈
- 点赞 / 点踩
- 手动修正答案
- 用于训练或微调排序模型
-
隐式反馈
- 用户追问或快速跳出
- 可作为相关性或满意度的信号
-
检索命中分析
- 统计哪些文档或 chunk 被频繁命中
- 分析召回率与命中质量,优化索引策略
-
Chunk / Query / Rerank 参数调优
- 动态调整 chunk 大小、查询策略、重排序模型参数
- 以达到更高召回率与更低冗余
-
自适应检索深度
- 根据查询复杂度或历史反馈动态决定检索层数
- 减少无效计算,提升效率
-
Pipeline 动态路由(Adaptive RAG)
- 根据查询类型或上下文复杂度选择不同检索 / 生成路径
- 实现计算资源与输出质量的最优平衡
RAG 评估
检索评估指标
-
召回率(Recall)
-
检索出的相关文档占所有相关文档的比例
-
衡量系统 “找回” 了多少真实相关信息,在 RAG、问答场景中,强调不要漏关键信息
-
-
精确率(Precision)
-
检索出的文档中有多少是真正相关的
-
衡量检索结果的纯度,用于希望 LLM 输入更干净、减少噪声时
-
-
F1 分数(F1 Score)
-
精确率与召回率的调和平均
-
综合考虑召回与精度的平衡
-
-
平均精度均值(MAP, Mean Average Precision)
-
对每个查询计算平均精度(AP),再对所有查询取均值
-
= 前 k 个结果的精确率
-
= 第 k 个文档是否相关(1 或 0)
-
= 查询相关文档总数
-
= 查询总数
-
综合考察排序的精度,越靠前的相关文档贡献越大
-
-
归一化折损累积增益(NDCG, Normalized Discounted Cumulative Gain)
-
考虑相关性等级和结果位置的重要性
-
= 第 i 个文档的相关性评分
-
= 理想排序下的 DCG
-
越靠前的高相关文档贡献越大,适合评估排序质量
-
-
Top-k 召回(Recall@k)
-
在前 k 个检索结果中,包含相关文档的比例
-
RAG 或 LLM 检索中最常用指标,反映实际使用中 LLM 能够获取到关键信息的概率
-
-
命中率 / Hit Rate(Hit@k)
-
Top-k 结果中至少包含一个相关文档的查询比例
-
强调 “至少找到一条相关信息”,对问答和推荐场景非常直观
-
-
MRR(Mean Reciprocal Rank,平均倒数排名)
-
衡量系统返回结果中 “正确答案的排名” 情况,核心思想是越靠前找到正确答案越好
-
对于一组查询集合 ,假设每个查询 的检索结果列表中,第一个正确答案的排名为 ,则 MRR 定义为:
- 是第 个查询第一个正确答案在检索列表中的位置(从 1 开始计数)
- 如果该查询没有正确答案,则通常取
-
-
评估指标总结
-
Recall / Recall@k / Hit@k → 高召回,关注不漏信息
-
Precision / MAP / NDCG → 高精度,关注结果质量和排序
-
F1 → 兼顾精度和召回的平衡
-
-
在 RAG / LLM 检索场景中,召回率和 Top-k 召回是最重要的指标,因为 LLM 可以在候选集上进行生成或推理,候选集覆盖率不足会导致关键知识缺失
生成评估指标
- 在 RAG 系统中,评估生成输出的质量需要同时考虑流畅性、连贯性、语义准确性等多个维度。常用指标包括:
- BLEU(双语评估替补):通过计算生成文本与参考句子的 n-gram 重叠度进行评估,常用于机器翻译和文本生成任务,可视为生成任务的 “精度” 指标
- ROUGE(基于召回率的摘要评估替补):关注生成文本与参考句子的重叠度,更侧重召回率,适合摘要任务,也被称为生成任务的 “召回率”
- Meteor(显式排序翻译评估指标):在计算重叠的同时考虑词语顺序,适用于机器翻译和文本生成任务
- BERTScore:利用预训练语言模型衡量生成文本与参考句子的语义和词汇相似度,更关注语义而非表面词汇
- ParaScore:结合有参考和无参考指标的优点,针对释义生成任务建模生成文本与参考文本的词汇差
- 困惑度(PPLX):用于大型语言模型,衡量模型对参考句子的预测能力,计算输入下模型对所有可能输出概率分布的几何平均值的倒数
端到端评估指标
- 忠诚度(Faithfulness)
- 作用:衡量生成答案与原始上下文信息的匹配程度,判断答案中的所有主张是否可在原始上下文中找到
- 评分范围:0-1,分数越高匹配度越好
- 评估流程:先将答案拆分为多个陈述(基于 Prompt 1),再判断每个陈述是否被上下文支持(基于 Prompt 2)
- 答案相关性(Answer Relevance)
- 作用:评估答案与问题、上下文的关联程度,避免答案缺失关键信息或包含冗余内容
- 计算方式:生成多个基于答案的人工问题,计算原始问题与这些人工问题的嵌入向量相似度平均值,分数越高相关性越强
- 核心 Prompt:“为给定答案生成一个问题”,确保答案紧扣用户查询核心
- 上下文相关性(Context Relevance)
- 作用:衡量检索到的上下文与问题、答案的相关性,确保上下文仅包含回答问题所需的重要信息
- 评分范围:0-1,分数越高相关性越好
- 评估方式:从检索上下文中提取能回答问题的相关句子(基于特定 Prompt),无相关句子则返回 “信息不足”
- 维度评价(Aspect Critique)
- 作用:基于正确性、无害性等特定标准评估生成内容,结果为二元(符合 / 不符合标准)
- 可自定义标准:包括偏见(评估系统生成有偏见内容的可能性,可通过检索和生成环节的机制缓解)、毒性(评估系统生成冒犯性或有害内容的风险,可通过生成环节的机制处理)
Advanced RAG
查询转换 (Query Transformation)、重排序 (Re-ranking)、混合搜索 (Hybrid Search)、多路召回 (Multi-query Retriever)