DeepSeek
介绍 DeepSeek 系列模型的架构与训练方法
- Deepseek 主要技术:MTP、MLA、DualPipe、MoE 负载均衡
- 参考资料
- 帖子
- 论文
- DeepSeek:DeepSeek LLM: Scaling Open-Source Language Models with Longtermism
- DeepSeek-MoE:DeepSeekMoE: Towards Ultimate Expert Specialization in Mixture-of-Experts Language Models
- DeepSeek-V2:DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model
- DeepSeek-Coder-V2:DeepSeek-Coder-V2: Breaking the Barrier of Closed-Source Models in Code Intelligence
- DeepSeek-V3:DeepSeek-V3 Technical Report
- DeepSeek-R1:DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning
- DeepSeek-V3.2-Exp:https://github.com/deepseek-ai/DeepSeek-V3.2-Exp
- DeepSeek-V3.2:DeepSeek-V3.2: Pushing the Frontier of Open Large Language Models
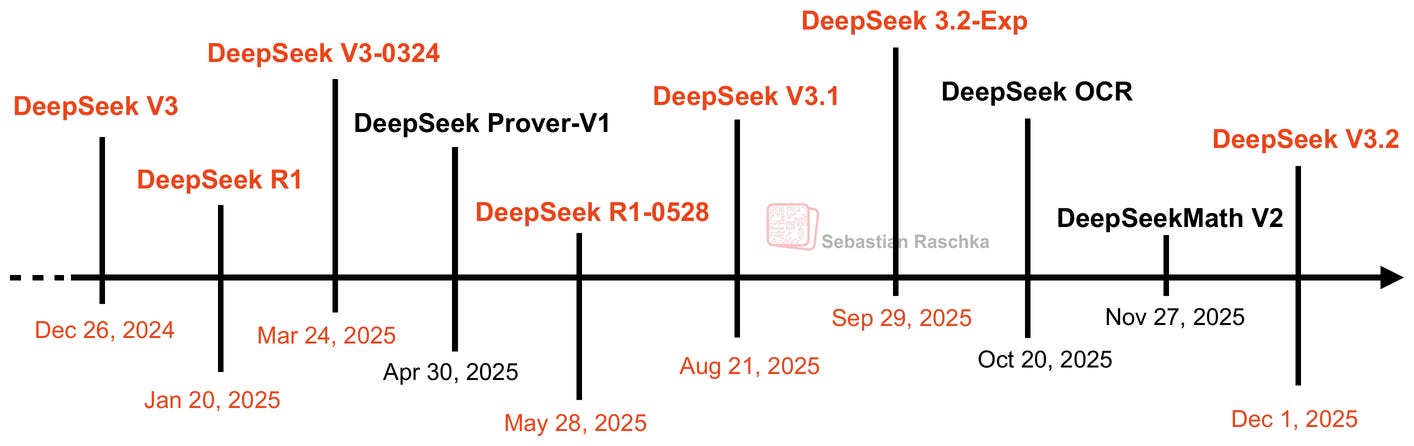
DeepSeek 技术发展
DeepSeek V3

-
架构
-
无辅助损失的负载平衡策略(auxiliary-loss-free strategy for load balancing)
-
Multi-Token Prediction(MTP)

-
-
预训练
- FP8 混合精度训练框架
- DualPipe 流水线并行算法
- 跨节点 MoE 训练的通信效率提升
- 两次长上下文扩展,最终达到 128K
-
后训练
- 监督微调
- 从 DeepSeek R1 模型生成推理数据
- 从 DeepSeek V2.5 模型生成非推理数据
- 从 DeepSeek R1 系列模型(长 CoT 模型)提炼推理能力到 DeepSeek V3 中
- 强化学习
- 基于规则的奖励模型:针对具有特定规则验证的问题(如数学问题具有准确结果,编程问题使用编译器生成反馈)
- 基于模型的奖励模型
- 针对没有明确真实答案的问题,从 DeepSeek-V3 SFT 检查点训练得到
- 构建偏好数据集,包含最终奖励和导致奖励的思维链,来避免奖励黑客
- 采用组相对策略优化(Group Relative Policy Optimization,GRPO)
- 监督微调
DeepSeek R1
DeepSeek R1-0528
DeepSeek V3.1
DeepSeek 3.2-Exp
DeepSeekMath V2
DeepSeek V3.2
这篇文档有帮助吗?