PEFT
介绍参数高效微调(PEFT)技术及其应用
- 参考资料
什么是参数高效微调
-
基本思想
- 像 BERT、GPT-3 以及其他 Transformer 这样的现代大规模模型,通常拥有数亿甚至数十亿个参数
- 针对每一个新任务都对这些模型进行完整微调,不仅计算开销巨大,而且内存占用也很高,尤其是在需要为多个任务分别维护模型副本的情况下
- 参数高效微调(Parameter-Efficient Fine-Tuning,PEFT)方法正是为了解决这一问题而提出的
- 其核心思想是:只调整模型中极小一部分参数,或者在模型中引入轻量级的附加模块,同时将绝大多数预训练权重保持冻结状态
- 通过这种方式,可以在显著降低存储和计算成本的前提下,将预训练模型高效地适配到新的任务上
-
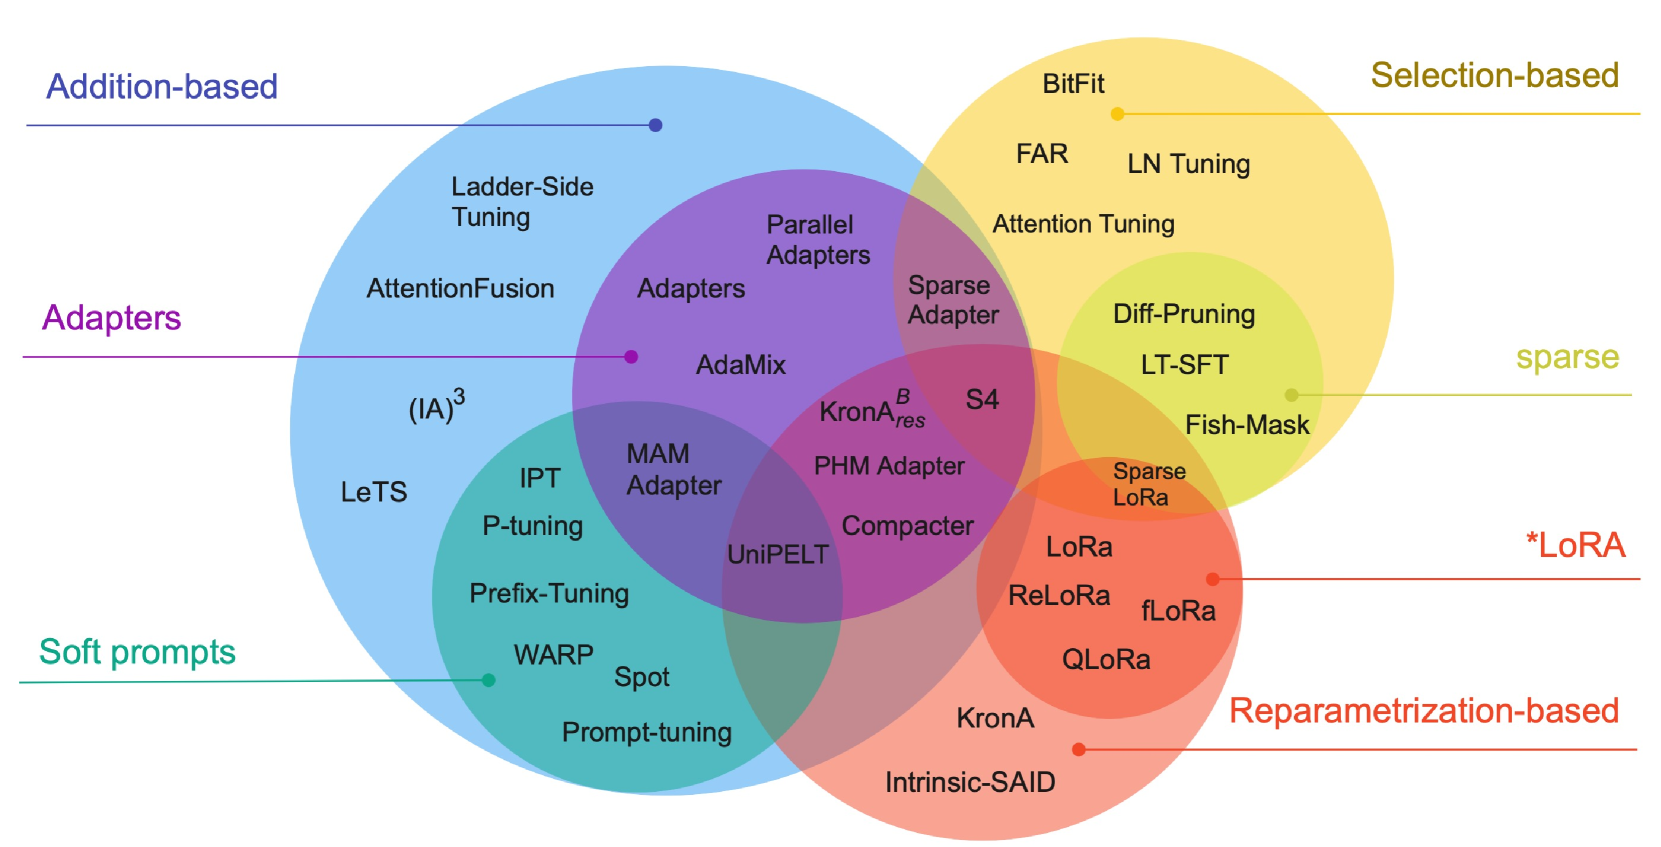
PEFT 的类型
-
PEFT 可以大致分为三类
- 引入额外参数(Additive-based):包括适配器(Adapters)、软提示(Soft prompts)、hard prompts
- 选择部分参数(Selective-based):选择参数进行更新
- 引入重参数(Reparametrization-based):LoRA(Low-rank Adaptation)系列
Additive-based Methods
基本思想
-
基于额外参数的方法通过向预训练模型中引入额外的参数或层,并且只训练这些新加入的部分来实现微调
-
这是 PEFT 方法中规模最大、研究也最为广泛的一类。
-
在这一大类中,又发展出了两个重要的子方向:Adapter 类方法和 Soft Prompt(软提示)方法
-
Adapters
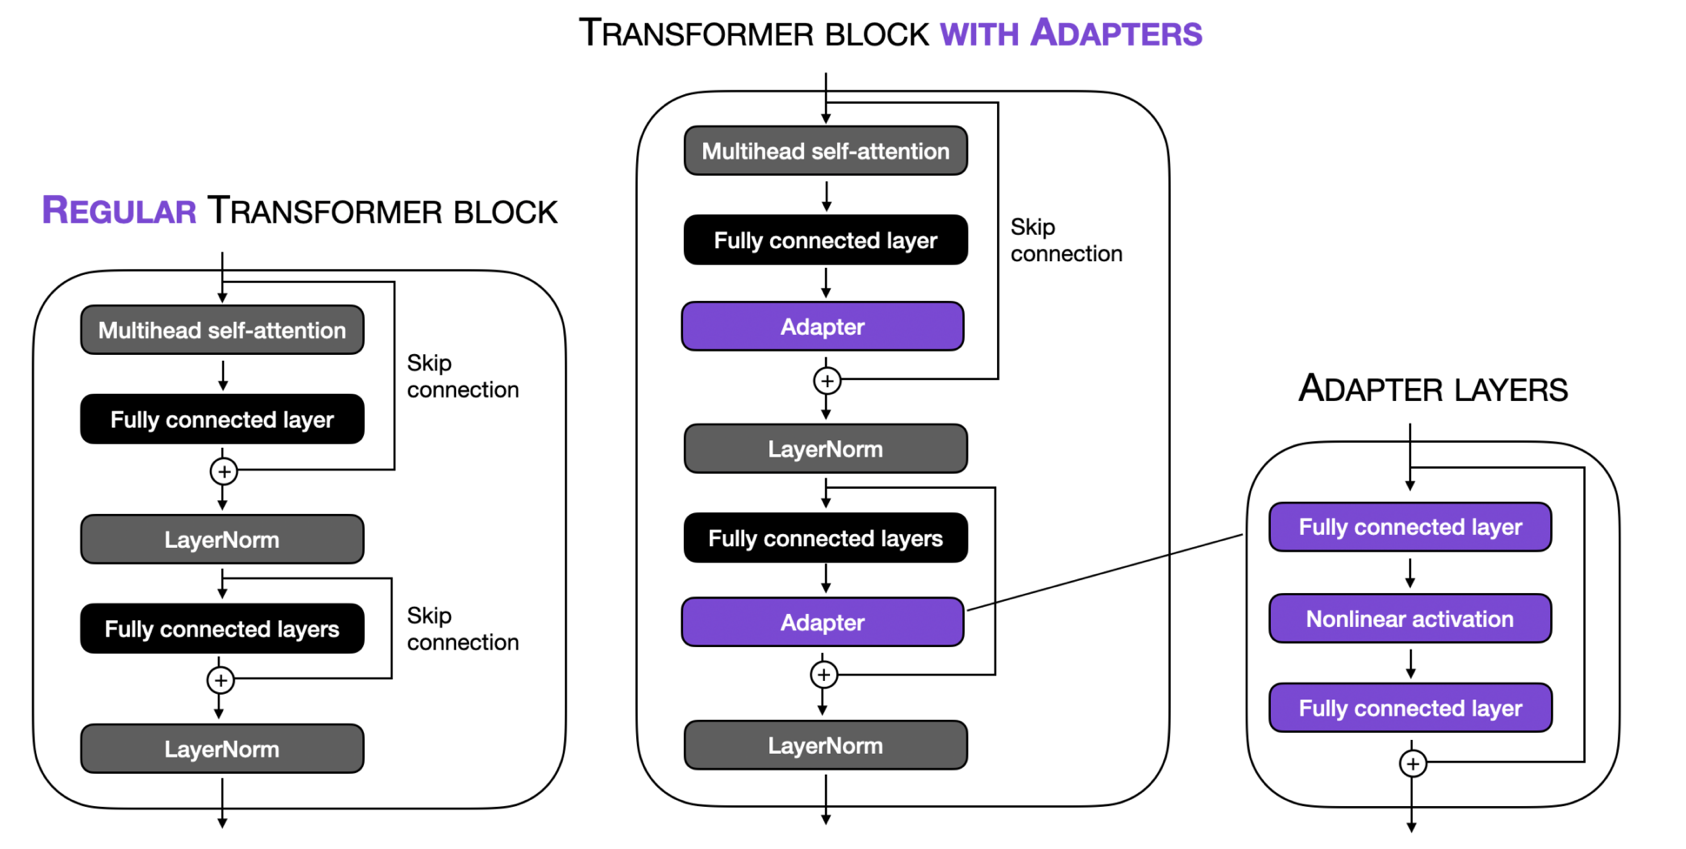
- Adapters 是一种典型的基于额外参数的 PEFT 方法,它在 Transformer 的子层之后插入小型的全连接网络
- 这一思想被广泛采用(Pfeiffer et al., 2020b,见 https://github.com/adapter-hub/adapter-transformers),并且衍生出了多种变体,包括
- 改变 Adapter 的插入位置
- 对 Adapter 进行剪枝
- 通过重参数化来减少可训练参数数量
-
Soft Prompts
- 语言模型提示旨在通过修改输入文本来控制语言模型的行为,输入通常由任务描述和少量上下文示例组成,然而,这类方法往往难以优化,并且受限于模型的最大输入长度
- 为了解决这些问题,引入了 “软提示”(Soft prompts)的概念,其核心思想是:通过梯度下降直接微调模型输入嵌入的一部分,这样就把在离散空间中搜索提示的问题,转化为了一个连续优化问题
- 软提示既可以只作用在输入层(Prompt Tuning),也可以扩展到模型的所有层(Prefix Tuning)
- 近期的一些研究还探索了对软提示进行预训练或部分复用,以进一步降低微调成本
-
基于额外参数的方法是一种非常多样化的参数高效微调技术,其范围不仅限于 Adapter 和 Soft Prompt
-
为什么要增加参数
-
尽管这些方法向网络中引入了额外参数,但它们依然能够在速度和内存占用上带来显著提升,原因在于,它们大幅减少了梯度和优化器状态的规模
-
以 Adam 为例,对于每 1 字节的可训练参数,需要额外 1 字节来存储梯度,以及 2 字节来存储优化器状态(梯度的一阶矩和二阶矩),因此在实际训练中,模型训练所需的 GPU 内存通常是模型权重本身的 12–20 倍
-
通过减少优化器状态和梯度的内存占用,并对冻结的模型参数进行量化,基于额外参数的方法使得微调更大规模的网络成为可能,或者允许使用更大的 microbatch size,从而提升 GPU 上的训练吞吐率。其中,batch size 的关系为
-
此外,由于需要更新的参数数量更少,PEFT 方法中的优化器更新步骤相比全量微调要快得多,这一点在实际中非常明显
-
同时,在分布式训练环境下,优化参数数量的减少还会显著降低通信量,这对大规模训练尤为重要
-
Adapters
-
基本思想
- 全参数微调的参数量 ,显存、通信、checkpoint 成本极高
- 但是下游任务通常只需要改变模型的 “行为偏置”,而不是重塑整个表示空间
- Adapter 的核心思想是冻结原模型参数,只引入一小组可训练参数,用极低成本实现任务适配
-
模型结构
-
Adapter 是插入在 Transformer 层中的一个小瓶颈网络(bottleneck module)
- :Transformer 层的隐藏状态
- 、
- :瓶颈维度
- :非线性激活函数(ReLU / GELU)
-
每个 Adapter 模块中的第一个全连接层会将输入投影到一个低维表示空间中;第二个全连接层再将该低维表示投影回原始的输入维度
-
这样,低秩瓶颈限制了 Adapter 的表达能力,而残差连接保证初始状态等价于原模型,不会破坏预训练分布
-
-
参数量计算
-
hidden size = 、bottleneck = 、Transformer 层数 =
-
每层 Adapter 参数量:
-
全模型 Adapter 参数量:
-
全参数微调参数量:
-
比例:
- 当 、 时,参数比例 ,参数规模显著更小
-
-
根据最初的 Adapter 论文结果,使用 Adapter 方法训练的 BERT 模型,在仅训练 3.6% 参数的情况下,就可以达到与全参数微调的 BERT 模型相当的性能
-
同时,可以针对不同的任务使用不同的 Adapter,主干则是共享的
-
伪代码
def transformer_block_with_adapter(x): residual = x x = self_attention(x) x = AdapterLayers (x) # adapter x = LayerNorm(x + residual) residual = x x = FullyConnectedLayers (x) x = AdapterLayers (x) # adapter x = LayerNorm(x + residual) return x -
Pfeiffer 发现
-
如果只在每个 Transformer block 中的 self-attention 之后(LayerNorm 之后)插入一个 adapter,其性能几乎与在同一个 block 中插入两个 adapter(通常是 attention 后一个、MLP 后一个)相当
-
attention 后的 hidden state 已经包含了任务相关的结构性信息,token 之间的依赖模式,在 attention 之后插入 adapter 收益较大
-
在 MLP 后加一个 adapter,能学到的新自由度其实高度相关,信息增益很小,但参数和计算翻倍
-
LayerNorm 之后的表示具有数值尺度稳定、各层分布一致、更接近 “模型的自然表示空间” 的性质,从而使得 adapter 接收的是一个 “干净、稳定、语义明确” 的表示,这样 adapter 的低秩更新更容易学习,不容易破坏主干网络,这也是为什么 Adapter、LoRA、Prefix / Prompt(在隐空间)几乎都偏好 LN 后或 residual 分支中插入
-
Prompt-Tuning
-
参考论文:The Power of Scale for Parameter-Efficient Prompt Tuning
-
Soft / Hard Prompt Tuning
- Hard Prompt Tuning 指使用真实的离散 token,作为 prompt 拼接到输入中,prompt 本身是自然语言或符号,不可微、不可直接反向传播 —— 也就是一般提到的提示工程
- Soft Prompt Tuning 也即一般的 Prompt / Prefix Tuning,这时 prompt 不再是离散 token,而是可训练的连续向量,直接作为 embedding 使用
-
核心问题:全参数微调代价太高,而 Adapter 仍然需要改动网络内部结构或权重,是否能只通过 “输入” 来控制模型行为?
-
Prompt / Prefix Tuning 的统一思想:冻结整个 Transformer,仅学习一小段连续向量,通过影响注意力分布来 “操控” 模型
-
本质上:不改模型,不加模块,只改模型看到的上下文表示
-
Prompt Tuning 学习的是一段连续向量 prompt,直接拼接到输入 embedding 前面
-
设原始输入 token embedding:
-
可训练 prompt:
-
模型实际输入为:
-
其中 即为学习的参数,而 是数据,Transformer 权重完全冻结
-
-
Prompt Tuning 的参数量:
- 当 、 时,参数量 ,相比 Adapter / LoRA 更小
-
训练时,梯度只更新 prompt embedding,非常稳定
-
推理时,prompt 作为额外 token,序列长度增加 ,注意力计算成本略增
-
本质上,Prompt Tuning 是在调整模型的 “条件分布起点”,改变输出风格、任务偏好
Prefix-tuning
-
Prompt Tuning 的核心限制在于 prompt 只在 embedding 层起作用,深层 Transformer 只能 “间接感知”
-
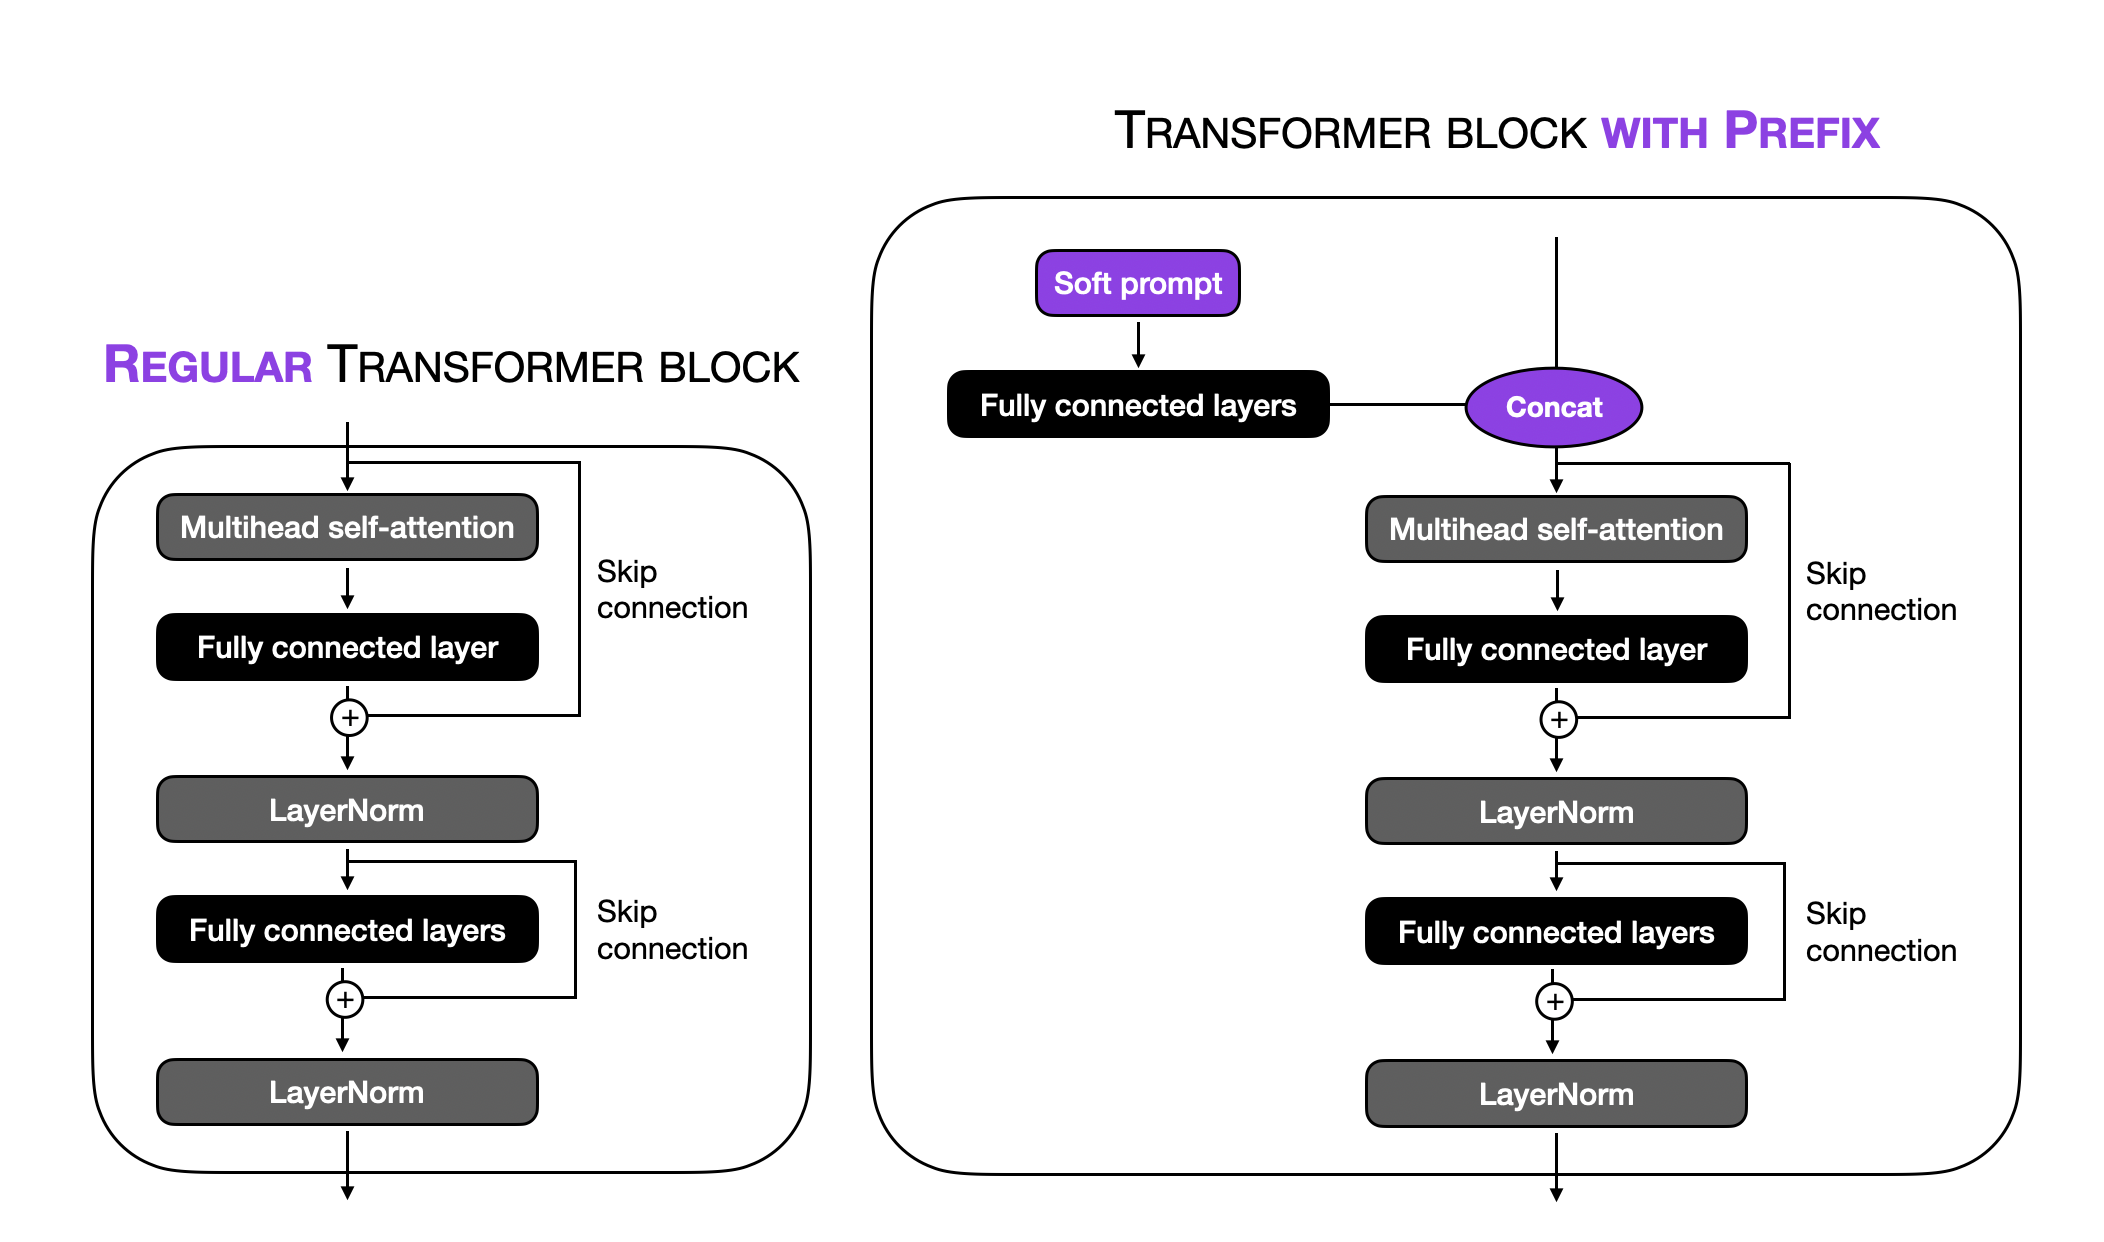
Prefix Tuning 的关键改进:在每一层注意力中都插入可学习前缀
-
形式化定义
-
Transformer 第 层注意力:
-
Prefix Tuning 学习的是:
-
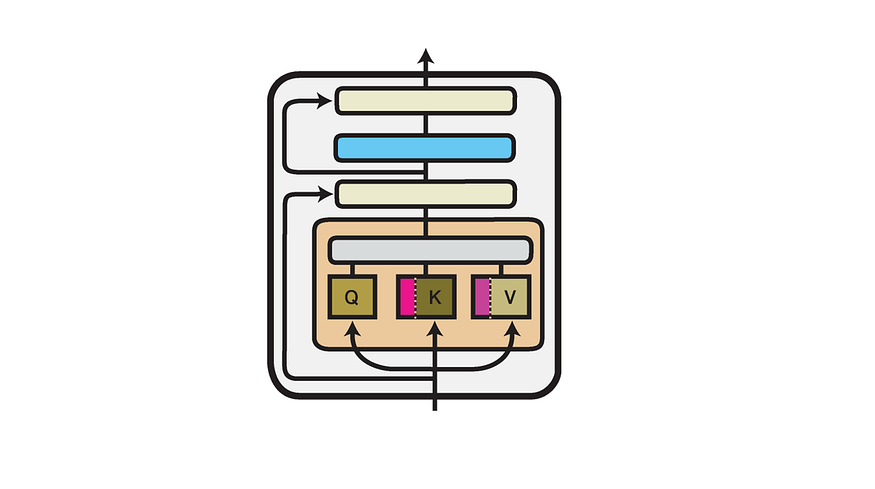
实际注意力计算变为:
-
Prefix 不参与 Query,只影响 Key / Value,且在每一层都生效
-
-
参数规模
-
若每层都有 prefix,参数量为
-
其中, 来自 和 , 是 Transformer 层数
-
为了压缩参数,实际常共享低维 prefix,使用 MLP 投影到各层
-
-
训练时,梯度流入每一层,比 Prompt Tuning 更强
-
推理时,prefix 不增加序列长度,但会增加注意力 Key / Value 缓存
-
Prefix Tuning 实际上是在学习每一层的注意力偏置,这意味着能影响深层语义,并模拟一部分 Adapter 的效果,但仍然不改 FFN / 权重
-
伪代码
def transformer_block_with_prefix(x, soft_prompt):
    soft_prompt = FullyConnectedLayers(soft_prompt)		# Prefix
    x = concatenate([soft_prompt,x],dim=seq_len)    	# Prefix
    residual = x
    x = self_attention(x)
    x = LayerNorm(x + residual)
    residual = x
    x = FullyConnectedLayers(x)
    x = LayerNorm(x + residual)
    return x
Adaptive Prefix Tuning
-
参考论文:Towards Adaptive Prefix Tuning for Parameter-Efficient Language Model Fine-tuning
-
出发点
- 普通 Prefix Tuning 的隐含假设是 prefix 是静态的,与输入 无关,对同一任务的所有样本使用同一组
- 这带来的问题是表达能力受限,无法针对不同输入动态调整注意力偏置,在复杂任务(推理、多域、多风格)上效果不稳定
- 实际上,静态 prefix ≈ 固定注意力 bias,但多样性要求输入不同,prefix 也不同,于是引出 Adaptive Prefix Tuning
-
基本思想
- Prefix 不再是参数本身,而是由输入条件生成的函数输出,即:
-
其中, 是一个小型可训练网络, 是唯一需要更新的参数,而 Transformer 主模型依然保持完全冻结
-
对于标准 Prefix Tuning,第 层注意力:
-
其中, 是直接可训练参数,与输入无关
-
Adaptive Prefix Tuning 引入条件生成器 :
-
其中 通常是输入 embedding 的池化或某一层的 CLS /mean 表示
-
这样,注意力变为:
-
参数规模
-
假设 prefix 长度 、hidden size 、条件向量维度 、层数
-
普通 Prefix:
-
Adaptive Prefix(共享 MLP):
-
Adaptive Prefix(每层独立):
-
参数量略高于静态 Prefix,但远低于 Adapter / LoRA
-
-
根本区别
- 标准 Prefix Tuning 学习的是
- Adaptive Prefix Tuning 学习的是
-
伪代码
def adaptive_adjustment(x, layer_index):
    alpha = sigmoid(W[layer_index, ...] @ x)
    adaptive_factor = lambda_[layer_index] * alpha
    return adaptive_factor


def prefix_tuning(x, layer_index):
    # adaptive gating and scaling
    adaptive_factor = adaptive_adjustment(x, layer_index)

    # soft prompt
    soft_prompt = FFN(soft_prompt)
    soft_prompt *= adaptive_factor

    # regular prefix-tuning
    x = concat([soft_prompt, x], dim=seq)
    return transformer_block(x)
Intrinsic Prompt Tuning (IPT)
-
参考论文:Exploring Universal Intrinsic Task Subspace via Prompt Tuning
-
出发点
- IPT 针对的是 Soft Prompt Tuning 的两个核心痛点:Prompt tuning 在新任务上收敛慢,每个任务都要训练一整段 prompt,参数量仍然不小()
- IPT 的核心假设是:虽然 soft prompt 定义在高维空间 ,但不同任务的 prompt 实际上位于一个低维的 “内在任务子空间” 中,即原始 prompt:,展平后:,存在低维表示 ,其中
- 这与 Intrinsic Dimension Hypothesis、Lottery Ticket / Low-rank adaptation 在思想上是一致的
-
算法流程
- 阶段一:标准 Prompt Tuning(多任务)
- 给定一组任务 ,对每个任务,独立训练一个 soft prompt
- 阶段二:学习 prompt 的低维表示(Autoencoder)
- 将每个 prompt 展平:,输入自编码器
- Encoder 学到 “任务内在坐标”,Decoder 学到 “从子空间到 prompt 的映射”
- 阶段三:新任务的 IPT 训练
- 对一个新任务,丢弃 Encoder,冻结 Decoder(或微调)
- 只训练一个低维向量
- 每个新任务只需要训练 个参数,而不是
- 阶段一:标准 Prompt Tuning(多任务)
-
参数规模对比 ——Prompt Tuning:,IPT:,其中
-
伪代码
def autoencoder(soft_prompt):
    soft_prompt = soft_prompt.flatten()
    P = FFN_A(soft_prompt)  # encoder
    P = FFN_B(P)            # decoder
    P = P.reshape(prompt_len, hidden)
    return P

def ipt_model(x):
    P = FFN_B(intrinsic_subspace_prompt)
    P = P.reshape(prompt_len, hidden)
    x = concat([P, x], dim=seq)
    return model(x)
P-Tuning
- 参考论文
Selection-based Methods
基本思想
- 最早的选择式 PEFT 方法之一是只微调网络顶部的少数几层
- 现代方法通常基于层的类型,或者基于模型的内部结构来进行选择,例如只微调模型中的偏置参数,或者仅微调特定的参数行
- 稀疏训练是选择式 PEFT 的另一种形式,它往往不显式考虑模型结构,而是根据精心设计的选择准则来决定哪些参数参与微调
- 然而,稀疏参数更新在工程实现和计算效率方面面临诸多挑战
- 近年来的一些研究在参数重配置(Parameter Reconfiguration)以及 NxM 稀疏性方面对这些问题进行了部分缓解
- 但即便如此,在当前主流硬件上,完全不受约束的非结构化稀疏仍然不具备实用性
BitFit (Bias Fine-Tuning)
Sparse Fine-Tuning
Reparametrization-based Methods
基本思想
-
基于重参数化的 PEFT 方法通过利用低秩表示来最小化可训练参数的数量
-
神经网络具有低维表示这一观点,已经在深度学习的经验研究和理论分析中被广泛探讨
-
Aghajanyan et al. (2020) 证明了在低秩子空间中同样可以有效地进行微调,同时发现对于规模更大的模型,或者预训练时间更长的模型,所需进行适配的子空间维度反而更小
-
他们提出的方法被称为 Intrinsic SAID,该方法利用 Fastfood 变换对神经网络参数的更新进行重参数化
-
这一思想启发了多种后续方法,包括 IntrinsicSAID、LoRA 以及 KronA
-
在这些方法中,最为人熟知的是 Low-Rank Adaptation(LoRA),其采用一种简单的低秩矩阵分解来参数化权重更新:
-
这种方法实现起来非常直接,并且已经在参数规模高达 1750 亿的模型上进行了验证
-
此外,一些工作还探索了使用 Kronecker 积进行重参数化:
-
这种方式在秩大小与参数数量之间提供了更优的权衡
Intrinsic SAID
-
参考论文:Intrinsic Dimensionality Explains the Effectiveness of Language Model Fine-Tuning
-
Intrinsic SAID 研究的是一个非常根本的问题
-
微调一个大模型时,真正 “有用” 的参数自由度到底有多少?
-
换句话说,虽然模型参数维度是 (动辄 ),但是否只需要在一个远小于 的子空间中更新,就能达到同样效果?
-
这就是 Intrinsic Dimensionality(内在维度) 问题
-
-
Aghajanyan 等人的研究发现
-
为了达到同样的微调性能,模型越大,所需的内在可调维度越低
-
即原始参数为 ,而实际需要优化的自由度:
-
这为两个方向提供了理论基础:
-
模型越大,越适合参数高效微调
-
不必显式地修改少量参数(如 Adapter),也可以低维控制 “全模型更新”
-
-
-
Intrinsic SAID 的核心技术是 Fastfood Transform,它定义了一个映射:
-
并用它来表示参数更新:
-
是唯一需要训练的参数
-
是一个投影到全参数空间的 “低秩扰动”
-
Fastfood 是一种随机但结构化、计算高效、不需要显式存储 矩阵的高维扩展方法
-
它的关键性质是计算复杂度:,内存复杂度:,可以近似一个随机高斯投影
-
直觉上, 是 “控制旋钮”,而 Fastfood 把它 “扩散” 成作用于所有参数的更新方向
-
-
Intrinsic SAID 与 “选择性微调” 的根本区别
-
其他 PEFT 方法(Adapter / LoRA / Prompt):只更新模型的一小部分参数,其余参数完全冻结
-
Intrinsic SAID:更新所有模型参数,但更新方向被限制在一个低维子空间中
-
也就是说,参数空间是 维,但可达更新空间是 维
-
-
Intrinsic SAID 在工程上几乎不可用
- Fastfood 本身需要 内存,虽然不训练 个参数,但 Fastfood 需要存储结构化映射,并在每一步生成 维更新
- 每次更新都要对所有参数生效,无法像 LoRA / Adapter 那样局部注入
- Intrinsic SAID 不适合 ZeRO / FSDP,不适合参数分片,不适合增量 checkpoint
LoRA
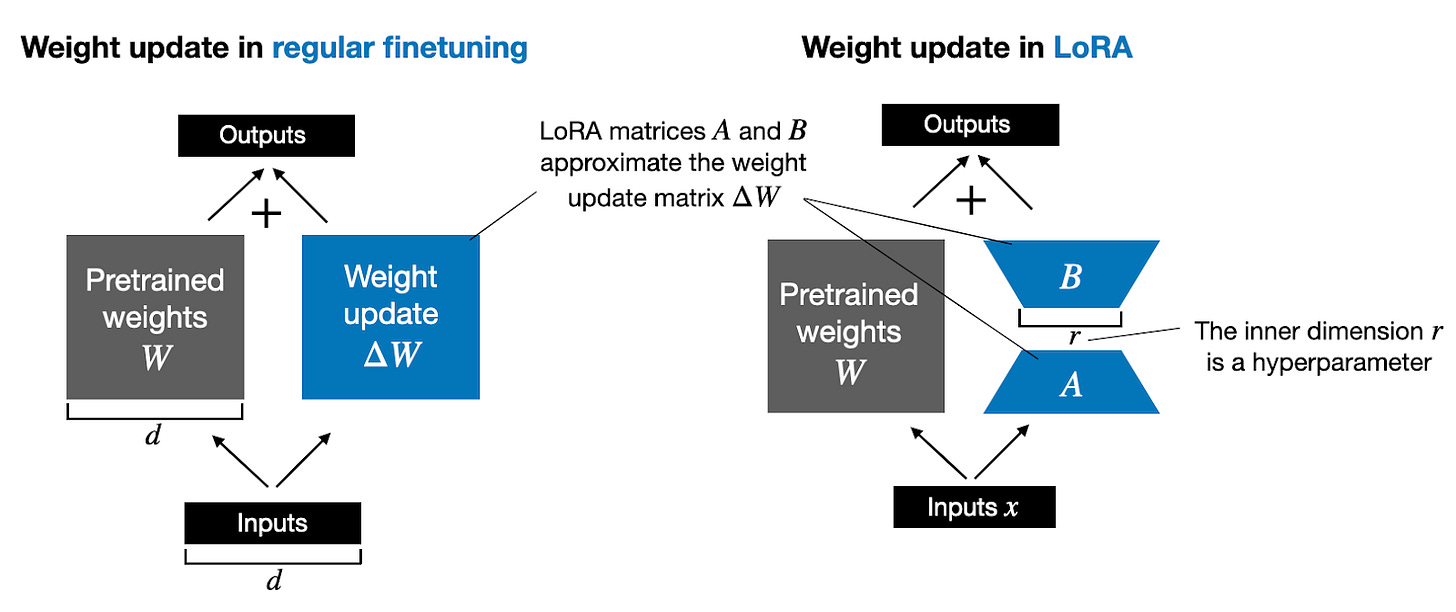
-
基本思想
-
设一个大模型包含一个权重矩阵
-
例如总参数规模是 7B,在标准微调中,反向传播会学习一个与 同形状的更新量:
-
问题在于, 和 一样大,需要存梯度、optimizer states(Adam: 2×FP32),显存和带宽成本与模型规模线性增长,这在 7B、70B 甚至 175B 模型上是不可承受的
-
LoRA(Hu et al., 2022)基于一个关键观察:虽然 是高维的,但任务相关的权重更新 通常位于一个低秩子空间
-
因此,LoRA 不直接学习 ,而是令:
-
这就是 LoRA 的低秩分解
-
-
参数量节省
- 原始微调需要优化的参数量:
- LoRA 需要优化的参数量:
- 当 很小时(如 4、8、16),参数量下降 10–100×,梯度、optimizer states 同比例下降,显存占用显著减少
-
LoRA 的关键工程优势在于:
- 训练时从不构造 ,只在前向中引入一个额外的低秩路径
- 前向计算为 ,其中缩放因子通常是
-
训练阶段:冻结 ,只训练 ,梯度只回传到低秩矩阵
-
推理 / 合并阶段:可以显式合并权重 ,推理时无额外计算开销,与原模型结构完全一致
-
LoRA 的思想直接继承自 Intrinsic SAID:
-
Intrinsic SAID:更新在低维子空间中,低维变量 → Fastfood → 更新所有参数(不实用)
-
LoRA:用显式低秩矩阵来参数化这个子空间,低维变量 → 低秩矩阵 → 局部权重(工程可行)
-
LoRA 是 Intrinsic SAID 的 “工程化版本”
-
-
LoRA 应用到哪些部分
- 最常见的位置是多头注意力中的 、、、
- 原因是注意力对任务适配高度敏感,权重矩阵形状规则、适合低秩分解
- 但后续研究表明对所有线性层应用 LoRA,效果最好,包括 MLP 的 up /down/gate 投影
-
输出计算方法为:
-
其中, 表示预训练权重(旧知识), 表示增量权重 的近似(新知识)
-
理论上说,当 较小时,提取的是 中信息含量最丰富的维度,此时信息精炼,但不全面
-
当 较大时,我们的低秩近似越逼近 ,此时信息更加全面,但带来的噪声也越多(含有很多冗余无效的信息)
-
基于这个猜想,当第一次做实验时,尽量把 调得大些,例如 32、64,并假设在这个秩下,低秩权重已经非常近似 了,因此这时设置 ,意味着我们假定 LoRA 低秩微调的效果和全参数微调持平
-
那么接下来,往小的 进行尝试,这时把 固定住,意味着随着 的减小, 会越来越大,这样做的原因是:
- 当 越小时,低秩矩阵表示的信息精炼,但不全面
- 我们通过调大 ,来放大 forward 过程中新知识对模型的影响
- 当 越小时,低秩矩阵表示的信息精炼,噪声 / 冗余信息少,此时梯度下降的方向也更加确信,所以可以通过调大 ,适当增加梯度下降的步伐,也就相当于调整 learning rate 了
-
伪代码
def lora_linear(x):
    h = x @ W          # frozen base weight
    dh = x @ W_A @ W_B # low-rank update
    h += scale * dh    # scaling
    return h
KronA
-
LoRA 的局限
-
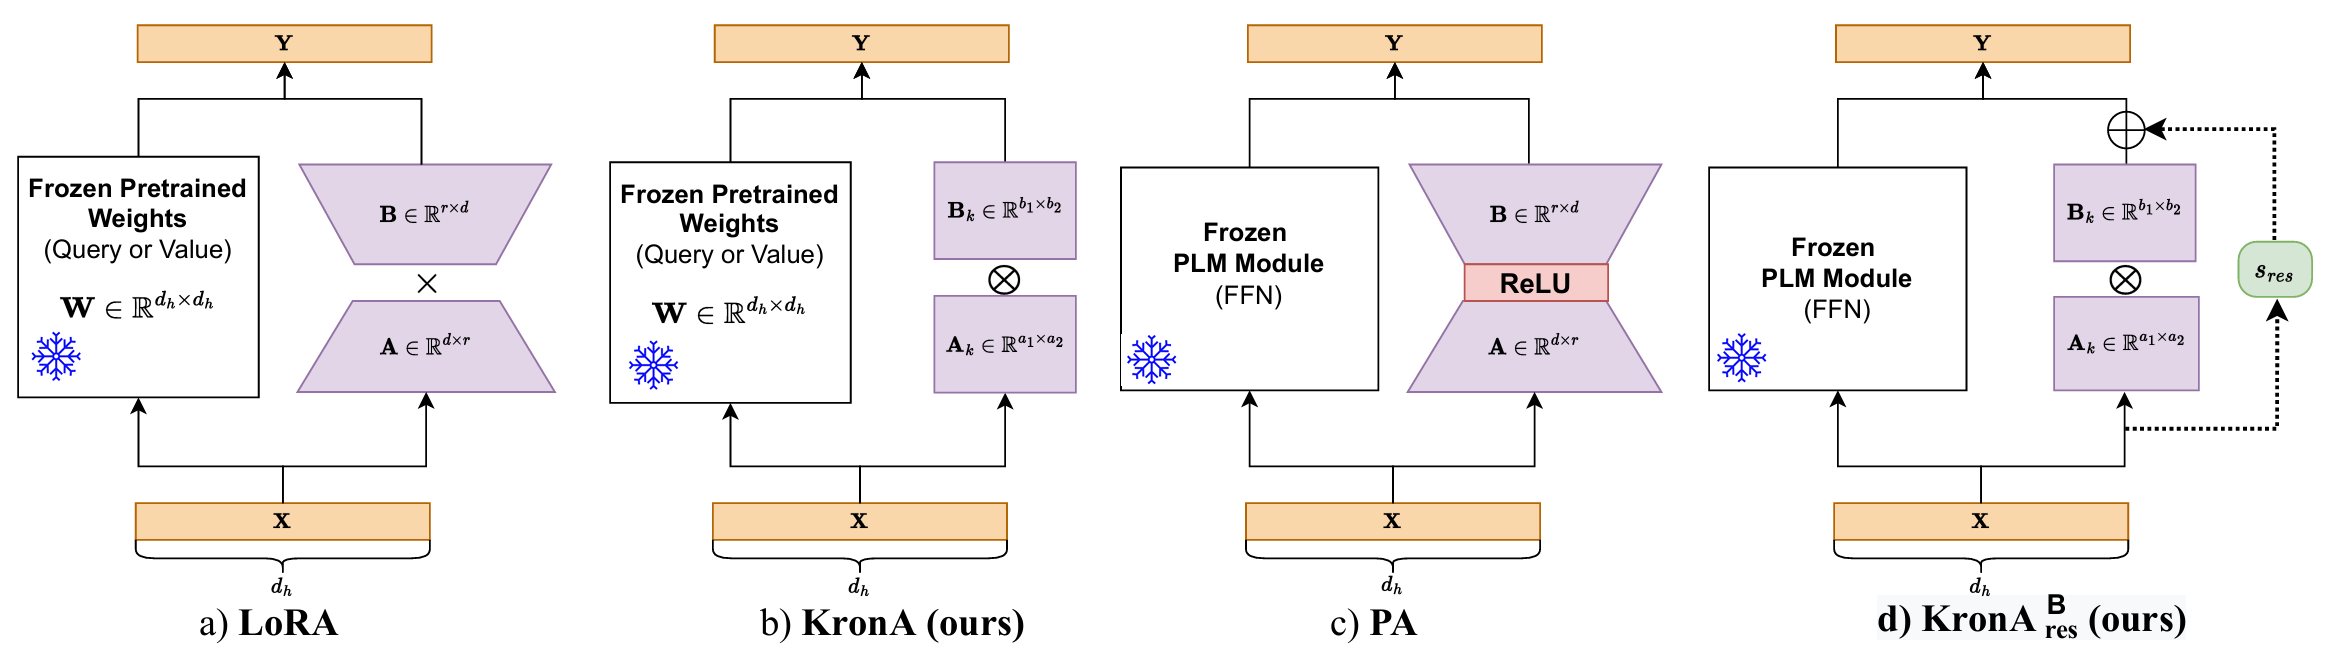
LoRA 用的是低秩矩阵乘法来参数化权重更新:
- 其中 、
-
这在工程上非常高效,但有一个结构性限制:
-
也就是说,参数量和可表达的秩是线性绑定的,想要更高表达能力,就必须增大 ,参数量随之线性增加
-
KronA 的核心想法是:能不能在相同参数预算下,得到更高 “有效秩” 的更新?
-
-
KronA 的核心思想:用 Kronecker 积代替矩阵乘法
-
KronA 不再使用矩阵乘法,而是改为
-
其中 、、
-
关键性质是 Kronecker 积的秩:
-
这意味着如果 和 都是低秩的,它们的 Kronecker 积可以拥有显著更高的秩
-
-
为什么 Kronecker 积更划算
- 假设 LoRA:参数量 ,秩 ,KronA:参数量 ,秩
- 在合理拆分矩阵形状的情况下,KronA 用相同甚至更少参数,可以表达更复杂的线性变换结构,尤其适合具有二维或块结构的权重矩阵
- 直觉上,LoRA 是 “一条低维通道”,而 KronA 是 “两个低维结构的张量化组合”
-
和 LoRA 一样,KronA 也不会显式构造 Kronecker 积,而是直接计算:
-
利用 Kronecker 积的恒等式:
-
KronA 的实现思路是先把向量 reshape 成矩阵,然后左乘 ,再右乘 ,最后 flatten 回向量
-
-
在 GLUE 上,参数预算约为 时:
- 性能:KronA ≥ LoRA ≈ Adapter ≈ Compacter
- 推理速度:KronA 显著快于 Adapter 和 Compacter
- 训练参数量:相同
- 其优势主要来自更高表达秩、无中间层、纯线性算子
-
KronA-resB—— 带残差的并行 Adapter
-
伪代码
# same as x @ kronecker_product(A, B) def kronecker_vector_prod(x, A, B): x = x.reshape(A.shape[1], B.shape[1]) x = A.T @ x @ B return x.reshape(-1) def krona_linear(x): x = x @ W # frozen base weight x += kronecker_vector_prod(x, W_A, W_B) return scale * x -
Kronecker 积定义为:
-
其本质是用 的每个元素去缩放整个 ,构造一个具有强结构性的 “大矩阵”
-
PyTorch 中可用 einsum 实现 batch 版本:
def batched_kronecker_product(a, b):
    bs, i, j = a.shape
    bs, k, m = b.shape
    res = einsum("bij,bkm->bikjm", a, b)
    return res.view(bs, i - k, j - m)
-
DoRA
-
方向变化与模长变化的关系
-
设某一层权重矩阵为 ,比较微调前后:
- 方向变化:
- 模长变化:
-
DoRA 对全量微调的多个 checkpoint 和多层权重做了统计,发现:
- full fine-tuning 中, 与 呈显著负相关
- 要改变方向很多,模长变化往往很小
- 模长变化很大时,方向反而变化较小
-
但在 LoRA 微调中,现象恰好相反:
- 与 正相关
- 方向变化越大,模长也被迫一起变大
-
这说明 LoRA 在结构上把 “方向” 和 “模长” 耦合在了一起
-
这是由于在 LoRA 的权重更新中, 同时决定了权重方向和权重整体模长,优化器无法 “只调方向、不动模长” 或 “只调模长、不改方向”
-
-
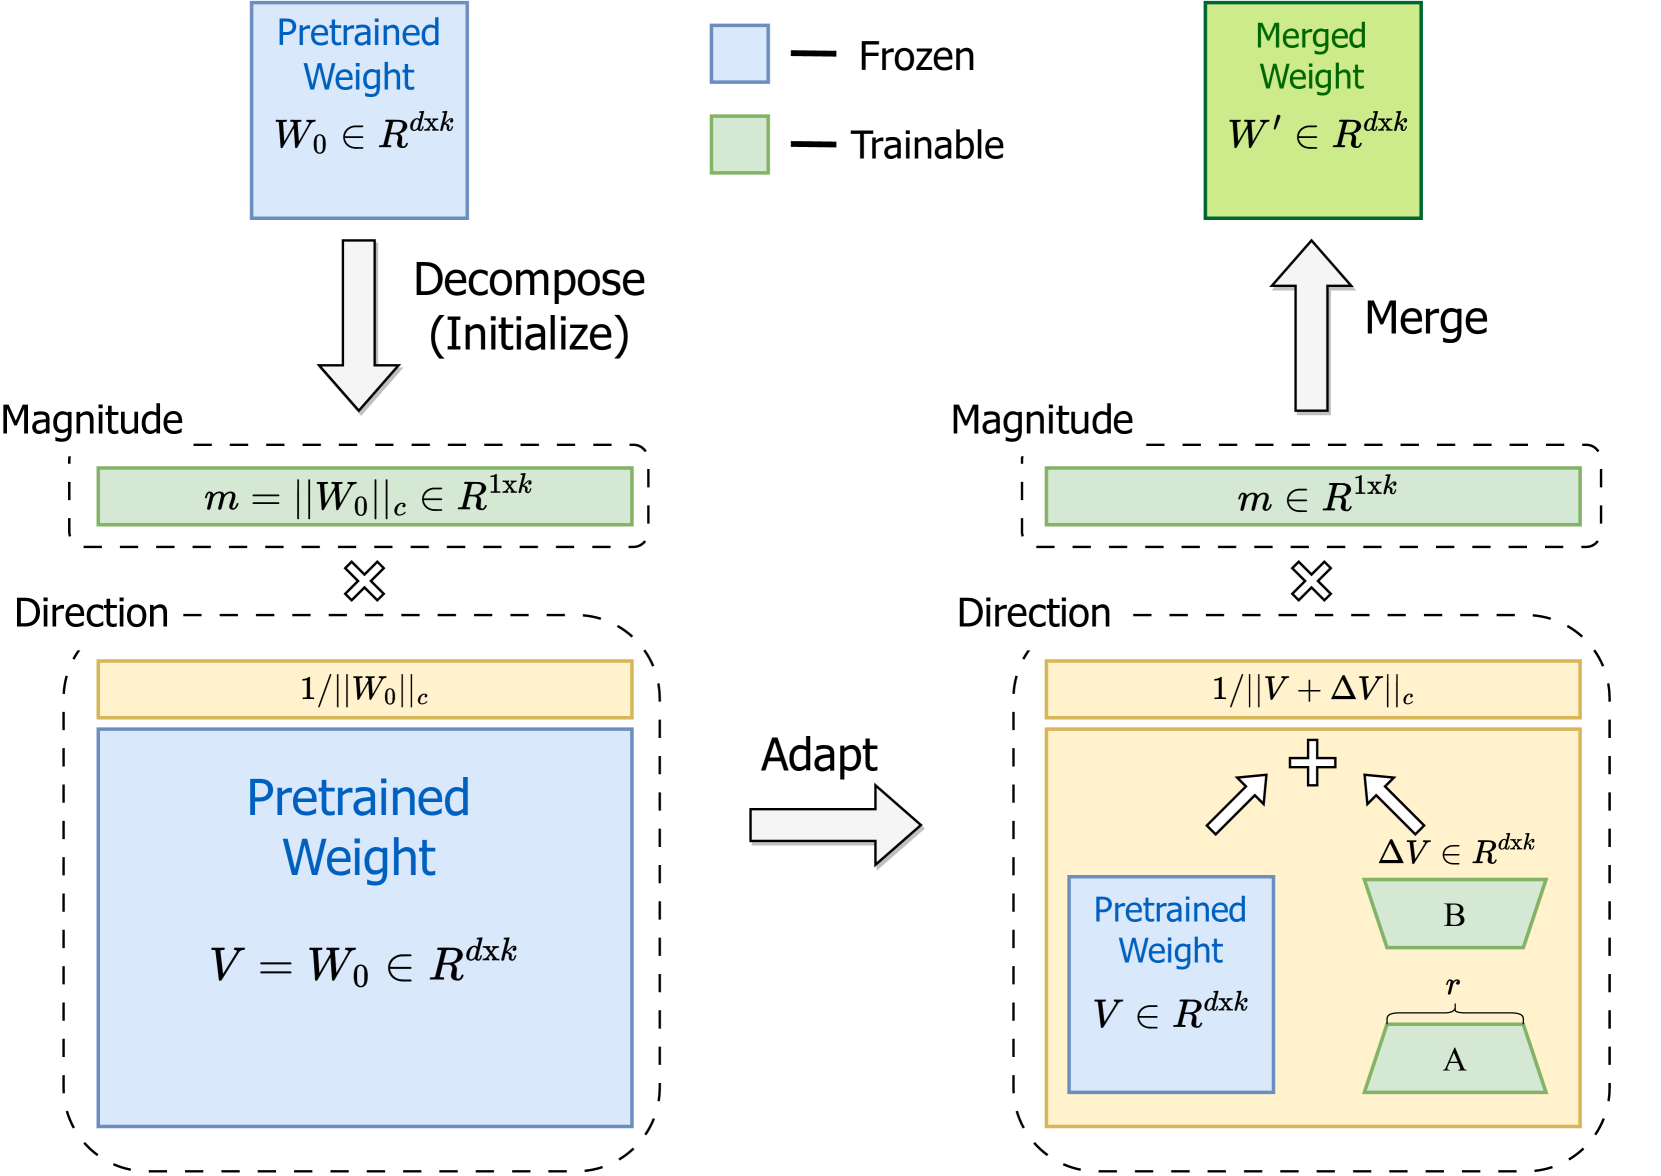
DoRA 借鉴了 weight normalization 的思想,将权重拆成:
- 其中 表示方向(direction), 表示模长(magnitude,可学习标量)
- 方向由 LoRA-style 的低秩更新负责,模长由一个独立的可学习参数 负责
- 这种重参数化带来的直接后果是改变 主要影响 (方向),改变 只影响整体尺度
- 因此模型可以用很小的模长变化实现大的方向旋转,或保持方向稳定,仅缩放权重强度
- 这在理论上恢复了 full fine-tuning 中观察到的现象
-
DoRA 在低秩设置下提升尤其明显
- 在 rank 很小(如 4, 8)时 LoRA 的表达能力严重受限,每一次方向改变都会 “浪费” 参数去同时调整模长
- 而 DoRA 把有限的低秩参数全部用于 “方向调整”,把 “模长自由度” 单独交给
- 结果是在极低 rank 下,DoRA 的有效表达能力显著高于 LoRA,指令微调、few-shot 场景中 sample efficiency 更高
-
伪代码
def initialize_m(W):
    m = Parameter(l2_norm(W), requires_grad=True)
    return m

def dora_linear(x):
    W_cur = W + (W_A @ W_B)
    v = W_cur / l2_norm(W_cur)
    W_cur = m * v
    return x @ W_cur + b
GLoRA(Generalized-LoRA)
-
标准 LoRA 只通过 “加法” 改变权重,不改变输入、激活或偏置的缩放结构,表达能力受限于低秩与仅加性更新,这在复杂任务(分布变化大、非线性强)上可能不够
-
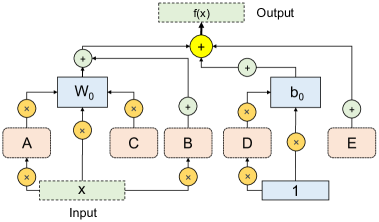
GLoRA 的假设是 LoRA 只改变 “权重的加性部分” 还不够,更强的适配需要权重缩放、激活缩放、偏置修正,但仍希望训练时参数可学习推理时不引入额外结构或计算,因此提出了 Generalized-LoRA(GLoRA)
-
GLoRA 对线性层的更新为:
-
冻结参数 :预训练权重、:预训练偏置
-
可训练参数:
- :权重缩放(右乘),相当于对原始权重进行任务相关的 re-scaling,能表达通道级、子空间级的适配
- :LoRA-style 权重增量,等价于 LoRA 的 ,负责主要的方向性变化
- :输出平移(activation shift),类似一个 data-independent 的残差,用于任务级 bias /prior 注入
- :偏置缩放
- :偏置平移
-
其中 A、B、C 矩阵都可以进行低秩分解来减少参数量;A、C、D、E 可以退化为对角矩阵 / 向量 / 标量,从而严格控制参数预算
-
-
模型合并,所有可学习参数在训练后都可以合并进:
-
新权重:
-
新偏置:
-
-
伪代码
def glora_linear(x):
    # frozen parameters
    # W_0: pre-trained weight
    # b_0: pre-trained bias (optional)

    # learnable GLoRA parameters
    # A: weight scaling
    # B: LoRA-style additive update
    # C: activation shift
    # D: bias scaling
    # E: bias shift

    # effective weight
    W_cur = W_0 + W_0 @ A + B

    # main linear transformation
    h = x @ W_cur + C @ W_0

    # bias adjustment (optional)
    if bias_present:
        h = h + D * b_0 + E + b_0

    return h
AdaLoRA
-
参考论文:AdaLoRA: Adaptive Budget Allocation for Parameter-Efficient Fine-Tuning
-
出发点
- 标准 LoRA 有一个关键超参数:秩 ,问题在于:
- 在训练前固定,但是不同层、不同任务对 rank 的需求差异极大
- 统一使用相同 会导致:有些层 rank 过高,浪费参数,而有些层 rank 不够,限制性能
- AdaLoRA 的核心目标是在给定参数预算下,自动把 rank 分配到 “更重要” 的层和方向上,训练过程中动态降低不重要的 rank
- 标准 LoRA 有一个关键超参数:秩 ,问题在于:
-
AdaLoRA 将 LoRA 的更新写成一种 SVD-like 形式:
-
其中 、、 是对角矩阵
-
可以把它类比为:
-
每一维 rank 都有一个独立的重要性系数 ,而 rank 是否 “有用”,由 决定
-
-
AdaLoRA 的核心思想是剪掉不重要的奇异值
-
并非所有 rank 维度对 loss 同样重要,如果某个 对 loss 影响很小,就可以把这一 rank 删除
-
因此 AdaLoRA 在训练中不断计算每个 rank 维度的重要性分数,剪掉分数最低的 rank,逐步降低有效秩
-
AdaLoRA 定义 importance score 来衡量当前 rank 维度对 loss 的影响程度
- 分数依赖于参数本身 和梯度信息
- 形式上是一个加权组合
- 为了避免抖动,AdaLoRA 使用指数滑动平均(EMA)平滑 importance score
-
Rank 剪枝(pruning)过程
-
给定当前 rank 和 目标剪枝数
-
计算 importance score ,找到最小的 个维度
-
对这些维度执行剪枝:将对应的 ,停止这些维度的梯度更新,等价于删除对应 rank
-
这样,有效 rank 从 变为
-
-
为了让 SVD-like 解释成立,AdaLoRA 还引入了 和 的正交正则项,目的是为了减少不同 rank 维度之间的信息冗余,让每个 更 “可解释”
-
-
相关实验发现,Transformer 的浅层不需要高 rank 更新,而深层对 rank 更敏感,AdaLoRA 会自动把 rank “迁移” 到深层
-
AdaLoRA 的代价
- 需要维护额外状态变量:、、、
- 剪枝过程依赖梯度统计和 EMA
- 当模型很大或初始 rank 很高时,内存开销显著
- 所以后来的工作尝试选择更轻量 rank 或无需额外状态的自适应 LoRA
-
伪代码
def prune(W_A, W_B, lambda_, dW_A, dW_B, dlambda, k):
    # calculate importance score for each rank dimension
    s = importance_score(W_A, W_B, lambda_, dW_A, dW_B, dlambda)

    # find bottom-k least important ranks
    indices = find_bottom_k(s, k)

    # prune corresponding rank dimensions
    W_A[:, indices] = W_A[:, indices].detach()
    W_B[indices, :] = W_B[indices, :].detach()

    lambda_[indices] = 0
    lambda_[indices] = lambda_[indices].detach()

    return W_A, W_B, lambda_

def ada_lora_linear(x):
    # frozen pretrained weight
    h = x @ W_0

    # adaptive low-rank update
    h += x @ W_A @ lambda_ @ W_B

    return h
GaLore
-
参考论文:GaLore: Memory-Efficient LLM Training by Gradient Low-Rank Projection
-
GaLore 要解决的根本问题
- 大多数 PEFT 方法(LoRA、Adapter、Prefix 等)的共同特点是冻结大部分模型参数、只训练一小部分参数,用 “参数受限” 换取 “显存节省”
- 但这样做有一个根本代价:表达能力下降,和全量微调之间存在不可避免的性能差距
- GaLore 的核心问题意识是全量微调真正吃显存的不是参数本身,而是优化器状态(动量和方差),特别是 Adam 类优化器需要存储和参数等大的一阶动量和二阶动量,总显存
- GaLore 不减少可训练参数数量,而是在低秩子空间中表示梯度、做动量更新、做正则化,然后再把更新后的梯度投影回原空间
- 即参数是 full-rank,但是梯度统计是 low-rank
-
GaLore 和 LoRA 的对比
LoRA GaLore 是否冻结参数 是 否 是否低秩参数 是() 否 是否低秩梯度 否 是 显存节省来源 参数 + 梯度 优化器状态 表达能力 受限 接近全量微调 -
数学流程
-
假设当前参数为 ,梯度为
-
(1) 梯度的低秩分解
-
对梯度矩阵做 SVD 分解:
-
选择较小的一侧作为投影基,若 ,选 ,否则选 ,记投影矩阵为
-
-
(2) 梯度投影到低维空间
- 是低维梯度,后续优化器状态都只维护在这个空间中
-
(3) 低维空间中的 Adam 更新
- 在低维空间维护一阶动量 和二阶动量 ,并做标准 Adam 更新:
-
(4) 投影回原始参数空间
-
(5) 最终参数更新:
-
-
假设参数维度 ,投影维度 ,Adam 状态显存从 降低到 ,但参数本身仍是 full-rank
-
GaLore 的理论分析表明大模型的梯度天然集中在低秩子空间,只在该子空间中维护历史统计,不会显著损害优化轨迹
-
伪代码
def update_momentum(grad_):
    # first-order momentum
    m = beta_1 * m + (1 - beta_1) * grad_
    m /= (1 - beta_1**t)

    # second-order momentum
    v = beta_2 * v + (1 - beta_2) * grad_**2
    v /= (1 - beta_2**t)

    return m, v

def galore_update(w, grad, lr):
    # low-rank decomposition of gradient
    u, s, v = SVD(grad)

    m_dim, n_dim = u.shape[-1], v.shape[0]
    P = u if m_dim < n_dim else v

    # project gradient to low-dimensional space
    grad_ = P.T @ grad

    # update optimizer states in low-dim space
    m, v = update_momentum(grad_)

    # gradient regularization (Adam-style)
    g = m / (sqrt(v) + eps)

    # project back to original space
    grad = alpha * (P @ g)

    # parameter update
    return w - lr * grad
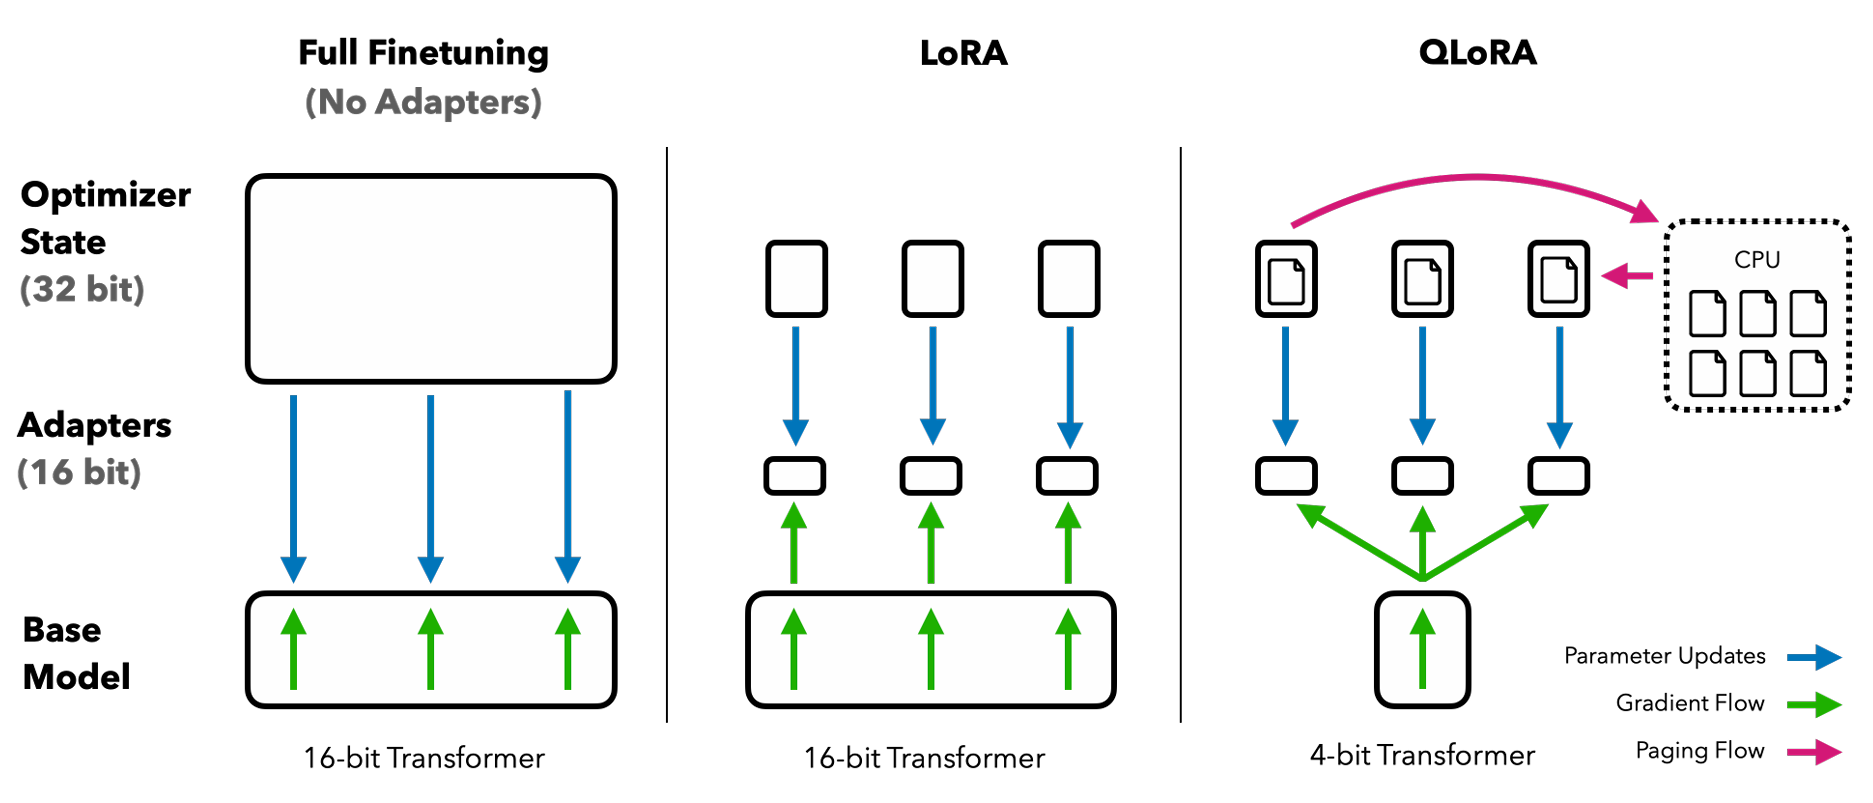
Quantization and LoRA (QLoRA)
-
LoRA 仍然基于大模型本身
- LoRA 的基本假设是冻结 backbone LLM,只训练低秩矩阵
- 这在训练参数数量上非常省,但存在一个被忽略的问题:冻结的 backbone 仍然以 FP16 / BF16 / FP32 存在于 GPU 中
- 也就是说,LoRA 解决了 “反向传播”,但没解决 “模型本体太大”
-
QLoRA 的目标是
- 在不损失 LoRA 效果的前提下,把 frozen backbone 的显存占用压到极限
- 关键洞察是冻结权重不需要高精度,只要前向数值足够稳定即可
-
4-bit NormalFloat (NF4)
-
QLoRA 使用了一种新的 4-bit 量化格式:NormalFloat 4(NF4)
-
假设权重服从近似正态分布,使用非均匀量化点,在 4-bit 下最大化信息保留
-
相比 INT4 和 FP4,NF4 在语言模型权重上表现更稳定
-
这样,backbone 权重从 BF16(2 bytes)降到 4-bit(0.5 bytes),显存直接缩小 4 倍
-
-
Double Quantization(量化的量化)
- 量化权重通常需要 scale 和 zero-point,这些量化常数本身是 FP16 / FP32,会带来额外显存开销
- QLoRA 引入对量化常数再做一次量化,即权重被量化,量化参数也被量化
-
Optimizer State Paging(CPU–GPU 分页)
- 即使 LoRA 参数很小,Adam 仍然可能在梯度 spike、梯度累积、多任务 batch 时造成显存峰值
- QLoRA 的解决方案是将 optimizer states 放在 CPU,按需 paging 到 GPU,这使得单卡消费级 GPU 也能训 65B 模型
-
QloRA 在训练时:
- backbone:4-bit NF4 + frozen
- LoRA 参数:FP16 / BF16 + trainable
- 前向:量化权重 on-the-fly dequant
- 反向:梯度只流经 LoRA
-
一个现实问题是 QLoRA 训练完成后,通常希望部署一个全量化模型,但研究发现对 LoRA-tuned 模型再做 post-training quantization,性能明显下降,原因在于 LoRA 学到的更新假设权重是高精度的,导致训练阶段与部署阶段数值分布不一致,从而引出了 Group-wise Quantization
混合方法
-
一些方法将多个 PEFT 类别中的思想结合在一起,这种做法允许在不同的算法权衡之间进行组合,以针对特定目标进行优化,例如减少可训练参数的数量
- MAM Adapter 同时结合了 Adapter 和 Prompt Tuning
- UniPELT 在此基础上进一步引入了 LoRA
- Compacter 和 KronAresB 通过使用 Kronecker 积对 Adapter 进行重参数化,从而减少其参数量
-
下表比较了不同 PEFT 方法在存储(disk)、内存(RAM)以及计算效率方面的表现
-
计算效率包括反向传播成本(BP)的降低以及推理阶段的额外开销(inference overhead)
-
✓ 表示该方法在该维度上优于全参数微调,✗ 表示劣于全参数微调
-
A:基于额外参数的方法
-
S:选择性方法
-
R:基于重参数化的方法
-
| Method | Type | Disk | RAM | BP | Inference overhead | Notes |
|---|---|---|---|---|---|---|
| Adapters Houlsby et al. (2019) | A | ✓ | ✓ | ✗ | + FFN | |
| AdaMix Wang et al. (2022) | A | ✓ | ✓ | ✗ | + FFN | |
| SparseAdapter He et al. (2022b) | AS | ✓ | ✓ | ✗ | + FFN | |
| Cross-Attn tuning Gheini et al. (2021) | S | ✓ | ✓ | ✗ | No overhead | |
| BitFit Ben-Zaken et al. (2021) | S | ✓ | ✓ | ✗ | No overhead | |
| DiffPruning Guo et al. (2020) | S | ✓ | ✗ | ✗ | No overhead | |
| Fish-Mask Sung et al. (2021) | S | ✓ | ✗ | ✗ | No overhead | |
| LT-SFT Ansell et al. (2022) | S | ✓ | ✗ | ✗ | No overhead | |
| Prompt Tuning Lester et al. (2021) | A | ✓ | ✓ | ✗ | + input | |
| Prefix-Tuning Li and Liang (2021) | A | ✓ | ✓ | ✗ | + input | |
| Spot Vu et al. (2021) | A | ✓ | ✓ | ✗ | + input | |
| IPT Qin et al. (2021) | A | ✓ | ✓ | ✗ | + FFN and input | |
| MAM Adapter He et al. (2022a) | A | ✓ | ✓ | ✗ | + FFN and input | |
| Parallel Adapter He et al. (2022a) | A | ✓ | ✓ | ✗ | + FFN | |
| Intrinsinc SAID Aghajanyan et al. (2020) | R | ✓ | ✗ | ✗ | No overhead | |
| LoRA Hu et al. (2022) | R | ✓ | ✓ | ✗ | No overhead | |
| DoRA Liu et al. (2024) | R | ✓ | ✓ | ✗ | No overhead | |
| UniPELT Mao et al. (2021) | AR | ✓ | ✓ | ✗ | + FFN and input | |
| Compacter Karimi Mahabadi et al. (2021) | AR | ✓ | ✓ | ✗ | + FFN | |
| PHM Adapter Karimi Mahabadi et al. (2021) | AR | ✓ | ✓ | ✗ | + FFN | |
| KronA Edalati et al. (2022) | R | ✓ | ✓ | ✗ | No overhead | |
| KronAresB Edalati et al. (2022) | AR | ✓ | ✓ | ✗ | + linear layer | |
| (IA) 3 Liu et al. (2022) | A | ✓ | ✓ | ✗ | + gating | |
| Attention Fusion Cao et al. (2022) | A | ✓ | ✓ | ✓ | + decoder | |
| LeTS Fu et al. (2021) | A | ✓ | ✓ | ✓ | + FFN | |
| Ladder Side-Tuning Sung et al. (2022) | A | ✓ | ✓ | ✓ | + decoder | |
| FAR Vucetic et al. (2022) | S | ✓ | ✓ | ✗ | No overhead | |
| S4-model Chen et al. (2023) | ARS | ✓ | ✓ | ✗ | + FFN and input |
- 表 2 展示了不同 PEFT 方法在不同模型规模(<1B、<20B、>20B 参数)上的评估情况,以及文献中报告的典型可训练参数比例
-
% Trainable parameters:可训练参数占模型总参数的百分比
-
% Changed parameters:训练后发生变化的参数占比
-
| 方法 | 可训练参数比例 | 发生变化的参数比例 | <1B | <20B | >20B |
|---|---|---|---|---|---|
| Adapters | 0.1–6 | 0.1–6 | ✓ | ✓ | ✓ |
| AdaMix | 0.1–0.2 | 0.1–0.2 | ✓ | ✗ | ✗ |
| SparseAdapter | 2.0 | 2.0 | ✓ | ✗ | ✗ |
| BitFit | 0.05–0.1 | 0.05–0.1 | ✓ | ✓ | ✓ |
| DiffPruning | 200 | 0.5 | ✓ | ✗ | ✗ |
| Fish-Mask | 0.01–0.5 | 0.01–0.5 | ✓ | ✓ | ✗ |
| Prompt Tuning | 0.1 | 0.1 | ✓ | ✓ | ✓ |
| Prefix-Tuning | 0.1–4.0 | 0.1–4.0 | ✓ | ✓ | ✓ |
| IPT | 56.0 | 56.0 | ✓ | ✗ | ✗ |
| MAM Adapter | 0.5 | 0.5 | ✓ | ✗ | ✗ |
| Parallel Adapter | 0.5 | 0.5 | ✓ | ✗ | ✗ |
| Intrinsic SAID | 0.001–0.1 | 100 | ✓ | ✓ | ✗ |
| LoRA | 0.01–0.5 | 约 30 | ✓ | ✓ | ✓ |
| DoRA | 0.01–0.5 | 约 30 | ✗ | ✓ | ✗ |
| UniPELT | 1.0 | 1.0 | ✓ | ✗ | ✗ |
| Compacter | 0.05–0.07 | 约 0.1 | ✓ | ✓ | ✗ |
| PHM Adapter | 0.2 | 约 1.0 | ✓ | ✗ | ✗ |
| KronA | 0.07 | 约 30.0 | ✓ | ✗ | ✗ |
| KronAresB | 0.07 | 约 1.0 | ✓ | ✗ | ✗ |
| (IA) 3 | 0.02 | 0.02 | ✗ | ✓ | ✗ |
| Ladder Side-Tuning | 7.5 | 7.5 | ✓ | ✓ | ✗ |
| FAR | 6.6–26.4 | 6.6–26.4 | ✓ | ✗ | ✗ |
| S4-model | 0.5 | >0.5 | ✓ | ✓ | ✗ |
LlaMA-Adapter
-
详细细节
-
核心结构
-
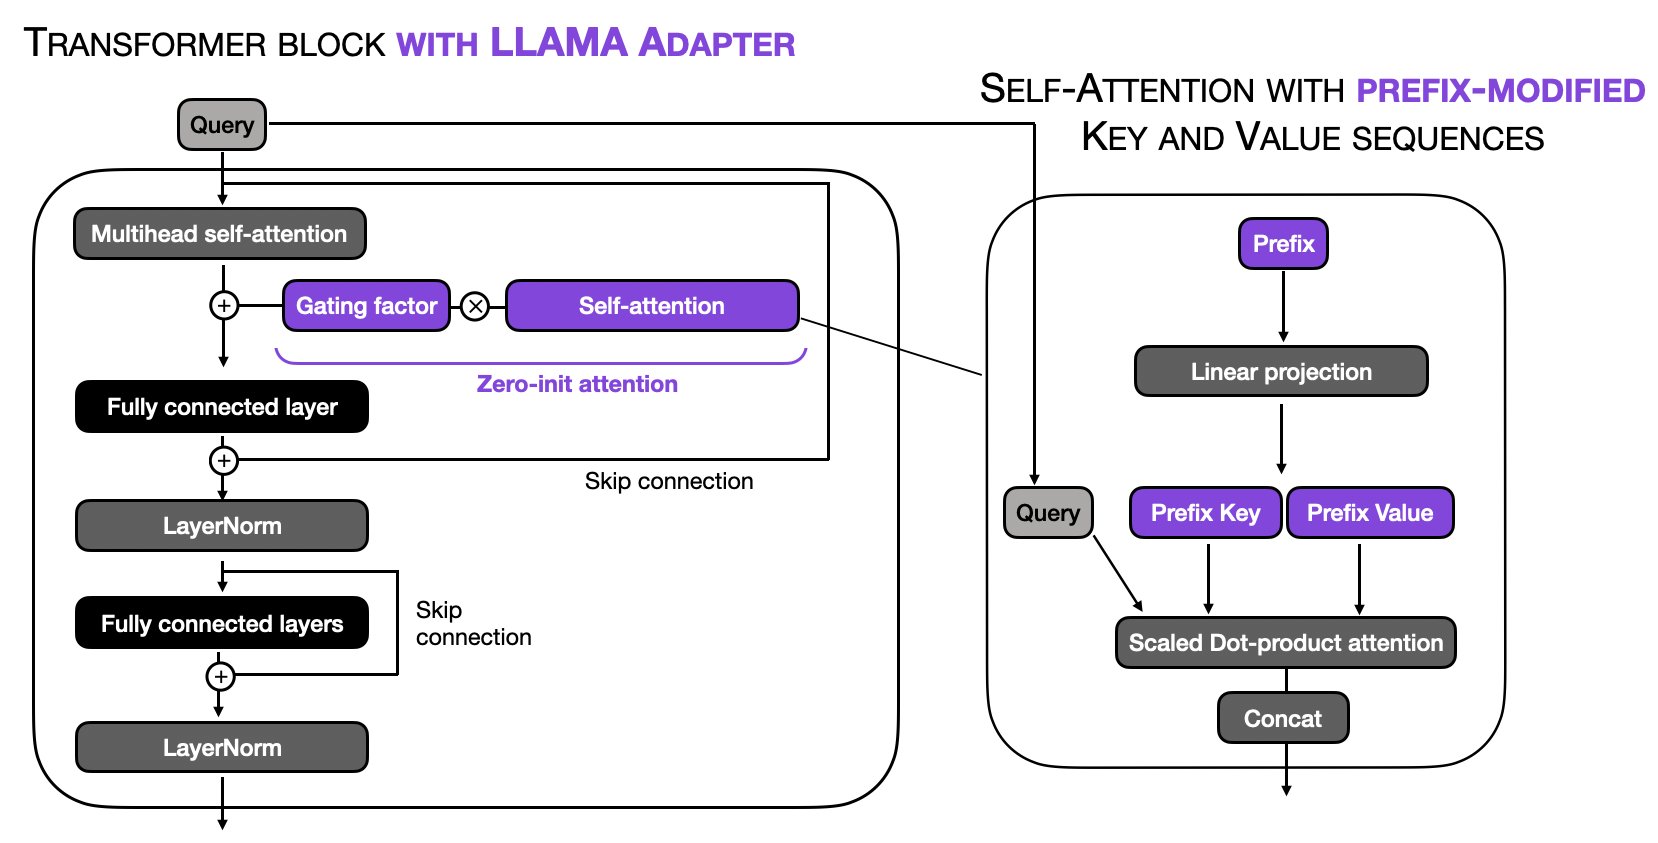
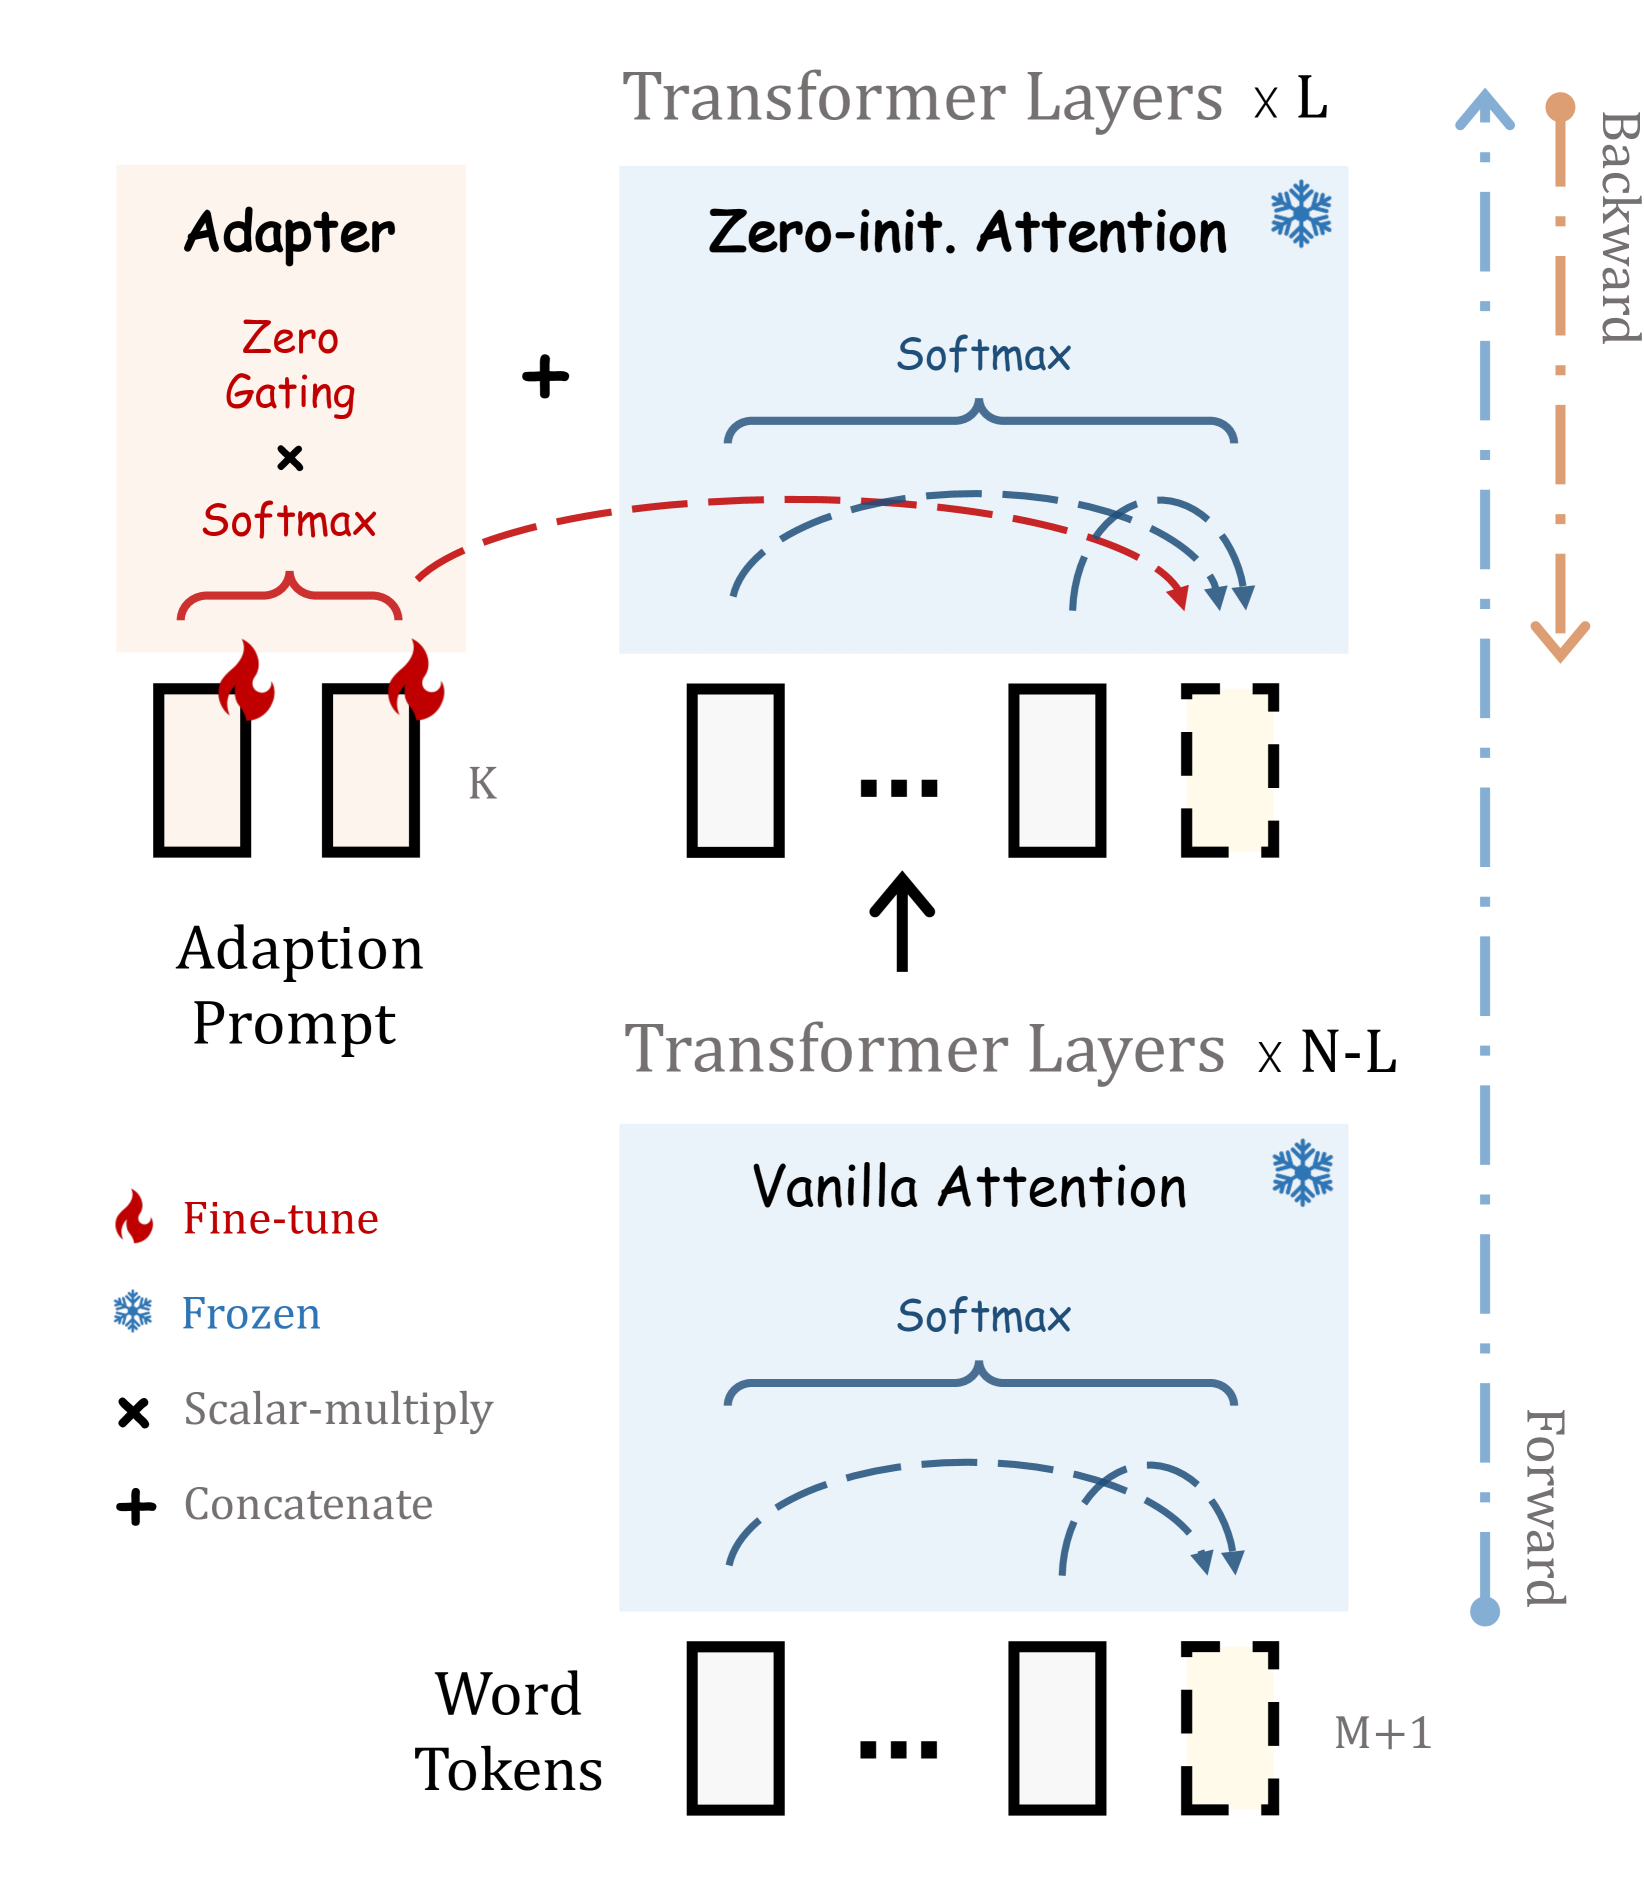
Adapter Prompt
- LLaMA-Adapter 引入了一组 learnable adapter tokens,长度通常很短(如 10–20 tokens),维度与 LLaMA hidden size 相同,不来自 tokenizer,直接作为 embedding 学习
- 但关键区别在于:它们不是简单拼接在输入序列前,而是通过 attention 机制注入
-
Zero-initialized Attention
-
Adapter Prompt 通过一个额外的 attention 分支注入:
-
Query:来自原始 token
-
Key / Value:来自 adapter prompt
-
该 attention 分支 初始化为 0
-
初始阶段几乎不影响原模型行为
-
-
这带来两个重要好处:
- 训练稳定(不破坏预训练分布)
- 适合小数据 / 指令微调
-
-
在每一层 Transformer block 中原始 self-attention 保持不变,新增一条 adapter-attention 路径,两者输出相加
-
可以理解为,LLaMA 主干负责 “语言能力”,而 Adapter Prompt 负责 “新任务偏置”
-
-
前向传播过程
-
设 为原始 token hidden states, 为 adapter prompt(可学习)
-
原 attention:
-
Adapter attention:
-
最终输出:
-
-
伪代码
def zero_init_attention(soft_prompt, x):
    """
    soft_prompt: learnable adapter tokens (num_prompt, hidden)
    x: input hidden states (seq_len, hidden)
    """
    # linear projections
    Q = x @ W_q                     # queries from input tokens
    K = soft_prompt @ W_k_adapter   # keys from adapter prompt
    V = soft_prompt @ W_v_adapter   # values from adapter prompt

    # scaled dot-product attention
    attn_scores = Q @ K.T / sqrt(d_k)
    attn_weights = softmax(attn_scores, dim=-1)

    # attention output
    y = attn_weights @ V

    # zero initialization ensures no effect at start of training
    y = y @ W_o_adapter             # W_o_adapter is zero-initialized

    return y

def transformer_block_with_llama_adapter(x, gating_factor, soft_prompt):
	residual =x
	y= zero_init_attention(soft_prompt, x) # llama-adapter: prepend prefix
	x= self_attention(x)
	x = x+ gating_factor * y  # llama-adapter: apply zero_init_attention
	x = LayerNorm(x+residual)
	residual = x
	x = FullyConnectedLayers(x)
	x = AdapterLayers(x)
	x = LayerNorm(x + residual)
	return x