题面
给你一个整数数组 nums 和一个整数 k ,请你统计并返回 该数组中和为 k 的子数组的个数 。
子数组是数组中元素的连续非空序列。
示例 1:
输入: nums = [1,1,1], k = 2 输出: 2
示例 2:
输入: nums = [1,2,3], k = 3 输出: 2
提示:
1 <= nums.length <= 2 104
-1000 <= nums[i] <= 1000-107 <= k <= 107
分析
-
如果数组是具有单调性的,那么显然可以通过双指针(滑动窗口)来处理子数组——滑动窗口需要满足单调性
-
参考题目:930. 和相同的二元子数组
-
但是由于数组无法进行排序,那么就要枚举所有子数组,求这些子数组的和,判断是否等于 K
-
如何高效地求解子数组的和?可以使用前缀和数组
-
代码实现
class Solution { public: int subarraySum(vector<int>& nums, int k) { vector<int> presum = vector(nums.size() + 1, 0); int res = 0; for (int i = 0; i < nums.size(); i++) { presum[i + 1] = presum[i] + nums[i]; } for (int i = 0; i < nums.size(); i++) { for (int j = i; j < nums.size(); j++) { if (presum[j + 1] - presum[i] == k) res++; } } return res; } }; -
然而,以上代码对于几个测试用例超时,其主要原因是其时间复杂度还是 ,实际上可以进行公式变形:
presum[j+1] - presum[i] = k→presum[i] = presum[j+1] - k -
这样,问题就转化成了,针对一个前缀和 presum[j],去查找在 j 前面是否有一个前缀和 presum[i] 满足其差值为 k,这正是两数之和问题,可以使用哈希表优化
-
显然,哈希表在这里的应用是将两层的遍历枚举,变为了枚举右端点,使用哈希表维护左侧,以能够快速查找满足条件的值,这正是枚举技巧——枚举右,维护左的应用
class Solution { public: int subarraySum(vector<int>& nums, int k) { int n = nums.size(); vector<int> s(n + 1); for (int i = 0; i < n; i++) { s[i + 1] = s[i] + nums[i]; } unordered_map<int, int> cnt; int ans = 0; for (int sj : s) { // 注意不要直接 += cnt[sj-k],如果 sj-k 不存在,会插入 sj-k ans += cnt.contains(sj - k) ? cnt[sj - k] : 0; cnt[sj]++; } return ans; } }; -
实际上,可以不需要先求出前缀和数组,而是在遍历前缀和时,用哈希表记录某个前缀和出现的次数
-
这样,无需双重循环,一次遍历即可完成计数
-
代码实现
#include <vector> #include <unordered_map> using namespace std; class Solution { public: int subarraySum(vector<int>& nums, int k) { int res = 0; int cur_sum = 0; // 动态计算前缀和(无需存储整个前缀和数组) unordered_map<int, int> sum_count; // 前缀和: 出现次数 // 初始化:前缀和0出现1次(对应presum[0]=0) sum_count[0] = 1; for (int num : nums) { cur_sum += num; // 计算当前前缀和(等价于presum[j+1]) // 关键:查找cur_sum - k的出现次数,累加到结果 if (sum_count.find(cur_sum - k) != sum_count.end()) { res += sum_count[cur_sum - k]; } // 记录当前前缀和的出现次数 sum_count[cur_sum]++; } return res; } }; -
参考题目
和为 k 的子数组长度之和
-
当遍历到
i时,若pre_sum[i] - k = target,则所有等于target的pre_sum[j]对应的子数组j...i-1都满足和为 k,此时:- 每个符合条件的子数组长度是
i - j + 1; - 所有这样的长度之和 = 符合条件的
j的数量 ×(i+1)- 所有符合条件的j的索引之和
- 每个符合条件的子数组长度是
-
因此需要统计每个前缀和
pre_sum[j]出现的次数,以及这些j的索引之和 -
也即需要维护:
- count[prefix]
- index_sum[prefix]
-
代码实现
class SolutionTotalLen {
public:
    long long totalLengthSubarraySumK(vector<int>& nums, int k) {
        unordered_map<long long, long long> count;
        unordered_map<long long, long long> index_sum;

        long long cur = 0;
        long long ans = 0;

        count[0] = 1;
        index_sum[0] = -1;  // 前缀0在-1位置

        for (int i = 0; i < nums.size(); ++i) {
            cur += nums[i];

            long long target = cur - k;
            if (count.count(target)) {
                long long m = count[target];
                long long total_index = index_sum[target];

                ans += m * (i + 1LL) - total_index;
            }

            count[cur]++;
            index_sum[cur] += i;
        }

        return ans;
    }
};
和为 k 的最短子数组长度
-
核心策略:
- 为了让区间尽可能短
- 必须让左端点 l 尽可能靠近当前 r
- 因此前缀和只保留“最后一次出现位置”
-
代码实现
#include <vector>
#include <unordered_map>
#include <climits>
using namespace std;

class SolutionMinLen {
public:
    int minSubarraySumK(vector<int>& nums, int k) {
        unordered_map<long long, int> last_pos;
        long long cur = 0;
        int ans = INT_MAX;

        last_pos[0] = -1;  // 前缀和0出现在-1位置

        for (int i = 0; i < nums.size(); ++i) {
            cur += nums[i];

            if (last_pos.count(cur - k)) {
                ans = min(ans, i - last_pos[cur - k]);
            }

            // 更新为最后出现位置
            last_pos[cur] = i;
        }

        return ans == INT_MAX ? -1 : ans;
    }
};
和为 k 的最长子数组长度
-
核心策略:
-
为了让区间最长
-
左端点应尽可能靠前
-
因此前缀和只记录“第一次出现”
-
-
代码实现
class SolutionMaxLen {
public:
    int maxSubarraySumK(vector<int>& nums, int k) {
        unordered_map<long long, int> first_pos;
        long long cur = 0;
        int ans = 0;

        first_pos[0] = -1;

        for (int i = 0; i < nums.size(); ++i) {
            cur += nums[i];

            if (first_pos.count(cur - k)) {
                ans = max(ans, i - first_pos[cur - k]);
            }

            // 只记录第一次出现
            if (!first_pos.count(cur)) {
                first_pos[cur] = i;
            }
        }

        return ans;
    }
};
和至少为 k 的最短子数组长度
-
元素正负的影响
- 如果数组全为正数:可以用滑动窗口(双指针) 高效解决,时间复杂度 O (n)
- 如果数组包含负数 / 零:滑动窗口不再适用(因为缩小左指针可能导致和反而增大),需要用前缀和 + 单调队列,时间复杂度 O (n)
-
暴力枚举
- 遍历数组,将每个位置
j作为子数组的右端点 - 对于每个右端点
j,向前寻找最小的左端点i(i ≤ j),使得nums[i...j]的和 ≥ k - 记录所有满足条件的子数组长度(
j - i + 1),最终取最小值
- 遍历数组,将每个位置
-
前缀和 + 单调队列
-
前缀和预处理
- 先计算前缀和数组
pre_sum,其中pre_sum[i]表示前i个元素的和 - 那么子数组
nums[i...j]的和 =pre_sum[j+1] - pre_sum[i]
- 先计算前缀和数组
-
单调队列维护
-
维护一个单调递增的队列存储前缀和的索引,目的是快速找到满足
pre_sum[j] - pre_sum[i] ≥ k的最小j-i -
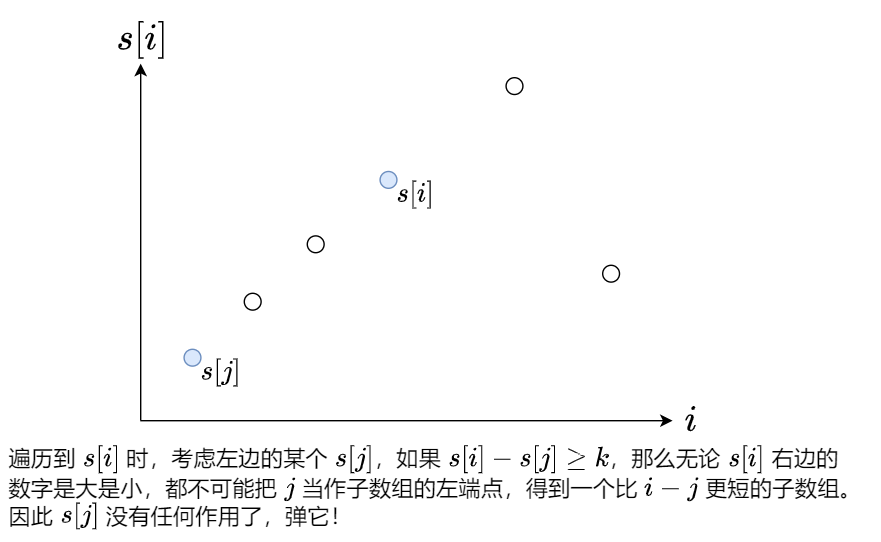
遍历前缀和数组时,如果当前前缀和与队首元素的差 ≥ k,更新最短长度并弹出队首(即使后面的前缀和会更大,但是因为后面的前缀和的索引更大,长度只会更长,不会是答案)
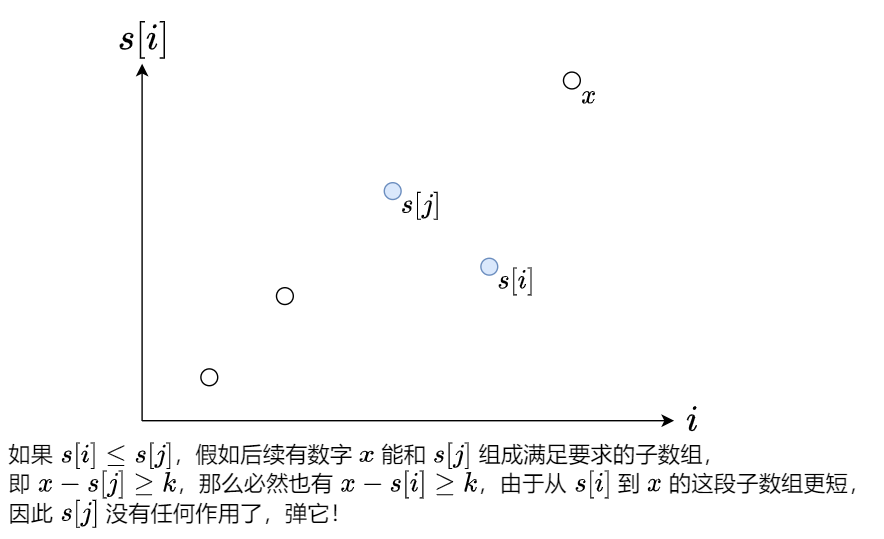
- 如果当前前缀和小于等于队尾元素,假设后续有前缀和满足 x-队尾元素对应前缀和 ≥ k,那么由于当前前缀和更小且索引更靠后,因此更有机会成为后续的最优解,故可以弹出队尾
-
-
-
此时,需要找到前面已经遍历过的前缀和中所有满足
≤ pre_sum[j] - k的最大位置 i -
如何维护这个数据结构?
-
如果有两个前缀点满足以上条件,且有
i1 > i2 且 pre[i1] <= pre[i2],那么此时 i1 更晚,且 i1 更符合条件,即 i2 被 i1 支配,可以删掉 -
由于 presum[i] 越小越好,因此需要维护一个单调递增队列,同时,当队首不满足
≥ pre_sum[j] - k时,弹出队首 -
这样,队首的元素就是最远且满足条件的元素
-
参考题目:209. 长度最小的子数组(该题目不包含负数,可以直接使用滑动窗口)
-
代码实现
int shortestSubarray(vector<int>& nums, int k) { int n = nums.size(); // 前缀和数组,pre_sum[0] = 0,pre_sum[i] 表示前 i 个元素的和 vector<long long> pre_sum(n + 1, 0); // 用long long防止整数溢出 for (int i = 0; i < n; ++i) { pre_sum[i + 1] = pre_sum[i] + nums[i]; } deque<int> q; // 单调队列,存储前缀和的索引,保证索引对应的值单调递增 int min_length = INT_MAX; // 初始化最短长度为最大值 for (int i = 0; i <= n; ++i) { // 1. 检查当前前缀和与队首的差是否≥k,更新最短长度并弹出队首 while (!q.empty() && pre_sum[i] - pre_sum[q.front()] >= k) { min_length = min(min_length, i - q.front()); q.pop_front(); // 弹出队首,因为后续i更大,长度只会更长 } // 2. 维护队列的单调递增性:移除队尾比当前前缀和大的元素 while (!q.empty() && pre_sum[i] <= pre_sum[q.back()]) { q.pop_back(); // 队尾元素不可能成为最优左边界,直接移除 } // 3. 将当前索引加入队列 q.push_back(i); } // 若仍为最大值,说明无符合条件的子数组,返回-1,否则返回最短长度 return min_length == INT_MAX ? -1 : min_length; } -
这里的双端队列,并不是单纯的单调队列模板,而是结合了前缀和的特性,针对 “最短子数组” 问题做了特殊设计的单调队列变种
- 普通单调队列(比如解决滑动窗口最大值问题)的核心特点:
- 队列维护的是滑动窗口内的元素 / 索引;
- 队列的 “单调性” 是为了快速获取窗口极值;
- 队列的弹出操作主要是 “移除窗口外的元素”+“维护单调性”;
- 队首一般不会被主动弹出(除非出窗口)
- 而本题的队列:
- 队列维护的是所有遍历过的前缀和索引(不是窗口内);
- 队列的 “单调性” 是为了筛选 “能构成最优解的前缀和”;
- 队首会被主动弹出(一旦满足条件,就不再需要);
- 核心目标是 “找差值≥k 的最小索引差”,而非 “找极值”
- 普通单调队列(比如解决滑动窗口最大值问题)的核心特点:
和不超过 k 的最长子数组长度
-
如果数组全为正数,用滑动窗口即可,当和超过 k 时,收缩左指针(因为数组全正,收缩后和会减小)
-
如果数组包含负数 / 零,此时滑动窗口不适用(收缩左指针可能导致和更小,错过更长的子数组)
- 转化为
pre_sum[j] - pre_sum[i] ≤ k→pre_sum[i] ≥ pre_sum[j] - k - 此时,需要找到前面已经遍历过的前缀和中所有满足
≥ pre_sum[j] - k的最小位置 i - 如何维护这个数据结构?
- 如果有两个前缀点满足以上条件,且有
i1 < i2 且 pre[i1] >= pre[i2],那么此时 i1 更早,且 i1 更符合条件,即 i2 被 i1 支配,可以删掉 - 由于 presum[i] 越大越好,因此需要维护一个单调递增队列,同时,当队首不满足
≥ pre_sum[j] - k时,弹出队首 - 这样,队首的元素就是最远且满足条件的元素
- 转化为
-
代码实现
class Solution {
public:
    int longestSubarrayLessOrEqualK(vector<int>& nums, int k) {
        int n = nums.size();

        vector<long long> pre(n + 1, 0);
        for (int i = 0; i < n; i++) {
            pre[i + 1] = pre[i] + nums[i];
        }

        deque<int> dq;
        dq.push_back(0);

        int ans = 0;

        for (int j = 1; j <= n; j++) {

            // 维护窗口合法性
            while (!dq.empty() && pre[j] - pre[dq.front()] > k) {
                dq.pop_front();
            }

            if (!dq.empty()) {
                ans = max(ans, j - dq.front());
            }

            // 插入 j(维护单调递增 pre)
            while (!dq.empty() && pre[dq.back()] >= pre[j]) {
                dq.pop_back();
            }
            dq.push_back(j);
        }

        return ans;
    }
};
和不超过 k 的子数组个数(数组可能含负数)
-
实现步骤
-
转化条件:要求
pre_sum[i] - pre_sum[j] ≤ k→pre_sum[j] ≥ pre_sum[i] - k -
有序列表维护前缀和
-
遍历前缀和数组时,维护一个有序的列表存储已遍历过的前缀和
-
对于当前前缀和
pre_sum[i],用二分查找找到列表中第一个 ≥pre_sum[i] - k的位置,该位置到列表末尾的元素个数,就是以i为结尾、和 ≤ k 的子数组个数
-
-
插入当前前缀和:将
pre_sum[i]插入有序列表(保持有序),供后续查找
-
-
等价问题:在一个可能包含负数的数组中,找到所有连续子数组里和 ≤ k 的最大值
-
前缀和转化:子数组
nums[j...i-1]的和 =pre_sum[i] - pre_sum[j] ≤ k→pre_sum[j] ≥ pre_sum[i] - k -
找最优解:对于每个
pre_sum[i],我们需要找到最小的满足pre_sum[j] ≥ pre_sum[i] - k的值(因为pre_sum[i] - 最小的pre_sum[j]能得到最大的、且 ≤k 的子数组和) -
有序列表维护:遍历前缀和时,用有序列表存储已遍历的前缀和,通过二分查找快速定位目标值,计算候选解并更新最大值
-
-
代码实现
#include <vector> #include <set> #include <algorithm> using namespace std; class Solution { public: int countSubarraySumLeqK(vector<int>& nums, int k) { int count = 0; long long cur_sum = 0; // 防止溢出(前缀和可能很大) set<long long> pre_sum_set; // 有序存储遍历过的前缀和 // 初始化:加入前缀和0(对应i=-1的情况) pre_sum_set.insert(0); for (int num : nums) { cur_sum += num; // 计算当前前缀和S[j] // 目标:找S[i] ≥ cur_sum - k 的元素 long long target = cur_sum - k; // 找第一个 ≥ target 的迭代器 auto it = pre_sum_set.lower_bound(target); // 该迭代器之后的所有元素都满足条件,数量累加 if (it != pre_sum_set.end()) { count += distance(it, pre_sum_set.end()); } // 将当前前缀和加入有序集合(供后续j使用) pre_sum_set.insert(cur_sum); } return count; } }; -
时间复杂度 O(n log n)
和为奇数的子数组个数
-
核心等价条件:区间和为奇数 ⇔ 前缀奇偶性不同
-
只需统计:
-
even_count
-
odd_count
-
-
代码实现
class SolutionOddCount {
public:
    long long countOddSubarrays(vector<int>& nums) {
        long long even = 1;  // 前缀0
        long long odd = 0;

        long long cur = 0;
        long long ans = 0;

        for (int num : nums) {
            cur += num;

            if (cur % 2 == 0) {
                ans += odd;
                even++;
            } else {
                ans += even;
                odd++;
            }
        }

        return ans;
    }
};
总结
- 这类问题的核心是「快速计算任意子数组的和」,而前缀和是解决这类问题的基石(子数组
[i,j]的和 =pre_sum[j+1] - pre_sum[i]) - 和为 k 的子数组个数
pre_sum[j+1] - pre_sum[i] = k→pre_sum[i] = pre_sum[j+1] - k,用哈希表统计pre_sum[i]的出现频次
- 和为 k 的最短 / 最长子数组
- 最短子数组:哈希表存「前缀和→第一次出现的索引」(保证长度最短)
- 最长子数组:哈希表存「前缀和→最后一次出现的索引」(保证长度最长)
- 关键:哈希表只存首次 / 末次索引,避免重复覆盖
- 和至少为 k 的最短子数组
- 数组含负数时滑动窗口不适用,需用单调队列维护递增的前缀和索引
- 队列中保存递增的
pre_sum索引,遍历到j时,弹出队首满足pre_sum[j] - pre_sum[q.front()] ≥k的元素,更新最短长度
- 和为奇数的子数组个数、和不大于 k 的个数
- 和为奇数:转化为「前缀和奇偶性」(奇数 - 偶数 = 奇数,偶数 - 奇数 = 奇数),统计奇偶前缀和的数量
- 和不大于 k:数组全正数时用滑动窗口(右扩左缩),含负数时需前缀和 + 有序集合(如 multiset)二分查找