题面
给定一个 m x n 二维字符网格 board 和一个字符串单词 word 。如果 word 存在于网格中,返回 true ;否则,返回 false 。
单词必须按照字母顺序,通过相邻的单元格内的字母构成,其中“相邻”单元格是那些水平相邻或垂直相邻的单元格。同一个单元格内的字母不允许被重复使用。
示例 1:
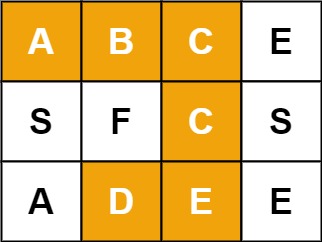
输入: board = [['A','B','C','E'],['S','F','C','S'],['A','D','E','E']], word = "ABCCED" 输出: true
示例 2:
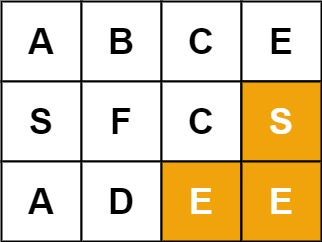
输入: board = [['A','B','C','E'],['S','F','C','S'],['A','D','E','E']], word = "SEE" 输出: true
示例 3:
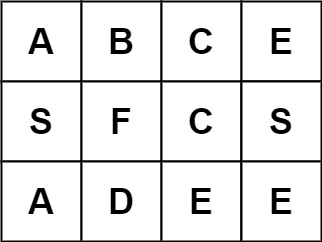
输入: board = [['A','B','C','E'],['S','F','C','S'],['A','D','E','E']], word = "ABCB" 输出: false
提示:
m == board.lengthn = board[i].length1 <= m, n <= 61 <= word.length <= 15board和word仅由大小写英文字母组成
进阶: 你可以使用搜索剪枝的技术来优化解决方案,使其在 board 更大的情况下可以更快解决问题?
分析
-
朴素的想法是,从左上角开始进行搜索,当遍历到的格子符合 word 模式时,就向前进行,否则进行回溯,并更换方向;
-
代码实现如下
class Solution { public: vector<char> path; bool res; void backtracking(vector<vector<char>>& board, string word, int i, int j, vector<vector<bool>>& visited) { if (path.size() == word.size()) { res = true; return; } if (res || i < 0 || i >= board.size() || j < 0 || j >= board[0].size() || visited[i][j]) return; if (board[i][j] != word[path.size()]) return; path.push_back(board[i][j]); // for (char p : path) { // std::cout << p << ""; // } // std::cout << std::endl; visited[i][j] = true; vector<vector<int>> directions = {{-1, 0}, {1, 0}, {0, -1}, {0, 1}}; for (vector<int> direction : directions) { backtracking(board, word, i + direction[0], j + direction[1], visited); } path.pop_back(); visited[i][j] = false; } bool exist(vector<vector<char>>& board, string word) { vector<vector<bool>> visited = vector(board.size(), vector(board[0].size(), false)); for (int i = 0; i < board.size(); i++) { for (int j = 0; j < board[0].size(); j++) { backtracking(board, word, i, j, visited); } } return res; } }; -
但是这其中,存在大量的冗余分支搜索,需要进行剪枝
-
首先,可以做一些预处理剪枝,如果单词长度超过网格总字符数或者单词中某字符频次超过网格,则直接不满足;同时外层循环中已找到结果,直接终止循环
#include <algorithm> // 用于count统计 #include <string> #include <vector> using namespace std; class Solution { public: // 移除全局path(改用索引更高效),res改为局部并通过引用传递 void backtracking(vector<vector<char>>& board, string& word, int i, int j, int index, vector<vector<bool>>& visited, bool& res) { // 剪枝1:已找到结果,直接返回(最核心的剪枝) if (res) return; // 剪枝2:边界越界,直接返回(修复原代码的j判断错误) if (i < 0 || i >= board.size() || j < 0 || j >= board[0].size()) return; // 剪枝3:当前位置已访问过,或字符不匹配,直接返回 if (visited[i][j] || board[i][j] != word[index]) return; // 剪枝4:已匹配到最后一个字符,直接标记结果并返回 if (index == word.size() - 1) { res = true; return; } // 标记当前位置为已访问 visited[i][j] = true; // 向四个方向递归 vector<vector<int>> directions = {{-1, 0}, {1, 0}, {0, -1}, {0, 1}}; for (auto& dir : directions) { backtracking(board, word, i + dir[0], j + dir[1], index + 1, visited, res); } // 回溯:恢复状态 visited[i][j] = false; } bool exist(vector<vector<char>>& board, string word) { int m = board.size(); int n = board[0].size(); // 剪枝0:预处理(递归前的全局剪枝) // 0.1 单词长度超过网格总字符数,直接返回false if (word.size() > m * n) return false; // 0.2 统计网格和单词的字符频次(支持任意大小写字符) unordered_map<char, int> boardCount; for (auto& row : board) { for (char c : row) { boardCount[c]++; // 直接统计原始字符(区分大小写) } } // 检查单词中每个字符的频次是否超过网格 unordered_map<char, int> wordCount; for (char c : word) { wordCount[c]++; // 如果网格中没有该字符,或频次不足,直接返回false if (boardCount.find(c) == boardCount.end() || wordCount[c] > boardCount[c]) { return false; } } vector<vector<bool>> visited(m, vector<bool>(n, false)); bool res = false; // 遍历每个起点 for (int i = 0; i < m && !res; i++) { // 剪枝5:外层循环中已找到结果,直接终止循环 for (int j = 0; j < n && !res; j++) { // 同上 backtracking(board, word, i, j, 0, visited, res); } } return res; } }; -
接下来,优化方向不再是 “简单的条件判断剪枝”,而是:
- 移除所有冗余数据结构(如
vector方向数组、path数组) - 调整递归遍历顺序(优先匹配高频成功的方向)
- 原地标记访问状态(避免
visited数组的拷贝 / 初始化开销) - 提前预判递归深度(减少无效递归调用)
- 反向匹配优化(针对首字符少、尾字符多的单词)
- 移除所有冗余数据结构(如
-
代码实现
#include <vector>
#include <string>
#include <algorithm>
using namespace std;

class Solution {
public:
    bool exist(vector<vector<char>>& board, string word) {
        int m = board.size();
        int n = board[0].size();
        int len = word.size();

        // 预处理剪枝(基础但关键)
        if (len > m * n) return false;

        // 字符频次剪枝(适配大小写:ASCII范围0-127,覆盖所有大小写字母)
        int boardCount[128] = {0}, wordCount[128] = {0};
        for (int i = 0; i < m; ++i) {
            for (int j = 0; j < n; ++j) {
                // 直接用字符的ASCII值作为索引,区分大小写
                boardCount[(unsigned char)board[i][j]]++;
            }
        }
        for (char c : word) {
            int idx = (unsigned char)c;
            if (++wordCount[idx] > boardCount[idx]) return false;
        }

        // 反向匹配优化:适配大小写(比较首尾字符的ASCII值频次)
        char first = word[0];
        char last = word.back();
        if (boardCount[(unsigned char)first] > boardCount[(unsigned char)last]) {
            reverse(word.begin(), word.end());
        }

        // 遍历起点(带剪枝:找到结果立即返回)
        for (int i = 0; i < m; ++i) {
            for (int j = 0; j < n; ++j) {
                // 首字符匹配才进入递归(核心剪枝)
                if (board[i][j] == word[0] && backtrack(board, word, i, j, 0, m, n, len)) {
                    return true;
                }
            }
        }
        return false;
    }

private:
    // 核心递归函数:无额外数据结构,原地标记,方向硬编码
    bool backtrack(vector<vector<char>>& board, string& word, int i, int j, int idx, int m, int n, int len) {
        // 剪枝1:已匹配完成(终止条件)
        if (idx == len) return true;

        // 剪枝2:边界越界
        if (i < 0 || i >= m || j < 0 || j >= n) return false;

        // 剪枝3:字符不匹配 或 已访问过(用特殊字符标记)
        char c = board[i][j];
        if (c != word[idx] || c == '#') return false;

        // 原地标记访问状态(替代visited数组,无内存开销)
        board[i][j] = '#';

        // 方向硬编码(替代vector方向数组,减少拷贝和访问开销)
        // 递归顺序可根据实际场景调整(比如优先向右/下,适配大多数测试用例)
        bool found = backtrack(board, word, i+1, j, idx+1, m, n, len) ||
                     backtrack(board, word, i-1, j, idx+1, m, n, len) ||
                     backtrack(board, word, i, j+1, idx+1, m, n, len) ||
                     backtrack(board, word, i, j-1, idx+1, m, n, len);

        // 回溯:恢复原字符
        board[i][j] = c;

        return found;
    }
};
这篇文档有帮助吗?