分布式训练概述
介绍分布式训练的基本概念与技术,以及 PyTorch 中常用的分布式训练库 torchrun 和 Accelerate
- 参考资料
- HuggingFace 分布式训练手册:The Ultra-Scale Playbook
- Accelerating PyTorch Model Training
- NVIDIA 分布式训练手册:Parallelisms Guide — Megatron Bridge
- 参考文章
分布式训练的基本概念
- 模型训练一般包括三个步骤
- 根据输入进行前向计算
- 反向传播计算梯度
- 利用梯度更新参数
- 分布式训练关心的三个核心问题
- 内存占用(Memory Usage):这是一个硬性限制 —— 如果一次训练步骤无法装入内存,训练就无法继续进行
- 计算效率(Compute Efficiency):希望硬件的大部分时间都用于实际计算,因此需要减少花在数据传输上的时间,或等待其他 GPU 完成工作的空闲时间
- 通信开销(Communication Overhead):希望将通信带来的额外开销降到最低,因为通信会使 GPU 处于空闲状态
- 为此,需要尽可能充分利用节点内(速度更快)和节点间(速度较慢)的带宽,并尽量将通信与计算进行重叠
- 这也是一个关键改进点,Overlap computation and communication(计算与通信重叠)
- 主节点(Master Node)
- 主节点通常负责管理任务调度、参数初始化和分布式通信的协调
- 在 PyTorch 分布式环境中,主节点通常具有以下职责:
- 初始化分布式环境(
init_process_group) - 分发模型参数或数据到其他节点
- 处理日志记录或统计信息
- 初始化分布式环境(
- 在 PyTorch 中,主节点由环境变量
MASTER_ADDR和MASTER_PORT指定 - 主节点并不一定承担实际训练任务,可能只负责通信和协调
- 进程组(Process Group)
- 进程组是 PyTorch 分布式通信的基本单元,表示一组参与通信的分布式进程,定义哪些进程参与分布式操作
- 提供通信接口,如广播(Broadcast)、全归约(AllReduce)等
- 初始化:
- 使用
torch.distributed.init_process_group()初始化 - 支持多种后端,如 NCCL(GPU)、Gloo(CPU/GPU)和 MPI
- 使用
- 如果有 4 个 GPU 参与训练,可以初始化一个包含 4 个进程的进程组,每个 GPU 对应一个进程
- Rank
- 在分布式训练中,Rank 是用于标识每个进程的唯一编号,用于区分不同的计算任务和通信操作
- Global Rank:在整个分布式系统中唯一标识一个进程
- Local Rank:在某个节点(物理机器)中标识该节点内的进程编号
- Group Rank:在某个并行组中的进程编号
- Rank 决定了进程的角色,例如哪一个进程是主节点
- 在多 GPU 训练中,Rank 通常和 GPU ID 对应
- 如果有 8 个 GPU 和 2 个节点,每个节点有 4 个 GPU:
- 节点 1 的 Global Rank 为 0, 1, 2, 3
- 节点 2 的 Global Rank 为 4, 5, 6, 7
- 在分布式训练中,Rank 是用于标识每个进程的唯一编号,用于区分不同的计算任务和通信操作
- NCCL(NVIDIA Collective Communication Library)
- NVIDIA 提供的高性能通信库,专为 GPU 集群上的深度学习训练优化
- 提供高效的分布式通信操作,包括广播、Reduce、All-Reduce、all-gather
- 利用 GPU 的高速 NVLink、PCIe 和 InfiniBand 实现低延迟、高带宽通信
- 支持多 GPU 和多节点通信
- 深度集成到 PyTorch 和 TensorFlow 等框架中
- 自动优化通信拓扑,减少通信瓶颈
- Backend:分布式通信的底层实现方式,在 PyTorch 中常见的后端包括:
- NCCL:用于 GPU 通信,性能最佳
- Gloo:支持 CPU 和 GPU,适用于多种环境
- MPI:使用消息传递接口,适合高性能计算环境
分布式训练库
torchrun
-
功能
torchrun是 PyTorch 提供的一个 CLI 工具,用于管理分布式训练任务,特别是基于torch.distributed的分布式环境- 负责初始化 PyTorch 的分布式训练环境
- 自动设置分布式所需的主节点地址 (
MASTER_ADDR) 和端口 (MASTER_PORT) - 简化进程启动,支持多 GPU 和多节点训练
- 替代了旧的
torch.distributed.launch工具,提供更易用和灵活的接口
-
工作原理
torchrun为每个 GPU 启动一个进程- 使用 NCCL(默认后端)或其他后端初始化通信
- 进程通过
torch.distributed.init_process_group互相通信,完成梯度同步
-
单卡多 GPU
torchrun --nproc_per_node=4 train.py -
多卡多 GPU
torchrun --nproc_per_node=4 --nnodes=2 --node_rank=0 --master_addr="192.168.1.1" --master_port=12345 train.py
Accelerate
-
功能
- 自动处理多 GPU、TPU 和混合精度训练(FP16)
- 自动设备分配:在 CPU、单 GPU 和多 GPU 环境中无缝切换
- 支持分布式训练的关键操作,如梯度累积、参数同步等
-
示例代码
from accelerate import Accelerator

accelerator = Accelerator()

# 自动分配设备
device = accelerator.device
model.to(device)

# 自动包装模型和优化器
model, optimizer = accelerator.prepare(model, optimizer)

for batch in dataloader:
    # 自动将数据分配到正确设备
    batch = batch.to(accelerator.device)
    outputs = model(batch)

    # 自动反向传播和梯度同步
    loss = loss_fn(outputs, targets)
    accelerator.backward(loss)
    optimizer.step()
    optimizer.zero_grad()
单个 GPU 的训练
Batch Size
- Batch Size 和训练时间的关系
- 每个 epoch 的优化器步数 = 总样本数 / 批次大小
- 而每个优化器步数需要进行的操作
- 前向传播(forward)
- 反向传播(backward)
- 梯度同步 / 累积(多卡时)
- 参数更新(optimizer step)
- backward 通常是 forward 的 2–3 倍计算量,optimizer step 涉及大量参数读写,在数据并行中还要做梯度通信(all-reduce),所以一次 step 的固定开销很大
- 训练的总时间 ≈ steps×(固定成本 + 每个批次的计算时间),而当 batch 很小时固定成本占比变大,GPU 更容易空转
- 固定成本包括
- Kernel launch 开销(GPU):每个算子都要 launch kernel,kernel launch 本身有不可忽略的延迟,batch 小时,算子算得快,但 launch 时间不变
- 反向传播的调度与同步:autograd 图的遍历,backward 中的算子依赖管理
- 梯度清零(zero_grad):需要遍历全部参数,batch 再小,也要清一整套梯度
- 优化器更新参数 Adam / AdamW:读参数、读一阶、二阶动量、写回更新结果,而参数量固定 → 则这部分成本固定
- 每个批次的计算时间会随 batch size 增长而增长,包括矩阵乘法 FLOPs、attention 计算、token-level loss、embedding lookup 的有效计算部分
- Batch Size Tokens
- 在大语言模型预训练领域,batch size 通常以 token 数量来表示,而不是以样本数来表示(即 Batch Size Tokens)
- 这种表示方式使得训练规模在数值上基本不依赖于训练过程中所使用的具体输入序列长度
- 通常而言 Batch Size Tokens = Batch Size Samples × Sample Token Length
- Llama 1 使用约 4M tokens 的 batch size 训练了 1.4T tokens,而 DeepSeek 使用约 60M tokens 的 batch size 训练了 14T tokens
- 在将模型训练扩展到大规模 batch size 时,面临的首要挑战就是内存不足问题 —— 即,当 GPU 内存不足以容纳 batch 大小时,应该如何应对
Activations
-
从神经网络的函数复合本质与反向传播中的链式法则出发,可以直接得到核心结论:反向传播在计算梯度时,所需的局部导数依赖前向传播产生的激活值,因此激活值必须在前向阶段被存储,以供反向阶段使用
-
神经网络的本质
-
神经网络本质上是复合函数,对任意一层前馈神经网络,其前向计算为:
-
整个模型的损失函数是高度嵌套的函数复合:
-
而反向传播,就是对这个复合函数逐层应用链式法则
-
-
权重的梯度显式依赖前向激活值
-
考虑某一层参数的梯度:
-
由链式法则:
-
而线性层有:
-
因此:
-
可见,前一层的激活值 是权重梯度计算中不可缺失的因子,如果前向传播时没有保存 ,反向传播在数学上就无法进行
-
-
非线性层的梯度同样依赖激活值
-
激活层:
-
反向传播需要:
-
而 在实际中必须通过前向结果确定:
- ReLU:,需要知道 forward 时哪些 为正
- Sigmoid:,通常直接由已存的 计算
- GELU / SiLU:梯度是激活值或其数值近似的函数
-
非线性层的梯度不是常数,必须依赖 forward 的激活信息
-
-
激活值是 “边上的数值”
-
自动微分会将模型表示为计算图,其中节点是张量,而边则是算子
-
反向传播会在图上计算:
-
这些局部的 Jacobian 几乎都依赖前向阶段的具体数值
-
因此反向传播不是符号推导,而是在已知前向数值的前提下,执行数值化的链式法则,这就要求前向阶段的中间结果(激活值)必须被保存
-
-
为什么不能等反向时再算激活值?
-
理论上可以重算,但代价是每一层反向都需要重新执行前向,而前向本身又依赖更早的激活
-
总复杂度变为:
-
而不是标准的:
-
这在深层网络(尤其是 Transformer)中是不可接受的
-
Transformer 中的 Activations
-
可视化预测模型需要的内存:Predict Memory - a Hugging Face Space by nanotron
-
以一个四个 Linear 的模型结构为例说明,其前向传播和损失函数的公式如下:
-
其中,x 和 y 为数据的特征和标签; 为四个 Linear 层的权重和偏置; 都是计算过程中的中间状态
-
反向传播对权重更新需求损失相对于各权重的偏导,按链式求导法则得:
-
权重矩阵 的梯度计算包含两项,一是第 层反传回来的值(记为 ),二是第 层的中间激活值(记为 ),因此可简化为:
-
MHA 层公式
-
FFN 层公式
-
MHA 层输入为 x,输出为 ;FFN 层输入为 ,输出为
-
符号定义
- b:batch_size(批次大小)
- s:seq_length(文本序列长度)
- h:hidden_dim(隐藏层维度)
- a:多头注意力的头数
- ha:hidden_dim_per_head(每个注意力头的隐藏层维度),实际使用中满足
-
MHA 层激活值及显存占用
计算项 维度 显存大小(字节) -
FFN 层激活值及显存占用
计算项 维度 显存大小(字节) -
单 Transformer 层总显存 —— 将 MHA 和 FFN 层显存相加:
-
若有 L 层 Transformer,则 L 层总中间激活值显存为:
-
模型中除 Transformer 层外,还包含 embedding 层和解码层,其中解码层无中间激活值,仅需分析 embedding 层:
- embedding 层功能:将输入的 token ID 转为向量
- 输出矩阵维度:
- 显存占用: 字节
-
整个模型的中间激活值总显存 —— 结合 Transformer 层和 embedding 层,整个模型的中间激活值显存为:
-
当模型层数 L 较大时,可忽略 embedding 层的 ,直接用 估算
-
对于短序列()而言,,FFN / QKV activation 占主导
-
对于长序列()而言,,Attention softmax 成为绝对瓶颈,正是 Activation Recomputation、Long Context、FlashAttention、Linear Attention 等这些工作的动机来源
激活重计算(Activation Recomputation)
- 激活重计算又称 Gradient Checkpointing、Gradient rematerialization
- 核心思想是在前向计算时丢弃部分激活值,然后在反向传播时重新计算这些激活值,从而用额外的计算量换取更低的显存占用
- 如果不使用重计算,需要在两个可学习算子之间(例如前馈网络、LayerNorm 等)保存所有中间隐藏状态,以便在反向传播时直接使用它们来计算梯度
- 而如果使用重计算,通常只在模型结构中的少数关键位置保存激活,其余激活在前向阶段直接丢弃
- 等到反向传播需要这些激活时,再从最近一次保存的激活出发,在线重新执行一小段前向计算把它们算出来
- 本质上,这是重新执行一部分前向传播,用额外的计算开销来换取激活显存的显著下降
- 在选择哪些激活作为检查点进行存储时,通常有几种策略:
- Full(全量重计算)
- 在这种策略下,在 Transformer 模型每一层之间的边界处保存一次激活
- 在反向传播过程中,几乎需要对每一层的内部重新执行一次前向传播,等价于在 backward 阶段额外再跑一遍完整的 forward
- 这种策略节省的显存最多,但在计算开销上也是最昂贵的,通常会使整体计算量和训练时间增加 30–40%
- Selective(选择性重计算)
- Reducing Activation Recomputation in Large Transformer Models 这篇论文的作者分析了哪些激活张量占用内存最大,同时其重计算所需的浮点运算(FLOPs)成本最低
- 分析结果表明,注意力相关的计算正好符合这一特征:其激活占用内存很大,但重新计算的计算代价相对较低
- 因此,在实践中,通常会丢弃 attention 相关的激活,而保存计算代价高但内存占用相对可控的前馈网络部分的激活值
- 以 GPT-3(175B)模型为例,这种选择性重计算策略可以在仅增加约 2.7% 的计算开销的情况下,实现约 70% 的激活显存降低
- Full(全量重计算)
- HFU 与 MFU
- HFU(Hardware FLOPS Utilization):统计硬件实际执行的计算量,包括由于重计算(checkpoint /recomputation)带来的额外 FLOPs,用来衡量当前训练实现对硬件算力的利用程度
- MFU(Model FLOPS Utilization):只统计模型在一次 forward + backward 中理论上必须执行的计算量,不包含重计算,用来衡量模型本身的计算效率,与具体实现策略弱相关
- 如今大多数训练框架都会使用 FlashAttention,其在其优化策略中原生集成了选择性激活重计算,即在反向传播时重新计算 attention 的分数和矩阵,而不是在前向传播时把它们存下来
- 优先重计算的对象,必须满足以下两个条件:
- 内存占比高:保存它的激活会显著增加显存压力;
- 重计算成本低:重新前向计算它的时间开销远小于保存的收益(比如不用 OOM、能放更大 batch)
- 最高优先级的重计算对象是 Attention 层的中间激活(如 Q/K/V、注意力分数矩阵),它们会随着序列长度平方级增长,占用大量显存,但重计算它们的 FLOPs 却相对较低(因为它们的计算主要是矩阵乘法,且通常在 GPU 上高度优化)
- 次优先级的重计算对象是前馈网络(FFN)层的中间激活,虽然它们的内存占用也不小,但相较于 Attention 层来说,重计算它们的 FLOPs 较高,因此在实际应用中通常会选择保留 FFN 的激活,而重计算 Attention 的激活
- MoE (Mixture of Experts)层的激活重计算
- MoE 层的激活重计算策略与标准 Transformer 层类似,但由于 MoE 的稀疏性(每个 token 只激活部分专家),其激活显存占用和重计算成本都相对较低,因此在实践中通常会选择保留 MoE 层的激活,而重计算其他更昂贵的部分
- LN (LayerNorm)层的激活重计算
- LayerNorm 的激活重计算通常优先级较低,因为它的内存占用相对较小,且重计算成本较高(需要重新计算统计量和归一化结果)
- 因此,在实际应用中,通常会选择保留 LayerNorm 的激活,而重计算其他更昂贵的部分
梯度累积(Gradient Accumulation)
- 激活重计算无法解决 Batch Size 带来的线性增长
- 激活重计算的核心是减少了 “每个样本” 的 activation 常数项,特别是 Attention 中的 激活,把 “存激活” 变成 “多算一点”
- 然而,它不能解决 batch 维度即 本身带来的线性增长,即重计算降低的是 “每个样本需要多少显存”,但 batch size 决定的是 “要存多少个样本的激活”
- 假设:单样本 activation(使用 FlashAttention + checkpoint)= 1.2 GB,那么有
- → 1.2 GB
- → 9.6 GB
- → 19.2 GB
- 梯度累积的核心思想是把一个大 batch 拆成多个小 micro-batch,一次只在显存里放一个 micro-batch 的激活,但在数学上等价于用大 batch 更新参数
- 相关术语
- micro-batch size(mbs):每一次 forward /backward 实际送进模型的 batch 大小
- global batch size(gbs):两次 optimizer step 之间,模型 “等效看到” 的总 batch 大小
- grad_acc(gradient accumulation steps):在执行一次 optimizer.step () 之前,累计多少次梯度
- 显然,gbs = mbs × grad_acc
- 梯度累积示意图
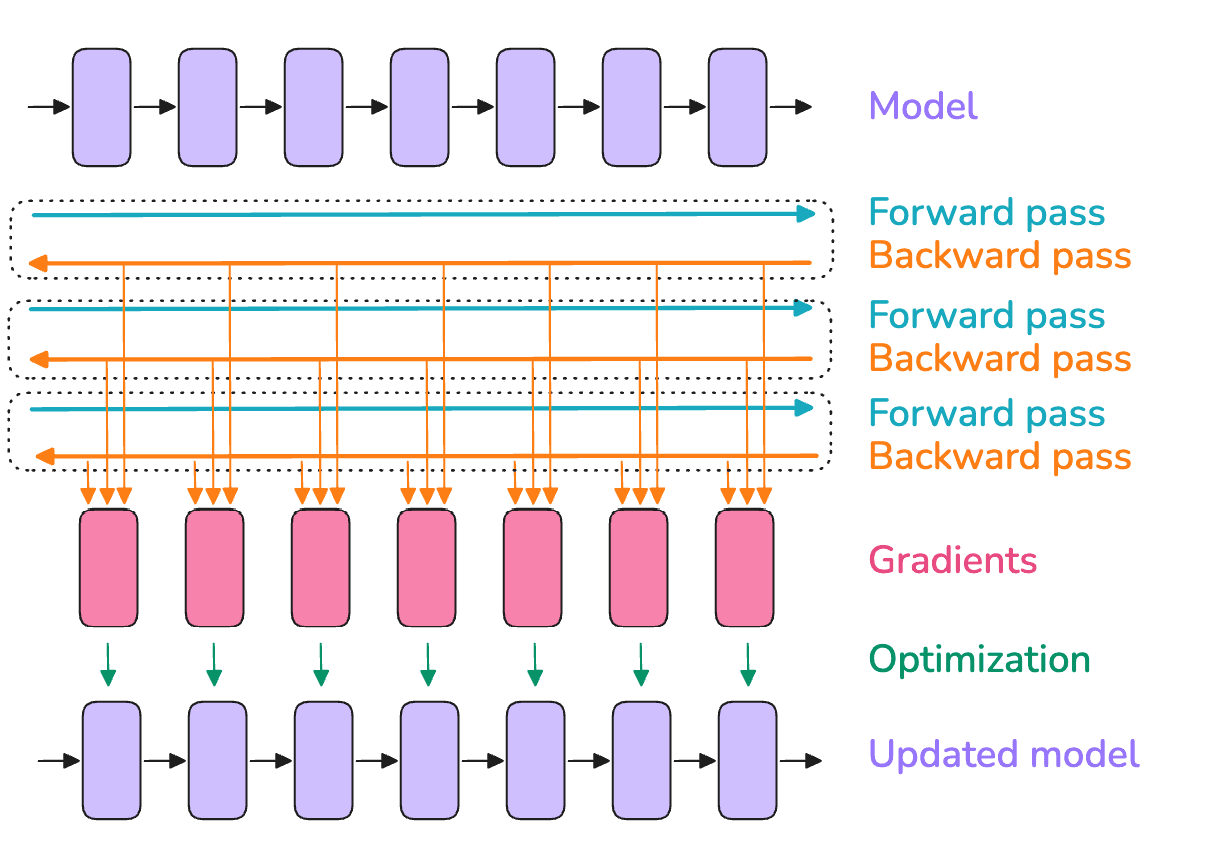
-
梯度累积的过程
-
假设:、、
-
第 次 micro-batch:forward(仅 2 个样本),backward,得到梯度 ,但是不更新参数
-
优化时,实际使用的是平均梯度
-
这样,在任意时刻,显存里只有一个 micro-batch 的激活,只要 固定,激活显存就是常数
-
-
梯度为什么要 “取平均” 而不是 “取和”?
-
如果不取平均,梯度会随 grad_acc 线性放大,等价于隐式改变 learning rate
-
取平均后,与 batch size 无关,学习率无需调整
-
-
两种优化技术的对比
- activation recomputation 控制每个样本的激活大小,降低常数项
- gradient accumulation 控制同时在显存中的样本数,降低
-
与激活重计算相同,梯度累积的真实代价也是计算量(FLOPs)
-
forward /backward 次数增加:
-
wall-clock time 增加,但可以换来更大等效 batch、更稳定的优化、显存可控
-
-
自然而然地,不同的 micro batch 的前向和后向传播是可以并行运行的,它们彼此之间相互独立,唯一的区别只是输入样本不同,而这正是一个信号 —— 可以把训练扩展到多张 GPU 上
两种优化后的激活显存
-
统一符号:
- :micro-batch size
- :global batch size
- :gradient accumulation steps
- :sequence length
- :hidden size
- :attention heads
- :Transformer layers
-
不使用任何优化(baseline)的 activation 显存(每一层)
-
token-wise 激活:
-
attention softmax:
-
因此总 activation memory:
-
-
加上 FlashAttention(去掉 )
-
FlashAttention 的本质是不保存 ,backward 时重算
-
于是 级别的 activation 被消除,只剩 token-wise 激活
-
但此时 ,所以 batch size 一大,activation 仍然线性爆炸
-
-
加上 gradient accumulation(把 变成 )
-
gradient accumulation 的关键作用是,显存中同时存在的 batch = micro-batch,于是 ,公式变为
-
global batch size 与 activation 显存彻底解耦
-
-
加上 checkpoint(降低 layer 维度)
-
checkpoint 的本质是:不存每一层的 activation,只存少数 “锚点层”
-
假设每 层存一个 checkpoint,需要存的层数约为
-
则 activation 显存变为:
-
训练所需的内存计算
- 在训练神经网络时,占用 GPU 内存的内容主要如下
- 模型权重参数:参数量乘以每个参数的字节数
- FP32 精度:
- BF16 混合精度:
- 在 BF16 混合精度下,需要使用 FP32 额外存储模型参数副本(主权重),即
- 模型梯度:参数量乘以每个参数的字节数
- FP32 精度:
- BF16 混合精度:
- 在 BF16 混合精度下,需要使用 FP32 额外存储模型梯度副本,即
- 优化器状态:Adam 优化器需要额外存储动量和方差,每个 4 字节,以实现数值稳定性,即
- 用于计算梯度的激活值:通常是主要显存瓶颈
- CUDA 内核一般需要占用 1-2 GB
- 模型权重参数:参数量乘以每个参数的字节数
- 这些内容以张量的形式存储,并具有不同的形状和精度
- 形状通常由批次大小、序列长度、模型的隐藏层维度、注意力头数、词汇表大小等决定
- 精度指的是 FP32、BF16 或 FP8 等格式,分别需要 4、2 或 1 字节来存储张量中的每个值
- 混合精度
- 混合精度并不会凭空减少模型的总显存占用,因为为了数值稳定性,仍然需要保留 FP32 的权重和梯度,甚至在梯度用 FP32 累积时,参数相关显存还会略微增加
- 但混合精度依然是必须的,因为 FP16/BF16 可以使用 GPU 的高速低精度算子,显著加快训练,前向传播中的激活以半精度存储,极大降低了激活显存,而激活正是训练时的主要显存瓶颈
PyTorch Profiler
- PyTorch 的 profiler 允许精确地追踪和可视化训练过程中 CPU 和 GPU 的动态变化过程
- Profiler 会产生训练时的运行轨迹,可以在 TensorBoard 或 Chrome 的 trace viewer 中可视化,如
- CPU 线程如何以异步方式向 GPU 发射(launch)kernel
- 多个 CUDA stream 如何并行处理计算与通信
- 各个 kernel 的执行时间以及显存分配情况
- 这个运行轨迹有助于识别训练过程中的性能瓶颈,例如:
- 本可以重叠执行却被串行化的计算与通信
- GPU 因等待数据传输而产生的空闲时间
- CPU 与 GPU 之间的 CUDA 同步与内存拷贝开销
- GPU 上 kernel 启动本身带来的额外开销
- 理解这些执行模式对于优化分布式训练性能至关重要,例如,trace 能清楚地展示梯度同步是否与反向传播计算正确地实现了重叠