优化算法
从优化问题的形式化定义出发,引入梯度下降,并逐步发展出更复杂的优化机制
- 参考资料
优化问题与梯度下降
什么是优化问题
- 在机器学习与统计建模中,优化问题指的是在参数空间中寻找一组参数 ,使某个目标函数达到最小(或最大)值
- 以最小化为例,标准形式可写为(其中 通常表示损失函数或经验风险)
- 在监督学习中, 往往由样本损失的平均构成:
- 这一形式将学习问题转化为一个连续参数空间中的数值优化问题,其核心困难在于:
- 参数维度通常很高
- 一般是非凸函数
- 无法通过解析方式直接求解最优解
什么是梯度下降
- 在目标函数 可微的前提下,其一阶导数(梯度)提供了函数在当前点的局部变化信息
- 梯度 定义为:
- 根据多元微积分中的一阶泰勒展开,在 附近有:
- 若希望 在下一步下降最快,应选择使上式下降幅度最大的方向,即令:
- 由此得到**梯度下降(Gradient Descent)**的基本更新规则(其中 为学习率,用于控制更新步长):
- 梯度下降可以被理解为:在每一步中,用目标函数的局部线性近似来指导参数更新,从而逐步逼近极小值点
Batch / Stochastic / Mini-batch
全梯度计算的代价
-
当损失函数由全体样本的平均构成时,其梯度具有如下形式:
-
这意味着每一次参数更新都需要遍历全部数据样本
-
在数据规模较大时,这种 “全梯度下降” 在计算上难以承受,也不适用于在线或流式学习场景
批量梯度下降
- 在批量梯度下降(Batch Gradient Descent)中,每一步更新都使用全部训练样本来计算梯度
- 对应的梯度形式为:
- 更新规则为:
- 这一方式的关键特征在于梯度是精确的(在经验风险意义下),更新方向稳定,优化轨迹平滑
- 但其隐含代价是:单次更新成本随样本数线性增长,在大规模数据场景下难以应用
随机梯度下降
-
为降低单次更新的计算成本,可以将梯度计算从 “全体样本” 降为 “单个样本”,即随机梯度下降(Stochastic Gradient Descent, SGD)
-
在第 步,随机抽取一个样本 ,构造梯度估计:
-
对应的更新规则为:
-
在概率意义下,有:
-
即随机梯度是全梯度的无偏估计
-
然而,由于 SGD 只依赖单个样本,梯度估计的方差较大,导致参数更新在最优点附近持续震荡,而非严格收敛
小批量梯度下降
-
小批量梯度下降(Mini-batch Gradient Descent)可以视为在批量梯度下降与随机梯度下降之间的折中
-
在第 步,从数据集中采样一个大小为 的 minibatch:
-
构造梯度估计:
-
更新规则仍为:
-
当 时,该方法退化为随机梯度下降;当 时,则等价于批量梯度下降
-
在期望意义下, 是全梯度的无偏估计,但其方差不可避免地引入了更新噪声
-
这种噪声使得优化轨迹不再沿着平滑的下降路径,而呈现出震荡特性
-
小批量梯度下降在以下意义上成为实践中的默认选择:
- 梯度噪声被部分平均,更新方向更稳定
- 可充分利用向量化与并行计算(GPU / TPU)
- 在噪声存在的情况下,有助于跳出浅层局部极小或鞍点
梯度下降训练的挑战
- 学习率选择难:学习率过小导致收敛极慢,过大则使损失函数在最小值附近波动甚至发散
- 学习率调度局限性:预设调度(如退火)无法适配数据集特性,需提前定义阈值
- 参数更新公平性问题:相同学习率适用于所有参数,稀疏数据中高频与低频特征需不同更新幅度(低频特征需更大更新)
- 非凸误差面困境:神经网络常见的高度非凸误差面中,问题并非来自局部最小值,而是鞍点(一维向上、一维向下倾斜),其周围误差平台使 SGD 难以逃离(梯度接近零)
动量方法(Momentum)
- 引入动量的动机
- 在标准 SGD 中,梯度通常包含较强的随机噪声,尤其是在狭长谷地或各向异性(曲率不均)的损失地形中,参数更新容易在陡峭方向上来回摆动,从而减慢沿平坦方向的前进速度
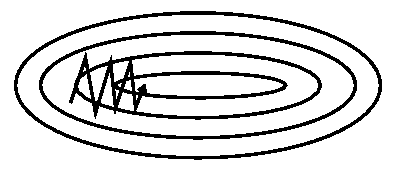
- 单步更新完全依赖当前梯度,使得优化过程对瞬时噪声高度敏感,历史梯度中所蕴含的稳定方向信息被忽略
- 动量方法的核心思想是:将参数更新视为一个具有 “惯性” 的动态过程,通过累积历史梯度来平滑噪声,并在长期一致的方向上加速收敛
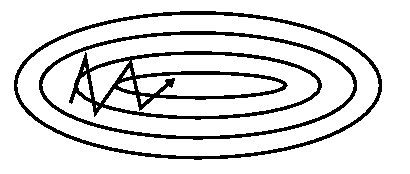
- 在标准 SGD 中,梯度通常包含较强的随机噪声,尤其是在狭长谷地或各向异性(曲率不均)的损失地形中,参数更新容易在陡峭方向上来回摆动,从而减慢沿平坦方向的前进速度
Momentum
-
通过引入动量变量 ,对历史梯度进行指数加权平均:
- 其中 控制历史梯度的保留程度,通常设置为 0.9
-
参数更新不再直接使用当前梯度,而是沿动量方向前进:
-
本质上,当利用动量时,可以看作将一个球推下山坡,球在向下滚动的过程中会积累动量,速度变得越来越快(如果存在空气阻力,即 ,会达到最终速度)
-
这种机制在梯度方向长期一致的维度上实现 “加速”,同时在噪声较大的方向上起到平滑作用
NAG
-
然而,一个顺着山坡盲目滚动的球是非常令人不满意的,而是想要一个更聪明的球,一个知道自己要去哪里的球,这样它就知道在山坡再次向上倾斜之前减速
-
Nesterov accelerated gradient (NAG) 先按历史动量方向预估参数位置,再基于预估位置计算梯度(“预判” 式更新)
-
提供了参数下一个位置的近似值,让我们大致了解参数的变化方向
-
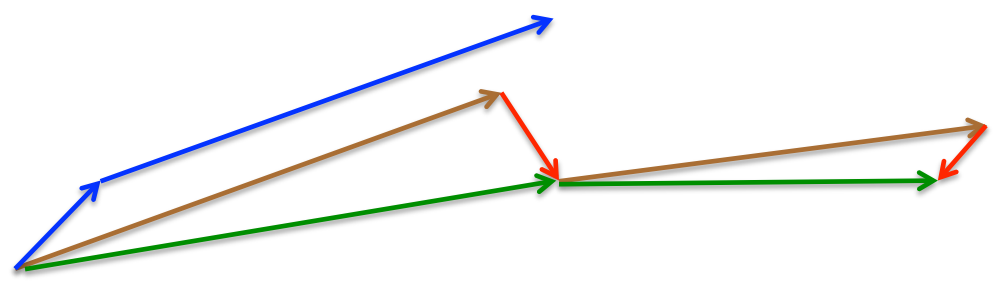
如图所示,动量法首先计算当前梯度(图中的小蓝色向量),然后沿着更新后的累积梯度方向大幅跳跃(大蓝色向量),而 NAG 首先沿着之前的累积梯度方向大幅跳跃(棕色向量),测量梯度,然后进行修正(红色向量),这就形成了完整的 NAG 更新(绿色向量)
-
这种前瞻性更新防止前进过快,并提高了响应速度,这显著提升了循环神经网络在多项任务上的性能
-
-
需要注意的是,动量方法仍假设所有参数维度共享同一学习率尺度,无法应对梯度幅值差异巨大的情况
-
因此,除了动量机制,我么还希望针对每个单独的参数调整更新,根据它们的重要性进行不同尺度的更新
自适应学习率(Adaptive Learning Rate)
- 学习率尺度问题
-
在高维参数空间中,不同参数维度的梯度幅值可能相差数个数量级
-
若使用统一的学习率:
- 在梯度幅值较大的维度上,更新可能过快甚至不稳定
- 在梯度幅值较小的维度上,更新则可能极其缓慢
-
这使得单一全局学习率难以同时适配所有参数方向
-
Adagrad(自适应梯度)
-
对于与频繁出现的特征相关的参数采用较小的更新(即较低的学习率),而对于与不常出现的特征相关的参数采用较大的更新(即较高的学习率),因此,Adagrad 非常适合处理稀疏数据
-
之前的实现会一次性更新所有参数 ,这是因为每个参数 都使用了相同的学习率 ,而 Adagrad 算法会在每一个时间步 为每个参数 分配不同的学习率
-
首先介绍 Adagrad 的单参数更新规则,再将其向量化
-
为了简化表达,用 表示时间步 的梯度, 则表示目标函数在时间步 对参数 的偏导数:
-
在随机梯度下降(SGD)中,每个时间步 对参数 的更新规则为:
-
Adagrad 在其更新规则中,会根据参数 过往计算得到的梯度,在每个时间步 为该参数单独调整全局学习率 :
- 是一个对角矩阵,其对角线上的第 个元素 代表截至时间步 ,参数 对应的所有梯度的平方和
- 是一个平滑项,用于避免出现除以零的情况(通常取值为 量级)
- 有趣的是,如果去掉平方根运算,该算法的性能会大幅下降
-
由于 的对角线上存储了所有参数 的过往梯度平方和,可以通过矩阵与向量的哈达玛积()来实现向量化更新:
-
Adagrad 最主要的优势之一是无需手动调优学习率,大多数实现中直接使用默认值 即可
-
Adagrad 的核心缺陷在于分母中梯度平方的累积导致学习率衰减:由于每一项都是正数,训练过程中累积的平方和会持续增大,导致学习率不断缩小,最终趋近于无穷小,此时算法将无法再学习到新的知识,而后续提出的优化算法(如 RMSProp、Adam)正是为了解决这一问题
Adadelta(自适应增量)
-
Adadelta 是 Adagrad 的扩展算法,旨在缓解 Adagrad 中学习率单调且激进下降的问题
-
与累积所有过往梯度平方不同,Adadelta 将梯度平方的累积窗口限制在一个固定大小 内
-
为避免低效地存储 个历史梯度平方值,它将梯度平方和定义为所有过往梯度平方的衰减平均值,通过递归方式计算
-
时间步 的梯度平方滑动平均 (类似动量项)仅依赖于上一步的平均值和当前梯度:
-
通常将 设置为与动量项相近的值,约为 0.9
-
为了清晰表达,先以参数更新向量 的形式重写基础 SGD 的更新规则:
-
之前推导的 Adagrad 参数更新向量形式为:
-
在 Adadelta 中,只需将对角矩阵 替换为梯度平方的衰减平均值 :
-
由于分母就是梯度的均方根(RMS)误差,可以用简写形式表示:
-
Adadelta 的作者指出,该更新规则(以及 SGD、动量法、Adagrad 的更新规则)存在量纲不匹配的问题,即更新量的理论量纲应与参数本身的量纲一致
-
为解决这一问题,Adadelta 定义了另一个指数衰减平均值,这次不是针对梯度平方,而是针对参数更新量的平方:
-
参数更新量的均方根误差为:
-
由于 在当前步是未知的,可以用前一时间步的参数更新量均方根来近似它
-
将之前更新规则中的学习率 替换为 ,最终得到 Adadelta 的更新规则:
-
使用 Adadelta 时,甚至无需设置默认学习率,因为它已从更新规则中被完全移除
RMSProp(均方根传播)
-
RMSProp 是一种未正式发表的自适应学习率方法,由 Geoff Hinton 在其 Coursera 课程的第 6e 讲中提出
-
RMSProp 与 Adadelta 几乎是在同一时期被独立提出的,两者的初衷都是解决 Adagrad 中学习率过快衰减的问题
-
实际上,RMSProp 的更新规则与之前推导的 Adadelta 第一个更新向量完全一致:
- 其中 控制统计量的平滑程度, 用于数值稳定,防止除零
-
RMSProp 的核心思想是将学习率除以梯度平方的指数衰减平均值
-
Hinton 建议将衰减系数 设为 0.9,而学习率 的一个良好默认值为 0.001
-
这种按维度缩放的更新方式有效缓解了梯度尺度不一致的问题,使得每个参数都能以 “合适的步长” 更新
-
然而,RMSProp 的更新方向仍完全由当前梯度 决定,未显式建模梯度在时间维度上的方向一致性
-
从优化思想上看:
- 动量方法主要解决 “方向是否稳定” 的问题
- RMSProp 主要解决 “不同方向该走多快” 的问题
- 二者分别从一阶与二阶统计角度改进 SGD,也为后续将二者统一起来的 Adam 方法奠定了基础
Adam(自适应矩估计)
-
动量方法通过指数滑动平均引入一阶历史信息,能够在方向一致时加速收敛,但对不同参数维度上的梯度尺度差异不敏感
-
RMSProp 通过对梯度平方的滑动平均建模二阶统计量,能够自适应调整每个参数的学习率,但忽略了梯度方向在时间维度上的一致性
-
Adam(Adaptive Moment Estimation)是一种为每个参数计算自适应学习率的优化方法,它将二者视为互补信息:
- 一阶矩刻画 “往哪个方向走更稳定”
- 二阶矩刻画 “在不同维度上该走多大步长”
- 从而在噪声较大、梯度尺度不均的场景中显著提升优化稳定性
-
Adam 在 Adadelta 和 RMSProp 的基础上,不仅维护了梯度平方的指数衰减平均值 ,还额外维护了梯度的指数衰减平均值 (类似动量机制)
-
动量机制可以类比为一个沿斜坡滚落的球,而 Adam 则像一个带有摩擦力的重球,因此它倾向于在误差曲面中选择更平坦的极小值点
-
Adam 的形式化推导
-
首先分别计算梯度的一阶矩(均值) 和二阶矩(非中心化方差) 的指数衰减平均值
-
一阶矩估计(梯度的指数滑动平均):
- 其中 , 控制动量的 “记忆长度”
-
二阶矩估计(梯度平方的指数滑动平均):
- 该项用于刻画不同参数维度上的梯度尺度
-
由于 和 初始化为全零向量,在迭代初期会存在向零偏移的偏差(尤其当衰减系数 和 接近 1 时)
-
为修正这一偏差,计算偏差校正(Bias Correction)后的一阶矩和二阶矩估计:
- 由于 ,在训练早期滑动平均会系统性偏小,偏差校正用于恢复无偏估计
-
使用校正后的矩估计,可以得到 Adam 的参数更新规则:
- 其中 用于数值稳定,防止除零
-
-
Adam 推荐的默认值为:,,,而实验表明 Adam 在实际应用中表现优异,性能优于其他自适应学习率算法
-
从梯度下降到 Adam 的演化视角
- SGD:使用当前梯度,易受噪声影响,且对尺度不敏感
- Momentum:引入方向上的历史一致性,减少震荡
- RMSProp:引入尺度自适应,但忽略方向积累
- Adam:同时建模方向与尺度,在不改变目标函数的前提下,提高了实际可优化性与收敛稳定性
AdaMax
-
在 Adam 的更新规则中, 项通过梯度平方和来缩放梯度,其本质是基于梯度的 范数,可以将其推广到 范数的形式:
-
当 取值较大时, 范数在数值上通常不稳定,因此实践中 和 范数最为常用
-
但 (无穷)范数通常表现出稳定的数值特性,基于此提出了 AdaMax
-
在 AdaMax 中,用无穷范数约束的 替代原有的 :
-
将 代入 Adam 的更新方程(用 替换 ),得到 AdaMax 的更新规则:
-
由于 基于最大值运算,它不会像 Adam 中的 和 那样出现向零偏移的偏差,因此无需对 进行偏差校正
-
AdaMax 的推荐默认值为:,,
Nadam
-
之前已经了解到,Adam 可以看作是 RMSProp 与动量机制的结合:RMSProp 提供了梯度平方的指数衰减平均值 ,而动量机制提供了梯度的指数衰减平均值 ;同时也知道 Nesterov 加速梯度(NAG)的性能优于普通的动量机制
-
Nadam(Nesterov-accelerated Adaptive Moment Estimation)正是结合了 Adam 和 NAG 的算法
-
为了将 NAG 融入 Adam,需要修改其动量项
-
首先,回顾标准动量机制的更新规则:
-
其中 是目标函数, 是动量衰减系数, 是步长。展开第三式可得:
-
这表明动量机制的更新由两部分组成:沿之前动量向量方向的一步,以及沿当前梯度方向的一步
-
NAG 通过在计算梯度之前先用动量更新参数,从而在梯度方向上迈出更精准的一步,只需修改梯度 即可得到 NAG 的更新规则:
-
Dozat 提出了对 NAG 的另一种修改方式:不再两次应用动量步骤(一次更新梯度 ,一次更新参数 ),而是直接用 “前瞻” 动量向量来更新当前参数:
-
注意,这里不再像之前展开的动量更新规则那样使用前一时刻的动量向量 ,而是用当前动量向量 来 “前瞻”
-
为了给 Adam 添加 Nesterov 动量,可以用同样的思路,将前一时刻的动量向量替换为当前的动量向量
-
首先,回顾 Adam 的更新规则(注意 无需修改):
-
将 和 的定义代入并展开第二式,可得:
-
注意, 正是前一时刻动量向量的偏差校正估计,可以用 来替换它:
-
为了简化,忽略分母是 而非 的细节,因为下一步会替换类似的分母,该式与之前展开的动量更新规则非常相似
-
现在,只需将前一时刻动量向量的偏差校正估计 替换为当前动量向量的偏差校正估计 ,即可得到 Nadam 的更新规则:
AMSGrad
-
随着自适应学习率方法成为神经网络训练的主流,研究者发现,在一些场景(如图像识别或机器翻译)中,这些方法无法收敛到最优解,性能甚至不如带动量的 SGD
-
Reddi 等人正式提出了这一问题,并指出梯度平方的指数移动平均是导致自适应学习率方法泛化能力差的原因之一
-
回顾一下,引入指数平均的初衷是防止学习率在训练过程中变得无限小,但梯度的短期记忆在某些场景下反而成为了缺陷
-
在 Adam 收敛到次优解的场景中,观察发现某些极小值点能提供丰富的梯度信息,但这些极小值点仅在训练初期出现,而指数平均会淡化它们的影响,导致最终收敛效果不佳。作者用一个简单的凸优化问题为例,展示了 Adam 的这种行为
-
为解决这一问题,作者提出了 AMSGrad 算法,它使用历史梯度平方的最大值而非指数平均来更新参数,而 的定义与 Adam 中一致:
-
但不再直接使用 (或其偏差校正版本 ),而是维护一个单调递增的序列:
-
这样,AMSGrad 能保证步长不会减小,从而避免了 Adam 可能出现的缺陷
-
作者还推荐移除 Adam 中已被证明有害的偏差校正步骤
-
完整的 AMSGrad 更新规则(不含偏差校正)如下:
-
作者观察到,在小型数据集和 CIFAR-10 上,AMSGrad 的性能优于或与 Adam 相当;但在更大规模的实验中,它的表现与 Adam 相似或更差
-
尽管如此,AMSGrad 仍是深度学习优化领域的重要进展
AdamW
-
AdamW 是对 Adam 的一个关键修正版本,主要区别在于权重衰减(Weight Decay)的处理方式
-
在原始 Adam 中,权重衰减通常通过在损失函数中加入 正则项实现:
-
这会导致正则项的梯度也被送入 Adam 的自适应缩放机制中,使得:
- 权重衰减的效果与梯度统计量耦合
- 不同参数维度的衰减强度不一致
-
AdamW 的核心思想是解耦权重衰减与梯度更新:
- 梯度更新仍然由 Adam 的一阶 / 二阶矩控制
- 权重衰减作为一个独立的、直接作用于参数的衰减项
-
AdamW 的更新形式可以写为:
- 其中 明确表示权重衰减系数,而不是损失函数的一部分
-
这种解耦方式使得权重衰减真正起到 “限制参数规模” 的作用,而不会被自适应学习率机制削弱或放大,因此在 Transformer 等大模型中表现更稳定、可控
-
Adam 解决了 “怎么走得稳、走得快” 的问题,而 AdamW 进一步解决了 “如何正确地约束参数规模” 的问题,这也是为什么 AdamW 成为 Transformer 训练中的事实标准优化器
-
超参数的设置
- 学习率 / :决定整体更新步长,是最关键的超参数,在 Transformer 中通常与 warmup + 衰减调度联合使用
-
:控制一阶动量的平滑程度,常用值为 ,在稳定性与响应速度之间取得平衡
- :控制二阶矩估计的时间尺度,常用值为 ,保证对梯度尺度的稳定估计
- :主要用于数值稳定,虽然对最终结果影响不大,但在混合精度或极小梯度场景下很重要
-
权重衰减 ”:用于限制参数规模、提升泛化能力,在 AdamW 中通常单独调节,而不与学习率强耦合
Muon
不同算法对比
-
不同算法在 Beale 函数损失曲面等高线上随时间的收敛轨迹
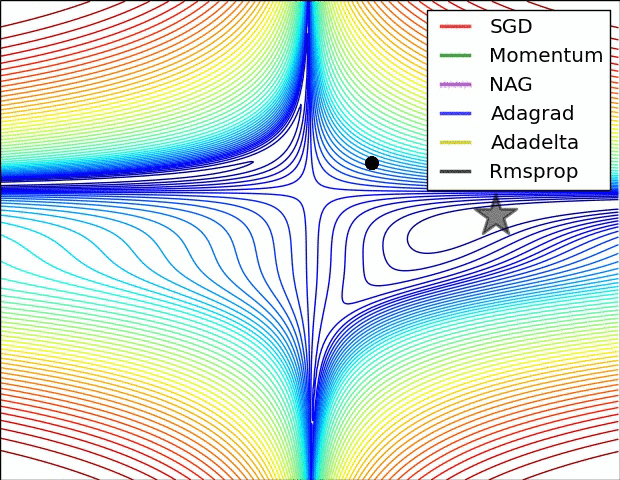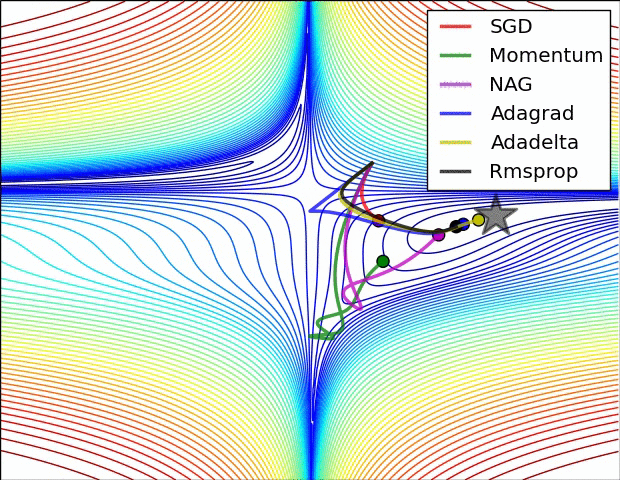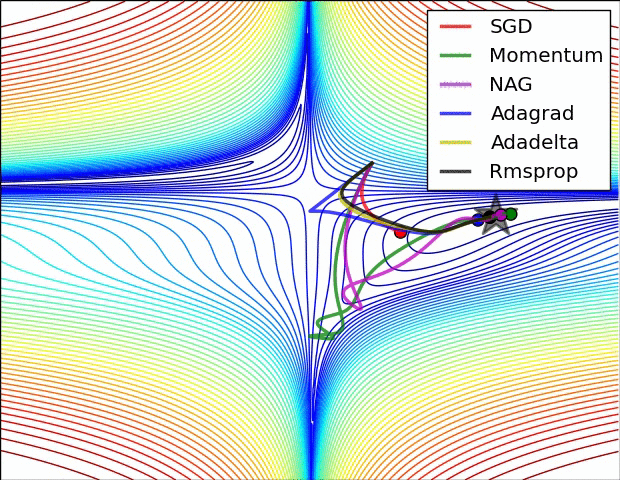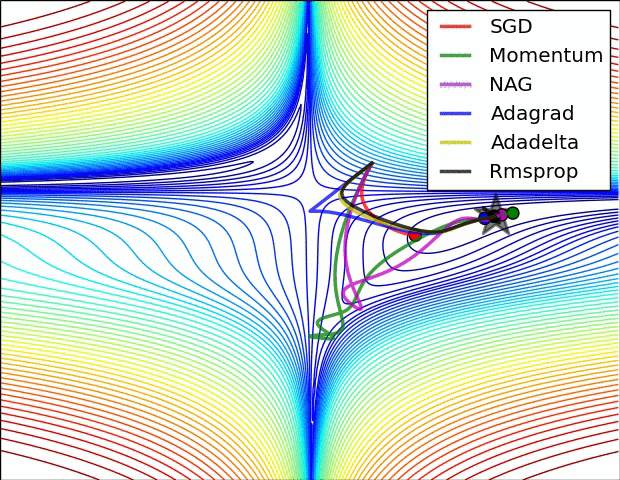
- Adagrad、Adadelta、RMSProp:几乎立刻就能朝着正确方向前进,并且收敛速度相近
- Momentum、NAG:初期会像 “滚下山的球” 一样偏离正确路径,但 NAG 凭借其前瞻机制带来的高响应性,能迅速修正方向并收敛到最小值
-
算法在鞍点(一个维度斜率为正、另一维度斜率为负的点)的行为,这类点对 SGD 来说是典型的挑战
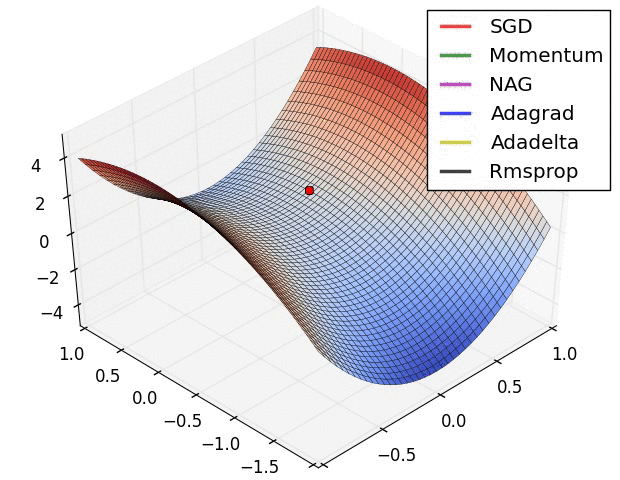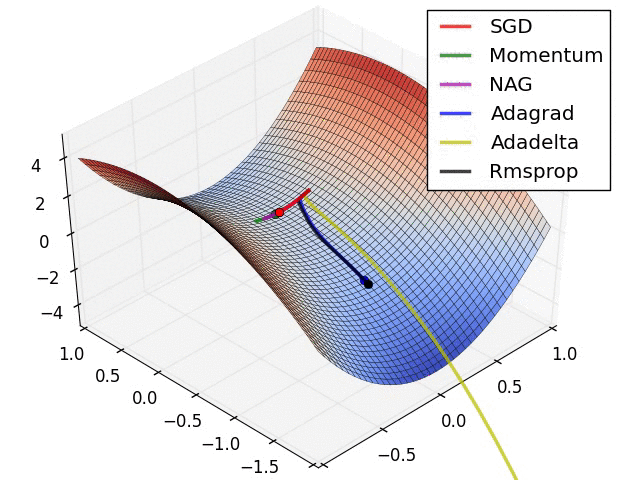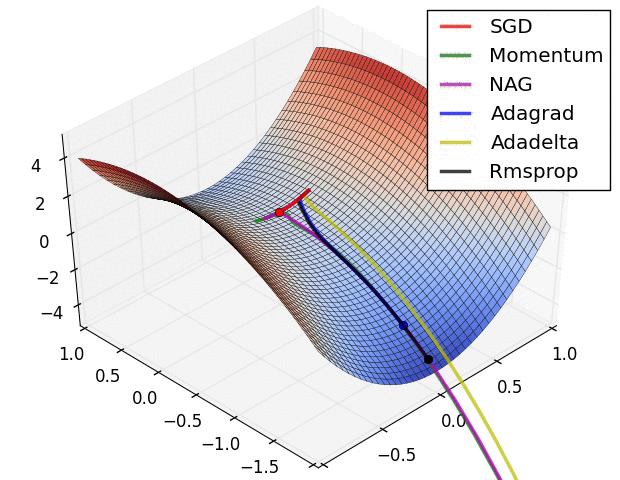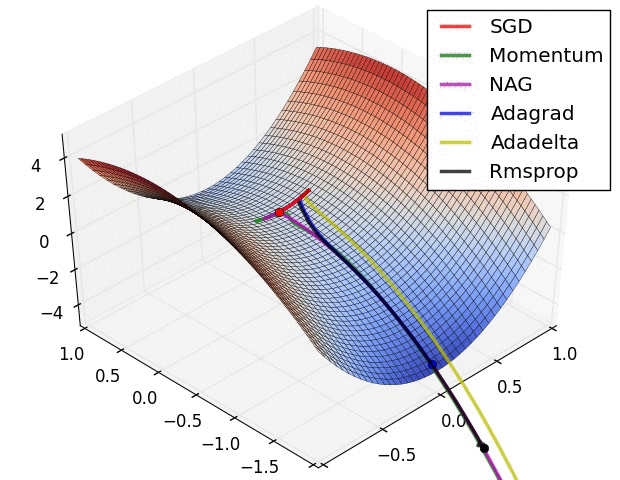
- SGD、Momentum、NAG:难以打破对称性,虽然 Momentum 和 NAG 最终能逃离鞍点,但过程较为缓慢
- Adagrad、RMSProp、Adadelta:能迅速沿着负斜率方向下降,表现出更强的逃离能力