归一化

从优化动力学与表示分布出发,系统阐明归一化方法为何出现、如何工作,以及它与正则化的本质差异

什么是归一化

  • 归一化(Normalization)是深度学习中常用的一类技术,是将特征转换为可比尺度的过程

  • 特征归一化的方法多种多样,包括标准评分和最小最大特征缩放

  • 最大最小特征缩放(Min-Max Scaling)将特征缩放到固定范围(通常是 0 到 1):

    x′=x−xminxmax−xminx' = \frac {x - x_{min}}{x_{max} - x_{min}}
  • 标准评分(Standard Score)将特征转换为均值为 0、方差为 1 的分布:

    z=x−μσμ=mean(x)=1N∑i=1Nxiσ=std(x)=1N∑i=1N(xi−μ)2z = \frac {x - \mu}{\sigma}\\ \mu = \text{mean}(x) = \frac {1}{N} \sum_{i=1}^{N} x_i\\ \sigma = \text{std}(x) = \sqrt {\frac {1}{N} \sum_{i=1}^{N} (x_i - \mu)^2}

为什么需要归一化

  • 在深度网络中,训练困难往往并非来自欠拟合或过拟合,而是来自梯度传播的不稳定性

  • 随着网络加深,各层输入分布不断变化,梯度尺度在层与层之间被放大或压缩

  • 抽象地看,一个深度网络的训练问题可以写为:

    θ∗=arg⁡min⁡θ  E[L(fθ(x),y)]\theta^* = \arg\min_\theta \; \mathbb {E}[L (f_\theta (x), y)]
  • 实际执行梯度下降时,更新方向为:

    ∇θL=∂L∂h(L)∏l=1L−1∂h(l+1)∂h(l)\nabla_\theta L = \frac {\partial L}{\partial h^{(L)}} \prod_{l=1}^{L-1} \frac {\partial h^{(l+1)}}{\partial h^{(l)}}
  • 当中间激活 h(l)h^{(l)} 的分布均值不断漂移 / 方差不断放大或塌缩时,梯度乘积会迅速失控

  • 归一化的根本动机:不是约束模型,而是稳定 “信号与梯度在网络中的流动环境”

  • 所有归一化方法的步骤大致如下

    • 选一组数,算均值和方差

      μ=mean(h),σ2=var(h),σ′=σ2+ϵ\mu = \text{mean}(h), \quad \sigma^2 = \text{var}(h), \quad \sigma^{\prime} = \sqrt {\sigma^2 + \epsilon}
    • 标准化

      h^=h−μσ2+ϵ\hat {h} = \frac {h - \mu}{\sqrt {\sigma^2 + \epsilon}}
      • μ\mu:某种统计维度下的均值
      • σ′\sigma^{\prime}​:对应的标准差或尺度估计
      • ϵ\epsilon:防止除零的微小常数,当方差极小时,避免数值不稳定
      • 从而让每一层的输入:均值 ≈ 0,方差 ≈ 1
    • 为了避免丧失网络的表达能力,引入可学习的重参数化:

      y=γh^+βy = \gamma \hat {h} + \beta
      • 归一化只负责稳定数值尺度
      • 而 γ,β\gamma, \beta 保证模型的表达能力不被削弱,恢复网络所需的表达自由度
      • γ\gamma 控制输出尺度,初始化为 1
      • β\beta 控制输出偏移,初始化为 0
      • 由此可见,归一化并不是 “强制标准化输出”,而是重参数化(reparameterization)
    • 不同归一化方法之前的所有差别,只在于:“这组 hh 到底是谁?”,即在一组四维张量 h∈R(N,C,H,W)h \in \mathbb {R}^{(N, C, H, W)} 里,到底在哪些维度上算均值和方差?

    • 核心思想:归一化维度的选择,本质上是对 “哪些相关性应该被消除” 的假设

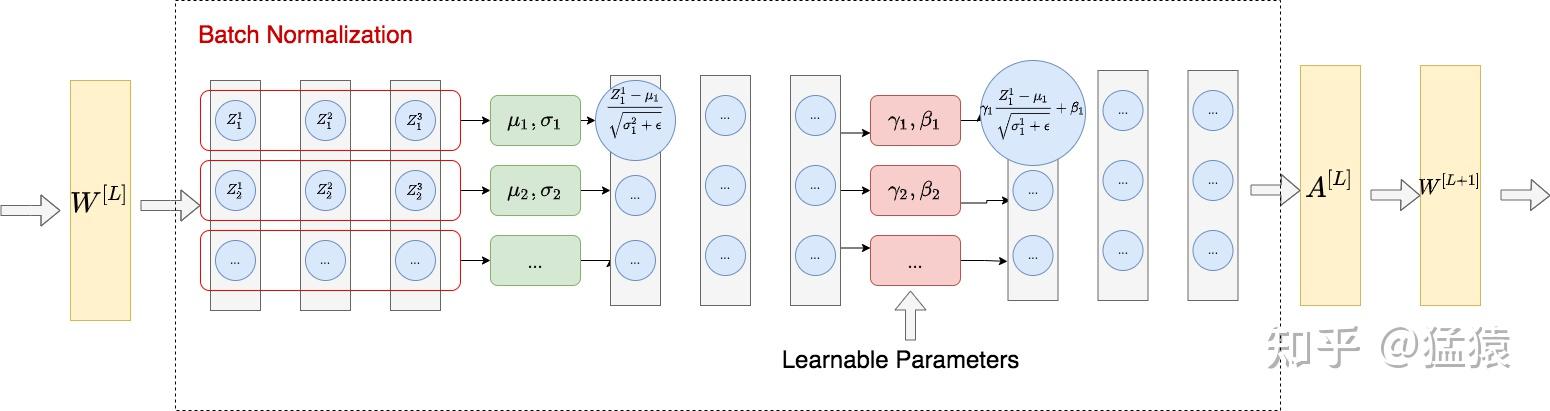
Batch Normalization

  • BatchNorm(BN)最初提出是为了减少内部协变量偏移(Internal Covariate Shift),即训练集和测试集在同一时间内采集的数据,但其输入数据分布发生了变化,但更本质的理解是:BN 改变了参数空间的几何结构,使梯度下降更容易进行

  • BN 默认假设:同一通道在不同样本之间,表示的是 “同一种语义特征”,所以可以跨样本一起统计

  • 因此对同一个通道 cc:在一个 batch 里的所有样本 + 所有空间位置上统一算均值和方差

    bn

  • 对 mini-batch,对特定通道 cc:

    μc=1N⋅H⋅W∑n,h,whn,c,h,w,σc2=1N⋅H⋅W∑n,h,w(hn,c,h,w−μc)2\mu_c =\frac {1}{N \cdot H \cdot W} \sum_{n,h,w} h_{n,c,h,w} ,\quad \sigma_c^2 =\frac {1}{N \cdot H \cdot W} \sum_{n,h,w} (h_{n,c,h,w} - \mu_c)^2
  • 机制理解:

    • 参数尺度变化不再直接影响激活尺度
    • 梯度对参数的敏感性被显著降低
    • 梯度对学习率不敏感,学习率可设得更大
    • 隐含效果:mini-batch 统计噪声带来轻微正则化效应
  • BatchNorm 的结构性局限

    • BN 的统计依赖于 batch:

      • batch 太小 → 统计假设失效,μ(B),σ(B)\mu^{(B)}, \sigma^{(B)} 噪声巨大,梯度方向不稳定
      • batch 太大 → 训练与推理行为差异明显
    • BN 的行为在训练 / 测试阶段不一致:

      • 训练:使用 batch 统计,对于每一个 batch,μ(B),σ(B)\mu^{(B)}, \sigma^{(B)} 都不一样

      • 推理:batch size = 1 或 batch size 很小或实时流式输入,无法保证 “当前 batch” 是一个好统计样本,因此不再使用当前 batch 的统计而是使用训练期间累计的滑动平均

        μc(test)≈Etrain[μc(B)](σc(test))2≈Etrain[(σc(B))2]x^=x−μc(test)(σc(test))2+ϵ\mu_c^{(test)} \approx \mathbb {E}_{\text{train}}[\mu_c^{(B)}]\\ (\sigma_c^{(test)})^2 \approx \mathbb {E}_{\text{train}}[(\sigma_c^{(B)})^2]\\ \hat {x}=\frac {x - \mu_c^{(test)}}{\sqrt {(\sigma_c^{(test)})^2 + \epsilon}}
      • 这样就导致,对于同一个输入 xx,在训练阶段和在测试阶段,经过 BN 后的输出可能不同

    • 在以下场景中表现不佳:

      • RNN / 序列模型
      • 强依赖单样本统计的任务
      • 强分布漂移场景

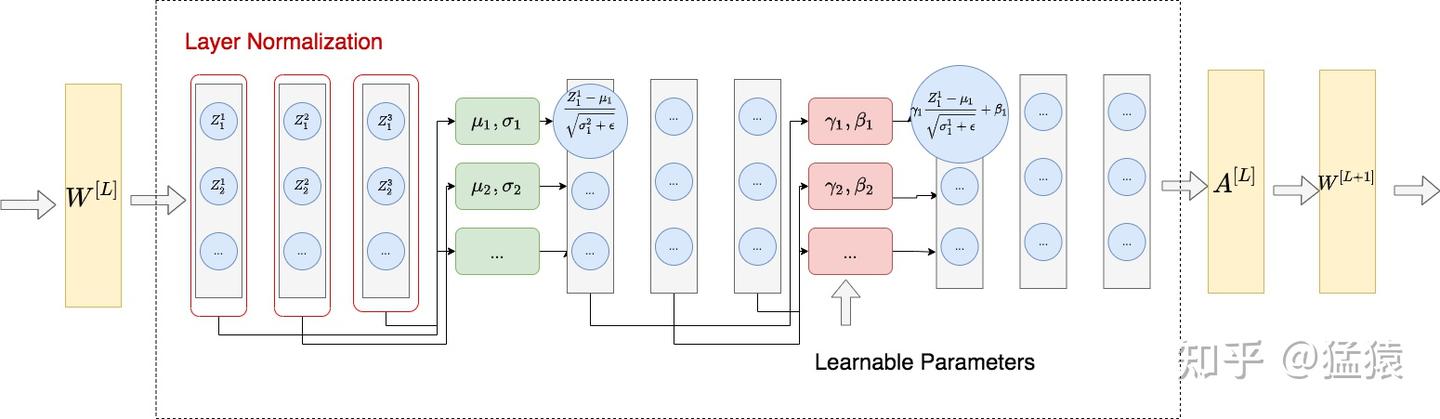
Layer Normalization

  • Layer Normalization(LN)不再跨样本统计,而是对单个样本,在特征维度上算均值和方差

  • LN 假设一个样本内部的各维特征构成一个完整的 “状态表示”,所以不关心 batch,每个样本自己对自己负责
    ln

  • 对每一个样本,沿其特征维度做归一化

    • 例如,对于维度为 (O,P,Q)(O,P,Q) 的矩阵,对每一行 oo 做归一化:

      μo=1P×Q∑p∑qho,p,q,σo2=1P×Q∑p∑q(ho,p,q−μo)2\mu_o =\frac {1}{P\times Q} \sum_{p}\sum_{q} h_{o,p,q},\quad \sigma_o^2 =\frac {1}{P\times Q} \sum_{p}\sum_{q} (h_{o,p,q} - \mu_o)^2
    • 更通用地,对一个样本 nn(CC 指特征维度数 / 通道数,即参与归一化的维度数):

      μn=1C∑chn,c,σn2=1C∑c(hn,c−μn)2\mu_n =\frac {1}{C} \sum_c h_{n,c},\quad \sigma_n^2 =\frac {1}{C} \sum_c (h_{n,c} - \mu_n)^2
  • 统计只在单个样本内部,与 batch size 无关,因此训练 / 推理行为完全一致,非常适合序列建模

  • 与 Transformer 的天然契合:

    • 每个 token 是一个完整语义单位,不同 token 之间不应混合统计,独立归一化

    • 与自注意力的并行结构一致

  • 在自然语言处理中,层归一化发生在每个词的嵌入维度上

    • 对于包含 2 个序列、3 个词和维度为 5 的嵌入向量的输入张量:

      X=[[x1,1,1x1,1,2x1,1,3x1,1,4x1,1,5x1,2,1x1,2,2x1,2,3x1,2,4x1,2,5x1,3,1x1,3,2x1,3,3x1,3,4x1,3,5][x2,1,1x2,1,2x2,1,3x2,1,4x2,1,5x2,2,1x2,2,2x2,2,3x2,2,4x2,2,5x2,3,1x2,3,2x2,3,3x2,3,4x2,3,5]]X = \begin {bmatrix} \begin {bmatrix} x_{1,1,1} & x_{1,1,2} & x_{1,1,3} & x_{1,1,4} & x_{1,1,5} \\ x_{1,2,1} & x_{1,2,2} & x_{1,2,3} & x_{1,2,4} & x_{1,2,5} \\ x_{1,3,1} & x_{1,3,2} & x_{1,3,3} & x_{1,3,4} & x_{1,3,5} \end {bmatrix} \\ \begin {bmatrix} x_{2,1,1} & x_{2,1,2} & x_{2,1,3} & x_{2,1,4} & x_{2,1,5} \\ x_{2,2,1} & x_{2,2,2} & x_{2,2,3} & x_{2,2,4} & x_{2,2,5} \\ x_{2,3,1} & x_{2,3,2} & x_{2,3,3} & x_{2,3,4} & x_{2,3,5} \end {bmatrix} \end {bmatrix}
    • 参与归一化的维度数为 1(嵌入向量的维度),即

      μn=15∑d=15xn,t,d,σn2=15∑d=15(xn,t,d−μn)2\mu_{n} = \frac {1}{5} \sum_{d=1}^{5} x_{n,t,d}, \quad \sigma_n^2 = \frac {1}{5} \sum_{d=1}^{5} (x_{n,t,d} - \mu_n)^2
    • 例如对于张量

      tensor([[[49., 90., 29., 76., 33.],
               [86., 42., 20., 56., 79.],
               [40., 49., 72., 16., 85.]],
      
              [[44., 62., 14., 46.,  5.],
               [22., 45.,  8., 47., 78.],
               [96., 17.,  7., 56., 60.]]])
    • 嵌入后得到

      tensor([[[-0.2675,  1.4464, -1.1036,  0.8611, -0.9364],
               [ 1.2167, -0.6042, -1.5147, -0.0248,  0.9270],
               [-0.5116, -0.1403,  0.8087, -1.5018,  1.3450]],
      
              [[ 0.4601,  1.3051, -0.9483,  0.5539, -1.3708],
               [-0.7518,  0.2088, -1.3366,  0.2924,  1.5872],
               [ 1.5204, -0.9409, -1.2525,  0.2742,  0.3988]]],
             grad_fn=<NativeLayerNormBackward0>)

Instance / Group Normalization:

  • InstanceNorm(IN):

    • 假设每一张图、每一个通道都应该拥有自己的对比度与亮度标准

    • 对单个样本、单个通道:只在空间维度 (H,W)(H, W)​ 上算统计量

      μn,c=1HW∑h,whn,c,h,w\mu_{n,c} =\frac {1}{H W} \sum_{h,w} h_{n,c,h,w}
    • 常用于风格迁移、生成模型

    • 风格 ≈ 均值 / 方差,内容 ≈ 相对空间结构,而 IN 主动抹掉风格统计

  • GroupNorm(GN):

    • BN 太依赖 batch,LN 又完全忽略通道结构,那么在通道维度上进行折中

    • 把通道 CC 分成 GG 组,每一组内部算均值和方差

      μn,g=1∣g∣⋅H⋅W∑c∈g,h,whn,c,h,w\mu_{n,g} = \frac {1}{|g| \cdot H \cdot W} \sum_{c \in g, h, w} h_{n,c,h,w}
    • 也是只在 “单个样本内部” 做统计,与 batch size 无关,保留部分通道结构,在小 batch CNN 中非常稳定

这篇文档有帮助吗?

On this page

页面信息