题面
编写一个高效的算法来搜索 m x n 矩阵 matrix 中的一个目标值 target 。该矩阵具有以下特性:
- 每行的元素从左到右升序排列。
- 每列的元素从上到下升序排列。
示例 1:
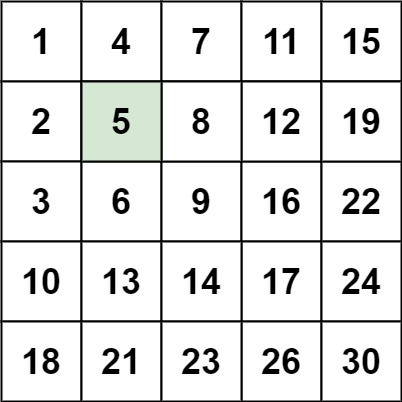
输入: matrix = [[1,4,7,11,15],[2,5,8,12,19],[3,6,9,16,22],[10,13,14,17,24],[18,21,23,26,30]], target = 5 输出: true
示例 2:
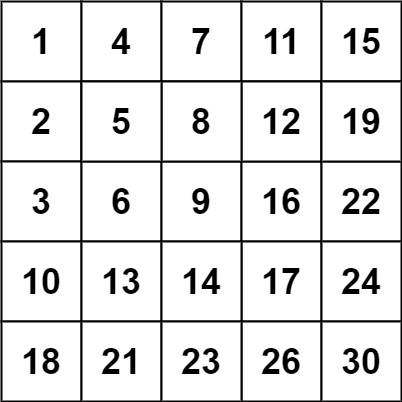
输入: matrix = [[1,4,7,11,15],[2,5,8,12,19],[3,6,9,16,22],[10,13,14,17,24],[18,21,23,26,30]], target = 20 输出: false
提示:
m == matrix.lengthn == matrix[i].length1 <= n, m <= 300-109 <= matrix[i][j] <= 109- 每行的所有元素从左到右升序排列
- 每列的所有元素从上到下升序排列
-109 <= target <= 109
分析
-
元素从左到右升序,从上到下升序
-
分治思想
bool searchMatrix(vector<vector<int>>& matrix, int target) { if (matrix.empty() || matrix[0].empty()) return false; return dfs(matrix, target, 0, 0, matrix.size()-1, matrix[0].size()-1); } // 分治:矩阵拆分为4个子矩阵,优先排除不可能的子矩阵 bool dfs(vector<vector<int>>& matrix, int target, int x1, int y1, int x2, int y2) { // 终止条件:子矩阵无效 if (x1 > x2 || y1 > y2) return false; // 子矩阵只有1个元素 if (x1 == x2 && y1 == y2) return matrix[x1][y1] == target; // 1. 分:取矩阵中心,拆分为4个子矩阵 int mid_x = x1 + (x2 - x1)/2; int mid_y = y1 + (y2 - y1)/2; int mid_val = matrix[mid_x][mid_y]; // 2. 治:优先判断中心值,排除不可能的子矩阵 if (mid_val == target) return true; else if (mid_val > target) { // 目标比中心小 → 排除右下子矩阵,递归查另外3个 return dfs(matrix, target, x1, y1, mid_x-1, y2) || dfs(matrix, target, mid_x, y1, x2, mid_y-1); } else { // 目标比中心大 → 排除左上子矩阵,递归查另外3个 return dfs(matrix, target, x1, mid_y+1, x2, y2) || dfs(matrix, target, mid_x+1, y1, x2, mid_y); } } -
利用 matrix 行列有序的性质,可以用 O(1) 的时间获取 O(m) 或 O(n) 的信息。相比之下,O(mn) 的暴力查找(一个一个地找),每次花费 O(1) 的时间,只获取了 O(1) 的信息
-
代码实现
class Solution {
public:
    bool searchMatrix(vector<vector<int>>& matrix, int target) {
        int m = matrix.size(), n = matrix[0].size();
        int i = 0, j = n - 1; // 从右上角开始
        while (i < m && j >= 0) { // 还有剩余元素
            if (matrix[i][j] == target) {
                return true; // 找到 target
            }
            if (matrix[i][j] < target) {
                i++; // 这一行剩余元素全部小于 target,排除
            } else {
                j--; // 这一列剩余元素全部大于 target,排除
            }
        }
        return false;
    }
};
这篇文档有帮助吗?