Word2Vec
介绍 Word2Vec 的基本概念、模型结构、训练方法及应用等内容
基本概念
-
词向量(Word Vector):对于词典 中任意词 ,指定一个长度为 的实值向量 ,该向量即为单词 的词向量,用于编码其语义和使用模式
-
词嵌入(Word Embedding):将不可计算、非结构化的词转化为可计算、结构化的向量,将现实问题转化为数学问题
-
早期词向量采用 One-Hot 编码,其特点包括:
-
维度过高:向量维度等于词表大小,常为百万级。
-
稀疏且无语义:不同词向量相互正交,无法反映语义距离。
-
为突破上述限制,分布式表示(Distributed Representation)提出以低维稠密向量替代高维稀疏编码,并通过训练使向量捕捉词语的语义与上下文关系
N-Gram 模型
-
N-Gram 模型是 Word2Vec 的理论基础之一,通过使用前 个单词预测下一个单词来估计句子概率
-
N-Gram 是由连续 个词语或字符组成的序列
-
利用链式法则与马尔可夫假设,可将句子概率近似为:
-
马尔科夫假设:假设一个单词的概率仅取决于其前 个单词,而非完整句子
-
常见的 N-Gram 模型
- Unigram (1-gram):假设每个单词的概率与上下文无关,即
- Bigram (2-gram):假设每个单词的概率仅取决于前一个单词,即
- Trigram (3-gram):假设每个单词的概率取决于前两个单词,即
Word2Vec 的原理

-
Word2Vec 是 Google 于 2013 年提出的词向量学习工具,其核心目标是将离散的单词映射到连续向量空间,从而以数学方式度量词语之间的语义关联。通过向量化表示,模型能够在低维空间中捕捉语义关系并降低计算复杂度
-
Word2Vec 是一个单隐层神经网络,用于学习词向量,其训练任务包括:
-
CBOW(Continuous Bag-of-Words):根据上下文预测中心词
-
Skip-Gram:根据中心词预测上下文
-
其中,CBOW 在小语料中效果较好,而 Skip-Gram 更适用于大规模语料
-
-
模型架构
-
输入:One-Hot 编码词向量
-
隐层:维度 N(可自定义,即词向量维度)
-
输出:词表大小为 的概率分布(Softmax)
-
训练完成后:
-
-
假如有一个句子 “
There is an apple on the table” 作为训练数据,CBOW 的输入为(is,an,on,the),输出为 apple。而 Skip-gram 的输入为 apple,输出为(is,an,on,the)。
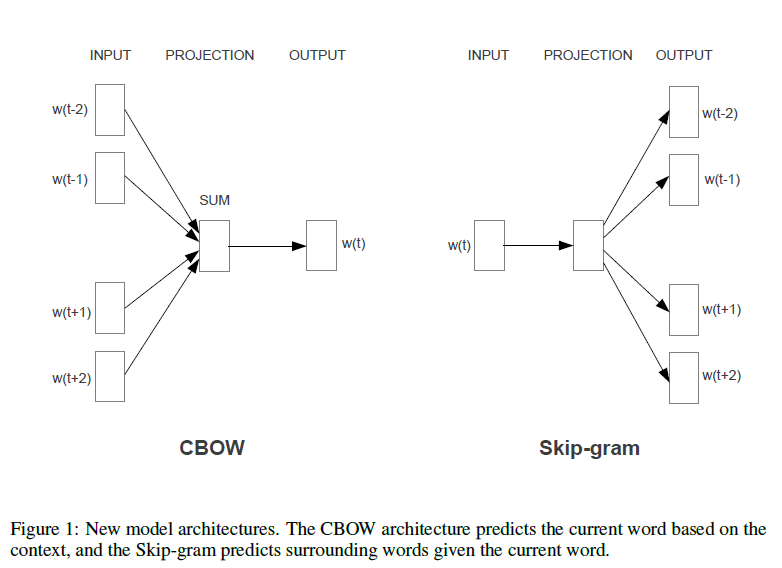
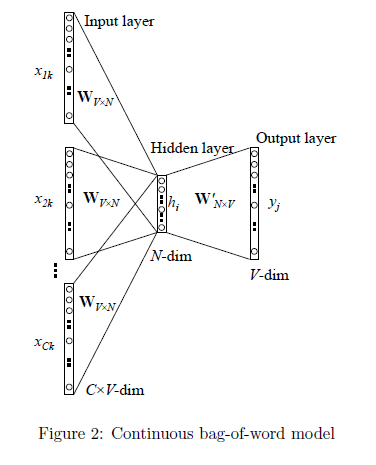
CBOW (Continuous Bag-of-Words)
-
具体流程
- 输入层:使用上下文单词的 One-Hot 编码表示,词汇表大小为 ,上下文窗口大小为 。以句子
There is an apple on the table为例,若 ,则输入为单词(is, an, on, the)的 One-Hot 向量 - 嵌入层:初始化权重矩阵 ,将每个输入 One-Hot 向量左乘 得到 维嵌入向量 ,其中 为嵌入维度,可根据任务需求设定。
- 隐藏层:对上下文向量求平均,得到隐藏层向量
- 输出层:初始化权重矩阵 ,计算输出向量 其中 表示词汇表中每个单词的预测概率分布, 是输出权重矩阵(N × V,V 是词表大小),而词表非常大(V ≥ 1M),每次训练样本都需要计算完整 softmax 和梯度 → 计算量巨大!
- 预测与训练:取 中概率最大的元素对应的单词作为预测目标词,与真实词的 One-Hot 向量计算误差,通过反向传播更新 和
- 输入层:使用上下文单词的 One-Hot 编码表示,词汇表大小为 ,上下文窗口大小为 。以句子
-
训练完成后,输入层每个单词与矩阵 相乘得到的向量即对应的词向量(word embedding)
-
由于 One-Hot 编码中只有一个元素为 ,其余为 ,第 个单词与 相乘结果就是矩阵 的第 行
-
因此, 也称为 lookup table,在拥有 lookup table 后,可以直接通过查表获取单词的词向量,无需再次训练
Skip-gram
-
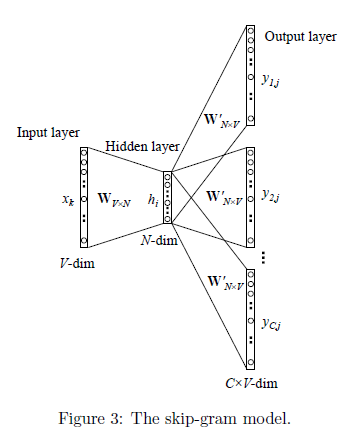
与 CBOW 不同,Skip-Gram 模型是给定输入词(input word)预测其上下文词,结构如上图所示
-
Skip-Gram 的核心思想是:将目标词的上下文词作为输出,而目标词本身作为输入,即给定一个词,预测可能出现的上下文词。通过在大规模语料库上训练,得到从输入层到隐藏层的权重矩阵,作为词向量表示。例如,“apple” 的上下文词为 (
there,is,an,on,the,table),则以 “apple” 的 One-Hot 向量作为输入,输出为上下文词的 One-Hot 向量。训练完成后,与 CBOW 模型类似,输入到隐藏层的权重矩阵即为每个词的向量表示 -
具体流程
-
选取输入词:从句子
There is an apple on the table中选取中间词作为输入,例如apple -
定义上下文窗口:设定参数
skip_window,表示从输入词左右各选取的上下文词数。例如skip_window=2,则包含输入词左右各 2 个词,窗口为 ['is', 'an', 'apple', 'on', 'the'],窗口总跨度span=2×2=4。另设num_skips表示每个输入词生成的输出词数量,例如num_skips=2,则生成训练样本对:(apple,an) 和 (apple,on) -
概率分布学习:神经网络基于训练样本统计输入词与输出词同时出现的概率,输出对整个词典的概率分布。例如输入单词 “中国”,模型输出中 “英国”、“俄罗斯” 等相关词概率高,而 “苹果”、“蝈蝈” 等非相关词概率低。
-
参数更新:通过梯度下降和反向传播更新输入层到隐藏层的权重矩阵
-
词向量表示: 的行向量即为每个词的 Word Embedding 表示
-
-
然而,直接计算完整 softmax 的训练开销非常大,实际应用中效率较低
-
为提升训练效率,提出了两种改进方法:Hierarchical Softmax 和 Negative Sampling
Hierarchical Softmax
-
Hierarchical Softmax 对原模型的改进主要包括两方面:
-
输入层到隐藏层的映射:不再使用原先将输入词向量与矩阵 相乘再求平均的方法,而是直接对输入词向量求和。例如,若输入词向量为 和 ,则隐藏层向量为
-
输出层优化:使用 哈夫曼树 替代原始 softmax。哈夫曼树的叶节点对应词汇表中的单词,从根节点到叶节点的路径表示单词概率,从而将输出复杂度从 降低到
-
-
具体实现上,除根节点外,每个非叶节点包含一个由参数 确定的 sigmoid 函数,不同节点的 值不同
-
训练时,隐藏层向量与节点的 sigmoid 函数运算,根据输出结果选择分类方向:分类为负类沿左子树传递(编码 0),分类为正类沿右子树传递(编码 1),直到到达叶节点获得目标单词的概率
Negative Sampling
-
基本思想
- 尽管哈夫曼树能够在一定程度上降低模型训练开销,但对于一些不常见或生僻词汇,计算其词向量仍需要大量运算
- 而负采样是一种提高 Word2Vec 训练效率的策略,其核心思想是:在之前的神经网络训练过程中,每个样本都会更新网络中所有权重以提升预测精度。实际上,不必更新所有输出词的权重,只更新正样本 + 少量随机负样本
- 直观上理解,教模型 “谁是邻居(上下文)”,顺便告诉它 “其他随机词不是邻居”
-
从数学角度而言,Skip-gram 的目标函数原本是 softmax:
-
:输入(中心词)
-
:输出(上下文词)
-
:词向量
-
-
以上公式的计算量大,因为分母是 V 项求和
-
而 Negative Sampling 将 softmax 转换为二分类:
-
正样本 :中心词与上下文词对,应该让网络输出概率高,即希望模型预测为 1
-
负样本 :从词表随机抽取的词,不在上下文中,应该让网络输出概率低,即希望模型预测为 0
-
-
目标函数变为:
-
-
= 负样本数量(一般 5~20)
-
= 抽负样本的概率分布(通常根据词频调整)
-
-
举例
-
例如,对于句子:
There is an apple on the table-
中心词:
apple -
上下文词:
is, an, on, the
-
-
训练时,只更新这几个输出的权重,不更新全词表:
- 正样本: (
apple,is) - 负样本:随机抽取 5 个词,例如 (
apple,dog), (apple,car), …
- 正样本: (
-