循环神经网络
介绍循环神经网络的基本概念,包括RNN的结构、训练方法、长短期记忆网络(LSTM)及门控循环单元(GRU)等内容
基本概念
- FNN、CNN 处理序列数据的局限性
- 只适合:图片分类、识别等任务
- 不适合:连续数据处理,与时间有关数据(序列依赖关系)
- 比如语音、文本、视频、金融数据(股票波动)
- 整个数据由若干同类型单元组成,称为 “帧”,如音素、字词、每帧图像
- 帧与帧之间存在相互依赖关系,不再满足独立性假设, 需要考虑数据前后位置关系
- 无法处理变长度数据
- 全部或者部分丧失数据之间前后依赖性
- 单次处理数据长度不能过长,容易引起参数爆炸
循环神经网络(Recurrent Neural Network, RNN)
- 给定输入序列 ,RNN 的计算过程为:
-
输入层:序列中的每个时间步 ,输入
-
隐藏层:每个时间步的隐藏状态 根据当前输入 和前一时间步的隐藏状态 计算:
- :输入到隐藏层的权重矩阵
- :隐藏层到隐藏层的权重矩阵(时间共享)
- :隐藏层的偏置。
- :激活函数(如 tanh 或 ReLU)
-
输出层:计算每个时间步的输出 :
- :隐藏层到输出层的权重矩阵
- :输出激活函数(如 softmax 或 sigmoid)
-
双向循环神经网络
-
基本思想
- 普通 RNN 只能利用序列的过去信息(即从 到 的顺序)
- BiRNN 在同一时间步 同时考虑:
- 前向 RNN:从 到 的正向传播
- 后向 RNN:从 到 的反向传播
- 最终输出结合两种方向的信息
-
每个时间步 的隐藏状态为:
- :前向隐藏状态
- :后向隐藏状态
- 输出 结合了前向和后向隐藏状态的信息
-
给定输入序列
-
前向 RNN:
-
后向 RNN:
-
输出层:每个时间步的输出
-
-
基本循环神经网络和双向神经网络:只有单个隐藏层,不能很好学习数据内部关系
-
Deep(Bidirectional)RNN:叠加多个隐藏层,即在每个时刻会有多个隐藏层,有更强学习能力,但需要更多训练数据
-
循环神经网络训练算法 —— 基于时间的反向传播 BPTT(Back-Propagation Through Time)
-
优化问题
- RNN 循环神经网络在时间维度上非常深,导致在训练中很容易发生梯度爆炸和梯度消失问题
- 训练时梯度不能在较长序列中一直传递下去,从而使 RNN 无法捕捉到长距离的影响
-
正则化方法(Dropout)
RNN 的架构类型
| 架构类型 | 输入形态 | 输出形态 | 应用场景 | 特点 |
|---|---|---|---|---|
| 一对一 | 单一输入 | 单一输出 | 图像分类 | 无时间维度,类似传统神经网络 |
| 一对多 | 单一输入 | 序列输出 | 图像描述生成 | 单一输入扩展为序列输出,常结合解码器使用 |
| 多对一 | 序列输入 | 单一输出 | 情感分析、分类 | 将输入序列压缩为单一结果,依赖隐藏状态捕捉序列信息 |
| 多对多 (定长) | 序列输入 | 序列输出 | 视频帧分类、同步时间序列处理 | 输入和输出长度相同,适合逐时间步预测 |
| 多对多 (变长) | 序列输入 | 序列输出 | 机器翻译、对话生成 | Encoder-Decoder/Seq2Seq;编码器提取上下文向量,解码器生成序列输出 |
| 长短期记忆网络 (LSTM) | 序列输入 | 灵活 | 长期时间序列预测 | 通过记忆单元和门机制缓解梯度消失问题 |
| 门控循环单元 (GRU) | 序列输入 | 灵活 | 长距离依赖建模 | 结构更简洁,效率更高,但效果与 LSTM 相近 |
LSTM
-
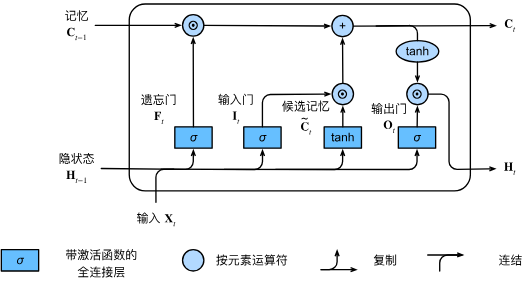
公式:假设当前输入为 ,前一时刻的隐藏状态和记忆单元状态分别为 和
-
遗忘门(Forget Gate):决定当前时刻哪些信息需要从记忆单元中删除
- :表示是否保留记忆单元中信息的比例
-
输入门(Input Gate):决定当前输入信息的重要性,并选择性地将其添加到记忆单元
- :表示当前输入的重要程度
-
候选记忆单元状态:
- :表示当前输入的候选记忆信息
-
更新记忆单元状态(Cell State):用来存储长期的上下文信息
- :结合过去的记忆和当前的输入,更新记忆单元状态
-
输出门(Output Gate):决定从记忆单元中读取哪些信息作为当前的隐藏状态输出
- :表示当前记忆单元中哪些信息用于生成隐藏状态
-
隐藏状态:
- :作为当前时刻的输出信息
-
-
综述所述,LSTM 公式可描述如下
GRU
-
GRU 比 LSTM 网络更简单的循环神经网络
- LSTM 中引入三个门函数控制输入值、记忆值和输出值,参数较多,训练起来比较困难
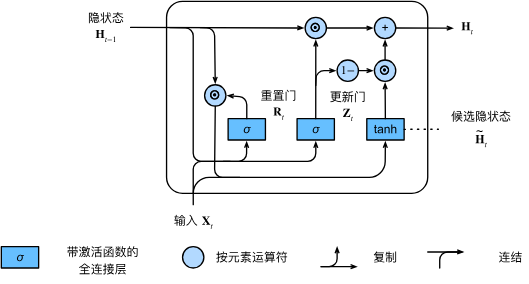
- 遗忘门和输入门合并成更新门,另外多一个重置门
- 不需要计算额外的内部状态 ,在当前状态 和历史状态 之间引入线性依赖关系
-
公式:假设当前时刻的输入为 ,上一时刻的隐藏状态为
-
更新门:控制当前时刻的隐藏状态中有多少信息需要从上一时刻传递,以及有多少新信息需要添加
- :更新门的输出,表示上一时刻的隐藏状态与当前时刻的输入的权重
-
重置门:决定丢弃多少过去的记忆,从而有选择性地 “重置” 上一时刻的隐藏状态
- :重置门的输出,控制当前时刻如何利用上一时刻的隐藏状态
-
候选隐藏状态:将记忆直接集成到隐藏状态 中,结构更为简单
- :基于当前输入和重置后的隐藏状态计算得到的候选隐藏状态
-
隐藏状态更新:
- :结合上一时刻的隐藏状态(通过更新门的权重)和候选隐藏状态,更新当前隐藏状态
-
-
当 且 时,隐状态 退化为简单循环神经网络,即
Seq2Seq 模型
Seq2Seq(Sequence-to-Sequence)
-
输入序列 → 输出序列的模型
-
典型任务:机器翻译、文本摘要、对话生成
-
核心特性:输入和输出长度不必相等
-
公式表示:
- 特点:
-
强调 “序列映射” 关系
-
可以使用 RNN、LSTM、GRU 或 Transformer 实现
- 不一定是端到端的(可以有特征工程或分阶段处理)
-
End-to-End(端到端)
-
模型直接从原始输入到目标输出,不需要人工设计中间步骤
-
核心思想:所有处理通过一个模型学习完成
-
特点:数据驱动,最小人工干预
-
例子:
- 图片 → 描述(Image Captioning)
- 语音 → 文本(ASR)
-
End-to-End 是训练方式或设计理念,而非具体网络结构
Encoder-Decoder(编码器 - 解码器)
-
一种具体模型结构
-
分两步:
- Encoder:把输入序列编码成上下文向量(Context Vector 或一系列 hidden states)
- Decoder:根据上下文生成输出序列
-
公式表示:
-
Encoder:
-
Decoder:
-
特点:
-
Encoder-Decoder 是 Seq2Seq 的典型实现方式
-
可以支持 Attention(增强性能,解决长序列瓶颈)
-