深度学习概述
介绍深度学习的基本概念,包括深度学习的定义、核心思想、优化器、前馈神经网络、反向传播及激活函数等内容
深度学习
-
传统机器学习的步骤
- 原始数据 数据预处理 特征提取 特征转换 预测识别 结果
- 第 2-4 步为特征处理,第 5 步为浅层学习
-
深度学习 = 表示学习 + 浅层学习
- 原始数据 底层特征 中层特征 高层特征 预测识别 结果
-
深度学习的核心思想:通过层次化的表征学习,从数据中自动提取特征
-
尽管深度学习通常使用多层神经网络,但深度学习的范围实际上更广
-
深度学习天然不是神经网络,但神经网络天然是深度学习
-
正则化方法
- L1 正则化
- L2 正则化
-
优化器(Optimizer)
-
核心功能:计算梯度,并基于梯度信息调整模型参数
-
通常,优化器通过梯度下降法来更新参数,即沿着损失函数的梯度方向,调整模型参数,以减少损失值
-
基本步骤
- 计算梯度: 计算损失函数相对于模型参数的梯度
- 更新参数: 根据梯度的方向和大小,调整模型参数,使损失函数逐步减小
- 计算梯度: 计算损失函数相对于模型参数的梯度
-
常见优化器类型
-
梯度下降法(GD, Gradient Descent)
- 批量梯度下降(Batch GD):每次使用所有训练数据来计算梯度并更新参数,计算量大,适用于小型数据集
- 随机梯度下降(SGD, Stochastic GD):每次使用一个样本来计算梯度并更新参数,计算效率高,但容易受噪声影响
- 小批量梯度下降(Mini-batch GD):每次使用一小部分样本来计算梯度并更新参数,是大多数实际应用中最常用的方法,平衡了计算效率和稳定性
- 批量梯度下降(Batch GD):每次使用所有训练数据来计算梯度并更新参数,计算量大,适用于小型数据集
-
动量法(Momentum):在每次更新时加入之前梯度的加权平均,能加速收敛并减少震荡,特别在处理有很多局部最小值的问题时表现较好
-
AdaGrad:自适应地调整每个参数的学习率,适用于稀疏数据(例如文本数据或推荐系统中的数据)
-
RMSprop:结合了动量法和 AdaGrad,适用于非平稳目标函数,通常用于训练深度神经网络
-
Adam(Adaptive Moment Estimation):结合了动量法和 RMSprop 的优点,计算每个参数的自适应学习率,且在训练过程中能够自动调整。Adam 广泛用于深度学习训练中,通常能提供较好的效果
-
前馈神经网络
-
神经网络
- 激活规则:神经元输入到输出之间的映射关系,一般为非线性函数
- 网络结构:不同神经元之间的连接关系
- 学习算法:通过训练数据来学习神经网络的参数
-
M - P 神经元模型
- 神经元接受来自 个其他神经元传递过来的输入信号,这些输入信号通过带权重的连接进行传递,将神经元接收到的总输入值与神经元的阈值进行比较,然后通过 “激活函数”(activation function)处理产生神经元输出
-
学习与优化
-
将样本数据实际输出与神经元输出进行比较,计算模型偏差 / 损失,以自适应线性单元(无激活函数的线性层)为例,假设有 个样本
-
梯度下降
-
-
沿着损失函数的曲线下降,直到达到局部或全局的最小值点
-
-
-
前馈神经网络(Forward Nerual Network)
- 各神经元分别属于不同的层
- 整个网络中无反馈,信号从输入层向输出层单向传播,可用一个有向无环图表示
- 同一层神经元之间没有连接;前后两层所有神经元相连(即 full connected),前层神经元输出就是后层神经元输入;每一个连接都有一个权重
-
通用近似原理:对于具有线性输出层和至少一个使用 “挤压” 性质的激活函数的隐藏层组成的前馈神经网络,只要其隐藏层神经元的数量足够,它可以以任意精度来近似任何从一个定义在实数空间中的有界闭集函数
反向传播
-
BP(Back Propagation)神经网络是前馈神经网络,但权重学习过程是 BP 过程
- 第 层共有 个神经元
- 第 层第 个神经元的输入线性加权和为 ,其中
- 第 层第 个神经元的输出为
- 一个三层的 BP 神经网络可以任意精度逼近任意连续函数 (通过学习不断调整边权重)
- 给定 组输入样本 ,如何调整 BP 神经网络的权重,使得输入为 时,输出为
-
BP 学习算法的基本思想
- 基本思想:目标函数为神经网络输出层每个神经元实际输出值 与期望输出值 之差的平方和,其中 是向量 的第 维分量
- 如何不断调整权重:利用 “最快下降法” 使得权值沿着目标函数的负梯度方向改变(这样可以使得目标函数值迅速下降,接近 0)
- 目标函数:
- 约束条件:,
- 连接权重的修正量:
- 梯度:在单变量的函数中,梯度即为导数,也就是曲线上某点的斜率。但是在多维变量的函数中,梯度就是函数对每一维度变量求偏导得出的向量
-
BP 学习算法的步骤
- 正向传播输入信息,产生输出
- 反向传播误差,反向逐层计算偏导,调整网络权值(最快下降法,调整权值使得误差迅速减小)
- 例如:
- 同样把其余所有的权值都进行更新迭代,然后再进行正向传播计算, 并且每次重新计算误差,根据误差再反向传播更新权重。
- 直至达到损失函数的最小值,最后得到的就是具有正确权值的最佳模型
-
优化问题
- 在每一层都要乘以该层的激活函数的导数
- 梯度消失问题
- 激活函数求导过小(求导小于 1)前面的层比后面的层梯度变化更小,故变化更慢,从而引起了梯度消失问题
- 在反向传播中,梯度通过链式法则传递,多个小于 1 的数相乘会使梯度指数级衰减
- 梯度爆炸问题
- 激活函数求导过大(求导大于 1),前面层比后面层梯度变化更快,会引起梯度爆炸问题
- 在反向传播中,梯度通过链式法则传递,多个大于 1 的数相乘会使梯度指数级增大
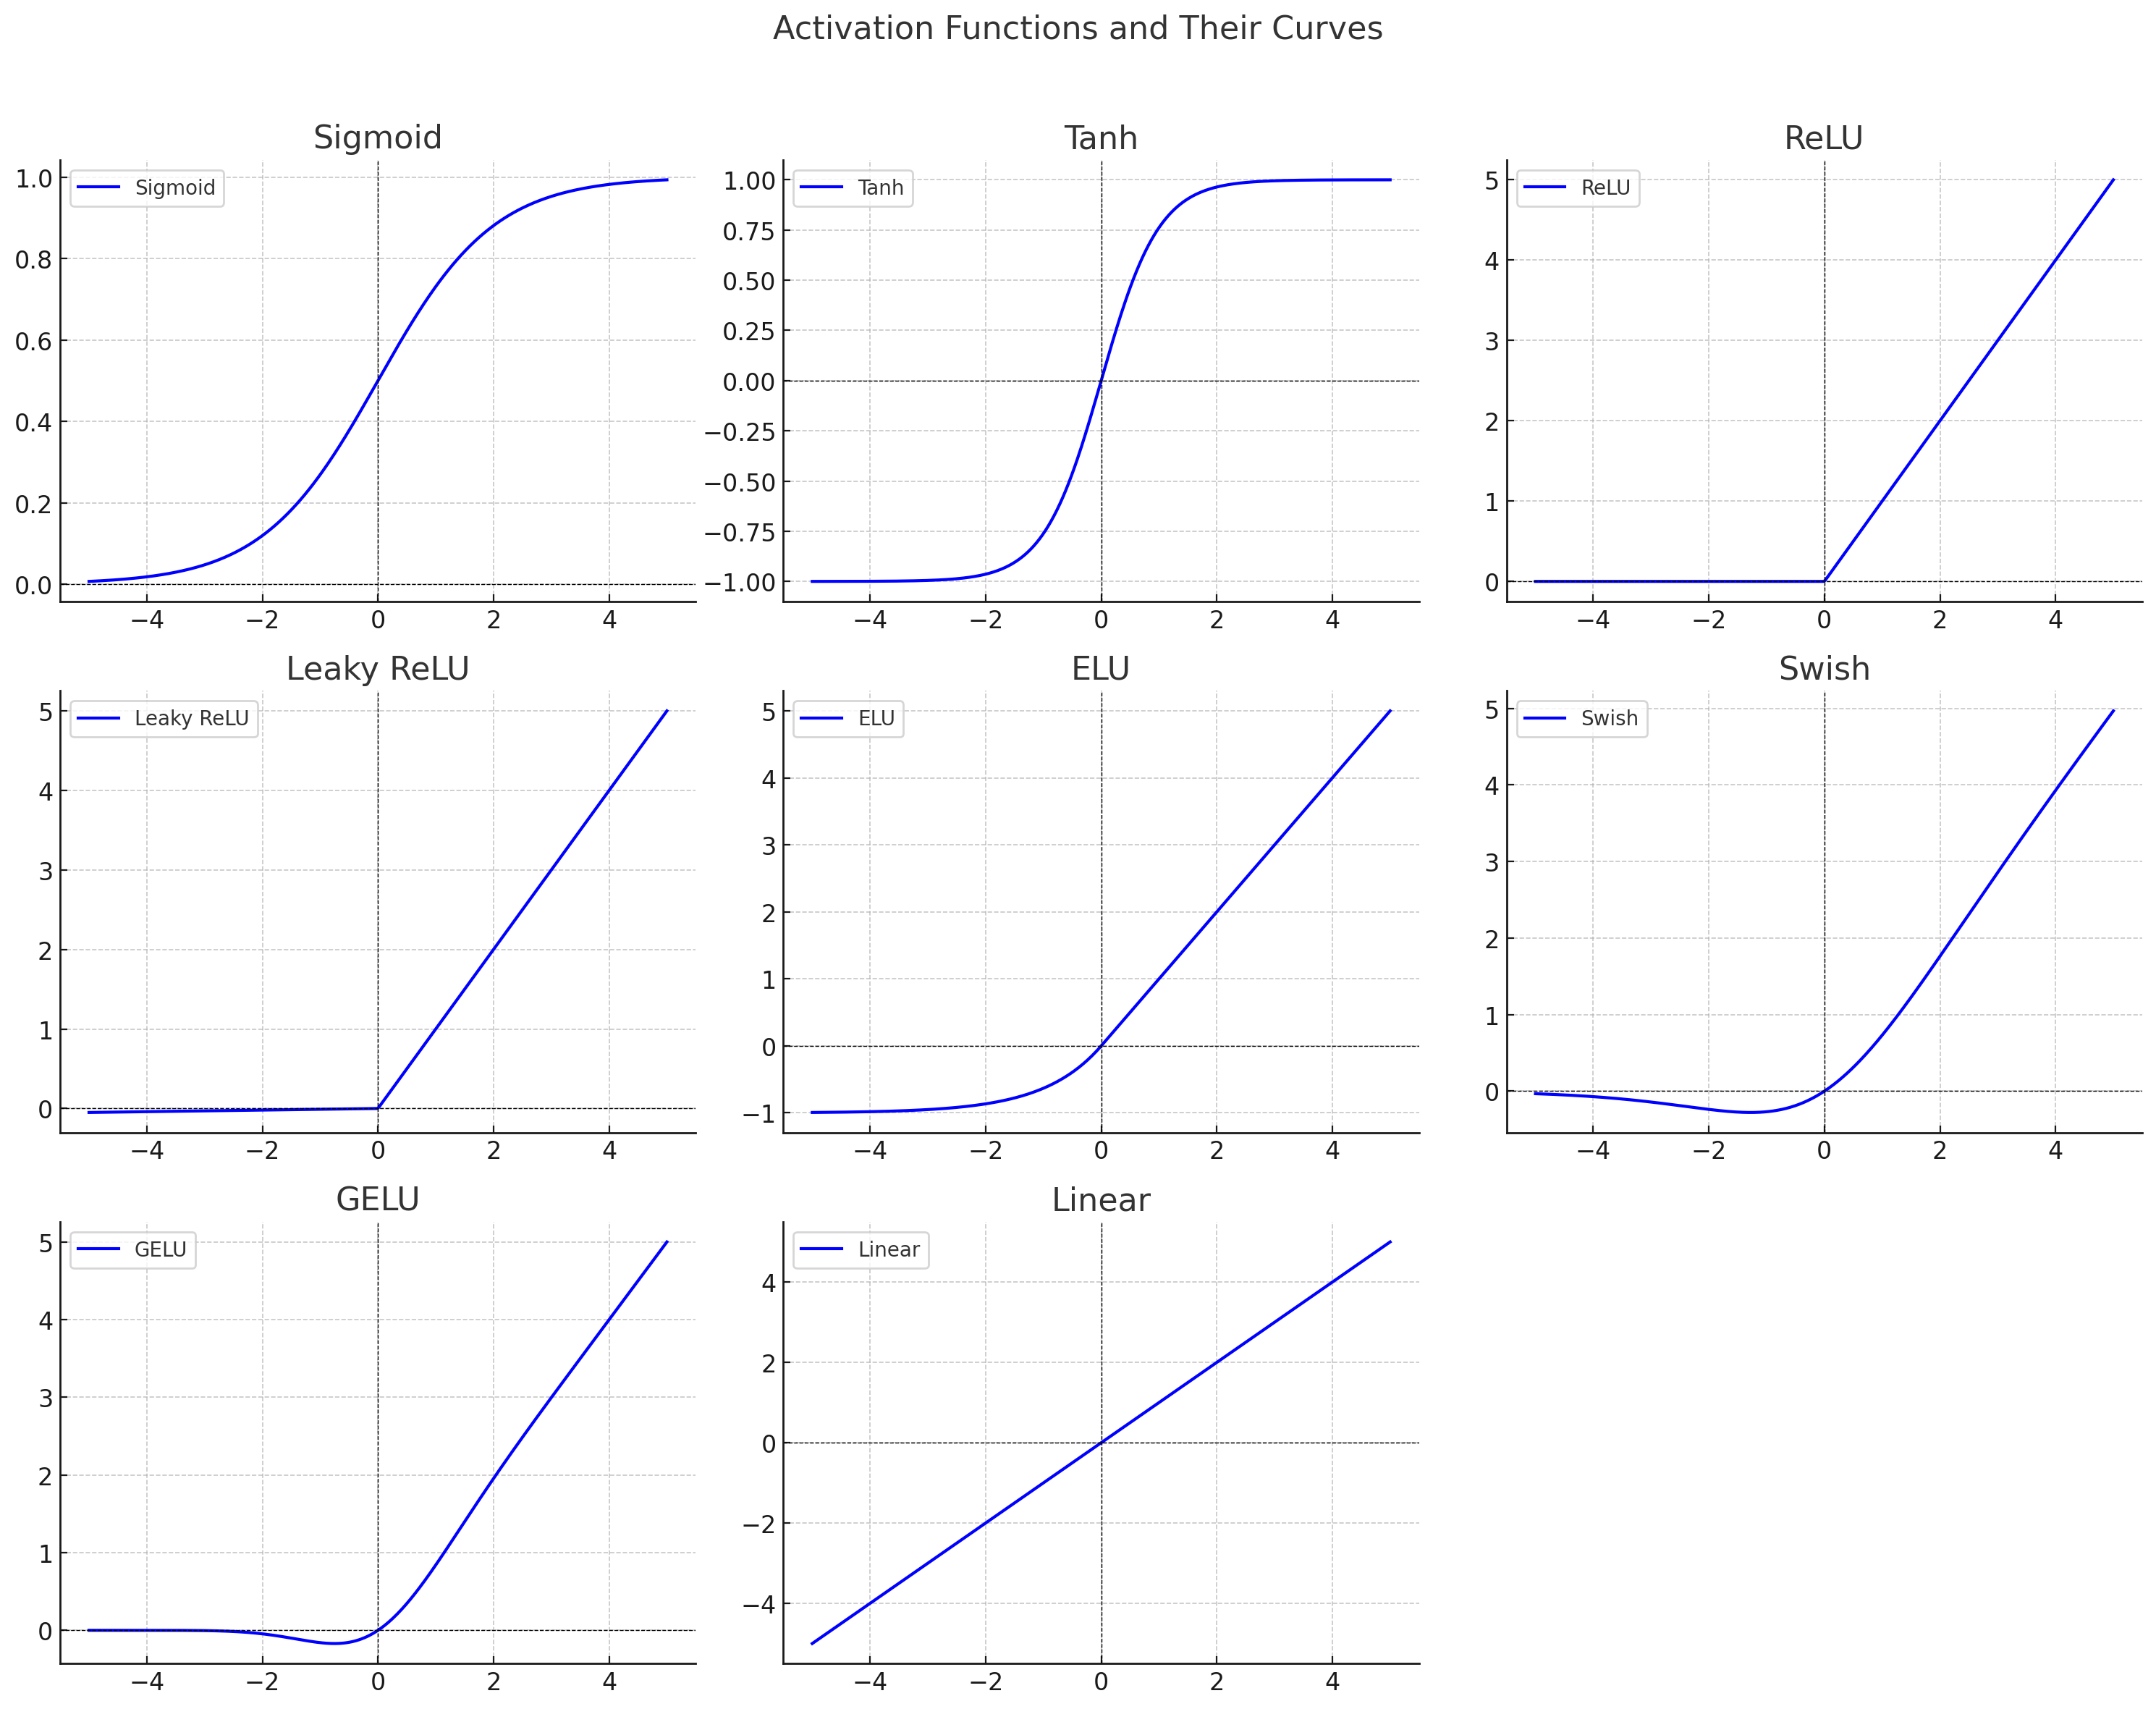
激活函数
| 激活函数 | 数学表达式 | 导数表达式 | 特点 |
|---|---|---|---|
| Sigmoid | 输出范围为 (0, 1),常用于概率预测。容易导致梯度消失问题,特别是在深层网络中。 | ||
| Tanh | 输出范围为 (-1, 1),比 Sigmoid 更常用。仍有梯度消失风险。 | ||
| ReLU | 简单高效,避免梯度消失 / 爆炸问题。导数在 时为 0,可能导致 “死亡神经元”。 | ||
| Leaky ReLU | 解决 ReLU 的 “死亡神经元” 问题, 是一个小的正常数(如 0.01)。 | ||
| ELU | 更平滑,输出范围更接近 0,增强训练稳定性。 | ||
| Softmax | (单一元素导数) (交叉元素导数) | 用于多分类问题,输出为概率分布。 | |
| Swish | 平滑非线性,比 ReLU 表现更好,尤其在深层网络中。 | ||
| GELU | , 其中 是标准正态分布的 CDF | 无明确的闭式解,可近似为 | 平滑近似,性能优于 ReLU 和 Swish,常用于 Transformer。 |
| Linear | 输出未受限,通常用于回归问题或最后一层。 |
-
常见激活函数的曲线图