Quantization
介绍量化技术在 LLM 推理中的应用,包括 GPTQ、GGUF、AWQ、QuIP# 等方法,以及它们的原理和实现细节
- 参考资料
- A Visual Guide to Quantization
- The Complete Guide to LLM Quantization with vLLM: Benchmarks & Best Practices | Jarvislabs.ai Docs
- The Ultimate Handbook for LLM Quantization
- The Ultimate Handbook for LLM Quantization | Towards Data Science
- A Survey of Quantization Methods for Efficient Neural Network Inference
大模型的数值存储
数值表示方式
-
数值常以浮点数 floats 表示,即带有小数点的正数或负数
-
这些值由二进制比特表示,通常包括符号、指数和尾数
-
FP16 的表示
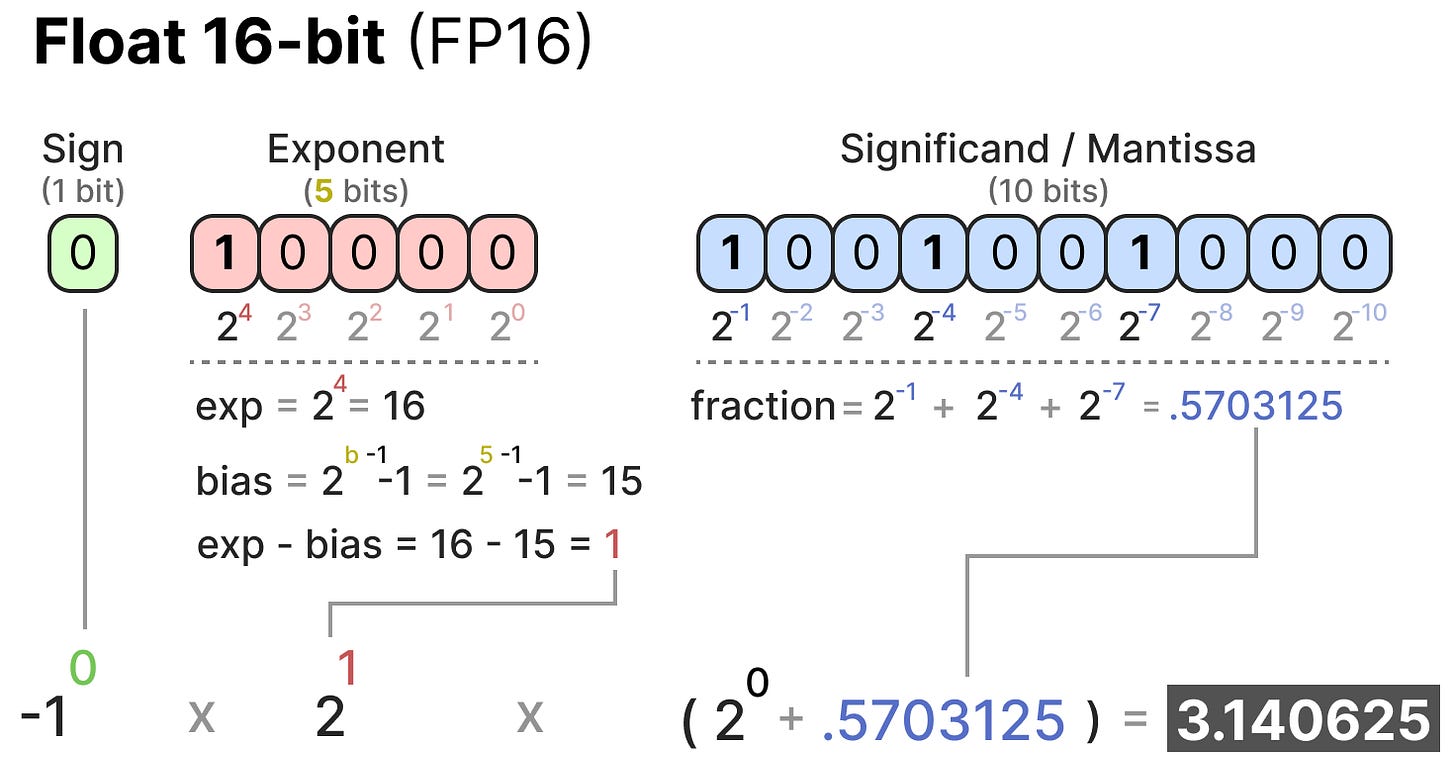
-
FP32 的表示
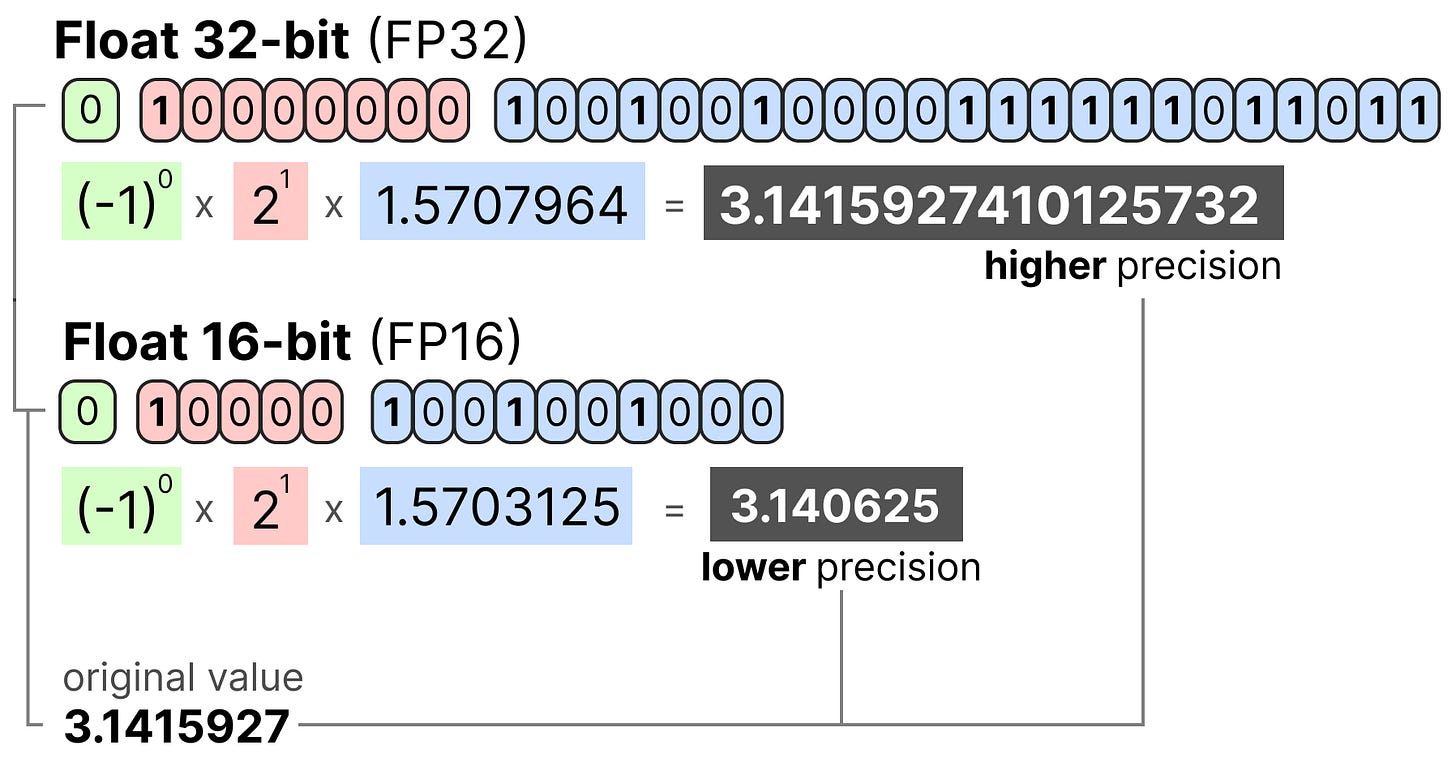
-
用来表示一个数值的比特数越多,它通常就越精确
内存限制
-
可用比特数越多,那么可表示的数值范围越大
-
可表示数字的区间称为 “动态范围”(dynamic range),相邻数值间的距离称为 “精度”(Percision)
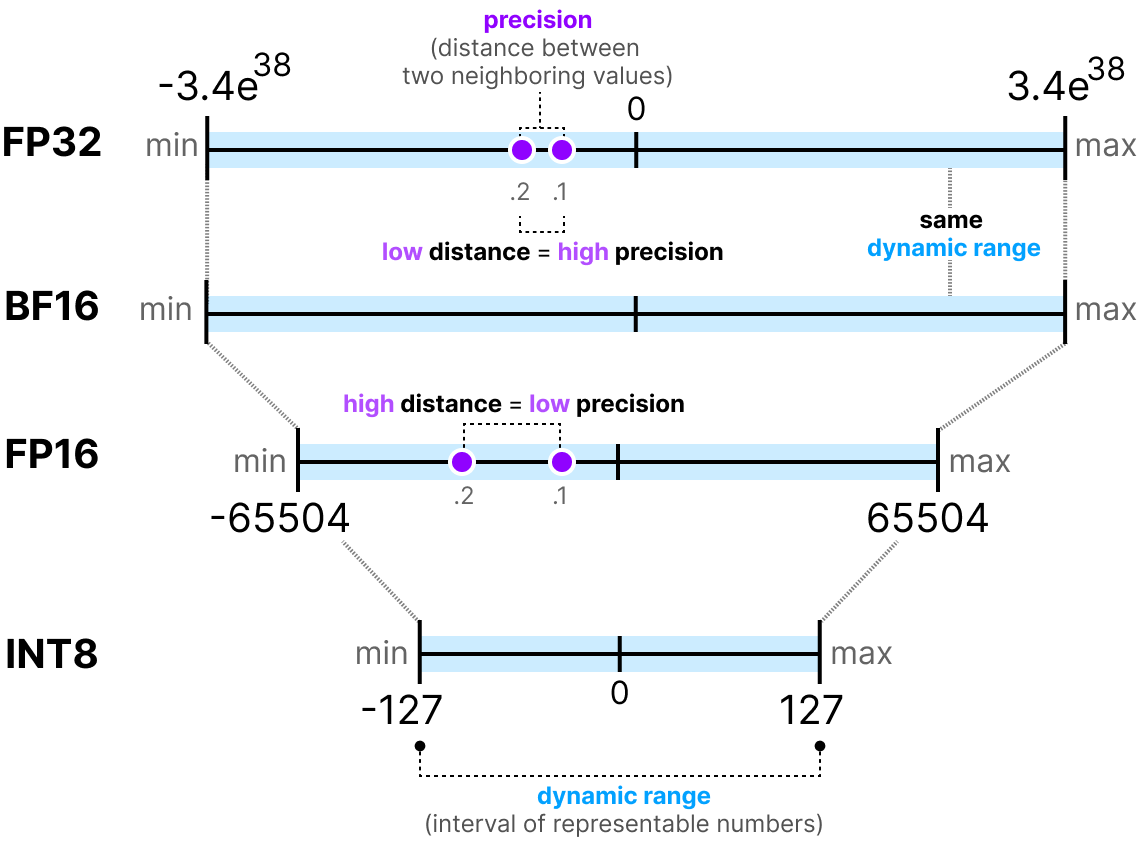
-
由于 1 字节内存包含 8 个比特位,那么所需内存的计算公式如下
-
假设一个 70B(700 亿)参数的模型,加载该模型所需的内存如下:
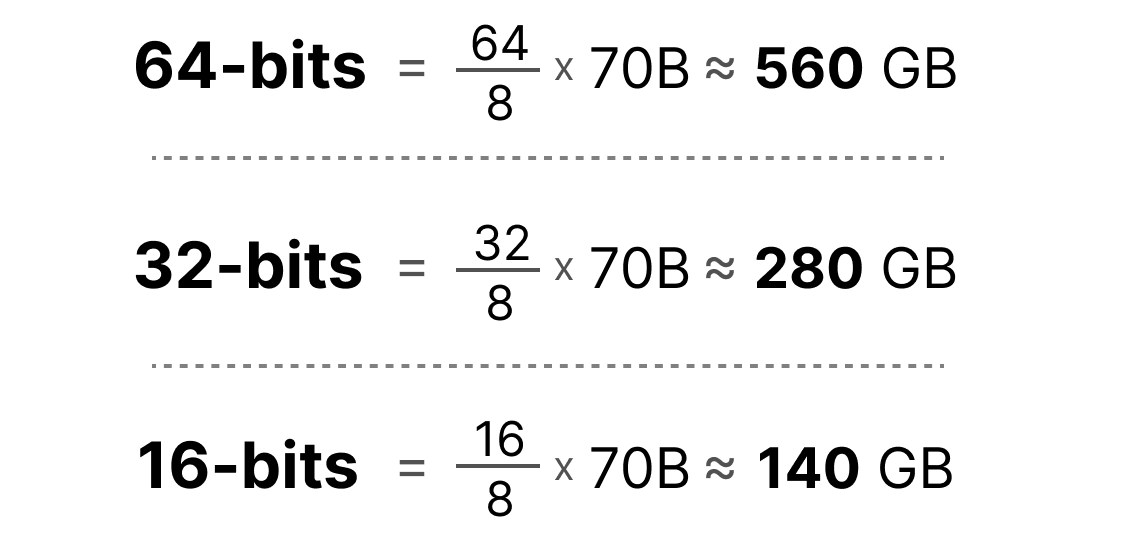
-
一般使用 32 位浮点数(FP32, 全精度,full-percision)来原生加载模型,而 70B 模型就需要 280GB 的显存来加载
-
因此,尽可能地减少表示模型参数(以及训练过程中)所需的位数很有必要,但是精度降低一般会导致模型准确性下降,而量化技术可以在减少比特殊的同时尽量保持模型的准确性
什么是量化
-
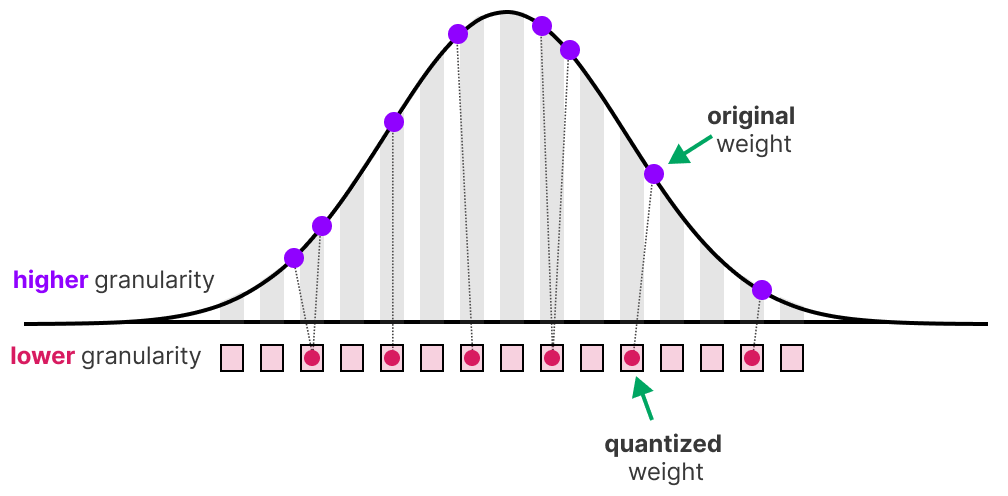
量化(Quantization)旨在将模型参数精度从高位宽(如 32 位浮点数)降至低位宽(如 8 位整数)
-
如图所示,减少比特数时通常会有精度(粒度)损失
-
而量化的主要目标是在尽量保留原参数精度的前提下减少表示所需比特数
常见数值类型
-
FP16 半精度浮点数(half percision)
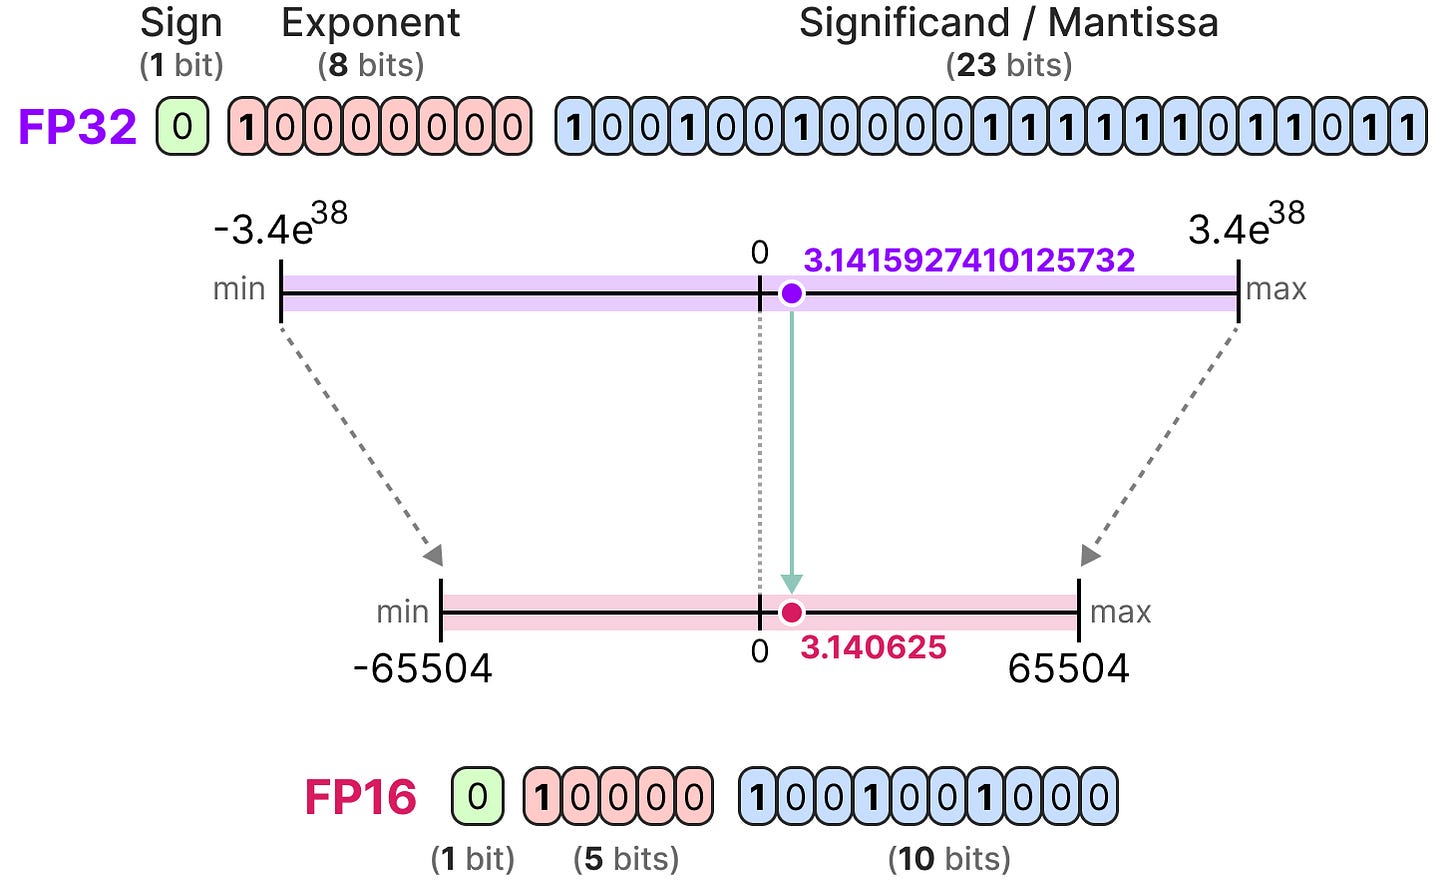
- 可以看到 FP16 所能表示的值的范围要比 FP32 小很多
-
BF16:为了获得与原始 FP32 相似的数值范围,引入了 bfloat 16,即截断的 FP32
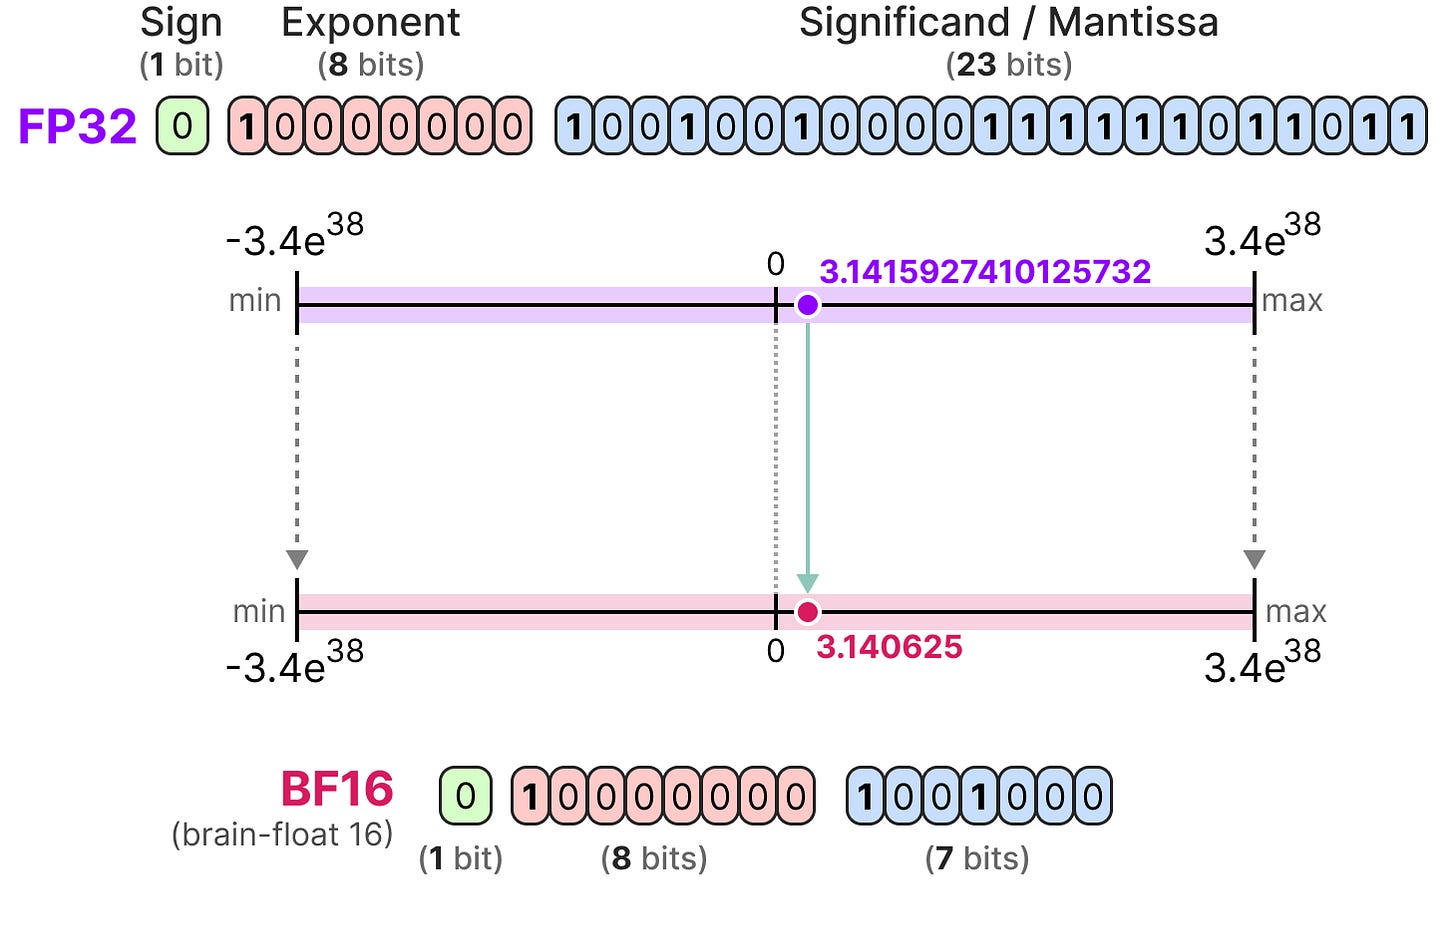
- BF16 与 FP16 所使用的比特数均为 16 位,但能表示更广范围的数值,常用于深度学习应用中
-
当进一步减少位数时,得到基于整数的表示领域,而非浮点表示,如 FP32 转为 INT8 时,其位数仅为原先的四分之一
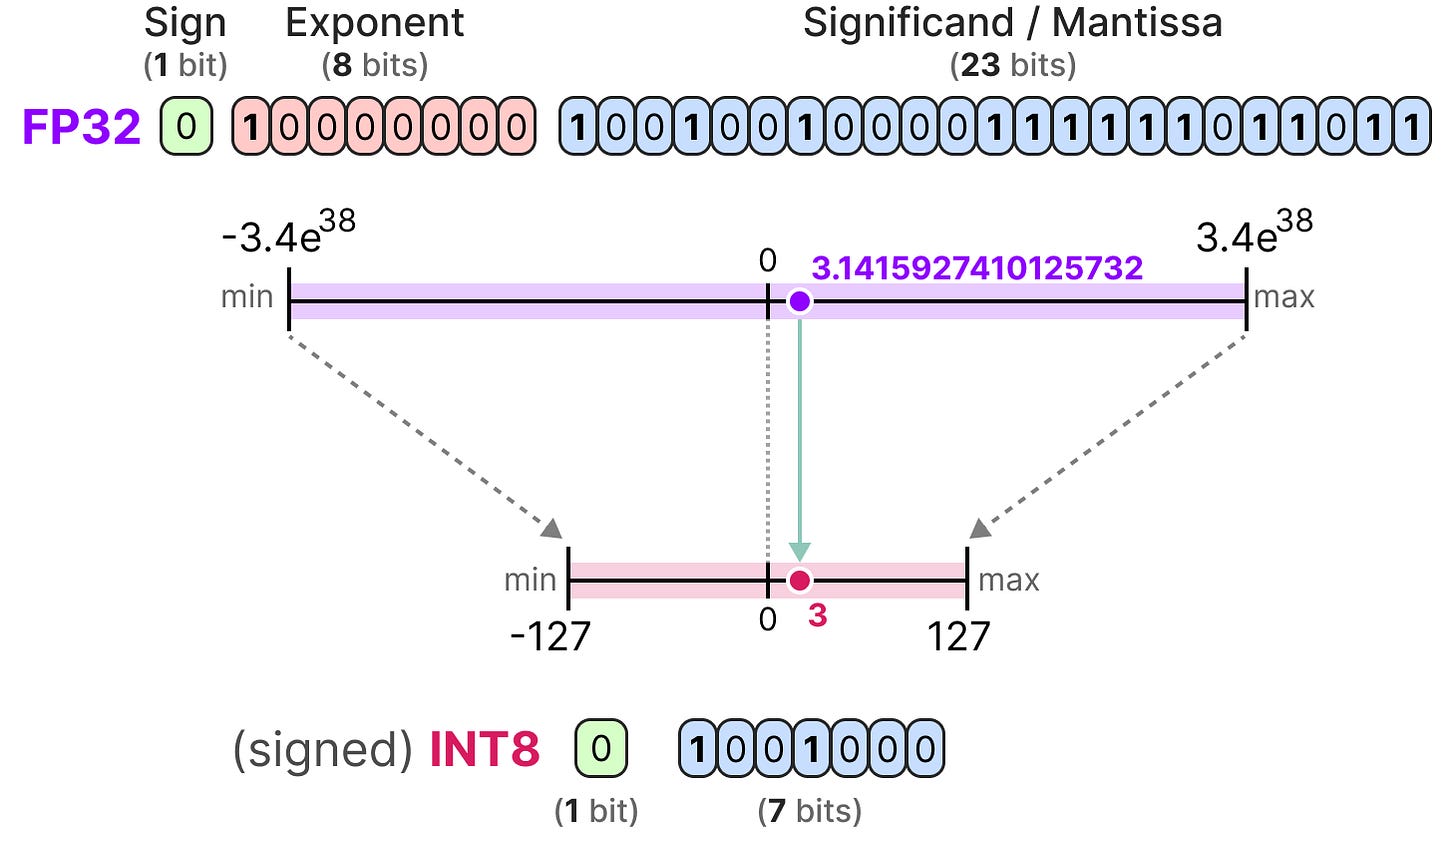
- 根据硬件的不同,基于整数的计算可能会比浮点计算更快
-
每种比特数减少的情况都需通过映射将初始 FP32 表示 “压缩” 到低位宽
-
实际上,无需将 FP32 全范围 [-3.4e38, 3.4e38] 映射到 INT8,只需要找到一种方法,把模型的参数范围映射到 INT8 中
-
常见的压缩 / 映射方法包括对称量化和非对称量化,都属于线性映射的形式
对称量化
-
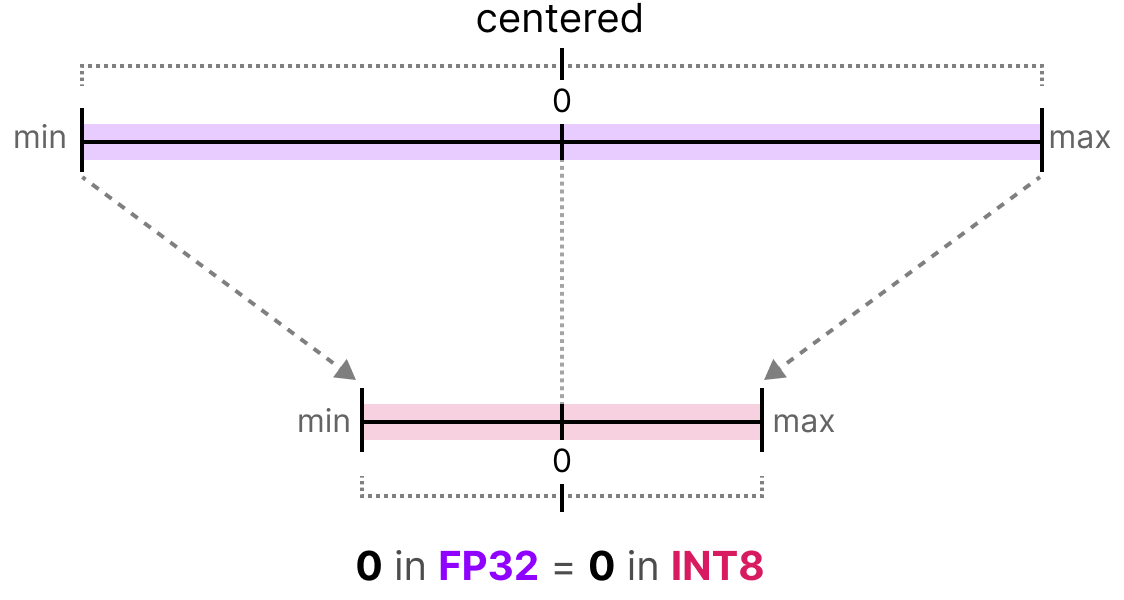
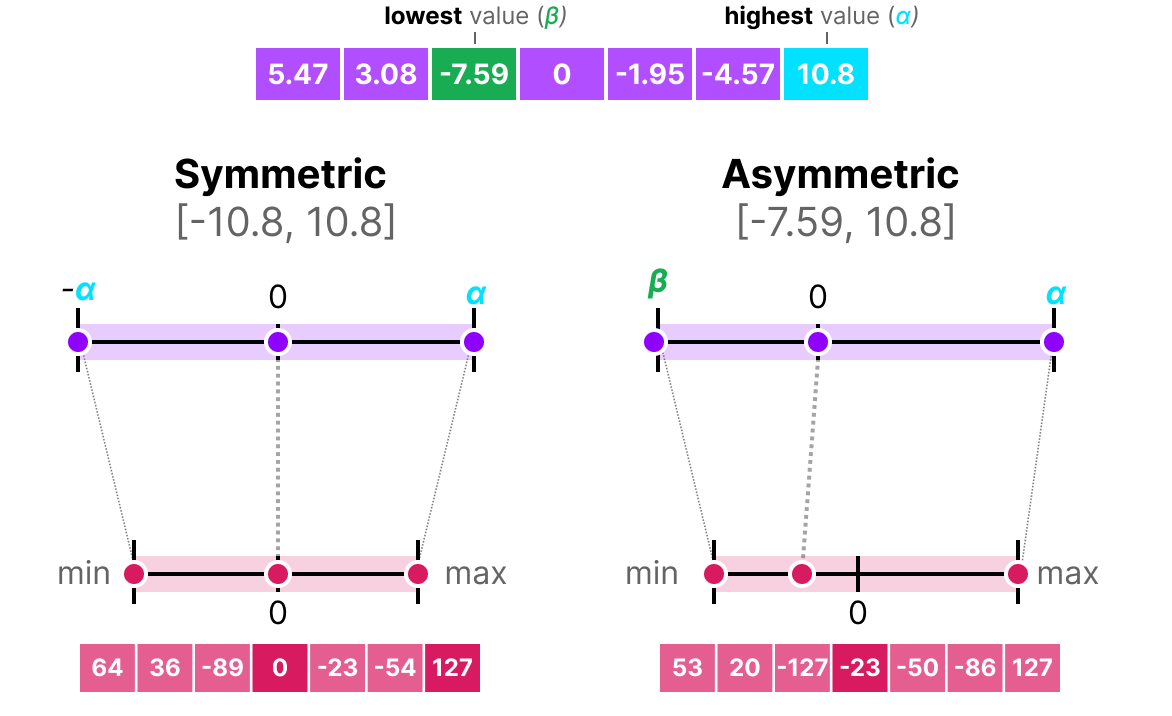
在对称量化(Symmetric Quantization)中,原始浮点数的范围被映射到量化空间中以零为中心的对称范围
-
这意味着浮点空间中零的量化值在量化空间中恰好是零
-
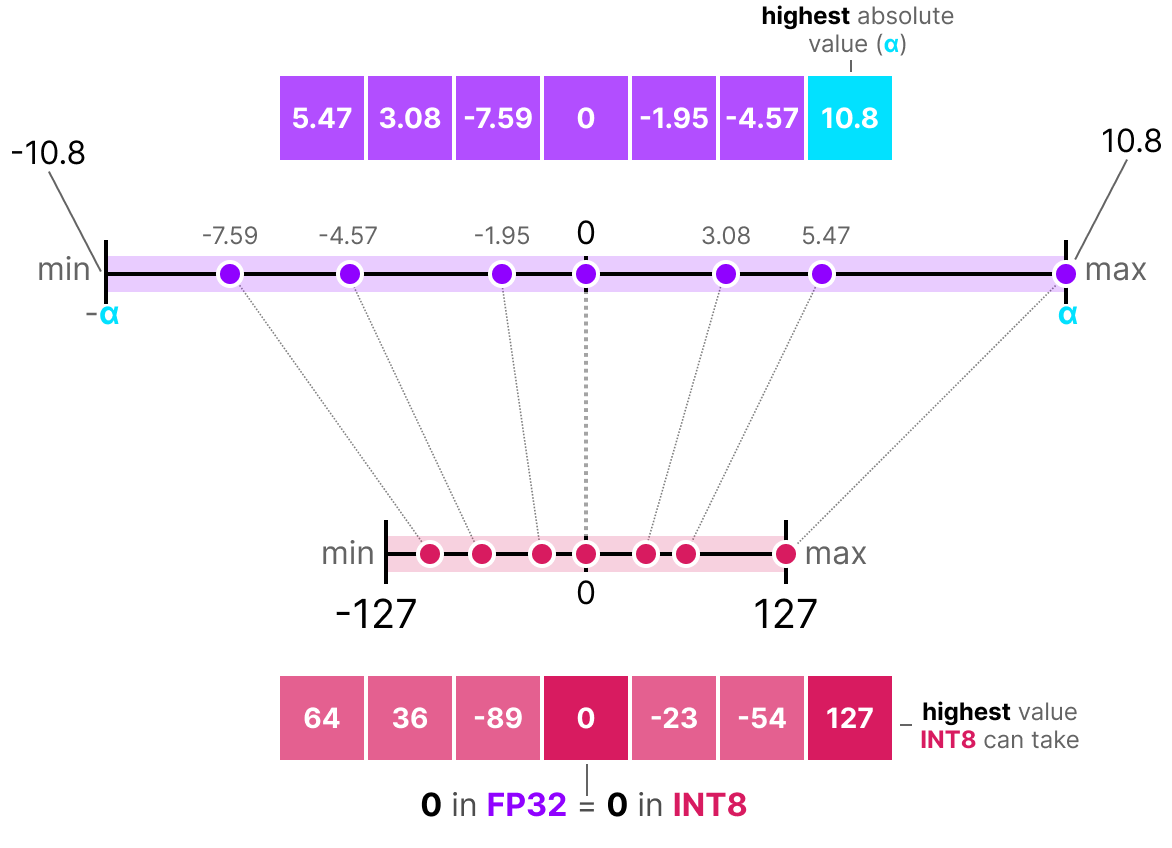
对称量化的一种实现方式是绝对最大值(absmax)量化
-
给定一个数值列表,取最大的绝对值 作为范围来执行线性映射
-
首先计算缩放因子,其中 是需要量化到的比特数
-
然后对输入 进行量化
-
例如,对于以下例子
-
计算得到:,
-
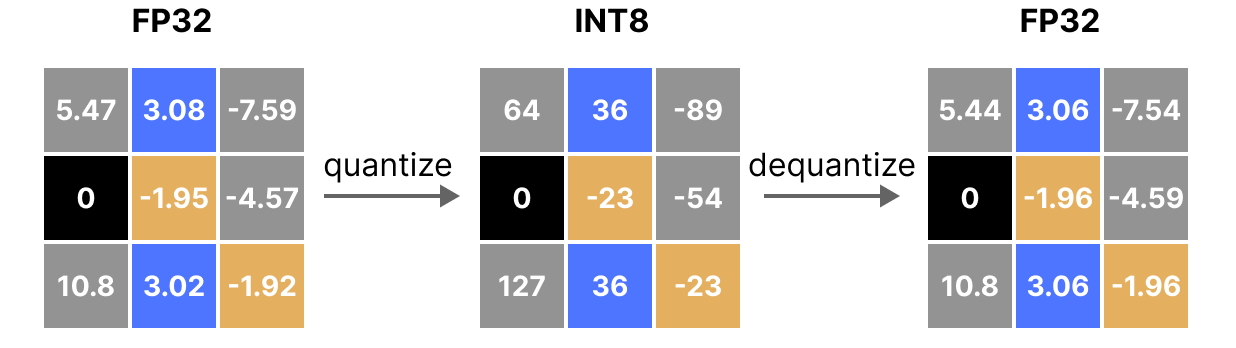
为了恢复原始的 FP32 值,可以使用之前计算的缩放因子进行反量化(dequantize)
-
示例如下
-
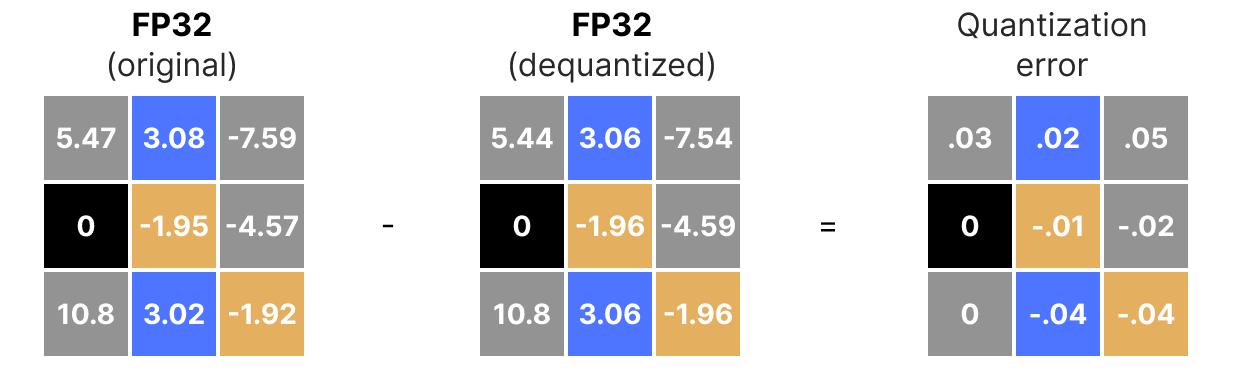
从图中可以看到,原始的数值 3.08 和 3.02 在经过量化再反量化后,被映射到同一个值 3.06,这通常被称为量化误差(quantization error),乐意通过计算原始值与反量化值之间的差值计算得到
-
被量化到的比特数越少,量化误差通常越大
-
非对称量化
-
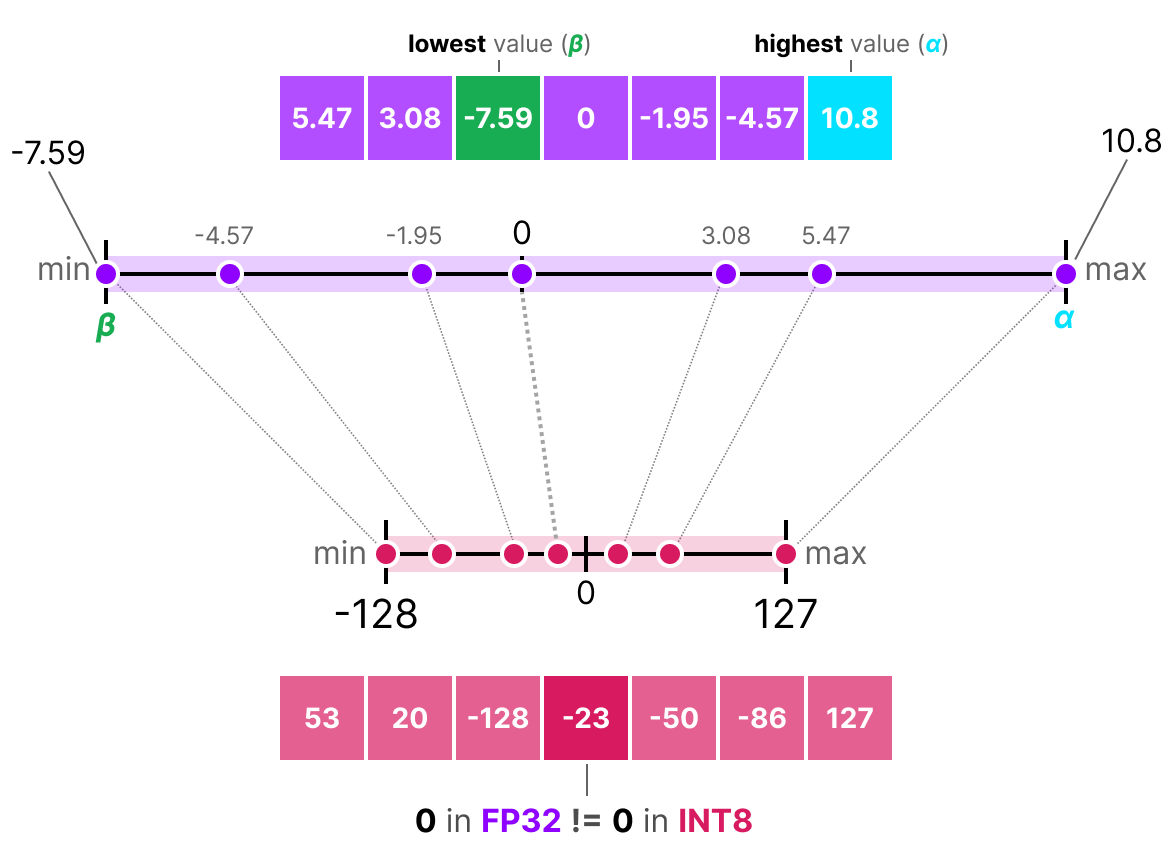
相比之下,非对称量化(asymmetric quantization)不围绕零对称,相反它将浮点范围内的最小值 和最大值 映射到量化范围的最小值和最大值
-
以零点量化(zero-point quantization)介绍非对称量化
-
可以看到,量化前后,0 的位置发生了变化,这是由于在 [-7.59,10.8] 这个范围内,最小值 / 最大值到 0 的距离不同
-
由于位置发生了偏移,必须计算 INT8 范围的零点来进行线性映射,计算过程如下
-
对于示例,计算过程如下
-
将量化后的 INT8 值反量化为 FP32 的公式如下
-
对称量化和非对称量化的对比
裁剪
-
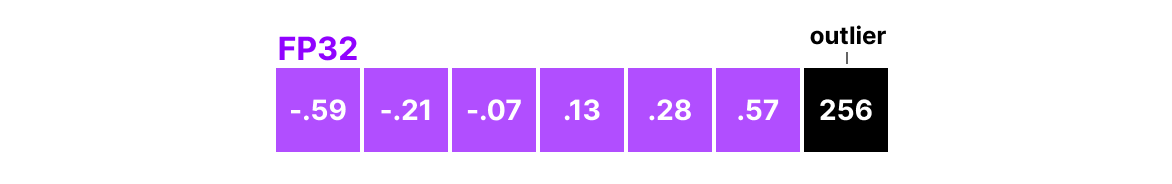
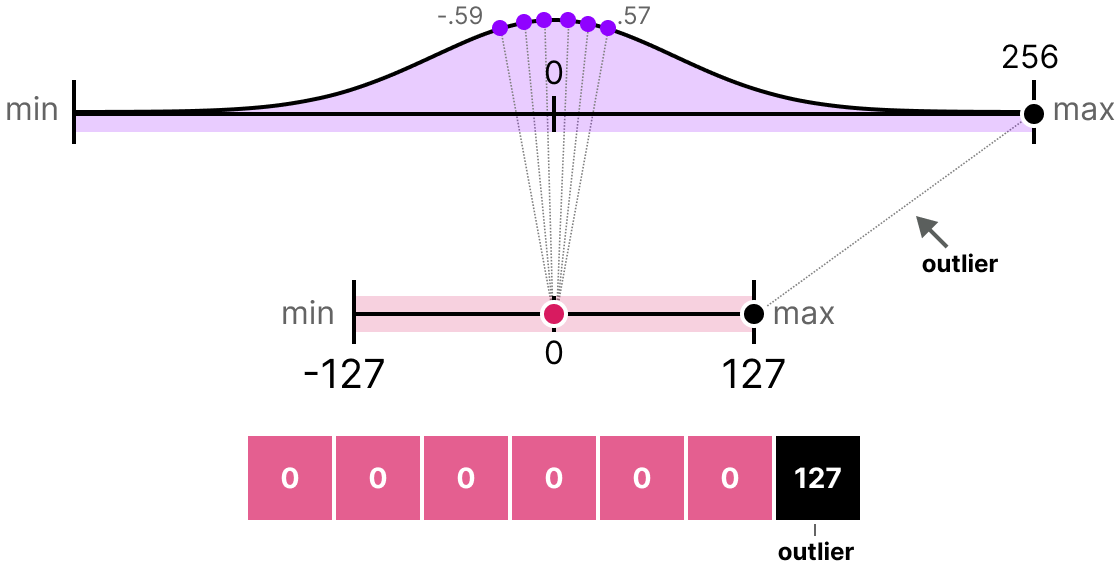
映射向量数值范围到低位宽表示时,若存在异常值(outliers),会导致小值映射到相同低位宽表示而失去区分度,对称和非对称量化不裁剪均会出现此问题
-
例如,对于包含以下值的向量
-
在上面这个例子中,其中一个值比其他所有值都大得多,可以被视为异常值,如果要映射这个向量的完整范围,所有小值都会被映射到相同的低位表示,从而无法被区分
-
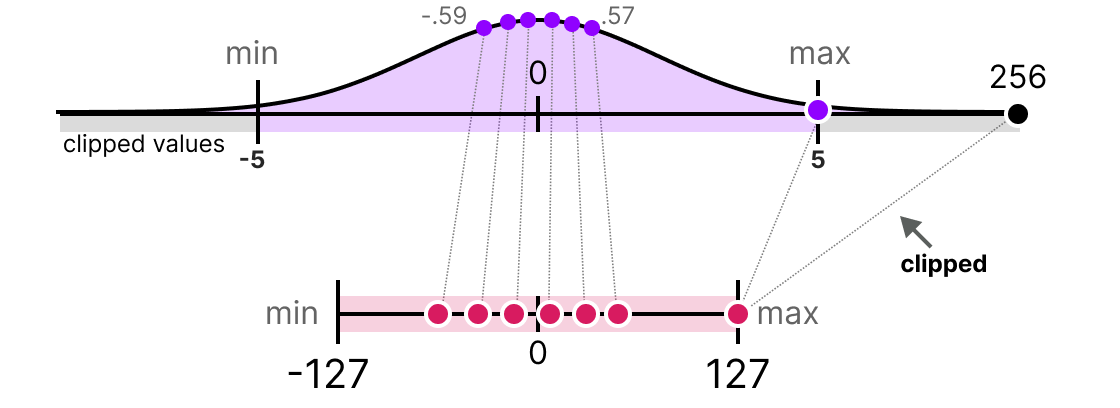
为了解决这个问题,可以选择对某些值进行截断(clipping),截断可以为原始数值设置不同的动态范围,使得所有异常值都被映射到相同的值
-
例如,将动态范围设置为 [-5,5],而所有超出该范围的数值都会被映射到 -127 或 127
-
通过截断操作,非异常值的量化误差显著降低,然而异常值的量化误差则相对增加
校准
-
根据原始数值列表,选择裁剪范围的过程被称为校准(Calibration),其目的是找到一个包含尽可能多的数值的范围,同时最小化量化误差,且不同类型参数的校准方式不同
-
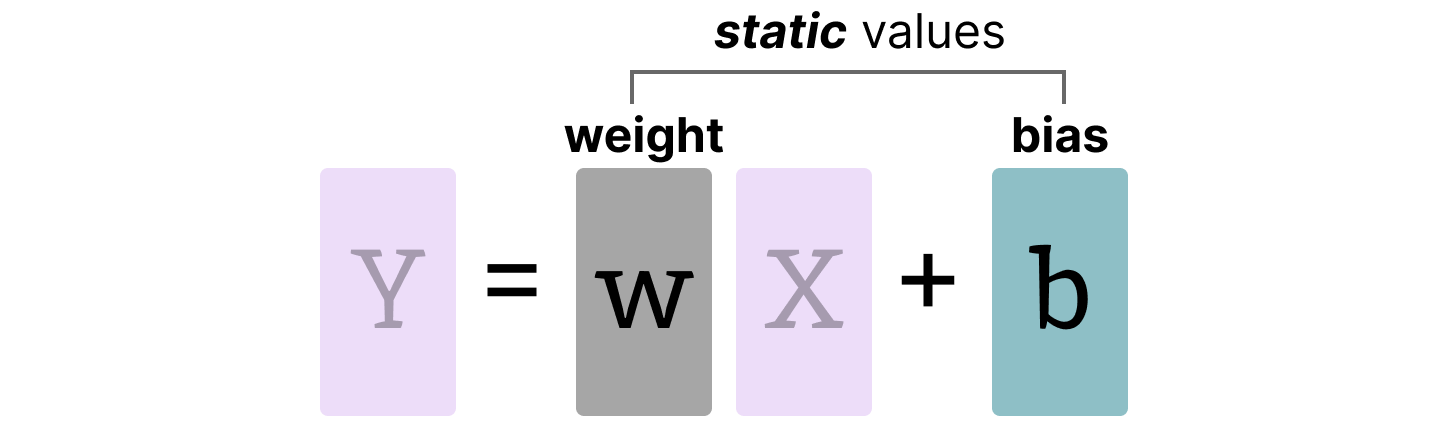
大语言模型的参数主要包括两部分,权重 weights 和偏置 bias,它们都是静态值,而且偏置的数量(数百万)要远远少于权重的数量(数十亿),因此偏置通常会保持更高的精度(如 INT16),而量化工作主要集中在权重上
-
对于静态且已知的权重,选择裁剪范围的校准技术包括
- 手动选择输入范围的百分位
- 优化原始权重和量化权重之间的均方误差(MSE)
- 最小化原始值和量化值之间的熵(KL 散度)
-
激活值的量化
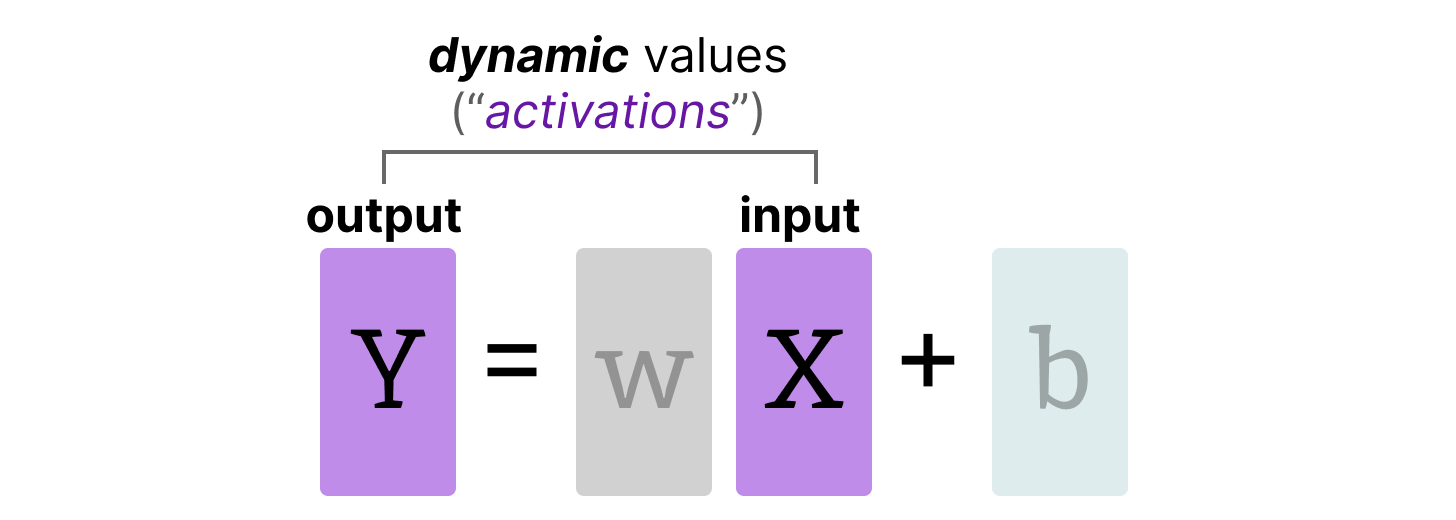
- 与权重不同,激活值会随着推理过程中输入数据的变化而变化,这使得其量化难度大
- 由于这些值在每个隐藏层之后都会更新,因此只有在推理过程中,当输入数据通过模型时,才知道激活值是什么
-
大致来说,有两种可以校准权重和激活的量化方式
- Post-Training Quantization(PTQ):在训练后量化
- Quantization Aware Training(QAT):在训练 / 微调期间量化
Post-Training Quantization
- PTQ 是最流行的量化技术之一,它在模型训练后对参数(权重和激活值)进行量化
- 权重的量化采用对称或非对称量化
- 激活值的量化则需通过模型推理获取其潜在分布,然后再确定范围
动态量化
-
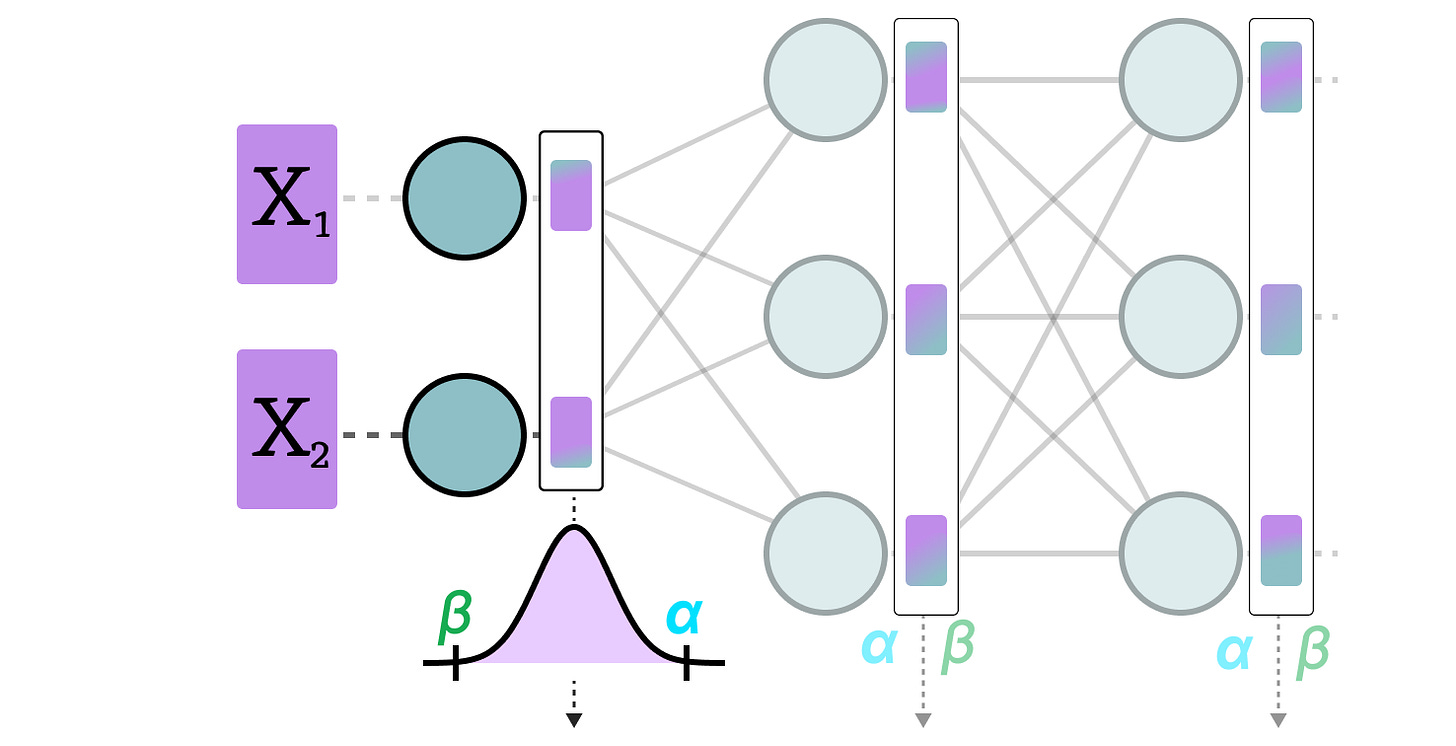
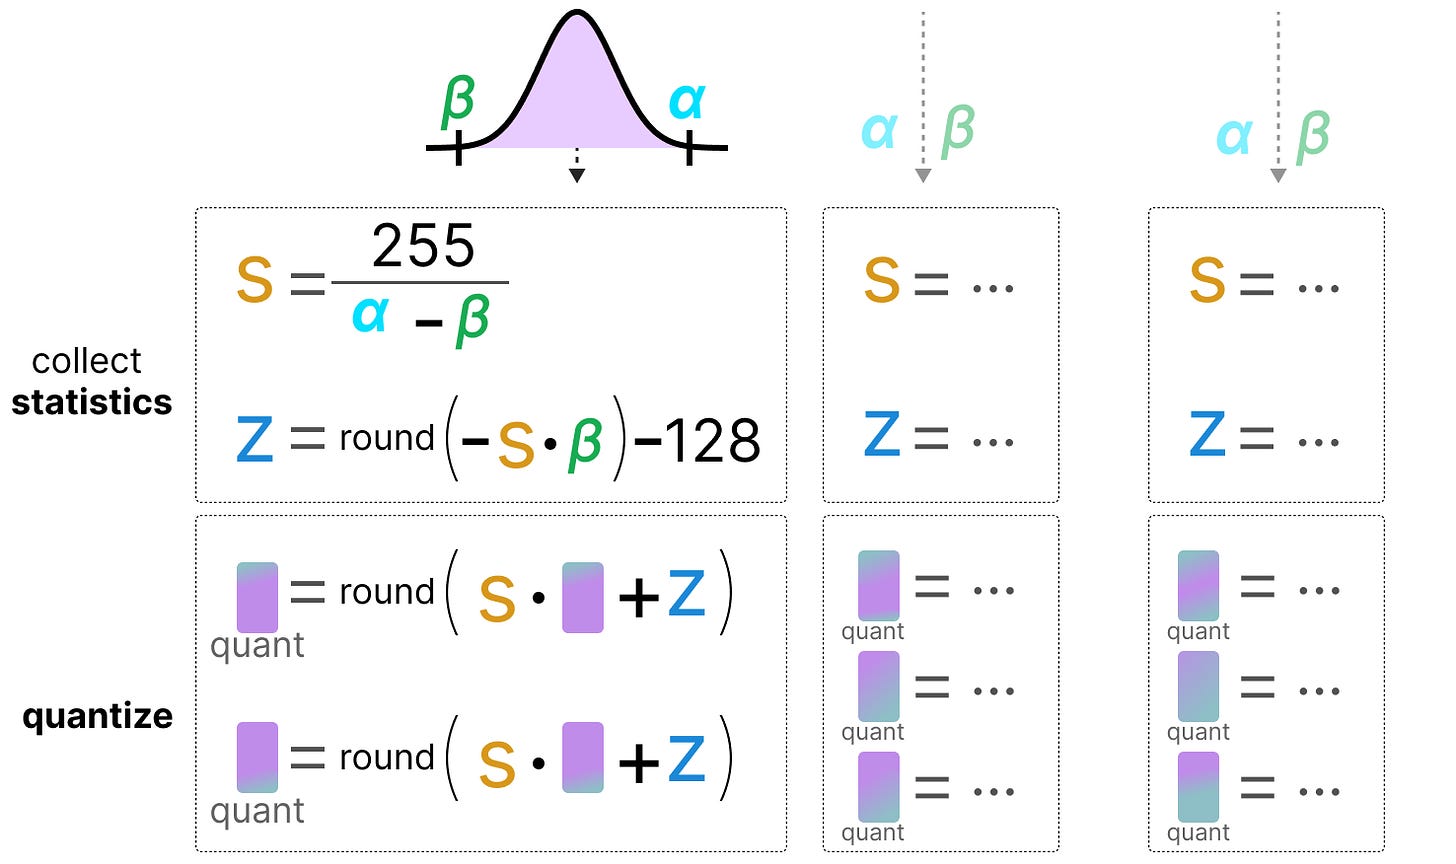
输入数据经过隐藏层后,会收集其激活值
-
然后,根据这些激活值的分布来计算量化所需的零点(z)和缩放因子(s)
-
每次输入数据通过新的层时,都会独立计算该层自己的零点和缩放因子,因而也有不同的量化方案
-
由于动态量化按层计算,准确性较高,但计算时间可能增加
静态量化
-
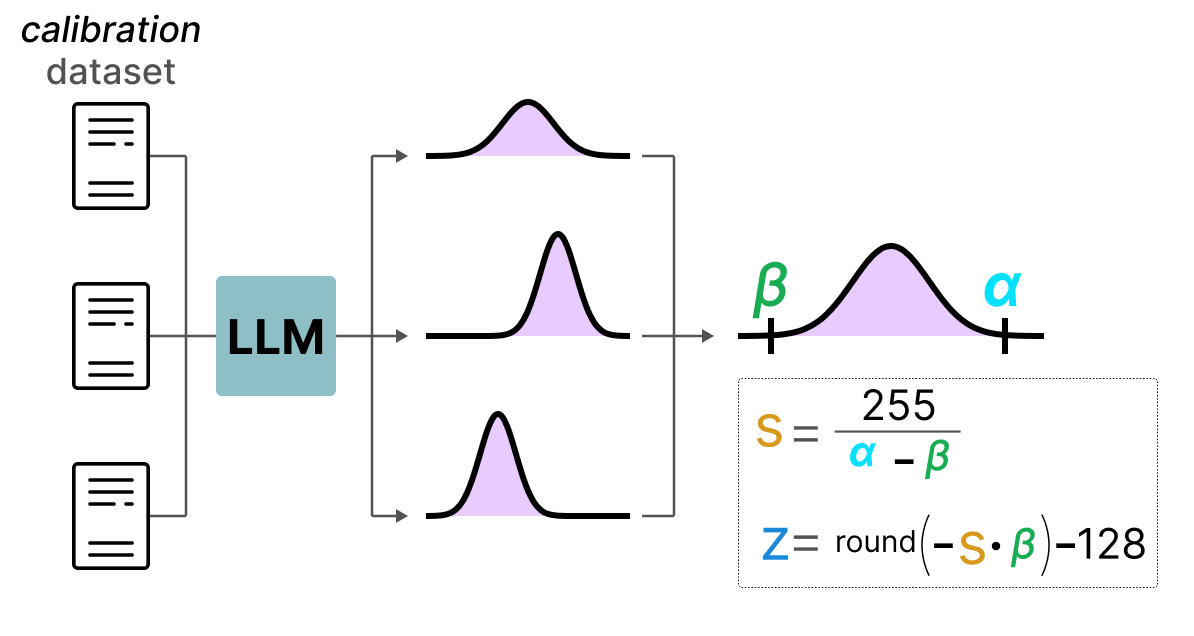
与动态量化不同,静态量化不会在推理过程中计算零点和缩放因子,而是提前计算
-
为了计算这些值,会在推理前利用校准数据集(calibration dataset)来获取激活值的潜在分布,计算零点和缩放因子
-
在推理时,全局使用提前计算得到的这些值来量化激活值,准确性较低,但是速度更快
LLM.int8 ()
AWQ
QuIP#
GPTQ
-
由于将量化精度降低至 8 位以下时,量化误差不断增加,因此难度较大,但是有集中巧妙的方法可以将量化位数减少到 6 位、4 位甚至 2 位(通常不建议量化到低于 4 位),包括 GPTQ、GGUF 等方法
-
参考资料
-
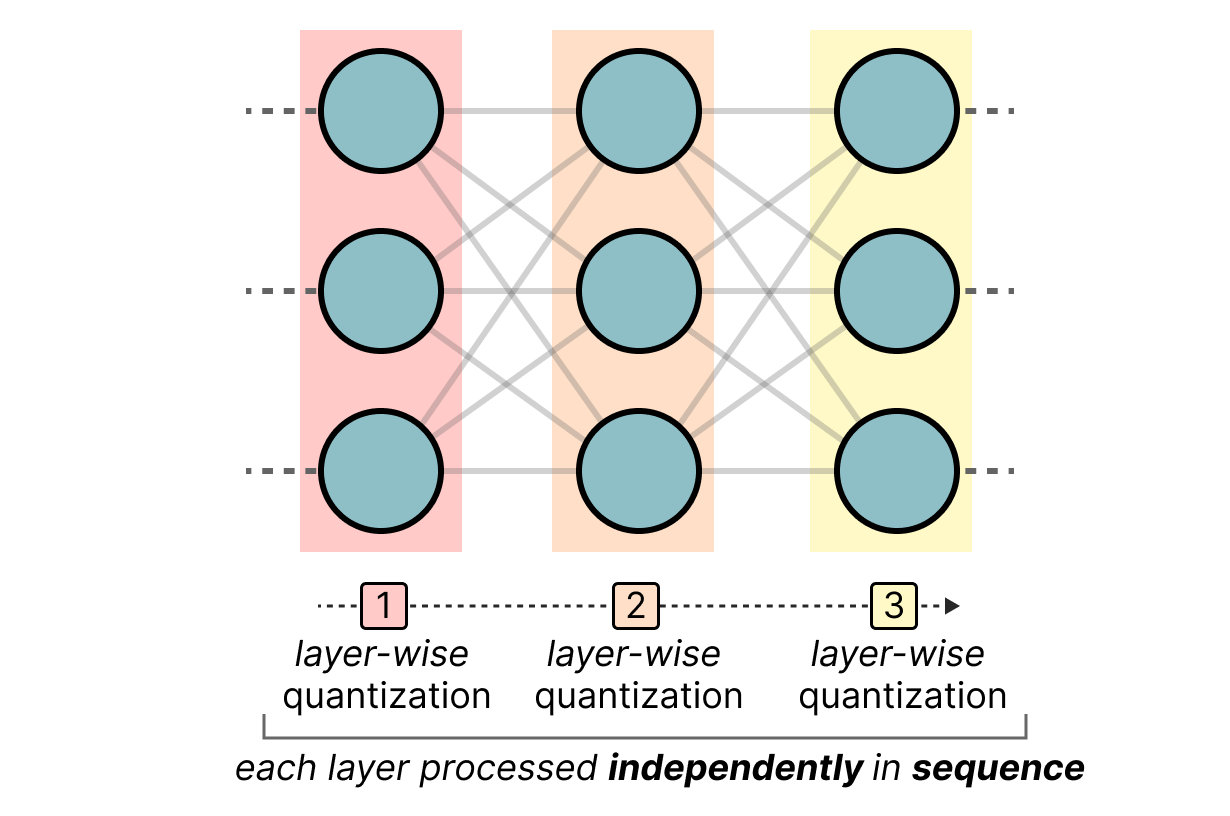
GPTQ 采用非对称量化,并逐层进行,以便在进入下一层之前,每一层都能独立处理
-
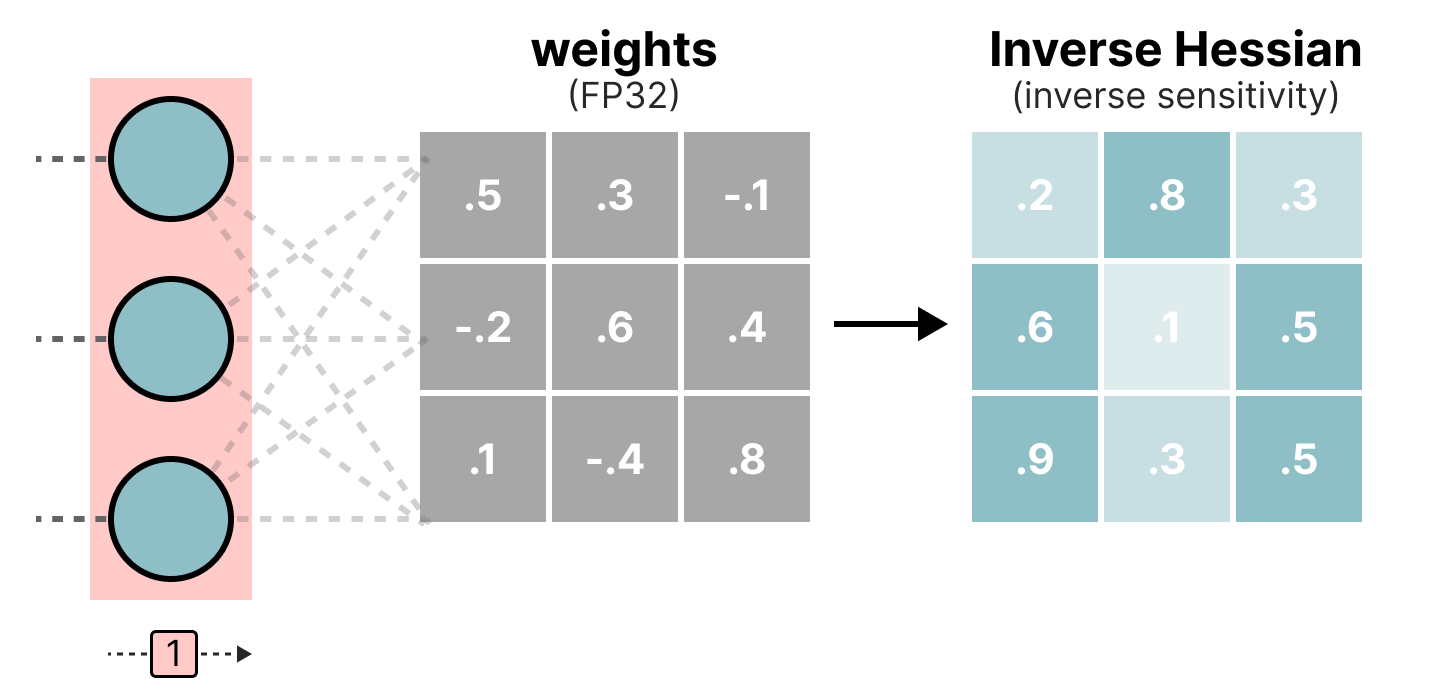
首先,将层的权重转换为逆海森矩阵(inverse-Hessian),这是模型损失函数的二阶导数,表示模型的输出对每个权重变化的敏感程度
-
简而言之,它本质上展示了层中每个权重的重要性,值越小权重越重要
-
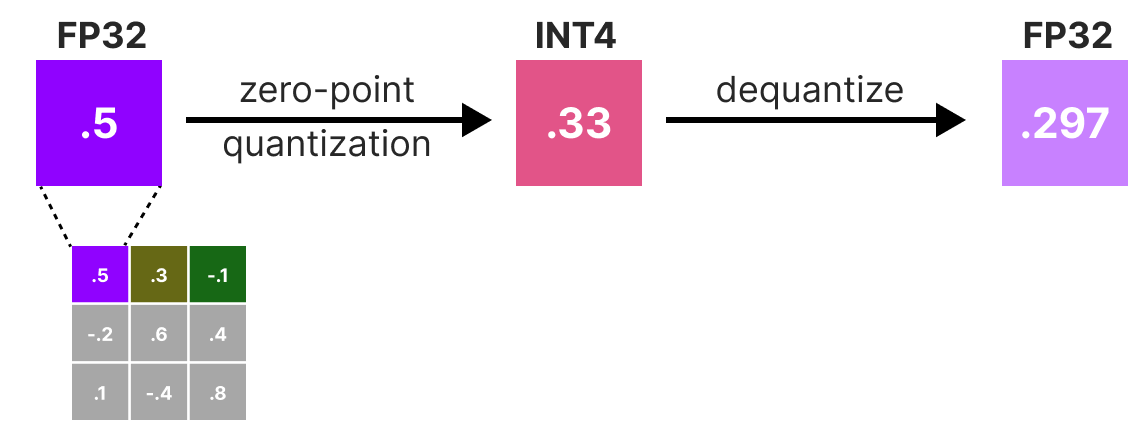
然后,对权重矩阵中第一行的权重进行量化,然后再进行反量化
-
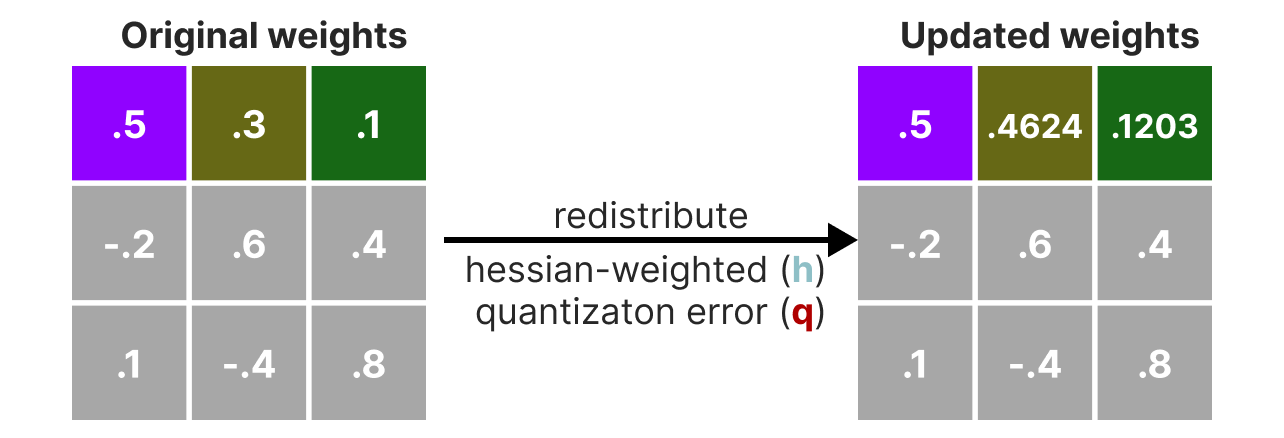
通过这一过程,能够计算得到量化误差(q),利用预先计算出的逆海森矩阵()对其加权,本质上是基于权重的重要性来计算加权的量化误差
-
然后,将这种加全量化误差重新分配到该行的其他权重上,有助于位置网络的整体功能和输出
-
例如,对于第二个值 执行此操作
-
对给定行中的所有权重都执行相同的步骤,直到所有值都被量化
-
这个方法之所以效果很好,是因为权重之间通常是相互关联的,因此当某个权重存在量化误差时,相关的权重会相应地通过逆海森矩阵得到更新
-
GPTQ 的作者使用了多种技巧来加快计算速度并提升性能,如在逆海森矩阵中添加阻尼因子、惰性批处理以及使用 Cholesky 方法预计算信息
GGUF
-
虽然 GPTQ 量化方法很好,可以在 GPU 上运行完整的大语言模型,但在 GPU 显存不够时,可以通过 GGUF 将大语言模型的任何层卸载到 CPU 上,从而同时使用 GPU 和 CPU
-
GGUF 量化方法更新频繁,且取决于位量化的级别,其一般原理如下
-
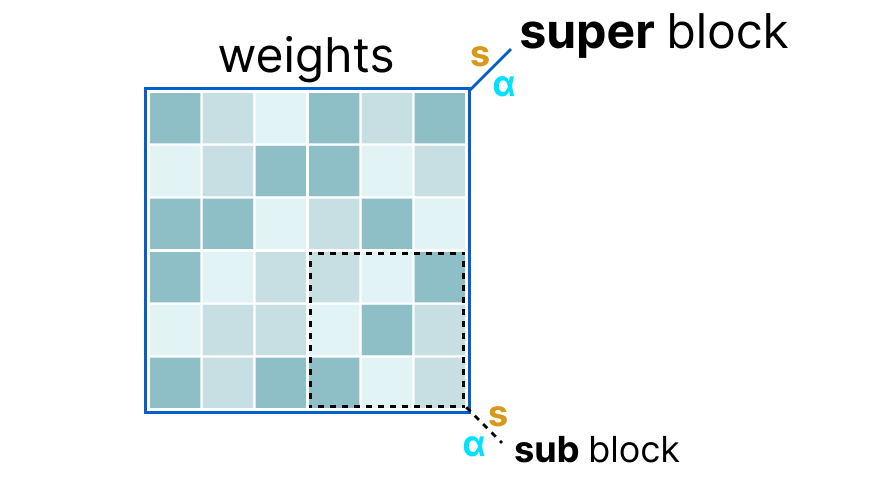
首先,给定层的权重被分割为 super 块,每个 super 块包括一组 sub 块,从这些块中计算得到缩放因子和最大值
-
对于给定的 sub 块,可以使用 absmax 量化方法
-
首先用 sub 块信息计算缩放因子,然后再用 super 块的缩放因子量化 sub 块的缩放因子,从而得到 sub 块的 “真实” 的缩放因子
-
super 块的缩放因子的精度通常高于 sub 块的缩放因子
-
不同的量化级别
Name Weight quant Scale (s) quant ("super") Scale (s) quant ("sub") Bits per weight (w) # Sub blocks Weights per block Q2_K 2 bits 4 bits 2 bits 2.5625 16 16 Q4_K 4 bits 6 bits 4 bits 4.5 8 32 Q6_K 6 bits 8 bits 6 bits 6.5625 16 16 -
如果采用非对称量化,可能需要一个额外的最小值 m 来调整零点,这些值的量化方式与缩放因子相同
AQLM
Quantization Aware Training
QAT 的原理
-
传统的训练后量化将模型从 FP32 量化到 INT8 精度时会产生较大的数值精度损失。感知量化训练(Aware Quantization Training)通过在训练期间模拟量化操作,可以最大限度地减少量化带来的精度损失
-
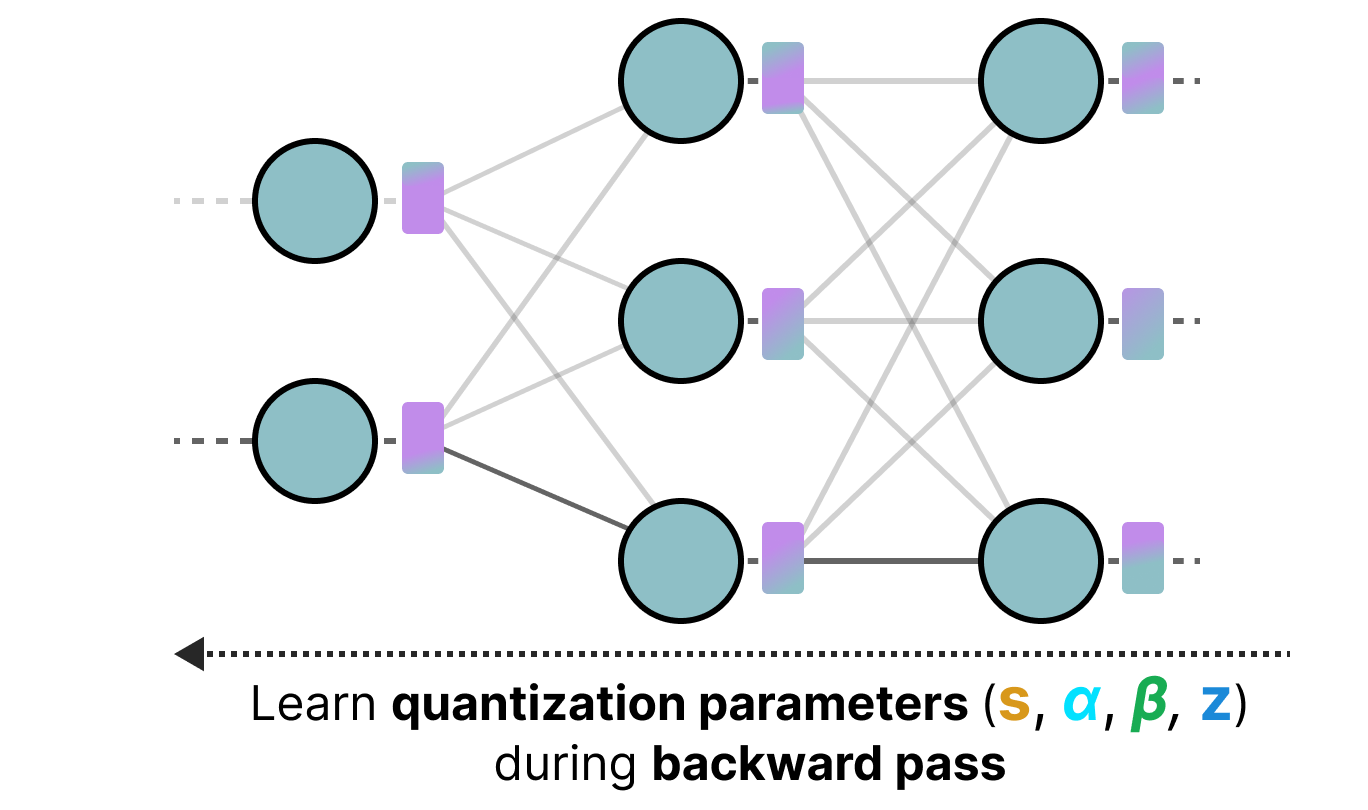
PTQ 方法在训练之后对模型进行量化,而没有考虑实际的训练过程,而 QAT 方法旨在在训练过程中学习量化过程
-
QAT 通常会比 PTQ 更准确,因为在训练过程中已经考虑了量化
-
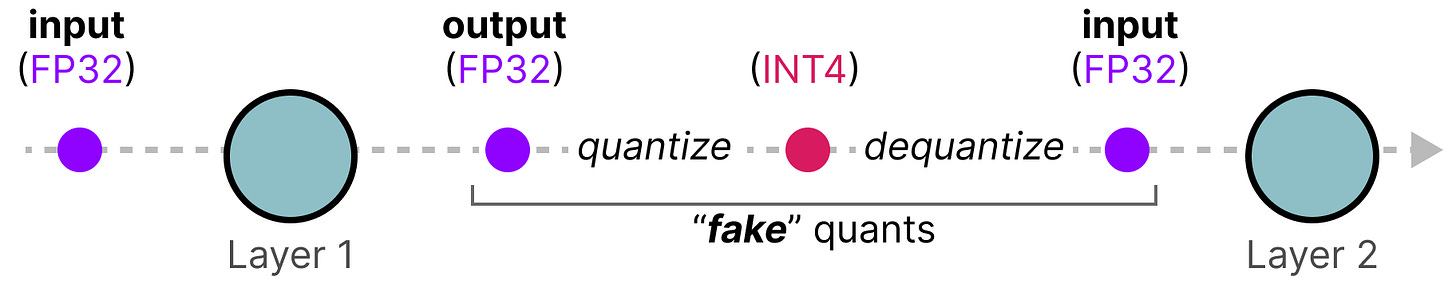
在训练过程中,QAT 会引入所谓的伪量化(fake quants):首先将权重量化为如 INT4,然后再反量化为 FP32
-
首先,找到输入数据的分布,即找到 MIN 和 MAX 值
-
对于每一个算子,量化参数通过以下公式得到:
-
缩放因子 :
-
零点偏移 :
-
量化值 :
-
:原始浮点数据的最小 / 最大值
-
:目标量化格式的最小 / 最大值(如 INT8 为 -128 和 127)
-
:原始浮点数据
-
:缩放因子,用于将浮点范围映射到整数范围
-
:零点偏移,用于对齐浮点零点与整数零点
-
-
FakeQuant 量化和反量化的完整过程可表示为:
-
量化:将浮点输入 除以缩放因子 ,四舍五入为整数,再减去零点 ,并通过 Clamp 限制在整数范围内
-
反量化:将量化后的整数加上零点 ,再乘以缩放因子 ,恢复为浮点数据
-
这一过程能够模拟量化到低比特操作的时候的精度损失,把该损失作用到网络模型中,传递给损失函数,让优化器去在训练过程中对该损失值进行优化
-
-
反向传播
-
在反向传播过程中,模型需要计算损失函数相对于每个权重和输入的梯度,梯度通过 FakeQuant 节点进行传递,这些节点将量化误差反映到梯度计算中,模型参数的更新因此包含了量化误差的影响,使模型更适应量化后的部署环境
-
按照前向传播的公式,因为量化后的权重是离散的,反向传播的时候对 求导数为 0:
-
因为梯度为 0,所以网络学习不到任何内容,权重 也不会更新:
-
这里可以使用直通估计器(Straight-Through Estimator,简称 STE)简单地将梯度通过量化层传递,近似来计算梯度,这使得模型能够在前向传播中进行量化模拟,但在反向传播中仍然更新高精度的浮点参数
-
STE 近似假设量化操作的梯度为 1,从而允许梯度直接通过量化节点:
-
如果被量化的值在 范围内,STE 近似的结果为 1,否则为 0。这种方法使模型能够在训练期间适应量化噪声,从而在实际部署时能够更好地处理量化误差
-
-
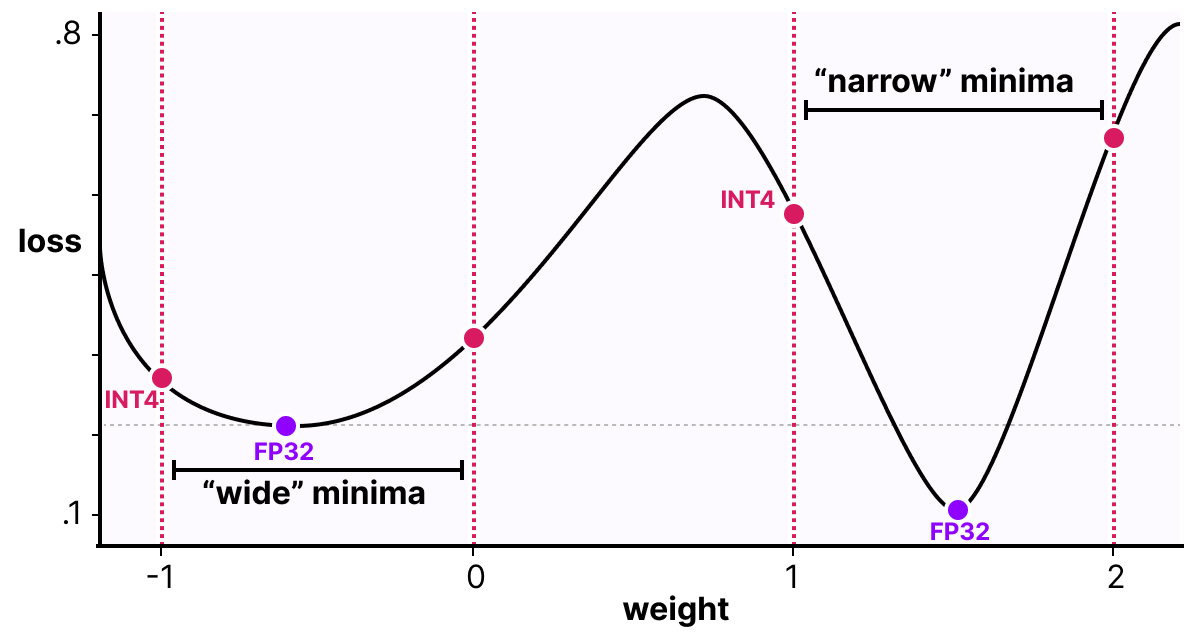
假设在反向传播过程中没有进行量化,会根据梯度下降选择损失最小的权重,然而,如果该权重位于狭窄的极小值点,会导致更大的量化误差
-
因此,QAT 试图探索更宽的极小值点对应的损失曲面,来最小化量化误差
-
QAT 与 PTQ 的对比
-
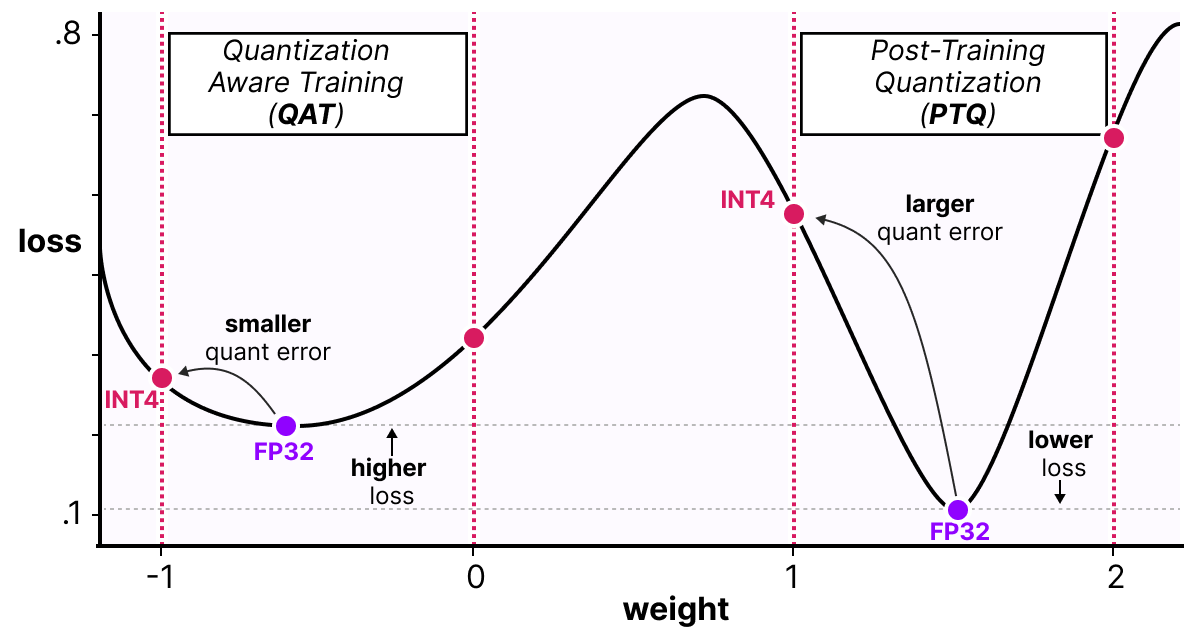
根据 QAT 和 PTQ 的对比图,可以得到,尽管 PTQ 在高精度如 FP32 下的损失较低,但 QAT 在低精度下的损失更低
1 位 LLM
-
参考资料:BitNet: Scaling 1-bit Transformers for Large Language Models
-
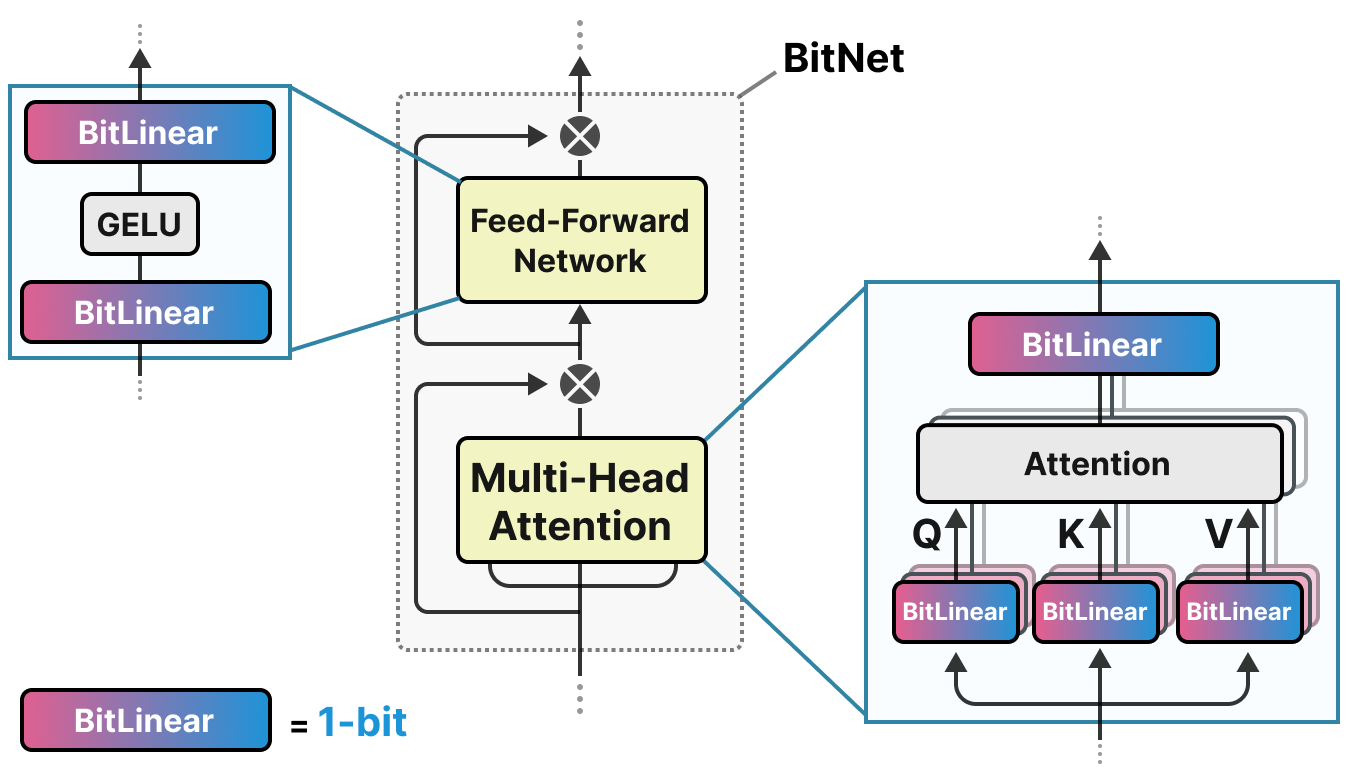
BitNet 将模型的权重用 1 位表示,仅使用 -1 或 1,通过将量化过程直接注入 Transformer 架构来实现
-
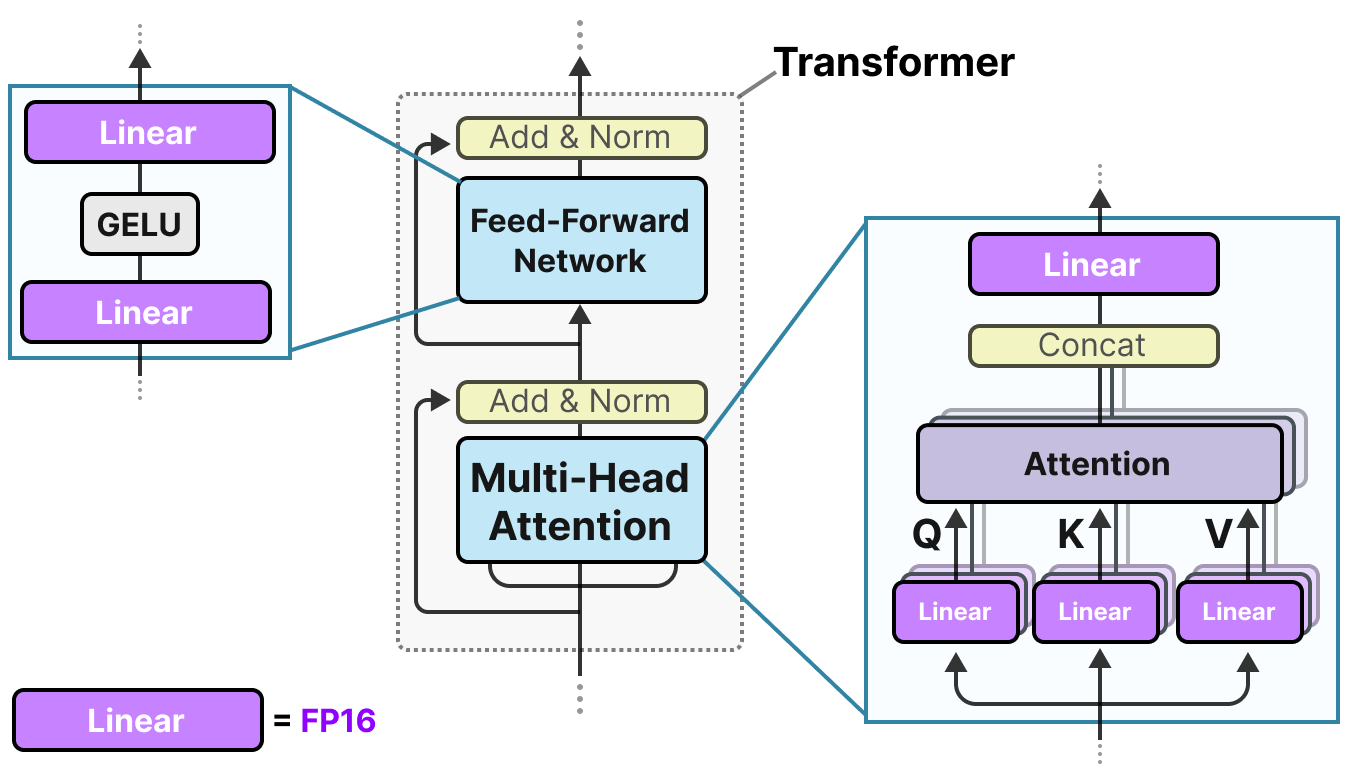
在标准 Transformer 架构中,先行词通常以更高的精度表示,如 FP16,而且模型的权重大多都由这些线形层的权重组成
-
BitNet 使用 BitLinear 取代了线性层
-
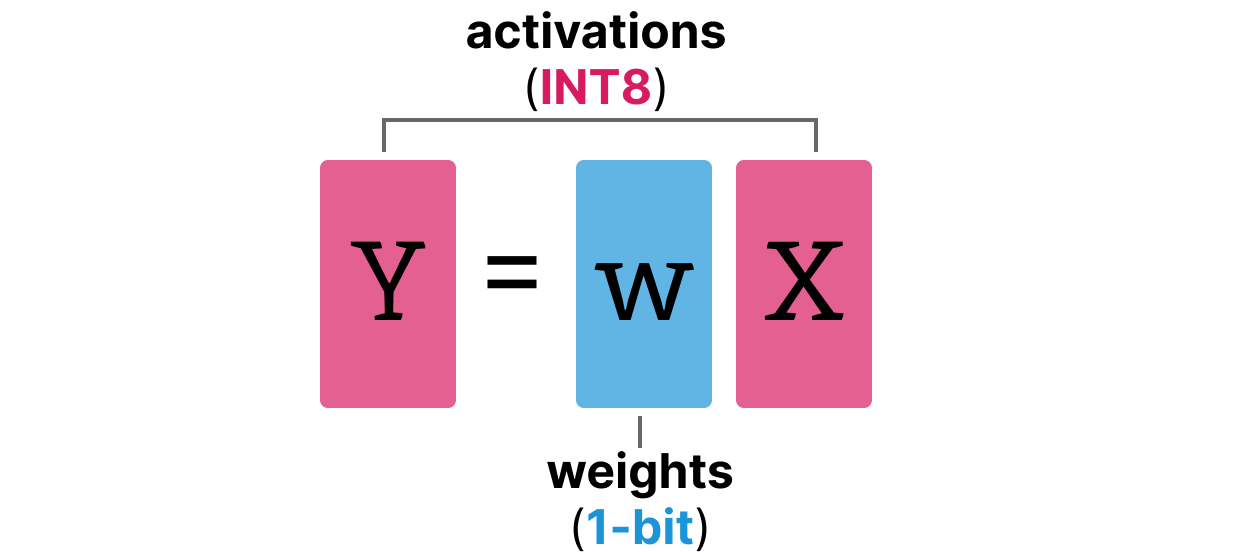
BitLinear 层使用 1 位表示模型的权重,使用 INT8 表示激活值
-
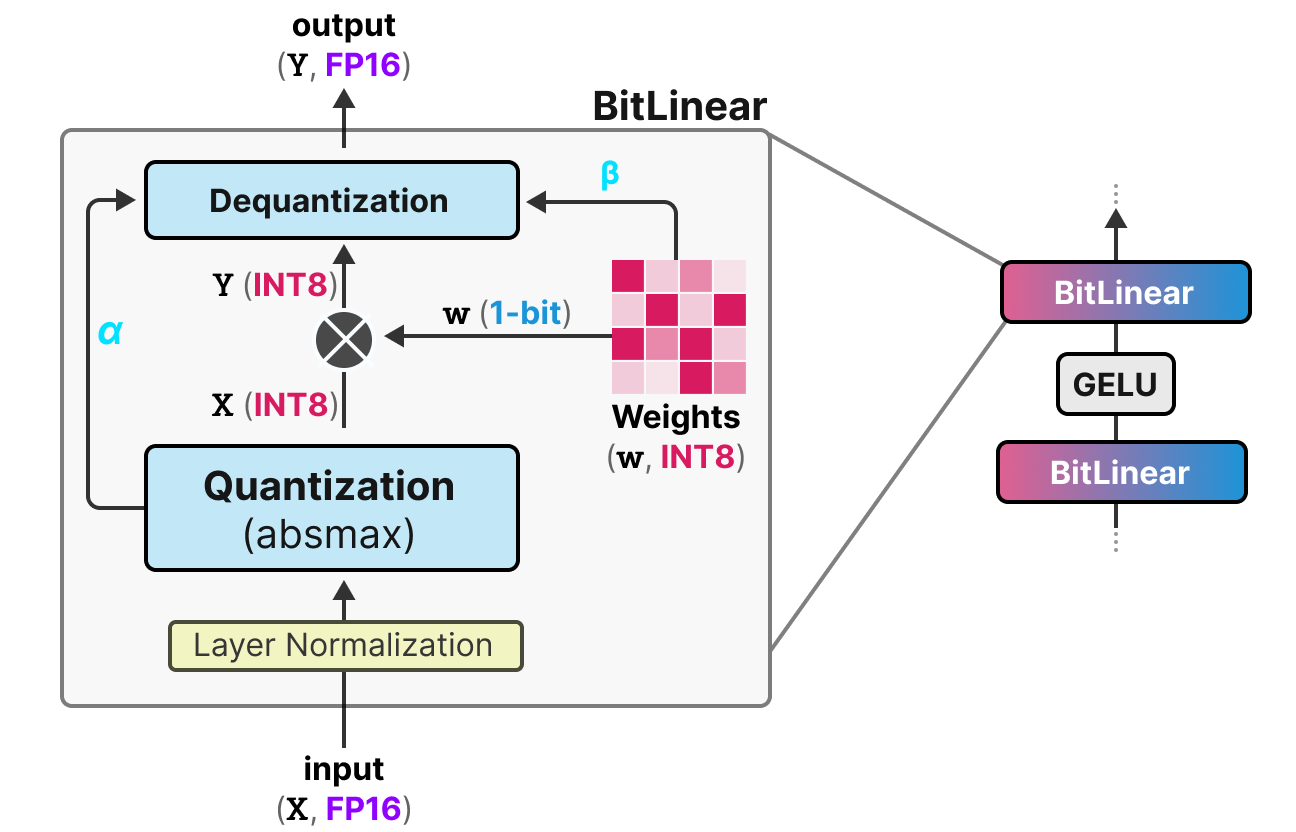
BitLinear 层与 QAT 类似,在训练过程中执行 “伪” 量化,以分析权重和激活量化的效果(下图中的 指得平均绝对值)
-
BitLinear 中的权重量化
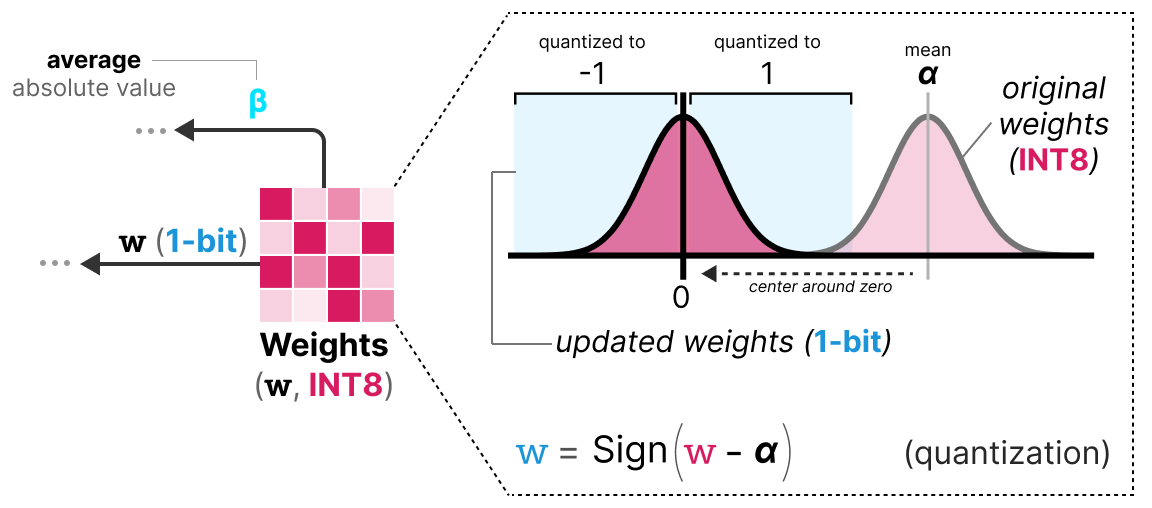
- 训练时,权重以 INT8 格式存储,然后使用符号函数量化到 1 位
- 本质上,它将权重分布调整为以 0 为中心,然后将 0 左侧置为 -1,右侧的值置为 1
- 此外,还会计算平均绝对值
-
BitLinear 中的激活值量化
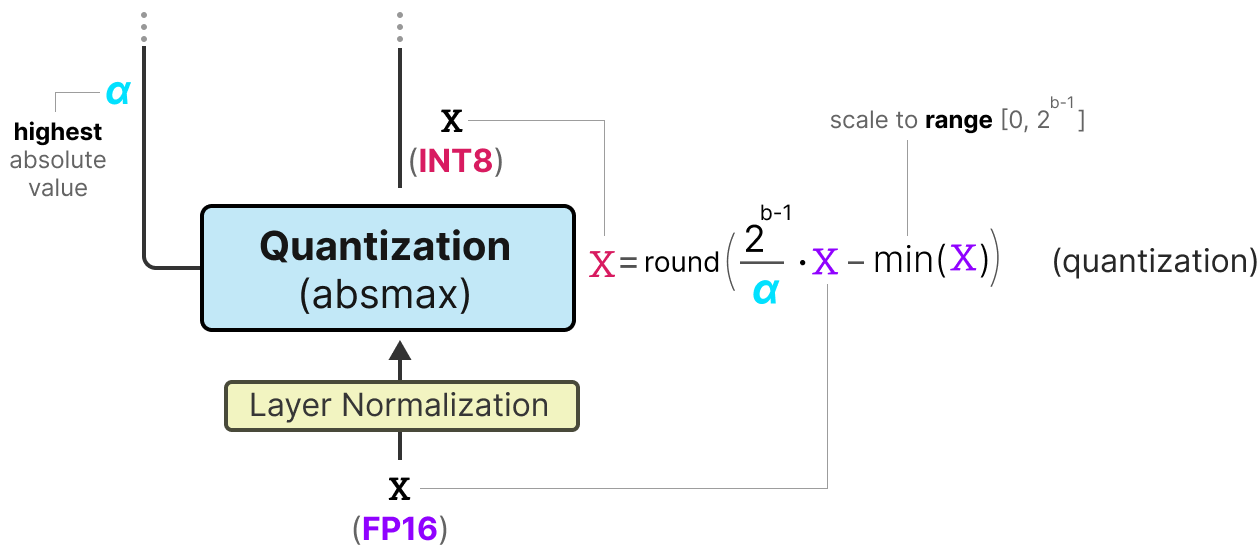
- 使用 absmax 量化将激活值从 FP16 转换为 INT8,因为在矩阵乘法中,激活值需要更高的精度
- 此外,还会计算最高绝对值
-
反量化
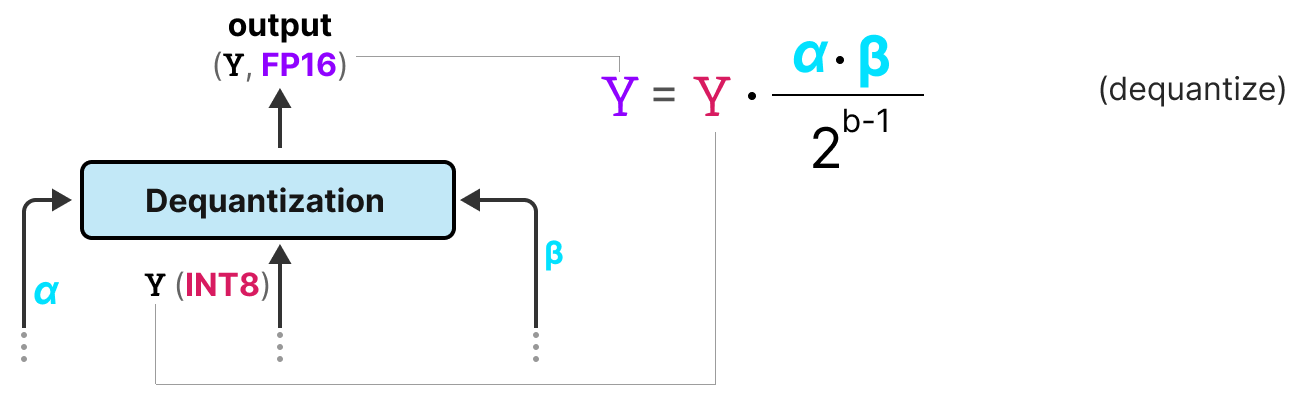
- 利用前面计算的 和 反量化至原始精度
-
BitNet 发现,随着模型规模的增大,1-bit 训练模型与 FP16 训练模型之间的性能差距会越来越小,不过一般只适用于更大的模型(参数超过 30B)
1.58 位 LLM
-
参考资料:The Era of 1-bit LLMs: All Large Language Models are in 1.58 Bits
-
BitNet 1.58b 正是为了改善 BitNet 中存在的扩展问题,其权重取值可以为 - 1、0、1(三元表示),仅增加 0 值就大幅提升性能且加快计算速度
-
为什么 0 能够带来如此重大的改进
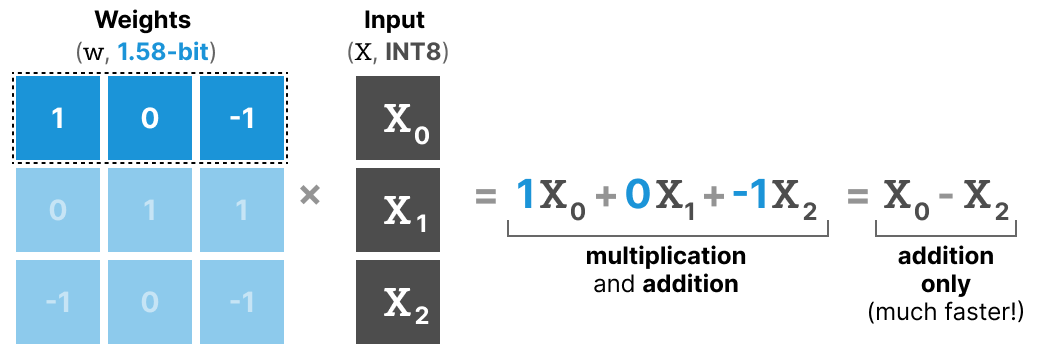
- 矩阵乘法通常包含权重与输入的乘法和加法
- 而 BitNet 1.58b 的三元权重可以省去乘法(1 表示加、0 表示忽略、-1 表示减),从而只剩下加法运算
- 这样可以显著加快计算速度,还能实现特征过滤(权重设为 0 可忽略该值)
-
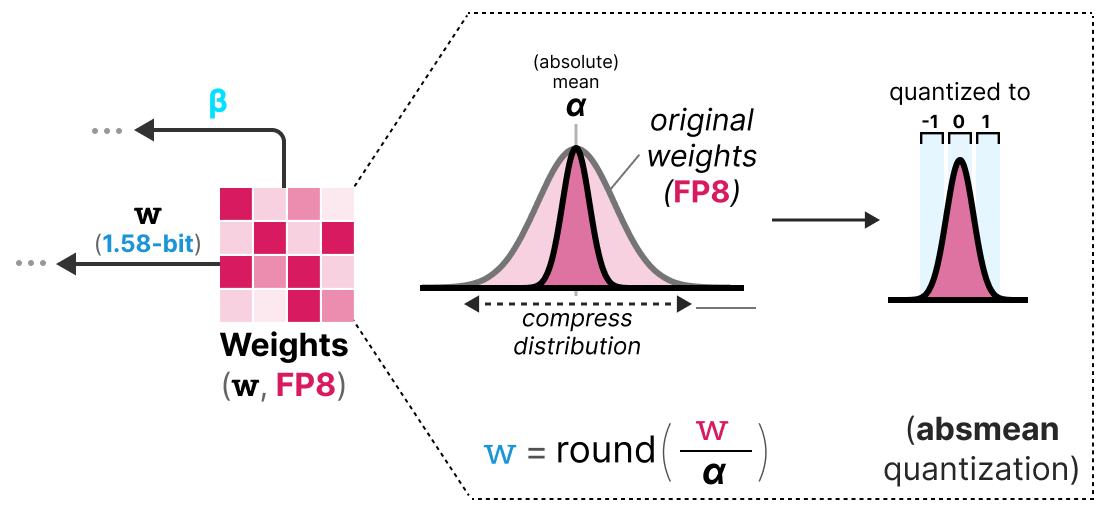
BitNet 1.58b 使用 absmen 量化来下执行权重量化,它只是对权重分布进行压缩,并使用绝对均值 来量化数值,并四舍五入为 -1、0、1
-
与 BitNet 相比,激活值量化基本相同,不同点在于激活值不再被缩放到 范围内,而是使用 absmax 量化到
-
实验证明,13B 参数的 BitNet 1.58b 模型在延迟、内存使用和能耗方面比 3B 参数的 FP16 模型更高效