vLLM
介绍 vLLM 库在 LLM 推理中的应用
- 参考资料
什么是 vLLM
PagedAttention
KV Cache 预留空间
-
模型训练完成后,通常会将其封装为推理服务(server)对外部署。推理服务接收客户端请求(request),读取请求中的输入文本(prompt)并执行推理。一个请求可以包含单个 prompt,也可以同时包含多个 prompts
-
在常规推理框架中,服务在收到请求后,会为请求中的所有 prompt 分配 GPU 显存,其中就包括 KV Cache 所需空间
-
由于推理生成的序列长度无法预先确定,大多数框架会按照
(batch_size, max_seq_len)的固定形状,在 GPU 上为单个请求预先开辟一块连续的矩形显存区域 -
这种固定大小的分配方式容易导致 GPU 显存利用率不足,进而降低模型推理的吞吐量
-
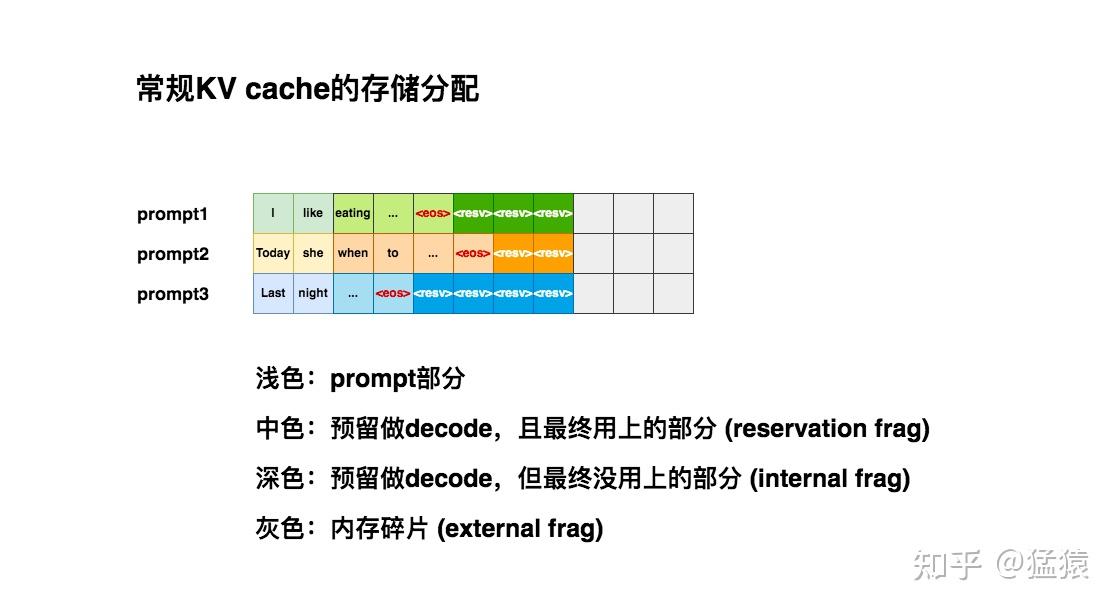
假设预设的最大序列长度
max_seq_len = 8,当第一条请求(prompt1)到达时,推理框架会为其分配尺寸为(1, 8)的连续显存空间 -
当第二条请求(prompt2)抵达时,同样需要
(1, 8)的存储空间,但此时 prompt1 占用的区域仅剩 3 个空闲位置,因此只能另起一行分配显存;第三条请求(prompt3)也面临相同情况 -
观察这三条请求的 KV Cache 显存排布可以发现,这种静态分配方式并未充分利用 GPU 显存资源,具体可从四类显存块的特性分析:
- 浅色块
- 对应 prefill 阶段 prompt 的 KV Cache,是推理必需的空间,不存在显存浪费
- 中色块
- 对应 decode 阶段的 KV Cache(<eos> 为序列生成终止符)
- 这类空间最终会被完全使用,但在 decode 阶段逐 token 生成过程中,无法预知哪些位置会被实际占用(例如生成 prompt2 的 "when" 时,无法确定下一个 token 是 <eos> 还是其他词汇),因此属于「预留碎片(reservation fragment)」,是潜在的显存浪费
- 深色块
- 同样属于 decode 阶段的 KV Cache 预留空间,但直到序列生成结束都未被使用,这类未利用的预留空间被称为「内部碎片(internal fragment)」
- 灰色块
- 不属于 KV Cache 预留空间且完全未被使用,被称为「外部碎片(external fragment)」
- 例如新请求 prompt4 需 8 个连续显存位置时,尽管显存中共有 9 个空闲位置,但因碎片分散无法形成连续空间,prompt4 只能进入等待队列,直至有足够连续显存资源时才能执行推理 —— 这会显著降低模型推理的吞吐量
- 浅色块
-
整体来看,传统 KV Cache 排布的核心问题在于「静态化分配」
- 既然无法预知序列实际长度,为何要为每个序列固定预留最大尺寸的 KV Cache 空间?
- vLLM 的核心优化思路正是将这种静态分配改为「动态化分配」,实现 KV Cache 「用多少占多少」,从而大幅减少各类显存碎片,提升单时刻可处理的请求数量,最终显著提高推理吞吐量
-
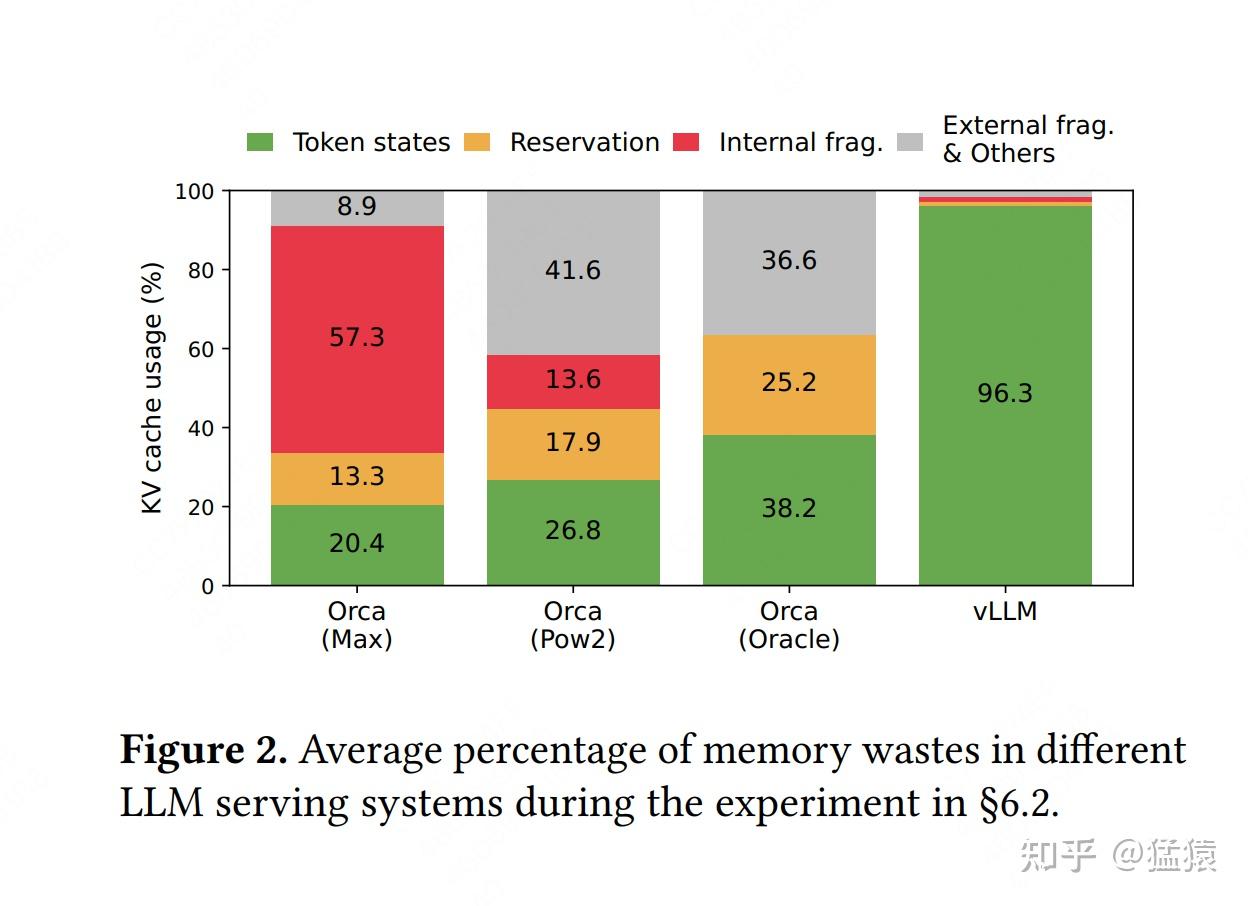
接下来通过一组实验对比图,直观感受 vLLM 相较于其他推理框架在显存利用率上的优化效果
操作系统的虚拟内存
-
vLLM 通过一种名为 PagedAttention 的技术,动态地为请求分配 KV cache 显存,提升显存利用率
-
PagedAttention 的设计灵感来自操作系统中虚拟内存的分页管理技术
-
不使用虚拟内存
-
程序运行时,需要将代码、数据等内容存放在物理内存中
-
在最原始的方式下(没有操作系统,例如单片机),程序直接访问物理内存地址,自行决定使用哪些地址空间
-
如果只运行一个进程,这种方式没有问题
-
但如果需要同时运行多个进程,问题就会出现:由于进程直接操作物理地址,在分配内存时必须考虑其他进程的占用情况,避免冲突。这会导致进程之间耦合度极高,极大增加开发难度
-
那么,有没有办法让各个进程相互独立、互不干扰?
-
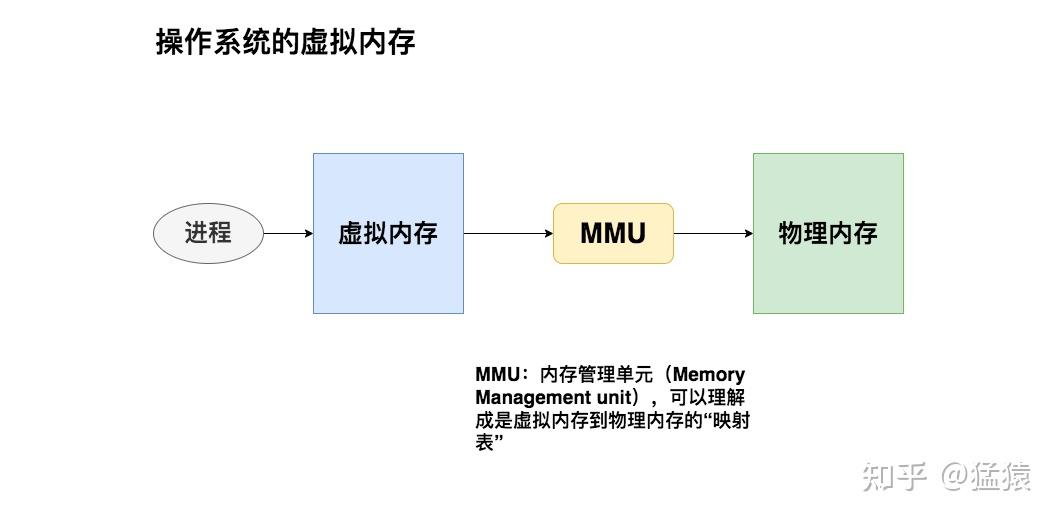
一个很自然的思路是:为每个进程提供一套虚拟内存。每个进程在开发和运行时,可以认为整个虚拟地址空间只属于自己,可以自由访问
-
虚拟内存负责统一管理代码、数据在物理内存上的实际存放位置,这一过程对进程完全透明,进程无需关心底层细节
-
虚拟内存的核心思想可以用下图直观表示:
-
-
虚拟内存的分段管理
-
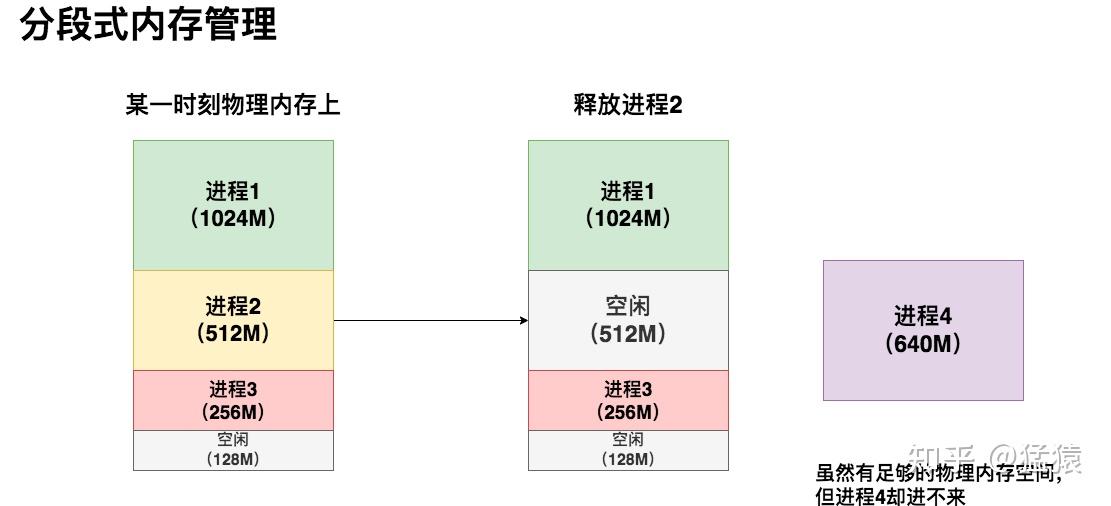
在分段式内存管理中,虚拟内存会尽量为每个进程在物理内存中寻找一整块连续的存储空间,用于加载该进程的全部代码和数据
-
举一个具体例子:假设有 3 个进程,它们的虚拟内存分别在物理内存中映射了一块连续区域;某一时刻,释放了进程 2,并希望运行进程 4
-
这时会遇到一个尴尬的问题:虽然物理内存总共剩余 640MB 空间,但这些空间是碎片化、不连续的,进程 4 仍然无法加载,只能等待
-
这和本文第二部分中,传统 KV Cache 显存分配遇到的问题高度相似
-
如果必须立刻运行进程 4,也有解决方案:可以先把进程 3 从物理内存交换(swap)到磁盘,腾出连续空间,再将进程 4 载入物理内存,之后再把进程 3 从磁盘读回
-
通过这种方式可以整合内存碎片,让进程 4 得以运行,但这种方法有明显缺点:如果进程 3 体积很大,且内存与磁盘之间带宽有限,整个交换过程会非常缓慢,导致系统卡顿 —— 这就是分段式内存管理的核心缺陷
-
为什么一定要为每个进程预先分配一整块固定大小的连续空间(段)?以浏览器进程为例,并不会同时使用它的所有功能
-
能不能做到:进程用到哪部分功能,就只加载对应部分到内存,让内存分配更加动态?
-
-
虚拟内存的分页管理
-
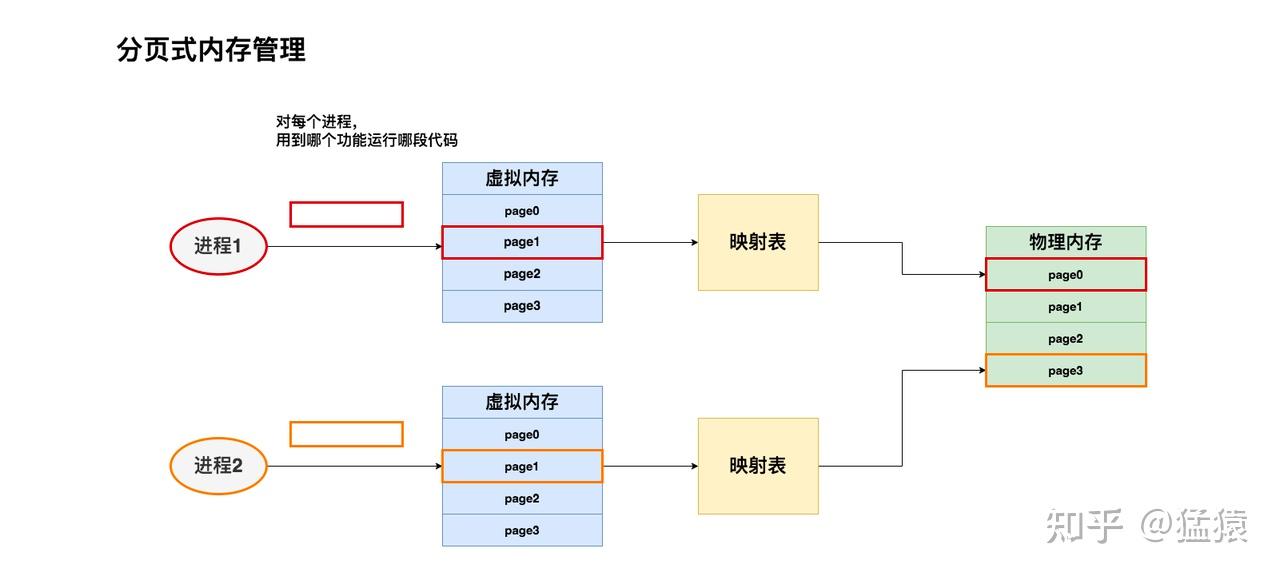
可以把进程 1、进程 2 想象成两本书,代码和数据分布在书的不同页码(page)上
-
希望:用到哪一页,就加载哪一页,而不是一次性把整本书全部读入内存;同样,不再需要的页也可以按页码释放
-
分页管理的思路正是如此:当需要访问进程 1 和进程 2 的第 1 页时,就只把这两页加载到物理内存
-
虚拟内存会自动维护虚拟地址到物理地址的映射,把来自不同进程的页放到物理内存的合适位置
-
虚拟内存分页管理可以总结为:
- 把物理内存划分为固定大小的块,称为页(page)
- 从物理内存抽象出来的虚拟内存,也按照同样大小划分页面
- 对于一个进程,不需要一次性静态加载全部代码和数据
- 用到哪部分、执行到哪部分,就动态加载对应页面到虚拟内存,再由虚拟内存映射到物理内存
- 一个进程在物理内存中可以是不连续的,分散在不同页面中
- 但在进程自己的虚拟地址空间里,地址是连续的
-
通过这种 “模拟连续地址空间” 的方式,分页机制既解决了物理内存的碎片问题,又简化了进程的开发与运行
-
PagedAttention 原理
-
单个请求的执行流程
-
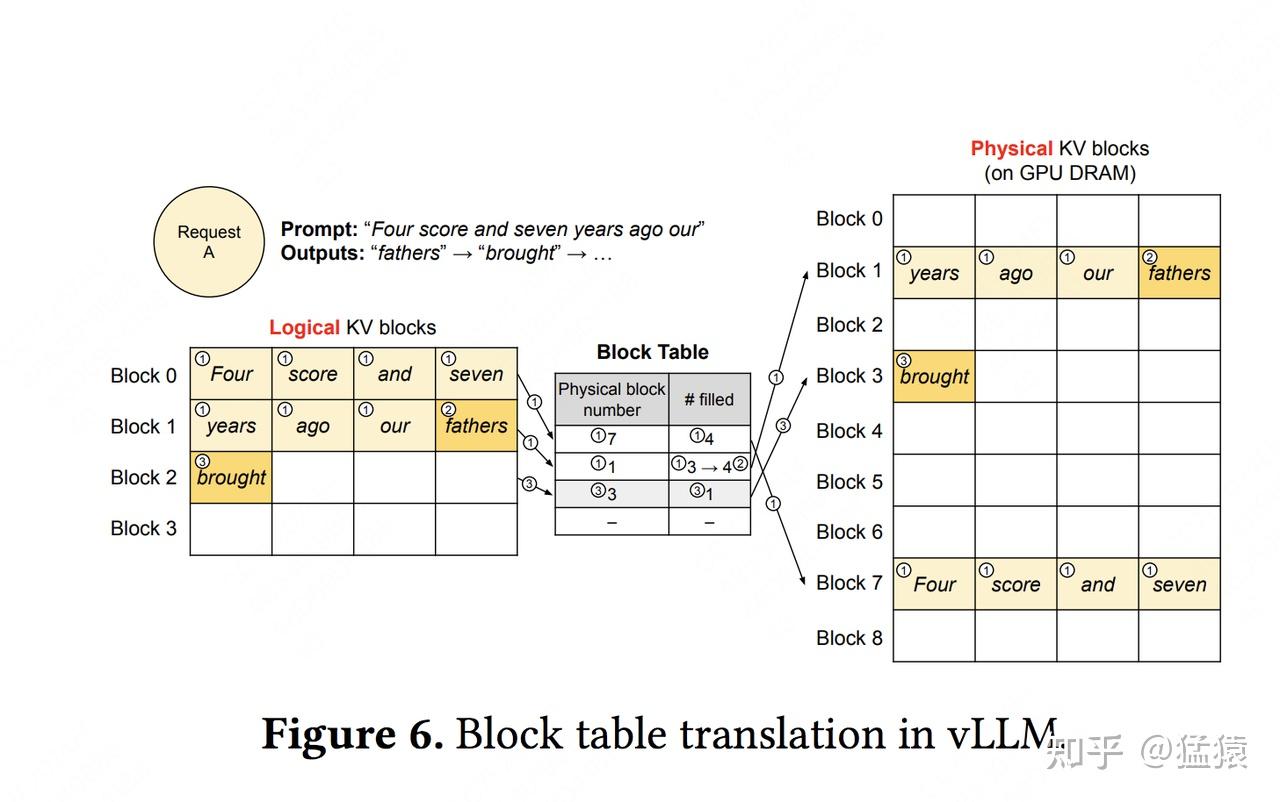
以 prompt
Four score and seven years ago our为例,vLLM 会按以下步骤执行: -
Prefill 阶段
-
划分逻辑块:
-
vLLM 按设定的 block 大小(本例中 B=4),将 prompt 划分为逻辑 KV 块
-
该 prompt 共 7 个 token,因此需要 2 个逻辑块:
-
逻辑块 0:存放前 4 个 token
Four score and seven的 KV 值,4 个槽位全部填满处理多个请求 -
逻辑块 1:存放后 3 个 token
years ago our的 KV 值,剩余 1 个槽位作为保留位(reservation)
-
-
-
映射到物理块:
- 通过 Block Table 建立逻辑块到物理块的映射关系,表中记录:
- 逻辑块与物理块的编号对应关系(如逻辑块 0 → 物理块 7)
- 每个物理块中已填充的槽位数量(# filled),用于追踪使用情况
- 通过 Block Table 建立逻辑块到物理块的映射关系,表中记录:
-
计算并填充 KV 值:
- 正常计算 prompt 的 KV cache,并根据 Block Table 的映射关系,将结果写入对应的物理块槽位中
-
-
Decode 阶段 - 生成第 1 个词
fathers- 使用 KV cache 计算 attention:
- 推理时,模型从逻辑块视角访问 KV cache,认为所有 token 是连续存储的
- vLLM 后台通过 Block Table 自动完成从物理块中读取数据的过程,对上层完全透明
- 更新 KV cache:
- 新生成的 token
fathers被写入逻辑块 1 中剩余的保留位,Block Table 中该物理块的# filled字段从 3 更新为 4
- 新生成的 token
- 分配新块:
- 逻辑块 1 已被完全填满,vLLM 自动分配新的逻辑块 2,并同步更新 Block Table 和对应的物理块,为下一次生成做准备
- 使用 KV cache 计算 attention:
-
Decode 阶段 - 生成第 2 个词
brought- 重复上述流程:将新 token
brought写入新分配的逻辑块 2 中,并更新 Block Table 中的槽位计数 - 若逻辑块 2 再次被填满,vLLM 会继续分配新的逻辑块和物理块,实现无限长度的序列生成
- 重复上述流程:将新 token
-
-
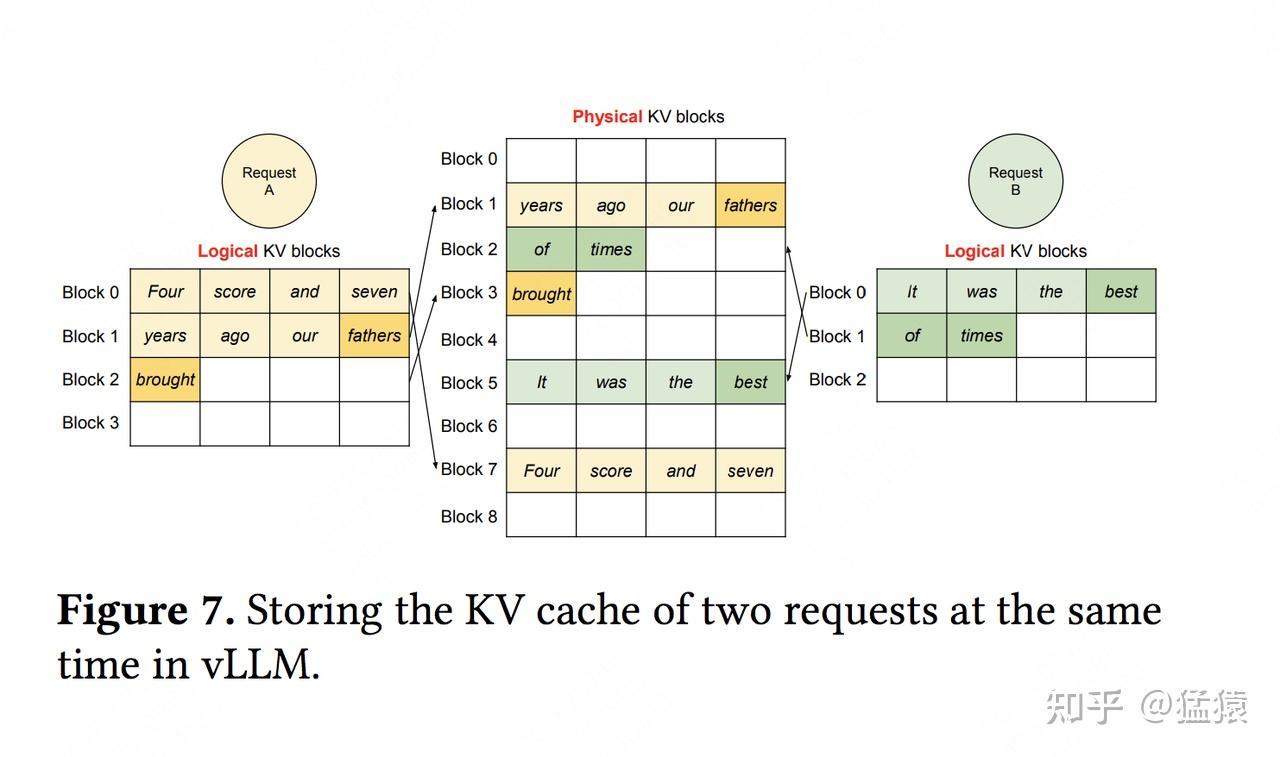
处理多个请求
在不同解码策略下的效果
-
大模型的解码策略会根据实际业务需求灵活调整,不同策略对 KV Cache 的存储和复用提出了不同要求,典型场景如下:
-
Parallel Sampling(并行采样)
- 该场景下,用户发送一个续写请求,要求模型针对同一个 prompt 生成多个不同的回答(例如 3 种)
- 实现方式通常是将原 prompt 复制多份(如 3 份),拼接成一个 batch 送入模型推理
- 核心问题:prompt 部分的 KV Cache 会被重复存储(3 份完全相同的 prompt KV Cache),造成 GPU 显存的冗余占用
-
Beam Search(束搜索)
-
束搜索是大模型常用的解码策略,核心逻辑是:
-
在每个 decode 阶段,模型并非只生成 1 个 token,而是保留得分最高的
k个 token(k称为束宽); -
这
k个 token 对应k个候选序列,下一阶段会基于这k个序列生成k×|V|个候选 token(|V|为词表大小),再从中筛选出 topk个序列; -
以此循环,直到生成终止符(
<eos>) -
核心问题:每一轮筛选出的 top
k个序列,其前置 token 序列高度重叠,导致这些重叠部分的 KV Cache 被重复存储,显存利用率低
-
-
Shared Prefix(共享前缀)
- 在很多实际场景中,所有请求会包含相同的前置信息(最典型的是 System Message,如 “假设你是一个有帮助的 AI 助手,回答需简洁、准确...”)
- 核心问题:如果每个请求都单独存储这部分共享前缀的 KV Cache,会产生大量重复数据,完全浪费显存资源
-
-
Parallel Sampling 场景
-
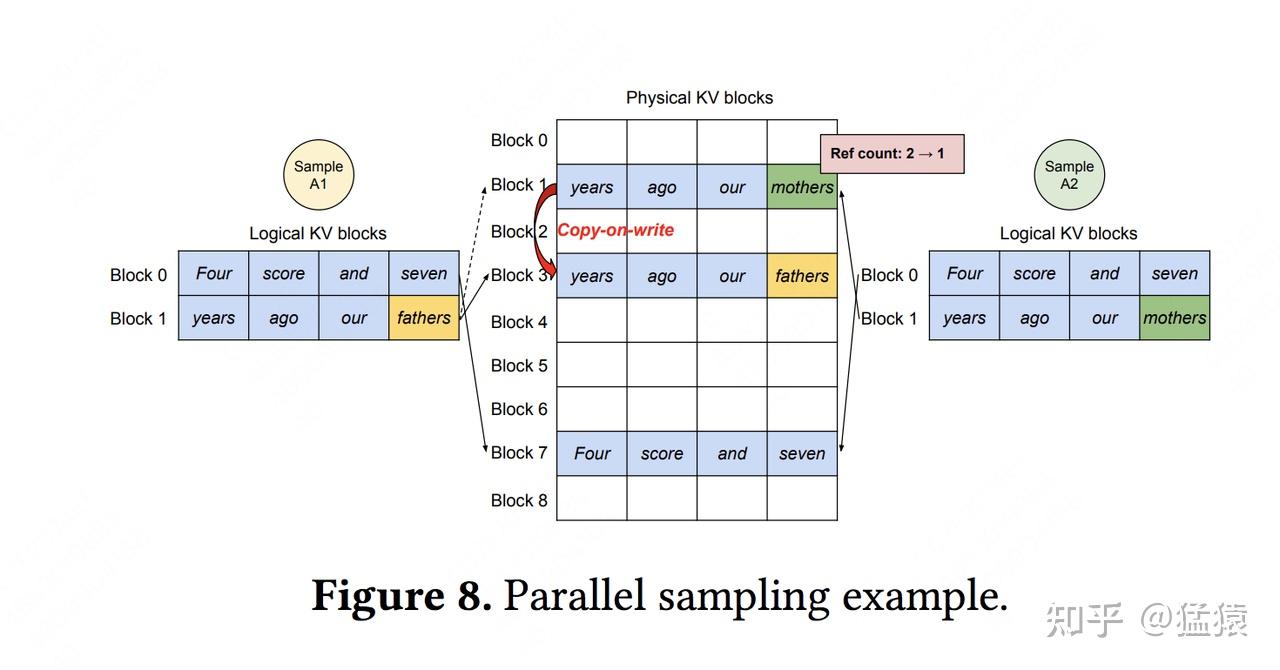
向模型发送 1 个请求(request),该请求包含 2 个完全相同的 prompt(记为 Sample A1、Sample A2),内容均为
Four score and seven years ago our,要求模型对两个 prompt 分别续写 -
Prefill 阶段:KV Cache 共享分配
-
vLLM 拿到 Sample A1 和 A2 后,按以下步骤分配逻辑块与物理块:
-
分配逻辑块
-
对 A1:分配独立的逻辑块 block0、block1(用于存放 prompt 对应的 KV 值);
-
对 A2:分配独立的逻辑块 block0、block1;
-
A1 和 A2 的逻辑块是完全独立的(即便编号相同),可类比操作系统中两个独立进程的虚拟内存页
-
-
分配物理块(核心:共享复用)
-
由于 A1 和 A2 的 prompt 内容完全一致,其 KV Cache 数据也完全相同,因此复用同一物理块:
- A1 的逻辑块 block0/1 → 物理块 block7/1;
- A2 的逻辑块 block0/1 → 物理块 block7/1;
-
引入引用计数(ref count)追踪物理块的复用次数:
- 物理块 block7 的 ref count = 2(被 A1、A2 共同引用);
- 物理块 block1 的 ref count = 2(被 A1、A2 共同引用)。
-
-
-
Decode 阶段:Copy-on-Write(写时复制)机制触发
-
A1 和 A2 各自推理生成第一个 token:A1 生成
fathers,A2 生成mothers -
写入逻辑块
-
A1 将
fathers写入自身的逻辑块 block1; -
A2 将
mothers写入自身的逻辑块 block1
-
-
触发写时复制(Copy-on-Write)
-
由于两个 token 完全不同,原本共享的物理块 block1 无法同时存储不同数据,因此触发核心机制:
-
为 A1 新开辟物理块 block3,将 A1 的逻辑块 block1 映射到 block3;
-
物理块 block1 仅保留与 A2 逻辑块 block1 的映射;
-
更新引用计数:
- 物理块 block1 的 ref count = 2 - 1 = 1(仅被 A2 引用);
- 物理块 block3 的 ref count = 1(仅被 A1 引用);
- 物理块 block7 的 ref count 仍为 2(A1、A2 的 prompt 前缀未修改,继续共享)
-
-
-
vLLM 优化 KV Cache 显存占用的核心逻辑:
- 最大化复用:对于内容相同的 prompt,其 KV Cache 共享同一物理块(通过 ref count 追踪复用次数),避免重复存储;
- 按需复制:当不同样本生成差异化 token、无法继续共享时,触发 Copy-on-Write 机制,仅为差异化部分开辟新物理块,而非整体重新分配,最小化显存新增开销
-
-
Beam Search 场景(以 beam width = 4 为例)
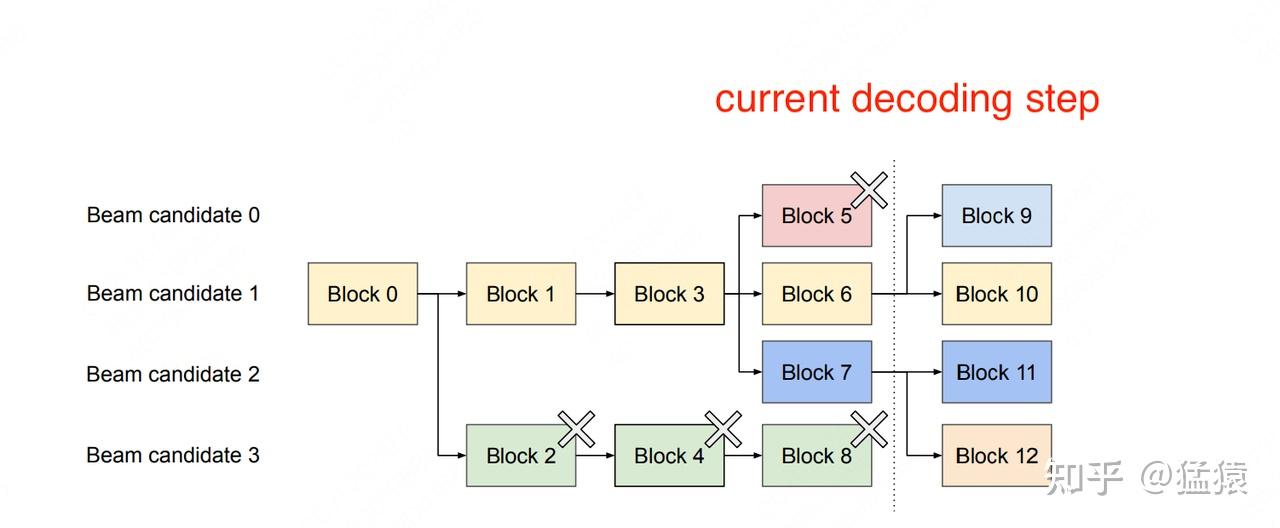
- 从右往左分析这张图,虚线位置代表当前解码时刻,所有块均为逻辑块:
- 当前解码时刻
- 根据 Beam Search,生成了概率最高的 4 个候选 token(beam candidate 0/1/2/3),分别存储在逻辑块
Block5、Block6、Block7、Block8中 - 在下一轮解码中,需要从这 4 个候选序列中,再次选出概率最高的 4 个新 token
- 计算后发现,这 4 个新 token 中有 2 个来自
beam candidate 1(对应Block6),另外 2 个来自beam candidate 2(对应Block7) - 因此,从
Block6中延伸出Block9和Block10,从Block7中延伸出Block11和Block12,用于存储这 4 个新的候选 token Block9/10/11/12中的 token 成为了新的 beam candidates,用于下一轮的 Beam Search- 而
Block5(来自 candidate 0)和Block8(来自 candidate 3)中的序列在本轮筛选中被淘汰,后续解码不再依赖它们,因此可以清除这两个逻辑块,并释放其对应的物理块内存
- 根据 Beam Search,生成了概率最高的 4 个候选 token(beam candidate 0/1/2/3),分别存储在逻辑块
- 回溯释放
- 继续向左看,
Block3引出了Block5/6/7,Block4引出了Block8 - 这表明当前的 4 个候选 token 是由上一时刻的
candidate 1和candidate 3相关序列生成的(candidate 0和candidate 2的序列已被淘汰,因此未在图中画出) - 由于
Block8已被淘汰,其前驱Block4也不再被任何序列需要,因此也被淘汰并释放内存 - 以此类推,一路向左回溯,直到代表 prompt 的
Block0(它被所有序列共享,因此必须保留)
- 继续向左看,
- 核心思想
- 在每一轮 Beam Search 后,vLLM 会根据最新的候选序列,动态地释放掉那些不再被需要的逻辑块及其对应的物理内存
- 这种动态管理方式,避免了为所有历史候选序列无差别地保留 KV Cache,从而大幅节省了 GPU 显存占用
调度和抢占
- 到目前为止,已经详细阐述了 vLLM 是如何优化 KV Cache 显存分配的
- 现在来探讨另一个关键问题:当采用动态显存分配策略时,虽然理论上同一时刻能处理更多的 prompt,但由于不再为每个 prompt 预先预留充足的显存空间,一旦在某个时刻整个 GPU 显存被占满,而此时所有正在处理的 prompt 都尚未完成推理,该如何应对?
- 当一批请求到达 vLLM 服务器时,vLLM 遵循以下调度原则来安排执行顺序:
- 先来先服务(First-Come-First-Serve, FCFS):优先处理到达时间更早的请求
- 后来先抢占(Preemption):在需要抢占时,优先中断后到达的请求,以保障先到请求的执行
- 先来先服务
- 当多批请求到达 vLLM 服务器时,调度器会优先处理到达时间更早的请求,保证服务的公平性和响应效率
- 后来先抢占
- 当大量请求涌入导致 GPU 显存不足时,vLLM 会优先中断最后到达的一批请求,将其相关的 KV Cache 从 GPU 显存中释放,为更早到达的请求腾出空间,确保它们能完成推理
- 如果不执行抢占,所有请求会因资源争夺陷入死锁,导致无一完成
- 待先到的请求完成后,GPU 显存释放出足够空间,被中断的请求即可恢复执行
- 这种在资源不足时临时暂停部分任务的行为,被称为抢占(preemption)
- 终止和恢复被抢占的请求
- 对于因显存不足被抢占的任务,vLLM 需要完成两个核心操作:
- 暂停任务执行,并释放其相关的 KV Cache
- 当 GPU 显存充足时,恢复任务的执行
- 针对这两个操作,vLLM 设计了 Swapping(交换策略) 和 Recomputation(重计算策略) 两种方案
- Swapping(交换策略)
- 对于被抢占的请求,需要解决两个关键问题:释放哪些 KV Cache?释放到哪里?
- 释放范围:根据 PagedAttention 原理,一个请求对应多个逻辑块;vLLM 采用 all-or-nothing 策略,即释放被抢占请求的所有相关 KV block,而非部分释放
- 释放位置:vLLM 不会直接丢弃这些 KV block,而是将它们从 GPU 显存交换(Swap)到 CPU 内存中暂存;当 GPU 显存充足时,再将这些 block 从 CPU 重载回 GPU,恢复任务执行
- Recomputation(重计算策略)
- 对于部分任务(例如并行采样数 n=1 的任务),当它们被抢占时,vLLM 可以选择不执行 swap,而是直接释放其物理块,将任务重新放回等待队列
- 待后续 GPU 显存充足时,再从 prefill 阶段重新执行推理
- 对于因显存不足被抢占的任务,vLLM 需要完成两个核心操作:
- vLLM 请求调度处理流程总结
- 当一批请求到达 vLLM 服务器时,按照 先来先服务(FCFS) 原则,优先处理最早到达的请求
- 当 GPU 显存不足时,为保障先到请求的完成,vLLM 会对后到的请求执行抢占,临时终止其执行
- 一旦决定执行抢占,vLLM 会暂停处理新请求,将被抢占请求的所有 KV block 全部交换(swap)到 CPU 内存;待交换完成后,再继续处理新请求
- 对于部分序列(seq),vLLM 会直接丢弃其 KV Cache,将任务放回等待队列,后续重新执行 prefill 阶段
分布式 vLLM
- 示意图
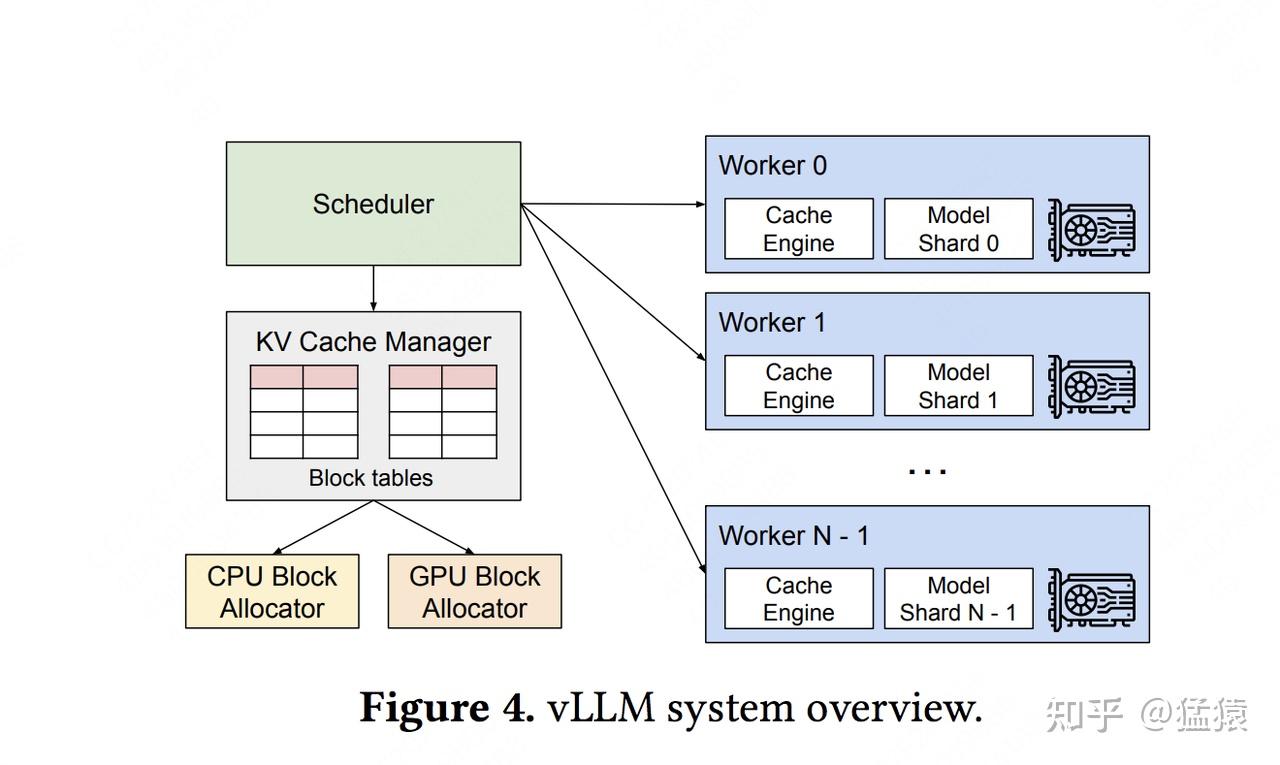
-
中央调度器(Scheduler)
- vLLM 引入了一个中央调度器,它负责统一计算和管理所有 GPU 上的逻辑块到物理块的映射表(block tables),确保全局视角下的 KV Cache 分配和调度
-
广播与执行
- 在进行分布式推理时,中央调度器会将 block tables 广播到各个 GPU 上
- 每个 GPU 上的 Cache engine 接收到映射信息后,负责管理本卡上的 KV block
-
张量并行(Tensor Parallelism)下的特殊处理
- 以上图中基于 Megatron-LM 的张量模型并行(Tensor Parallelism)为例
- 在张量并行模式下,各 GPU 上的输入数据是完全相同的,只是每个 GPU 负责计算不同注意力头(attention head)的 KV Cache
- 因此,各 GPU 上的逻辑块到物理块的映射关系(block table)是完全一致的,只是每个物理块中存储的 KV Cache 数据因负责的注意力头不同而有所差异