Flash Attention

介绍 Flash Attention 技术在注意力机制中的优化

FlashAttention

基本思想

  • 对于 Transformer 类的模型,假设其输入序列长度为 NN,那么其计算复杂度和消耗的存储空间都为 N2N^2​;也就是说随着输入序列的变长,将给计算和存储带来极大的压力

  • 因此迫切需要找到一种方法,能够解决这个复杂度问题

  • FlashAttention 提出了一种显存高效、GPU / TPU friendly 的注意力实现,在保持数值精度的前提下显著降低显存使用,并加速训练和推理

    • FlashAttention 全称为 Fast and Memory Efficient Exact Attention with IO-Awareness

    • Fast(IO-Aware 加速):不通过减少 FLOPs 来加速,而是针对 “读写速度是瓶颈” 的问题,通过分块计算(tiling)和核函数融合(kernel fusion),大幅降低对高带宽显存(HBM)的访问次数,从而提升整体运算速度

    • Memory Efficient(显存高效):标准注意力机制需要计算并保存 N2N^2 大小的注意力矩阵,导致显存压力巨大;Flash Attention 巧妙地避开了这一问题,将存储复杂度降至 O (N),显著节省了显存

    • Exact Attention(精准注意力):与稀疏注意力等近似方法不同,Flash Attention 在实现加速和节省显存的同时,保证了计算结果与标准注意力机制完全等价,没有精度损失

  • 主要贡献包括:

    • 计算 softmax 时,不需要全量 input 数据,可以分段计算

    • 反向传播的时候,不存储 N2N^2 注意力矩阵,而是只存储 softmax 归一化的系数

  • 其优化思路来自于 GPU 的层级结构:

    • GPU 中不同硬件层级在带宽与存储容量上存在显著差异
    • 共享内存 SRAM
      • 虽然容量极小,但具备极高的带宽
      • 以 A100 GPU 为例,其芯片包含 108 个流式多处理器(SM),每个 SM 配备约 192 KB 的片上 SRAM
      • 因此总体 SRAM 容量约为 192 KB×108≈20 MB192\ \text{KB} \times 108 \approx 20\ \text{MB}
      • 尽管容量有限,SRAM 的带宽却可高达约 19 TB/s,远超 GPU 其他层级的存储
    • 普通显存
      • A100 的 HBM(High Bandwidth Memory,即通常所说的 GPU 显存)容量在 40–80 GB 范围内,显著大于 SRAM,但其带宽仅约 1.5 TB/s
      • 这一对比体现出典型的 “容量越大、带宽越低、访问延迟越高” 的存储层级规律
    • FlashAttention 的核心动机在于最大化利用 GPU 片上 SRAM 的超高带宽,然而,SRAM 容量极其有限,通常无法容纳完整的注意力矩阵或标准矩阵乘法所需的全部中间张量
    • 针对这一瓶颈,FlashAttention 的基本策略是对注意力计算过程进行精细化分块,将原本的大规模矩阵运算拆解为可在 SRAM 中容纳的小型计算单元
    • 这些子任务按顺序流式处理,使计算始终在片上完成,从而显著减少对带宽较低的 HBM 的访问次数,实现 Attention 的 IO-optimal 计算
  • 为了实现减少对高带宽内存的访问,具体实现包括两个方面:

    • 增量计算 Softmax 缩减

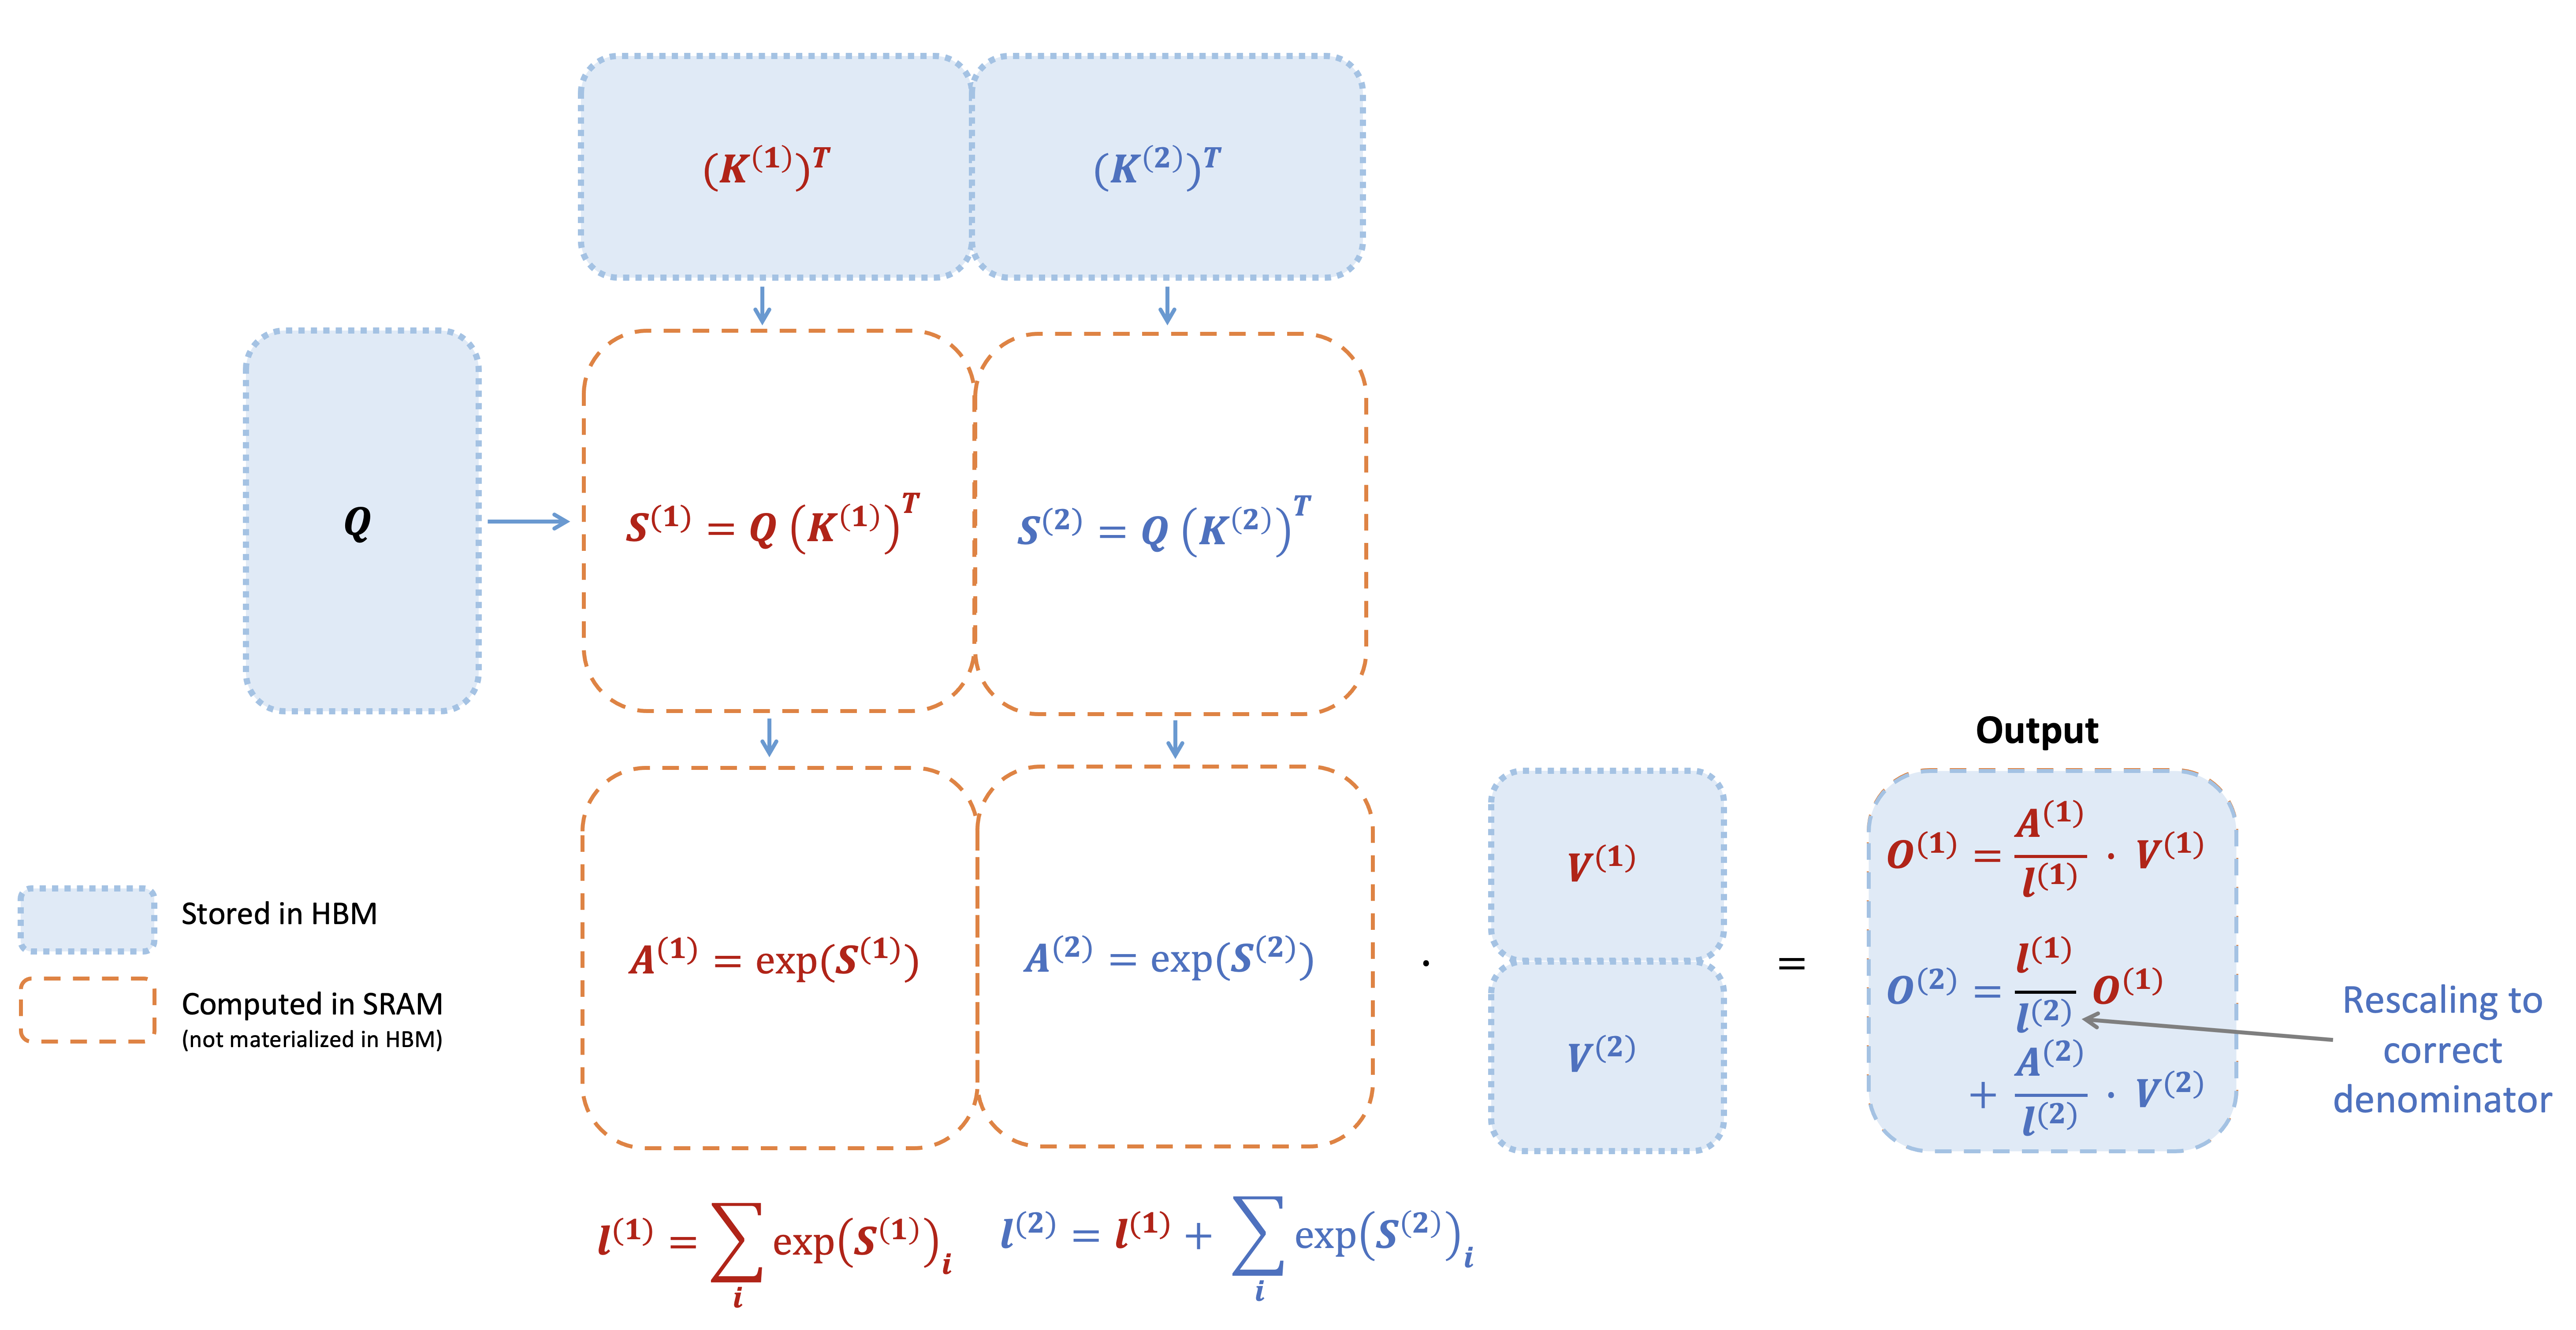
      • 为避免一次性访问整个输入序列以计算 Softmax,FlashAttention 将输入划分为若干块(block),并在每个输入块上多次迭代计算,从而以增量方式完成 Softmax 缩减

      • 设输入矩阵为 X∈RL×dX \in \mathbb {R}^{L \times d},注意力权重为 A=Softmax(QK⊤d)VA = \text{Softmax}\left (\frac {QK^\top}{\sqrt {d}}\right) V,则 FlashAttention 对每个块 XiX_i 分别计算局部最大值和归一化因子,再在全局范围内进行累积,从而高效获得最终 Softmax 输出,而无需同时存储完整的 QK⊤QK^\top

    • 后向传播中减少中间矩阵存储

      • 在标准 Attention 实现中,反向传播通常需要保存中间矩阵 SS 和 PP(例如 Softmax(QK⊤)\text{Softmax}(QK^\top),这也就是 Softmax 中间缓存),其尺寸与序列长度 LL 呈二次关系,导致 HBM 占用量巨大
      • FlashAttention 则通过仅保存归一化因子来避免存储完整的中间注意力矩阵,从而显著降低内存消耗
  • kernel 融合和尽可能利用 SRAM,以减少数据读取时间,都是 flash attention 的重要优化点,例如分块之后 flash attention 将矩阵乘法、mask、softmax、dropout 操作合并成一个 kernel,做到了只读一次和只写回一次,节省了数据读取时间

如何计算 FLOPs

  • 两个矩阵相乘,要怎么统计它们的计算量?

  • 一般用 FLOPs(floating point operations,浮点运算次数)来表示运算量的大小

  • 对于 “两矩阵相乘” 这个操作而言,其运算量 = 乘法运算的次数 + 加法运算的次数
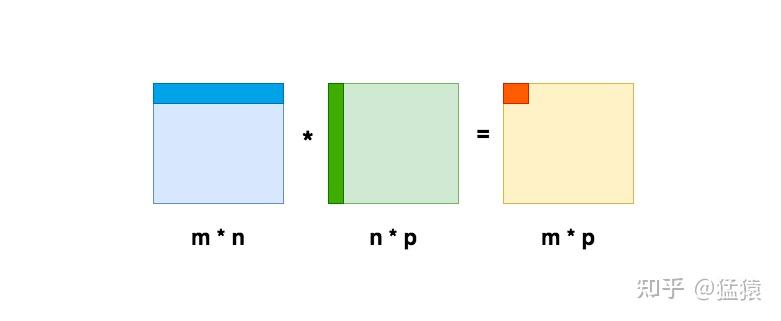
    img

  • 两矩阵相乘,为了获取图中深橘色部分的元素,一共需要进行 n 次乘法运算和 n-1 次加法运算

  • 而结果矩阵中一共有 m×pm\times p 个橘色方块,意味着需要进行:m×p×(n+n−1)m\times p\times(n + n - 1) 次浮点计算

  • 再进一步,假设此时在蓝色和绿色的矩阵外,还有一个 bias 矩阵,意味着计算单个橘色方块时我们需要进行 n 次乘法和 n-1+1 次加法运算,那么此时总计算量为:m∗p∗(n+n)=2mnpm*p*(n+n) = 2mnp

  • 因此,假设有两个矩阵 A 和 B,它们的维度分别为 (m, n) 和 (n, p),则这两矩阵相乘的运算量为 2mnp2mnp

  • 一般在矩阵运算中,乘法运算的时间要高于加法运算的时间,因此有时在统计运算量时,只考虑乘法运算的次数,则此时两矩阵相乘的运算量可近似为 mnp

  • 那么对于注意力机制而言,对于 Q,K∈RN×dQ,K\in \mathbb {R}^{N\times d},其中 N 为序列长度,d 为嵌入维度,那么要计算 S=QKTS=QK^T,其算术强度为

    πtβt=2N2d2Nd+2Nd+2N2=N2d2Nd+N2\frac {\pi_t}{\beta_t} = \frac {2N^2d}{2Nd + 2Nd + 2N^2} = \frac {N^2d}{2Nd + N^2}
  • 对于 A100-40GB SXM 芯片,采用混合精度训练(FP16,每个参数占用 2 字节),其算力与带宽比值为

    πβ=312×10121555×109=201 FLOPs/Bytes\frac {\pi}{\beta} = \frac {312 \times 10^{12}}{1555 \times 10^9} = 201 \ \text{FLOPs/Bytes}
  • 典型的取值如下

    Ndops/bytes受限类型
    2566443<201, memory-bound
    20486460<201, memory-bound
    40966462<201, memory-bound
    25612864<201, memory-bound
    2048128114<201, memory-bound
    4096128120<201, memory-bound
    25625685<201, memory-bound
    2048256205>201, math-bound
    4096256228>201, math-bound
  • 计算限制(math-bound):大矩阵乘法(N 和 d 都非常大)、通道数很大的卷积运算 —— 相对而言,读得快,算得慢

  • 内存限制(memory-bound):逐点运算操作,例如:激活函数、dropout、mask、softmax、BN 和 LN —— 相对而言,算得快,读得慢

标准 Attention 计算

  • 前向计算过程
    • 输入: 位于高带宽内存(HBM)中的矩阵 Q,K,V∈RN×dQ, K, V \in \mathbb {R}^{N \times d}
    • 从 HBM 中按块加载 QQ 和 KK,计算 S=QK⊤S = QK^\top,并将 SS 写回 HBM
    • 从 HBM 中读取 SS,计算 P=softmax(S)P = \text{softmax}(S),并将 PP 写回 HBM
    • 从 HBM 中按块加载 PP 和 VV,计算 O=PVO = PV,并将 OO 写回 HBM
    • 返回 OO​
  • 标准实现需要在 HBM 中存储中间结果 SS 和 PP,并且需要在 SRAM 和 HBM 中读写,带宽开销很大
  • 反向传播过程
    • 输入: 位于高带宽内存(HBM)中的矩阵 Q,K,V,dO∈RN×dQ, K, V, dO \in \mathbb {R}^{N \times d},以及 P∈RN×NP \in \mathbb {R}^{N \times N}

    • 从 HBM 中按块加载 PP 和 dOdO,计算 dV=P⊤dO∈RN×ddV = P^\top dO \in \mathbb {R}^{N \times d},并将 dVdV 写回 HBM

    • 从 HBM 中按块加载 dOdO 和 VV,计算 dP=dOV⊤∈RN×NdP = dO V^\top \in \mathbb {R}^{N \times N},并将 dPdP 写回 HBM

    • 从 HBM 中读取 PP 和 dPdP,计算 dS∈RN×NdS \in \mathbb {R}^{N \times N},其中 dSij=Pij(dPij−∑lPildPil)dS_{ij} = P_{ij}\left (dP_{ij} - \sum_l P_{il} dP_{il}\right),并将 dSdS 写回 HBM

    • 从 HBM 中按块加载 dSdS 和 KK,计算 dQ=dSKdQ = dS K,并将 dQdQ 写回 HBM

    • 从 HBM 中按块加载 dSdS 和 QQ,计算 dK=dS⊤QdK = dS^\top Q,并将 dKdK 写回 HBM

    • 返回 dQ,dK,dVdQ, dK, dV

分块 Tiling

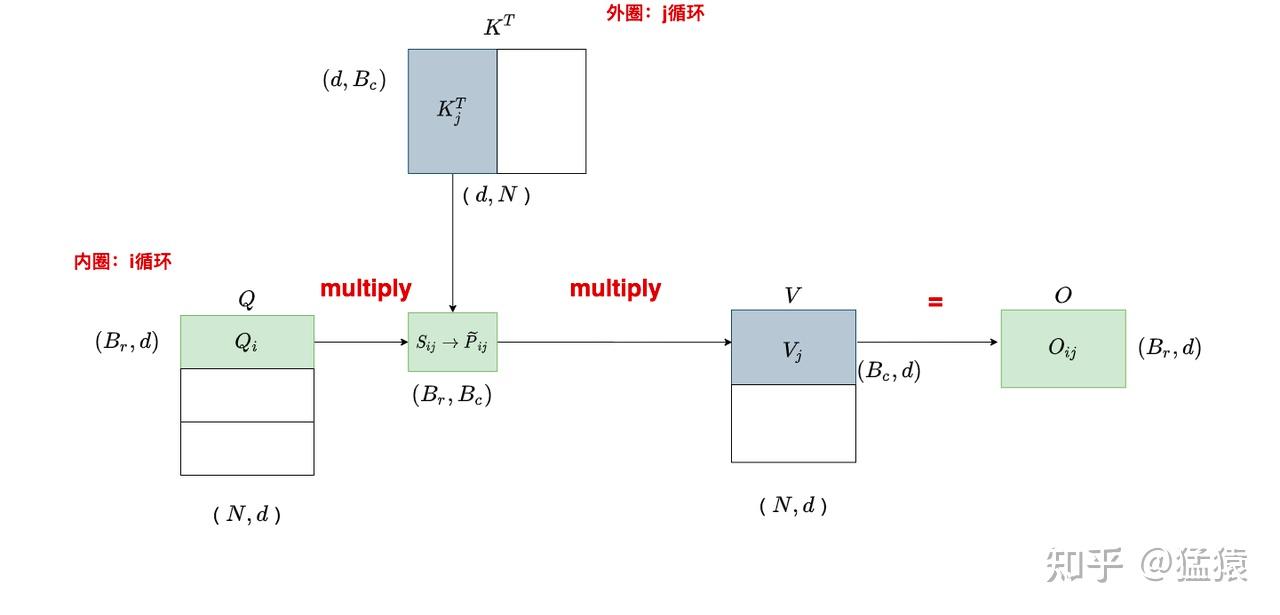
  • 如何对 Q/K/V 矩阵进行分块?

    img

  • Q 矩阵分块

    • 将 QQ 矩阵切分为 TrT_r 个块(block),每块长度为 BrB_r
    • 用 QiQ_i 表示切完后的某块矩阵,维度为 (Br,d)(B_r, d)
    • QiQ_i 中存储着某 BrB_r​ 个 token 的 query 信息
  • KTK^T 矩阵分块

    • 将 KTK^T 矩阵切分为 TcT_c 个块,每块长度为 BcB_c
    • 用 KjTK_j^T 表示切完后的某块矩阵,维度为 (d,Bc)(d, B_c)
    • KjTK_j^T 中存储着某 BcB_c​ 个 token 的 key 信息
  • V 矩阵分块

    • 将 VV 矩阵也切分为 TcT_c 个块,每块长度为 BcB_c
    • 用 VjV_j 表示切完后的某块矩阵,维度为 (Bc,d)(B_c, d)
    • VjV_j 中存储着某 BcB_c​ 个 token 的 value 信息
  • 初始注意力分数 SijS_{ij} 表示前 BrB_r 个 token 和前 BcB_c 个 token 间的原始相关性分数

    Sij=Qi×KjT=(Br,d)×(d,Bc)=(Br,Bc)S_{ij} = Q_i \times K_j^T = (B_r, d) \times (d, B_c) = (B_r, B_c)
  • 对初始注意力分数 SijS_{ij} 执行 safe softmax、mask 和 dropout 操作,得到中间结果 P~ij\widetilde {P}_{ij}

    • P~ij\widetilde {P}_{ij} 是分块计算中的归一化中间结果,而非最终的 PijP_{ij}
    • 在分块计算的细节中,只需用到 P~ij\widetilde {P}_{ij} 即可完成后续步骤,符号 PP​ 代表归一化后的注意力权重
  • 计算分块输出:

    Oij=P~ij×Vj=(Br,Bc)×(Bc,d)=(Br,d)O_{ij} = \widetilde {P}_{ij} \times V_j = (B_r, B_c) \times (B_c, d) = (B_r, d)
    • 维度上 OijO_{ij} 符合预期的 (Br,d)(B_r, d),但其内容是前 BrB_r 个 token 与前 BcB_c 个 token 的注意力结果,并非最终输出
    • 正常情况下,前 BrB_r 个 token 的最终输出应与所有 token 做注意力计算,而 OijO_{ij}​ 只是局部块的中间结果,需要通过后续分块累加得到完整输出
  • 在计算这些分块时,GPU 是可以做并行计算的,这也提升了计算效率

  • 循环流程如下:

    # ---------------------
    # Tc: K和V的分块数
    # Tr: Q的分块数量
    # ---------------------
    for 1 <= j <= Tc:
        for 1 <= i <= Tr:
            do....
  • 决定如何进行分块后,接下来就需要考虑

    • 分块后,如何正确计算注意力分数
    • 分块后,如何正确计算输出 O
    • 分块后,如何解决 memory-bound 问题

分块计算 Softmax

  • Softmax 运算涉及指数函数,为避免数值溢出,可对输入向量每个元素减去最大值(max-shift)

  • 定义如下:

    m(x):=max⁡ixif(x):=[ex1−m(x),…,exB−m(x)]ℓ(x):=∑if(x)i\begin {align*} m (x) &:= \max_i x_i \\ f (x) &:= \left [e^{x_1 - m (x)}, \ldots, e^{x_B - m (x)}\right] \\ \ell (x) &:= \sum_i f (x)_i \end {align*}
  • 则 Softmax 表示为:

    softmax⁡(x)=f(x)ℓ(x)softmax(xi)=exi−m(x)∑j=1dexj−m(x)\operatorname {softmax}(x) = \frac {f (x)}{\ell (x)}\\ softmax (x_i) = \frac {e^{x_i - m (x)}}{\sum_{j=1}^d e^{x_j - m (x)}}
  • 考虑将一行数据 x∈R2Bx \in \mathbb {R}^{2B} 切分为两部分 x=[x(1),x(2)]x = [x^{(1)}, x^{(2)}],其中 x(1),x(2)∈RBx^{(1)}, x^{(2)} \in \mathbb {R}^B,则 Softmax 可按块计算如下:

  • 最大值分解:

    m(x)=max⁡(m(x(1)), m(x(2)))m (x) = \max\big (m (x^{(1)}),\ m (x^{(2)})\big)
  • 指数向量分解:

    f(x)=[em(x(1))−m(x)f(x(1)),⋯ ,em(x(2))−m(x)f(x(2))]f (x) = \left [e^{m (x^{(1)}) - m (x)} f (x^{(1)}) ,\cdots, e^{m (x^{(2)}) - m (x)} f (x^{(2)}) \right]
  • 归一化项(分母)分解:

    ℓ(x)=em(x(1))−m(x)ℓ(x(1))+em(x(2))−m(x)ℓ(x(2))\ell (x) = e^{m (x^{(1)}) - m (x)} \ell (x^{(1)}) + e^{m (x^{(2)}) - m (x)} \ell (x^{(2)})
  • 最终 Softmax 表达:

    softmax⁡(x)=f(x)ℓ(x)=[e(m(x(1))−m(x))f(x(1)),e(m(x(2))−m(x))f(x(2))]em(x(1))−m(x)l(x(1))+em(x(2))−m(x)l(x(2))\operatorname {softmax}(x) = \frac {f (x)}{\ell (x)} = \frac {\left [e^{(m (x^{(1)}) - m (x))} f (x^{(1)}), e^{(m (x^{(2)}) - m (x))} f (x^{(2)})\right]}{e^{m (x^{(1)}) - m (x)} l (x^{(1)}) + e^{m (x^{(2)}) - m (x)} l (x^{(2)})}
  • 可见,在计算各块 f(x)f (x) 时,需要乘上不同的系数 em(x(k))−m(x)e^{m (x^{(k)}) - m (x)},但整体结果等价于对整行向量使用数值稳定的 Softmax 运算

  • 例如,对于 x(1)x^{(1)}:

    em(x(1))−m(x)f(x(1))=em(x(1))−m(x)[ex1(1)−m(x(1)),…,exB(1)−m(x(1))]=[ex1(1)−m(x),…,exB(1)−m(x)]em(x(1))−m(x) ℓ(x(1))=em(x(1))−m(x)⋅∑i=1Bexi(1)−m(x(1))=∑i=1B(em(x(1))−m(x)⋅exi(1)−m(x(1)))=∑i=1Be m(x(1))−m(x)  +  xi(1)−m(x(1))=∑i=1Be xi(1)−m(x)\begin {align*} e^{m (x^{(1)}) - m (x)} f (x^{(1)}) &= e^{m (x^{(1)}) - m (x)} \left [e^{x_1^{(1)} - m (x^{(1)})}, \ldots, e^{x_B^{(1)} - m (x^{(1)})}\right] \\ &= \left [e^{x_1^{(1)} - m (x)}, \ldots, e^{x_B^{(1)} - m (x)}\right]\\ e^{m (x^{(1)}) - m (x)}\,\ell (x^{(1)}) &= e^{m (x^{(1)}) - m (x)} \cdot \sum_{i=1}^B e^{x_i^{(1)} - m (x^{(1)})} \\ &= \sum_{i=1}^B \Big (e^{m (x^{(1)}) - m (x)} \cdot e^{x_i^{(1)} - m (x^{(1)})} \Big) \\ &= \sum_{i=1}^B e^{\,m (x^{(1)}) - m (x)\;+\;x_i^{(1)} - m (x^{(1)})} \\ &= \sum_{i=1}^B e^{\,x_i^{(1)} - m (x)} \end {align*}
  • 通过以上推导可以得出,分块计算 Softmax 保持了与整行计算一致的数值稳定性

  • 分块计算 safe softmax 的核心意义,就是彻底抹去了对 SS 和 PP​ 的读写需求:

    • 需要访存什么内容?

      • 通过上述方式,在整个计算过程中,只有 mim_i(最大值)、lil_i(归一化项)、OiO_i(输出块)这三个中间结果需要从片上 SRAM 写回到显存(HBM);遍历完所有块后,总读写量仅为 mm、ll、OO
      • 而原先需要读写的张量包括 SS(注意力分数矩阵)、PP(归一化后的注意力权重)、OO​(输出),读写量远大于 Flash Attention
    • 由此可知,引入分块计算 saft softmax 后,不再需要将巨大的 O(N2)O (N^2) 注意力矩阵 SS 和 PP 写入显存,也无需在反向传播时再次读取

    • 这直接解决了标准注意力中 memory-bound(内存受限) 的问题,大幅提升了计算效率和可扩展性

  • 如何逐步更新输出 O?

    • 在循环中不断用当前最新的 rowmax 和 rowsum 去更新,直到遍历完最后一块,就是标准场景下的结果

      Oi(j+1)=Pi,:j+1V:j+1=softmax(Si,:j+1)V:j+1=diag(l(j+1))−1[exp([Si,:j,Si(j+1)]−m(j+1))][V:jVj+1]=diag(l(j+1))−1[exp(Si,:j−m(j+1))V:j+exp(Si(j+1)−m(j+1))Vj+1)]=diag(l(j+1))−1[e−m(j+1)exp(Si,:j)V:j+e−m(j+1)exp(Si(j+1))Vj+1)]=diag(l(j+1))−1[diag(l(j))em(j)−m(j+1)diag(l(j))−1exp(Si,:j−m(j))V:j+e−m(j+1)exp(Si(j+1))Vj+1)]=diag(l(j+1))−1[diag(l(j))em(j)−m(j+1)Pi,:jV:j+e−m(j+1)exp(Si(j+1))Vj+1)]=diag(l(j+1))−1[diag(l(j))em(j)−m(j+1)Oi(j)+em~−m(j+1)exp(Si(j+1)−m~)Vj+1]=diag(l(j+1))−1[diag(l(j))em(j)−m(j+1)Oi(j)+em~−m(j+1)P~i(j+1)Vj+1]\begin {aligned} O^{(j+1)}_{i}&= P_{i,:j+1} V_{:j+1}\\ &= softmax (S_{i,:j+1}) V_{:j+1}\\ &= diag (l^{(j+1)})^{-1}[exp ([S_{i,:j}, S_{i (j+1)}]-m^{(j+1)})]\begin {bmatrix} V_{:j}\\V_{j+1} \end {bmatrix}\\ &= diag (l^{(j+1)})^{-1}[exp (S_{i,:j}-m^{(j+1)}) V_{:j} + exp (S_{i (j+1)}-m^{(j+1)}) V_{j+1})]\\ &= diag (l^{(j+1)})^{-1}[e^{-m^{(j+1)}} exp (S_{i,:j}) V_{:j} + e^{-m^{(j+1)}} exp (S_{i (j+1)}) V_{j+1})]\\ &= diag (l^{(j+1)})^{-1}[diag (l^{(j)}) e^{m^{(j)}-m^{(j+1)}} diag (l^{(j)})^{-1} exp (S_{i,:j}-m^{(j)}) V_{:j} + e^{-m^{(j+1)}} exp (S_{i (j+1)}) V_{j+1})]\\ &= diag (l^{(j+1)})^{-1}[diag (l^{(j)}) e^{m^{(j)}-m^{(j+1)}}{P}_{i,:j} V_{:j} + e^{-m^{(j+1)}} exp (S_{i (j+1)}) V_{j+1})]\\ &= diag (l^{(j+1)})^{-1}[diag (l^{(j)}) e^{m^{(j)}-m^{(j+1)}} O^{(j)}_{i} + e^{\widetilde {m}-m^{(j+1)}} exp (S_{i (j+1)}-\widetilde {m}) V_{j+1}]\\ &= diag (l^{(j+1)})^{-1}[diag (l^{(j)}) e^{m^{(j)}-m^{(j+1)}} O^{(j)}_{i} + e^{\widetilde {m}-m^{(j+1)}}\widetilde {P}_{i (j+1)} V_{j+1}] \end {aligned}
    • 符号约定

      • Oi(j+1)O_i^{(j+1)}:第 ii 行,处理完前 j+1j+1 个分块后的输出
      • Pi,:j+1P_{i,:j+1}:第 ii 行,前 j+1j+1 个分块对应的 attention 权重(已归一化)
      • V:j+1V_{:j+1}:前 j+1j+1 个分块对应的 value 矩阵
      • Si,:j+1S_{i,:j+1}:第 ii 行,前 j+1j+1 个分块对应的 score 矩阵
      • m(j)m^{(j)}:前 jj 个分块对应的 rowmax(用于数值稳定)
      • l(j)l^{(j)}:前 jj 个分块对应的 rowsum(用于归一化)
      • m~\widetilde {m}:当前分块 j+1j+1 的局部 rowmax
      • P~i(j+1)\widetilde {P}_{i (j+1)}:当前分块 j+1j+1 的局部 attention 权重(未全局归一化)
    • 第一行:目标定义

      Oi(j+1)=Pi,:j+1V:j+1O_i^{(j+1)} = P_{i,:j+1} V_{:j+1}
      • 这是期望的结果:每处理完一个分块,就更新一次输出 OiO_i
      • 这里 Pi,:j+1P_{i,:j+1} 是用最新的 rowmax 和 rowsum 更新后的归一化 attention 权重,V:j+1V_{:j+1} 是前 j+1j+1 个分块的 value 矩阵
    • 第二行:softmax 展开

      Oi(j+1)=softmax(Si,:j+1)V:j+1O_i^{(j+1)} = \text{softmax}(S_{i,:j+1}) V_{:j+1}
      • 将 attention 权重 PP 显式写成对 score SS 做 softmax 的形式
      • 注意,这里的 Si,:j+1S_{i,:j+1} 包含了所有独立分块的 score,在计算 softmax 时,会用最新的 rowmax 和 rowsum 来更新 PP
    • 第三行:分块展开

      Oi(j+1)=diag(l(j+1))−1[exp⁡([Si,:j,Si(j+1)]−m(j+1))][V:jVj+1]O_i^{(j+1)} = \text{diag}(l^{(j+1)})^{-1} \left [\exp\left ([S_{i,:j}, S_{i (j+1)}] - m^{(j+1)}\right) \right] \begin {bmatrix} V_{:j} \\ V_{j+1} \end {bmatrix}
      • 为了实现分块计算,把前 j+1j+1 个分块拆成「前 jj 个分块」和「当前第 j+1j+1 个分块」两部分:
        • Si,:j+1→[Si,:j,Si(j+1)]S_{i,:j+1} \to [S_{i,:j}, S_{i (j+1)}]
        • V:j+1→[V:jVj+1]V_{:j+1} \to \begin {bmatrix} V_{:j} \\ V_{j+1} \end {bmatrix}
        • 同时,用 diag(l(j+1))−1\text{diag}(l^{(j+1)})^{-1} 来实现归一化,用 m(j+1)m^{(j+1)} 做数值稳定
    • 第四行:矩阵乘法分配律

      Oi(j+1)=diag(l(j+1))−1[exp⁡(Si,:j−m(j+1))V:j+exp⁡(Si(j+1)−m(j+1))Vj+1]O_i^{(j+1)} = \text{diag}(l^{(j+1)})^{-1} \left [\exp (S_{i,:j} - m^{(j+1)}) V_{:j} + \exp (S_{i (j+1)} - m^{(j+1)}) V_{j+1} \right]
      • 这是简单的代数变形,将矩阵乘法分配到两个分块上,把求和拆成了两部分
    • 第五行:指数项分离常数

      Oi(j+1)=diag(l(j+1))−1[e−m(j+1)exp⁡(Si,:j)V:j+e−m(j+1)exp⁡(Si(j+1))Vj+1]O_i^{(j+1)} = \text{diag}(l^{(j+1)})^{-1} \left [e^{-m^{(j+1)}} \exp (S_{i,:j}) V_{:j} + e^{-m^{(j+1)}} \exp (S_{i (j+1)}) V_{j+1} \right]
      • 利用指数性质 exp⁡(a−b)=e−bexp⁡(a)\exp (a - b) = e^{-b} \exp (a) ,把 −m(j+1)-m^{(j+1)} 从指数里提出来,作为公因子 e−m(j+1)e^{-m^{(j+1)}}
    • 第六行:引入前一轮输出 Oi(j)O_i^{(j)}

      Oi(j+1)=diag(l(j+1))−1[diag(l(j))em(j)−m(j+1)diag(l(j))−1exp⁡(Si,:j−m(j))V:j⏟Oi(j)+e−m(j+1)exp⁡(Si(j+1))Vj+1]O_i^{(j+1)} = \text{diag}(l^{(j+1)})^{-1} \left [\text{diag}(l^{(j)}) e^{m^{(j)} - m^{(j+1)}} \underbrace {\text{diag}(l^{(j)})^{-1} \exp (S_{i,:j} - m^{(j)}) V_{:j}}_{O_i^{(j)}} + e^{-m^{(j+1)}} \exp (S_{i (j+1)}) V_{j+1} \right]
      • 这是最关键的一步,目的是把前一轮的输出 Oi(j)O_i^{(j)} 代入进来,实现增量更新:
        • 我们知道 Oi(j)=softmax(Si,:j)V:j=diag(l(j))−1exp⁡(Si,:j−m(j))V:jO_i^{(j)} = \text{softmax}(S_{i,:j}) V_{:j} = \text{diag}(l^{(j)})^{-1} \exp (S_{i,:j} - m^{(j)}) V_{:j}
        • 所以 exp⁡(Si,:j)V:j=diag(l(j))em(j)Oi(j)\exp (S_{i,:j}) V_{:j} = \text{diag}(l^{(j)}) e^{m^{(j)}} O_i^{(j)}
        • 代入后,就得到了用 Oi(j)O_i^{(j)} 表示的前半部分,同时用 em(j)−m(j+1)e^{m^{(j)} - m^{(j+1)}} 抵消了前后两次 rowmax 引入的差异
    • 第七行:显式写出 Oi(j)O_i^{(j)}

      Oi(j+1)=diag(l(j+1))−1[diag(l(j))em(j)−m(j+1)Oi(j)+e−m(j+1)exp⁡(Si(j+1))Vj+1]O_i^{(j+1)} = \text{diag}(l^{(j+1)})^{-1} \left [\text{diag}(l^{(j)}) e^{m^{(j)} - m^{(j+1)}} O_i^{(j)} + e^{-m^{(j+1)}} \exp (S_{i (j+1)}) V_{j+1} \right]
      • 把上一步中代表 Oi(j)O_i^{(j)} 的部分直接写出来,公式的结构就清晰了:前半部分是对历史信息的复用,后半部分是当前分块的新信息
    • 第八行:引入局部归一化 P~\widetilde {P}

      Oi(j+1)=diag(l(j+1))−1[diag(l(j))em(j)−m(j+1)Oi(j)+em~−m(j+1)exp⁡(Si(j+1)−m~)Vj+1⏟P~i(j+1)Vj+1]O_i^{(j+1)} = \text{diag}(l^{(j+1)})^{-1} \left [\text{diag}(l^{(j)}) e^{m^{(j)} - m^{(j+1)}} O_i^{(j)} + e^{\widetilde {m} - m^{(j+1)}} \underbrace {\exp (S_{i (j+1)} - \widetilde {m}) V_{j+1}}_{\widetilde {P}_{i (j+1)} V_{j+1}} \right]
      • 为了让表达更统一,也为了在计算 rowsum 时避免直接操作大矩阵 SS ,引入当前分块的局部 rowmax m~\widetilde {m},将当前分块的项重写为局部归一化的 P~i(j+1)\widetilde {P}_{i (j+1)}
    • 第九行:最终增量更新公式

      Oi(j+1)=diag(l(j+1))−1[diag(l(j))em(j)−m(j+1)Oi(j)+em~−m(j+1)P~i(j+1)Vj+1]O_i^{(j+1)} = \text{diag}(l^{(j+1)})^{-1} \left [\text{diag}(l^{(j)}) e^{m^{(j)} - m^{(j+1)}} O_i^{(j)} + e^{\widetilde {m} - m^{(j+1)}} \widetilde {P}_{i (j+1)} V_{j+1} \right]
    • 这就是最终的增量更新公式,它清晰地表明:

      • 新的输出 Oi(j+1)O_i^{(j+1)} 是在旧输出 Oi(j)O_i^{(j)} 的基础上,加上当前分块的贡献 P~i(j+1)Vj+1\widetilde {P}_{i (j+1)} V_{j+1}
      • 所有的系数 em(j)−m(j+1)e^{m^{(j)} - m^{(j+1)}}、em~−m(j+1)e^{\widetilde {m} - m^{(j+1)}} 和 diag(l(j+1))−1\text{diag}(l^{(j+1)})^{-1}​​ 都是为了保证数值稳定性和正确的归一化
    • 总结来看

      • 保留历史结果:不丢弃上一轮算好的 Oi(j)O_i^{(j)},只乘以一个缩放系数 em(j)−m(j+1)e^{m^{(j)}-m^{(j+1)}}(因为最大值更新了,要对齐数值尺度)

      • 计算新增块贡献:只在片上算当前新块的 P~i(j+1)Vj+1\widetilde {P}_{i (j+1)} V_{j+1},不生成全局矩阵

      • 合并得到新输出

        Oi(j+1)=缩放×旧O⏟历史贡献+缩放×新块计算值⏟新增贡献新归一化项l(j+1)O_i^{(j+1)} = \frac {\underbrace {\text{缩放} \times 旧 O}_{\text{历史贡献}} + \underbrace {\text{缩放} \times 新块计算值}_{\text{新增贡献}} }{\text{新归一化项} l^{(j+1)}}
      • 写回 HBM,循环继续:只用很小的空间存 O,m,lO, m, l,全程不生成 N×NN×N 矩阵

  • 完整的前向计算流程

    • 输入:位于高带宽内存(HBM)中的矩阵 Q,K,V∈RN×dQ, K, V \in \mathbb {R}^{N \times d},片上 SRAM 大小为 MM

    • 设置块大小:Bc=⌈M4d⌉, Br=min⁡(⌈M4d⌉,d)B_c = \left\lceil \frac {M}{4d} \right\rceil,\ B_r = \min\left (\left\lceil \frac {M}{4d} \right\rceil, d\right)

    • 在 HBM 中初始化:O=(0)N×d∈RN×d, ℓ=(0)N∈RN, m=(−∞)N∈RNO = (0)_{N \times d} \in \mathbb {R}^{N \times d},\ \ell = (0)_N \in \mathbb {R}^N,\ m = (-\infty)_N \in \mathbb {R}^N

    • 数据分块(Q/K/V):

      • 将 QQ 划分为 Tr=⌈NBr⌉T_r = \left\lceil \frac {N}{B_r} \right\rceil 个块 Q1,…,QTrQ_1, \dots, Q_{T_r},每个大小为 Br×dB_r \times d
      • 将 K,VK, V 划分为 Tc=⌈NBc⌉T_c = \left\lceil \frac {N}{B_c} \right\rceil 个块 K1,…,KTcK_1, \dots, K_{T_c} 和 V1,…,VTcV_1, \dots, V_{T_c},每个大小为 Bc×dB_c \times d
    • 结果分块(O/ℓ/m):

      • 将 OO 划分为 TrT_r 个块 O1,…,OTrO_1, \dots, O_{T_r},每个大小为 Br×dB_r \times d
      • 将 ℓ\ell 划分为 TrT_r 个块 ℓ1,…,ℓTr\ell_1, \dots, \ell_{T_r},每个大小为 BrB_r
      • 将 mm 划分为 TrT_r 个块 m1,…,mTrm_1, \dots, m_{T_r},每个大小为 BrB_r
    • 外层循环(遍历 K/V 块):

      • for 1≤j≤Tc1 \leq j \leq T_cdo
      • 从 HBM 加载 Kj,VjK_j, V_j 到片上 SRAM
      • 内层循环(遍历 Q 块):
        • for 1≤i≤Tr1 \leq i \leq T_rdo
        • 从 HBM 加载 Qi,Oi,ℓi,miQ_i, O_i, \ell_i, m_i 到片上 SRAM
        • 片上计算注意力分数:Sij=QiKj⊤∈RBr×BcS_{ij} = Q_i K_j^\top \in \mathbb {R}^{B_r \times B_c}
        • 片上计算 Softmax 中间值:
          • m~ij=rowmax(Sij)∈RBr\tilde {m}_{ij} = \text{rowmax}(S_{ij}) \in \mathbb {R}^{B_r}
          • P~ij=exp⁡(Sij−m~ij)∈RBr×Bc\tilde {P}_{ij} = \exp (S_{ij} - \tilde {m}_{ij}) \in \mathbb {R}^{B_r \times B_c}(逐元素计算)
          • ℓ~ij=rowsum(P~ij)∈RBr\tilde {\ell}_{ij} = \text{rowsum}(\tilde {P}_{ij}) \in \mathbb {R}^{B_r}
        • 片上更新 Softmax 统计量:
          • minew=max⁡(mi,m~ij)∈RBrm_i^{\text{new}} = \max (m_i, \tilde {m}_{ij}) \in \mathbb {R}^{B_r}
          • ℓinew=emi−minewℓi+em~ij−minewℓ~ij∈RBr\ell_i^{\text{new}} = e^{m_i - m_i^{\text{new}}} \ell_i + e^{\tilde {m}_{ij} - m_i^{\text{new}}} \tilde {\ell}_{ij} \in \mathbb {R}^{B_r}
        • 更新输出并写回 HBM:
          • Oi←diag(ℓinew)−1(diag(ℓi)emi−minewOi+em~ij−minewP~ijVj)O_i \leftarrow \text{diag}(\ell_i^{\text{new}})^{-1} \left (\text{diag}(\ell_i) e^{m_i - m_i^{\text{new}}} O_i + e^{\tilde {m}_{ij} - m_i^{\text{new}}} \tilde {P}_{ij} V_j \right)
        • 将更新后的 ℓinew、minew\ell_i^{\text{new}}、m_i^{\text{new}} 写回 HBM
        • end for
      • end for
    • 返回最终输出 OO

Softmax 的求导

  • 设

    {y=softmax(z)L=f(y)\begin {cases} y = softmax (z) \\ L = f (y) \end {cases}
  • 其中,LL 表示 Loss, f(.)f (.) 表示 Loss 函数,y=[y1y2y3]y = \begin {bmatrix} y_1 & y_2 & y_3 \end {bmatrix}, z=[z1z2z3]z = \begin {bmatrix} z_1 & z_2 & z_3 \end {bmatrix},若现在我们想求 ∂L∂zj\frac {\partial L}{\partial z_j},要怎么算呢?

  • 根据链式法则,有 ∂L∂zj=∂L∂y∂y∂zj\frac {\partial L}{\partial z_j} = \frac {\partial L}{\partial y} \frac {\partial y}{\partial z_j}, 所以分别来看这两项

    • ∂L∂y\frac {\partial L}{\partial y}:现在不考虑具体的 Loss 函数,直接假设这一项的结果为 [m1m2m3]\begin {bmatrix} m_1 & m_2 & m_3 \end {bmatrix}
    • ∂y∂zj\frac {\partial y}{\partial z_j}:对于某个 zjz_j 来说,在 softmax 的操作下,它参与了 y1,y2,y3y_1, y_2, y_3 三者的计算,因此它的偏导也和这三者密切相关,这里分成两种情况:
    {∂yi∂zj=yi(1−yi),当i=j∂yi∂zj=−yiyj,当i≠j\begin {cases} \frac {\partial y_i}{\partial z_j} = y_i (1 - y_i), & \text{当} i = j \\ \frac {\partial y_i}{\partial z_j} = -y_i y_j, & \text{当} i \neq j \end {cases}
  • 有了这个理解,再来谈谈基于 y=softmax(z)y = softmax (z) 的 Jacobian 矩阵 diag(y)−yTydiag (y) - y^T y:

    diag(y)−yTy=[y1000y2000y3]−[y1y2y3]∗[y1y2y3]=[y1−y12−y1y2−y1y3−y2y1y2−y22−y2y3−y3y1−y3y2y3−y32]diag (y) - y^T y = \begin {bmatrix} y_1 & 0 & 0 \\ 0 & y_2 & 0 \\ 0 & 0 & y_3 \end {bmatrix} - \begin {bmatrix} y_1 \\ y_2 \\ y_3 \end {bmatrix} * \begin {bmatrix} y_1 & y_2 & y_3 \end {bmatrix} = \begin {bmatrix} y_1 - y_1^2 & -y_1 y_2 & -y_1 y_3 \\ -y_2 y_1 & y_2 - y_2^2 & -y_2 y_3 \\ -y_3 y_1 & -y_3 y_2 & y_3 - y_3^2 \end {bmatrix}
  • 很容易发现只要把每行 / 每列相加,就能得到对应 zz 的偏导

    ∂L∂zj=∂L∂y∂y∂zj\frac {\partial L}{\partial z_j} = \frac {\partial L}{\partial y} \frac {\partial y}{\partial z_j}
  • 推导 ∂L∂zj\frac {\partial L}{\partial z_j},有:

    ∂L∂zj=∂L∂y∂y∂zj=∑i=1l∂L∂yi∂yi∂zj=yj(dyj−∑j=1lyjdyj)\frac {\partial L}{\partial z_j} = \frac {\partial L}{\partial y} \frac {\partial y}{\partial z_j} = \sum_{i=1}^{l} \frac {\partial L}{\partial y_i} \frac {\partial y_i}{\partial z_j} = y_j \left (\mathrm {d} y_j - \sum_{j=1}^{l} y_j \mathrm {d} y_j \right)
  • 例如,现在想求 ∂L∂z1\frac {\partial L}{\partial z_1},将 ∂L∂y=[m1m2m3]\frac {\partial L}{\partial y} = \begin {bmatrix} m_1 & m_2 & m_3 \end {bmatrix} 代入上面公式,则有:

    ∂L∂z1=m1(y1−y12)−m2y1y2−m3y1y3\frac {\partial L}{\partial z_1} = m_1 (y_1 - y_1^2) - m_2 y_1 y_2 - m_3 y_1 y_3
  • 针对所有的 zz,将 ∂L∂z\frac {\partial L}{\partial z} 写成矩阵表达式有:

    ∂L∂z=∂L∂y∂y∂z=dy(diag(y)−yTy)=[m1m2m3]([y1000y2000y3]−[y1y2y3][y1y2y3])=[m1m2m3][y1−y12−y1y2−y1y3−y2y1y2−y22−y2y3−y3y1−y3y2y3−y32]\begin {align*} \frac {\partial L}{\partial z} &= \frac {\partial L}{\partial y} \frac {\partial y}{\partial z} = \mathrm {d} y \left (diag (y) - y^T y \right) \\ &= \begin {bmatrix} m_1 & m_2 & m_3 \end {bmatrix} \left (\begin {bmatrix} y_1 & 0 & 0 \\ 0 & y_2 & 0 \\ 0 & 0 & y_3 \end {bmatrix} - \begin {bmatrix} y_1 \\ y_2 \\ y_3 \end {bmatrix} \begin {bmatrix} y_1 & y_2 & y_3 \end {bmatrix} \right) \\ &= \begin {bmatrix} m_1 & m_2 & m_3 \end {bmatrix} \begin {bmatrix} y_1 - y_1^2 & -y_1 y_2 & -y_1 y_3 \\ -y_2 y_1 & y_2 - y_2^2 & -y_2 y_3 \\ -y_3 y_1 & -y_3 y_2 & y_3 - y_3^2 \end {bmatrix} \end {align*}
  • 至此,有两个重要的结论:

    ∂L∂z=∂L∂y∂y∂z=dy(diag(y)−yTy)∂L∂zj=yj(dyj−∑j=1lyjdyj)\frac {\partial L}{\partial z} = \frac {\partial L}{\partial y} \frac {\partial y}{\partial z} = \mathrm {d} y \left (diag (y) - y^T y \right)\\ \frac {\partial L}{\partial z_j} = y_j \left (\mathrm {d} y_j - \sum_{j=1}^{l} y_j \mathrm {d} y_j \right)

反向传播

  • 标准反向传播的算法流程如下

  • 为表达简便,省略 mask、dropout 等操作,假设损失函数为 f(.)f (.):

    S=QKTP=softmax(S)O=PVL=f(O) \begin {align*} S &= QK^T \\ P &= softmax (S) \\ O &= PV \\ L &= f (O) \end {align*}
    • 已知梯度 dO∈RN×d\mathrm {d} O \in \mathbb {R}^{N \times d},按以下步骤计算梯度 dQ,dK,dV\mathrm {d} Q, \mathrm {d} K, \mathrm {d} V​:

    • 输入: 位于高带宽内存(HBM)中的矩阵 Q,K,V,dO∈RN×dQ, K, V, dO \in \mathbb {R}^{N \times d},以及 P∈RN×NP \in \mathbb {R}^{N \times N}

      • 从 HBM 中按块加载 PP 和 dOdO,计算 dV=P⊤dO∈RN×ddV = P^\top dO \in \mathbb {R}^{N \times d},并将 dVdV 写回 HBM
      • 从 HBM 中按块加载 dOdO 和 VV,计算 dP=dOV⊤∈RN×NdP = dO V^\top \in \mathbb {R}^{N \times N},并将 dPdP 写回 HBM
      • 从 HBM 中读取 PP 和 dPdP,计算 dS∈RN×NdS \in \mathbb {R}^{N \times N},其中 dSij=Pij(dPij−∑lPildPil)dS_{ij} = P_{ij}\left (dP_{ij} - \sum_l P_{il} dP_{il}\right),并将 dSdS 写回 HBM
      • 从 HBM 中按块加载 dSdS 和 KK,计算 dQ=dSKdQ = dS K,并将 dQdQ 写回 HBM
      • 从 HBM 中按块加载 dSdS 和 QQ,计算 dK=dS⊤QdK = dS^\top Q,并将 dKdK 写回 HBM
      • 返回 dQ,dK,dVdQ, dK, dV
    • 关键推导说明

      • dV\mathrm {dV}: 由 O=PVO = PV 可得 dV=P⊤dO\mathrm {dV} = P^\top \mathrm {dO}

      • dP\mathrm {dP}: 由 O=PVO = PV 可得 dP=dOV⊤\mathrm {dP} = \mathrm {dO} V^\top

      • dS\mathrm {dS}: 由 P=softmax(S)P = softmax (S),利用 softmax 求导公式:

        dSij=Pij(dPij−∑lPildPil)dS_{ij} = P_{ij}\left (dP_{ij} - \sum_l P_{il} dP_{il}\right)
      • 这对应了之前总结的 softmax 梯度结论:

        ∂L∂zj=yj(dyj−∑j=1lyjdyj)\frac {\partial L}{\partial z_j} = y_j\left (\mathrm {d} y_j - \sum_{j=1}^l y_j \mathrm {d} y_j\right)
      • dQ\mathrm {dQ}: 由 S=QK⊤S = QK^\top 可得 dQ=dSK\mathrm {dQ} = \mathrm {dS} K

      • dK\mathrm {dK}: 由 S=QK⊤S = QK^\top 可得 dK=dS⊤Q\mathrm {dK} = \mathrm {dS}^\top Q​

    • 显然,对于标准反向传播而言,显存上已经存储了 Q、K、V、O、S、P 等矩阵

  • 经过分块 Forward 计算后,显存已经存储了:

    • mm:全局 rowmax
    • ll:全局 rowsum
    • Q,K,VQ, K, V:等同于标准 attention 场景下的结果
    • OO:等同于标准 attention 场景下的输出结果 OO
    • dO\mathrm {d} O:有了完整的 OO,就可以按正常的 backward 步骤先求出它的梯度,也存放在显存上;然后就能按照链式法则,分块地去求其他矩阵的梯度
  • 既然有了全局的 m,lm, l,那么现在对于任意一块 SijS_{ij},就能基于 m,lm, l 算出和标准场景下完全一致的 PijP_{ij}

  • 因此,在 backward 的过程中,flash attention 将采用重计算的方式,重新算出 Sij,PijS_{ij}, P_{ij},并将它们运用到 backward 的计算中去

  • 所以在接下来的说明中,就可以把 S,PS, P 理解成完全等同于标准场景下的结果,而不是像分块计算 forward 中那样的 S,PS, P

  • 完整的伪代码流程如下

    • 输入:

      • 位于高带宽内存(HBM)中的矩阵 Q,K,V,O,dO∈RN×dQ, K, V, O, dO \in \mathbb {R}^{N \times d}

      • 位于 HBM 中的向量 ℓ,m∈RN\ell, m \in \mathbb {R}^N

      • 片上 SRAM 大小为 MM

      • Softmax 缩放常数 τ\tau

      • 掩码函数 MASK

      • Dropout 概率 pdropp_{\text{drop}}

      • 前向传播时的伪随机数生成器状态 R\mathcal {R}

    • 将伪随机数生成器状态设置为 R\mathcal {R}

    • 设置块大小:

      • Bc=⌈M4d⌉B_c = \left\lceil \frac {M}{4d} \right\rceil
      • Br=min⁡(⌈M4d⌉,d)B_r = \min\left (\left\lceil \frac {M}{4d} \right\rceil, d\right)
    • 划分块

      • 将 QQ 划分为 Tr=⌈NBr⌉T_r = \left\lceil \frac {N}{B_r} \right\rceil 个块 Q1,…,QTrQ_1, \dots, Q_{T_r},每个大小为 Br×dB_r \times d;
      • 将 K,VK, V 划分为 Tc=⌈NBc⌉T_c = \left\lceil \frac {N}{B_c} \right\rceil 个块 K1,…,KTcK_1, \dots, K_{T_c} 和 V1,…,VTcV_1, \dots, V_{T_c},每个大小为 Bc×dB_c \times d;
      • 将 OO 划分为 TrT_r 个块 O1,…,OTrO_1, \dots, O_{T_r},每个大小为 Br×dB_r \times d;
      • 将 dOdO 划分为 TrT_r 个块 dO1,…,dOTrdO_1, \dots, dO_{T_r},每个大小为 Br×dB_r \times d;
      • 将 ℓ\ell 划分为 TrT_r 个块 ℓ1,…,ℓTr\ell_1, \dots, \ell_{T_r},每个大小为 BrB_r;
      • 将 mm 划分为 TrT_r 个块 m1,…,mTrm_1, \dots, m_{T_r},每个大小为 BrB_r
    • 在 HBM 中初始化梯度:

      • dQ=(0)N×ddQ = (0)_{N \times d},并划分为 TrT_r 个块 dQ1,…,dQTrdQ_1, \dots, dQ_{T_r},每个大小为 Br×dB_r \times d
      • dK=(0)N×d,dV=(0)N×ddK = (0)_{N \times d}, dV = (0)_{N \times d},并划分为 TcT_c 个块 dK1,…,dKTcdK_1, \dots, dK_{T_c} 和 dV1,…,dVTcdV_1, \dots, dV_{T_c},每个大小为 Bc×dB_c \times d
    • 外层循环(遍历 K/V 块):for 1≤j≤Tc1 \leq j \leq T_cdo

      • 从 HBM 加载 Kj,VjK_j, V_j 到片上 SRAM
      • 在 SRAM 上初始化临时梯度:dK~j=(0)Bc×d,dV~j=(0)Bc×d\tilde {dK}_j = (0)_{B_c \times d}, \tilde {dV}_j = (0)_{B_c \times d}
      • 内层循环(遍历 Q 块):for 1≤i≤Tr1 \leq i \leq T_rdo
        • 从 HBM 加载 Qi,Oi,dOi,dQi,ℓi,miQ_i, O_i, dO_i, dQ_i, \ell_i, m_i 到片上 SRAM
        • 在片上计算:Sij=τQiKj⊤∈RBr×BcS_{ij} = \tau Q_i K_j^\top \in \mathbb {R}^{B_r \times B_c}
        • 在片上应用掩码:Sijmasked=MASK(Sij)S_{ij}^{\text{masked}} = \text{MASK}(S_{ij})
        • 在片上计算注意力概率:Pij=diag(ℓi)−1exp⁡(Sijmasked−mi)∈RBr×BcP_{ij} = \text{diag}(\ell_i)^{-1} \exp (S_{ij}^{\text{masked}} - m_i) \in \mathbb {R}^{B_r \times B_c}
        • 在片上计算 Dropout 掩码 Zij∈RBr×BcZ_{ij} \in \mathbb {R}^{B_r \times B_c}:
          • 每个元素以 1−pdrop1-p_{\text{drop}} 的概率取 11−pdrop\frac {1}{1-p_{\text{drop}}}
          • 以 pdropp_{\text{drop}} 的概率取 00
        • 在片上应用 Dropout:Pijdropped=Pij∘ZijP_{ij}^{\text{dropped}} = P_{ij} \circ Z_{ij}(逐元素乘法)
        • 在片上累加 dVdV 梯度:dV~j←dV~j+(Pijdropped)⊤dOi∈RBc×d\tilde {dV}_j \leftarrow \tilde {dV}_j + (P_{ij}^{\text{dropped}})^\top dO_i \in \mathbb {R}^{B_c \times d}
        • 在片上计算 dPdP 梯度:dPijdropped=dOiVj⊤∈RBr×BcdP_{ij}^{\text{dropped}} = dO_i V_j^\top \in \mathbb {R}^{B_r \times B_c}
        • 在片上应用 Dropout 反向:dPij=dPijdropped∘ZijdP_{ij} = dP_{ij}^{\text{dropped}} \circ Z_{ij}(逐元素乘法)
        • 在片上计算行和:Di=rowsum(dOi∘Oi)∈RBrD_i = \text{rowsum}(dO_i \circ O_i) \in \mathbb {R}^{B_r}
        • 在片上计算 dSdS 梯度:dSij=Pij∘(dPij−Di)∈RBr×BcdS_{ij} = P_{ij} \circ (dP_{ij} - D_i) \in \mathbb {R}^{B_r \times B_c}
        • 更新 dQdQ 并写回 HBM:dQi←dQi+τdSijKj∈RBr×ddQ_i \leftarrow dQ_i + \tau dS_{ij} K_j \in \mathbb {R}^{B_r \times d}
        • 在片上累加 dKdK 梯度:dK~j←dK~j+τdSij⊤Qi∈RBc×d\tilde {dK}_j \leftarrow \tilde {dK}_j + \tau dS_{ij}^\top Q_i \in \mathbb {R}^{B_c \times d}
        • 结束内层循环
      • 将 dK~j,dV~j\tilde {dK}_j, \tilde {dV}_j 写回 HBM 中的 dKj,dVjdK_j, dV_j
      • 结束外层循环
    • 返回 dQ,dK,dVdQ, dK, dV

  • 求 VjV_j 的梯度

    • 假设现在 j=0j = 0,那要怎么求 dV0dV_0 呢?

    • V0V_0 都参与了 OO 哪些部分的计算,以及是怎么参与的?

    • 由图可知,P00P_{00} 和 V00V_{00} 参与了 O0O_0 的计算,P10P_{10} 和 V00V_{00} 参与了 O1O_1 的计算,P20P_{20} 和 V0V_0 参与了 O2O_2 的计算,所以有:

      dV0=(P00)TdO0+(P10)TdO1+(P20)TdO2dV_0 = (P_{00})^T dO_0 + (P_{10})^T dO_1 + (P_{20})^T dO_2
    • 进而推知:

      dVj=∑i(Pij)TdOidV_j = \sum_i (P_{ij})^T dO_i
    • 在伪代码第 11~15 行中,做的都是 S,PS, P 重计算的过程;伪代码的第 16 行,就是在按这个方法分块计算并累积 dVjdV_j

  • 求 PijP_{ij} 的梯度

    • 观察上图,可以发现 PijP_{ij} 只与 Vj,OiV_j, O_i 相关,例如 P10P_{10} 只与 V0,O1V_0, O_1 相关
    • 因此有: dPij=dOiVjTdP_{ij} = dO_i V_j^T​,这就是伪代码第 17 行做的事情
  • 求 SijS_{ij} 的梯度

    • 回顾 “softmax 求导” 部分的一个重要结论:

      ∂L∂z=∂L∂y∂y∂z=dy(diag(y)−yTy)\frac {\partial L}{\partial z} = \frac {\partial L}{\partial y} \frac {\partial y}{\partial z} = dy (diag (y) - y^T y)
    • 假设 si,pi,ois_i, p_i, o_i 分别为矩阵 S,P,OS, P, O 的某一行(注意这里 ii 不是表示第 ii 块的意思,是表示第 ii 行,所以用小写的 s,p,os, p, o 表示),那么根据这个结论,有:

      dsi=dpi(diag(pi)−piTpi)=dpidiag(pi)−dpipiTpi=dpidiag(pi)−doiVTpiTpi=dpidiag(pi)−doioiTpi=pi∘[dpi−rowsum(doi∘oi)]\begin {aligned} ds_i &= dp_i (diag (p_i) - p_i^T p_i) \\ &= dp_i diag (p_i) - dp_i p_i^T p_i \\ &= dp_i diag (p_i) - do_i V^T p_i^T p_i \\ &= dp_i diag (p_i) - do_i o_i^T p_i \\ &= p_i \circ [dp_i - rowsum (do_i \circ o_i)] \end {aligned}
    • 为什么要大费周章,将 dsids_i 改写成这么复杂的形式呢?因为在最后一步之前,都是针对 “某一行” 来求导,而引入最后一步的目的,是为了延展至对 “某一块(多行)” 的求导,也就是说针对某一块 dSidS_i(注意这里是大写的 SS,ii 的含义也回归至 “第几块”),有:

      dSi=Pi∘[dPi−rowsum(dOi∘Oi)]dS_i = P_i \circ [dP_i - rowsum (dO_i \circ O_i)]
    • 进而,可以推知:

      dSij=Pij∘[dPij−rowsum(dOi∘Oi)]dS_{ij} = P_{ij} \circ [dP_{ij} - rowsum (dO_i \circ O_i)]
    • 这就是伪代码第 19~20 行做的事情

  • 求 QiQ_i 的梯度

    • 到目前为止,已经知道 dSijdS_{ij},那么现在就可以根据链式法则继续求 dQidQ_i

    • 观察 Q0Q_0,由 forward 过程可知:

      S00=Q0K0TS01=Q0K1T\begin {aligned} S_{00} &= Q_0 K_0^T \\ S_{01} &= Q_0 K_1^T \end {aligned}
    • 因此,针对 Q0Q_0,有:dQ0=dS00K0+dS01K1dQ_0 = dS_{00} K_0 + dS_{01} K_1

    • 推广到任意 QiQ_i,有:dQi=∑jdSijKjdQ_i = \sum_j dS_{ij} K_j

    • 这就是伪代码第 21 行做的事情

  • 求 KjK_j 的梯度

    • 某块 KjK_j 和对应的 QiQ_i 共同计算出了对应的 SijS_{ij},因此有

      dKj=∑idSijTQidK_j = \sum_i dS_{ij}^T Q_i
    • 这就是伪代码第 22 行做的事情

显存量计算

  • 以前向计算为例

  • 在代码第 9 行,有 Sij=QiKjTS_{ij} = Q_i K_j^T,其中 Qi∈RBr∗d,KjT∈Rd∗BcQ_i \in \mathbb {R}^{B_r \ast d}, K_j^T \in \mathbb {R}^{d \ast B_c},根据前置知识,求 SijS_{ij} 的计算量为 O(BrBcd)O (B_r B_c d)

  • 在代码第 12 行,有 P~ijVj\widetilde {P}_{ij} V_j,其中 P~ij∈RBr∗Bc,Vj∈RBc∗d\widetilde {P}_{ij} \in \mathbb {R}^{B_r \ast B_c}, V_j \in \mathbb {R}^{B_c \ast d}。则这里的计算量同样为 O(BrBcd)O (B_r B_c d)

  • 执行内循环的次数

    TcTr=NBcNBrT_c T_r = \frac {N}{B_c} \frac {N}{B_r}
  • 综合以上三点,flash attention 的 forward 计算量为:

    O(N2BcBrBrBcd)=O(N2d)O (\frac {N^2}{B_c B_r} B_r B_c d) = O (N^2 d)
  • 因为计算量是用大 O 阶表示的,所以这里把常数项都省略掉

  • 同理 backward 中的计算量是 O(N2)O (N^2),d 远小于 N,因此 d 也可以略去不表达

  • 和标准 attention 相比,如果不考虑 O,Flash Attention 只需要存储 m 和 l,其显存需求为 O (N)

  • 而标准 attention 需要存储 S 和 P,其显存需求为 O (N²)

  • 可以发现相比于标准 attention,flash attention 明显降低了对显存的需求

  • FlashAttention 的计算复杂度依旧是 O (n^2 d),但显存占用从标准注意力的 O (n^2 + n d) 降为 O (n d)

  • FlashAttention 并没有减少模型实际进行的浮点运算次数(Floating Point Operations, FLOPs),但显存瓶颈大幅降低,因此实际训练速度提升

IO 复杂度

  • 标准 Attention 的 IO 复杂度

    • 从 HBM 中读取 Q,K∈RN∗dQ, K \in \mathbb {R}^{N \ast d},计算 S=QKT,S∈RN∗NS = QK^T, S \in \mathbb {R}^{N \ast N} 并将 SS 写回 HBM,一读一写的 IO 复杂度为:O(Nd+N2)O (Nd + N^2),在表示大 O 阶时忽略常数项
    • 从 HBM 中读取 S∈RN∗NS \in \mathbb {R}^{N \ast N},同时计算 P∈RN∗NP \in \mathbb {R}^{N \ast N} 并将其写回 HBM,一读一写的 IO 复杂度为:O(N2)O (N^2)
    • 从 HBM 中读取 P∈RN∗N,V∈RN∗dP \in \mathbb {R}^{N \ast N}, V \in \mathbb {R}^{N \ast d},计算 O=PV,O∈RN∗dO = PV, O \in \mathbb {R}^{N \ast d} 并将 OO 写回 HBM,一读一写的 IO 复杂度为:O(Nd+N2)O (Nd + N^2)
    • 标准 attention 的 IO 复杂度为:O(Nd+N2)O (Nd + N^2)​
  • FlashAttention 的 IO 复杂度

    • 伪代码的第 6 行,在每个外循环中,都会加载 K,VK, V 的 block;所有外循环结束后,相当于加载了完整的 K,V∈RN∗dK, V \in \mathbb {R}^{N \ast d},因此这里的 IO 复杂度为:O(Nd)O (Nd)

    • 伪代码第 8 行,在每个内循环中,都加载了部分 Q,O,m,lQ, O, m, lblock,由于 m,lm, l 本身比较小(IO 复杂度是 O(N)O (N)),因此暂时忽略它们,只考虑 Q,OQ, O

    • 固定某个外循环,所有内循环结束后,相当于完整遍历了 Q,O∈RN∗dQ, O \in \mathbb {R}^{N \ast d};同时会经历 TcT_c 次外循环,因此最终的 IO 复杂度为:O(TcNd)O (T_c Nd)

    • 将 O,m,lO, m, l 写回 HBM,近似后的 IO 复杂度为:O(Nd)O (Nd)

    • 总体来说 flash attention 的 IO 复杂度为:

      O(TcNd)=O(NBcNd)=O(4NdMNd)=O(N2d2M)O (T_c Nd) = O (\frac {N}{B_c} Nd) = O (\frac {4Nd}{M} Nd) = O (\frac {N^2 d^2}{M})
    • 一般 dd 的取值在 64~128,M 的取值在 100KB 左右,因此有 d2M<1\frac {d^2}{M} < 1

    • 因此可以看出,Flash attention 的 IO 复杂度是要显著小于标准 attention 的 IO 复杂度

FlashAttention2

循环顺序调换

  • V1 存在的问题 —— 外层循环 = KV 块,内层循环 = Q 块

    flash_attention_diagram

    • FlashAttention V1 中,循环顺序是 KV 外循环、Q 内循环,导致:
      • 每个 thread block 内,将 K 和 V 的计算拆分给多个 warp,而所有 warp 共享 Q
      • 每次外循环(j++)处理一个 KV 块,都要更新一次输出 OiO_i
      • 每次更新 OiO_i,都需要从 HBM 中重新读取 Qi,Oi,mi,ℓiQ_i, O_i, m_i, \ell_i,累加计算后再写回 HBM
      • 这种方式叫 split-K,warp 之间需要频繁读写 HBM/Shared Memory,中间结果的同步开销极大,效率很低
    • 一个最终 O 块,要被多次读写 HBM
      • 最终输出只有 3 块:O0,O1,O2O_0, O_1, O_2
      • 但计算时会产生中间块:O00,O01O_{00}, O_{01}
      • O0O_0 需要:
        • j=0:计算 O00O_{00}→ 写回 HBM
        • j=1:读取 O00O_{00}+ 计算 O01O_{01}→ 合并 → 写回最终 O0O_0
    • 中间结果必须在 HBM ↔ SRAM 之间来回搬运
      • 每处理一个 KV 块,都要把旧的 O、m、ℓ 读上来
      • 计算完增量后,又要把更新后的 O、m、ℓ 写回去
      • 带来冗余访存开销
    • 不符合 Softmax 天然计算特性
      • Softmax 是按 Q 行独立计算的(一行 Q 对应一整行注意力权重)
      • 但 V1 却先遍历 KV,破坏了局部性
  • V2 的改进 —— 外层循环 = Q 块,内层循环 = KV 块

    • FlashAttention V2 将循环顺序反转为 Q 外循环、KV 内循环,彻底改变了 Warp 的工作方式:
      • 每个 thread block 内,将 Q 的计算拆分给多个 warp,所有 warp 共享 K 和 V
      • 外循环固定一个 QiQ_i,加载到 SRAM 后全程驻留,不再和 HBM 交互
      • 内循环依次加载 Kj,VjK_j, V_j,所有 warp 在片上 SRAM 中直接累加 Oi(j)O_i^{(j)}
      • 遍历完所有 KV 块后,只在最后一步将最终的 OiO_i 和 LiL_i 写回 HBM
      • 优点:OiO_i 的中间结果全程留在 SRAM,避免了 HBM 的反复读写,warp 间无需同步中间结果
    • 彻底消除 O/m/ℓ 的来回读写
      • 固定一个 Q 块(Q0Q_0),一次性遍历所有 KV 块(KV0 → KV1 → KV2)
      • 在片上直接累加出最终 O0O_0,中间结果 O00,O01O_{00}, O_{01} 完全留在 SRAM 里,不写回 HBM
    • 计算流程更自然、更高效
      • 加载 Q0Q_0 到 SRAM 一次就够了,依次流式加载 KV 块,片上直接完成 O00→O01→O0O_{00} \rightarrow O_{01} \rightarrow O_0(最终结果)
      • 最后只写回一次最终 O0O_0
    • 完美匹配 Softmax 的计算特性
      • Softmax 是 row-wise(按 Q 行) 操作
      • V2:固定 Q → 遍历 KV
      • 完全对齐 “一行 Q 算完整行注意力” 的物理意义

减少非矩阵运算

  • 现代 GPU(如 A100)对矩阵乘法(GEMM/MatMul)有专用的 Tensor Core 加速,效率极高:

    • FP16/BF16 矩阵乘法:理论吞吐量 312 TFLOPs/s
    • FP32 非矩阵运算:仅 19.5 TFLOPs/s
    • 每个非矩阵运算 FLOP,成本是矩阵乘法的 16 倍
  • FlashAttention V2 的核心目标之一,就是把更多时间花在高效的矩阵乘法上,减少低效的非矩阵运算(如逐元素乘、对角线矩阵求逆等)

  • Softmax 的数值稳定实现:

    softmax(xi)=exi∑jexj=exi−xmax∑jexj−xmax\text{softmax}(x_i) = \frac {e^{x_i}}{\sum_j e^{x_j}} = \frac {e^{x_i - x_{\text{max}}}}{\sum_j e^{x_j - x_{\text{max}}}}
  • 传统实现需要对 xx​ 做 3 次遍历(求 max、指数、求和),引入了较多非矩阵运算

  • FlashAttention V1 为了分块 Softmax,引入了大量 diag(ℓ)⁻¹ 缩放操作,而 V2 对这部分做了关键优化

  • FlashAttention V1 的计算流程(含大量非矩阵运算)

    • 第 1 个 KV 块(j=1):

      m(1)=rowmax(S(1))ℓ(1)=rowsum(eS(1)−m(1))O(1)=diag(ℓ(1))−1⏟非矩阵运算eS(1)−m(1)V(1)\begin {align*} m^{(1)} &= \text{rowmax}(S^{(1)}) \\ \ell^{(1)} &= \text{rowsum}(e^{S^{(1)}-m^{(1)}}) \\ O^{(1)} &= \underbrace {\text{diag}(\ell^{(1)})^{-1}}_{\text{非矩阵运算}} e^{S^{(1)}-m^{(1)}} V^{(1)} \end {align*}
    • 这里每一步都即时应用了归一化因子 diag(ℓ)⁻¹,引入了低效的对角线矩阵求逆与逐元素乘

    • 第 2 个 KV 块(j=2):

      m(2)=max⁡(m(1),rowmax(S(2)))=mℓ(2)=em(1)−m(2)ℓ(1)+rowsum(eS(2)−m(2))O(2)=diag(ℓ(1)/ℓ(2))−1⏟非矩阵运算O(1)+diag(ℓ(2))−1⏟非矩阵运算eS(2)−m(2)V(2)\begin {align*} m^{(2)} &= \max (m^{(1)}, \text{rowmax}(S^{(2)})) = m \\ \ell^{(2)} &= e^{m^{(1)}-m^{(2)}} \ell^{(1)} + \text{rowsum}(e^{S^{(2)}-m^{(2)}}) \\ O^{(2)} &= \underbrace {\text{diag}(\ell^{(1)}/\ell^{(2)})^{-1}}_{\text{非矩阵运算}} O^{(1)} + \underbrace {\text{diag}(\ell^{(2)})^{-1}}_{\text{非矩阵运算}} e^{S^{(2)}-m^{(2)}} V^{(2)} \end {align*}
    • 每次更新都需要对旧输出做一次缩放,进一步增加了非矩阵运算的开销

  • V2 的核心思路:分块计算时,不即时应用 Softmax 的归一化因子,只在最后一步统一归一化,从而消除中间步骤的非矩阵运算

    • 第 1 个 KV 块(j=1):

      m(1)=rowmax(S(1))ℓ(1)=rowsum(eS(1)−m(1))O~(1)=eS(1)−m(1)V(1)(去除了diag(ℓ(1))−1)\begin {align*} m^{(1)} &= \text{rowmax}(S^{(1)}) \\ \ell^{(1)} &= \text{rowsum}(e^{S^{(1)}-m^{(1)}}) \\ \tilde {O}^{(1)} &= e^{S^{(1)}-m^{(1)}} V^{(1)} \quad (\text{去除了} \text{diag}(\ell^{(1)})^{-1}) \end {align*}
    • 直接计算未归一化的输出 tilde(O),避免了第一次缩放

    • 第 2 个 KV 块(j=2):

      m(2)=max⁡(m(1),rowmax(S(2)))=mℓ(2)=em(1)−m(2)ℓ(1)+rowsum(eS(2)−m(2))O~(2)=diag(em(1)−m(2))⏟仅指数缩放,无ℓ参与O~(1)+eS(2)−m(2)V(2)\begin {align*} m^{(2)} &= \max (m^{(1)}, \text{rowmax}(S^{(2)})) = m \\ \ell^{(2)} &= e^{m^{(1)}-m^{(2)}} \ell^{(1)} + \text{rowsum}(e^{S^{(2)}-m^{(2)}}) \\ \tilde {O}^{(2)} &= \underbrace {\text{diag}(e^{m^{(1)}-m^{(2)}})}_{\text{仅指数缩放,无ℓ参与}} \tilde {O}^{(1)} + e^{S^{(2)}-m^{(2)}} V^{(2)} \end {align*}
    • 这里只做了基于 m 的指数缩放,不再需要 diag(ℓ) 相关的复杂运算

    • 最后一步统一归一化(仅 1 次):

      O(2)=diag(ℓ(2))−1O~(2)O^{(2)} = \text{diag}(\ell^{(2)})^{-1} \tilde {O}^{(2)}
    • 遍历完所有 KV 块后,只做一次归一化,得到最终结果

  • 核心修改

    • 去除中间步骤的 diag(ℓ)⁻¹ 归一化

      • V1:每个 KV 块计算后,都用 diag(ℓ)⁻¹ 缩放输出 O
      • V2:中间步骤只计算未归一化的 tilde(O),消除了每一步的低效缩放
      • 结果:大幅减少了对角线矩阵求逆、逐元素乘等非矩阵运算
    • 简化旧输出的更新公式

      • V1 更新公式: O(j+1)=diag(ℓ(j)/ℓ(j+1))−1O(j)+diag(ℓ(j+1))−1eS(j+1)−m(j+1)V(j+1)O^{(j+1)} = \text{diag}(\ell^{(j)}/\ell^{(j+1)})^{-1} O^{(j)} + \text{diag}(\ell^{(j+1)})^{-1} e^{S^{(j+1)}-m^{(j+1)}} V^{(j+1)}
      • V2 更新公式: O~(j+1)=diag(em(j)−m(j+1))O~(j)+eS(j+1)−m(j+1)V(j+1)\tilde {O}^{(j+1)} = \text{diag}(e^{m^{(j)}-m^{(j+1)}}) \tilde {O}^{(j)} + e^{S^{(j+1)}-m^{(j+1)}} V^{(j+1)}
      • 不再需要处理 ℓ 的比值,仅基于 m 做指数缩放,运算更简单高效
    • 仅在最后一步做 1 次归一化

      • 遍历完所有 KV 块后,用全局的 ℓ^(last) 做一次归一化,得到最终输出
      • 归一化次数从 TcT_c​ 次(KV 块数)减少到 1 次,非矩阵运算的开销降到最低
  • V2 通过延迟归一化,把大部分非矩阵运算的开销压缩到了最后一步,让 GPU 的计算时间更多地集中在高效的矩阵乘法上,从而提升了整体吞吐量

并行维度扩展

  • FlashAttention V1 仅在 batch 和 heads 两个维度上并行:
    • 一个 thread block 处理一个 attention head
    • 总 thread block 数 = batch_size × num_heads
    • 优点:当 batch×heads 足够大(≥80,超过 A100 的 108 个 SM 数)时,能高效占满所有 SM
    • 缺点:长序列场景下,受内存限制会减小 batch 和 head 数量,导致 thread block 数不足,GPU 利用率骤降
  • FlashAttention V2 在原有基础上,新增了序列长度维度(sequence length)的并行性:
    • 即使 batch×heads 很小,也能通过序列维度的并行,让 thread block 数达到 SM 数量,提升 GPU 利用率
    • 对长序列(比如 16k/32k 上下文)和小 batch 场景非常友好,显著提升计算速度

前向传播

  • 前向流程

    • 输入:

      • 位于高带宽内存(HBM)中的矩阵 Q,K,V∈RN×dQ, K, V \in \mathbb {R}^{N \times d}

      • 块大小 Bc,BrB_c, B_r

    • 划分块

      • 将 QQ 划分为 Tr=⌈NBr⌉T_r = \left\lceil \frac {N}{B_r} \right\rceil 个块 Q1,…,QTrQ_1, \dots, Q_{T_r},每个大小为 Br×dB_r \times d;
      • 将 K,VK, V 划分为 Tc=⌈NBc⌉T_c = \left\lceil \frac {N}{B_c} \right\rceil 个块 K1,…,KTcK_1, \dots, K_{T_c} 和 V1,…,VTcV_1, \dots, V_{T_c},每个大小为 Bc×dB_c \times d;
      • 将输出 O∈RN×dO \in \mathbb {R}^{N \times d} 划分为 TrT_r 个块 O1,…,OTrO_1, \dots, O_{T_r},每个大小为 Br×dB_r \times d;
      • 将 log-sumexp 向量 LL 划分为 TrT_r 个块 L1,…,LTrL_1, \dots, L_{T_r},每个大小为 BrB_r
    • 外层循环(遍历 Q 块):for 1≤i≤Tr1 \leq i \leq T_rdo

      • 从 HBM 加载 QiQ_i 到片上 SRAM
      • 在 SRAM 上初始化:Oi(0)=(0)Br×d∈RBr×d, ℓi(0)=(0)Br∈RBr, mi(0)=(−∞)Br∈RBrO_i^{(0)} = (0)_{B_r \times d} \in \mathbb {R}^{B_r \times d},\ \ell_i^{(0)} = (0)_{B_r} \in \mathbb {R}^{B_r},\ m_i^{(0)} = (-\infty)_{B_r} \in \mathbb {R}^{B_r}
      • 内层循环(遍历 K/V 块):for 1≤j≤Tc1 \leq j \leq T_cdo
        • 从 HBM 加载 Kj,VjK_j, V_j 到片上 SRAM
        • 在片上计算注意力分数:Si(j)=QiKj⊤∈RBr×BcS_i^{(j)} = Q_i K_j^\top \in \mathbb {R}^{B_r \times B_c}
        • 在片上更新 Softmax 统计量:
          • mi(j)=max⁡(mi(j−1),rowmax(Si(j)))∈RBrm_i^{(j)} = \max\left (m_i^{(j-1)}, \text{rowmax}(S_i^{(j)})\right) \in \mathbb {R}^{B_r}
          • P~i(j)=exp⁡(Si(j)−mi(j))∈RBr×Bc\tilde {P}_i^{(j)} = \exp\left (S_i^{(j)} - m_i^{(j)}\right) \in \mathbb {R}^{B_r \times B_c}(逐元素计算)
          • ℓi(j)=emi(j−1)−mi(j)ℓi(j−1)+rowsum(P~i(j))∈RBr\ell_i^{(j)} = e^{m_i^{(j-1)} - m_i^{(j)}} \ell_i^{(j-1)} + \text{rowsum}\left (\tilde {P}_i^{(j)}\right) \in \mathbb {R}^{B_r}
        • 在片上更新输出:Oi(j)=diag(emi(j−1)−mi(j))−1Oi(j−1)+P~i(j)VjO_i^{(j)} = \text{diag}\left (e^{m_i^{(j-1)} - m_i^{(j)}}\right)^{-1} O_i^{(j-1)} + \tilde {P}_i^{(j)} V_j
        • 结束内层循环
      • 在片上计算最终输出块:Oi=diag(ℓi(Tc))−1Oi(Tc)O_i = \text{diag}\left (\ell_i^{(T_c)}\right)^{-1} O_i^{(T_c)}
      • 在片上计算 log-sumexp 块:Li=mi(Tc)+log⁡(ℓi(Tc))L_i = m_i^{(T_c)} + \log\left (\ell_i^{(T_c)}\right)
      • 将 OiO_i 写回 HBM,作为 OO 的第 ii 个块
      • 将 LiL_i 写回 HBM,作为 LL 的第 ii 个块
      • 结束外层循环
    • 返回输出 OO 和 log-sumexp 向量 LL

  • 在固定单块 Q(记为 i)并循环遍历 K、V 分块(记为 j)的视角下:

    • 第 8 行:计算分块注意力得分矩阵 Si(j)=QiKjT∈RBr×BcS_i^{(j)} = Q_i K_j^T \in \mathbb {R}^{B_r \times B_c}
    • 第 9 行:
      • mi(j)m_i^{(j)}:截止到当前分块 Si(j)S_i^{(j)}(含当前分块)的行最大值(rowmax)
      • P~i(j)\tilde {P}_i^{(j)}:基于当前行最大值计算的未归一化概率矩阵,即 P~i(j)=exp⁡(Si(j)−mi(j))\tilde {P}_i^{(j)} = \exp (S_i^{(j)} - m_i^{(j)})
      • ℓi(j)\ell_i^{(j)}:截止到当前分块 Si(j)S_i^{(j)}(含当前分块)的行和(rowsum),递推关系为: ℓi(j)=emi(j−1)−mi(j)ℓi(j−1)+rowsum(P~i(j))\ell_i^{(j)} = e^{m_i^{(j-1)} - m_i^{(j)}} \ell_i^{(j-1)} + \text{rowsum}(\tilde {P}_i^{(j)})
    • 第 10 行:Oi(j)O_i^{(j)}:截止到当前分块 Si(j)S_i^{(j)}(含当前分块)的累积输出
    • 核心逻辑:在固定 Q 分块、循环 KV 分块时,每一步均使用最新的 rowmax 和 rowsum 计算;遍历完所有 KV 分块后,Oi(j)O_i^{(j)} 即收敛为全局最终结果
    • V2 关键优化:归一化因子 diag(ℓi(j))−1diag (\ell_i^{(j)})^{-1} 未在第 10 行即时应用,而是统一移至第 12 行执行,以减少 GPU 中低效的非矩阵运算
  • 与 V1 的对比:

    • V2 无需存储每个 Q 分块对应的 mim_i 和 ℓi\ell_i
    • 但反向传播(BWD)阶段,仍需利用 mim_i 和 ℓi\ell_i 重计算 Si(j)S_i^{(j)} 与 P~i(j)\tilde {P}_i^{(j)},以完成链式求导
  • V2 的存储优化:

    • 通过存储单一变量 Li=mi(Tc)+log⁡(ℓi(Tc))L_i = m_i^{(T_c)} + \log (\ell_i^{(T_c)})(代码第 13 行),有效降低了共享内存的读写开销
    • 其中 mi(Tc)m_i^{(T_c)} 和 ℓi(Tc)\ell_i^{(T_c)} 分别为全局 rowmax 和 rowsum

反向传播

  • 伪代码

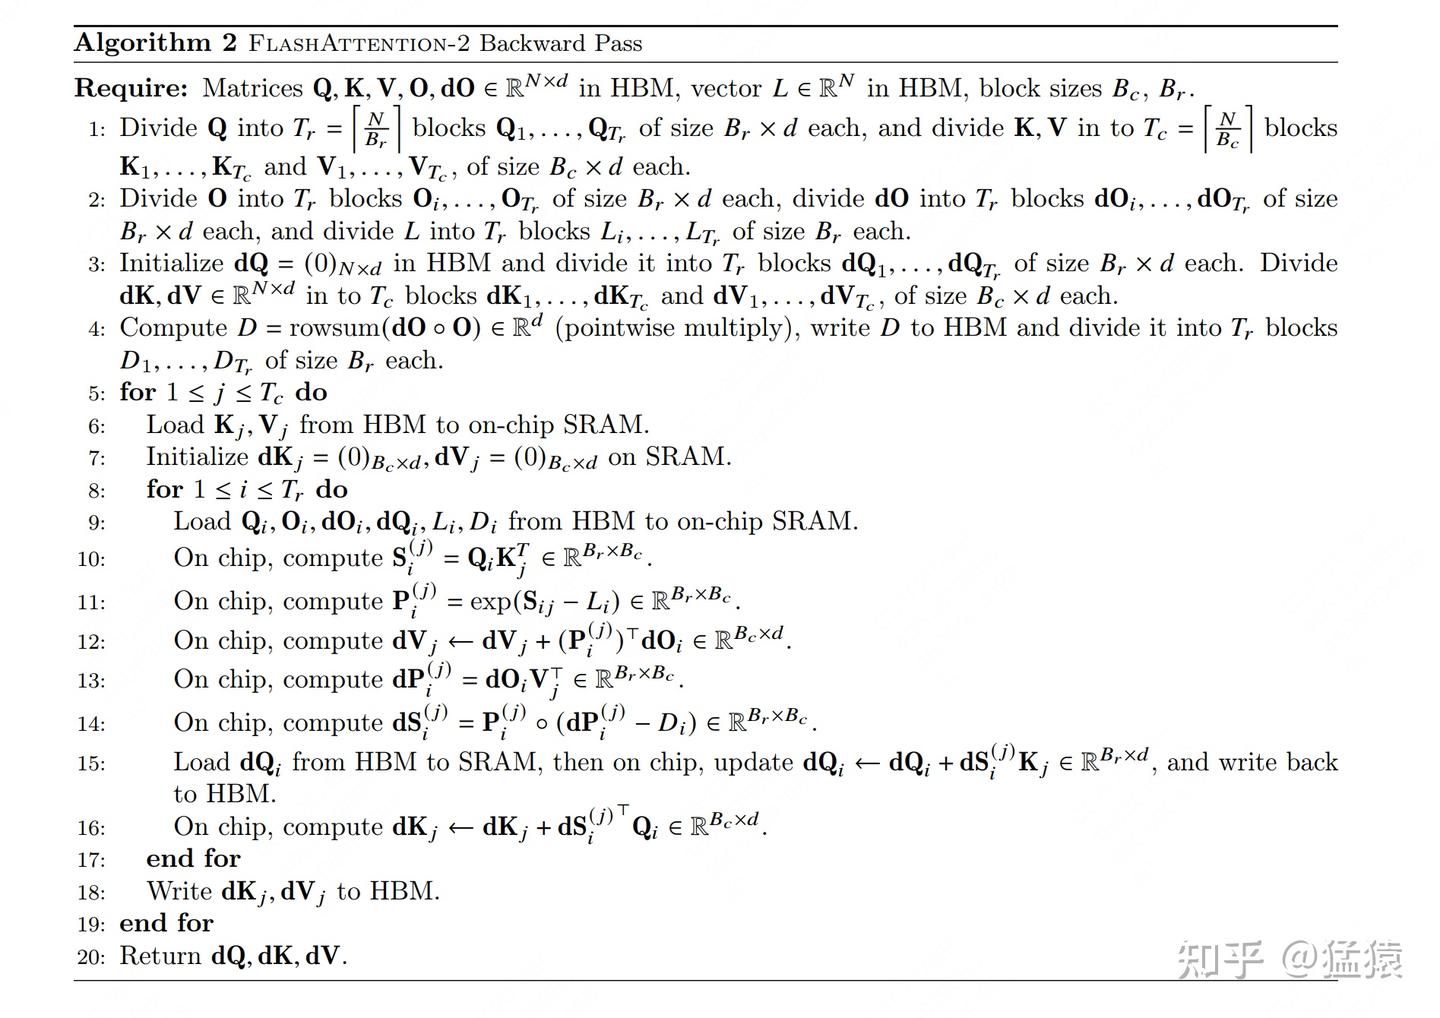
img

  • 在 V2 BWD 中,内外循环的位置又换回来了,即还是 KV 外循环,Q 内循环,这是为什么?

  • 在 BWD 的过程中,主要是求 dVjdV_j,dKjdK_j,dQidQ_i(为了求它们还需要求中间结果 dSijdS_{ij},dPijdP_{ij}),这些梯度都需要沿着哪些方向 AllReduce?

    • dVjdV_j:沿着 i 方向做 AllReduce,也就是需要每行的结果加总
    • dKjdK_j:沿着 i 方向做 AllReduce,也就是需要每行的结果加总
    • dQidQ_i:沿着 j 方向做 AllReduce,也就是需要每列的结果加总
    • dSijdS_{ij},dPijdP_{ij}:只与当前 i,j 相关
  • 在上述伪代码中,外层循环是 KV 块(第 5 行 for 1 ≤ j ≤ T_c do ),内层循环是 Q 块(第 8 行for 1 ≤ i ≤ T_r do),这正是 KV 外循环、Q 内循环的结构

  • 基于此,如果还是保持 Q 外循环,KV 内循环不变的话,这种操作其实是固定行,遍历列的,那么在这些梯度中,只有 dQidQ_i 从中受益了,K 和 V 的梯度则进入了别扭的循环(也意味着要往 shared memory 上写更多的中间结果)

  • 但如果采用 KV 外循环,Q 内循环,这样 K 和 V 都受益,只有 Q 独自别扭,因此是一种更好的选择(S 和 P 的计算不受循环变动影响)

  • 在 BWD 过程中,需要用全局的 mi(j)m_i^{(j)},li(j)l_i^{(j)} 重新计算 Pi(j)P_i^{(j)},计算公式如下:

    Pi(j)=diag(li(j))−1exp(Si(j)−mi(j))P_i^{(j)} = diag (l_i^{(j)})^{-1} exp (S_i^{(j)} - m_i^{(j)})
  • 但如此一来,就要从 shared memory 上同时读取 mi(j)m_i^{(j)},li(j)l_i^{(j)},似乎有点消耗读写

  • 所以在 V2 中,只存储 Li=mi(j)+log(li(j))L_i = m_i^{(j)} + log (l_i^{(j)}),然后计算:

    Pi(j)=exp(Si(j)−Li)P_i^{(j)} = exp (S_i^{(j)} - L_i)
  • 在伪代码第 11 行,正是直接使用了这个优化后的公式compute P_i^(j) = exp(S_ij - L_i),很容易发现这两个计算是等价的,但 V2 的做法节省了读写量

优化点

  • V2 从以下三个方面做了改进:
    • 置换内外循环位置,同时减少非矩阵的计算量
    • 优化 Attention 部分 thread blocks 的并行化计算,新增 seq_len 维度的并行,使 SM 的利用率尽量用满,这其实也是内外循环置换这个总体思想配套的改进措施
    • 优化 thread blocks 内部 warp 级别的工作模式,尽量减少 warp 间的通讯和读取 shared memory 的次数

FlashAttention3

FlexAttention

Block-Sparse FlashAttention

这篇文档有帮助吗?

On this page

页面信息