KV Cache
介绍 KV Cache 在 LLM 推理中的作用与优化
- 参考资料
什么是 KV Cache
- KV Cache 是大语言模型推理阶段的关键优化技术,通过存储注意力机制中生成的中间键(K)和值(V)向量,避免后续生成步骤中重复计算
- KV Cache 用于提升文本生成效率,仅适用于推理阶段,无法在训练中使用
- LLM 生成文本时采用 “逐 token 生成” 模式
- 无 KV Cache 时,每生成一个新 token,模型需重新计算整个序列(含历史 token)的 K 和 V 向量,存在大量冗余计算
- 例如生成 “Time flies fast” 时,生成 “fast” 需重新计算 “Time”“flies” 的 KV 向量
- KV Cache 可存储历史 KV 向量,新 token 生成仅需计算当前 token 的 KV,再结合缓存复用历史数据,避免冗余计算历史 token 的 KV 向量
KV 计算分析
-
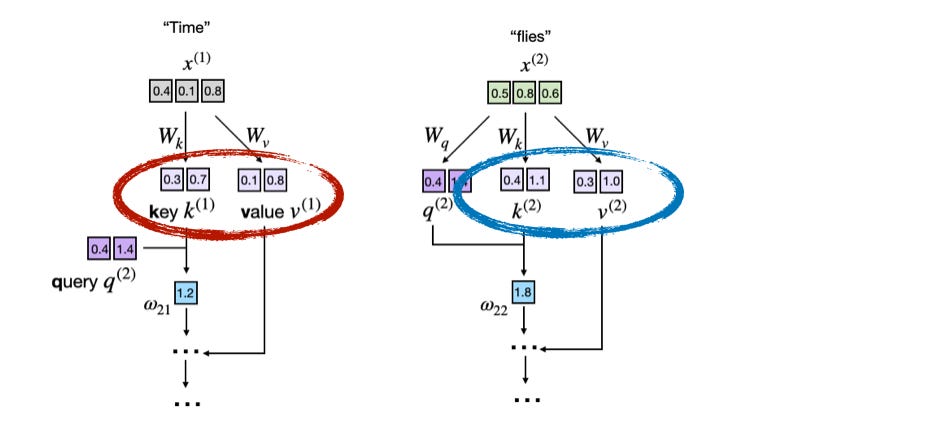
下图展示了在注意力计算过程中如何从 token embeddings 中计算得到 KV 向量
-
每个输入的 token(例如,“Time” 和 “flies”)通过学习矩阵 和 进行投影,以获得其相应的 KV 向量
-
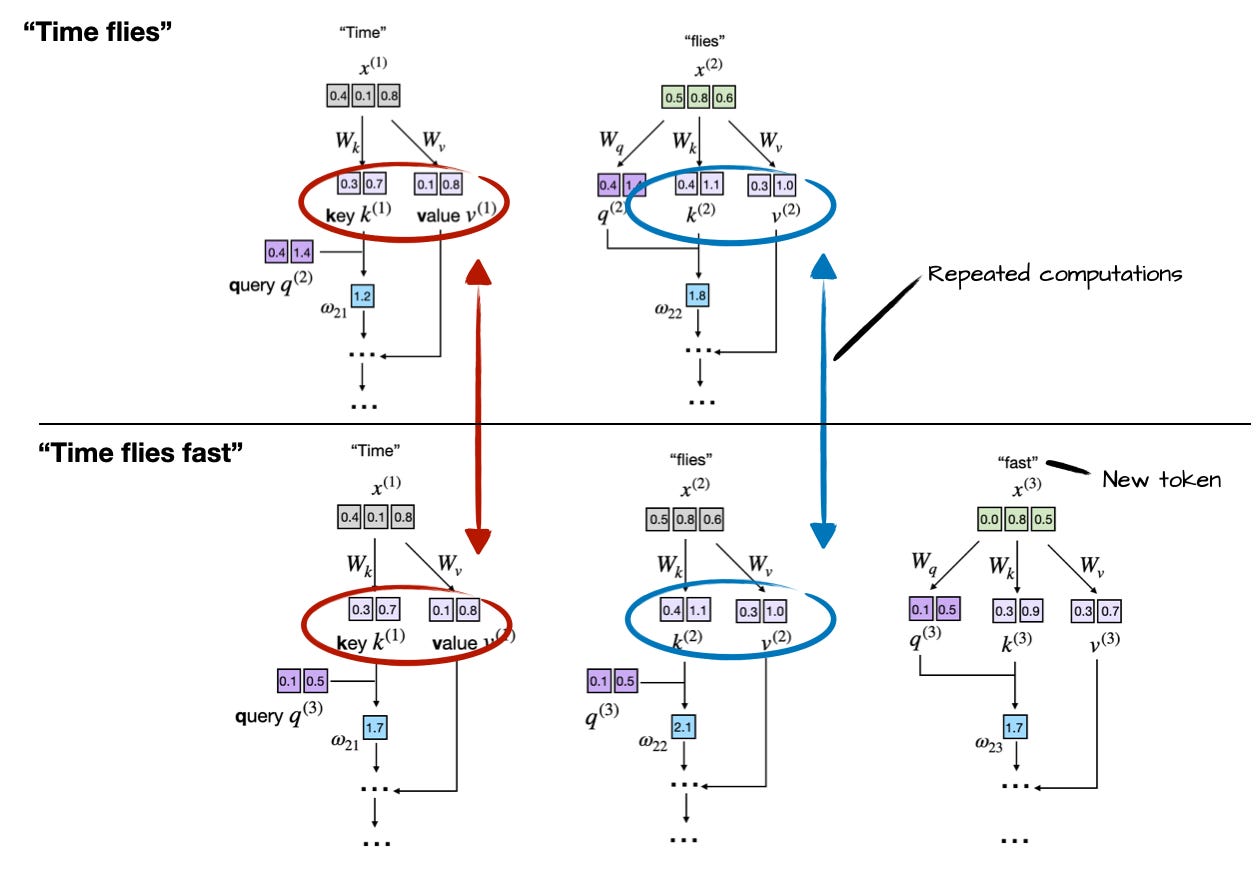
大语言模型一次生成一个词(或者 token),假设大语言模型生成了 “fast” 这个词,那么下一轮的 Prompt 就变成了 “Time flies fast”
-
可以看出,当处理 “Time flies fast” 时,“Time” 和 “flies” 两个 token 的 KV 向量是完全重复计算的
-
因此,KV Cache 的理念是实现一种缓存机制,用于存储之前生成的 KV 向量以供重复使用,从而避免这些不必要的重新计算
KV Cache 的计算流程
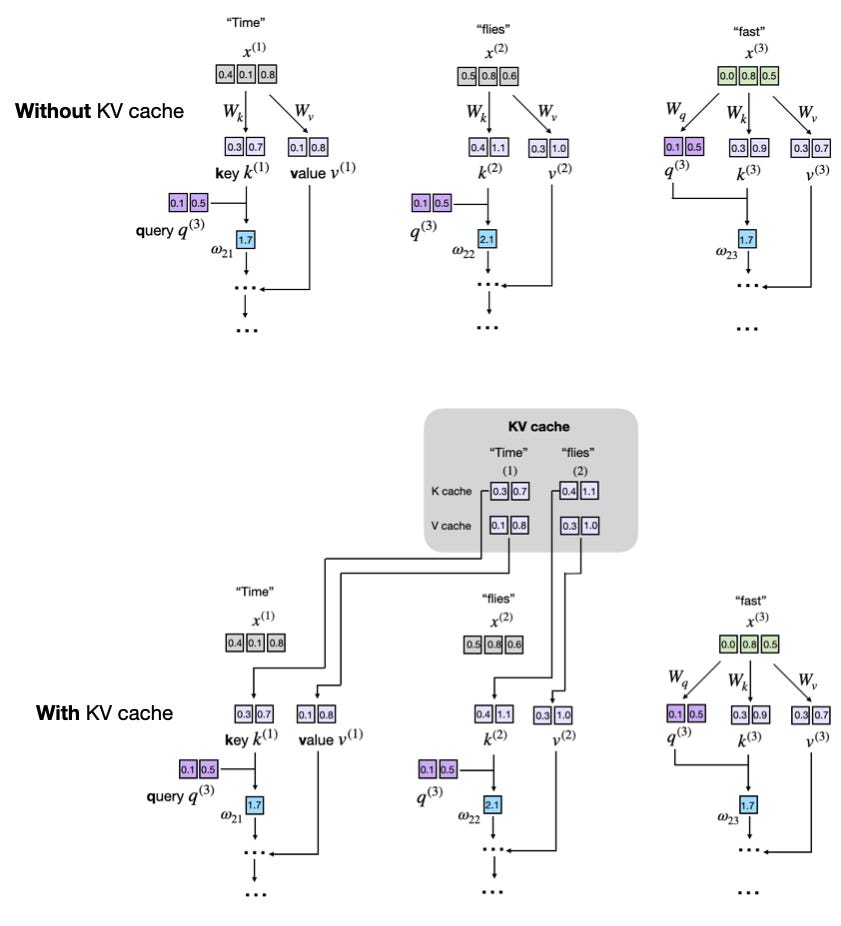
-
无 KV Cache 的计算
Generation Step Input Tokens Computed KV 1 "Time""Time"2 "Time flies""Time","flies"3 "Time flies fast""Time","flies","fast" -
有 KV Cache 的计算
Generation Step Input Tokens Computed KV Cached KV 1 "Time""Time"- 2 "Time flies""flies""Time"3 "Time flies fast""fast""Time","flies"
KV Cache 的代码实现
(1)注册缓存缓冲区(MultiHeadAttention 类构造函数)
-
在多头注意力类中添加
cache_k和cache_v两个缓冲区,用于存储拼接后的 KV 向量:self.register_buffer("cache_k", None) self.register_buffer("cache_v", None)
(2)带 use_cache 参数的前向传播(MultiHeadAttention.forward)
-
扩展 forward 方法,根据
use_cache标志决定是否使用缓存,核心逻辑为 “初始化缓存→拼接新 KV →检索缓存”:def forward(self, x, use_cache=False): b, num_tokens, d_in = x.shape keys_new = self.W_key(x) # 新token的K向量 values_new = self.W_value(x) # 新token的V向量 queries = self.W_query(x) # Q向量(无需缓存) if use_cache: if self.cache_k is None: # 初始化缓存(首次调用) self.cache_k, self.cache_v = keys_new, values_new else: # 拼接新KV到缓存 self.cache_k = torch.cat([self.cache_k, keys_new], dim=1) self.cache_v = torch.cat([self.cache_v, values_new], dim=1) keys, values = self.cache_k, self.cache_v # 检索缓存 else: keys, values = keys_new, values_new # 不使用缓存,直接用新KV
(3)缓存重置(MultiHeadAttention.reset_cache)
-
避免不同文本生成任务间的缓存污染(新 prompt 使用旧缓存会导致输出混乱),因此要新增重置缓存的方法:
def reset_cache(self):
    self.cache_k, self.cache_v = None, None
(4)全模型 use_cache 参数传播(GPTModel 类)
- 新增
current_pos跟踪已缓存 token 数量,确保新 token 的位置索引连续:self.current_pos = 0 # 缓存token计数器 - 修改前向方法,传递
use_cache参数到每个 Transformer 块,并更新位置索引:def forward(self, in_idx, use_cache=False): seq_len = in_idx.shape[1] # 计算位置嵌入(带缓存时从current_pos开始,否则从0开始) if use_cache: pos_ids = torch.arange(self.current_pos, self.current_pos + seq_len, device=in_idx.device) self.current_pos += seq_len else: pos_ids = torch.arange(0, seq_len, device=in_idx.device) pos_embeds = self.pos_emb(pos_ids).unsqueeze(0) x = self.tok_emb(in_idx) + pos_embeds # 词嵌入+位置嵌入 # 传递use_cache到每个Transformer块 for blk in self.trf_blocks: x = blk(x, use_cache=use_cache) return self.fc_out(x) - 模型级缓存重置(批量重置所有 Transformer 块的缓存):
def reset_kv_cache(self):
    for blk in self.trf_blocks:
        blk.att.reset_cache()  # 调用每个块的reset_cache
    self.current_pos = 0  # 重置计数器
(5)带缓存的文本生成函数(generate_text_simple_cached)
-
仅向模型输入新 token(而非完整序列),结合缓存生成文本:
def generate_text_simple_cached(model, idx, max_new_tokens, use_cache=True):
    model.eval()
    ctx_len = model.pos_emb.num_embeddings  # 模型最大上下文长度
    if use_cache:
        model.reset_kv_cache()  # 初始化缓存
        with torch.no_grad():
            logits = model(idx[:, -ctx_len:], use_cache=True)  # 首次输入完整prompt
        for _ in range(max_new_tokens):
            next_idx = logits[:, -1].argmax(dim=-1, keepdim=True)  # 选概率最高的token
            idx = torch.cat([idx, next_idx], dim=1)  # 拼接序列
            with torch.no_grad():
                logits = model(next_idx, use_cache=True)  # 仅输入新token
    else:
        # 无缓存:每次输入完整序列
        for _ in range(max_new_tokens):
            with torch.no_grad():
                logits = model(idx[:, -ctx_len:], use_cache=False)
            next_idx = logits[:, -1].argmax(dim=-1, keepdim=True)
            idx = torch.cat([idx, next_idx], dim=1)
    return idx
KV Cache 的优化
-
优点
- 计算效率显著提升:复杂度从 降至 ,序列越长收益越明显
- 推理速度快:减少重复计算,尤其适合长文本生成场景(如对话、文档生成)
-
缺点
- 内存占用线性增长:每新增一个 ,缓存大小增加,长序列或大模型可能耗尽 内存
- 代码复杂度提高:需处理缓存初始化、重置、位置跟踪等逻辑,增加实现成本
-
CPU 环境:KV Cache 带来显著速度提升,结合
torch.compile后效率更高 -
GPU 环境:小模型(0.6B/1B)下,KV Cache 优势不明显,因为设备的传输 / 通信成本抵消了缓存收益,在大模型场景下缓存优势会凸显
-
优化
-
预分配内存(解决
torch.cat的内存碎片问题):避免频繁拼接张量(torch.cat会反复分配 / 释放内存),提前按最大序列长度分配缓存空间,确保内存使用的一致性并减少开销max_seq_len = 1024 # 模型支持的最大序列长度 batch_size, num_heads, head_dim = 1, 8, 64 # 示例参数 # 预分配KV缓存张量(零初始化) cache_k = torch.zeros((batch_size, num_heads, max_seq_len, head_dim), device="cuda") cache_v = torch.zeros((batch_size, num_heads, max_seq_len, head_dim), device="cuda") # 生成时直接写入对应切片(如第t个token写入第t个位置) cache_k[:, :, t:t+1, :] = keys_new cache_v[:, :, t:t+1, :] = values_new -
滑动窗口缓存(解决内存线性增长问题):仅保留最近的
window_size个 token 的缓存,截断早期 token,平衡内存与上下文相关性window_size = 512 # 滑动窗口大小 # 截断缓存,仅保留最后window_size个token cache_k = cache_k[:, :, -window_size:, :] cache_v = cache_v[:, :, -window_size:, :] -
模型外缓存(配合
torch.compile加速):将 KV Cache 模型外部,便于使用torch.compile编译模型,进一步提升计算效率(尤其适用于 Qwen3、Llama 3 等大模型)
-