时间差分学习

介绍时间差分学习的基本概念,自举、蒙特卡洛方法与 TD 方法的对比,TD (λ) 的基本思想以及前向 / 后向 TD (λ) 的等价性等内容

时间差分学习

  • TD 方法的基本思想

    • TD 学习是在 “没有模型” 的情况下,用一次真实转移来近似 Bellman 期望算子

    • 与 MC 方法相同,直接从经验中学习:TD 方法通过与环境的交互,不依赖于模型,是模型无关的

    • 与 MC 方法不同,学习自不完全回合:TD 方法能够在回合尚未结束时进行学习,即在回合的中间就开始更新估计

    • 在策略评估时,真实的值函数满足:

      vπ(s)=Eπ[Rt+1+γvπ(St+1)∣St=s]v_\pi (s)=\mathbb {E}_\pi\big [R_{t+1} + \gamma v_\pi (S_{t+1}) \mid S_t = s\big]
      • 即当前状态的价值 =一步奖励 + 折扣后的下一状态价值的期望,那么这个期望怎么计算?
      • DP 的答案:知道模型 P,R\mathcal {P}, \mathcal {R},精确计算期望(Full Backup)
      • MC 的答案:不知道模型,等整条轨迹结束,用真实回报 GtG_t 的均值逼近
      • TD 的答案:不知道模型,但也不等到结尾,用一次真实样本 + 当前估计来近似这个期望
  • 自举(Bootstrapping)

    • 与 MC 方法的根本区别:TD 使用当前对值函数的估计来更新自己,而不是依赖最终的回报

    • 每次更新不仅仅依赖于一个实际的回报,而是基于当前状态和动作的估计,以及下一状态的价值估计

    • 当获得新的样本 (St,Rt+1,St+1)(S_t, R_{t+1}, S_{t+1}) 时,使用当前的估计值来更新状态的价值函数,即

      V(St)←V(St)+α(Rt+1+γV(St+1)−V(St))V (S_t)\leftarrow V (S_t)+\alpha\left (R_{t+1}+\gamma V (S_{t+1})-V (S_t)\right)
      • 其中,V(St+1)V (S_{t+1}) 即用当前的价值函数取估计下一个状态的价值 —— 这就是 Bootstrap
      • TD 目标:Rt+1+γV(St+1)R_{t+1}+\gamma V (S_{t+1}),即预估的回报
      • TD 误差:δt=Rt+1+γV(St+1)−V(St)\delta_t=R_{t+1}+\gamma V (S_{t+1})-V (S_t),表示当前估计 V(St)V(S_{t})​ 和 “更好的估计目标” 差多少
        • δt>0\delta_t>0:实际比你想的好,低估了
        • δt<0\delta_t<0:实际比你想的差,高估了
        • δt=0\delta_t=0​:贝尔曼一致
      • 这也是为什么叫时间差分 —— 两个相邻时间点的估计之差,而不是整条时间序列
    • 更新过程:用 “对未来的当前猜测”,来修正 “对现在的猜测”

      • 用随机逼近(SGD)来更新

        V(St)←V(St)+αδtV (S_t)\leftarrow V (S_t)+\alpha\delta_t
      • 这等价于对平方误差做随机梯度下降

        min⁡12(Rt+1+γV(St+1)⏟target−V(St))2\min\frac12\Big (\underbrace {R_{t+1} + \gamma V (S_{t+1})}_{\text{target}}-V (S_t)\Big)^2
      • 即 TD 在用单步样本,逼近 Bellman 方程的固定点

      • Bellman 方程说 “平均应该这样”,而 TD 说 “我就用这一次发生的,慢慢往平均靠”

  • 蒙特卡洛方法与 TD 方法的形象对比

    • 蒙特卡洛方法:像看完一部电影后写影评
      • 蒙特卡洛方法就像一个影评人,必须把整部电影看完,从头到尾看清所有情节,才能写出一篇完整的影评。
      • 比如你想知道某个演员在电影中的表现有多好,影评人会等电影结束后,回想起演员在不同场景中的表现,然后总结打分。这相当于在强化学习中,蒙特卡洛方法等到整个回合(从初始状态到终止状态)结束后,再回过头来计算每个状态的价值。
    • 时序差分方法:像追剧时边看边预测剧情
      • 时序差分方法就像一个追剧爱好者,每看一集就开始预测下一集剧情,然后用下一集的内容来调整自己的预测。
      • 比如你在看电视剧,看到男主角一脸愁容时,你预测接下来他会有重大打击。看了下一集发现他真的失业了,你会根据这个信息修正自己的预测。TD 方法就是根据 “当前的状态价值” 加上 “下一个状态的反馈”,不断调整估计。
  • 偏差(bias)和方差(variance)的权衡

    • 蒙特卡洛方法
      • GtG_t 表示从某个状态开始,到达终止状态所得到的真实总回报
      • 完全基于实际经历,不使用当前估计值,是 vπ(St)v_{\pi}(S_t) 的无偏估计
      • GtG_t 的方差较大,因为它包含整个未来回报序列,依赖于多个随机变量(策略选择的动作、环境转移、奖励)
      • 每次经历不同,回报可能变化很大,更新不稳定,导致收敛较慢
      • 必须等 episode 结束,不适合持续任务
    • TD 方法
      • 真 TD 目标 Rt+1+γVπ(St+1)R_{t+1}+\gamma V_{\pi}(S_{t+1}) 也是 vπ(St)v_{\pi}(S_t) 的无偏估计,其中的 vπ(St+1)v_\pi (S_{t+1}) 是在策略 π\pi 下状态 St+1S_{t+1} 的真实状态价值函数,是期望意义下的 “正确答案”
      • 而 TD 目标 Rt+1+γV(St+1)R_{t+1}+\gamma V (S_{t+1}) 中的 V(St+1)V (S_{t+1}) 是当前对下一状态价值的估计,而非真实未来回报,是 vπ(St)v_{\pi}(S_t)​ 的有偏估计
      • TD 目标的方差较小,因为它只使用当前的即时奖励和一个时间步的估计值,不依赖完整轨迹,并且通过自举更新逐步减少方差
      • TD 更新更稳定,尤其在数据稀缺或回合长时尤为重要
  • TD 与 MC 相比的优点

    • TD 可以在知道最终结果前进行学习
    • TD 可以在不知道最终结果的情况下学习
    • TD 可以从不完整的序列中学习
    • TD 可以在线学习,每一步之后更新(增量式)的学习,每走一步就更新一次价值函数;适合实时系统,不需要完整数据批量处理)
    • TD 利用了马尔可夫性质(未来只依赖当前状态),隐式地构建最大似然马尔可夫过程
  • Bootstrapping 和 Sampling(引导和采样)

    • Bootstrapping:在更新估计时,利用当前的估计值来计算新的估计值
      • MC 不进行 Bootstrap,而 DP 和 TD 进行
    • Sampling:是否通过从环境中采样来估计期望值
      • DP 算法是 No Sampling 的,它需要完全了解环境动态,详细地知道每种可能性,即 Full Backup

      • MC 和 TD 是 Sampling 的,它们只需要从环境中采样,即 Sample Backup
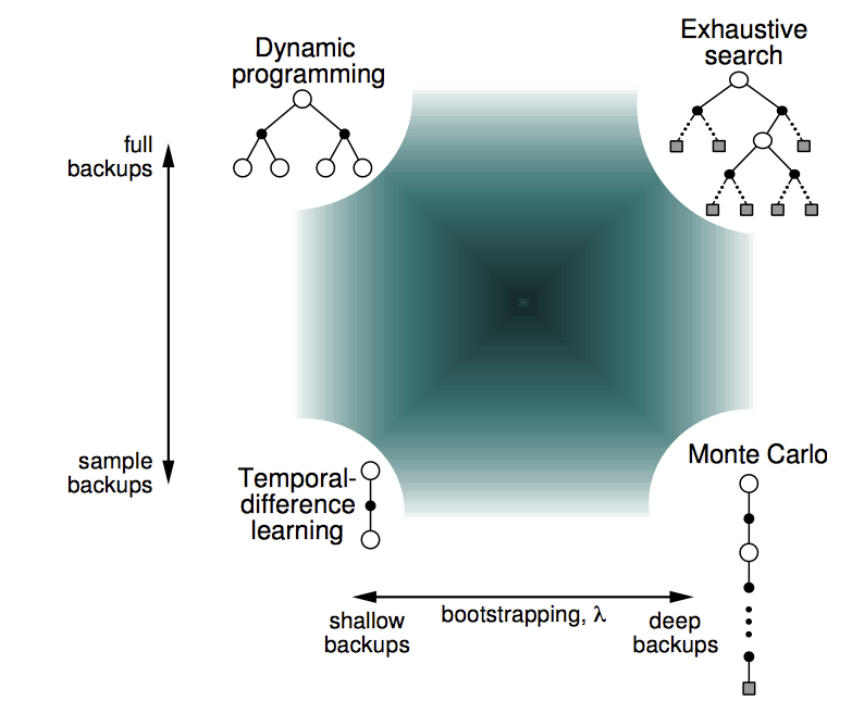
        DP、MC 和 TD 的对比

  • MC 方法、TD 方法、动态规划的对比

比较点动态规划(DP)蒙特卡洛(MC)时序差分(TD)
是否 Bootstrapping是否是
是否 Sampling否(用模型计算期望)是(直接采样)是(直接采样)
是否需要完整回合不需要需要不需要
是否需要环境模型是否否

TD (λ\lambda)

TD (λ\lambda) 的基本思想

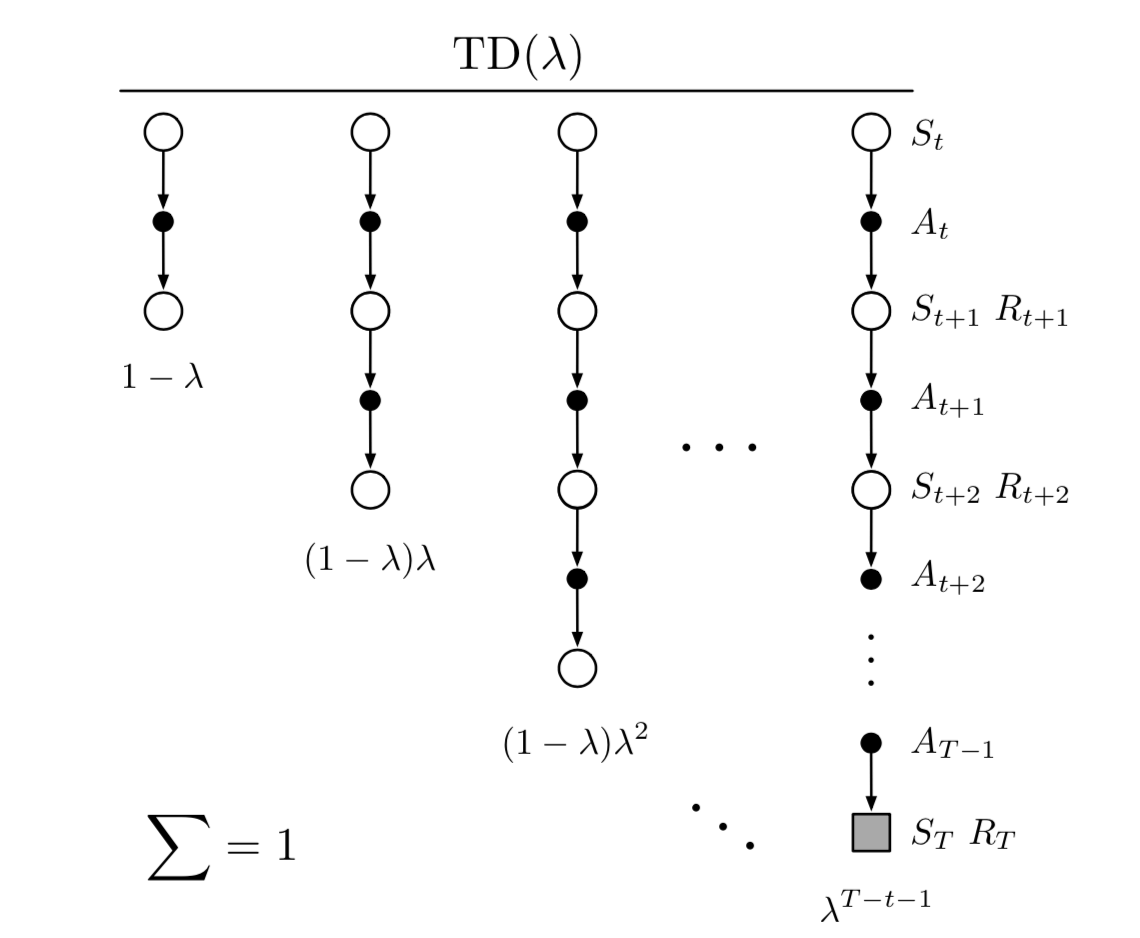
  • TD (λ) 是 TD 和 MC 的 “加权平均”,使用**资格迹(eligibility traces)**累积影响
  • TD (λ) 的基本思想
    • 让 TD 目标猜测未来 nn 步

      (TD)n=1Gt(1)=Rt+1+γV(St+1)n=2Gt(2)=Rt+1+γRt+2+γ2V(St+2)(MC)n=∞Gt(∞)=Rt+1+γRt+2+...+γT−1RT\begin {align*} (TD)\quad n=1\quad & G_{t}^{(1)}=R_{t+1}+\gamma V (S_{t+1}) \\ n=2\quad & G_{t}^{(2)}=R_{t+1}+\gamma R_{t+2}+\gamma^{2} V (S_{t+2}) \\ (MC)\quad n=\infty\quad & G_{t}^{(\infty)}=R_{t+1}+\gamma R_{t+2}+...+\gamma^{T-1} R_{T} \end {align*}
    • nn 步回报

      Gt(n)=Rt+1+γRt+2+⋯+γnV(St+n)G_{t}^{(n)}=R_{t+1}+\gamma R_{t+2}+\cdots+\gamma^{n} V (S_{t+n})
    • nn 步 TD 学习

      V(St)←V(St)+α(Gt(n)−V(St))V (S_t)\gets V (S_t)+\alpha (G_t^{(n)}-V (S_t))

TD (λ)

  • 两种不同的视角
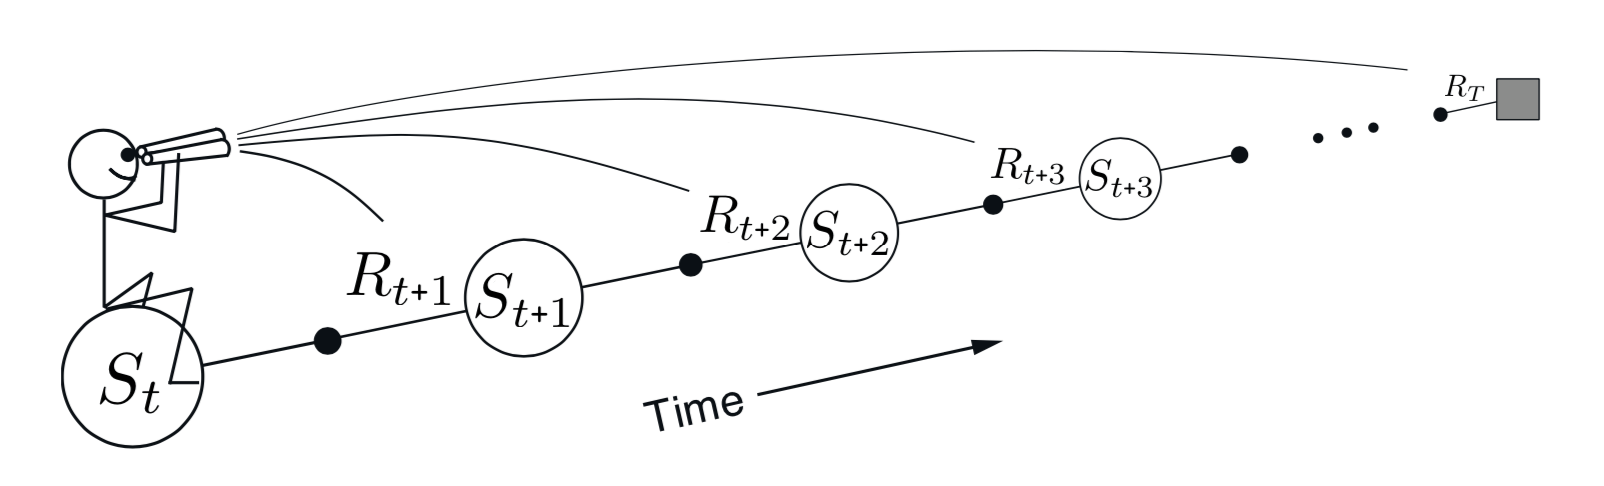
    • 前向视角(定义层面的)
      • 如果我能看到未来,我该怎么更新?
      • 理论清晰,但必须等未来奖励出来才能计算 Gt(n)G_{t}^{(n)}
    • 后向视角(算法层面实现的)
      • 当前 TD 误差,应该影响哪些过去状态?
      • 用资格迹实现在线更新,无需等 episode 结束

前向 TD (λ\lambda​)

  • 引入 λ\lambda,合并来自所有不同时间步的信息

  • λ\lambda- 回报

    Gtλ=(1−λ)∑n=1∞λn−1Gt(n)G_t^{\lambda}=(1-\lambda)\displaystyle\sum_{n=1}^{\infty}\lambda^{n-1} G_t^{(n)}
  • λ\lambda 的含义

    • 如果 λ=0\lambda=0,则整体更新减少到其第一个分量,只信一步的预测,即 TD (0) 更新
    • 如果 λ=1\lambda=1,则整体更新减少到其最后一个分量,只信真实回报,即 MC 更新
  • 更新价值函数

    V(St)←V(St)+α(Gtλ−V(St))V (S_t)\gets V (S_t)+\alpha (G_t^{\lambda}-V (S_t))
  • 需要在完整的回合之后计算,不适合在线学习

    前向 TD (λ)

后向 TD (λ\lambda)

  • 资格迹(Eligibility traces)

    • 资格迹是 “Bellman 误差的时间传播核”
    • 对每个状态维护一个 “记忆痕迹”,表示 “状态 s 最近和当前时间 t 的相关程度”,即 “最近访问过哪些状态”
    • 每访问一个状态,资格迹 +1(或置为 1)
    • 随着时间推移,资格迹以 γλ\gamma\lambda 衰减
    • 当 TD 误差产生时,不只当前状态更新,资格迹值越大,更新越多
    • 资格迹 ≈ 强化学习中的 “注意力残留” ,就像你刚刚看完一本书,印象最深的部分更容易被你调整认知
  • 在时间步 tt,状态 ss 的资格迹为 Et(s)∈R+\mathbb {E}_t (s)\in \mathbb {R}^+,λ\lambda 为资格迹衰减因子

    {Et(s)=γλEt−1(s),fors≠StEt(St)=γλEt−1(St)+1,fors=St⇒Et(s)=γλEt−1(s)+1(St=s)\begin {cases} \mathbb {E}_t (s) = \gamma \lambda \mathbb {E}_{t-1}(s), & \text{for} s \ne S_t \\ \mathbb {E}_t (S_t) = \gamma \lambda \mathbb {E}_{t-1}(S_t) + 1, & \text{for} s = S_t \\ \Rightarrow \mathbb {E}_t (s) = \gamma \lambda \mathbb {E}_{t-1}(s) + \mathbf {1}(S_t = s) \end {cases}
  • 资格迹记录了最近哪些状态或动作对当前学习目标的重要性,资格迹通过控制 “谁被更新” 和 “更新多少”,提供更新范围的衰减机制

  • 资格迹值越高,说明状态越 “新鲜”,该状态的价值函数(或动作值函数)就越需要根据当前的强化信号(如奖励)进行更新:

    δt=Rt+1+γV(St+1)−V(St)V(St)←V(St)+αδtEt(s)\delta_t=R_{t+1}+\gamma V (S_{t+1})-V (S_t)\\ V (S_t)\gets V (S_t)+\alpha\delta_t \mathbb {E}_t (s)
  • 当前 TD 误差不仅更新 StS_t,还按资格迹大小,回传给过去的状态

  • 后向 TD (λ\lambda) 的特殊情况

    • 当 λ=0\lambda=0 时,Et(s)=1(St=s)\mathbb {E}_t (s)=\mathbf {1}(S_t=s),仅有当前状态被更新,退化为 TD(0)\text{TD}(0)
    • 当 λ=1\lambda=1 时,Et(s)=∑k=0∞γk1(St+k=s)\mathbb {E}_t (s)=\displaystyle\sum_{k=0}^{\infty}\gamma^k1 (S_{t+k}=s),退化为 MC 或称为 TD(1)\text{TD}(1)

前向 / 后向 / MC/TD 的等价性

  • 前向与后向的等价性

    • 前向混合目标:

      V(St)→Gtλ=(1−λ)∑n=1∞λn−1Gt(n)V (S_t)\to G_t^\lambda=(1-\lambda)\sum_{n=1}^{\infty}\lambda^{n-1} G_t^{(n)}
    • 后向混合误差,把未来每一步 TD 误差累积起来:

      • TD 误差的公式

        δt=Rt+1+γV(St+1)−V(St)\delta_t=R_{t+1}+\gamma V (S_{t+1})-V (S_t)
      • 加权 TD 误差和

        ∑n=0∞(γλ)nδt+n\sum_{n=0}^{\infty}(\gamma\lambda)^n\delta_{t+n}
      • 代入 δt+n\delta_{t+n}​:

        ∑n=0∞(γλ)nδt+n=∑n=0∞(γλ)n(Rt+n+1+γV(St+n+1)−V(St+n))\sum_{n=0}^{\infty}(\gamma\lambda)^n\delta_{t+n}=\sum_{n=0}^{\infty}(\gamma\lambda)^n\big (R_{t+n+1}+\gamma V (S_{t+n+1})-V (S_{t+n})\big)
      • 拆开求和得到:

        ∑n=0∞(γλ)nRt+n+1⏟(A)+∑n=0∞(γλ)nγV(St+n+1)⏟(B)−∑n=0∞(γλ)nV(St+n)⏟(C)\underbrace {\sum_{n=0}^{\infty} (\gamma\lambda)^n R_{t+n+1} }_{(A)} + \underbrace {\sum_{n=0}^{\infty} (\gamma\lambda)^n\gamma V (S_{t+n+1}) }_{(B)} - \underbrace {\sum_{n=0}^{\infty} (\gamma\lambda)^n V (S_{t+n}) }_{(C)}
      • 对 (B) 做变量替换 m=n+1m=n+1:

        (B)=∑m=1∞(γλ)m−1γV(St+m)=∑m=1∞(γλ)mV(St+m)(C)=V(St)+∑m=1∞(γλ)mV(St+m)\begin {align*} (B)&=\sum_{m=1}^{\infty}(\gamma\lambda)^{m-1}\gamma V (S_{t+m})\\&=\sum_{m=1}^{\infty}(\gamma\lambda)^m V (S_{t+m})\\ (C)&=V (S_t)+\sum_{m=1}^{\infty}(\gamma\lambda)^m V (S_{t+m}) \end {align*}
      • 对 (B) 和 (C) 做 “错位相消”

        (B)−(C)=−V(St)(B)-(C)=-V (S_t)
      • 合并得到

        ∑n=0∞(γλ)nδt+n=∑n=0∞(γλ)nRt+n+1−V(St)\sum_{n=0}^{\infty}(\gamma\lambda)^n\delta_{t+n}=\sum_{n=0}^{\infty}(\gamma\lambda)^n R_{t+n+1}-V (S_t)
      • 把奖励项写成 λ- 回报

        ∑n=0∞(γλ)nRt+n+1=(1−λ)∑n=1∞λn−1(∑k=0n−1γkRt+k+1+γnV(St+n))\sum_{n=0}^{\infty}(\gamma\lambda)^n R_{t+n+1}=(1-\lambda)\sum_{n=1}^{\infty}\lambda^{n-1}\Big (\sum_{k=0}^{n-1}\gamma^k R_{t+k+1}+\gamma^n V (S_{t+n})\Big)
      • 上式正是 GtλG_t^\lambda 的展开形式,从而得到:

        Gtλ−V(St)=∑k=t∞(γλ)k−tδkG_t^\lambda - V (S_t)=\sum_{k=t}^{\infty}(\gamma\lambda)^{k-t}\delta_k
    • 这说明:前向 λ- 回报 = 后向 TD 误差的指数加权和,也即前向 / 后向的更新量是等价的

  • TD(λ)\text{TD}(\lambda) 与 MC 方法

    • 对于 TD(λ)\text{TD}(\lambda),展开资格迹(数学归纳法)

      Et(s)=γλEt−1(s)+1(St=s)={0 if t<k(γλ)t−k if t≥k \begin {align*} \mathbb {E}_{t}(s) & =\gamma\lambda \mathbb {E}_{t-1}(s)+\mathbf {1}(S_{t}=s) \\ & =\left\{\begin {array} {ll} 0 & \mathrm {~if~} t<k \\ (\gamma\lambda)^{t-k} & \mathrm {~if~} t\geq k \end {array}\right. \end {align*}
    • 上述展开形式,也说明了状态 ss 的 “信用” 会以 γλ\gamma\lambda 指数衰减

    • 对于 TD(1)\text{TD}(1) ,其资格迹不衰减

      Et(s)=(γ)t−k\mathbb {E}_t (s)=(\gamma)^{t-k}
    • 根据 TD(λ)\text{TD}(\lambda) 的更新规则,对状态 SkS_k,把一个 episode 内所有更新加起来

    ∑t=1T−1αδtEt(s)=α∑t=kT−1γt−kδt=α(Gk−V(Sk))\sum_{t=1}^{\mathcal {T}-1}\alpha\delta_{t}\mathbb {E}_{t}(s)=\alpha\sum_{t=k}^{\mathcal {T}-1}\gamma^{t-k}\delta_{t}=\alpha\left (G_{k}-V (S_{k})\right)
    • 上式中的累计 TD 误差 = MC 误差:

      ∑t=kT−1γt−kδt=δt+γδt+1+γ2δt+2+...+γT−1−tδT−1=Rt+1+γV(St+1)−V(St)+γRt+2+γ2V(St+2)−γV(St+1)+γ2Rt+3+γ3V(St+3)−γ2V(St+2)+γT−1−tRT+γT−tV(ST)−γT−1−tV(ST−1)=Rt+1+γRt+2+γ2Rt+3...+γT−1−tRT−V(St)=Gt−V(St)\begin {align*} \sum_{t=k}^{\mathcal {T}-1}\gamma^{t-k}\delta_{t}=&\delta_t+\gamma\delta_{t+1}+\gamma^2\delta_{t+2}+...+\gamma^{T-1-t}\delta_{T-1} \\ &=R_{t+1}+\gamma V (S_{t+1})-V (S_t) \\ &+\gamma R_{t+2}+\gamma^2V (S_{t+2})-\gamma V (S_{t+1}) \\ &+\gamma^2R_{t+3}+\gamma^3V (S_{t+3})-\gamma^2V (S_{t+2}) \\ &+\gamma^{T-1-t} R_{T}+\gamma^{T-t} V (S_{T})-\gamma^{T-1-t} V (S_{T-1}) \\ &=R_{t+1}+\gamma R_{t+2}+\gamma^2R_{t+3}...+\gamma^{T-1-t} R_T-V (S_t) \\ &=G_t-V (S_t) \end {align*}
    • TD(1)\text{TD}(1) 大致相当于 Every-Visit 蒙特卡洛:

      • 每次访问状态都更新
      • 更新量等于 MC 误差
      • 但实现是在线、逐步的
    • 对于一般的 λ\lambda,TD 误差也会累积到 λ\lambda - 误差

      ∑k=t∞(γλ)k−tδk=Gtλ−V(St)\sum_{k=t}^{\infty}(\gamma\lambda)^{k-t}\delta_k=G_t^\lambda - V (S_t)
    • λ 的作用本质:控制 TD 误差向过去传播的 “深度”

  • 从上式可以看出

    • 前后向的等价性与 TD (1) 和 MC 的等价性之间的推导过程在数学上是相同的
    • TD (λ) 的前后向等价,本质上就是 “TD 误差 → 回报” 的推广版 MC 推导
    • MC 不是特例,MC 是 TD (λ) 在 λ=1 时的极限情形

离线与在线

  • 离线与在线

    • “离线” 不是指不能边走边学,而是指:某个状态 StS_t 的更新,要等到未来奖励都出现后,才能算清楚它应该更新多少
    • 在线指的是每一步一到,就立刻更新,不等未来
  • 前述推导的 “离线性”

    • 在在线世界中,普通 TD (λ) 实际上每一步会立即更新 VV,即 V(St+n)V (S_{t+n}) 在未来会被更新,而 Forward TD (λ) 假设所有 V(⋅)V (\cdot) 都是冻结的
    • 在前面的等价性推导过程中,实际上也都基于**“价值函数在一个 episode 内不变”**的分析前提
    • 或者说,在tabular + 小步长情况下,每一步对 VV 的改变是 O(α)O (\alpha),误差是 O(α2)O (\alpha^2),一阶近似下 Vt+1≈VtV_{t+1}\approx V_t
    • 因此,普通 TD (λ) 被视为:forward TD (λ) 的一阶近似在线实现
  • 在真正的在线世界中

    • 后面的 TD 误差,是在 “新函数” 上算的,而 forward view 的目标,是在 “旧函数” 上定义的
    • 因此,在在线世界中,对于 0 < λ < 1,前向和后向不再严格等价,对于 λ = 1 更明显地不等价
  • 离线

    λ 值Forward ViewBackward View
    λ = 0TD (0)TD (0)
    0 < λ < 1Forward TD (λ)(λ-return)TD (λ)(eligibility traces)
    λ = 1Monte Carlo(完整回报)TD (1)(累计 TD 误差)
  • 在线

    λ 值Forward ViewBackward View精确在线更新
    λ = 0TD (0)TD (0)TD (0)
    0 < λ < 1≠ TD (λ)TD (λ) ≠ Forward TD (λ)Exact Online TD (λ)
    λ = 1= MCTD (1) ≠ MCExact Online TD (1)
  • Sutton et al. 2014 提出了 Exact Online TD (λ) ,其目的是在每一步,用一个额外的修正项,抵消 “价值函数变化” 带来的偏差

    • 问题根源中的偏差来自

      forward 目标用的是Vold,而 TD 误差用的是Vnew\text{forward 目标用的是} V_{\text{old}}, \quad \text{而 TD 误差用的是} V_{\text{new}}
    • Exact Online TD (λ) 显示跟踪前后价值函数的差距

      ΔV=Vt−Vt−1\Delta V = V_t - V_{t-1}
    • 在 eligibility trace 更新中加入修正项以显式补偿 “VV 在在线过程中变化” 带来的二阶误差

    • 确保每一步的在线更新之和等于假设 VV 冻结时的 forward 更新

    • Exact Online TD (λ) 是唯一一个在任意时刻,都严格等价于 forward TD (λ) 的在线算法

  • 三种方法的对比

    方法使用的估计是否偏差是否高方差
    MCGtG_t(整个回报),收敛于局部最优无偏高方差
    TD (0)Rt+1+γv^(St+1)R_{t+1} + \gamma \hat {v}(S_{t+1}),收敛于全局最优有偏低方差
    TD (λ\lambda)λ\lambda - 回报 GtλG_t^\lambda控制偏差 - 方差平衡
    Q-learningRt+1+γmax⁡a′q^(St+1,a′)R_{t+1} + \gamma \max_{a'} \hat {q}(S_{t+1}, a')off-policy 学习,学习更快

TD 控制(SARSA)

  • 基本思想

    • On-Policy 的 TD 控制(SARSA)
    • 应用 TD 到 Q(S,A)Q (S,A) 中
    • 每一个时间步均进行更新
  • 为什么控制要用到动作值函数

    • 策略改进需要比较动作
    • V(s)V (s) 没法直接比较动作
  • 名称由来

    • 表示一组连续的五元组:(St,At,Rt+1,St+1,At+1)(S_t, A_t, R_{t+1}, S_{t+1}, A_{t+1})
    • 即:当前状态、当前动作、奖励、下一个状态、下一个动作
    • 下一步动作是按当前策略采样的(On-policy)
  • SARSA 的推导

    • 首先有动作值函数的贝尔曼期望方程
    qπ(s,a)=E[Rt+1+γqπ(St+1,At+1)∣St=s,At=a]q_\pi (s,a) =\mathbb {E} \big [R_{t+1} + \gamma q_\pi (S_{t+1}, A_{t+1}) \mid S_t=s, A_t=a \big]
    • 与 TD 方法类似,样本近似 Bellman 右边:

      Rt+1+γQ(St+1,At+1)R_{t+1}+\gamma Q (S_{t+1},A_{t+1})
    • 由此,其 TD 误差变为

      δt=Rt+1+γQ(St+1,At+1)−Q(St,At)\delta_t=R_{t+1}+\gamma Q (S_{t+1},A_{t+1})-Q (S_t,A_t)
    • 即,使用当前的动作值函数去估计下一个状态与动作的值

      Q(St,At)←Q(St,At)+αδtQ (S_t,A_t)\leftarrow Q (S_t,A_t)+\alpha \delta_t
    • 其中,At+1A_{t+1} 是当前行为策略π\pi​​ 真正采样出来的动作(On-Policy),其评估的是当前行为策略,更新用的就是行为本身

  • 初始化:

    • 动作值函数 Q(s,a)Q (s, a) 随机初始化
    • ϵ\epsilon- 贪婪策略初始化
  • 循环更新(对于每个时间步):

    1. 从起始状态 S0S_0 开始

    2. 根据 ϵ\epsilon- 贪婪策略选择动作 AtA_t

    3. 执行动作 AtA_t,观察奖励 Rt+1R_{t+1} 和下一状态 St+1S_{t+1}

    4. 根据策略选择下一动作 At+1A_{t+1}

    5. 更新动作值函数:

      Q(St,At)←Q(St,At)+α(Rt+1+γQ(St+1,At+1)−Q(St,At)) Q (S_t, A_t) \leftarrow Q (S_t, A_t) + \alpha \left (R_{t+1} + \gamma Q (S_{t+1}, A_{t+1}) - Q (S_t, A_t) \right)
    6. 将状态和动作更新为 St+1S_{t+1} 和 At+1A_{t+1}

    7. 重复直到达到终止状态

  • 更新策略:使用新的 Q(s,a)Q (s, a) 利用贪婪算法改进策略

  • SARSA 的收敛性:SARSA 收敛于最优动作值函数,即 Q(s,a)→q∗(s,a)Q (s,a)\rightarrow q_*(s,a),当满足

    • GLIE 性质

SARSA (λ\lambda)

  • 引入资格迹,考虑多步回报

    (SARSA)n=1qt(1)=Rt+1+γQ(St+1)n=2qt(2)=Rt+1+γRt+2+γ2Q(St+2)(MC)n=∞qt(∞)=Rt+1+γRt+2+...+γT−1RT\begin {align*} (SARSA)\quad n=1\quad & q_{t}^{(1)}=R_{t+1}+\gamma Q (S_{t+1}) \\ n=2\quad & q_{t}^{(2)}=R_{t+1}+\gamma R_{t+2}+\gamma^{2} Q (S_{t+2}) \\ (MC)\quad n=\infty\quad & q_{t}^{(\infty)}=R_{t+1}+\gamma R_{t+2}+...+\gamma^{T-1} R_{T} \end {align*}
  • nn 步 Q 回报

    qt(n)=Rt+1+γRt+2+⋯+γnQ(St+n)q_{t}^{(n)}=R_{t+1}+\gamma R_{t+2}+\cdots+\gamma^{n} Q (S_{t+n})
  • nn 步 SARSA

    Q(St,At)←Q(St,At)+α(qt(n)−Q(St,At))Q (S_t,A_t)\leftarrow Q (S_t,A_t)+\alpha\left (q_t^{(n)}-Q (S_t,A_t)\right)
  • TD 误差

    δt=Rt+1+γQ(St+1,At+1)−Q(St,At)\delta_t=R_{t+1}+\gamma Q (S_{t+1},A_{t+1})-Q (S_t,A_t)
  • 核心思想

    • 不再只更新 (St,At)(S_t, A_t) 一个状态 - 动作对
    • 对 “最近访问过” 的所有状态 - 动作对都按其资格迹权重进行更新
    • 将过去的 TD 误差反向传播(如梯度传播)
  • 引入 λ\lambda

    • λ\lambda-Q 回报

      Gtλ=(1−λ)∑n=1∞λn−1qt(n)G_t^\lambda=(1-\lambda)\displaystyle\sum_{n=1}^\infty\lambda^{n-1} q_t^{(n)}
    • 前瞻性 SARSA (λ\lambda)

      • 从 “未来回报” 的视角计算状态 - 动作值函数的更新

        Q(St,At)←Q(St,At)+α(qtλ−Q(St,At))Q (S_t,A_t)\leftarrow Q (S_t,A_t)+\alpha\left (q_t^{\lambda}-Q (S_t,A_t)\right)
      • 由于需要计算 nn- 步回报,前瞻性 SARSA (λ\lambda) 必须等待整个回合结束才能更新动作值函数

      • 无法在线更新

      • SARSA (λ) ≈ 用λ-回报更新动作价值函数

    • 后瞻性 SARSA (λ\lambda​)

      • 从 “过去的状态 - 动作对对当前 TD 误差的影响” 的视角出发

      • 将 TD 误差 δt\delta_t 不仅用于更新当前状态 - 动作对,还用于调整所有之前访问过的状态 - 动作对

      • Et(s,a)\mathbb {E}_t (s,a) 是资格迹(Eligibility Traces),表示某状态 - 动作对与当前学习更新的相关性

        • 对所有状态 - 动作对初始化,Et(s,a)=0\mathbb {E}_t (s,a)=0
        • 更新规则为 Et(s,a)←γλEt−1(s,a)+1(St=s,At=a)\mathbb {E}_t (s,a)\gets \gamma\lambda \mathbb {E}_{t-1}(s,a)+\mathbf {1}(S_t=s,A_t=a)
      • 对动作值函数进行更新

        δt=Rt+1+γQ(St+1,At+1)−Q(St,At)Q(s,a)←Q(s,a)+αδtEt(s,a)\delta_t=R_{t+1}+\gamma Q (S_{t+1},A_{t+1})-Q (S_t,A_t)\\ Q (s,a)\leftarrow Q (s,a)+\alpha\delta_t\mathbb {E}_t (s,a)
    • 按时间步更新,无需完整的轨迹,可以逐步在线更新值函数,效率高

  • SARSA (0) → 纯 TD

  • SARSA (1) →Every-visit Monte Carlo Control(on-policy)

    • 在线实现是近似
    • Exact Online SARSA (1) 才严格等价
  • 总而言之,SARSA 是:on-policy + TD + 动作价值函数 + 样本 Bellman 期望更新;用真实执行的下一步动作,学习真实执行策略的价值

这篇文档有帮助吗?

On this page

页面信息