Q-Learning
介绍 Q-Learning 算法的基本原理,重要性采样以及从算子与不动点的角度看强化学习等内容
- Q-learning 是一种 off-policy 的 TD 控制算法,通过 “假设下一步采取最优动作(max)”,来直接学习最优动作价值函数 ,与实际行为策略无关
- 基本思想
- Off-Policy 学习
- 希望观察他人的行为 / 利用旧策略来学习
- 希望遵循探索性策略来学习最优策略
- 希望遵循一个策略来学习多个策略
重要性采样
-
离策略学习
- 目标策略 :用于更新值函数的策略,即
- 行为策略 :实际选择动作的策略,在当前状态下,下一步动作从行为策略采样,即
- 目标:学习最优策略 ,即
-
重要性采样(Importance Sampling)
-
如果你想估计:
-
但你手头的数据却来自另一个分布 ,怎么办?
-
数学技巧:如何估计另一个分布的期望
-
用 采样,但用 修正偏差
-
-
离策略蒙特卡洛:利用从 得到的回报来评估
- 缺点:方差过大;如果 为 0 该方法失效
- 若存在状态–动作对 ,使得 且
- 则重要性采样比率 将变为无穷大,导致估计不稳定
- 这是 Support mismatch (支持集不重叠) 问题:目标策略选择了行为策略从未选择过的动作,无法通过行为策略的数据来估计目标策略的价值
-
离策略 TD 学习:基于重要性采样,给 TD 目标添加权重,即
- 依然存在高方差和支持集不重叠问题
-
为什么二者需要重要性采样?
- 只要你的更新目标里包含 “对目标策略 下动作的期望”,而你的数据来自另一个策略 ,就必须使用重要性采样
- Q-learning 之所以不需要重要性采样,是因为它根本不在估计任何策略的期望,而是在逼近 Bellman 最优算子
- 离策略 MC 的目标是从行为策略 中采样轨迹,来评估并改进某个目标策略 的价值
Q-Learning 的实现
-
Q-Learning 的关键突破:完全绕开重要性采样
- Q-learning 根本不在做策略评估,没有 ,没有对动作分布取期望
- Q-Learning 学的是什么?不是 ,而是最优动作价值函数
- 考虑动作值函数 ,不需要重要性采样
- 不存在用 的分布去估计 的期望
- Q-Learning 直接对 Bellman 最优方程进行随机近似,不涉及对目标策略期望的估计,因此不需要重要性采样
-
Q-Learning(SARSAMAX)的推导过程:
-
Q-Learning 更新的是 Bellman 最优算子
-
和 TD / SARSA 一样,样本近似期望(TD-Target 与行为策略 无关):
-
TD 误差(Q-learning):
-
更新规则:
-
这一更新规则本质上是在最小化如下均方 TD 误差:
-
其中 并非环境中实际执行的动作,而是由当前动作价值函数在下一个状态上给出的记号性贪婪选择
-
在上述公式中可以看到,Q-Learning 更新时用的是 ,而不是从行为策略中采样的动作,与行为策略完全无关;即行为 ≠ 目标,故 Q-Learning 是 off-policy 的
-
在 Q-Learning 中,目标策略 是隐式的,其选取贪婪策略
-
-
综上所述,Q-learning = off-policy + TD + max-backup + 学最优动作价值函数,它假装未来会完美贪心,从而忽略探索的风险
-
当状态–动作空间巨大或连续时,无法再用表格存储 ,于是将其替换为参数化函数逼近:
-
在这种情况下,Q-learning 的更新不再是 “直接改表格”,而是对参数 做梯度下降:
-
这一步并没有改变 Q-learning 的本质假设:
- TD 目标仍然来自一步 bootstrap
- 下一状态价值仍然通过 给出
- 行为策略仍可包含探索,但目标值函数始终对应最优贪心策略
- 而 DQN 所做的事,正是将 替换为 深度神经网络 ,并配合经验回放、目标网络等工程机制,但这些机制并未改变 Q-learning 的 “off-policy + TD + max-backup” 核心结构
类别 Full Backup (DP) Sample Backup (TD) Bellman 期望方程() Iterative Policy Evaluation TD Learning
Bellman 期望方程() Q-Policy Iteration SARSA Bellman 最优方程() Q-Value Iteration Q-Learning 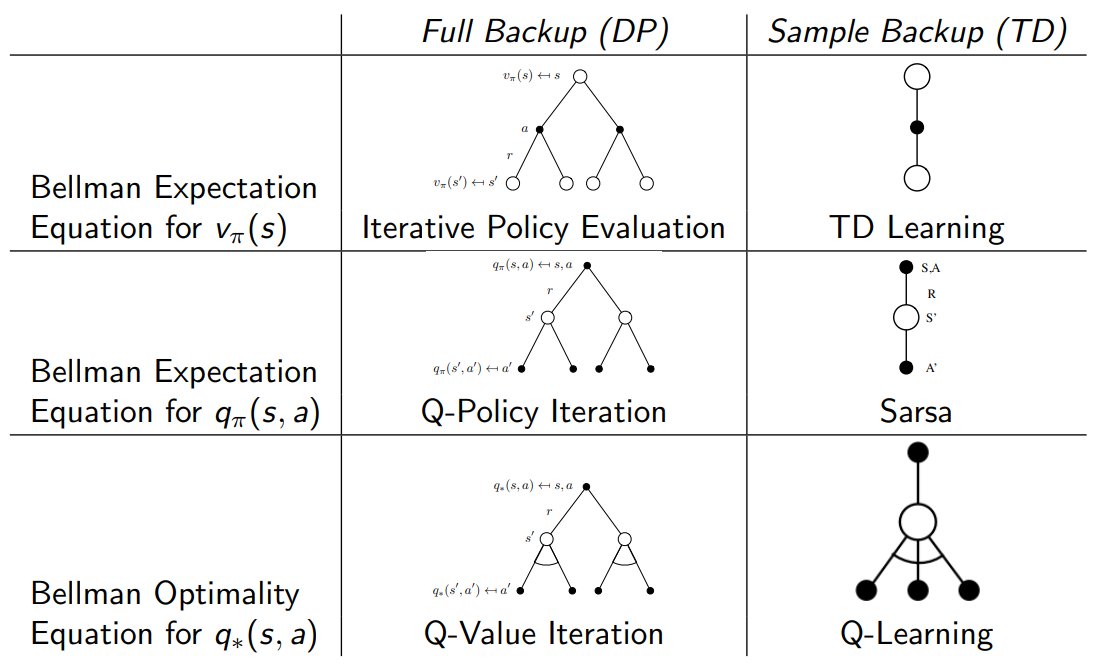
从算子与不动点的角度看强化学习
这篇文档有帮助吗?