强化学习与 LLM

介绍强化学习与大语言模型(LLM)的结合,包括 LLM 代理的设计与实现、LLM 在强化学习中的应用,以及当前面临的挑战和未来的发展方向

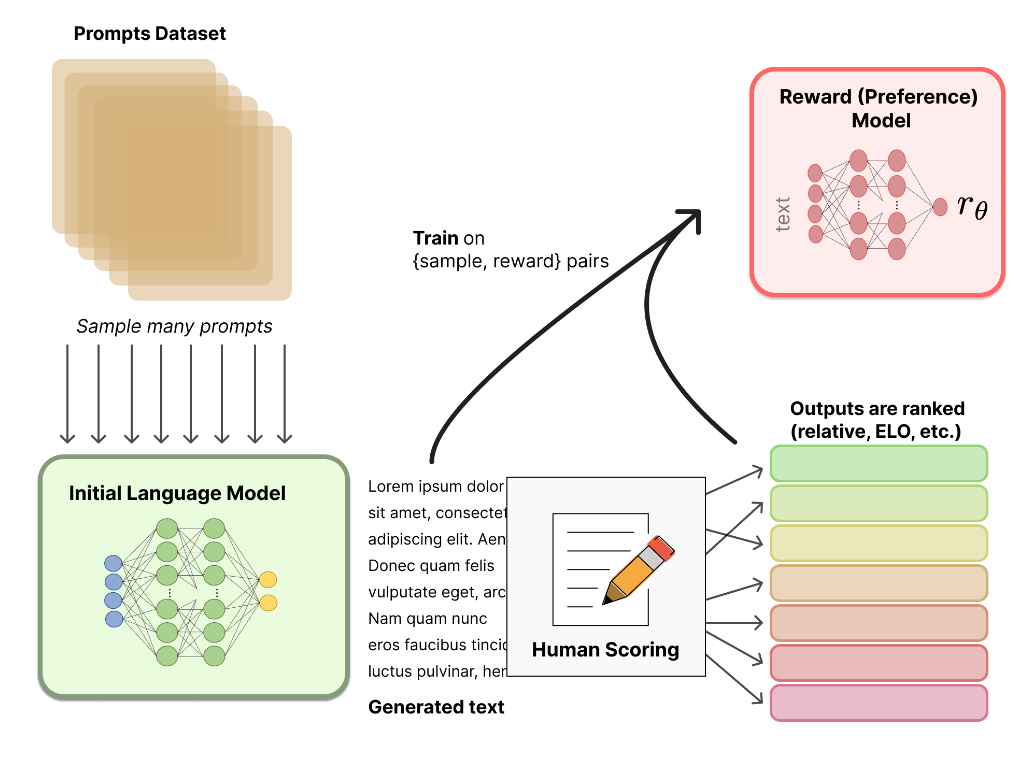
RLHF 范式

  • RLHF 的流程
    • SFT 监督微调阶段:得到 πSFT\pi^{SFT}

    • 奖励建模阶段

      • 根据 Bradley-Terry(BT)模型,偏好分布 p∗p^* 可以建模为

        p∗(y1≻y2∣x)=exp⁡(r∗(x,y1))exp⁡(r∗(x,y1))+exp⁡(r∗(x,y2))p^*(y_1\succ y_2\mid x)=\frac {\exp\left (r^*(x,y_1)\right)}{\exp\left (r^*(x,y_1)\right)+\exp\left (r^*(x,y_2)\right)}
      • 假设从偏好分布 p∗p^* 采样得到数据集(人类偏好反馈数据集)D=x(i),yw(i),yl(i)i=1N\mathcal {D}={x^{(i)},y_w^{(i)},y_l^{(i)}}^N_{i=1}

      • 可以通过最大似然估计奖励模型 rϕ(x,y)r_\phi (x,y) 的参数

        LR(rϕ,D)=−E(x,yw,yl)∼D[log⁡σ(rϕ(x,yw)−rϕ(x,yl))]\mathcal {L}_{R}(r_{\phi},\mathcal {D})=-\mathbb {E}_{(x,y_{w},y_{l})\sim\mathcal {D}}\left [\log\sigma (r_{\phi}(x,y_{w})-r_{\phi}(x,y_{l}))\right]
      • 通常,奖励模型从 πSFT\pi^{SFT} 初始化,并在最后加一层线性层来生成标量奖励

      • 为了降低方差,可以正则化奖励,如 Ex,y∼D[rϕ(x,y)]\mathbb {E}_{x,y\sim\mathcal {D}}\left [r_{\phi}(x,y)\right]

      奖励模型建模

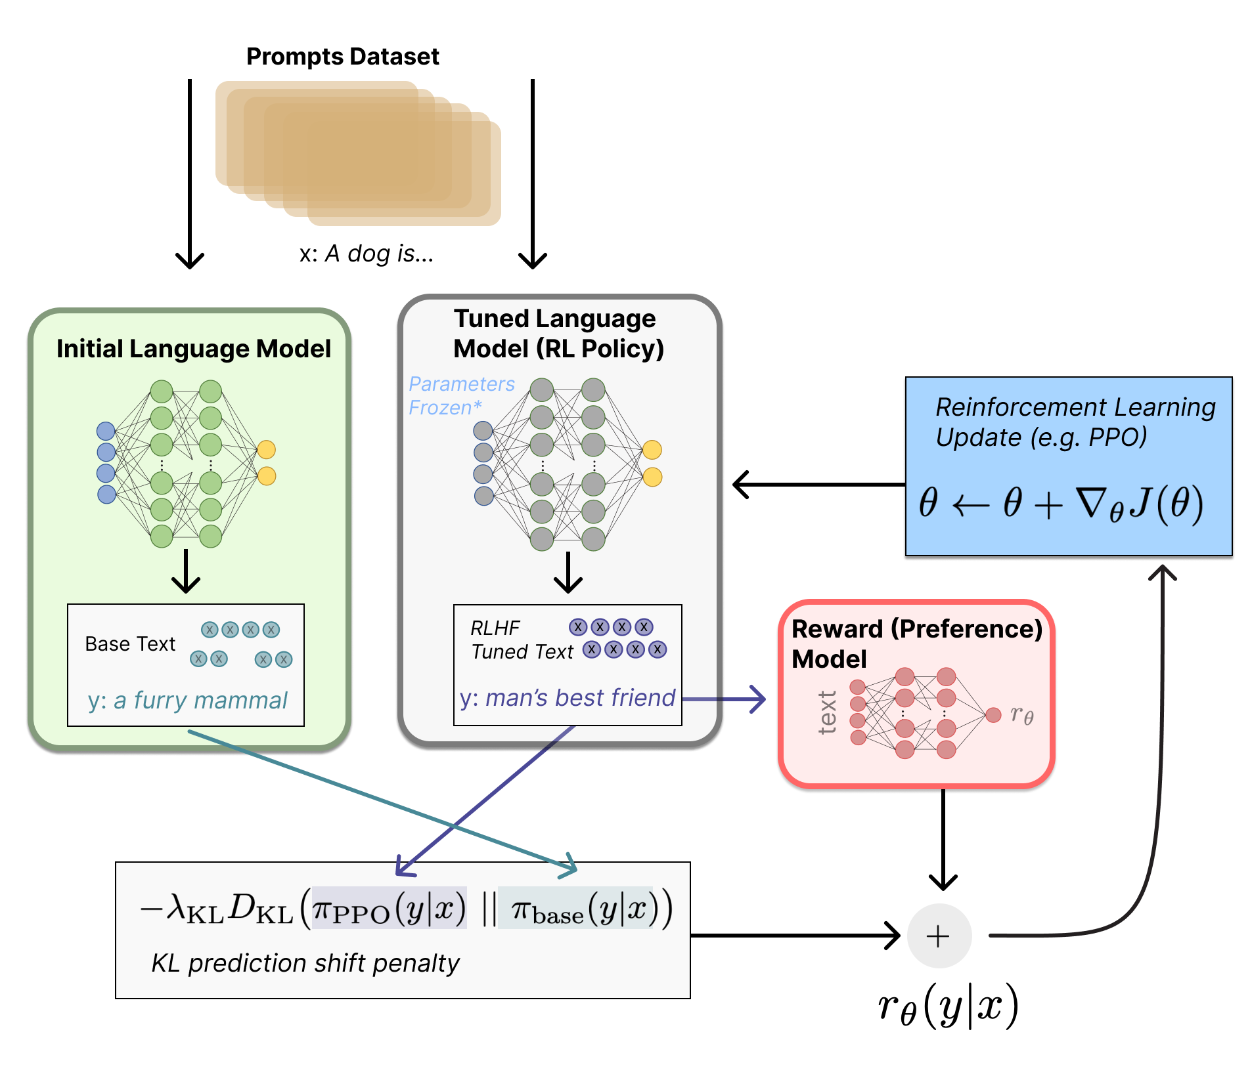
    • 强化学习阶段

      • 利用奖励模型为 LLM 提供反馈,目标为最大化奖励,建模为

        max⁡πθEx∼D,y∼πθ(y∣x)[rϕ(x,y)]−βDKL[πθ(y∣x)∥πref(y∣x)]\max_{\pi_{\theta}}\mathbb {E}_{x\sim\mathcal {D},y\sim\pi_{\theta}(y|x)}\left [r_{\phi}(x,y)\right]-\beta\mathbb {D}_{\mathrm {KL}}\left [\pi_{\theta}(y\mid x)\parallel\pi_{\mathrm {ref}}(y\mid x)\right]
      • β\beta 用于控制策略模型和参考模型之间的偏差

      • 策略模型和参考模型均使用 πSFT\pi^{SFT} 初始化

      • 由于该目标不可微分,可以通过以下奖励函数建模

        r(x,y)=rϕ(x,y)−β(log⁡πθ(y∣x)−log⁡πref(y∣x))r (x,y)=r_{\phi}(x,y)-\beta (\log\pi_{\theta}(y\mid x)-\log\pi_{\mathrm {ref}}(y\mid x))

      强化学习阶段

直接偏好优化(DPO)

  • 直接偏好优化的公式推导

    • 最大化奖励建模的最优解形式如下

      Objective Function=max⁡πθEx∼D,y∼πθ(y∣x)[rϕ(x,y)]−βDKL[πθ(y∣x)∥πref(y∣x)]=max⁡πEx∼DEy∼π(y∣x)[r(x,y)−βlog⁡π(y∣x)πref(y∣x)]=min⁡πEx∼DEy∼π(y∣x)[log⁡π(y∣x)πref(y∣x)−1βr(x,y)]=min⁡πEx∼DEy∼π(y∣x)[log⁡π(y∣x)1Z(x)πref(y∣x)exp⁡(1βr(x,y))−log⁡Z(x)]πr(y∣x)=1Z(x)πref(y∣x)exp⁡(1βr(x,y))Z(x)=∑yπref(y∣x)exp⁡(1βr(x,y))\begin {align*} \text{Objective Function}&=\max_{\pi_\theta}\mathbb {E}_{x\sim\mathcal {D},y\sim\pi_\theta (y|x)}\left [r_\phi (x,y)\right]-\beta\mathbb {D}_{KL}\left [\pi_\theta (y|x)\parallel\pi_{\mathrm {ref}}(y|x)\right] \\ & =\max_\pi\mathbb {E}_{x\sim\mathcal {D}}\mathbb {E}_{y\sim\pi (y|x)}\left [r (x,y)-\beta\log\frac {\pi (y|x)}{\pi_{\mathrm {ref}}(y|x)}\right] \\ & =\min_\pi\mathbb {E}_{x\sim\mathcal {D}}\mathbb {E}_{y\sim\pi (y|x)}\left [\log\frac {\pi (y|x)}{\pi_{\mathrm {ref}}(y|x)}-\frac {1}{\beta} r (x,y)\right] \\ & =\min_\pi\mathbb {E}_{x\sim\mathcal {D}}\mathbb {E}_{y\sim\pi (y|x)}\left [\log\frac {\pi (y|x)}{\frac {1}{Z (x)}\pi_{\mathrm {ref}}(y|x)\exp\left (\frac {1}{\beta} r (x,y)\right)}-\log Z (x)\right]\\ \pi_r (y\mid x)&=\frac {1}{Z (x)}\pi_{\mathrm {ref}}(y\mid x)\exp\left (\frac {1}{\beta} r (x,y)\right)\\ Z (x)&=\sum_{y}\pi_{\mathrm {ref}}(y\mid x)\exp\left (\frac {1}{\beta} r (x,y)\right) \end {align*}
      • 其中 Z(x)Z (x) 为配分函数
    • 对上式两边取对数,得到奖励函数(也即 BT 模型中的 “能力”)

      r(x,y)=βlog⁡πr(y∣x)πref(y∣x)+βlog⁡Z(x)r (x,y)=\beta\log\frac {\pi_{r}(y\mid x)}{\pi_{\mathrm {ref}}(y\mid x)}+\beta\log Z (x)
    • 代入 BT 模型

      p∗(y1≻y2∣x)=exp⁡(βlog⁡π∗(y1∣x)πref(y1∣x)+βlog⁡Z(x))exp⁡(βlog⁡π∗(y1∣x)πref(y1∣x)+βlog⁡Z(x))+exp⁡(βlog⁡π∗(y2∣x)πref(y2∣x)+βlog⁡Z(x))=11+exp⁡(βlog⁡π∗(y2∣x)πref(y2∣x)−βlog⁡π∗(y1∣x)πref(y1∣x))=σ(βlog⁡π∗(y1∣x)πref(y1∣x)−βlog⁡π∗(y2∣x)πref(y2∣x))=σ(r(x,y1)−r(x,y2))\begin {align*} p^{*}(y_{1}\succ y_{2}|x) & =\frac {\exp\left (\beta\log\frac {\pi^*(y_1|x)}{\pi_{\mathrm {ref}}(y_1|x)}+\beta\log Z (x)\right)}{\exp\left (\beta\log\frac {\pi^*(y_1|x)}{\pi_{\mathrm {ref}}(y_1|x)}+\beta\log Z (x)\right)+\exp\left (\beta\log\frac {\pi^*(y_2|x)}{\pi_{\mathrm {ref}}(y_2|x)}+\beta\log Z (x)\right)} \\ & =\frac {1}{1+\exp\left (\beta\log\frac {\pi^*(y_2|x)}{\pi_{\mathrm {ref}}(y_2|x)}-\beta\log\frac {\pi^*(y_1|x)}{\pi_{\mathrm {ref}}(y_1|x)}\right)} \\ & =\sigma\left (\beta\log\frac {\pi^*(y_1|x)}{\pi_{\mathrm {ref}}(y_1|x)}-\beta\log\frac {\pi^*(y_2|x)}{\pi_{\mathrm {ref}}(y_2|x)}\right)\\ &=\sigma\left (r (x,y_1)-r (x,y_2)\right) \end {align*}
    • 制定最大似然目标

      LR(rϕ,D)=−E(x,yw,yl)∼D[log⁡σ(rϕ(x,yw)−rϕ(x,yl))]=−E(x,yw,yl)∼D[log⁡σ(βlog⁡πθ(yw∣x)πref(yw∣x)−βlog⁡πθ(yl∣x)πref(yl∣x))]=LDPO(πθ;πref)\begin {align*} \mathcal {L}_R (r_\phi,\mathcal {D}) & =-\mathbb {E}_{(x,y_w,y_l)\sim\mathcal {D}}\left [\log\sigma\left (r_\phi (x,y_w)-r_\phi (x,y_l)\right)\right] \\ & =-\mathbb {E}_{(x,y_w,y_l)\sim\mathcal {D}}\left [\log\sigma\left (\beta\log\frac {\pi_\theta (y_w|x)}{\pi_{\mathrm {ref}}(y_w|x)}-\beta\log\frac {\pi_\theta (y_l|x)}{\pi_{\mathrm {ref}}(y_l|x)}\right)\right] \\ & =\mathcal {L}_{\mathrm {DPO}}(\pi_\theta;\pi_{\mathrm {ref}}) \end {align*}
    • 分析该损失函数的梯度

      ∇θLDPO(πθ;πref)=−E(x,yw,yl)∼D[σ′(u)σ(u)∇θ(u)]=−βE(x,yw,yl)∼D[σ(r^θ(x,yl)−r^θ(x,yw))⏟higher weight when reward estimate is wrong[∇θlog⁡π(yw∣x)⏟increase likelihood ofyw−∇θlog⁡π(yl∣x)⏟decrease likelihood ofyl]]u=βlog⁡πθ(yl∣x)πref(yl∣x)−βlog⁡πθ(yw∣x)πref(yw∣x)\begin {align*} \nabla_{\theta}\mathcal {L}_{\mathrm {DPO}}(\pi_{\theta};\pi_{\mathrm {ref}})&=-\mathbb {E}_{(x,y_{w},y_{l})\sim\mathcal {D}}\left [\frac {\sigma^{\prime}\left (u\right)}{\sigma\left (u\right)}\nabla_{\theta}\left (u\right)\right] \\ & = -\beta\mathbb {E}_{(x,y_{w},y_{l})\sim\mathcal {D}}\left [\underbrace {\sigma (\hat {r}_{\theta}(x,y_{l})-\hat {r}_{\theta}(x,y_{w}))}_{\text{higher weight when reward estimate is wrong}}\left [\underbrace {\nabla_{\theta}\log\pi (y_{w}\mid x)}_{\text{increase likelihood of} y_{w}}-\underbrace {\nabla_{\theta}\log\pi (y_{l}\mid x)}_{\text{decrease likelihood of} y_{l}}\right]\right]\\ u&=\beta\log\frac {\pi_\theta (y_l|x)}{\pi_\mathrm {ref}(y_l|x)}-\beta\log\frac {\pi_\theta (y_w|x)}{\pi_\mathrm {ref}(y_w|x)} \end {align*}
    • 其中隐式奖励模型:

      r^θ(x,y)=βlog⁡πθ(y∣x)πref(y∣x)\hat {r}_{\theta}(x,y)=\beta\log\frac {\pi_{\theta}(y|x)}{\pi_{\mathrm {ref}}(y|x)}
    • 当真实参考分布不可用时,可以采用偏好对的最大似然估计:

      πref=arg⁡max⁡πEx,yw∼D[log⁡π(yw∣x)]\pi_{\mathrm {ref}}=\arg\max_\pi\mathbb {E}_{x,y_w\thicksim\mathcal {D}}\left [\log\pi (y_w\mid x)\right]
  • Bradley-Terry 模型

    • 建模成对比较数据的概率模型,通常用来预测多个对象之间的相对优劣(如排名、胜率等)

    • 假设有 nn 个对象 A1,A2,…,AnA_1, A_2, \dots, A_n,每个对象 AiA_i 都有一个正的能力值(或评分) πi>0\pi_i > 0

      • Bradley-Terry 模型定义了两两比较中对象获胜的概率

      • 对于对象 AiA_i 和 AjA_j:

        P(Ai 击败Aj)=πiπi+πjP (A_i \text{ 击败} A_j) = \frac {\pi_i}{\pi_i + \pi_j}
      • 其中 πi\pi_i 和 πj\pi_j 分别是 AiA_i 和 AjA_j 的能力值

    • 对于 AiA_i 和 AjA_j,如果已知 AiA_i 和 AjA_j 比赛了 nijn_{ij} 次,且 AiA_i 赢了 wijw_{ij} 次,则其获胜的概率可以用最大似然估计(MLE)求解,似然函数为:

      L(π1,π2,…,πn)=∏i<j(πiπi+πj)wij(πjπi+πj)lijL (\pi_1, \pi_2, \dots, \pi_n) = \prod_{i < j} \left (\frac {\pi_i}{\pi_i + \pi_j} \right)^{w_{ij}} \left (\frac {\pi_j}{\pi_i + \pi_j} \right)^{l_{ij}}
      • 其中 lij=nij−wijl_{ij} = n_{ij} - w_{ij} 为 AjA_j 胜利的次数
    • 对数似然函数:

      log⁡L=∑i<jwijlog⁡πi−(wij+lij)log⁡(πi+πj)\log L = \sum_{i < j} w_{ij} \log \pi_i - (w_{ij} + l_{ij}) \log (\pi_i + \pi_j)
  • Plackett-Luce 模型

    • 将 BT 模型推广至建模排序数据

    • 给定一组对象 {A1,A2,…,An}\{A_1, A_2, \dots, A_n\},Plackett-Luce 模型定义了以下排序概率:

      • 假设 σ=(σ1,σ2,…,σn)\sigma = (\sigma_1, \sigma_2, \dots, \sigma_n) 是对象的一个排序(即 σ1\sigma_1 是第 1 名,σ2\sigma_2 是第 2 名,依此类推),

      • 排序 σ\sigma 的概率为:

        P(σ)=∏j=1nπσj∑k=jnπσk,P (\sigma) = \prod_{j=1}^n \frac {\pi_{\sigma_j}}{\sum_{k=j}^n \pi_{\sigma_k}},
      • 其中,πσj\pi_{\sigma_j} 是对象 σj\sigma_j​ 的能力值,分母表示从剩余未排序对象中选择当前对象的概率

    • 最大似然估计(MLE):给定观测到的排序数据 {σ(1),σ(2),…,σ(m)}\{\sigma^{(1)}, \sigma^{(2)}, \dots, \sigma^{(m)}\},

      • 似然函数为:

        L(π1,π2,…,πn)=∏i=1mP(σ(i)),L (\pi_1, \pi_2, \dots, \pi_n) = \prod_{i=1}^m P (\sigma^{(i)}),
      • 对似然函数取对数后,通过优化算法(如梯度下降)求解

RLOO

  • 与 PPO 的区别
    • RLOO 将整个模型补全视为单一动作,而常规 PPO 将每个补全 token视为单独的动作
    • 在 PPO 中,只有 EOS token 获得真正的奖励,奖励非常稀疏
    • 常规 PPO 会将奖励归因于 EOS token,而 RLOO 会将 EOS 奖励归因于整个补全

组相对策略优化(GRPO)

  • 在 LLM 环境中,奖励模型通常只为最后一个标记分配奖励分数,这可能会使训练针对每个标记都准确的价值函数变得复杂
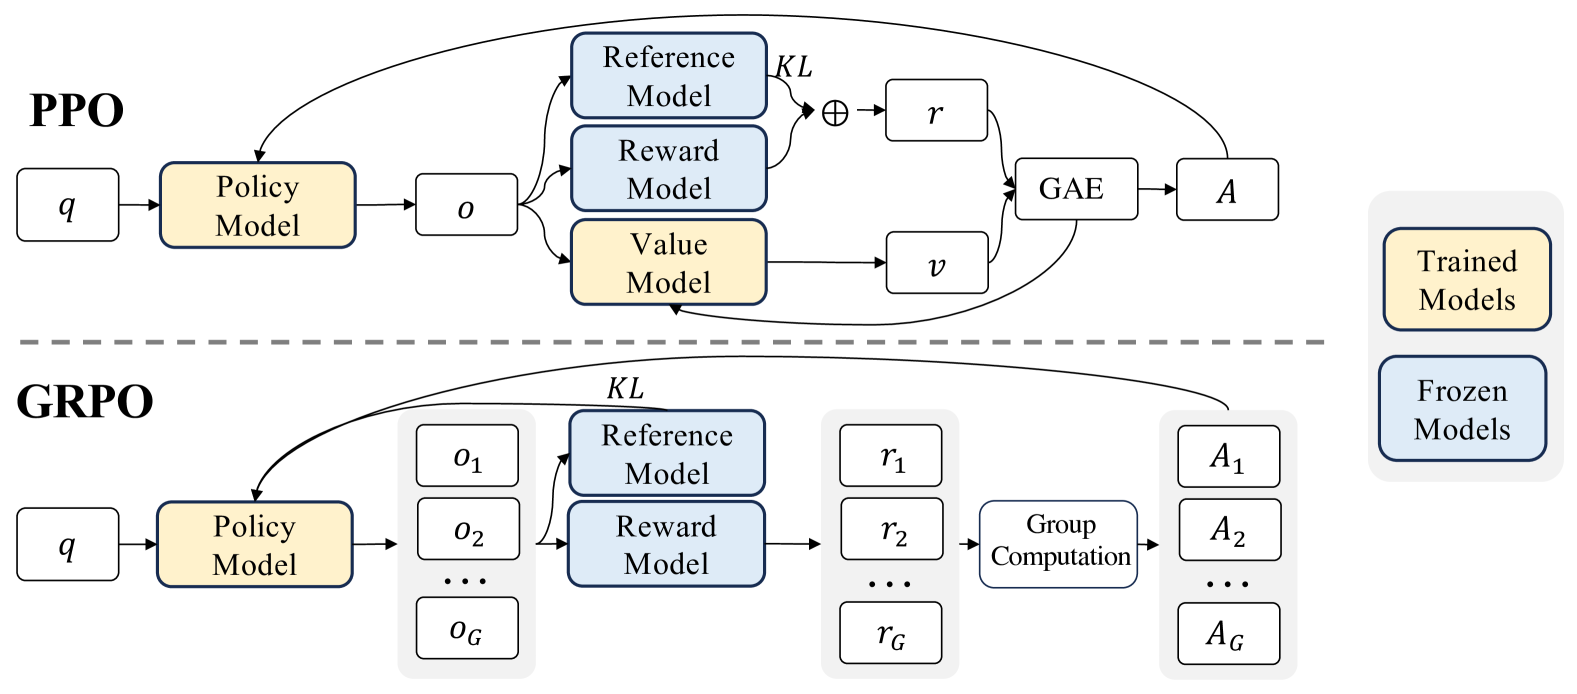
    PPO vs GRPO

  • GRPO 目标函数

    JGRPO(θ)=E[q∼P(Q),{oi}i=1G∼πθad(O∣q)][1G∑i=1G1∣oi∣∑t=1∣oi∣{min⁡[πθ(oi,t∣q,oi,<t)πθad(oi,t∣q,oi,<t)A^i,t,clip⁡(πθ(oi,t∣q,oi,<t)πθad(oi,t∣q,oi,<t),1−ϵ,1+ϵ)A^i,t]−βDKL[πθ∥πref]}]\mathcal {J}_{\mathrm {GRPO}}(\theta)=\mathbb {E}\left [q\sim P (Q),\{o_i\}_{i=1}^G\sim\pi_{\theta_{ad}}(O|q)\right]\left [\frac {1}{G}\sum_{i=1}^G\frac {1}{|o_i|}\sum_{t=1}^{|o_i|}\left\{\min\left [\frac {\pi_\theta (o_{i,t}|q,o_{i,<t})}{\pi_{\theta_{ad}}(o_{i,t}|q,o_{i,<t})}\hat {A}_{i,t},\operatorname {clip}\left (\frac {\pi_\theta (o_{i,t}|q,o_{i,<t})}{\pi_{\theta_{ad}}(o_{i,t}|q,o_{i,<t})},1-\epsilon,1+\epsilon\right)\hat {A}_{i,t}\right]-\beta D_{KL}\left [\pi_\theta\parallel\pi_{\mathrm {ref}}\right]\right\}\right]
  • KL 散度的无偏估计

    DKL[πθ∣∣πref]=πref(oi,t∣q,oi,<t)πθ(oi,t∣q,oi,<t)−log⁡πref(oi,t∣q,oi,<t)πθ(oi,t∣q,oi,<t)−1\mathrm {D}_{KL}\left [\pi_{\theta}||\pi_{ref}\right]=\frac {\pi_{ref}(o_{i,t}|q,o_{i,<t})}{\pi_{\theta}(o_{i,t}|q,o_{i,<t})}-\log\frac {\pi_{ref}(o_{i,t}|q,o_{i,<t})}{\pi_{\theta}(o_{i,t}|q,o_{i,<t})}-1
  • 优势函数

    A^i,t=ri~=ri−mean(r)std(r)\hat {A}_{i,t}=\widetilde {r_{i}}=\frac {r_{i}-\mathrm {mean}(\mathbf {r})}{\mathrm {std}(\mathbf {r})}

强化学习亟待解决的问题

  • 样本效率低下
    • 语言和视觉任务涉及庞大而复杂的状态 - 动作空间,这使得强化学习智能体难以学习有效的策略
    • 智能体必须理解任务并将其与相应的状态联系起来,这需要更广泛的交互
  • 奖励函数设计
    • 在语言和视觉任务中,设计有效的奖励函数尤其具有挑战性。这些函数必须捕捉微妙的语言细微差别和复杂的视觉特征,这大大增加了本已困难的过程的复杂性。
    • 在这些领域中,将奖励与高级任务目标相结合通常需要领域专业知识和大量的反复试验
  • 泛化
    • 强化学习代理通常会过度拟合训练数据,尤其是在基于视觉的环境中,导致在有干预(例如添加噪音)的状态下部署时性能不佳。代理必须学习对此类干预具有鲁棒性的不变特征,从而能够在不同的语言环境和视觉场景中实现泛化。 然而,这些领域的复杂性使得提取此类特征并适应新环境特别具有挑战性
  • 自然语言理解
    • 深度强化学习在自然语言处理和理解场景中面临困难,其中人类语言的细微差别和复杂性带来了独特的挑战,而当前的强化学习方法无法充分解决这些挑战
  • 奖励黑客(Reward Hacking)
    • 当强化学习(RL)代理利用奖励函数中的缺陷或模糊性来获得高额奖励,而没有真正学习或完成预期任务时,奖励黑客就会发生
    • 奖励黑客行为的存在是因为强化学习环境通常不完美,并且准确设计奖励函数从根本上来说是一项重大挑战
    • 解决方法
      • 动态调整奖励函数:通过持续监控智能体行为,动态更新奖励函数,防止固定奖励机制被智能体利用
      • 引入对抗训练:训练额外的判别器或模型检测奖励黑客行为,限制智能体对奖励函数漏洞的利用
      • 多层次奖励建模:将 PRM 与结果奖励模型结合,通过最终目标奖励约束中间奖励优化,防止中间步骤过拟合
  • 奖励稀疏(Reward Sparsity)
    • 智能体在环境中执行动作后,很少或者根本得不到有意义的奖励信号
    • 奖励信号的缺乏使得学习过程变得非常困难,因为强化学习算法需要通过奖励信号来引导策略的改进
    • 使用过程奖励模型 PRM 可以提供更密集的奖励信号,能够指导长程任务的中间优化
  • 语言模型的应用已从语言建模转向任务解决,从基本的文本分类和情感分析到复杂的高级任务规划和决策

LLM 代理亟待解决的问题

  • 上下文长度有限
    • 上下文容量有限,限制了包含历史信息、详细说明、API 调用上下文和响应
    • 系统的设计必须适应这种有限的通信带宽,而从过去的错误中学习的自我反思等机制将从长或无限的上下文窗口中受益匪浅
    • 尽管向量存储和检索可以提供对更大知识池的访问,但它们的表示能力不如全注意力机制那么强大
  • 长期规划和任务分解的挑战
    • 长期规划和有效探索解决方案空间仍然具有挑战性。 LLMs 当遇到意外错误时,很难调整计划,这使得它们与从试错中学习的人相比不太稳健
  • 自然语言接口的可靠性
    • 当前的代理系统依赖自然语言作为 LLMs 与外部组件(例如内存和工具)之间的接口。
    • 然而,模型输出的可靠性值得怀疑,因为 LLMs 可能会出现格式错误,并且偶尔会表现出叛逆行为(例如拒绝遵循指令)
    • 因此,大部分论文中的工作都专注于解析模型输出
这篇文档有帮助吗?

On this page

页面信息