Attention(注意力)
介绍 Attention 机制的基本原理,包括 Scaled Dot-Product Attention、Bahdanau Attention、Self-Attention、Cross-Attention、多头注意力等内容,以及相关的数学公式和直观理解
- 参考资料
- 帖子
- 论文
- Scale Dot-Product Attention:Attention Is All You Need
- Bahdanau Attention:Neural Machine Translation by Jointly Learning to Align and Translate
- Sparse Attention:Generating Long Sequences with Sparse Transformers
- Attention Survey:A General Survey on Attention Mechanisms in Deep Learning
什么是 Attention
-
Attention 的本质是 “根据相关性分配权重”。模型在处理某个 token 时,会考虑 “当前 token 应该关注其它哪些 token?关注多少?”
-
信息检索类比
-
Query(Q)=“我想找什么信息”
-
Key(K)=“别人能提供什么信息”
-
Value(V)=“别人具体能给的内容”
-
Attention 就像:你(Query)→ 浏览所有人的 Key → 判断谁更相关 → 根据权重从每个人的 Value 中取信息并加权融合
-
-
社交网络传播类比
- 你(当前词)发布一个问题(Query),所有其他词用 Key 回应 “我能提供什么”,然后你按相似度给每个词评分(注意力权重),最后根据评分汇总各词提供的 Value(上下文信息)
-
因此 Attention 最终输出一个融合上下文语义的向量
Scaled Dot-Product Attention
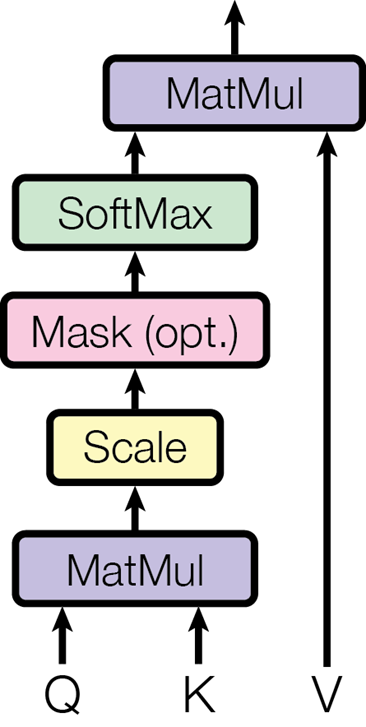
- Scaled Dot-Product Attention(点乘缩放注意力) 是 Transformer 中最常用的注意力机制,由 Vaswani 等人在 2017 年提出
-
其核心思想是通过计算 Query 和 Key 之间的点积来衡量相关性,并根据相关性对 Value 进行加权求和
-
设输入为矩阵 、、,其求解过程如下:
计算相似度
-
第一步,通过 Query 和 Key 的点积来计算相似度
-
其中 表示第 个 Query 与第 个 Key 的相关性
Scaled(缩放)
-
对计算得到的相似度进行缩放
-
这是为了避免 的数值随维度 增大而过大,导致 Softmax 梯度消失 / 梯度爆炸
-
点积方差随维度增加而变大
-
设 和 的每个元素独立且服从均值为 0,方差为 1 的分布, 是向量维度,那么 与 的点积:
-
根据方差公式:
-
假设 ,则
-
即,随着 增大,点积的方差也会增大
-
-
softmax 函数对大值敏感
-
太大
- 指数函数膨胀 → 、 → softmax 的输出接近 one-hot
- 此时 、 ,即梯度都接近于 0
- 这就叫饱和区(saturation region)
-
太小 → 近似均匀 → 注意力不够尖锐
-
当 很大时, 数值很大,点积的分布会随着 变得越来越 “宽”
-
从而使得 softmax 输出过于尖锐 → 直接进入梯度几乎为 0 的饱和状态 → 反向传播时 极小 → 梯度消失 → 难以训练
-
-
缩放的作用:
- 方差从 缩小到 1
- Softmax 输出保持合理分布,不至于饱和
- 训练更加稳定,梯度不会消失或爆炸
-
公式示意
-
假设 ,Q / K 元素服从
-
不缩放: → Softmax 输出接近 one-hot
-
缩放 → → Softmax 平滑
-
Mask(可选)
-
Decoder 中的 causal mask
- 保证不能看到未来
- 此时称为 Causal-Attention,又称 Masked Self-Attention
- 可以对上三角的注意力分数替换为
-
Padding mask(忽略 PAD token)
- 在掩码矩阵 M 中,对需要屏蔽的无效位置填充
- 在对 padding 位置进行处理时,将其置为 而不是 0,是为了在后续计算 Softmax 时能够正确地屏蔽这些位置
- 若对应位置为 0,Softmax 会产生非零权重(),从而引入错误的注意力贡献
- 而当该位置为 时,Softmax 输出为 0(),可以将 padding 位置完全忽略
Softmax → 权重分布
-
Q 与 K 的缩放点积计算得到一个原始注意力分数矩阵,刻画了 Query 与 Key 向量之间的匹配程度,但由于尚未进行归一化,其数值范围不受约束,因而不能直接作为注意力权重来使用
-
为了将这些原始分数转化为可解释、可用的注意力分布,对注意力矩阵的每一行独立地应用 softmax 函数,从而得到一组非负且和为 1 的权重
-
对于特定的查询 (对应 的第 行),它与键 (对应 的第 列)对齐的原始注意力分数记作
-
softmax 函数将查询 与所有 个键( 代表键 / 值对的序列长度)的注意力分数向量 转换为注意力权重向量 ,其中每个权重 的计算方式如下:
-
总而言之,通过 Softmax 函数,将原始注意力分数转为权重分布
-
softmax 的作用
- 归一化
- 非负性:由于指数函数 的输出恒为正,因此每个注意力权重 都保证是正数
- 概率解释:针对查询 的权重集合 ,代表了模型在计算第 个位置的输出时,对输入序列中各个元素的注意力概率分布, 表示分配给第 个输入元素的注意力比例
- 突出重要性:指数函数会放大较大的分数,缩小较小的分数,如果某个分数 在该行中显著大于其他分数,对应的权重 会趋近于 1,而其他权重则趋近于 0,这让模型能有效聚焦于最相关的输入元素
加权求和 Value
-
最终公式为
-
最终输出形状与 相同
-
像注意力机制这种基于矩阵运算的关键优势在于高度的并行性,其整个计算过程主要由矩阵乘法和逐行 softmax 组成,能够在为此类操作优化的硬件上高效执行
-
与需要按时间步 顺序处理的 RNN 和 LSTM 不同,注意力机制可以近似并行地计算所有位置对 之间的交互,从而消除了顺序计算瓶颈,使得训练速度更快,并在条件允许的情况下支持更长序列的建模
Bahdanau Attention
-
Bahdanau Attention,又称Additive Attention,是 2015 年 Bahdanau 等人在神经机器翻译中提出的注意力机制
-
它主要解决了 Seq2Seq 模型在长序列下 Encoder 隐藏状态信息压缩成单个上下文向量的问题
-
核心思想:
-
不再将 Encoder 隐藏状态全部压缩成单个向量,而是将 Encoder 的所有隐藏状态输入给 Decoder
-
Decoder 在生成每个输出时,可以 “选择性关注” Encoder 的不同时间步
-
注意力权重通过可学习的对齐模型(alignment model)计算
-
-
给定 Encoder 隐藏状态序列:,Decoder 当前隐藏状态:
-
计算对齐分数(score function)
-
Bahdanau 采用加性函数:
-
其中,,,,
-
是对齐向量的维度,通常小于 或
-
-
归一化注意力权重,使用 softmax 将对齐分数归一化为概率:
- 表示 Decoder 在时间步 对 Encoder 隐藏状态 的注意力权重
-
将 Encoder 隐藏状态按注意力权重加权求和,得到上下文向量:
-
上下文向量与 Decoder 隐藏状态结合,生成最终输出(例如预测下一个词):
-
与 Dot-Product Attention 对比
特性 Additive Attention Dot-Product (Luong, 2015) score function 或 维度要求 与 可以不同 (或需线性投影) 计算复杂度 高(需要 和向量乘法) 低(只做矩阵乘法) 精度表现 对短序列效果略好 对长序列训练效率高 -
实际上,点乘注意力是 Bahdanau Attention 的高效近似
-
Bahdanau Attention 可以处理 Encoder 与 Decoder 不同维度的隐藏状态,其对齐模型可学习复杂非线性关系,并且动态生成上下文向量,提高长序列性能
-
但是与 dot-product attention 相比,计算开销大。在 Transformer 出现后,由于可并行计算的优势,Additive Attention 多用于 RNN/GRU/LSTM 架构
Self-Attention
-
自注意力(Self-Attention)用于 Transformer Encoder、Decoder
-
输入序列的每个 token 与序列中的所有 token 进行注意力计算
-
输出每个 token 的向量,是对整个序列上下文的加权融合
-
每个词在生成自己的表示时 “看看” 其他词,按相关性分配权重
-
自注意力是一种高层的概念,可能有不同的计算方法,如点乘缩放注意力、多头注意力
Cross-Attention
-
Cross-Attention (交叉注意力)是 Transformer 中 Encoder – Decoder 结构的核心机制之一,用于让一个序列的表示动态依赖另一个序列
-
在 Encoder-Decoder Transformer 中:
- Encoder 产生隐藏序列
- Decoder 在生成每个输出时,通过 Cross-Attention 查询 Encoder 的表示
-
在这里,Cross-Attention 的目标:
- 根据 Decoder 当前隐藏状态(Query)从 Encoder 隐藏状态(Key/Value)中提取相关信息 —— Query 来自 Decoder,而 Key/Value 来自 Encoder
- 动态生成上下文向量,增强输出的条件依赖性
-
假设,Encoder 隐藏状态(Key / Value)中 ,Decoder 当前隐藏状态(Query)中 ,其中 表示 Encoder 序列长度, 表示 Decoder 序列长度,那么 Cross-Attention 本质是Query 与外部序列的注意力机制,其输出为
-
Cross-Attention 的直观理解
-
Query: Decoder 当前的 “问题” 或 “需求”
-
Key: Encoder 中各个位置的 “候选答案索引”
-
Value: Encoder 中各个位置的 “实际信息”
-
Softmax 权重:衡量 Decoder 当前需求与 Encoder 各位置信息的相关性
-
输出是加权求和的上下文向量,指导 Decoder 生成下一步 token
-
注意力权重 显示 Decoder 每个输出 token 依赖 Encoder 哪些位置
-
| 特性 | Self-Attention | Cross-Attention |
|---|---|---|
| Query、Key、Value 来源 | 同一序列 | Query 来自 Decoder ,K / V 来自 Encoder |
| 序列关系捕捉 | 内部依赖 | 条件依赖 |
| Mask | Decoder 自注意力需要 causal mask | 无 causal mask(可以访问整个 Encoder ) |
| 计算复杂度 |
Multi-Head Attention
-
基本思想
- 在单头注意力中,除了输入投影外并不存在可学习的匹配参数,其相似度度量本质上是向量内积
- 由于单一的内积形式难以捕获多样的模式,引入加性注意力以允许一个可学习的打分函数,从而获得更灵活的相似度估计
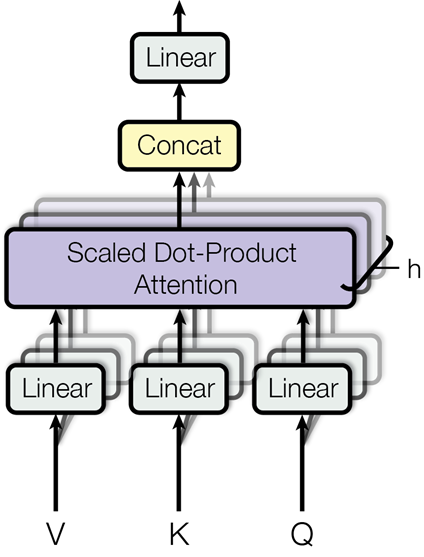
- 多头注意力(Multi-Head Attention)通过提供 组独立的投影,使模型能够在 个不同的度量子空间中分别学习模式匹配策略
- 各头在其独立空间中计算注意力后将输出拼接,并通过一次线性变换进行整合,从而提升表达能力
- 对于第 个头,模型使用可学习矩阵 将 投影到维度 的子空间,并在该子空间中计算注意力,得到
-
数学公式
-
将输入 映射到多个不同的 子空间:
- 其中 为注意力头数,各投影矩阵大小为:
- 其中 为注意力头数,各投影矩阵大小为:
-
每个头独立计算注意力:
-
将所有头的输出拼接:
-
并再通过一个线性层,重新投影到模型维度:
-
其中 ,从而
-
线性投影的作用有两个
-
信息混合: 它使得从不同头(代表不同子空间)中学习到的信息得以组合和整合,线性层充当一个学习到的组合函数
-
维度匹配: 它确保输出张量具有 Transformer Block 其余部分所需的 维度,从而能够进行残差连接和归一化等操作
-
-
-
这种方法具有多种优势:
-
多子空间学习:每个头学习不同的关系模式,如基于语法依赖的关系、基于语义的长距离依赖、基于局部结构的相似性
-
信息并行提取:多个注意力分布可以同时学习,使模型对输入的不同方面保持敏感
-
稳定训练:多头结构在高维空间分散参数,使每个头的注意力权重矩阵规模较小,数值更稳定
-
-
本质上,多头机制首先将模型的表示能力分解为多个子空间( 个头,每个维度为 ,允许每个头在其子空间内专门关注输入的不同方面,然后使用拼接,再进行线性投影(),将这些专业化的表示合并回一个维度为 的单一、更丰富的表示
-
计算复杂度
-
对于输入序列长度 、模型维度 ,其时间复杂度(总):
-
由于 (标准 Transformer 设置),所以整体复杂度保持不变:
-
MHA 的多头并不会增加数量级,仅是常数倍的线性投影开销
-
-
MHA 算法的平面展示图如下:

Multi-Query Attention
-
参考论文:Fast Transformer Decoding: One Write-Head is All You Need
-
基本思想
- Multi-Query Attention(MQA)是为了解决 Transformer 在推理(特别是自回归生成)阶段效率低、KV cache 过大等问题而提出的注意力变体
- 它在保持模型质量基本不降的前提下显著降低推理开销,因此 GPT-3.5、PaLM、Gemini、LLaMA-3 等均采用了 MQA 或 GQA
- 与 MHA 相比,MQA 的关键改动:每个注意力头依然有独立的 Query 投影,所有注意力头共享同一组 Key 和 Value
-
数学公式(对于输入 )
-
Query(多头):每个头有自己独立的投影
-
Key / Value(单头共享):使用单组投影
- 注意:这里不存在 或
-
注意力计算,对于第 个头:
-
区别仅在:
- MHA:每个头有自己的
- MQA:所有头共享同一个
-
最后拼接得到:
-
-
为什么 MQA 能加速推理?
-
KV Cache 大幅减少
-
自回归推理中,需要缓存历史 token 的
-
MHA 的缓存大小(per layer)为 ,而 MQA 则为
-
缓存大小直接减少H 倍(例如 H = 32 → KV cache 减少 32×),这对长上下文推理非常关键
-
-
推理时每步注意力计算更快
-
自回归中每次新 token 的注意力计算为:
- MHA: 组
- MQA: 组 Query,但共享 的 Key
-
K 的读取和 V 的读取次数减少了 倍,这在 GPU/TPU 上极大降低了 memory bandwidth 压力(推理瓶颈)
-
因此,MQA 的推理延迟显著降低,并提升吞吐(tokens/s)
-
-
为什么共享 K / V 不会降低太多质量?
- Q 决定 “看哪里”,K / V 决定 “有哪些内容可看”
- 多头的差异主要在 Query 的投影(注意力查询方式不同)
- 多头的 K / V 差异相对较小,实验显示合并对模型能力影响很小
- PaLM 论文表明:在模型较大时(几十亿参数以上),共享 K / V 对质量影响极小,但能显著提升推理效率
-
-
MQA 算法的平面展示图如下:

Grouped-Query Attention
-
参考论文:GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints
-
基本思想
- Grouped-Query Attention(GQA)是 MQA 和 MHA 的折中形式:
- 将多头分组,每组共享 K / V
- 例如 ,分为 4 组,则每组 8 个头共享 K / V
-
三种形式
- GQA-G 是指具有 G 组的 grouped-query attention
- GQA-1 具有单个组,因此具有单个 Key 和 Value,等效于 MQA
- 而 GQA-H 具有与头数相等的组,等效于 MHA
-
GQA 算法的平面展示图如下:

MHA / MQA / GQA
-
MHA / MQA / GQA 基本概念对比( 表示注意力头数, 表示 GQA 的分组数)
特性 MHA(Multi-Head Attention) MQA(Multi-Query Attention) GQA(Grouped-Query Attention) Query (Q) 每头独立 每头独立 每头独立 Key (K) 每头独立 所有头共享 1 份 每组头共享 1 份 Value (V) 每头独立 所有头共享 1 份 每组头共享 1 份 KV cache 内存 最大, 最小, 中等, 推理速度 较慢 快(尤其长上下文) 较快,介于 MHA 和 MQA 之间 表达能力 最强 略低于 MHA 介于 MHA 与 MQA 之间 使用场景 训练 / 小模型 / 高精度 自回归大模型推理 训练阶段或推理折中方案 -
MHA、MQA、GQA 算法的对比如下:

- MHA / MQA / GQA 参数量比较(设 表示隐藏维度, 表示注意力头数,,)
-
MHA(每头独立 Q/K/V)
-
MQA(所有头共享 K/V,对大 (如 32),参数略小于 MHA)
-
GQA(每组头共享 K/V,组数 )
-
Multi Latent Attention
-
MLA 解决了传统注意力中 KV Cache 过大的问题,核心做了两件事:
- 共享低维潜在向量:用一个低维向量 同时生成 K 和 V,避免重复缓存
- 位置信息分离:将位置编码(RoPE)从主 K 中分离,单独缓存无位置的压缩向量,大幅降低显存占用
-
Query 侧:内容分支 + 位置分支分开构造
- 内容分支: 负责语义信息,从压缩向量 生成
- 位置分支: 负责位置信息,通过 RoPE 编码
- 最终 Query 是两个分支的拼接,兼顾内容与位置表达
-
Key/Value 侧:低维压缩 + 位置解耦
- 关键压缩点: 是低维共享向量,推理时只缓存这一个向量,而不是缓存完整的 K 和 V
- 位置分支分离: 直接从原始 生成并加 RoPE,不需要缓存,推理时可动态生成
- 显存收益:传统 KV Cache 大小为
2 × seq_len × hidden_dim,MLA 仅需seq_len × d_c(d_c是低维压缩维度,远小于 hidden_dim),显存可降低 70% 以上
-
注意力计算
- 注意力分数同时考虑内容分支和位置分支,缩放因子是两个分支维度和的平方根
- Value 直接使用从 生成的 ,不需要额外缓存
-
为什么 RoPE 不能直接对低秩的 Q/K 做
-
无 RoPE 时:矩阵吸收 + 低秩压缩(MLA 的基础)
-
在不加入 RoPE 的情况下,MLA 能实现极致的 KV Cache 压缩,核心就是矩阵吸收计算:
-
是一个固定矩阵,可以提前计算好
-
推理时,只需要缓存低维的 ,而不是高维的完整 Key
-
直接用预计算的矩阵和 做一次矩阵乘法,就能还原出 Key 的内积结果
-
缓存的是低维 (维度 ),而不是高维 Key(维度 )
-
KV Cache 显存占用直接降低了 12 倍,这就是 MLA 压缩的核心原理
-
-
加入 RoPE 后:矩阵吸收失效
-
当直接对 Key 应用 RoPE 时,矩阵吸收的前提被破坏了:
-
中间的 是随相对位置变化的,不是固定矩阵
-
RoPE 矩阵插在了两个权重矩阵之间,而矩阵乘法不满足交换律,无法再提前计算吸收
-
这意味着必须为每个 token 重新计算完整的 RoPE Key,压缩收益完全消失,推理效率大幅下降
-
-
为了解决 RoPE 与低秩压缩的矛盾,MLA 设计了双分支拼接结构:
-
分支双工
分支 生成方式 缓存与否 作用 核心特点 内容分支() 从低维 生成 缓存 承载语义信息 可矩阵吸收,保持低秩压缩 位置分支() 直接从 生成并加 RoPE 不缓存 承载位置信息 采用 MQA 范式,维度很小(64) -
显存占用(以 DeepSeek-V2 为例)
- :维度 (低秩压缩向量,核心缓存)
- :维度 (共享位置分支,不缓存,动态生成)
-
-
KV Cache 大小
- MLA 的 KV Cache 维度只跟潜在向量维度
d_c有关,跟注意力头数n_heads完全无关 - 普通 MHA / GQA / MQA 的 KV 维度都是头数 × 头维度,头越多,KV Cache 越大
- MLA 完全不一样:
- 所有头 共享同一个低维潜在向量
- K 和 V 都是 从这个
c还原出来的,每个头用不同的投影矩阵从 里提取自己的 K/V - 缓存的只有这个
c,不存任何按头分开的 K、V
- MLA 的 KV Cache 维度只跟潜在向量维度
-
MLA 的缺点?
-
推理实现复杂
- MLA 不是标准 attention 结构,无法直接用 FlashAttention、FlashAttention-2、xFormers 等高度优化的核,必须自己写 双分支 QKV 构造 + 分拆注意力计算
- 推理引擎(vLLM、TGI、TensorRT-LLM)都要专门适配 MLA,原生不支持
-
RoPE 必须解耦,不能简单套用
- 位置分支不缓存,每次都要重新计算,增加一点点推理延迟
-
计算量并没有减少,同时扩展性也不如 GQA/MQA 灵活,想微调精度 / 速度,只能改 dc(潜在维度),不如 GQA 直观
-
双分支 + 动态位置分支,访存模式更零散,对硬件不友好,老卡更慢
-
Sparse Attention
什么是稀疏注意力
-
标准注意力存在的缺点
-
对长序列,计算量 ,显存需求高(其中 是序列长度)
-
特别是在自回归推理或大 batch 训练时,矩阵 和 softmax 中间缓冲区会占用大量显存
-
为了降低原本 的注意力计算成本,设计了一系列方法,如 Sparse Attention、Performer、Linear Attention、FlashAttention
-
-
Sparse Attention 的核心思想
-
稀疏注意力(Sparse Attention)只计算部分相关位置的注意力,而不是全量 计算,降低复杂度并保持性能
-
但显然,计算部分位置的注意力的效果理论上不如计算全部位置的注意力的效果
-
-
Sparse Attention 的数学形式
-
令 为 Query 对应的 Key 索引集合(稀疏模式):
-
上下文向量:
-
复杂度由 降为 ,显著节省计算和显存
-
-
为了实现稀疏注意力,可以引入稀疏模式矩阵 ,定义哪些 Query-Key 对需要计算注意力,也即 Masked Sparse Attention
-
表示元素级掩码
-
表示 与 有效计算
-
表示跳过计算(节省 FLOPs 和内存)
-
这种方式显著降低了计算量,复杂度 ,其中 是每个 Query 有效 Key 的数量()
-
-
Sparse Attention 的优缺点
- 通过引入稀疏注意力,提高了 Transformer 的长序列可扩展性,并降低计算量与显存消耗
- 同时,可以组合多种掩码模式(局部 / 随机 / 跨步长),保证模型捕捉局部和长程依赖
- 但是也存在一些缺点:
-
稀疏模式设计难:不同任务可能需要不同模式(Local / Strided / Global)
-
梯度传播受限:某些未被注意的 Key 无法直接影响输出,需要全局 token 或跳跃连接
-
硬件优化复杂:GPU / TPU 更适合连续矩阵乘法,稀疏模式可能导致内存访问不连续
-
- 但是也存在一些缺点:
-
Sparse Attention 的常见模式
-
Local / Sliding Window Attention(局部窗口注意力)
-
每个 Query 仅关注固定窗口 内的 Key
-
适合长文本、图像 patch 或时间序列
-
复杂度 ,通常
-
-
Strided / Dilated Attention
-
每个 Query 按固定步长访问 Key(如每隔 个位置)
-
可扩大感受野而保持稀疏
-
结合局部窗口可捕捉长程依赖
-
-
Global + Local Attention
-
少数全局 token(CLS 或 summary token)关注全序列
-
大部分 token 仅做局部注意力
-
代表模型:Longformer、BigBird
-
-
Random / Learned Sparse Patterns
-
每个 Query 随机选择 个 Key 或通过训练学习稀疏模式
-
BigBird 使用了 Random + Local + Global 组合,保证稀疏性的同时保持理论上各个 token 之间可完全互连
-
-
-
Sparse Attention 代表模型
模型 Sparse Attention 模式 复杂度 Longformer Sliding window + global token BigBird Local + Global + Random Reformer Local + LSH (hashing) Performer Kernel-based attention(稀疏近似),高效近似 softmax attention Linformer 低秩矩阵近似 Linear Transformer Sinkhorn Attention Synthesizer -
Sparse Attention 测试基准:Long Range Arena: A Benchmark for Efficient Transformers
Performer
-
Performer(Choromanski et al., 2020)提出线性注意力,通过核方法近似 softmax,实现 复杂度,显著提升长序列可扩展性
-
核心思想
-
核心问题:标准注意力中 是 矩阵,计算量
-
将 softmax attention 视为核函数:
- 其中 是正交随机特征映射
-
利用线性化性质:
-
重新排列求和顺序:
-
关键优化:先对 K / V 做线性组合,再与 Q 做点积,实现线性复杂度
-
-
数学公式
-
定义映射 ,例如:
-
Attention 线性化:
- 输出
-
正则化处理(确保概率性质):
-
Linformer
RoPE 中的旋转注意力
-
本质是把位置信息编码进 :
-
拥有相对位置性质
-
支持更强的外推能力(extreme long context)
ALiBi 中的线性偏置注意力
-
通过给注意力打分加入位置偏置:
-
适用于超长上下文任务,训练短上下文 → 推理超长上下文