Transformer
介绍 Transformer 结构,包括 Encoder-Decoder 架构、多头自注意力机制、前馈网络、残差连接、层归一化等内容,以及相关的变量符号说明
- 参考资料
- 帖子
- 图解 Transformer 模型:The Illustrated Transformer
- 论文
- 帖子
Transformer 模型架构
-
基本思想
- Transformer 模型由 Vaswani 等人在 2017 年提出,是基于自注意力机制的序列到序列模型,彻底改变了自然语言处理领域
- 它摒弃了传统的循环神经网络(RNN)和卷积神经网络(CNN),通过并行计算和全局依赖建模实现了高效的序列处理
- Transformer 的核心创新在于 多头自注意力机制,允许模型在处理每个 token 时同时关注序列中的所有其他 token,从而捕捉长距离依赖
- 模型由 Encoder 和 Decoder 两部分组成,支持并行训练,并通过位置编码引入序列顺序信息
-
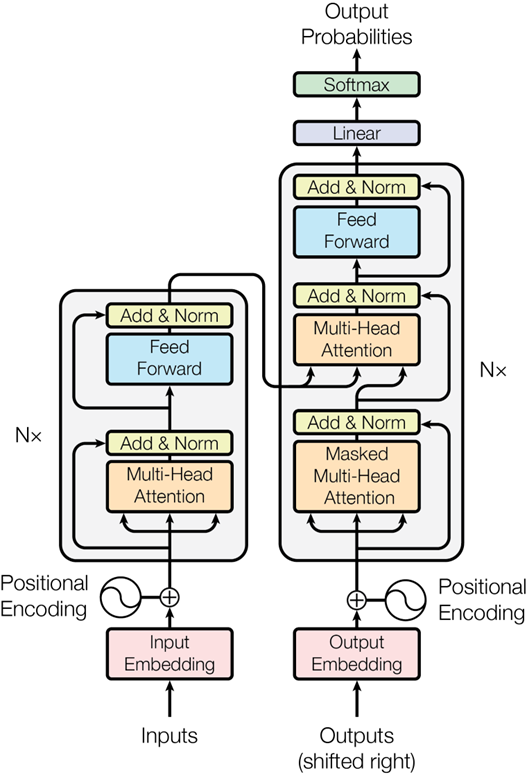
Transformer 采用 Encoder-Decoder 架构:
- Encoder:将输入序列编码为连续表示(向量序列)
- Decoder:基于 Encoder 输出和自身历史生成输出序列
- 整个模型由 层堆叠组成(通常 或 ),每层包含多头注意力、前馈网络、残差连接和层归一化
- 输入输出均为向量序列,维度为 (如 512 或 768)
变量符号说明
| 符号 | 含义 |
|---|---|
| 输入序列长度(token 数量) | |
| 输出序列长度(token 数量) | |
| 模型维度(嵌入向量和隐藏层维度,通常 512 或 768) | |
| 多头注意力头数(通常 8 或 12) | |
| 注意力 Key/Query 维度(通常 ) | |
| 注意力 Value 维度(通常 ) | |
| 前馈网络中间维度(通常 2048 或 4096) | |
| 或 | 词表大小(vocabulary size,通常 30000 或更多) |
| Encoder/Decoder 层数(通常 6 或 12) | |
| 输入序列嵌入矩阵() | |
| 输出序列嵌入矩阵() | |
| Encoder 输出() | |
| Decoder 输出() | |
| 输出 logits() | |
| 输出概率分布() | |
| 注意力投影矩阵( 或 ) | |
| 前馈网络权重矩阵( 和 ) | |
| 输出线性层权重() |
Encoder 结构
-
在 Encoder 之前,存在嵌入层(Embedding Layer):
- 输入 token 通过可学习嵌入矩阵映射为向量,维度
- 嵌入矩阵大小:, 为词表大小
- 与位置编码相加后输入第一层
-
Encoder 由 个相同层堆叠而成,每层包括:
- 多头自注意力子层:对输入序列进行自注意力计算,捕捉 token 间的依赖关系
- 前馈网络子层:对每个 token 独立进行非线性变换
- 残差连接和层归一化:围绕每个子层添加
-
Encoder 输入:token 嵌入 + 位置编码的序列 ( 为序列长度)
-
每个 Encoder Block(层):
-
输入:上一层输出或初始 ,维度
-
多头自注意力子层:
- 输入
- 生成 Q/K/V:对于每个头
- 单个注意力头计算:
- 多头拼接并投影:
- 其中 ,可见多头注意力输出的维度和输入一致,可以进行残差连接
- 残差 + LayerNorm
- 残差连接可以让网络只关注当前差异的部分,Layer Normalization 会将每一层神经元的输入变为均值方差一样,可以加快收敛
-
前馈网络子层:
- 输入
- 输出
- 残差 + LayerNorm
-
层输出: 传递到下一层,维度始终保持
-
-
Encoder 输出:经过 层后输出最终表示 ,用于 Decoder 或下游任务
-
Encoder 的特点:
- 双向注意力:每个 token 可以关注序列中所有其他 token(包括未来 token),适合理解完整上下文的任务,如分类或编码
- 无掩码:注意力矩阵不使用 causal mask,因为 Encoder 不需要生成顺序依赖
Decoder 结构
-
Decoder 也由 个相同层堆叠而成,每层包括:
- 掩码多头自注意力子层:仅关注当前及之前位置的 token,防止信息泄露(causal mask)
- 多头交叉注意力子层:Query 来自 Decoder,Key/Value 来自 Encoder 输出,实现条件生成
- 前馈网络子层:与 Encoder 相同
- 残差连接和层归一化:围绕每个子层添加
-
Decoder 输入为目标序列的 token 嵌入 + 位置编码 ( 为目标长度),在训练时使用 teacher forcing(真实目标序列),推理时自回归生成
-
每个 Decoder Block(层)的详细流向:
-
输入:上一层输出或初始 ,维度 ;Encoder 输出
-
掩码多头自注意力子层:
- 输入
- 生成 Q/K/V:类似 Encoder, 等
- 计算未掩码的注意力打分(逐头)
- 构造 causal mask(上三角掩码)
- 在 softmax 之前施加掩码
- 归一化得到注意力权重
- 加权求和得到单头输出
- 多头拼接并线性映射
- 残差 + LayerNorm
-
多头交叉注意力子层:
- 输入 (作为 Query),(作为 Key/Value)
- 生成 Q:
- 生成 K/V:,
- 注意力计算:
- (可选)施加 encoder padding mask
- softmax 得到注意力权重
- 加权求和得到单头输出
- 多头拼接与线性映射
- 残差 + LayerNorm
-
前馈网络子层:
- 输入
- 输出
- 残差 + LayerNorm:
-
层输出: 传递到下一层,维度始终保持
-
-
Decoder 输出
-
经过 层后输出
-
线性映射到词表空间(逐位置独立)
-
其中
-
再应用 Softmax 生成概率分布
-
由于 decoder 的 masked self-attention 在每一层都施加了 causal mask,第 个位置的隐状态 在计算过程中只能依赖于输入序列中第 个 token 以及 encoder 输出 ,从而保证模型满足自回归生成的因果性
-
因此,在输出概率矩阵 中,第 行表示在已知上下文 和输入 的条件下,第 个位置生成词表中各词的条件概率分布
-
训练阶段(Teacher Forcing):对第 个位置,使用真实标签 ,最大化条件对数似然:
-
推理阶段(自回归生成):对每个时间步 :
-
采样
-
或贪心
-
-
(可选)权重共享,投影矩阵与输入嵌入矩阵共享参数:
-
-
Decoder 的特点:
- 单向注意力:自注意力使用 causal mask,确保生成时只能看到历史 token
- 交叉注意力:依赖 Encoder 输出,实现序列到序列转换
- 与 Encoder 的区别:
特性 Encoder Decoder 注意力类型 自注意力(无掩码) 自注意力(causal mask) + 交叉注意力 输入 源序列 目标序列 + Encoder 输出 输出 上下文表示 生成序列 并行性 完全并行 自注意力部分并行,生成时顺序 适用场景 编码理解任务 生成任务
残差连接和层归一化
-
Transformer 中,每个子层(注意力或前馈)后都添加 残差连接(Residual Connection) 和 层归一化(Layer Normalization),这是训练深层网络的关键
-
为什么使用残差连接?
- 残差连接允许梯度直接传播,避免梯度消失或爆炸问题,使深层网络更容易训练
- 公式:输出 = 子层输入 + 子层输出,即
- 在 Transformer 中,如果没有残差,深层堆叠会导致信息丢失;残差确保低层特征能直接传递到高层
- 实验证明,残差连接使 Transformer 能稳定训练到 12+ 层,而非残差版本难以收敛
-
为什么使用层归一化?
-
层归一化对每个样本的特征维度进行归一化,稳定训练并加速收敛
-
公式(其中 和 为均值和方差):
-
相比批归一化(BatchNorm),LayerNorm 不依赖 batch size,更适合序列数据和变长输入
-
在 Transformer 中,LayerNorm 放在残差连接后,确保每层输出分布稳定,避免内部协变量偏移(internal covariate shift)
-
好处:提高训练稳定性,减少过拟合,支持更大学习率
-
LN 使得各条数据间在进行标准化的时候相互独立,因此 LN 在训练和测试过程中是一致的
-
LN 不需要保留训练过程中的额外参数,每当来一条数据时,对这条数据的指定范围内单独计算所需统计量即可
-
-
Pre-LN 和 Post-LN
-
Post-LN
- LN 作用在残差和上,而 LN 的归一化操作会缩放梯度,上层的梯度需要经过多层 LN 的缩放,越往下层,梯度 Norm 衰减越明显(相当于梯度被层层「稀释」)
- 训练初期问题:输出层梯度 Norm 大,若用大学习率,会导致输出层参数更新幅度过大,模型参数剧烈波动(震荡),甚至不收敛
- 解决办法:必须用 warm-up(学习率从 0 缓慢升到目标值),先让底层梯度稳定,再逐步提升学习率
-
Pre-LN
- 只作用在子层输入上,残差连接直接传递梯度(没有经过 LN 的缩放)—— 梯度可以从顶层无衰减地传到底层,各层梯度 Norm 基本一致,不会出现「上大下小」
- 在输出层的 gradient norm 较小,且其不随层数递增或递减而变动,保持稳定
- 训练初期优势:输出层梯度 Norm 小且稳定,即使不用 warm-up,大学习率也不会导致参数剧烈震荡,梯度更新始终平稳
-
无论使用何种 Optimzer,不采用 warm-up 的 Post-LN 的效果都不如采用 warm-up 的情况,也不如 Pre-LN
-
因此,Pre-LN 不需要进行学习率的预热阶段
-
前馈网络
-
每个 Encoder/Decoder 层包含一个位置 - wise 前馈网络(Position-wise Feed-Forward Network),对每个 token 独立进行变换
-
结构:两层全连接网络,中间有 ReLU 激活
- 输入维度:
- 中间维度:(通常 2048 或 4096)
- 输出维度:
-
公式:
-
作用:
- 提供非线性变换,增强模型表达能力
- 位置 - wise 设计允许并行计算,提高效率
- 与注意力互补:注意力捕捉依赖,前馈进行特征变换
-
然而,ReLU 存在死亡神经元,因此被 GLU/SwiGLU 替代
-
GLU 引入「门控机制」,将输入分成两部分:一部分作为「线性输出」,另一部分通过 sigmoid 生成「门控值」,门控值控制线性输出的权重(类似 LSTM 的门控)
-
其中, 是 sigmoid 激活函数,输出为 0-1,作为门控来控制线性输出的值
-
工程上,常通过一个线性层投影到 维度,然后沿最后一维拆分为两部分
-
其中 , 的维度均为 [B, L, d_ff]
-
SwiGLU 是 GLU 的改进版,用 Swish 激活函数替代 sigmoid 激活函数,其中 一般为 1
-
SwiGLU 既保留门控机制,又提升非线性表达能力,是 LLaMA/PaLM 等大模型的标配
-
LLaMA 中为了提升效率,对 SwiGLU 做了小幅调整(隐藏层维度比例改为 4/3)
参数量计算
- Transformer 参数主要来自 Q/K/V 的线性投影和前馈网络,忽略偏置和 LayerNorm(通常小)
- 多头注意力(每层):
- Q/K/V 投影:
- 输出投影:
- 总:( 时简化)
- 前馈网络(每层):
- 嵌入层:(输入) + (输出,若共享则减半)
- 总参数(Encoder + Decoder, 层):约
- 示例(Base Transformer:):
- 注意力 / 层:
- 前馈 / 层:
- 每层总:, 层 Encoder/Decoder:,总 (含嵌入)
为什么适合并行
- Transformer 摒弃 RNN 的顺序依赖,所有 token 的计算可以同时进行:
- 注意力机制:Q/K/V 矩阵乘法(如 )可并行计算,无需循环
- 前馈网络:位置 - wise,每个 token 独立处理,可批量运算
- 层间:每层独立,无跨层依赖
- Encoder:完全并行,适合 GPU 矩阵运算
- Decoder 训练:使用 teacher forcing,目标序列也并行;推理时仅生成部分顺序,但 KV cache 优化加速
- 相比 RNN 的 顺序复杂度,Transformer 并行度,使长序列训练高效
- 并行性强,适合 GPU/TPU,但长序列时注意力复杂度 ,变体如 Sparse Transformer 优化长序列效率
- 原始 Transformer 对长序列效率低,后续如 Longformer、Performer 等改进
- 缺乏显式递归,某些任务需额外机制(如记忆模块)
正则化
-
Dropout 是一种简单而有效的正则化技术,最初用于缓解前馈神经网络中的过拟合问题
-
其核心思想是在每次训练更新时,随机将一部分神经元的输出置零,从而向网络注入噪声
-
这种随机失活机制可以防止神经元对特定其他单元产生过度依赖,促使模型学习更加分散、鲁棒的表示
-
在标准的 Transformer 架构中,Dropout 通常应用于以下位置:
-
嵌入与位置编码相加之后
- 作用于合并后的输入表示,在其进入编码器或解码器堆栈之前
-
各子层内部
- 应用于多头注意力输出之后(在残差连接和层归一化之前)
- 应用于前馈网络输出之后(同样在残差连接和层归一化之前)
-
可选地,应用于注意力权重
- 即对 的输出进行 Dropout,然后再与 相乘
- 这种做法有时被称为注意力 Dropout
-
-
将单元输出置零的概率 是一个超参数
- 典型取值范围为 0.1 到 0.3,具体最优值依赖于模型规模、数据集大小和任务特性
- 在训练阶段,每个单元的输出以 的概率被随机置零
- 其余未被置零的输出通常按 进行缩放,以保持输出的期望不变
- 这种缩放策略保证了训练阶段与推理阶段的输入分布一致
-
在推理或评估阶段,Dropout 被禁用
- 所有单元均参与计算
- 不再进行随机置零或额外缩放,从而保证输出的确定性
-
一个子层内部的简化示例如下:
# 示例(以 PyTorch 为例) import torch import torch.nn as nn dropout_prob = 0.1 # 假设 sublayer_output 是 MHA 或 FFN 的输出 dropout_layer = nn.Dropout(p=dropout_prob) # x 为子层输入(用于残差连接) # layer_norm 为层归一化 # 训练阶段 # 在残差连接和层归一化之前应用 Dropout output_dropped = dropout_layer(sublayer_output) normalized_output = layer_norm(x + output_dropped) # 评估阶段(model.eval()) # Dropout 表现为恒等映射 output_no_drop = dropout_layer(sublayer_output) normalized_output = layer_norm(x + output_no_drop) -
通过在训练过程中注入随机噪声,Dropout 促使模型形成冗余表示,抑制神经元之间复杂的共同适应,从而有效提升模型的泛化能力
MTP
-
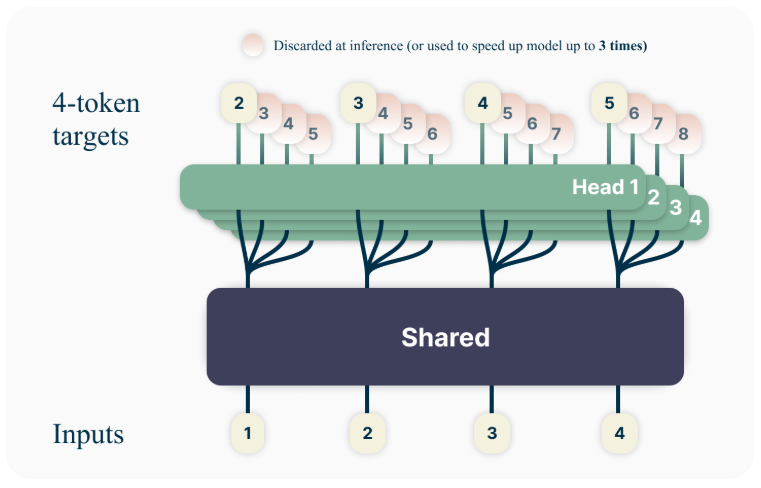
Meta 的 MTP 实现
-
训练阶段:通过预测多步 token,迫使模型学到更长的 token 依赖关系,从而更好理解上下文,避免陷入局部决策的学习模式;同时一次预测多个 token,可大大提高样本的利用效率,相当于一次预估可生成多个 <predict, label> 样本,来更新模型,有助于模型加速收敛
-
推理阶段:并行预估多个 token,可提升推理速度
-
主干网络
- 主干网络就是训练好的 decoder-only 的多层 Transformer 的网络
- 个输入 token 经过主干网络计算,最终输出隐层表示:(来自于 编码结果)
-
多输出 Head 结构
- 上面接了 多输出 Head,每个 Head 负责预估一个 token
- 负责预估 next token
- 负责预估 next next token
- 以此类推
- 上面接了 多输出 Head,每个 Head 负责预估一个 token
-
Head 内部细节
-
Head 是一个 Transformer 层(包括 MHA + 2 层 FFN),且每个 Head 的 Transformer 层是独立的,非共享的
-
经过这层处理后的结果记作:
-
-
词表投影层
- 再将 送入到词表投影层 (),包括 1 个投影矩阵 + 1 个 Softmax,预估每个词的概率分布
- 最终通过某种采样方法(如:greedy,beam search 等)生成 token
- 这个词表投影层是共享的,使用的是原预训练网络(original model)的投影矩阵 + Softmax,多 Head 共享
-
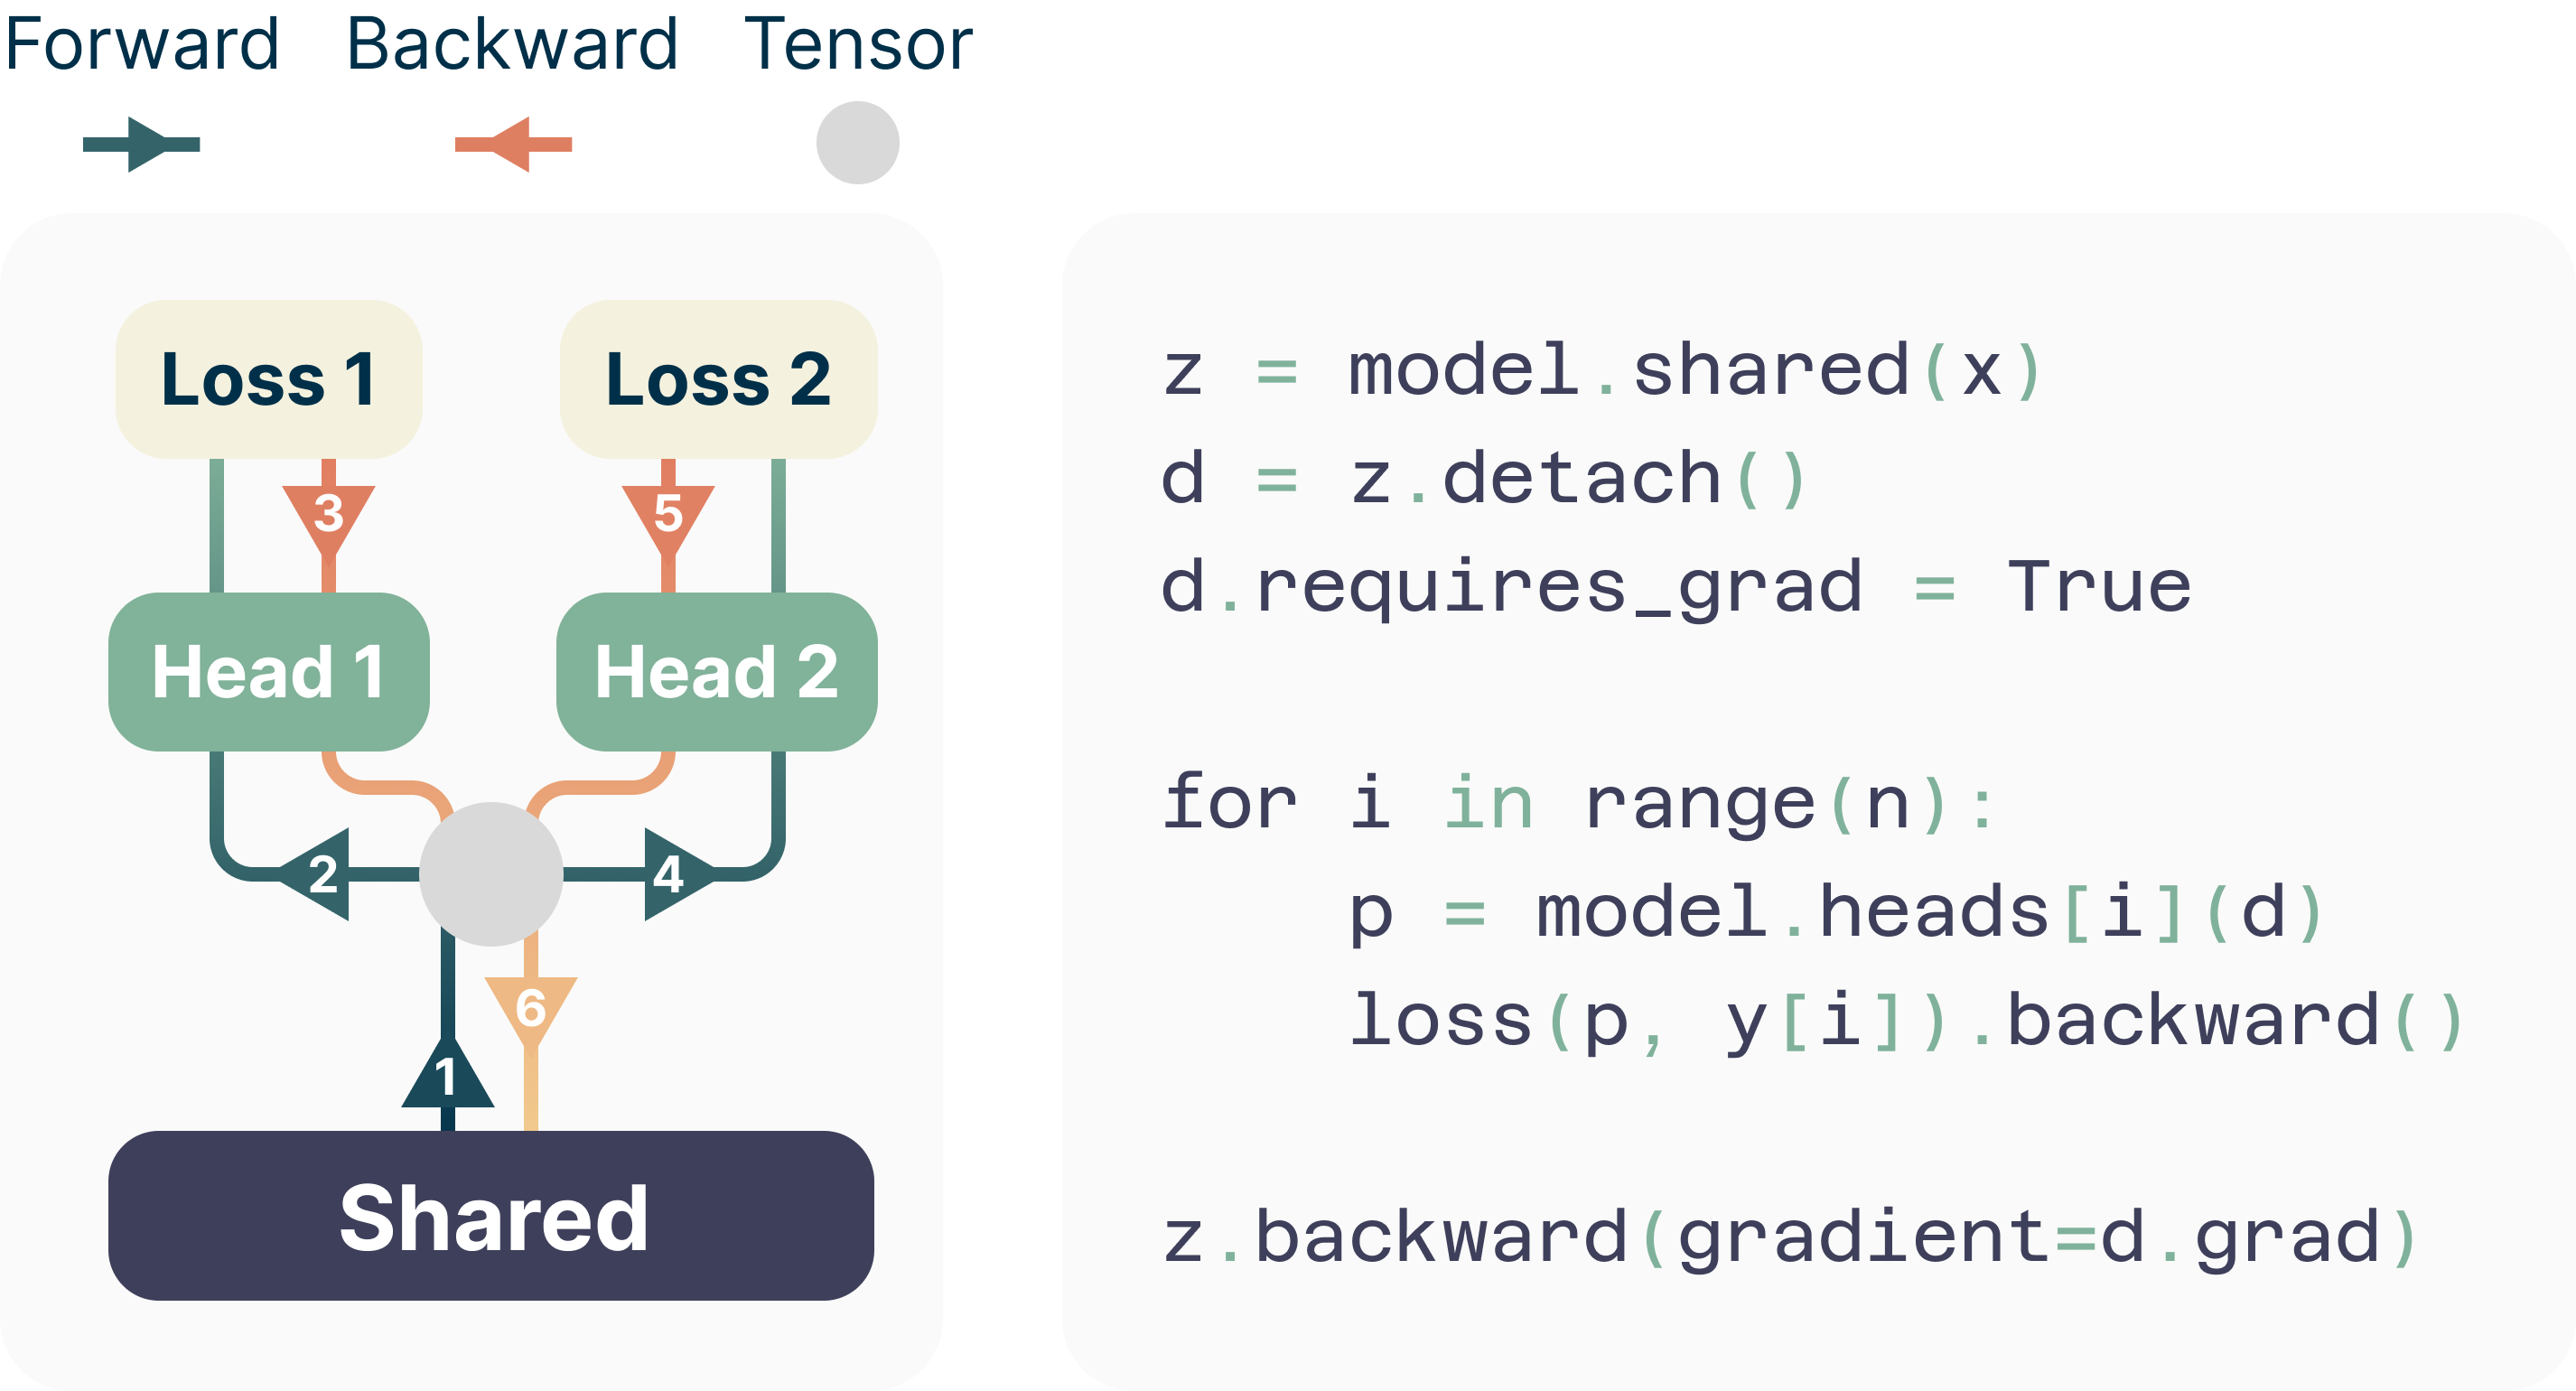
这种并行的方式存在一个缺点,也就是需存储 n 个预测 head 的 logits,空间复杂度为 ,因此还做了一个优化是先执行完一个模块的前向和反向,再执行下一个模块
-
-
DeepSeek 的 MTP
-
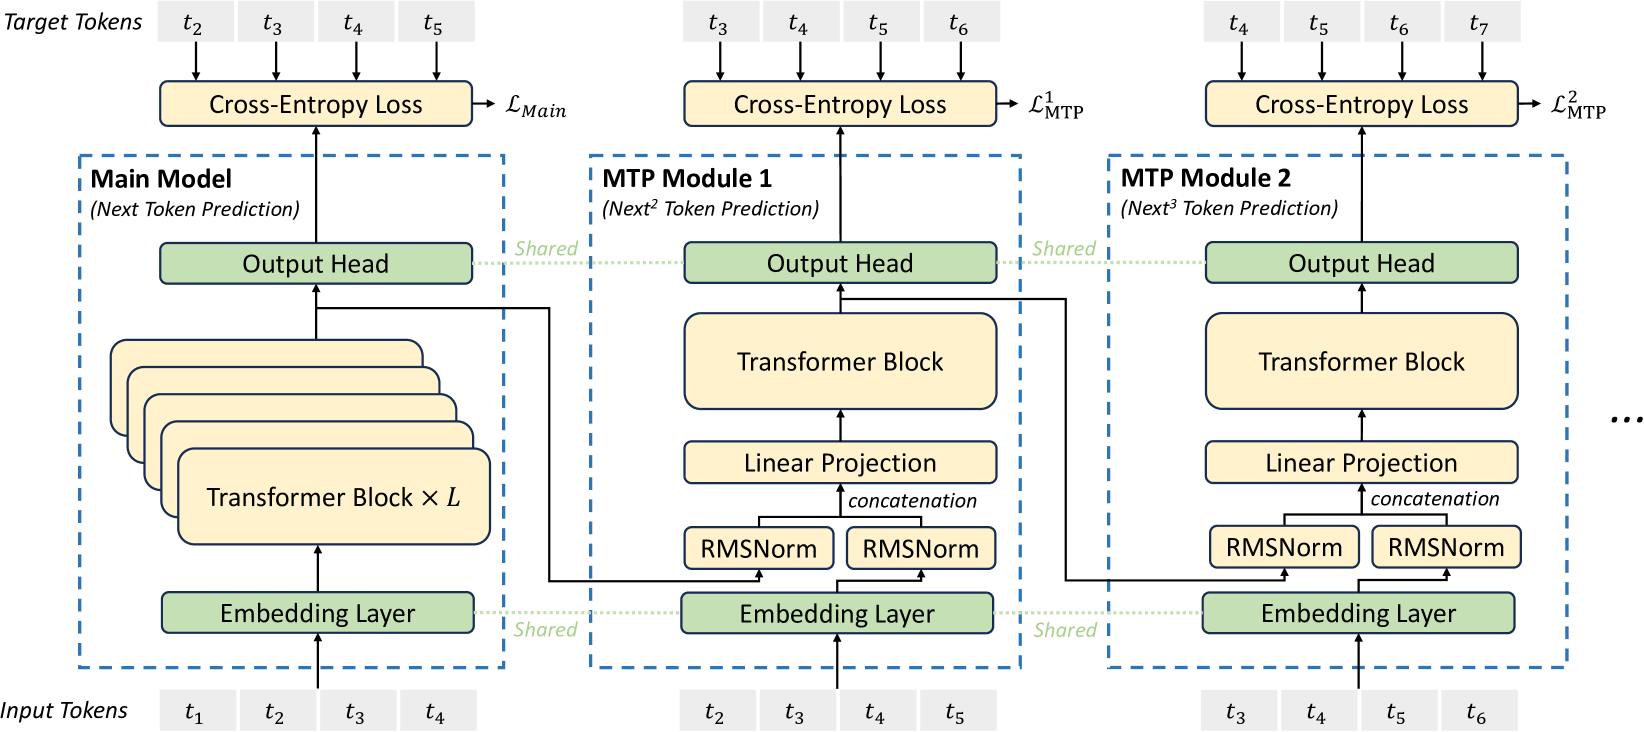
DeepSeek 参照 Meta 的 MTP 设计,在实现上保留了序列推理的连接关系(causal chain)
-
整体架构
- Main Model:传统 decoder-only 主干网络,负责 next token 预测(第 0 个预测深度)
- MTP Module 1~D:D 个顺序串联的模块,分别负责预测第 1~D 个后续 token(next next token、next³ token 等)
- 共享机制:词表投影层(vocab_predict_head)全局共享,embedding 层在模块间共享参数
-
单个 MTP 模块结构
- Embedding Layer:接收输入 token 序列,生成 token embedding
- 双路 RMSNorm:
- 对前序模块的隐层输出做 RMSNorm 归一化
- 对当前位置的 token embedding 做 RMSNorm 归一化
- Concatenation + Linear Projection:拼接两路归一化结果,通过投影矩阵做线性变换,融合特征
- Transformer Block:独立的 Transformer 层,处理融合后的特征,提取序列上下文
- Output Head:共享的词表投影层 + Softmax,输出词表概率分布
- Cross-Entropy Loss:计算当前模块的预测损失
-
变量定义
- :输入序列总长度
- :预测深度( 对应 Main Model, 对应 MTP Module )
- :输入 token 的位置索引
- :隐层维度,:词表大小
-
第一步特征融合
- 输入:
- :第 层的隐层输出( 时为 Main Model 的隐层表征)
- :第 位置的 token embedding
- 处理:两路分别做 RMSNorm 归一化 → 拼接 → 投影矩阵 线性变换
- 输出:融合后的特征
- 输入:
-
第二步特征提取
- 输入:融合特征序列 (切片范围 ,保证 )
- 处理:第 个独立 Transformer 层 提取上下文特征
- 输出:第 预测深度的隐层表征
- :第 预测深度的输入 token 位置 需满足 ,因此有效输入范围为
-
第三步词表概率输出
- 输入:隐层表征
- 处理:共享的映射矩阵 变换 + Softmax
- 输出:第 个输入 token 对应预测的第 位置 token 的概率分布
- 下标 :输入 预测的是序列中第 位的 token,对应 input 与 label 序列错位 位(Main Model 错位 1 位,MTP Module 1 错位 2 位,以此类推)
-
损失计算
- 下标解释:
- :label 范围,起始下标 (MTP Module 第一个预测 token 为 ),结束下标 (eos token 位置)
- 到 :遍历所有有效预测位置,计算交叉熵损失
- 总损失:Main Model 损失 + 所有 MTP Module 损失加权求和,联合训练
- 下标解释:
-
训练模式
- 训练时直接使用样本中的 ground truth token 作为 MTP 模块的输入,而非上一模块的预测输出
- 避免预测误差累积,提升训练效果;推理时切换为 free-running 模式,用上一模块输出作为输入
-
-
MTP 的缺点
- MTP 训练时每一步都用 ground truth 输入(teacher forcing),但真实推理时前面的 token 是模型自己生成的,有误差
- MTP 因为预测更远,对误差累积更敏感,所以推理时更容易偏离训练分布 → 生成质量下降,这比普通 next-token 模型的 exposure bias 更严重