Multi-modal
介绍多模态大规模语言模型的基本概念及其应用
- 参考资料
- 综述
综述
ViT
基本思想
-
ViT 模型首次将 NLP 领域的 Transformer 成功迁移到图像分类,证明大规模数据下 Transformer 可超越 CNN
-
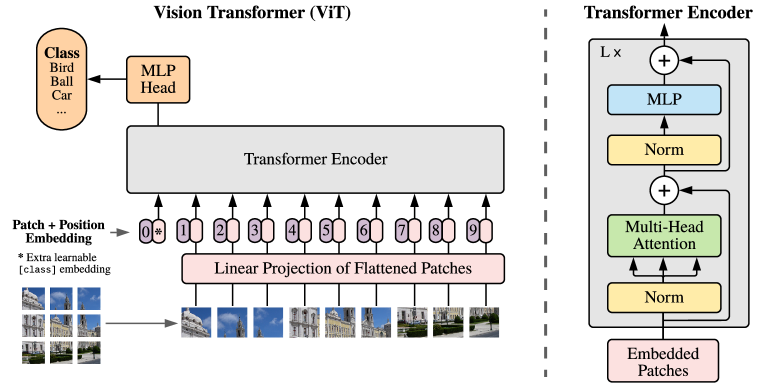
ViT 模型的核心逻辑是将 2D 图像切分为固定大小的 Patch(视觉 Token),展平后通过线性投影映射为嵌入向量,补充位置信息后输入 Transformer Encoder,最终用 [CLS] 输出做任务预测
-
模型架构
-
ViT 的模型结构和 Bert 非常像,都是 Encoder-only 模型
-
在输入处理上,包含对图片的 Patch 过程、Position Embedding 过程
-
送入 Encoder 后,拿出 CLS 对应位置的向量,经过一个简单的 Softmax 多分类模型,去预测原始图片中的物品类别
从 Patch 到 Token
-
假设原始图片尺寸大小为:224*224*3 (H * W * C)
-
现在将这个图片切分为小 Patch,每个 Patch 的大小为 16,则每个 Patch 图片大小为 16*16*3,因此一共有 个 Patch
-
每个 patch 对应着一个 token,将每个 patch 展平,则得到输入矩阵 X,其大小为
(196, 768),也就是每个 token 是 768 维 -
那么如何将每个小方块展平为一个一维向量?最简单的方法是拼接几个 channel,但是在这种方法下,同一个 pixel 本来是三个 channel 的值共同表达的,现在变成竖直的向量之后,这三个值的距离反而离得更远了
-
因此,ViT 采用 CNN 进行特征提取,采用 768 个
16*16*3尺寸的卷积核,stride=16,padding=0,这样就能得到14*14*768大小的特征图 -
这里用到了二维卷积的输出尺寸通用公式
-
每个卷积核 = 16×16×3,刚好覆盖一个完整的小 Patch(16×16×3);stride=16,卷积窗口不重叠,刚好从左到右、从上到下,逐个切 Patch;每个卷积核对一个 Patch 做一次点积,把 16×16×3 = 768 个数值,压缩成 1 个数值;768 个卷积核,每个 Patch 输出 768 维向量
-
为什么 ViT 要先分 Patch 再转 Token?
- 降低 Transformer 计算复杂度
- Transformer 自注意力的计算复杂度为 , 为序列长度,如果直接以像素为 token,序列长度会极大,计算量难以承受
- 通过划分 Patch 可以显著减小 ,在精度与计算成本间取得平衡
- Patch 尺寸 越小, 越大,计算量越高,因此需要选择合适的 控制计算开销
- 利用图像天然的空间冗余性
- 图像相邻像素高度相关、信息冗余度高,无需以单个像素作为基本计算单元
- 用 Patch 作为基本单元既能保留局部结构信息,又能去除大量冗余,这也是 MAE、MoCo 等像素级预测与自监督算法能够有效工作的重要前提
- 降低 Transformer 计算复杂度
嵌入层
-
Token Embedding
-
将经过 Patch 处理后的
(196, 768)的输入向量,经过 Embedding 层得到(196, 768)的嵌入 -
输入 本身已经是 ,为什么还要再经过一层 embedding 映射?
-
关键不在于维度是否变化,而在于表征含义与可学习性:
- 原始 是通过卷积 / 展平得到的固定预处理特征,与模型主体无关
- token embedding 矩阵 是可学习参数,会在训练中随梯度更新,能让向量更适配 Transformer 内部的语义空间
-
更进一步, 的形状也可以设为 ,即第二维不一定要等于 768
-
通过这层线性映射,可以自由设定最终送入 Transformer 的特征维度,灵活控制模型规模
-
-
Position Embedding
- 记位置向量为 ,则它是一个形状为
(196,768)的矩阵,表示 196 个维度为 768 的向量,每个向量表示对应 token 的位置信息 - 无位置编码
- 完全不加入任何位置信息,把所有 patch 当作无序集合输入,模型无法感知空间结构,性能通常会显著下降
- 1-D 绝对位置编码
- ViT 最终采用的方案,可学习 1-D 位置编码(与 BERT 一致)
- 直接为第 1、2、…、196 个 token 分配独立可学习向量,区别于原始 Transformer 的三角函数固定编码
- 2-D 绝对位置编码
- 针对图像 2D 空间结构设计,认为 patch 不仅有全局序号,还存在行、列二维位置
- 将位置编码拆分为水平方向 + 垂直方向分别学习,最终拼接或相加得到完整位置向量
- 相对位置编码(RPE)
- 在计算 Attention 时,将相对位置信息作为偏置(bias)加入注意力分数,为不同相对距离学习不同权重
- 可通过 clip 截断控制距离范围,减少参数量:超出 k 步的相对位置共用同一套编码
- 记位置向量为 ,则它是一个形状为
-
模型的完整数学表达
-
输入预处理与嵌入层
- ViT 的输入构建阶段,完成「分 Patch → 线性投影 → 加分类头 → 加位置编码」的全流程
- 例如:输入 图像,,则 ,,最终 形状为 (196 个 Patch + 1 个
clstoken)
符号 含义 细节说明 第 个图像 Patch 原始图像尺寸 ,切分为 个 的 Patch,展平后为 维向量(例: 时为 维) Token Embedding 矩阵 可学习参数,形状 ,作用是将 Patch 从像素空间线性投影到 维模型隐空间(例:,即 BERT-base 维度) 分类头( clstoken)额外添加的可学习向量,形状 ,类比 BERT 的 clstoken,最终用它的输出做分类1-D 可学习位置编码 形状 ,为每个 Patch token + clstoken 注入空间位置信息,ViT 默认采用可学习式 1-D 绝对位置编码ViT 的最终输入 形状 ,由「 clstoken + 所有 Patch 的投影向量」拼接后,加上位置编码得到 -
多头自注意力(MSA)层 + 残差连接
符号 含义 细节说明 Layer Normalization(层归一化) 对输入做归一化,稳定训练,ViT 采用 Pre-LN 结构(先归一化再进注意力 / MLP,区别于原始 Transformer 的 Post-LN) Multi-Head Self-Attention(多头自注意力) 将 维特征拆分为 个独立头(例:,每头 维),并行计算注意力后拼接,捕捉不同子空间的依赖关系 上一层的输出 第 层 Encoder 的输出,作为当前层的输入 残差连接(Residual Connection) 将 MSA 的输出与输入直接相加,缓解深层网络的梯度消失问题 MSA 子层的输出 形状与输入一致 ,进入下一个 MLP 子层 Encoder 层数 ViT-B/16 为 12 层,ViT-L/16 为 24 层 -
多层感知机(MLP)层 + 残差连接
符号 含义 细节说明 多层感知机 结构为「线性层 → GELU 激活 → Dropout → 线性层」,中间层维度通常为 (例: 时中间层为 维),用于特征的非线性变换 层归一化 同样采用 Pre-LN 结构,先归一化再进 MLP 上一个 MSA 子层的输出 作为 MLP 子层的输入 残差连接 将 MLP 的输出与输入相加,进一步稳定梯度 第 层 Encoder 的最终输出 形状 ,作为下一层 Encoder 的输入( 时),或最终层输出( 时) -
分类输出层:ViT 的最终预测阶段,用
clstoken 完成分类任务符号 含义 细节说明 第 层 Encoder 输出中, clstoken 对应的向量取 的第 0 个元素(形状 ),聚合了全局图像特征 层归一化 对 clstoken 做最终归一化模型最终输出 后续接一个线性分类层(公式中省略),将 维特征映射为类别数维度,得到分类概率 -
分类头是「」, 为分类权重矩阵
微调
-
预训练完成的 ViT 是一个强大的特征提取器,其输出的特征可用于各类下游任务,例如更丰富的分类任务、目标检测等
-
在执行这些任务时,会向预训练模型输入新数据,同时尽可能保留模型主体架构不变(例如冻结 ViT 整体参数,仅在输出层后新增模型,训练时仅更新新模型参数)
-
这种既复用已有模型的特征提取能力,又让模型适配新任务的操作,称为微调(fine-tune)
-
在微调时,输入图像的尺寸往往与预训练阶段不一致:
- 预训练阶段:通常使用
224×224×3大小的图像 - 微调阶段:为提升效果,一般采用更高分辨率的图像,例如
1024×1024×3
- 预训练阶段:通常使用
-
若保持 Patch 尺寸 不变:
- 预训练阶段的 Patch 数量:
- 微调阶段的 Patch 数量:
-
Transformer 主体架构理论上可处理任意长度的输入序列,但可学习(learnable)位置编码与输入序列长度强绑定(一个位置对应一条独立的位置编码),无法直接适配变长输入
-
针对新增 Patch 的位置编码初始化问题:
- 若统一赋值为 0 向量,再在微调中训练,虽可实现,但会增加计算量,且浪费预训练阶段学到的位置信息
- 更优方案:充分利用已有位置编码的先验信息,对预训练阶段的位置编码做 2D 插值处理,完成新位置编码的初始化,再在微调中进行适配性更新
-
2D 插值的过程
-
插值分为 3 个核心步骤:
-
Reshape 还原 2D 结构
-
将预训练阶段的 1D 位置编码(形状 , 为隐维度),还原为 2D 特征图:
-
对应公式中的 空间结构
-
2D 插值扩展尺寸
-
对 2D 特征图执行双三次插值(bicubic),将空间尺寸从 扩展到 :
-
插值过程中保持特征维度 不变,仅对空间维度做缩放
-
Reshape 还原 1D 序列
-
将插值后的 2D 特征图重新展平为 1D 位置编码,适配微调阶段的长序列输入:
-
-
代码实现
new_pos_embedding_img = nn.functional.interpolate( pos_embedding_img, size=new_seq_length_1d, mode=interpolation_mode, align_corners=True ) -
参数说明
参数 含义 ViT 实践细节 pos_embedding_img输入的预训练位置编码(已 reshape 为 2D 格式) 形状为 (batch, hidden_dim, h_pretrain, w_pretrain),PyTorch 插值默认以最后两维为空间维度size目标空间尺寸 对应微调阶段的 ,如 64×64 mode插值方法 ViT 论文默认采用 bicubic(双三次插值),相比线性插值能更好保留局部细节 align_corners=True角点对齐 固定原矩阵的四个角点位置不变,仅对中间区域做插值,保证空间位置的一致性(如图中白色圆圈为原始点,蓝色点为插值后点) -
cls token 位置编码:分类头
clstoken 的位置编码不参与插值,直接保留预训练值,仅对图像 Patch 对应的位置编码做 2D 插值 -
插值方法选择:除 bicubic 外,也可根据任务选择 bilinear(双线性)、nearest(最近邻)等,bicubic 在图像任务中通常效果最优
-
微调阶段更新:插值后的位置编码会作为初始化参数,在微调过程中继续参与梯度更新,适配新分辨率的空间分布
-
与 CNN 的对比
-
实际实验结果表明,ViT 在准确率上早期不如卷积网络,这主要是由于卷积神经网络的归纳偏置(inductive biases)
-
归纳偏置可以简单理解为一种先验假设或领域先验知识,有了这些先验,才能判断哪种模型更适合某类任务。不同任务的归纳偏置内容不同,对图像任务而言,核心有两点:
- 空间局部性(locality):假设图像中相邻区域的特征高度相关,比如太阳和天空常常一起出现,邻近像素语义相似
- 平移等变性(translation equivariance):满足 ,其中 为卷积, 为平移;物体在图中移动后,卷积核仍能以相同方式提取特征;无论物体出现在哪里,只要局部模式一致,卷积输出就一致
-
在这两种先验下,CNN 成为图像任务的主流方案,卷积核天然保持空间局部性与平移等变性,能在训练中最大程度学习并保留图像结构信息
-
反观 ViT,它在这两种先验的保持上不如 CNN:
- 同一物体被切分成不同 patch 后,在序列中距离变远,即使 Attention 能学习关联,空间局部性的保持也弱于直接用卷积框选局部区域
- 在平移等变性上,ViT 依赖学习得到的位置编码,同一个 patch 移动位置后对应的编码不同,输出也会变化,因此架构本身没有天然维护平移等变性
-
但这并不代表 ViT 没有优势,Transformer 系列有一个标志性特点:大力出奇迹
-
只要数据量足够大,模型就能充分学习 patch 之间的关联,从而弥补归纳偏置的不足
CLIP
基本思想
-
所谓多模态,就是指来自不同领域的输入数据,比如文字、图片、语音、视频等,在传统方法中,各个领域都有相对独立的经典处理算法:
- 处理文本:RNN、LSTM、Transformer 等
- 处理图像:各类卷积神经网络等
-
不同模态的建模方式相对独立,但现实场景中常常需要跨模态联合建模,例如:
- 输入一张图片,输出对应的描述文字(图像 caption)
- 输入一段文字,生成符合描述的图片(文生图)
-
实现这类任务的核心难点在于:不同模态数据的特征分布、信息结构差异巨大
-
因此,多模态模型的总体目标就是训练一个统一模型,既能对齐不同模态的特征空间,又能让不同模态的特征之间学到语义相关性
-
ViT 的缺陷
- 在使用 ViT 做传统图像分类时,训练过程是有监督、带标签的
- 每张训练数据以
<image, label>形式输入,最终通过 MLP Head 输出的向量完成图片类别预测 - 这种设计存在两个明显缺点:
- 缺点 1:遇到训练集中从未见过的新类别时,模型无法正确预测。例如训练数据只有动物,测试时输入汽车图片,模型会完全失效
- 缺点 2:当输入数据出现分布偏移(distribution shift)时,模型性能会大幅下降。比如训练用普通动物照片,测试用毕加索风格的动物画作,就属于典型的分布偏移
- 传统解决思路是微调,但多模态模型希望做到一步到位,即不做任何微调,直接实现零样本(zero-shot)图像分类
-
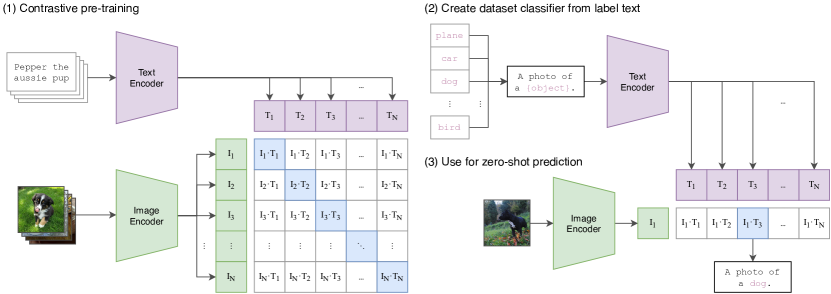
CLIP(Contrastive Language-Image Pre-training)是 OpenAI 提出的双塔结构多模态模型,核心是通过对比学习实现图像 - 文本的跨模态语义对齐,从而支持零样本(zero-shot)图像分类
-
模型结构
-
CLIP 由两个独立的编码器组成,分别处理图像和文本两种模态:
- 图像编码器(Image Encoder):可以用 ResNet 或 ViT(论文中两种都做了实验,ViT 效果更优),负责将输入图像编码为固定维度的图像特征向量
- 文本编码器(Text Encoder):采用 Transformer 结构(类似 BERT),负责将输入文本编码为固定维度的文本特征向量
-
两个编码器输出的特征维度完全一致,确保可以在同一个语义空间中计算相似度
-
阶段一:对比预训练(Contrastive Pre-training)
-
CLIP 最核心的训练阶段,目标是让匹配的图像 - 文本对特征相似度高,不匹配的对相似度低
-
训练数据:用海量(4 亿对)弱对齐的
<图像, 文本描述>数据对,无需人工标注分类标签 -
计算流程
- 输入一个 batch 包含 对
<图像, 文本>,分别通过两个编码器,得到 个图像特征 和 个文本特征 - 计算所有图像 - 文本对的余弦相似度,得到一个 的相似度矩阵:
- 对角线元素():正样本对(图像和对应文本匹配)
- 非对角线元素():负样本对(图像和其他文本不匹配)
- 损失函数:对称交叉熵损失,同时优化两个方向:
- 图像到文本的分类:让每个图像特征正确匹配到对应的文本特征
- 文本到图像的分类:让每个文本特征正确匹配到对应的图像特征
- 输入一个 batch 包含 对
-
通过这个训练,CLIP 会学到一个统一的跨模态语义空间:语义相似的图像和文本,在这个空间里的特征会被拉得很近
-
-
阶段二:零样本分类的推理流程
-
预训练完成后,CLIP 无需任何微调,就能直接完成零样本图像分类,分为两步:
-
用标签文本生成分类器
- 针对目标数据集的类别标签(如
plane, car, dog, bird),用 prompt 模板(论文中用A photo of a {object}.)将标签转化为自然语言描述 - 将这些描述文本输入文本编码器,得到每个类别对应的文本特征向量 ,这些特征就构成了零样本分类器
- 针对目标数据集的类别标签(如
-
零样本预测
- 输入一张待分类的测试图像,通过图像编码器得到图像特征
- 计算 与所有类别文本特征的余弦相似度,相似度最高的类别,就是模型预测的结果
- 例:输入狗的图片, 与
A photo of a dog.的文本特征相似度最高,模型就输出dog类别
-
-
Prompt 工程:CLIP 的零样本效果高度依赖 prompt 设计,好的 prompt 能显著提升分类准确率,这也是后续多模态模型的核心优化方向
-
编码器选择:CLIP 图像编码器支持 ResNet 和 ViT,其中 ViT 版本(如 ViT-L/14)在大模型规模下效果远优于 ResNet,也是后续多模态模型的主流选择
数据集
- CLIP 的训练数据为 <图像,文本> 配对(pair),在一个训练 batch 中,包含若干张图像,每张图像都对应一条文本描述(prompt),例如:小狗的图像,对应 prompt
<dog>或A photo of a dog - CLIP 作者通过实验发现,prompt 的设计会显著影响模型的最终性能,典型案例如下:
- 通用图像分类:将 prompt 从单词
<dog>改为完整句子A photo of a dog,模型在 ImageNet 分类任务上的准确率直接提升 1.3% - OCR 识别任务:将待识别的文字、数字用引号包裹,能大幅提升识别效果
- 卫星图像分类:将 prompt 替换为
A satellite photo of a house,更贴合数据场景,分类效果显著优化 - 多语义歧义场景:针对
crane这类多义词(可表示 “仙鹤” 或 “起重机”),通过 prompt 补充语义约束,如A photo of a crane, a type of pet,可有效消除歧义,提升分类准确性
- 通用图像分类:将 prompt 从单词
- CLIP 没有使用前人构建的图像 - 文本数据集,原因在于:
- 现有数据集质量参差不齐
- 数据规模远不足以支撑大模型训练
- 因此,CLIP 团队构建了一个包含 4 亿对 <图像,文本> 的大规模数据集,制作流程如下:
- 从 Wikipedia 中提取出现次数 ≥ 100 的词,构建查询词列表(query list)
- 为列表中的每个查询词,匹配约 2 万条 <图像,文本> 配对,最终形成 4 亿级的大规模训练数据集
预训练
-
CLIP 模型由两大核心模块组成:Text Encoder 和 Image Encoder,它们分别是文本与图像的特征提取器
-
Text Encoder
- CLIP 的 Text Encoder 直接借鉴了 OpenAI 在 2019 年提出的 GPT2 模型架构,采用 Transformer 解码器结构作为核心,专门处理自然语言文本的特征提取
- 在文本预处理阶段,模型会对输入的每一条文本提示词(prompt)进行标准化处理:在文本序列的起始位置添加特殊符号
[SOS](Start of Sequence,序列开始),在末尾位置添加[EOS](End of Sequence,序列结束),以此标识文本的完整范围,帮助编码器明确文本边界 - 文本序列经 GPT2 架构的多层 Transformer 编码后,CLIP 选取最后一层 Transformer 输出中
[EOS]位置对应的特征向量,作为该条文本的最终全局特征表示,记为 ,每一条独立的 prompt 都会对应唯一的文本特征向量
-
Image Encoder
- CLIP 的 Image Encoder 并未直接沿用单一架构,而是在研究阶段做了大量对比实验
- 先后测试了 5 种不同深度的 ResNet 架构和 3 种不同规格的 ViT 架构,最终选定性能最优的 ViT-L/14@336px 作为正式的图像编码器
- 该编码器的核心参数定义为:ViT 的模型规模为 Large(大容量版本),图像分块大小 patch_size=14,即把输入图像划分为 14×14 的像素块进行 Transformer 编码
- 同时,在 CLIP 完成全部预训练流程后,研究团队额外使用 336×336 高分辨率图像对该图像编码器进行了 1 个 epoch 的微调(fine-tune),通过提升输入图像的细节信息,进一步激发模型的跨模态理解能力,让图像特征表达更精准
- 与文本编码器的输出逻辑一致,每张输入图像经过 ViT 编码后,都会生成一个对应的全局特征向量,记为 ,虽然原论文中未明确标注 的具体提取层位置,但从 Transformer 视觉模型的通用设计逻辑推断,该特征向量大概率取自 ViT 的
[CLS]分类标记位(与文本编码器取[EOS]向量的设计思路同源,均取模态序列的全局聚合特征)
-
批次数据与基础特征输出
- 假设模型训练时一个批次(batch)中包含 N 组一一对应的 <图像,文本> 配对数据,即第 1 张图像对应第 1 条文本、第 2 张图像对应第 2 条文本…… 第 N 张图像对应第 N 条文本
- 这 N 组数据分别通过 Image Encoder 和 Text Encoder 后,会输出两组基础特征序列:
- 文本基础特征序列:,维度为 ( 为文本编码器输出特征维度)
- 图像基础特征序列:,维度为 (为图像编码器输出特征维度)
-
多模态 Embedding 特征投影
-
由于文本、图像的基础特征分属不同模态空间,无法直接计算相似度,因此 CLIP 引入了可学习的多模态投影层,将两种特征映射到统一的跨模态特征空间中:
- 为文本特征设置可学习投影矩阵 (维度 , 为统一的跨模态特征维度)
- 为图像特征设置可学习投影矩阵 (维度 )
-
文本、图像基础特征分别与对应投影矩阵做矩阵乘法后,再进行 L2 归一化处理,得到最终的跨模态对齐特征:
- 文本跨模态特征:,维度
- 图像跨模态特征:,维度
-
这一步的核心作用是消除不同模态特征的维度差异与数值量级差异,让文本、图像特征处于同一度量空间,保证相似度计算的合理性
-
-
跨模态相似度计算
-
完成特征投影后,通过向量点积计算图像特征与文本特征之间的余弦相似度,构建 N×N 的相似度矩阵(logits 矩阵):
-
为图像特征与文本特征的点积,直接反映两两之间的余弦相似度,生成维度为 的基础相似度矩阵
-
为模型可学习的温度参数,通过指数缩放调整相似度数值分布,避免相似度值过于集中或分散,提升训练稳定性
-
-
损失函数
-
CLIP 的损失函数采用双向对称交叉熵设计,同时从 “图像检索文本” 和 “文本检索图像” 两个方向优化模型,具体分为两步计算后取平均:
-
按行计算图像→文本检索损失(loss_i)
- 以每一行为单位做 softmax 归一化,再计算交叉熵损失,真值为每行的对角线位置
- 该损失的物理意义:对于每一张输入图像,强制模型在当前批次的所有文本中,匹配出与其唯一对应的正确文本,最大化图像检索对应文本的准确率
-
按列计算文本→图像检索损失(loss_t)
- 以每一列为单位做 softmax 归一化,再计算交叉熵损失,真值为每列的对角线位置
- 该损失的物理意义:对于每一段输入文本,强制模型在当前批次的所有图像中,匹配出与其唯一对应的正确图像,最大化文本检索对应图像的准确率
-
将两个方向的损失相加后取平均值,得到最终训练损失:
-
缺陷
- 零样本性能并非顶尖,规模化提升成本极高
- CLIP 零样本在 ImageNet 达 76.2%,与有监督 ResNet50 相当,但远低于 MAE 等 SOTA 模型的 80%+ 精度
- 虽随模型增大性能会提升,但训练成本高昂,小幅精度提升需付出巨大代价
- 缺乏逻辑推理能力,难以处理抽象任务
- 无法完成物体计数、复杂纹理分类等需逻辑推理的抽象任务,在 DTD 纹理分类、CLEVRCountS 计数数据集上表现显著弱于 ResNet
- 对分布严重偏移的测试集泛化失效
- 零样本鲁棒性存在局限,当测试数据与训练集分布差异极大时效果不佳,如简单的 MNIST 手写数字识别仅 88% 准确率,远低于常规模型水平
- 文本标签为闭集,不支持开放式预测
- 零样本推理只能从预设的固定标签集合中选择匹配结果,无法自主生成全新的文本标签,自动化与开放泛化能力不足
- 不具备生成能力,仅为判别式多模态模型
- 受计算与架构设计限制,CLIP 只能实现图像 - 文本匹配判别,无法完成文本生成图像、图像生成文本等生成式任务,该缺陷后续被 DALL・E 2、Stable Diffusion 等模型弥补
BLIP
- BLIP (Bootstrapping Language-Image Pretraining) 是 salesforce 在 2022 年提出的多模态框架