MoE(Mixture of Experts)
介绍混合专家(Mixture of Experts,MoE)架构及其在大语言模型中的应用
- 参考资料
- 帖子
- A Visual Guide to Mixture of Experts (MoE)
- Mixture-of-Experts (MoE) LLMs - by Cameron R. Wolfe, Ph.D.
- nanoMoE: Mixture-of-Experts (MoE) LLMs from Scratch in PyTorch
- MoE 相关成果:Mixture-of-Experts (MoE): The Birth and Rise of Conditional Computation
- MoE 发展时间线与 MoE 并行:Distributed Mixture-of-Experts and Expert Parallelism | Bruno Magalhaes
- 论文
- 帖子
什么是 MoE
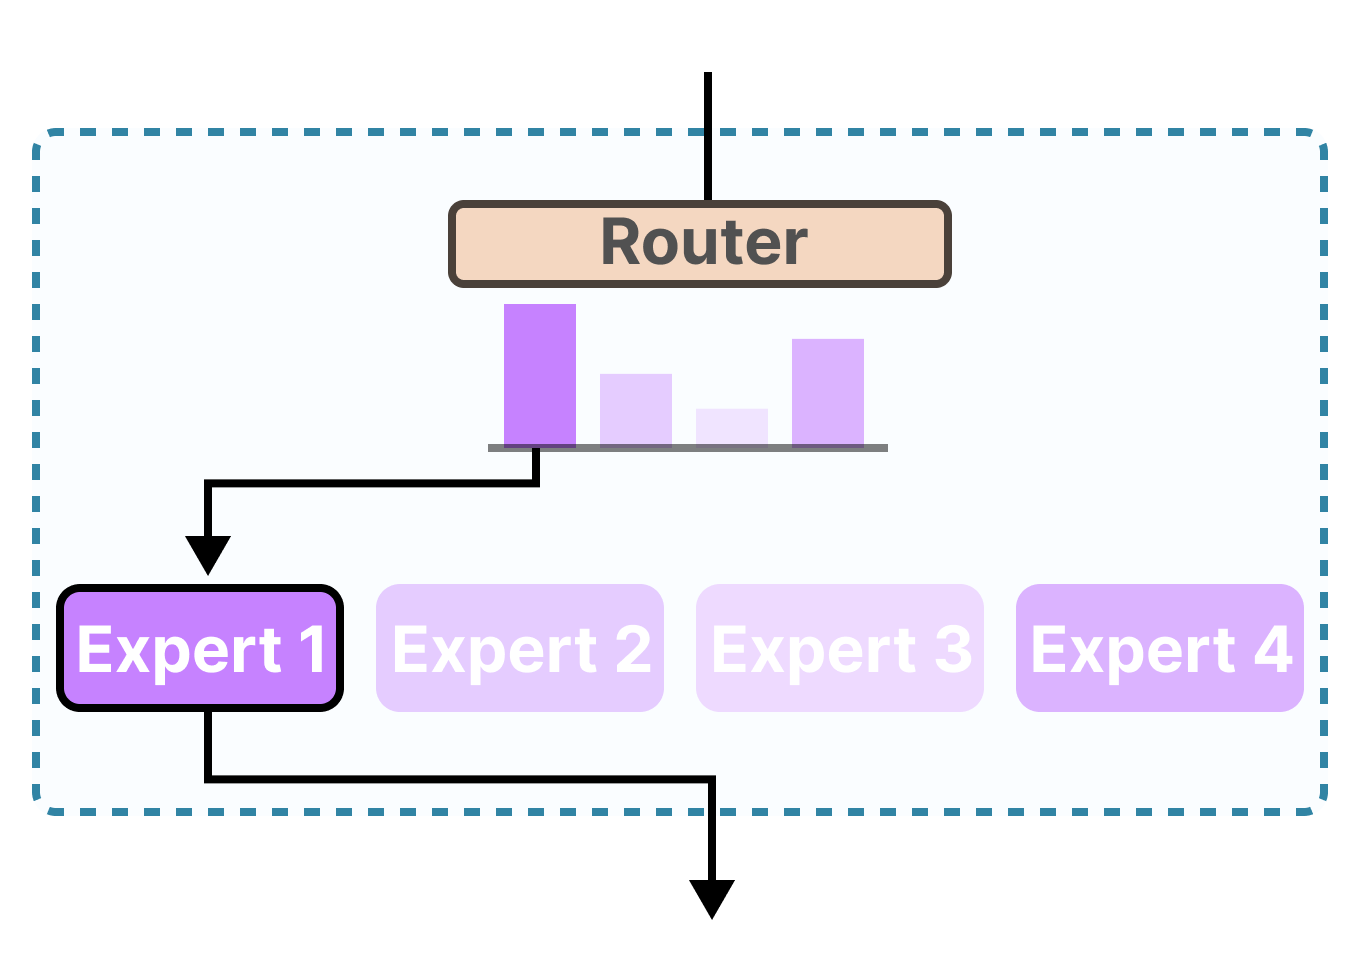
MoE 的基本架构
-
Dense 架构
- Dense 架构是传统的大语言模型架构,其中所有的参数都参与每个输入的前向计算
- 模型的每一层对输入数据进行完整的计算,参数是全局共享的
- 尽管每个前向计算使用了所有参数,但对于不同的任务或样本,很多参数的贡献可能较低,导致计算资源利用率不高
-
混合专家模型(Mixture of Experts,MoE)的优势
- 模型规模是提升模型性能的关键因素之一,在有限的计算资源预算下,用更少的训练步数训练一个更大的模型,往往比用更多的步数训练一个较小的模型效果更佳
- MoE 的一个显著优势是它能够在远少于 Dense 模型所需的计算资源下进行有效的预训练,这意味着在相同的计算预算条件下,可以显著扩大模型或数据集的规模
- 特别是在预训练阶段,与 Dense 模型相比,混合专家模型通常能够更快地达到相同的质量水平
- 关键技术:专家网络、门控网络、Top-K 激活、负载均衡机制、稀疏激活机制
-
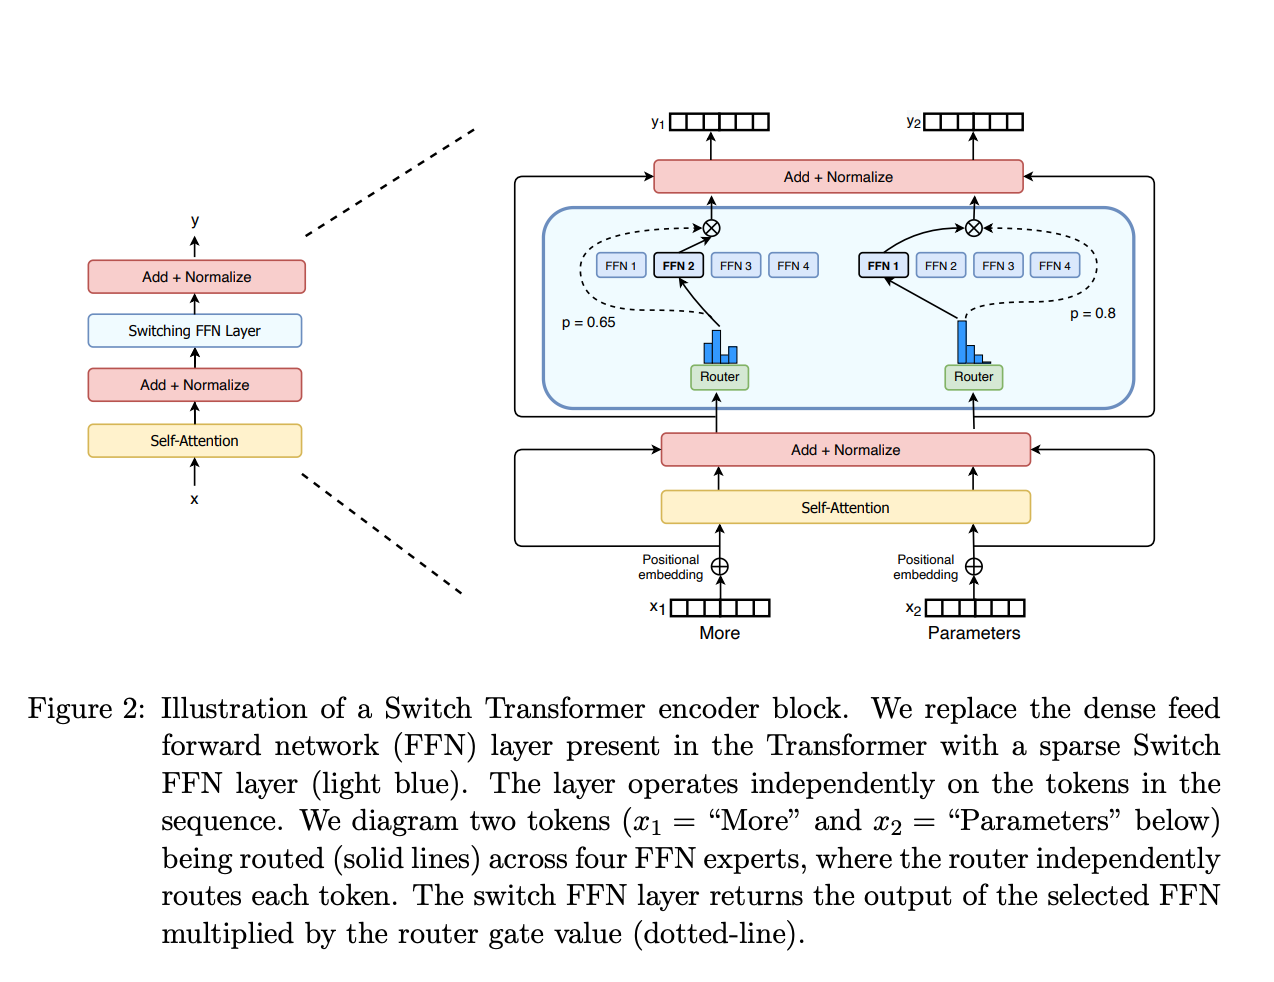
MoE 模型主要由两个关键部分组成
-
稀疏 MoE 层
- MoE 层代替了传统 Transformer 模型中的前馈网络 (FFN) 层
- MoE 层包含若干 “专家”(例如 8 个),每个专家本身是一个独立的神经网络
- 在实际应用中,这些专家通常是前馈神经网络,也可以是更复杂的网络结构,甚至可以是 MoE 层本身,从而形成层级式的 MoE 结构
- GPU / TPU 的计算和内存访问优化主要针对 Dense 计算,稀疏激活可能导致硬件利用率降低
-
门控网络或路由(Gating Network)
- 这个部分用于动态决定哪些 token 被发送到哪个专家,从而决定哪些专家模块参与计算
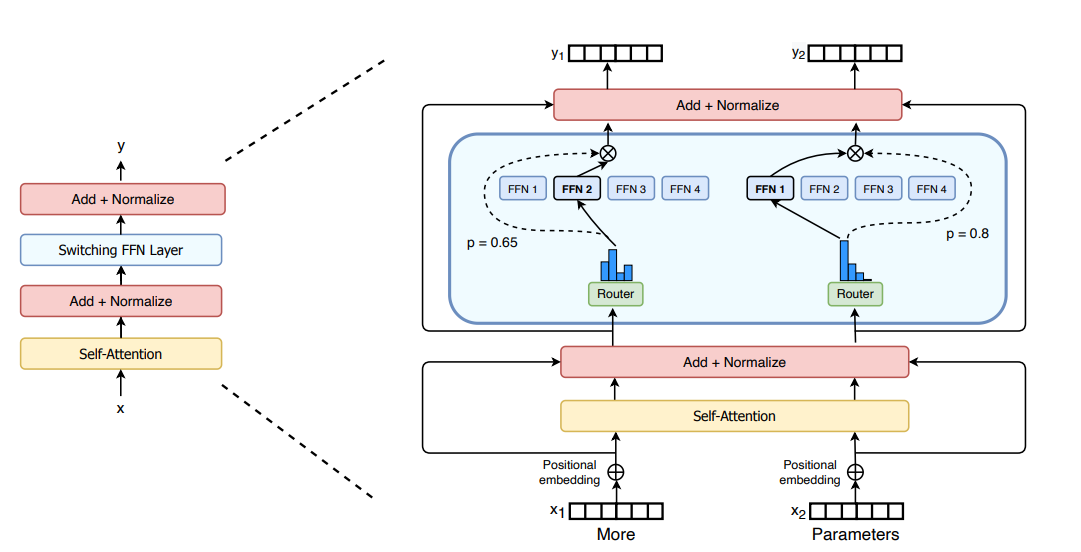
- 例如,在上图中,“More” 可能被发送到第二个专家,而 “Parameters” 被发送到第一个专家;有时,一个 token 可以被发送到多个专家
- token 的路由方式是 MoE 使用中的一个关键点,因为门控网络由可学习的参数组成,并且与网络的其他部分一同进行预训练
- 门控网络可能引入优化难题,例如专家负载不均(Load Balancing)
-
-
训练挑战:虽然 MoE 能够实现更高效的计算预训练,但在微调阶段往往面临泛化能力不足的问题,长期以来易于引发过拟合现象
-
推理挑战
- MoE 模型虽然可能拥有大量参数,但在推理过程中只使用其中的一部分,这使得推理速度快于具有相同数量参数的 Dense 模型
- 然而,MoE 模型需要将所有参数加载到内存中,因此对内存的需求非常高
- 以 Mixtral 8x7B 这样的 MoE 为例,需要足够的 VRAM 来容纳一个 47B 参数的稠密模型。之所以是 47B 而不是 8 x 7B = 56B,是因为在 MoE 模型中,只有 FFN 层被视为独立的专家,而模型的其他参数是共享的
- 此外,假设每个 token 只使用两个专家,那么推理速度(以 FLOPs 计算)接近于 12B 模型(而不是 14B 模型),因为虽然它进行了 2x7B 的矩阵乘法计算,但某些层是共享的
MoE 的本质
- 专家不是在领域知识层面的,而是语法句法层面的
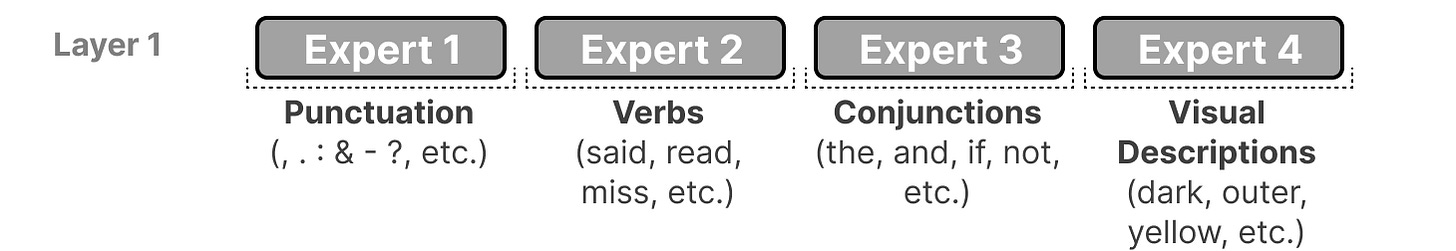
- encoder 中的 MoE 专家并非专注于 “心理学” 或 “生物学” 等特定领域,而是呈现出明显的 token / 概念级分工,例如:标点符号、数字、格式化 token、专有名词、实体、形态学或浅层句法线索,更擅长在特定语境下处理特定 tokens
- encoder 的目标是构建输入表示,而不是做决策,每个 token 的表示是 “并行” 的,不需要为最终输出承担直接责任
- encoder 中的路由看到的是当前 token 的 embedding,梯度主要来自 token 级重建 /attention 对齐
- 浅层统计模式在 encoder 中梯度最稳定,标点、大小写、子词边界在所有任务中高度一致,这些模式对 loss 的贡献密集、噪声小
- 因此,encoder 中非常容易形成这种结构:
- 专家 A:高频结构 token
- 专家 B:实体类 token
- 专家 C:函数词、连接词
- decoder 中的专家往往表现为语义混合、专精边界模糊、很难指认 “这个专家只做某一类 token”,原因恰恰来自 decoder 的角色不同:
- decoder 的损失是序列级、决策级,每一步预测都会影响未来 token,梯度高度耦合、非局部
- decoder token 不再是 “被解释的对象”,而是 “要被生成的决策”,不同类型 token 的预测共享相同的上下文依赖
- 从优化角度看,一个 decoder 专家如果只擅长 “某一类 token”,那么在其他时间步就会变成低效参数,门控网络会自然避免这种高度专一但覆盖率低的专家
- 结果是 decoder 专家更像 “通用语言建模子网络”,差异体现在风格或高阶特征,而不是 token 类型
- 为什么多语言训练中不会出现 “一专家一语言”
- MoE 路由器优化的目标是:降低 task loss,同时满足负载均衡约束,而不是最大化语言间可分性或最小化跨语言干扰
- MoE 的路由粒度是 token 级,而不是句子、段落或语言标签级
- 在多语言文本中同一语言内部 token 类型高度多样,不同语言之间 token 类型反而大量重叠
- 于是自然形成的是 “跨语言的功能专家”,而不是 “单语言专家”
- 从模型能力角度看,这种现象反而是 MoE 的优势,专家学的是 “可迁移的语言结构”,而不是 “语言标签本身”,多语言泛化能力更强,低资源语言可以共享高资源语言的专家能力
MoE 发展历史
-
混合专家模型的概念最早可以追溯到 1991 年的工作 Adaptive Mixture of Local Experts
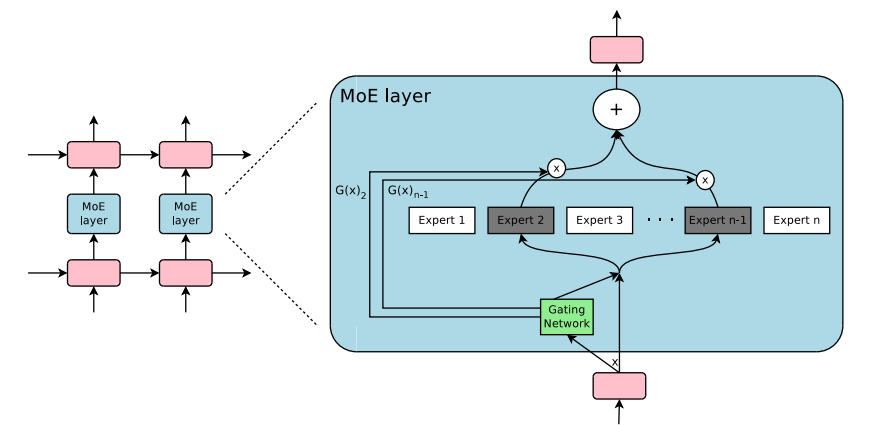
- 这一思想与集成学习方法在动机上较为相似,其目标是为由多个独立子网络组成的系统引入一种统一的调度与决策机制
- 在该框架下,每个子网络被视为一个 “专家”,负责处理训练数据的不同子集,并专注于输入空间中的特定区域
- 专家之间的选择与分配由门控网络完成,门控网络为每个输入样本分配对应的专家权重
- 在训练过程中,专家网络与门控网络是联合优化的,从而同时提升专家的表达能力与路由决策的有效性
-
在 2010 至 2015 年期间,两个相对独立的研究方向为混合专家模型的进一步发展奠定了基础:
-
作为网络组件的专家模型
- 在早期的 MoE 设定中,系统通常由一个门控网络和多个专家整体构成
- 在支持向量机、高斯过程等模型中,MoE 往往被视为完整模型的一种形式
- Eigen、Ranzato 和 Ilya 的研究 则提出将 MoE 作为深层神经网络中的一个组成模块
- 这种设计使得 MoE 可以嵌入到多层网络的特定位置,从而在显著提升模型容量的同时保持计算效率
-
条件计算
- 传统神经网络在前向传播时会对每一层、每一个参数执行完整计算
- 这一时期,Yoshua Bengio 等研究者开始探索根据输入动态激活或跳过部分网络结构的条件计算机制
- 条件计算为在不成比例增加计算量的前提下扩展模型规模提供了新的可能性
-
上述两个研究方向的逐步融合,直接推动了混合专家模型在自然语言处理领域中的应用与发展
-
-
在 2017 年,Shazeer 等人 将混合专家模型引入到大规模序列建模中,并将其应用于一个参数规模达到 137B 的 LSTM 模型
- LSTM 是当时 NLP 领域的主流架构之一,最早由 Schmidhuber 提出
- 通过引入稀疏激活机制,该工作在保持极大模型规模的同时,实现了相对高效的推理速度
- 尽管该模型主要应用于机器翻译任务,但仍面临通信开销较高、训练过程不稳定等实际问题
-
混合专家模型的提出与持续演进,使得参数规模达到数千亿乃至万亿级别的模型在工程上成为可能,例如公开发布的 1.6 万亿参数 Switch Transformers
Dense vs. Sparse
-
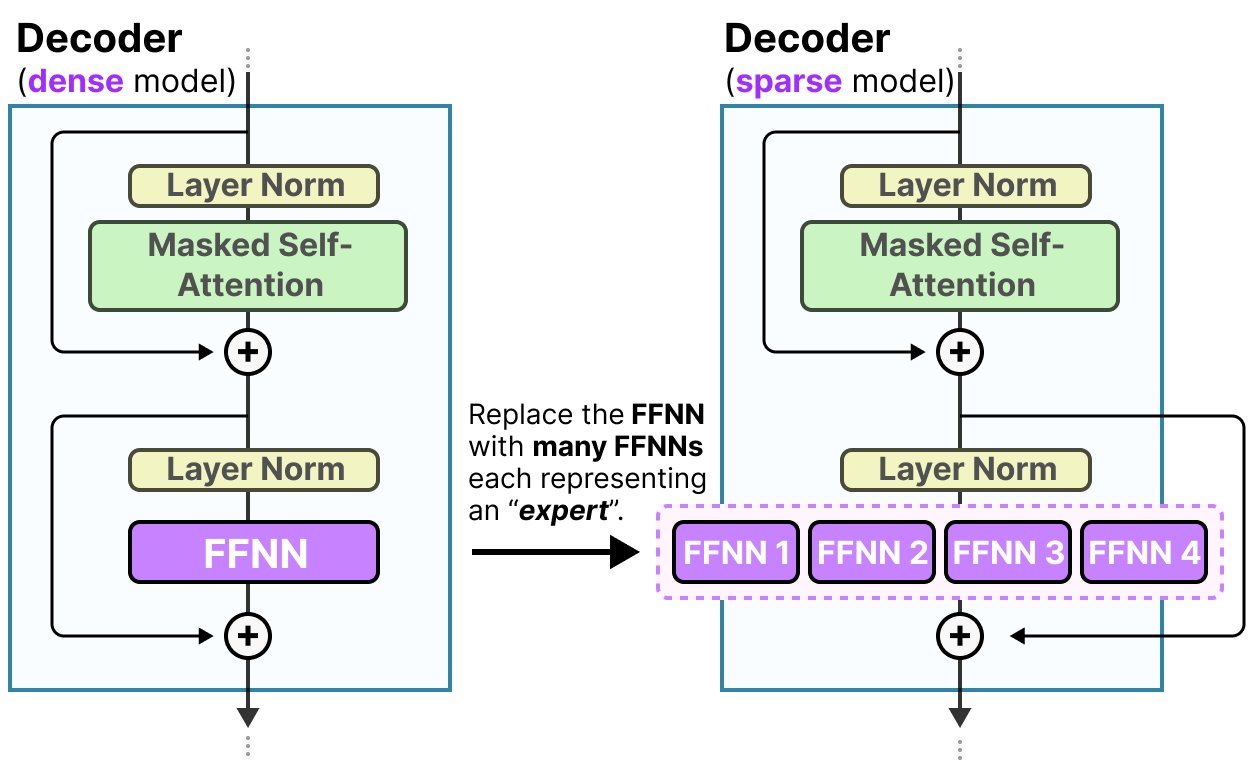
标准的 decoder-only Transformer 架构会在层归一化之后使用前馈神经网络
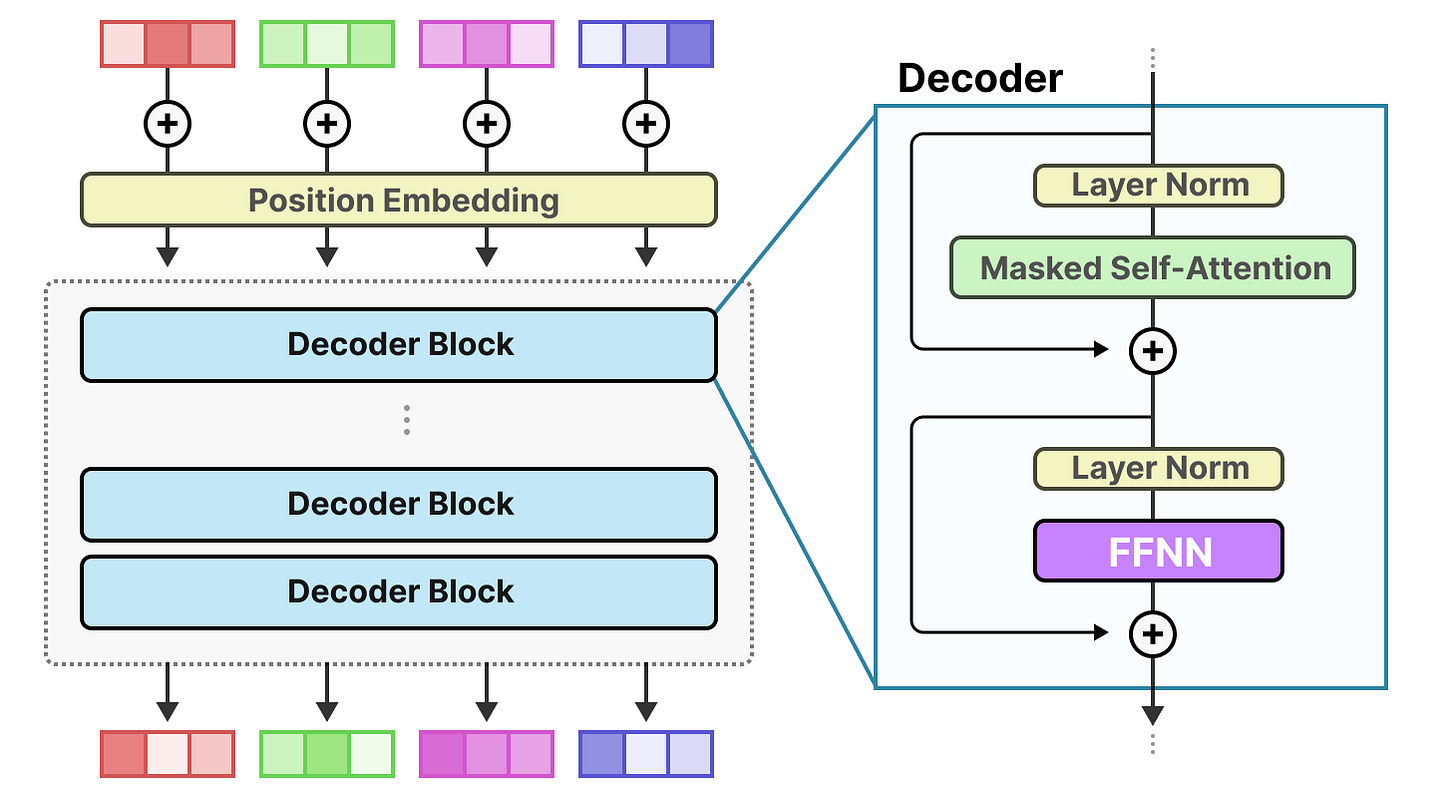
-
为了重新学习 token 中的复杂关系,FFN 通常会对输入进行扩展,隐藏层维度很大
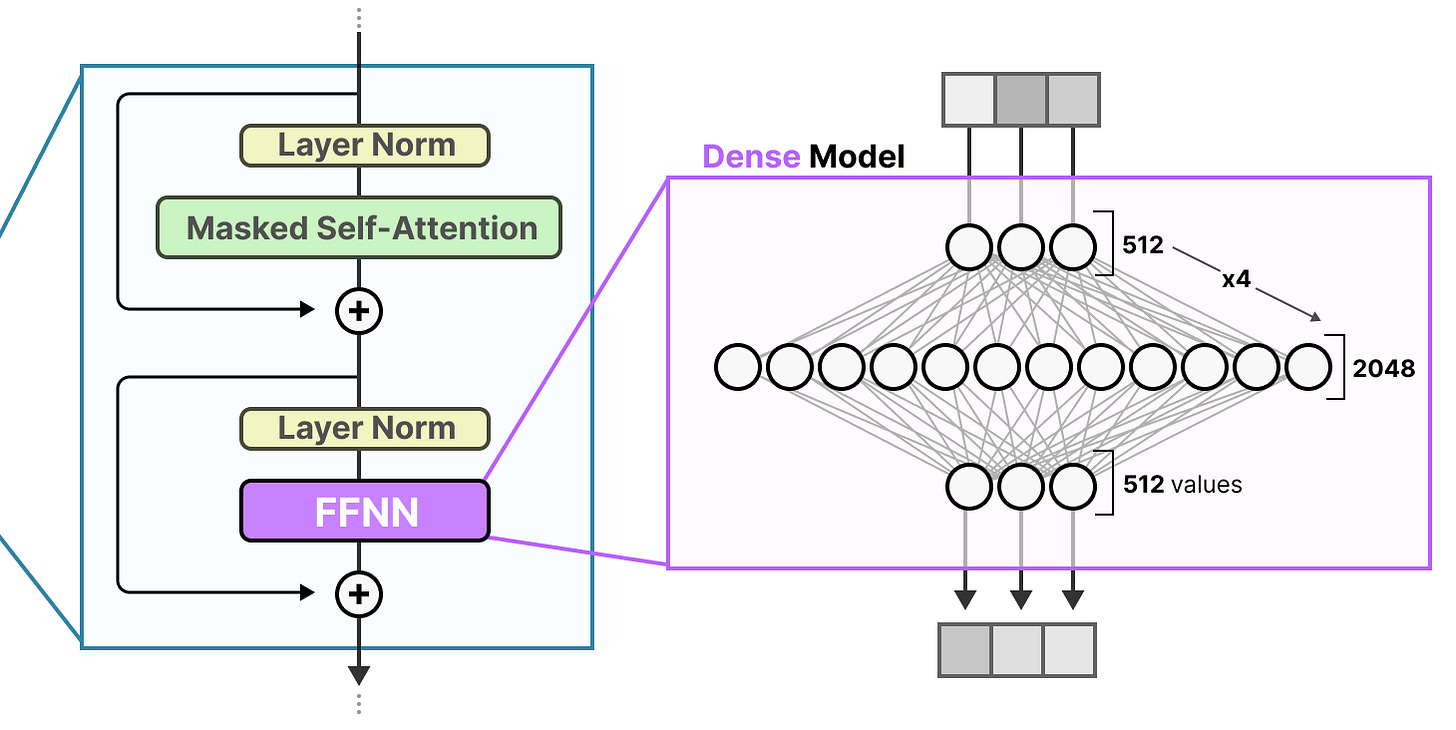
-
上述前馈神经网络被称为 Dense 模型,因为所有参数(其权重和偏置)都会被激活,没有任何参数被遗漏,所有参数都会用于计算输出
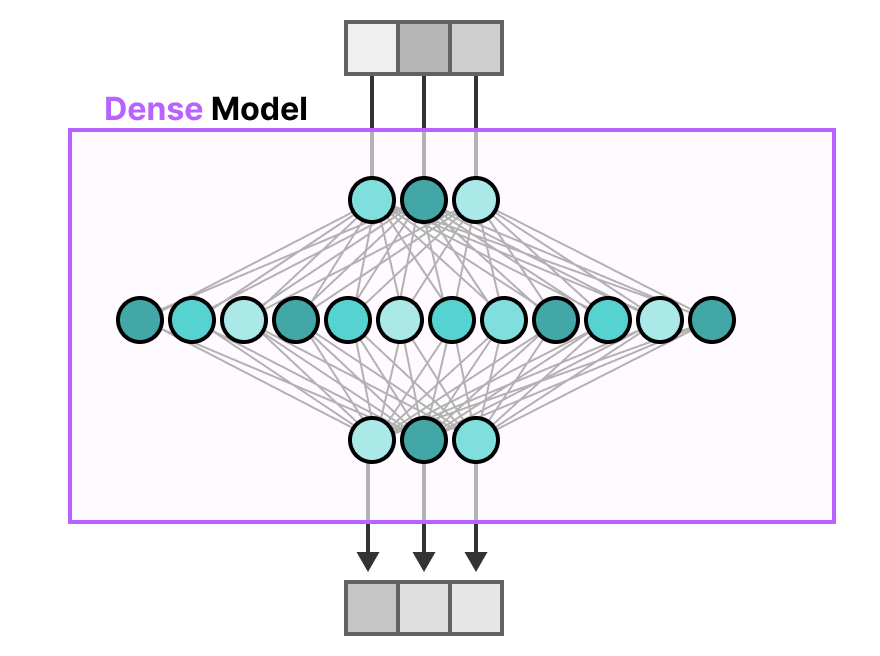
-
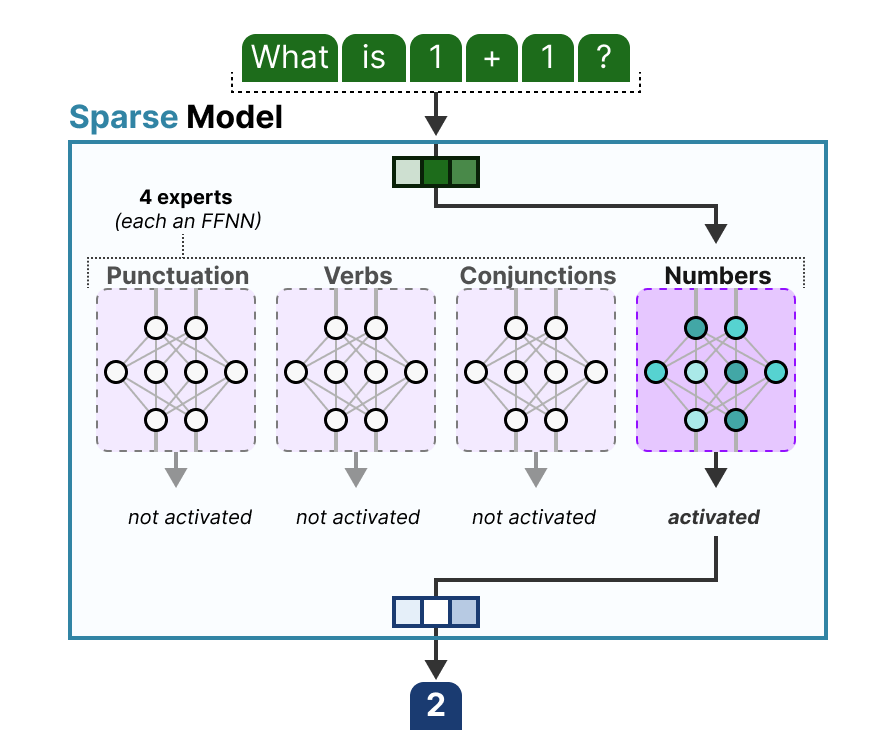
相比之下,稀疏模型仅激活总参数的一部分,举个例子,可以将 Dense 模型分割成多个部分(即所谓的专家),对其重新训练,并且在特定时间只激活一部分专家:
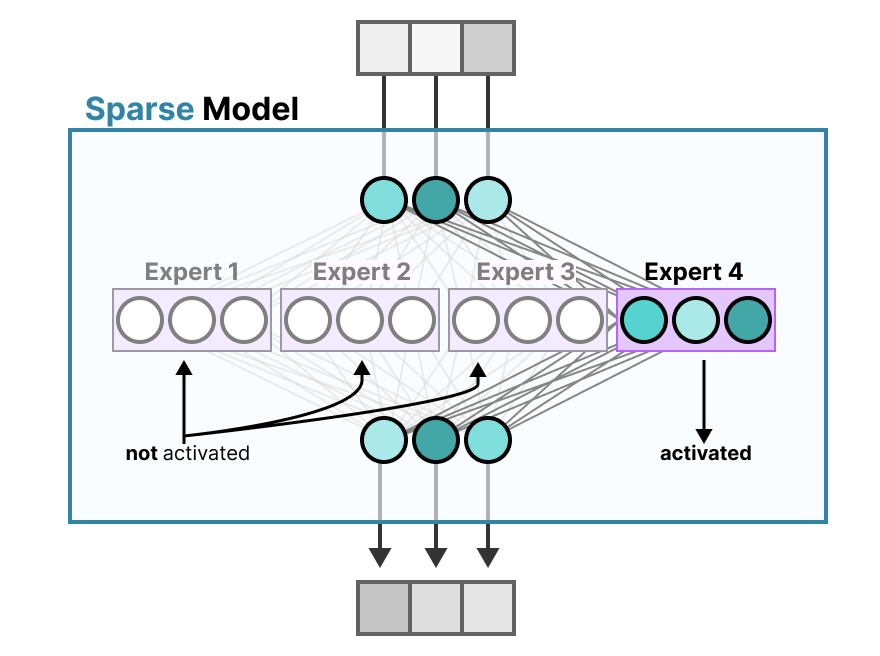
-
其核心思想是,每个专家在训练过程中会学习不同的信息,在进行推理时,只会使用那些与特定任务最相关的专家
-
当接收到一个输入时,可以据此选择最适合特定任务的专家:
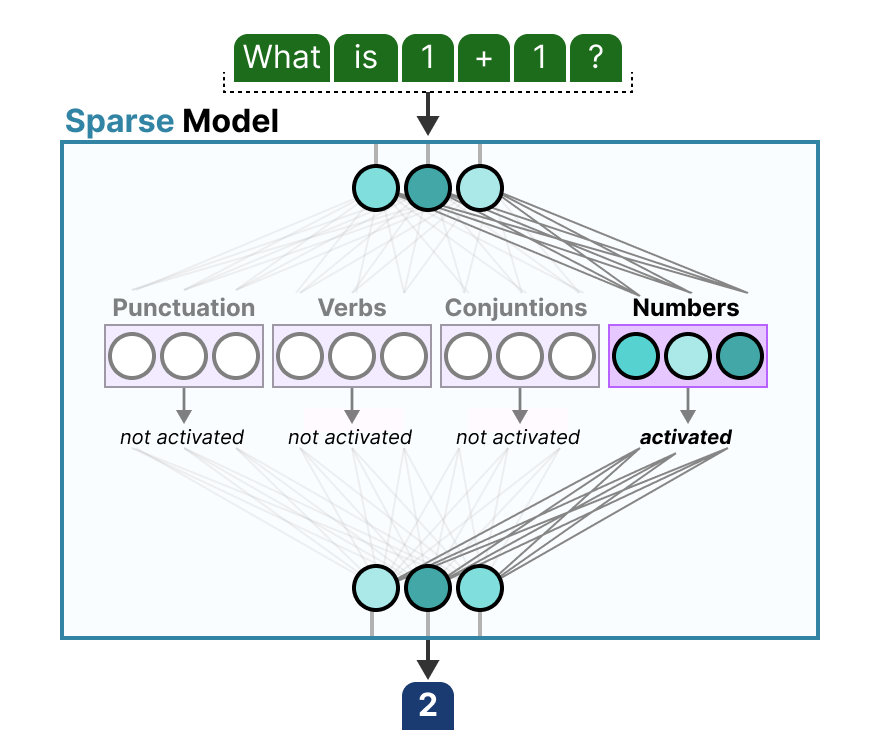
-
实际上,这里的专家学到的是更细粒度的信息,而非整个领域的知识,因此称之为 “专家” 是有一定误导性的,如 ST-MoE 论文的统计:
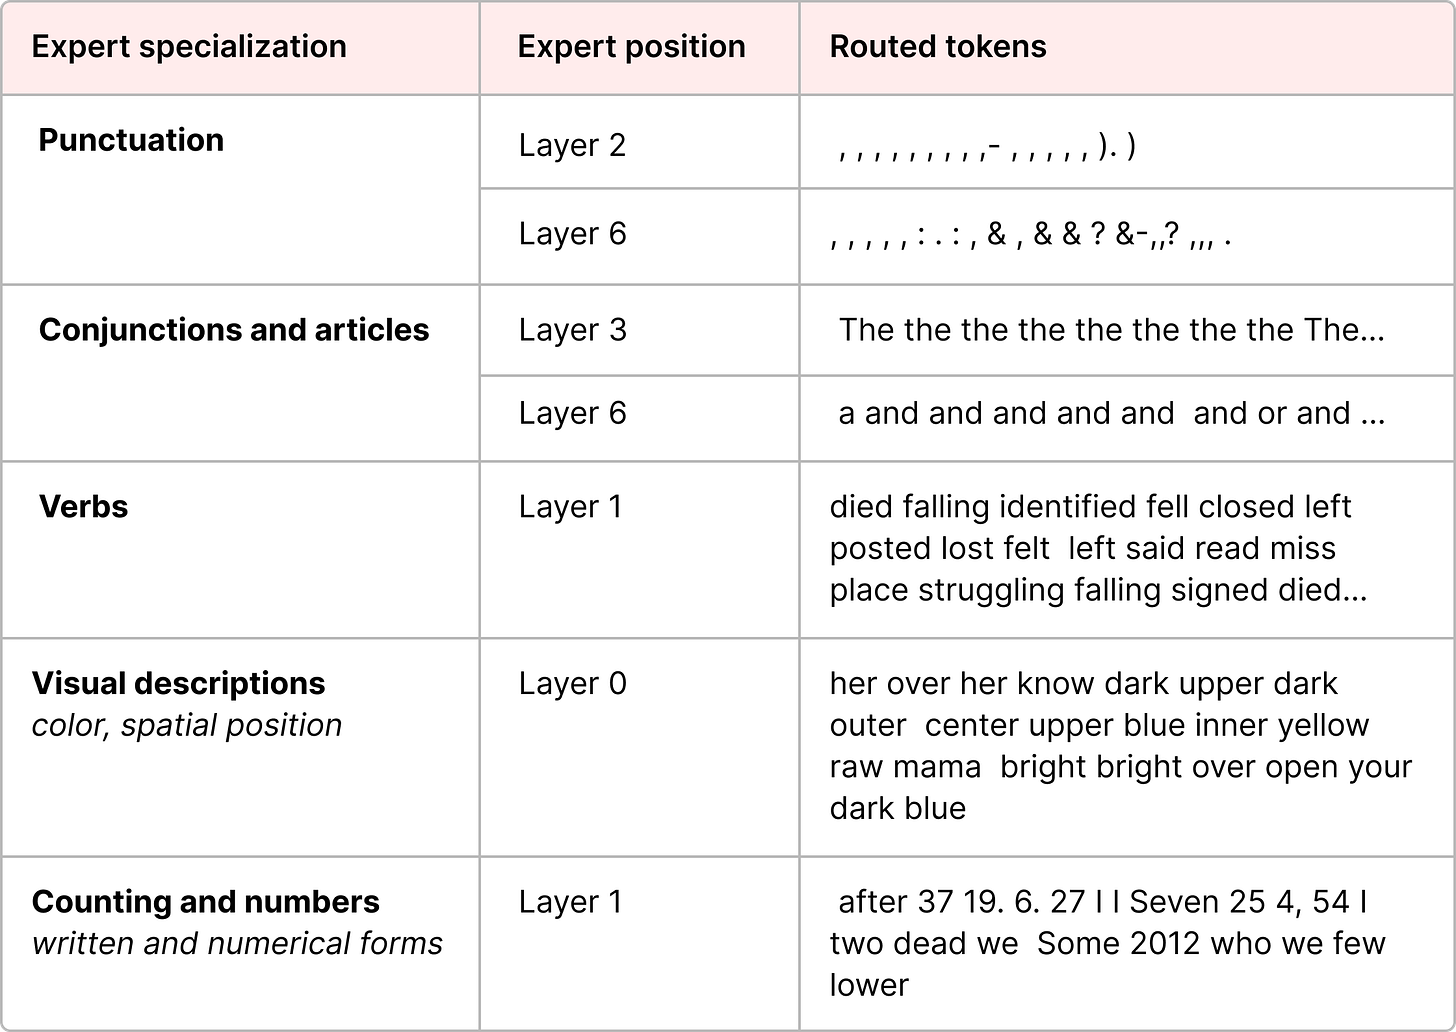
-
Mixtral 的论文展示了每个 token 被分配到的第一个专家,也表明专家们倾向于关注语法而非特定领域
-
从理论上来讲,稀疏性的核心思想来源于条件计算(Conditional Computation):
- 在传统的 Dense 模型中,所有参数都会参与对每一个输入样本的计算过程,而稀疏模型允许仅对部分输入执行计算
- 具体而言,并非所有参数在处理每个输入时都会被激活,而是根据输入的特征,仅激活与之相关的一小部分参数
- 这种 “按样本激活不同子网络” 的条件计算机制,使得模型参数规模可以显著扩展,而不会线性增加计算开销
- 在 MoE 层中,该策略使得数以千计甚至更多专家能够被有效整合到同一个模型中
-
在上面的说明中,我们将专家描述为由一个 Dense 模型分割为不同的子模块,但在实际工程中,专家本身通常是完整的前馈神经网络
-
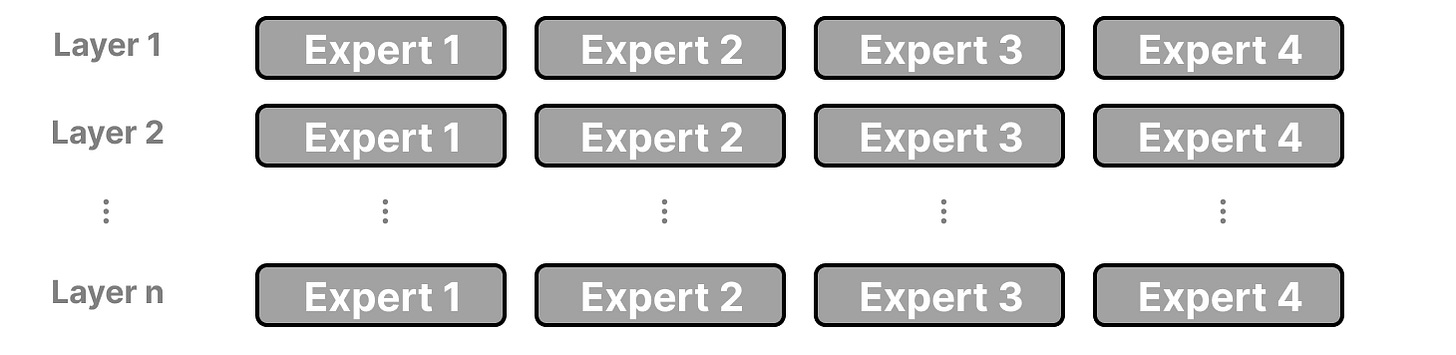
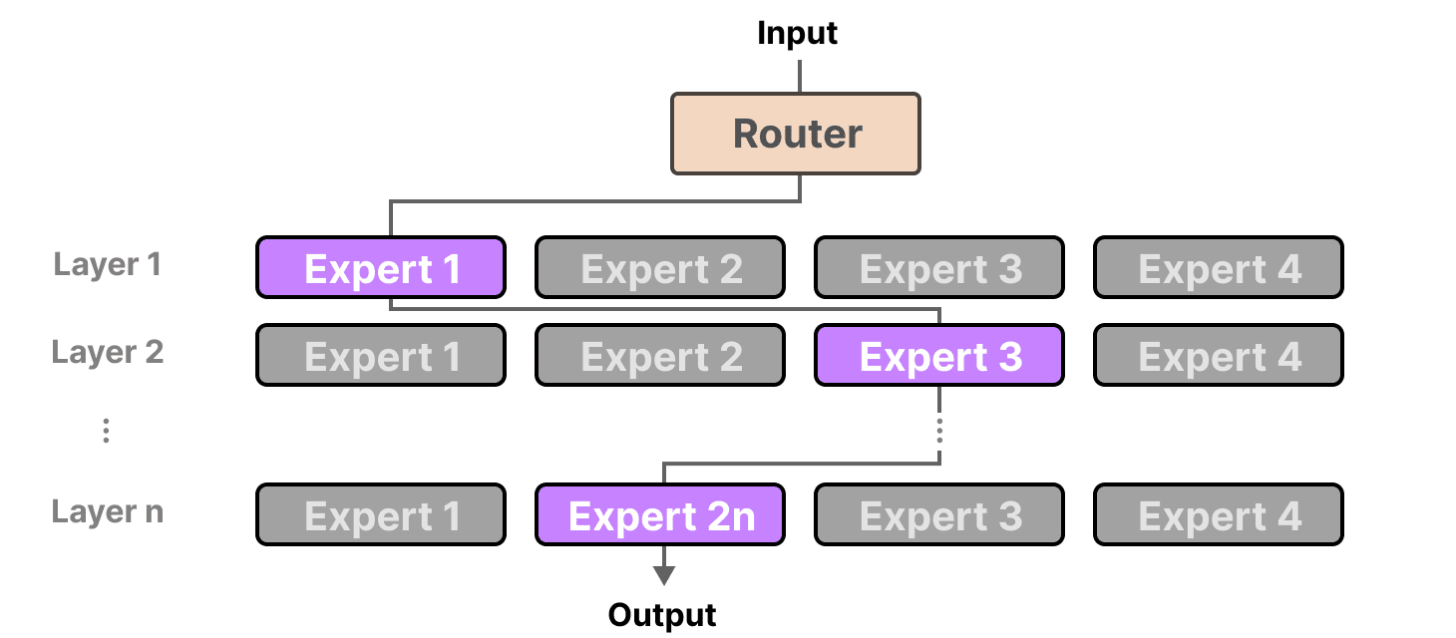
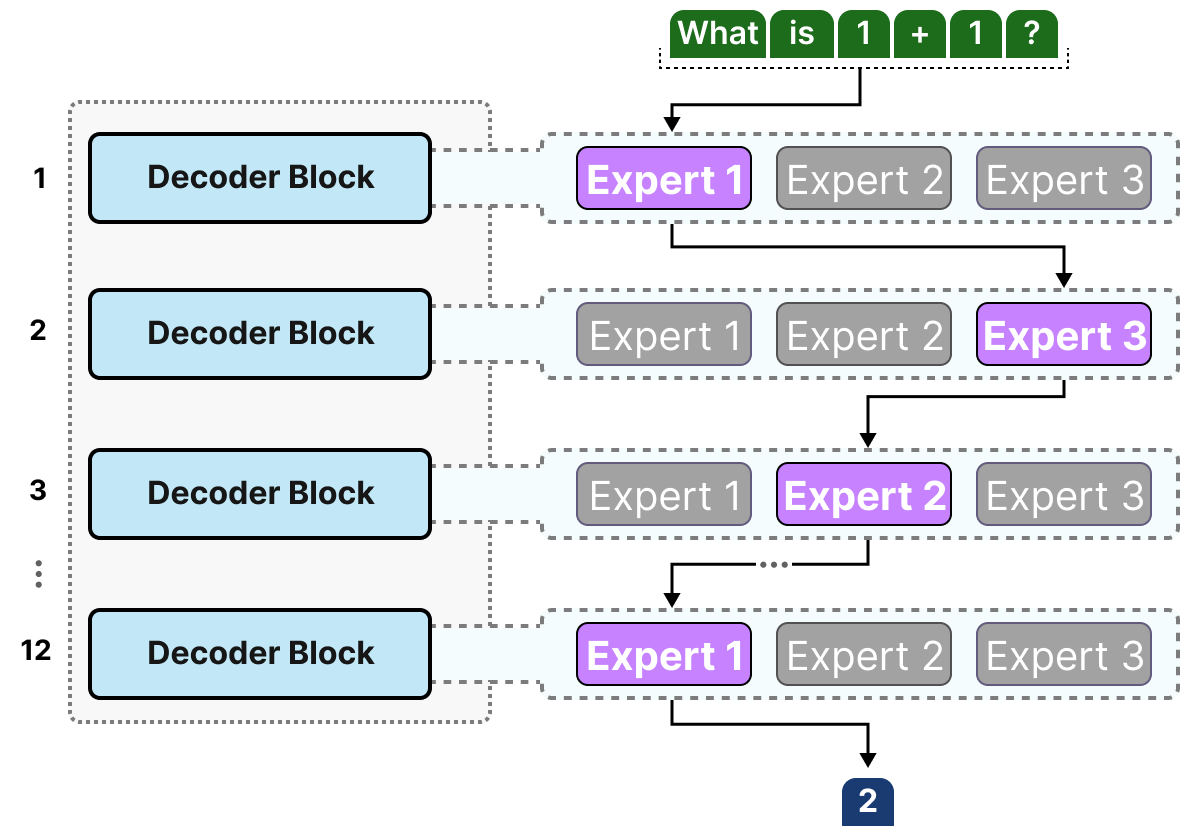
由于存在多个 Decoder Block,因此一般需要经过多个专家的处理
-
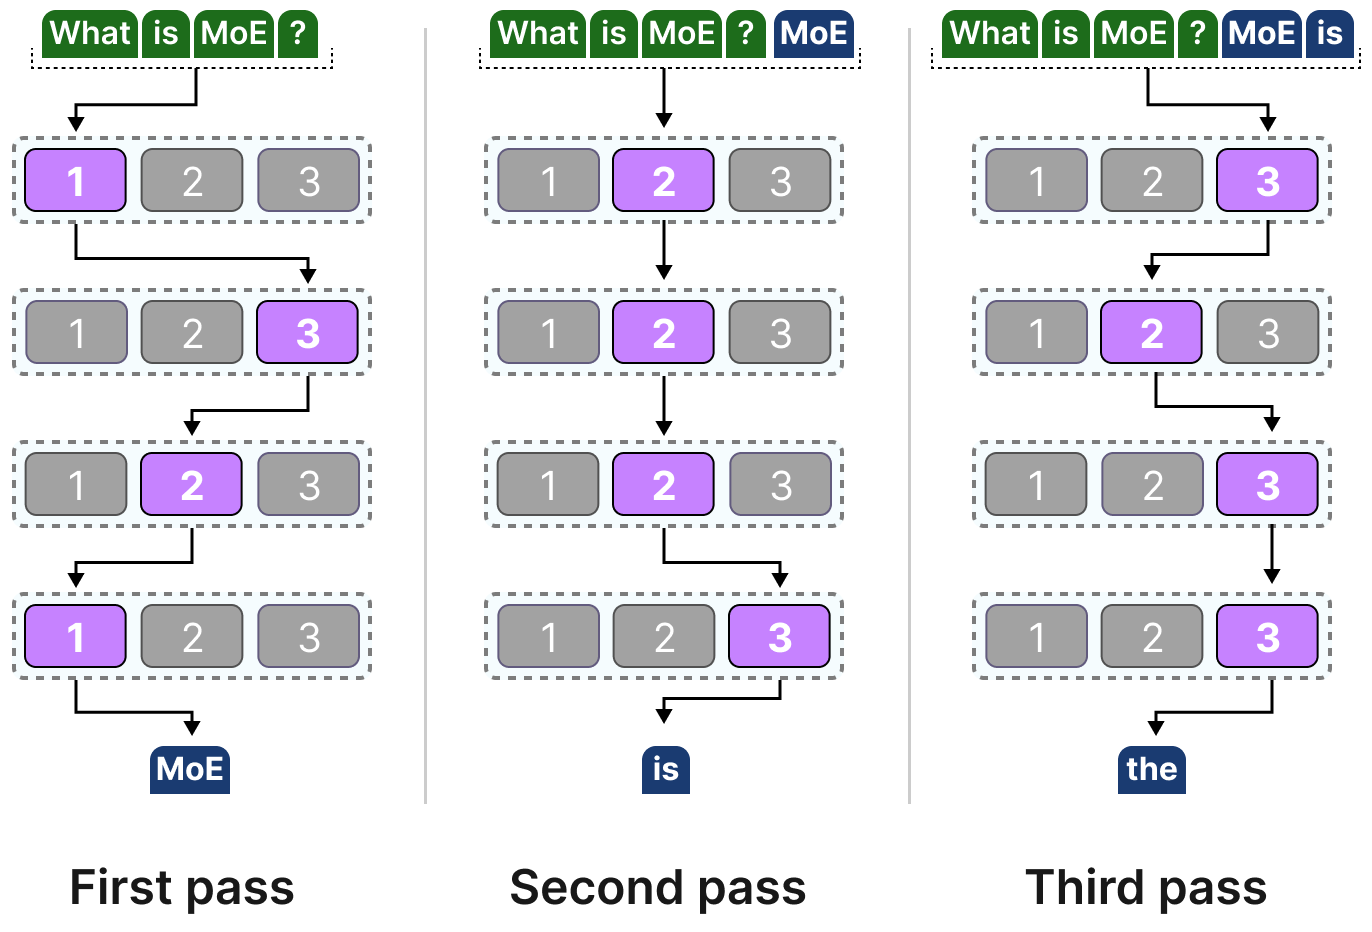
由于不同的专家在不同的 token 处理中存在差异,因此会有多条流向路径产生
-
Dense 模型与稀疏模型的对比
Router / Gating Network
-
既然现在有了一组专家,那么如何选择使用哪些专家?
-
为此,引入一个可学习的门控网络 ,用于决定输入应被分配给哪些专家 ,并基于此解决负载均衡问题:
-
在这一形式化描述中,输出由各专家的结果加权求和得到
-
当某个专家对应的门控权重 时,该专家的计算可以被跳过,从而节省计算资源
-
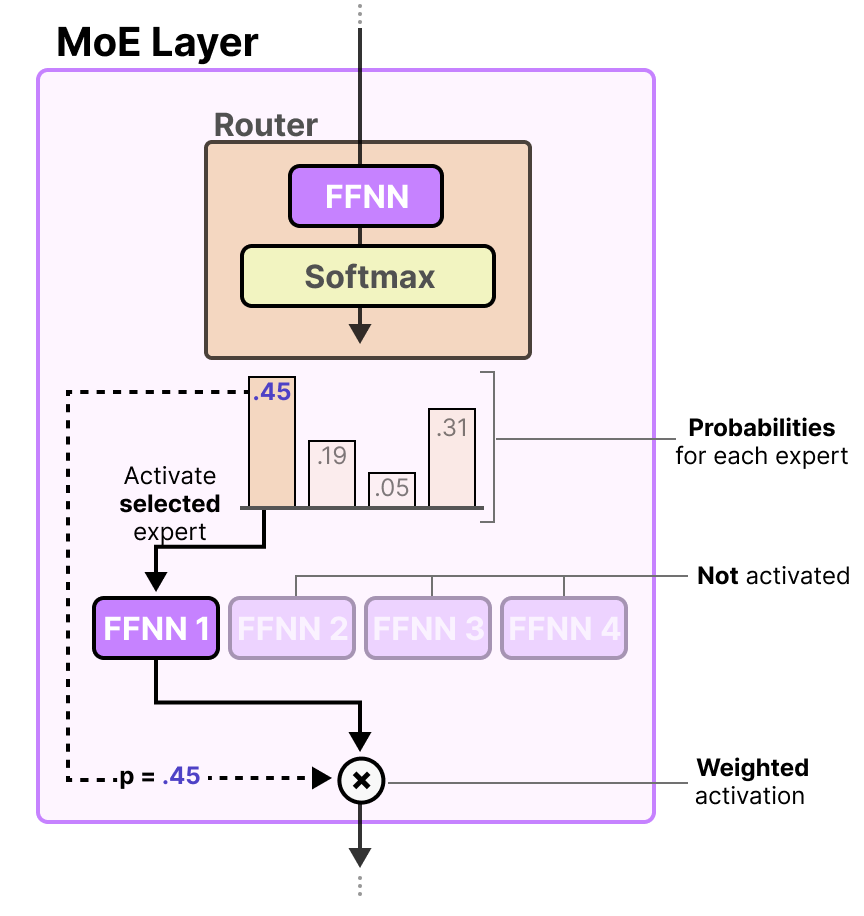
实际应用中,门控网络通常采用一个简单的前馈神经网络加 Softmax,用于学习输入到专家的分配关系:
-
-
门控网络的示意图如下:
-
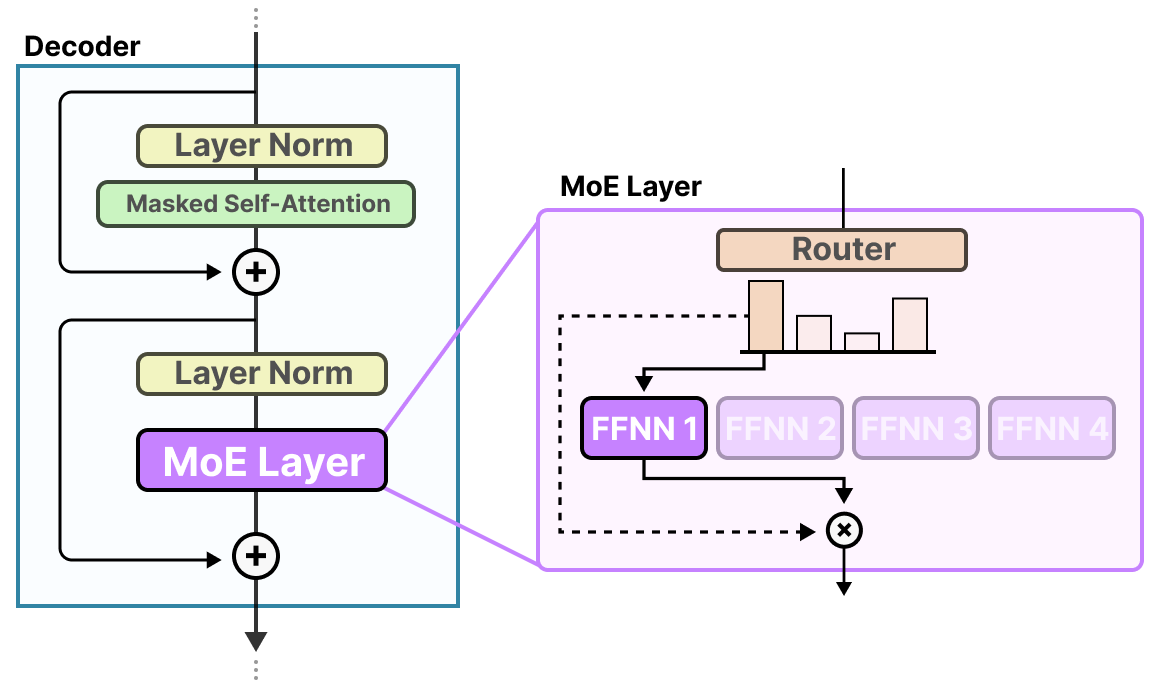
这样路由和一组专家组成了 MoE 层
-
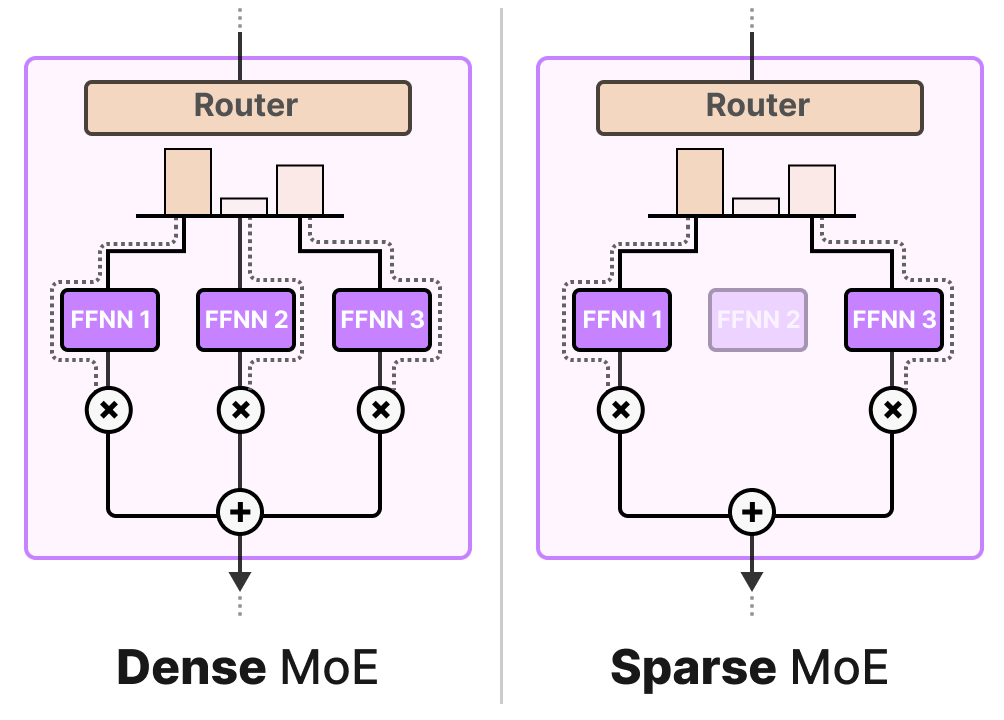
MoE 层也可以分为 Dense 和 sparse 两种,两者都使用路由器来选择专家,但 Sparse MoE 模型只选择少数专家,而 Dense MoE 模型则会选择所有专家,只是可能分布不同,一般来说,MoE 指的是 Sparse MoE 模型
-
路由的工作原理
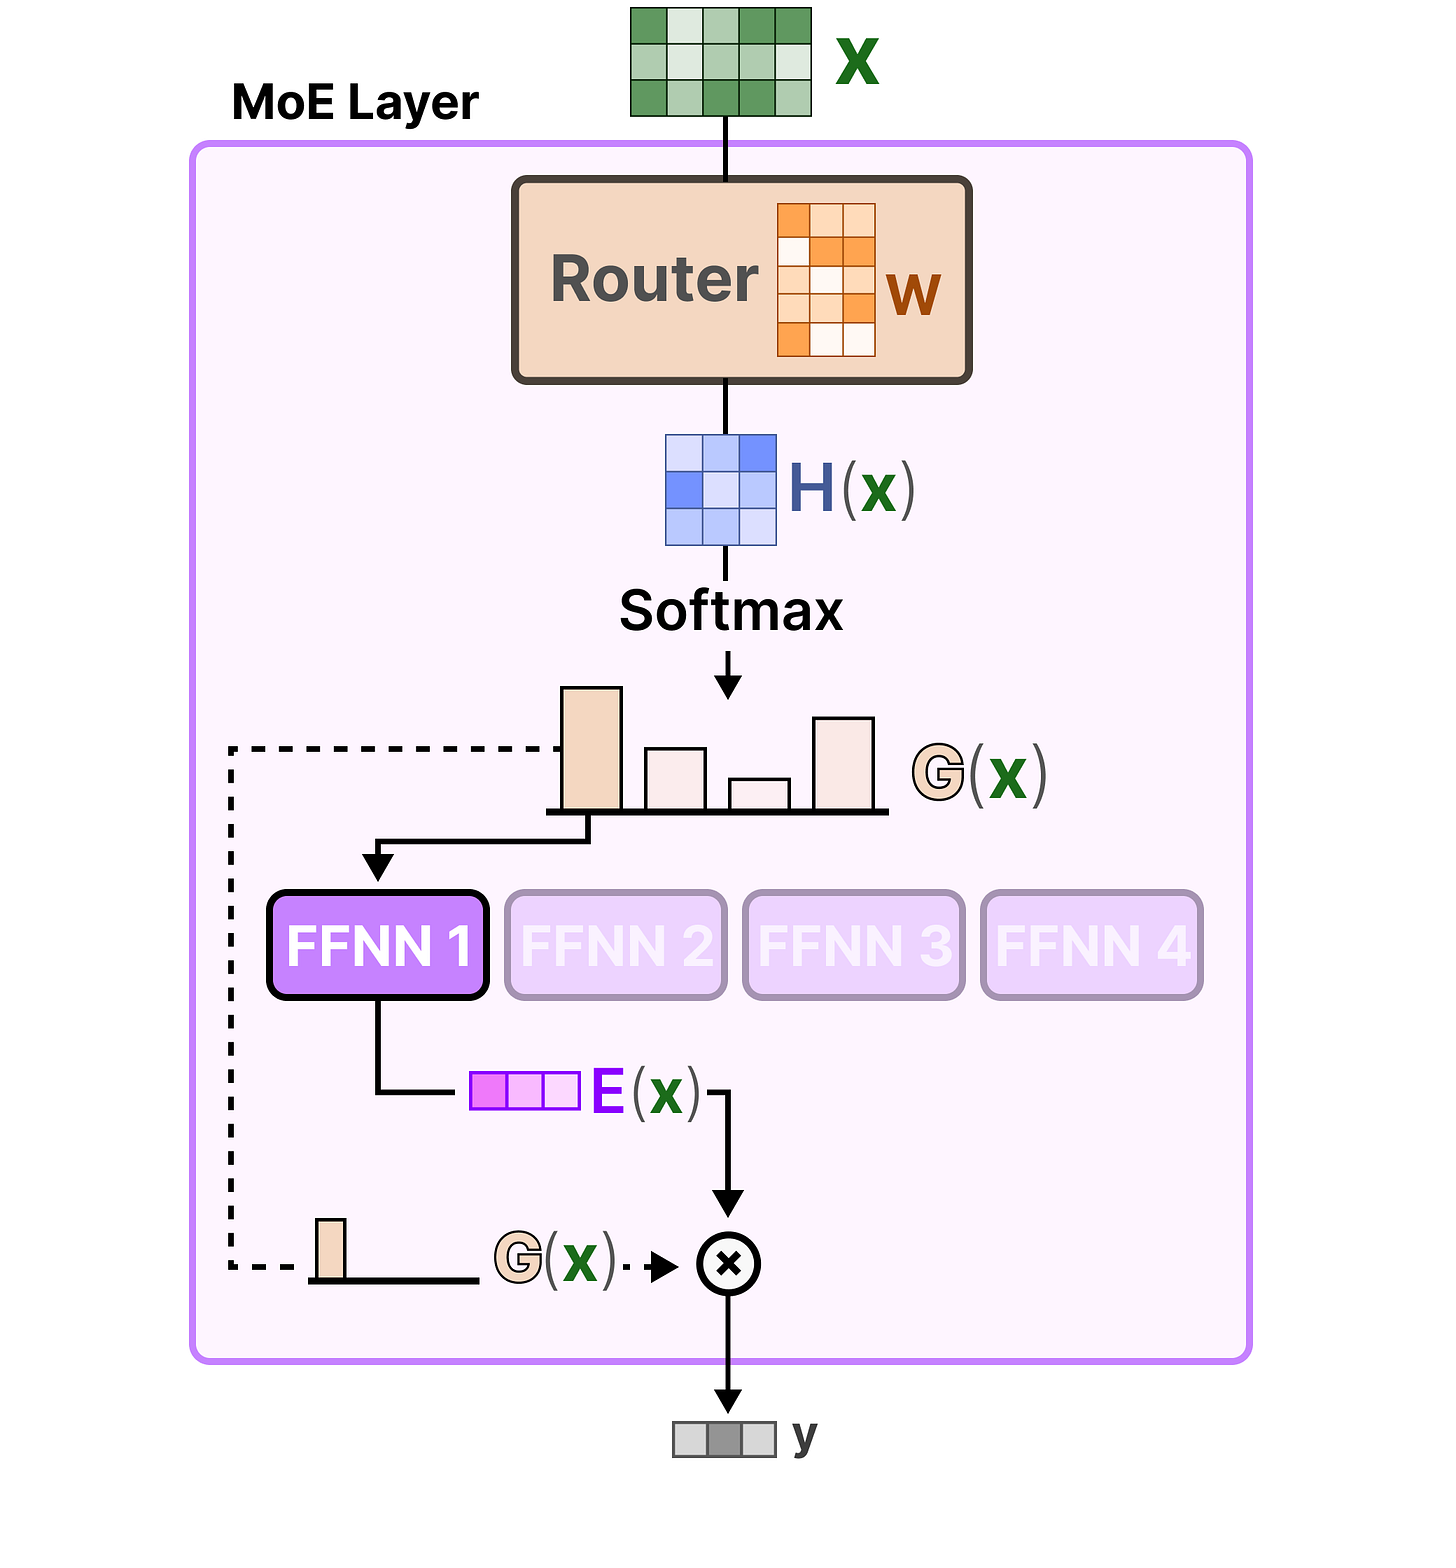
-
负载均衡问题
- 过于简单的路由网络往往会导致路由器选择同一个专家,不仅选定专家的分布会不均衡,而且有些专家几乎不会得到任何训练,而这会在训练和推理阶段都引发问题
- 即尽管较大的 batch size 通常有助于提升训练效率,但在 MoE 中,token 在专家之间的动态路由会导致有效 batch size 的不均匀分布
- 例如,对于包含 10 个 token 的输入批量,可能有 5 个 token 被路由到同一个专家,而剩余 token 分散到多个不同专家
- 这会造成专家负载不平衡,从而降低计算资源的整体利用率
Load Balancing
KeepTopK
-
Shazeer 等人的工作进一步探索了更复杂的门控策略,其中最具代表性的是带噪声的 Top-K 门控(Noisy Top-K Gating),该方法在门控网络中引入可学习的高斯噪声,并仅保留得分最高的 个专家
-
首先,在门控 logits 上加入噪声:
- 其中, 是每个令牌采样的标准高斯噪声, 是另一个可训练的权重矩阵,用于根据输入对噪声进行缩放
- softplus 函数确保噪声缩放因子为正,随后使用这些含噪声的分数进行 top-k 选择
- 而后续用于加权专家输出的概率通常仍从所选专家的原始、非噪声对数几率中得出,以保持输出计算的稳定性,即噪声仅仅用于选择专家
-
示意图如下:
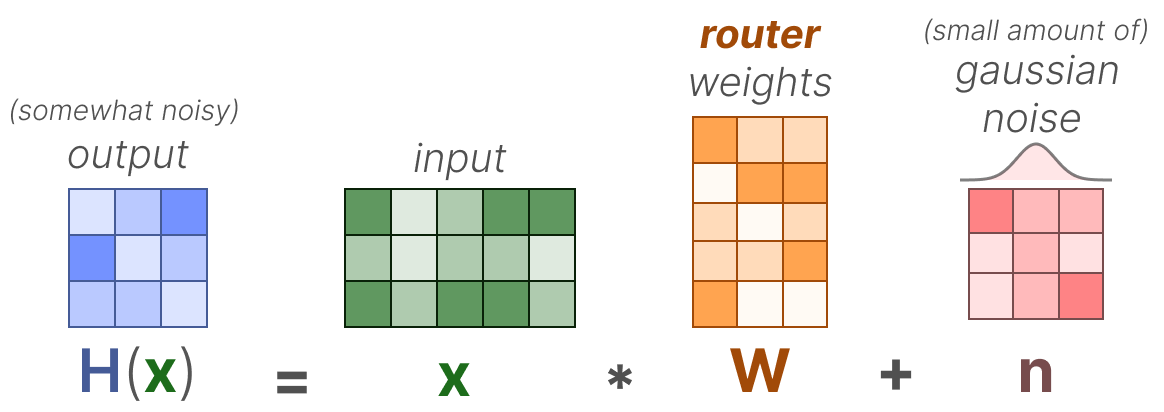
-
随后,仅保留前 个值,其余位置置为 :
-
示意图如下:
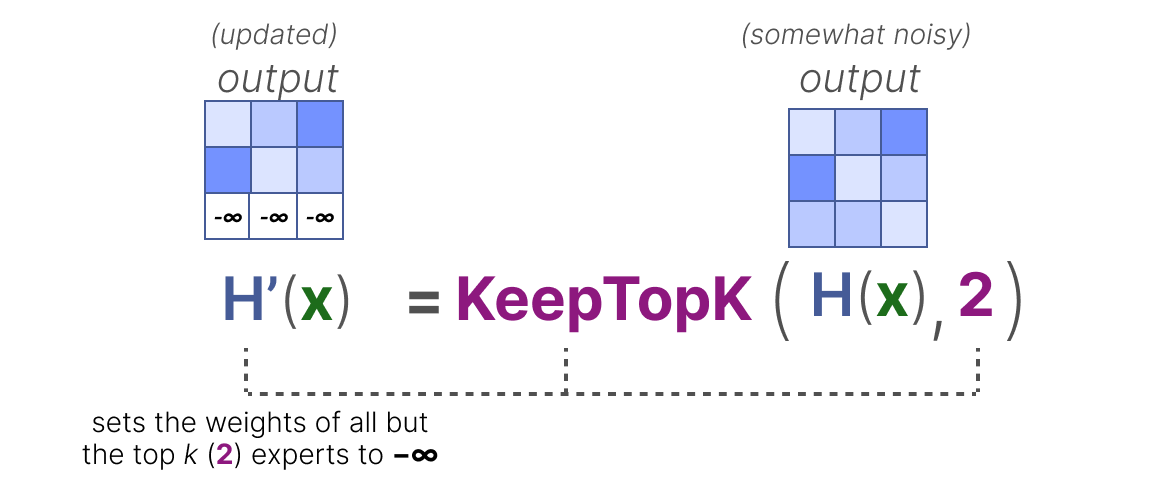
-
最后对结果应用 Softmax,得到最终门控权重:
-
示意图如下:
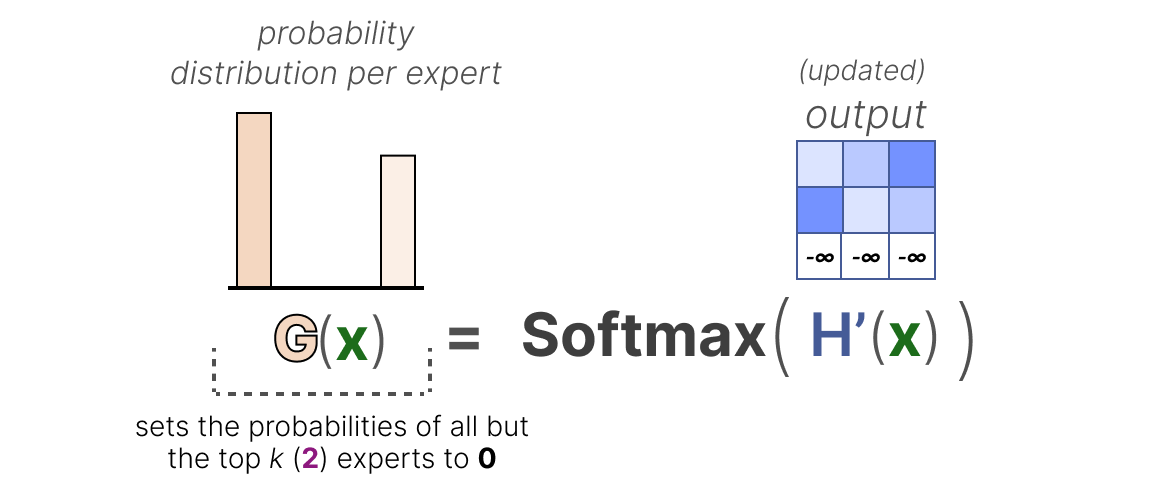
-
-
KeepTopK 策略将每个 token 路由到几个选定的专家,这种方法被称为 token 选择,并允许将给定的 token 发送到一个专家(如 top-1)
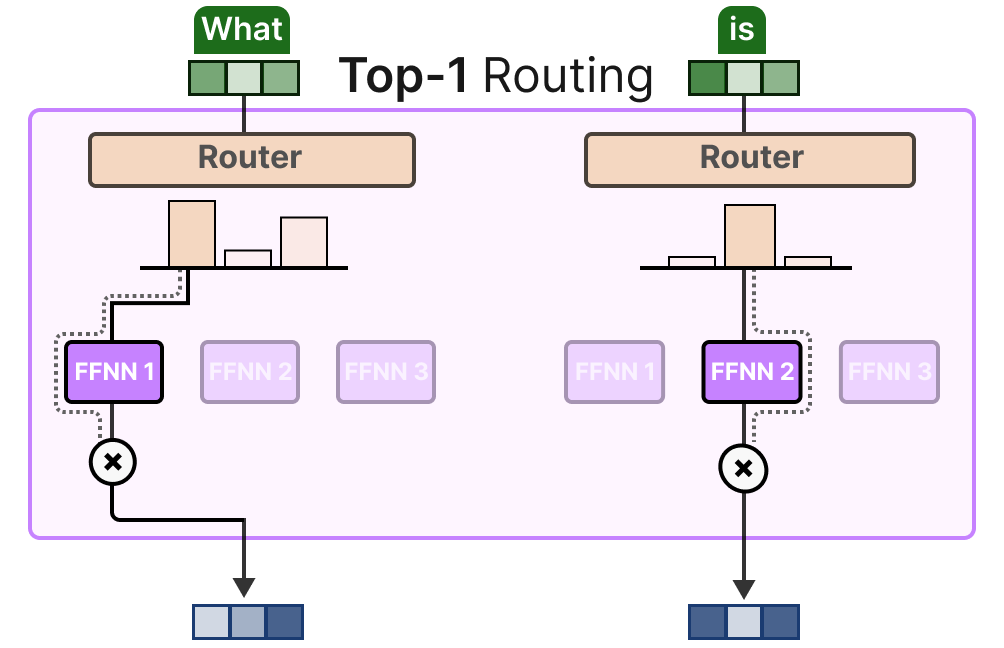
-
也可以发送到多个专家(如 top-2)
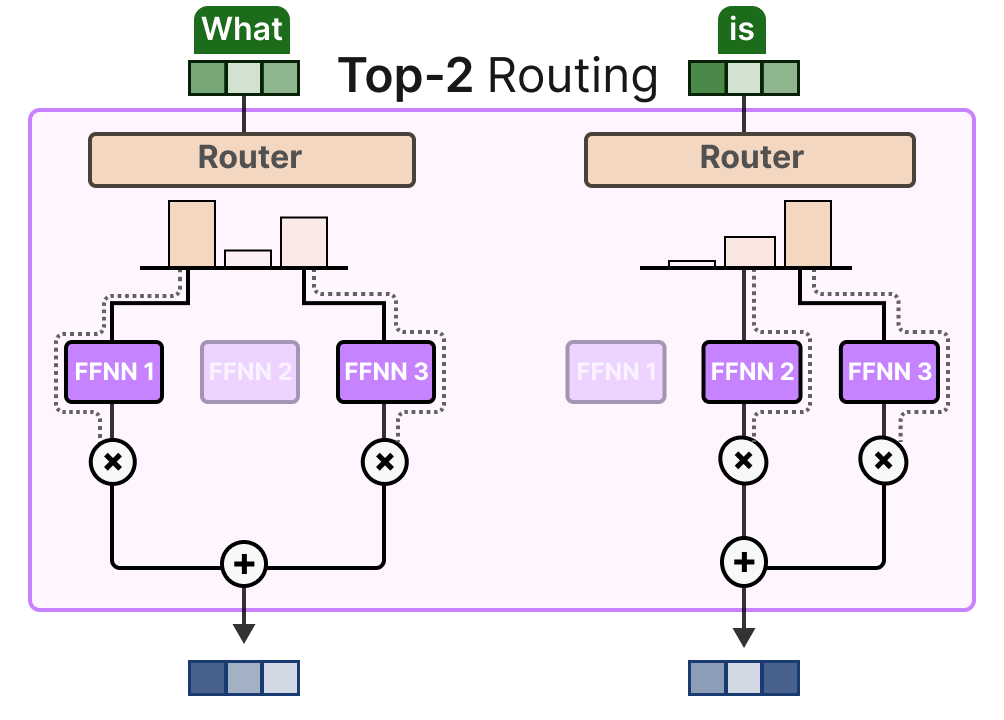
-
KeepTopK 的特性:
- 通过选取较小的 (如 1 或 2),可以在保证模型容量的同时显著提升训练和推理速度
- 若仅始终选择单一最优专家,门控网络难以学习有效的路由策略,因此通常至少需要激活两个专家
- Switch Transformers 对这一现象及其工程影响进行了系统分析
-
在 KeepTopK 路由策略中,引入噪声的核心目的在于缓解专家负载不均衡,防止少数专家在训练过程中长期占据大部分计算资源
-
在 MoE 训练中,路由网络往往容易出现负载坍塌:大量 token 被持续分配给少数专家,而其余专家几乎得不到训练信号。这不仅导致专家利用率严重失衡,也会降低整体吞吐率与训练效率,削弱 MoE 所期望的容量扩展优势
-
为缓解这一问题,KeepTopK 在执行 top-k 专家选择之前,对路由器输出的门控 logits 注入随机噪声,并在加入噪声后的 logits 上进行 top-k 操作。该机制在 logits 接近的专家之间引入随机扰动,打破确定性的路由决策,使原本处于边缘的专家获得被选中的机会,从而逐步缓解路由偏置
-
从优化角度看,噪声并非用于提升单次路由决策的准确性,而是一种探索机制
-
在训练初期和中期,较高幅度的噪声能够提升路由选择的多样性,避免 “冷启动” 问题,使所有专家都能接收到足够的 token 并获得有效梯度
-
随着训练的推进,噪声强度通常会逐步衰减,路由决策从探索阶段过渡到利用阶段,此时,路由器可以基于已经形成的专家专业化结构,做出更加稳定和确定的选择
-
从动态系统的角度看,噪声的引入有助于打破早期的确定性反馈循环,防止专家仅因初始化或微小的早期优势而持续占据主导地位,使专家分工能够在更公平的条件下逐步形成
-
Auxiliary Loss
-
KeepTopK 中的噪声
-
噪声的作用本质是在 logits 接近的专家之间打破确定性排序,给 “边缘专家” 一个被偶然选中的机会
-
噪声提供的是一种局部层面、样本级别的探索机制,作用于单个 token 的路由决策
-
噪声(如 Gaussian)在期望上是零均值的,如果某个专家在平均意义上 logit 明显更大,那么即使加噪声,它仍然会在大多数样本中胜出
-
-
但负载不均衡不是一个局部现象,而是一个跨 token、跨 batch、跨 step 的统计问题:
- 专家 在一个训练窗口中接收的 token 数
- 是否接近均匀分布
- 是否超过容量、或长期低于容量
-
为缓解这一现象,MoE 模型通常引入辅助损失(auxiliary loss)
- 又称为负载均衡损耗(load balancing loss),用于鼓励各个专家在整体上具有相近的重要性
- 该损失项通过约束路由分布,使每个专家接收到的大致训练样本数量保持均衡,从而改善负载分配与训练稳定性
- 在 transformers 库的实现中,可以通过
aux_loss参数调节上述辅助损失项
-
该损耗的第一个组成部分是指定专家对整个批次中每个 token 的路由值的和,这个结果表示每个专家的重要性分数,该分数表示无论输入如何,某个特定专家被选中的可能性
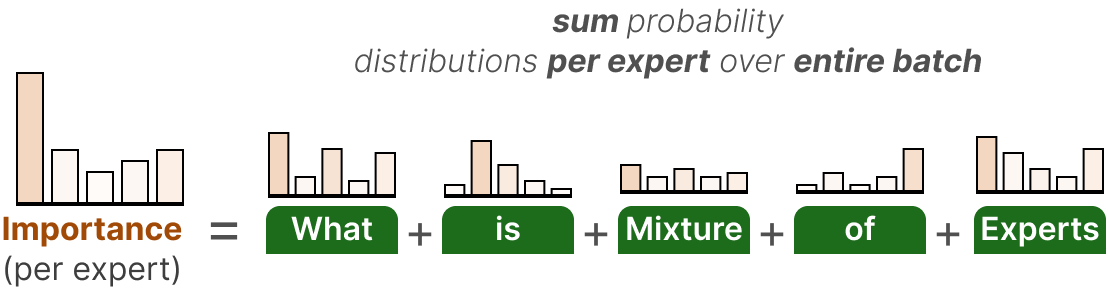
-
然后利用重要性分数来计算 coefficient variation(CV),衡量专家重要性差异
-
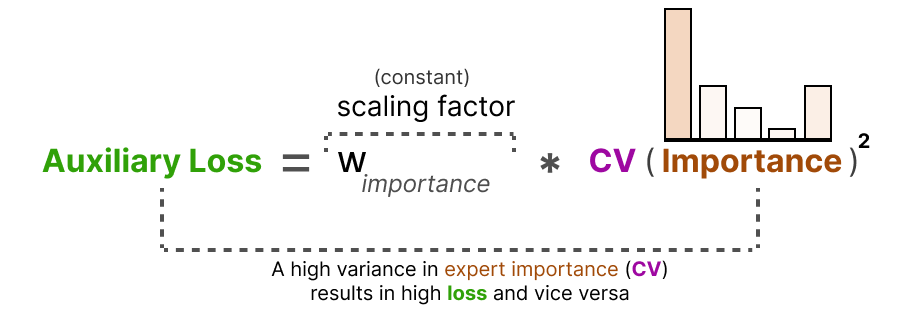
如果重要性分数存在很大差异,那么 CV 将会很高
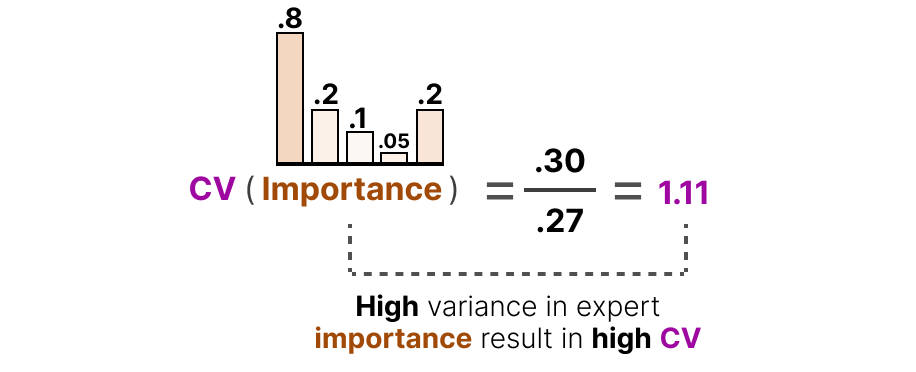
-
如果重要性分数差异较小,那么 CV 较低,也正是我们所希望得到的
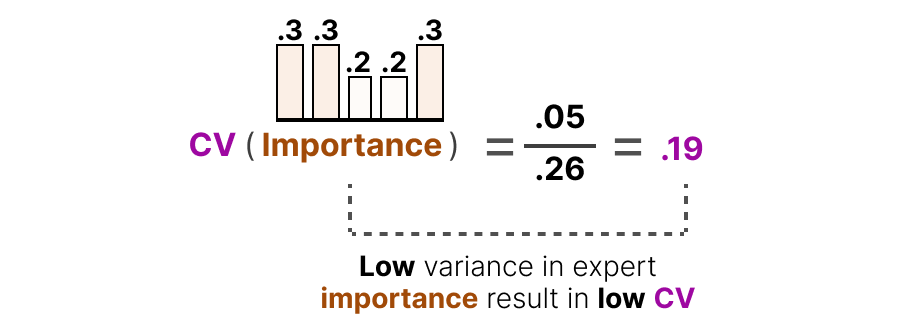
-
利用这个 CV 值,可以在训练过程中更新辅助损失,使其尽可能降低 CV,从而给予每个专家同等的重要性
-
辅助损失被作为一个单独的损失项添加进损失函数中,以在训练过程中进行优化
-
CV 为什么能约束负载均衡
-
设第 个专家的负载为 ,均值为
-
采用 作为辅助损失:
-
对 求偏导,注意到 ,但
-
因此均值项对一阶梯度的贡献相互抵消,得到
-
去掉正的常数因子,方向上等价于
-
由于
-
梯度继续传到 router logit ,其方向保持一致:
- 若 :
- 若 :
-
Expert Capacity
-
Auxiliary Loss 解决的是 “平均负载”,是一种长期、统计意义上的均衡机制
-
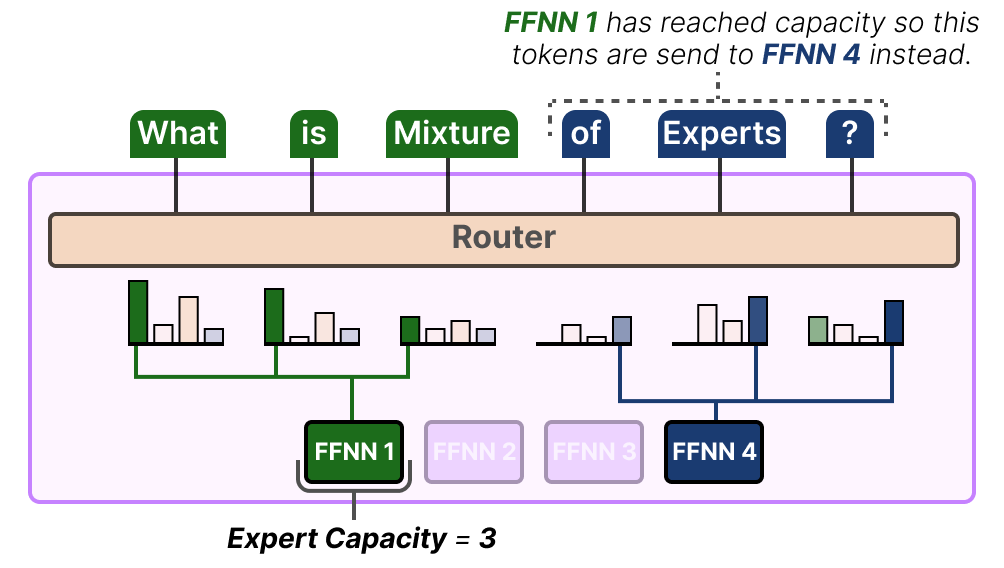
而专家容量(Expert Capacity)作用在前向路由阶段中,规定了每个专家在一个 batch 中最多接收的 token 数
-
其通过硬截断来防止某个专家在单个 step 内被压爆,限制最坏情况的显存和计算量
-
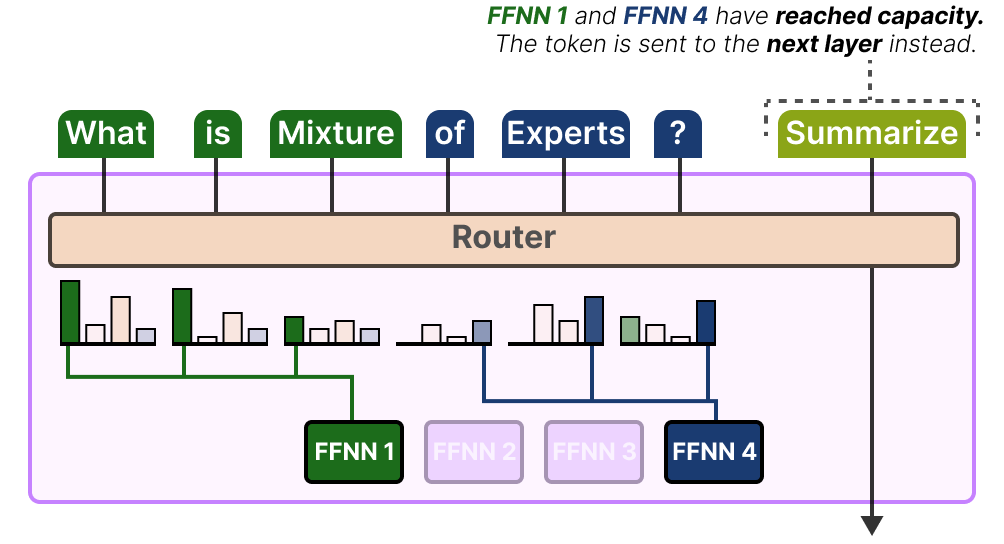
当一个专家达到容量时,多余的 token 将被发送给下一个专家:
-
token 溢出:如果两位专家都已达到其容量,token 将不会被任何专家处理,而是被发送到下一层
参数对比
-
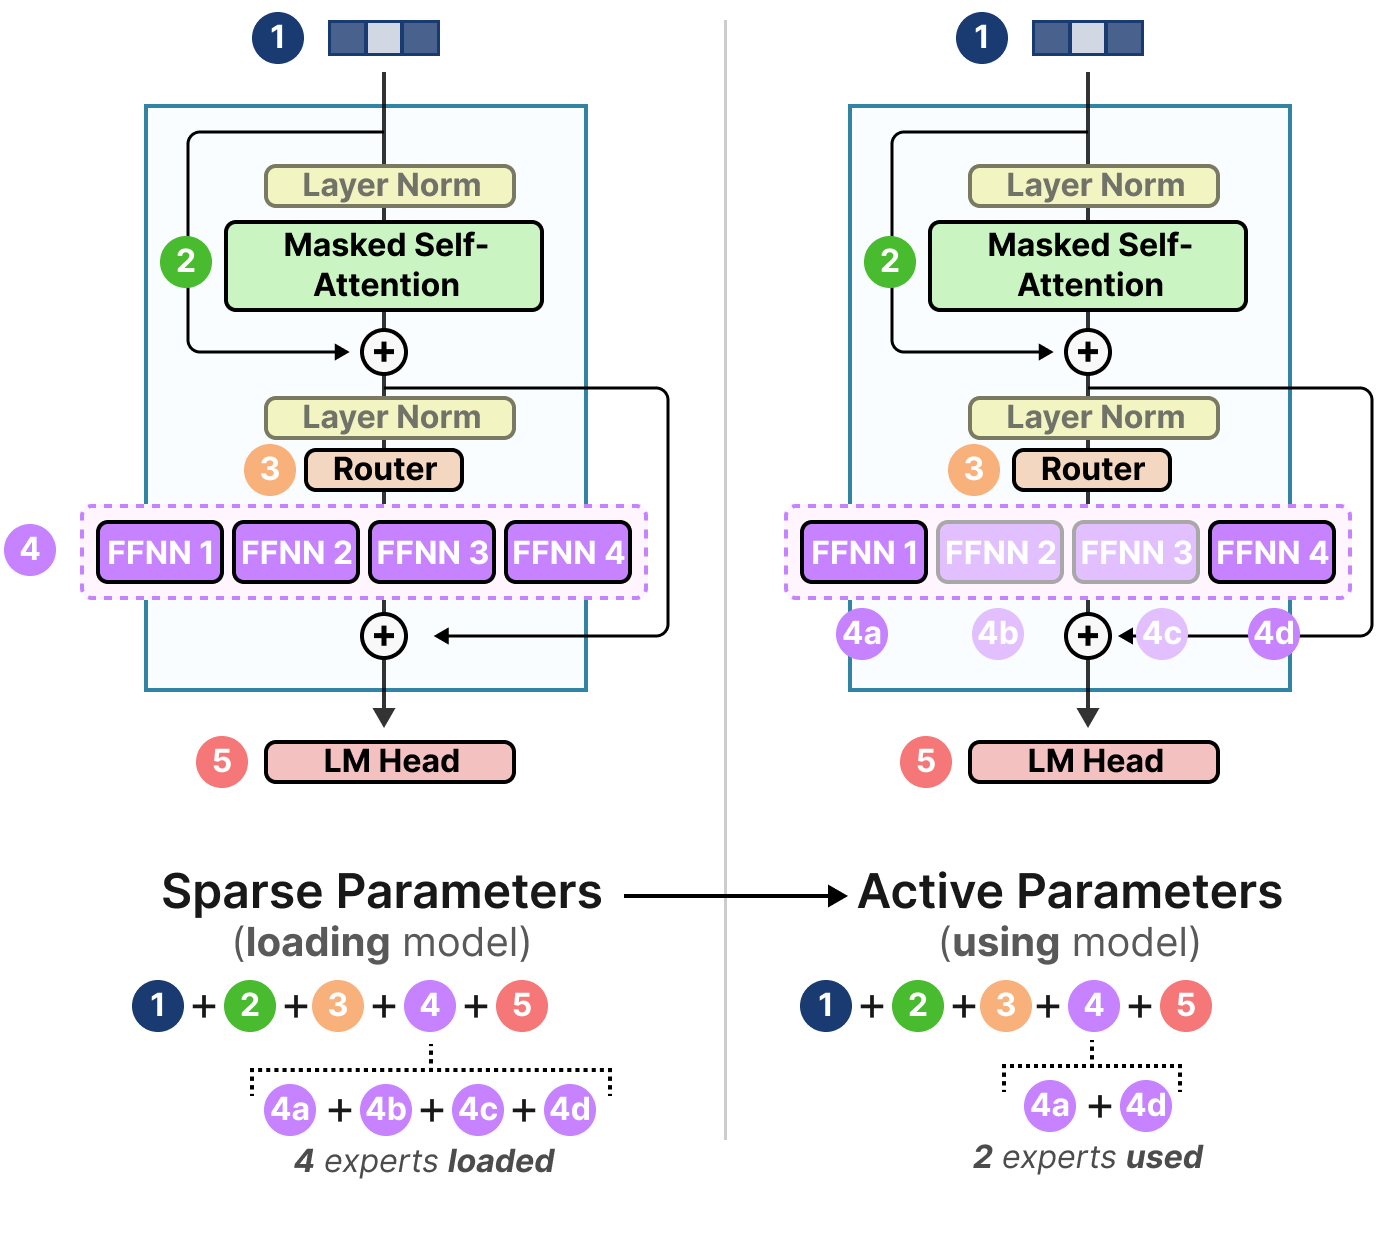
尽管 MoE 模型推理时需要加载更多参数(稀疏参数),但实际激活的参数更少,因为在推理过程中只使用部分专家(活跃参数)
-
在推理时,仍然需要将整个模型(包括所有专家)加载到设备上(稀疏参数),但在进行推理时,只需要使用其中的一个子集(激活参数)
-
混合专家模型需要更多的显存来加载所有专家,但在推理过程中运行速度更快
-
Mixtral 8x7B 的模型参数计算
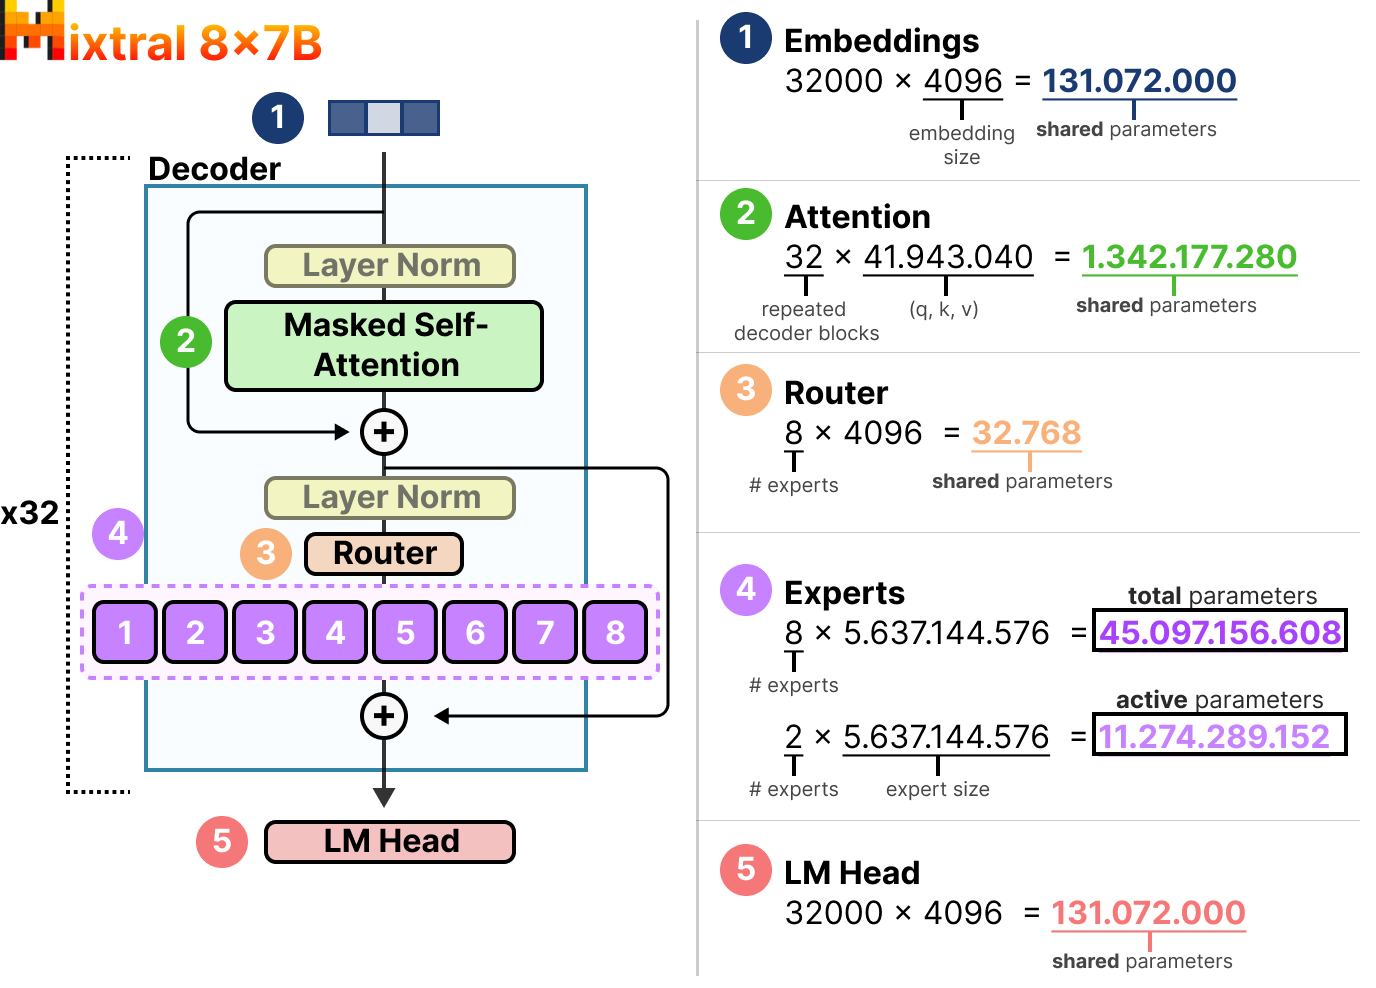
- 单个专家规模为 5.6B(非 7B),共 8 个专家;
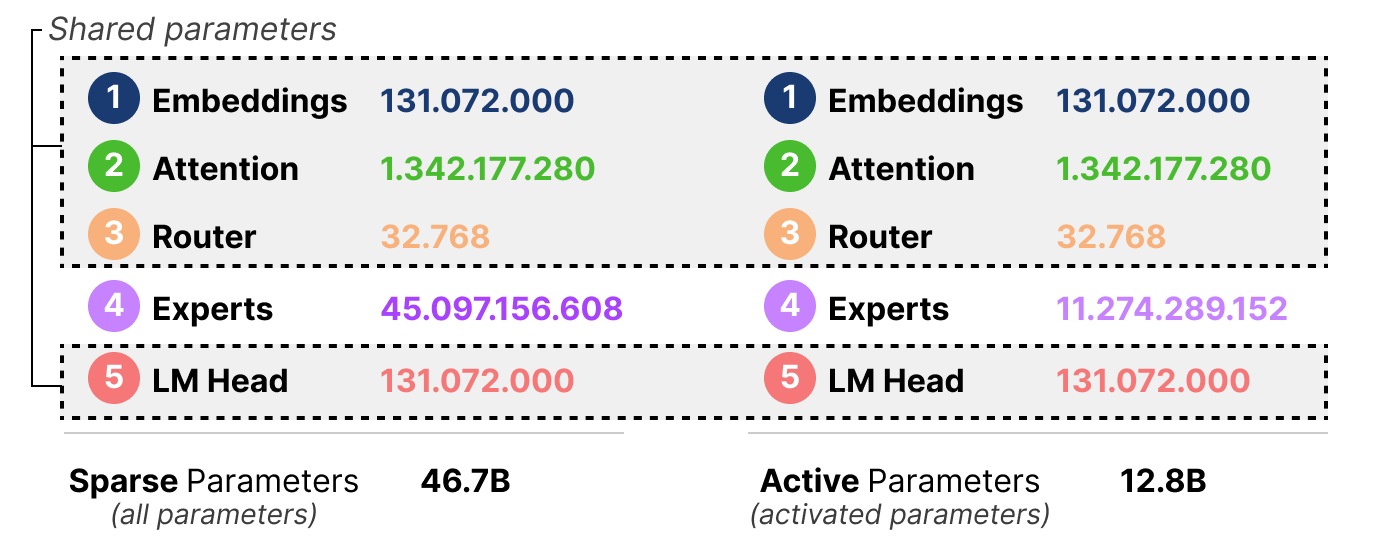
- 加载时需处理 “8×5.6B=46.7B” 参数(含所有共享参数);
- 推理时仅使用 “2×5.6B=12.8B” 参数,体现 “高显存占用但快推理速度” 的特点
-
Mixtral 参数示意
GShard
-
以往对 Transformer 的研究表明,模型性能通常会随着参数规模的增加而持续提升
-
基于这一经验,Google 提出了 GShard,尝试将 Transformer 的参数量扩展到 6000 亿以上,从而探索超大规模模型的可行性与效率边界
-
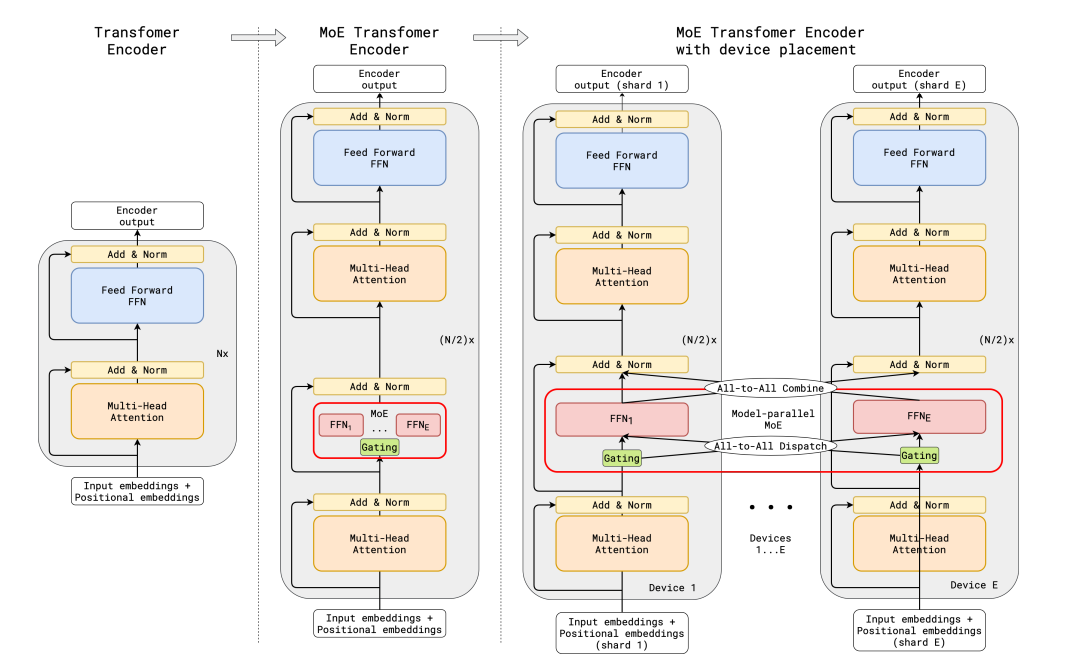
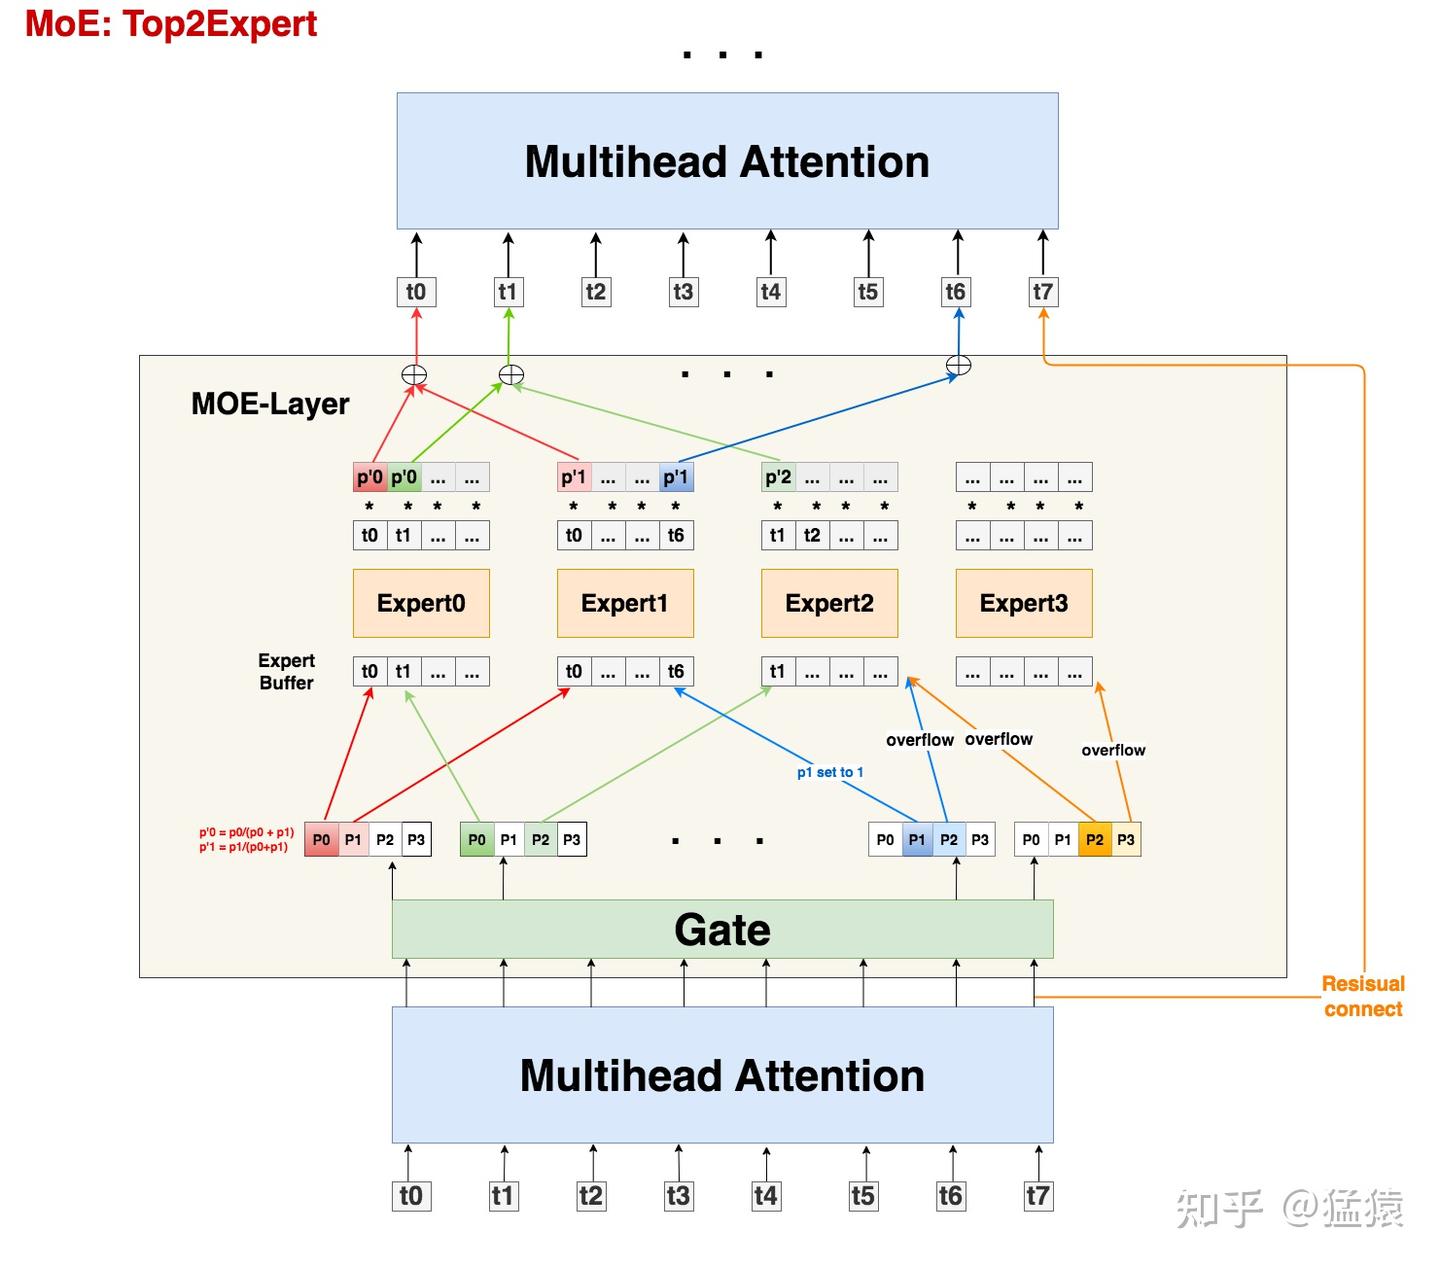
GShard 将 Encoder 和 Decoder 中的每一个前馈神经网络(FFN)层,统一替换为采用 Top-2 门控机制的 MoE 层
-
上图展示的是 Encoder 侧的整体结构,这种设计在大规模分布式环境下尤为高效:
- 当模型扩展到多张 GPU 或多台设备时,MoE 层中的专家参数在不同设备之间进行分片与共享
- 其余非 MoE 层(如注意力层、嵌入层等)则在每个设备上完整复制
- 这种划分方式在保证模型容量的同时,有效控制了通信与计算开销
-
假设输入维度为 [B,S,H],那么总的 token 数量就是 B×S
-
路由网络
- 一个线性层 + softmax,即
- 维度大小为 [H,E],当输入数据 [B,S,H] 经过路由网络后,得到 prob 数据 [B,S,E],含义是每个 token 对应 E 个专家的分数(概率)
- 基于此,进行 Top-K 选择,输出 scores 和 indices,维度均为 [B,S,K]
-
为了在超大规模训练中维持负载均衡与训练稳定性,GShard 在引入前文所述的辅助损失之外,还对 MoE 的路由与容量机制进行了两个关键改进:
- 专家容量(Expert Capacity)
- 为每个专家设置一个容量上限,用于限制其在一次前向计算中最多可处理的 token 数
- 当一个 token 被分配到的两个专家均已达到容量上限时,该 token 会发生溢出
- 溢出的 token 通常通过残差连接直接传递到下一层,在部分实现中也可能被直接丢弃
- 随机路由(Random Routing)
- 在 Top-2 路由设置中,第一个专家始终选择门控得分最高的专家
- 第二个专家不再固定为次高得分,而是按照门控权重比例进行随机采样
- 这种方式可以缓解专家负载过度集中在少数专家上的问题,从而提升整体训练效率
- 专家容量(Expert Capacity)
-
其他细节
-
Zero Padding
- 尽管前述优化手段能够缓解 MoE 模型中专家负载不均的问题,但无法从根本上彻底解决这一痛点 —— 实际场景中仍会出现部分专家(Expert)的缓存区(Expert buffer)未能被充分利用、存在空闲空间的情况
- 针对这一问题,最直接且高效的解决方案是零填充(Zero padding):在各专家缓存区未被填满的空闲位置处,填充零向量(0 向量)。具体来说,经过零填充后,所有专家接收的输入数据会被统一规整为固定维度
(E, C, M)(其中E为专家总数,C代表每个专家的容量上限(capacity),M为单条输入数据的特征维度) - 这种处理方式的核心优势在于:强制统一了所有专家待处理输入数据的维度,不仅规避了因各专家输入维度不一致导致的计算逻辑混乱,还能显著优化硬件层面的后续操作(例如多卡间的数据通信负载均衡、并行计算调度等),提升整体运行效率
-
Drop tokens
- 在 MoE 模型的运行过程中,当分配给某一专家的 token 数量超过其预设容量(capacity)时,会触发溢出(overflow) 现象 —— 此时并非所有 token 都能被该专家正常处理,未被处理的 token 会被直接舍弃,这一操作被称为丢弃 token(drop tokens)
- 若被丢弃的 token 数量过多,会造成显著的信息损失(这些 token 未经过任何专家的特征解析,相当于模型丢失了这部分输入信息)
- 虽然可以通过调大专家的容量上限来缓解 token 丢弃问题,但容量设置过大会加剧零填充(Zero padding) 的负面影响:更多的空闲缓存区需要填充 0 向量,这会显著增加输入矩阵的稀疏性,不仅浪费计算资源,还会降低硬件层面的计算效率
-
-
伪代码实现
# -------------------------------------------------------------------------------------
# 1.通过gate,计算每个token去到每个expert的概率
#
# 【input】:Attention层输出的一整个batch的token,其尺寸为(seq_len, batch_size, M),
#             其中M表示token_embedding
# 【reshaped_input】:由input做reshape而来,尺寸为(S, M), 其中S = seq_len * batch_size
# 【Wg】: gate的权重,尺寸为(M, E),其中E表示MoE-layer层的专家总数
# 【gates】: 每个token去到每个expert的概率,尺寸为(S, E)
# -------------------------------------------------------------------------------------
M = input.shape[-1]
reshape_input = input.reshape(-1, M)

gates = softmax(enisum("SM, ME -> SE"), reshape_input, Wg)

# -------------------------------------------------------------------------------------
# 2. 确定每个token最终要去的top2Expert,并返回对应的weight和mask
#
# 【combine_weights】:尺寸为(S, E, C),其中C表示capacity(Expert buffer)。
#                     表示对每个token(S)而言,它对每个专家(E)的weight,而这个weight按照
#                     该token在buffer中的位置(C)存放,不是目标位置的地方则用0填充
#                     例如图中token1,它将被发送到expert0和expert2,且它在expert0的buffer中排在
#                     1号位置,在expert2中排在0号位置,那么token1的combine_weights就是:
#                     [[0., p0, 0., 0.],
#                     [0. , 0.,  0., 0.],
#                     [p2, 0.,  0., 0.],
#                     [0.,  0.,  0., 0.]]
#                     最后再复习一下weight和gates所表示的prob的区别:前者是在后者基础上,
#                     做了random + normalize,确定最终的top2Expert后返回的对应结果
#
# 【dispatch_mask】:  尺寸为(S,E,C),它等于combine_weights.bool(), 也就是对combine_weights
#                     为0的地方设为False,为1的地方设为True。
#                     dispatch_mask后续将被用在zero padding上
# -------------------------------------------------------------------------------------
# (S, E, C)      (S, E, C)
combine_weights, dispatch_mask = Top2Gating(gates)


# -------------------------------------------------------------------------------------
# 3. 将输入数据按照expert的顺序排好,为下一步送去expert计算做准备(很重要)
#
# 【dispatch_mask】:尺寸为(S, E, C),定义参见2
# 【reshape_input】:尺寸为(S, M),定义参见1
# 【dispatched_expert_input】:本步的输出结果,表示按专家排序好的输入数据,尺寸为(E, C, M)
#  这个结果表示,每个专家(E)的buffer(C)下要处理的token_embedding(M),
#  例如dispatched_expert_input[0]就表示expert0 buffer中的情况
#  注意:
#  (1)每个专家buffer中的token是按顺序排列好的,
#       回到图中的例子,expert0 buffer下0号位置排的是token0,
#       3号位置排的是token6,以此类推。dispatch_mask就起到了维护这种顺序的作用
#  (2)当对应专家接收的token数不足buffer长度C时,不足的地方用0向量填充。
# -------------------------------------------------------------------------------------
dispatched_expert_input = einsum("SEC, SM -> ECM", dispatched_mask, reshape_input)

# -------------------------------------------------------------------------------------
# 4. 将排序好的input送入expert进行计算。
#    同正常的FFN层一样,每个expert也由2个线形层Wi, Wo组成
# 【dispatched_expert_input】:按专家顺序和专家buffer中的token顺序排好的输入数据,
#                             尺寸为(E, C, M),具体定义见3
# 【Wi】:experts的Wi层,尺寸为(E,M, H),
# 【Wo】:experts的Wo层,尺寸为(E, H, M)
# 【expert_outputs】:experts的输出结果,不含加权处理,尺寸为(E, C, M)
# -------------------------------------------------------------------------------------
h = enisum("ECM, EMH -> ECH", dispatched_expert_input, Wi)
h = relu(h)
expert_outputs = enisum("ECH, EHM -> ECM", h, Wo)

# -------------------------------------------------------------------------------------
# 5. 最后,进行加权计算,得到最终MoE-layer层的输出
# -------------------------------------------------------------------------------------
outputs = enisum("SEC, ECM -> SM", combine_weights, expert_outputs)
outputs_reshape = outputs.reshape(input.shape) # 从(S, M)变成(seq_len, batch_size, M)
Switch Transformers
- Switch Transformers 是首批基于 Transformer 的 MoE 模型之一,它解决了 MoE 的训练不稳定性问题(如负载均衡),并简化了大部分架构和训练流程,同时提高了训练的稳定性
-
该工作同时在 Hugging Face 上发布了一个 1.6 万亿参数的 MoE,其中包含 2048 个专家,展示了该架构在极端规模下的可行性
-
模型架构
-
主要目标:在保持 T5 任务范式(如微调、多任务)的前提下,通过 MoE 提升参数规模与效率
-
Switching Layer:
- 基于 T5 Encoder-Decoder 架构,用 “稀疏 MoE 层” 替代传统 FFN 层
- 采用 “Top-1 路由”,该简化显著降低了门控网络的计算与通信开销,每个专家所需处理的有效 batch size 至少减少一半,在降低系统复杂度的同时,模型质量得以保持
-
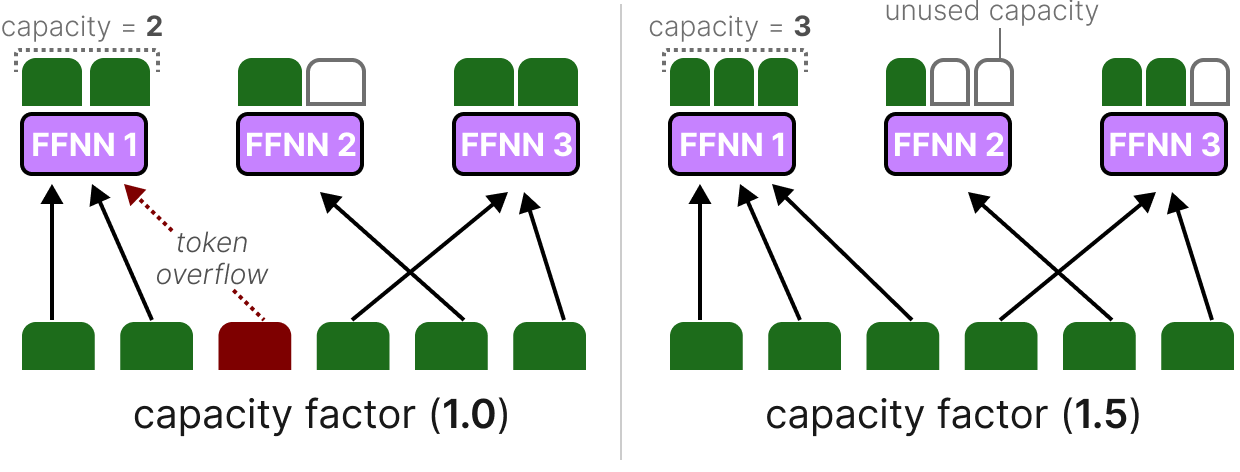
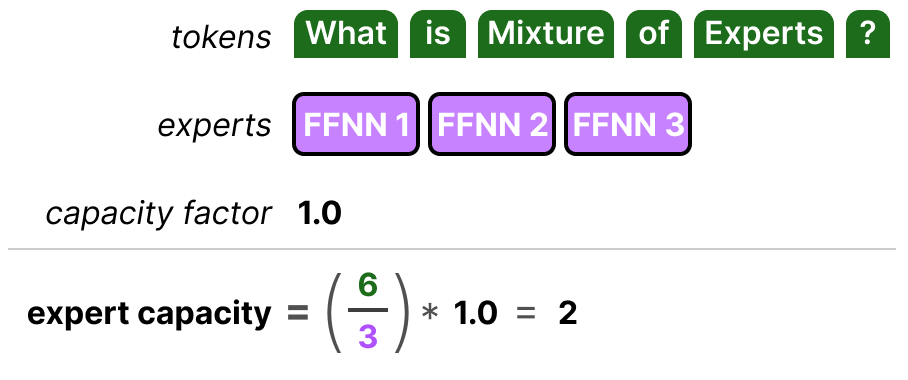
Capacity factor:
- 决定了专家可以处理的 token 数量,如果提高容量因子,每个专家将能够处理更多的 token
- 当容量因子大于 1 时,可以在一定程度上缓解 token 在专家之间分配不均的问题
- 容量因子过大,会显著增加跨设备通信开销,浪费计算资源
- 容量因子过小,模型性能会因 token 溢出而下降,因此需要在性能与效率之间进行权衡
- 实验表明,Switch Transformers 在较低的容量因子(如 1 至 1.25)条件下即可获得良好性能
-
容量因子与 token 溢出
-
容量因子与专家容量的计算关系
-
简化的辅助损失
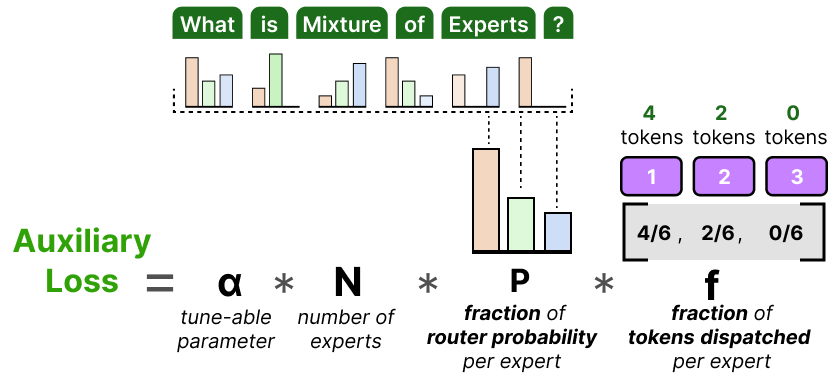
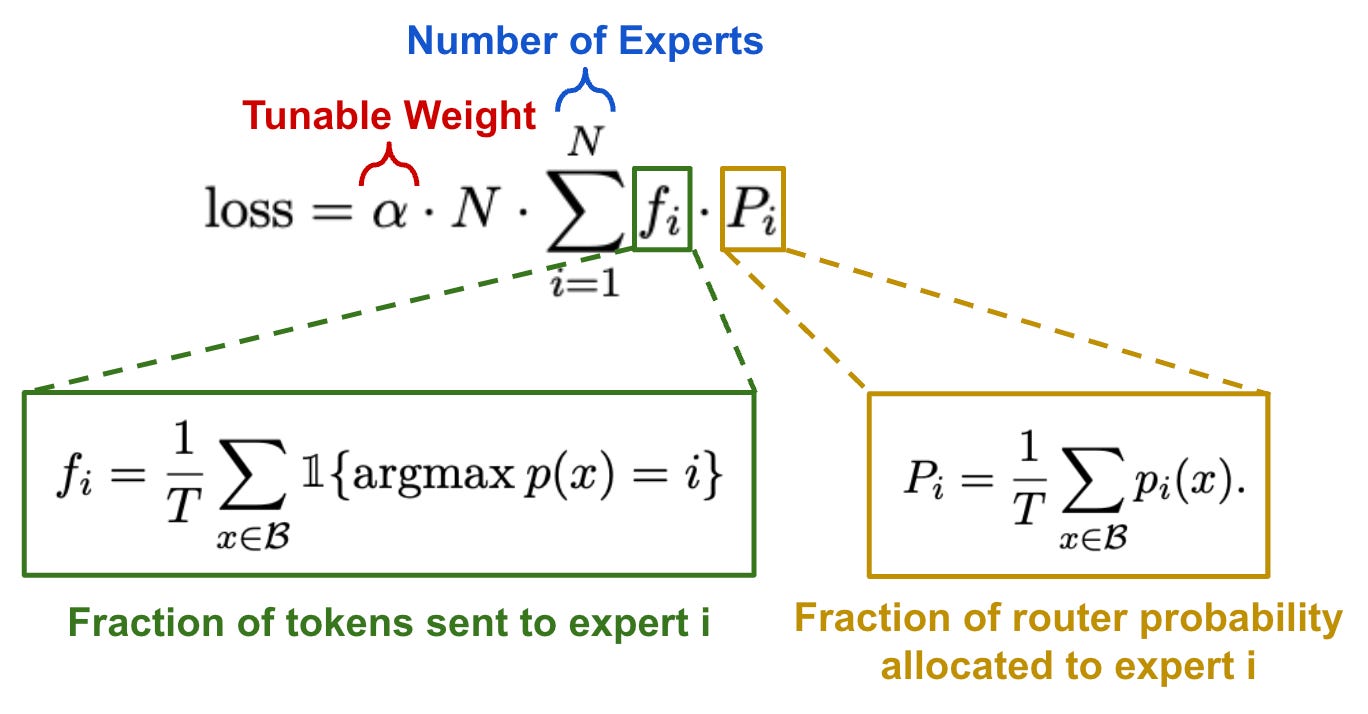
- 无需计算 coefficient variation(CV),而是根据每个专家的路由概率占比来权衡分配的 token 占比
- 由于目标是在 N 个专家之间实现 token 的统一路由,所以希望向量 P 和 f 的值为 1/N
- 会倾向于降低 “高 + 高 ” 的专家,鼓励概率质量向低负载专家扩散
- 超参数 α 用于微调该损失在训练中的重要性,值过高会超过主要的损失函数,值过低则对负载均衡几乎没有作用
-
辅助损失的公式表示
-
混合精度训练策略:
- 专家网络可采用
bfloat16精度训练,而其余计算保持全精度,从而降低计算、通信与激活存储成本 - 实验发现,当专家与门控网络同时使用
bfloat16时,训练过程容易出现不稳定 - 不稳定性主要来源于路由计算中涉及的指数等对数值精度敏感的操作
- 因此,为保证路由决策的稳定性与准确性,门控与路由相关计算仍采用全精度实现
- 专家网络可采用
-
-
模型对比
-
在预训练效率方面,Switch Transformers 相较于 T5-XXL 实现了约 4 倍的训练速度提升
-
与 GShard 类似,Switch Transformers 通过将 Transformer 中的前馈神经网络层替换为 MoE 层,从而显著提升模型容量
-
在结构设计上,Switch Transformers 提出了专门的 Switch Transformer 层,该层在概念上接收多个输入 token,并在一个包含多个专家的 MoE 模块中完成路由与计算
-
GLaM
-
参考论文:GLaM: Efficient Scaling of Language Models with Mixture-of-Experts
-
架构:decoder-only(更接近 GPT 系列)
-
目标:在语言建模质量上达到 GPT-3 水平,但训练能耗只用大约 1/3
-
核心动机:MoE 在每个 token 上只激活少量 expert,有效 FLOPs 显著低于同参数量的 Dense 模型,因此能显著降低训练计算量
-
评测方式:侧重 few-shot /one-shot,而不是下游任务微调(这点和 GPT-3 一致)
-
路由:Top-2 routing,每个 token 同时发给两个 expert,负载更均衡、稳定性更好,但计算量和通信略高
-
使用更大的 capacity factor:capacity factor 控制每个 expert 能接收的 token 上限,对于大 CF,更少 token 被丢弃,更好的质量,更高的计算和显存开销
-
GLaM 把 capacity factor 当成一个训练 / 推理时可调的算力–性能权衡参数
ST-MoE
-
参考论文:ST-MoE: Designing Stable and Transferable Sparse Expert Models
-
Switch-Tranformer 模型存在训练不稳定性,尽管 Switch Transformer 在预训练速度上超过了 Dense 模型,但在 SuperGLUE 等主流基准上进行微调时,其性能落后于之前的最先进模型
-
这些基于 MoE 的语言模型只有在数据集非常大时才能表现良好,否则会因过拟合而导致性能下降
-
ST-MoE 系统性地解决了训练不稳定的问题
- 通过 dropout 或输入抖动(将路由器的 logits 乘以
[0.99, 1.01]范围内的随机值)向模型注入噪声 - 在反向传播过程中,基于固定阈值裁剪梯度或权重更新,以解决梯度爆炸问题
- 通过 dropout 或输入抖动(将路由器的 logits 乘以
-
在稀疏 MoE 中,训练不稳定往往不是来自专家本身,而是来自路由网络:
-
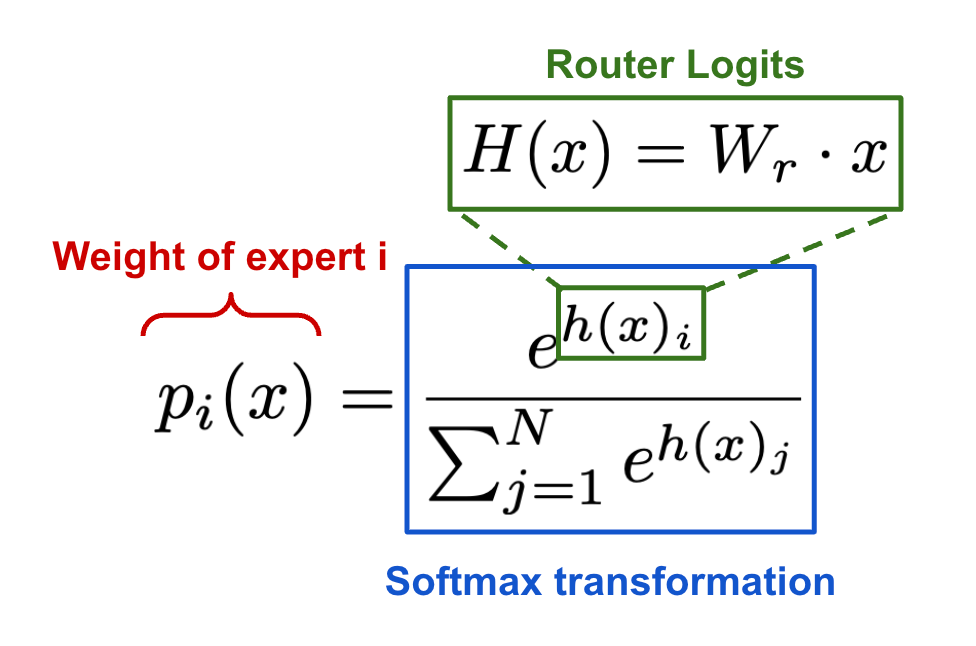
路由网络通常输出 logits,然后通过 softmax 或 Top-K + softmax 决定专家分配
-
随着训练进行,门控网络很容易产生绝对值越来越大的 logits,一旦 logits 的幅值变大,softmax 中的指数项数值范围急剧扩大,不同 expert 之间的概率差异被极度放大,浮点舍入误差和数值不稳定开始主导梯度
-
这会导致几类典型问题:梯度突然爆炸或消失、路由分布高度尖锐,专家塌缩、混合精度下训练直接发散
-
传统的负载均衡损失只能约束「概率分布形态」,但无法限制 logits 的数值尺度本身,而简单地对路由输出到 logits 进行截断可能会损害模型性能
-
-
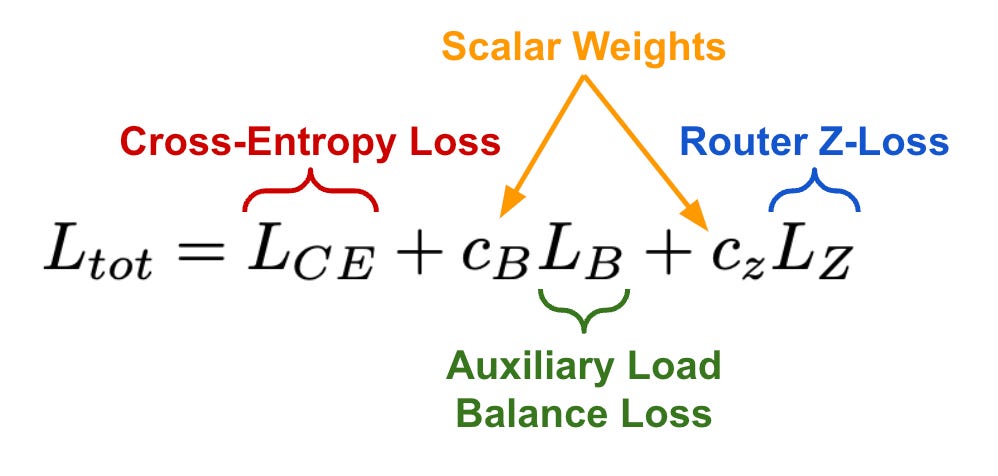
ST-MoE 引入了 Router z-loss,来促使路由输出的值更小 —— 路由网络的正则化技术
-
Router z-loss 的目标非常明确:不去干预 token 被送到哪个专家,而是约束「路由网络输出 logits 的数值规模」,这是一种纯数值稳定性正则项,而非结构性或语义性约束
-
实际上,softmax 对 logits 的相对差异敏感,但对整体平移不敏感,因此 Router z-loss 实际上在做的是抑制 logits 的无意义整体放大,强迫模型通过 “相对差异” 而非 “绝对数值” 来表达路由偏好
-
这使得 softmax 输入始终处于安全数值区间,指数计算不容易溢出或产生严重舍入误差,从而使混合精度下梯度更加平滑
-
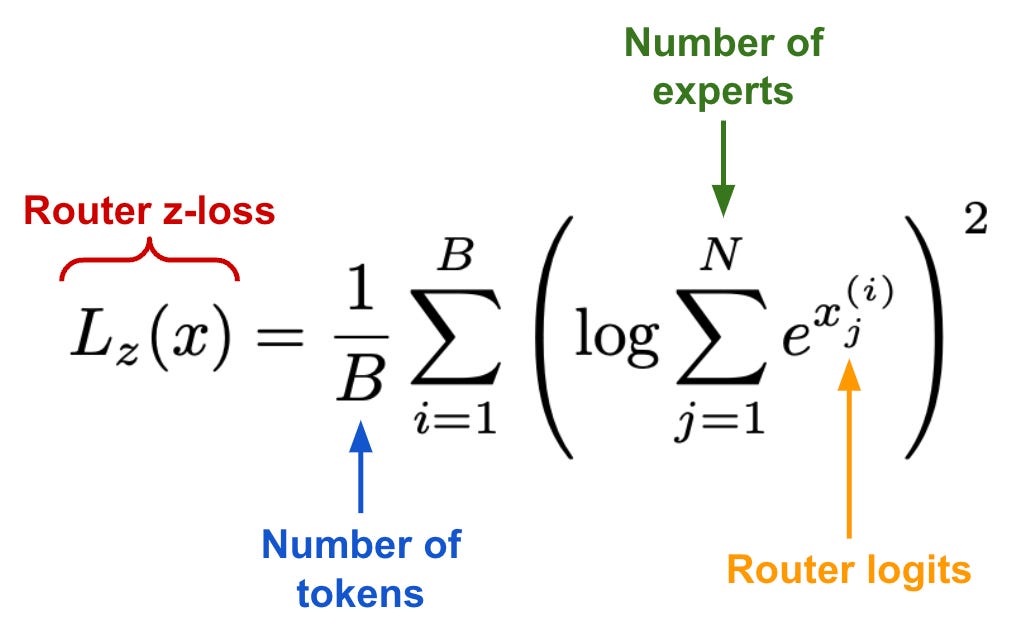
设路由对某个 token 输出的 logits 为 ,其中 是专家数量
-
Router z-loss 定义为:
-
z-loss 常被称为对 log-sum-exp 的平方惩罚,当 logits 整体平移或幅值增大时,该项会迅速变大,平方使得对 “大值” 惩罚更强
-
该损失会被加到总训练损失中:
-
-
对比几种常见方法:
- dropout:稳定,但直接破坏表示能力,在 MoE 中容易导致专家学习不足
- 减小模型容量 / 减少专家数:稳定,但直接降低上限性能
- 强行平滑路由概率:稳定,但限制模型做 “尖锐选择”
- 而 Router z-loss 不限制 Top-1 / Top-2 的选择,不干预专家间的相对竞争关系,只约束一个数值冗余自由度
-
同时,尽管稀疏模型在大规模数据集上表现良好,但对这些模型进行微调可能存在困难
- 稀疏模型在小型 / 大型数据集这两种情况下都比 Dense 模型收敛得更快,然而在数据较少的下游任务中,稀疏模型的验证质量远不如 Dense 模型 —— 换句话说,稀疏模型由于缺乏足够的数据而发生过拟合
- 为了减轻过拟合,ST-MoE 首先尝试只对 MoE 模型的某些部分参数进行微调,但仅微调 MoE 层会导致性能急剧下降,而选择性地微调其他参数组的效果则与微调所有参数相当,这表明在微调阶段,非 MoE 层对任务适配起着关键作用
- 在训练稀疏模型时,采用更强的内部正则化通常是有益的,例如,可以对 Dense 层使用较低的 dropout 率,而对稀疏(MoE)层使用更高的 dropout 率,以平衡模型容量与泛化能力
- ST-MoE 的实验表明,即使关闭辅助损失并导致高达约 11% 的 token 被丢弃,模型质量也未出现明显下降,这表明 token 丢弃本身可能起到了一种正则化作用,有助于缓解过拟合
- 相较于 Dense 模型,稀疏模型通常更适合使用较小的批量大小,同时采用更高的学习率往往可以获得更好的微调效果
-
MoEs Meets Instruction Tuning 对微调的发现
- Flan-MoE 相对于原始 MoE 的性能增益,明显大于 Flan-T5 相对于原始 T5 的提升幅度,表明 MoE 模型可能比 Dense 模型从指令微调中获得更大的收益
- MoE 在多任务学习场景下具有更强的优势
- 保留辅助损失反而有助于抑制过拟合,从而提升整体泛化性能
PR-MoE
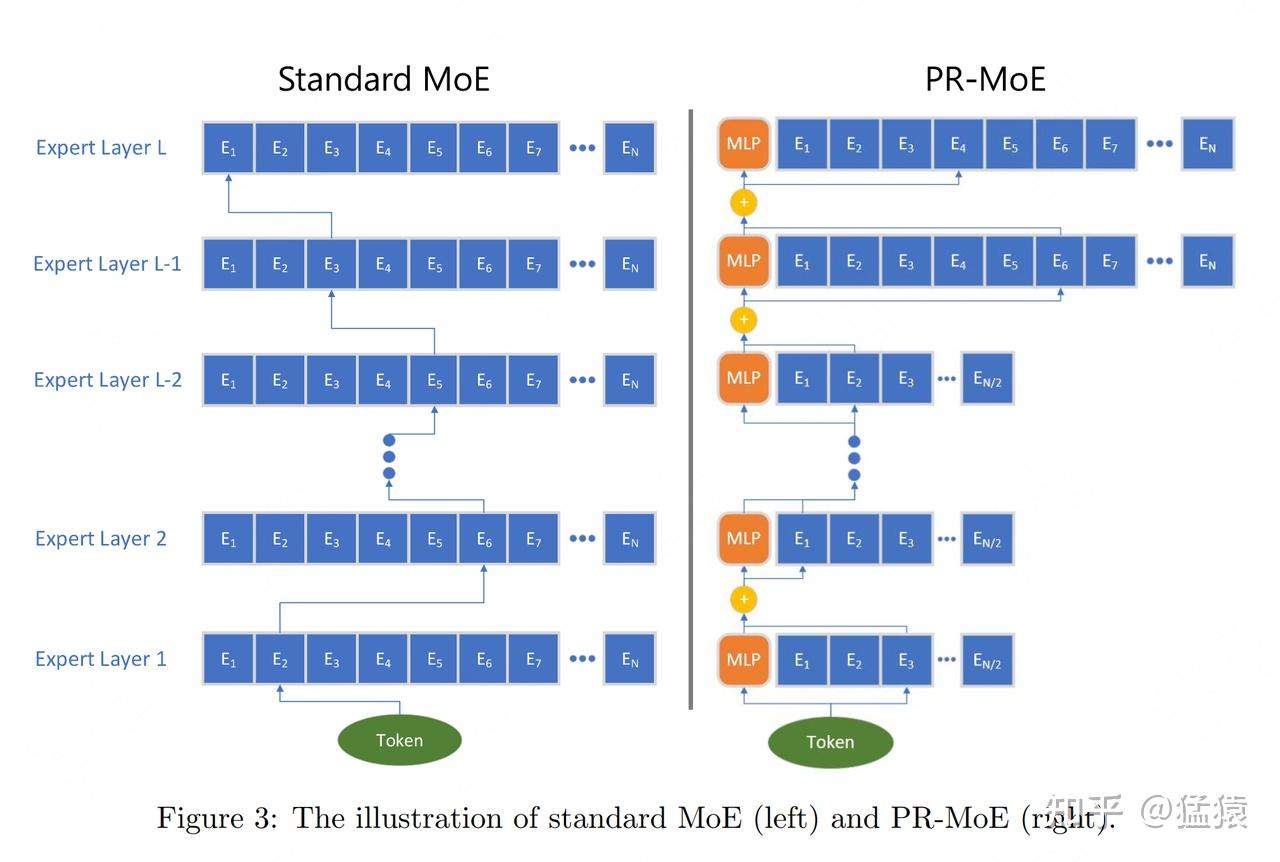
-
DeepSpeed 提出了 PR-MoE 架构,其中的 R 正是该设计的核心
-
PR-MoE 的整体结构包含两部分:
- P(Pyramid):金字塔式专家结构,允许为每一层灵活配置不同数量的专家
- R(Residual MLP):一个固定的残差 MLP 模块,可看作一个全局共享的固定专家,所有 token 都必须经过它进行特征提取
-
在此基础上,再为每个 token 从剩余的动态专家池中选择 Top-1 专家 进行计算
-
DeepSpeed 提出这一设计的动机源于对传统 MoE 路由策略的思考:
- 在常见的 Top-2 Expert 策略中,第二个专家(2nd expert)本质上是对第一个专家(1st expert)的纠偏与补偿 —— 因为第一个专家的选择未必完全准确,需要第二个专家补充缺失的信息
- 既然始终需要一个 “固定负责纠偏” 的分支,那么更高效的做法是直接将这个纠偏分支固化为一个共享的残差 MLP(即 R 模块),只对另一个专家做动态路由选择
- 这就是 PR-MoE 中 R 模块的设计意义
-
在 DeepSpeed 中,可以通过 MoE 模块,并定义每个 Expert 是一个 ParallelMLP 来实现专家并行
class ParallelTransformerLayer(MegatronModule): """A single transformer layer. Transformer layer takes input with size [s, b, h] and returns an output of the same size. """ def __init__(self, config, layer_number, layer_type=LayerType.encoder, self_attn_mask_type=AttnMaskType.padding, drop_path_rate=0., num_experts=1): ...... # ------------------------------------------------------------------- # Attention (non-MoE)部分 # ------------------------------------------------------------------- self.self_attention = ParallelAttention( config, layer_number, attention_type=AttnType.self_attn, attn_mask_type=self_attn_mask_type) ...... # ------------------------------------------------------------------- # MLP(MoE)部分,提供三种MLP定义方式 # 1、SwitchMLP: Megatron设计的MoE架构 # 2、普通MLP:当num_expert=1时,说明该模型不是MoE,只是一个普通的dense MLP层 # 3、deepspeed MoE: deepspeed自定义的MoE架构 # ------------------------------------------------------------------- self.num_experts = num_experts if args.num_experts_switch is not None: self.mlp = SwitchMLP(config) # 1. Megatron-LM's MoE else: if self.num_experts <= 1: # 2. dense, not MoE self.mlp = ParallelMLP(config) else: # 3. DeepSpeed's MoE # enable_expert_tensor_parallelism:表示是否要对专家做tp切分 enable_expert_tensor_parallelism = args.enable_expert_tensor_parallelism self.mlp = MoE(args.hidden_size, # token_embedding # 定义单个专家 ParallelMLP(config, moe=True, enable_expert_tensor_parallelism=enable_expert_tensor_parallelism), num_experts=self.num_experts, # 每层专家总数 ep_size=args.moe_expert_parallel_size, # ep_world_size k=args.topk, # topKEpert中的K,deepspeed使用Gshard模型,一般而言K=2,但也提供了K=1时方法 use_residual=(args.mlp_type == 'residual'), # deepspeed自创的PR-MoE架构中提出的方法 capacity_factor=args.moe_train_capacity_factor, # train过程中expert的capacity factor eval_capacity_factor=args.moe_eval_capacity_factor, # eval过程中expert的capacity factor min_capacity=args.moe_min_capacity, # expert最少需要达到的capacity drop_tokens=args.moe_token_dropping, # 是否需要对tokens做溢出处理 use_tutel=args.use_tutel, # 是否需要使用tutel路由优化方法 enable_expert_tensor_parallelism=enable_expert_tensor_parallelism # 是否需要对专家层做tp切分 ) -
单个 expert 模型架构的入口为
ParallelMLP()class ParallelMLP(MegatronModule): """MLP. MLP will take the input with h hidden state, project it to 4*h hidden dimension, perform nonlinear transformation, and project the state back into h hidden dimension. """ def __init__(self, config, moe=False, enable_expert_tensor_parallelism=False): ...... # -------------------------------------------------------------------- # self.dense_h_to_4h:Wi,尺寸大小(h, 4h/tp_world_size) # -------------------------------------------------------------------- self.dense_h_to_4h = tensor_parallel.ColumnParallelLinear( config.hidden_size, ffn_hidden_size, config=config, init_method=config.init_method, bias=self.add_bias, gather_output=False, skip_bias_add=True, moe=moe, enable_expert_tensor_parallelism=enable_expert_tensor_parallelism ) ...... # -------------------------------------------------------------------- # self.dense_4h_to_h, Wo, 尺寸大小为(4h/tp_world_size, h) # -------------------------------------------------------------------- self.dense_4h_to_h = tensor_parallel.RowParallelLinear( config.ffn_hidden_size, config.hidden_size, config=config, init_method=config.output_layer_init_method, bias=self.add_bias, input_is_parallel=True, moe=moe, enable_expert_tensor_parallelism=enable_expert_tensor_parallelism ) def forward(self, hidden_states): # -------------------------------------------------------------------- # 输入数据过Wi层 # [s, b, 4h/tp_word_size] # -------------------------------------------------------------------- intermediate_parallel, bias_parallel = self.dense_h_to_4h(hidden_states) ...... # -------------------------------------------------------------------- # Wi层输出数据过Wo层 # 在对expert采取tp切分的情况下,这里的输出需要在tp_group内做AllReduce # [s, b, h] # -------------------------------------------------------------------- output, output_bias = self.dense_4h_to_h(intermediate_parallel) return output, output_bias -
这段代码与不启用 MoE 时类似,关键在于对于列切割和行切割的算子中
class ColumnParallelLinear(torch.nn.Module): """Linear layer with column parallelism. ...... """ def __init__(self, input_size, output_size, *, config: ModelParallelConfig, init_method: Callable, bias=True, gather_output=False, stride=1, keep_master_weight_for_test=False, skip_bias_add=False, skip_weight_param_allocation: bool=False, moe=False, enable_expert_tensor_parallelism=False): torch.nn.Module.__init__(self) # Keep input parameters self.input_size = input_size self.output_size = output_size self.gather_output = gather_output # --------------------------------------------------------------- # 判断相关module是否表示expert # 1、如果是moe,但不希望对expert做tp处理,则强制设tp_world_size = 1 # 2、其余情况(非moe,或者是moe且希望对expert做tp处理),则复用non-Moe # 的tp_world_size # --------------------------------------------------------------- if moe and (not enable_expert_tensor_parallelism): world_size = 1 self.is_expert_without_slicing = True else: world_size = get_tensor_model_parallel_world_size() self.is_expert_without_slicing = False self.output_size_per_partition = divide(output_size, world_size) self.skip_bias_add = skip_bias_add self.config = config ...... def forward(self, input_: torch.Tensor, weight: Optional[torch.Tensor] = None): """Forward of ColumnParallelLinear ...... """ ...... # ------------------------------------------------------------------------ # 定义f算子 # 1、如果expert未采用tp切分,则对expert的forward和backward方法不需要做任何修改 # 2、如果expert采用tp切分,则需要对expert的forward和backward方法做修改 # 具体为forward时直接copy input,backward时allreduce梯度 # 可参考下放示意图 # ------------------------------------------------------------------------ if self.async_tensor_model_parallel_allreduce or \ self.sequence_parallel or \ self.is_expert_without_slicing: # non-expert only tensor parallelism input_parallel = input_ else: input_parallel = copy_to_tensor_model_parallel_region(input_) # Matrix multiply. output_parallel = linear_with_grad_accumulation_and_async_allreduce( input=input_parallel, weight=weight, bias=bias, gradient_accumulation_fusion=self.gradient_accumulation_fusion, async_grad_allreduce=self.async_tensor_model_parallel_allreduce, sequence_parallel=self.sequence_parallel ) # ------------------------------------------------------------------------ # 定义g算子 # 同理根据expert是否做了tp切分,决定要不要更改forward和backward方法 # 需要注意,当你对单个expert做tp切分时,不管你的gather_output是True/False, # 单个expert的输出结果一定会在同个tp组内强制做allReduce # ------------------------------------------------------------------------ if self.gather_output and not self.is_expert_without_slicing: # All-gather across the partitions. assert not self.sequence_parallel output = gather_from_tensor_model_parallel_region(output_parallel) else: output = output_parallel output_bias = self.bias if self.skip_bias_add else None return output, output_bias -
单个 Expert 的模型架构复用 ParallelMLP 的基础定义,核心差异在于是否对 Expert 进行 TP(Tensor Parallelism,张量并行)切割,具体规则如下:
- 无 TP 切割场景:无需重写 Expert 的
forward(前向)和backward(反向)方法,直接沿用 ParallelMLP 的原生逻辑即可 - 有 TP 切割场景:需重写
forward和backward方法,切割逻辑与 Megatron 框架中 MLP 层的列切割(Column Parallel) 和行切割(Row Parallel) 完全一致 - TP 切割后的通信规则:数据经过 TP 切割的单个 Expert 计算后,其输出结果必须在同一 TP 通信组(tp_group)内执行 AllReduce 操作,以完成张量并行的结果同步
- 无 TP 切割场景:无需重写 Expert 的
-
MoE 的实现
class MoE(torch.nn.Module): """Initialize an MoE layer. Arguments: - 【hidden_size】 (int): token_embedding - 【expert】 (torch.nn.Module): 单个expert架构,属于ParallMLP类 - 【num_experts】: 每层expert总数 - 【ep_size】 (int, optional): default=1, ep_world_size - 【k】 (int, optional): default=1, topKexpert中的K,只支持K=1或2 - 【capacity_factor】 (float, optional): default=1.0, train步骤的容量因子 - 【eval_capacity_factor】 (float, optional): default=1.0, eval步骤的容量因子 - 【min_capacity】 (int, optional): default=4, 每个专家最小的容量值 - 【use_residual】 (bool, optional): default=False, 用于表示该层是否是一个residual expert层 (https://arxiv.org/abs/2201.05596) layer. - 【noisy_gate_policy】 (str, optional): default=None, noisy gate policy(加噪策略), valid options are 'Jitter', 'RSample' or 'None'. - 【drop_tokens】 (bool, optional): default=True, whether to drop tokens - (setting to False is equivalent to infinite capacity). - 【use_rts】 (bool, optional): default=True, whether to use Random Token Selection. - 【use_tutel】 (bool, optional): default=False, whether to use Tutel optimizations (if installed). - 【enable_expert_tensor_parallelism】 (bool, optional): default=False, 是否对expert做tp切分 """ def __init__(self, hidden_size, expert, num_experts=1, ep_size=1, k=1, capacity_factor=1., eval_capacity_factor=1., min_capacity=4, use_residual=False, noisy_gate_policy: typing.Optional[str] = None, drop_tokens: bool = True, use_rts=True, use_tutel: bool = False, enable_expert_tensor_parallelism: bool = False): super(MoE, self).__init__() self.use_residual = use_residual self.enable_expert_tensor_parallelism = enable_expert_tensor_parallelism assert num_experts % ep_size == 0, f"Number of experts ({num_experts}) should be divisible by expert parallel size ({ep_size})" self.ep_size = ep_size self.expert_group_name = f"ep_size_{self.ep_size}" self.num_experts = num_experts # 单块gpu上需要存放的expert数量 self.num_local_experts = num_experts // self.ep_size log_dist( f'Creating MoE layer with num_experts: {num_experts} | num_local_experts: {self.num_local_experts} | expert_parallel_size: {self.ep_size}', [0]) assert noisy_gate_policy is None or noisy_gate_policy in ['None', 'Jitter', 'RSample'], \ 'Unsupported noisy_gate_policy: ' + noisy_gate_policy # ------------------------------------------------------------------------- # 定义一个MoE层上所有的expert。见下面Experts类定义(很重要) # ------------------------------------------------------------------------- experts = Experts(expert, self.num_local_experts, self.expert_group_name) # ------------------------------------------------------------------------- # 定义MoE层 # ------------------------------------------------------------------------- self.deepspeed_moe = MOELayer(TopKGate(hidden_size, num_experts, k, capacity_factor, eval_capacity_factor, min_capacity, noisy_gate_policy, drop_tokens, use_rts), experts, self.expert_group_name, self.ep_size, self.num_local_experts, use_tutel=use_tutel) if self.use_residual: self.mlp = expert # coefficient is used for weighted sum of the output of expert and mlp self.coefficient = torch.nn.Linear(hidden_size, 2) def set_deepspeed_parallelism(self, use_data_before_expert_parallel_=False): """ ep相关分布式设置。 如前文所说,我们在deepspeed.initialize()中,如果检测到一个module拥有 set_deepspeed_parallelism属性,则我们就对它执行相关的分布式设置操作 """ self._create_process_groups(use_data_before_expert_parallel_=use_data_before_expert_parallel_) def _create_process_groups(self, use_data_before_expert_parallel_=False): """ ep相关分布式设置 """ # ---------------------------------------------------------------------------- # 如果当前还未做ep相关分布式设置,那么就先做设置 # ---------------------------------------------------------------------------- if self.expert_group_name not in groups._get_expert_parallel_group_dict(): print(f"No existing process group found, creating a new group named: {self.expert_group_name}") # ---------------------------------------------------------------------------- # 1、当你没使用Megatron分布式并行,或者你使用了Megatron但又不想对expert组tp切分 # 那么你就按EP + DP的方式设置ep相关group # ---------------------------------------------------------------------------- if (groups.mpu is None) or (not self.enable_expert_tensor_parallelism): # Condition 1 - no groups.mpu means no tensor parallelism # Condition 2 - disabling expert tensor parallelism on purpose groups._create_expert_and_data_parallel( self.ep_size, use_data_before_expert_parallel_=use_data_before_expert_parallel_) # ---------------------------------------------------------------------------- # 2、其余情况则使用EP + DP + TP方式 # ---------------------------------------------------------------------------- else: # expert tensor parallelism is enabled groups._create_expert_data_and_model_parallel( self.ep_size, mpu=groups.mpu, use_data_before_expert_parallel_=use_data_before_expert_parallel_) # ---------------------------------------------------------------------------- # 在做完ep相关分布式设置的情况下,为当前进程所属的MoE层显示设置ep_group # 这样就可以在ep_group内做all2all通讯 # 如果不显示设置ep_group,则默认是对所有gpu卡(world_size)做all2all # ---------------------------------------------------------------------------- self.deepspeed_moe._set_ep_group(groups._get_expert_parallel_group(self.expert_group_name)) def forward(self, hidden_states, used_token=None): """ MoE forward Arguments: hidden_states (Tensor): input to the layer used_token (Tensor, optional): default: None, mask only used tokens Returns: A tuple including output, gate loss, and expert count. * output (Tensor): output of the model * l_aux (Tensor): gate loss value * exp_counts (int): expert count """ output = self.deepspeed_moe(hidden_states, used_token) if self.use_residual: # Residual MoE output_mlp = self.mlp(hidden_states) if type(output_mlp) is tuple: output_mlp = output_mlp[0] # Ignore the bias term for now coef = self.coefficient(hidden_states) coef = torch.nn.functional.softmax(coef, dim=-1) output = output * coef[..., 0:1] + output_mlp * coef[..., 1:] return output, self.deepspeed_moe.l_aux, self.deepspeed_moe.exp_counts class Experts(nn.Module): """ 相关脚本:DeepSpeed/deepspeed/moe/experts.py 定义一个MoE层上所有的Expert """ def __init__(self, expert: nn.Module, num_local_experts: int = 1, expert_group_name: Optional[str] = None) -> None: super(Experts, self).__init__() # ---------------------------------------------------------------------------- # 每块gpu上共num_local_experts个expert # ---------------------------------------------------------------------------- self.deepspeed_experts = nn.ModuleList([copy.deepcopy(expert) for _ in range(num_local_experts)]) self.num_local_experts = num_local_experts # TODO: revisit allreduce for moe.gate... for expert in self.deepspeed_experts: # TODO: Create param groups to handle expert + data case (e.g. param.group = moe_group) for param in expert.parameters(): param.allreduce = False param.group_name = expert_group_name def forward(self, inputs: torch.Tensor) -> torch.Tensor: """ 我们知道,在分发去experts前,每张卡上的输出结果为(E, C, M),其中E=该MoE层专家总数, C = capacity,M = token embedding。 设ep_world_size = G, num_local_experts = e, 则易知E = G * e 对于All2All通讯,你可以理解成对于ep_group内的每张卡,都将数据沿着E维度切成G块后,再进行通讯。 (保证每张卡上的数据块数量 = ep_world_size,这样All2All通讯才不会出错) 因此发送完毕后,每张卡上的数据可以又表示为(G*e, C, M) 进一步在正式把数据喂给这张卡上维护的experts前,我们可以把数据reshape成(G, e, C, M)的形式。 此时如果我们沿着e维度将数据切分为e个chunck,则一个chunk对应一个local_expert,再次实现了token 和local expert间一一对应的关系 """ # ------------------------------------------------------------------- # 将input做切分后,将分块分别喂给该gpu上维护的若干个expert # inputs尺寸:(G, e, C, M), # G = ep_world_size # e = num_local_experts,满足G*e = E,E为该层expert总数 # C = expert capacity, # M = token embedding # chunk_input: 沿着e维度切分inputs,方便各块input喂给该gpu上对应的各个expert # ------------------------------------------------------------------- chunks = inputs.chunk(self.num_local_experts, dim=1) expert_outputs: List[torch.Tensor] = [] for chunk, expert in zip(chunks, self.deepspeed_experts): # out尺寸:(G, C, M) out = expert(chunk) if isinstance(out, tuple): out = out[0] # Ignore the bias term for now expert_outputs += [out] # concat后最终out尺寸: (G, e, C, M) return torch.cat(expert_outputs, dim=1) -
定义 MoE 层的整体流程
- 首先,定义单个 expert 的核心模型架构(ParallelMLP),这是构成 MoE 层的基础计算单元
- 其次,考虑分布式部署场景下的显存 / 算力分配:单张计算卡上维护的 expert 数量为
num_local_experts = num_experts // ep_world_size(其中ep_world_size为 expert 并行的进程数),基于此通过nn.ModuleList定义该卡上的 expert 集合(Experts),统一管理本地所有 expert 实例 - 然后,设计 TopKGate 门控策略,实现 token 到 expert 的选择逻辑(下文将详细解读该策略)
- 最后,将上述模块(单个 expert 架构、本地 expert 集合、TopKGate 门控)整合,组装为完整的 MOELayer
-
MOELayer
class MOELayer(Base): """MOELayer module which implements MixtureOfExperts as described in Gshard_. :: gate = TopKGate(model_dim, num_experts) moe = MOELayer(gate, expert) output = moe(input) l_aux = moe.l_aux .. Gshard_: https://arxiv.org/pdf/2006.16668.pdf Args: gate (torch.nn.Module): gate network expert (torch.nn.Module): expert network """ def __init__(self, gate: Module, experts: Module, ep_group_name, ep_size, num_local_experts: int, use_tutel: bool = False) -> None: super().__init__() # ------------------------------------------------------------------------- # TopKGate类,用来决定token的分法策略(细节见下文代码解读) # ------------------------------------------------------------------------- self.gate = gate # ------------------------------------------------------------------------- # 当前进程所属的gpu上维护的所有experts,nn.ModuleList[ParallelMLP()] # ------------------------------------------------------------------------- self.experts = experts # ------------------------------------------------------------------------- # 当前进程所属的ep_group,为None时表示所有的gpu构成一个ep_group # 当执行_set_ep_group方法时,可以自定义ep_group(参见MoE类下_create_process_groups方法) # ------------------------------------------------------------------------- self.ep_group = None # ------------------------------------------------------------------------- # 当前进程所属的ep_group的ep_world_size # ------------------------------------------------------------------------- self.ep_size = ep_size # ------------------------------------------------------------------------- # 当前进程所属的ep_group的名字 # ------------------------------------------------------------------------- self.ep_group_name = ep_group_name # ------------------------------------------------------------------------- # 当前进程所属的gpu上所维护的experts数量,它即为self.experts中维护的experts数量 # ------------------------------------------------------------------------- self.num_local_experts = num_local_experts # ------------------------------------------------------------------------- # 一些用于衡量MoE计算过程的时间技术器,可以忽略不看(后面代码中我都用省略号替换了) # ------------------------------------------------------------------------- self.time_falltoall = 0.0 self.time_salltoall = 0.0 self.time_moe = 0.0 self.timers = SynchronizedWallClockTimer() self.wall_clock_breakdown = False # 是否使用tutel做路由优化(tutel的实现细节我们不在本文中分析) self.use_tutel = use_tutel and TUTEL_INSTALLED and gate.k == 1 if self.use_tutel: logger.info('Using Tutel optimizations.') elif use_tutel and not TUTEL_INSTALLED: logger.warning("Tutel optimization requested but not installed. " "Proceeding without Tutel.") elif use_tutel and TUTEL_INSTALLED and gate.k != 1: logger.warning("To enable Tutel optimization, use top-1 instead of top-2 gate. " "Proceeding without Tutel.") def _set_ep_group(self, ep_group): self.ep_group = ep_group def forward(self, *input: Tensor,**kwargs: Any) -> Tensor: ...... # ------------------------------------------------------------------------- # 1. 对input做reshape # 注意入参中input前面带*号,意味着传入的input是一个tuple,一般是一个二元组 # input[0]是我们真正要做计算的batch数据,其尺寸为(seq_len, batch_size, M) # input[1]是掩码数据,其尺寸为(seq_len*batch_size),有时在计算MoE结果时,我们相对 # 某些token做mask,使其不参与计算,就可以把mask数据装在这里。由于这一策略不常用, # 因此在本文中我们不关注这块 # # reshaped_input尺寸为(S, M),其中S = seq_len * batch_size # ------------------------------------------------------------------------- d_model = input[0].shape[-1] # Initial implementation -> Reshape into S tokens by dropping sequence dimension. # Reshape into G groups so that each group can distribute tokens equally # group_size = kwargs['group_size'] if 'group_size' in kwargs.keys() else 1 reshaped_input = input[0].reshape(-1, d_model) # ------------------------------------------------------------------------- # 是否使用Tutel做路由优化(不是本文讲解内容) # ------------------------------------------------------------------------- if self.use_tutel: self.l_aux, C, E, indices_, locations_, gates_, self.exp_counts = self.gate(reshaped_input, input[1], True) S, M = reshaped_input.size(0), reshaped_input.size(1) if not hasattr(self, '_tutel_dispatcher'): self._tutel_dispatcher = tutel_moe.fast_dispatcher(E, C, M, dispatch_dtype=reshaped_input.dtype) self._tutel_dispatcher.update(indices_, locations_, gates_, capacity=C) dispatched_input = self._tutel_dispatcher.encode(reshaped_input) # ------------------------------------------------------------------------- # 2. 使用自定义的Gshard gate,确定token的分法策略 # (对以下输出结果解释有疑惑的,都可以参考原理篇2.6节伪代码讲解,有详细的图例) # gate:TopKGate类,后文做解读 # l_aux: 辅助损失函数值 # combine_weights: 尺寸为(S, E, C),表示对每个token(S)而言,它对每个专家(E)的weight, # 而这个weight按照该token在buffer中的位置(C)存放,不是目标位置的地方则用0填充 # dispatch_mask: 它等于combine_weights.bool(), 也就是对combine_weights # 为0的地方设为False,为1的地方设为True。 # dispatch_mask后续将被用在zero padding上 # ------------------------------------------------------------------------- else: # 确认token分法策略 self.l_aux, combine_weights, dispatch_mask, self.exp_counts = self.gate(reshaped_input, input[1]) # ------------------------------------------------------------------------- # 3. 将输入数据按照expert的顺序排好,并做zero padding, # 为下一步送去expert计算做准备(很重要) # dispatched_input: 尺寸为(E, C, M), # 表示每个专家(E)的buffer(C)下要处理的token_embedding(M), # 当对应专家接收的token数不足buffer长度C时,不足的地方用0向量填充。 # ------------------------------------------------------------------------- dispatched_input = einsum("sec,sm->ecm", dispatch_mask.type_as(input[0]), reshaped_input) ...... # ------------------------------------------------------------------------- # 4. 当expert不采用tp切分,而non-MoE部分采用tp切分时,为避免数据重复发送,需要对 # 同一个tp组内的tokens做去重(见原理篇3.2节) # ------------------------------------------------------------------------- if groups._get_expert_model_parallel_world_size() == 1: # If the non-expert is tensor-parallel, it will create # duplicate tokens on the tensor-parallel ranks. # Since our experts are not tensor-parallel, these duplicates # need to be dropped to ensure correctness. # this also doubles up as a communication optimization as we are # reducing the all-to-all communication volume. dispatched_input = drop_tokens(dispatched_input, dim=1) # ------------------------------------------------------------------------- # 5. 第一次All2All:将token发给对应的expert # dispatched_input尺寸为(E, C, M),又可以写成(G*e, C, M), # 其中G=ep_world_size, e = num_local_experts # 在将它正式喂给expert前,把它reshape成(G, e, C, M) # (参见1.5(3) Experts类注释) # ------------------------------------------------------------------------- dispatched_input = _AllToAll.apply(self.ep_group, dispatched_input) ...... # Re-shape after all-to-all: ECM -> GeCM dispatched_input = dispatched_input.reshape(self.ep_size, self.num_local_experts, -1, d_model) # ------------------------------------------------------------------------- # 6. 将token喂给expert计算 # expert_output尺寸为(G, e, C, M) # ------------------------------------------------------------------------- expert_output = self.experts(dispatched_input) ...... # ------------------------------------------------------------------------- # 7. 第二次All2All:将算好的token返回给产出它的gpu # expert_output为(G, e, C, M),即此时这张卡上维护的token过MoE的结果, # 是由它从ep_group(G)内所有expert(e)的结果汇总而来的 # ------------------------------------------------------------------------- expert_output = _AllToAll.apply(self.ep_group, expert_output) ...... # Re-shape back: GeCM -> ECM expert_output = expert_output.reshape(self.ep_size * self.num_local_experts, -1, d_model) # ------------------------------------------------------------------------- # 8. 如果之前在tp组内做过数据去重处理,这里要把数据all-gather回来 # (参见原理篇3.2) # ------------------------------------------------------------------------- if groups._get_expert_model_parallel_world_size() == 1: # the dropped duplicate tokens need to be gathered on each # tensor parallel rank again for the tensor-parallel # non-expert of the next layer. expert_output = gather_tokens(expert_output, dim=1) # ------------------------------------------------------------------------- # 9. 使用combine_weights进行加权计算 # combined_output尺寸为(S, M),其中S = seq_len * batch_size # ------------------------------------------------------------------------- if self.use_tutel: combined_output = self._tutel_dispatcher.decode(expert_output.view(E * C, M)) else: combined_output = einsum("sec,ecm->sm", combine_weights.type_as(input[0]), expert_output) # 最终输出a尺寸为:(seq_len, batch_size, M) a = combined_output.reshape(input[0].shape) ...... return a -
TopKGate
class TopKGate(Module): wg: torch.nn.Linear def __init__(self, model_dim: int, num_experts: int, k: int = 1, capacity_factor: float = 1.0, eval_capacity_factor: float = 1.0, min_capacity: int = 8, noisy_gate_policy: Optional[str] = None, drop_tokens: bool = True, use_rts: bool = True) -> None: super().__init__() # Only top-1 and top-2 are supported at the moment. if k != 1 and k != 2: raise ValueError('Only top-1 and top-2 gatings are supported.') # 定义gate层架构 self.wg = torch.nn.Linear(model_dim, num_experts, bias=False).float() -
Gate 模块的核心职责是为每个 token 计算分配到各个 expert 的概率(prob),并基于 TopK 策略完成 token 到 expert 的路由
-
在 DeepSpeed 的 MoE 设计中,每张计算卡都会部署独立的 Gate 模块实例,而算法逻辑的正确性高度依赖所有卡上的 Gate 模块行为完全一致 —— 若不同卡的 Gate 输出的 token 分配概率存在差异,会导致 token 路由逻辑混乱,最终引发 MoE 层计算结果错误
-
要保证所有卡上的 Gate 模块行为一致,最核心的前提是:
- 所有 Gate 模块使用完全相同的初始化方法(如 nn.Linear 的默认初始化、自定义的 xavier 初始化等);
- 初始化时使用相同的随机种子,确保随机初始化的参数(如权重、偏置)在所有卡上完全一致
Megatron MoE
-
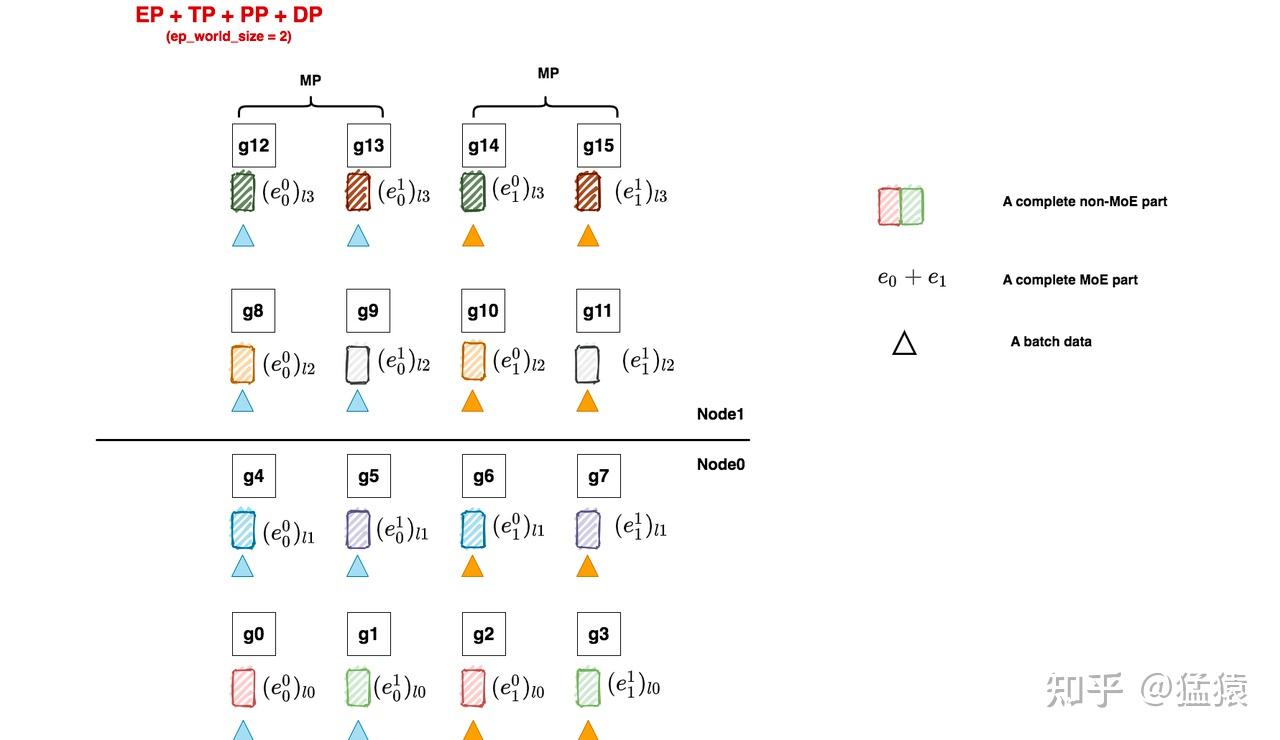
deepspeed 把 ep 相关的初始化设置放到模型切割之后,megatron 则在模型切割之前一次性把包括 ep 在内的初始化完成
-
下面是一个 EP+TP+DP+PP 的例子
-
对应代码
...... # ------------------------------------------------------------------------------- # ep_group # [[g0, g1, g2, g3], [g4, g5, g6, g7],[g8, g9, g10, g11], [g12, g13, g14, g15]] # 假设当前进程为0,同样都是ep_world_size = 2的情况下: # - 在Megatron中,当前进程对应的ep_group为[g0, g1, g2, g3], # ep_group内通讯为ReduceScatter/AllGather(下文会细说) # - 在deepspeed中,当前进程对应的ep_group为[g0, g2], # ep_group内通讯为All2All # ------------------------------------------------------------------------------- _TENSOR_AND_EXPERT_PARALLEL_GROUP = None # ------------------------------------------------------------------------------- # ep_dp_group # [[g0], [g1], [g2],...], 每张卡单独组成1个ep_dp_group # 对ep_dp_group定义有疑问的朋友,可先阅读原理篇第三部分 # deepspeed和megatron对ep_dp_group的定义是一致的 # ------------------------------------------------------------------------------- _DATA_MODULO_EXPERT_PARALLEL_GROUP = None # ep_dp_group ...... # ------------------------------------------------------------------------------- # 在megatron中,强制MoE部分复用non-MoE部分的tp和pp group,那么ep部分的划分就只能在 # dp维度上进行,所以需要强制data_parallel_size % expert_model_parallel_size == 0, # 这里expert_model_parallel_size就是ep_world_size(注意在图例中ep_world_size是2不是4!) # ------------------------------------------------------------------------------- if data_parallel_size % expert_model_parallel_size != 0: raise RuntimeError( f"data_parallel_size ({data_parallel_size}) is not divisible by expert_model_parallel_size " ) # ------------------------------------------------------------------------------- # 具体划分_TENSOR_AND_EXPERT_PARALLEL_GROUP和_TENSOR_AND_EXPERT_PARALLEL_GROUP的代码 # 我们就不特别列出了,大家知道了这些group的定义后阅读起来应该不困难, # 大家可以多尝试一些切分方式,跑一跑看看megatron会给出什么样的group,哪些组合是被megatron禁止的, # 加深对代码理解 # ------------------------------------------------------------------------------- ...... -
Megatron SwitchMLP 与 DeepSpeed MOELayer 的核心差异分析
- 核心路由策略差异
- Megatron SwitchMLP:采用 Top1Expert 策略,即每个 token 仅选择得分最高的 1 个 expert 进行计算,是 Switch Transformer 原始论文的经典实现
- DeepSpeed MOELayer:默认采用 TopKExpert 策略(通常 K=2),每个 token 会选择得分最高的 K 个 expert,兼顾计算效率与表达能力
- Token 处理逻辑差异(核心区别)
- Megatron SwitchMLP
- 实现 Token Dropless(无 Token 丢失) 设计
- 所有 token 都会被路由到其匹配的 Top1 expert 上,无任何 token 溢出(overflow)问题
- 该设计的前提是:Megatron 会通过全局负载均衡策略(如动态调整 expert 的路由概率、限制单 expert 的 token 承载上限),确保每个 expert 的计算负载在预设范围内,避免单 expert 过载
- DeepSpeed MOELayer
- 存在 Token Overflow 机制
- 当 TopK 选择后,若某 expert 被分配的 token 数超过预设上限(capacity factor),超出部分的 token 会被标记为 “溢出”
- 溢出 token 通常会被路由到备用 expert、或直接丢弃(视配置而定),因此存在 token 丢失 / 重新分配的情况
- Megatron SwitchMLP
- 核心路由策略差异
-
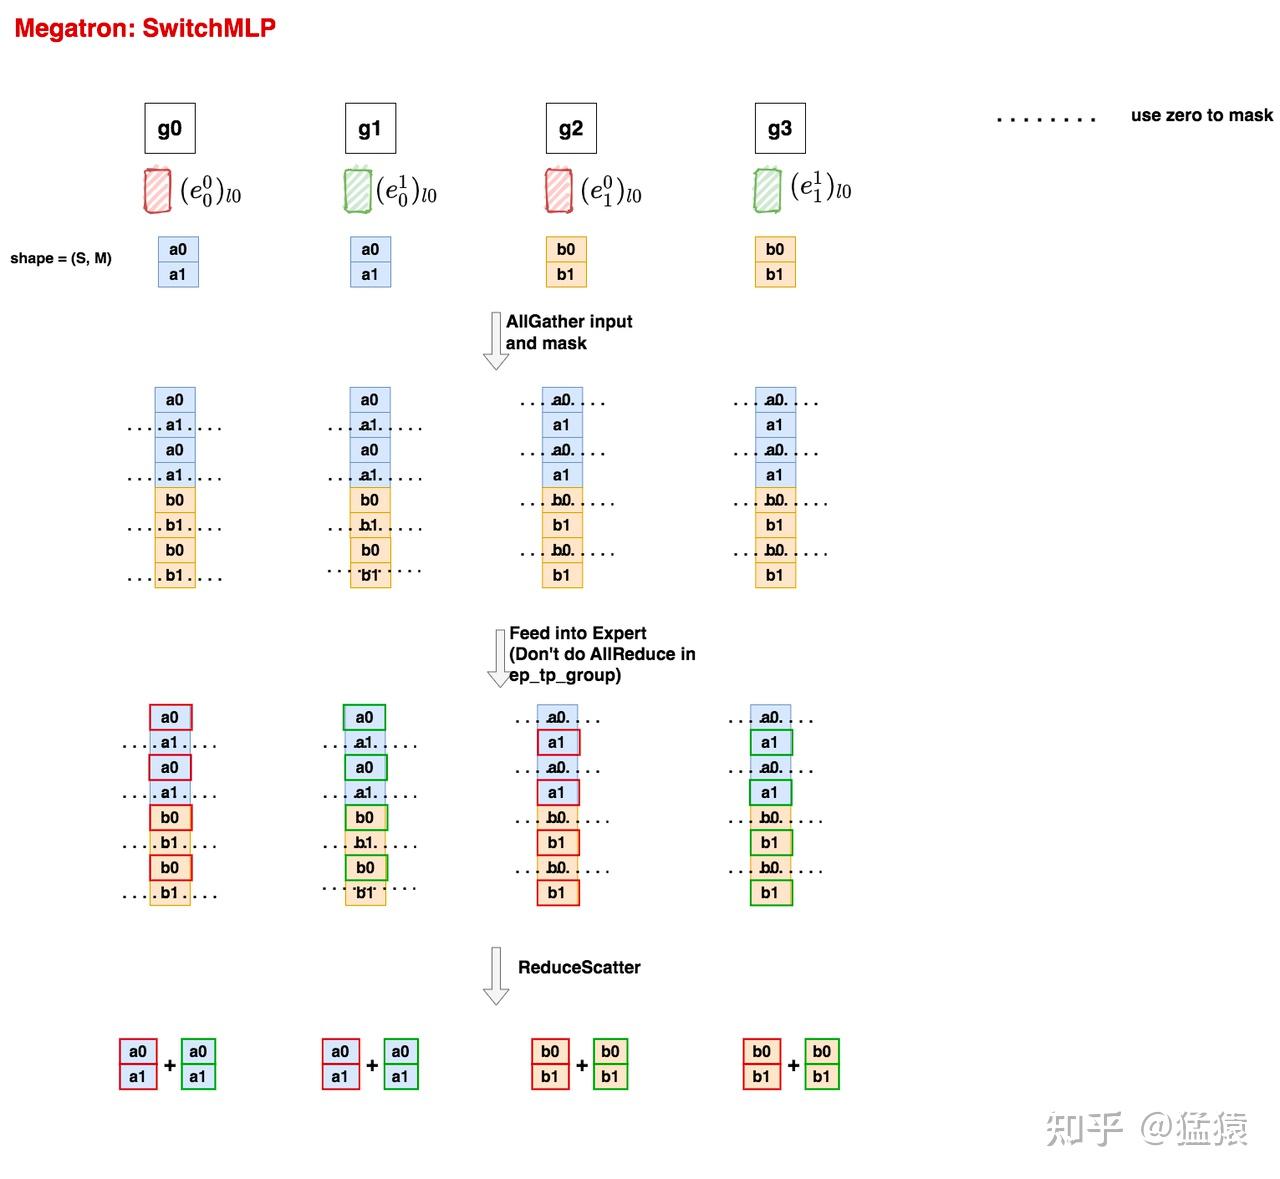
SwitchMLP 的流程图
-
初始数据处理
- 非 MoE 层的输出维度为
(seq_len, batch_size, M),首先将其 reshape 为(S, M)(其中S = seq_len * batch_size) - 同一 TP(Tensor Parallelism)组内的输出经过 AllReduce 操作后,数据完全一致
- 以 GPU g0 为例:假设 a0 是需送往 expert e0 的 tokens,a2 是需送往 expert e1 的 tokens,其余 GPU 的数据处理逻辑以此类推,对应流程图第一行
- 非 MoE 层的输出维度为
-
EP 组内 AllGather + Mask 操作(Megatron vs DeepSpeed 核心差异)
- 在 EP 组内,先对所有数据执行 AllGather 通讯操作,再将非当前卡上 expert 负责的 token 进行 mask 处理。这一步能直观体现 Megatron 与 DeepSpeed 的设计差异:
- DeepSpeed
- 在 EP 组内采用 All2All 通讯方式,token 会定向发送至其对应 expert 所在的 GPU
- 由于不同 expert 负责的 token 数量存在差异,通讯过程中必然出现负载不均问题
- 为解决该问题,DeepSpeed 为 expert 引入「capacity(容量)机制」—— 可理解为 token 被装入固定容量的 buffer 中传输,buffer 未填满的部分用 0 填充,以此保证通讯时的负载均衡
- Megatron
- 在 EP 组内直接执行 AllGather 通讯,不区分 token 对应的 expert 归属,将全量数据发送至组内所有 GPU;随后在各 GPU 上 mask 掉非当前卡 expert 负责的 token
- 这种方式虽能保证 EP 组内通讯的负载均衡,但会传输大量重复数据
- 这一设计差异也解释了 Megatron 与 DeepSpeed 中 EP 组定义不同的底层原因
-
Expert 计算(ParallelMLP)
- 各 GPU 完成非目标 token 的 mask 后,将剩余有效 token 输入至 expert 进行计算(对应流程图第三行)
- 与 DeepSpeed 一致,Megatron 的单个 expert 同样基于 ParallelMLP 实现
- 但核心差异在于:若 Megatron 的某个 expert 启用了 TP 切分,同一 TP 组内不会对 expert 的输出结果执行 AllReduce 操作 —— 这是因为后续会在 EP 组内执行 ReduceScatter 操作,该操作会自动将 expert 不同 TP 组的计算结果求和
-
EP 组内 ReduceScatter 与结果输出
- MoE 层计算完成后,将每张 GPU 上的数据划分为
ep_world_size份 - 需注意:此处 Megatron 的 ep_world_size 指 EP 组内的 GPU 数量,示例中为 4;而分布式组网时配置的 ep_world_size 为 2
- 随后对数据执行 ReduceScatter 操作,最终得到 MoE 层的输出结果(对应流程图最后一行
- 此时同一 TP 组内的数据恢复为完全一致的状态,可直接作为输入传递至下一层非 MoE 层
- MoE 层计算完成后,将每张 GPU 上的数据划分为
MoE 的稳定性训练
-
熵正则化
-
与侧重于平衡各专家接收 token 总量的负载均衡损失不同,熵正则化直接作用于路由器对单个 token 的专家分配概率分布
-
其目标是鼓励 softmax 输出在专家维度上更加平坦,即具有更高的熵,从而避免路由器过早做出过于确定的决策
-
熵正则化项通常定义为:
-
其中, 表示 token 被分配给专家 的门控概率, 为专家数量, 为数值稳定项, 为熵正则化系数
-
该损失项通过惩罚低熵分布,促使路由器在专家选择上保持一定的不确定性
-
这在训练早期尤为重要,有助于提高路由探索性,避免因初始化偏置或早期噪声导致专家利用率迅速失衡
-
与路由噪声类似,熵正则化的权重 通常会在训练过程中逐步衰减,使路由策略从探索阶段平滑过渡到更加确定的利用阶段
-
-
至此,已经引入了五种有助于 MoE 负载均衡和稳定性训练的技术
机制 作用对象 主要解决的问题 核心机制 是否参与反向传播 典型使用阶段 熵正则化 单个 token 的专家概率分布 路由过早变得确定,softmax 分布过于尖锐 惩罚低熵分布,鼓励概率更平坦 是 训练早期为主,权重常随时间衰减 Noise router logits(softmax 之前) 确定性 top-k 导致的路径依赖与早期偏置 在 logits 上注入随机扰动,提升探索性 否 训练早期与中期,噪声幅度逐步衰减 auxiliary loss 跨 token 的专家负载统计 专家负载不均衡、表示坍塌 惩罚负载的相对方差,拉平专家使用率 是 全训练过程,通常保持恒定或弱衰减 Expert Capacity 单个专家可接收的 token 数 专家过载、显存和吞吐失控 对路由结果施加硬上限,超额 token 被丢弃或重路由 否 全程启用,工程层面约束 Router z-loss router logits 的整体尺度 logits 过大导致 softmax 饱和与梯度消失 惩罚 的幅值,稳定数值尺度 是 全训练过程,通常权重较小 -
完整的路由参数决定因素
flowchart LR
  %% 全局样式
  classDef router fill:#e9ecef,stroke:#495057,rx:8,ry:8;
  classDef influence fill:#f8f9fa,stroke:#495057,rx:8,ry:8;
  classDef expert fill:#adb5bd,stroke:#495057,rx:30,ry:30;
  classDef constraint fill:#ffe3e3,stroke:#c92a2a,rx:8,ry:8;

  %% 路由器网络
  subgraph RouterNet["路由器网络"]
    direction LR
    Router["路由器参数<br/>(权重, 偏置)"]:::router
    Gating["门控对数 (h)"]:::router
    Softmax["Softmax (g)"]:::router

    Router --> Gating
    Gating --> Softmax
  end

  %% 优化影响因素
  subgraph Influences["优化影响因素"]
    direction TB
    TaskLoss["任务损失梯度<br/>(分工信号)"]:::influence
    AuxLoss["辅助损失梯度<br/>(负载均衡信号)"]:::influence
    Noise["注入噪声 (ε)<br/>(多样性 / 稳定性)"]:::influence
    LR["学习率<br/>(更新幅度)"]:::influence
    Reg["正则化<br/>(权重衰减, 裁剪)"]:::influence
  end

  %% 容量约束
  Capacity["专家容量约束<br/>(capacity limit)"]:::constraint

  %% 专家
  Experts["专家"]:::expert

  %% 连接关系
  TaskLoss -->|反向传播| Router
  AuxLoss -->|反向传播| Router
  Noise -.->|加性| Gating
  LR -.->|缩放更新| Router
  Reg -.->|修改更新| Router

  Softmax --> Capacity
  Capacity -.->|截断 / 丢弃 / 重路由| Experts
MoE 高效推理
-
token 级分组与置换(Token-level Grouping & Permutation),其核心思想是:根据每个 token 被分配到的专家,对批次内的 token 进行主动重排,从而把 “稀疏、不规则” 的专家访问,转化为 “致密、规则” 的批处理计算
-
整体工作流程通常如下:
-
门控计算
- 门控网络对输入批次中的所有 token 进行处理
- 根据门控输出,确定每个 token 应被路由到的专家
- 推理阶段通常采用 Top-1 路由以降低计算与通信开销
- 在部分设置中也可能使用 Top-2 路由以提升模型质量
-
路由决策与排序
- 为每个 token 确定其目标专家 ID
- 根据专家 ID 对 token 进行排序或建立索引
- 排序后的目标是所有分配给同一专家的 token 在逻辑或物理上相邻,为后续的批量专家计算做准备
-
token 置换(Gather)
- 根据排序结果,对 token 表示进行内存中的重新排列,使分配给专家 0 的 token 连续,接着是专家 1、专家 2,依此类推
- 如果专家分布在不同设备上,该阶段会触发 All-to-All 通信,每个设备发送属于远程专家的 token,同时接收分配给本地专家的 token
- 高效实现通常依赖优化的集体通信库(如 NCCL)或专门针对 MoE 优化的框架(如 Tutel)
-
批处理专家计算
- 每个专家(或承载该专家的设备)接收到一个只包含 “自己负责 token” 的致密小批次
- 专家网络(通常是 FFN)对该批次执行高效的向量化计算
- 这一阶段充分利用 GPU 对致密矩阵运算的高吞吐能力
-
令牌反置换(Scatter)
- 专家计算完成后,输出 token 的顺序仍然是 “按专家分组” 的
- 需要执行与置换相反的操作,将 token 恢复到原始批次与序列顺序
- 在分布式设置下,通常涉及第二次 All-to-All 通信,将处理后的 token 结果发回其原始设备
-
组合与继续计算(Combine & Continue)
- 来自专家的输出按照原始 token 顺序重新对齐
- 根据门控 logits 对专家输出进行组合,即使推理时使用 Top-1 计算,组合阶段仍可能保留加权形式以匹配训练行为
- 得到的 token 表示进入模型的下一层,如后续 FFN、LayerNorm、残差连接等
-
-
“分组与置换” 将 MoE 的不规则路由问题转化为专家内部的规则批处理计算
-
All-to-All 通信是跨设备专家部署时的关键成本,该机制是 MoE 在推理阶段实现高吞吐与可扩展性的核心基础
开源 MoE 模型
-
有多种开源项目可用于训练 MoE 模型:
- Megablocks
- 提供高效的稀疏 MoE 训练实现
- https://github.com/stanford-futuredata/megablocks
- Fairseq
- 在其语言模型示例中支持 MoE 训练
- https://github.com/facebookresearch/fairseq/tree/main/examples/moe_lm
- OpenMoE
- 面向社区的 MoE 训练与实验框架
- https://github.com/XueFuzhao/OpenMoE
- Megablocks
-
开源的 MoE 模型:
- Switch Transformers(Google)
- 基于 T5 架构的 MoE 模型系列
- 专家数量从 8 到 2048 不等
- 最大模型规模达到 1.6 万亿参数
- https://huggingface.co/collections/google/switch-transformers-release-6548c35c6507968374b56d1f
- NLLB MoE(Meta)
- NLLB 翻译模型的混合专家版本
- https://huggingface.co/facebook/nllb-moe-54b
- OpenMoE
- 社区对基于 LLaMA 架构的 MoE 模型探索
- https://huggingface.co/fuzhao
- Mixtral 8×7B(Mistral)
- 高质量混合专家模型,在多项基准上性能超过 LLaMA 2 70B
- 同时具备更快的推理速度
- 提供指令微调版本
- https://mistral.ai/news/mixtral-of-experts/
- Switch Transformers(Google)