BERT GPT T5 模型
介绍 BERT、GPT、T5 等主流模型的结构与推理方法
-
参考资料
- 帖子
- 文章
- BERT:BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding
- RoBERTa:RoBERTa: A Robustly Optimized BERT Pretraining Approach
- ALBERT:ALBERT: A Lite BERT for Self-supervised Learning of Language Representations
- DeBERTa:DeBERTa: Decoding-enhanced BERT with Disentangled Attention
- BART:BART: Denoising Sequence-to-Sequence Pre-training for Natural Language Generation, Translation, and Comprehension
- T5:Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer
- Flan-T5:Scaling Instruction-Finetuned Language Models
- GPT:Improving Language Understanding by Generative Pre-trained Transformer
- GPT-2:Release Strategies and the Social Impacts of Language Models
- GPT-3:Language Models are Few-Shot Learners
-
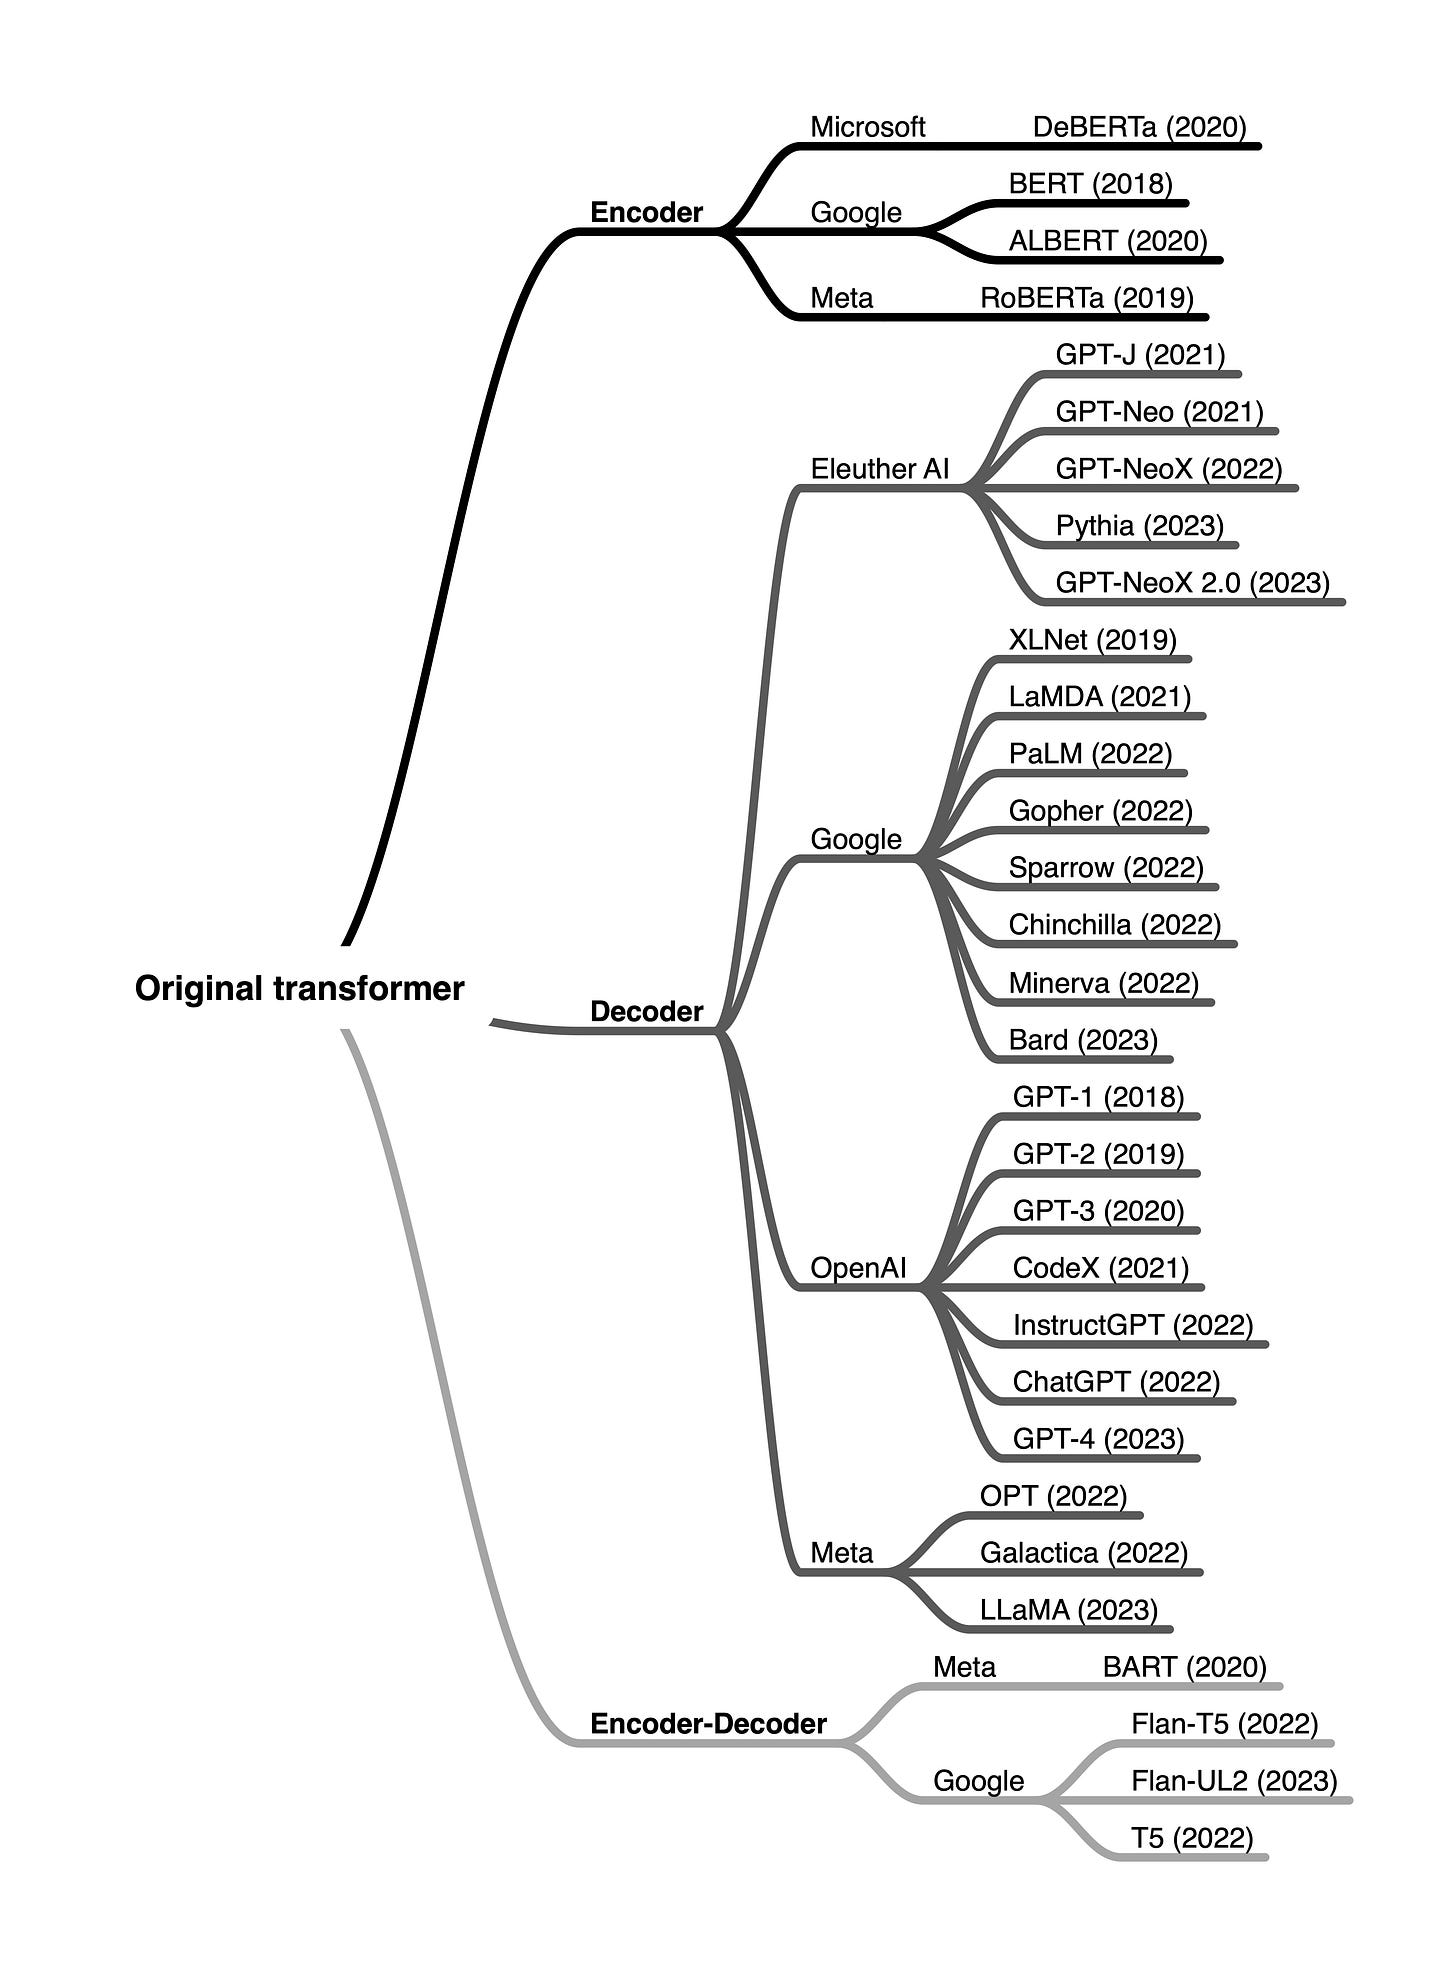
Transformer 相关变种模型
BERT
-
BERT(Bidirectional Encoder Representations from Transformers)是由 Google 于 2018 年提出的预训练语言表示模型
-
相较于 Transformer 模型,BERT 模型完全移除 Decoder,仅保留 Encoder,因此其不做自回归建模,输出为上下文相关的双向表示
-
输入表示的变化
-
Token Embedding
- BERT 使用 WordPiece 分词,将句子拆成子词
- 其中 通常是 768(BERT-base)或 1024(BERT-large)
-
区分不同句子
- 首先,在被分割的句子之间插入 [SEP] token,用以明确区分各句子
- 其次,为每个 token 的表示添加可学习的 Segment Embedding,以指示其所属的句子类别(句子 A 或句子 B)
- 对于单句任务,所有 token 的 Segment Embedding 均设为 0
- 区分句子 A 与句子 B 主要用于 NSP(Next Sentence Prediction)或句对建模任务
-
添加分类 token
- 在每个输入序列的开头插入专用的分类 token [CLS]
- 该 token 在最后一个 Encoder 层的输出向量用于汇聚整个序列的语义表示
- 主要应用于句子级任务,例如自然语言推断(NLI)和情感分类等
-
-
Encoder 结构
- BERT-base:12 层 Transformer Encoder,隐藏维度 768,12 个注意力头
- BERT-large:24 层 Transformer Encoder,隐藏维度 1024,16 个注意力头
-
输出
- CLS 向量(第一个 token 的隐藏向量 ):用于分类任务或句子级任务
- 每个 token 的向量 :用于序列标注、问答等 token 级任务
-
BERT 共提出两种预训练任务
- Masked Language Model(MLM)
- Next Sentence Prediction(NSP)
-
Masked Language Model (MLM)
-
MLM 是 BERT 能够突破单向语言模型限制的关键机制
-
在预训练阶段,BERT 会以 15% 的概率随机选择训练序列中的 token,将其替换为 [MASK],并要求模型预测这些位置原始的 token
-
由于 [MASK] 在下游任务中并不存在,这会造成预训练与微调阶段的不匹配:模型在预训练中对 [MASK] 过于敏感,而对实际 token 不够敏感
-
为缓解这一问题,BERT 对被选中的 token 进行如下替换策略:
- 80% 的概率替换为 [MASK],例如:
my dog is hairy→my dog is [MASK] - 10% 的概率替换为随机 token,例如:
my dog is hairy→my dog is apple - 10% 的概率保持原 token 不变,例如:
my dog is hairy→my dog is hairy
- 80% 的概率替换为 [MASK],例如:
-
模型通过这些位置对应的表示 预测原 token,将输出通过全连接层映射到词表维度,并使用 softmax 计算每个 token 的概率,最后采用交叉熵计算损失
-
该策略确保 BERT 对所有 token 都敏感,从而能够学习到每个 token 的表征信息
-
-
Next Sentence Prediction (NSP)
-
某些下游任务(如问答或自然语言推断)需要理解句子间的关系,而 MLM 更侧重于 token 层次的表征,无法直接捕捉句子级语义
-
为此,BERT 在预训练中引入 NSP 任务:预测两个句子是否相邻
-
具体做法:对每个训练样例,随机选取句子 A 和句子 B
- 50% 的概率句子 B 为句子 A 的下一句(标注为 IsNext)
- 50% 的概率 B 为语料库中的随机句子(标注为 NotNext)
-
将训练样例输入 BERT 后,使用 [CLS] 对应的表示进行二分类预测,损失定义如下:
-
预训练阶段的总体损失为 MLM 损失和 NSP 损失的加权和
-
这两个任务的数据均可从无标签文本构建(自监督),相比计算机视觉中的 ImageNet 标注数据集,构建更为简单
-
后续研究(如 RoBERTa)发现 NSP 效果不明显,因此可以去掉
-
-
BERT 是一个通用编码器,可以在各种任务上微调。微调时,通常只需在输出层加一层任务特定的全连接网络
任务类型 输入 输出 处理方式 分类(情感分析) [CLS] sentence [SEP][CLS]向量通过全连接 + softmax 分类 序列标注(NER) [CLS] token1 ... tokenn [SEP]每个 token 向量 每个 token 输出 softmax 分类 问答(SQuAD) [CLS] question [SEP] context [SEP]token 向量 用 start/end 分类器选择答案 span -
BERT 参数量
模型 层数 隐藏维度 d 注意力头数 参数量 BERT-base 12 768 12 110M BERT-large 24 1024 16 340M
BERT 变种
RoBERTa
-
RoBERTa(RobustlyoptimizedBERTpretrainingapproach)是对 BERT 的一种改进方法
-
RoBERTa 本质上是在证明:BERT 的问题不在结构,而在训练范式
-
RoBERTa = 不改模型结构的前提下,把 BERT 的预训练 “彻底做对”
-
BERT 存在几个非理论而是工程性的限制
问题 原因 改动 训练数据偏小 当时算力与数据有限 提高数据的数量级 训练步数太少 预训练不足 增加训练步数 MLM masking 固定 每个样本只 mask 一次 动态 Masking NSP 目标可疑 是否真的有用? 删除 NSP 任务 -
去掉 NSP(Next Sentence Prediction)
- RoBERTa 通过系统实验发现,NSP 对下游任务无明显帮助,甚至可能干扰 MLM 学习
- NSP 强迫模型学习 “句子级分类信号”,而很多任务需要的是 token-level 表示,且 NSP 的负样本构造非常粗糙(随机拼接)
-
动态 Masking
- BERT 中:每个样本只 mask 一次,mask 位置在整个训练中固定,而这意味着模型可能记住 mask 模式,而不是语言规律
- RoBERTa 中:每个 epoch,同一句话随机生成新的 mask pattern,相比 BERT,覆盖更多 token,学到更鲁棒的上下文关系
-
更大的训练数据(数量级差异)
- BERT 训练数据约 16GB,而 RoBERTa 训练数据约 160 GB
- RoBERTa 的训练数据包括 BookCorpus、Wikipedia、CC-News、OpenWebText、Stories 等
-
更长训练、更大 batch:BERT-base 大约训练 100k 步,RoBERTa 大约训练 500k+ 步
-
更大的 batch
- RoBERTa 使用的 batch size = 8k–32k sequences,借助 LARS / Adam + warmup
- 更大的 batch ≠ 更快收敛,而是更稳定的 MLM 梯度估计
-
输入拼接策略改进
- BERT 的句子对模型输入人为限制句子边界,强制 segment embedding
- RoBERTa 直接把文本当成连续 token 流,不强制 sentence boundary,而 segment embedding 也可有可无
- 这样模型更自然地学习长程依赖,减少人为 inductive bias
ALBERT
DeBERTa
T5
-
T5 是 Google Research 在 2019 年提出的模型,全称 Text-to-Text Transfer Transformer
-
核心思想
- 统一 NLP 任务
- 传统 NLP 模型通常针对分类、生成、翻译等任务分别设计不同结构
- T5 将所有 NLP 任务统一成 Text-to-Text 的形式:输入是文本,输出也是文本
- 例如:
- 翻译:
translate English to German: That is good→Das ist gut - 文本分类:
sst2 sentence: I love it→positive - 摘要:
summarize: <文章>→<摘要>
- 翻译:
- 基于 Transformer Encoder-Decoder
- 与 BERT(只用 Encoder)和 GPT(只用 Decoder)不同,T5 使用 完整的 Encoder-Decoder 架构,即标准 Transformer
- 大规模预训练 + 统一微调
- T5 在大规模语料(C4 数据集)上进行预训练,然后在 GLUE、SQuAD、翻译、摘要等任务上统一微调
- 统一 NLP 任务
-
输入表示的变化
- 分词
- 使用 SentencePiece 子词分词器,输出 token 序列
- 使用 可变长度序列,最大长度通常为 512 或 1024
- 文本前缀(Task Prefix):
- 为了统一任务类型,每个输入前面会加一个 文本前缀:
summarize: ...translate English to German: ...- 这个前缀让模型知道任务类型
- 位置编码采用绝对位置编码或可学习的位置嵌入
- 分词
-
T5 提出了 “填空式语言建模” (Span Corruption / Masked Span Prediction)
-
Span Corruption:随机选择连续 token span(非单个 token),用一个特殊 token
<extra_id_n>替换:-
输入:
The quick brown <extra_id_0> jumps over the lazy <extra_id_1> -
输出:
fox <extra_id_0> dog <extra_id_1> -
这种设计让模型学会生成被遮挡的文本片段,增强生成能力
-
-
目标损失,可以看作 seq2seq 的交叉熵损失:
-
-
下游任务微调 —— 由于所有任务都是 text-to-text 的,因此其微调方式统一,微调时,只需训练 decoder 输出的线性 + softmax
任务类型 输入文本 输出文本 处理方式 文本分类 sst2 sentence: I love itpositive将分类 label 作为文本输出 问答 question: ... context: ...<答案>输出答案 span 摘要 summarize: ...<摘要>输出摘要文本 翻译 translate English to German: ...<德语句子>输出目标语言文本 -
T5 模型的参数规模
模型 层数 Encoder/Decoder d 注意力头 参数量 T5-Small 6 / 6 512 8 60M T5-Base 12 / 12 768 12 220M T5-Large 24 / 24 1024 16 770M T5-3B 24 / 24 1024 32 3B T5-11B 24 / 24 1024 128 11B
Flan-T5
GPT
-
GPT(Generative Pre-trained Transformer)由 OpenAI 提出
-
核心思想
- 在 GPT 出现之前
- RNN / LSTM 难以并行且长依赖建模能力有限
- BERT 是 encoder-only 的,适合理解型任务(classification、span extraction),不天然适合自由生成
- 而 GPT 的目标非常明确:用一个统一的、自回归的语言模型,解决所有 NLP 任务
- GPT = Transformer Decoder × N 层 + 自回归语言模型目标,只用 Decoder、不做双向注意力、每一步只预测下一个 token
- 在 GPT 出现之前
-
输入表示的变化
- 分词使用 BPE /byte-level BPE 分词器
- GPT-1 / GPT-2:可学习绝对位置编码
-
Decode-only
- GPT 堆叠了 层 Transformer Decoder Block
- 每一层包括:Input → Masked Multi-Head Self-Attention → Add & LayerNorm → Feed Forward Network → Add & LayerNorm
- 与 Transformer Decoder 相比,去掉了 Encoder–Decoder Attention
- 前馈神经网络使用的激活函数
- GPT-1 / GPT-2:GELU
- GPT-3 之后:SwiGLU / GeGLU(变体)
-
残差连接与归一化的不同之处
-
Tranformer 模型使用 Post-LN:
-
考虑梯度反向传播的公式:
-
LayerNorm 是非线性、带缩放的,残差路径必须穿过 LN,即 “恒等路径被破坏”
-
当层数变深,梯度在 LN 中被不断缩放、旋转,非常容易梯度消失 / 爆炸,表现出 “深层退化”
-
GPT 模型使用 Pre-LN:
-
反向传播变为:
-
由此,残差路径是真正的恒等映射,梯度可以完全绕过注意力和 FFN,直接从顶层流回底层
-
Pre-LN 不是让 “训练更快”,而是让深层 Transformer 在数学上 “可训练”
-
-
训练目标
-
原始 Transformer 的目标是条件概率
- decoder 的确是逐 token 生成的,但它是在条件 已知的情况下
-
而 GPT 的目标则是最大化:
-
其与 Transformer 的根本区别在于概率建模对象不同
- Transformer 是 ,上下文是 + ,条件信息来自 Encoder 的输出
- GPT 是 ,上下文是 ,无条件信息,上下文本身就是所有信息
- GPT 并没有显式建模 ,但只要它学好了 ,所有 “任务条件分布” 都隐含在里面
- 理论上覆盖了 ,不是因为 “更强”,而是因为条件分布只是联合分布的一个切片
-
等价于最小化交叉熵损失:
-
训练阶段:所有 token 并行计算,使用 teacher forcing
-
推理阶段:必须逐 token 生成
-
-
GPT 模型中的 KV Cache:
-
假设已经生成了:
x₁ x₂ x₃ ... xₜ -
如果没有 cache,下一步重新生成 时,要重新算所有 token 的 Q,K,V,对应每层的复杂度为 ,整个生成过程的复杂度为
-
而 KV Cache 的核心思想是历史 token 的 K 和 V 不会再变,因为 decoder-only 和 causal mask 的存在,历史 token 不依赖未来
-
所以可以缓存 ,下一步只需要计算
-
这样,注意力变成:,复杂度降低为
-
为什么 Transformer 结构无法用 KV Cache?因为在 Encoder–decoder 架构中,虽然 encoder 输出固定可以缓存,但 decoder 每一层的 cross-attention 都要重新算;而 GPT 模型只有 self-attention,缓存一次可以用到结束
-
-
泛化能力的来源
- GPT 不像 BERT / T5 那样显式区分任务,而是把任务描述 + 示例,直接拼成文本,而这就是 In-context Learning、Few-shot Learning、Prompt-based Learning
- GPT 的重要贡献包括扩展规模(Scaling Law)、简单但通用的目标函数、数据多样性丰富
- 当模型足够大、数据足够广、上下文足够长时,GPT 的条件分布就近似了 “世界模型”
-
Decoder-only 架构更适合扩展规模
- Scaling Law 的本质:当模型规模、数据量、计算量一起增长时,损失函数呈幂律下降
- 第一个优势:目标函数极其 “干净”。相比两套网络且具有交叉注意力的 Encoder-Decoder 结构,Decoder-only 架构优化路径更平滑
- 第二个优势:参数 “每一分都在干同一件事”。在 encoder–decoder 里,encoder 负责理解,decoder 负责生成,cross-attn 负责对齐,而 GPT 模型的每一层、每一个参数,都在学同一个分布 ,这对 scaling 至关重要:参数越多 → 对同一目标的逼近能力越强
- 第三个优势:数据效率极高。GPT 的训练数据不需要标注,不需要对齐,不需要任务定义 —— 互联网上的所有文本,都是合法训练样本
- 第四个优势:推理结构与训练结构一致(结构一致性 = scaling 稳定性)。GPT 模型在训练时预测下一个 token,推理时预测下一个 token,而 Encoder–decoder 模型在训练时使用 teacher forcing,推理时则使用 exposure bias
-
推理阶段的解码策略
- GPT 只是给出概率,生成策略决定最终文本
- 可选贪心解码策略、Beam Search、Sampling(top-p、top-k)
- GPT 的 “创造性” 主要来自 采样策略,不是模型结构
-
模型规模
模型 层数 Hidden 参数 GPT-1 12 768 117M GPT-2 48 1600 1.5B GPT-3 96 12288 175B GPT-4 未公开 未公开 超 1T(推测) -
各个模型之间的对比
模型 架构 方向性 核心优势 BERT Encoder-only 双向 表示学习 T5 Encoder–Decoder seq2seq 任务统一 GPT Decoder-only 单向 生成 & Prompt