GPU
介绍 GPU 的基本概念、GPU 的计算层次结构、内存层次结构、通信 - 计算重叠的开销等内容
- 参考资料
GPU
-
CPU 与 GPU 的组织架构区别
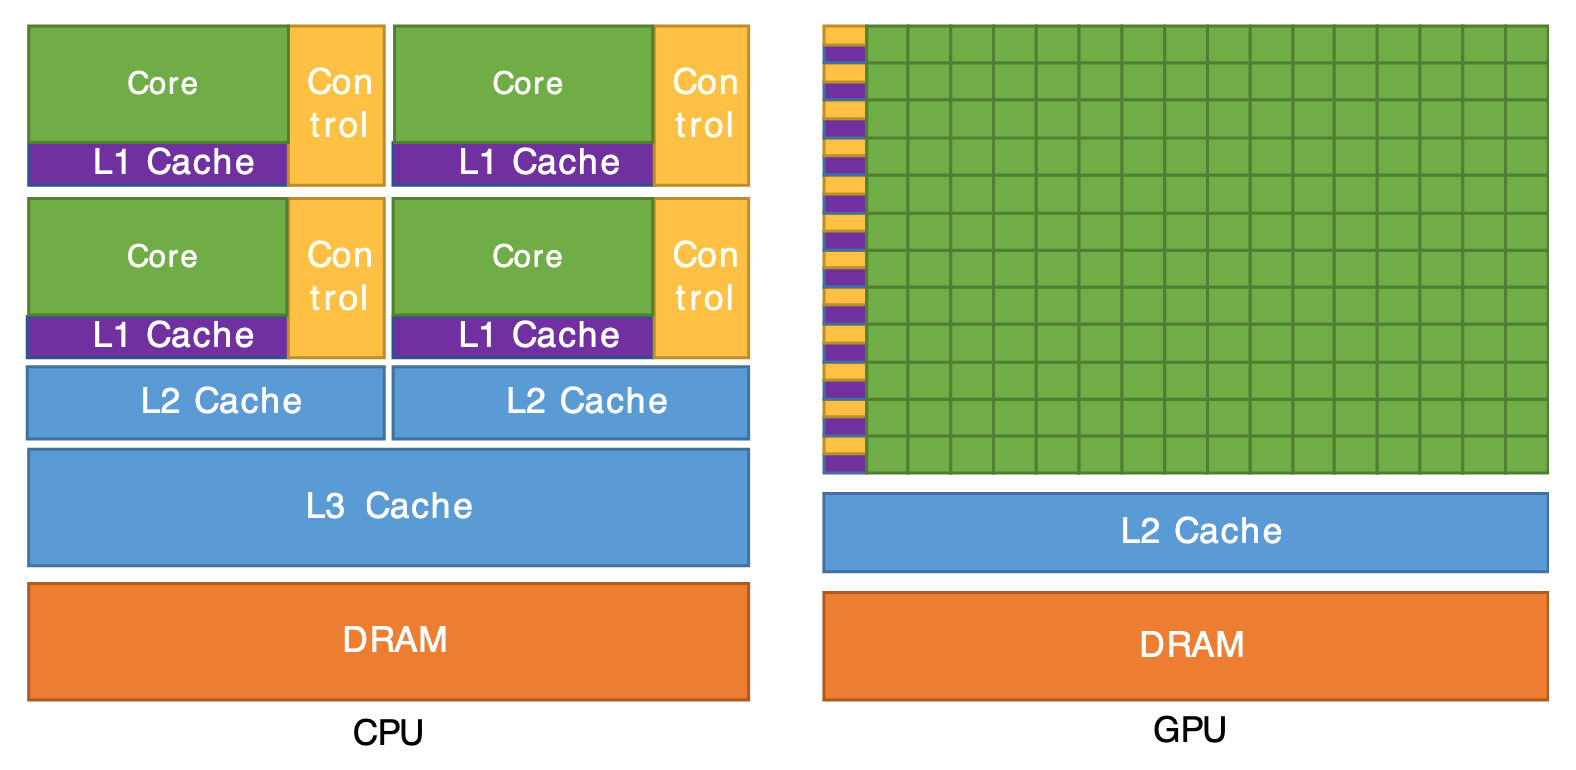
- 其中,绿色代表计算;金色代表指令处理;紫色代表 L1 缓存;蓝色代表更高级别的缓存;橙色代表内存(DRAM,其实际容量应该是缓存的数千倍)
- CPU 的设计核心是低延迟、强控制流,包含分支预测 / 乱序执行 / 缓存等核心机制,单线程性能很强发,其是为「复杂逻辑 + 少量并发」而生的
- 而 GPU 的设计核心是高吞吐、大规模并行、简单控制流,用并行来掩盖内存延迟,很适合大规模数值计算、规则的数据访问、相同算子作用在大量数据上,其是为「简单逻辑 + 海量并行」而生的
- 深度学习的核心操作是矩阵乘法、卷积、逐元素运算、归约等,这些操作的共同特征是数据量大、计算规则统一、控制流很简单、并行度很高,所以深度学习的计算形态正好符合 GPU 的设计假设
-
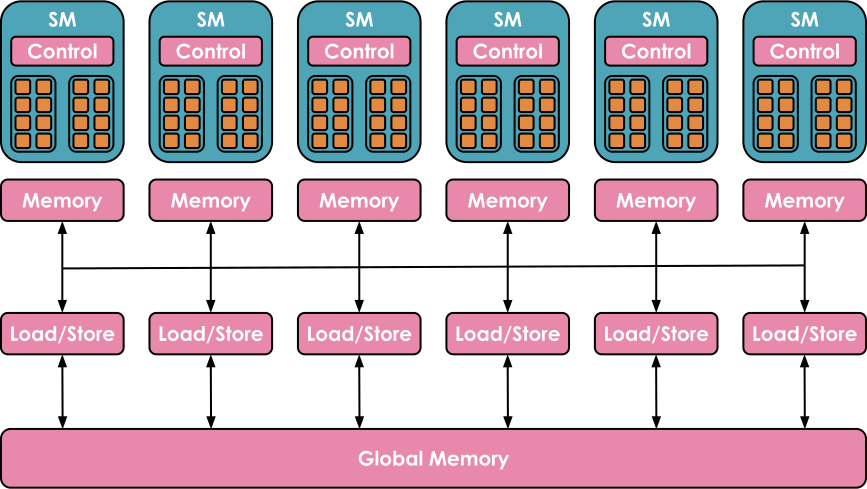
GPU 的计算层次结构:线程(Thread) → Warp → SM
-
线程(Thread)
- 线程是最小执行单位,它可以执行一段标量指令,有自己的私有寄存器
- GPU 上的线程不会单独调度
-
Warp(真正的调度单位)
- 线程被分组为 Warp,每个 Warp 包含 32 个线程
-
Warp 中的所有线程同步,它们执行同一条指令,但处理不同的数据
-
即 SIMT —— Single Instruction, Multiple Threads
-
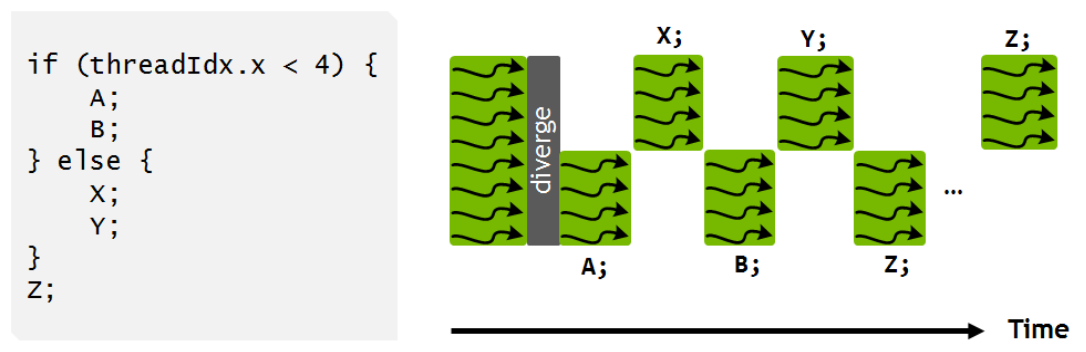
对于 if /else 分支,不同的线程会走不同的分支,会被串行执行(warp divergence),因此 GPU 极其不适合复杂的控制流
-
SM(并行计算核心)
- GPU 的基本计算单元是流式多处理器(Streaming Multiprocessor, SM)
- GPU 由多个 SM 组成,每个 SM 同时驻留多个 Warp
- 每个 SM 包含若干流处理器 / 核心(core),例如 NVIDIA H100 GPU 包含 132 个 SM,每个 SM 包含 128 个核心,总共 16,896 个核心
- SM 中的每个核心可以同时处理多个线程(threads)
- GPU 的高性能效果,实际上来自于用并行掩盖延迟:当一个 Warp 等待内存时,SM 立刻切换到另一个 Warp
- 在 GPU 上,一次核函数调用由一个或多个流式多处理器(SM)执行
-
GPU 的使用受制于各层内存大小、warp 内线程数和 block 数量,合理分配这些资源,可实现 GPU 的高效利用
-
-
内存层次结构
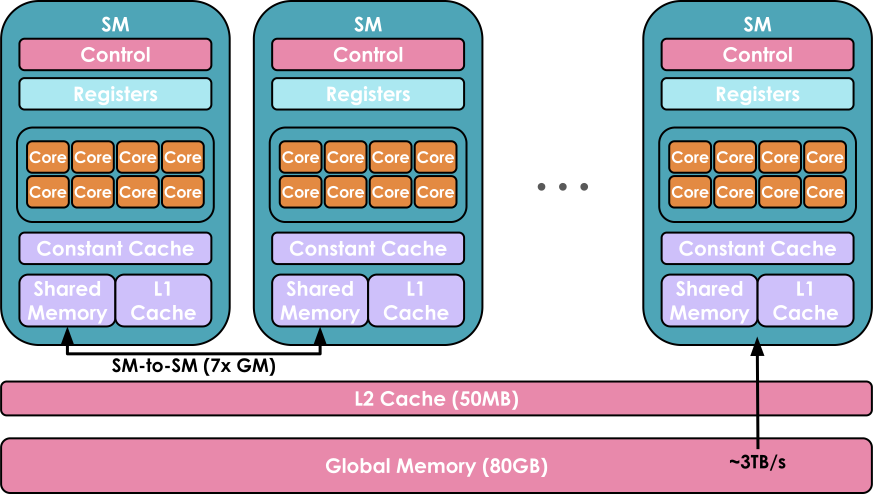
- GPU 内存同样高度分层,包含多层缓存和内存
内存层级 作用 共享对象 特点 寄存器(Registers) 最小单元,线程私有 线程私有 访问最快,容量最小 共享内存(Shared Memory) SM 内线程共享 同一个 SM 内的所有线程 速度快,容量中等 L1 Cache SM 内线程共享 同一个 SM 内的所有线程 速度快,容量中等 L2 Cache 所有 SM 共享 全 GPU 较大、访问比 L1 慢 全局内存(Global Memory) GPU 最大内存 全 GPU 容量大(H100 为 80GB),访问最慢 -
使用 GPU 时的目标是利用计算 / 内存资源的层级组织,尽可能多的工作负载并行运行于可用核心上
-
GPU 的算子性能,80% 是内存访问决定的,不是算力不够,而是数据移动瓶颈、memory access 不连续、cache 命中率低
-
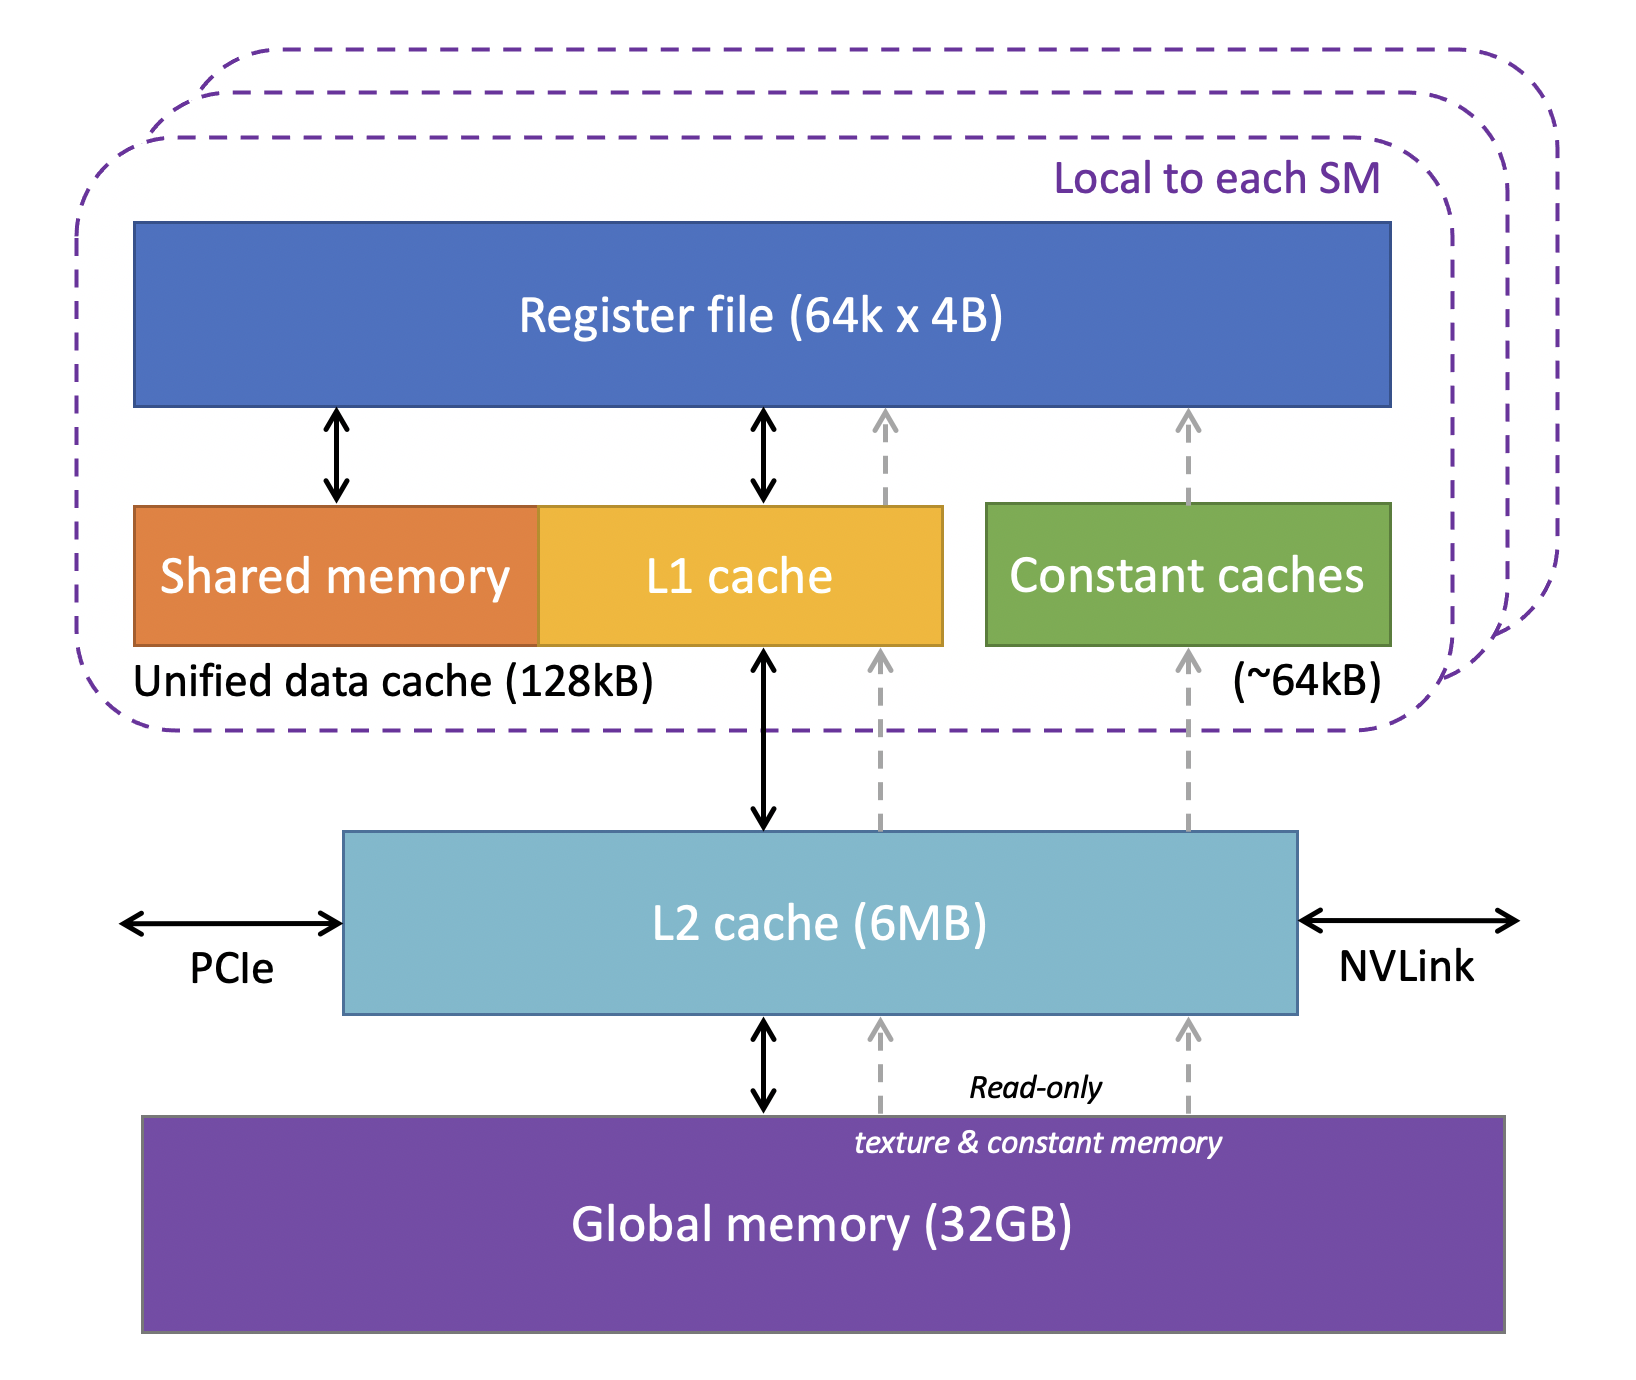
Tesla V100 的内存组织架构
-
片上存储(SRAM)
- 寄存器文件(Register File)
- 直接为 CUDA 核心提供数据的专属存储区域,其硬件架构被划分为 32 个存储体(bank),与线程束(warp)的 32 个线程数量对应
- 可以将寄存器文件理解为一个由 4 字节数据单元构成的大型矩阵,包含若干行与 32 列;线程束以整行为单位进行数据操作,在某一行内,每个线程(对应一个 CUDA 核心)分别对不同列(对应不同存储体)的数据执行运算
- 一级缓存(L1 Cache)
- 即常规的片上高速缓存,可为近期从主存(RAM)读取或向主存写入的数据提供高速访问能力
- 当活跃数据量超出 SM 寄存器文件的存储上限时,L1 缓存会作为寄存器溢出(register spilling)的兜底溢出区域
- 在该场景下,L1 缓存中的缓存行与溢出寄存器会沿用寄存器文件的设计逻辑,同样按存储体划分组织
- 共享内存(Shared Memory)
- 共享内存与 L1 缓存物理上同属一块片上存储区域,核心差异在于:共享内存中的所有数据可被一个线程块(thread block)内的任意线程访问,这为线程间的通信与数据共享提供了硬件支撑
- 共享内存中的变量需由应用程序显式声明,且开发者可通过程序配置调整 L1 缓存与共享内存的存储空间划分比例
- 常量缓存(Constant Caches)
- 针对全局内存中声明为只读常量的变量设计的专用高速缓存,这类常量变量可被一个线程块内的任意线程读取
- 该缓存的核心且最优的应用场景为:向一个线程束内的所有线程广播同一个常量值,借助硬件特性实现高效的批量数据分发
- 寄存器文件(Register File)
-
离 CUDA Core 较远的存储结构
- L2 Cache
- 片上高阶缓存,用于暂存流多处理器(SM)与主存之间交互的各类数据副本
- 可以视为设备内存的中介缓存 / 代理缓存,设备内存的所有访问操作均经由 L2 Cache 完成,当需要为新数据腾出空间时,缓存中最久未被访问的数据会根据缓存淘汰策略,被回写至设备内存中
- 与 L1 Cache 相同,L2 Cache 的设计初衷是为后续数据重加载提供加速;但与独立的各 L1 缓存不同,GPU 中仅配备一个全局 L2 Cache,由所有流多处理器(SM)共享使用
- L2 Cache 还部署在设备通过 PCIe 或 NVLink 进行片外数据传入 / 传出的核心数据通路上,是设备与外部交互的必经缓存层
- 全局内存(Global Memory)
- 全局内存是设备主存的核心组成部分,对应 CPU 架构中的随机存取存储器(RAM)
- 为了性能优化,不同型号的 GPU 都搭载了专属高速主存:如 Tesla V100 配备了高性能的第二代高带宽内存(HBM2),而 Quadro RTX 5000 则采用了高速图形双倍数据率 6 代内存(GDDR6)
- 纹理内存与常量内存(Texture and Constant Memory)
- 设备主存中被定义为只读属性的存储区域,所有 SM 都可以访问
- 当这类内存中的数据被调取至 SM 后,以 “纹理” 或 “常量” 关键字声明的变量,可以被核函数(kernel)内的任意线程访问,相当于功能扩展型的共享内存
- 其中,纹理内存的缓存由一级缓存(L1)实现,而常量内存则依托专用的常量缓存完成数据缓存
- 本地内存(Local Memory)
- 主存中为每个 SM 单独映射的专属存储区域,仅每个 SM 单独可访问
- 当某一 SM 发生寄存器溢出且数据量超出一级缓存(L1)承载上限时,多余数据会被进一步转存至二级缓存(L2),最终写入本地内存
- 寄存器溢出数据的重加载性能损耗会随数据调取所需遍历的存储层级增加而显著增大
- 全局数据的一致性(write-through 策略)
- 当 SM 对全局数据执行写操作时,L1 缓存中对应的数据行会立即写入 L2(写透策略),这样 L2 总是保持全局数据的最新版本
- 因为 L2 是共享的,不同 SM 访问全局数据时,都会通过 L2 获取一致的值,GPU 不需要像 CPU 那样使用复杂的互连来维持各个 L1 之间的一致性
- 本地数据的一致性(write-back 策略)
- 当 SM 对本地数据执行写操作时,L1 缓存中的数据不必立即写回 L2(写回策略),因为 L2 中的本地内存是预留给单个 SM 的,不会被其他 SM 访问
- 因此,L1 可以暂时保留修改,不必立即同步到 L2,这也可以提高性能,因为减少了写 L2 的频率
- 当 L1 缓存行需要腾出空间时,才会写回 L2
- L2 Cache
-
缓存行的大小设计
- 4 字节操作数在 GPU 的缓存、寄存器和 CUDA 核心之间传输时,如果按 32 个为一组进行整体传输,会带来显著的性能优势
- 这是因为一个包含 32 个操作数的分组,正好可以一次性为一个由 32 个线程组成的线程束(warp)提供所需的数据,因此 GPU 的缓存行通常设计为 32 × 4 字节,即 128 字节
- 如果缓存行设计过小,例如 64 字节,一个线程束的 32 个操作数就需要分两次传输,从而增加内存访问延迟,显著降低并行计算效率
- 而如果缓存行设计过大,则会造成缓存空间浪费,降低缓存命中率
-
通信 - 计算重叠的开销
- 显存碎片:显存池频繁申请释放不同大小块导致不连续空闲区,会 OOM、延迟毛刺。推理用 PagedAttention 解决,训练用内存池和固定 shape
- 通信操作需要 kernel launch:AllReduce/AllGather 都由 GPU kernel 完成,会占用 SM,也有启动开销,所以要做通信计算重叠来掩盖延迟
GPU 性能瓶颈模型
-
GPU 的性能,本质上取决于:
- 计算资源(ALU / Tensor Core)
- 内存带宽(从 DRAM 到寄存器的链路)
- 并行度(SM 内的 warp 调度、线程数)
-
计算平台的两个指标
-
算力
-
也称为计算平台的性能上限,指的是一个计算平台倾尽全力每秒钟所能完成的浮点运算数,单位是
FLOP/s -
是计算单元数量, 是主频,IPC 是每周期可完成的运算量(Tensor Core 场景下通常远大于 1)
-
-
带宽
- 也即计算平台的带宽上限,指的是一个计算平台倾尽全力每秒所能完成的内存交换量,单位是
Byte/s
- 也即计算平台的带宽上限,指的是一个计算平台倾尽全力每秒所能完成的内存交换量,单位是
-
计算强度上限
- 两个指标相除即可得到计算平台的计算强度上限,它描述的是在这个计算平台上,单位内存交换最多用来进行多少次计算,单位是
FLOP/Byte
- 两个指标相除即可得到计算平台的计算强度上限,它描述的是在这个计算平台上,单位内存交换最多用来进行多少次计算,单位是
-
-
模型的两个指标
-
计算量
-
指的是输入单个样本(对于 CNN 而言就是一张图像),模型进行一次完整的前向传播所发生的浮点运算个数,也即模型的时间复杂度
-
单位是
#FLOPorFLOPs,例如卷积层的计算量公式如下: -
:每个卷积核输出特征图(Feature Map)的边长
-
:每个卷积核(Kernel)的边长
-
:每个卷积核的通道数,也即输入通道数,也即上一层的输出通道数
-
:本卷积层具有的卷积核个数,也即输出通道数
-
其中,输出特征图尺寸本身又由输入矩阵尺寸 、卷积核尺寸 、、 这四个参数所决定,表示如下
-
-
访存量
-
指的是输入单个样本,模型完成一次前向传播过程中所发生的内存交换总量,也即模型的空间复杂度
-
在理想情况下(即不考虑片上缓存),模型的访存量就是模型各层权重参数的内存占用(Kernel Memory)与每层所输出的特征图的内存占用(Output Memory)之和,单位是 Byte
-
由于数据类型通常为 float32 ,因此需要乘以四
-
-
模型的计算强度 / 算术强度(Arithmetic Intensity)
-
由计算量除以访存量就可以得到模型的计算强度,它表示此模型在计算过程中,每 Byte 内存交换到底用于进行多少次浮点运算,单位是
FLOPs/Byte -
可以看到,模计算强度越大,其内存使用效率越高
-
-
模型的理论性能 :最关心的指标,即模型在计算平台上所能达到的每秒浮点运算次数(理论值),单位是
FLOPS或FLOP/s
-
-
算力瓶颈
- 在算力瓶颈中,GPU 的执行单元(CUDA Core、Tensor Core、SFU 等)已经接近满负载运行,而内存系统还有富余,此时程序的性能主要受限于单位时间内能执行多少条算术或矩阵指令
- GPU 的峰值算力也即上文提到的计算平台的指标之一 —— 算力
- 如果 kernel 的实际吞吐率已经逼近 ,那么再去做诸如减少访存、增加 cache 命中率之类的优化,往往几乎看不到收益,因为瓶颈不在内存而在计算单元本身
- 典型例子包括大规模矩阵乘、卷积在高复用率下的核心计算阶段
-
内存带宽瓶颈
- 当 kernel 的执行速度主要受限于数据拷贝速度时,就进入了内存带宽瓶颈区间,这在 embedding lookup、稀疏访问、注意力中的 KV cache 读取等场景尤为常见
- GPU 的显存系统有一个理论带宽上限,也即上文提到的计算平台的指标之一 —— 带宽
- 而 kernel 的实际性能往往取决于单位时间内需要从显存中读写多少字节
- 一个非常核心的衡量标准是模型的算术强度,当 很低时,哪怕 GPU 的算力再强,也会因为 “算得太少、搬得太多” 而被内存拖慢,这类瓶颈的本质不是 “GPU 不够快”,而是 “数据供不上”
-
Roofline 模型:模型在一个计算平台的限制下,到底能达到多快的浮点计算速度
- Roofline 认为模型的理论性能上限满足
- 其示意图如下
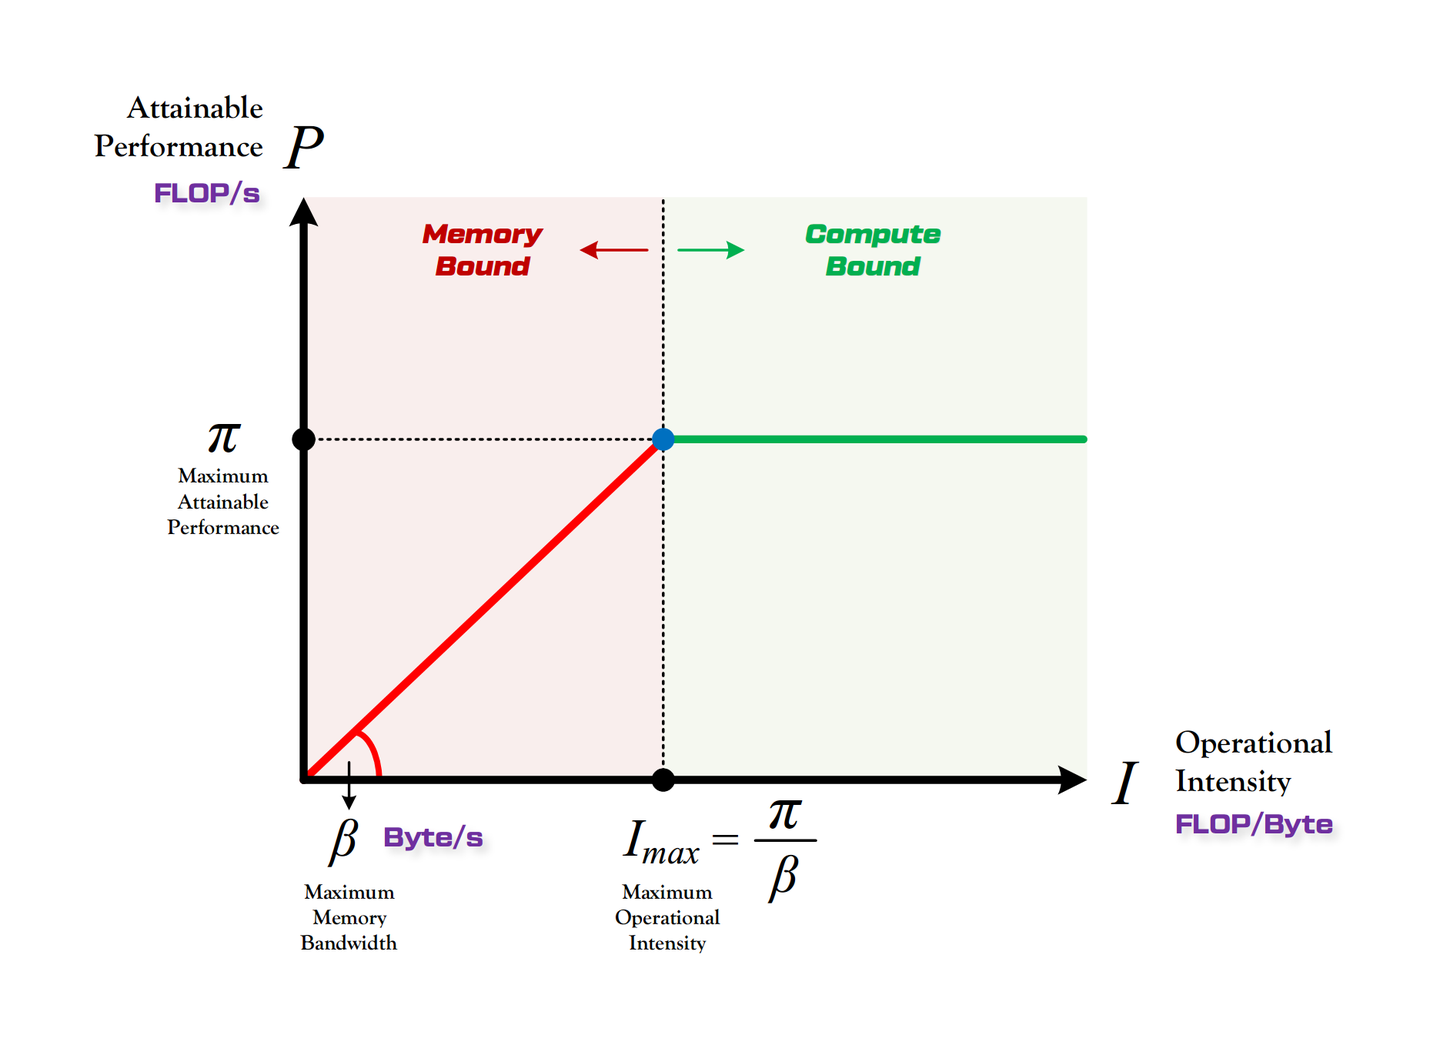
- 可以看到,最高算术强度为
-
当 时,性能由内存带宽决定;反之则由算力决定 —— 算力决定屋顶的高度,而带宽决定屋檐的斜率
-
Roof-line Model 解决的,是计算量为 A 且访存量为 B 的模型在算力为 C 且带宽为 D 的计算平台所能达到的理论性能上限 E 是多少这个问题
-
在大模型推理中,attention 的 score 计算往往接近算力屋顶,而 KV cache 的读取阶段则明显落在带宽斜线区域
-
延迟与并行度瓶颈(Latency & Occupancy)
-
即便既不是算力瓶颈,也不是带宽瓶颈,GPU 程序仍然可能很慢,其原因通常是延迟无法被隐藏
-
GPU 的核心思想是用大量线程来掩盖长延迟操作(如 global memory load):如果每个 SM 上活跃的 warps 数量不足,或者寄存器 / 共享内存占用过高导致 occupancy 下降,那么一旦线程遇到长延迟,就没有其他 warp 可以切换执行,硬件只能空转
-
这类瓶颈的典型表现是:理论带宽没打满、算力也没打满,但 SM 利用率很低
-
根源不是硬件能力不足,而是并行度不够或资源分配不合理
-
可以用 Occupancy 来衡量并行度:
-
SM 的资源是有限的,比如 register 总量、shared memory 总量、最大线程数、最大 block 数等都是有限的
-
假如一个 SM 有 65536 个 register,每个 thread 用 64 个 register,那么线程数最多为 1024 个
-
Occupancy 越高,说明正在使用的 warp 越多,但每个 warp 算的慢(内存多、复用少),而使用 Register Blocking 后,使用的 warp 变少,但是每个 warp 计算密度高
-
很多时候,低一点 occupancy + 高算术强度 = 更快,在真实高性能 kernel 中 Occupancy 常常只有 30%~60%,但此时性能是峰值,因为内存访问已经被压到最低
-
-
控制流与指令级瓶颈
- GPU 是 SIMT 架构,warp 内线程执行同一条指令;当存在严重分支发散时,同一个 warp 内的不同路径会被串行执行,等价于降低了有效并行度,而这类瓶颈在复杂条件判断、稀疏结构遍历中很常见
- 此外,指令混合也可能成为限制因素,例如大量依赖链导致指令级并行度(ILP)不足,或者 SFU 指令(exp、log、sqrt)占比过高,使特定执行单元成为热点
-
系统层瓶颈(Kernel 粒度与调度)
- 在真实系统中,GPU 性能还可能被更 “外层” 的因素限制,例如 kernel 太小导致 launch overhead 占比过高,或者频繁 kernel 切换、PCIe/NUMA 访问、CPU–GPU 同步等
- 这些瓶颈不体现在单个 kernel 的 Roofline 上,但会显著拉低端到端吞吐
- 在大模型 serving 场景中,batch size 过小导致 GPU 处于 “算力和带宽都没吃饱” 的状态,本质上就是一种调度层面的瓶颈
-
GPU kernel 的性能瓶颈,本质上不是由某一个单独因素决定的
- 而是由 Roofline 模型、并行度(Occupancy)以及内存层级结构(Memory Hierarchy)三者的共同约束所决
- Roofline 给出了算力与带宽的理论上限,Occupancy 决定这些上限能否在现实执行中被逼近,而内存层级则决定数据在不同速度层次之间流动时的真实成本
- 这三者叠加在一起,构成了判断一个 kernel “为什么慢、慢在哪里、还能不能再快” 的完整框架
-
因此,从结果形态上看,kernel 的瓶颈通常会落入三种基本类型之一
- 内存带宽受限:也就是算术强度较低,性能主要由 DRAM 或更低层级内存的吞吐能力决定;这时优化的核心不是 “算得更快”,而是 “让数据走得更短、更顺”,例如使用 shared memory 做 tiling、通过更好的 memory coalescing、减少不必要的全局访存,或者避免 shared memory 的 bank conflict
- 算力受限:即 kernel 已经接近 GPU 的峰值 FLOPs,此时性能提升依赖于更高效地利用计算单元,包括更合理的寄存器使用(Register Blocking)、更高的指令级并行度、Tensor Core 的充分利用,以及更好的指令调度、Fused Kernels
- 延迟受限:这类 kernel 往往既没有打满算力,也没有打满带宽,但仍然很慢,其根本原因在于延迟没有被足够的并行度隐藏,此时需要从 warp 调度、occupancy、Launch Overhead、persistent kernel 或线程粗化等角度入手
-
在实践中,一条相对稳健的优化路径通常是:先通过算术强度判断算力与带宽的主导关系,再检查寄存器、shared memory 和 warp 分布等资源占用情况,明确是否存在并行度或调度层面的限制,随后选择与瓶颈类型相匹配的优化手段,并在每一次修改后重新测量性能,观察瓶颈是否发生转移
-
Memory-bound 优化路线:降低访存次数,提高数据复用率
- 第一步:访问模式 —— 如何高效地将数据从 DRAM 拷贝到片上存储
- Memory Coalescing:warp 内线程访问连续地址以充分利用 cache line /memory segment
- Layout Transformation(AoS ↔ SoA):调整数据存储布局以优化访问连续性
- 数据重排 / Padding / Alignment:对齐数据、填充空位以减少非对齐访问和伪共享
- 第二步:数据复用 —— 通过尽可能复用已经拷贝的数据,来减少内存访问次数
- Block Tiling:将全局内存数据划分为可重复利用的块,减少 DRAM 访问
- Warp Tiling:在 block 内进一步划分 warp 工作负载,实现局部复用
- Thread / Register Tiling:更细粒度的数据复用,充分利用寄存器和线程局部存储
- 第三步:片上存储优化 —— 优化片上存储的并行访问
- Bank Conflict:优化 shared memory 访问,避免不同线程访问同一 bank 产生冲突
- Register Blocking:通过寄存器划分和复用,提高片上并行访问效率
- 第一步:访问模式 —— 如何高效地将数据从 DRAM 拷贝到片上存储
-
Compute-bound 优化路线:提升指令级并行度与算力密度,充分利用专用硬件单元
- 第一步:指令级并行度与流水线效率 —— 执行单元是否能保持高利用率,减少依赖链阻塞
- Thread Coarsening:增加每个线程的工作量以提升指令级并行度(ILP)
- 减少长依赖链:优化指令调度,缩短关键路径
- 第二步:Kernel 优化 —— 减少不必要的延迟开销和气泡,提升算力密度
- Fused Kernels:将多个 kernel 融合,减少中间结果读写和依赖延迟
- Pipeline Kernel:流水线处理多个计算阶段,提高连续计算密度
- 第三步:专用计算单元与指令调度
- Tensor Core 利用:调用专用硬件单元加速矩阵运算
- Instruction Scheduling:优化指令顺序,减少 SFU 或其他执行单元热点
- 该层通常由框架或编译器完成,但手写 kernel 时仍然关键
- 第一步:指令级并行度与流水线效率 —— 执行单元是否能保持高利用率,减少依赖链阻塞
-
Latency-bound 优化路线:隐藏硬件不可避免的延迟,保持执行单元持续工作
- 第一步:Occupancy 与可调度性 —— 是否有足够可调度的 warp 来隐藏延迟
- Register / Shared Memory 占用控制:限制资源使用以提升 occupancy
- Block 配置优化:合理设置线程块大小,避免过度占用资源
- Warp 数量充足:保证 scheduler 有足够 warp 切换执行
- 第二步:调度结构优化
- Persistent Kernel:持久化 kernel 以减少重复调度开销
- Launch Overhead:降低启动 kernel 的延迟
- Software-managed work queue:软件层面管理任务分发,提升调度效率
- 第三步:执行路径稳定性 —— 减少分歧和同步
- 最小化 Control Divergence:减少 warp 内分支差异
- 减少不必要的同步:降低延迟叠加
- 分支和同步优化:保持峰值算力不变的情况下降低延迟放大效应
- 第一步:Occupancy 与可调度性 —— 是否有足够可调度的 warp 来隐藏延迟
-
MFU
-
MFU(Maximum FLOPs Utilization)指的是 GPU 实际算力消耗占理论峰值算力的百分比,它衡量 GPU 的 “满载” 程度:
- 理论 FLOPs:GPU 在给定精度(如 FP32、FP16、BF16)下每秒最多能执行的浮点运算次数
- 实际 FLOPs:GPU 在训练 / 推理过程中每秒实际执行的浮点运算次数
-
计算公式
-
首先要统计模型的计算量,对于 Transformer 类模型,常用的估算公式(以前向计算为例):
-
Self-Attention (每层):
-
MLP (Feed-Forward) 每层:
-
然后累加所有层,并乘以 batch size 得到每个 step 的 FLOPs
-
乘以 2 是因为前向和反向都要计算(梯度计算 FLOPs 通常是前向的 2-3 倍)
-
-
然后结合吞吐率(Throughput),假设已经知道每秒处理的样本数(tokens 或 batch):
-
例如,每秒训练 1000 个序列,每个序列 1024 token,模型每 token 前向 + 反向需要 10 GFLOPs,那么:
-
理论峰值 FLOPs 通常可以在 GPU 数据手册查到,例如:
- NVIDIA RTX 4090*- FP32 理论峰值约 82.6 TFLOPs,FP16 Tensor Core 可达 330 TFLOPs
- 计算公式:
-
Tensor Core 的情况要区分 FP16/BF16,因为每个 Tensor Core 每个时钟周期可以做多个 MAC(乘加)操作
-
计算 MFU 示例,假设用 4 张 4090 训练一个 350M 模型:
-
每步实际 FLOPs:0.1 TFLOPs
-
Step/s:50
-
那么实际 FLOPs/s:0.1 × 50 = 5 TFLOPs/s
-
单张 4090 FP16 理论峰值:330 TFLOPs
-
4 张 GPU 理论峰值:1320 TFLOPs
-
MFU:
-
很低,说明 GPU 大部分时间没在做计算,可能瓶颈在 显存带宽、通信、数据加载或 Kernel 利用率不高
-
-
高 MFU(大于 50%-70%):表示训练很高效,GPU 充分利用
-
低 MFU (小于 30%):可能存在瓶颈,需要优化 batch size、分布式策略、内核调度或混合精度
-
MFU 与吞吐率直接相关,是评估模型训练效率的重要指标
-