CUDA Stream
介绍 CUDA Stream 的基本概念、CUDA Stream 的创建与管理、CUDA Stream 的同步与异步操作等内容
CUDA Stream
-
GPU 的执行模式
- 潜意识中,可能会认为 GPU 的执行流程是这样的:
CPU 调用 → GPU 立刻执行 → GPU 算完 → 返回 CPU - 但实际上,CPU 不会等待 GPU 执行完成,CPU 创建任务并提交给 GPU 后就会立即执行其他流程,而 GPU 则是异步执行设备,它自己对 CPU 提交的任务进行排队和执行
- 潜意识中,可能会认为 GPU 的执行流程是这样的:
-
CUDA Stream
-
CUDA 的设计目标是尽可能发挥并行能力,它要求开发者通过流(stream)来定义高层次的并行操作
-
CUDA Stream 是 GPU 上的一条指令队列(command queue),这条队列里可以包含
-
计算任务:kernel launch
-
数据拷贝:memcpy(H2D / D2H / D2D)
-
通信任务:AllReduce
-
事件:event
-
清空内存:memset
-
-
每次内核(kernel)调用都会被放入某个 stream 中,即使没有显式指定 stream,它也会使用默认流(default stream,又称 NULL 流或 stream 0)
-
当一个指令被放入 stream 中时,它会进入该 stream 的先进先出(FIFO)队列,GPU 会先执行队列中第一条指令的线程块,执行完毕后,再执行下一条指令,直到队列中的所有指令执行完毕
-
不同的 stream 默认没有顺序关系,可以并发执行(如果资源允许),这也是设计 Stream 的初衷,即允许 GPU 并行调度不同任务流,使得计算 A、同时拷贝 B、同时通信 C 可以并行执行,从而大幅提升 GPU 利用率 —— 这也是一种计算与通信、数据拷贝中间重叠的一种关键实现
-
一个 stream 的例子
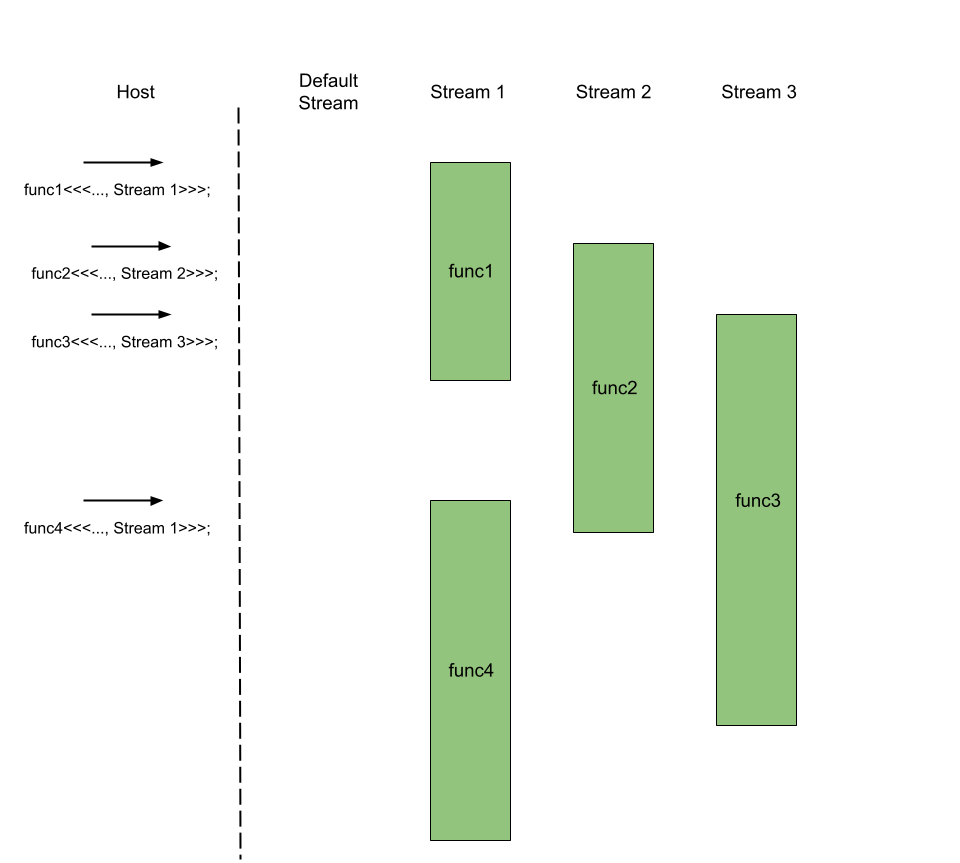
-
-
使用 stream 的步骤如下:
-
声明一个
cudaStream_t类型的变量 -
用
cudaStreamCreate()初始化 stream -
调用内核时,将流变量作为执行配置的第四个参数传入(第三个参数是内核动态分配的共享内存大小)
-
程序结束时,用
cudaStreamDestroy()销毁 stream -
示例代码
cudaStream_t stream1;
cudaStreamCreate(&stream1);

// 在 stream1 中调用内核
func<<<1, 1024, 0, stream1>>>();

...

cudaStreamDestroy(stream1);
-
-
Default stream
-
没有显式指定 stream 的操作,都会进入 Default stream(stream 0,NULL 流)
-
例如
x = torch.matmul(a, b)在 PyTorch 中,本质是会把kernel launch → default stream -
早期设计中,Default stream 是特殊 stream,任何 stream 都要等待 Default stream,Default stream 也要等待所有 stream,也即 Default stream 被设计成了一个全局同步机制,这使得看似可以并行的多个 stream 变成了串行执行
-
而在现在的设计中,改为了 Per-thread Default Stream,每个 CPU 线程拥有独立的 Default stream,不在自动同步其他 stream
-
default stream 的示例
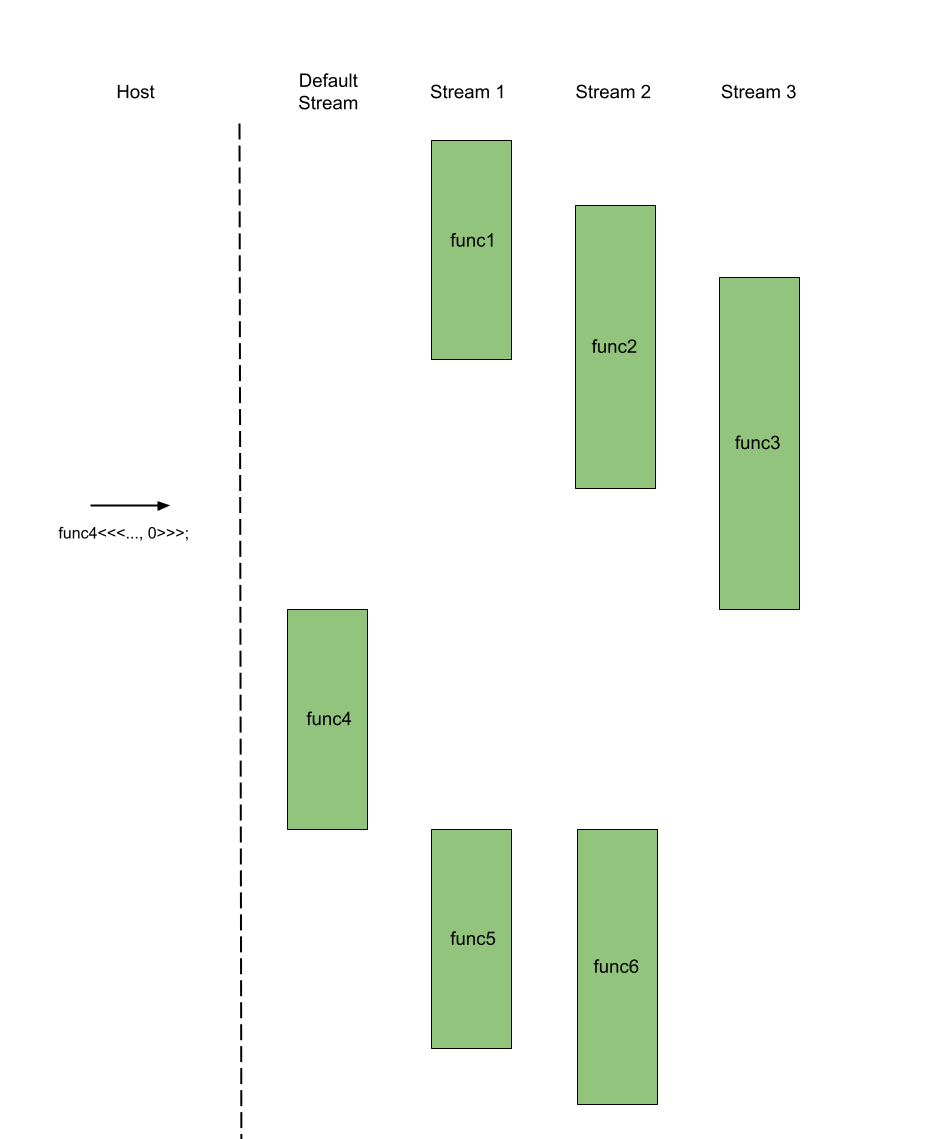
-
-
强制同步
- 不同 stream 的内核完成顺序是不确定的,如果需要控制不同 stream 中内核的执行顺序,CUDA 提供了同步机制(如
cudaStreamSynchronize、事件(event)等) .item()、.cpu()、torch.cuda.synchronize()都会强制同步 GPU- 前面提到的 Dataloader 的
pin_memory=True和non_blocking=True,就是为了让 memcpy 操作能够进入 Stream 中并行执行,否则 CPU 会同步等待
- 不同 stream 的内核完成顺序是不确定的,如果需要控制不同 stream 中内核的执行顺序,CUDA 提供了同步机制(如
-
异步内存传输
-
CUDA 的内存传输模型中,
cudaMemcpy占用主机 CPU 和默认流,这会导致一次只能进行一个同步内存传输 -
如果使用非默认流,则可以使用异步内存传输(
cudaMemcpyAsync),实现 GPU 与 CPU 的并行工作 -
异步传输的关键是
-
使用固定内存(pinned memory),即不会被交换到磁盘,使得系统可以使用 DMA(Direct Memory Access)直接在主机和设备间传输数据
-
通过非默认流执行内存传输,避免阻塞默认流和其他非默认流,从而 CPU 和 GPU 可以同时继续执行其他任务
-
-
示例代码
// 分配固定内存 int *h; cudaMallocHost((int**) &h, SIZE); // 分配设备内存 int *d; cudaMalloc(&d, SIZE); // 创建并初始化流 cudaStream_t stream1; cudaStreamCreate(&stream1); // 异步内存传输 cudaMemcpyAsync(d, h, SIZE, cudaMemcpyHostToDevice, stream1); // 在 stream1 上执行内核 func<<<1, 1024, 0, stream1>>>(d); ... cudaFree(h); cudaFree(d); cudaStreamDestroy(stream1); -
异步内存传输的示例如下
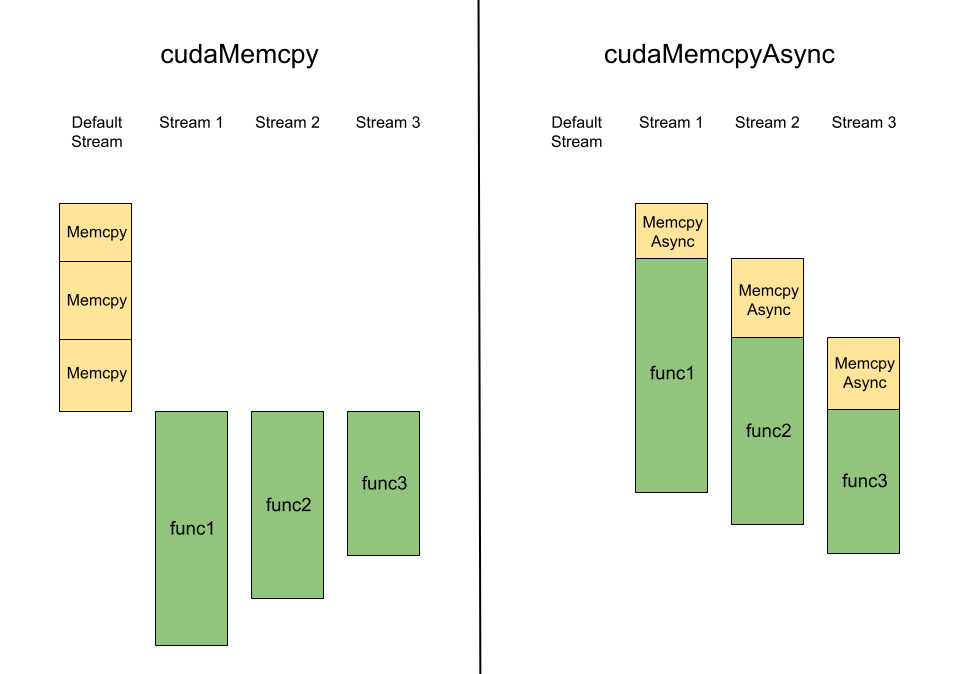
-
-
Stream 的一些误区
- Stream ≠ 线程,CPU thread 可以控制多个 stream,而 stream 是 GPU 队列
- Stream 不能强制并发、自动优化性能、避免资源冲突,它只是允许 GPU 有机会并发
- 在自定义算子优化、通信计算重叠、流水线并行、数据预取等场景中,就需要自己写 Stream 来实现
- 实际上,Stream 只定义依赖关系和执行顺序,而 CUDA Runtime / Driver 将任务翻译为 GPU 可执行任务,由 GPU Hardware Scheduler 来进行 SM 资源分配、Warp 调度、执行重叠、延迟隐藏、冲突回避(部分)
- 因此,开发者就需要写出容易被 GPU 高效执行的代码
CUDA 同步
-
在 CUDA 程序中存在许多并行组件,因此自然会有多种同步方法对应不同组件,主要有三类同步方法:
- 主机端同步(Host-Side Synchronization)
- 设备端同步(Device-Side Synchronization)
- 线程级同步(Thread-Level Synchronization)
-
同步的定义
- 同步指的是将两个或多个进程带到已知的执行点,当一个进程必须等待另一个进程到达某个执行点后才能继续时,前者就被阻塞
- 在 CUDA 中,由于存在大量并行进程,因此需要明确到底是哪一类进程在同步
-
主机端同步
-
主机端同步指的是主机(CPU)等待设备(GPU)或特定流完成任务
- 主机在读取 GPU 输出之前,需要等待所有内核完成
- 主机在启动新的内核前,需要确保设备完成某些任务
-
主机端同步的方法:
-
cudaDeviceSynchronize():等待设备上所有流中的内核完成 -
cudaMemcpy(...)和cudaFree(...):虽然本身用于内存操作,但它们隐式阻塞主机,等待设备完成当前队列中的所有内核 -
cudaStreamSynchronize(stream):只等待指定流完成
-
-
一个例子
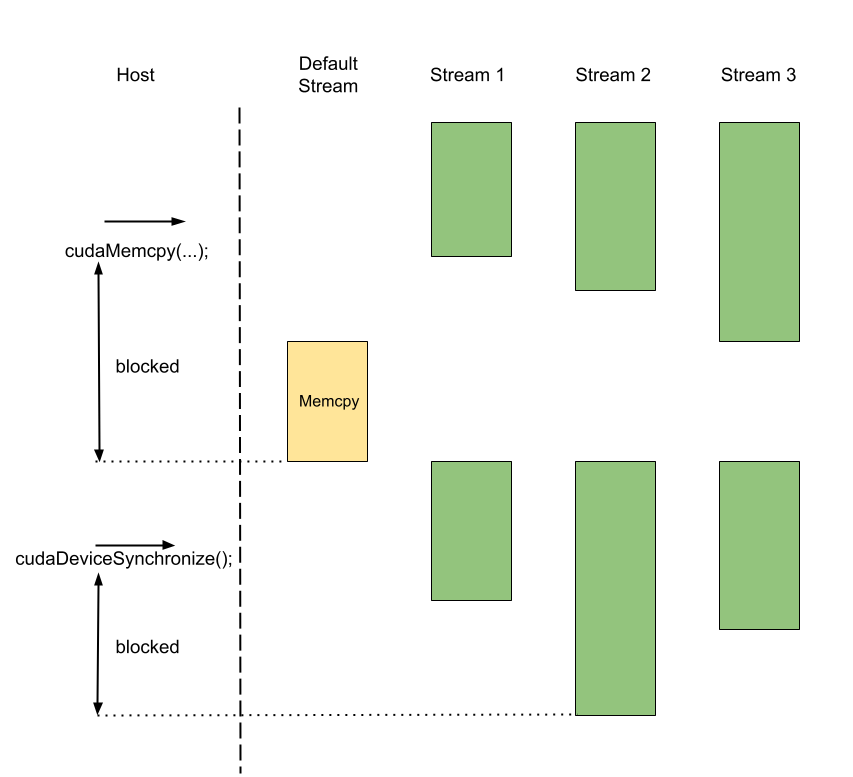
- 在上面的例子中,主机调用
cudaMemcpy,所有流被隐式同步;在调用cudaDeviceSynchronize()后,主机和所有流必须等待最慢的流完成
-
-
设备端同步
-
设备端同步发生在 GPU 内部,它允许非默认流与其他非默认流同步,默认流与所有流同步
-
设备端同步不影响主机的行为(主机端同步可以影响设备)
-
在默认流中启动内核时,会阻塞默认流直到其他流的活动内核完成;之后在默认流中启动的内核,也会被阻塞,直到默认流完成
-
类似行为也适用于
cudaMalloc和cudaMemcpy -
CUDA 提供了事件(event)机制来在流间同步,事件类型:
cudaEvent_t,相关函数有-
cudaEventCreate():创建事件 -
cudaEventRecord():在流中记录事件 -
cudaStreamWaitEvent():让另一个流等待事件
-
-
一个示例如下:
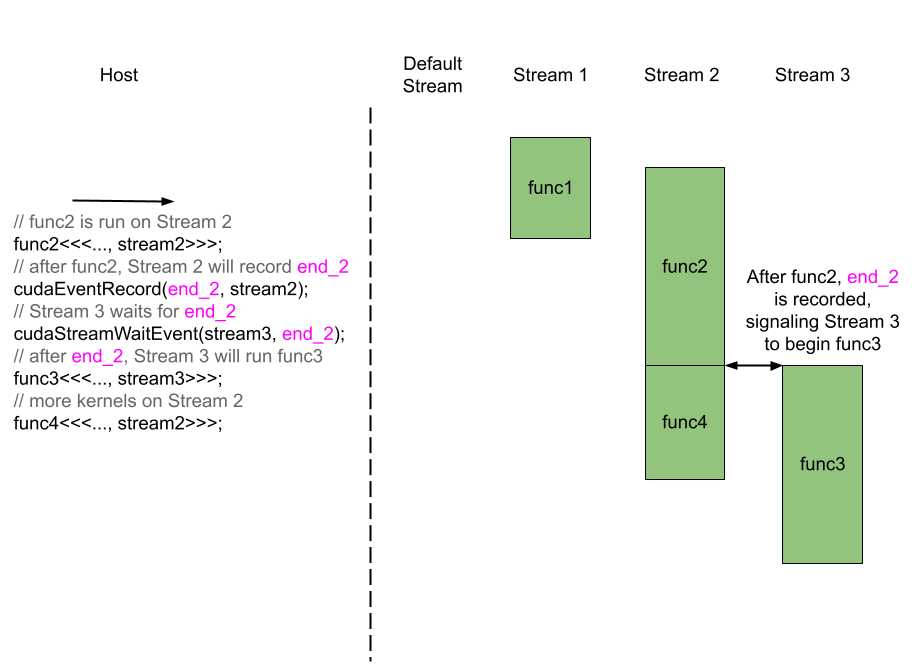
-
上述例子的执行流程:
- 主机创建事件
end_2并初始化
- 主机创建事件
-
主机在
stream2的内核执行到某个点时调用cudaEventRecord(end_2, stream2) -
stream3调用cudaStreamWaitEvent(stream3, end_2),阻塞自己直到事件被触发 -
stream2内核执行到事件点,记录事件,stream3收到信号后继续执行内核 -
程序结束后,需要调用
cudaEventDestroy()销毁事件 -
伪代码示例:
cudaStream_t stream2, stream3;
cudaStreamCreate(&stream2);
cudaStreamCreate(&stream3);

cudaEvent_t end_2;
cudaEventCreate(&end_2);

// 在 stream2 执行内核
func2<<<1, 1024, 0, stream2>>>();

// stream2 记录事件
cudaEventRecord(end_2, stream2);

// stream3 等待事件
cudaStreamWaitEvent(stream3, end_2);

// stream3 执行内核
func3<<<1, 1024, 0, stream3>>>();

// 清理
cudaStreamDestroy(stream2);
cudaStreamDestroy(stream3);
cudaEventDestroy(end_2);
-
-
线程级同步
-
在 CUDA 中,同一个线程块(block)内的线程通常不会同时完成任务,为了确保线程块内的所有线程在某个应用点同步,需要使用同步屏障(synchronization barrier)——
__syncthreads() -
注意:
__syncthreads()只作用于同一个线程块内的线程,其作用范围比之前介绍的其他 CUDA 同步函数(如cudaDeviceSynchronize()或cudaStreamSynchronize())更有限 -
__syncthreads()最常用于防止竞态条件(race condition) -
竞态条件的典型场景是:线程先把计算结果写入共享内存(shared memory),然后又尝试读取这些值,如果线程没有同步,就可能出现 “读取到还未计算或存储的值” 的情况
-
因此,如果一个线程使用了另一个线程更新的变量,就必须指定线程的执行顺序,否则结果不可预测
-
示例代码:
__global__ void func(int n, int *a, int *b, int *c) { // 声明共享内存 __shared__ int val[1024]; // 假设数组长度小于 1024 int idx = threadIdx.x + blockIdx.x * blockDim.x; if (idx < n) { // 各线程计算 a[idx] + b[idx],存入共享内存 val[idx] = a[idx] + b[idx]; } // 同步所有线程,确保共享内存数据可用 __syncthreads(); // 假设接下来要将当前 val 与下一个 val 相乘 if (idx < n - 1) { c[idx] = val[idx] * val[idx + 1]; } } -
在这个例子中,如果没有
__syncthreads(),线程可能在共享内存val中访问还未被其他线程计算或写入的元素,导致计算结果错误 -
线程同步通常会带来性能损失:
- 最早到达
__syncthreads()的线程必须等待最后一个线程 - 如果某些线程执行时间较长,资源会被占用在同步点上
- 同样的性能损失也存在于其他 CUDA 同步函数中
- 尽管如此,为了保证正确性,在必要时使用
__syncthreads()是必须的;开发者可以考虑是否有其他无需同步就能计算的方式,以避免同步开销
- 最早到达
-
使用
__syncthreads()的注意事项- 所有线程必须执行到同一个
__syncthreads(),如果某些线程由于分支语句(if/else)跳过了同步点,而其他线程到达了同步点,就会造成死锁(deadlock)—— 死锁的线程永远无法继续执行 - 正确的编程规则是,对于每个线程块,每个
__syncthreads()要么被块内所有线程执行,要么都不执行,避免在条件分支中单独执行同步屏障,除非保证条件一致
- 所有线程必须执行到同一个
-
使用示例
-
下面的例子演示了如何使用流(streams)和异步内存传输(asynchronous memory transfer)
-
原始代码实现了一个矩阵转置内核,每个线程负责矩阵的一个元素:
#include <stdio.h> #include <stdlib.h> #include <assert.h> // Both WIDTH and HEIGHT of a matrix is SIZE in this case #define SIZE 1024 __global__ void transpose(int *original_matrix, int *transposed_matrix) { int i = threadIdx.x + blockIdx.x * blockDim.x; int j = threadIdx.y + blockIdx.y * blockDim.y; if (i < SIZE && j < SIZE) { transposed_matrix[j * SIZE + i] = original_matrix[i * SIZE + j]; } } int main() { // Allocate the matrices int *original_matrix_h; int *original_matrix_d; int *transposed_matrix_h; int *transposed_matrix_d; size_t size = SIZE * SIZE * sizeof(int); original_matrix_h = (int *) malloc(size); transposed_matrix_h = (int *) malloc(size); // Allocate the matrices on device cudaMalloc((void**) &original_matrix_d, size); cudaMalloc((void**) &transposed_matrix_d, size); // Assign values to matrix for (int i = 0; i < SIZE; i++) { for (int j = 0; j < SIZE; j++) { original_matrix_h[i * SIZE + j] = i * SIZE + j; } } // Copy host matrix to device cudaMemcpy(original_matrix_d, original_matrix_h, size, cudaMemcpyHostToDevice); // Define block dimensions dim3 BlocksPerGrid(32, 32); dim3 threadsPerBlock(32, 32); // Kernel call transpose<<<BlocksPerGrid, threadsPerBlock>>>(original_matrix_d, transposed_matrix_d); // Copy result back to host cudaMemcpy(transposed_matrix_h, transposed_matrix_d, SIZE, cudaMemcpyDeviceToHost); // Validate the transposed matrix for (int i = 0; i < SIZE; i++) { for (int j = 0; j < SIZE; j++) { assert(transposed_matrix_h[i * SIZE + j] == original_matrix_h[j * SIZE + i]); } } // Free memory cudaFree(original_matrix_d); cudaFree(transposed_matrix_d); free(transposed_matrix_h); free(original_matrix_h); return 0; } -
在
main()中,原始矩阵在主机(host)分配、初始化后复制到设备(device),调用内核执行转置,然后将结果复制回主机并验证 -
为了展示流,需要不止一个内核调用,这里将原来的一次转置改成两次,分别操作两个不同的矩阵:
... int main() { // Allocate the matrices for two transposes int *original_matrix_h_1; int *original_matrix_d_1; int *original_matrix_h_2; int *original_matrix_d_2; int *transposed_matrix_h_1; int *transposed_matrix_d_1; int *transposed_matrix_h_2; int *transposed_matrix_d_2; size_t size = SIZE * SIZE * sizeof(int); original_matrix_h_1 = (int *) malloc(size); transposed_matrix_h_1 = (int *) malloc(size); original_matrix_h_2 = (int *) malloc(size); transposed_matrix_h_2 = (int *) malloc(size); // Allocate the matrices on device cudaMalloc((void**) &original_matrix_d_1, size); cudaMalloc((void**) &transposed_matrix_d_1, size); cudaMalloc((void**) &original_matrix_d_2, size); cudaMalloc((void**) &transposed_matrix_d_2, size); // Assign random values to matrices for (int i = 0; i < SIZE; i++) { for (int j = 0; j < SIZE; j++) { original_matrix_h_1[i * SIZE + j] = rand(); original_matrix_h_2[i * SIZE + j] = rand(); } } // Copy host matrices to device cudaMemcpy(original_matrix_d_1, original_matrix_h_1, size, cudaMemcpyHostToDevice); cudaMemcpy(original_matrix_d_2, original_matrix_h_2, size, cudaMemcpyHostToDevice); // Define block dimensions dim3 BlocksPerGrid(32, 32); dim3 threadsPerBlock(32, 32); // Invoke kernels transpose<<<BlocksPerGrid, threadsPerBlock>>>(original_matrix_d_1, transposed_matrix_d_1); transpose<<<BlocksPerGrid, threadsPerBlock>>>(original_matrix_d_2, transposed_matrix_d_2); // Copy results back to host cudaMemcpy(transposed_matrix_h_1, transposed_matrix_d_1, size, cudaMemcpyDeviceToHost); cudaMemcpy(transposed_matrix_h_2, transposed_matrix_d_2, size, cudaMemcpyDeviceToHost); // Validate the transposed matrices for (int i = 0; i < SIZE; i++) { for (int j = 0; j < SIZE; j++) { assert(transposed_matrix_h_1[i * SIZE + j] == original_matrix_h_1[j * SIZE + i]); assert(transposed_matrix_h_2[i * SIZE + j] == original_matrix_h_2[j * SIZE + i]); } } // Free memory cudaFree(original_matrix_d_1); cudaFree(original_matrix_d_2); cudaFree(transposed_matrix_d_1); cudaFree(transposed_matrix_d_2); free(transposed_matrix_h_1); free(transposed_matrix_h_2); free(original_matrix_h_1); free(original_matrix_h_2); return 0; } -
使用流
... // Declare and create two non-default streams cudaStream_t stream1; cudaStreamCreate(&stream1); cudaStream_t stream2; cudaStreamCreate(&stream2); ... // Kernel invokes on stream1 and stream2 transpose<<<BlocksPerGrid, threadsPerBlock, 0, stream1>>>(original_matrix_d_1, transposed_matrix_d_1); transpose<<<BlocksPerGrid, threadsPerBlock, 0, stream2>>>(original_matrix_d_2, transposed_matrix_d_2); ... // destroy streams after cudaStreamDestroy(stream1); cudaStreamDestroy(stream2); ... -
使用流可以让两个内核同时执行,从而实现并行化
-
为了实现异步传输,需要:
- 固定内存(pinned memory):使用
cudaMallocHost替代malloc - 流(stream):将异步内存传输与流绑定
- 设备同步:
cudaDeviceSynchronize()确保主机在验证结果前等待数据传回
- 固定内存(pinned memory):使用
-
最终实现
... // replaces malloc for pinned memory cudaMallocHost((int**) &original_matrix_h_1, size); cudaMallocHost((int**) &transposed_matrix_h_1, size); cudaMallocHost((int**) &original_matrix_h_2, size); cudaMallocHost((int**) &transposed_matrix_h_2, size); ... // Copy host matrices to device asynchronously using streams cudaMemcpyAsync(original_matrix_d_1, original_matrix_h_1, size, cudaMemcpyHostToDevice, stream1); cudaMemcpyAsync(original_matrix_d_2, original_matrix_h_2, size, cudaMemcpyHostToDevice, stream2); ... // Copy results back to host asynchronously using streams cudaMemcpyAsync(transposed_matrix_h_1, transposed_matrix_d_1, size, cudaMemcpyDeviceToHost, stream1); cudaMemcpyAsync(transposed_matrix_h_2, transposed_matrix_d_2, size, cudaMemcpyDeviceToHost, stream2); // This code is necessary, since the host must wait for the results to be copied back cudaDeviceSynchronize(); ... // pinned memory must be freed with cudaFree cudaFree(original_matrix_h_1); cudaFree(transposed_matrix_h_1); cudaFree(original_matrix_h_2); cudaFree(transposed_matrix_h_2); ... -
注意:即使没有使用 pinned memory,
cudaMemcpyAsync也不会报错,只是会退化为同步传输行为