CUDA 执行模型
介绍 CUDA 执行模型的基本概念,包括核函数、CUDA 的执行层级、线程索引体系等内容
核函数(Kernels)
-
核函数是运行在 GPU 核心上的代码
-
可以用高级语言编写,如 CUDA 或 Triton,例如在 CUDA C++ 中
__global__ void my_kernel(...) { ... } -
编译后生成并行线程执行 Parallel Thread Execution(PTX),即 NVIDIA GPU 的低级汇编
-
运行核函数还需要主机代码(host code),这些代码在 CPU 上执行,负责数据分配、加载数据和代码
-
kernel 与普通函数有两个本质区别,首先其不能返回值,其次会被大量线程并行执行
CUDA 的执行层级
-
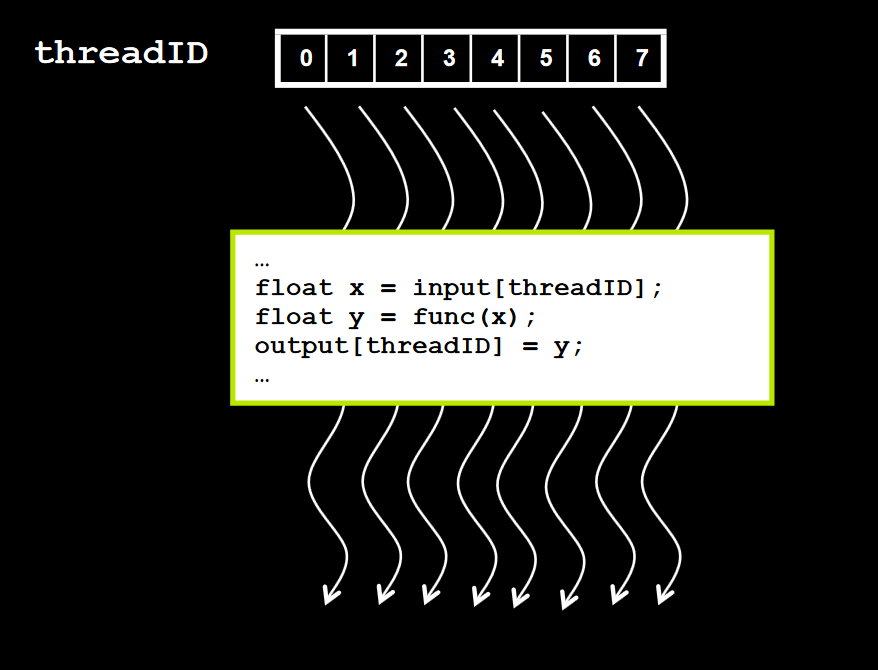
CUDA 里不是 “一个程序顺序执行”,而是同一个 kernel 被大量线程并行执行,每个线程通过自己的索引(ID)知道应该运算哪一块数据
-
CUDA 的执行层级是一个树形结构
Kernel —— GPU 函数
 └── Grid —— 一次 kernel launch 的“并行总规模”
      └── Block —— 线程协作单元
           └── Thread —— 最小执行单元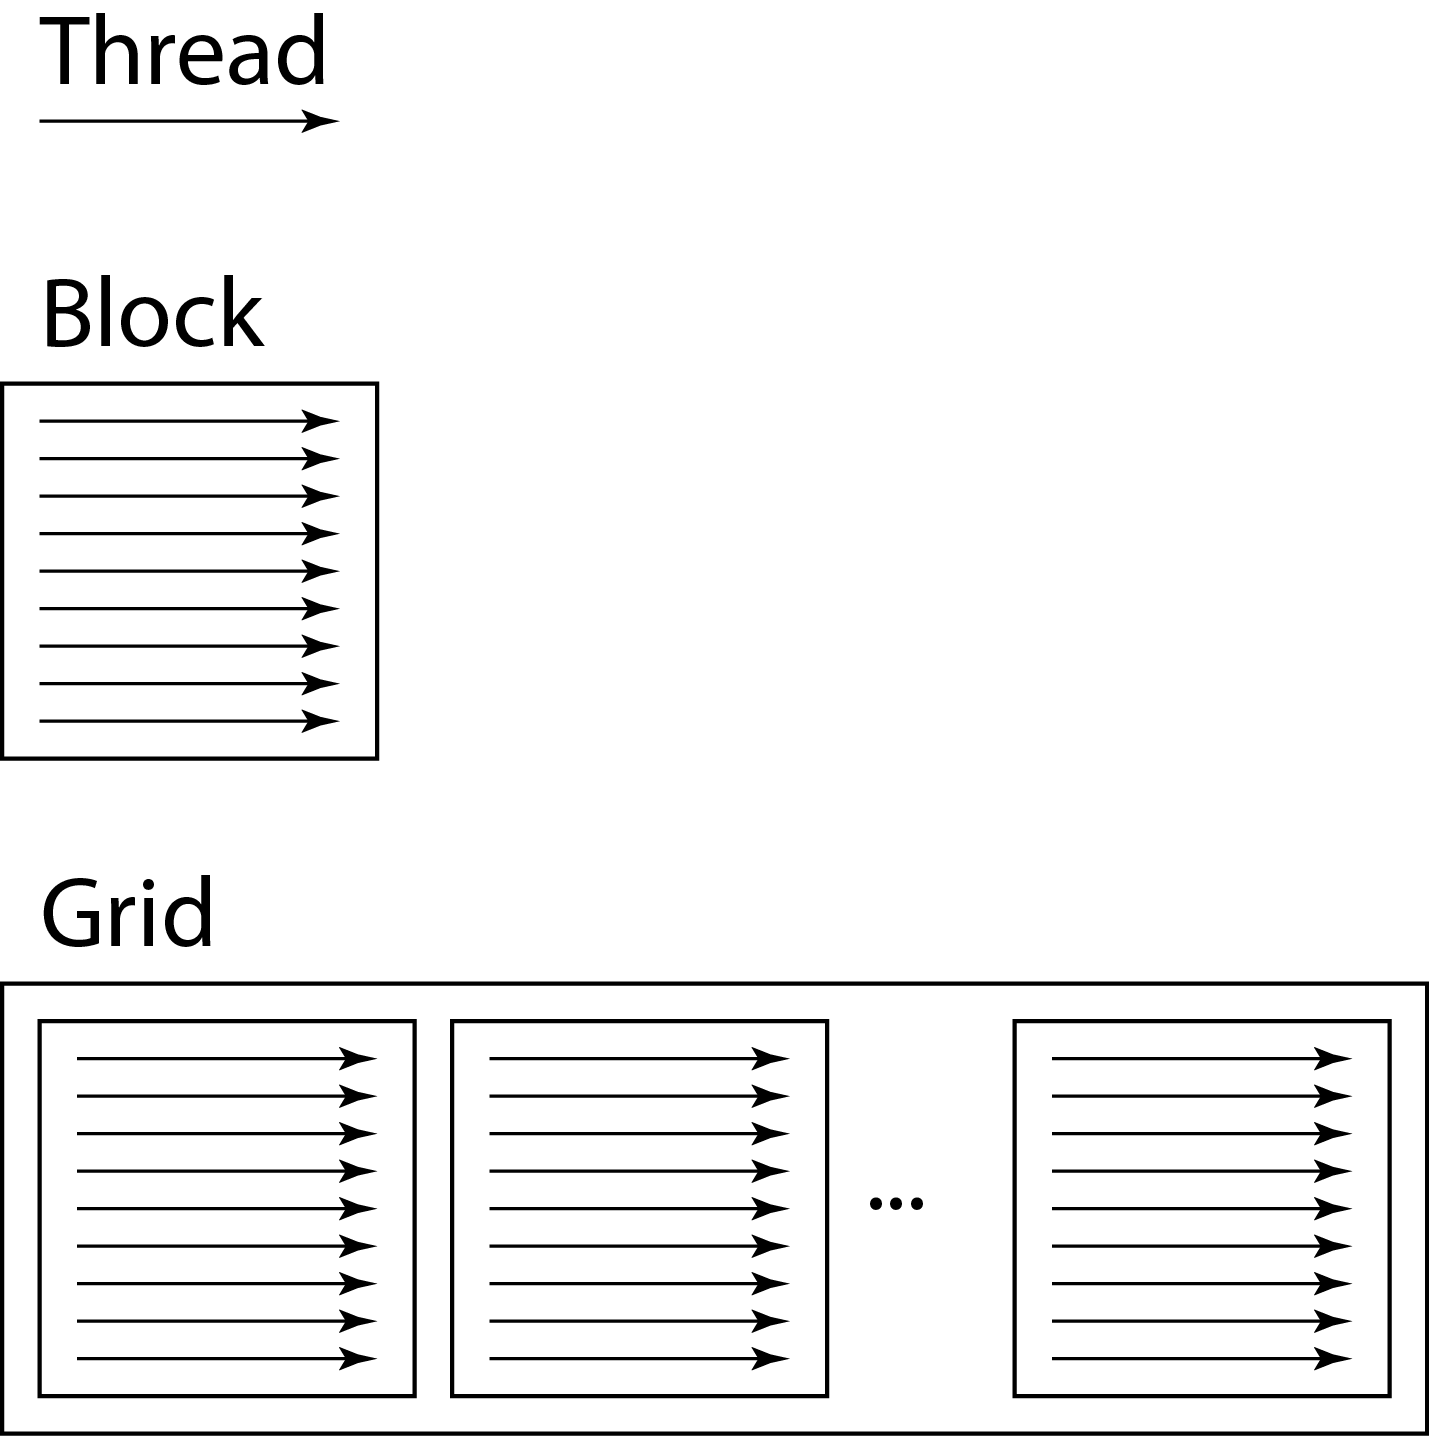
-
Grid:一次 kernel launch 的全局并行空间
- Grid 是一次 kernel 调用中,所有线程的集合
- 当 launch kernel 时,会指定
<<<blocksPerGrid, threadsPerBlock>>>,例如my_kernel<<<1024, 256>>>();的含义是这次 kernel 调用启动了 1024 个 block,每个 block 256 个 thread
-
Block:并行 + 协作的最小单位
-
Block 的作用:线程可以同步、线程可以共享内存
__syncthreads(); __shared__ float buf[256]; -
GPU 实际用于执行内核调用的 SM 数量受限于调用中指定的 block 数量
-
以 kernel
fun<<<M, N>>>(x, y, z)为例,最多有 M 个 block 可以分配给不同的 SM -
一个 block 不能拆分到不同的 SM 中,如果 block 的数量多于可用的 SM 数量,那么可能会有多个 block 分配给同一个 SM,通过这种方式分配 block,GPU 可以在不同的 SM 上并行运行独立的 block
-
grid 和 block 的维度不能无限大,它们的最大值取决于设备的计算能力(Compute Capability,CC)
- grid 最大维度通常为
(2^31−1) × 65535 × 65535 - block 最大维度为
1024 × 1024 × 64,但由于每个 block 的最大线程数为 1024,因此实际可用维度通常远小,例如 32 × 32 × 1
- grid 最大维度通常为
-
-
Thread:真正执行指令的实体
- Thread 是最小执行单元,拥有自己的寄存器、program counter、局部变量
- Thread ≠ 独立核心
-
Warp:执行层面的真实最小单位
-
Warp 是 32 个 thread 组成的执行束,GPU 实际上是以 warp 为单位发指令,不是 thread,也不是 block
-
Warp 的执行特性是所有 thread 执行同一条指令,不同数据(SIMT)
-
如果出现不同 thread 执行的指令不同,就会导致 warp divergence(分支发散),这时 GPU 会先执行 A 分支,再执行 B 分支,而被 mask 掉的 thread 只能空转
if (threadIdx.x % 2 == 0) A(); else B(); -
block size 通常是 256 / 512,因为 256 = 8 warps、512 = 16 warps,便于调度,隐藏访存延迟,提高 SM 利用率
-
-
SM
- SM 是 GPU 上可以独立执行多个 warp 的计算单元,一个 SM 包含多个 warp scheduler、ALU / Tensor Core、寄存器文件、shared memory
- SM 决定了同时驻留多少 block,同时跑多少 warp 以及 shared memory /register 怎么划分
- SM 的内部工作流程是 warp scheduler 选一个 warp,给这个 warp 发一条指令,32 个 thread 锁步执行,所以一个 warp ≈ 一条 SIMD 指令,而多个 warp 在 SM 内轮流执行(时间复用,从而隐藏延迟)
- 例如,当一个 warp 等待 global memory 时,调度器会切换到另一个 ready warp,所以 GPU 性能关键是让 SM 里始终有足够多的 warp
Thread 的索引体系
-
索引体系中的维度,和 GPU 的物理结构没有一一对应关系,而是逻辑索引空间
-
实际上,Grid / Block / Thread → 程序员看到的逻辑并行空间,而 SM /warp/core → 硬件执行结构
-
例如下列中的二维逻辑坐标系统,意味着 grid 是一个 8 × 4 的 block 网,每个 block 是 16 × 16 = 256 个 thread
// dim3 表示一个最多包含 x / y / z 三个维度的结构体 struct dim3 { unsigned int x, y, z; dim3(unsigned int vx = 1, unsigned int vy = 1, unsigned int vz = 1); }; // 对于这个二维 grid,其 grid.z = 1 dim3 grid(8, 4); dim3 block(16, 16); // 对于这个一维 grid,其 grid.y = 1,grid.z = 1 dim3 grid(8); // 网格被解释为 3 × 1 × 1 个块,每个块包含 U × V × W 个线程 // gridDim.x = 3 // blockDim.x = U // blockDim.y = V // blockDim.z = W int blocksPerGrid = 3; // 网格 x 维有 3 个块,blockDim.y 和 blockDim.z 为 1 dim3 threadsPerBlock(U, V, W); -
在实践中,数据通常是多维的,例如
- 图像是 ,很自然地,blockIdx.x → 宽度方向、blockIdx.y → 高度方向、blockIdx.z → 通道方向
- 矩阵乘法中,输出矩阵是 ,每个 block 负责一个 tile
- 3D 数据(体数据、视频)的维度为 ,那么 grid.z 直接对应时间 / 深度
-
在这里,维度并不代表执行顺序,CUDA 不保证 block 的执行顺序,不同的 block 可以并行、可以乱序、可以延迟执行
-
block 内部索引:
threadIdx-
线程在 block 内的编号,表示当前线程在它所属 block 里的位置
-
是一个三维向量,包括
threadIdx.x、threadIdx.y、threadIdx.z -
threadIdx.x:block 内 x 方向的线程编号,取值范围为
-
-
block 维度大小:
blockDim-
一个 block 有多少线程,表示一个 block 的尺寸
-
也是三维向量,包括
blockDim.x、blockDim.y、blockDim.z -
blockDim.x:block 在 x 方向有多少线程,是在 launch kernel 时指定的
-
-
block 在 grid 中的索引:
blockIdx-
这是第几个 block,表示当前 block 在整个 grid 里的编号
-
也是三维向量,包括
blockIdx.x、blockIdx.y、blockIdx.z -
blockIdx.x:表示 grid 中第几个 block(x 方向)
-
-
grid 维度大小:
gridDim- 一个 grid 有多少个 Block,表示一个 grid 的尺寸,即这个 Kernel 中包含多少个 Block
- 也是三维向量,包括
gridDim.x、gridDim.y、gridDim.z
-
全局 idx 计算
// 一维映射:每个 block 负责一段连续数据,block 内 thread 负责 offset int global_idx = blockIdx.x * blockDim.x + threadIdx.x; // 二维索引,如图像 / 矩阵:(x, y) ↔ 数据坐标 // 以一个向量加法 C[i] = A[i] + B[i] 为例,映射方式是每个 thread 负责一个 i,而 grid 覆盖整个张量,多余的 thread 做 boundary check int x = blockIdx.x * blockDim.x + threadIdx.x; int y = blockIdx.y * blockDim.y + threadIdx.y; // 三维索引,体数据 int x = blockIdx.x * blockDim.x + threadIdx.x; int y = blockIdx.y * blockDim.y + threadIdx.y; int z = blockIdx.z * blockDim.z + threadIdx.z; // 扁平化索引(Flatten):全局线性 id int block_id = blockIdx.x + blockIdx.y * gridDim.x + blockIdx.z * gridDim.x * gridDim.y; int thread_id = threadIdx.x + threadIdx.y * blockDim.x + threadIdx.z * blockDim.x * blockDim.y; int global_id = block_id * (blockDim.x * blockDim.y * blockDim.z) + thread_id; -
如果数据大小在编译时未知,或数据元素数量超过最大线程数(无法一一对应),那么单线程对应单数据元素的策略就会失败,为了保证核函数鲁棒性,可以使用网格跨步循环(Grid-Stride Loops)
-
网格跨步循环允许每个线程处理多个数据元素,每个元素的间隔为网格中线程总数。例如,在一维情况中:
__global__ void func(int N, float* a, float* b) { int T = blockDim.x * gridDim.x; // 网格中总线程数 for (int i = blockIdx.x * blockDim.x + threadIdx.x; i < N; i += T) { // 线程 0(块 0)处理 i = 0, T, 2T, ... // 线程 1(块 0)处理 i = 1, T+1, 2T+1, ... // ... // 线程 1023(块 1)处理 i = 1023, T+1023, ... a[i] += b[i]; // 举例操作 } } int main() { int blocksPerGrid = 2; int threadsPerBlock = 1024; func<<<blocksPerGrid, threadsPerBlock>>>(N, a, b); } -
这样,每个线程可以处理多个数据,保证无论数据大小如何,都能完整覆盖所有输入元素
-
索引体系的工程原则
- block 内:threadIdx 连续 → 内存访问连续
- warp 内:threadIdx.x 连续 → coalesced memory access
- grid 维度:对齐数据形状,减少 if boundary check
线程映射举例
-
下面的例子展示如何使用二维 grid 和 block 调用 CUDA 内核函数来计算矩阵转置
-
原始的 CPU C 语言程序,用于转置一个方阵
#include <stdio.h> #include <stdlib.h> #include <assert.h> #define SIZE 1024 // 转置矩阵 void transpose(int**original_matrix, int**transposed_matrix) { for (int i = 0; i < SIZE; i++) { for (int j = 0; j < SIZE; j++) { transposed_matrix[j][i] = original_matrix[i][j]; } } } int main() { int**original_matrix = (int**) malloc(SIZE * sizeof(int *)); int**transposed_matrix = (int**) malloc(SIZE * sizeof(int *)); for (int i = 0; i < SIZE; i++) { original_matrix[i] = (int *) malloc(SIZE * sizeof(int)); transposed_matrix[i] = (int *) malloc(SIZE * sizeof(int)); } // 初始化矩阵 for (int i = 0; i < SIZE; i++) for (int j = 0; j < SIZE; j++) original_matrix[i][j] = i * SIZE + j; transpose(original_matrix, transposed_matrix); // 验证矩阵 for (int i = 0; i < SIZE; i++) for (int j = 0; j < SIZE; j++) assert(transposed_matrix[i][j] == original_matrix[j][i]); for (int i = 0; i < SIZE; i++) { free(original_matrix[i]); free(transposed_matrix[i]); } free(original_matrix); free(transposed_matrix); return 0; } -
第一步优化,在 GPU 中,矩阵分配存在几个问题:
- 多级指针访问效率低:如果使用
int**matrix,GPU 访问[0][0]时需要访问两次内存(先访问指针,再访问元素),效率低下 - 数据连续性:GPU 访问内存时,会一次性读取一块固定大小的数据。非连续存储会导致多次访问,降低性能
- 因此,通常将矩阵展平为一维数组:
matrix[i][j] → matrix[i * WIDTH + j]
- 多级指针访问效率低:如果使用
-
第一步优化后结果
#include <stdio.h> #include <stdlib.h> #include <assert.h> #define SIZE 1024 void transpose(int *original_matrix, int *transposed_matrix) { for (int i = 0; i < SIZE; i++) for (int j = 0; j < SIZE; j++) transposed_matrix[j * SIZE + i] = original_matrix[i * SIZE + j]; } int main() { int *original_matrix = (int *) malloc(SIZE * SIZE * sizeof(int)); int *transposed_matrix = (int *) malloc(SIZE * SIZE * sizeof(int)); for (int i = 0; i < SIZE; i++) for (int j = 0; j < SIZE; j++) original_matrix[i * SIZE + j] = i * SIZE + j; transpose(original_matrix, transposed_matrix); for (int i = 0; i < SIZE; i++) for (int j = 0; j < SIZE; j++) assert(transposed_matrix[i * SIZE + j] == original_matrix[j * SIZE + i]); free(original_matrix); free(transposed_matrix); return 0; } -
注意:行是连续存储的,因此访问原矩阵的行是高效的;但列是跨行存储的,因此写入转置矩阵时仍然有一定开销,这是无法避免的
-
在 GPU 中,可以使用二维线程块处理矩阵转置,每个线程负责一个矩阵元素
__global__ void transpose(int *original_matrix, int *transposed_matrix) { int i = threadIdx.x; int j = threadIdx.y; if (i < SIZE && j < SIZE) transposed_matrix[j * SIZE + i] = original_matrix[i * SIZE + j]; } dim3 threadsPerBlock(SIZE, SIZE); transpose<<<1, threadsPerBlock>>>(original_matrix_d, transposed_matrix_d); -
运行后会发现转置矩阵全是 0,assert 失败。原因是 GPU 每个 block 最大线程数为 1024,而这里配置 1024×1024,超出了限制
-
解决方案:将矩阵划分为 32×32 的子块,每个 block 处理一个子块,网格为 32×32 个 block,正好覆盖 1024×1024 矩阵
__global__ void transpose(int *original_matrix, int *transposed_matrix) { int i = threadIdx.x + blockIdx.x * blockDim.x; int j = threadIdx.y + blockIdx.y * blockDim.y; if (i < SIZE && j < SIZE) transposed_matrix[j * SIZE + i] = original_matrix[i * SIZE + j]; } int main() { dim3 threadsPerBlock(32, 32); dim3 blocksPerGrid(32, 32); transpose<<<blocksPerGrid, threadsPerBlock>>>(original_matrix_d, transposed_matrix_d); } -
这样每个线程块都只处理 32×32 的元素,符合 GPU 最大线程数限制
-
进一步思考与挑战
- 如何修改代码,使其能处理非方阵?
- 是否有其他 grid/block 配置可以运行更快?
- 最终版本的代码仅支持矩阵大小 ≤ 1024,如何修改,使其支持任意合理大小?
- 如何实现 grid-stride loop,让每个线程处理多个元素?无论矩阵大小或 block/grid 配置如何,程序都能顺利运行
内核编写
-
如果想增加一个新的操作,而该操作还没有经过优化后的 GPU 内核实现
-
或者想加速现有的 PyTorch 函数,那么自己实现高性能 CUDA 内核
-
看似直接,但实际上门槛很高:需要丰富的经验,学习曲线陡峭
-
通常,更好的方法是利用
torch.compile,它可以动态优化 PyTorch 代码,捕获操作,并使用 Triton 作为后端生成底层高性能内核 -
一个简单的例子:ELU 激活函数
-
ELU 激活函数的定义为:
-
可以先用 PyTorch 写一个普通实现:
def elu(x, alpha=1.0): return torch.where(x < 0, alpha * (torch.exp(x) - 1), x) -
然后只需加上
@torch.compile:@torch.compile def elu(x, alpha=1.0): return torch.where(x < 0, alpha * (torch.exp(x) - 1), x) -
这样 PyTorch 会自动生成更高性能的内核,实测性能提升显著,尤其是在大规模矩阵上
-
可以设置环境变量,来查看
torch.compile生成的 Triton 内核export TORCH_LOGS="output_code" -
然后运行 Python 脚本,PyTorch 会输出对应的 Triton 内核,例如:
@triton.jit def triton_(in_ptr0, out_ptr0, xnumel, XBLOCK : tl.constexpr): xnumel = 100000000 xoffset = tl.program_id(0) * XBLOCK xindex = xoffset + tl.arange(0, XBLOCK)[:] xmask = xindex < xnumel x0 = xindex tmp0 = tl.load(in_ptr0 + (x0), xmask) tmp1 = 0.0 tmp2 = tmp0 < tmp1 tmp3 = tl_math.exp(tmp0) tmp4 = 1.0 tmp5 = tmp3 - tmp4 tmp6 = tl.where(tmp2, tmp5, tmp0) tl.store(out_ptr0 + (x0), tmp6, xmask) -
为了可读性,可以重命名变量、加注释:
@triton.jit def elu_kernel(input_ptr, output_ptr, num_elements, BLOCK_SIZE: tl.constexpr): # 计算当前 block 的起始索引 block_start = tl.program_id(0) * BLOCK_SIZE # 当前 block 的索引范围 block_indices = block_start + tl.arange(0, BLOCK_SIZE)[:] # 掩码,确保只处理有效索引 valid_mask = block_indices < num_elements # 从内存中加载输入数据 input_values = tl.load(input_ptr + block_indices, valid_mask) # ELU 参数 zero_value = 0.0 negative_mask = input_values < zero_value exp_values = tl.math.exp(input_values) shifted_exp_values = exp_values - 1.0 # 计算输出 output_values = tl.where(negative_mask, shifted_exp_values, input_values) # 将结果写回内存 tl.store(output_ptr + block_indices, output_values, valid_mask) -
对 Triton 内核代码的解释:
tl.program_id(0)返回block ID,用来确定每个 block 处理数据的区间block_indices表示该 block 内的数据索引valid_mask确保不会越界- ELU 函数通过
tl.where应用 - 结果通过
tl.store写回 GPU 内存
-
通过 Triton,甚至可以在小规模数据上得到比
torch.compile更快的性能,因为编译开销低
-
-
性能优化工具对比
工具 难度 性能 灵活性 PyTorch 原生 容易 慢 低 @torch.compile容易 快 中等 Triton 中等 更快 高 CUDA 最难 最快 最高 -
上述是一个简单的内核例子,而一个完整的 Kernel 编写一般分为以下步骤
- 并行映射设计:每个 thread 到底负责算什么
- 最基本的映射是逐元素映射:比如矩阵乘法中,每个 thread 负责计算结果矩阵中的一个元素,这是最理想的情况,因为其完美符合并行设计:完全数据并行、没有依赖关系、访存连续
- 多维映射设计:如对于图像而言,其维度为
H × W × C,可以直接利用内存组织结构的三维进行映射 - 映射设计的核心目标是保证并行度足够(否则 GPU 会空闲)、保证访存规则(否则访存碎片化)
- Block 设计策略
- block 内线程可以共享 shared memory、同步、共同完成 tile 计算
- 一般而言,block 大小为 128 ~ 512 threads,通常是 32 的倍数
- block 主要影响 Occupancy,block 太大,其 shared memory 不够、register 不够;block 太小,其 warp 不够,延迟无法隐藏
- 并行映射设计:每个 thread 到底负责算什么
-
Kernel 如何优化
- 如何组织内存访问:减少访问 global memory
- 如何提高计算密度:在等数据的时候让 GPU 不会空闲
- 如何划分并行任务:让访问更并行
-
而这正好和 GPU 的性能瓶颈模型一一对应