并行通信原语
介绍 CUDA 中的并行通信原语,包括 Broadcast、Reduce、AllReduce、Gather、AllGather、Scatter、ReduceScatter、Ring AllReduce 和 Barrier 等内容
什么是原语
- 在并行编程中,有若干个相互独立的节点,它们可以是 CPU 核心、GPU,或者计算节点
- 每个节点先各自执行一些计算,然后将计算结果或其中的一部分传递给其他节点,用于下一步计算()
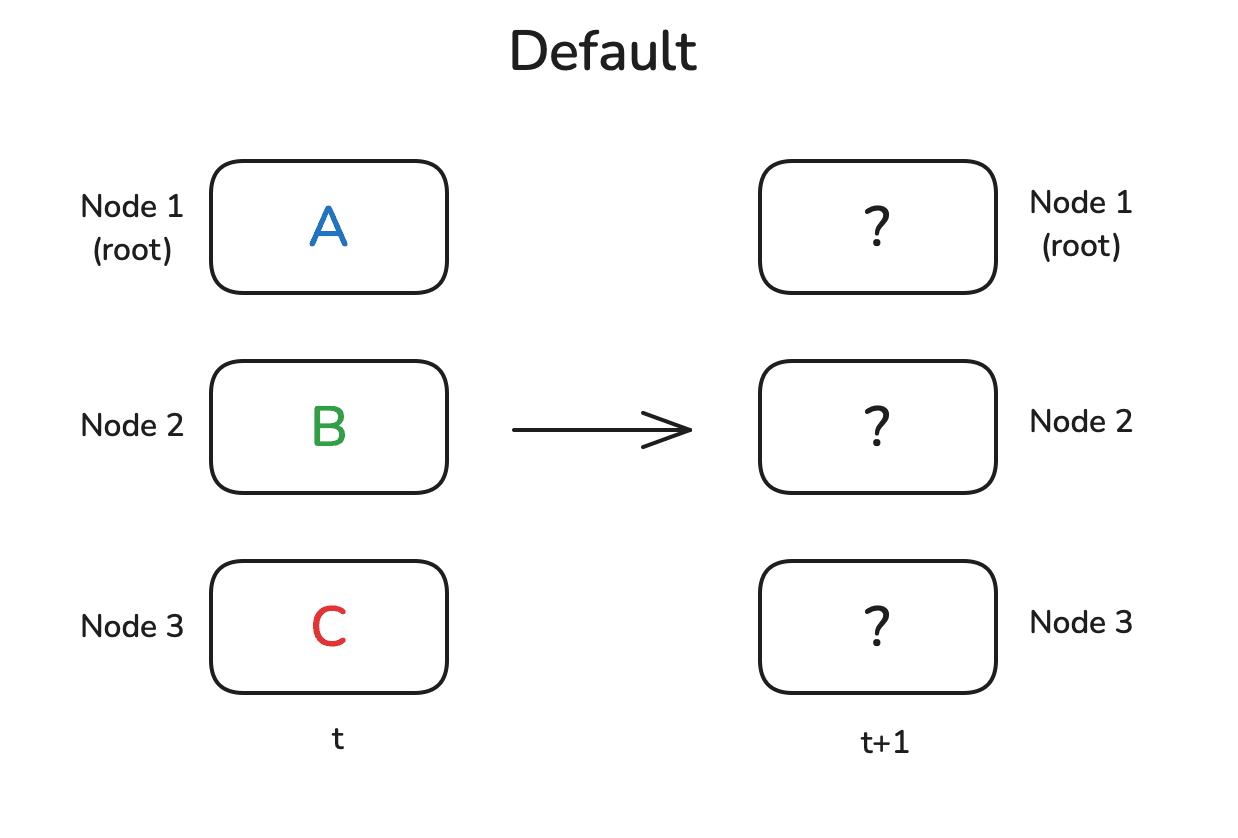
- 有时,需要把某一个节点的结果发送给所有其他节点
- 有时,则需要把每个节点的中间结果汇总求和,以得到整体结果并进行汇报
- 通常,会有一个具有更高地位的节点在这些操作中扮演核心角色,这里称之为 root,它可能是某些操作的源或目标
Broadcast
-
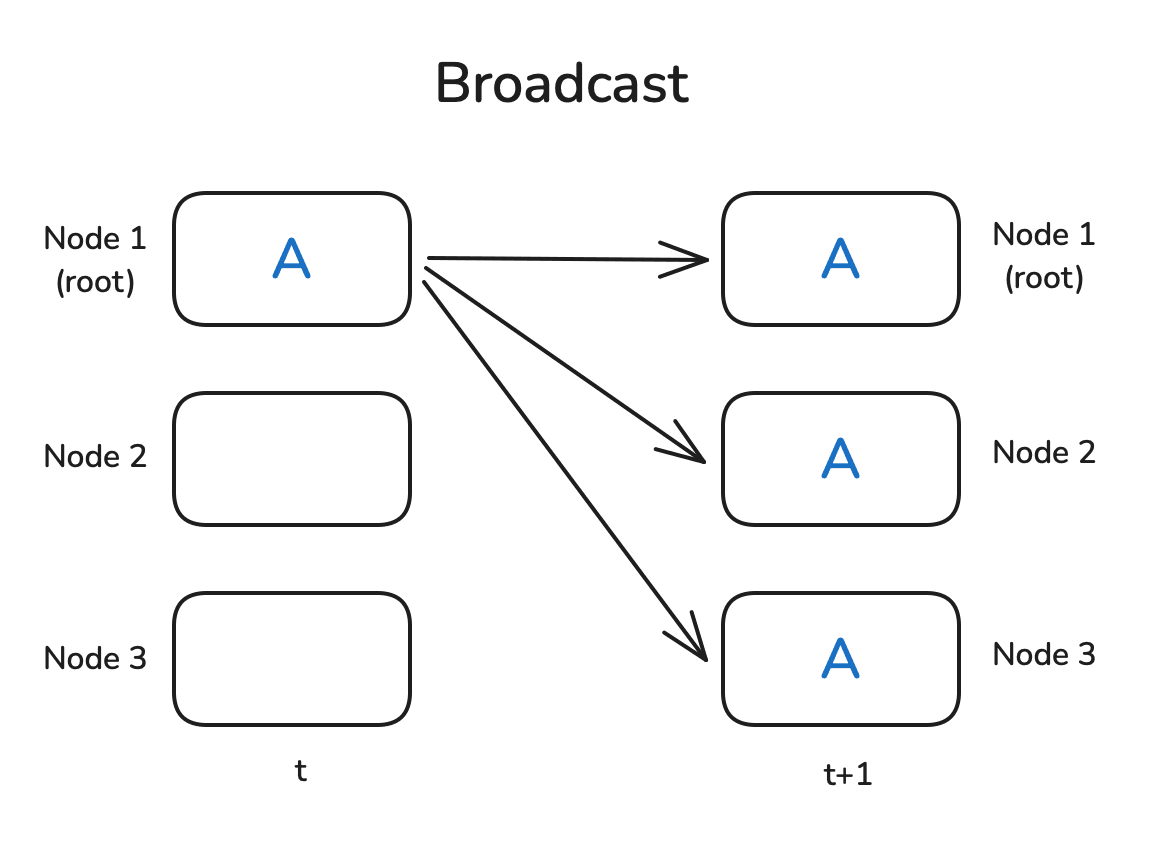
Broadcast(广播):某个节点(比如节点 1)上已经有了一份数据,我们希望把它共享给所有其他节点,让它们都能基于这份数据进行计
-
集合通信操作在 PyTorch 中是原生支持的,因此可以很容易地写一个小示例来展示广播是如何工作的
- 首先,需要使用
dist.init_process_group来初始化一个进程组,这一步会设置通信后端 - 它会确定一共有多少个工作进程(也叫节点),并为每一个进程分配一个 rank(可以通过
dist.get_rank获取) - 最后,这一步还会在各个工作进程之间建立通信连接
- 首先,需要使用
-
为了演示
dist.broadcast操作,在 rank=0 的进程上创建一个包含非零值的张量,而在其他进程上创建全为零的张量 -
然后,通过
dist.broadcast(tensor, src=0)将 rank=0 上的张量分发到所有其他 rank 上import torch import torch.distributed as dist def init_process(): dist.init_process_group(backend='nccl') torch.cuda.set_device(dist.get_rank()) def example_broadcast(): if dist.get_rank() == 0: tensor = torch.tensor([1, 2, 3, 4, 5], dtype=torch.float32).cuda() else: tensor = torch.zeros(5, dtype=torch.float32).cuda() print(f"Before broadcast on rank {dist.get_rank()}: {tensor}") dist.broadcast(tensor, src=0) print(f"After broadcast on rank {dist.get_rank()}: {tensor}") init_process() example_broadcats() -
可以使用下面的命令来运行这个脚本:
torchrun --nproc_per_node=3 dist_op.py -
以上命令需要三块 GPU(或者相应地修改 nproc_per_node),运行后输出如下:
Before broadcast on rank 0: tensor([1., 2., 3., 4., 5.], device='cuda:0') Before broadcast on rank 1: tensor([0., 0., 0., 0., 0.], device='cuda:1') Before broadcast on rank 2: tensor([0., 0., 0., 0., 0.], device='cuda:2') After broadcast on rank 0: tensor([1., 2., 3., 4., 5.], device='cuda:0') After broadcast on rank 1: tensor([1., 2., 3., 4., 5.], device='cuda:1') After broadcast on rank 2: tensor([1., 2., 3., 4., 5.], device='cuda:2') -
需要注意的是,不同 rank 的打印信息可能会乱序出现,因为无法控制各个进程中 print 语句的执行先后顺序
Reduce & AllReduce
-
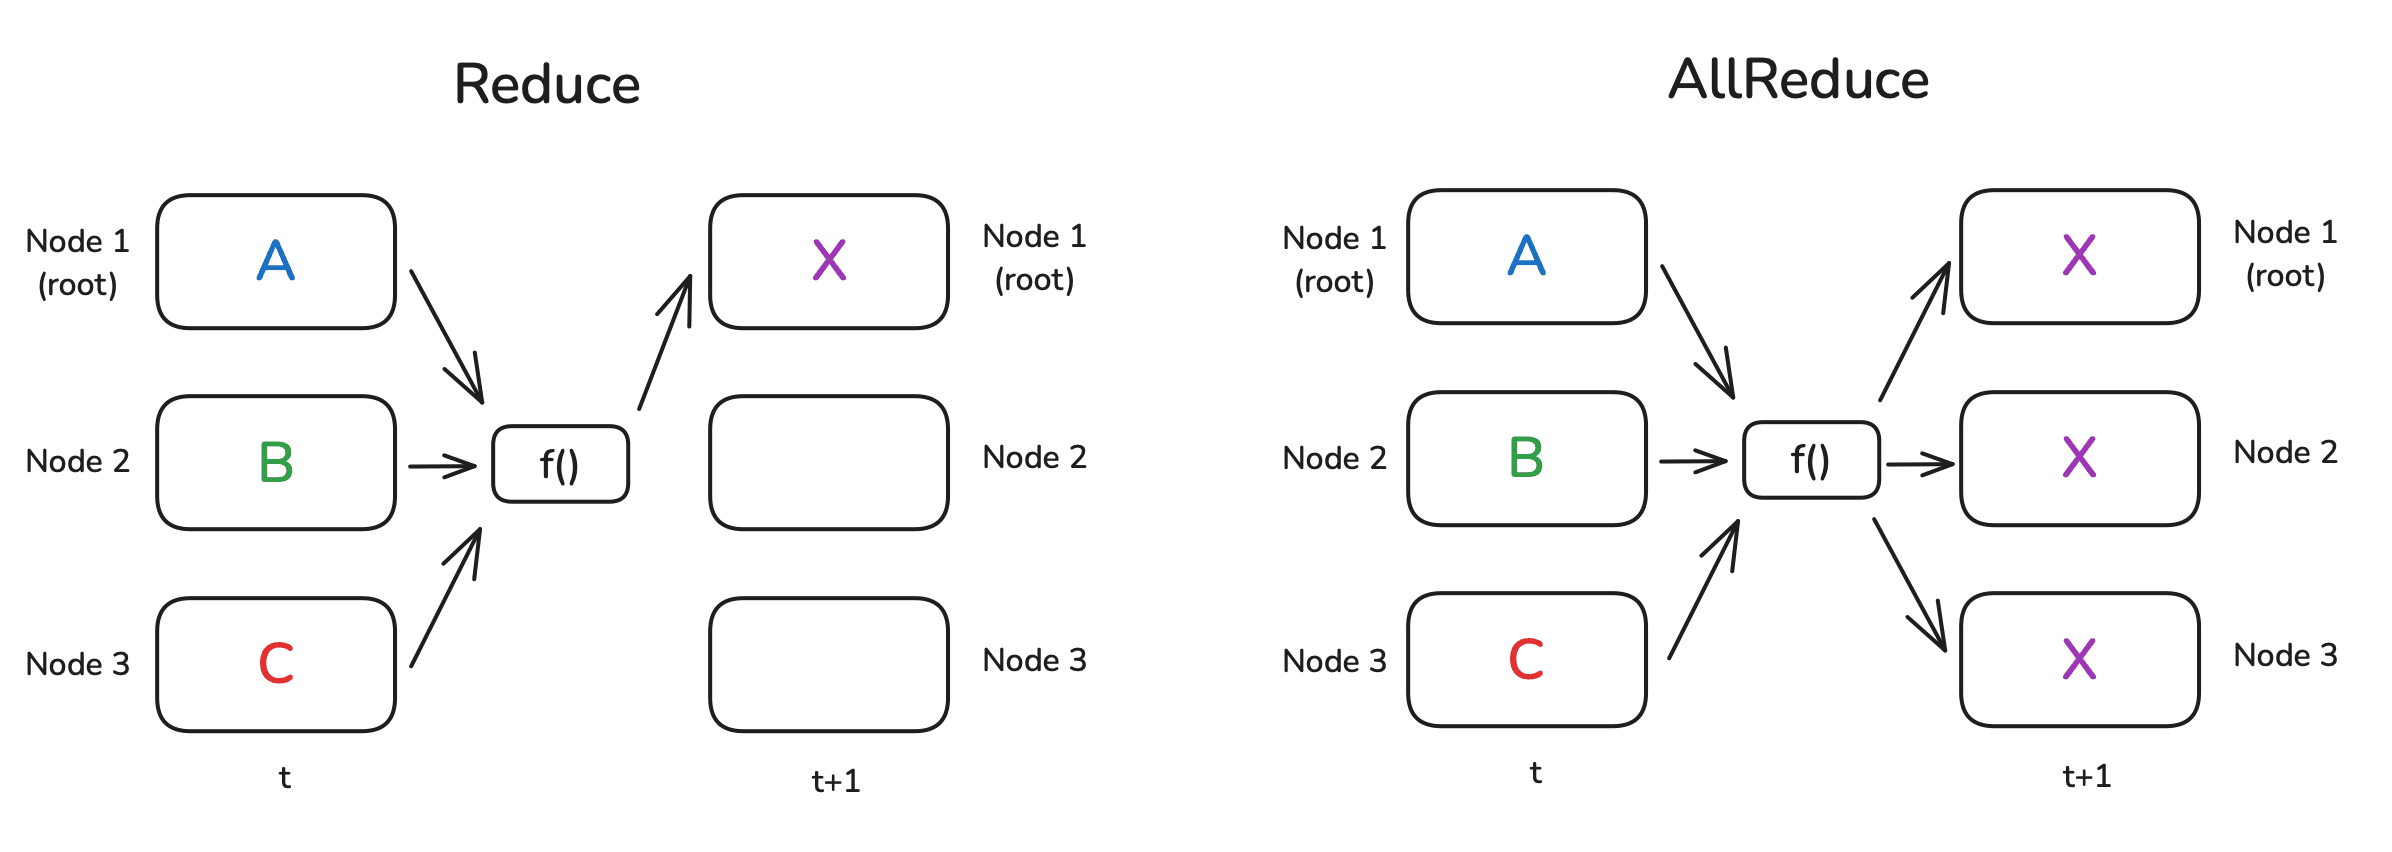
Reduce(归约)模式是分布式数据处理中最基础、也最常见的模式之一
-
其核心思想是:希望通过某个函数 ,将分布在各个节点上的数据组合起来,例如执行求和或求平均等操作
-
在 Reduce 范式中,最终结果只会被发送到 root 节点;而在 AllReduce 的情况下,最终结果会被广播到所有节点
-
通常的实现方式是:每个节点只负责一部分计算,节点之间按照环形(ring)或树形(tree)结构组织通信
-
环形结构:假设需要计算每个节点上的数值之和,并且节点是按环形结构连接的。第一个节点把自己的数值发送给相邻节点,后者在接收到该数值后,加上自己的数值,再转发给下一个节点。经过一整圈之后,第一个节点就会收到所有节点数值的总和
-
下面是一个运行 Reduce 操作、对张量进行求和的简单示例,通过
op=dist.ReduceOp.SUM来指定所使用的归约操作def example_reduce(): tensor = torch.tensor([dist.get_rank() + 1] * 5, dtype=torch.float32).cuda() print(f"Before reduce on rank {dist.get_rank()}: {tensor}") dist.reduce(tensor, dst=0, op=dist.ReduceOp.SUM) print(f"After reduce on rank {rank}: {tensor}") init_process() example_reduce() -
需要注意的是,在 Reduce 操作中,只有 dst 节点上的张量会被更新:
Before reduce on rank 0: tensor([1., 1., 1., 1., 1.], device='cuda:0') Before reduce on rank 1: tensor([2., 2., 2., 2., 2.], device='cuda:1') Before reduce on rank 2: tensor([3., 3., 3., 3., 3.], device='cuda:2') After reduce on rank 0: tensor([6., 6., 6., 6., 6.], device='cuda:0') After reduce on rank 1: tensor([2., 2., 2., 2., 2.], device='cuda:1') After reduce on rank 2: tensor([3., 3., 3., 3., 3.], device='cuda:2') -
类似地,可以执行 AllReduce 操作:
def example_all_reduce(): tensor = torch.tensor([dist.get_rank() + 1] * 5, dtype=torch.float32).cuda() print(f"Before all_reduce on rank {dist.get_rank()}: {tensor}") dist.all_reduce(tensor, op=dist.ReduceOp.SUM) print(f"After all_reduce on rank {dist.get_rank()}: {tensor}") init_process() example_all_reduce() -
在这种情况下,归约后的结果会在所有节点上都可用:
Before all_reduce on rank 0: tensor([1., 1., 1., 1., 1.], device='cuda:0')
Before all_reduce on rank 1: tensor([2., 2., 2., 2., 2.], device='cuda:1')
Before all_reduce on rank 2: tensor([3., 3., 3., 3., 3.], device='cuda:2')

After all_reduce on rank 0: tensor([6., 6., 6., 6., 6.], device='cuda:0')
After all_reduce on rank 1: tensor([6., 6., 6., 6., 6.], device='cuda:1')
After all_reduce on rank 2: tensor([6., 6., 6., 6., 6.], device='cuda:2')
Gather & AllGather
-
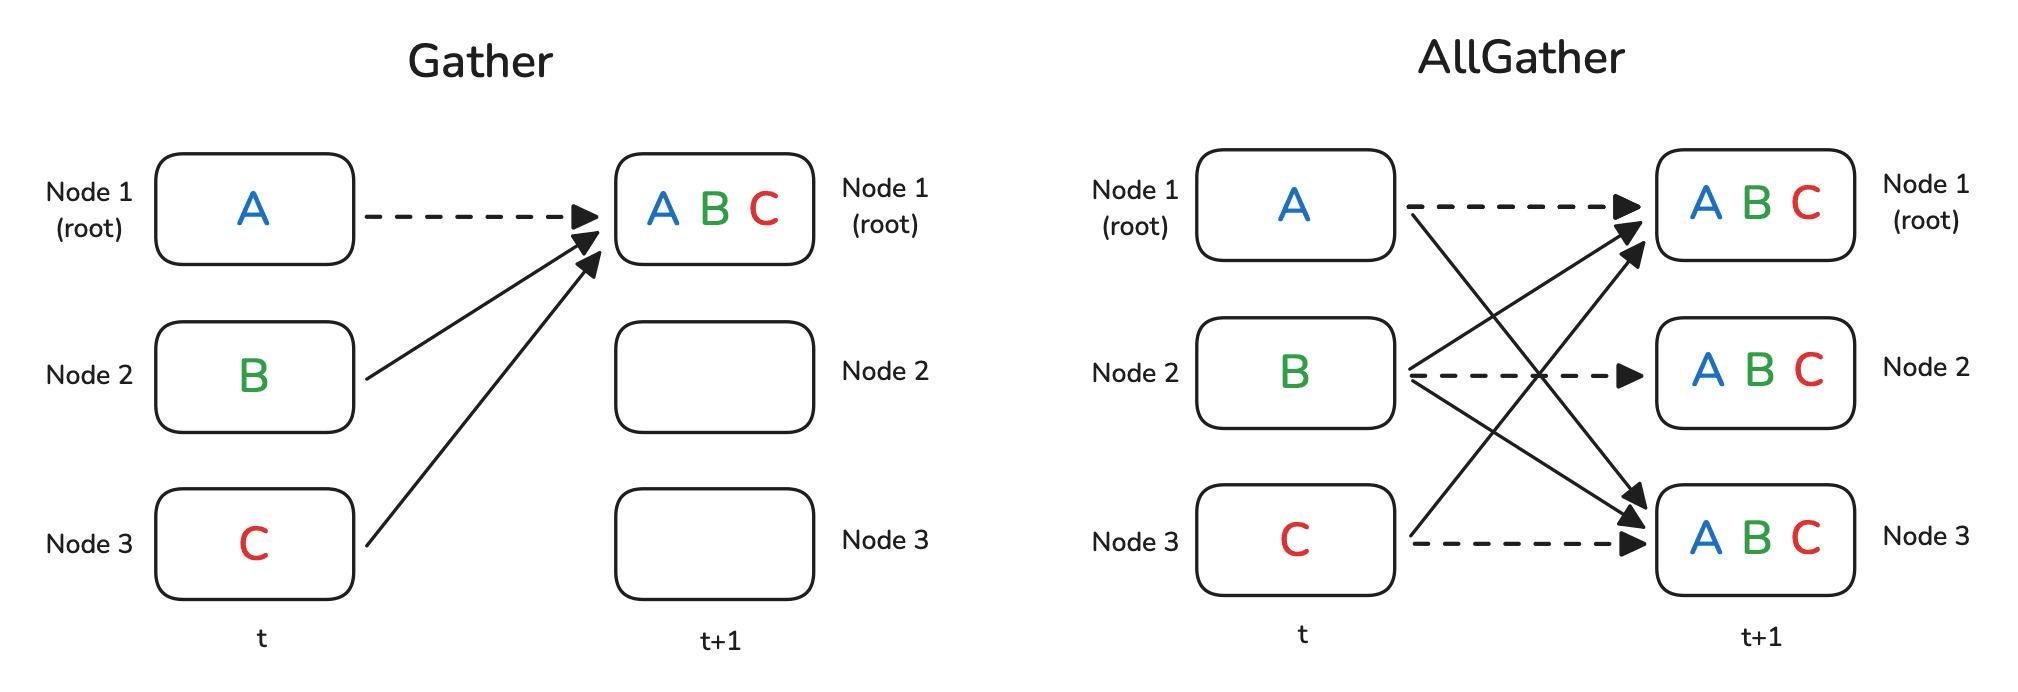
Gather 和 AllGather 与 Broadcast 操作非常相似,它们都允许在节点之间分发数据,并且不对数据本身做任何修改
-
与 Broadcast 的主要区别在于:Broadcast 是将一个节点上的同一份数据发送给所有其他节点;而在 Gather / AllGather 中,每个节点都持有一份不同的数据块,要做的是把这些数据块收集起来
-
Gather 把所有节点的数据收集到一个指定节点上
-
AllGather 把所有节点的数据收集到每一个节点上
-
-
上图中的虚线表示有些数据实际上并不会发生移动,因为这些数据本来就已经位于对应的节点上
-
在 Gather 操作中,需要事先准备一个容器(
gather_list),用来存放最终收集到的张量def example_gather(): tensor = torch.tensor([dist.get_rank() + 1] * 5, dtype=torch.float32).cuda() if dist.get_rank() == 0: gather_list = [ torch.zeros(5, dtype=torch.float32).cuda() for _ in range(dist.get_world_size()) ] else: gather_list = None print(f"Before gather on rank {dist.get_rank()}: {tensor}") dist.gather(tensor, gather_list, dst=0) if dist.get_rank() == 0: print(f"After gather on rank 0: {gather_list}") init_process() example_gather() -
可以看到,gather_list 中确实包含了来自所有 rank 的张量:
Before gather on rank 0: tensor([1., 1., 1., 1., 1.], device='cuda:0') Before gather on rank 1: tensor([2., 2., 2., 2., 2.], device='cuda:1') Before gather on rank 2: tensor([3., 3., 3., 3., 3.], device='cuda:2') After gather on rank 0: [ tensor([1., 1., 1., 1., 1.], device='cuda:0'), tensor([2., 2., 2., 2., 2.], device='cuda:0'), tensor([3., 3., 3., 3., 3.], device='cuda:0') ] -
对于 AllGather 示例,唯一需要做的改变是,每一个节点都要准备一个用于存放结果的占位容器:
def example_all_gather(): tensor = torch.tensor([dist.get_rank() + 1] * 5, dtype=torch.float32).cuda() gather_list = [ torch.zeros(5, dtype=torch.float32).cuda() for _ in range(dist.get_world_size()) ] print(f"Before all_gather on rank {dist.get_rank()}: {tensor}") dist.all_gather(gather_list, tensor) print(f"After all_gather on rank {dist.get_rank()}: {gather_list}") init_process() example_all_gather() -
此时可以看到,每一个节点上都拥有了所有节点的数据:
Before all_gather on rank 0: tensor([1., 1., 1., 1., 1.], device='cuda:0') Before all_gather on rank 1: tensor([2., 2., 2., 2., 2.], device='cuda:1') Before all_gather on rank 2: tensor([3., 3., 3., 3., 3.], device='cuda:2') After all_gather on rank 0: [ tensor([1., 1., 1., 1., 1.], device='cuda:0'), tensor([2., 2., 2., 2., 2.], device='cuda:0'), tensor([3., 3., 3., 3., 3.], device='cuda:0') ] After all_gather on rank 1: [ tensor([1., 1., 1., 1., 1.], device='cuda:1'), tensor([2., 2., 2., 2., 2.], device='cuda:1'), tensor([3., 3., 3., 3., 3.], device='cuda:1') ] After all_gather on rank 2: [ tensor([1., 1., 1., 1., 1.], device='cuda:2'), tensor([2., 2., 2., 2., 2.], device='cuda:2'), tensor([3., 3., 3., 3., 3.], device='cuda:2') ] -
Gather 的 “逆操作”:所有数据最初集中在一个节点上,并且需要将它们切分并分发到各个节点上,中间可能还会伴随一些额外的处理,这时可以使用 Scatter 操作;如果在分发之前还需要先对数据做一次归约操作,就可以使用 ReduceScatter 模式
Scatter & ReduceScatter
-
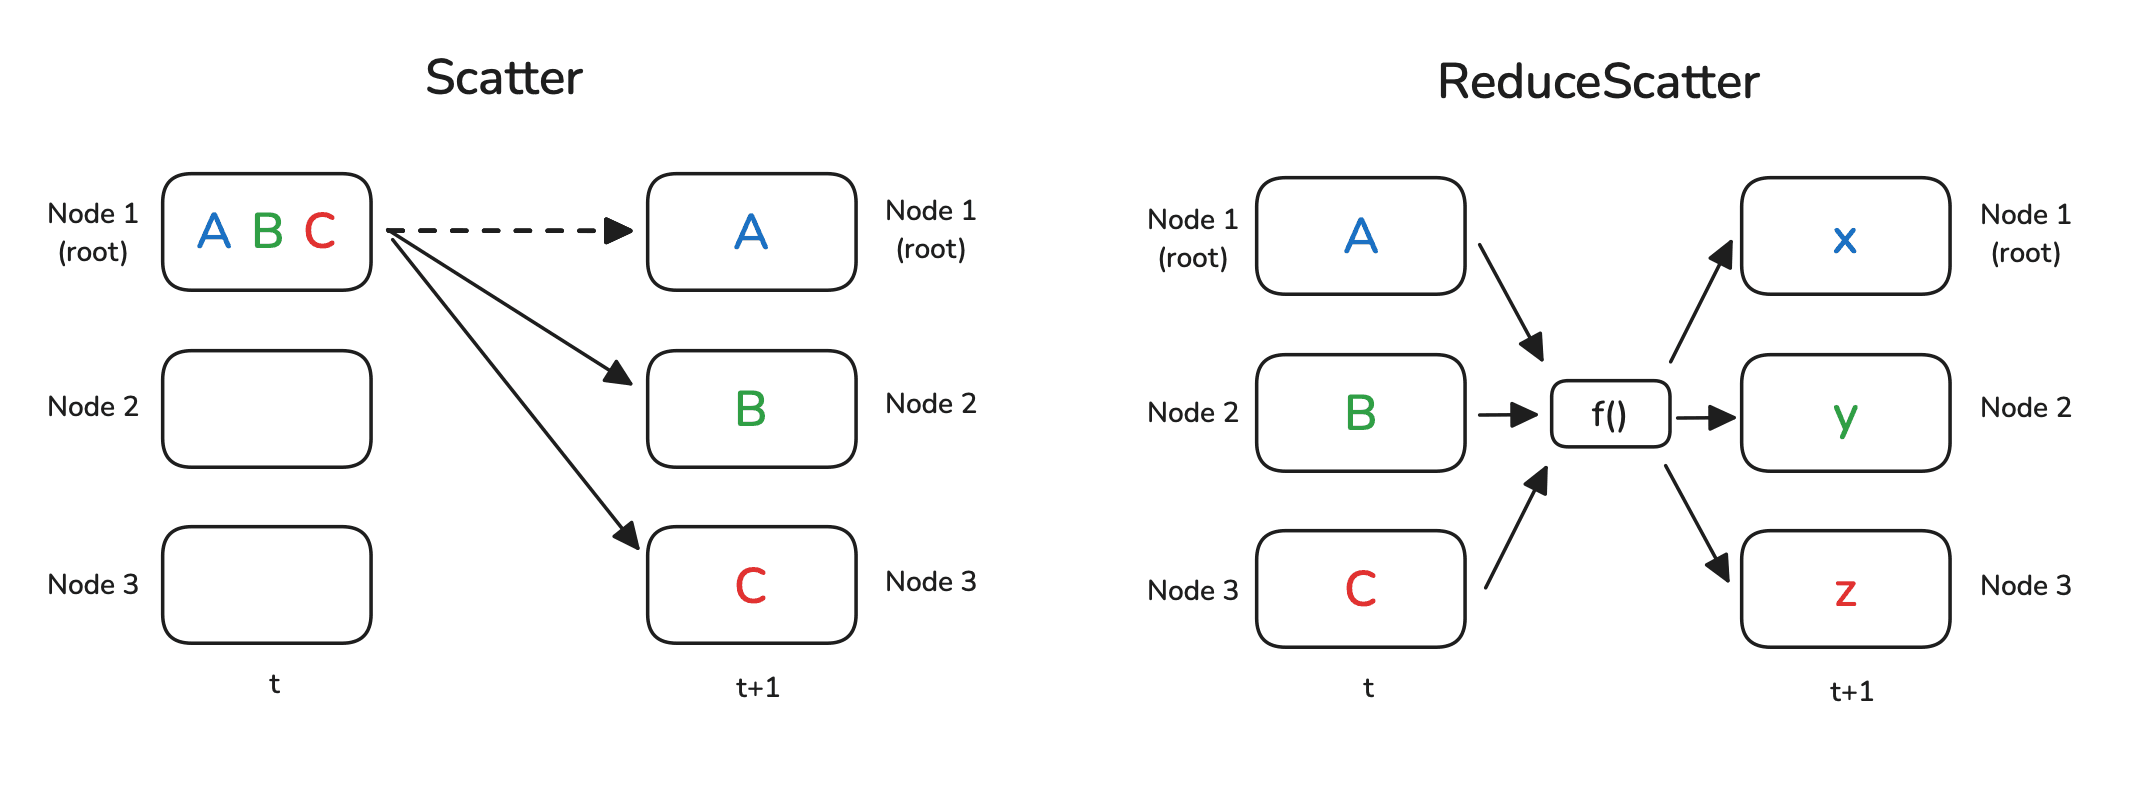
顾名思义,Scatter(散射)操作的目标是把集中在某一个节点上的数据分发到所有节点上,它通过将数据切分成若干片段,并把其中一片分配给每个节点来实现这一点
-
因此,Scatter 不同于 Broadcast 操作:广播是把完整的数据副本发送给每一个节点,而不对数据进行切分;Scatter 可以看作是 Gather 操作在逻辑上的逆过程
-
ReduceScatter 和 AllReduce 类似,都会先对来自所有节点的数据应用某种归约操作;但不同之处在于:在 AllReduce 中,每个节点都会收到完整的输出张量,而在 ReduceScatter 中,每个节点只会收到最终输出张量的一部分切片
-
Scatter 操作在代码层面上可以看作是 Gather 的反向过程:不再是准备一个张量列表作为接收目标,而是把源数据准备成一个张量列表,表示希望分发给各个节点的数据。同时,还需要指定源节点 src:
def example_scatter(): if dist.get_rank() == 0: scatter_list = [ torch.tensor([i + 1] * 5, dtype=torch.float32).cuda() for i in range(dist.get_world_size()) ] print(f"Rank 0: Tensor to scatter: {scatter_list}") else: scatter_list = None tensor = torch.zeros(5, dtype=torch.float32).cuda() print(f"Before scatter on rank {dist.get_rank()}: {tensor}") dist.scatter(tensor, scatter_list, src=0) print(f"After scatter on rank {dist.get_rank()}: {tensor}") init_process() example_scatter() -
执行结果表明,原本为空的张量被填充成了 scatter_list 中对应的内容:
Rank 0: Tensor to scatter: [ tensor([1., 1., 1., 1., 1.], device='cuda:0'), tensor([2., 2., 2., 2., 2.], device='cuda:0'), tensor([3., 3., 3., 3., 3.], device='cuda:0') ] Before scatter on rank 0: tensor([0., 0., 0., 0., 0.], device='cuda:0') Before scatter on rank 1: tensor([0., 0., 0., 0., 0.], device='cuda:1') Before scatter on rank 2: tensor([0., 0., 0., 0., 0.], device='cuda:2') After scatter on rank 0: tensor([1., 1., 1., 1., 1.], device='cuda:0') After scatter on rank 1: tensor([2., 2., 2., 2., 2.], device='cuda:1') After scatter on rank 2: tensor([3., 3., 3., 3., 3.], device='cuda:2') -
下面展示 ReduceScatter 的工作机制,在每个节点上,都会创建一个由二维向量组成的列表,这些向量由节点 rank 相关的倍率以及幂次关系生成:
def example_reduce_scatter(): rank = dist.get_rank() world_size = dist.get_world_size() input_tensor = [ torch.tensor([(rank + 1) * i for i in range(1, 3)], dtype=torch.float32).cuda()**(j + 1) for j in range(world_size) ] output_tensor = torch.zeros(2, dtype=torch.float32).cuda() print(f"Before ReduceScatter on rank {rank}: {input_tensor}") dist.reduce_scatter(output_tensor, input_tensor, op=dist.ReduceOp.SUM) print(f"After ReduceScatter on rank {rank}: {output_tensor}") init_process() example_reduce_scatter() -
从打印结果中可以清楚地看到刚刚构造的数据模式,同时也能直观地看到 ReduceScatter 的效果:第一个 rank 收到的是所有节点上第一个张量的求和结果,第二个 rank 收到的是所有节点上第二个张量的求和结果,以此类推:
Before ReduceScatter on rank 0: [
    tensor([1., 2.], device='cuda:0'),
    tensor([1., 4.], device='cuda:0'),
    tensor([1., 8.], device='cuda:0')
]
Before ReduceScatter on rank 1: [
    tensor([2., 4.], device='cuda:1'),
    tensor([4., 16.], device='cuda:1'),
    tensor([8., 64.], device='cuda:1')
]
Before ReduceScatter on rank 2: [
    tensor([3., 6.], device='cuda:2'),
    tensor([9., 36.], device='cuda:2'),
    tensor([27., 216.], device='cuda:2')
]

After ReduceScatter on rank 0: tensor([6., 12.], device='cuda:0')
After ReduceScatter on rank 1: tensor([14., 56.], device='cuda:1')
After ReduceScatter on rank 2: tensor([36., 288.], device='cuda:2')
Ring AllReduce
-
Ring AllReduce 是一种针对可扩展性优化的 AllReduce 实现方式
-
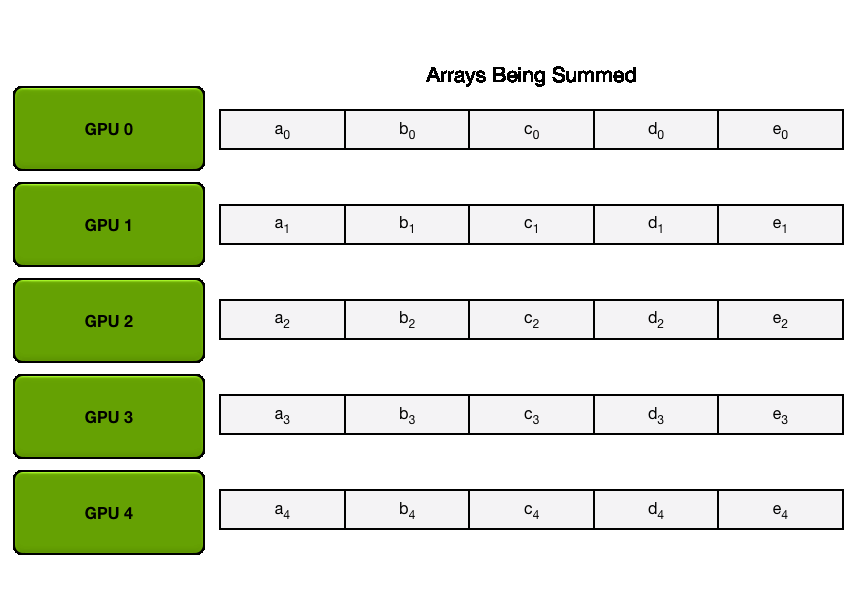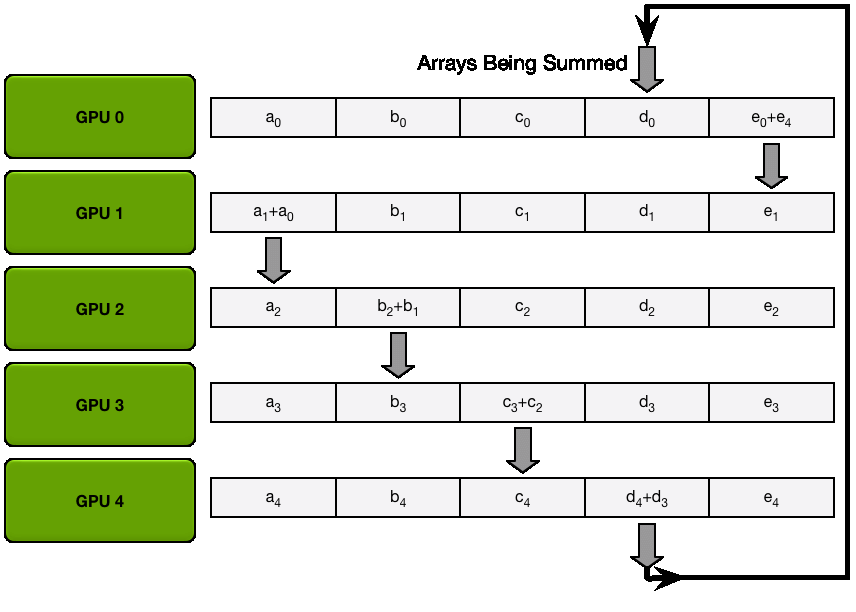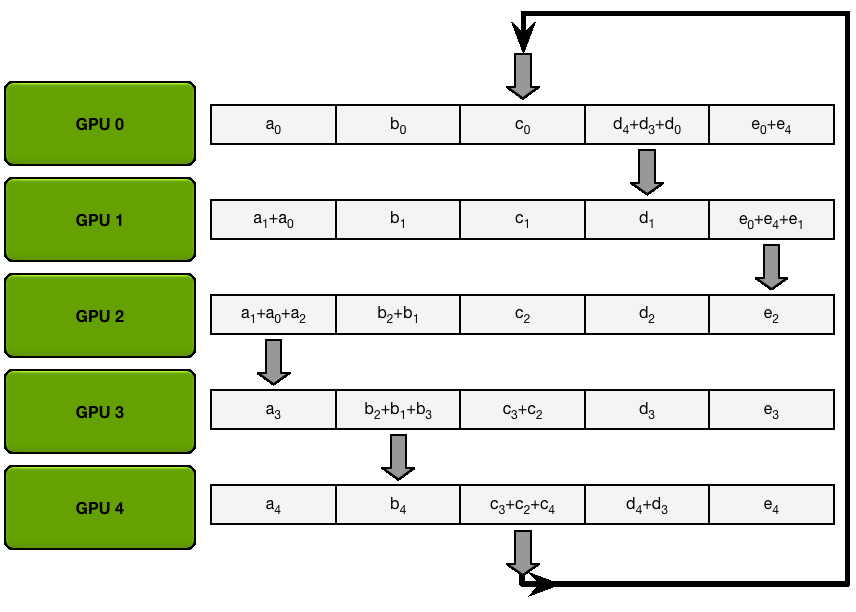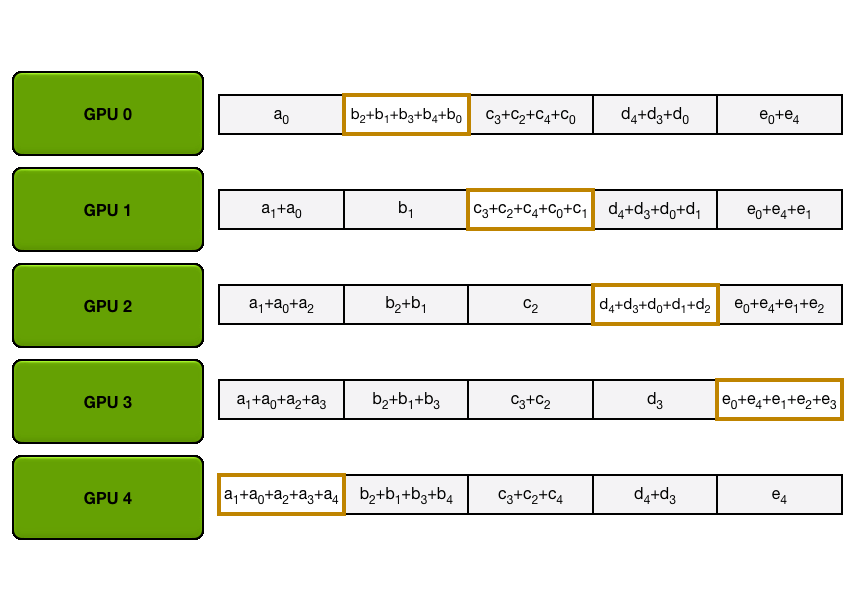
与所有设备彼此直接通信(这很容易造成通信瓶颈)不同,Ring AllReduce 可以拆解为两个关键步骤:ReduceScatter 和 AllGather,其工作流程如下:
-
ReduceScatter
- 每个设备将自己的数据(例如梯度)拆分成 个块(其中 是 GPU 的数量),并将其中一个数据块发送给相邻的设备
- 同时,每个设备也会从另一个相邻设备那里接收一个数据块
- 当设备接收到一个数据块时,会将自己对应位置的数据块与接收到的数据块做归约操作(例如求和)
- 这一过程沿着环不断进行,直到每个设备都持有一个已经完全归约的块,该块表示该分片在所有设备上的梯度之和
-
AllGather
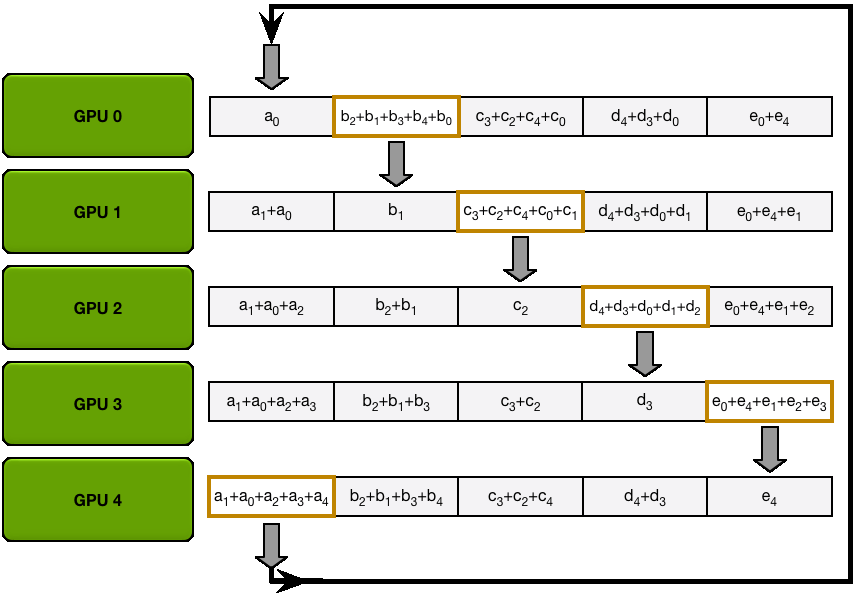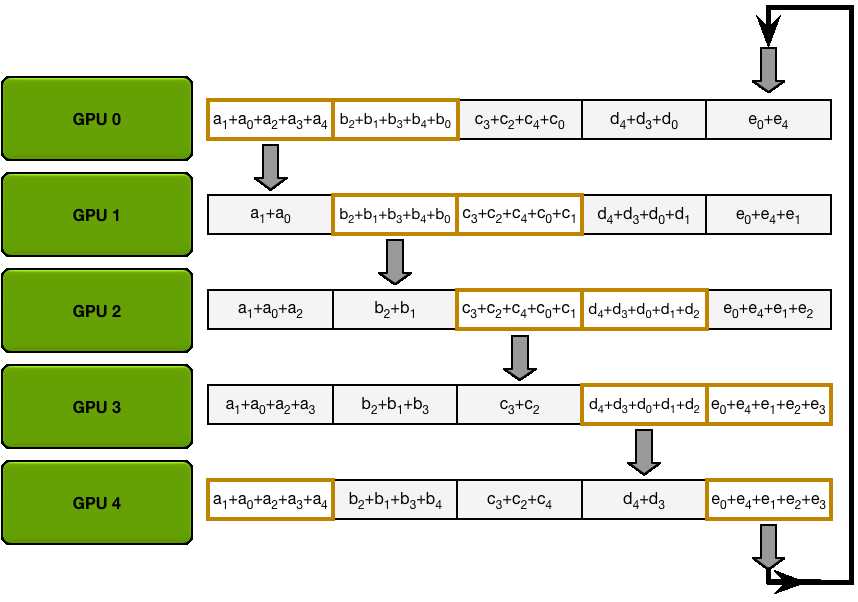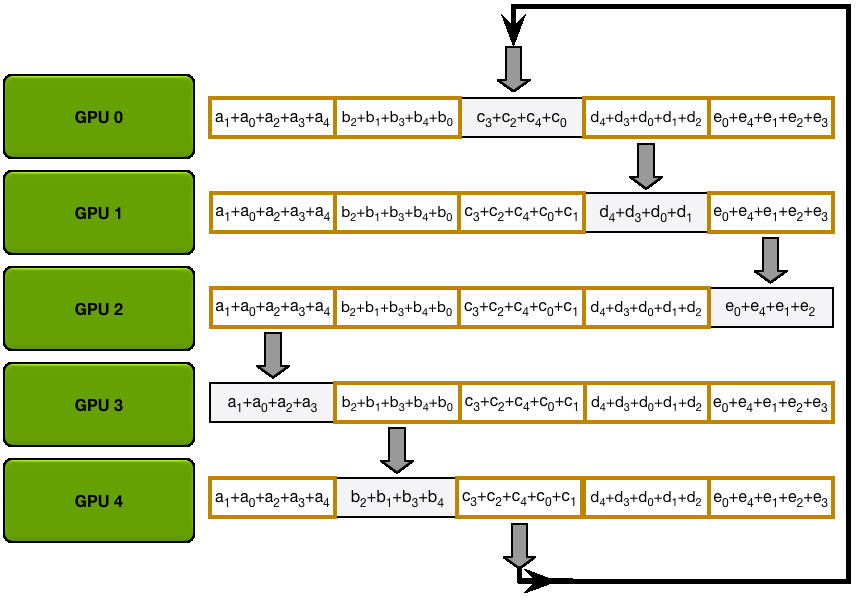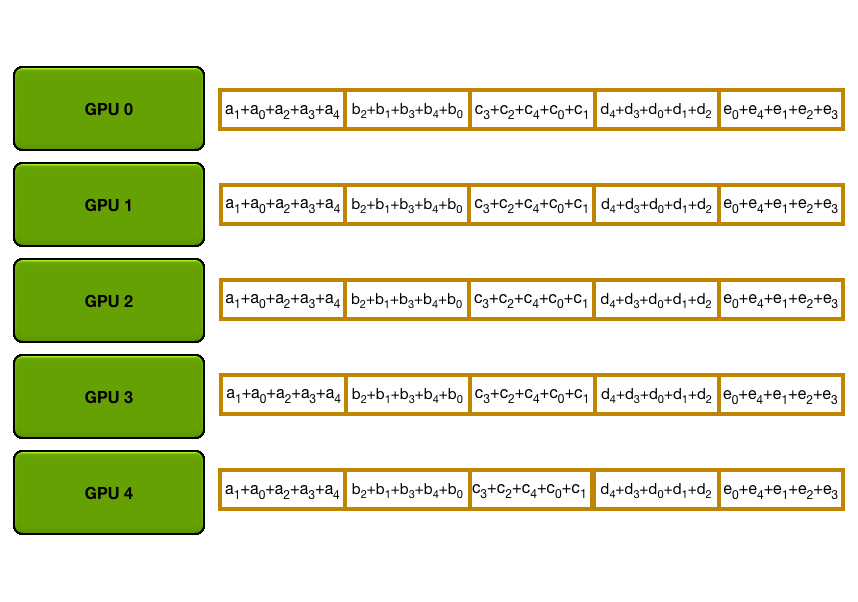
- 接下来,每个设备需要从其他设备那里收集这些已经完全归约好的数据块
- 每个设备会将自己持有的归约后数据块发送给相邻设备,并从另一个相邻设备接收数据块
- 设备会不断转发接收到的数据块,直到每个设备都拥有所有已经归约完成的数据块,从而使每个设备都获得完整的、加总后的梯度
-
-
可以通过下面的动画来直观理解这一过程。假设有 5 个 GPU,每个 GPU 上都有一个长度为 5 的张量。第一个动画展示的是 ReduceScatter 阶段,在该阶段结束时,每个 GPU 都得到了某一个特定数据块(橙色矩形)对应的归约结果
- 下一个动画展示的是 AllGather 阶段,在该阶段结束时,每个 GPU 都获得了 AllReduce 操作的完整结果:
-
在 ReduceScatter 和 AllGather 这两个阶段中,每个 GPU 都会发送和接收 次数据
-
每一次传输中,每个 GPU 会发送 个数值,其中 是在所有 GPU 之间参与求和的数值总数
-
因此,每个 GPU 的总通信数据量为
-
当 (GPU 的数量)很大时,每个 GPU 的通信数据量近似为
- 其中 是参数(或梯度)总数
-
关于 AllReduce,有两个关键点需要记住:
-
当 (GPU 数量)较大时,AllReduce 的通信成本大约是
-
一个 AllReduce 操作可以分解为一次 ReduceScatter 加一次 AllGather,而这两个操作各自的通信成本大约是 AllReduce 的一半,即约为
-
可以看到,这种实现方式即使在节点之间带宽有限的情况下,也能够非常高效地利用通信资源
-
Barrier
-
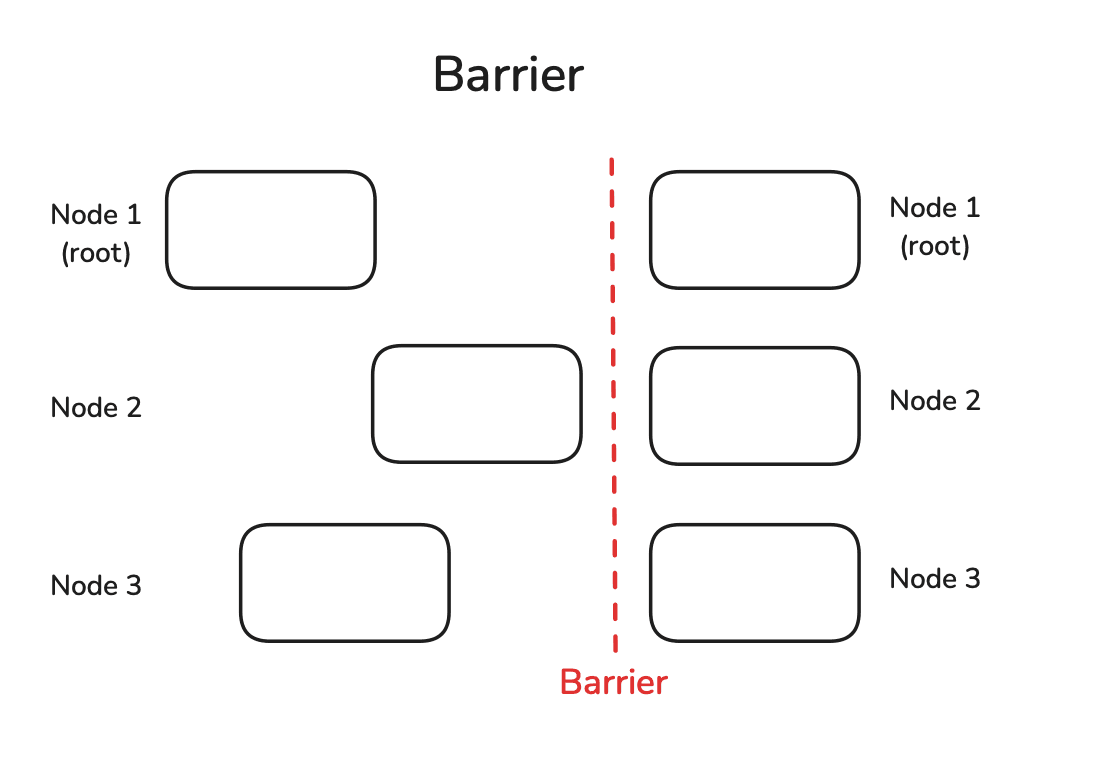
Barrier(屏障)是一种非常简单的同步操作,用于让所有节点在某个执行点上对齐
-
只有当所有节点都到达这个屏障之后,Barrier 才会被解除,随后所有节点才能继续进行后续计算
-
可以通过在不同节点上设置不同的休眠时间,来模拟节点处理速度不一致的情况,并观察它们通过 Barrier 所需的时间
def example_barrier(): rank = dist.get_rank() t_start = time.time() print(f"Rank {rank} sleeps {rank} seconds.") time.sleep(rank) # 模拟不同的处理时间 dist.barrier() print(f"Rank {rank} after barrier time delta: {time.time()-t_start:.4f}") init_process() example_barrier() -
从输出中可以看到,尽管 rank 0 完全没有休眠,它依然需要等待最慢的节点,最终也花了大约 2 秒才能通过 Barrier:
Rank 0 sleeps 0 seconds. Rank 1 sleeps 1 seconds. Rank 2 sleeps 2 seconds. Rank 0 after barrier time delta: 2.0025 Rank 1 after barrier time delta: 2.0025 Rank 2 after barrier time delta: 2.0024 -
这说明 Barrier 会强制所有节点以 “最慢节点” 的速度前进
-
因此,在使用这类全局同步操作时需要格外谨慎,因为它违背了并行、独立执行的初衷,可能会拖慢整体处理速度
-
在很多场景下,让更快的节点先一步开始处理下一项任务其实是完全可以接受的 —— 因为在后续迭代中,这些节点可能反而会变慢,从而在整个计算过程中自然地平衡掉这些延迟
NCCL
-
有多种实现了集合通信(collective communication)的库,并且都得到了 PyTorch 的支持
- 经典的 MPI(Message Passing Interface,消息传递接口)
- Meta 开发的 Gloo
- NCCL(NVIDIA Collective Communications Library,NVIDIA 集体通信库)
-
它们在提供的集合通信模式上功能相似,但针对不同的硬件配置进行了优化:
-
NCCL 专门为 GPU-GPU 之间的高效通信而设计
-
MPI 和 Gloo 则更适合 CPU-CPU 或 CPU-GPU 之间的通信
-
-
PyTorch 官方提供了一份 很好的指南,帮助选择合适的通信后端
-
GPU 训练:使用 NCCL
-
CPU 训练:使用 Gloo
-