CUDA
介绍 CUDA 的基础知识,包括 GPU 架构、CUDA 编程模型、PyTorch 中的 CUDA 支持等内容
CUDA
-
CUDA(Compute Unified Device Architecture)
- CUDA 是 NVIDIA 提供的一套并行计算平台和编程模型,用于在 GPU 上运行高性能计算任务
- 核心思想:让开发者可以使用类似 C/C++ 的语言编写程序,在 GPU 上并行执行大量线程
- 功能:提供线程管理、内存管理、硬件加速指令等接口,让 GPU 能高效执行计算密集型任务(矩阵运算、卷积、模拟等)
-
nvcc 是 CUDA 的编译器(NVIDIA CUDA Compiler)
- 作用:将 CUDA 代码(包含 CPU 端和 GPU 端代码)编译成可在 CPU 和 GPU 上运行的二进制文件
- 将 GPU 核心代码(kernel)编译成 PTX 或 SASS,然后由 GPU 执行
- 将 CPU 端代码编译成普通可执行程序
- 例如,写了
.cu文件,运行nvcc my_kernel.cu -o my_program,就会生成可以调用 GPU 的程序
-
CUDA Toolkit 是 NVIDIA 提供的一整套开发工具包,包括 nvcc 编译器、GPU 库(cuBLAS、cuDNN、cuFFT 等高性能计算库)、调试工具、分析工具、示例代码和文档
-
NVIDIA 驱动是 GPU 与操作系统之间的桥梁
- 提供底层硬件访问接口(管理 GPU 资源、执行 GPU 指令),让 CUDA 程序可以实际在 GPU 上运行
- 即使安装了 CUDA Toolkit,没有安装兼容的 NVIDIA 驱动,GPU 也不能工作
- 驱动版本必须与 CUDA Toolkit 兼容,否则可能报错或无法使用 GPU
-
PyTorch 与 CUDA
- PyTorch 可以使用 CUDA Toolkit 提供的库(如 cuBLAS、cuDNN)来执行 GPU 运算
- PyTorch 通过 CUDA API 调用 GPU,GPU 通过 NVIDIA 驱动执行具体指令,nvcc/Toolkit 用于在本地编译扩展 CUDA 内核(例如自定义 ops)
-
CUDA 的执行流程
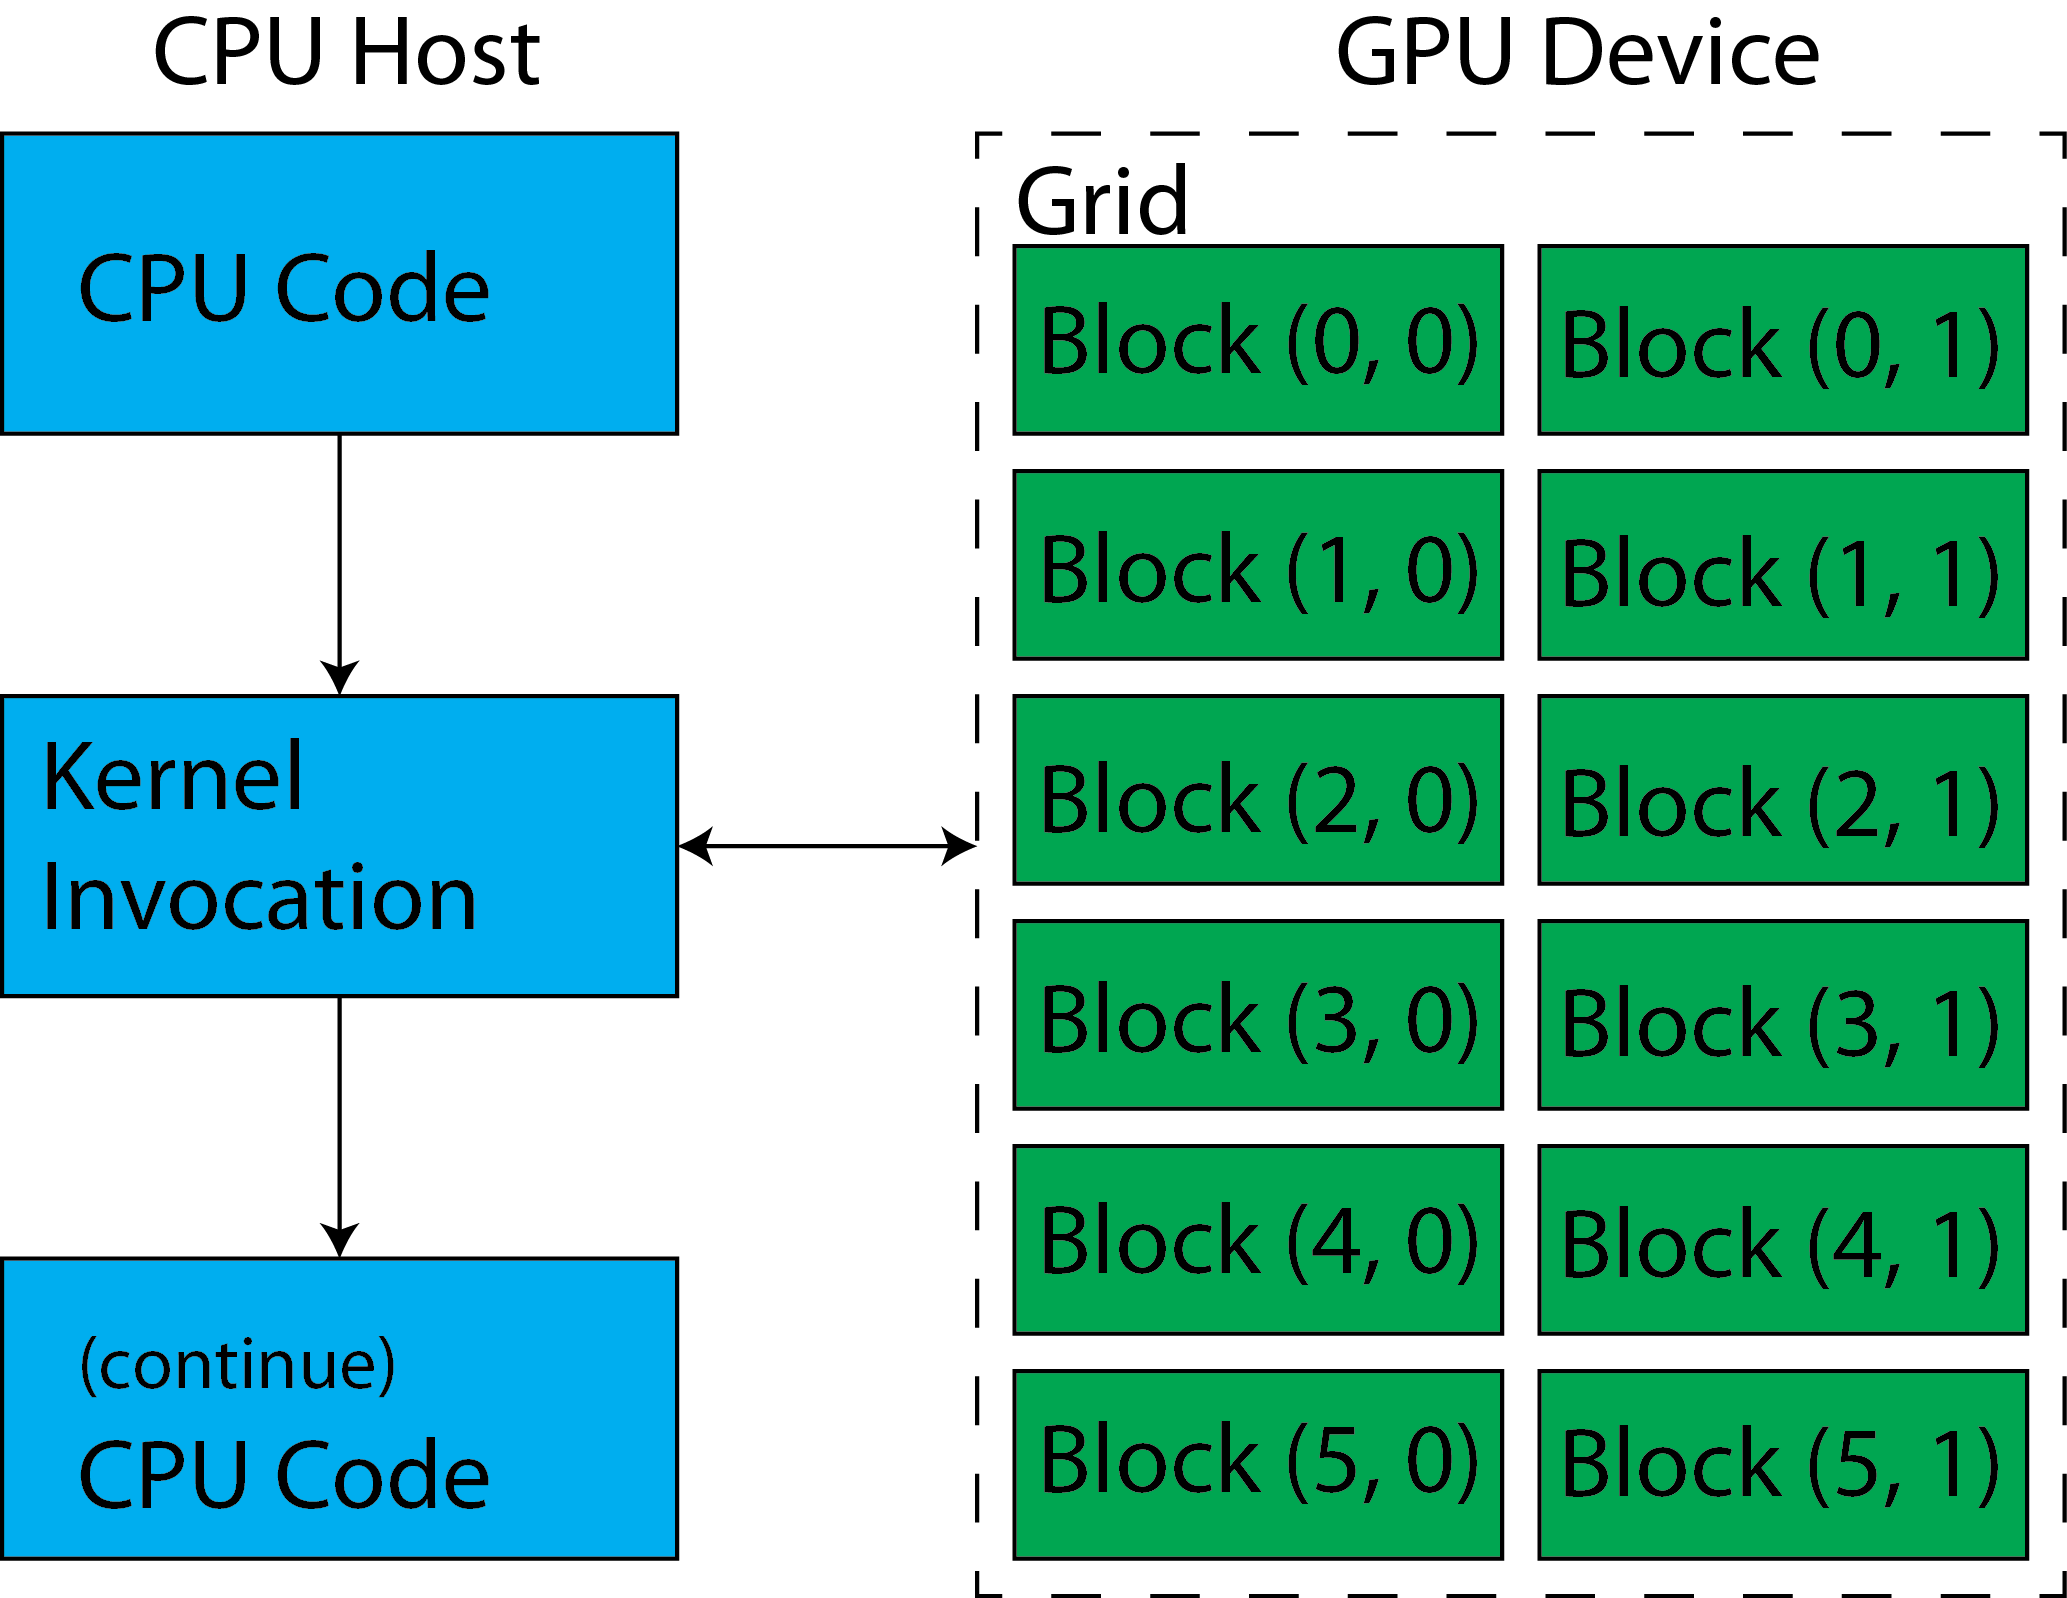
- 一个 CUDA 程序依赖两个主要组件:主机(host)和一个或多个 GPU 设备(device)
- 其中,主机负责执行主机代码(仅在 CPU 上运行的代码),GPU 设备负责执行设备代码(在 GPU 上运行的代码)
- 典型的 CUDA 程序通常从主机代码开始执行,在某个时刻调用核函数(kernel),来告诉 GPU 开始执行设备代码
- 这里,设备代码的执行是异步的,也就是说,在核函数调用之后,主机代码会继续执行而不会等待 GPU 完成计算;为此,CUDA 提供了显式和隐式的主机与设备同步机制
- 通过调用核函数,CUDA 程序会在 GPU 上启动大量线程,这些线程会并行执行核函数,这些线程被组织成线程块(block),多个线程块又组成网格(grid)
- 一次核函数调用只会启动一个网格,其内部的块和线程可以逻辑上排列成多维结构,每个线程块中的线程数量以及每个网格中的线程块数量,受 GPU 设备和其计算能力(Compute Capability) 的限制
-
cuBLAS(CUDA Basic Linear Algebra Subprograms)
- cuBLAS 的本质是:一组针对 GPU 架构高度特化的线性代数 kernel 集合,以及一套在运行时选择合适 kernel 的调度逻辑
- 它解决的核心技术问题是,在 GPU 的执行模型(SIMT、层级存储、有限寄存器、SM 并行)下,如何把以下操作做到接近硬件极限吞吐:
- 向量运算(Level-1 BLAS)
- 矩阵–向量运算(Level-2 BLAS)
- 矩阵–矩阵运算,尤其是 GEMM(Level-3 BLAS)
- 其中,GEMM 是绝对的核心,因为它满足三个条件:计算密集、数据复用强、可规则分块,非常适合 GPU
- 在实现层面,cuBLAS 的工作可以拆解为几件非常具体的事情:
- 把矩阵乘法拆分成 block /warp/thread 多级 tiling
- 明确哪些数据放在 global memory、shared memory、register
- 控制 shared memory 访问模式以避免 bank conflict
- 通过增加并发 warp 数量来隐藏 global memory latency
- 在支持的硬件上,将 FP16 / BF16 的矩阵乘法映射到 Tensor Core 指令
- 根据矩阵尺寸(如是否是方阵、是否是小 batch)选择完全不同的 kernel 实现
- 也就是说,cuBLAS 并不是 “一个矩阵乘法实现”,而是几十甚至上百个不同实现 + 选择逻辑
- 而在 API 层面调用的是同一个
cublasGemmEx,但在底层,走到的是完全不同的执行路径 - 一个重要的技术事实是:cuBLAS 的性能高度依赖输入张量的布局和数据类型,例如:
- 行主序 / 列主序是否需要转置
- 是否是对齐的 leading dimension
- batch GEMM 是否能合并
- 是否满足 Tensor Core 对 shape 和对齐的要求
- 这也是为什么在框架层面,经常通过改变 tensor layout、强制 contiguous、调整 reshape 顺序来 “优化 cuBLAS 性能”
-
cuDNN(CUDA Deep Neural Network library)
-
cuDNN 并不是 “比 cuBLAS 更高级”,而是针对一类特定计算模式提供了更直接的算子封装
-
它解决的问题是:对于卷积、归一化、激活等结构化算子,如何在不同参数组合下选择合适的实现算法
-
以卷积为例,从技术上看,卷积并不是一个单一算法,而是一族算法:
- 直接卷积(direct convolution)
- im2col + GEMM(本质上调用 cuBLAS)
- FFT-based convolution
- Winograd convolution
-
这些算法在以下维度上的表现完全不同:
- FLOPs 数量
- 对 memory bandwidth 的压力
- 中间 buffer 的大小
- 数值误差特性
- 对 kernel size /stride/dilation 的适配范围
-
cuDNN 的技术职责就是:
- 为同一个 “卷积算子语义” 维护多种算法实现
- 根据输入 shape、参数配置、数据类型、GPU 架构
- 在运行前或运行时选择一个可用且性能最优的实现
-
这里有一个很重要但常被忽略的点:cuDNN 并不保证选择 “全局最优” 的算法,它只保证在约束条件下选择一个可行且高性能的算法,例如:
- workspace 内存受限时,会放弃更快但占用内存大的算法
- 某些算法在 backward 上数值不稳定,会被禁用
- 某些 shape 下 autotune 本身的代价过高
-
从实现关系上讲,cuDNN 的很多路径最终会落到 cuBLAS,例如 im2col + GEMM 路径,本质是:
-
cuDNN 负责 reshape 和算法选择,cuBLAS 负责真正的矩阵乘法 kernel
-
CUDA Device 与 Context
-
device 的定义
device是一个计算位置的抽象描述,是一个可独立执行 kernel 的 GPU 实体,它决定 Tensor 的物理存储位置和运算 kernel 运行在哪类硬件上- 关键原则是,一个算子,只能作用在同一 device 上的 Tensor
- Tensor 出生在哪个 device,就一直待在那里,PyTorch 不会自动移动数据的位置,且 model /data/intermediate 必须在同一个 device
- 如
cuda:0, cuda:1, cuda:2, ...等只是一个逻辑编号,不等于进程 / 内存空间 / 执行上下文
-
device 的职责:执行 kernel、管理 device memory、提供 stream /event 等执行资源
-
CUDA Context
-
CUDA Context 是一个进程在某个 device 上的完整执行环境,它包含:
- 已分配的 GPU 内存
- kernel module
- stream /event
- cuBLAS /cuDNN 状态
- cache /allocator 状态
-
Context ≈ GPU 版的进程地址空间
-
Context 在第一次 CUDA API 调用时创建,比如:
tensor.cuda()model.to("cuda")torch.cuda.current_stream()
-
例如
print(torch.cuda.memory_allocated())  # 可能是 0
x = torch.randn(10).cuda()            # 这里才创建 context
-
-
进程与 GPU
-
一个进程在一个 device,对应一个 context,如
Process A + cuda:0 → Context A0 Process A + cuda:1 → Context A1 -
但当一个进程多 GPU = 多 Context 时,Context 的切换代价昂贵、内存 allocator 分离、cuBLAS /cuDNN 状态不共享、stream 管理复杂
-
因此,PyTorch 的设计是让一个进程只绑定一个 CUDA context,强制「一进程一张卡」
-
-
device 与 context 的映射
- 基于「一进程一张卡」的设定,可以为当前进程设置其 rank,即
torch.cuda.set_device(local_rank) - 以上代码设置了当前进程默认使用的 CUDA device,在之后执行的操作都会自动分配到 rank 对应的 GPU 上
.cuda()→ cuda:local_ranktorch.empty(..., device="cuda")→ cuda:local_rank
- 在实践中,需要尽早进行 set_device,这是因为如果在 set_device 之前创建了 CUDA Tensor,这时 Context 已经绑定到 cuda:0,之后再进行 set_device 时,会拥有多个 context,可能会导致显存碎片、性能下降、DDP 行为异常等问题
- 基于「一进程一张卡」的设定,可以为当前进程设置其 rank,即
-
既然不同的 rank 对应的进程只控制一张 GPU,其 Context 完全隔离,那么梯度等如何同步?
- 通过 NCCL、GPU 直接通信(NVLink / PCIe)等方式
- 即,Context 不共享内存, 但可以通过通信原语交换数据
-
Context 与 Stream 的关系
- Stream 是隶属于 Context 的,也就是说不同 context 的 stream 永远不能交互,所有异步行为都发生在同一个 context 内
- 这就是为什么一进程一 context 是前提,否则 stream /event 会发生错误
-
迁移模型:model.to (device) = 把 model 的所有参数 + buffer 移到 device
model = MyModel() model = model.to(device) # model.cuda() # 更推荐使用 .to(device),可以统一切换到 CPU / CUDA / MPS -
迁移数据:DataLoader 生成的数据永远都是在 CPU 上,必须在训练循环中手动迁移到 GPU 中
x = x.to(device) y = y.to(device) # 如果 CPU Tensor 来自 pinned memory,允许 CPU → GPU 拷贝异步进行 # 前提是 DataLoader 设置 pin_memory=True,Tensor 还在 CPU 上 x = x.to(device, non_blocking=True) -
什么时候在 CPU 和 GPU 之前迁移数据
-
每个 batch 的 x /y 一定在 forward 之前移动至 GPU 中,不能在 Dataset /collate_fn 中,因为 Dataset / DataLoader 是多进程,GPU context 不安全
for x, y in dataloader: x = x.to(device) y = y.to(device) -
GPU Tensor 在以下情况中回到 CPU 中
loss_value = loss.item() # 标量 preds_cpu = preds.cpu() # Tensor array = preds.cpu().numpy() # 保存 numpy # accuracy 统计、可视化 -
.item()会强制同步 GPU,所以不要在训练主路径里调用.item(),而日志可以 batch /step 间隔做,这也是训练慢的经典原因之一for step in range(...): print(loss.item()) # ❌ 每一步同步 GPU
-
-
多卡训练前的基本约束(DDP)
-
DDP 的硬约束:一张卡一个进程,不能一个进程用多张 GPU,也不能一个 GPU 跑多个 DDP rank
-
device 绑定必须明确
local_rank = int(os.environ["LOCAL_RANK"]) torch.cuda.set_device(local_rank) device = torch.device("cuda", local_rank) # 所有 Tensor → device # model → device # DDP(model, device_ids=[local_rank]) -
不能出现的行为
- 在 Dataset 里
.cuda() - 在 forward 里新建 CPU Tensor
- 在 loss 里混用 CPU / GPU Tensor
- 在 rank != 0 做 IO(保存、打印)
- 在 Dataset 里
-
所有 rank 的计算图必须一致 —— 每个 rank 必须执行完全相同的 forward /backward 结构,否则 DDP 的 AllReduce 会卡死,程序不报错,但会一直 hang
-