CUDA 优化
介绍 CUDA 优化的基本方法和技巧,包括访存模式优化、数据复用优化、片上存储优化等内容
Memory bound 优化之访存模式
Memory Coalescing
-
GPU 访问全局内存(DRAM)相比访问寄存器或共享内存要慢很多,所以需要尽量减少访问全局内存的开销
-
GPU 的内存组织
- 内存合并访问指的是将一个 warp(32 个线程)的全局内存访问请求合并成一次单一的内存操作
- 实现这种优化最容易的情况是,当访问的数据连续存储在内存中,并且从一个良好的内存对齐边界开始
- 当 warp 中的 32 个线程都参与访问时,这类请求相当于从 L1 缓存中加载一个缓存行(cache line),速度非常快
- NVIDIA GPU 的缓存行大小设计为 32 个单精度浮点数(4 字节 /float),总共 128 字节,然而,大多数类型的 RAM 数据通道宽度通常不超过 64 字节,这意味着从全局内存填充一个 GPU 缓存行需要多次事务,为此,NVIDIA 将 GPU 设计为每次可以访问全局内存中的连续 32 字节(8 个单精度浮点数)
- 因此,一个缓存行被划分为 4 个 “扇区”(sector),每个扇区 32 字节,可以独立从全局内存加载
- 例如,如果 warp 的 32 个线程访问内存中连续的 32 个单精度浮点数,并且数据不在 L1 或 L2 缓存(发生 L2 cache miss),则最少需要 4 次全局内存事务才能加载全部数据;但实际可能需要更多次,因为内存访问必须对齐到特定地址
-
DRAM 的突发传输(burst)特点
- DRAM 不是一次只返回一个数据,它一次访问一个地址时,会顺便把这个地址附近的一段连续数据也读出来
- 这些连续数据由 DRAM 内的多个传感器并行读取,然后通过高速通道一次性传给处理器
- 也就是说,如果程序访问连续地址,DRAM 可以一次性高效地返回一大块数据,而不是每次访问都慢慢取
-
使用
cudaMalloc()分配的内存至少按 256 字节对齐,这有助于保证内存访问能够合并,然而,以下情况仍可能导致内存访问无法合并:- 数组索引不是连续的
- 内存访问稀疏,例如通过结构体访问
- 内存访问未对齐,例如数组索引与线程索引存在偏移
-
内存访问模式示例
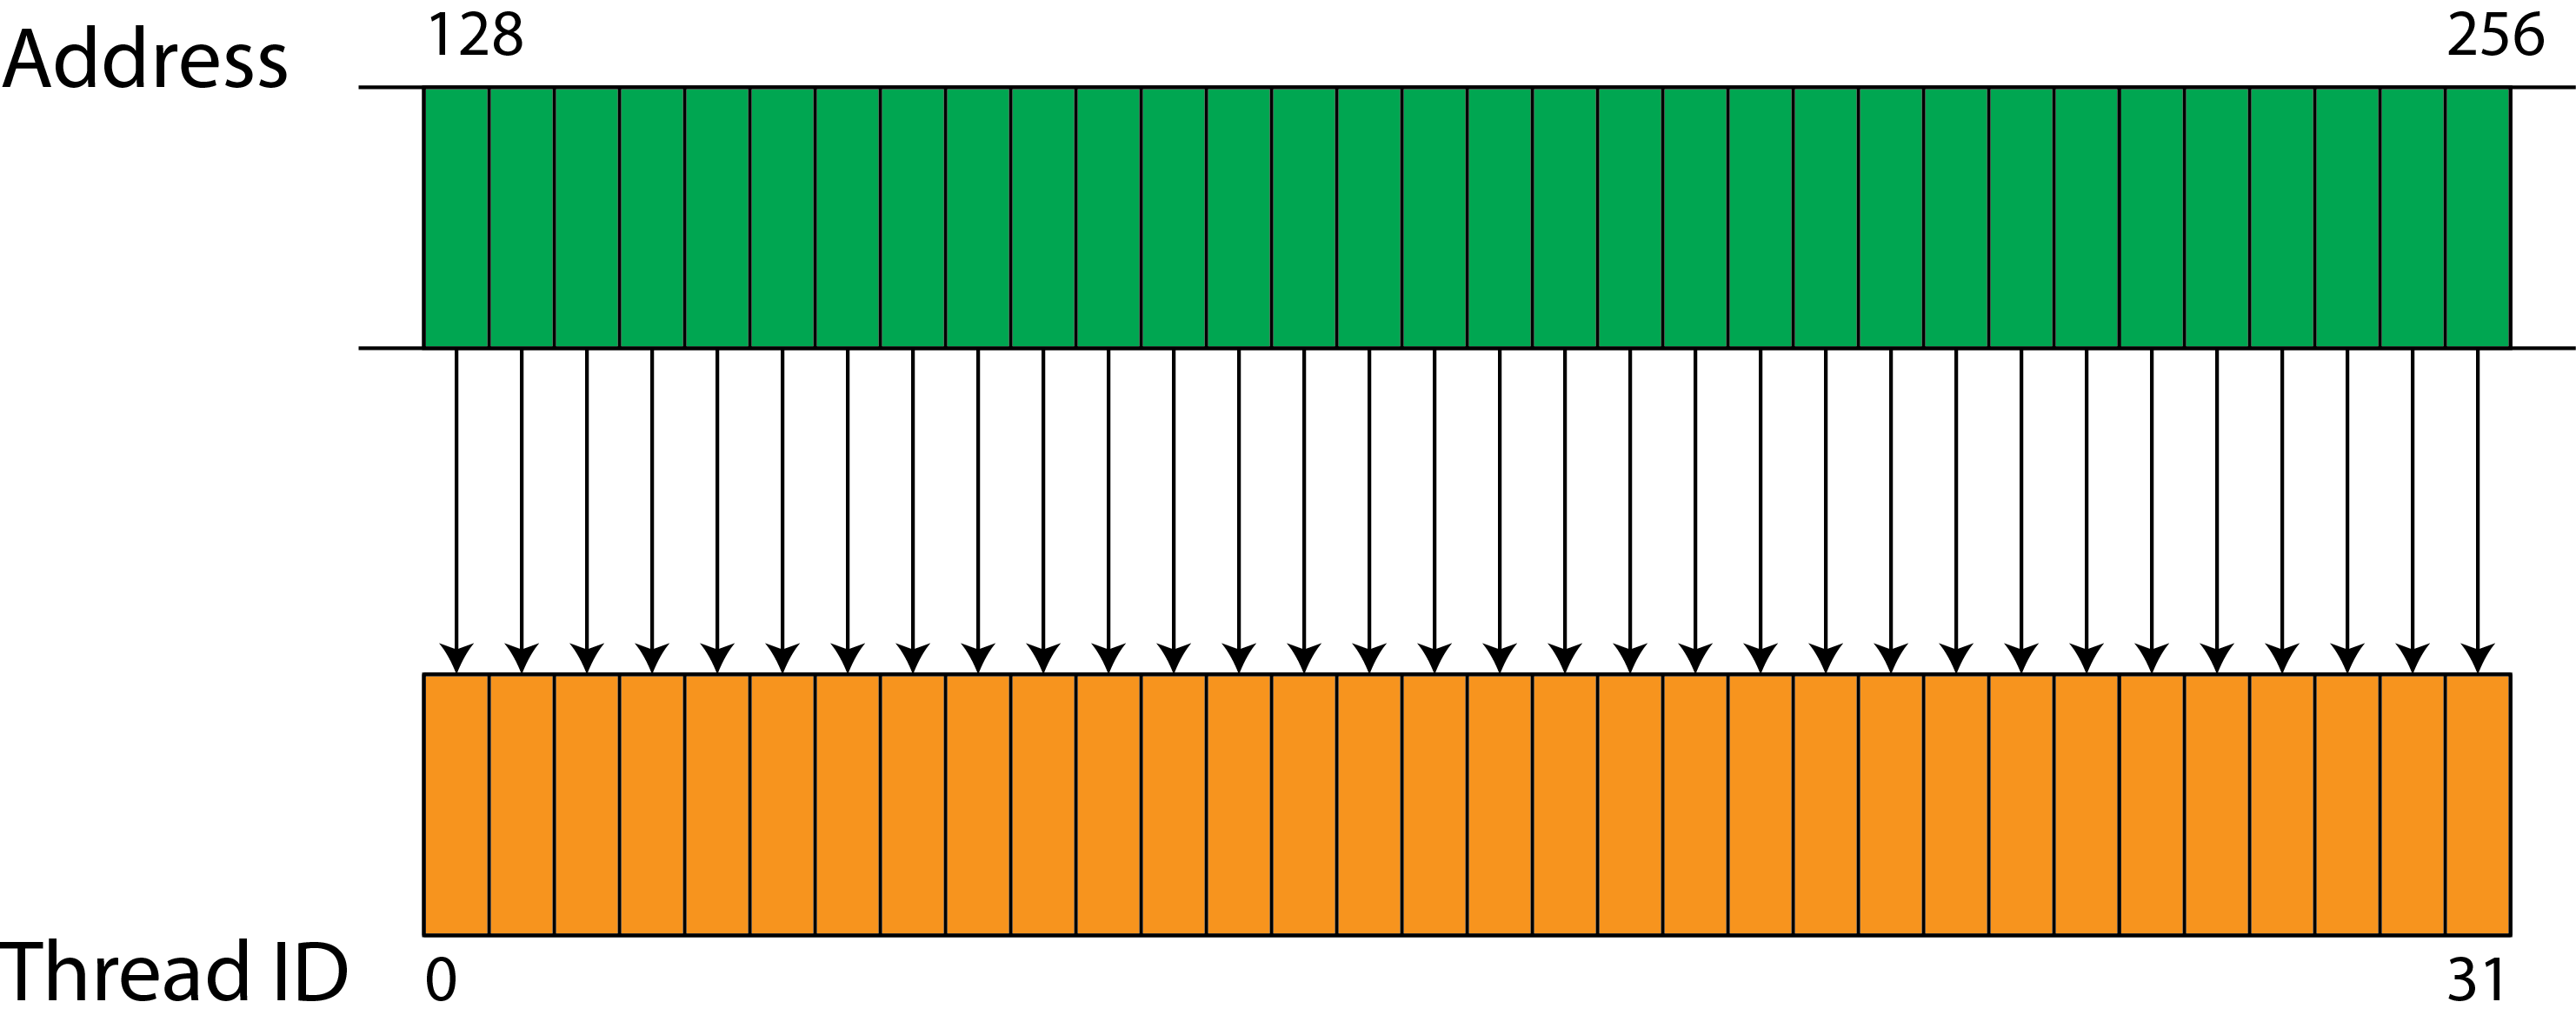
- 连续且对齐(Sequential and Aligned):如果 32 个连续线程访问连续内存地址,访问是顺序且对齐的,因此可以合并为一次操作,只需一次事务即可加载 32 个单精度浮点数
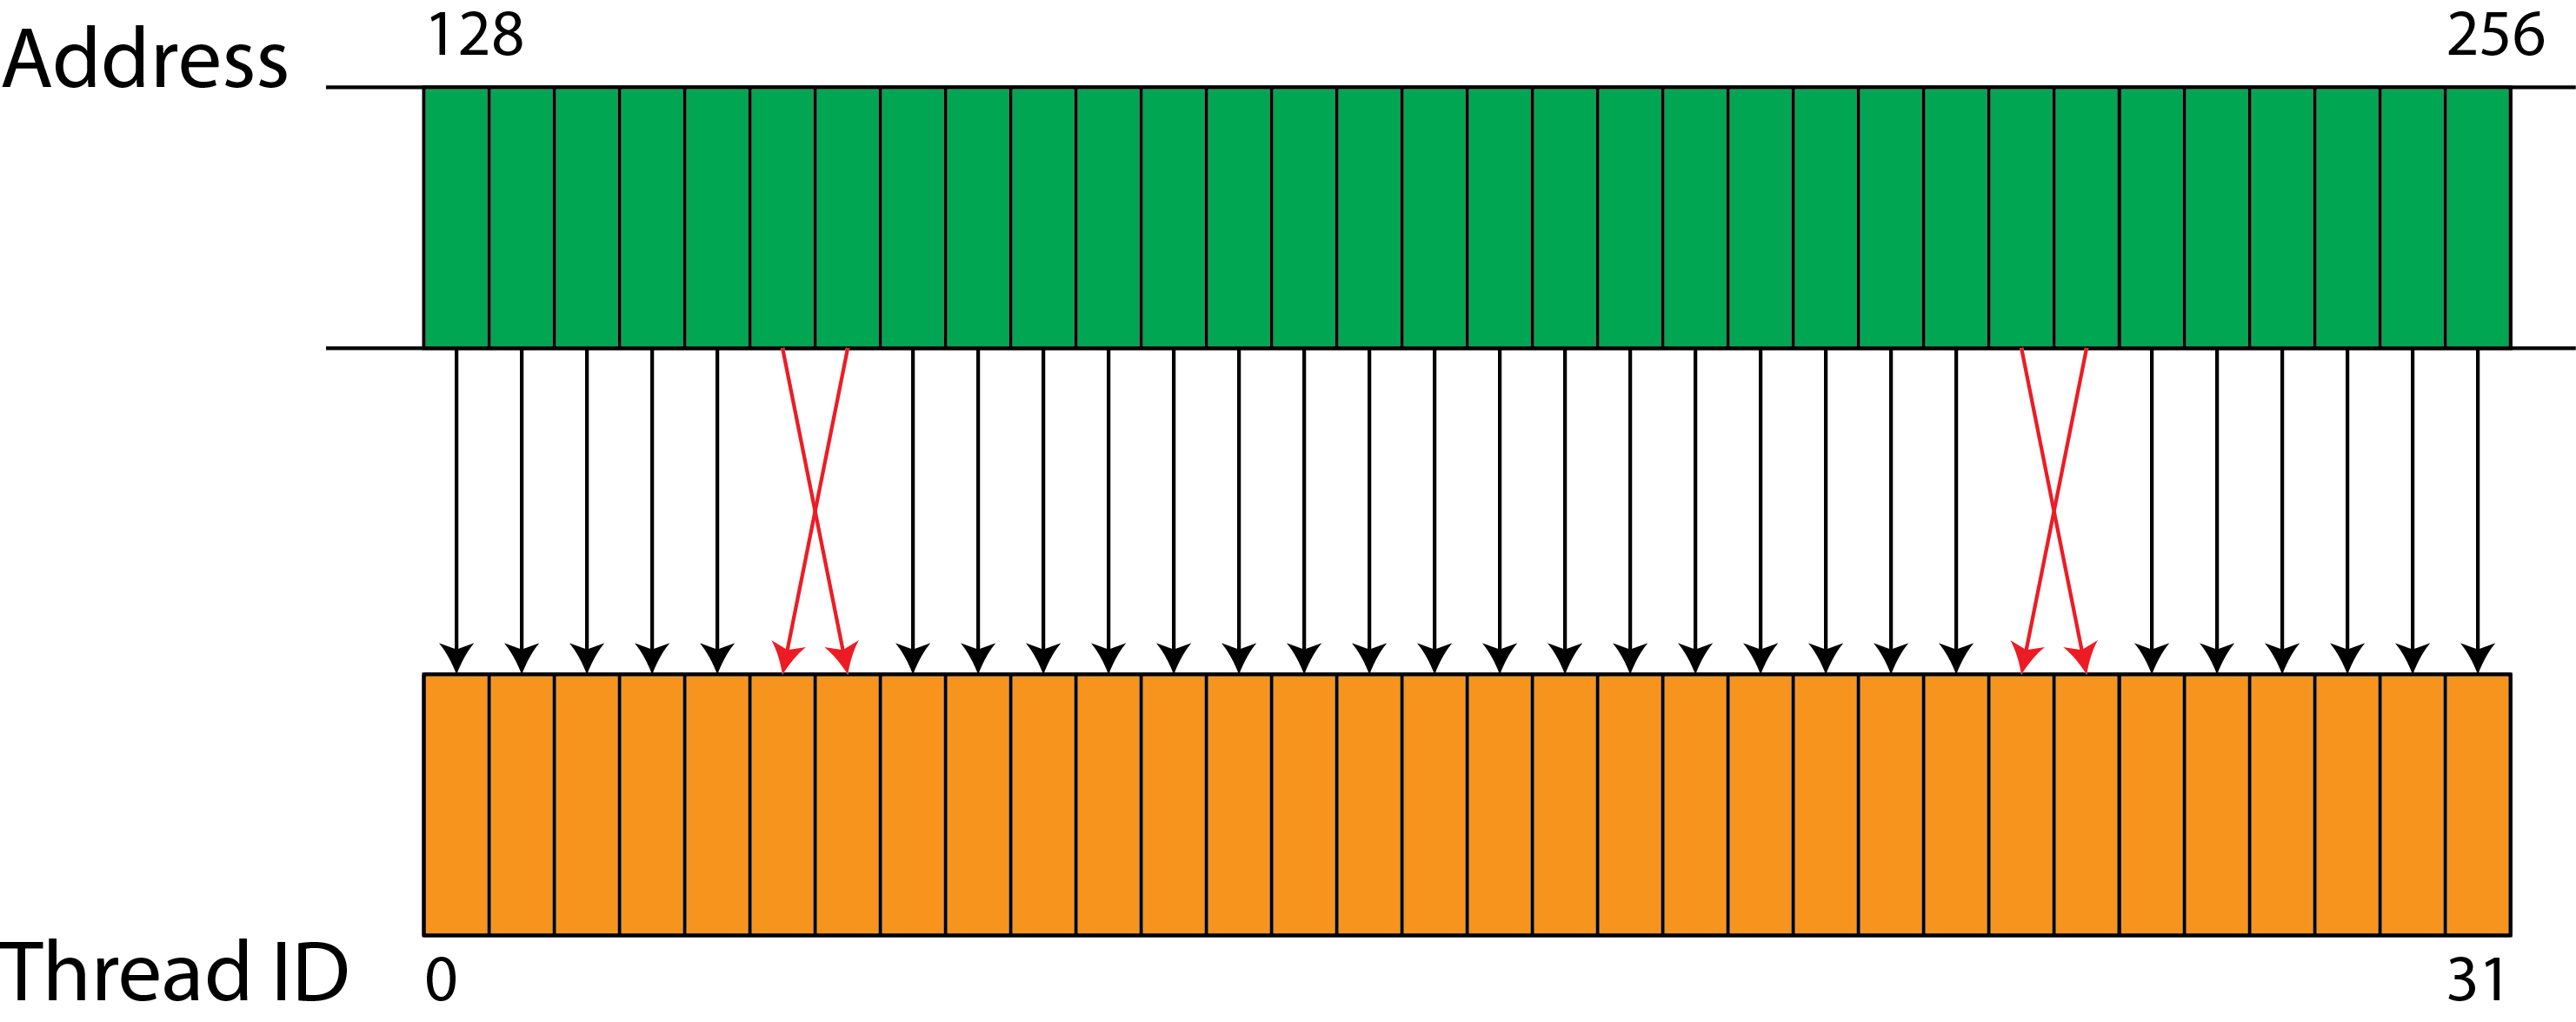
- 对齐但不连续(Aligned but Non-sequential):内存地址虽然对齐,但线程访问的不是连续地址
- 在现代 NVIDIA GPU 上,这种模式仍可能被合并为一次操作,但早期计算能力的 GPU 不支持这种合并
- 不连续访问(Not Consecutive):内存访问既不连续也可能未对齐,需要多次内存事务才能完成
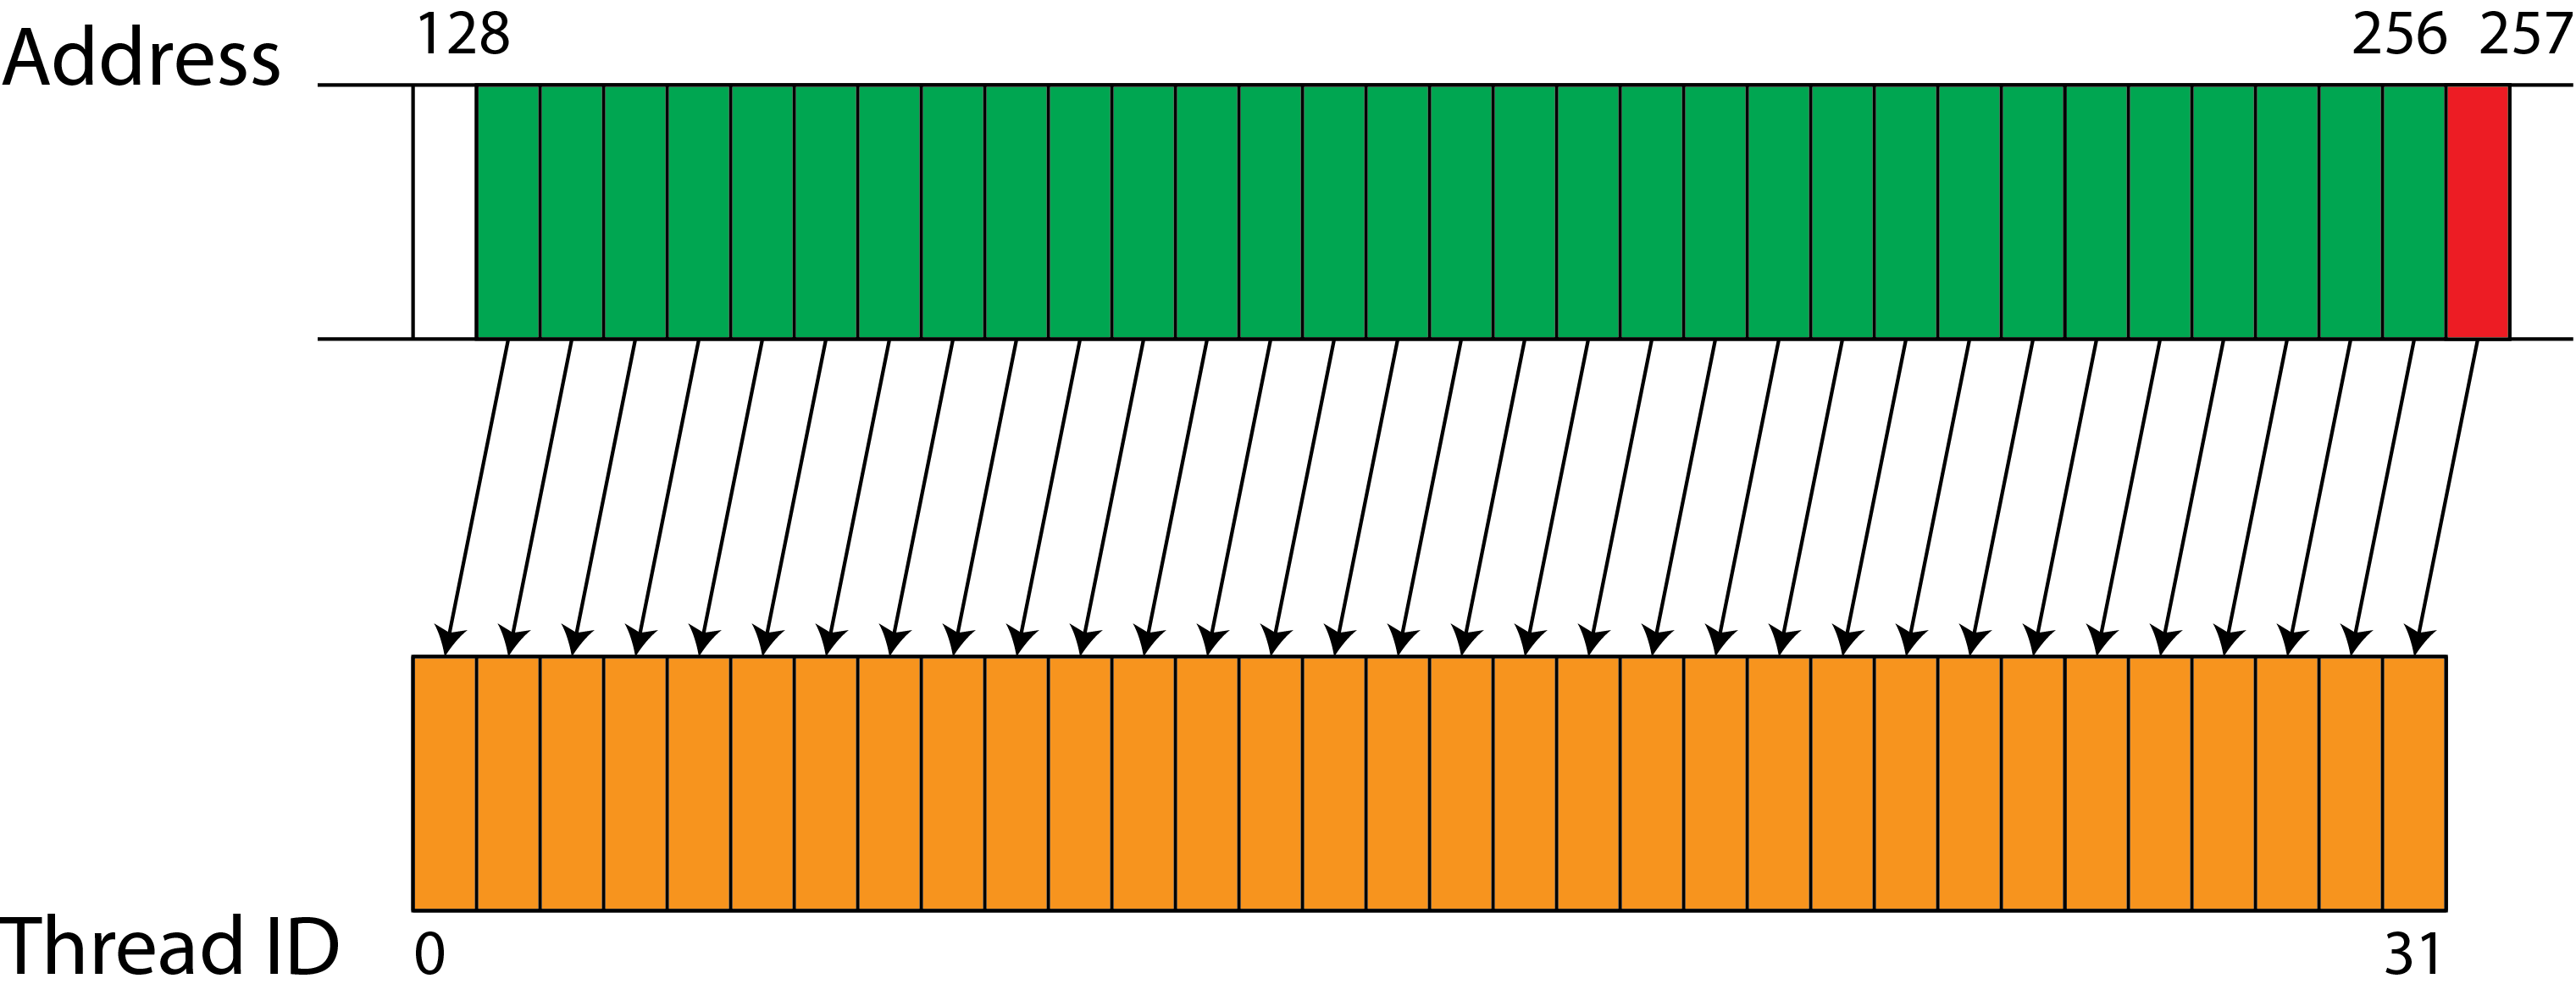
- 未对齐访问(Misaligned Access):如果访问起始地址未对齐,即使访问连续内存,也可能需要两次或更多内存事务才能完成
-
memory coalescing
- 内存合并的目标是让同一个 warp 内的线程访问连续的内存地址
- 如线程 0 访问 M、线程 1 访问 M+1、线程 2 访问 M+2,以此类推
- 这样 GPU 硬件可以把这些访问请求 “合并” 为一次大的 DRAM 访问请求(一次突发传输),效率比每个线程单独访问高很多
-
朴素的矩阵乘法实现
__global__ void matmul_naive(int M, int N, int K, const float *A, const float *B, float *C) { const uint x = blockIdx.x * blockDim.x + threadIdx.x; const uint y = blockIdx.y * blockDim.y + threadIdx.y; if (x < M && y < N) { float tmp = 0.0; for (int i = 0; i < K; ++i) { tmp += A[x * K + i] * B[i * N + y]; } C[x * N + y] = tmp; } } -
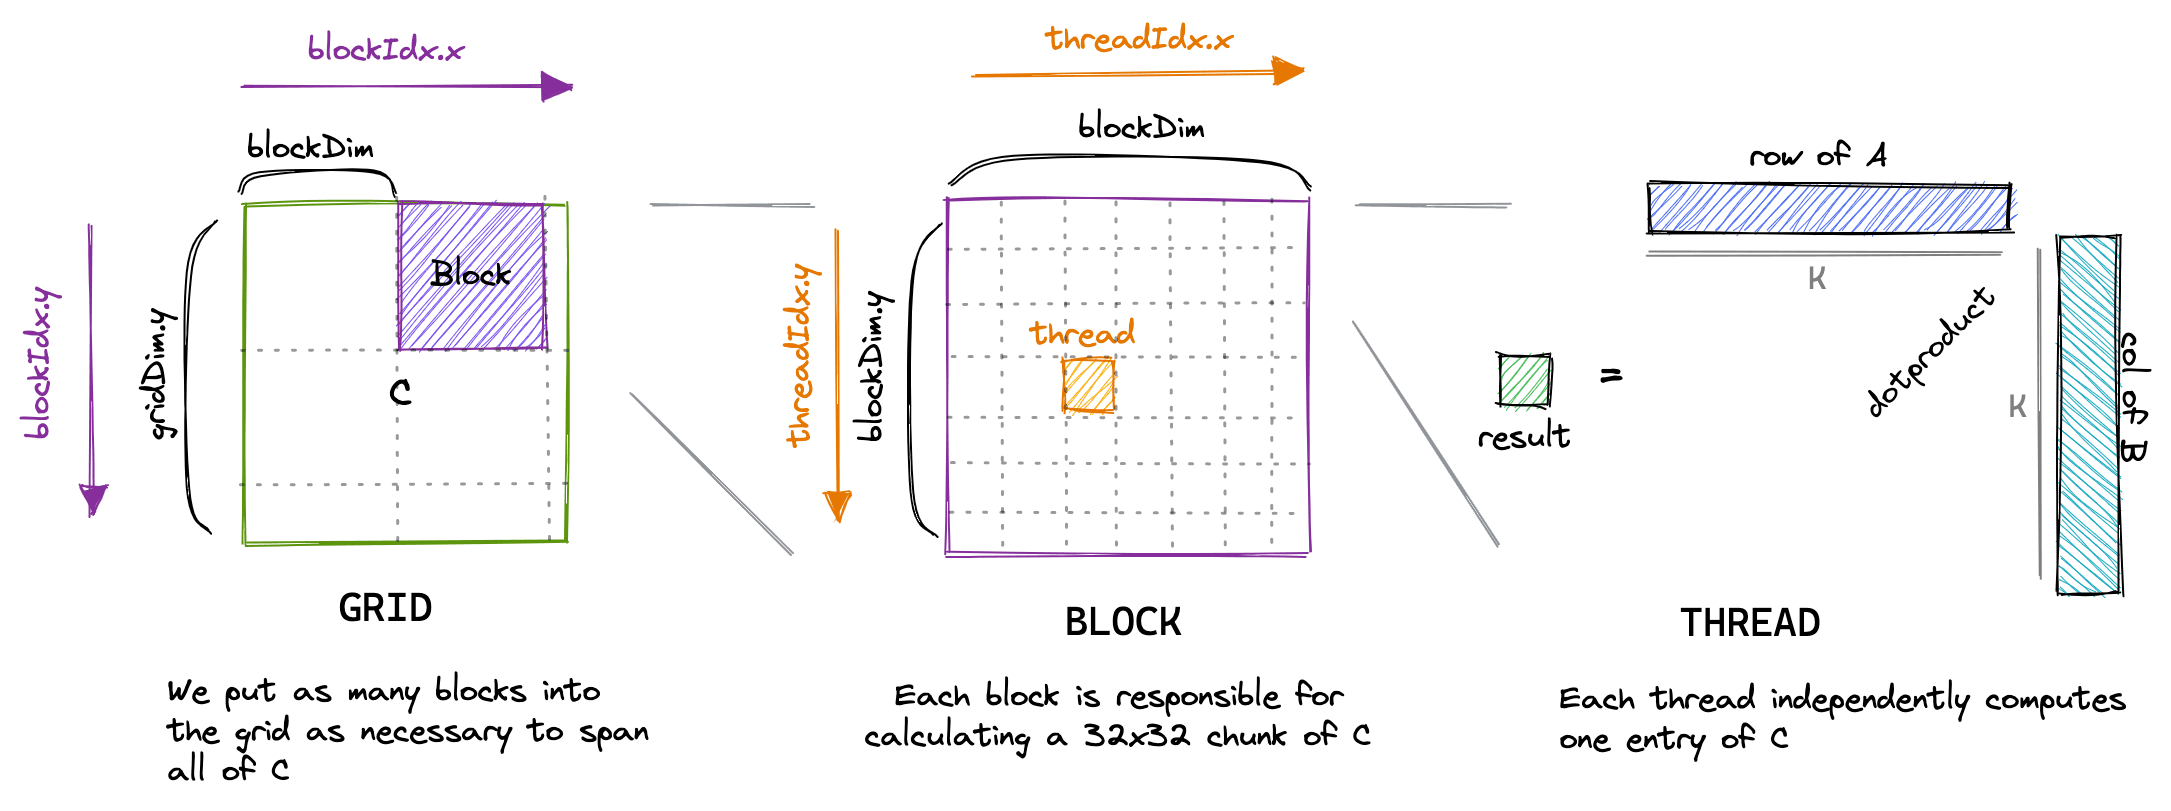
Simon Boehm 的 blog post 可视化说明了这个过程
-
上述 kernel 是在做矩阵乘法,而矩阵天然是二维的,行 → x、列 → y
-
所以常见的映射方式是一个线程 ↔ 矩阵里的一个元素,用 (x, y) 表示这个元素的位置
-
在这个实现中,每个线程负责计算输出矩阵 中的一个元素 ,计算公式是
-
对应到代码里,
x:输出矩阵的行号,y:输出矩阵的列号,循环里的i:沿着 维度做点积 -
对于一个 warp 中的线程 和 (即
threadIdx.x连续、threadIdx.y相同) -
在同一次循环 中,线程 访问 ,线程 访问
-
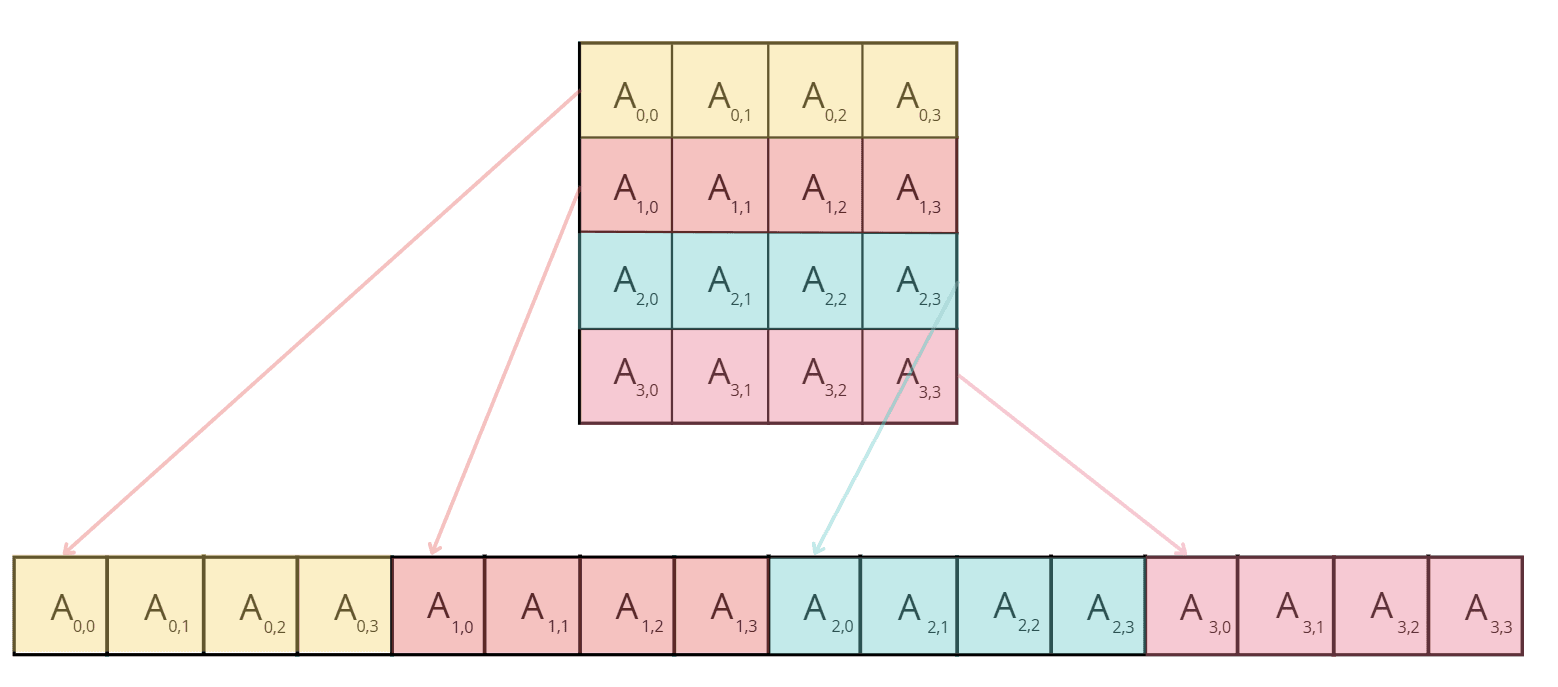
由于矩阵 A 采用 row-major 存储,同一行的数据在内存中是连续的,不同行之间相隔 个 float
-
因此 和 在内存中相隔 个 float,不是连续地址,导致 warp 内的全局内存访问无法合并(uncoalesced)
-
原有方法使用 2D block,threadIdx.x → 列方向,threadIdx.y → 行方向,使得同一个 warp 内的线程 x 不同,导致访问的是 A 的不同 “行”
-
可以改为使用 1D block,用一个 threadIdx.x 手动 “拆” 出二维坐标:
-
直观理解上,
threadIdx.x / BLOCKSIZE→ 行内编号(决定 x),threadIdx.x % BLOCKSIZE→ 列内编号(决定 y)const int x = blockIdx.x * BLOCKSIZE + (threadIdx.x / BLOCKSIZE); const int y = blockIdx.y * BLOCKSIZE + (threadIdx.x % BLOCKSIZE); if (x < M && y < N) { float tmp = 0.0; for (int i = 0; i < K; ++i) { tmp += A[x * K + i] * B[i * N + y]; } C[x * N + y] = tmp; } -
这也使得同一个 warp 中的线程 x 相同(同一行),而 y 连续变化(不同列)
-
对于矩阵 A,访问模式是 ,由于 warp 内
x相同,i相同(warp 锁步执行),所以所有线程访问的是同一个 A 元素,要么命中 L1 / L2 cache,要么由硬件自动广播 -
对于矩阵 B,访问模式是 ,由于 warp 内
i相同,y连续,因此线程访问的是: -
而矩阵 B 是 row-major 存储的,这正好对应内存中的连续地址,完美符合 DRAM burst 的访问模式,内存合并成功发生
-
经过改进后,内存带宽提高 10 倍,执行时间下降 10 倍
Layout transformation
数据重排
Memory bound 优化之数据复用
Block Tiling
-
问题分析
- 在 GPU 的内存层次中,全局内存的容量大,但慢,而共享内存的容量小,但非常快,且一个 block 内的线程都能访问
- 问题在于,在朴素矩阵乘法中,每个线程都会从全局内存中独立读取自己需要的 A 的一行和自己需要的 B 的一列
- 但同一个 block 内的线程实际上会反复读取大量相同的 A 和 B 元素
- 结果导致全局内存被重复访问,带宽浪费严重,算力被共享内存拖慢
- 因此,Tiling 的核心思想是把 “大家都会用到的数据”,只从全局内存读一次,然后放进共享内存反复用
-
以矩阵乘法为例
-
假设进行运算:
-
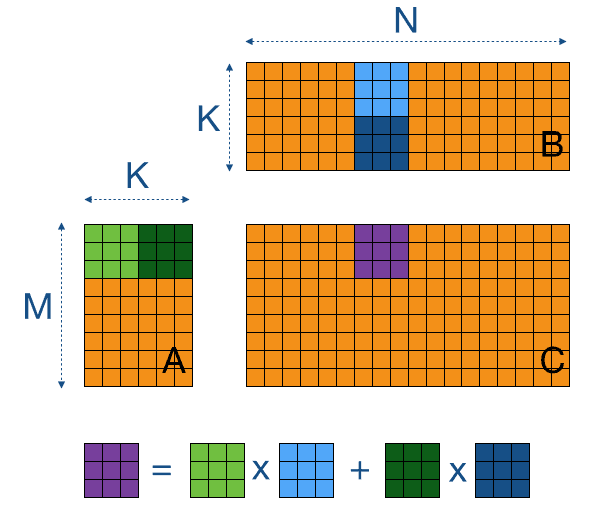
Tiling 会把大矩阵拆成很多小块:
- A 的一个 tile:
- B 的一个 tile:
-
这些 tile 的大小通常正好适合放进共享内存,并且和 block 中线程的排布对应
-
-
一次 Tiling 迭代,本质上就是沿着 维 “推进一步”
- 协作加载
- block 内所有线程一起行动,从全局内存中加载一个 A 的 tile,加载一个 B 的 tile
- 每个线程只负责加载其中的一小部分,加载完成后,数据放在共享内存里
- 这一步的特点是:全局内存访问次数少,访问模式可以做到内存合并
- 同步:使用 __syncthreads (),确保 A、B 的 tile 已经全部加载完成,没有线程读到未初始化的数据
- 在 shared memory 中计算
- 现在每个线程需要的数据都已经在共享内存里,访问延迟极低
- 于是线程就可以计算
- 并把结果累加到一个寄存器里的 accumulation matrix 中
- 这个 accumulation 是 跨 tile 的,不会每次清零
- 沿着 维移动到下一个 tile,重复加载、同步、计算、累加,直到所有 tile 都处理完
- 协作加载
-
通过 Tiling,内存吞吐量提高到 410 Gb/s,执行时间下降~43%,计算性能达到~6.6 TFLOPS
// Set pointers to the starting elements
A += blockRow * TILE_SIZE * K; // Start at row = blockRow, column = 0
B += blockCol * TILE_SIZE; // Start at row = 0, column = blockCol
C += blockRow * TILE_SIZE * N + blockCol * TILE_SIZE; // Start at row = blockRow, column = blockCol
float sum = 0.0;
// The outer loop moves through tiles of A (across columns) and B (down rows)
for (int tileIdx = 0; tileIdx < K; tileIdx += TILE_SIZE) {
sharedA[localRow * TILE_SIZE + localCol] = A[localRow * K + localCol];
sharedB[localRow * TILE_SIZE + localCol] = B[localRow * N + localCol];

// Ensure all threads in the block have completed data loading
__syncthreads();

// Shift pointers to the next tile
A += TILE_SIZE;
B += TILE_SIZE * N;

// Compute the partial dot product for this tile
for (int i = 0; i < TILE_SIZE; ++i) {
    sum += sharedA[localRow * TILE_SIZE + i] * sharedB[i * TILE_SIZE + localCol];
}
// Synchronize again to prevent any thread from loading new data
// into shared memory before others have completed their calculations
__syncthreads();
}
C[localRow * N + localCol] = sum;
Warp Tiling
Thread / Register Tiling
多级 Tiling
-
可以看到,前面提到的 Tiling 技术与 Register Blocking 的核心思想一致,Tiling 是把大问题拆成能放进高速存储的小块,将数据从 DRAM 移至 shared memory;而 Register Blocking 继续做同一件事,但更激进,将数据从 shared memory 移至 register 中
-
GPU 的并行层次可以总结如下
层次 硬件概念 数量 共享存储 备注 Grid 整个 kernel 1 Global Memory Block Thread Block / Workgroup 数百到数千 Shared Memory 前面提到的 Tiling Warp/Subgroup 32 线程一组 每 Block 若干 寄存器(shuffle 共享) Register Blocking Thread 单个线程 每 Block 256-1024 寄存器 Register Blocking -
相关知识参考:
-
Tiling 代码示例
#include <stdio.h>

#define MATRIX_WIDTH  4096
#define MATRIX_HEIGHT 4096
#define TILE_SIZE 16


__global__ void naive_matmul(int *a, int *b, int *c)
{
    int row = blockIdx.y * blockDim.y + threadIdx.y;
    int col = blockIdx.x * blockDim.x + threadIdx.x;

    if (row < MATRIX_HEIGHT && col < MATRIX_WIDTH) {
        int sum = 0;
        for (int i = 0; i < MATRIX_WIDTH; i++) {
            sum += a[row * MATRIX_WIDTH + i] * b[i * MATRIX_WIDTH + col];
        }
        c[row * MATRIX_WIDTH + col] = sum;
    }
}


__global__ void tiled_matmul(int *a, int *b, int *c)
{
    __shared__ int tile_a[TILE_SIZE][TILE_SIZE];
    __shared__ int tile_b[TILE_SIZE][TILE_SIZE];

    int tx = threadIdx.x;
    int ty = threadIdx.y;
    int bx = blockIdx.x;
    int by = blockIdx.y;
    int row = by * TILE_SIZE + ty;
    int col = bx * TILE_SIZE + tx;

    int value = 0;
    for (int i = 0; i < (MATRIX_WIDTH + TILE_SIZE - 1) / TILE_SIZE; i++) {
        if (row < MATRIX_HEIGHT && i * TILE_SIZE + tx < MATRIX_WIDTH) {
            tile_a[ty][tx] = a[row * MATRIX_WIDTH + i * TILE_SIZE + tx];
        } else {
            tile_a[ty][tx] = 0;
        }

        if (col < MATRIX_WIDTH && i * TILE_SIZE + ty < MATRIX_HEIGHT) {
            tile_b[ty][tx] = b[(i * TILE_SIZE + ty) * MATRIX_WIDTH + col];
        } else {
            tile_b[ty][tx] = 0;
        }

        __syncthreads();

        for (int j = 0; j < TILE_SIZE; j++) {
            value += tile_a[ty][j] * tile_b[j][tx];
        }

        __syncthreads();
    }

    if (row < MATRIX_HEIGHT && col < MATRIX_WIDTH) {
        c[row * MATRIX_WIDTH + col] = value;
    }
}


int main()
{
    int *h_a, *h_b, *h_naive_c, *h_tiled_c;
    int *d_a, *d_b, *d_naive_c, *d_tiled_c;

    int n = MATRIX_WIDTH * MATRIX_HEIGHT;
    int size = n * sizeof(int);
    dim3 threadPerBlock(TILE_SIZE, TILE_SIZE);
    dim3 blockPerGrid((MATRIX_WIDTH + threadPerBlock.x - 1) / threadPerBlock.x,
                      (MATRIX_HEIGHT + threadPerBlock.y - 1) / threadPerBlock.y);

    h_a = (int *)malloc(size);
    h_b = (int *)malloc(size);
    h_naive_c = (int *)malloc(size);
    h_tiled_c = (int *)malloc(size);

    cudaMalloc(&d_a, size);
    cudaMalloc(&d_b, size);
    cudaMalloc(&d_naive_c, size);
    cudaMalloc(&d_tiled_c, size);

    for (int i = 0; i < n; ++i) {
        h_a[i] = rand() % (100);
        h_b[i] = rand() % (100);
    }

    cudaMemcpy(d_a, h_a, size, cudaMemcpyHostToDevice);
    cudaMemcpy(d_b, h_b, size, cudaMemcpyHostToDevice);

    // Naive version
    cudaEvent_t naive_start, naive_end;
    cudaEventCreate(&naive_start);
    cudaEventCreate(&naive_end);

    cudaEventRecord(naive_start);
    for (int i = 0; i < 10; i++) {
        naive_matmul<<<blockPerGrid, threadPerBlock>>>(d_a, d_b, d_naive_c);
    }
    cudaEventRecord(naive_end);
    cudaDeviceSynchronize();
    cudaMemcpy(h_naive_c, d_naive_c, size, cudaMemcpyDeviceToHost);

    float naive_elapsed_time;
    cudaEventElapsedTime(&naive_elapsed_time, naive_start, naive_end);
    printf("Time taken: %f ms for 10 trials by the naive method\n", naive_elapsed_time);

    cudaEventDestroy(naive_start);
    cudaEventDestroy(naive_end);

    // Tiled version
    cudaEvent_t tiled_start, tiled_end;
    cudaEventCreate(&tiled_start);
    cudaEventCreate(&tiled_end);

    cudaEventRecord(tiled_start);
    for (int i = 0; i < 10; i++) {
        tiled_matmul<<<blockPerGrid, threadPerBlock>>>(d_a, d_b, d_tiled_c);
    }
    cudaEventRecord(tiled_end);
    cudaDeviceSynchronize();
    cudaMemcpy(h_tiled_c, d_tiled_c, size, cudaMemcpyDeviceToHost);

    float tiled_elapsed_time;
    cudaEventElapsedTime(&tiled_elapsed_time, tiled_start, tiled_end);
    printf("Time taken: %f ms for 10 trials by the tiled method\n", tiled_elapsed_time);

    cudaEventDestroy(tiled_start);
    cudaEventDestroy(tiled_end);

    // Comparison
    int errors = 0;
    for (int i = 0; i < n; i++) {
        if (h_naive_c[i] != h_tiled_c[i]) {
            errors++;
        }
    }
    printf("Number of errors: %d\n", errors);

    cudaFree(d_a);
    cudaFree(d_b);
    cudaFree(d_naive_c);
    cudaFree(d_tiled_c);
    free(h_a);
    free(h_b);
    free(h_naive_c);
    free(h_tiled_c);

    return 0;
}
Memory bound 优化之片上存储优化
共享内存优化
-
在 GPU 内存层级中
- Register → 线程私有(最快)
- Shared Mem → Block 共享(很快)
- Global Mem → 显存(慢)
-
因此 Kernel 设计中,需要尽量少访问 global memory,尽量把数据搬进 shared 或 register
Bank Conflict
-
shared memory 是在一个 SM 内给一个 block 的所有线程提供的高速 SRAM,它的设计目标是让一个 block 里的线程可以非常快地共享数据
-
为了并行访问,GPU 会把 shared memory 划分为多个 bank(通常 32 个,恰好等于 warp 的线程数),即一个 shared memory 包含多条独立告诉通道
-
当内核(kernel)为每个 block 分配共享内存时,地址会根据以下公式映射到 bank:
-
NVIDIA GPU 的 bank 数固定为 32(与 warp 大小相同)
-
默认 word 大小为 4 字节(float 或 int),也可以设置为 8 字节(double)
-
变量在共享内存中声明的顺序决定了它们的 bank 分配
-
例如,如果声明了一个 16 个 float 的数组(16 个 word,64 字节):
-
第 1 个 word 映射到 bank 0,第 2 个到 bank 1,以此类推,第 16 个到 bank 15
-
下一个声明的变量接着映射到 bank 16,依此类推
-
动态分配的数组会在所有静态声明之后映射
-
-
-
每个 bank 在一个 cycle 内只能服务于一次访问,理想情况下,一个 warp 有 32 个线程,shared memory 有 32 个 bank,那么 32 个线程同时读,1 个 cycle 即可完成
-
bank conflict 发生在多个线程访问同一个 bank 的不同 word 时,因为一个 bank 一次只能返回一个 word,访问会变为串行
-
例如,如果在共享内存中分配了 256 字节(64 个 word):
- 线程访问 bytes 0-3(word 0)和 bytes 128-131(word 32) → 都在 bank 0 → 发生冲突
- 如果访问 bytes 132-135(word 33) → 在 bank 1 → 不发生冲突
- 如果多个线程访问同一个地址 → 值会被广播,不产生冲突
// shared memory 地址到 bank 的映射通常是 bank = address % 32 __shared__ float tile[32][32]; float x = tile[threadIdx.x][k]; // address = base + row * stride + col // 如果 stride 恰好是 32,那么所有 thread 的访问地址 % 32 相同,会全部落到同一个 bank 中 -
解决方法
- Padding:例如
__shared__ float tile[32][33];,使地址分布改变,冲突消失 - 改变访问顺序:例如行访问替换为列访问,或者转置 tile
- Warp-level shuffle:绕过 shared memory
- Padding:例如
-
Bank Conflict 的示例代码
#include <stdio.h> #define SIZE 1048576 #define OFFSET 33 __global__ void func(int *a, int n) { __shared__ int val[1024]; int tid = threadIdx.x; int idx = blockIdx.x * blockDim.x + threadIdx.x; if (idx < n) { val[tid * OFFSET % 1024] = a[idx]; a[idx] = val[tid * OFFSET % 1024] + 1; } } int main() { int *h_a; int *d_a; int size = SIZE * sizeof(int); int threadPerBlock = 1024; int blockPerGrid = (SIZE + threadPerBlock - 1) / threadPerBlock; h_a = (int *)malloc(size); cudaMalloc(&d_a, size); for (int i = 0; i < SIZE; ++i) h_a[i] = i; cudaMemcpy(d_a, h_a, size, cudaMemcpyHostToDevice); cudaEvent_t t0, t1; cudaEventCreate(&t0); cudaEventCreate(&t1); cudaEventRecord(t0); for (int i = 0; i < 100; i++) func<<<blockPerGrid, threadPerBlock>>>(d_a, SIZE); cudaEventRecord(t1); cudaEventSynchronize(t1); float t = 0; cudaEventElapsedTime(&t, t0, t1); cudaEventDestroy(t0); cudaEventDestroy(t1); printf("t: %.3f ms\n", t); cudaFree(d_a); free(h_a); return 0; } -
在上述代码中,OFFSET 决定 bank 冲突的程度
- OFFSET = 32 → 线程都访问同一个 bank → 最大冲突
- OFFSET = 1 → 无冲突
-
双缓冲
-
Async copy
Register 优化
Register Blocking
-
register 是每个 thread 私有,是在 SM 内速度最快的存储,访问 register 的开销基本是 1 cycle
-
例如对于矩阵乘法,假如一个线程只处理一个输出元素,那么每算一步,都要从共享 / 全局内存中读取数据,数据复用率很低
-
Register Blocking 的核心思想是,每个 thread 一次计算多个输出元素,并把中间数据存储在 register 中反复使用
# 未优化的 thread → C[i,j] # Register Blocking 后的,一个 thread 计算一个小 block(比如 2×2) thread → C[i,j], C[i,j+1], C[i+1,j], C[i+1,j+1] -
这种方法用算力换掉了内存访问,从而减少了 shared memory 访问,增加计算密度,提高算术强度
-
然而,Register Blocking 会导致每个 thread 用更多 register,SM 中能同时放的 thread 变少,Occupancy 下降
Register 压力控制
Comupute bound 优化
Thread Coarsening(线程粗化)
- 通过分析 warp states(warp 停顿状态),可以发现大量周期消耗在一个看起来很 “神秘” 的状态上:
smsp__pcsamp_warps_issue_stalled_mio_throttle - 通过查询 NVIDIA 的 Kernel Profiling Guide 后,发现该状态的含义是 warp 因为 MIO(memory input/output)指令队列已满而停顿,其中 MIO pipeline 负责共享内存访问、特殊数学指令、动态分支等
- Tiling 虽然大幅减少了共享内存的访问,把大部分数据访问转移到共享内存中,但共享内存不是 “免费” 的,它仍然有端口数量限制,有指令发射和 pipeline 吞吐上限
- 在 tiled GEMM 中,每个线程在内层循环中会频繁地从共享内存读取 A_tile 和 B_tile,这就导致 warp 内 32 个线程每一轮都会发射大量共享内存 load 指令
- 最终结果是共享内存流水线被占满,warp 只能等待,所以现在的瓶颈已经从全局内存延迟变成了共享内存指令吞吐
- 对于这种情况,NVIDIA 建议不要让很多线程反复做小而碎的共享内存访问,而是用更少的线程,每个线程一次处理更多数据,这正是 thread coarsening
- 线程粗化也即让一个线程负责计算多个输出元素,而不是一个线程只算一个,也可以理解为把原来多个 “细线程” 合并成一个 “粗线程”
- 这样可以减少共享内存访问次数,提高吞吐量
Fused Kernels
-
CPU 和 GPU 可以异步执行
- CPU(host)可以异步向 GPU 提交工作
- 提交 kernel 之后,CPU 不需要等 GPU 执行完,可以继续做别的事情
- GPU 自己按顺序执行队列里的 kernel
- 这使得通信(memory copy)和计算(kernel 执行)可以重叠,是 GPU 高吞吐的基础之一
-
虽然 CPU 和 GPU 可以异步,但如果程序结构是:
- 启动 kernel A
- 把结果写回 global memory
- 再启动 kernel B
- kernel B 再从 global memory 读回刚算完的数据
-
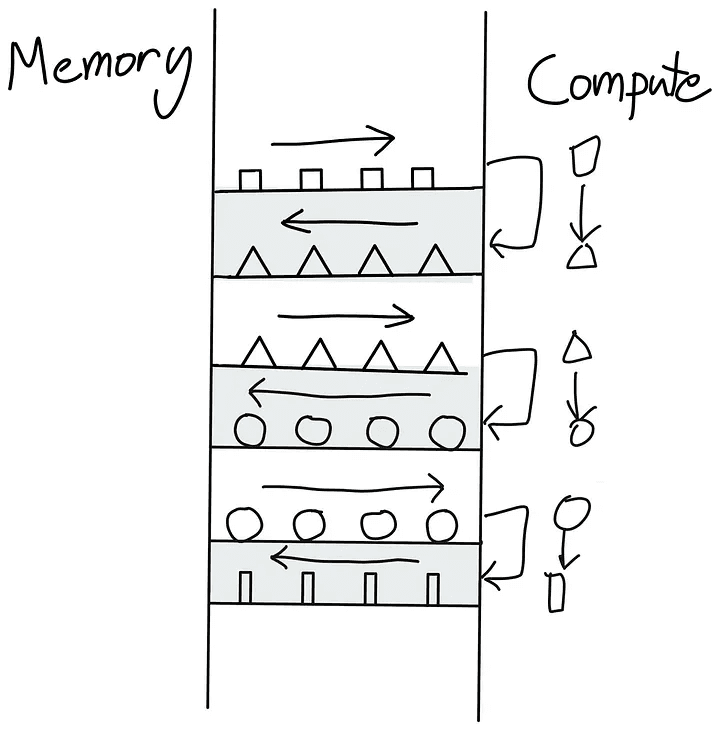
那么问题是全局内存是慢的,kernel launch 是有开销的,而数据在计算单元和全局内存之间反复 “折返跑”
-
下图形象描述了这个过程(Making Deep Learning go Brrrr From First Principles)
-
在这个反模式中,每一步计算写回全局内存,然后再读出来,即使这些中间结果马上就会被下一个 kernel 使用,这就导致了多次 DRAM 访问、多次 kernel 启动、pipeline 被打断
-
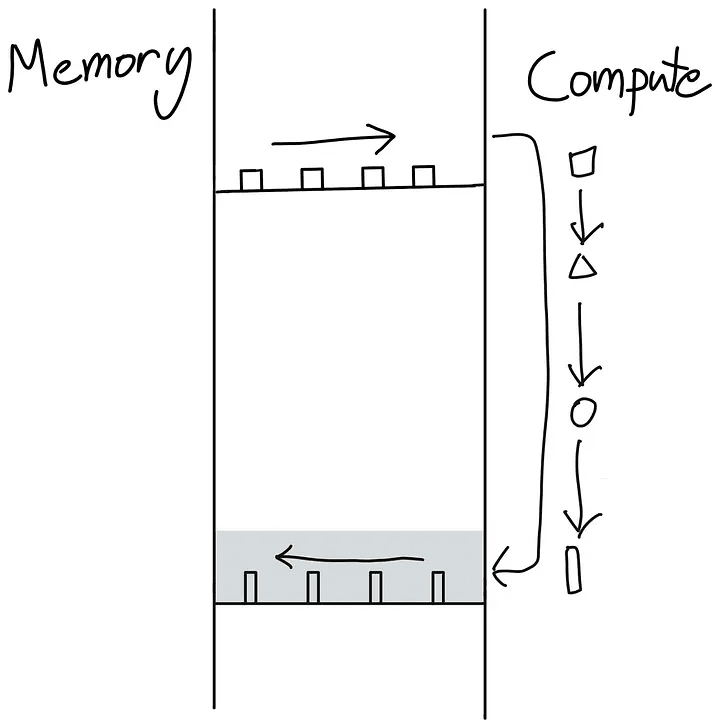
因此引入了核融合(kernel fusion):把多个原本需要分别启动的 kernel,合并成一个更大的 kernel
-
数据一旦进了 SM,就放在寄存器 / 共享内存,连续执行多个操作,最后只在必要时写回全局内存
-
这样做可以减少 kernel launch 次数、减少全局内存读写,提高数据局部性,让 GPU 更 “自主” 地完成一整段计算
-
融合内核尤其适合一系列逐点(point-wise)操作,其中 point-wise 操作指的是每个元素独立计算,不依赖其他元素,典型形式如加、乘、exp、sqrt、clamp、where 等运算,这些操作有一个共同点,即对每个 token / 元素独立,不存在跨元素的数据依赖
-
在 Transformer 里,这种 “逐点连续操作” 非常多,最典型的就是 LayerNorm
- LayerNorm 实际包含计算均值、计算方差、减均值、除标准差、乘 、加
- 如果使用 naive 方式,每一步一个 kernel,每一步都写回共享内存,性能会非常差
- 真正高性能实现一定是合并均值 + 方差 + 归一化 + affine,尽可能融合进少量 kernel
Pipeline Kernel
- Producer-consumer pipeline
- 多阶段流水
Latency-bound 优化
Thread Divergence(线程分歧)
-
Single Instruction, Multiple Data (SIMD) 执行模型
- 一个 warp = 32 个线程,同一时刻只取一条指令,这条指令会同时在 warp 内所有线程上执行,每个线程处理不同数据
- 这样设计的好处是指令取值、调度、分发这些控制逻辑只做一份,最大限度地减少了控制功能相关的硬件开销
- 那么就可以把更多硬件用在提高算术吞吐率上,这是 GPU 高性能的根本原因之一
- 同一个 warp 内的线程必须同时执行 相同的指令,也就是说,它们必须遵循同一条执行路径,那么当 warp 内出现条件判断(if 语句)时,线程如何执行?
-
if /else 中的线程分歧
-
假设 warp 内部分线程判断 if 条件为
true,部分为false,则 “true” 线程希望执行 if 块,“false” 线程希望执行 else 块 -
这种情况称为线程分歧(thread divergence),通常由分支语句引起
-
CUDA 的处理方式是:
- 先执行 if 块,即 if 条件为 false 的线程被 “停用”,保持空闲
- 再执行 else 块,之前停用的线程现在执行 else,而 if 条件为 true 的线程停用
-
可以看到,if 和 else 并不是并行执行的,而是依次执行,在每个块中总有部分线程空闲,这会造成显著的性能损失
-
因为 warp 是 GPU 的最小调度单位,只要 warp 内有分歧,那么整个 warp 都要付出代价
-
这和 CPU 不同,CPU 的线程是独立调度的,而 GPU 的线程是 “绑在一起” 的
-
示例如下
if (threadIdx.x % 2 == 0) { // 偶数线程执行 if 块 // 奇数线程空闲 ... } else { // 奇数线程执行 else 块 // 偶数线程空闲 ... } -
相反,下面的条件不会导致线程分歧(warp 内不会出现分支):
if (threadIdx.x < N) {
    ...
}
-
-
for 循环中的线程分歧
-
如果 warp 内不同线程的循环次数不一致,也会导致线程分歧
-
假设某些线程循环 5 次,其他线程循环 10 次,前 5 次迭代可以并行执行,而从第 6 次迭代开始,已完成循环的线程空闲,其他线程继续执行
-
当循环次数高度依赖线程时,循环可能完全串行化,性能损失严重;嵌套 if-else 的循环会进一步加剧分歧
-
在循环后调用
__syncthreads()会放大问题,因为整个线程块必须同步,而不仅仅是 warp
-
-
线程分歧与
__syncthreads()结合可能导致死锁:-
示例如下
if (threadIdx.x % 2 == 0) { myFunc_if(); __syncthreads(); } else { myFunc_else(); __syncthreads(); } -
问题分析:偶数线程执行 if 块,到达
__syncthreads()等待所有线程,而奇数线程执行 else 块,到达自己的__syncthreads(),从而偶数和奇数线程等待不同的同步点 → 死锁 -
解决方法:将
__syncthreads()放在 if-else 语句之后if (threadIdx.x % 2 == 0) { myFunc_if(); } else { myFunc_else(); } __syncthreads(); // 所有线程都执行这一同步点 -
这样,所有线程都会执行同一个同步点,避免死锁
-
-
相关的处理方法
- 优化代码,减少或消除分支
- 如果必须分支,确保 warp 内线程条件结果相同,如按数据块对齐线程,让相邻线程处理 “相似数据”
- 使用 predication(谓词化)
- 谨慎处理边界条件:在 block 边缘的 warp,很容易出现部分线程越界、部分不越界,从而引入分歧(例如上文中矩阵乘法运算的实现)
Launch Overhead
- 解决方案:
- fusion
- persistent kernel
- CUDA graph