CUDA 内存模型
介绍 CUDA 内存模型的基本概念,包括 CUDA 内存类型、内存访问模式、内存一致性模型等内容
CUDA 的内存模型
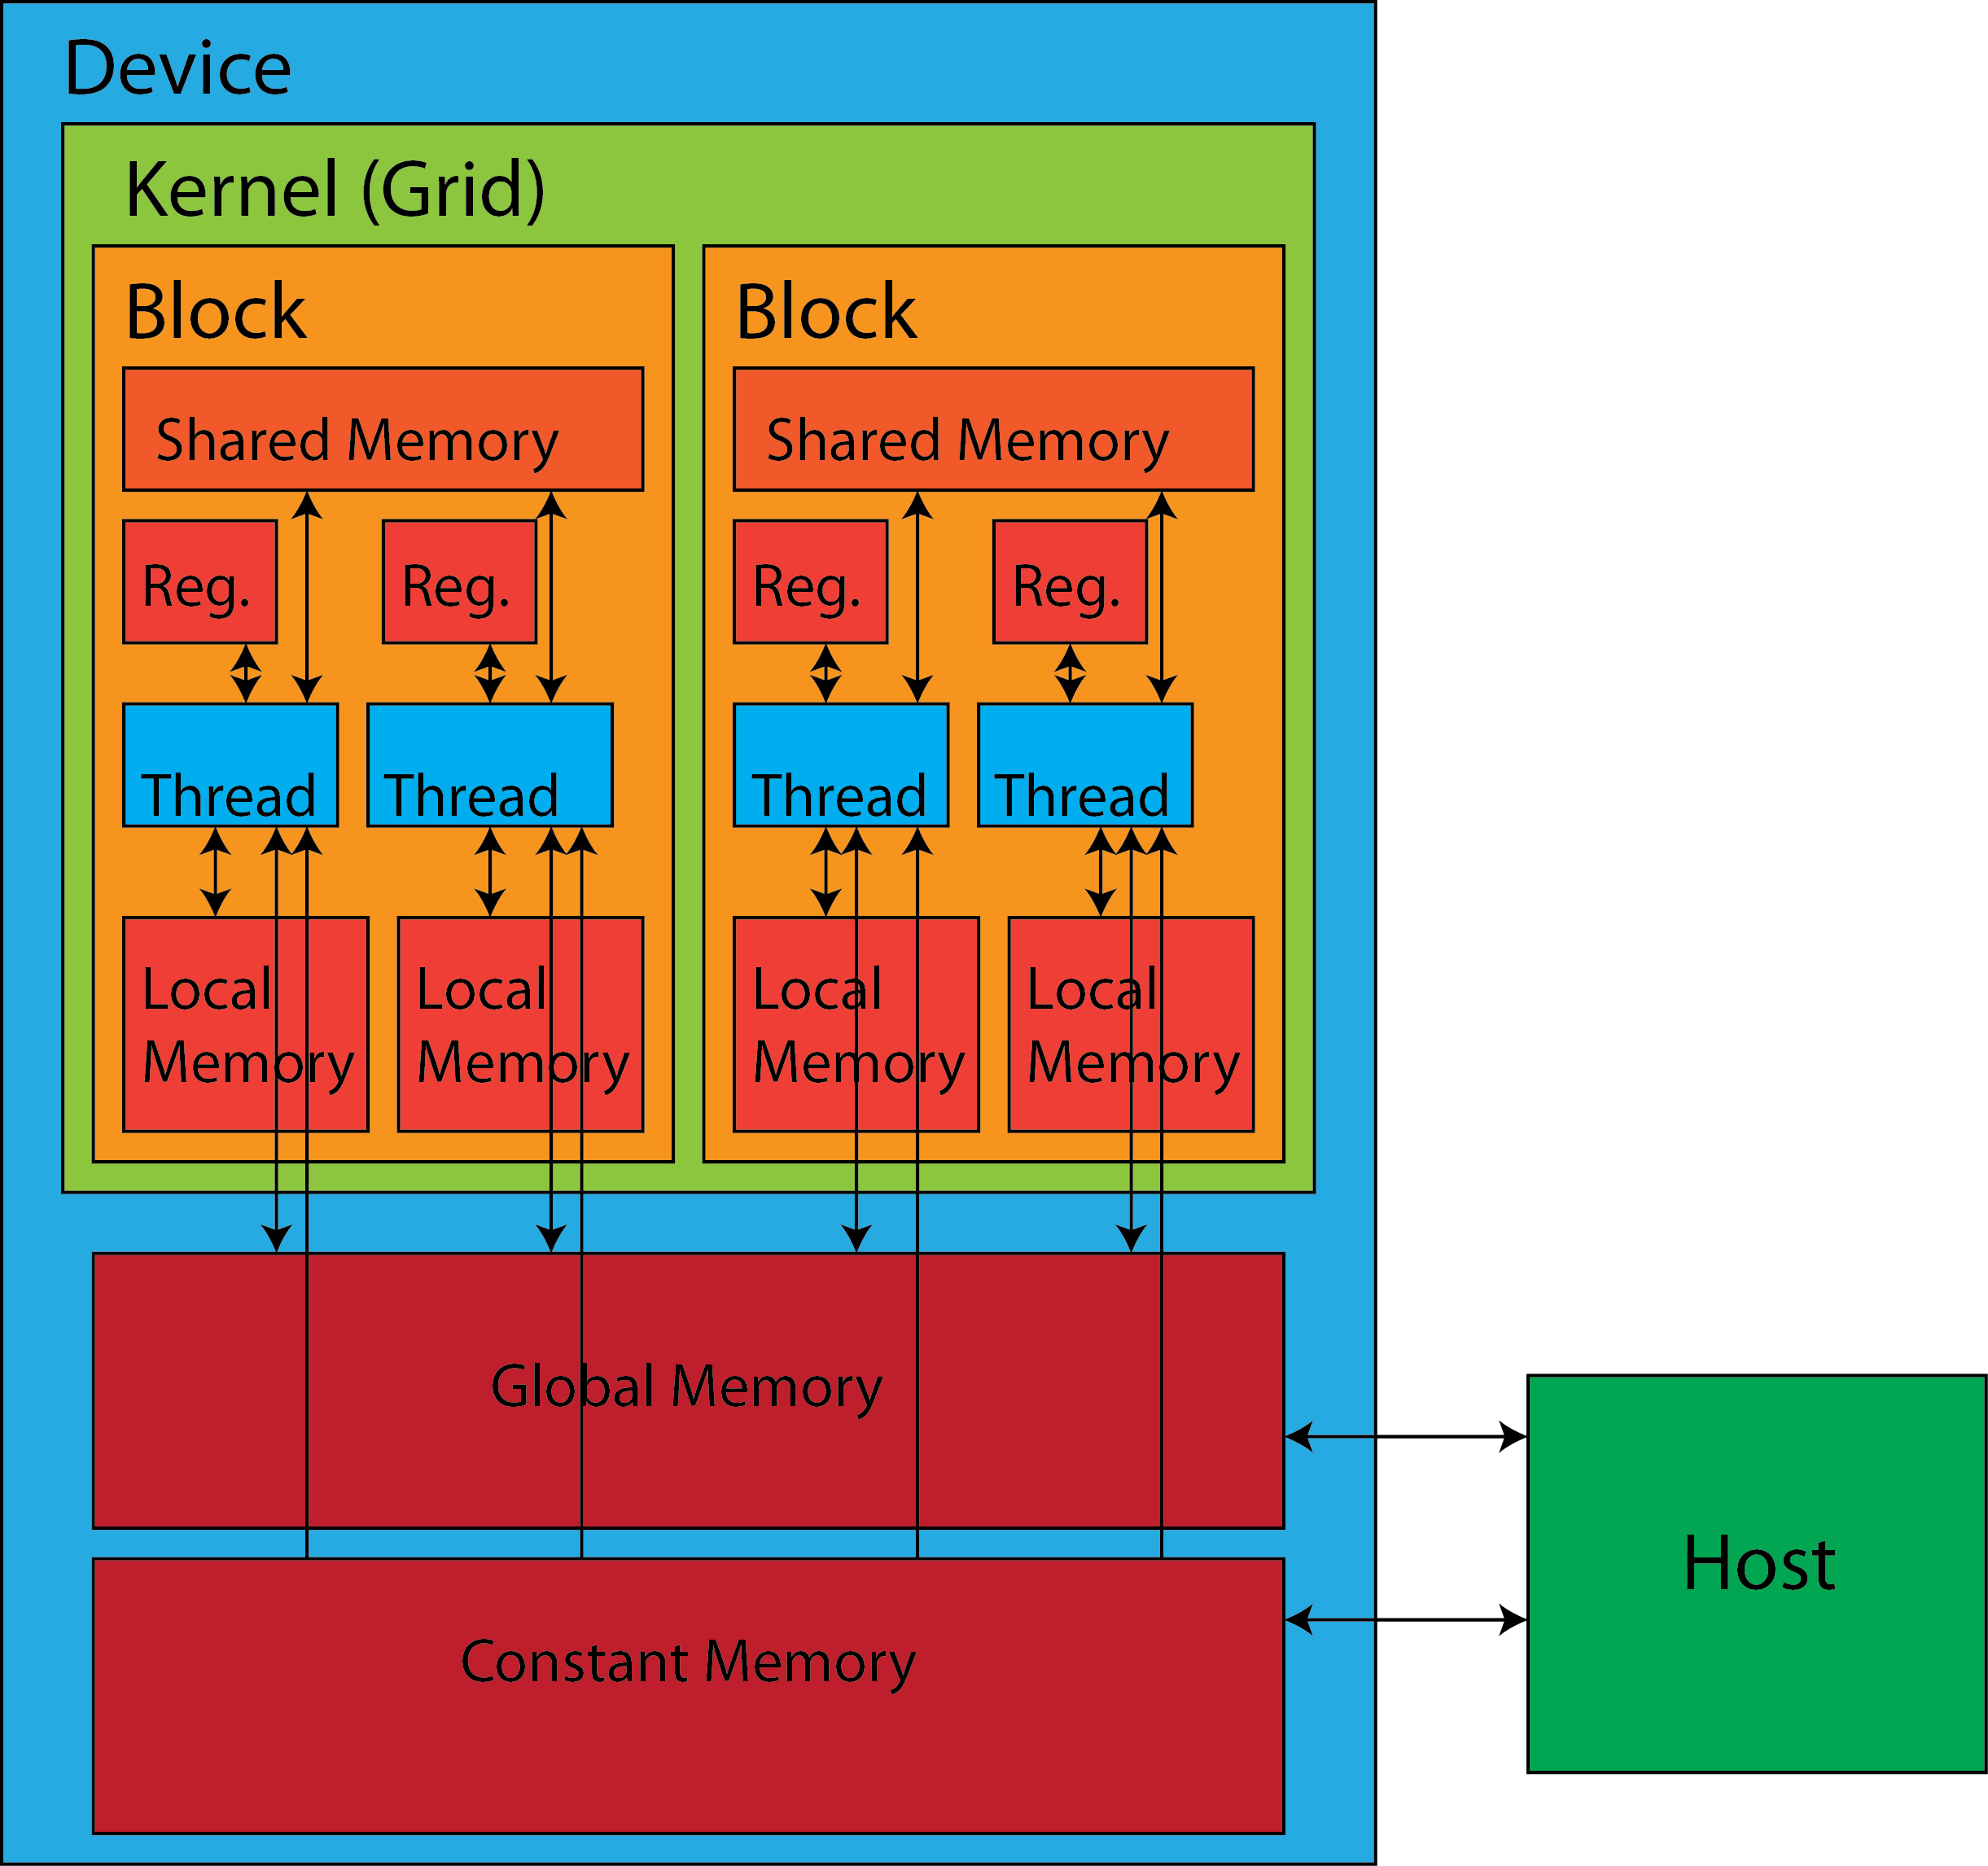
- 示意图如下
-
在图中,双向箭头表示对内存的 读(R)和写(W)能力。箭头指向某个内存组件,表示具备写入能力;箭头从内存组件指向外部,表示具备读取能力
-
通过观察可以发现,GPU 线程在某种程度上可以访问所有层级的内存;而 主机(CPU)只能访问全局内存(global memory)和常量内存(constant memory)。因此,当需要将数据加载到 GPU 设备上时,必须由主机参与,将数据拷贝到全局内存或常量内存中
-
从上面的示意图可以看出,同一个线程块(block)中的线程可以通过共享内存(shared memory)相互通信;然而,某个线程块的共享内存无法被其他线程块中的线程访问
-
即使是在同一个线程块内部,线程之间也不能访问彼此的寄存器(register)和本地内存(local memory)
-
这里的 “本地内存” 并不一定对应一块物理上独立的内存区域,而是一个概念上的线程私有存储空间:当寄存器空间不足以容纳线程的私有变量时,这些变量会被放入本地内存中
-
本地内存的实际存储位置可能位于 L1 缓存,并在必要时进一步延伸到 全局内存(global memory)
内存位置 作用范围(Scope) 访问权限 寄存器(Register) 单线程(per-thread) 读 / 写 本地内存(Local memory) 单线程(per-thread) 读 / 写 共享内存(Shared memory) 线程块(per-block) 读 / 写 全局内存(Global memory) 网格(per-grid) 读 / 写 常量内存(Constant memory) 网格(per-grid) 只读
带宽和容量
-
不同的 GPU 内存组件在容量和带宽方面存在显著差异,全局内存(global memory)具有最大容量但最低带宽
-
类似于 CPU 架构中的主存(RAM),全局内存的数据可以被缓存到片上 L1 和 L2 缓存中,以降低访问延迟
-
与之相比,常量内存(constant memory)在所有计算能力(Compute Capability)下的容量固定为 64 KB;顾名思义,设备端对常量内存的访问是只读的,常量内存最初存储在全局内存中,但会被缓存在片上的常量缓存(constant cache)中;在特定的访问模式下(例如所有线程访问相同地址),常量内存的访问速度甚至可以接近寄存器
-
共享内存(shared memory)的访问速度明显快于全局内存和未命中缓存的常量内存,并且可被同一线程块(block)内的所有线程访问。GPU 的计算能力决定了:
- 每个流式多处理器(SM)可用的共享内存总量
- 每个线程块可使用的最大共享内存大小
-
例如,在 Quadro RTX 5000 GPU 上,每个 SM 的最大共享内存为 64 KB,同时每个线程块的最大共享内存也为 64 KB。当一个 SM 上同时驻留多个线程块时,这部分共享内存会在这些线程块之间进行划分
-
每个线程都可以访问其私有的寄存器和本地内存(local memory)
-
其中,寄存器(register)位于芯片内部,是所有内存层级中速度最快但容量最小的一种。GPU 的计算能力决定了:
- 每个线程可使用的最大寄存器数量
- 每个线程块的寄存器上限
- 每个 SM 的寄存器总量
-
以 Quadro RTX 5000 为例:
- 每个线程最多可使用 256 个寄存器(约 1 KB)
- 每个线程块最多 65,536 个寄存器
- 每个 SM 总计 65,536 个寄存器(约 256 KB)
-
当寄存器数量不足以容纳线程所需的数据时,部分变量会发生寄存器溢出(register spilling),并被存放到本地内存中
-
本地内存的访问速度明显慢于寄存器,因为它最终位于全局内存中,尽管在访问过程中可能被缓存到 L1 或 L2 缓存中;本地内存是线程私有的,不会被其他线程访问
限定符
-
CUDA 支持多种内存空间限定符(memory space specifiers),用于在核函数中显式指定变量应当放置在哪一类内存中
-
不同内存组件中的变量,不仅存储位置和访问速度不同,其作用范围(scope)和生命周期(lifespan)也存在显著差异
变量声明 存储位置 作用范围 生命周期 访问权限 int Var;自动变量寄存器 线程 线程 读 / 写 int ArrayVar[N];自动数组本地内存(可能被缓存) 线程 线程 读 / 写 __shared__ int SharedVar;共享内存 线程块 线程块 读 / 写 __device__ int GlobalVar;全局内存 网格 应用程序 读 / 写 __constant__ int ConstVar;常量内存 网格 应用程序 只读 -
Automatic Variables(自动变量)
-
自动变量是不带任何内存空间限定符声明的变量
-
当设备端代码声明一个自动变量时,网格中的每个线程都会拥有该变量的一份独立副本
-
它位于每个线程的寄存器中,且仅能被该线程访问
-
自动变量的生命周期持续到内核结束
-
声明方式如下:
int autovar;
-
-
Automatic Arrays(自动数组)
-
自动数组默认存放在每个线程的本地内存(local memory)中,同样只对当前线程可见
-
本地内存是一个逻辑概念,实际上它最终位于全局内存中,因此访问速度可能较慢,但也可能会被缓存
-
如果数组足够小,并且所有访问都使用编译期可确定的常量索引,编译器可能会将其优化并放入寄存器中
-
自动数组的生命周期从线程创建持续到 kernel 结束
-
声明方式如下:
int autoarr[];
-
-
Shared Memory:
__shared__-
使用
__shared__内存空间限定符声明的变量,会被明确放入共享内存中,并由同一线程块(block)内的所有线程共享 -
共享内存变量的生命周期从线程块创建持续到 kernel 结束
-
以下两种声明方式是等价的:
__shared__ int shvar;
__device__ __shared__ int shvar2;
-
-
Global Memory:
__device__-
当变量仅使用
__device__修饰时,表示该变量存放在全局内存中,为整个网格中的所有线程可见 -
生命周期:从程序开始到程序结束
-
声明方式如下:
__device__ int dvvar;
-
-
Constant Memory:
__constant__-
使用
__constant__修饰的变量表示一个存放在常量内存中的只读变量,为整个网格中的所有线程可见 -
存储位置:常量内存(底层在全局内存中,有专用常量缓存)
-
生命周期:从程序开始到程序结束
-
常量变量必须在函数体外声明,可选的
__device__修饰符不会改变语义 -
以下两种声明方式等价:
__constant__ int cnvar;
__device__ __constant__ int cnvar2;
-
-
Assign by Address(通过地址赋值)
-
声明在共享内存、常量内存或全局内存中的变量,其地址可以被赋值给一个指针变量,用于间接访问,例如:
int *ptr = &GlobalVar; -
自动变量(寄存器变量)通常无法安全地获取其地址
-
通过指针访问全局或共享内存时,需要格外注意并发访问与同步问题
-
内存管理
-
内存管理(Memory Management)指的是如何分配内存空间,以及如何在主机(host,CPU)和设备(device,GPU)之间传输数据
-
在整体思想上,CUDA 的内存管理方式与 CPU 程序类似,但有一个非常关键的区别:主机代码负责管理所有需要在主机和设备之间共享的数据
-
因此,一个典型的 CUDA 程序中,主机代码需要完成以下工作:
- 在主机和 GPU 设备上分配内存
- 将数据从主机传输到设备
- 调用 kernel 在设备上进行计算
- 在 kernel 执行结束后,将结果从设备传回主机
- 释放之前分配的内存
-
内存声明与分配(Memory Declaration and Allocation)
-
主机内存分配
-
在主机端,通常使用
malloc()分配内存,并进行必要的数据初始化int *h_t1; h_t1 = (int *)malloc(size); -
malloc()的特点是返回分配内存的起始地址,由调用者直接接收并保存到指针中
-
-
设备内存分配
-
在 GPU 设备端,使用 CUDA API 函数
cudaMalloc()分配内存:int *d_t1; cudaMalloc((void**)&d_t1, size); -
cudaMalloc()不返回内存地址,它返回的是一个错误码 -
分配得到的设备指针是通过参数传回的,通常将指针强制转换为
void**,以便适用于任意数据类型
-
-
-
固定内存(Pinned Memory Allocation)
-
默认情况下,通过
malloc()分配的主机内存是可分页内存(pageable memory),即可能被操作系统换出到磁盘,当 GPU 要从该内存拷贝数据时,系统需要先确保数据在物理内存中,这会带来额外的 CPU 开销 -
为提升主机与设备之间的数据传输速度,可以使用固定内存(pinned memory),即禁止该内存被换出到磁盘,从而允许 GPU 使用 DMA(Direct Memory Access)直接传输数据
-
CUDA 提供了
cudaMallocHost()来分配并固定主机内存:cudaMallocHost((int**)&h_t1, size); -
这行代码替代了
malloc(),同时完成主机内存分配和内存固定 -
固定内存能显著提升传输速度,但不宜滥用,大量固定内存可能降低系统整体性能
-
如果主机端使用的是普通
malloc()内存,CUDA 通常会先把数据复制到一个内部的固定缓冲区,再从该缓冲区传输到设备,这一步会引入额外的 CPU 开销
-
-
Kernel 调用前后的内存传输
-
在内存分配并初始化完成后,需要使用
cudaMemcpy()在主机与设备之间传输数据 -
cudaMemcpy 的参数
cudaMemcpy(dst, src, size, direction);-
dst:目标指针 -
src:源指针 -
size:拷贝字节数 -
direction:传输方向,常用的传输方向包括:-
cudaMemcpyHostToHost -
cudaMemcpyHostToDevice -
cudaMemcpyDeviceToHost -
cudaMemcpyDeviceToDevice
-
-
-
示例:主机 → 设备 → 主机
// 主机到设备 cudaMemcpy(d_t1, h_t1, size, cudaMemcpyHostToDevice); // Kernel 调用 thread_multi<<<4, N/4>>>(d_t1); // 设备到主机 cudaMemcpy(h_t1, d_t1, size, cudaMemcpyDeviceToHost); -
非常重要的特性:
cudaMemcpy()是阻塞式(blocking)的,主机代码会一直等待,直到设备完成数据拷贝后才继续执行
-
-
内存释放(Memory Deallocation)
-
在 kernel 执行完成、数据传回主机之后,需要释放之前分配的内存
-
主机端内存:使用
free() -
设备端或 CUDA API 分配的内存:使用
cudaFree()// 释放主机内存 free(h_t1); // 释放设备内存 cudaFree(d_t1); -
凡是通过 CUDA API 分配的内存(如
cudaMalloc、cudaMallocHost),都必须使用cudaFree释放
-
共享内存
-
在设备端代码中,每个 kernel 函数负责管理其自身所需的设备内存,用于存储内部变量
-
正如前面所讨论的,这些内部变量大多是自动变量和自动数组,也就是线程私有(thread-local)变量,其作用域仅限于 kernel 函数内部,通常存放在寄存器或本地内存中
-
共享内存(shared memory)是设备内存中的一个特殊类型,CUDA 提供了明确的机制,用于规定同一线程块(block)内的线程如何使用共享内存
-
与 kernel 作用域内定义的其他变量一样,共享内存变量和数组在 kernel 函数退出后不会继续存在
-
在 CUDA 中,共享内存指的是一种位于芯片上的内存,对单个线程块私有,可被该线程块内的所有线程访问
-
从线程访问角度看,共享内存从全局内存加载数据时,理论上可以快约两个数量级(~100 倍)
-
共享内存的总容量以及每个线程块可用的最大共享内存大小,取决于 GPU 的计算能力(Compute Capability)
-
静态共享内存分配(Static Shared Memory)
-
如果共享内存数组的大小在编译期已知,可以在 kernel 函数体内使用
__shared__关键字进行静态声明:__global__ void staticmem(...) { __shared__ int sharememory[SIZE]; } -
这种方式下数组大小在编译期确定,每个线程块都会分配一份大小为
SIZE的共享内存数组
-
-
动态共享内存分配(Dynamic Shared Memory)
-
如果共享内存数组的大小在编译期未知,则可以使用 CUDA 提供的动态共享内存机制
-
在 kernel 中,通过
extern __shared__声明一个不定长数组(或等价地,一个指针):__global__ void dynamicmem(...) { extern __shared__ int sharememory[]; } -
此时,共享内存的实际大小需要在主机端调用 kernel 时指定,通过执行配置
<<<...>>>中的第三个参数给出,单位是字节 -
例如,为
sharememory分配n个int:dynamicmem<<<gridSize, blockSize, n * sizeof(int)>>>(...); -
为什么大小必须在 kernel 启动时指定?这是因为 kernel 函数体会被每个线程独立执行,如果允许每个线程自行决定共享内存大小,将导致线程块内的线程看到不一致的内存布局,因此共享内存的大小必须在线程块启动之前统一确定
-
-
多个动态共享数组的实现方式
-
动态共享内存看似有一个限制:只能声明一个不定长的
__shared__数组 -
如果需要多个数组,可以采用以下做法:声明一个大的、连续的共享内存数组,然后使用指针在其中手动划分不同的子数组
extern __shared__ int s[]; int *integerData = s; // nI 个 int float *floatData = (float*)&integerData[nI]; // nF 个 float // 在 kernel 调用时,需要指定总的共享内存大小: myKernel<<<gridSize, blockSize, nI * sizeof(int) + nF * sizeof(float)>>>(nI, nF, ...); -
nI和nF作为 kernel 参数传入,用于告知所有线程各个数组的边界位置和长度,保证线程块内的线程对共享内存布局有一致的理解 -
当不同数组类型的元素大小不一致(例如
char、int、float混用)时,必须特别小心对齐(alignment)问题,否则可能导致性能下降甚至非法访问
-
统一内存
-
从 Compute Capability 6.0 开始,CUDA 引入了 Unified Memory,也称为 Unified Virtual Memory(UVM)
-
Unified Memory 允许主机(CPU)和设备(GPU)使用同一块内存地址空间,而无需显式地在主机与设备之间拷贝数据(这并不意味着数据会同时驻留在主机内存和设备内存中)
-
在 Unified Memory 模型下,数据会根据访问需求,在主机和设备之间按需双向迁移(on-demand migration)
-
Unified Memory 的工作机制:按需迁移 + 页错误
-
在 Unified Memory 模型中,数据在任意时刻可能位于主机内存或设备(GPU)内存
-
当主机或设备试图访问当前不在其内存空间中的数据时,会发生一次页错误(page fault),该页错误会触发 CUDA 运行时系统,将包含该数据的内存页(page)自动迁移到请求访问的一方
-
页大小由操作系统决定,通常为 4 KB,因为迁移是以 “页” 为单位进行的,相邻数据也会一并被迁移,这有助于减少后续页错误的次数,从而降低整体迁移开销
-
从编程者的角度来看,主机和设备仿佛 “共享” 同一块内存,不再需要显式调用
cudaMemcpy,不需要维护一对 host/device 指针,从而极大简化内存管理,只在数据真正被设备使用时才发生迁移,也更灵活,因为未被 GPU 使用的数据不会被拷贝到设备 -
然而,页错误和按需迁移可能引入不可忽略的运行时开销;在某些高性能场景下,显式内存管理(手动 cudaMemcpy)仍可能更快、更可控
-
-
下面示例展示了如何使用 Unified Memory 分配一个包含 N 个整数的数组,其中
x是 同一个指针,主机代码和设备代码都可以直接使用它,不需要区分h_x/d_x// 声明指针 int* x; // 分配统一内存 cudaMallocManaged(&x, N * sizeof(int)); // 调用 kernel letsGo<<<4, N/4>>>(x); -
UVA 与 UVM 的关系
- 在较早的 CUDA 版本中,主机指针和设备指针是不同的,主机代码需要通过额外的 API 获取设备指针,再传给 kernel
- 统一虚拟地址(Unified Virtual Addressing, UVA)解决了地址映射问题,主机和设备共享同一个虚拟地址空间,指针值在两端一致
- Unified Memory(UVM)则是在 UVA 的基础上进一步自动化了数据迁移,通过分页机制在后台完成主机 ↔ 设备的数据移动
- UVA 解决 “地址一致性”,UVM 解决 “数据在哪儿”
-
页大小的影响
-
在部分 TACC 系统中,内存页大小并非 4 KB,如 Vista 的 GH200 节点页大小为 64 KB,Frontera 的 RTX 5000 节点页大小为 4 KB
-
较大的页大小意味着,更少的页错误(page faults),但每次迁移的数据量更大
-
在 GH200 Superchip 上,CPU 与 GPU 通过 NVLink-C2C 高速互连,大页大小反而更有优势
-
NVIDIA 的 Unified Memory 驱动还会进行 “密度预取(density prefetching)”,即多个页会被合并迁移,实际上传输的最小单位就是主机页大小
-
此外,开发者也可以手动触发大规模预取,例如
cudaMemPrefetchAsync(ptr, size, device);,用于提前将 Unified Memory 迁移到指定设备,减少运行时页错误
-