数据并行
介绍数据并行的基本概念、实现方法以及在 PyTorch 中的使用方法
基本思想
- 在多张 GPU 上各自复制一份完整的模型,然后让每张 GPU 并行地对不同的 micro-batch 执行前向和反向传播
- 由于并行化发生在数据维度上,因此被称为 “数据并行”
- 数据并行本质上就是梯度累积的并行化版本
- 梯度累积是单卡时序累加,数据并行是多卡空间并行累加
- 梯度累积中,同一张卡,时间换 batch,梯度串行累加
- 而对于 DDP,多张卡空间并行,一步完成梯度累积
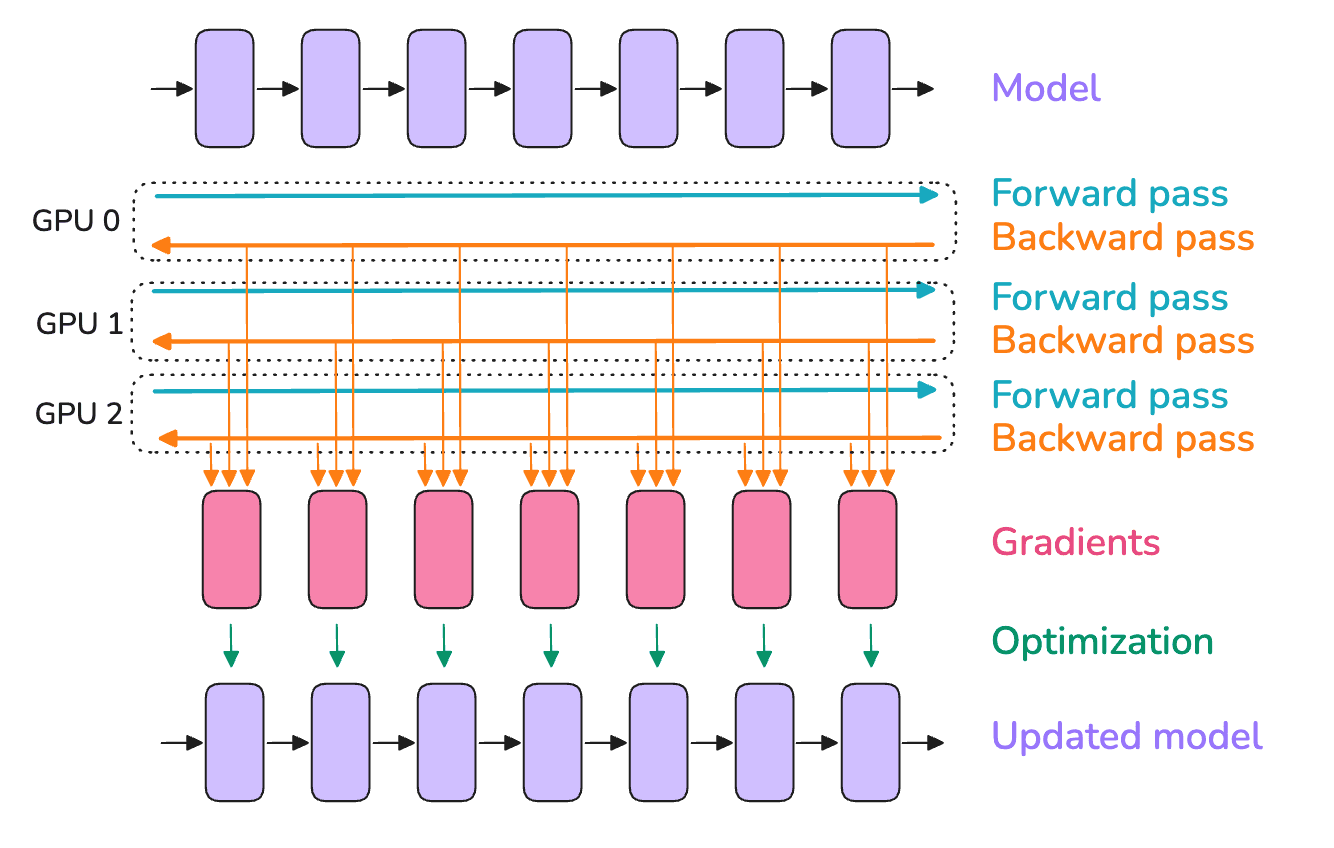
- all-reduce 通信
- 由于每张 GPU 使用的是不同的 micro-batch,各个 GPU 上算出来的梯度自然也不同
- 为了让所有 GPU 上的模型副本保持一致,需要在参数更新之前,对各个 GPU 的梯度进行平均
- 这个过程通过 all-reduce 操作来完成,这是迄今为止的第一个分布式通信原语,负责在不同 GPU(甚至不同节点)之间进行梯度的同步与通信
- 这个操作发生在反向传播阶段、optimizer step 之前
- 一般而言,计算 GPU 称为 Worker,梯度聚合 GPU 称为 Server,在实际应用中,为了减少通讯量,一般可以选择一个 Worker 同时作为 Server
- 数据并行需要解决的问题
- 存储开销大,因为每个 GPU 都存储了一份完整的模型,造成冗余 —— 通过 ZeRO 解决
- 通讯开销大,Server 需要和每一个 Worker 进行梯度传输,当 Server 和 Worker 不在一台机器上时,Server 的带宽将会成为整个系统的计算效率瓶颈 —— 通过 Ring AllReduce 解决
朴素数据并行
-
实现步骤
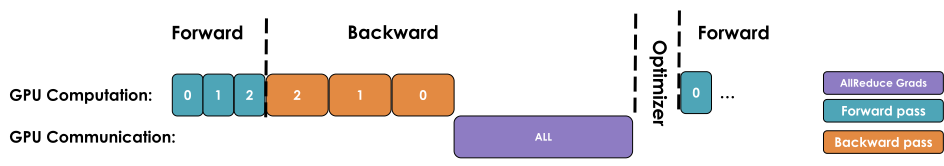
- 等所有反向传播全部完成,得到完整梯度
- 再对所有 GPU 的梯度执行一次 all-reduce,同步梯度
- 最后进行参数更新
-
存在的问题
- 计算结束 → 再通信是典型的反模式(A BIG NO-NO),原因是在 all-reduce 通信期间,GPU 基本处于空闲状态,白白浪费了大量算力
- 因此正确思路是,尽可能让通信与计算重叠(overlap),让它们同时进行
- 也即一边做反向传播计算,一边同步已经算好的梯度,这样 GPU 才不会因为等待通信而停下来
-
梯度异步更新:允许某些 Worker 可以先不同步梯度,而是使用旧的参数继续处理新的数据,但这样可能会导致模型整体的收敛速度减慢
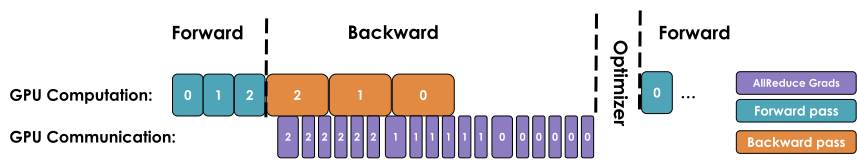
第一步优化:梯度同步与反向传播重叠执行
- 在反向传播中,最后一层的梯度最先算完,越靠前的层,梯度越晚算完
- 因此某一层的梯度一旦计算完成,就已经可以立刻进行 all-reduce,而不必等待整个模型的 backward 结束
- 在 PyTorch 中,可以通过给每个参数注册 backward hook 来实现:当某个参数的梯度刚刚计算完成,就立刻触发一次 all-reduce
- 此时其他参数的梯度仍在计算,backward 仍在继续,梯度同步被 “切碎”,并嵌入到 backward 过程中
- 这样,大部分通信时间被隐藏在计算时间里,GPU 等待通信的空闲时间大幅减少数据并行的整体效率显著提升
第二步优化:梯度分桶(bucket)
- 在第一步优化中,每个参数的梯度一旦计算完成,就立刻触发一次 all-reduce
- 这在逻辑上是正确的,但在工程上存在问题,因为
- GPU 和通信库(NCCL)非常不擅长处理大量小张量
- 每次 all-reduce 都有固定启动开销,而频繁的小张量通信,kernel launch 多、NCCL 调度频繁、网络带宽利用率低,结果导致通信被 “碎片化” 了
- 解决思路:不要对每个参数的梯度单独 all-reduce,而是把多个梯度拼在一起,一次性同步,这就是梯度分桶
- 典型流程:
- 框架预先定义若干个 bucket(按大小,比如 25 MB)
- 反向传播时,当某个参数梯度计算完成后,会被拷贝 / 映射进对应的 bucket
- 当一个 bucket 被填满,或其包含的梯度全部完成,就立刻触发一次 all-reduce,而 backward 则继续执行其他层
- 这样,就变成了 bucket 粒度的 overlap,而不是 parameter 粒度的 overlap
- 优点在于,减少 kernel / NCCL 启动次数、提高带宽利用率、具有更少的同步点(sync points)
第三步优化:梯度累积时延迟同步(no_sync)
-
只需要梯度累积的最后一次才会更新参数
- 在数据并行中,每张 GPU 对自己的 micro-batch 做 forward/backward,然后用 all-reduce 同步梯度
- 而在每张卡的梯度累积中,连续做多次 forward/backward,暂不更新参数,最后一次再 optimizer.step ()
- 如果把数据并行直接套在梯度累积上,最直接的实现是每一次 backward,都自动触发一次 all-reduce
- 但这是完全没有必要的,梯度只是被累加,并不会立刻用来更新参数,中间步骤的同步是纯粹的通信开销
- 因此,梯度累积期间不需要保持不同 GPU 之间的梯度一致
-
正确做法是,前 次 backward 不做梯度同步,第 次 backward 正常 all-reduce
-
PyTorch DDP 提供了一个非常直接的机制:model.no_sync (),其语义是在这个作用域内,禁止 DDP 在 backward 时触发 all-reduce
for k in range(K): if k < K - 1: with model.no_sync(): loss.backward() else: loss.backward() # 这里才做 all-reduce optimizer.step() optimizer.zero_grad() -
通过延迟同步,解决了 “梯度同步频率过高” 的问题,从而降低通信开销
-
通信缓冲区
- NCCL / GPU DMA 更擅长处理连续内存,而非连续张量需要额外 copy,增加延迟
- 因此在执行通信操作时,张量必须在内存中连续,以避免冗余的内存副本
- 为了实现最佳效果,工程上通常会预先分配一大块激活大小的连续缓冲区,把梯度 /bucket 拷贝进去做通信
- 虽然这提高了通信效率,但是这些通信缓冲区也会占用额外显存,部分提高训练期间的显存使用峰值
Ring - AllReduce
- DDP 首先要解决的是通讯问题,也就是将 Server 上的通讯压力均衡转到各个 Worker 上
- 实现这一点后,可以进一步省去 Server,只保留 Worker,这就是 Ring AllReduce 的初衷
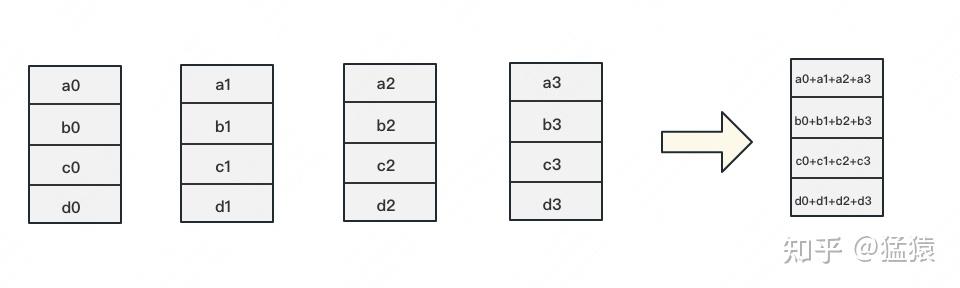
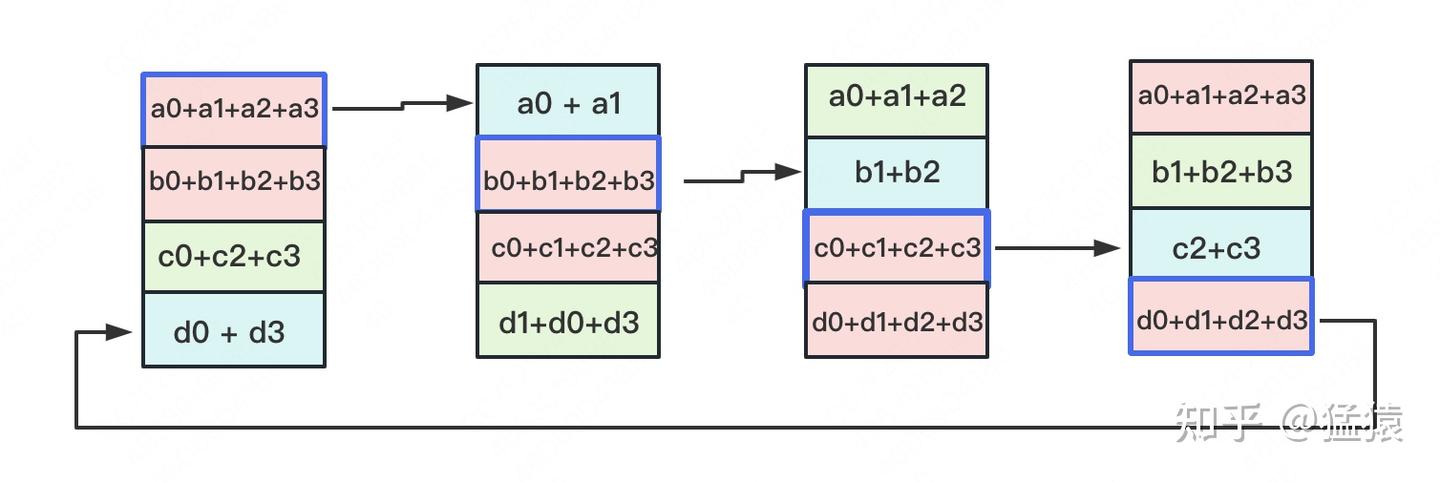
- 假设有 4 块 GPU,每块 GPU 上的梯度也对应被切成 4 份,而 AllReduce 的最终目标,就是让每块 GPU 上的梯度都变成汇总后的结果
-
Ring-ALLReduce 则分两大步骤实现该目标:Reduce-Scatter 和 All-Gather
-
Reduce-Scatter:首先定义网络拓扑关系,使得每个 GPU 只和其相邻的两块 GPU 通讯,每次发送对应位置的数据进行累加
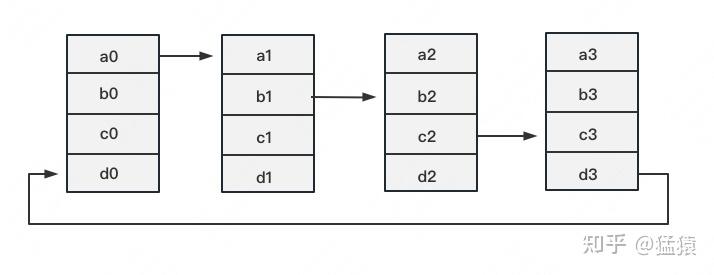
-
每一次累加更新都形成一个拓扑环,因此被称为 Ring
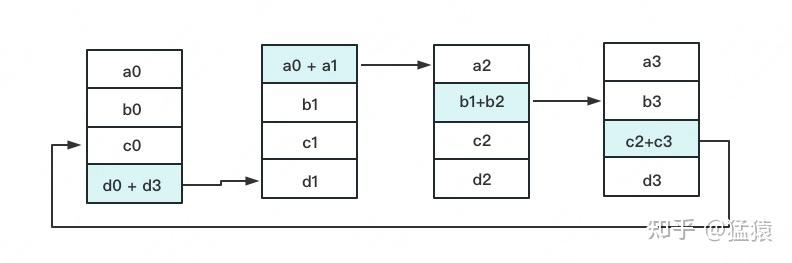
-
一次累加完毕后,蓝色位置的梯度块被更新,被更新的梯度块将成为下一次更新的起点,继续做累加操作
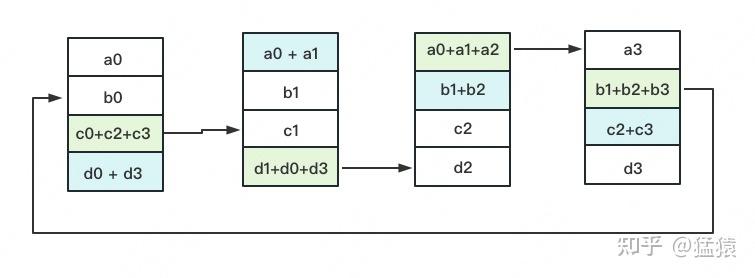
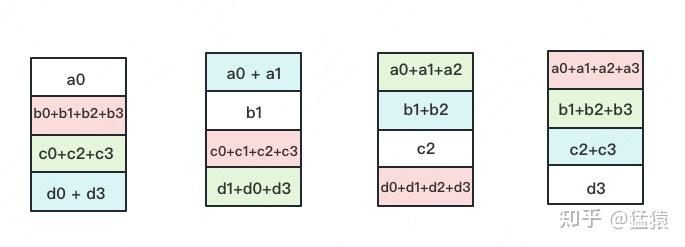
-
3 次更新之后,每块 GPU 上都有一块梯度拥有了对应位置完整的聚合
-
此时,Reduce-Scatter 阶段结束,进入 All-Gather 阶段,其目标是把红色块的梯度广播到其余 GPU 对应的位置上
-
All-Gather 操作依然按照 “相邻 GPU 对应位置进行通讯” 的原则,但对应位置的梯度不再做相加,而是直接替换
-
All-Gather 以红色块作为起点,经过 3 轮迭代后,每块 GPU 上都汇总到了完整的梯度
-
设模型参数量为 ,GPU 个数为 ,梯度总量为 ,每个梯度块大小为
-
DP(DataParallel)通讯量分析
- Server 承载通讯量:
- Workers 承载通讯量:
- 全卡总通讯量:
- 仅由 Server 负责数据搬运,通讯负载集中在单卡,在多机远距离场景下通讯时间会显著增加
-
Ring - AllReduce 通讯量分析
- Reduce-Scatter 阶段:单卡通讯量为
- All-Gather 阶段:单卡通讯量为
- 单卡总通讯量:,当 很大时,近似为
- 全卡总通讯量:
- 通讯负载均衡到每个 Worker,每个时刻都有 GPU 参与通讯,适合多机多卡场景
相关分析
-
batch size 的大小计算
-
已知数据并行 GPU 数为 、micro-batch size 为 、梯度累积步数为
-
于是等效的批次大小
-
假设目标是一个固定的
- 可以选择用更多 GPU(更大的 )或者更多梯度累积步数(更大的 )
- 工程上,更倾向于先使用更多的 GPU,这是由于
- 数据并行:不同 GPU 同时做 forward/backward,wall-clock 时间显著下降,是真正的并行加速
- 而梯度累积:多次 forward/backward 必须顺序执行,只省显存,不省时间,甚至会拉长一次 optimizer step 的耗时
- 因此工程经验是能用数据并行解决的 batch size,绝不用 grad_acc,只有当 GPU 不够用时,才增加 grad_acc
-
通过二者配合,activation 显存 ∝ ,通信频率 ∝ (有
no_sync),参数更新频率 ∝
-
-
大规模情况下的环延迟问题
- 当数据并行规模扩展到 512 张 GPU 甚至更多 时(具体阈值取决于网络拓扑和带宽),梯度同步中的 all-reduce 通信会出现一个新的瓶颈
- 此时,不再是带宽受限,而是被 ring latency(环延迟)限制
- 在 ring all-reduce 中,GPU 被组织成一个逻辑环,梯度数据需要在环上逐跳传播,即使数据量不大,也必须等信号绕完整个环一圈
- 当 GPU 数量很大时,环变长,单次 all-reduce 的最小耗时被 “信号传播时间” 锁死
- 而这部分时间无法通过并行计算掩盖,无法被 backward 继续重叠
-
大规模情况下 “通信与计算重叠” 开始失效
- 在中小规模 DP 下,backward 计算时间足够长,all-reduce 可以 “藏” 在计算后面,GPU 几乎不空闲
- 但在超大规模时:单卡计算量 ∝ ,通信延迟 ≈ 常数或缓慢下降,于是通信时间 > 可重叠的计算时间
- 从而导致 backward 结束了,但通信还没结束,GPU 被迫等待
-
大规模情况下的后果
- 计算效率下降:GPU 有更多空转时间,FLOPs 利用率下降
- 吞吐量下降:每增加一张 GPU,系统总吞吐的提升越来越小,甚至可能变差
- 这就是典型的规模扩展的边际收益递减
- 这是因为数据并行的通信模式是所有 GPU ↔ 所有 GPU,每一步都要全局同步梯度
- 当规模极大时通信同步本身成为主导成本,是由通信拓扑和物理网络决定的根本限制