张量并行
介绍张量并行的基本概念、实现方法以及在 PyTorch 中的使用方法
基本思想
-
张量并行(Tensor Parallelism,TP)是一种能够对权重、梯度、优化器状态,甚至激活值进行分片的并行算法,而且不需要在计算前将它们全部聚合
-
设输入数据为 X,参数为 W,X 的维度 = (b, s, h),W 的维度 = (h, h'),其中:
b:batch_size,表示批量大小s:sequence_length,表示输入序列的长度h:hidden_size,表示每个 token 向量的维度h':参数 W 的 hidden_size
-
张量并行利用了矩阵乘法 的数学性质
-
按列拆分 :
-
按行拆分 :
-
-
这意味着,可以通过两种方式来计算矩阵乘积:
- 逐列地对 的各个列块分别进行乘法
- 或者逐行地对 的各个行块分别计算,然后将结果相加
-
在神经网络中,矩阵乘法通常写成如下形式:
- 其中, 表示输入或激活值(activations), 表示线性层(Linear layer)的权重矩阵
-
一个简单的例子
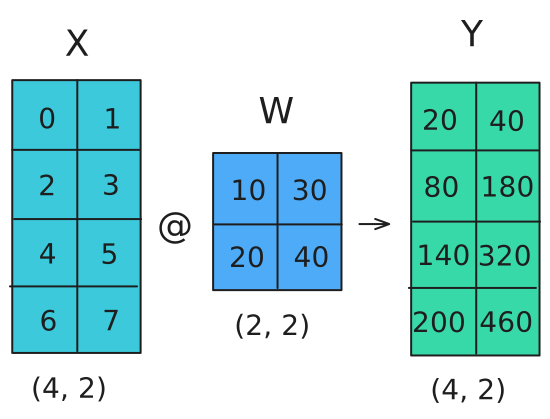
并行化矩阵乘法运算
-
在张量并行中,沿着某一个维度将张量切分成 个分片(shards),并分布到 张 GPU 上
-
矩阵既可以按列切分,也可以按行切分,因此形成了列并行(column parallelism)和行并行(row parallelism)两种方式
-
列并行(Column-wise / Column-linear Sharding)
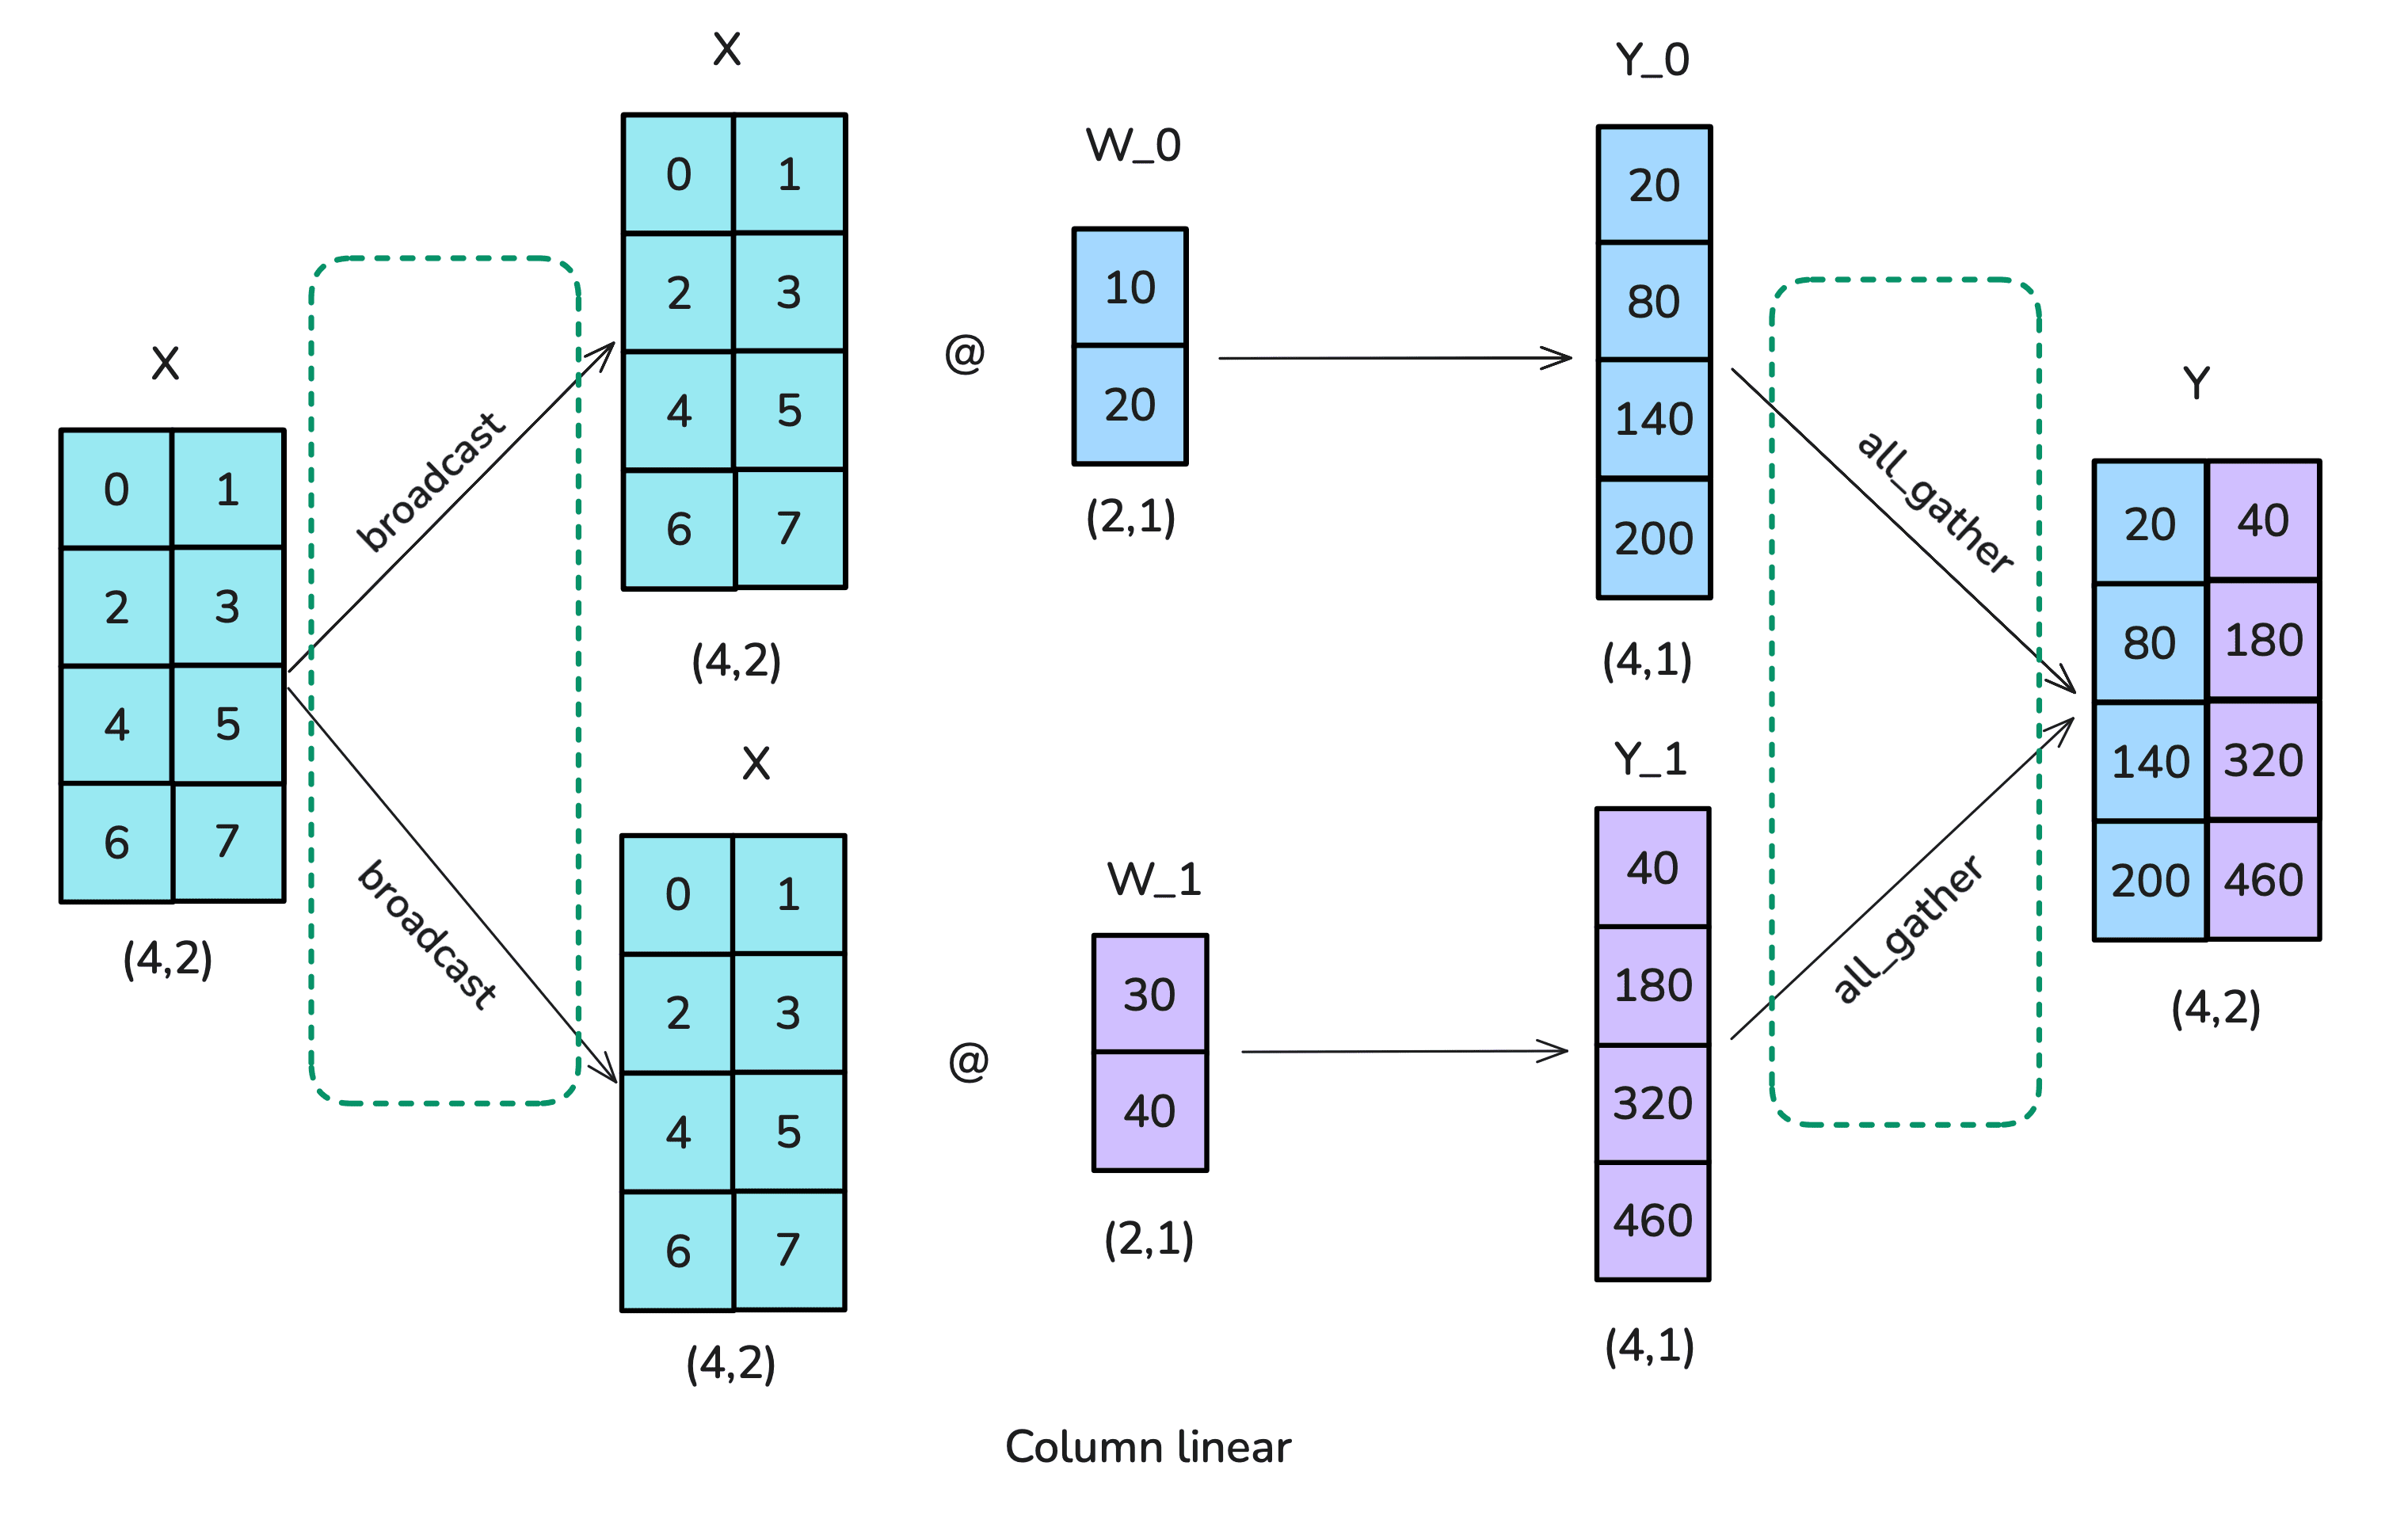
- 第一种方式是按列分片(也称 column-linear)
- 将完整的输入矩阵 复制到每一个 worker 上 → 这需要一次 broadcast
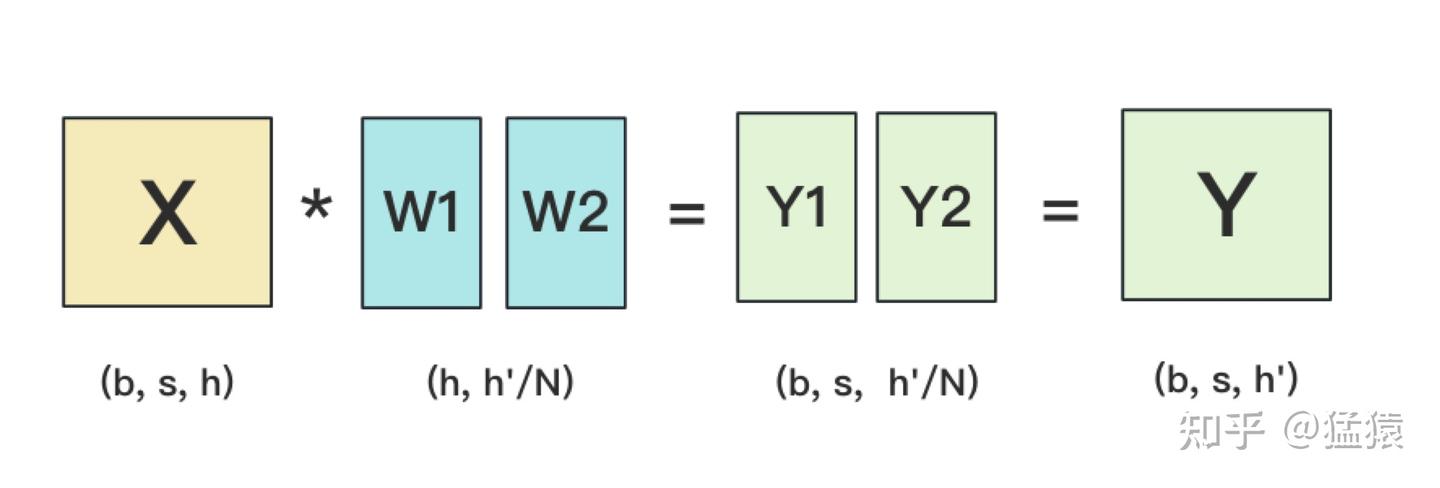
- 将权重矩阵 按列切分,每个 worker 使用完整的 与本地的部分权重 相乘
-
最后使用 all-gather 将各个 worker 的输出拼接成完整结果
-
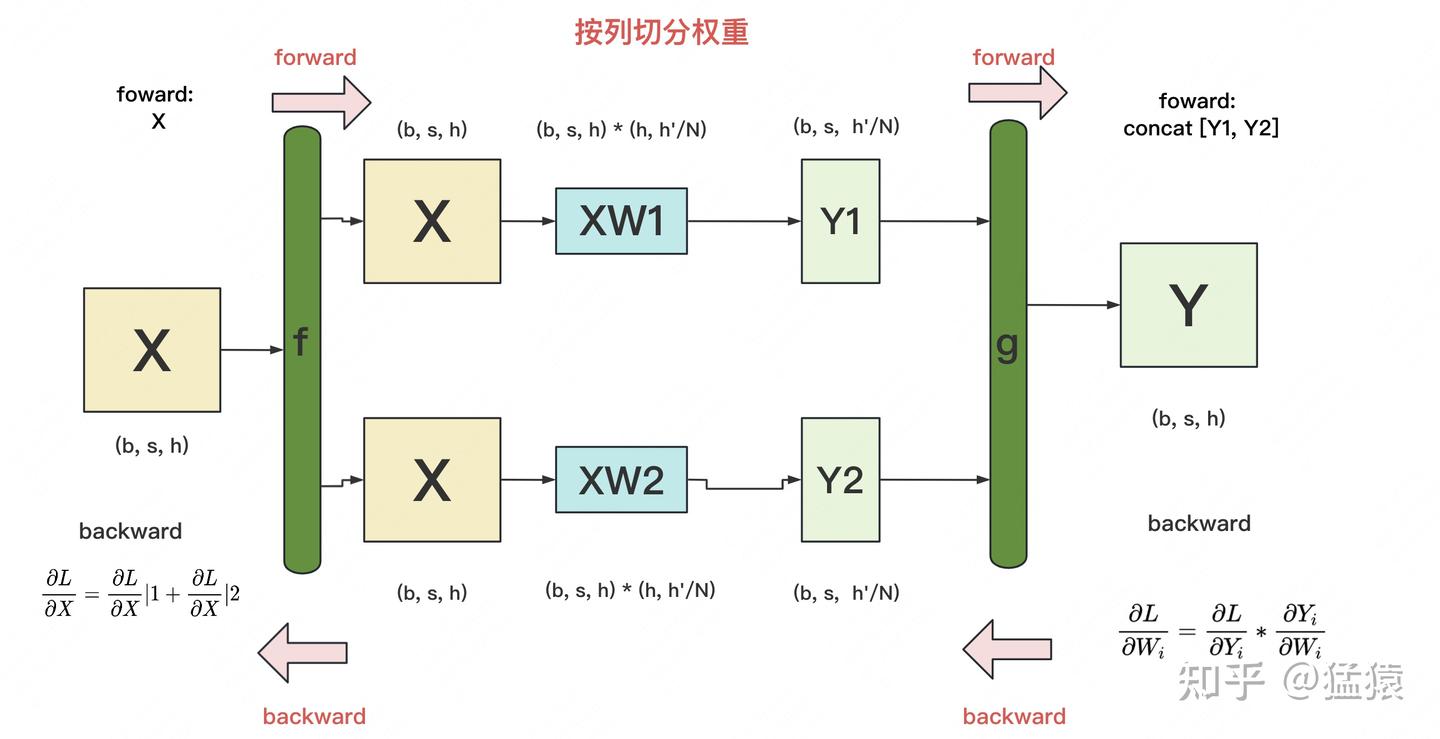
反向传播过程
-
g 的反向传播:
-
f 的反向传播:对于损失 L,X 既参与了 XW1 的计算,也参与了 XW2 的计算,因此有 ,其中 表示第 i 块 GPU 上计算到 X 时的梯度
-
行并行(Row-wise / Row-linear Sharding)
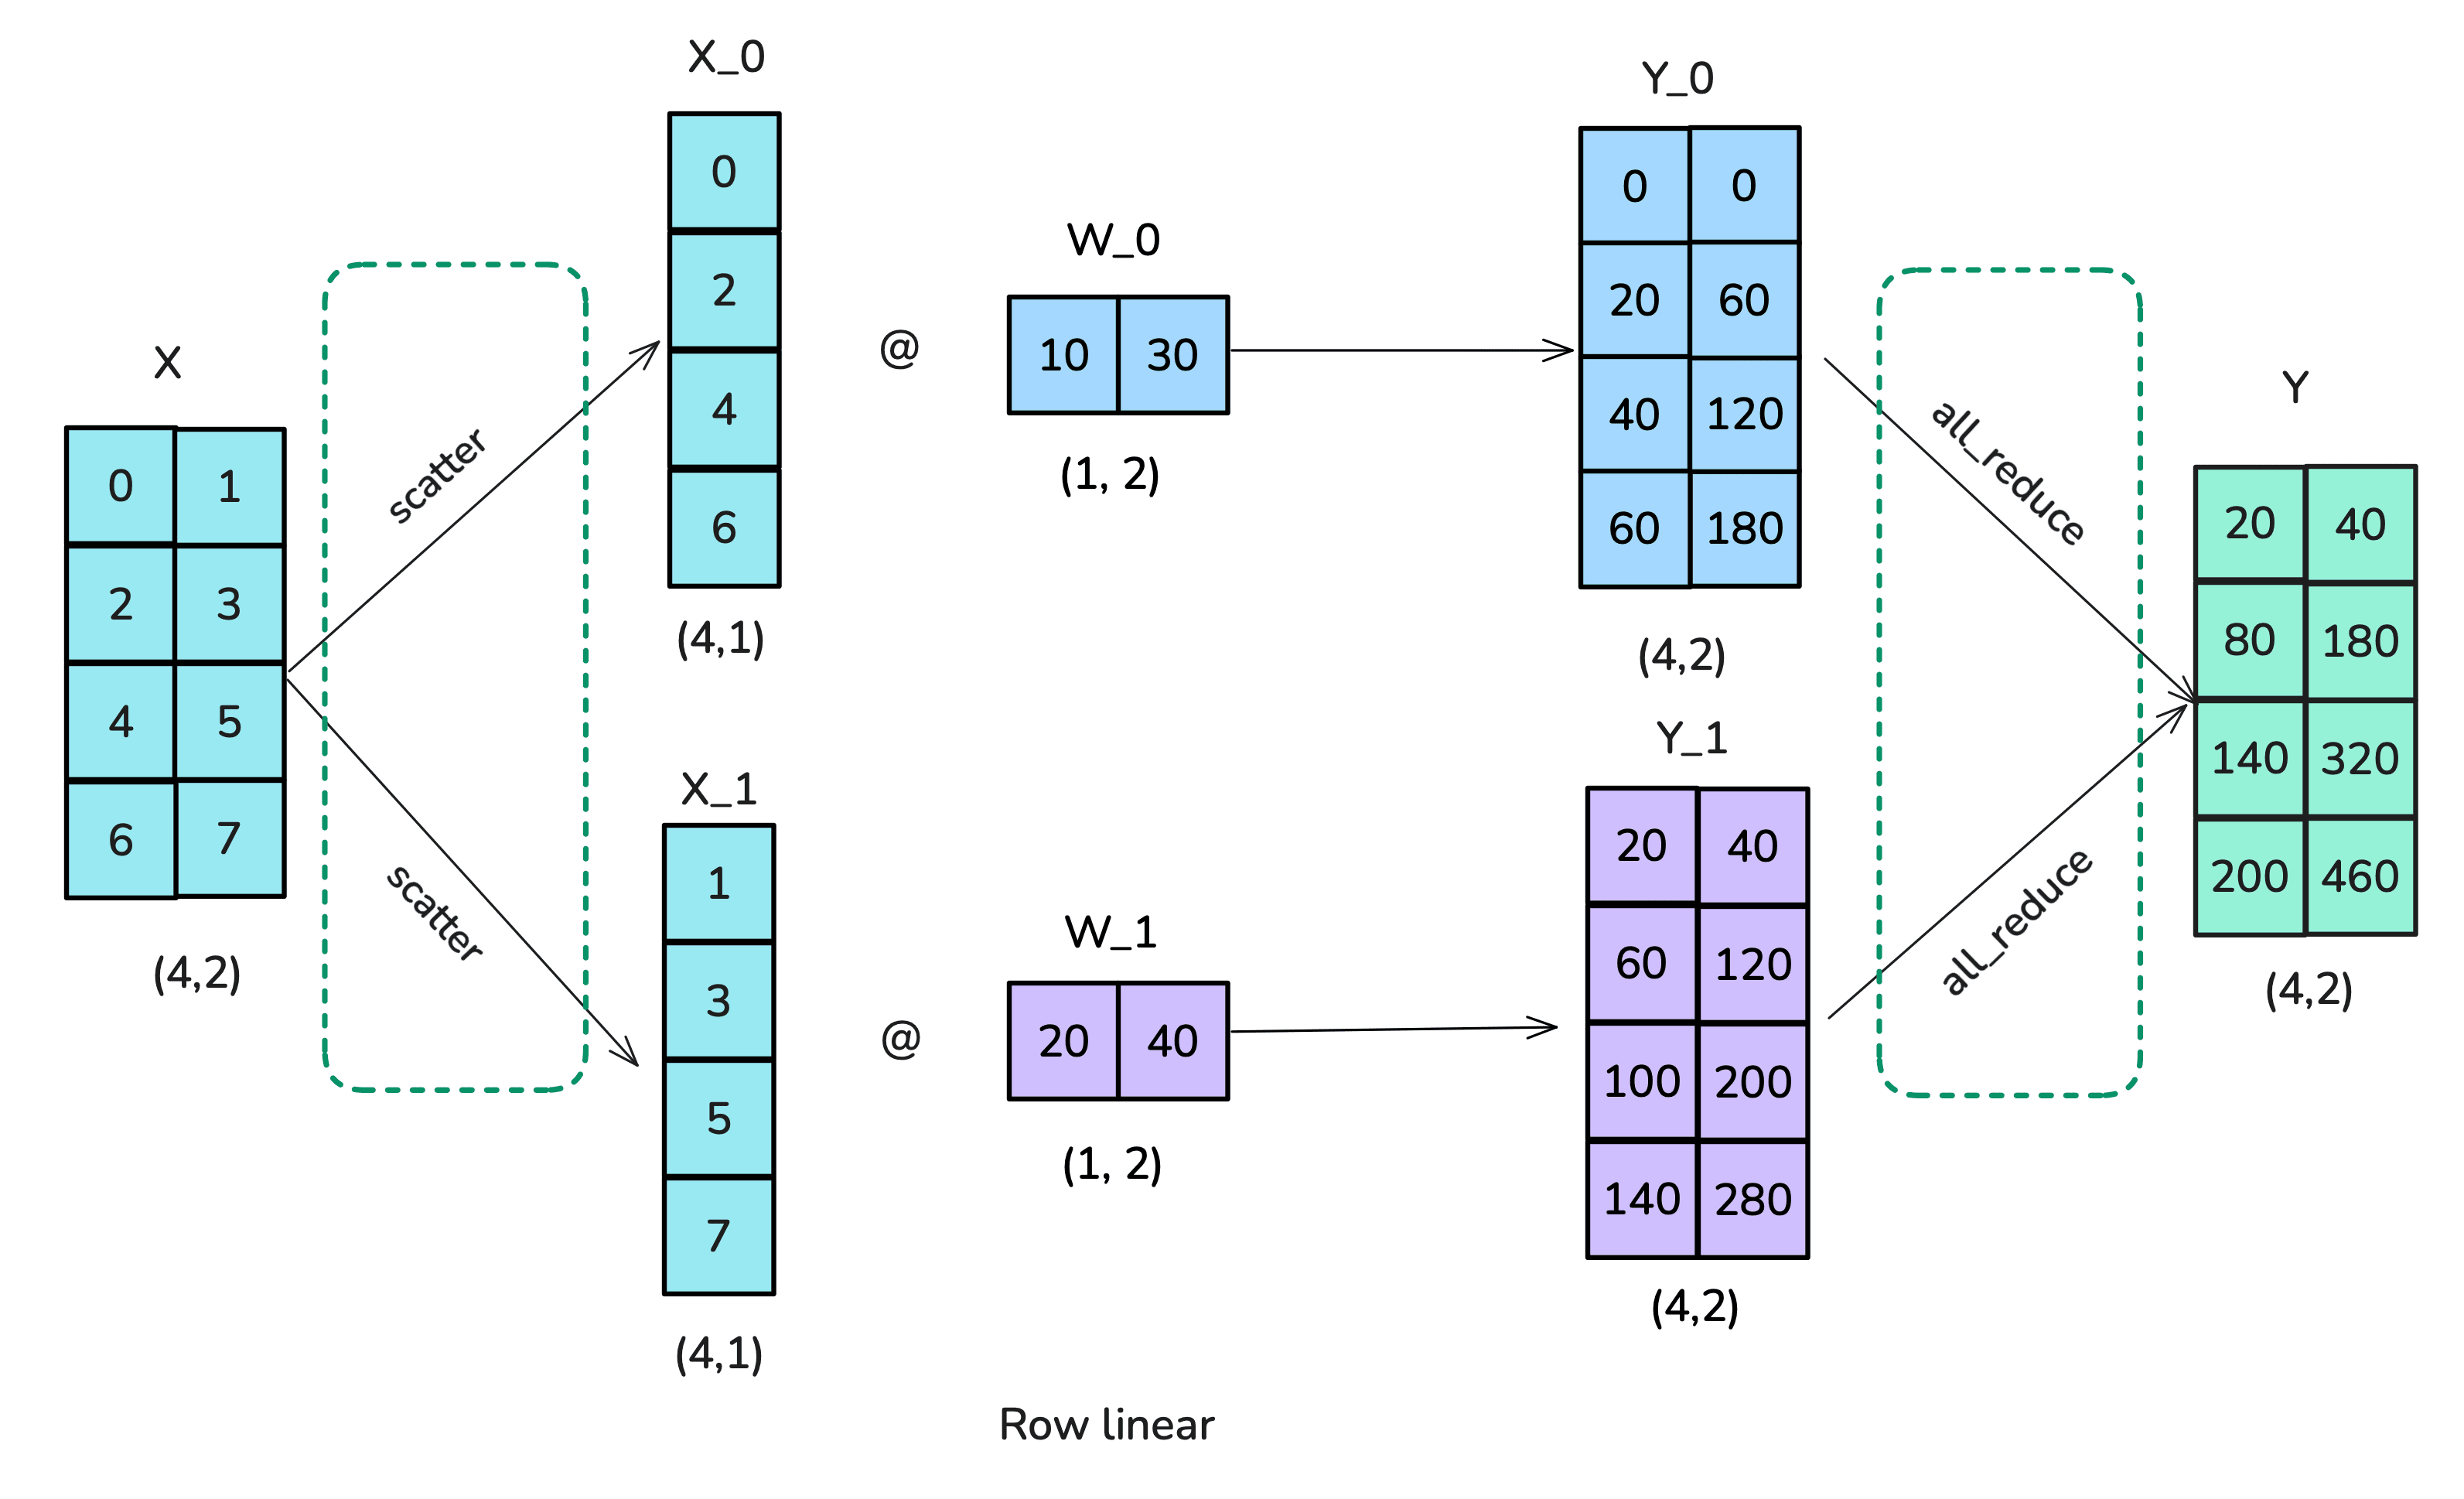
- 第二种方式是按行分片(也称 row-linear)
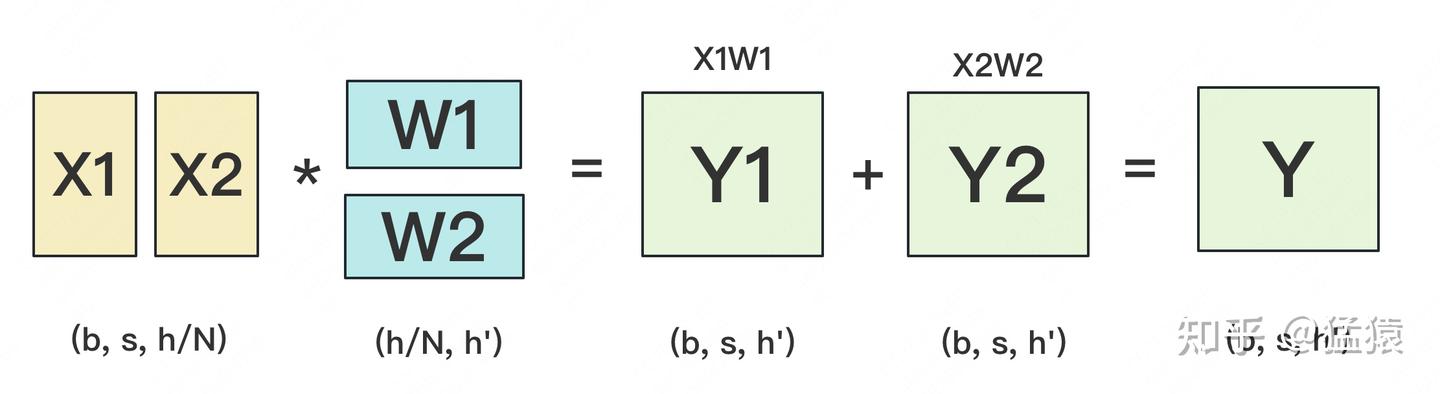
- 将权重矩阵 按行切分,X 和它的维度无法对齐,因此需要将输入 X 按列切分 → 这里不再使用 broadcast,而是使用 scatter(这是第四种通信原语)
-
每个 worker 计算本地部分的结果
-
各个 worker 的输出形状已经正确,但需要求和得到最终结果 → 使用 all-reduce
-
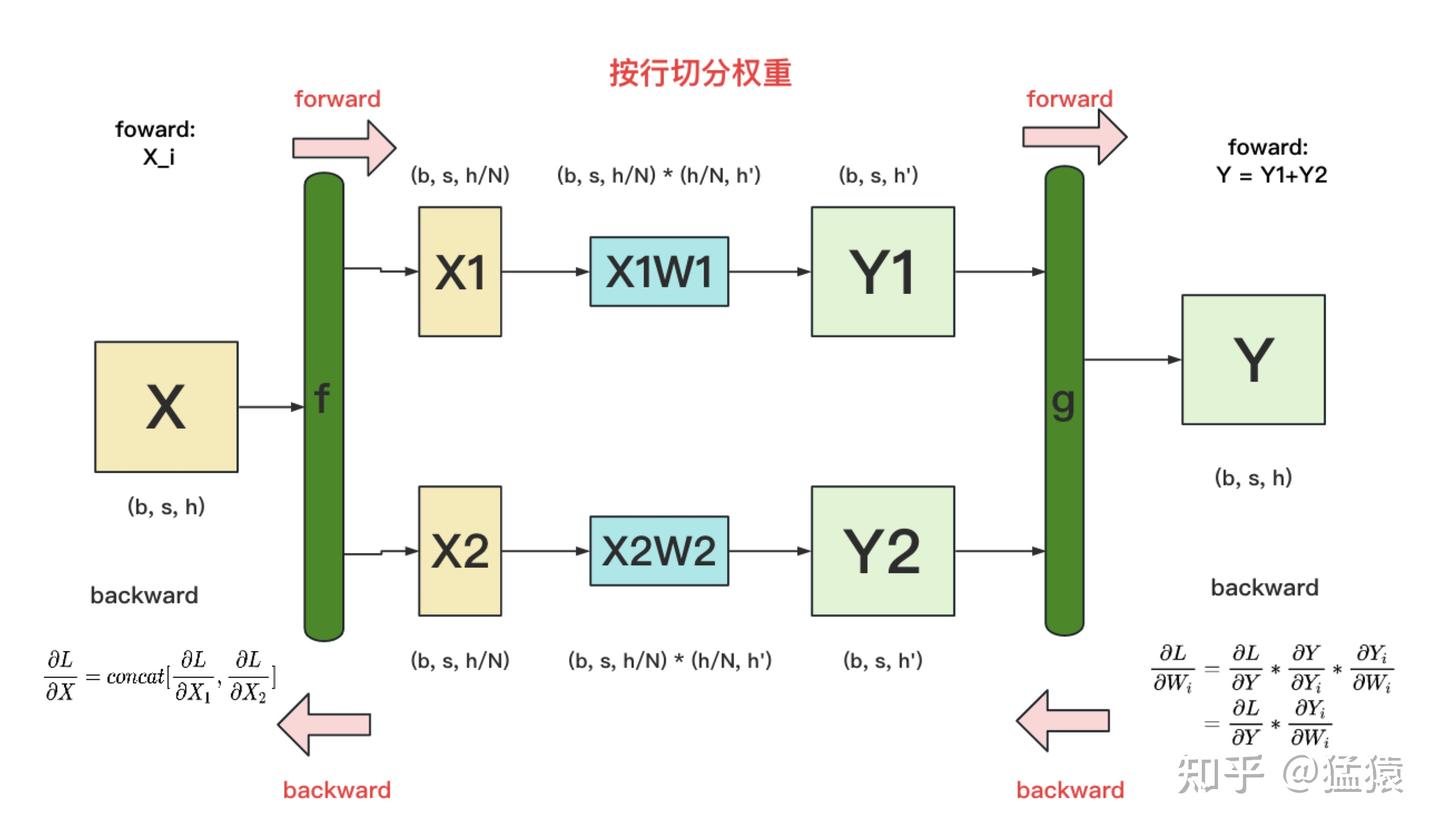
那么反向传播如何进行?
-
其中,f 和 g 分别表示两个算子,每个算子都包括一组 forward + backward 操作
-
g 的反向传播:假定现在对 求梯度,可以根据链式法则推出 ,因此只需要把 同时广播到两块 GPU 上,两块 GPU 就可以独自计算各自权重的梯度
-
f 的反向传播:
-
在 Megatron-LM 中,权重的切分操作就是由这两个基础算子组合而成
两个矩阵相乘
-
如果左矩阵按行划分,右矩阵按列划分
-
假设用 块 GPU 做张量并行,拆分规则如下:
-
A 的行切割(Row Parallel),将 按行切分为 份,即:
-
其中每份 ,对应输入维度的切片
-
为了匹配矩阵乘法,输入 也必须按最后一维(h 维)行切分为 份:
-
每份 ,对应 的第 个行切片
-
B 的列切割(Column Parallel),将 按列切分为 份,即:
-
每份 ,对应输出维度的切片
-
-
第一步:计算 ,根据分块矩阵乘法,行切割后的 计算为:
- 维度验证: 维度为 ,求和后 维度仍为 ,与原始计算一致
- 关键问题:每个 GPU 仅能计算自己的 ,无法直接得到完整的 ,必须通过 All-Reduce 求和才能得到完整张量
-
GELU 激活(非线性约束的核心)
-
GELU 是非线性激活函数,不满足加法可分性:
-
因此,必须先通过 All-Reduce 得到完整的 ,再对完整张量做 GELU:
-
维度: 维度仍为 ,与输入一致
-
通信代价:必须在 GELU 前做一次全局 All-Reduce,这是该方案的致命缺陷
-
-
第二步:计算 (B 列切割后的最终结果)
-
B 列切割后,分块矩阵乘法为:
-
将完整的 广播到所有 GPU,再由每个 GPU 独立计算自己的切片
-
-
所有 GPU 计算完成后,将各切片按列拼接,得到最终输出 :
-
每个 维度为 ,拼接后 维度为 ,与原始计算一致
MLP 层的并行化
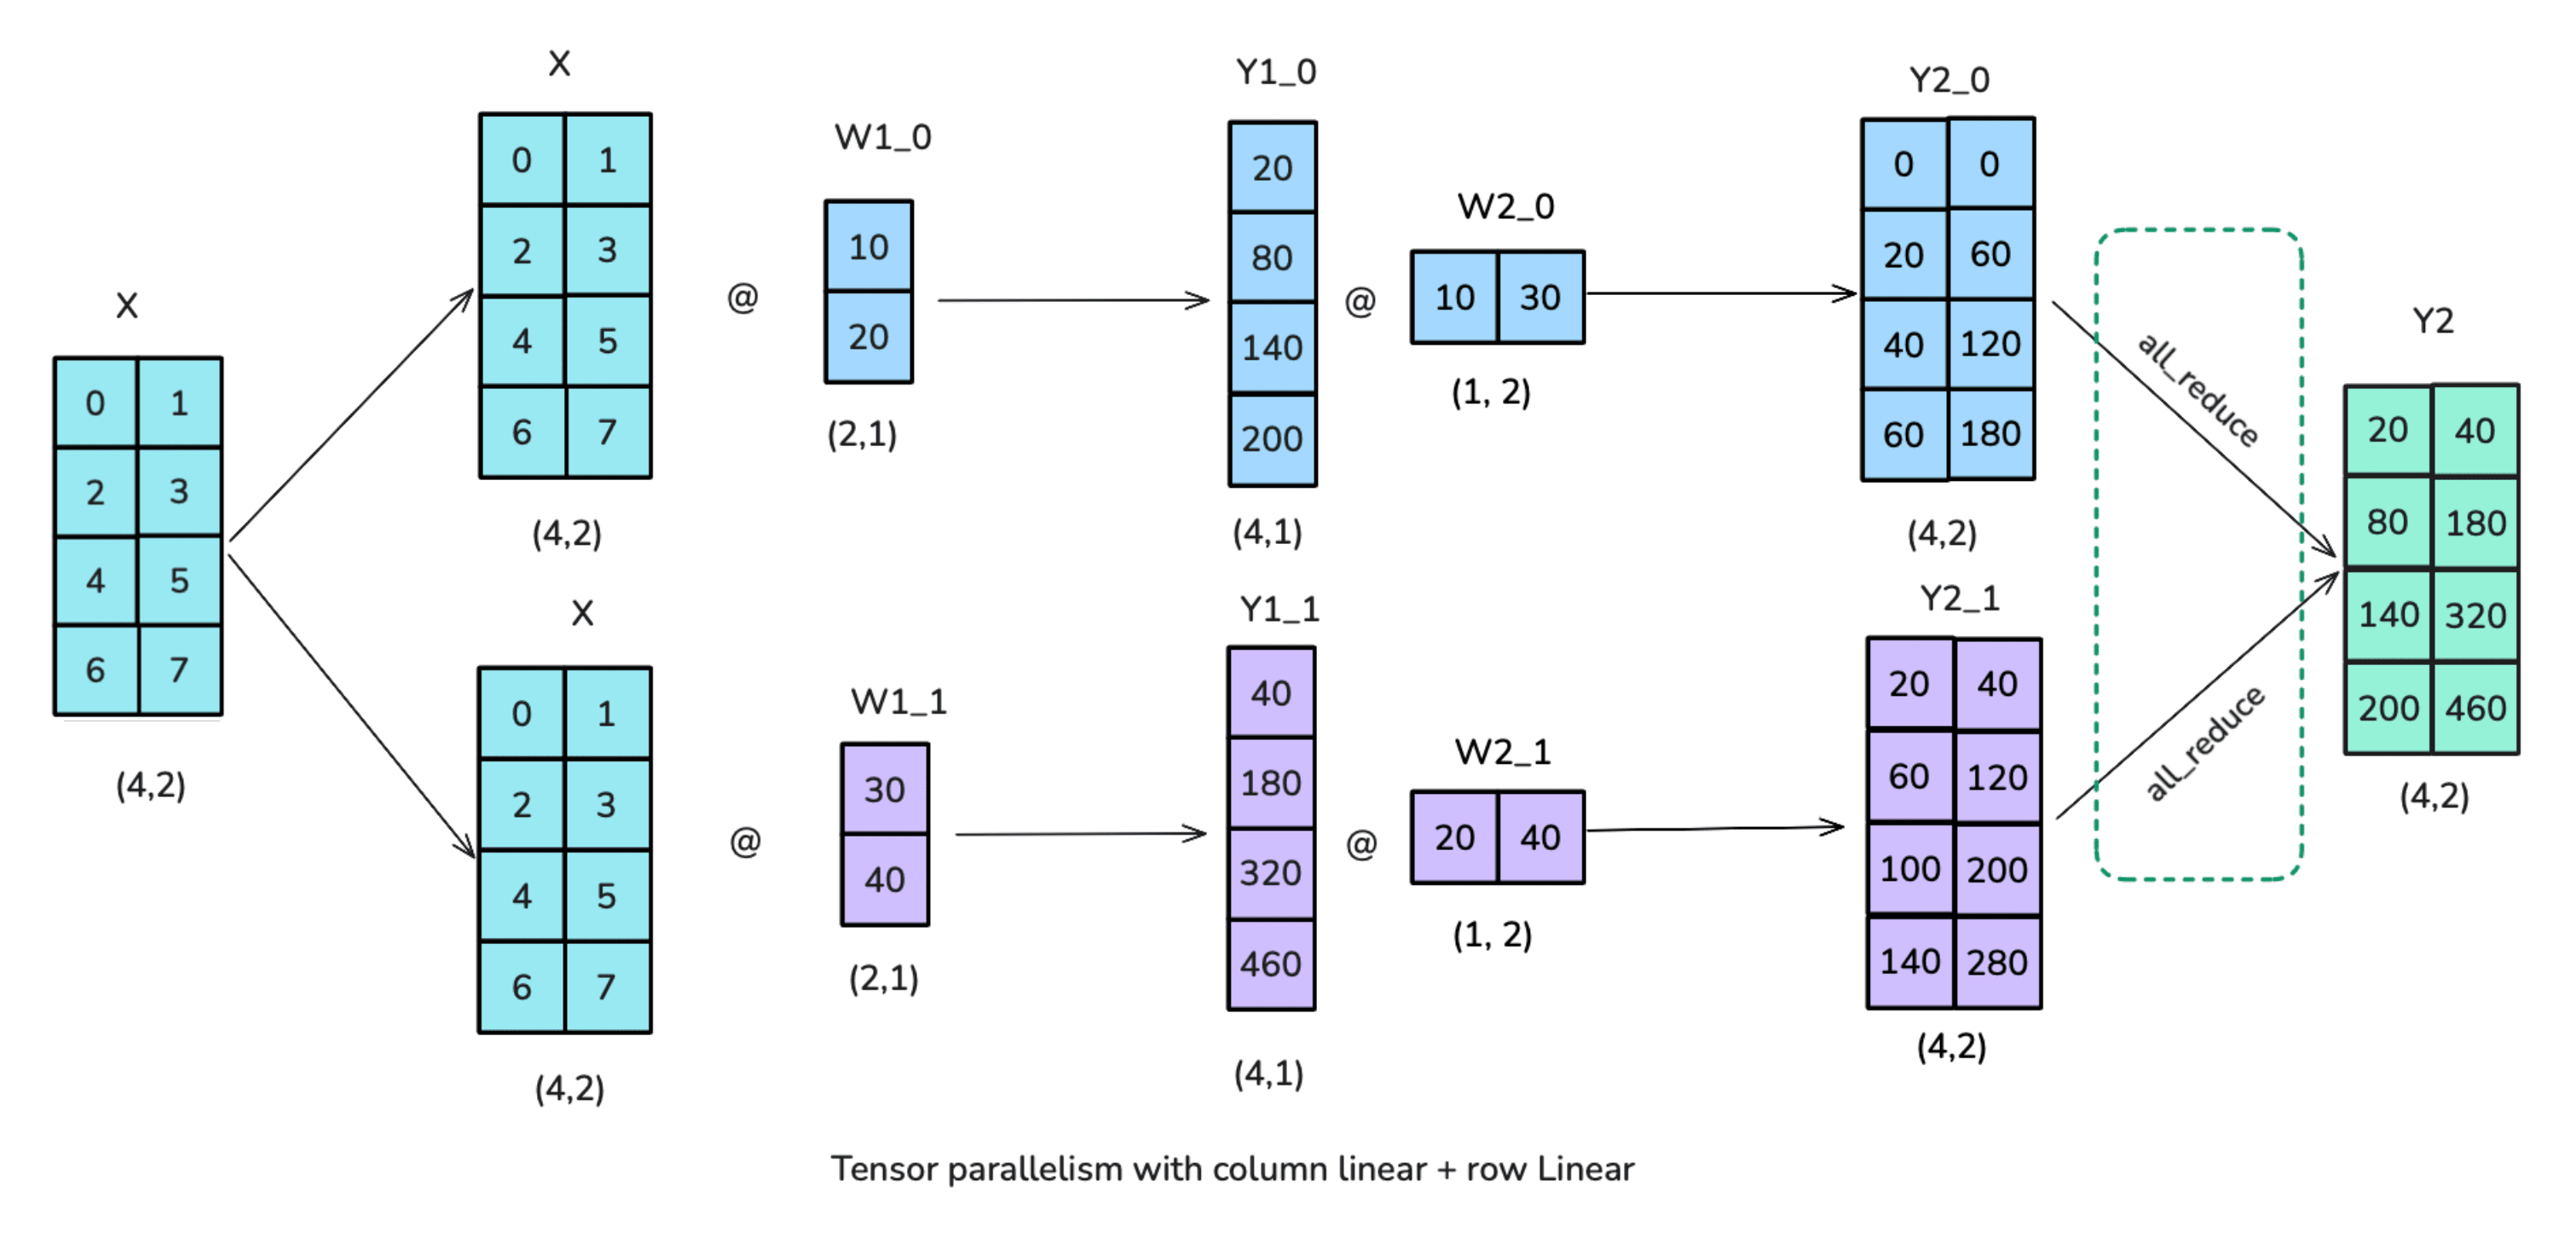
- MLP 通常是:
- Megatron 的拆分方法如下
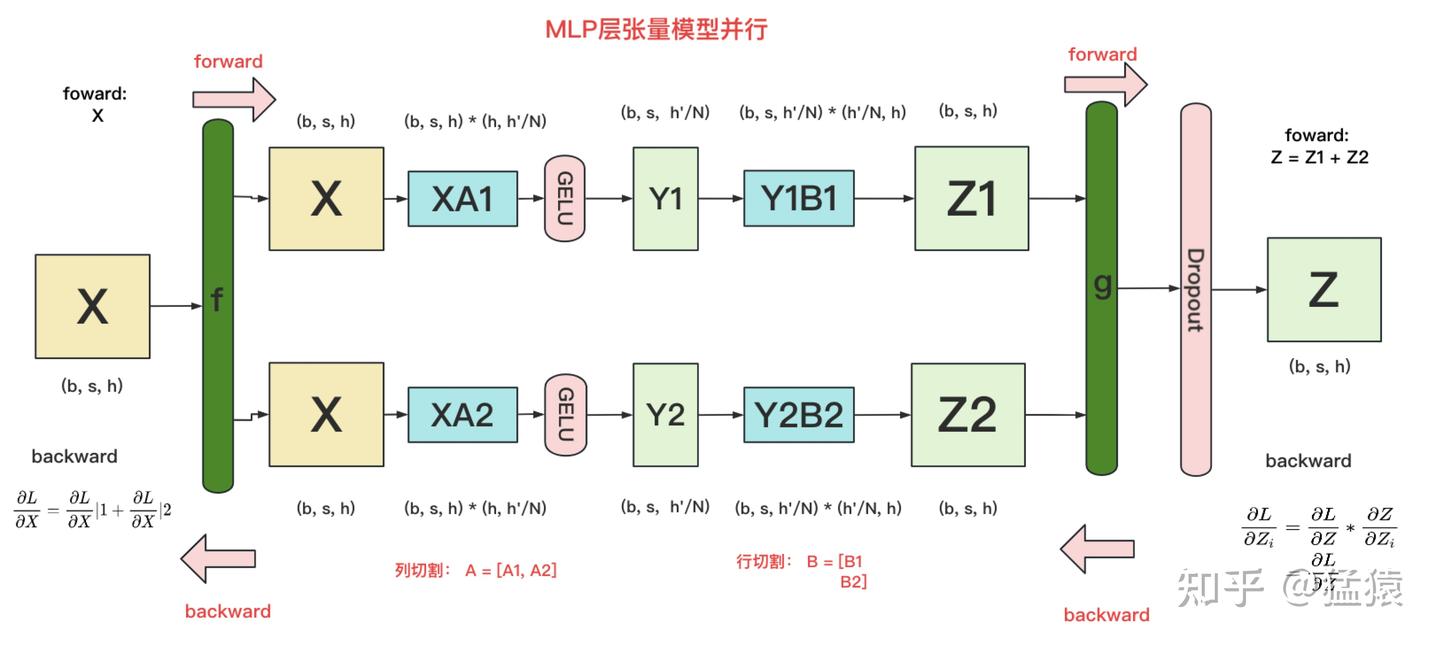
-
第一层():Column Parallel
- hidden dim 通常很大(如 4×)
- 切输出最自然
- 得到的是 sharded activation
- 在实际训练中,broadcast 通常并不需要,因为可以保证输入在各个 TP rank 上本来就是同步的
-
第二层():Row Parallel
- 输入正好是上一步的 sharded hidden
- 每个 GPU 只处理自己的那一块
- 最终 all-reduce 得到完整输出
-
算子的计算过程
- f 的 forward 计算:把输入 X 广播到两块 GPU 上,每块 GPU 即可独立进行 forward
- g 的 forward 计算:每块 GPU 上的 forward 计算完毕,得到 Z1 和 Z2 后,GPU 间进行一次 all-reduce,相加得到 Z
- g 的 backward 计算:把 广播到两块 GPU 上,每块 GPU 即可独立进行梯度计算
- f 的 backward 计算:当当前层的梯度计算完毕,需要传递到下一层继续做梯度计算时,需要求得 ,此时两块 GPU 进行一次 all-reduce,将各自的梯度相加
-
如果用 Row → Column:
-
由于 GELU 函数的性质
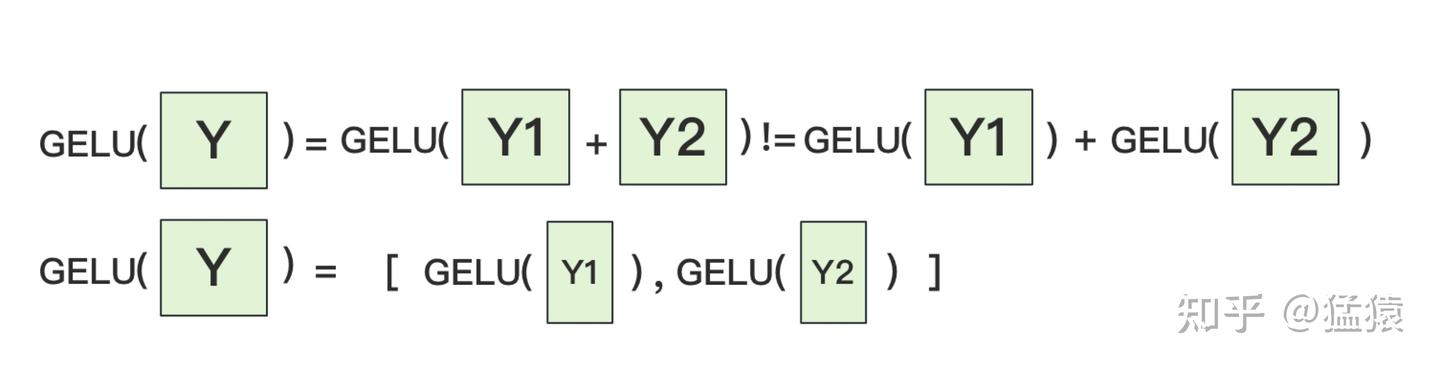
-
GELU 的标准计算公式为:
-
其中 是标准正态分布的累积分布函数,关键非线性性质:
- 不满足加法可分性:(非线性函数的核心特征,无法拆分加法后分别激活再求和)
- 满足列 / 通道可分性:(对张量的最后一维做列拆分后,每个子张量可独立做 GELU 计算,结果直接拼接即可)
-
必须在 GELU 计算前,做一次 All-Reduce,将所有 GPU 的 相加得到完整的 ,再广播到所有 GPU 做 GELU
-
引入了额外的全局通信,破坏了 GPU 计算的独立性,大幅增加通信开销,完全违背张量并行「减少通信、提升效率」的设计目标
-
-
A 列切 + B 行切的完整公式
- 从而只需在最后进行一次 all-reduce 通信
-
A 行切 + B 列切的完整公式
- 可见,必须在 GELU 之前做 all-reduce
-
MLP 层一共产生两次 all-reduce,而 AllReduce 的过程分为两个阶段,Reduce-Scatter 和 All-Gather,每个阶段的通讯量都相等,因此 all-reduce 产生的通讯量为 ,其中
Multi-Head Attention 的并行化
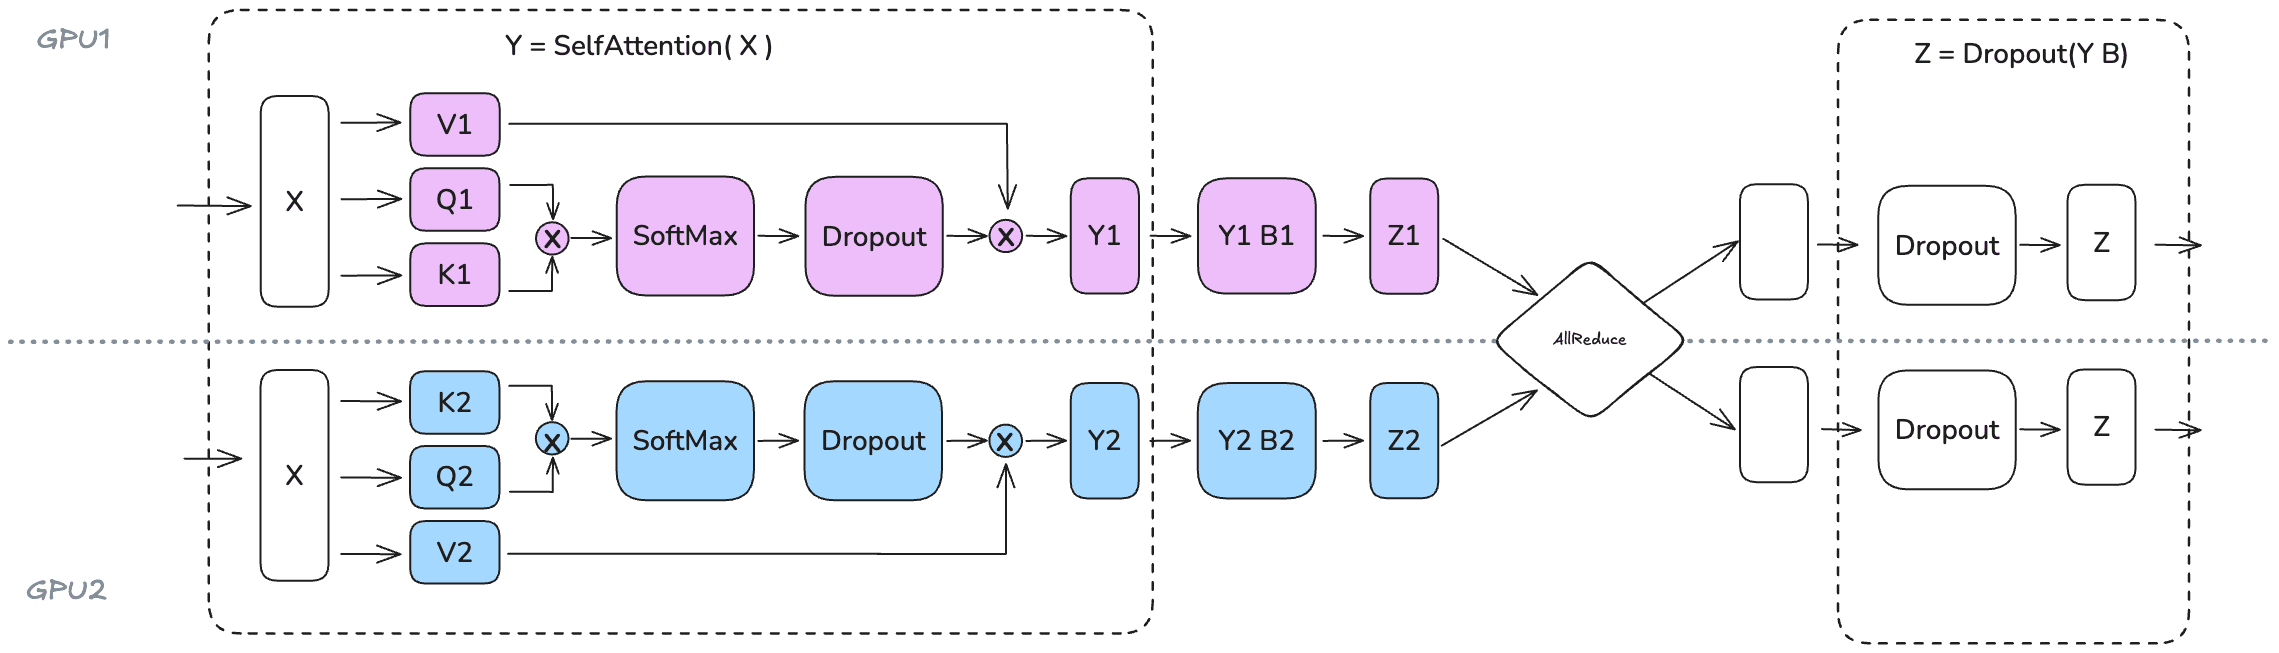
-
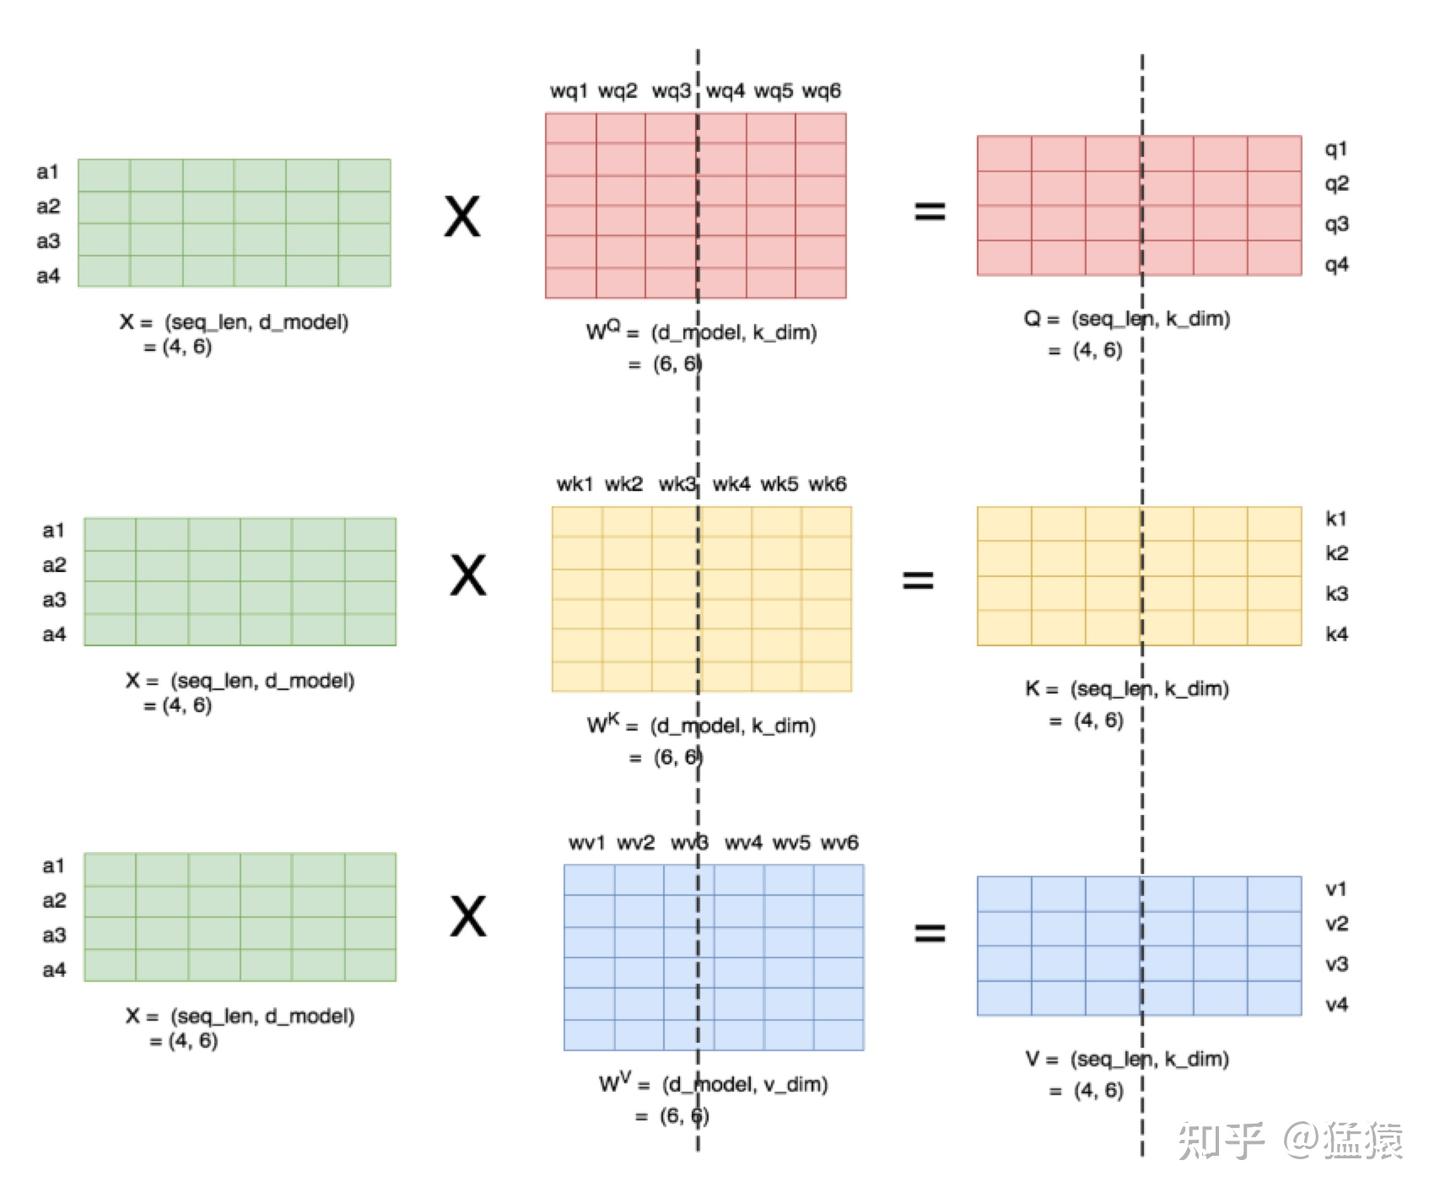
首先是单头注意力的 QKV 矩阵
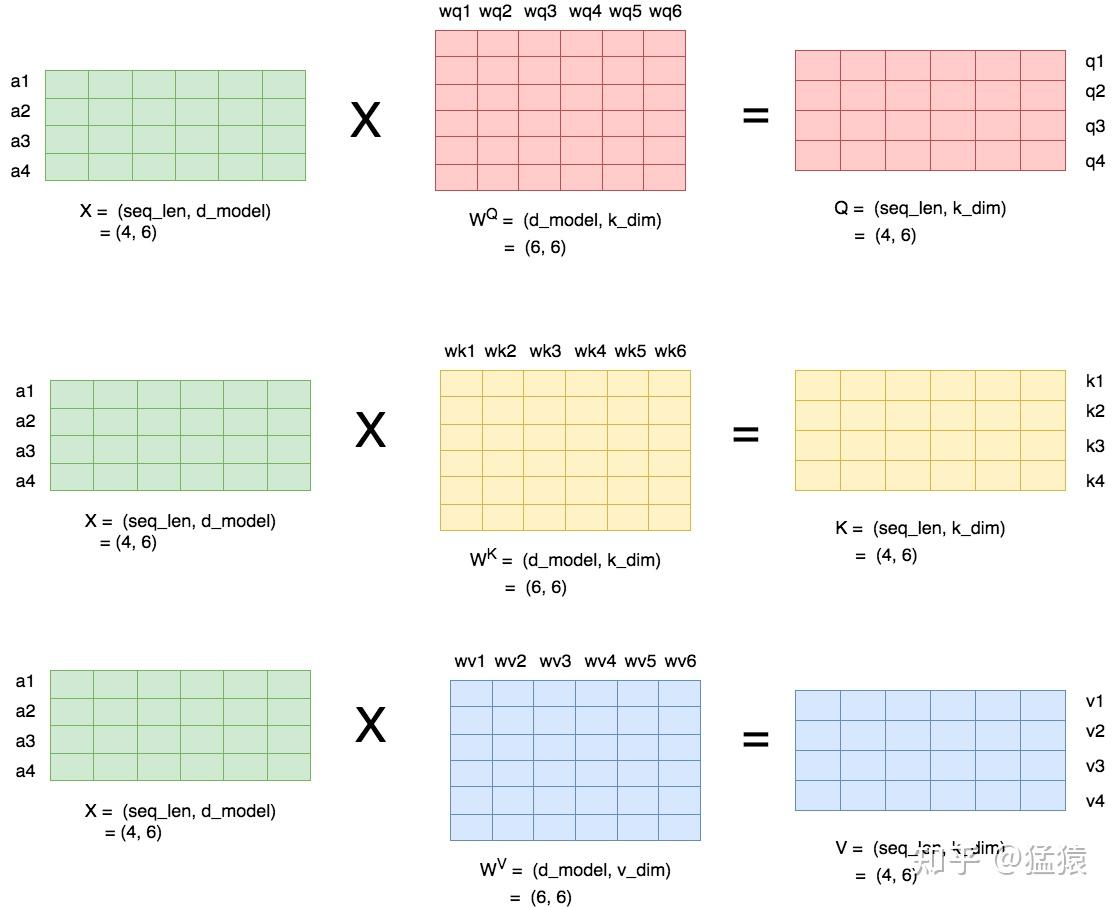
-
seq_len,d_model分别为s和h,也即序列长度和每个 token 的向量维度 -
W^Q,W^K,W^V即 attention 层需要做训练的三块权重 -
k_dim,v_dim满足: -
那么对于多头注意力,可以直接沿着 k_dim 的列方向切割 QKV 矩阵,这样三个权重矩阵的维度都变为 [d_model, k_dim//2],每个 head 上单独做矩阵计算,最后将计算结果 concat 起来即可
-
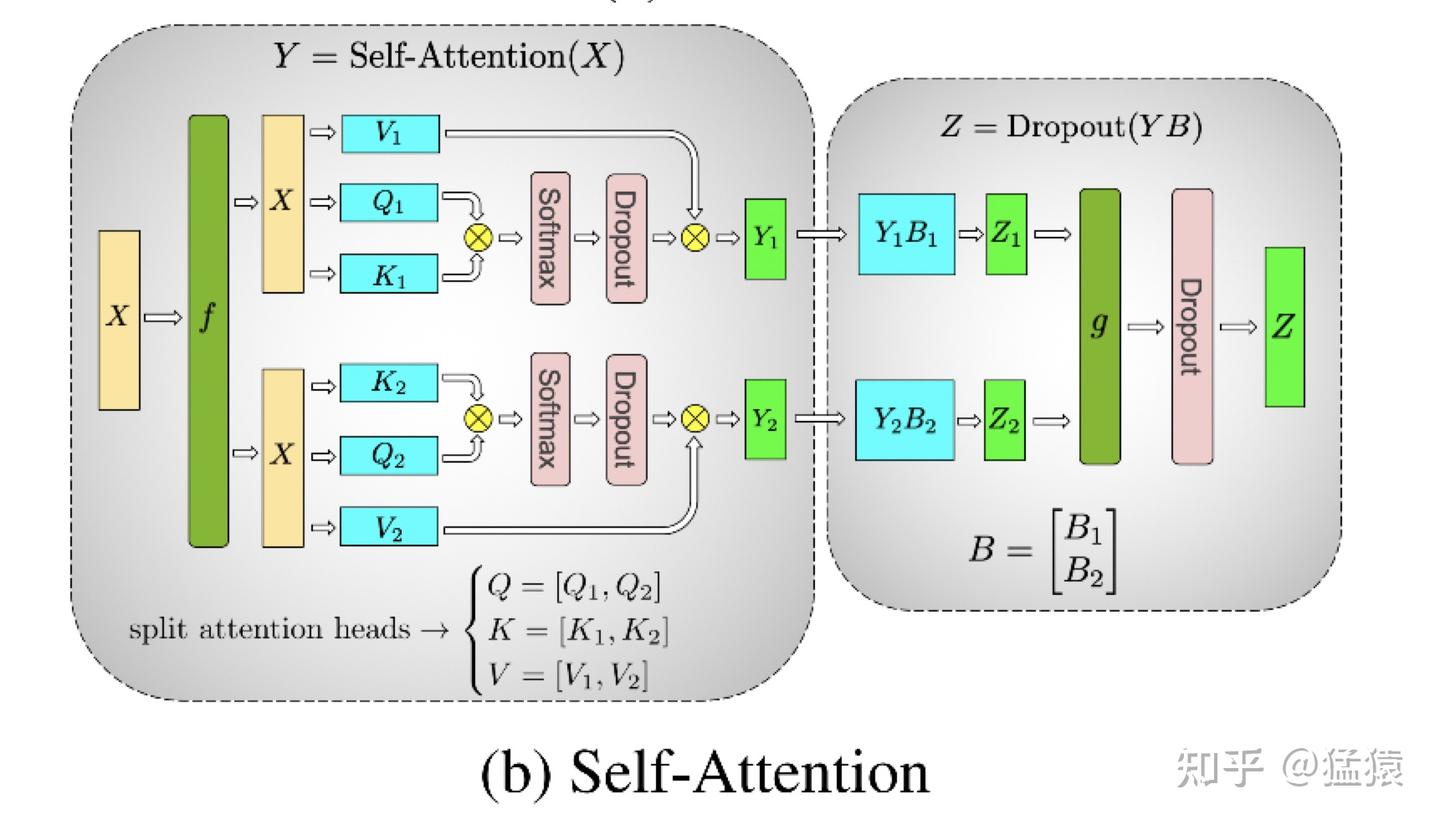
显然,多头注意力机制天然可以沿着 维度并行,每个 attention head 彼此独立
-
对于线性层 B,按照行切割,切割方式与 MLP 类似
-
在实际应用中,并不一定按照一个 head 占用一块 GPU 来切割权重,我们也可以一个多个 head 占用一块 GPU,这依然不会改变单块 GPU 上独立计算的目的
-
实际设计时,尽量保证 head 总数能被 GPU 个数整除
-
通信量分析
- 在 forward 时进行一次 all-reduce,在 backward 时进行一次 all-reduce
- 总通讯量为 ,其中
-
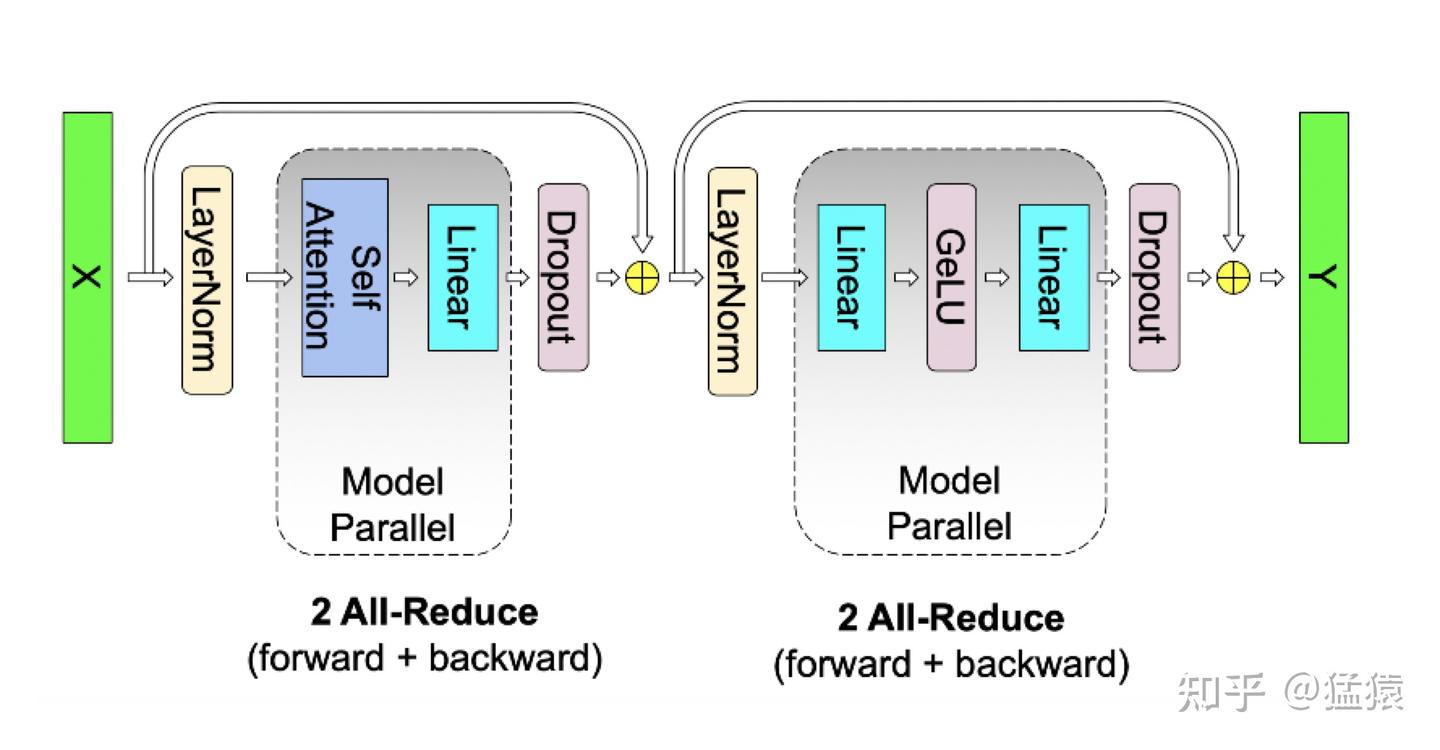
将 MLP 和 MHA 放在一起看
-
之所以能够如此高效地在 Attention 和 MLP 模块中应用张量并行,是因为它们都具有天然可独立分解的维度:
- Attention 模块可以沿着 维度并行(每个 attention head 彼此独立)
- MLP 模块可以沿着 维度并行(前馈网络在该维度上的计算彼此独立)
嵌入层的并行化
-
输入
-
对于位置编码 [max_s, h],max_s 不会太长,因此每个 GPU 都拷贝一份,对显存压力不会太大
-
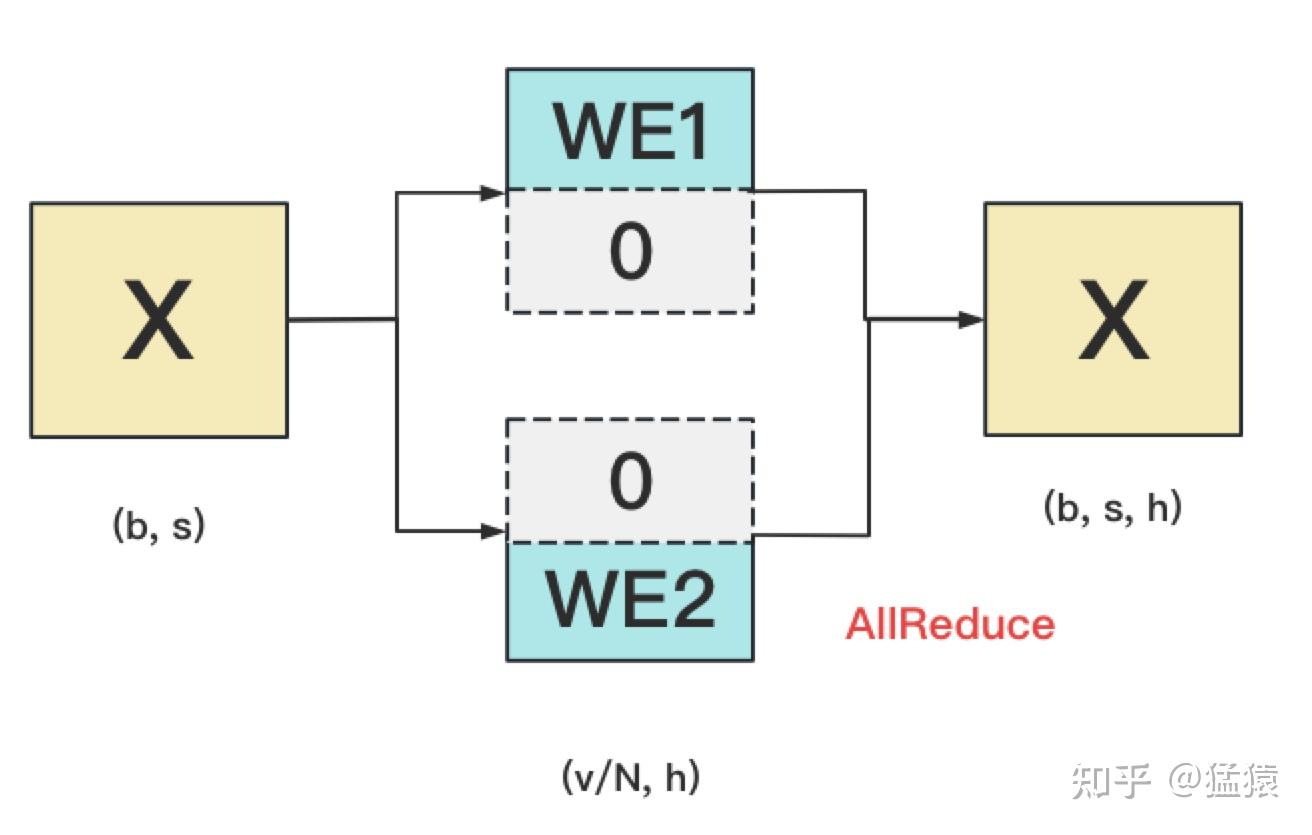
对于词嵌入 [v,h],则需要进行切分
-
当输入 X 在每块 GPU 上查找时,能够找到的词返回对应的词向量,如果找不到就都置为 0
-
这样查找完毕后,进行一次 all-reduce,就能够得到最终的输入
-
-
输出层
-
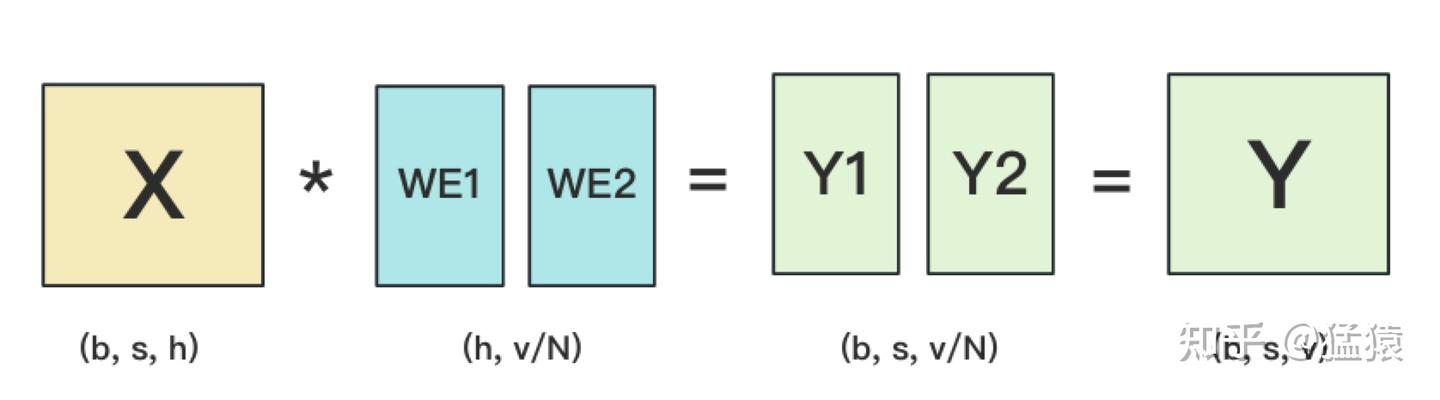
一般来说,输入层和输出层共用一个 word embedding
-
前向过程:输入层用这套权重把 token→向量;输出层用这套权重计算每个 token 的预测概率
-
反向过程:
- 输出层计算 loss 时,会对 Word Embedding 求一次梯度(记为
grad_out); - 输入层反向传播时,也会对 Word Embedding 求一次梯度(记为
grad_in); - 最终更新权重时,必须用
grad_total = grad_in + grad_out,而不是只用其中一个
- 输出层计算 loss 时,会对 Word Embedding 求一次梯度(记为
-
-
在张量并行场景下
- 当并行深度 = 1(所有层都在单 GPU):
grad_in和grad_out都在同一个 GPU 上,框架会自动累加,无需额外操作 - 当输入层和输出层拆分到不同 GPU(比如 GPU0 放输入层、GPU1 放输出层):
- GPU0 上只有
grad_in(输入层反向的梯度); - GPU1 上只有
grad_out(输出层反向的梯度); - 如果直接更新,两块 GPU 的 Word Embedding 权重会分别用单一梯度更新,导致权重不一致、模型训练失效
- GPU0 上只有
- 此时就需要在权重更新前,将两块 GPU 上的词嵌入梯度进行一次 all-reduce
- 当并行深度 = 1(所有层都在单 GPU):
损失计算层的并行化
-
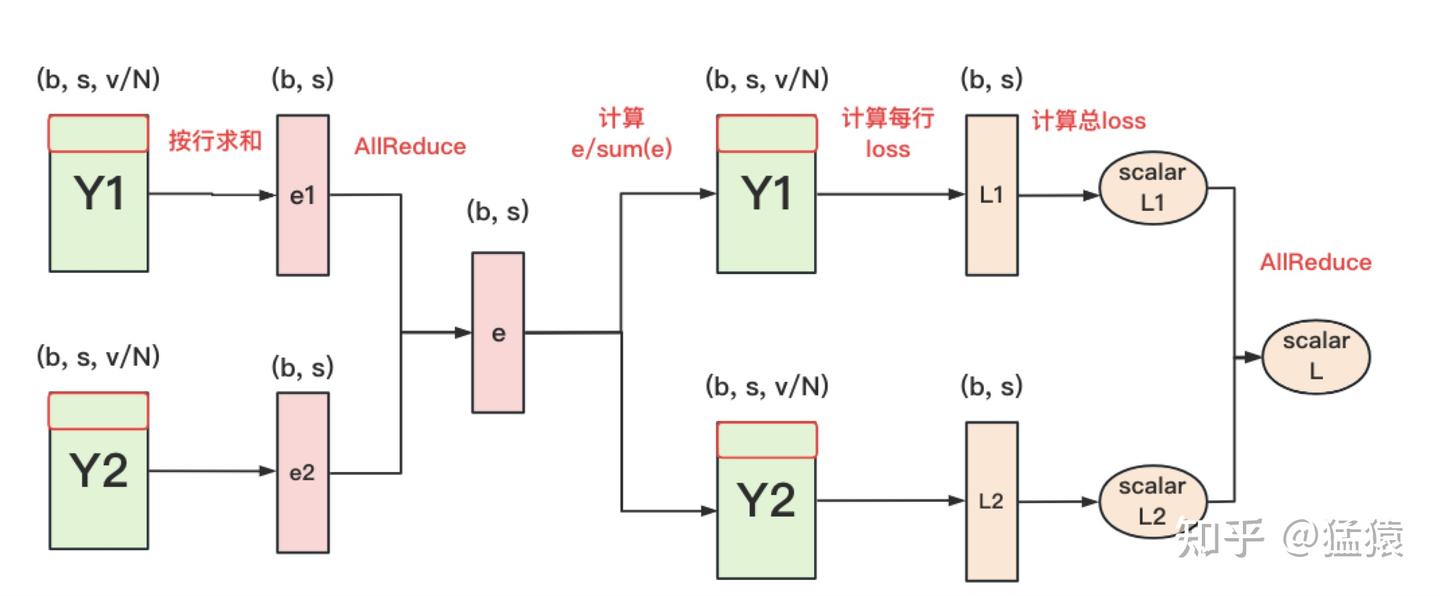
在输出嵌入层得到 Y1,Y2 后,可以对其做一次 all-gather 拼接起来后形成 Y,然后对 Y 的每一行进行 softmax,即可得到对于当前位置而言,每个词出现的概率,然后再用词概率和真值计算交叉熵损失
-
但是进行 all-gather 会引入额外的通讯量 ,当词表很大时,这个通讯量也不容忽视
-
在每块 GPU 上,可以先按行求和,然后进行 all-reduce,得到最终的和,也即 softmax 的分母,此时通讯量为
-
在每块 GPU 上,即可计算维护各自部分的 softmax 值,然后再与真值计算交叉熵损失,按行加总起来得到 GPU 上的标量损失
-
最后在进行一次 all-reduce,得到总损失,此时通讯量为 N
-
由此,将通讯量由 降低至
相关分析
-
张量并行度的限制(Attention Heads)
-
需要注意的是,张量并行的并行度不应超过 attention heads 的数量,因为我们是沿着 维度对 QKV 投影进行切分的
-
在使用 GQA 时,有 个 query heads,但只有 个 key/value heads,且满足
-
在这种情况下,理论上仍然可以设置 ,但需要确保 K/V heads 在不同 GPU 之间保持正确同步
-
例如,Llama-3 8B 模型有 32 个 query heads,但只有 8 个 key/value heads,因此,虽然 TP 理论上可以扩展到 32,但需要非常谨慎的实现来保证 K/V head 在各个 TP worker 之间的一致性
-
-
张量并行中的前向传播瓶颈
-
在张量并行的前向传播中,每一层 decoder 的前向传播中,都会遇到一个 all-reduce 的同步点,这个同步点无法与计算完全重叠
-
这是因为在 LayerNorm 之前,必须先将各个 TP rank 上的部分结果合并
-
前面的线性层 / Attention / MLP 是 TP 分片计算的,但在 LayerNorm 之前,必须通过 all-gather /all-reduce,使得每个 TP rank 都拿到完整的激活值
-
也就是说,对任意 TP rank :
-
这是 LayerNorm 的一个硬约束:它需要对完整 hidden dimension 做统计量(均值、方差),不能在 shard 上算
-
-
LayerNorm 的前向一致 ⇒ 反向梯度天然一致
-
因为每个 TP rank 的输入 完全相同,forward 输出也完全相同,loss 也是相同的
-
所以反向传播时,对 LayerNorm 参数的梯度:
-
对所有 TP rank 都成立
-
因此 LayerNorm 的梯度在各 TP rank 上是 “天然一致” 的,不需要 all-reduce 来同步
-
-
Dropout 要 “同步随机种子”
-
Dropout 本质上引入了随机性,其等价于:
- 其中 是一个随机 mask
-
如果 TP rank 使用不同的随机种子,即便输入 在 TP rank 上是一样的,但是 rank 0 用 mask ,rank 1 用 mask ,且 ,那么
-
接下来会发生灾难性的后果 ——backward 梯度不同、LayerNorm 前提被破坏、参数更新不一致、训练数值不再等价于单卡
-
-
一些系统(如 Megatron-LM、Nanotron)通过以下方式缓解这一问题:
- 在 FC1 计算过程中部分重叠 all-gather
- 当矩阵乘法的一部分结果计算完成后,就立即将其发送到其他 GPU
- 剩余部分仍在继续计算
-
-
激活内存与通信的权衡
- 引入额外的通信:ZeRO 的通信如 all-reduce /reduce-scatter,发生在 backward 阶段,可以和反向计算流水重叠;而张量并行在模型的前向计算路径(LayerNorm 之前)中直接引入了多种分布式通信原语,而这些通信很难被完全隐藏或与计算重叠
- 激活内存的节省被破坏:张量并行确实可以将矩阵乘法中的中间激活值分片到多个 GPU,从而减少单卡激活内存占用;但仍然存在限制,对于 LayerNorm 等操作,仍然需要收集完整激活,因此并不能获得 “完全” 的激活内存节省
- 吞吐率的下降:TP 引入了强依赖于网络条件的通信需求,由于某些 all-reduce 操作无法被完全隐藏,它们会直接落在前向传播的关键路径上 —— 也就是决定前向传播最短完成时间的那条操作链
- 因此,最终性能是以下因素之间的权衡结果:计算与显存节省带来的收益和额外通信开销带来的损失
TP 与 DP 的结合
-
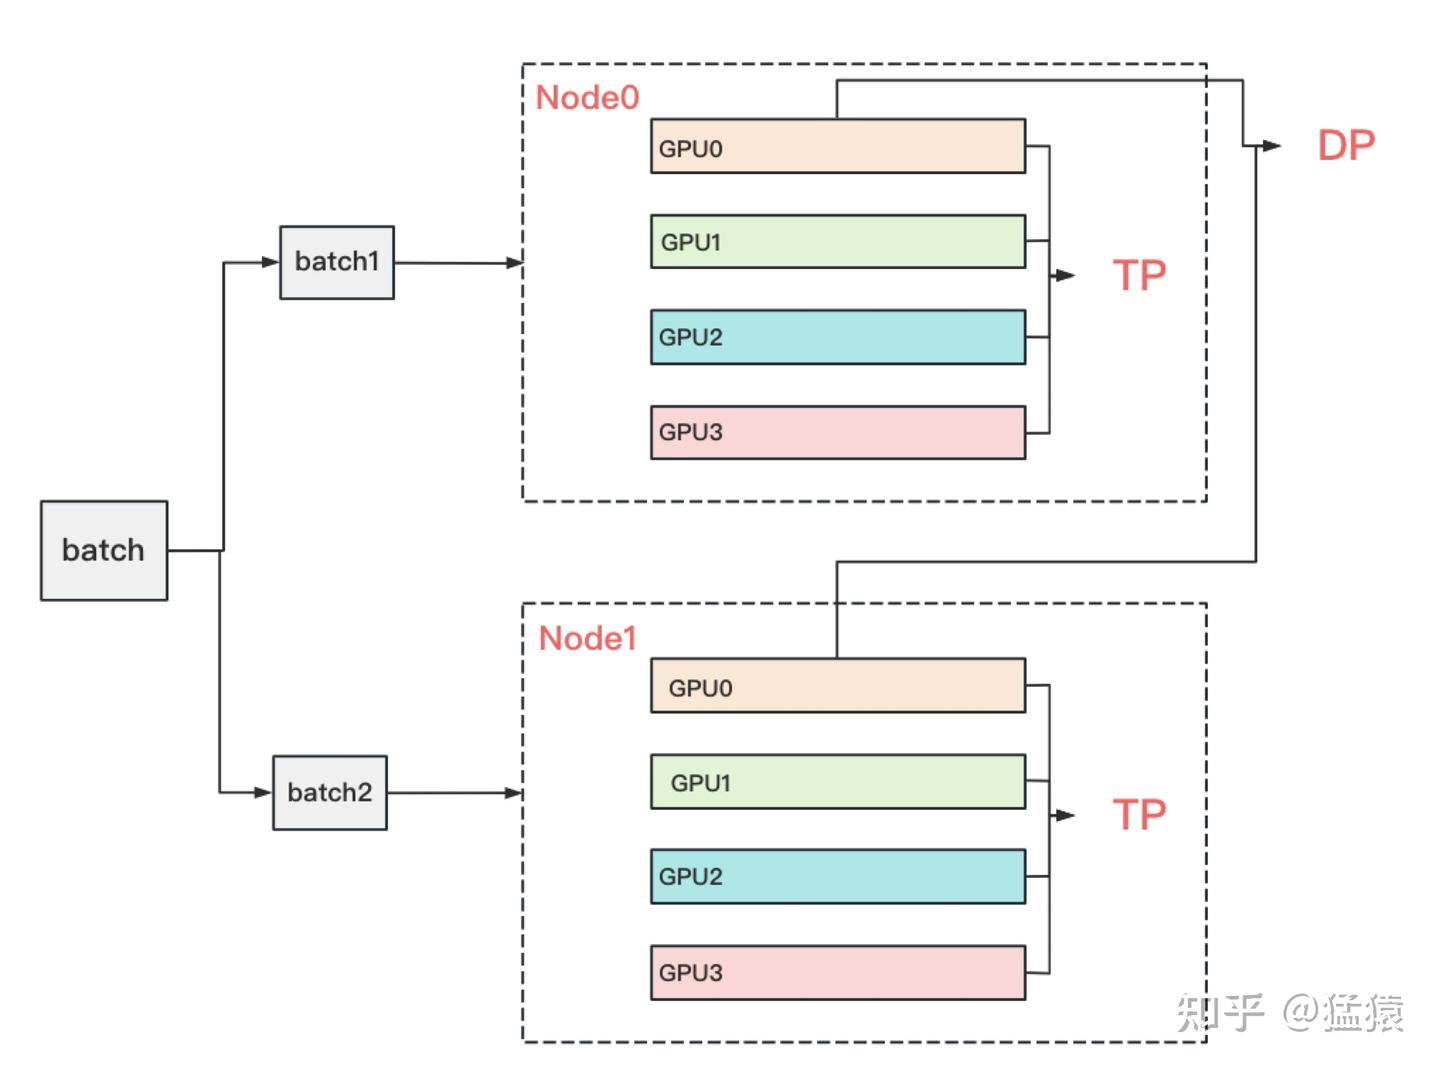
常见结合模式
-
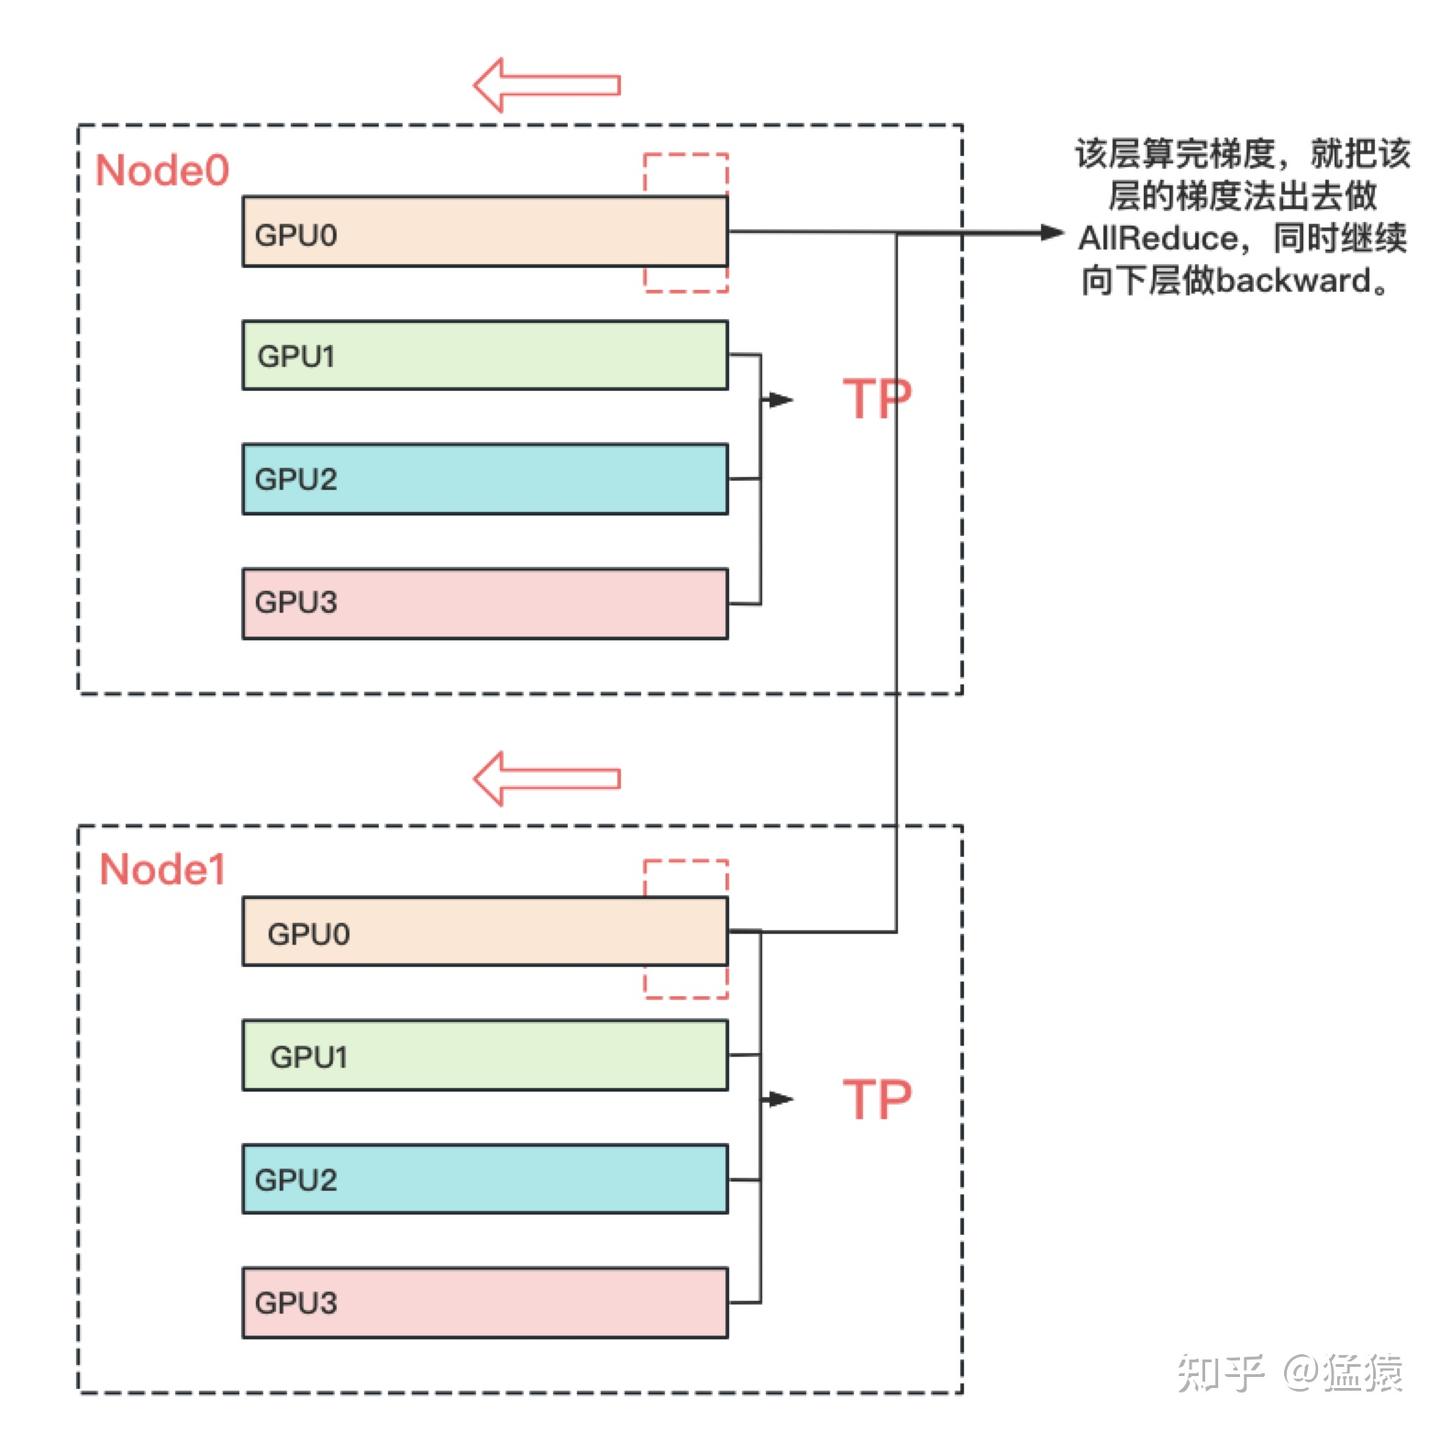
其中,node 表示一台机器,一般在同一台机器的 GPU 间做张量模型并行,而在不同的机器上做数据并行
-
通讯量分析(关注每层 Transformer)
-
在张量模型并行中,设每次通讯量为 ,从上面分析中知道每层做 4 次 AllReduce,其通讯总量为 ;其中,,则通讯总量为
-
在数据并行中,设每次通讯量为 ,每层做 1 次 AllReduce(先不考虑 ZeRO 拆分权重的情况),其通讯总量为 ;其中,通讯的主要是梯度,则 ,总通讯量为
-
因此,要比较的就是 和 。忽略常数和共同项,我们最终比较的是:
-
在实际应用中,前者可能会比后者大一些,但量级基本在 左右,因此通讯量有差异但不显著
-
理论来说,通讯量大的尽量放在同一台机器上,而通讯量小的则可以考虑在不同机器间做并行
-
-
反向传播的方式
-
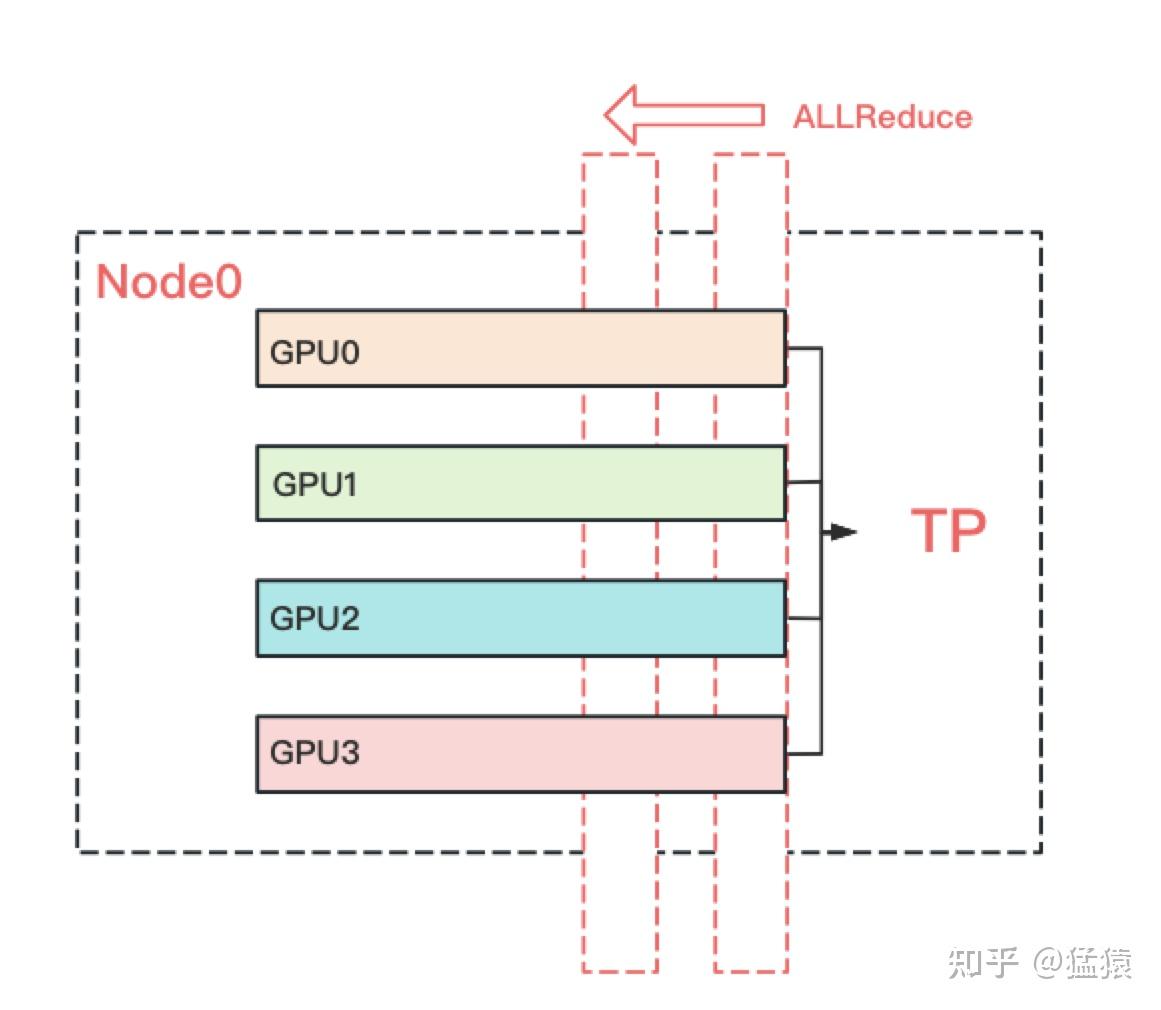
在 TP 中,从上一层到下一层进行反向传播时,所有 GPU 之间需要进行一次 all-reduce
-
而在 DP 中,本层计算完梯度后,既可以将本层的梯度转发出去,和属于同一个 DP 组的 GPU 进行 all-reduce,同时继续进行下一层的反向传播
-
也即,在 DP 组中,下一层不依赖上一层的梯度聚合结果,因此 DP 对带宽的需求相较来说没有那么高
-