上下文并行
介绍上下文并行的基本概念、实现方法以及在 PyTorch 中的使用方法
- 参考资料
基本思想
- TP+SP 无法应对超长上下文
- 如前文所述,在 TP+SP 中,当 变得非常大时,激活在 TP region 仍然线性随 增长
- 即使使用 activation recomputation,也必须在 layer 边界保存一些激活
- 这些激活的内存下界是 ,无法再缩减
- 上下文并行的本质是:把 SP 从 “只在非 TP 模块用”,升级为 “在整个模型中都用”
- SP 只在 LN 和 Dropout 中按照序列进行切分
- 而 CP 把输入序列沿 sequence 维切分到多个 GPU,每个 GPU 只负责一段上下文(context slice)
- 这一点和 SP 类似,但作用范围扩大到了 Attention / MLP 本身
- 这样,在 TP region 里:每个 GPU 处理的激活大小从 变成 ,激活显存随 的增长被 倍稀释
- 对于 MLP、LayerNorm、Dropout、逐 token 的线性变换等模块,切分序列是免费的
- 以上模块都有一个共同点:每个 token 是独立处理的
- 因此当把 sequence 切分后,不需要权重通信(权重不切),不需要跨 GPU 交换激活,backward 后只需要像 DP 一样对梯度做一次 all-reduce,其通信成本非常低
- 而对于 Attention 模块
- 在注意力计算中,每个 token 都要访问所有 token 的 key/value(在 casual attention 中,至少需要关注之前的每个 token 的 key/value)
- 当 sequence 被切分后,每个 GPU 只持有一部分 ,但需要全局的
- 如果直接 all-gather 全部 ,通信量是 ,显存和带宽都会直接爆炸
- 因此 CP 的可行性完全取决于有没有一种方法能高效地交换 ,而不是一次性 gather
- 上下文并行与 FlashAttention
- 二者都使用 online softmax,都避免保存完整 attention matrix
- 区别在于:FlashAttention 是单 GPU 内的 kernel 级优化,上下文并行是跨 GPU 的并行策略
- CP 关注的是 “序列如何分布到多卡”,不是单卡算得多快
朴素 Ring Attention
- 朴素 Attention 的计算过程
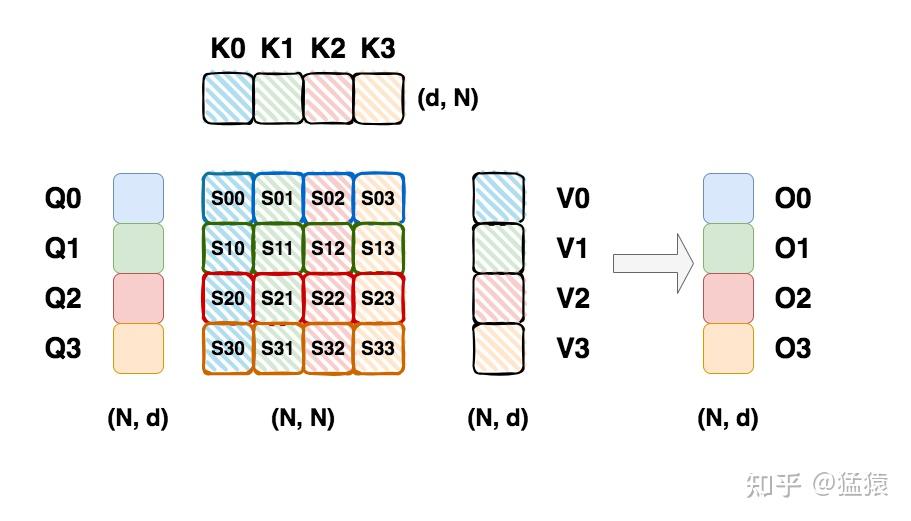
-
一个朴素 Attention 的计算过程如上图所示,在此设定 Q、K、V 三个矩阵的维度均为 ,其中 代表序列长度(), 代表隐藏层维度()
-
为了便于后续阐述 Ring Attention 的切块计算逻辑,上图将 Q、K、V 均切分为 4 个块,每个分块的维度为
-
图中维度为 的 Attention 矩阵,必须先经过 Softmax 归一化处理,才能与 V 矩阵进行相乘运算
-
为简化图示,Softmax 步骤未在图中画出,但这一步是 Attention 计算的核心环节
-
常规的 Softmax 计算公式如下:
-
在实际计算中,若 的数值过大,指数运算 极易引发数据上溢(Overflow)问题
-
为解决这一数值稳定性问题,可以采用 Safe Softmax 方法,其核心思路是先对输入做归一化处理,首先计算输入序列中的最大值:
-
再将每个输入值减去该最大值后进行 Softmax 计算:
-
对于单个 GPU,其基本思路是
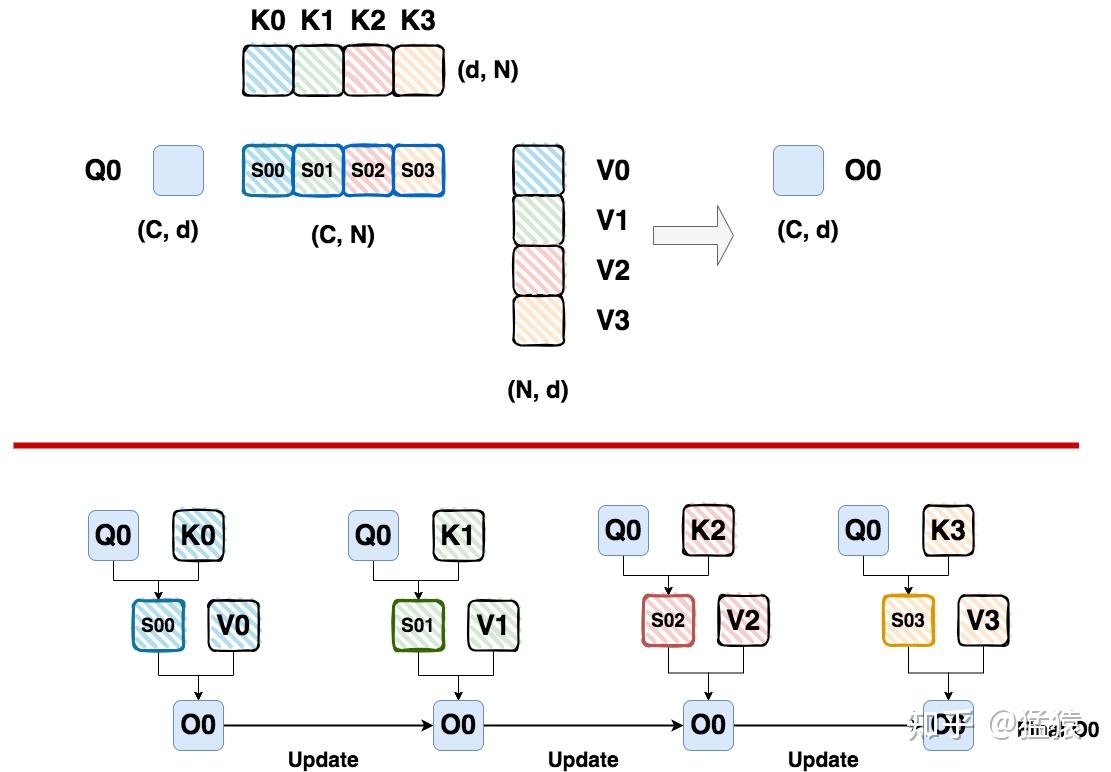
- 固定住某个 ,其尺寸为
- 将该 分别传入不同的 、 数据块,计算对应的
- 通过某种方式,每传入一份 ,就更新一次
- 当最后一份 传入并计算完毕后,即可得到最终的
- 这一过程可理解为:始终维护一个尺寸为 的 ,每次计算完毕后更新该
- 在代码实现中,遍历 Q 分块的过程可表示为外层循环(outer loop),遍历 KV 分块的过程可表示为内层循环(inner loop)
- 如果不对 Attention score 做 softmax,那么 的更新方式就可以简化为简单的累加形式,即本次计算出的 与上一步骤后 的结果直接相加
- 但当对 Attention score 做 softmax(默认指 safe softmax)时,情况则大不相同。举例来说:
- 计算 safe softmax 需要知道分数矩阵每行的最大值(global max)和每行的和(global sum)
- 当使用 的结果计算 时,采用的是 这个矩阵的 local max 和 global sum
- 因此,在使用 softmax 的情况下,无法对 进行简单的累加
- 那么,在分块的情况下,到底要采取什么方式更新 呢?本质上来说,ring attention 采用的是和 flash attention V2 非常相近的 更新方式
-
基于 FlashAttention 的思想,可以得到
- 的计算顺序不重要
- 在上图中,依次计算出了 ,并按此顺序更新
- 但实际上,只要每次计算时都能拿到当前的 、当前的 max 和当前的 sum 相关信息,就可以按任意顺序(如 )进行更新计算,且不影响最终结果
- 这是因为核心在于每次计算时都能获取到这些状态信息,从而正常完成更新
- 未用到的 块存在显存浪费问题:
- 例如在计算 时,、 可能暂时用不上,但它们依然占用显存,造成了不必要的浪费
- 的计算顺序不重要
-
Ring Attention 的核心思想
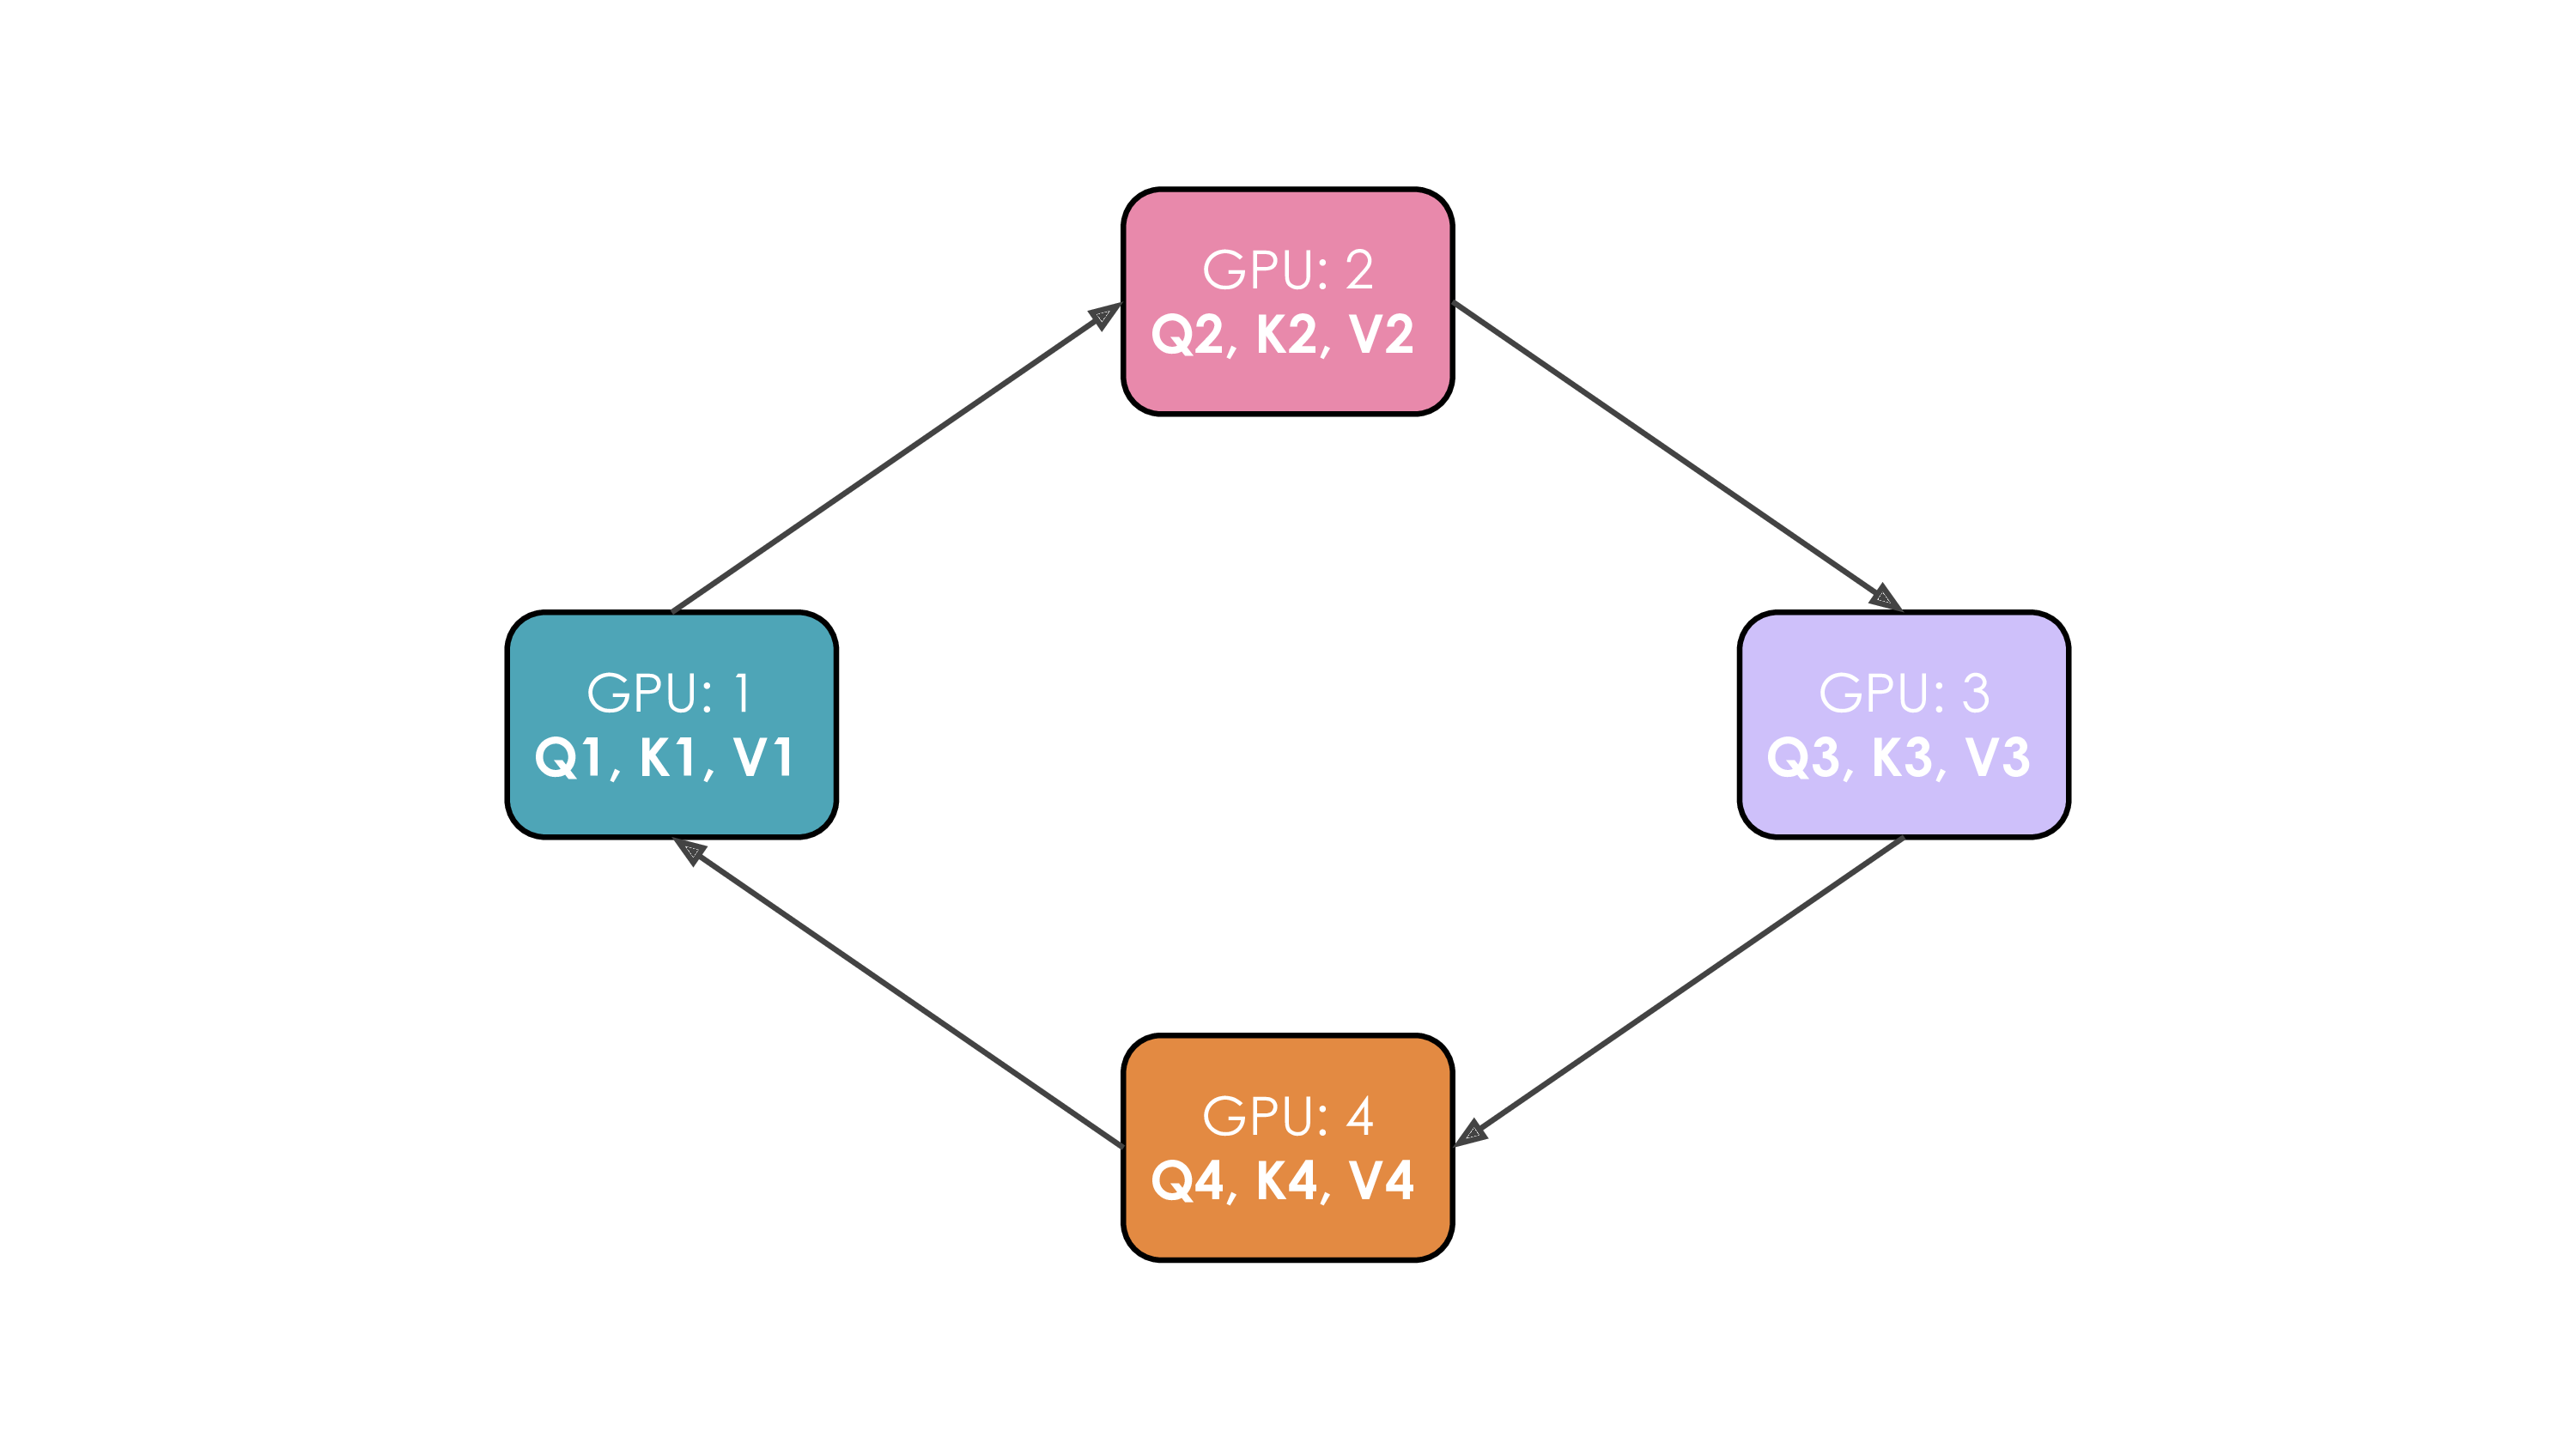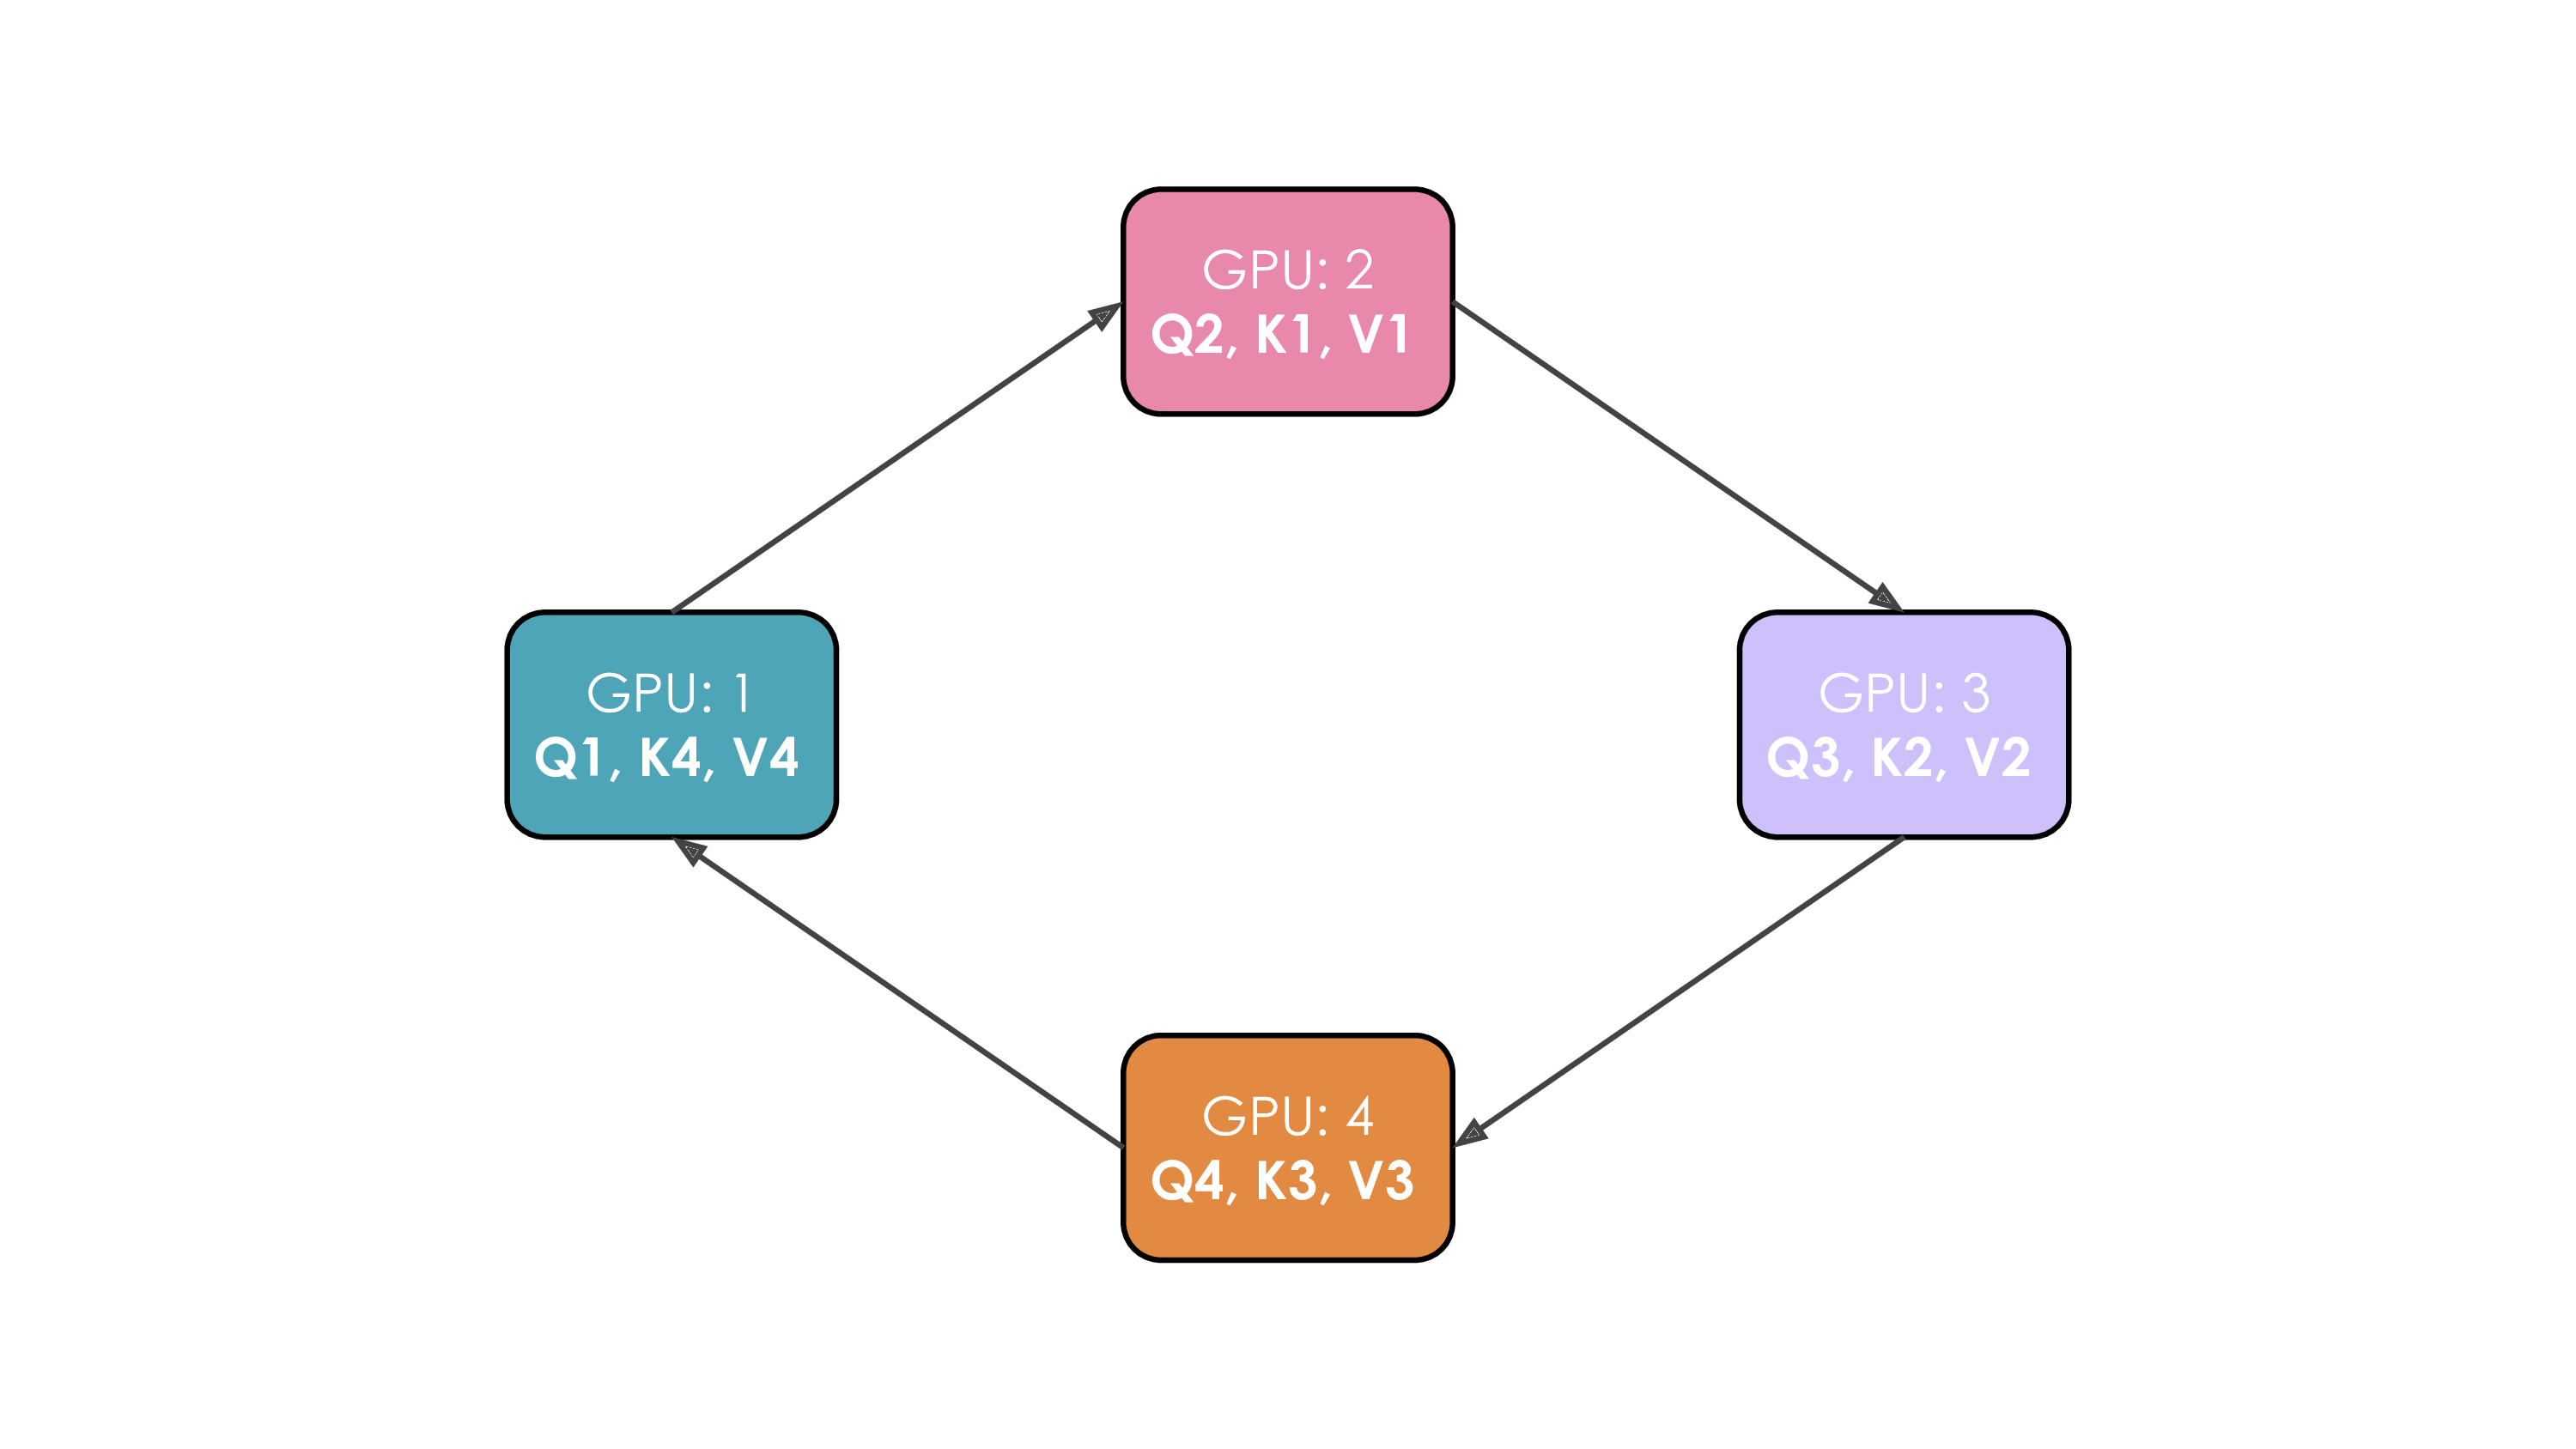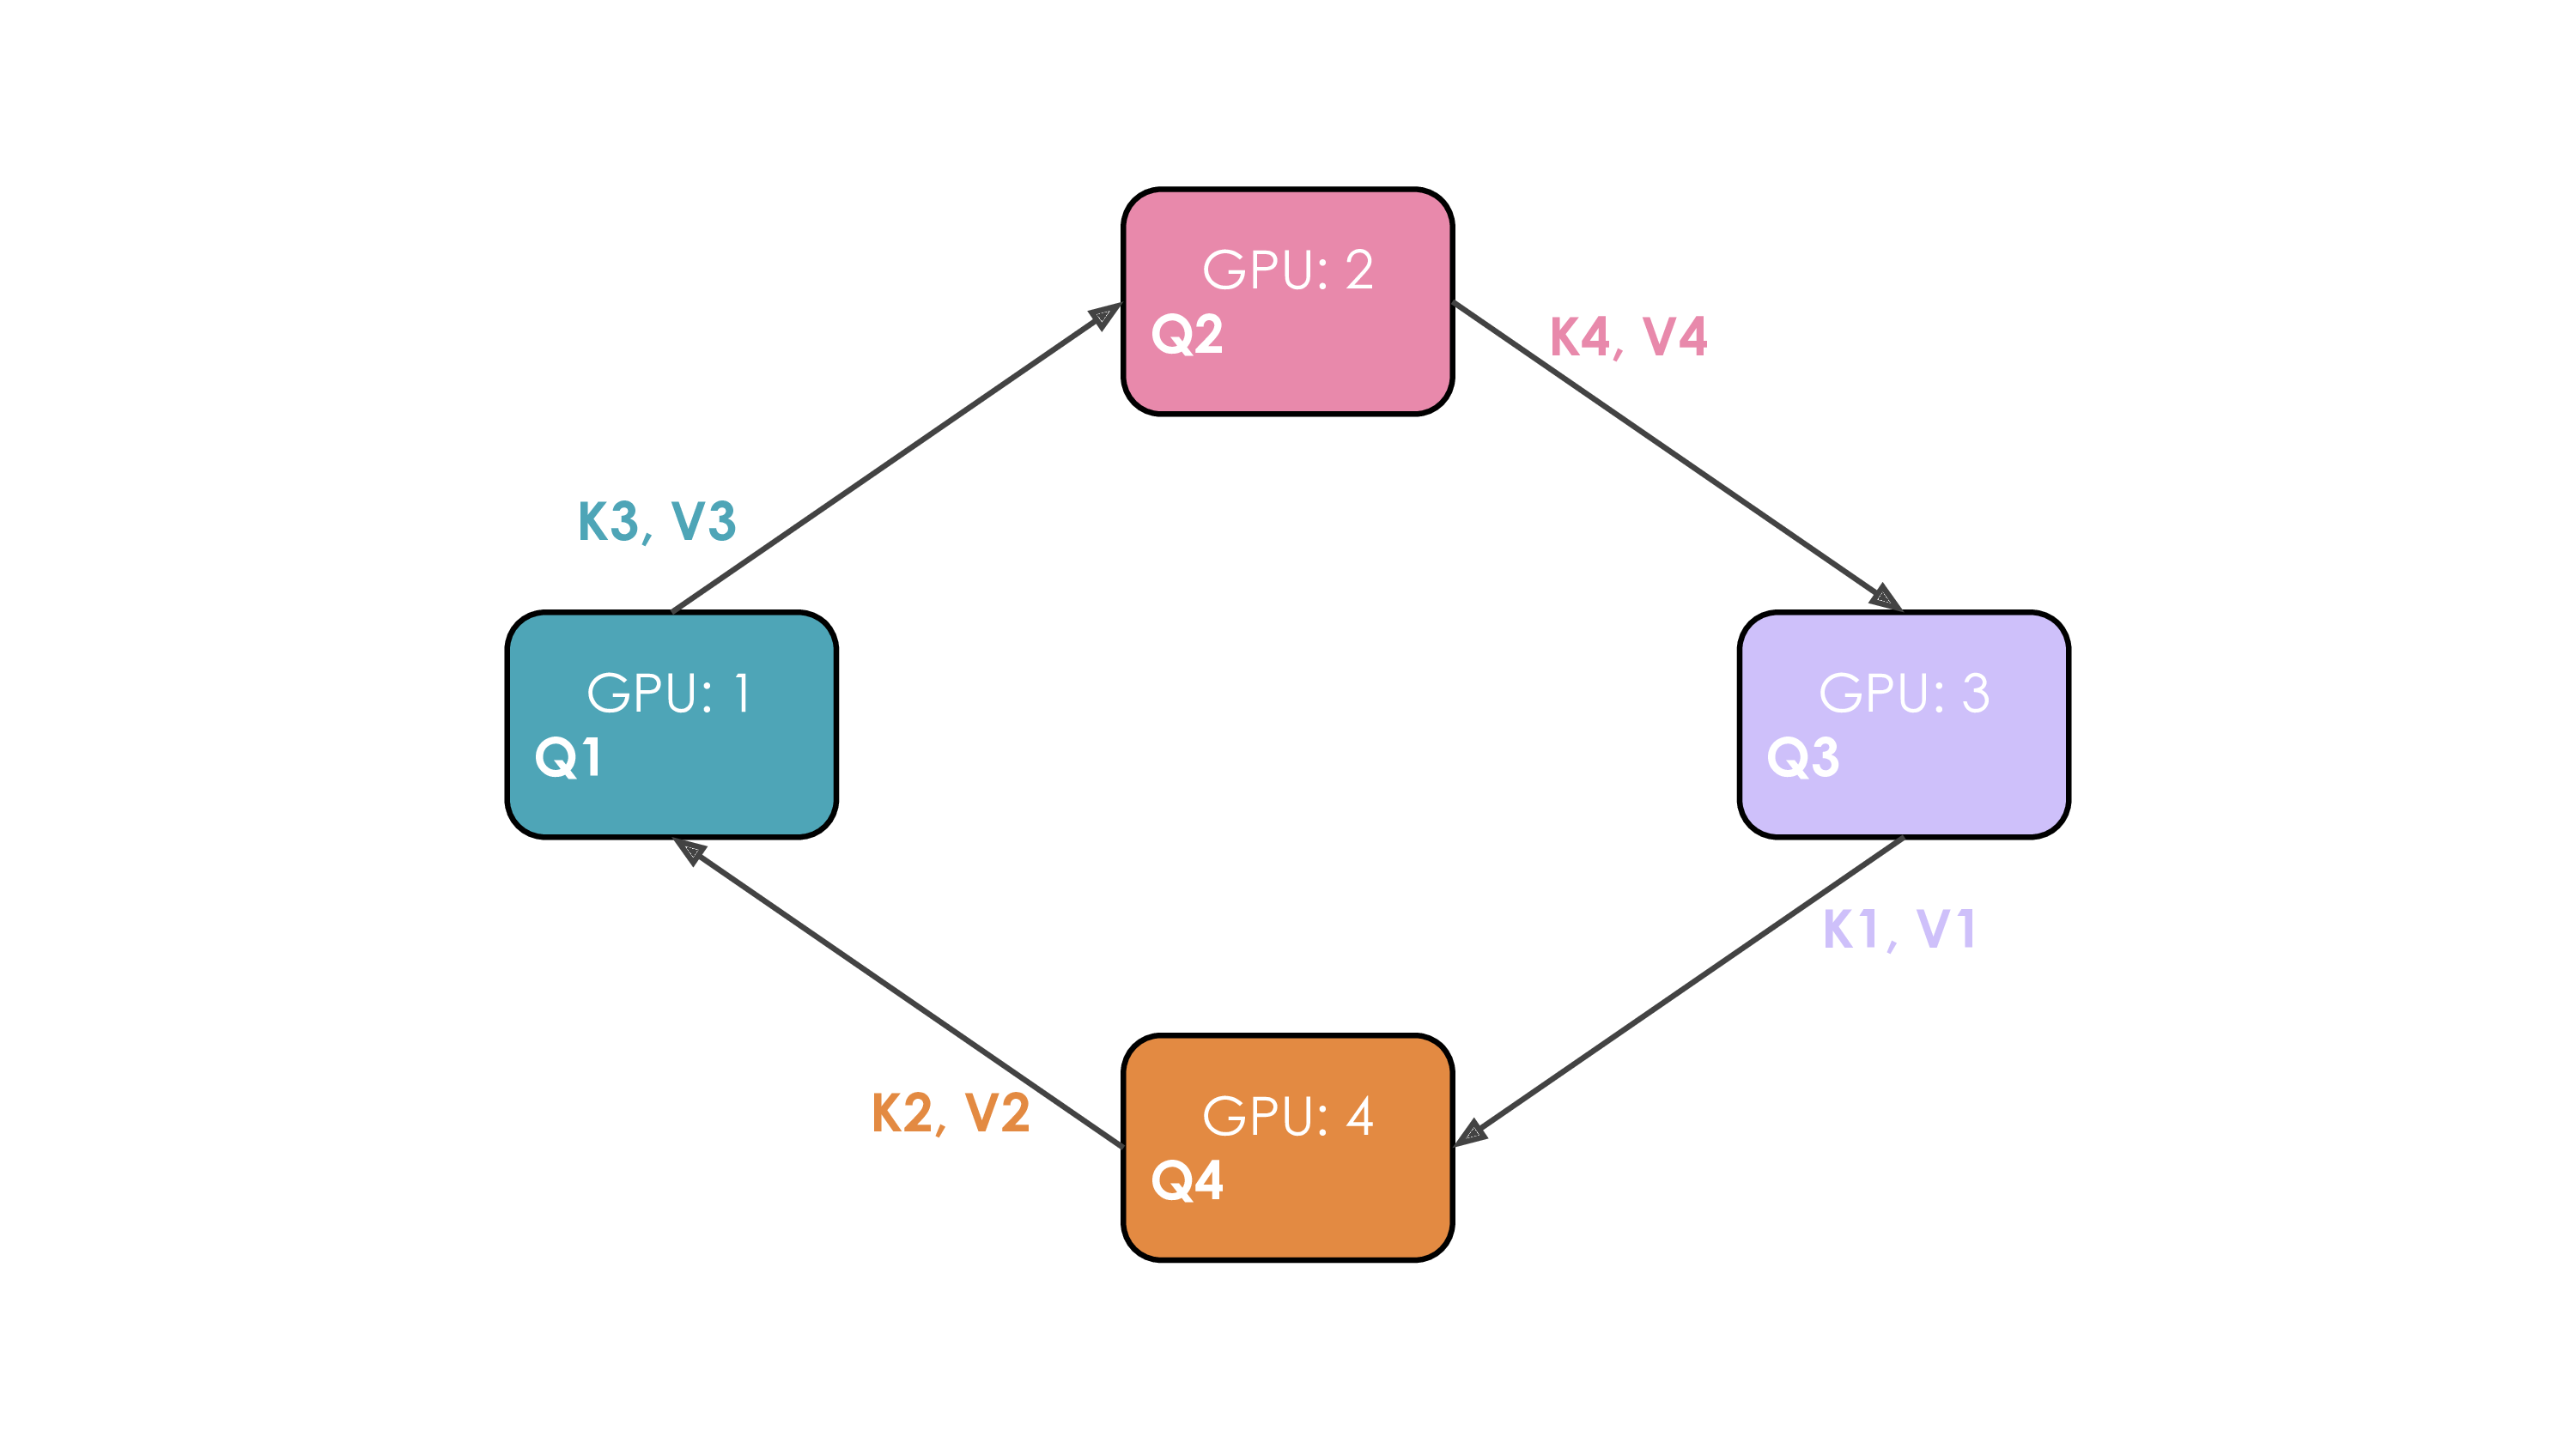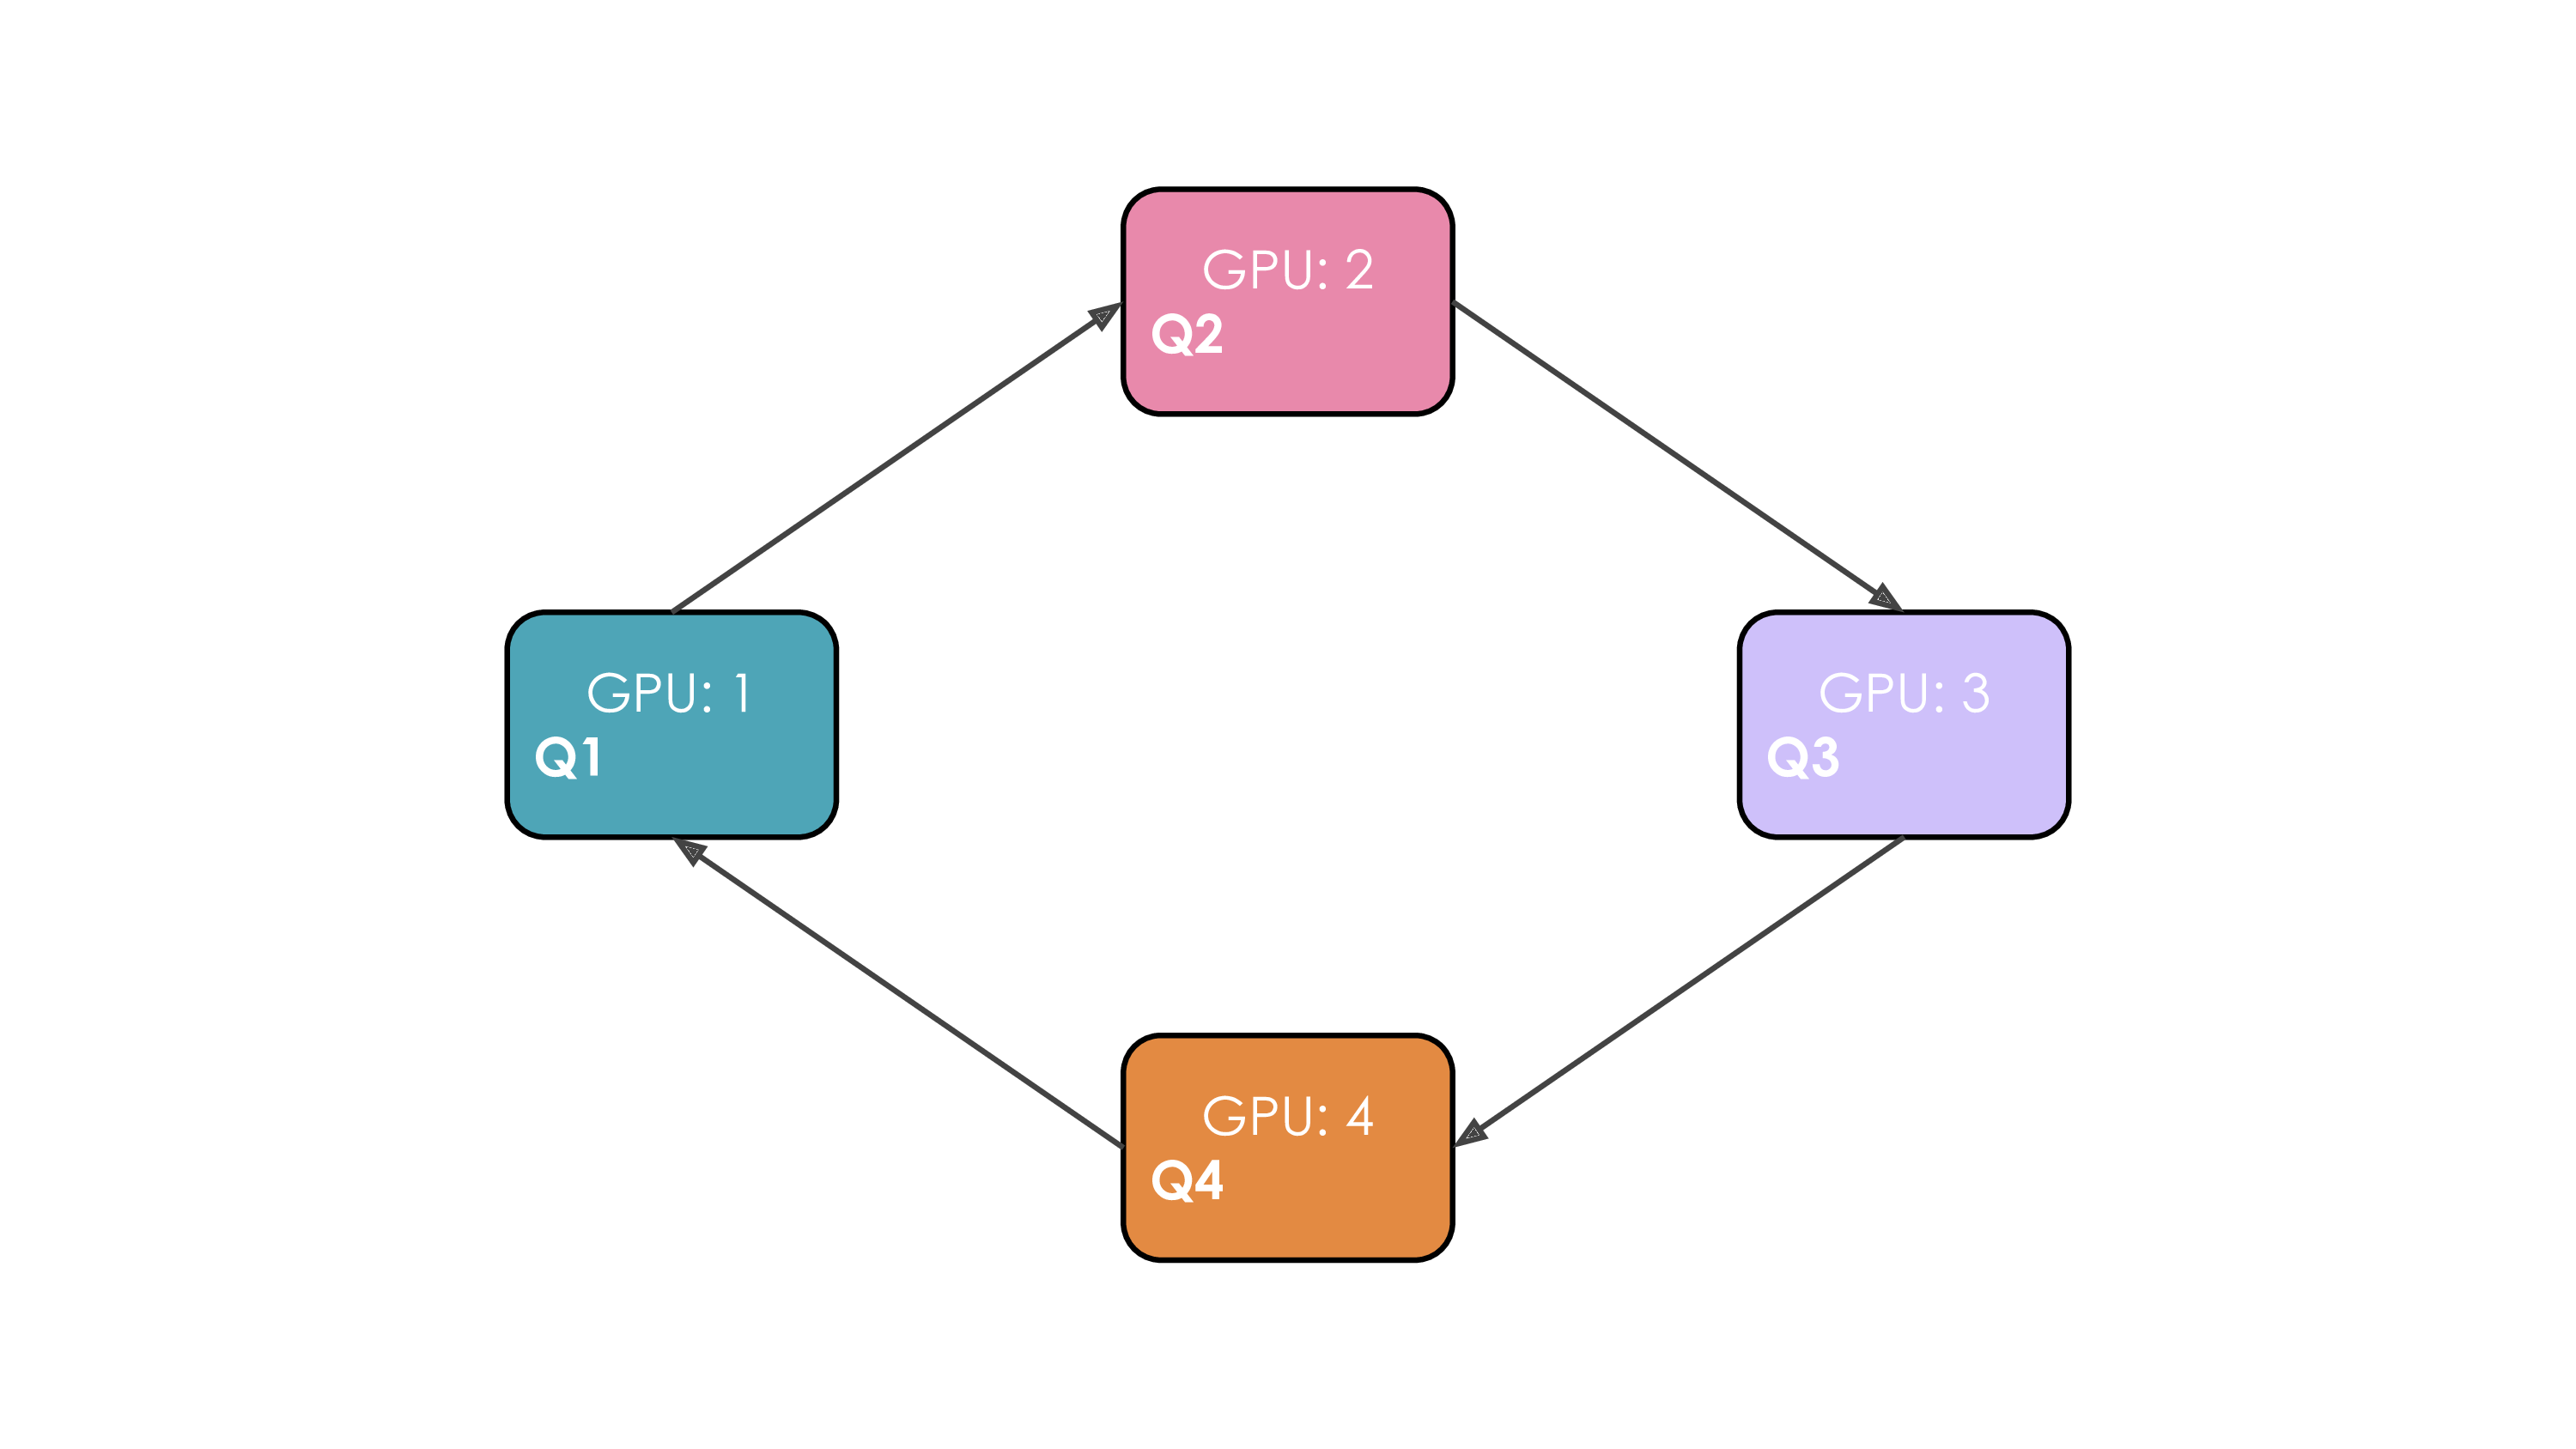
- K/V 不一次性 gather,而是在 GPU 之间按环形顺序流动
- 每个 GPU 一边接收 K/V,一边立刻算 attention 的一部分
- softmax 用 online 方式累计
-
一个更详细的流程如下
-
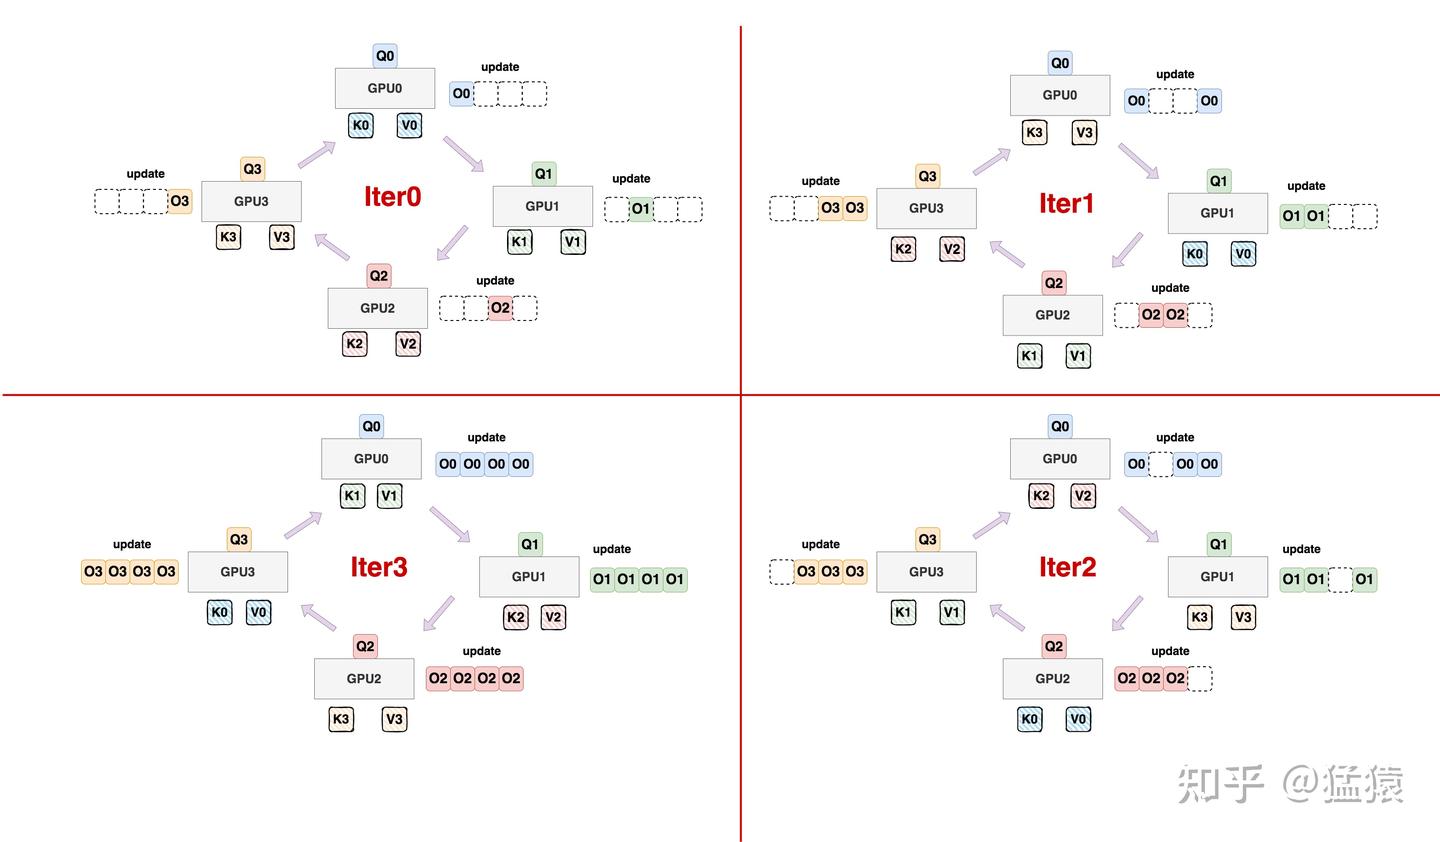
假设 4 张 GPU,序列长度 ,每张 GPU 上 1 个 token,GPU 初始持有
-
每一轮(总共 4 轮),每张 GPU 做三件事:
-
非阻塞地把当前的 发送给下一个 GPU
-
用当前持有的 计算局部 attention:
-
等待从上一个 GPU 接收到新的 ,进入下一轮
-
-
这样,每张 GPU 每一轮都会 “看到” 新的 token 的
-
4 轮之后,每个 都和所有 token 交互过,不需要任何时刻保存完整
-
这就是 “Ring” 的来源: 在 GPU 之间绕一圈
-
通过这种方式,当每张卡在做 attention 的过程中,它的显存占用是:
- 1 个 q block(2cd bytes)
- 1 个 k block + 1 个 v block,用于计算当前的 attention(4cd bytes)
- 1 个 k block + 1 个 v block,来自环状通讯拓扑中的前一张卡(4cd bytes)
- 1 个 o block,用于存储和更新最终 output(2cd bytes)
-
“ring attention 其实约等于分布式版本的 flash attention 2” 了:
- 在 Flash Attention V2 中,外层循环(Q 分块)和内层循环(KV 分块)都在单张卡上完成
- 在 Ring Attention 中,外层循环(Q 分块)首先被分配到多张卡上,然后内层循环(KV 分块)通过环状通讯拓扑轮流发送到各卡进行计算
- 每个 Q 分块更新对应 O 分块的方法,与 Flash Attention V2 基本一致
-
为了能够使计算时间覆盖传输时间,需要让传输时间 <= 计算时间,要做到这一点,需要根据所使用的卡的配置,设计好最优的分块大小,也就是 C(Chunk Size),用于表示一个分块中包含多长的序列
-
假设:
- 硬件(例如单张 GPU)的算力上限是 ,它表示这个硬件倾尽全力每秒所能完成的浮点运算量,单位是 FLOPS 或者 FLOP/s
- 硬件的带宽上限是 ,它表示这个硬件倾尽全力每秒所能完成的内存交换量,单位是 Byte/s
-
接下来为了表达简便,在做各种指标计算时忽略掉
batch_size维度 -
在单卡上当对某个 QKV chunk 计算 attention 时,有:
- ,因此 Attention score 的计算量为 FLOPs
- ,因此 score*V 的计算量为 FLOPs
- 总结来看,单卡 chunk 在计算 attention 时的总计算量为 FLOPs
-
假设用 bf16/fp16 进行训练,则传输的 KV 数据量大小(单位 bytes)为:
- K chunk 大小 bytes
- V chunk 大小为 bytes
- 总结来看,每次传输的 KV 数据量大小为 bytes
-
基于【传输时间 <= 计算时间】的基本要求,有:
-
进一步有:
-
也即可以根据硬件的 和 ,来计算最优的切块大小
-
在上文统计计算量的过程中,并没有把数据过 的计算过程、数据过 的计算过程包括进去,而是只侧重于 attention score 部分的计算量
-
因为这些计算过程不涉及通讯,只是单纯增加计算量而已
-
同时,在排除掉这些计算过程的情况下,对 的要求其实是更严格了(想想现在只允许 在 attn score 的计算时间内通讯完毕,而不排除的情况下允许 在 proj + attn + proj 的计算时间内通讯),所以这并不会影响到上面对最优 的求解
4D 并行
-
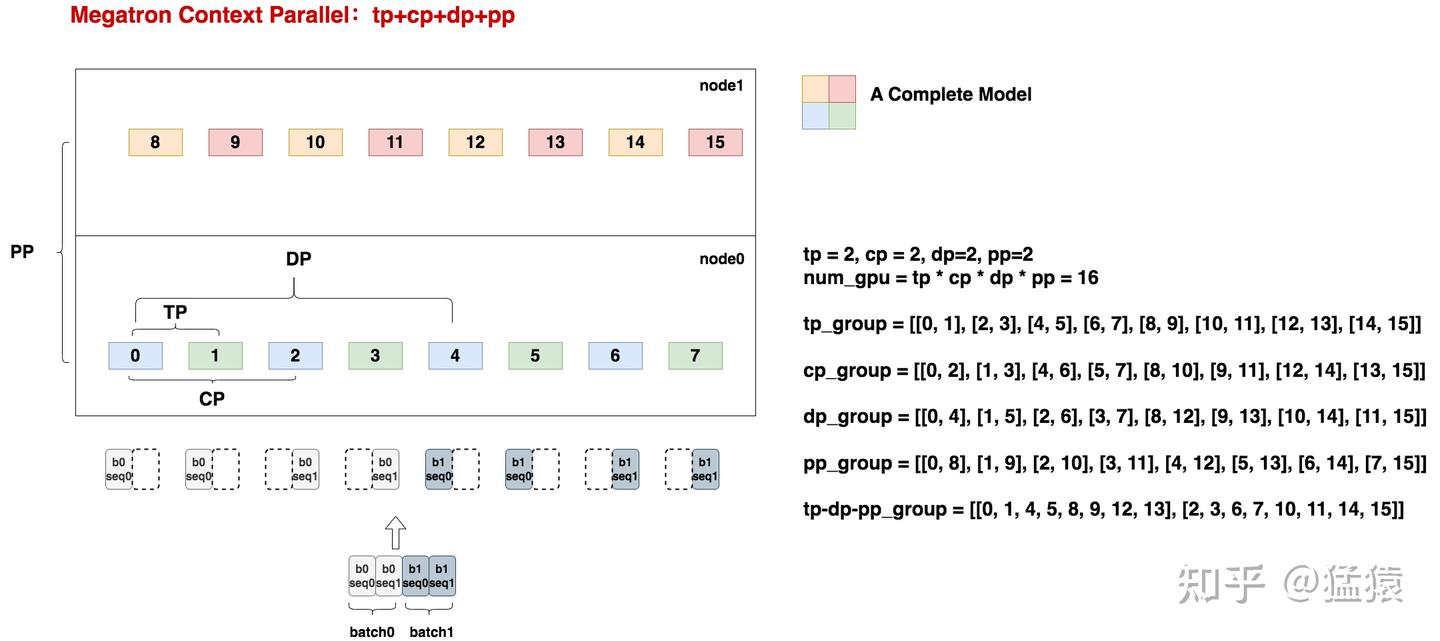
4D 并行示意图
-
并行维度与 GPU 数量计算
-
并行维度配置:
tp = 2,cp = 2,dp = 2,pp = 2 -
总 GPU 数量:
-
若单台机器配备 8 张 GPU,则需要 2 台机器完成部署
-
通常不考虑
ep(专家并行)维度(即ep = 1),因为它本质上不影响cp维度的并行(cp是对 attention 的优化,ep可理解为 MLP 层的操作)
-
-
并行组设置原则
- 并行组优先级顺序:
tp-cp-ep-dp-pp - 核心考量:越靠前的并行组,通讯量越大,所以应尽量安排在同一台机器内
- 例如
tp组,其每个子组关联的 2 张卡都位于同一台机器中 tp-cp-ep-dp-pp是 Megatron 代码的默认顺序,可根据实际情况修改,但必须优先考虑通讯量
- 例如
- 并行组优先级顺序:
-
数据与序列切分
- 由于
dp = 2,数据被划分为 2 个 micro-batch:batch0和batch1 - 由于
cp = 2,每个 batch 又在序列(seq)维度上被切分成两份:seq_chunk0和seq_chunk1
- 由于
-
在上述条件下,可以清晰地看到每个 GPU 在不同并行组中的角色,以
gpu0为例:- 模型切分:
- 模型沿 layer 层被横向切分成 2 份(
pp = 2) - 模型权重沿列被纵向切分成 2 份(
tp = 2) - 在图中,4 个不同颜色的色块共同组成了一个完整的模型
- 模型沿 layer 层被横向切分成 2 份(
- 并行组关系:
- MP 组(模型并行):
[0, 1, 8, 9]组成一个 MP 组,共同维护一个完整的模型副本 - TP 组(张量并行):
[0, 1]组成 TP 组,它们会接收相同的输入 X,并分别计算不同注意力头(head)的结果 - PP 组(流水线并行):
[0, 8]组成 PP 组,GPU0 和 GPU8 之间会进行层间激活值的传递 - CP 组(上下文并行):
[0, 2]组成 CP 组,它们维护着相同的模型权重,但分别处理同一个 batch 的不同序列块(seq_chunk0和seq_chunk1) - DP 组(数据并行):
[0, 4]组成 DP 组,它们维护着相同的模型权重,但分别处理不同 batch 的相同序列块(batch0的seq_chunk0)
- MP 组(模型并行):
- 模型切分:
-
从整体视角看,16 张 GPU 被划分到以下并行组中:
tp_group = [[0, 1], [2, 3], [4, 5], [6, 7], [8, 9], [10, 11], [12, 13], [14, 15]]cp_group = [[0, 2], [1, 3], [4, 6], [5, 7], [8, 10], [9, 11], [12, 14], [13, 15]]dp_group = [[0, 4], [1, 5], [2, 6], [3, 7], [8, 12], [9, 13], [10, 14], [11, 15]]pp_group = [[0, 8], [1, 9], [2, 10], [3, 11], [4, 12], [5, 13], [6, 14], [7, 15]]tp-dp-pp_group = [[0, 1, 4, 5, 8, 9, 12, 13], [2, 3, 6, 7, 10, 11, 14, 15]]
-
引入 Megatron CP 的核心逻辑可以概括为以下两点:
- 基准假设:先假设不对输入
X做任何序列维度的切分,此时得到的是原始的tp-dp-pp并行配置。 - CP 扩展:引入 CP 意味着需要将输入
X切分成cp_size份。因此,只需要将原始的tp-dp-pp组拷贝cp_size份,就得到了最终的分布式配置
- 基准假设:先假设不对输入
-
CP 组的成员是从
tp-dp-pp组中,按相同的local rank位置抽取出来的:- 在
tp-dp-pp组中,所有local rank = 0的 GPU 组成一个 CP 组 - 所有
local rank = 1的 GPU 组成另一个 CP 组,以此类推 - 例如,在之前的例子中,
0和2是各自tp-dp-pp组内的local rank = 0元素,因此它们组成一个 CP 组;1和3是各自组内的local rank = 1元素,因此它们组成另一个 CP 组
- 在
-
模型权重与数据维护:
- 同一个
cp_group内的所有 GPU 维护着 相同的模型权重 - 它们维护着 相同 batch 的不同序列块(seq_chunk)
- 同一个
-
最终目标:
- 一个 CP 组的最终目标是通过 ring attention 的方式,计算出自己所维护的这个
seq_chunk在自己所负责的这个 head 上的结果
- 一个 CP 组的最终目标是通过 ring attention 的方式,计算出自己所维护的这个
Zig-Zag Ring Attention
-
在 casual attention 中,Ring Attention 存在严重的负载不均衡
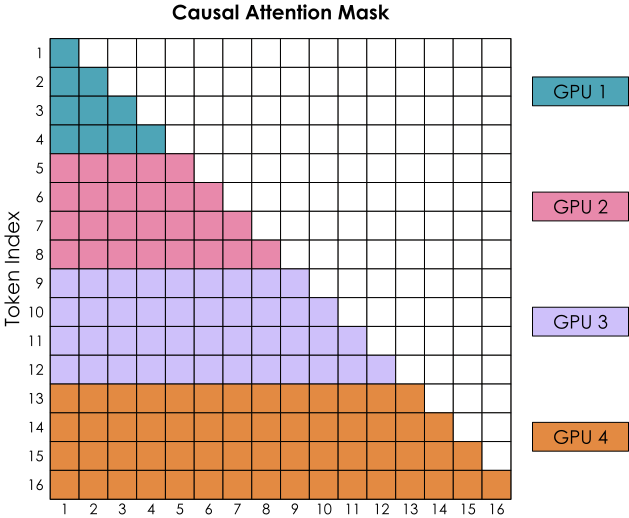
- 因果注意力的 mask 是下三角矩阵,token 只能看
- 而 softmax 是按行算的,因此一行只要 “所需的 K/V 都到了”,这一行就可以立刻算完,不需要等完整一圈,于是不同 GPU 的 “等待条件” 完全不同
- 如图中所示:GPU 1 很快空闲,GPU 2 少量工作,GPU 3、4 成为瓶颈,整体吞吐被最慢的 GPU 决定
-
前面提到过,分块 attention 的计算其实是和计算顺序无关的,核心是只要每次计算时都能拿到当前分块的 output,当前未做 softmax 前 attention score 矩阵的 max 和 sum 相关信息,就能正常更新最终的 output
-
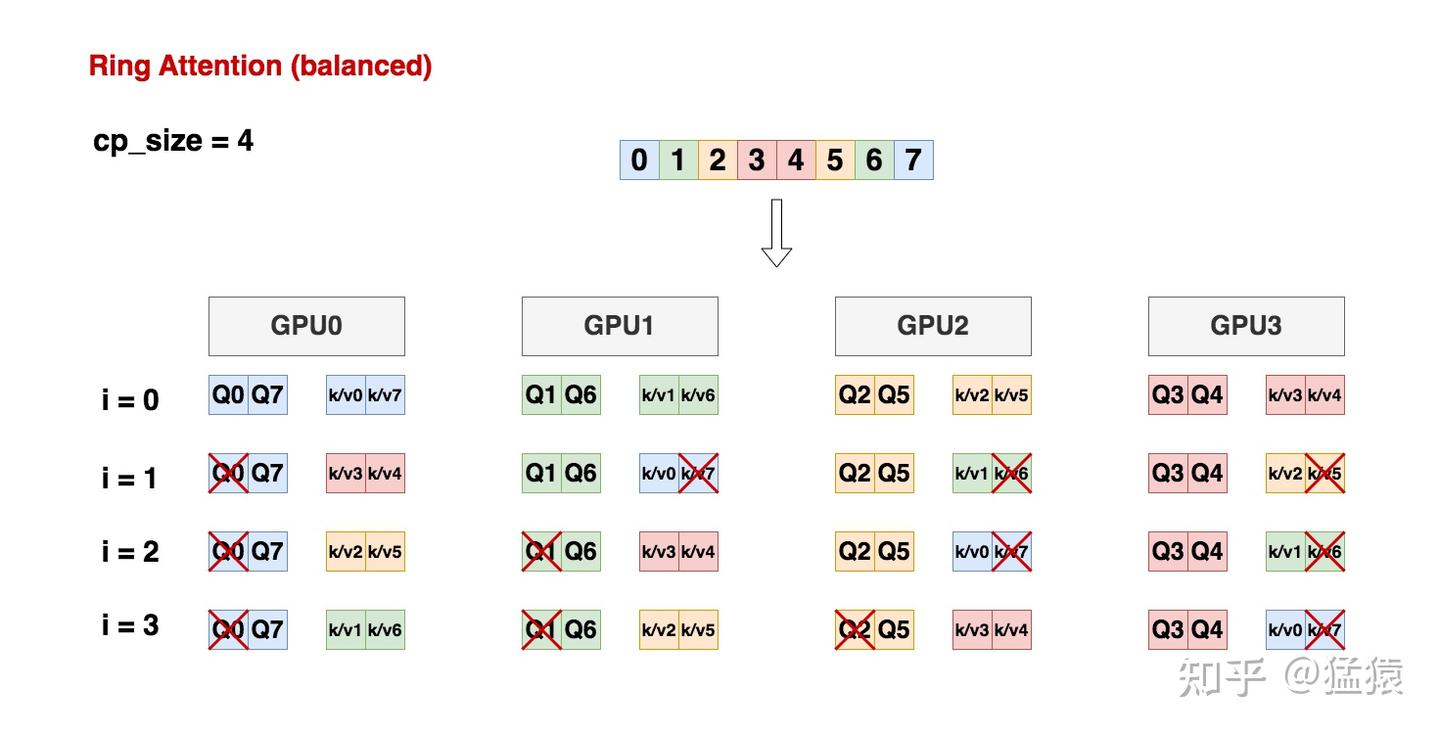
基于此,可以重新设计 Ring Attention 上每块卡中存放的 seq_chunk
-
假设上下文并行尺寸:
cp_size = 4(GPU0、GPU1、GPU2、GPU3 组成 CP 组)-
首先,原始输入数据
X被切分为2*cp_size = 8个序列块(记为 0~7) -
[0,7],[1, 6],[2, 5], [3, 4] 分别组成 4 个 seq_chunk,安放在 gpu0~gpu3 上
-
每张 GPU 需执行
cp_size次迭代计算(共 4 次),最终得到自身承载的 seq_chunk 对应的完整注意力计算结果(如 GPU0 最终输出 [0,7] 序列块的 attention 结果) -
以
rank表示 CP 组内 GPU 的序号(如 GPU0 的rank=0、GPU1 的rank=1),不同轮次i与rank的大小关系,决定了该 GPU 参与计算的 QKV 模块范围,具体规则如下:迭代轮次 i与rank的关系计算排除规则 i = 0无排除,所有 QKV 参与计算 i ≤ rank第 2 个 KV 块不参与计算 i > rank第 1 个 Q 块不参与计算
-
-
Megatron CP 的核心思想
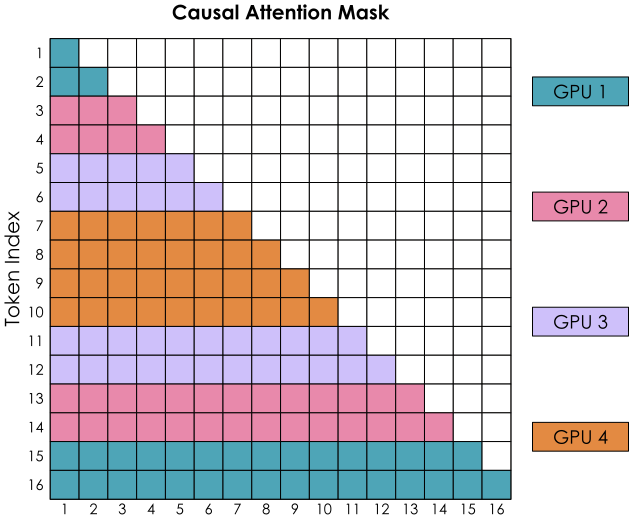
- Zig-Zag 的目标是在不破坏 Ring Attention 的通信结构,不引入全量 K/V 存储,不牺牲 online softmax 的前提下,让每张 GPU 的计算量接近一致
- causal attention 的计算量取决于 token 在序列中的 “相对位置”,越靠前的 token,可见的 key 越少,而越靠后的 token,可见的 key 越多
- Zig-Zag 的做法是不按 token 的自然顺序分配到 GPU,而是 “前后交错” 地分配
- 每张 GPU 同时拿到一部分早期 token + 一部分晚期 token,平均下来,每张 GPU 需要算的 attention 行数和每行的长度都接近
- 这一步不改变 attention 的数学定义,只改变 token 到 GPU 的映射
-
每个 GPU 都需要从其他 GPU 那里获取信息
- 即使做了 Zig-Zag,每个 token 仍然可能需要 attend 到序列中任意更早的位置,而这些位置被分散在所有 GPU 上
- 所以不可避免地,每张 GPU 最终仍然需要来自所有其他 GPU 的 K/V 信息,区别只是 “什么时候拿、拿多少、怎么拿”
-
在标准的 Ring Attention 中,核心优化思路是:
- 让 GPU 在计算注意力(attn)的同时,将自身的 KV 发送给下一张卡,并从上一张卡接收新的 KV
- 这种方式实现了计算与通讯的并行,用计算时间掩盖通讯开销
-
在代码实现上,通常通过创建不同的 CUDA 流(
torch.cuda.Stream())来实现:- 一个 CUDA 流内部的操作是串行的
- 不同的 CUDA 流之间可以并行执行
- 因此,可以定义一个流专门用于计算,另一个流专门用于通讯
-
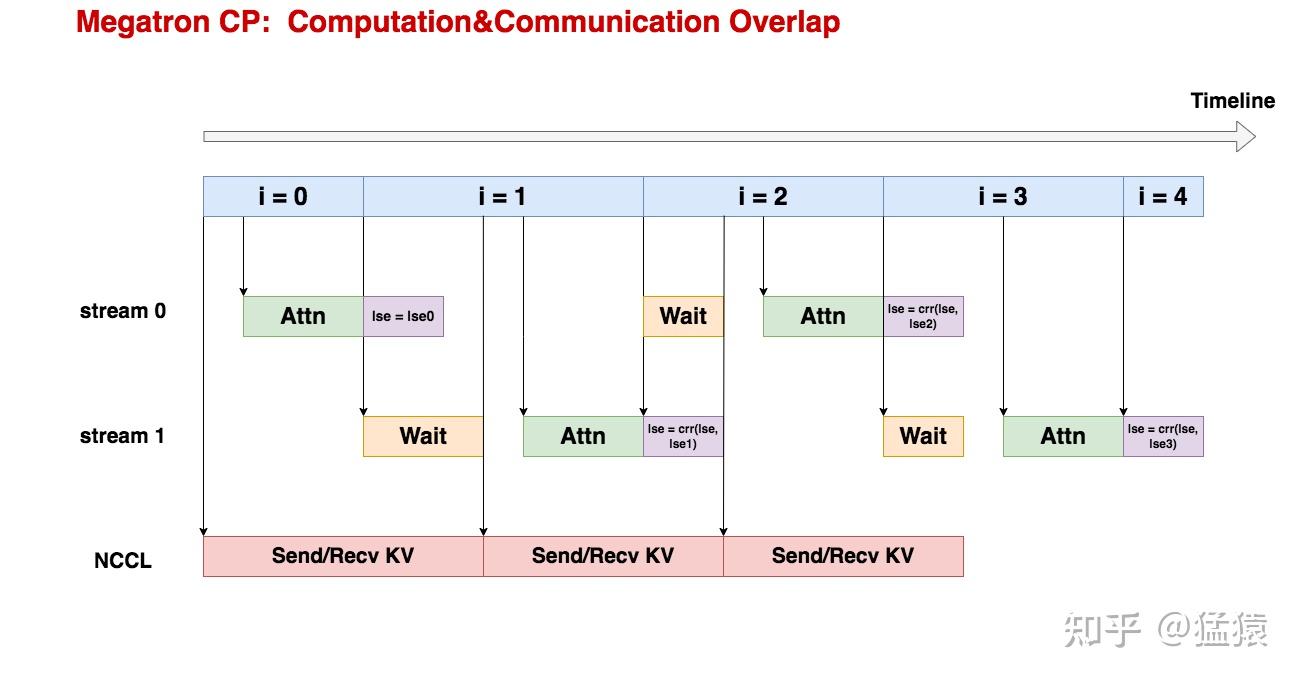
Megatron CP 在此基础上做了进一步优化,总共使用了 3 个 CUDA 流,实现了更细粒度的并行:
流名称 作用域 核心功能 NCCL stream cp_group内负责 KV 的发送和接收,是专门的通讯流 Stream0 计算侧 用于执行注意力(attn)计算 Stream1 计算侧 用于执行 softmax_lse 的更新 -
Megatron CP 的设计实现了双重并行:
- 计算与通讯并行:
NCCL stream与Stream0/Stream1并行执行,用计算时间掩盖通讯开销 - 计算内部并行:
Stream0(attn 计算)和Stream1(softmax_lse 更新)可以并行执行,进一步提升了计算效率
- 计算与通讯并行:
-
Zig-Zag Ring Attention 的通信与计算重叠
-
all-gather
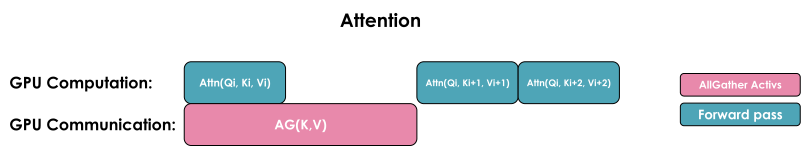
- 所有 GPU 同时执行一次 all-gather,每张 GPU 一次性拿到完整的 K/V
- 需要更多的临时内存,因为每块 GPU 需要一次性存储所有的 K/V 对
- 通信一步完成,但内存开销更大
-
all-to-all (Ring)
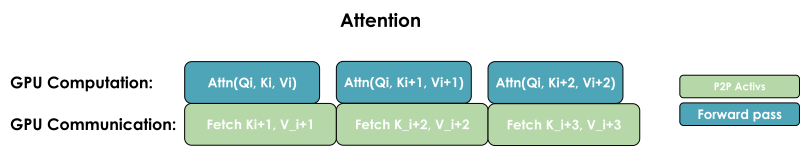
- K/V 以 chunk 为单位在 GPU 间按环流动
- 每张 GPU 每次只多拿一小块 K/V,拿到就立刻参与 attention 计算
- 通信与计算分散且重叠,但通信次数更多,每一轮有固定的基础通信开销,实现复杂度更高,因此更适合超长序列
-
Ulysses CP
- DeepSpeed Ulysses 借助 all-to-all 通信原语,借助 all-to-all 通信原语,在 Token 维度与 Attention Head 维度之间重排 hidden states
- 交互前:各 GPU 仅持有部分 Token 的完整头维度信息
- 交互后:各 GPU 持有所有 Token 的部分头维度信息,后续注意力计算类似张量并行
- 注意力输出计算后,需再次执行 all-to-all 将状态切回 Token 维度,以维持仅存储部分 Token 的状态,避免全量隐藏状态带来的内存开销
- 每个 GPU 初始拥有 的输入状态(即按 token 切分)
- 在进行注意力计算前,需要执行一次 all-to-all 以重排状态,使每个 GPU 拥有 的状态(即按 head 切分)
- 本质上是,每个 GPU 要把自己持有的 个 token 的所有 head 维度信息,按 head 维度切分成 块,每块大小为 ,然后把这 块数据分别发送给同组内的其他 GPU,同时自己也接收来自其他 GPU 的数据,最终每个 GPU 都能拿到所有 token 的 维度信息
- 对于单个特征(比如 Q),每个 GPU 发送量为 ,需要发送 块数据,因此总发送量为
- attn 之前,需要对 Q/K/V 三个特征都执行一次 all-to-all,因此总发送量为
- 注意力计算后,需要再次执行一次 all-to-all 将状态切回 Token 维度,因此总发送量再增加
- 最终总发送量为
- 相比普通的 TPSP,其需要进行两次 all-gather 和两次 reduce-scatter,通信量为 ,当 时,Ulysses CP 的通信量为 TPSP 的 ,大幅降低了通信开销
- Ulysses 的弊端是,head size 必须能够同时被 和 整除,否则无法实现 head 维度的切分和重排
USP
- USP: A Unified Sequence Parallelism Approach for Long Context Generative AI 是一种结合了 Ring Attention 和 Ulysses CP 思想的上下文并行方法
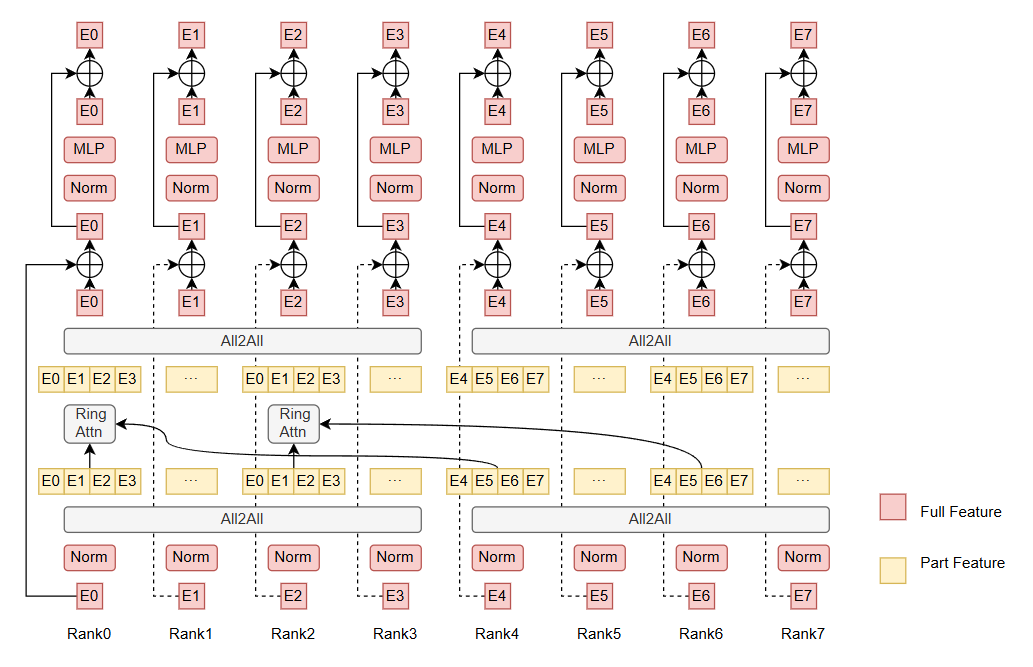
- 类似地,Megatron CP 支持三种模式
- all_gather 是最直接的实现 —— 每张卡在计算前把所有卡的 KV AllGather 到本地,凑出完整序列再跑标准 FA,实现最简单,但每张卡需要在显存里存放完整序列的 KV,显存开销随 cp_size 线性放大,长序列场景下不可接受
- p2p 是 Ring Attention 的标准形式 —— 每步只通过 P2P 传递相邻卡的一个 KV 块,显存开销固定,是长序列训练的主力方案
- a2a+p2p 是分层 CP 场景下的混合策略,节点内走 All-to-All,节点间走 P2P,两级通信分别匹配物理拓扑的带宽特征