并行策略总结
介绍各种并行策略的基本概念、实现方法以及在 PyTorch 中的使用方法
并行策略总结
总览
- 迄今为止,一共有五种用于扩展模型训练的并行策略,分别对应模型或数据的不同维度:
- 数据并行(Data Parallelism, DP):沿 batch 维度切分
- 张量并行(Tensor Parallelism, TP):沿隐藏维度切分
- 序列 / 上下文并行(Sequence / Context Parallelism, SP / CP):沿序列长度维度切分
- 流水线并行(Pipeline Parallelism, PP):沿模型深度(层)切分
- 专家并行(Expert Parallelism, EP):沿专家(MoE experts)维度切分
- 此外,还有三种可以与数据并行结合、用于降低显存占用的 ZeRO 策略:
- ZeRO-1:在 DP 副本之间切分优化器状态
- ZeRO-2:在 DP 副本之间切分优化器状态和梯度
- ZeRO-3:在 DP 副本之间切分优化器状态、梯度和参数
- 一个自然的问题是:这些并行方式和 ZeRO 策略之间,哪些可以高效组合,哪些组合起来收益有限甚至不划算?
流水线并行与 ZeRO-3 的对比
-
相似点
- 两者都将模型参数分布在多张 GPU 上
- 都沿模型深度方向进行通信与计算
- 在每个设备上执行的是 “完整层级” 的计算,而不是子层计算(不同于 TP 或 EP 那样对单层进行切分)
- 这里说的 “一层” 只是为了简化描述,实际的切分单位可以是多层、单层,甚至层的一部分,取决于具体实现
-
可以从以下几个方面理解两者的不同:
ZeRO-3 Pipeline Parallelism (PP) 存储单位 每个计算单元只存储层的一部分参数 每个计算单元存储完整的一层(或若干层) 通信内容 权重参数(weights) 激活值(activations) 调度特性 模型无关(model-agnostic) 模型无关(model-agnostic) 实现难点 复杂:需要处理模型切分、参数预取与释放 复杂:需要设计高效的流水线调度以减少空泡 扩展偏好 偏好大 micro-batch size(mbs)和长序列长度(seq_len),以隐藏通信开销 偏好大梯度累积步数(grad_acc)以隐藏流水线空泡 每个设备计算粒度 子层级或参数分片 整层或多层 目标 降低单节点显存占用,通过切分参数、梯度和优化器状态 提高训练吞吐量,通过流水线并行覆盖层级计算 是否常组合 可与 PP 组合,但需显著增加全局 batch size 可与 ZeRO-1/2 组合;与 ZeRO-3 组合较少,成本高 -
是否需要组合 PP 和 ZeRO-3
- 理论上,PP 和 ZeRO-3 是可以组合的,但实践中并不常见,原因在于:
- 组合后需要显著增大全局 batch size 才能摊薄通信成本
- 这会引入在 batch size、模型规模、网络带宽和训练效率之间的权衡
- 如果确实要组合使用,通常需要让 ZeRO-3 在多个 PP micro-batch 期间尽量保持权重常驻显存,以减少不必要的重复通信
- 相比之下,ZeRO-1 和 ZeRO-2 只涉及优化器状态和梯度,它们与 PP 的组合非常自然,几乎没有新的工程复杂度
- 例如,DeepSeek-V3 的训练就采用了 PP + ZeRO-1
- 理论上,PP 和 ZeRO-3 是可以组合的,但实践中并不常见,原因在于:
TP / SP 与 PP、ZeRO 的互补关系
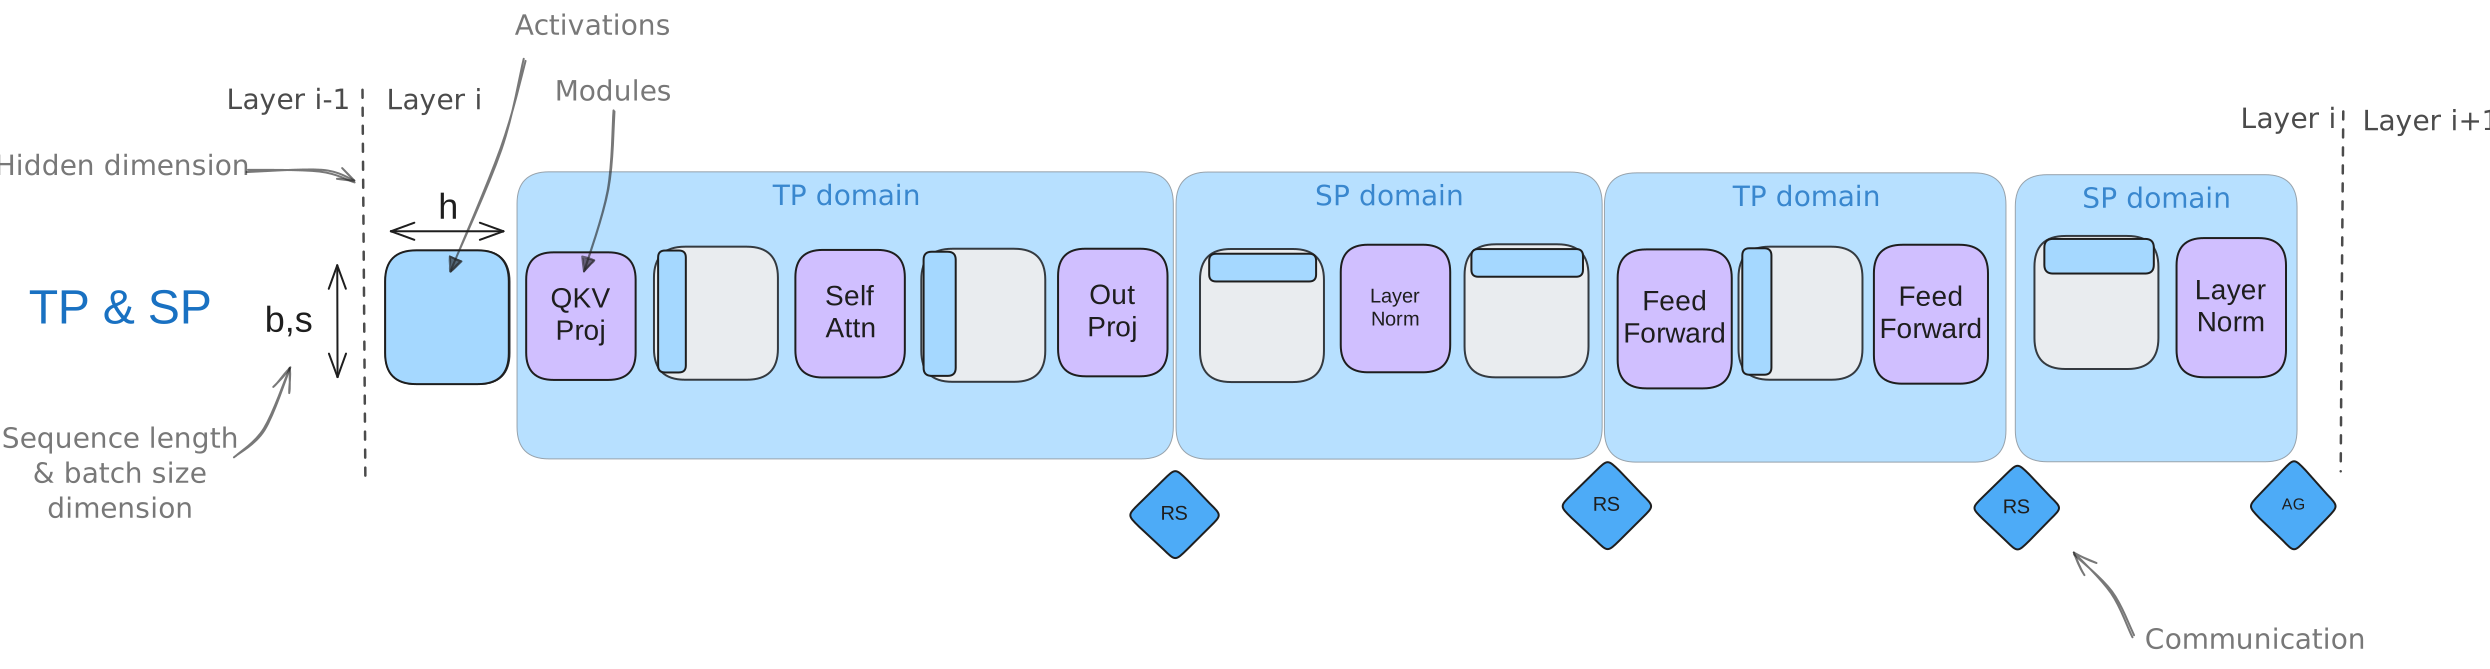
- 张量并行(TP)通常与序列并行(SP)一起使用,并且可以自然地与 PP 或 ZeRO-3 组合
- 原因在于 TP 利用了矩阵乘法的可分配性,权重和激活可以被切分后分别计算,再通过通信聚合结果
- 实践中,TP 单独扩展存在两个主要限制:
- 通信处于计算关键路径上,规模扩大到一定程度后,通信会主导整体时间
- TP 不是模型无关的,需要非常仔细地处理激活切分方式
- 有些地方沿隐藏维度切分(TP 区域)
- 有些地方沿序列维度切分(SP 区域)
- 这使得 TP 的实现对模型结构高度敏感,工程复杂度较高
- 因此,实际中的组合策略是:
- TP 主要用于节点内(intra-node)的高速通信
- PP 或 ZeRO-3 用于跨节点(inter-node)的并行
- PP:通信带宽需求相对较低
- ZeRO-3:通信更容易与计算重叠
- 设计重点在于:
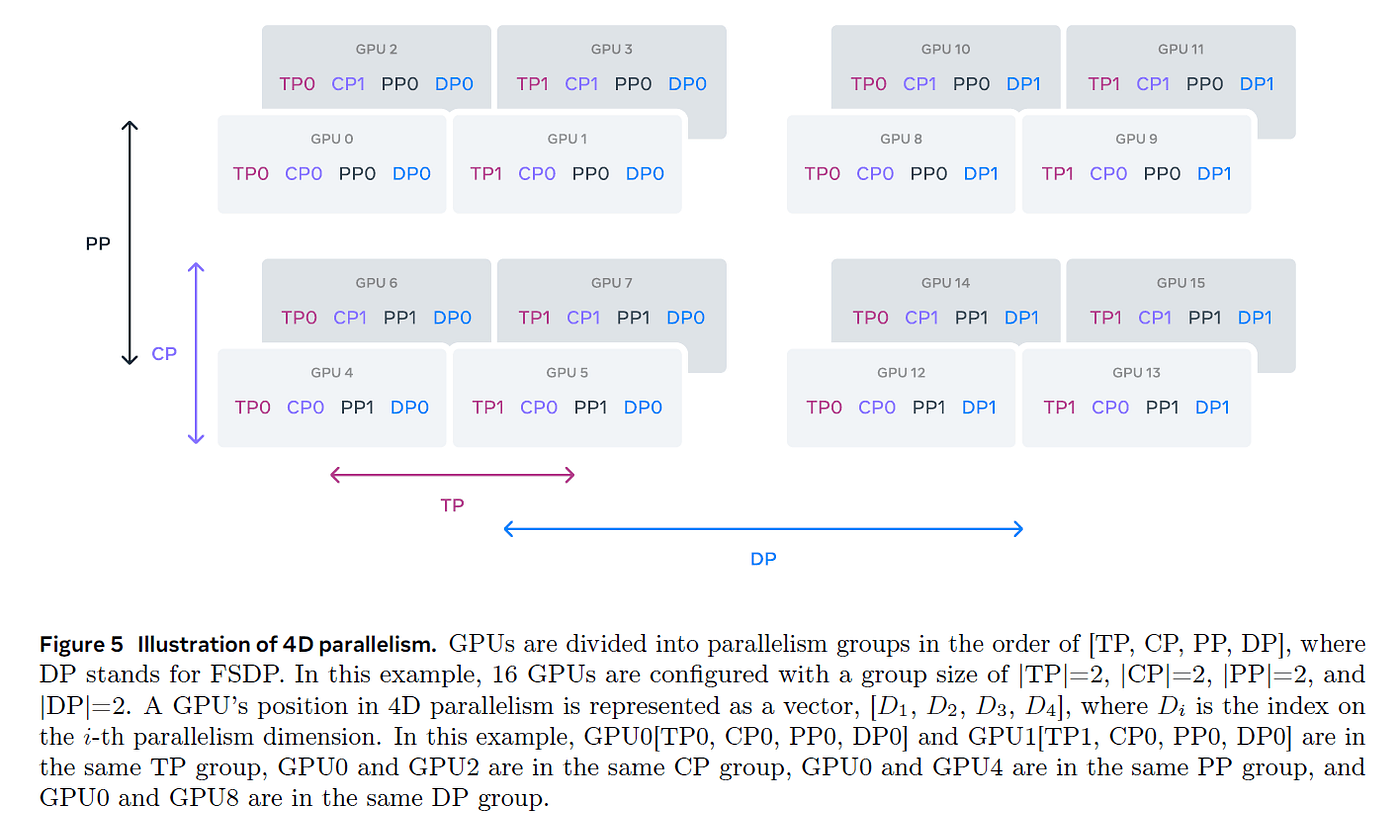
- 合理划分 GPU 分组
- 让 TP 通信尽量限制在单节点内
- 同时避免 TP 的扩展瓶颈
CP 和 EP
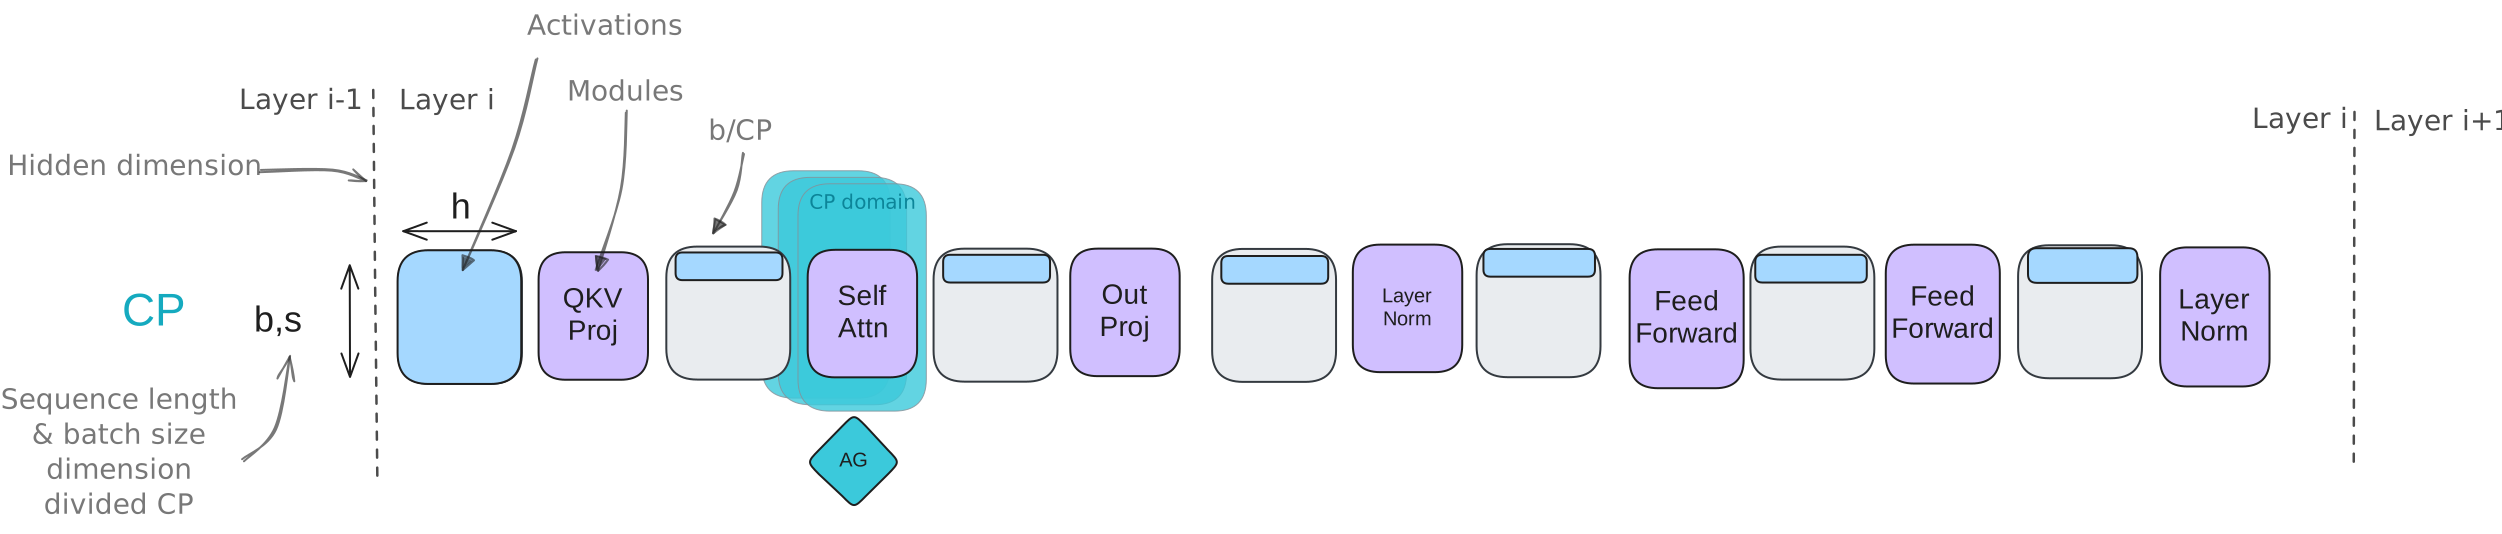
- CP 的目标是解决超长序列训练的问题,通过在序列维度上切分激活:
- MLP、LayerNorm 等模块可以直接在分片序列上独立计算
- 注意力层需要通信,因为每个 token 都需要访问全序列的 key /value
- 这一问题通过 Ring Attention 等通信模式解决,使通信与计算尽量重叠
- CP 在以下场景尤其关键:
- 序列长度达到 token
- 即使使用全量激活重计算,单卡显存仍无法容纳注意力中间状态
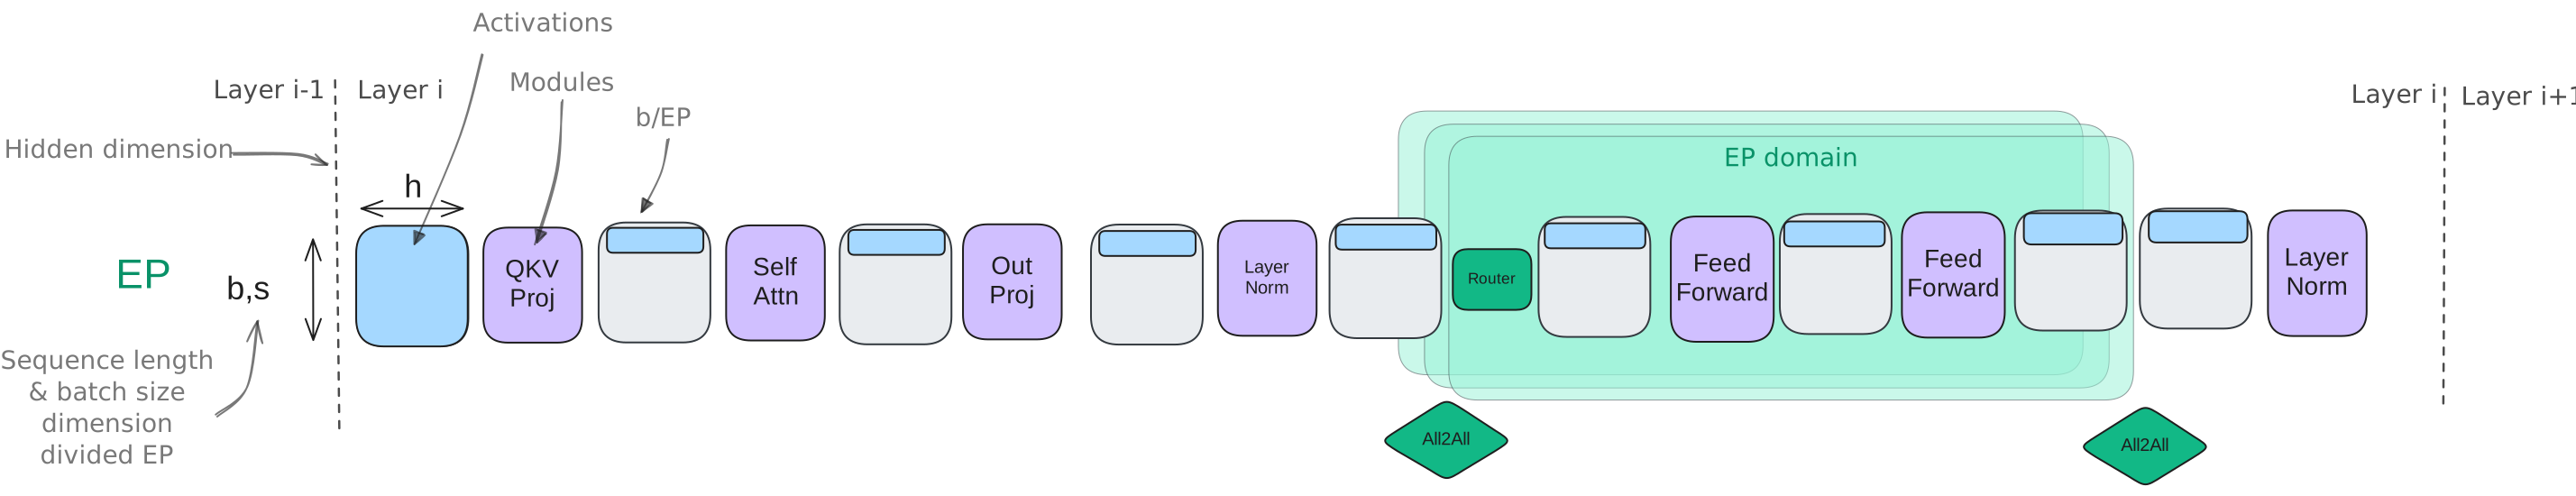
- EP 专门用于 MoE 模型训练,通过:
- 将不同专家分布在不同 GPU 上
- 在计算时将 token 动态路由到对应专家
- 再将结果聚合回原计算流
- 其主要通信开销来自 all-to-all 操作(token 分发与回收)
- 但 EP 带来的好处是每个 token 只经过全部参数中的一小部分,模型容量可以大幅提升,而计算成本增长相对可控
- 当专家数量非常大时(例如 DeepSeek-V3 使用了 256 个专家),EP 就变得尤为重要
- 由于在输入处理方式上,EP 与 DP 都涉及 token 在 GPU 之间的分发,一些实现中会将 EP 视为 DP 的一种变体:
- DP:所有 GPU 运行相同模型副本
- EP:GPU 上是不同专家,通过路由而非复制来处理输入
- 两者的关键差异在于是否存在 “专家专用结构”
作用范围
- 张量并行(TP)+ 序列并行(SP):影响整个模型的计算,通过切分权重和激活来实现分布式计算
- 上下文并行(CP):主要作用于 注意力层,因为跨序列通信只在注意力计算中需要,其他模块(如 MLP、LayerNorm)可以独立处理分片序列
- 专家并行(EP):主要作用于 MoE 层,注意力层和其他模块保持不变
- 流水线并行(PP)和 ZeRO:不局限于特定子模块,但 PP 中需要平衡模块和层的分配,第一层和最后一层通常会被特殊处理(例如额外的 embedding 层)
| 并行方式 | 作用对象 | 通信类型 | 实现特性 | 偏好 / 限制 |
|---|---|---|---|---|
| 张量 + 序列并行 | 整个模型的权重和激活 | 矩阵乘法操作(列 / 行线性变换) | 需要针对具体模型实现 | 偏好高速节点内通信(高带宽) |
| 上下文并行 | 注意力层的激活 | 注意力键 / 值的跨序列通信 | 除注意力外为模型无关 | 偏好超长序列训练 |
| 专家并行 | MoE 层的权重和激活 | token 路由到专家的通信 | 除 MoE 层外为模型无关 | 需要 MoE 层 |
总结
- 单一 Transformer Block(MoE 变体)的激活和模块图示
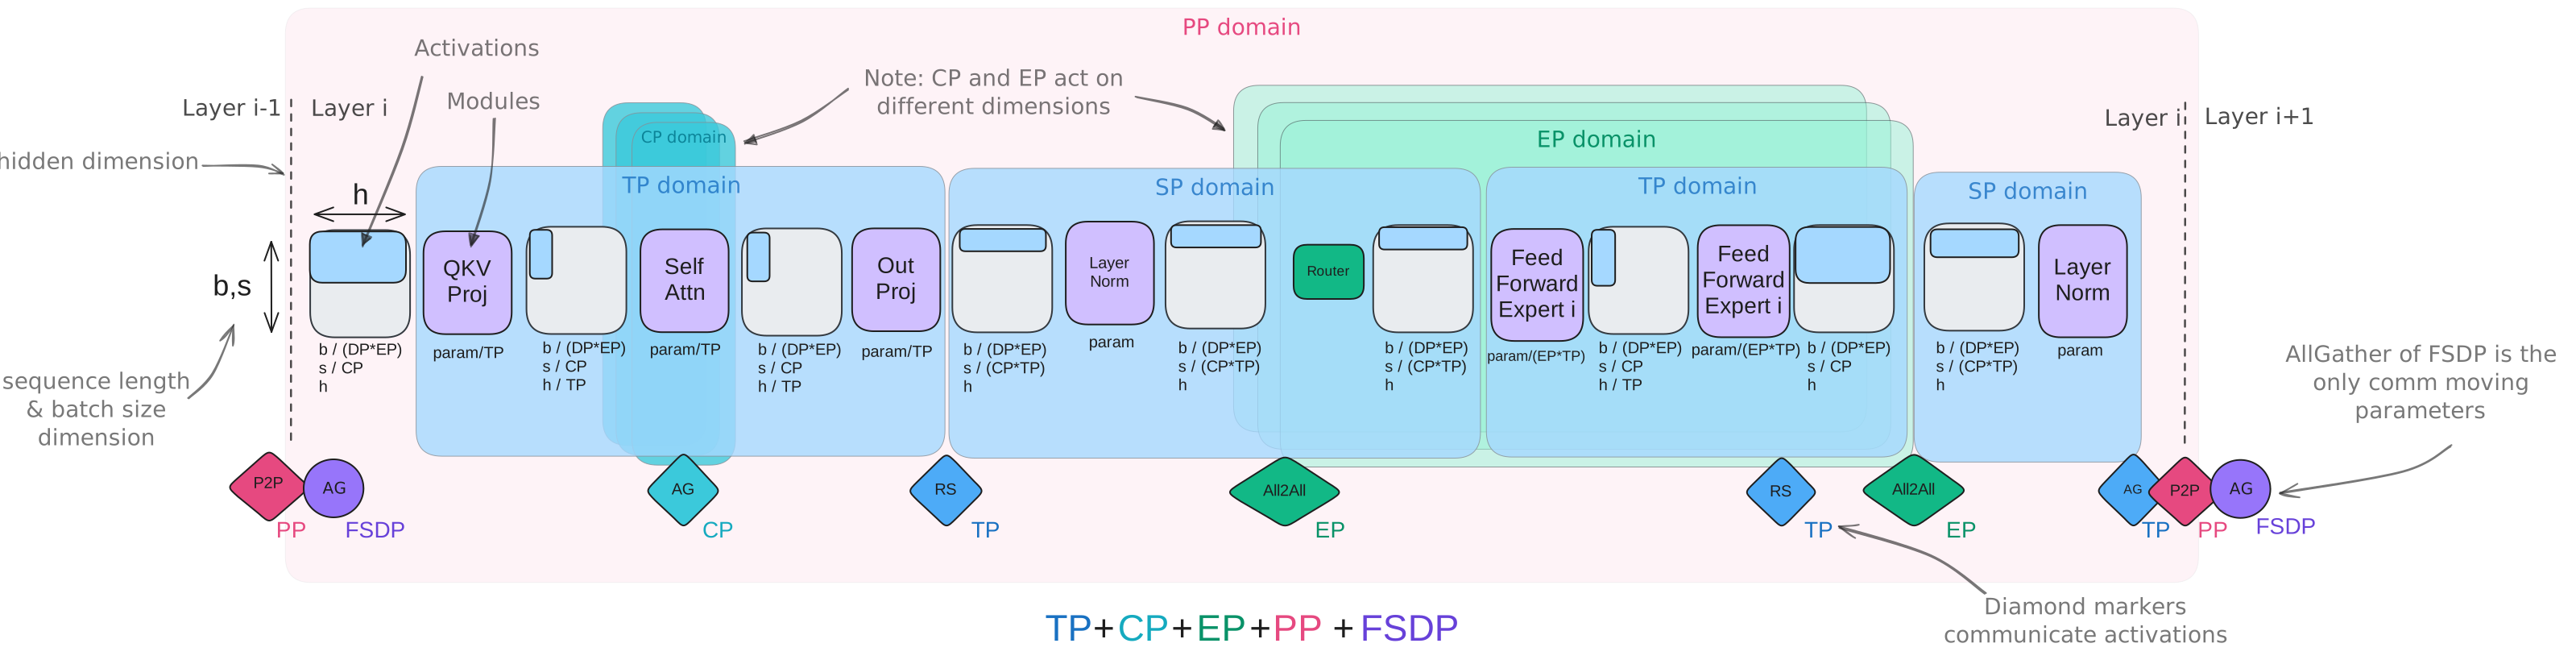
- 每种策略的内存节省情况
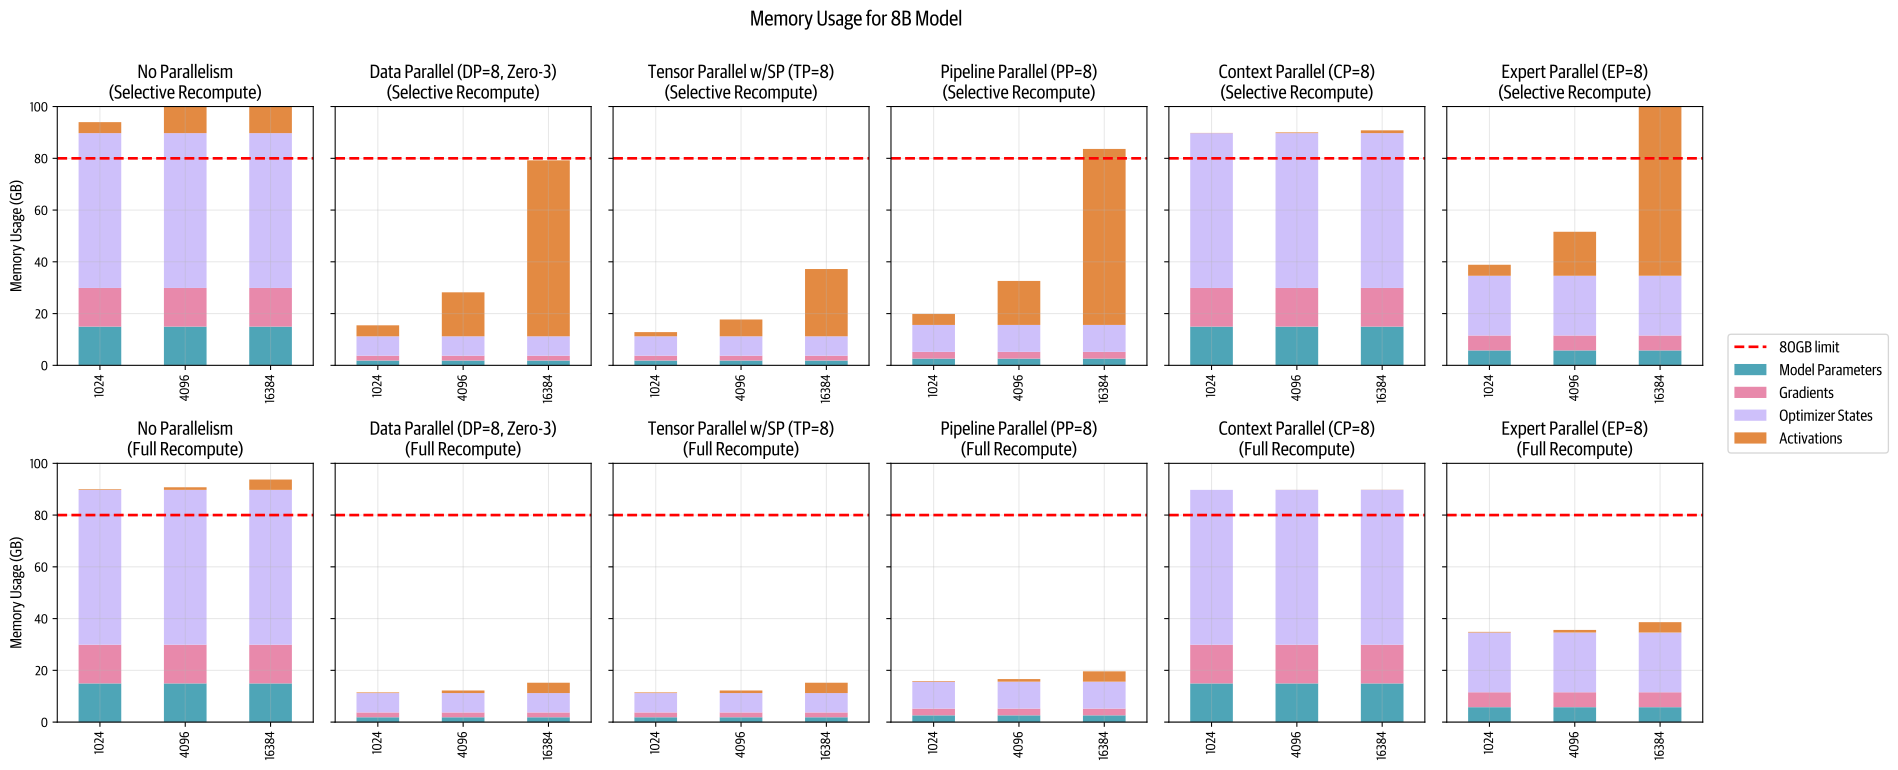
-
各种并行方法的对比
方法 显存节省作用对象 并行 / 切分维度 缺点 数据并行(DP) 激活值(通过减小本地 batch size) Batch 受最大 batch size 限制 流水线并行(PP) 模型参数 模型层 空泡(idle bubble)问题,调度复杂 张量 + 序列并行(TP+SP) 模型参数和激活 隐藏维度 / 序列长度 需要高速通信带宽 上下文并行(CP) 激活值 序列长度 注意力模块增加通信开销 专家并行(EP) MoE 层参数 专家维度 需要 MoE 层,增加 token 路由通信开销 ZeRO-1 优化器状态 在 DP 副本间切分 参数通信开销 ZeRO-2 优化器状态和梯度 在 DP 副本间切分 参数通信开销 ZeRO-3 优化器状态、梯度和模型参数 在 DP 副本间切分 参数通信开销
通讯量分析
-
定义符号:
- B = micro batch size
- S = sequence length
- H = hidden size
- L = layer 数
- V = vocab size
- T = TP size
- C = CP size
- P = PP size
-
activation 基本 tensor,很多通信量都可以看成它的某种切片
[B, S, H] -
通信 - 计算掩盖的核心思想
- Chunking /streaming(把 tensor 切块边算边传)
- pipeline overlap(下一步计算覆盖上一步通信)
-
DP
- DP 的通信发生在梯度同步阶段
- 每个 GPU 都有完整的模型参数
- 反向传播结束后 all-reduce 各个 DP rank 的梯度,通信量约为
- 与 B、S 无关,只和模型大小有关,因此大模型训练必须减少 DP 规模
- 如何进行通信 - 计算掩盖?
-
在一层的梯度计算完成后,就立刻进行通信 all-reduce 这层的梯度
-
为了避免每次传输的梯度数据过小,一般设置 Gradient Bucket,累积到一定阈值后进行传输
Backward L reduce grad L Backward L-1 reduce grad L-1 -
DP 通信可以被 backward 计算很好掩盖
-
-
PP
- PP 的通信主要是不同 PP rank 之间的激活值传递
- 两个 stage 之间传输的激活值大小约为
- 每个 micro-batch 前向传播时发送激活值,反向传播时发送梯度,因此通信量约为
- 如果一个 batch 有 M 个 micro-batch:则通信量为
- 总共有 个 stage,共发生 次传递
- 如何进行通信 - 计算掩盖
- 通过 micro-batch pipeline,将通信隐藏在下一个 microbatch 的计算中
- PP 的通信量较小,不是系统瓶颈
-
TP
- 通信来源一:Attention 输出的 需要进行 all-reduce 通信,通信量为
- 通信来源二:MLP 输出的 需要进行 all-reduce 通信,通信量为
- 每层通信约为 ,整个模型通信量为
- 以上通信量随着 sequence 增长,通信量很大
- 如何进行通信 - 计算掩盖
- MLP 层,计算量 ,通信量 ,由于 MLP GEMM 很大,可以通过分块掩盖通信
- TP 必须在 LN/Dropout 前必须同步所有 GPU
- TP 无法 scale 到跨机,因为 TP 需要高速的 NVLink / NVSwitch,而跨机连接 IB 带宽远低于此,所以 TP 只能 node 内通信
-
TP+SP
- SP 将 all-reduce 优化为 reduce-scatter 和 all-gather,有效降低了需要存储的激活值大小,为
- 但是通信量相比 TP 不变,主要是显存优化
-
TP+CP
- CP 只改变了 attention 层的通信方式,原先的 all-gather 变为了 Ring kv
- 每个 GPU 持有的 KV 为 ,每轮发送 ,共经过 轮,通信量为 ,减少了 TP 倍通信量
- MLP 层不变,仍旧为
- 每层总通讯量为
- 如何进行通信 - 计算掩盖
-
设置适当的分块大小,这样能够在传输分块时,使用计算注意力的时间覆盖传输的时间
recv KV chunk compute attention send KV chunk -> comm + compute overlap -
attention 的通信几乎可以完全掩盖
-
-
由此可见,通信压力最大的是 TP,TP > SP > CP > PP > DP
如何找到最佳的训练配置
- 总结来说,寻找最佳训练配置的关键思路是:
- 先保证单个模型实例在 GPU 上能跑
- 调整全局 batch size 达到训练目标
- 优化吞吐量,合理组合 TP / DP / PP / CP / EP / ZeRO 策略
步骤 1:让训练步能在显存中跑得下
- 首先要确保单个模型实例能放入 GPU 显存情况,大致分两类:
- GPU 资源充足(GPU-rich)
- 对于 <10B 参数模型:单一并行策略即可,例如张量并行(TP)或者 ZeRO-3 / 数据并行(DP)+ 全量重算,使用 8 张 GPU
- 对于 10B–100B 参数模型、需要 >8 张 GPU,可选方案包括:
- TP=8 + 流水线并行(PP)
- TP=8 + 数据并行(ZeRO-3)
- 仅 ZeRO-3(纯数据并行)
- 512+ GPU 规模:
- 纯 DP / ZeRO-3 开始因通信开销而效率下降
- 更优方案:DP + TP 或 PP 组合
- 1024+ GPU 规模:
- 推荐组合:TP=8 + DP(ZeRO-2)+ PP
- 注意:这里的重点是单模型实例能跑起来,使用 ZeRO-3 帮助节省模型参数显存
- 特殊情况:
- 超长序列 → 可能需要跨节点使用 CP
- Mixture of Experts(MoE)架构 → 可能需要跨节点使用 EP
- GPU 资源有限(GPU-poor)
- 可开启全激活重算(trade compute for memory)
- 可增加梯度累积步数,在显存有限情况下处理更大 batch
步骤 2:达到目标全局 batch size
- 在步骤 1 后,得到了一个可训练的微批量(micro-batch)配置,但可能离目标全局 batch size 还差距很大
- 增大全局 batch size
- 增加数据并行(DP)或梯度累积步数
- 超长序列时,可利用 CP 增大 batch size
- 减小全局 batch size
- 减少数据并行,转向其他并行策略
- 超长序列时,可减少 CP 使用
步骤 3:优化训练吞吐量(Throughput)
- 现在模型已经能跑在目标模型大小和 batch size 上,但希望训练尽可能快,让 GPU 高效利用,可尝试的优化方法:
- 扩展张量并行(TP)
- 利用高速节点内带宽
- 尽量达到单节点 GPU 数量
- 这样可以减少其他并行策略的依赖
- 增加数据并行 + ZeRO-3
- 保持目标 batch size
- 如果 DP 通信成为瓶颈 → 转向流水线并行(PP)
- 逐个尝试扩展不同并行策略
- 找到最优组合
- 调优微批量大小()
- 在全局 batch size、模型规模、计算量、通信开销之间找到最佳平衡
- 扩展张量并行(TP)
基准测试
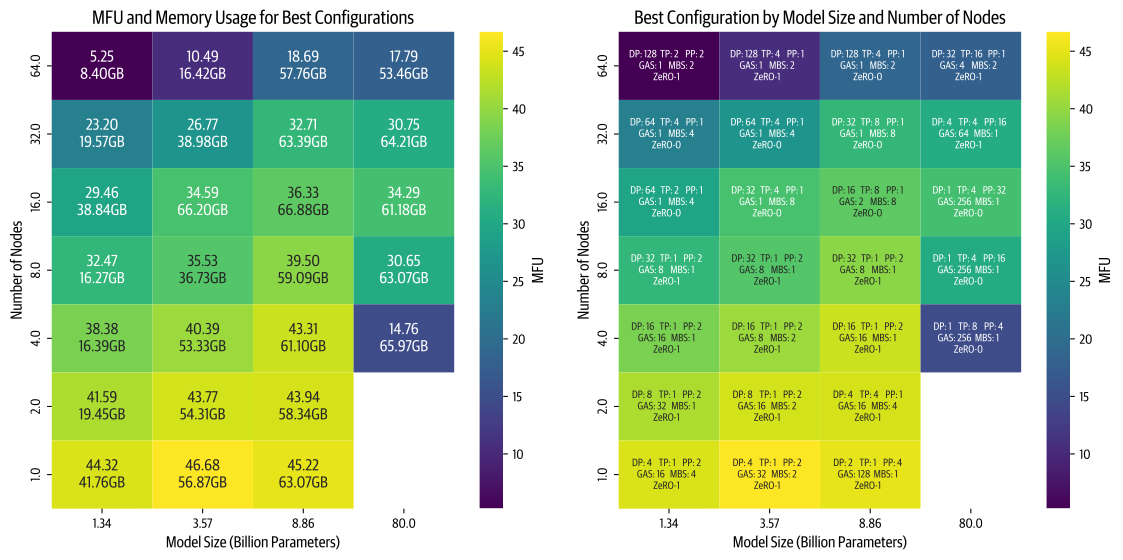
- 在 Nanotron 仓库中,可以找到多个脚本,用于运行之前讨论的所有实验,并对自己的模型和集群进行基准测试
- 基准测试的设置
- 序列长度:4,096
- 全局 batch size:1M tokens
- 热力图中展示了每个模型和集群规模下的最佳配置:
- 每个组合显示:DP、TP、PP、梯度累积步数(GAS)、微批量大小(MBS)、ZeRO 优化阶段
- 颜色亮度表示模型 FLOPs 利用率(MFU),越亮表示效率越高
- 节点数增加 → 效率下降
- 对小模型尤为明显,因为计算量与模型规模比低
- 虽然可以通过增加 batch size 来补偿,但受全局 batch size 限制(1M)
- 大模型面临显存压力
- 模型规模增大 → 显存需求显著增加
- 节点数少时:模型可能无法放入显存,或者运行效率低下,因为显存几乎满载
- 例如,80B 参数模型在 4 节点上训练时就属于此类情况
- 性能依赖实现质量
- 初期:TP 优于 PP
- 优化 PP 实现后:PP 性能更好
- 目前优化 TP 的通信重叠后,预计 TP 会再次领先
基准测试中的经验教训
- 基准测试的目标不仅是讨论理论和实现,更是提供实际测试数据。流程大致如下:
- 针对每个模型和多个集群规模,尝试所有可能的分布式配置
- 排除不可行配置后,仍需运行数千次实验
- 实际执行中遇到的挑战:
- PyTorch 进程有时无法正确清理
- Slurm 作业管理器会强制终止作业,导致节点失败
- 简单基准测试可能从几分钟变成几小时
- 一些作业可能无限挂起
- 为保证有限时间内完成实验,实验者做了额外工程工作:
- 最小化集群重启时间,优化空闲时间
- 分析 NCCL 调试日志
- 理解显存使用模式和 CUDA 内存分配器行为
- 改进多节点流水线并行性能
- 这些经历说明:
- 理论看似简单,但在实践中涉及许多细节
- 实际复现理论结果需要高度关注硬件和软件环境
- 分布式训练不仅是算法问题,也涉及工程能力
- 相关开源项目
FlashAttention
-
到目前为止的并行运算技术往往依赖一个关键假设:计算和通信可以在 GPU 上高效重叠,而不会影响计算吞吐量,但实际情况要复杂得多
-
使用常见的通信原语(如 NCCL 的 send/recv)时,计算和通信资源之间存在潜在的竞争,因为通信内核通常会使用与计算相同的 GPU 流式多处理器(Streaming Multiprocessors)
-
当通信与计算重叠时,这会导致吞吐量下降,要真正优化分布式训练,需要更深入地了解 GPU 的架构细节,可以详见 PyTorch 版块中的 CUDA 章节
-
基本思想
- FlashAttention 由 Tri Dao 提出,目标是通过手写 CUDA 内核,让 attention 的计算更快、更省显存、更贴合 GPU 的内存与计算结构
- FlashAttention 的核心思想是充分利用 GPU 中更快的内存,尽量避免使用最慢的那一层内存 —— 全局内存
-
现代 GPU 的全局内存通常使用 HBM(High Bandwidth Memory)
- HBM 带宽高,但仍然远慢于 GPU 内部的 SRAM、寄存器、共享内存、L1 cache
- HBM 这个名字容易误导,High Bandwidth ≠ Low Latency,和片上 SRAM 相比,HBM 仍然是 “慢内存”
-
Naive Attention 的内存灾难
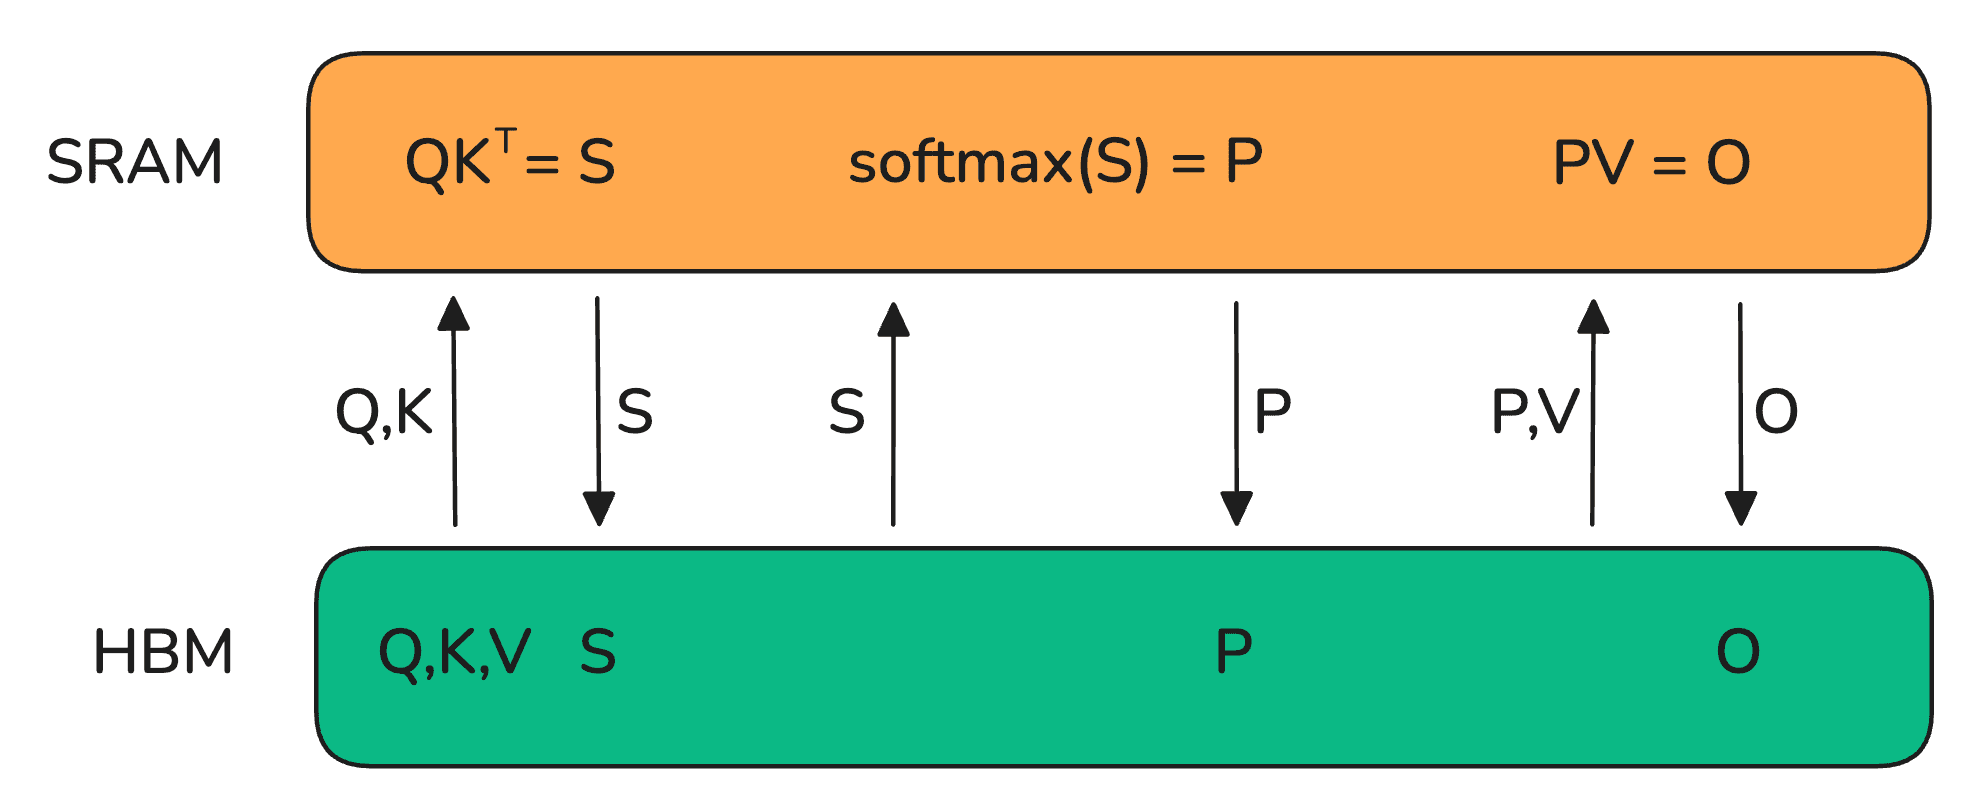
- 标准 attention 的计算流程是:
- 给定 、、
- 计算注意力分数
- softmax 归一化
- 得到输出
- 在 naive 实现中, 必须完整算出来, 也必须完整算出来,它们都被存进 HBM
- 算完 → 写回 HBM
- 再从 HBM 读 → 算 softmax → 写回 HBM
- 再从 HBM 读 → 算
- 这在长上下文下是灾难性的, 和 的大小是 ,它们是整个模型中最大的 activation 之一,带宽和显存同时爆炸
- 标准 attention 的计算流程是:
-
在注意力计算的过程中,带宽瓶颈的本质是 attention 在算术上是大量矩阵乘法,计算密度并不低,但性能被严重限制在 HBM 带宽而非算力上
-
FlashAttention 的核心思想是直接在 GPU 的 SRAM(共享内存 + 寄存器)里分块计算、边算边归一化、边算边累加
- 传统做法:QK^T → 写 S → 读 S → softmax → 写 P → 读 P → PV
- FlashAttention 的做法:Q_tile × K_tile^T → 在线 softmax(只保留 max /sum) → 直接更新 O_tile
- 从头到尾从未完整存在过,只保留 softmax 所需的当前最大值、归一化因子(sum of exp)
- 这样,不仅利用共享内存解决了 HBM 的带宽瓶颈,还释放了注意力矩阵的显存占用
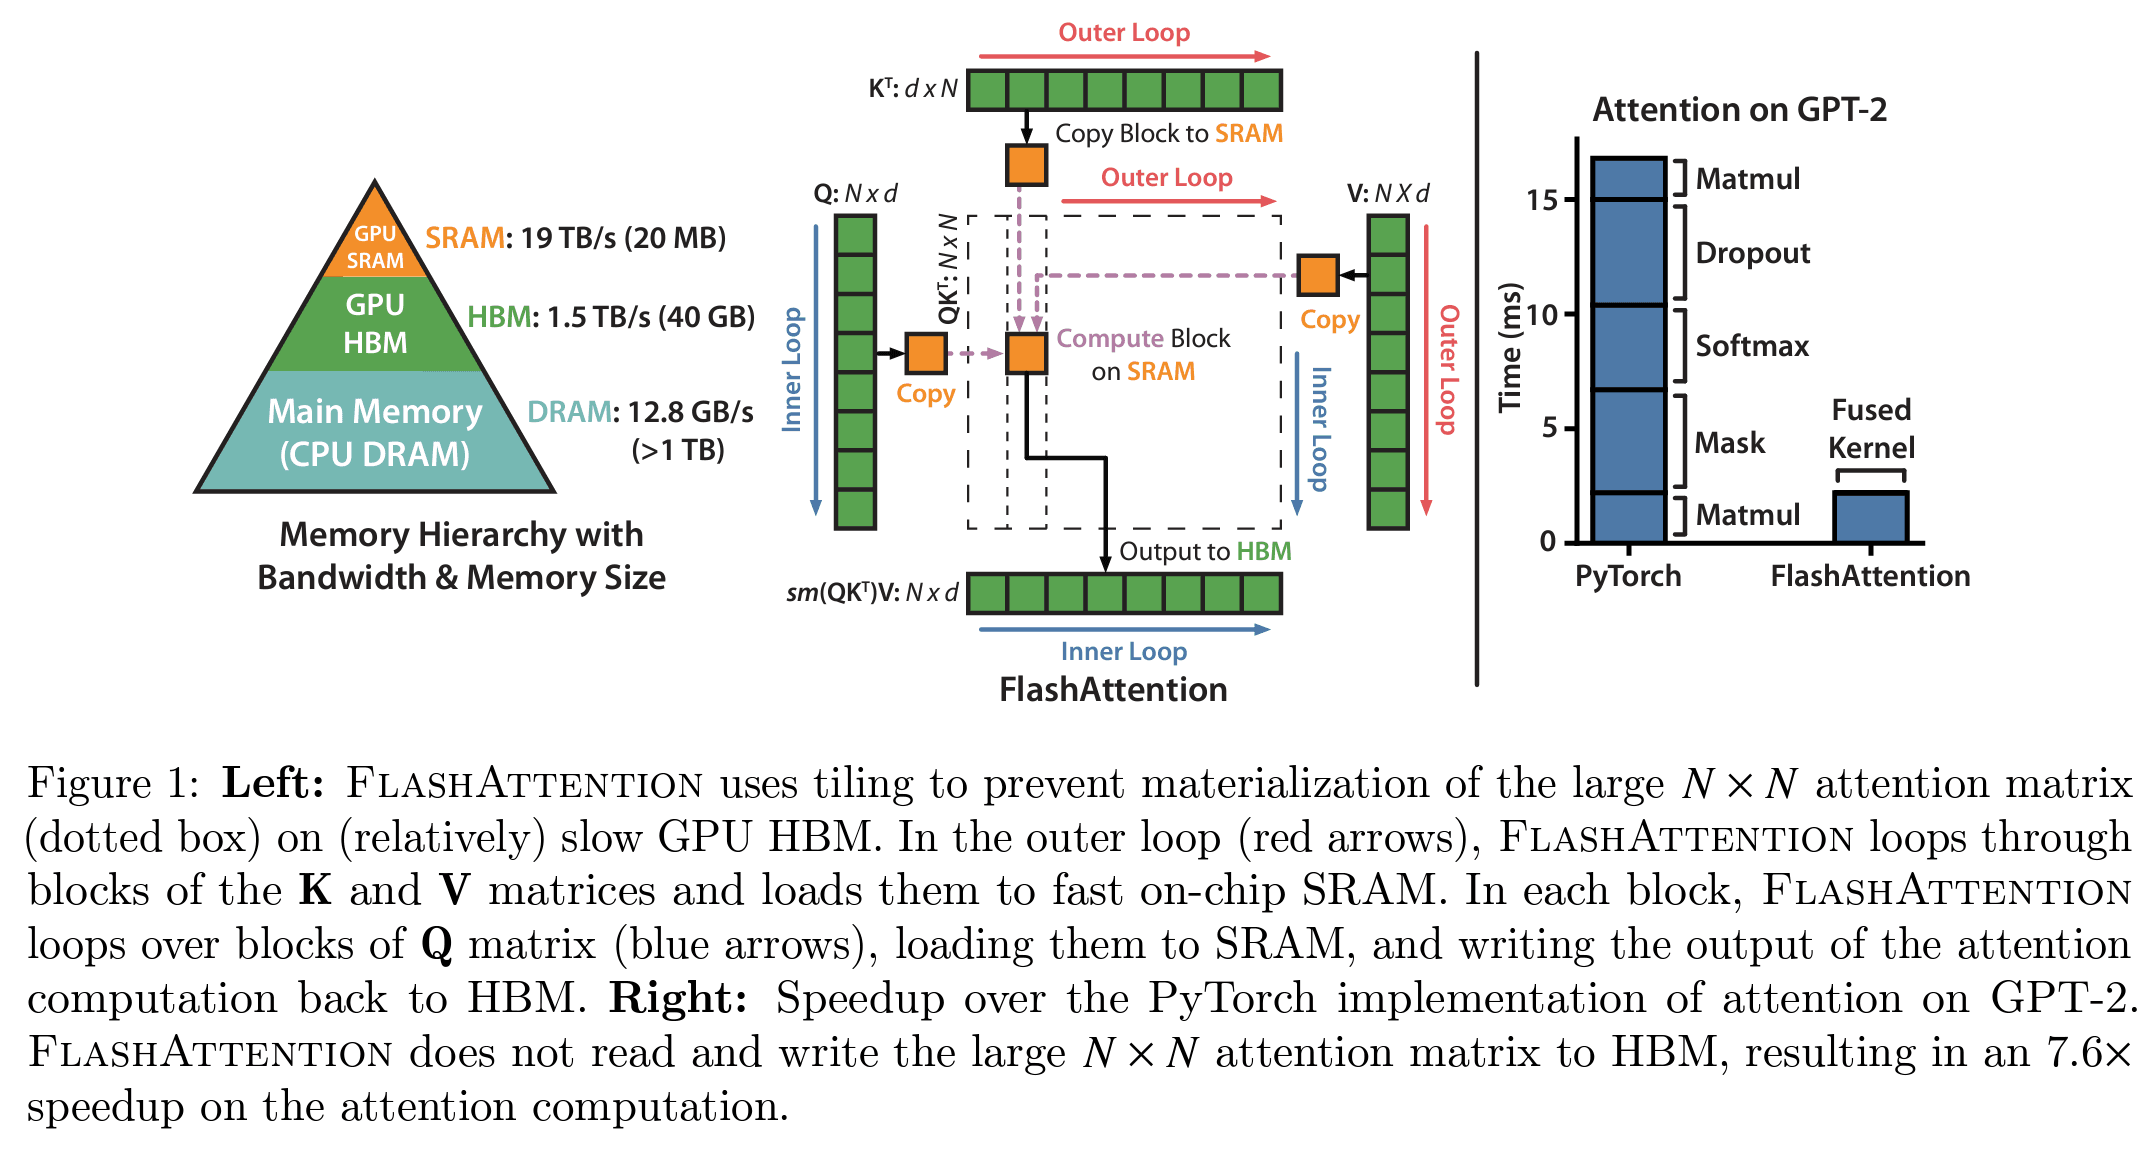
-
softmax 有一个重要性质:
- 只要维护当前块的最大值和累计的指数
- 就可以一块一块处理 ,最终得到和一次性 softmax 完全一样的结果
-
具体步骤
- 分块:不一次性算完整个 ,而是把 分成小块,每一小块能放进共享内存
- online softmax:利用 softmax 的重要性质,每个 block 维护当前最大值 和累计归一化因子
- 这样可以做到一边算 ,一边算 softmax,一边直接乘 ,一边累加
- 最终效果是: 从未完整存在过、 从未完整存在过,中间结果始终留在寄存器 / 共享内存,只在最后一次性把 写回 HBM
-
FlashAttention 的变革
- 在 FlashAttention 出现之前,大量工作集中在 linear attention、sub-quadratic attention 等各种近似 softmax
- 它们的动机是 的算法复杂度无法忍受,但 FlashAttention 证明了问题不在算法复杂度,而是在内存访问模式
- 于是精确的 attention + 正确的 kernel 设计,反而比近似方法更快、更省显存
-
后续优化
- FlashAttention-2:减少非 GEMM 操作,更精细地划分 warp、划分 thread block、更好地利用 GPU 的执行模型
- FlashAttention-3:专门针对最新 Hopper(H100)架构,支持 FP8,深度使用 Tensor Core,进一步压榨算力与带宽
- FlashAttention 对 attention pattern 有一定限制,不适用于所有稀疏或自定义 attention 形式,因此出现了 FlexAttention,在保持高性能的同时支持更灵活的 attention 结构
混合精度训练
基本思想
-
在前面的章节在,已经看到过低精度训练的应用
- 显存瓶颈并不只来自模型参数,激活和优化器状态往往更大
- 低精度的核心价值就在于用更少的 bit 表示数值,换取显著的内存节省和更高的吞吐
- 但这一定伴随着数值精度和稳定性的代价
-
混合精度训练(mixed precision training)
- 顾名思义,是指在训练过程中混合使用多种数值精度
- 在 PyTorch 中,张量的默认数值精度是单精度浮点数,也称为 FP32 或 float32,这意味着每个数占用 32 位(bit),即 4 个字节(byte)
- “混合” 这个词非常重要,它并不是说全部都用低精度,而是有些张量用 FP32,有些用 FP16 / BF16 / FP8;有些计算在低精度做,但结果保存在高精度里,这是后面能保证稳定训练的关键
-
浮点数的表示 —— 用于表示一个浮点数的比特被分成三部分:
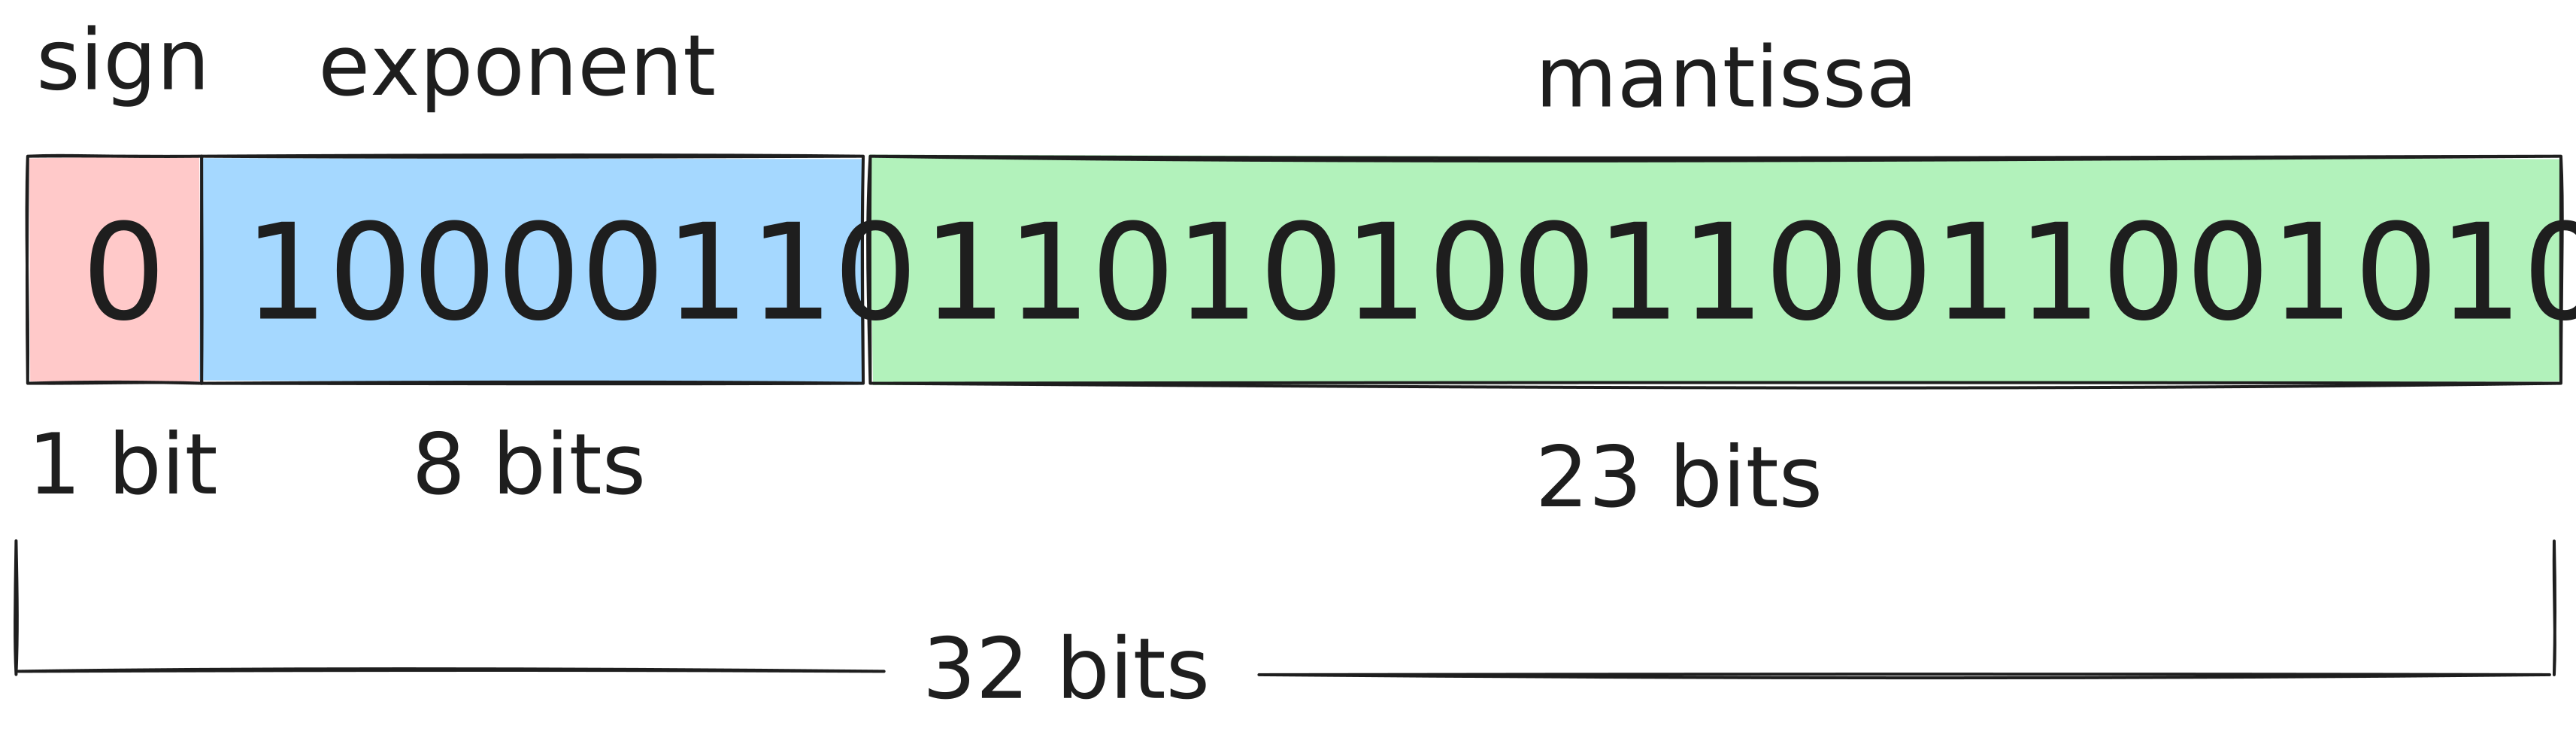
- 浮点数并不是 “定点表示”,而是用有限 bit 去近似表示一个连续实数空间
- 符号位(Sign):第一个 bit 决定这个数是正数还是负数,决定连续实数空间的反向
- 指数位(Exponent):控制数值的量级(范围),决定能表示多大或多小
- 尾数位(Mantissa,也叫有效数):决定数值的精度(有效数字),决定表示得有多细
- 浮点数的原理可以通过科学计数法来直观理解,例如:
- 在这种表示中,先有符号(负号),接着是尾数(5.734),最后是指数()
- 计算机里的浮点数本质上就是科学计数法的二进制版本:
- 区别只在于科学计数法是以 10 为底,浮点数是以 2 为底
-
PyTorch 提供的浮点数格式
格式 比特数 符号位比特数 指数位比特数 尾数位比特数 float32 32 1 8 23 float16 16 1 5 10 bfloat16 16 1 8 7 float8 (e4m3) 8 1 4 3 float8 (e5m2) 8 1 5 2 -
范围和精度的取舍
- 减少总 bit 数一定是有代价的,但可以选择代价付在哪里 —— 要么减少尾数的 bit,要么减少指数的 bit
- 浮点数的核心矛盾就是 exponent 决定 “能表示多大 / 多小”(数值范围),而 mantissa 决定 “能表示多细”(数值精度),bit 总数有限,只能在范围和精度之间做取舍
- 正因为这种取舍关系,FP8 并不是只有一种格式,而是有两种 float8 格式,根据指数位和尾数位命名
-
不同数值的表示范围
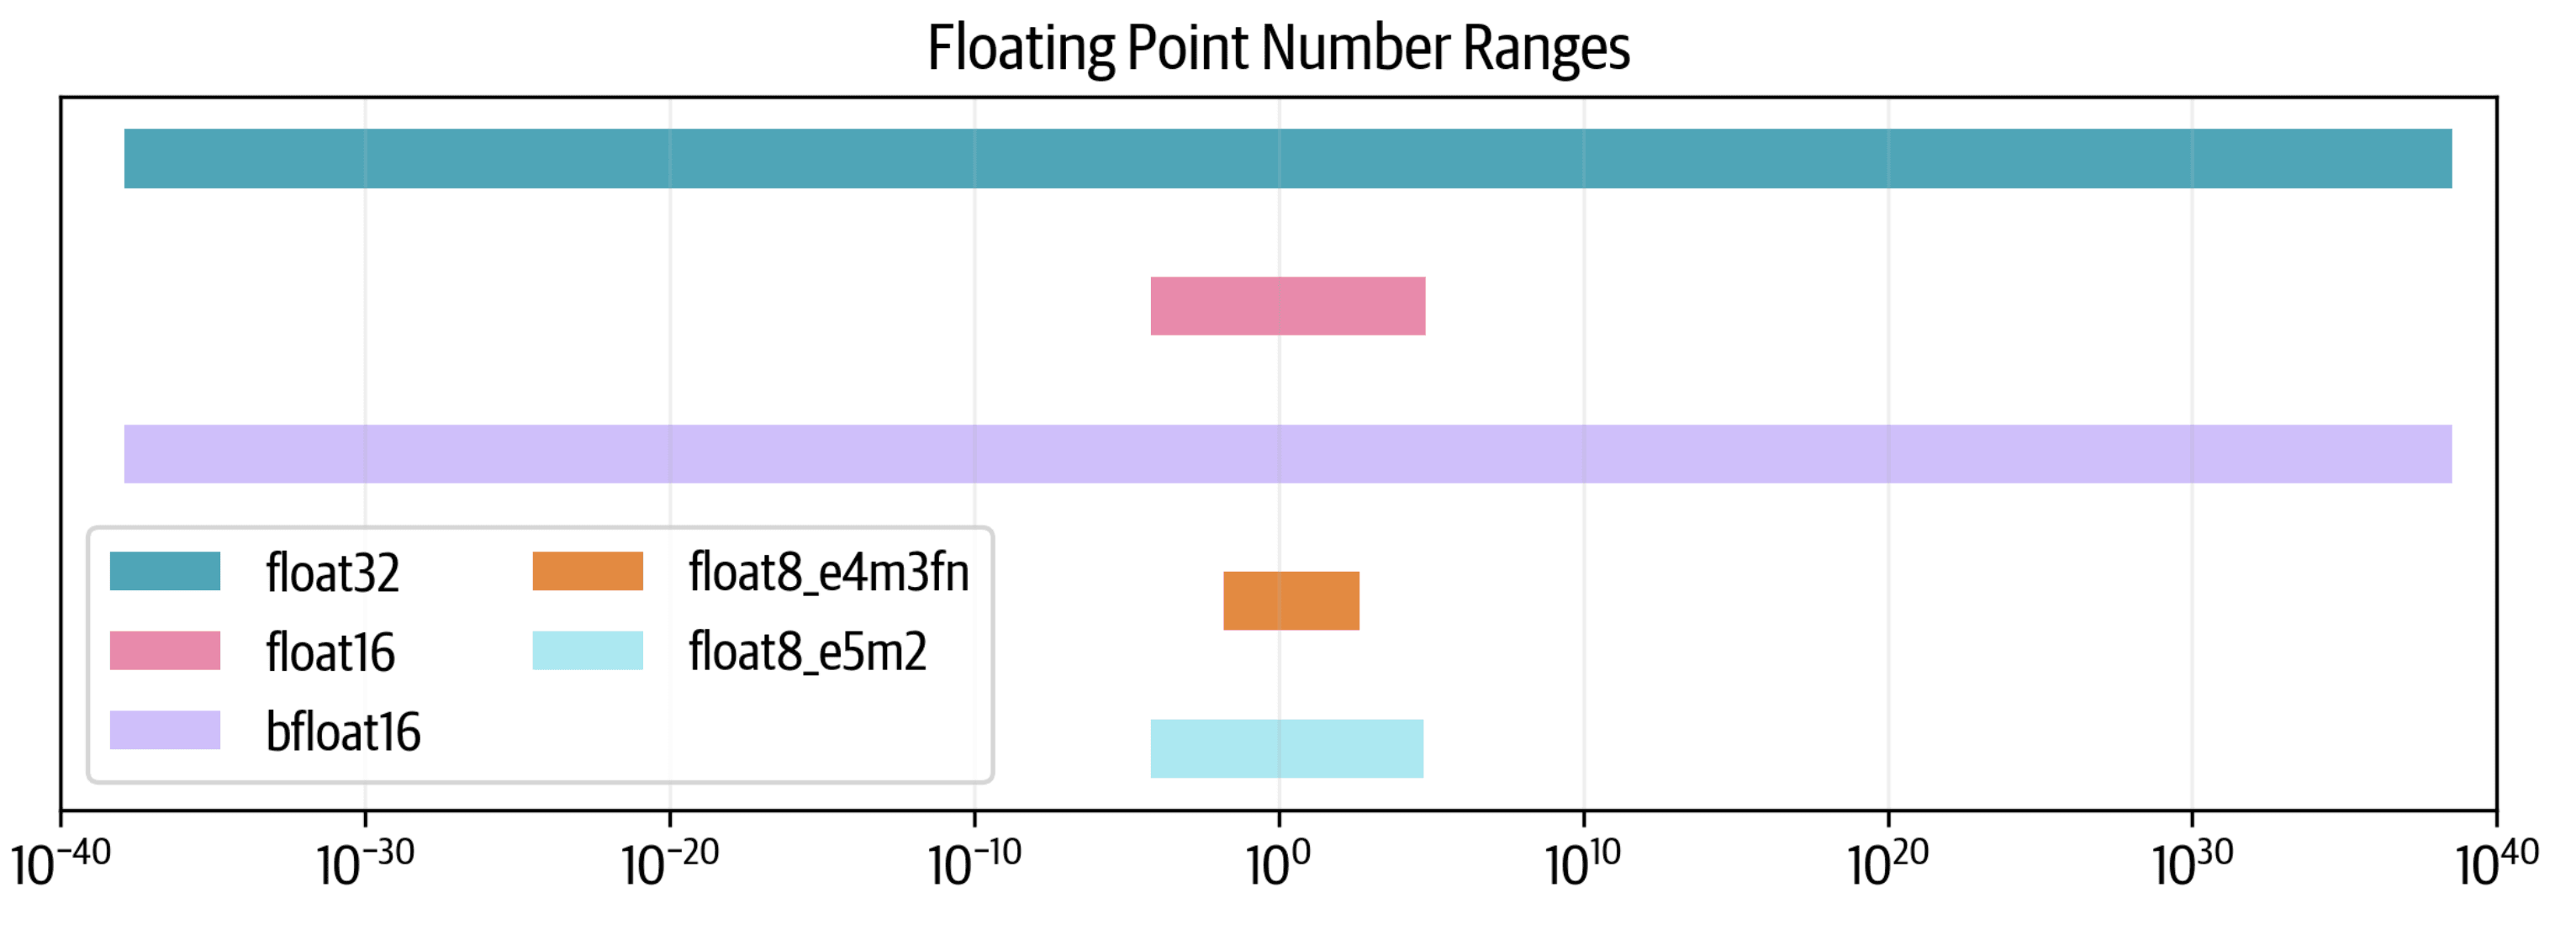
- float32 可以覆盖约 80 个数量级
- float16 为了节省 bit,牺牲了大量数值范围
- bfloat16 则保留了与 float32 相同的数值范围,
- float16 和 bfloat16 都是 16 bit,但 float16:指数少 → 容易 overflow /underflow,而 bfloat16:指数多 → 范围几乎和 float32 一样
- 对于 float8,e5m2 可以勉强维持 float16 的数值范围,而 e4m3 数值范围进一步缩小
-
不同数值的分辨率(resolution)
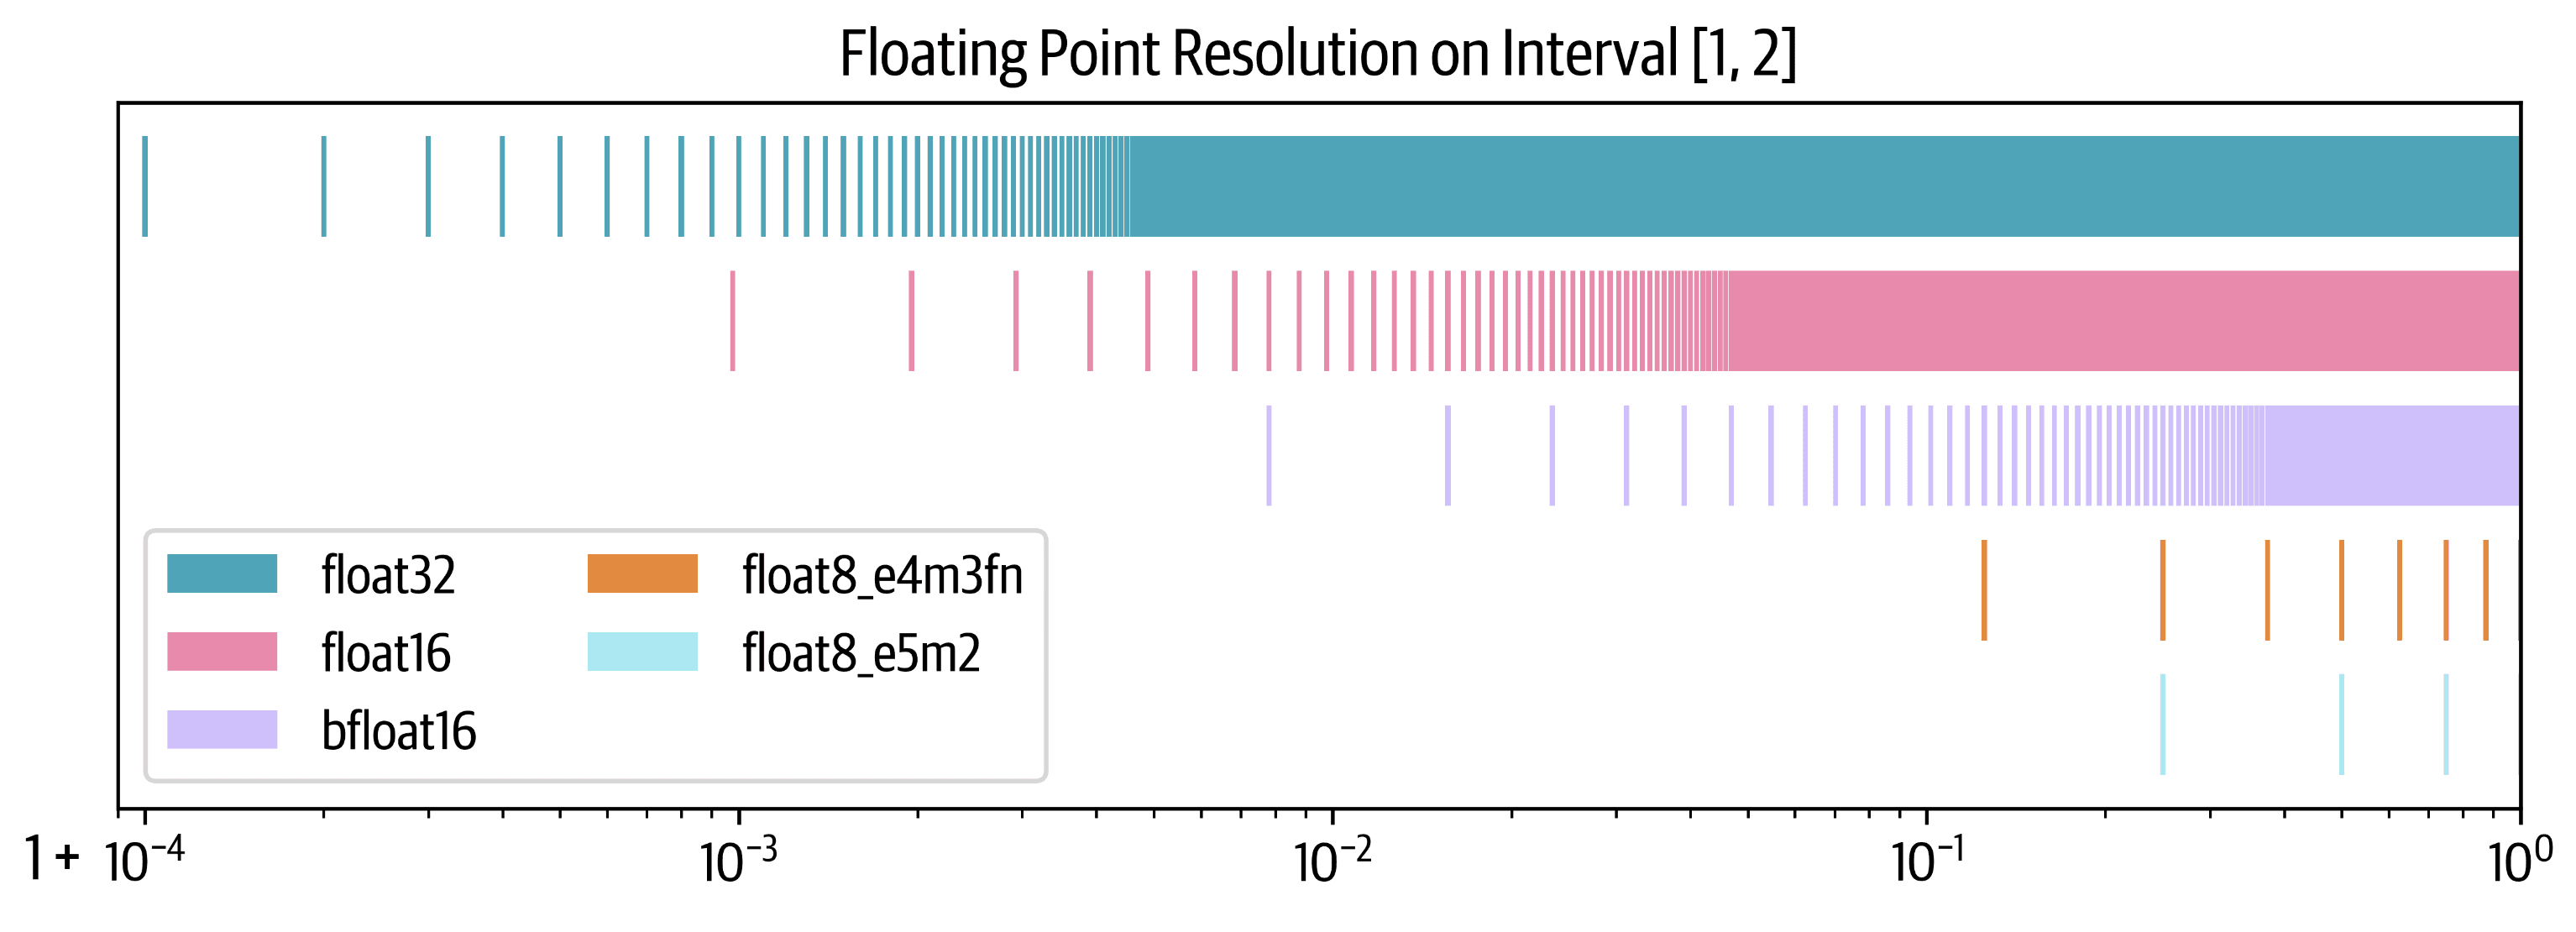
- 在区间 内取 10,000 个点,将这些点分别四舍五入到各个格式中最接近的可表示数
- 从图中可以看到,bfloat16 虽然维持了 float32 的数值范围,但代价是精度明显下降,可表示的数变得更稀疏
- 这正是 bfloat16 的设计哲学,宁愿数值表示得 “粗一点”,也要避免数值溢出,因为对深度学习来说,梯度爆炸 / 消失比 “多一点噪声” 更致命
- 在 float8 的情况下,问题更加严重
- e4m3 在区间 内只能表示 7 个数
- e5m2 甚至只能表示 3 个数
- 这意味着在这个区间内大量不同的实数会被量化成同一个值,这对梯度、激活、权重更新都是极大的挑战
- 衡量一个浮点格式分辨率的常用指标是 epsilon,即大于 1.00 的最小可表示数
- epsilon 越小,表示在 1 附近能表示得越精细,数值误差越小
- float32 的 epsilon 上界约为 ,实际值大约是
- float16 的 epsilon 约为 ,bfloat16 的 epsilon 还要再大 10 倍
-
混合精度训练的核心思想
- 在某些计算中使用低精度格式,同时保持与全精度训练几乎一致的效果和稳定性
- 关键不是 “用不用低精度”,而是哪些地方可以用,哪些地方绝对不能用
- 事实证明,无法彻底抛弃 float32,通常仍然需要在某些计算中使用全精度,如梯度累积、权重更新、loss scaling 的关键路径,否则训练会发散
FP16 / BF16
- 最早的混合精度训练论文:Mixed Precision Training
- FP32 权重副本:
- 使用 FP16 权重时,在训练过程中,一些权重可能会变得非常小,从而被直接舍入为 0
- 即便权重本身不接近 0,如果梯度更新量非常小,在做加法时,由于数量级差异,也可能发生下溢
- 更新规则本质是 ,当 时,在 FP16 中, 可能直接被忽略
- 一旦权重变成 0,梯度传播中断,该参数彻底失效
- 因此,混合精度训练中通常会维护一份 FP32 权重副本,用于存储和更新权重
- 前向传播时,FP32 权重会被转换为 FP16,用于计算
- 反向传播时,计算得到的 FP16 梯度会被转换为 FP32,用于更新 FP32 权重
- 这样可以确保权重更新的精度和范围,避免下溢问题
- Loss scaling:
- 梯度同样存在类似问题,因为梯度值通常远小于 1,因此极易发生下溢
- 在深度网络中,梯度往往是 、 甚至更小,FP16 对这种数值极其不友好
- 一个简单但非常有效的策略是在反向传播前放大 loss,在反向传播后再把梯度缩小回来
- 这样可以保证反向传播过程中不会发生下溢,而且由于在后续处理(如梯度裁剪)和参数更新前会把梯度缩放回来,因此不会影响训练结果
- 数值上,backward 用的是放大后的梯度,而语义上,optimizer 看到的仍是真实梯度
- 累加(Accumulation):
- 在 16-bit 精度下进行某些算术操作(例如求和、求平均)时,也可能发生下溢或上溢,如多个梯度求和、moving average、batch 内统计量
- 解决方法是,在运算过程中使用 FP32 累加中间结果,最终结果再转换回 16-bit 精度
- 即 compute 用 FP16 / BF16,accumulate 用 FP32
- 通过上述技术,混合精度训练能够在保持训练稳定性的同时,大幅提升计算速度和显存利用率
FP8
-
基本思想
- 即便能够把通信与计算做到完美重叠,最终仍然会碰到一个无法回避的瓶颈:硬件本身的理论 FLOPS 上限,也就是单个算子在硬件上的执行效率
- 前面所有优化(pipeline、overlap、fusion)解决的都是等待的问题,内存如何解决的问题,但现在的瓶颈是单次乘加本身有多快
- 例如,在 NVIDIA H100 GPU 上 FP8 的矩阵乘法(GEMM)的理论 FLOPS 是 BF16 的 2 倍,这使得更低精度的训练成为进一步提升性能的潜在方向
- 近期的研究工作,包括 FP8-LM、torchao 和 DeepSeek-V3,已经展示了 FP8 在大规模模型训练中的潜力
-
然而,FP8 预训练带来了一个极其严峻的挑战:数值稳定性
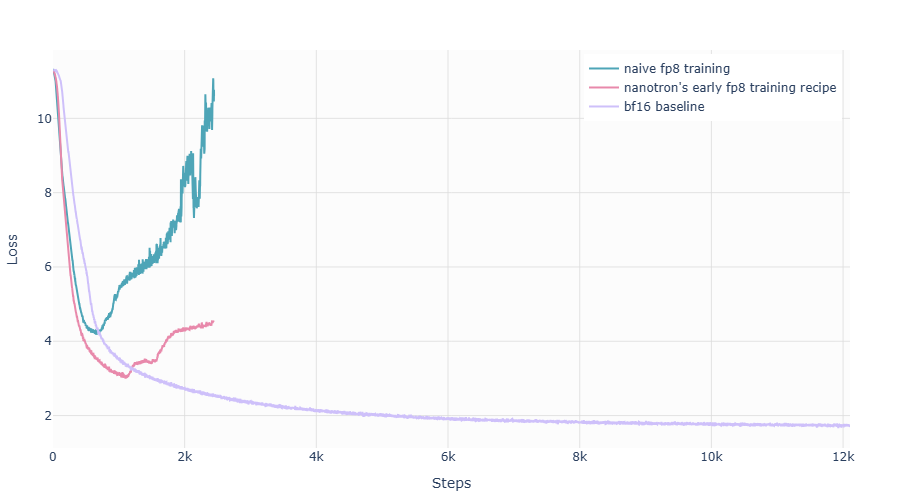
- 在更低精度下,数值不稳定性常常导致 loss 发散,使得训练效果难以达到高精度训练的水平
- 在模型规模固定的情况下,学习率越大,训练越不稳定,大模型预训练通常需要较大的 learning rate,而 FP8 对 learning rate 极其敏感
-
首次公开成功的大规模 FP8 混合精度训练来自 DeepSeek-V3 的技术报告
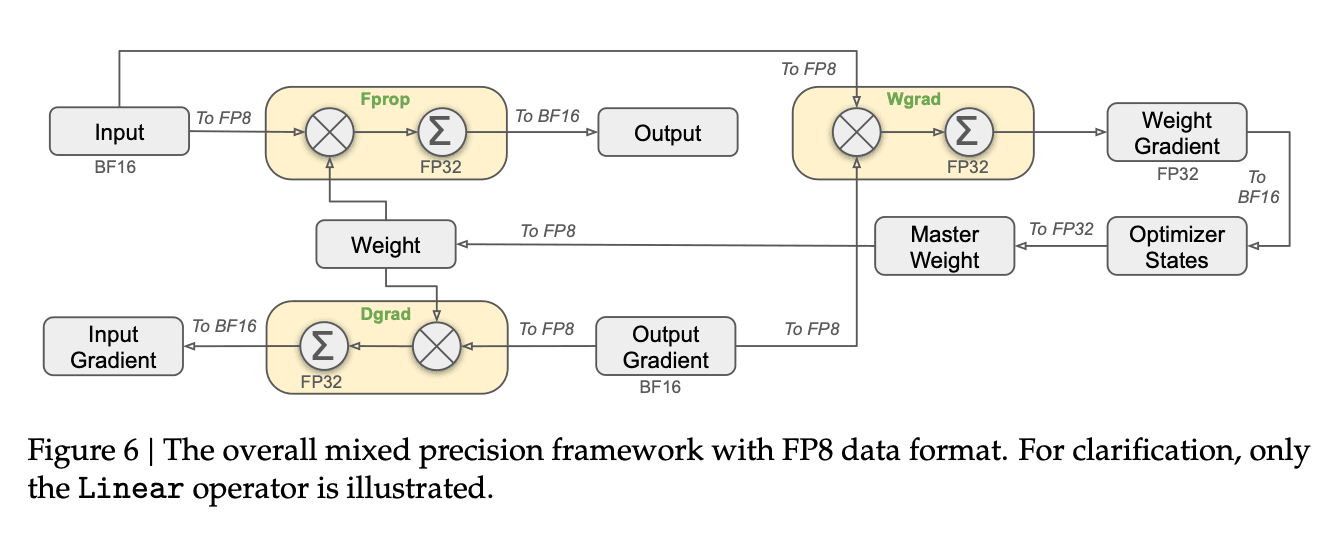
- 作者对以下所有阶段的每一个算子都进行了细致分析:
- 前向传播(Fprop)
- 激活反向(Dgrad)
- 权重反向(Wgrad)
- 类似于 BF16 混合精度训练,一些聚合操作以及 master 权重仍然保留在更高精度中,而具体算子本身使用 FP8
- 这延续在 FP16/BF16 中已经见过的原则:compute 可以低精度、state 和 accumulation 必须高精度
- 为了从高精度(如 FP32、BF16)切换到数值范围更小的低精度(如 FP16、FP8),需要对激活值的范围进行归一化,例如计算其绝对最大值,这是因为 FP8 表示范围极小,不缩放就必然溢出或下溢
- DeepSeek-V3 进一步提出了一种按 tile 进行归一化的量化方案:
- 输入 / 激活:
- 权重与 scale:
- 这种做法可以显著降低激活中异常值(outlier)对归一化范围的影响,如果全局 max → 极易被一个 outlier 毁掉,而使用 tile-wise max → 局部自适应缩放
- 作者对以下所有阶段的每一个算子都进行了细致分析:
-
常见的 FP8 策略
GEMM 精度方案 主模型权重 梯度累积 模型权重 梯度 优化器状态 总内存表示 单参数内存占用 BF16 + FP32 混合精度基线 BF16 FP32 FP32 BF16 BF16 FP32 + FP32 4 + 4 + 2 + 2 + 4 + 4 = 20 字节 去掉 FP32 梯度累积的上述方案 BF16 FP32 不需要 BF16 BF16 FP32 + FP32 4 + 2 + 2 + 4 + 4 = 16 字节(减少 20%) Transformer Engine FP8 不需要 不需要 FP32 FP32 FP32 + FP32 4 + 4 + 4 + 4 = 16 字节(减少 20%) FP8-LM 的 O3 级别 FP8 FP16 FP16 FP8 FP8 FP8 + FP16 2 + 2 + 1 + 1 + 1 + 2 = 9 字节(减少 55%) DeepSeek-V3 FP8 FP32 FP32 FP8 BF16 BF16 + BF16 4 + 4 + 1 + 2 + 2 + 2 = 15 字节(减少 25%) Nanotron 的 FP8 FP8 BF16 FP32 FP8 FP8 FP8 + FP8 2 + 4 + 1 + 1 + 1 + 1 = 10 字节(减少 50%) -
总体而言,截至 2025 年初,FP8 仍然是一种实验性技术
- 这里的 “实验性” 不是指 “不可用”,而是指:
- 没有形成单一、稳定、被广泛验证的 “标准 FP8 训练范式”
- 不同团队在 scale、quantization、accumulation、optimizer 精度上仍有明显分歧
- 和 BF16 的成熟度相比,BF16 几乎 “无脑可用”,而 FP8 必须理解数值细节才能用好
- 这里的 “实验性” 不是指 “不可用”,而是指:
分布式训练总结
LLM 参数量计算
- 在讨论显存或计算量时,通常统计的是 “元素数”(elements),可以把它理解为张量中的数值个数
- 要得到真实的内存占用(字节数),需要再乘以每个数值的字节大小,例如 BF16 是 2 字节,FP32 是 4 字节
- 输入 token 数:对于每个 micro-batch,处理的 token 数为 ,其中 是 micro-batch size, 是序列长度
- 激活值(隐藏状态):对于单个 Transformer 层,隐藏状态张量的大小为 个元素,其中 是 hidden size
- 模型权重与梯度:模型中的每个权重矩阵(例如线性层)大约包含 个元素,对应的梯度张量大小与权重完全相同
- 优化器状态:对于每一个大小为 的权重矩阵,使用 Adam 这类优化器并配合混合精度训练时,通常需要维护:
- 一阶动量(FP32)
- 二阶动量(FP32)
- 共 个 FP32 元素
- 以及 FP32 的 master weights: 个元素
- 因此,每个权重矩阵对应的优化器状态总量大约为 个元素
- Transformer 单层的参数量
- 注意力部分参数:
- QKV 投影:
- 输出投影:
- MLP(采用 GLU 结构)参数:
- gate 与 up 投影:(两组 的矩阵)
- down 投影:(一组 的矩阵)
- 使用 GLU 的单层 Transformer,总参数量约为
- 不使用 GLU 的情况下,总参数量约为
- 注意力部分参数:
- 全模型参数量:若模型包含 层 Transformer(使用 GLU),则参数总量约为
- 额外参数
- 输入词嵌入:
- LM head(若未与输入嵌入权重共享):
- 位置嵌入(若使用):
- 前向与反向计算量(FLOPs),一个非常粗略的估计是:
- 前向传播 FLOPs:
- 反向传播 FLOPs(约为前向的 2 倍):
- 更精确的前向 + 反向 FLOPs 公式为
- 其中第二项刻画了自注意力在整个序列维度上的二次复杂度。为了简化分析,通常假设