专家并行
介绍专家并行的基本概念、实现方法以及在 PyTorch 中的使用方法
什么是 MoE
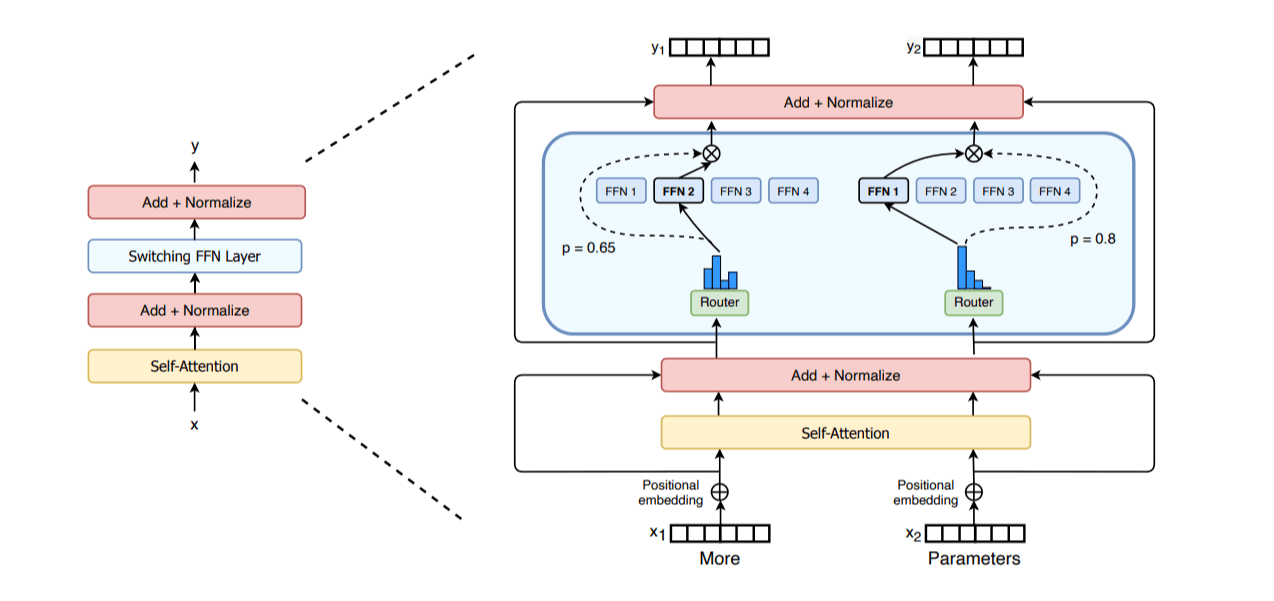
- MoE 的基本思想
- 近年来,MoE 范式随着 GPT-4、Mixtral、DeepSeek-V3 / R1 等模型的出现而受到广泛关注
- 其核心思想是:在每一层中,不再只使用一个前馈网络,而是使用多个并行的前馈模块(即多个 “专家”),并通过路由器(router)将不同的 token 分发到不同的专家中进行处理
- 这样,不同 token 可以被 “差异化” 地计算
- 什么是 Expert Parallelism
- MoE 层的结构天然适合在 “专家维度” 上做并行,这就是所谓的 Expert Parallelism
- 这是因为,每个专家对应一个独立的前馈网络,各个专家之间在计算上互不依赖
- 因此,实现 EP 时,只需要把不同专家的前馈网络放到不同的 GPU /worker 上,将 token 的隐藏状态路由到对应的专家
- 与张量并行相比,EP 更加轻量,不需要拆分矩阵乘法,只涉及 token 隐状态的路由与通信
EP+DP
-
示例
-
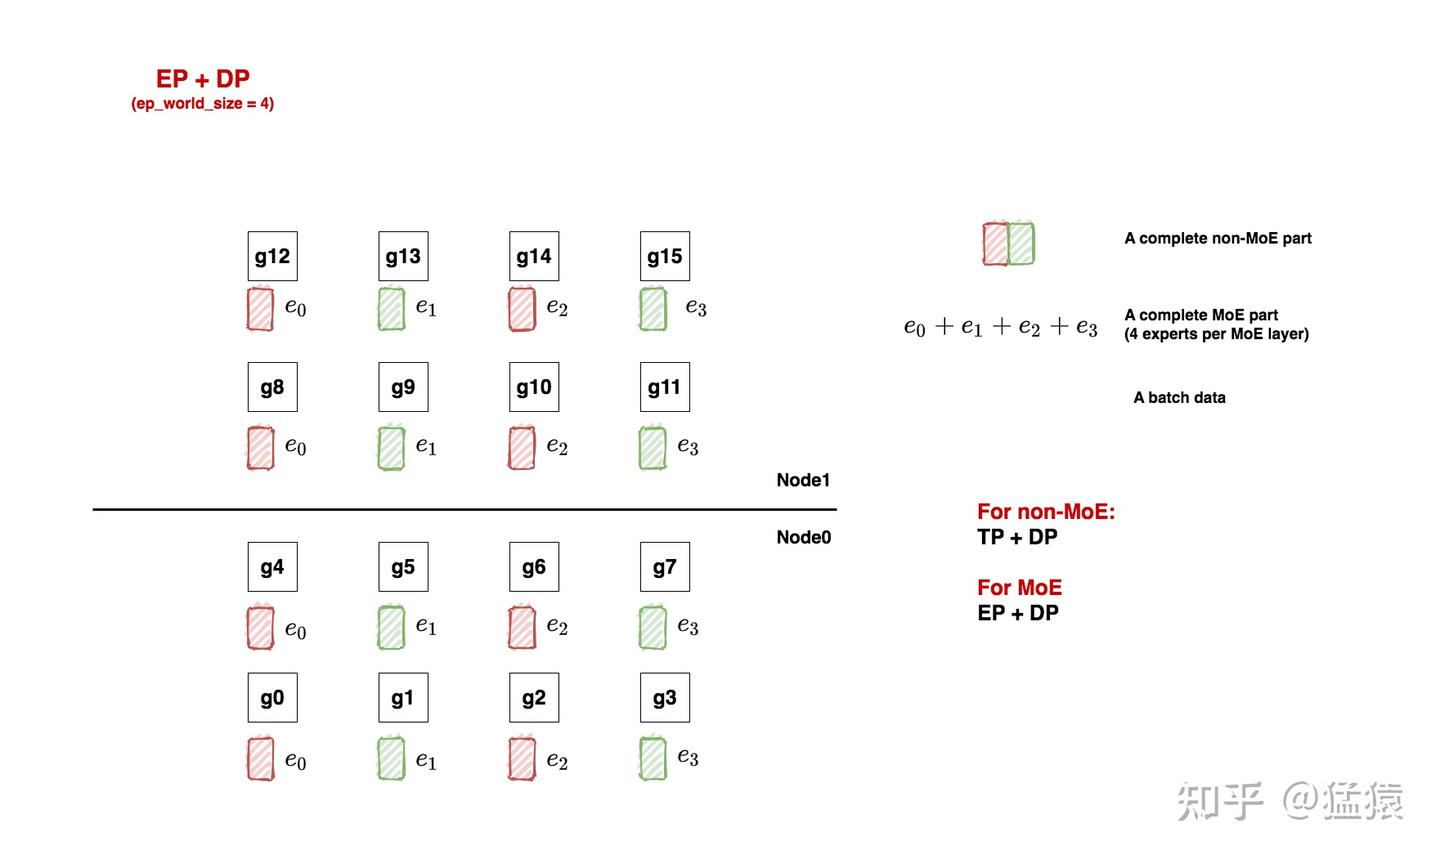
对于非 MoE 部分,其并行分组为
- tp_size 为 2,16 卡被拆分为 8 个独立的 TP 组(
[g0,g1]/[g2,g3]…[g14,g15]),组内 GPU 共同承担单个层 / 算子的张量切分计算 - dp_size 为 8,16 卡被拆分为 2 个独立的 DP 组(
[g0,g2,g4,g6,g8,g10,g12,g14]/[g1,g3,g5,g7,g9,g11,g13,g15]),组内 GPU 持有完整模型副本,切分训练数据
- tp_size 为 2,16 卡被拆分为 8 个独立的 TP 组(
-
对于 MoE 部分,其并行分组为
- ep_size 为 4,16 卡被拆分为 4 个独立的 EP 组(
[g0-g3]/[g4-g7]/[g8-g11]/[g12-g15]),组内每个 GPU 部署不同的专家 - local_expert_num:expert_num/ep_size,expert_num 表示一共有多少个专家,那么 local_expert_num 就表示一个 GPU 上部署多少个专家
- ep_dp_world_size 为 4,16 卡被拆分为 4 个独立的 EP-DP 组(
[g0,g4,g8,g12]/[g1,g5,g9,g13]/[g2,g6,g10,g14]/[g3,g7,g11,g15]),组内 GPU 承载同一专家的不同 batch 数据,因此在反向传播时,需要进行梯度的 all-reduce 通信
- ep_size 为 4,16 卡被拆分为 4 个独立的 EP 组(
-
输入示例
-
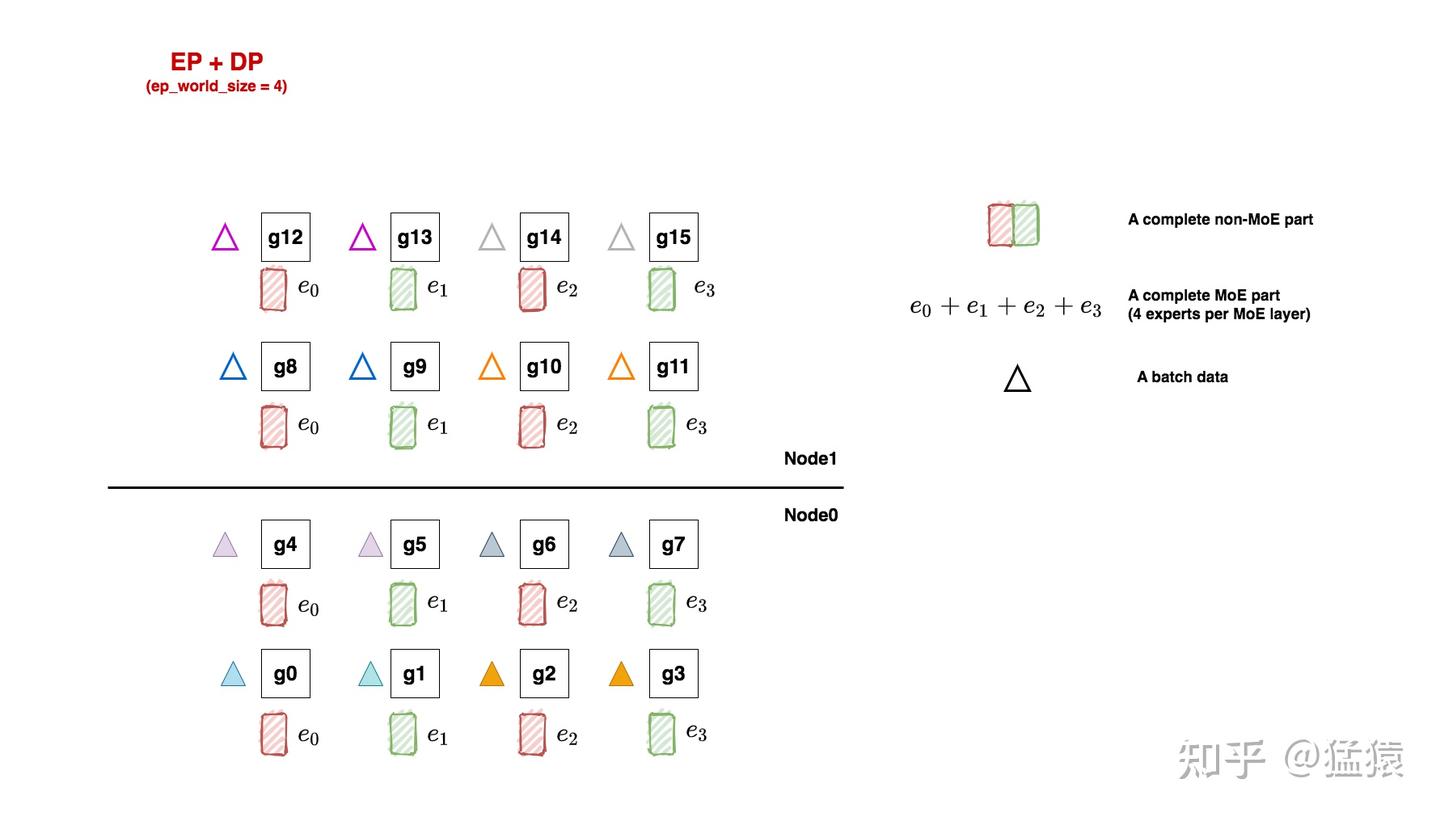
图中三角形表示一个 batch 的数据,显然图中一共输入了 8 个 batch,每个 DP 组(如
[g0,g2,g4,g6,g8,g10,g12,g14])内输入的数据不同;而对于同一个 TP 组(如g0,g1)内输入的数据相同 -
前向传播过程
-
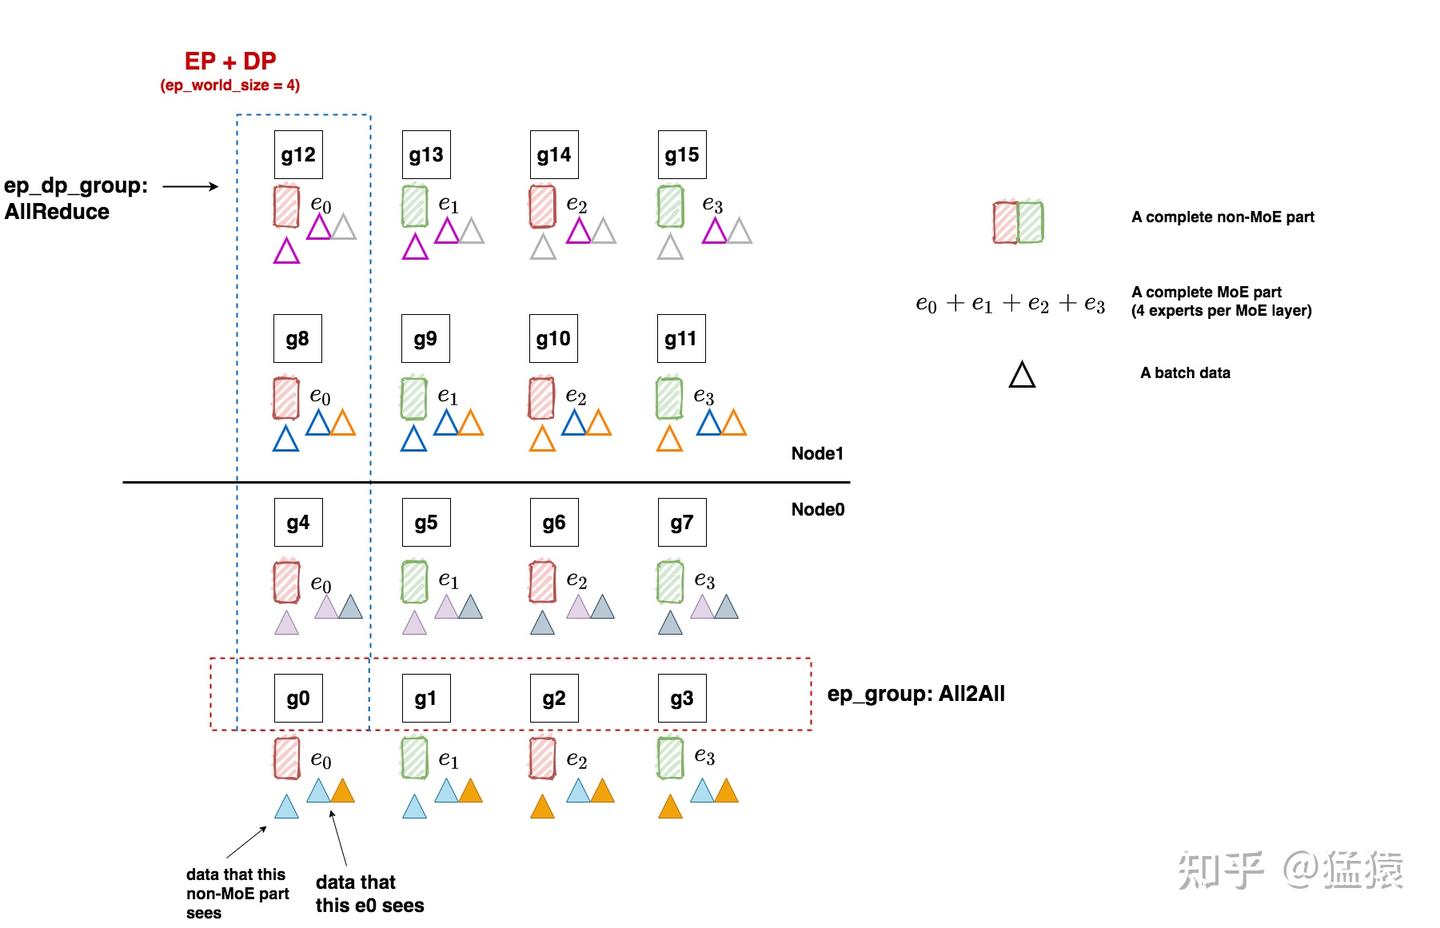
FWD - non-MoE(Attention)层
- 整个 batch 被 DP 组切分(如 8 卡 DP 组,每卡持有 1/8 batch),数据维度为
(B/8, S, D); - 同一 TP 组内(如
[g0,g1])的 2 卡,按张量并行切分 Attention 层权重,分别计算后通过通信合并结果 - 最终,同一 TP 组内的所有 GPU 输出完全一致(“三角形颜色分布不变”)
- non-MoE 层输出仍为
(B/8, S, D),直接传递到 MoE 层,且 TP 组内各卡数据无差异
- 整个 batch 被 DP 组切分(如 8 卡 DP 组,每卡持有 1/8 batch),数据维度为
-
FWD - MoE 层(核心是 EP 组的 All2All 通讯)
- 数据来到 MoE 层,此时 MoE 层输入已被规整为
(E, C, M)(E = 专家数,C = 容量,M = 特征维度),门控网络已为每个 token 分配好目标专家(如 top-2) - EP 组 All2All 通讯(token 分发):
- EP 组作用:同一 EP 组内(如
[g0,g1,g2,g3])的 4 卡,分别承载e0/e1/e2/e3专家; - 各 GPU 将分配给其他专家的 token,通过 All2All 发送到对应专家的 GPU(如 g0 把分配给 e1 的 token 发给 g1,g1 把分配给 e0 的 token 发给 g0);
- 通讯后,每个 GPU 只保留分配给自身专家的 token(如 g0 只留 e0 的 token),此时单个专家(如 e0)会收到 EP 组内所有 GPU 发来的、分配给 e0 的 token(对应 “e0 见过蓝色 + 橘色两个 batch”);
- EP 组作用:同一 EP 组内(如
- 专家计算:每个 GPU 上的专家(如 g0 的 e0)仅计算自身收到的 token,输出维度仍为
(N, M)(N 为该专家收到的 token 数) - EP 组反向 All2All 通讯(结果回传):
- 各专家将计算后的 token 结果,通过 All2All 发回原 GPU;
- 原 GPU 汇总所有分配给自身 token 的专家结果(top-2 加权),恢复维度为
(B/8, S, D);
- 数据来到 MoE 层,此时 MoE 层输入已被规整为
-
BWD(反向传播)- 先 MoE 层,后 non-MoE 层
- MoE 层梯度计算:
- 每个 GPU 先计算自身专家(如 g0 的 e0)的梯度,维度为专家权重的梯度维度
- EP-DP 组作用:同一专家(如 e0)分布在 EP-DP 组的 4 卡上(
[g0,g4,g8,g12]),需聚合这 4 卡的梯度 → 再结合其他 EP 组的 e0(共 8 卡),通过 EP-DP 组的AllReduce通讯,聚合所有 8 卡的 e0 梯度; - 聚合后的梯度用于更新 e0 专家的权重(这就是你说的 “allreduce 8 个 batch 的梯度更新 e0”);
- 同理,e1/e2/e3 分别在各自的 EP-DP 组内做 AllReduce 聚合梯度
- non-MoE 层梯度计算:
- MoE 层梯度回传到 non-MoE 层后,按 TP+DP 并行的常规逻辑处理(如 TP 组内通信拆分 / 合并梯度,DP 组内 AllReduce 聚合梯度),这部分和 Megatron 通用逻辑一致,无需额外说明
- MoE 层梯度计算:
All2All
-
图例
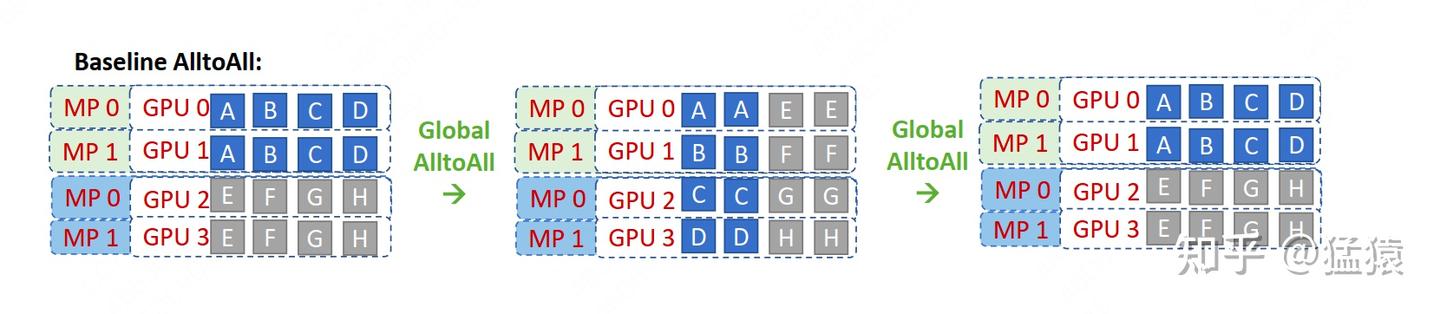
-
图中的 MP 在 DeepSpeed 语境下等价于 TP(即 MP = TP),对应的分布式通信组如下:
- tp_group:
[[g0, g1], [g2, g3]] - ep_group:
[[g0, g1, g2, g3]],表示四张卡上分别存放专家 e0、e1、e2、e3
- tp_group:
-
先看最左侧的图
- 它描述的是数据刚经过 non-MoE 层(Attention 层)后的状态
- 由于 TP 组内执行了 AllReduce,g0 与 g1 上的数据完全一致(均为 ABCD),g2 与 g3 上的数据也完全一致(均为 EFGH)
- 以
[g0, g1]这个 TP 组为例,共有 4 个专家,因此数据被切分为 A、B、C、D 四块,每块形状为(C, M),四块整体形状为(E, C, M) - 其中:A 应送往 e0,B 应送往 e1,依此类推
-
再看中间的图:它展示了 ep_group 内第一次 All2All 的过程
- 这一步的目的是把对应 token 发送到目标 expert 所在的卡上进行计算
- 可以发现:All2All 操作本质上等价于一次矩阵转置(对比左图与中图的数据块排布即可看出)
- 通过 All2All,数据块被分发到对应专家:AE 到 e0,BF 到 e1,依此类推
- 要实现这种转置,必须在 non-MoE 层之后提前对数据分块、排序,使其按目标专家的位置排布。这也正是分块排序的意义所在
-
最后看右侧的图:它展示了 ep_group 内第二次 All2All 的过程
- 这一步的目的是将 MoE 层计算完成的 token 送回原 TP 组对应的显卡,原理与前一次 All2All 一致
-
整套流程可以正常运行,但仍有优化空间
-
例如:同一 TP 组内的 g0、g1 持有完全相同的数据,在 All2All 过程中会被重复发送、重复计算,是否可以对这部分冗余通信与计算进行优化?
-
改进 All2All
-
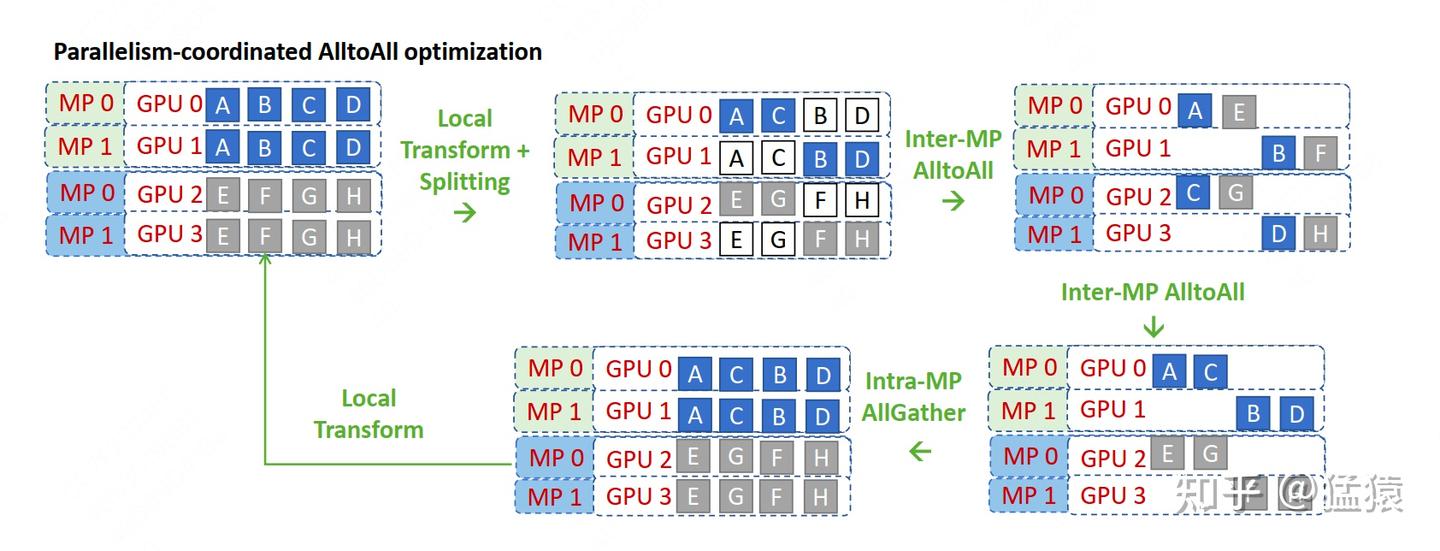
为了解决 TP 组内数据重复发送的问题,DeepSpeed 在论文中提出了一种改进版 All2All 算法
-
需要特别说明的是:DeepSpeed 的实际代码实现并没有完全严格遵循论文中的改进算法,只是在思路上借鉴了其核心思想
-
DeepSpeed 改进版 All2All 核心思想
- 既然问题出在 TP 组内多张卡持有完全相同的数据,导致 All2All 时出现大量冗余通信,那么最直接的思路就是:
- 在 TP 组内做数据切分,让每张卡只维护不重复的局部数据
- 以之前的配置为例:
- 原 TP 组:
[g0, g1]、[g2, g3] - 原本 g0 上有完整数据 ABCD,g1 上也有完整数据 ABCD
- 原 TP 组:
- 改进方案直接做数据裁剪:
- g0 只保留 AB,砍掉 CD
- g1 只保留 CD,砍掉 AB
- 其他 TP 组同理
- 这样一来,每张卡上只保留 2 个数据块,且组内无重复,从根源上消除了冗余
-
但随之而来一个新问题:
- 标准 All2All 要求每张卡上的数据块数量 = 通信域内的卡数
- 现在每张卡只有 2 块数据,而原 EP 组有 4 张卡,直接做 All2All 会不匹配
-
解决方案:重新划分 All2All 通信域
- 既然每张卡只剩 2 块数据,那就把 All2All 通信域也一分为二,每个新组只包含 2 张卡,这样数据块数量与卡数就能对齐
- 新的 All2All 组该如何划分?最简单且优雅的方式是:将 TP rank 相同的卡,组成新的 All2All 通信域
- 例如:
- g0 和 g2 的 TP rank 都是 0 → 组成一个 All2All 组
- g1 和 g3 的 TP rank 都是 1 → 组成另一个 All2All 组
- 于是只需要在
[g0, g2]和[g1, g3]内部分别执行 All2All 即可
-
这也是示意图中需要对 CB、FG 做位置交换的原因:为这种按 TP rank 划分的 All2All 做数据排布准备
-
至于另一种划分方式,比如
[g0, g3]、[g1, g2]并交换 CD、GH,理论上可行,但在代码实现上不够简洁优雅,远不如按相同 TP rank 分组直观高效 -
理解了这套流程,再回头看示意图就会一目了然:
- Local Transform:为改进版 All2All 做数据准备与重排
- 两次 All2All:分别在新的小通信域内完成 token 的分发与回收
- 最后 All-Gather:TP 组内做全局聚合,保证每张卡输出一致,以便继续后续的 non-MoE 层计算
-
原本是 4 卡全局 All2All,现在要拆成 2 卡小分组 All2All—— 这相当于直接破坏了预先设置好的
ep_group(专家并行组);如果真按这个思路改代码,需要调整的通信域、数据流转逻辑会非常多,改动成本太高 -
有么有方法既能保留 4 卡
ep_group做全局 All2All,又能避免 TP 组内重复发送数据? -
回顾每张卡输出数据的维度:
(E, C, M)(E 为专家数,C 为容量,M 为特征维度),同一 TP 组内所有卡的这个维度是完全一致的 -
如果沿着容量 C,把数据切分成 TP 并行度(tp_world_size)份,让 TP 组内每张卡只保留其中 1 份,其余部分直接舍弃 —— 这样既保证了 TP 组内每张卡的数据无重复,又能复用原来的 4 卡
ep_group做全局 All2All -
等两次 All2All(token 分发 + 回收)完成后,再通过一次
all-gather操作,把 TP 组内各卡的分片数据合并成完整的(E, C, M)维度即可 -
这就是 DeepSpeed 在代码实现中真正采用的方案
-
DeepSpeed 代码里把这个「沿 C 维度切分舍弃数据」的操作叫做
drop_tokens,一定要和 MoE 理论中「根据门控分数丢弃低优先级 token」的drop token区分开 —— 两者名称相似,但逻辑和目的完全不同
EP+TP+DP
-
现在考虑对专家也进行 TP 切分
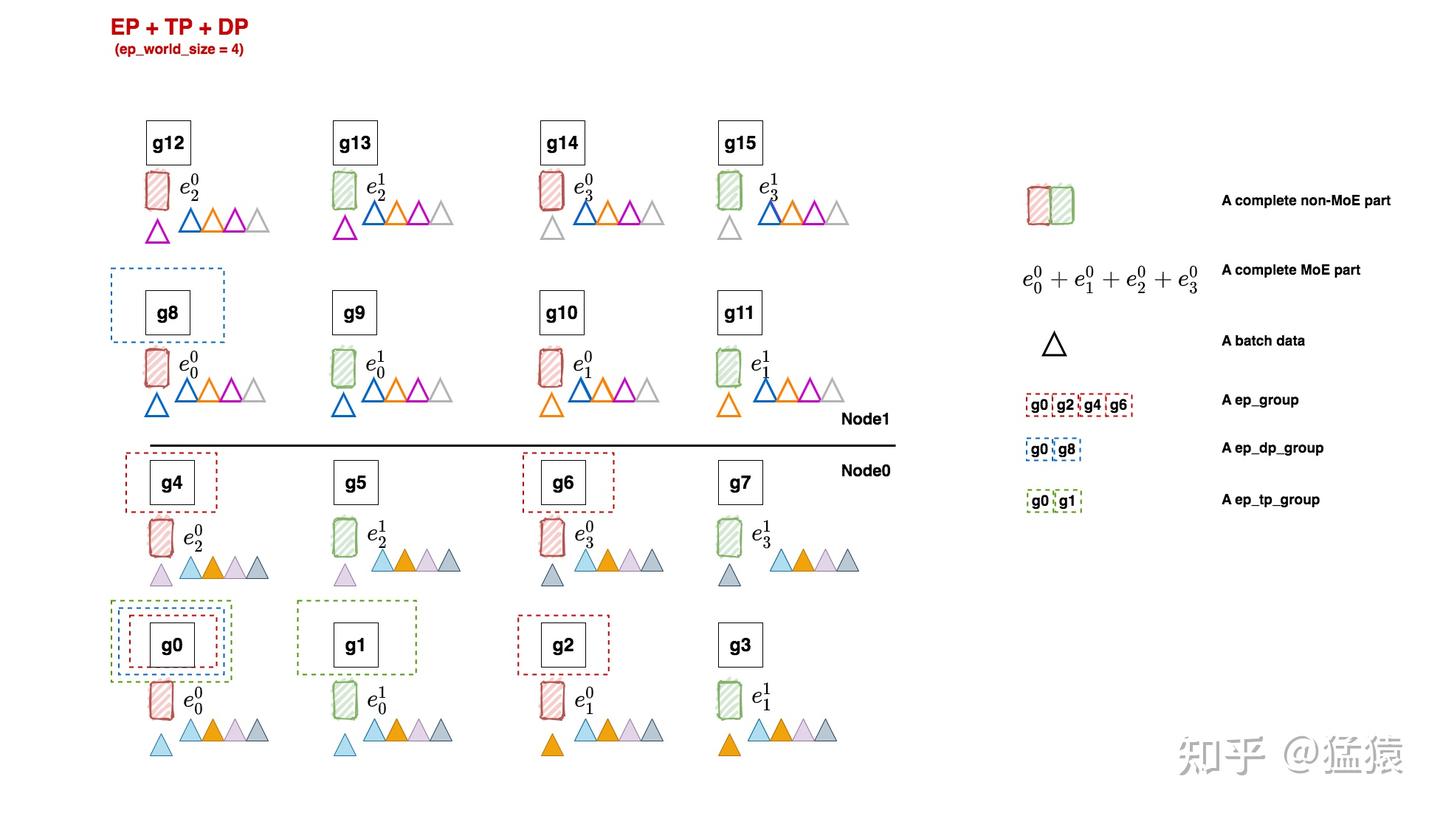
-
显然,此时的并行分组情况
ep_world_size = 4,保持和3.1一致 ep_groups = [ [g0, g2, g4, g6], [g1, g3, g5, g7], [g8, g10, g12, g14], [g9, g11, g13, g15] ] ep_dp_world_size = 2 ep_dp_groups = [ [g0, g8], [g1, g9], [g2, g10], [g3, g11], [g4, g12], [g5, g13], [g6, g14], [g7, g15] ] -
关于完整的 ep_group
- 前面提到,每个
ep_groups中的单个ep_group要装下一套「完整的」专家 - DeepSpeed 中的「完整」:即便
ep_group内的每个专家参数是被纵向切分(按维度分片)存储的,只要这个ep_group覆盖了所有专家(而非部分专家),就认为是「完整的」 - Megatron 中的「完整」:「完整」的核心是参数完整 —— 必须集齐所有卡(比如 g0~g7),让每张卡持有某专家的完整参数,且所有专家都被包含在内,才会被认定为一个
ep_group
- 前面提到,每个
-
定义不同,直接导致
ep_group内的通信方式天差地别:- DeepSpeed 基于自身的「完整」定义,在
ep_group内执行 All2All 完成 token 与专家的匹配分发; - Megatron 则基于参数完整的定义,在
ep_group内用 ReduceScatter + AllGather 替代 All2All(事实上 Megatron 的 MoE 实现全程没有用到 All2All) - DeepSpeed 的
ep_group设计更优 —— 不仅从操作逻辑上更符合「专家并行」的直觉认知(All2All 直接完成 token 到对应专家的分发),还能从根源上避免重复数据发送;而 Megatron 的实现方式会产生大量冗余数据传输,通信效率更低
- DeepSpeed 基于自身的「完整」定义,在
-
步骤 1:Non-MoE 层计算
- 数据首先经过 Non-MoE 层(如 Attention 层)
- 由于开启了 TP(张量并行),同一 TP 组内的所有卡输出数据完全一致 —— 这也是图中把相同颜色三角形标注在对应 Non-MoE 参数块下的原因
-
步骤 2:MoE 层计算(第一次 All2All + TP AllReduce)
- 数据进入 MoE 层后,首先执行「token 分发」
- 两个独立的 ep_group(
[g0, g2, g4, g6]和[g1, g3, g5, g7])内各自执行一次 All2All,将不同 token 分发到对应 expert 所在的卡上完成计算 - 由于 MoE 层也采用 TP 并行,计算完成后,
[g0, g1]、[g2, g3]、[g4, g5]、[g6, g7]这些 TP 组会各自执行 AllReduce,聚合得到该 TP 组内完整的 MoE 层输出结果
-
步骤 3:MoE 层结果回传(第二次 All2All)
- 完成 expert 计算后,两个 ep_group(
[g0, g2, g4, g6]、[g1, g3, g5, g7])会再执行一次 All2All,将计算完毕的 token 数据回传给原卡,确保数据能继续进入下一轮「Non-MoE → MoE」的计算流程
- 完成 expert 计算后,两个 ep_group(
-
反向传播(BWD)阶段
-
步骤 1:MoE 层梯度聚合(EP-DP 组 AllReduce)
- 反向数据首先流经 MoE 层,核心是「expert 参数梯度同步」:
- 同一 ep_dp_group 内的卡需要对 expert 梯度执行 AllReduce(例如图中的
[g0, g8]) - 这个 ep_dp_group 维护着相同的 expert(e),其中每个卡上的 expert 各自处理过 4 个 batch 的数据,聚合后刚好覆盖全局 8 个 batch 的梯度 —— 这也契合分布式训练「分片计算、全局聚合」的核心目标
-
步骤 2:Non-MoE 层梯度回传
- 梯度继续回传到 Non-MoE 层,此时进入「TP + DP(数据并行)」反向流程:按 TP 组做梯度分片通信、DP 组做梯度同步即可
专家并行的难点
- 专家并行的整体流程
- 本地路由
- 每个设备只对自己负责的一部分 token 计算路由决策,即判断每个 token 应该被分配给哪些专家
- 门控网络通常在所有设备上是完整复制的,以保证路由决策的一致性和局部可计算性
- All-to-All 分发
- 路由决策确定后,若某些 token 被分配到位于其他设备上的专家
- 这些 token 的隐藏状态需要通过 All-to-All 集体通信发送到对应的设备
- 并行专家计算
- 每个设备接收到属于本地专家的 token 后
- 独立执行专家网络的前向和反向计算,生成对应的输出
- All-to-All 聚合
- 专家计算完成后,token 的输出结果需要再次通过 All-to-All 通信
- 将结果发送回 token 最初所在的设备,以便继续后续模型层的计算
- 本地路由
- All-to-All 通信是专家并行的核心
- 根据门控网络的输出,每个设备都可能需要向所有其他设备发送一部分 token,同时也需要从其他设备接收属于本地专家的 token
- 这种通信模式不同于数据并行中的 All-Reduce,All-Reduce 是对称、规整的聚合通信,而 All-to-All 则是高度不规则、数据依赖路由结果的通信模式
- 由于专家选择具有稀疏性和不均匀性
- 通信通常伴随着较高的带宽需求和复杂的同步开销
- GPU 本身并非为这种高度分支化的计算模式而设计
- 频繁的跨设备数据交换往往使网络带宽成为主要性能瓶颈
- Transformer 中包含 MoE 层的前向传播典型顺序
- 输入 token 经过自注意力机制
- 输入 token 经过第一个前馈网络(FFN)的输入投影部分
- 门控网络为每个 token 计算专家分配结果
- All-to-All 通信:将 token 分发到其对应专家所在的设备
- 各专家网络对分配到的 token 执行计算
- All-to-All 通信:将专家输出的 token 发送回其原始设备
- 根据门控分数对来自不同专家的输出进行加权与聚合
- 输出 token 经过第二个 FFN 层(输出投影)
- 输出 token 进入下一层计算(如 LayerNorm、残差连接等)
- 通信与计算的重叠
- 在前向传播中,两次 All-to-All 通信(token 分发与结果回传)是最主要的重叠对象
- 在反向传播中,梯度同样需要按照路由路径返回专家,这又引入了额外的 All-to-All 通信阶段,同样可以进行重叠
- 实现通信与计算重叠的方法
- 异步通信原语
- 避免使用阻塞式通信调用,因为它们会在通信完成前停止后续执行
- 优先使用非阻塞通信接口,例如使用非阻塞的 All-to-All 变体或更底层的点对点原语,如 isend /irecv,并配合显式同步
- 典型的执行模式
- 启动非阻塞通信操作(如 handle = isend /irecv)
- 在通信进行的同时,执行不依赖通信结果的计算,例如:
- 流水线并行中后续层的计算
- 网络中并行分支或独立模块的计算
- 反向传播时,MoE 层通信之前的梯度计算
- 专家计算中可先处理本地已就绪的数据
- 在需要使用通信结果之前,通过 handle.wait () 显式等待通信完成
- 借助 CUDA 流实现更细粒度的并发
- CUDA 流提供了在 GPU 上调度并发操作的机制
- 不同流上的计算核与通信操作可能并行执行
- 通信库通常使用独立的 CUDA 流完成数据搬运和网络传输
- 通过精细管理流之间的依赖关系,可以让计算核与通信同时进行,从而最大化硬件利用率
- 这种方式通常需要框架层的深度支持或在自定义算子与通信逻辑中直接操作 CUDA 流
- 异步通信原语
工程实践
-
EP 为什么要和其他并行方式一起用
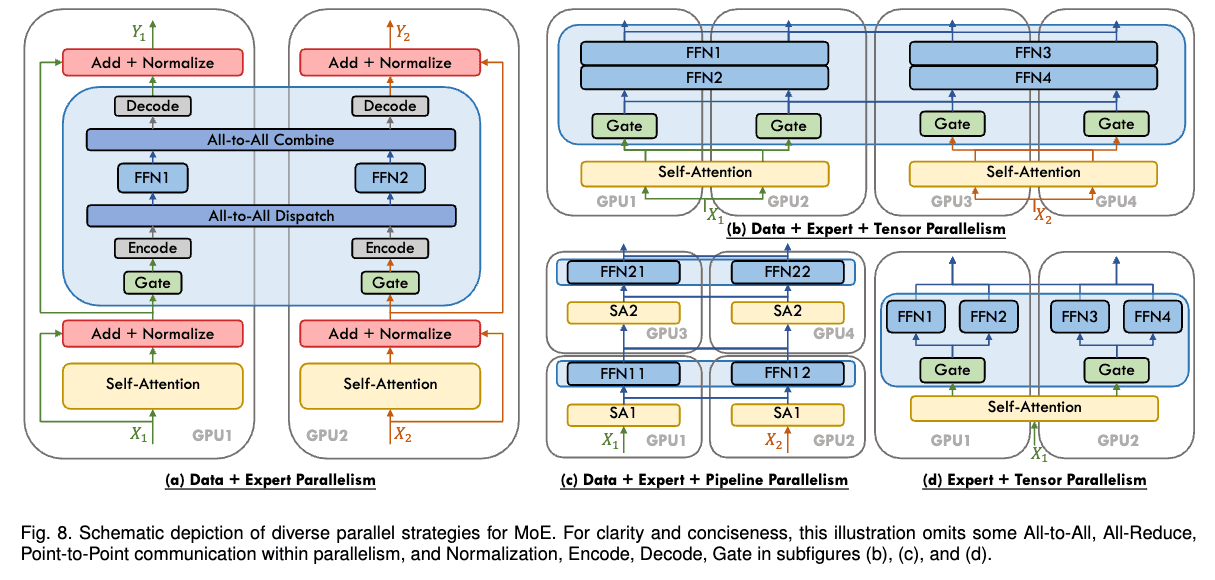
- 在实际训练中,EP 通常不会单独使用,而是与数据并行等方式结合
- 原因在于 EP 只作用于 MoE 层,对非 MoE 层(如注意力层、普通前馈层)不起作用,EP 也不会像上下文并行那样切分序列维度上的 token
- 如果只使用 EP,那么所有 GPU 仍然需要对非 MoE 模块做完全重复的计算,效率并不高
- 因此,常见做法是用 EP 在专家维度上切分 MoE 层,用 DP 在 batch 维度上切分输入数据
- 这样可以同时避免专家冗余和数据冗余
-
工程上的关键技巧
- 为了让 EP 在实践中高效运行,模型设计上通常需要配合一些约束
- 以 DeepSeek-V3 为例,路由器被限制为每个 token 最多只会被发送到 个节点,其中 ,这样做可以尽量让一个 token 的计算集中在少量节点上,减少跨节点通信带来的开销