DeepSpeed ZeRO
介绍 DeepSpeed ZeRO 的基本概念、实现方法以及在 PyTorch 中的使用方法
- 参考文档
基本思想
-
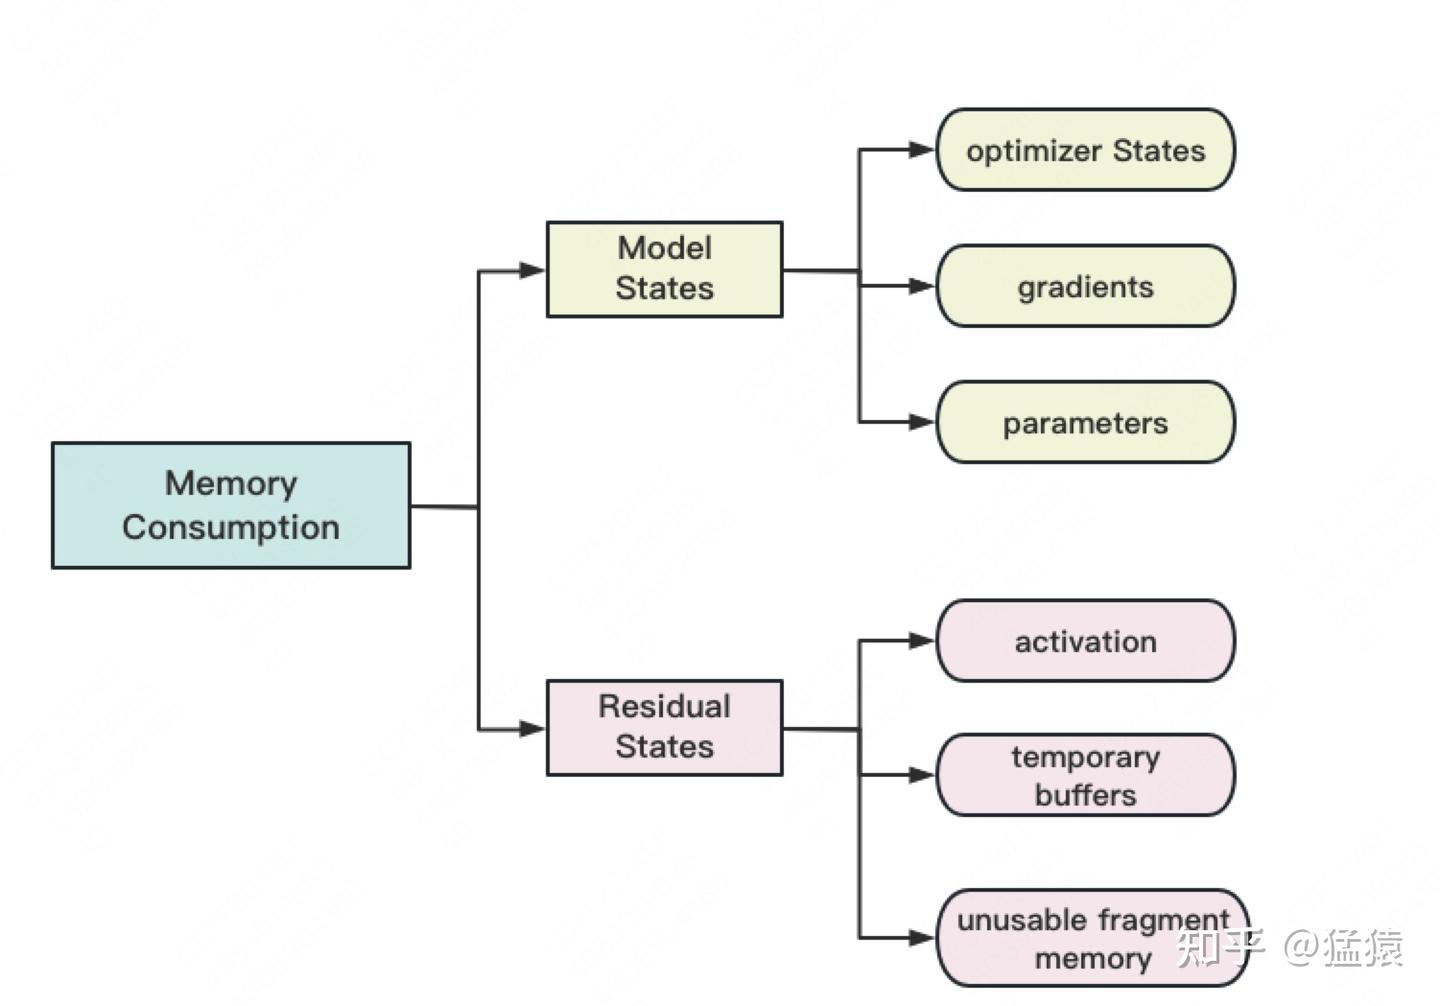
DeepSeed 将大模型训练的内存消耗模型定义如下
- 与模型本身相关的(Model States):优化器状态、梯度、模型参数
- 训练过程中产生的(Residual States):激活值、临时缓冲、碎片化空间
- 虽然总存储空间足够,但如果取不到连续的存储空间,相关的请求也会失败,对这类空间浪费可以通过内存整理来解决
-
模型显存计算(设参数 W 大小为 )
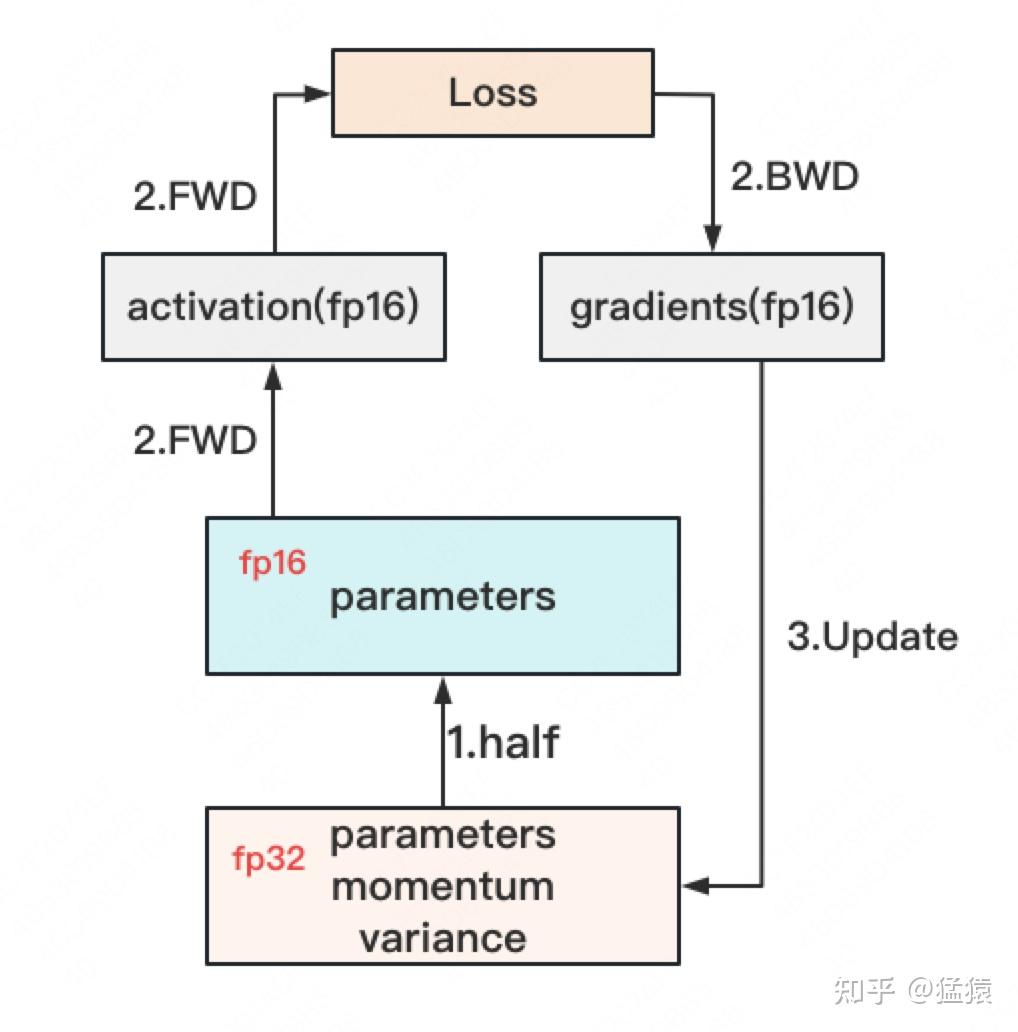
- 使用 FP32(单精度浮点数,存储占用 4 字节),或者使用 FP16/BF16(半精度浮点数,存储占用 2 字节)
- 首先存储一份 FP32 的 parameter,momentum 和 variance(统称 model states)
- 在 forward 开始之前,额外开辟一块存储空间,将 fp32 parameter 减半到 fp16 parameter
- 正常进行 forward 和 backward,在此之间产生的 activation 和 gradients 都用 fp16 进行存储
- 用 fp16 gradients 更新 fp32 下的 model states
- 当模型收敛后,fp32 的 parameter 就是最终的参数输出
-
表格计算
分类 大小 大小总计 必存 parameter (fp32) 4 12 momentum (fp32) 4 variance (fp32) 4 中间值 parameter (fp16) 2 4 gradients (fp16) 2 总计 16 -
以上计算中没有考虑激活值
- activation 不仅与模型参数相关,还与 batch size 相关
- activation 的存储不是必须的,存储 activation 只是为了在用链式法则进行 backward 的过程中,计算梯度更快一些,但也可以通过只保留最初的输入 X,重新做 forward 来得到每一层的 activation
- 因为 activation 的这种灵活性,纳入它后不方便衡量系统性能随模型增大的真实变动情况,因此在这里不考虑它
-
DP 扩展的关键误区是 “用更多 GPU 做数据并行,单卡显存会变小”
- DP 只分数据,不分模型状态,所以 GPU 数量变多,但是单卡显存不变,甚至通信更繁杂,这就是为什么 DP 无法训练超出单卡显存上限的模型
- 这就是从 DP 走向 ZeRO 的本质转折 —— 为什么所有 GPU 都要保存同一份模型状态?
-
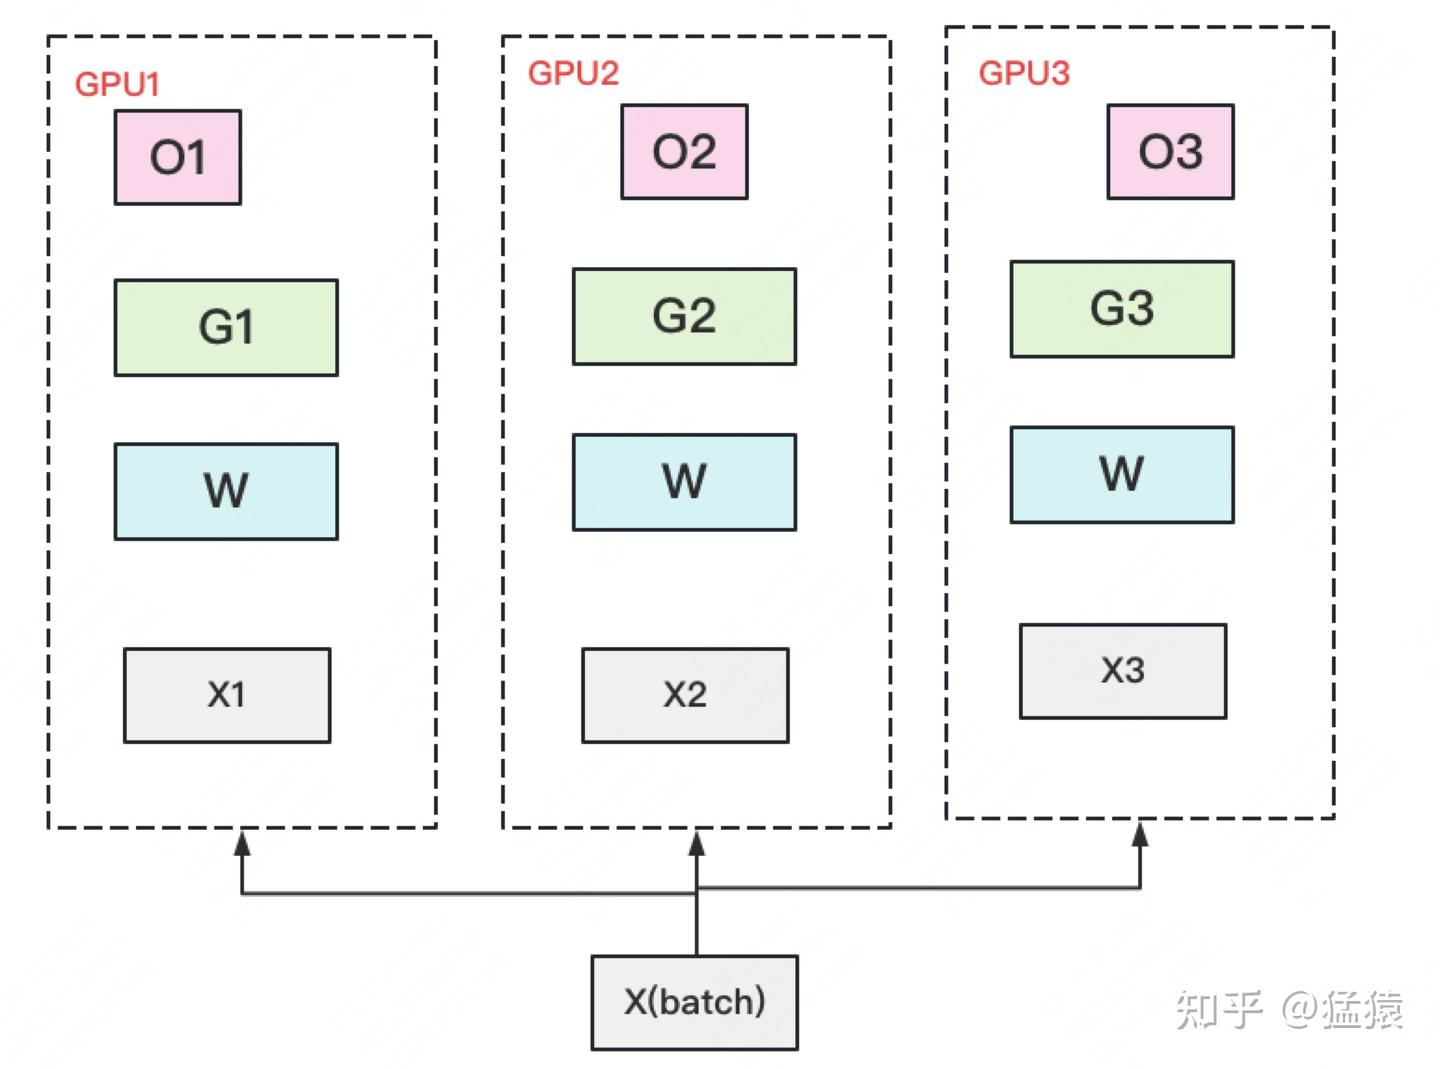
基于此,在标准数据并行中,每张 GPU 都有:
- 一份完整模型参数(W):只在进行前向传播和反向传播时使用
- 一份完整梯度(G):只在 All-Reduce 和更新参数时使用
- 一份完整 optimizer state(O):只在更新参数时使用
-
而 DeepSpeed ZeRO 的核心思想就是,将这些与模型相关的状态分片存储在各个 GPU 上
-
ZeRO 的全称是 Zero Redundancy Optimizer,指的是在数据并行组内,不再冗余存储模型状态,每个 GPU 只保留一部分
-
ZeRO 的不同阶段
- ZeRO Stage 0:标准的数据并行
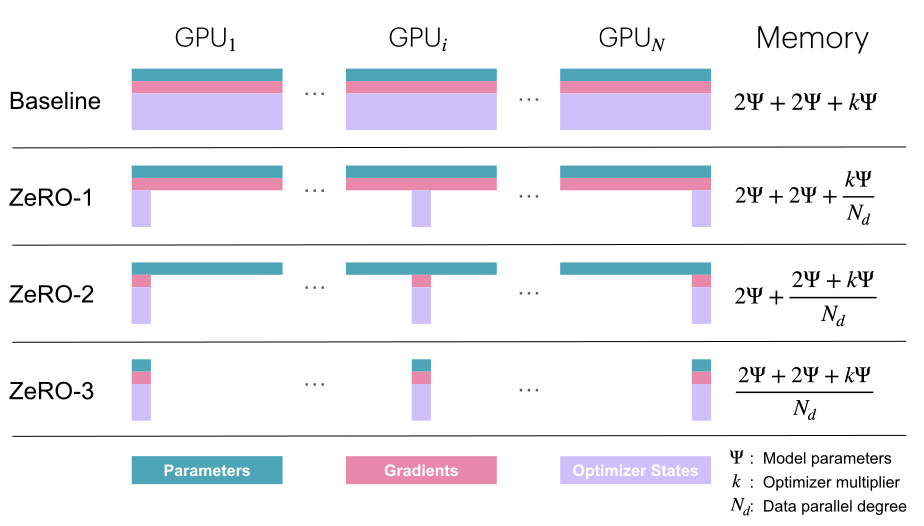
- ZeRO Stage 1:划分 optimizer state,这是由于 optimizer state 占用最大(Adam),因此 optimizer state 在 DP 组内按参数分片,每张 GPU 只保存 的 optimizer state,但参数、梯度仍然是完整的
- ZeRO Stage 2:再划分梯度,梯度也按参数分片,每张 GPU 只保存 的梯度,此时 backward 后不再做完整 all-reduce,而是 reduce-scatter + all-gather
- ZeRO Stage 3:划分参数,这是最激进的一步,参数本身也被分片,单张 GPU 上没有完整模型,在 forward /backward 时用到某一层参数就临时 all-gather,用完立刻释放
-
ZeRO 不同阶段的显存占用
- 回顾模型训练所需的显存占用
- 模型参数(半精度,即 BF16 / FP16):
- 模型梯度(半精度,即 BF16 / FP16):
- 模型参数的 FP32 主副本以及优化器状态:
- 模型梯度的 FP32 版本:(可选项,仅在需要以 FP32 累积梯度时才会存在)
- 那么 ZeRO 不同阶段对显存占用的优化如下( 表示 DP 度,即数据并行的规模)
- 回顾模型训练所需的显存占用
ZeRO Stage 1:切分优化器状态
-
基本思想
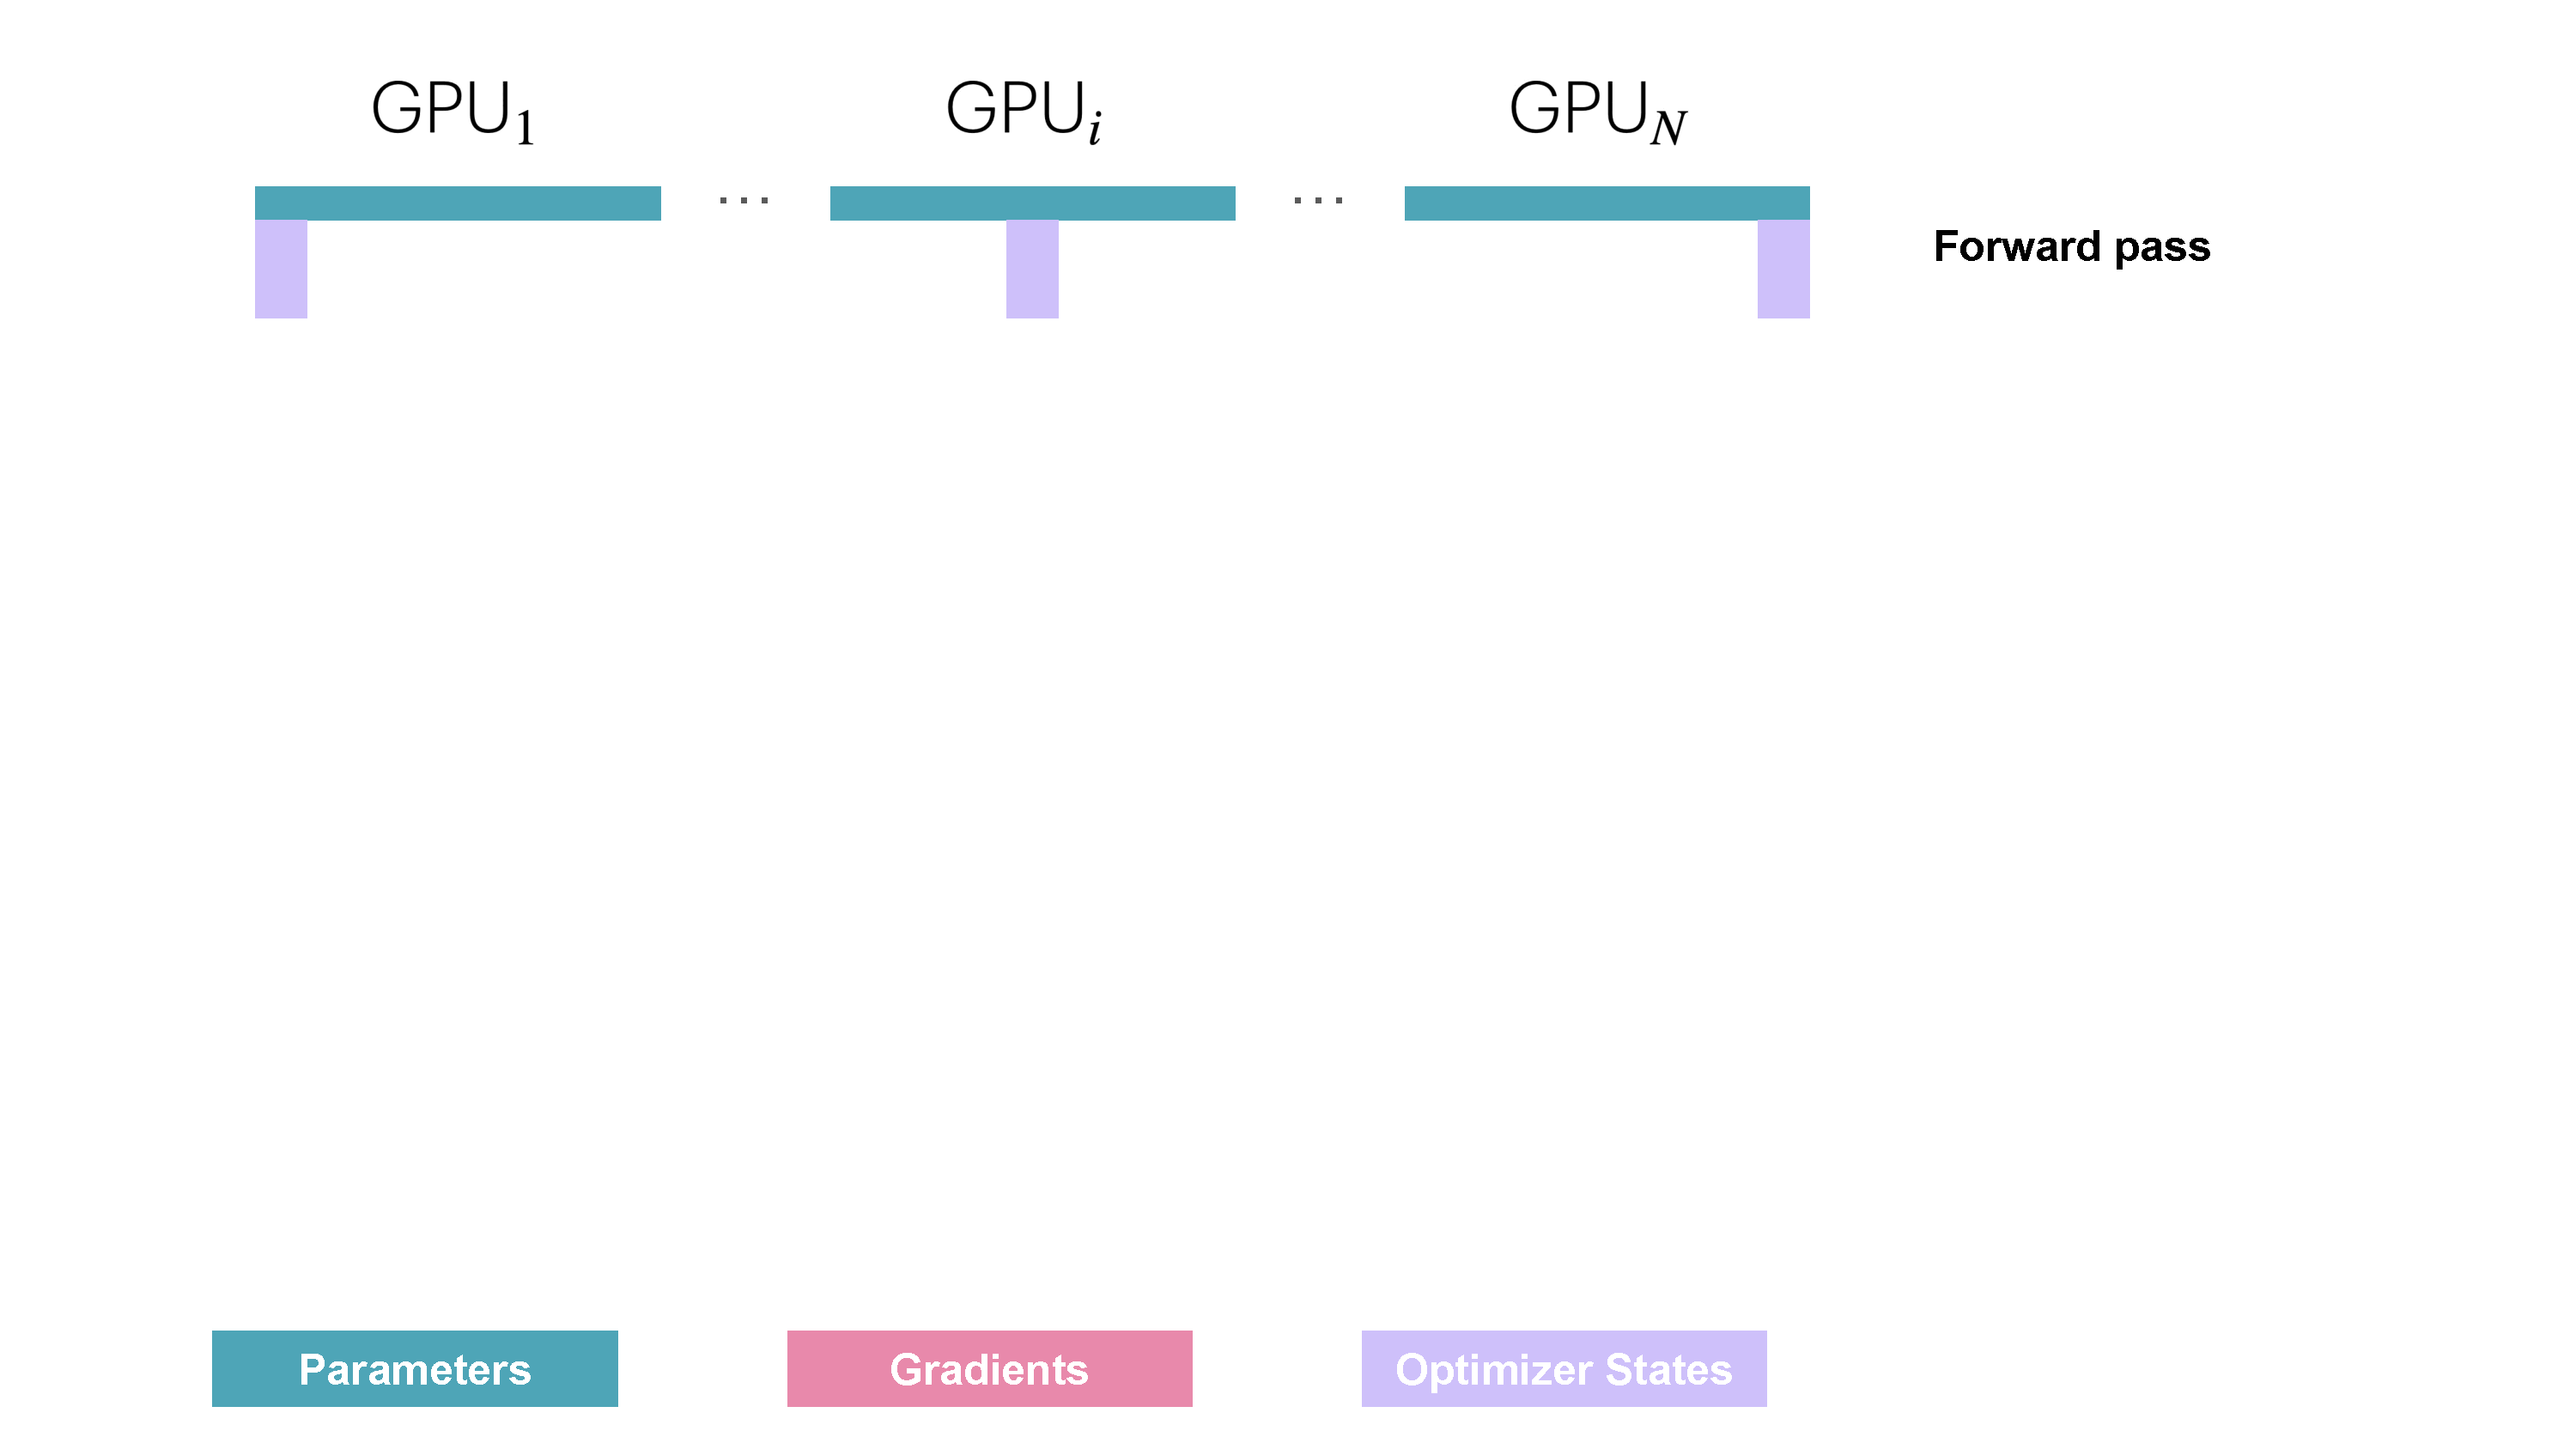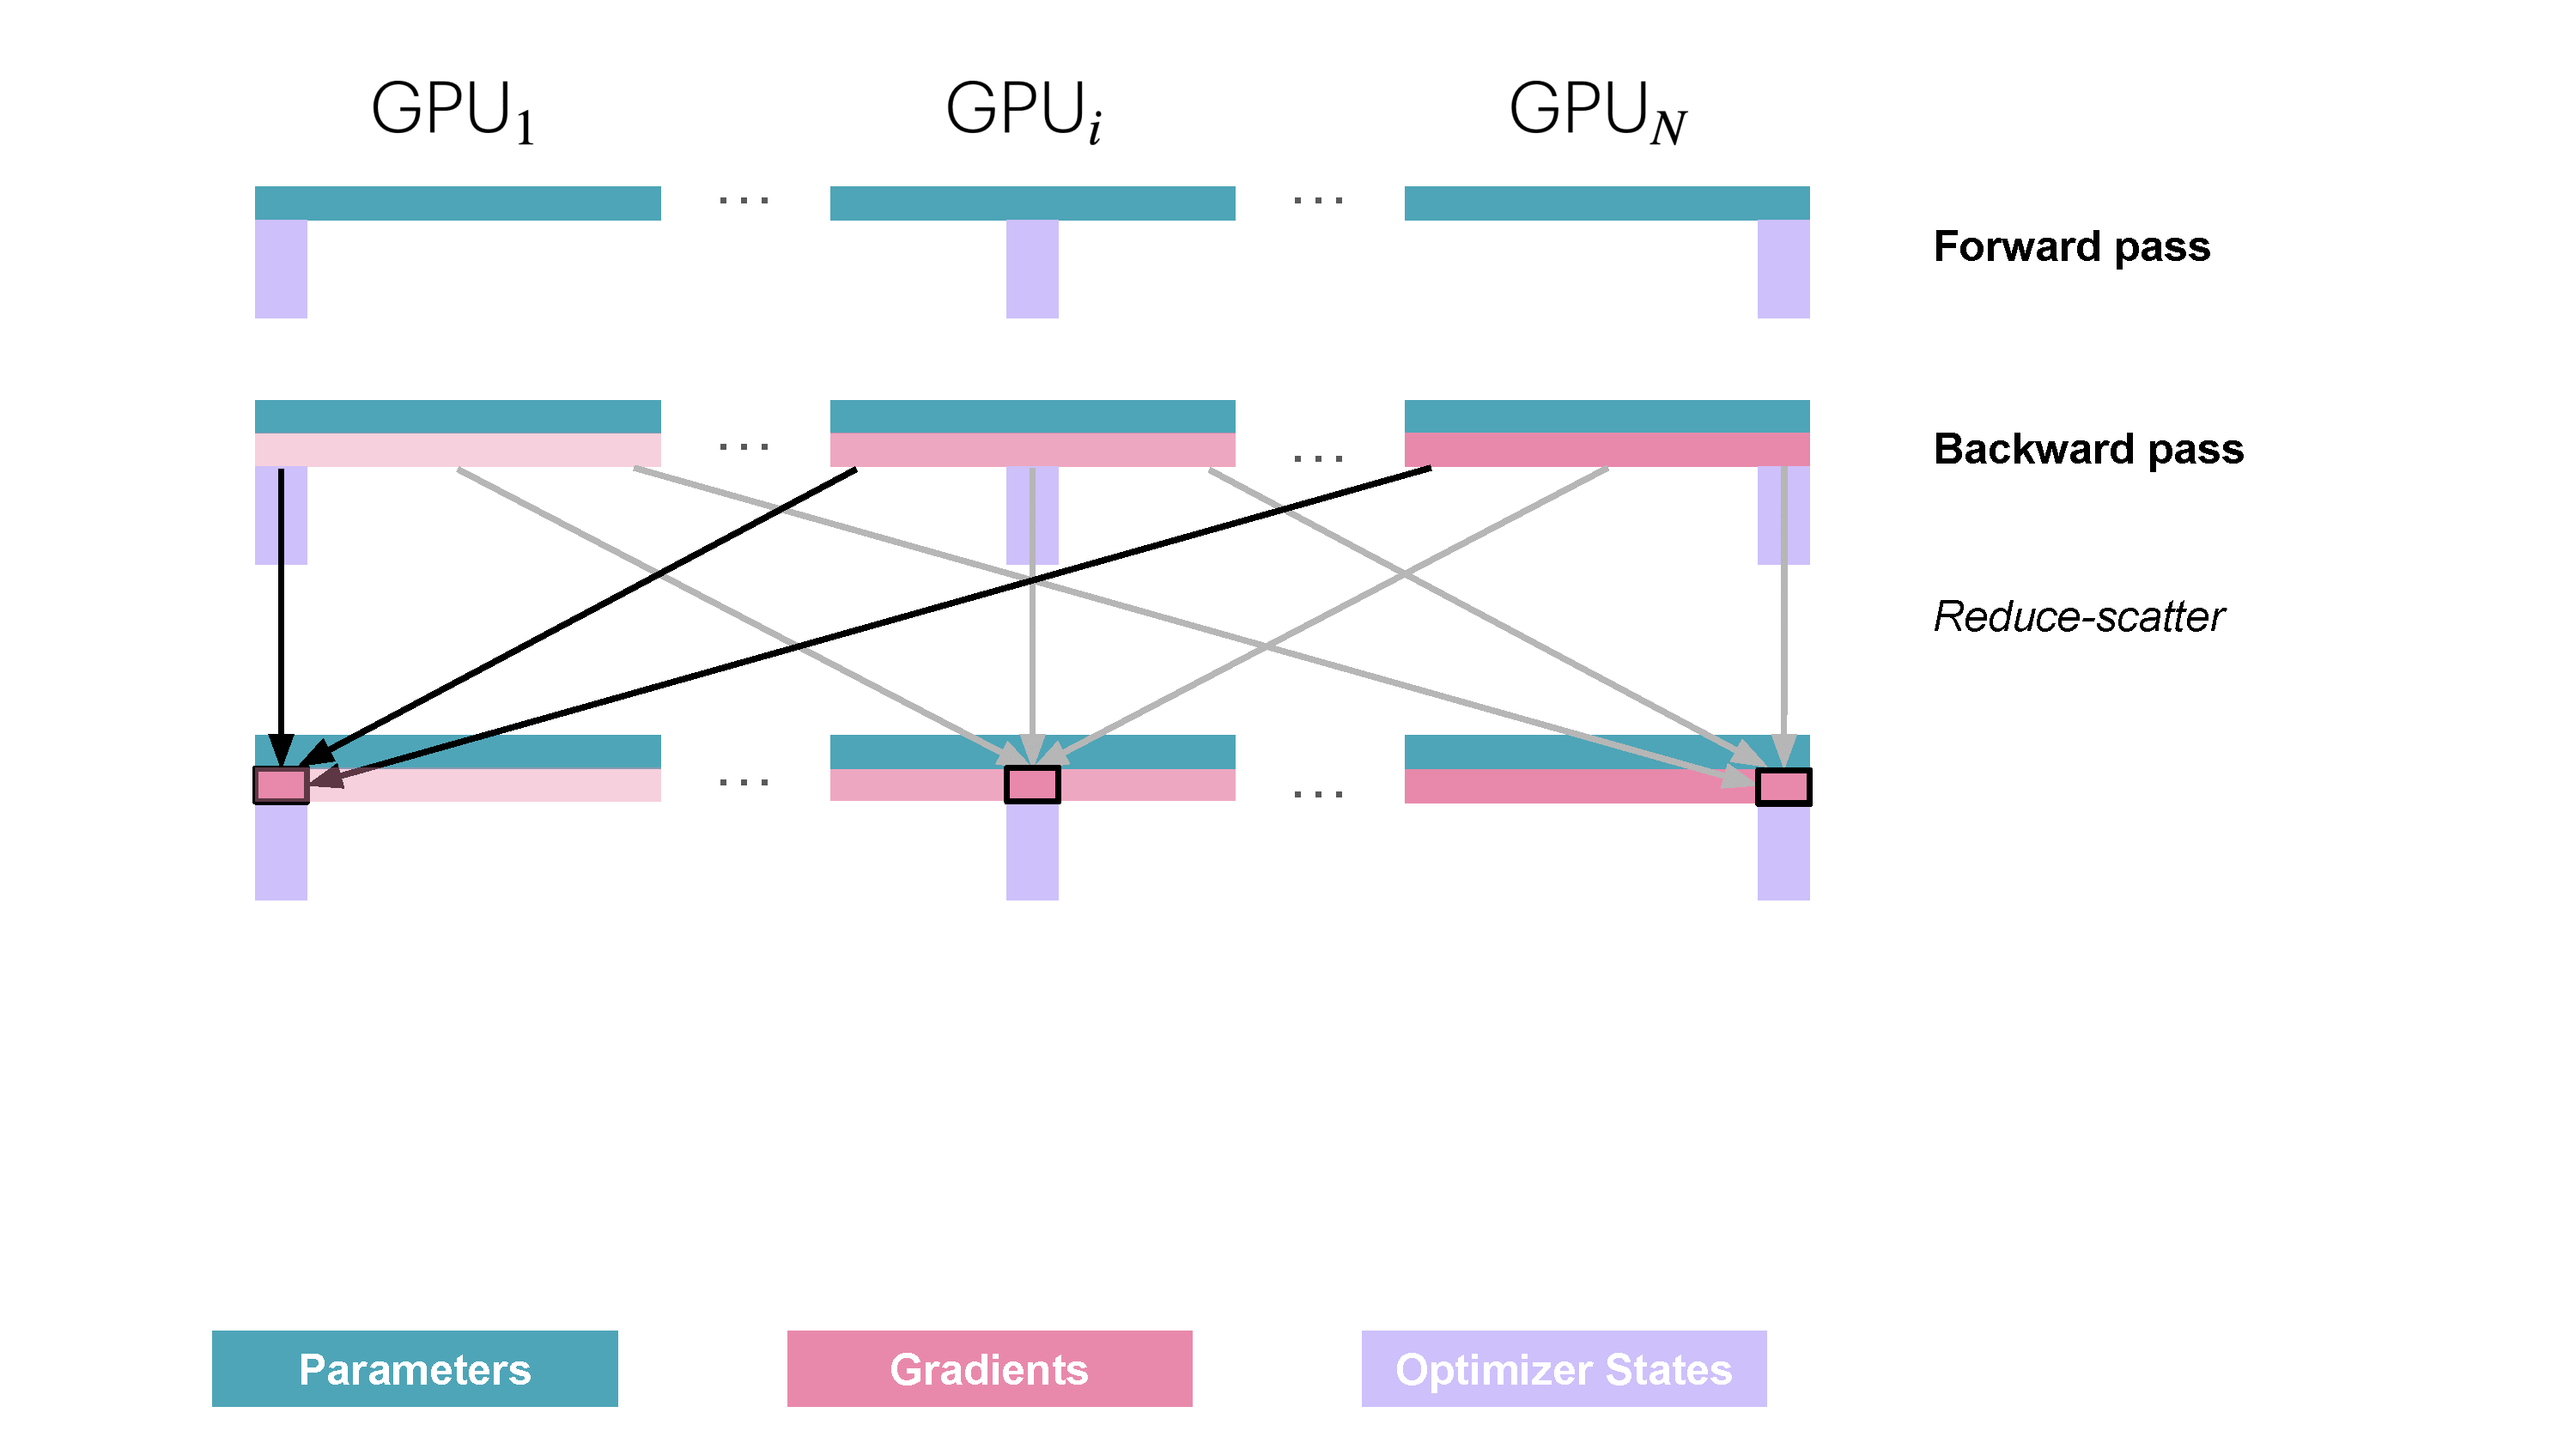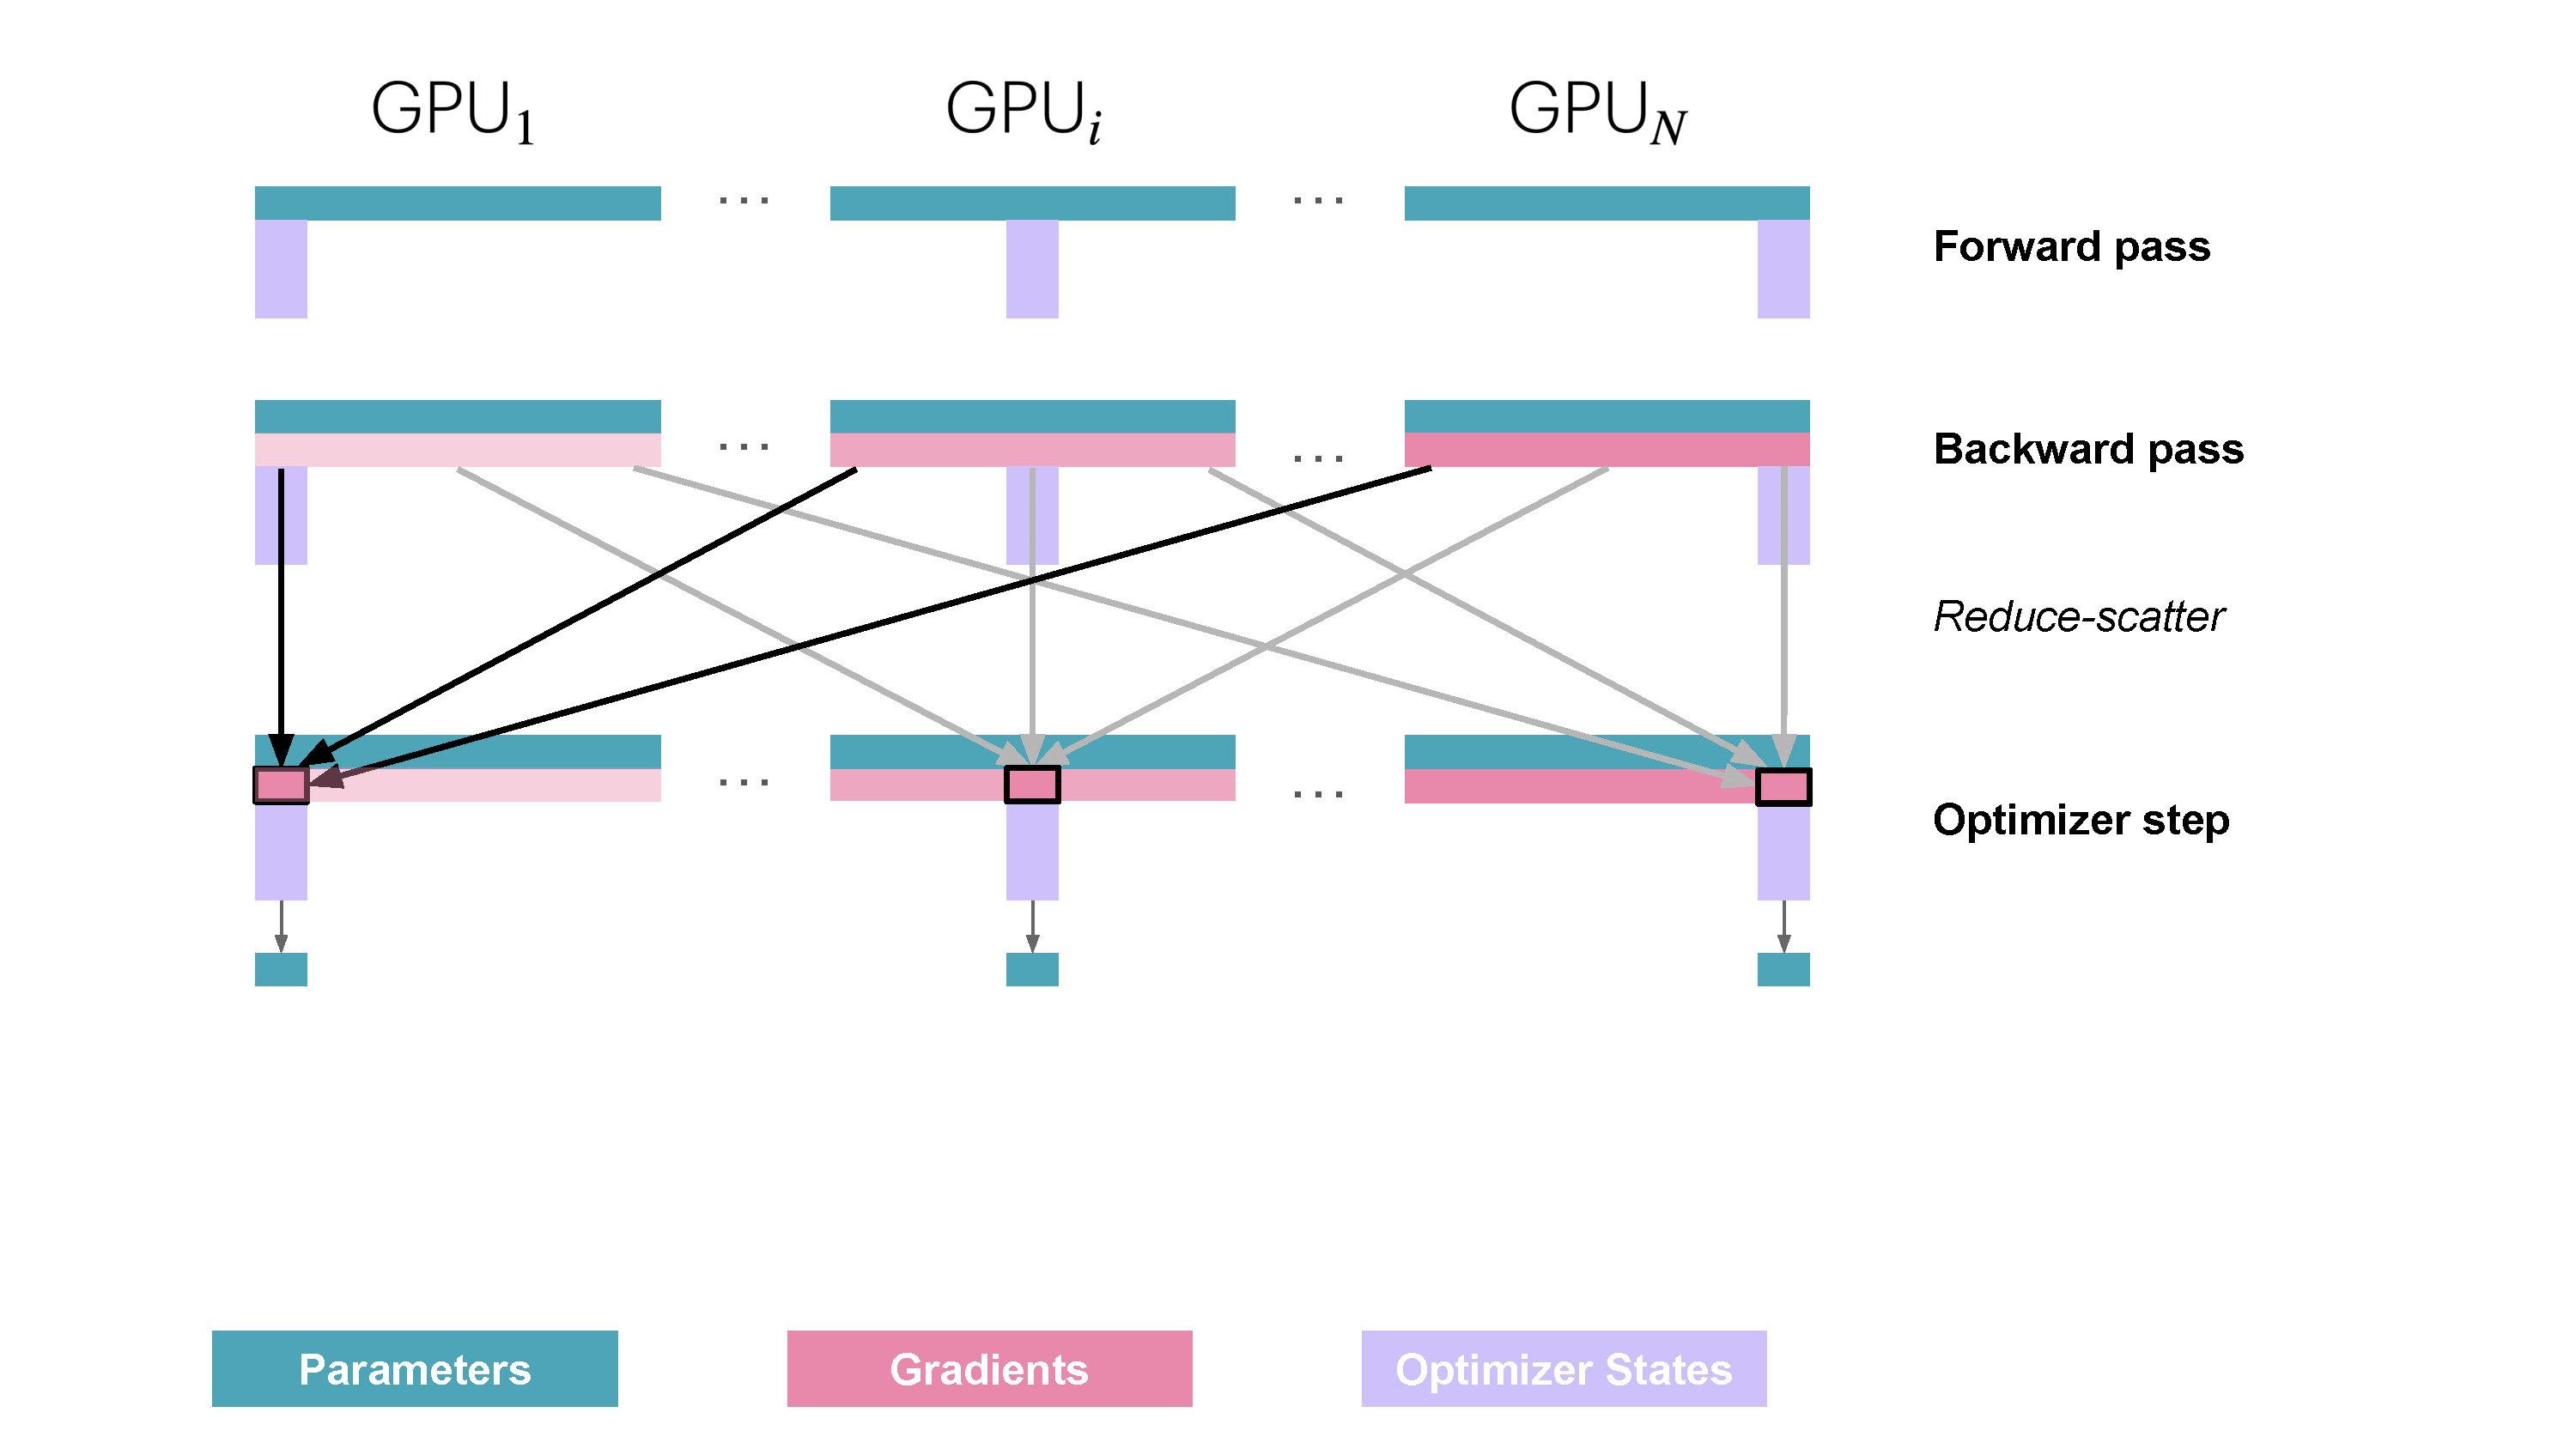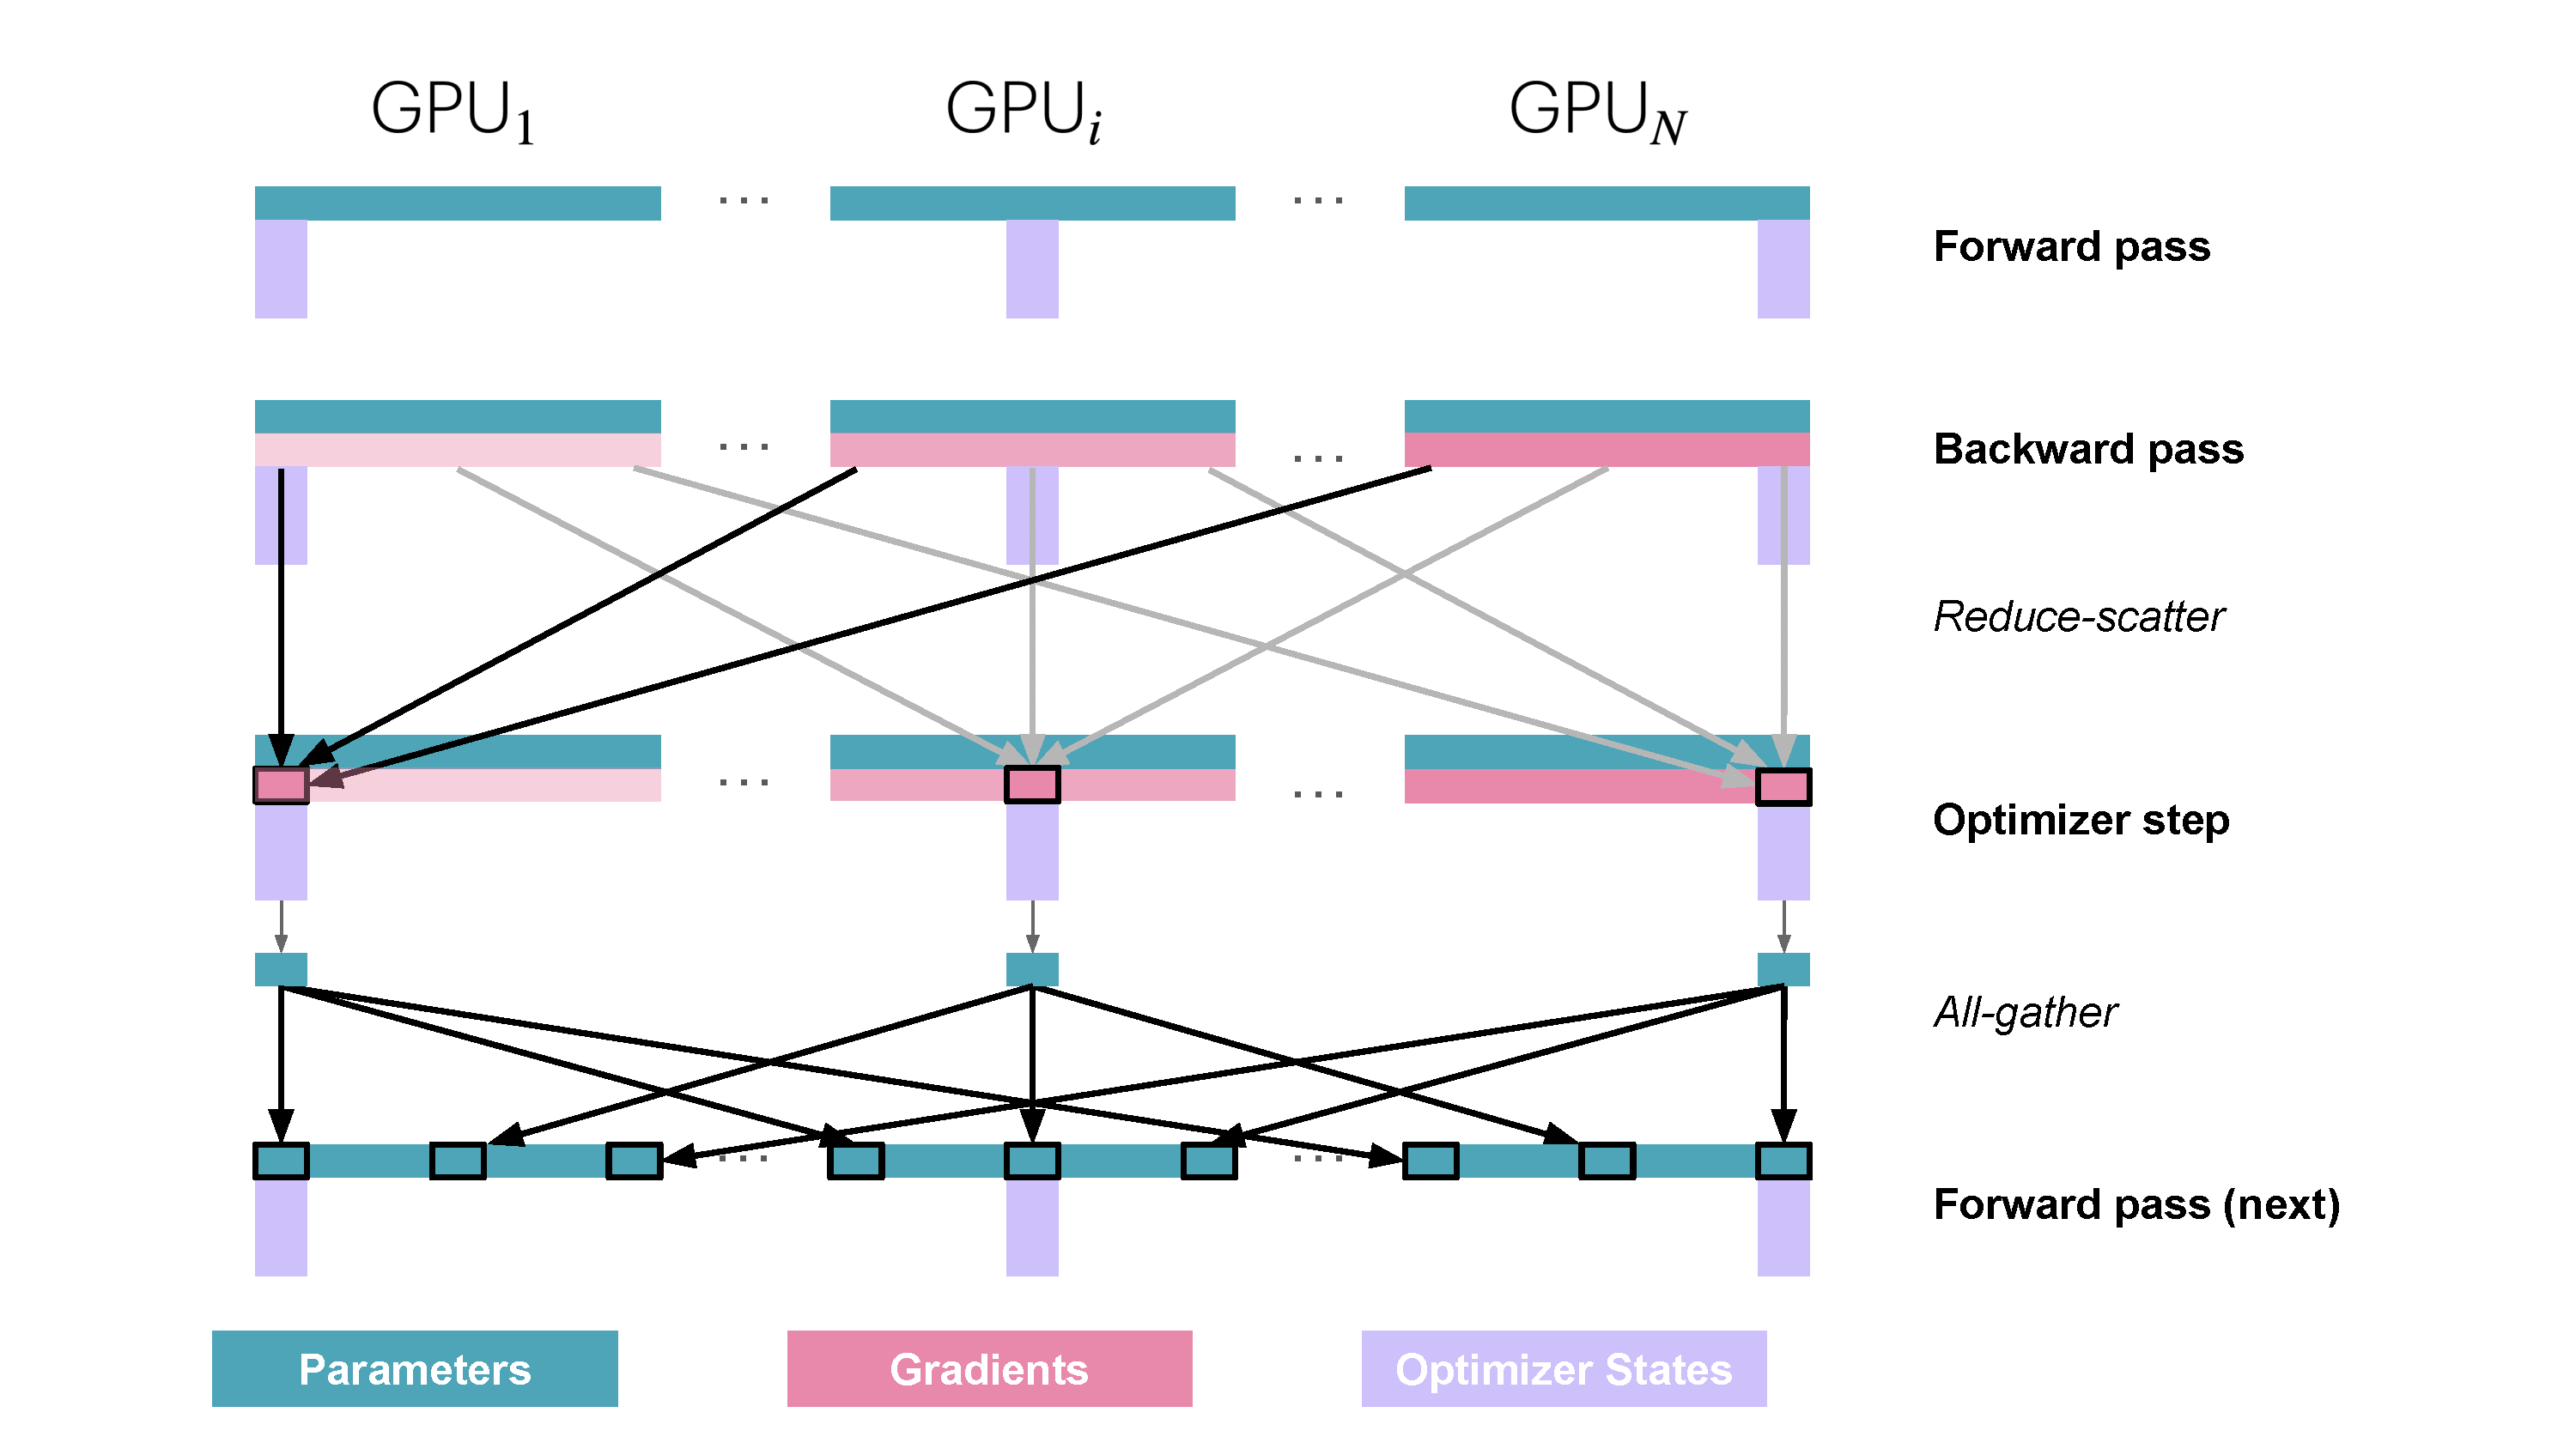
- 在普通的数据并行中,所有 DP rank 在反向传播结束后都会拿到完全相同的梯度,并且各自独立地执行一模一样的优化器更新,这显然存在大量重复计算和重复存储,那么能不能既避免这些重复工作,又同时降低显存占用?
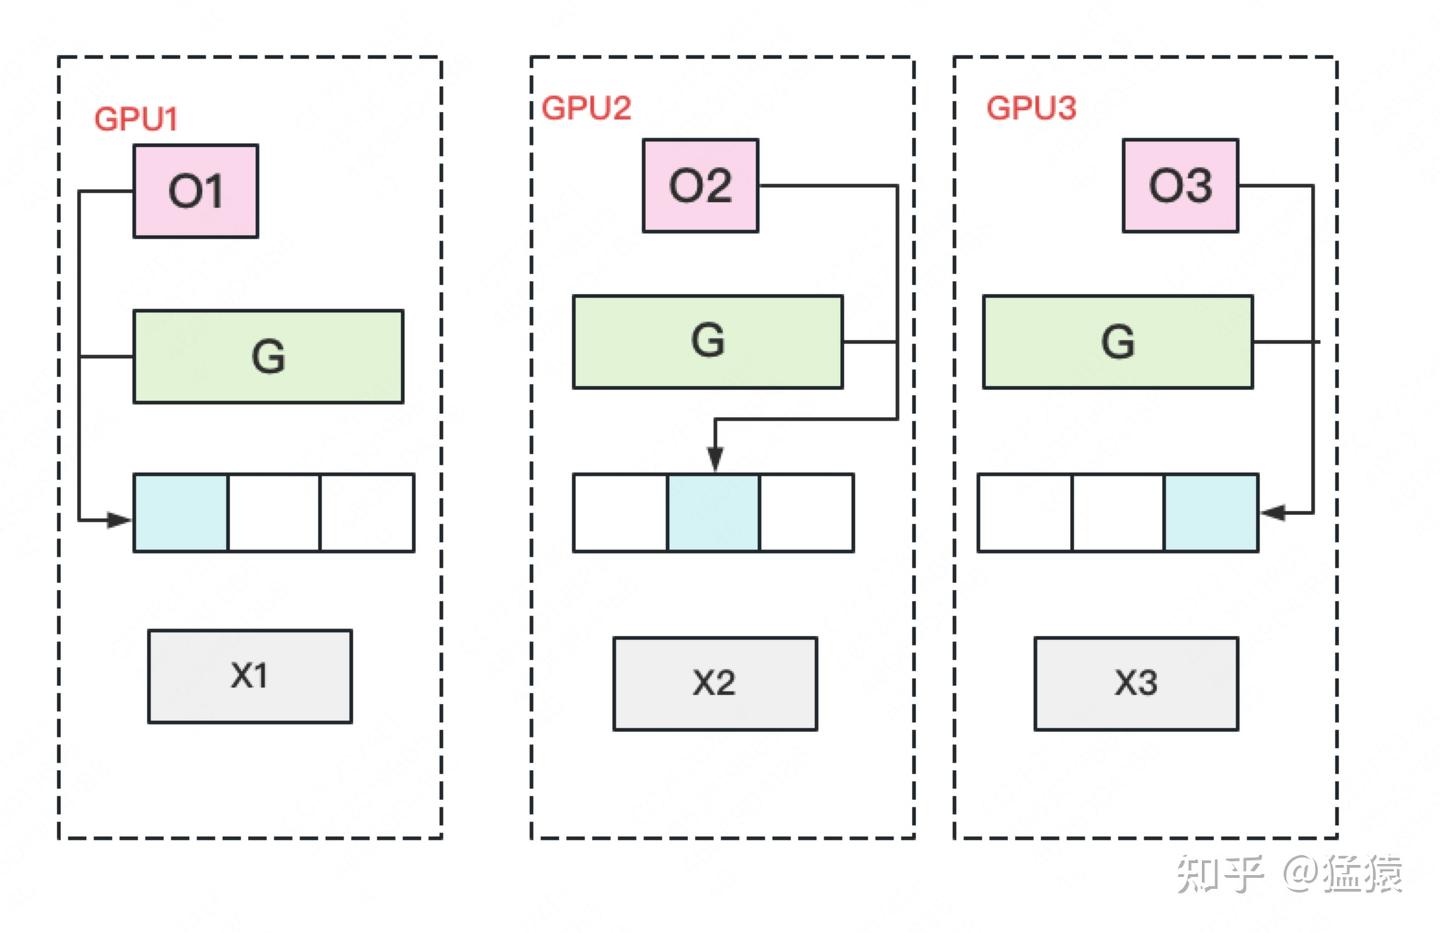
- 在 ZeRO-1 中,优化器状态(optimizer states)被切分成 份,这意味着每个 DP rank 只保存 的优化器状态
-
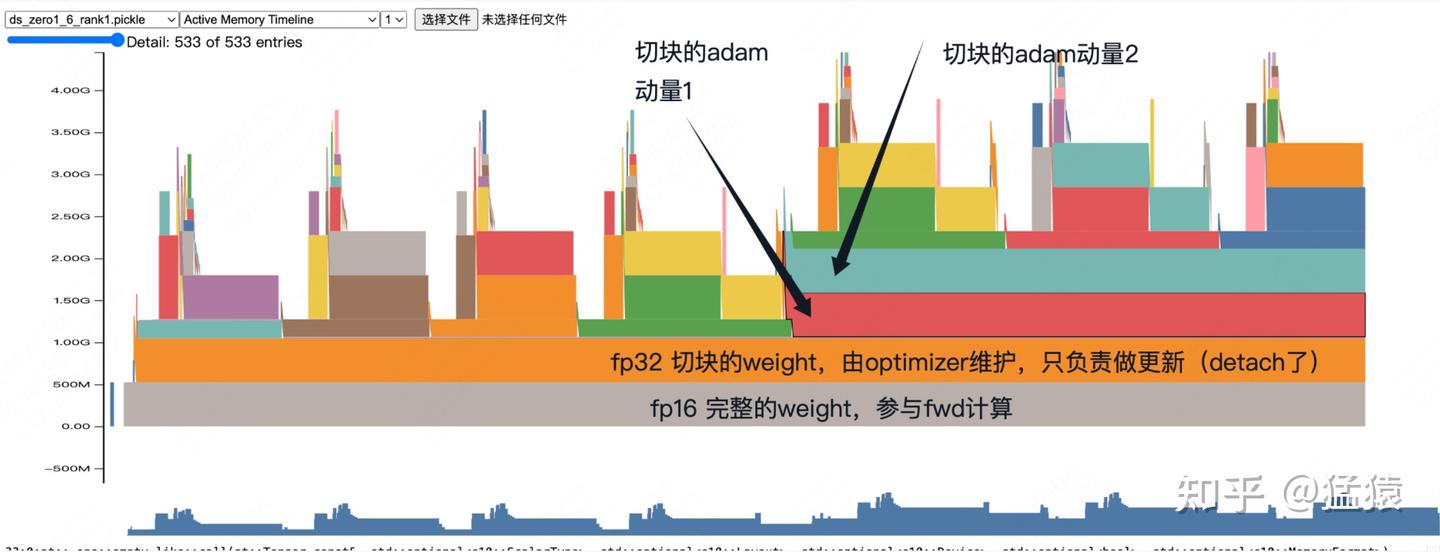
下图以 1G 模型(FP32 精度下)为例,一共有 2 张显卡
- 灰色部分一直占用的显存:每张 GPU 上都存放完整的 FP16 精度模型,这部分显存是固定占用的,专门负责前向传播和反向传播的计算,不会被释放
- 橙色部分一直被占用的显存:FP16 模型被按卡 “切块” 后转成 FP32 精度,存到优化器中(
partiton_fp16.copy().float().detach()),这部分显存只负责权重更新,且脱离计算图(detach)—— 意味着它不参与前 / 反向计算,仅作为优化器更新的 “数据源”
- 因此在一次 optimizer step 中,只有 的 FP32 参数会在该 rank 上被更新
-
权重更新的触发条件
- 在上图中,前 3 个 step 没有出发优化器更新,因为这时梯度还存在 nan/inf,不需要更新权重,因此优化器的两个动量参数不会初始化,fp32 优化器状态也不会向 fp16 模型同步,显存占用和权重值都保持不变
- 触发 Adam 动量初始化:首次正常更新参数时会执行的操作(前 3 步因梯度异常未触发),初始化后动量参数会占用少量额外显存,但不影响核心的 fp16/fp32 显存块
- 在第 4 个 step,梯度正常,触发两个操作
- 首先执行
fp16._copy(fp32):把 fp32 优化器中更新后的权重 “原位复制” 到 fp16 模型中(原位复制 = 不需要新分配显存,所以 fp16 的 500MB 显存块始终存在) - 然后执行 all-gather:同步各卡的 fp16 权重,保证模型参数一致性 —— 把各个 rank 上更新好的参数切片重新收集,使每个 DP rank 再次拥有完整、同步的模型参数,产生单卡通讯量
- 首先执行
-
经过 ZeRO-1 优化的显存计算
显存公式 显存(单位 GB) 单卡通讯量 朴素 DP 120GB 31.4GB -
通信发生时机
阶段 通讯操作 通讯量 核心目的 反向传播后 all-reduce梯度同步所有卡的完整梯度(和 DDP 一致) 优化器更新后 无额外通讯 0 仅更新本地 的 OS 参数同步 all-gather参数保证参数一致 -
优化器状态只在 “参数更新(optimizer step)” 阶段用到,而不是在反向传播阶段
-
反向传播(backward):输入激活值、参数,输出梯度 ,不使用优化器状态
-
参数更新(optimizer step):输入梯度(,FP16 / FP32)、优化器状态(如 Adam 的 )、FP32 主参数,输出更新后的 FP32 参数、更新后的优化器状态
-
以 AdaW 为例
-
-
具体训练步骤
- 前向传播:每个 DP rank 使用完整的 BF16 参数,但处理的是不同的 micro-batch
- 反向传播:每个 DP rank 计算基于各自的数据计算梯度
- All-reduce 梯度:all-reduce(或等价的 reduce-scatter + all-gather),每个 rank 拿到完整梯度
- 局部优化器更新:每个 rank 只更新 的优化器状态,得到对应的 FP32 参数,再转换成 BF16 参数
- All-gather 参数:对 BF16 参数执行 all-gather,把缺失的参数切片同步回每个 rank(这是 ZeRO-1 新增的通信步骤)
-
在通信与计算重叠方面,主要有两种策略
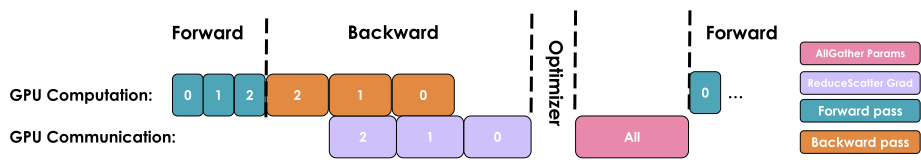
- 在 optimizer step 中重叠:每更新完一部分参数,就立刻开始 all-gather,与后续参数更新并行
- 在 forward 中重叠:将某一层参数的 all-gather,与该层的前向计算重叠
- 但这些优化实现复杂,需要精细的 hook /bucket 管理,实践中通常直接使用 PyTorch 的 FSDP / ZeRO-3 实现,并把整个模型作为一个 FSDP unit
- 在 ZeRO-1 中,优化器状态已经被切分,每个 rank 实际只更新 参数,那么既然只需要一部分梯度来更新,为什么还要在每个 rank 上保留完整梯度?—— 这也就是 ZeRO Stage 2 的出发点
ZeRO Stage 2:切分梯度
-
基本思想
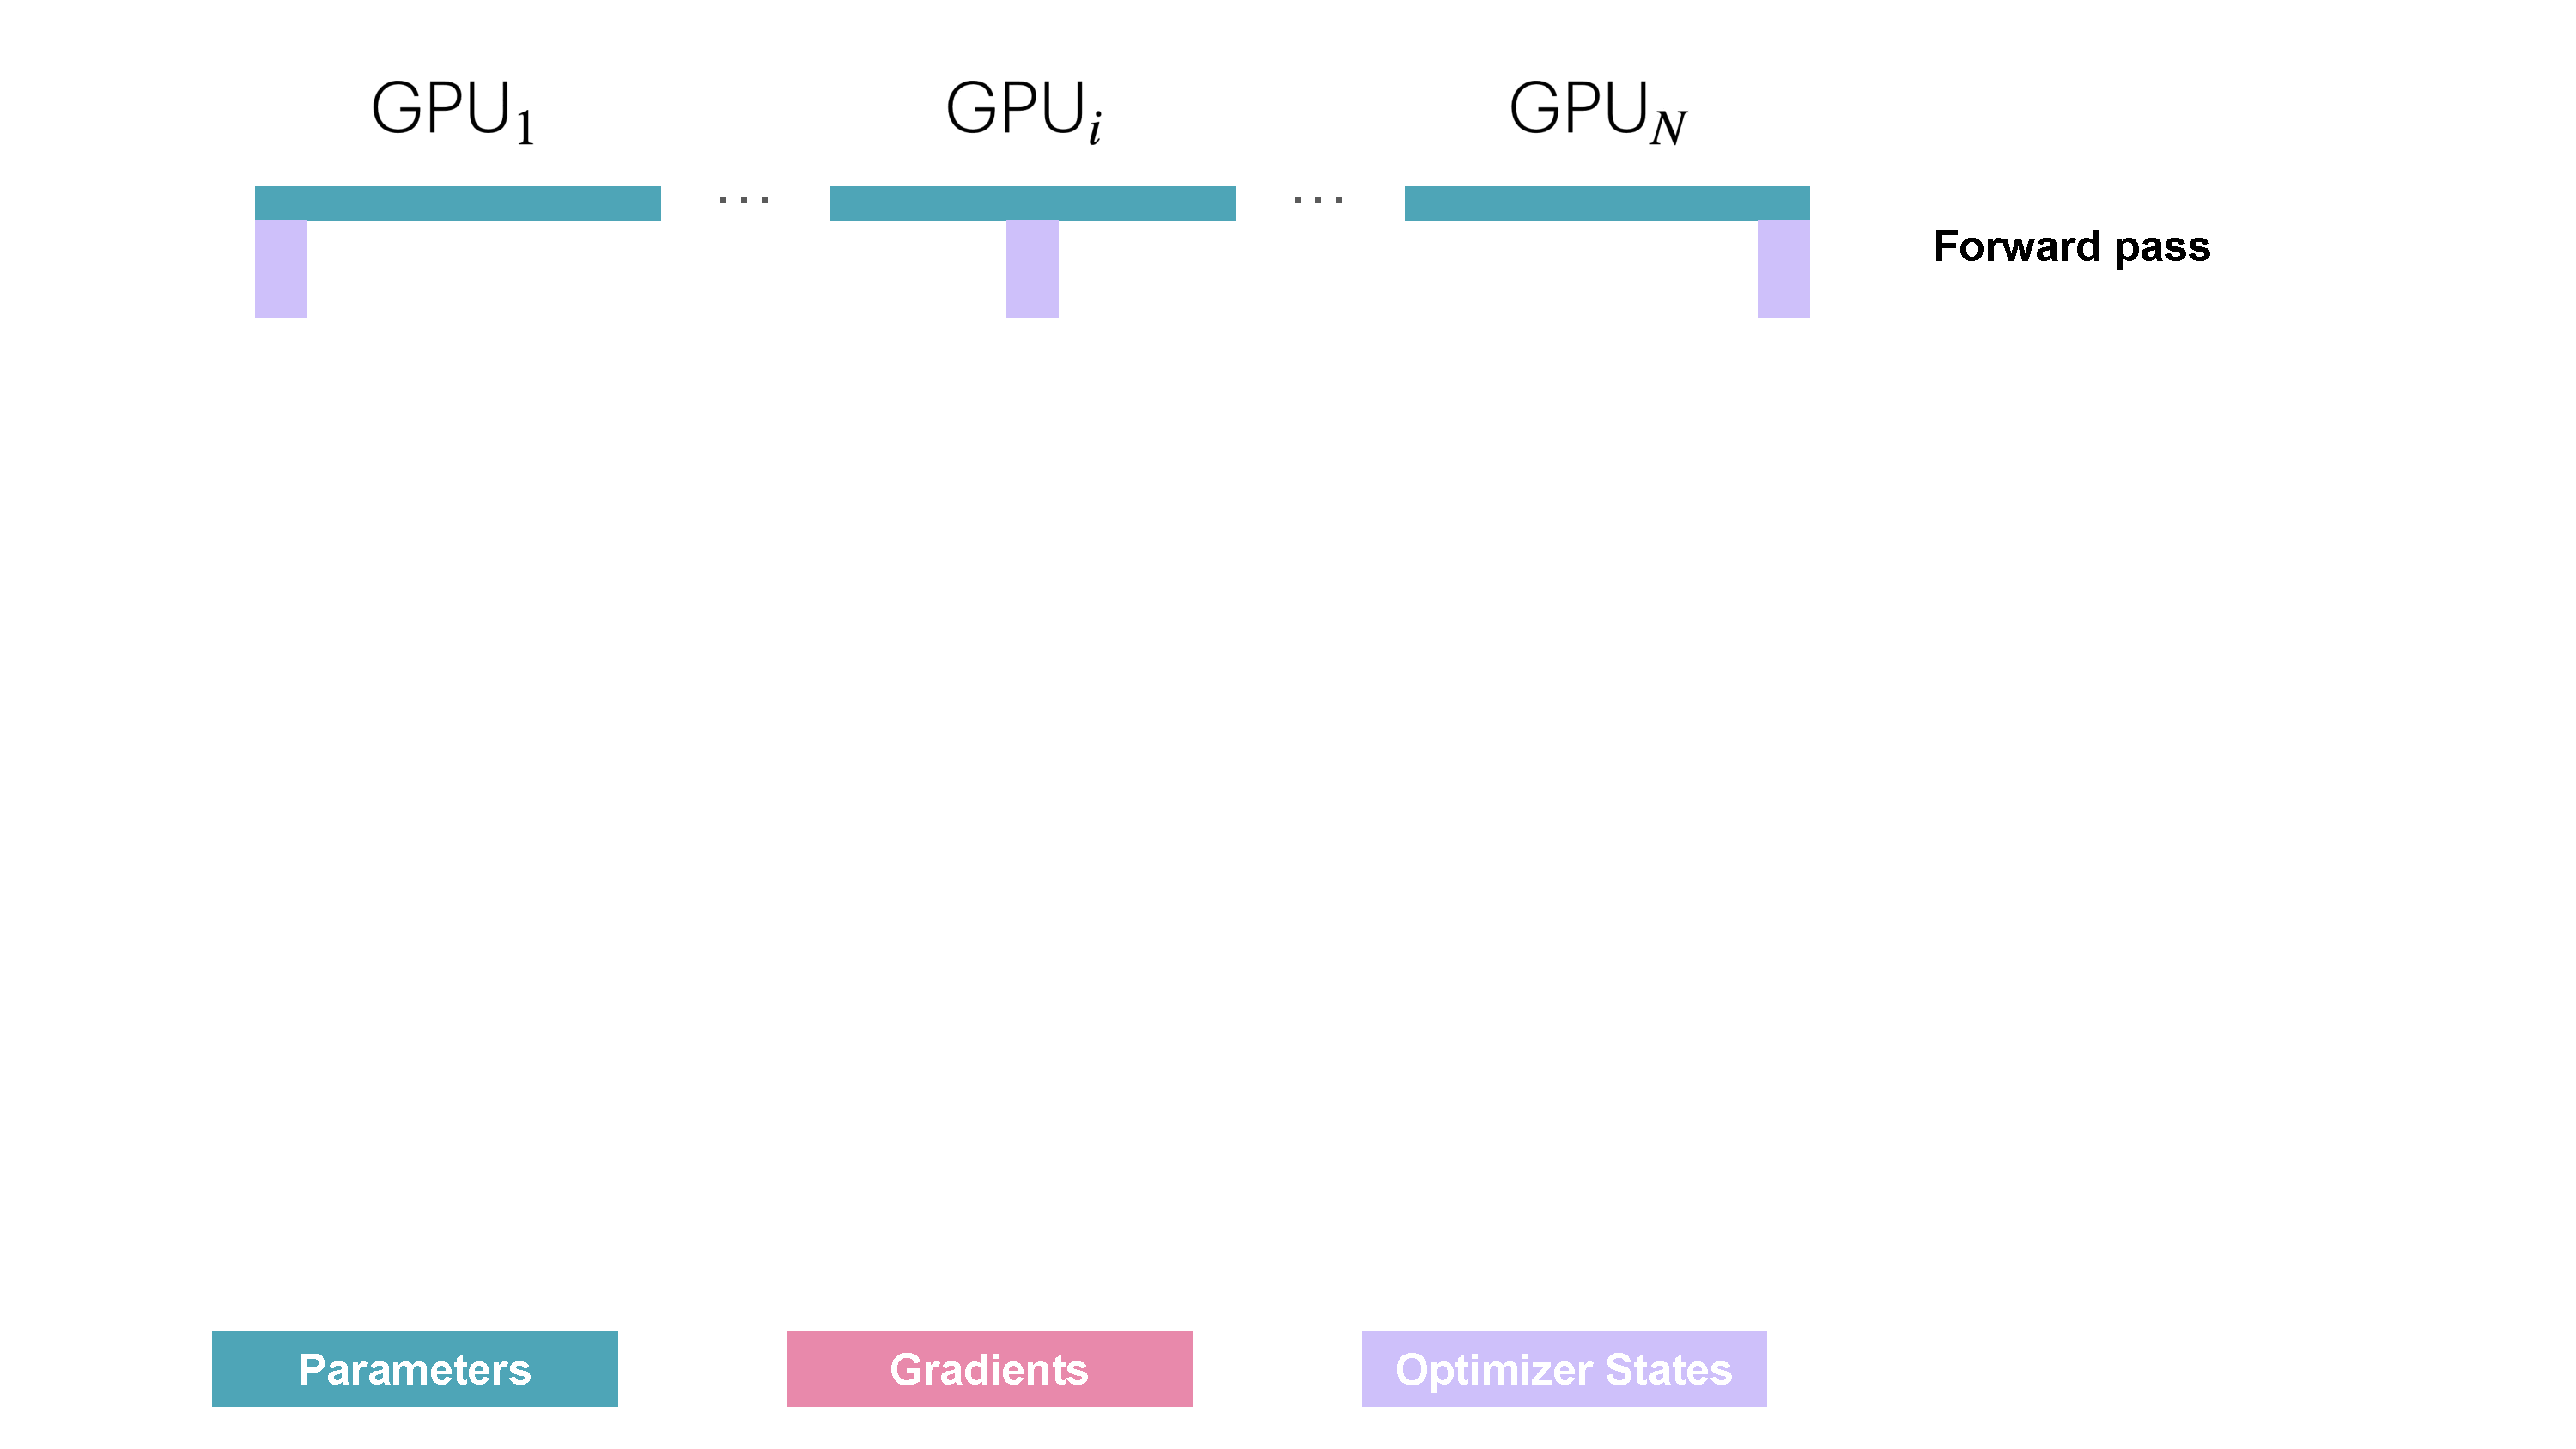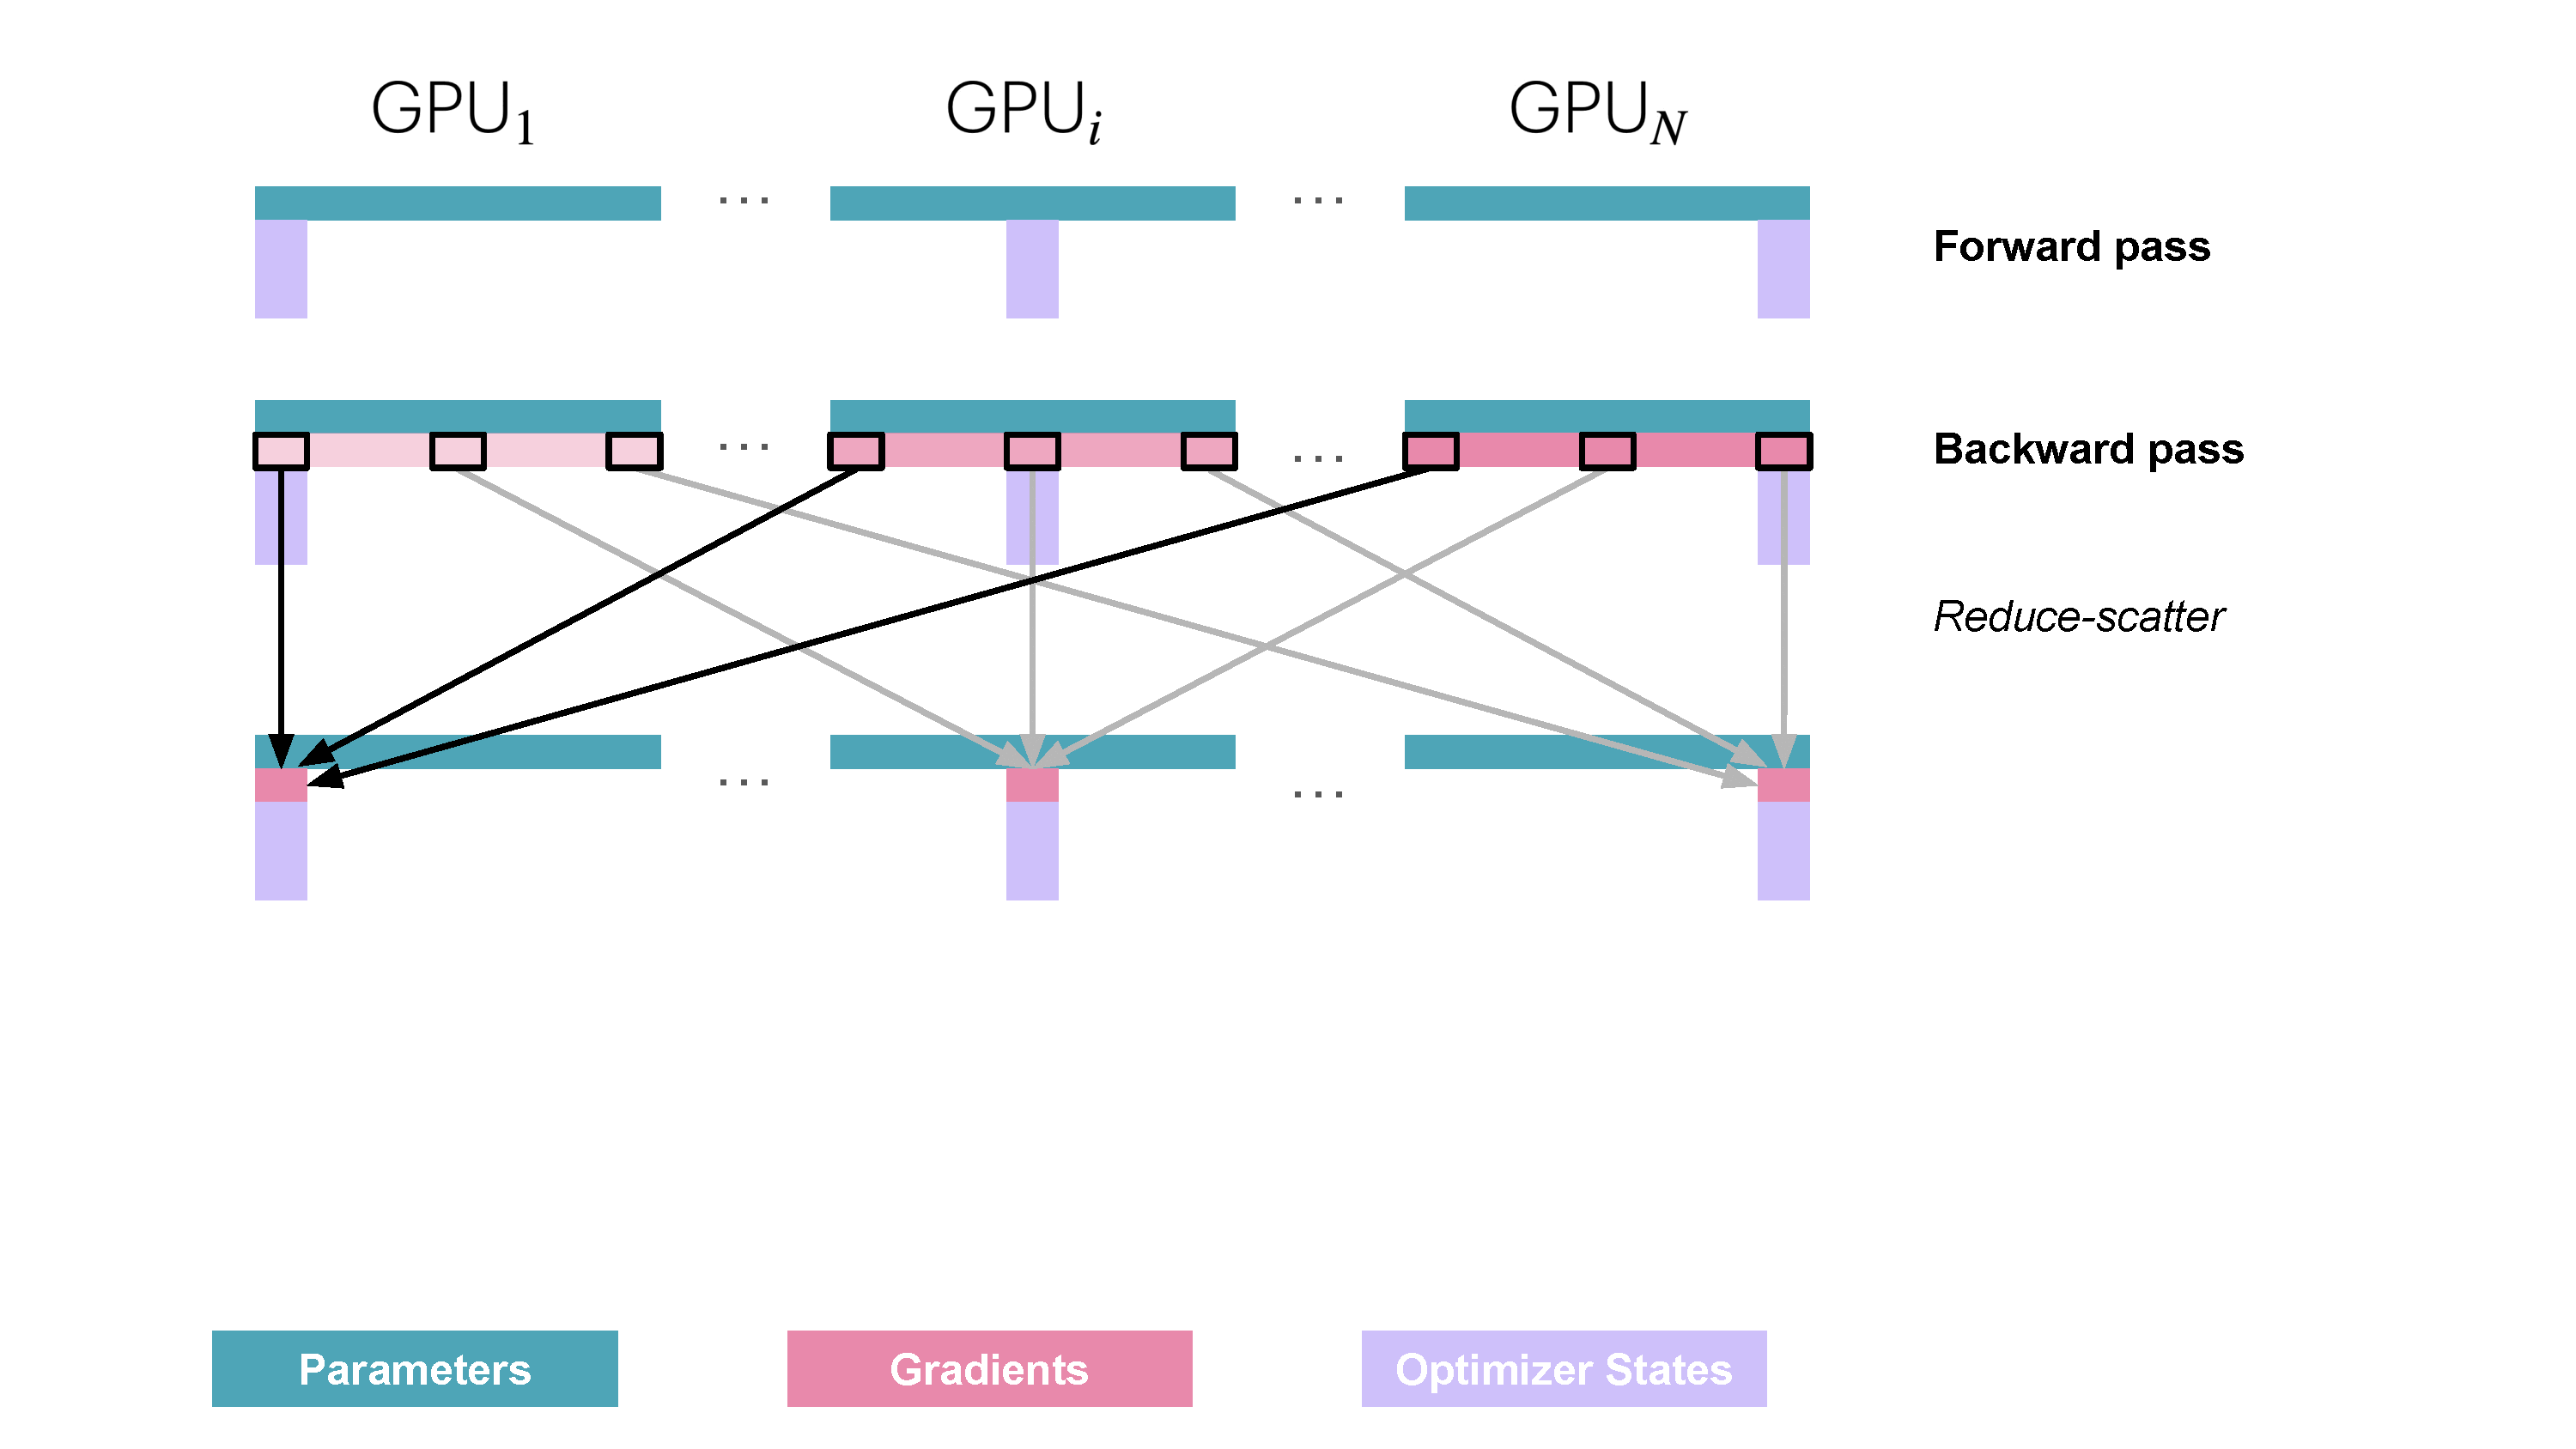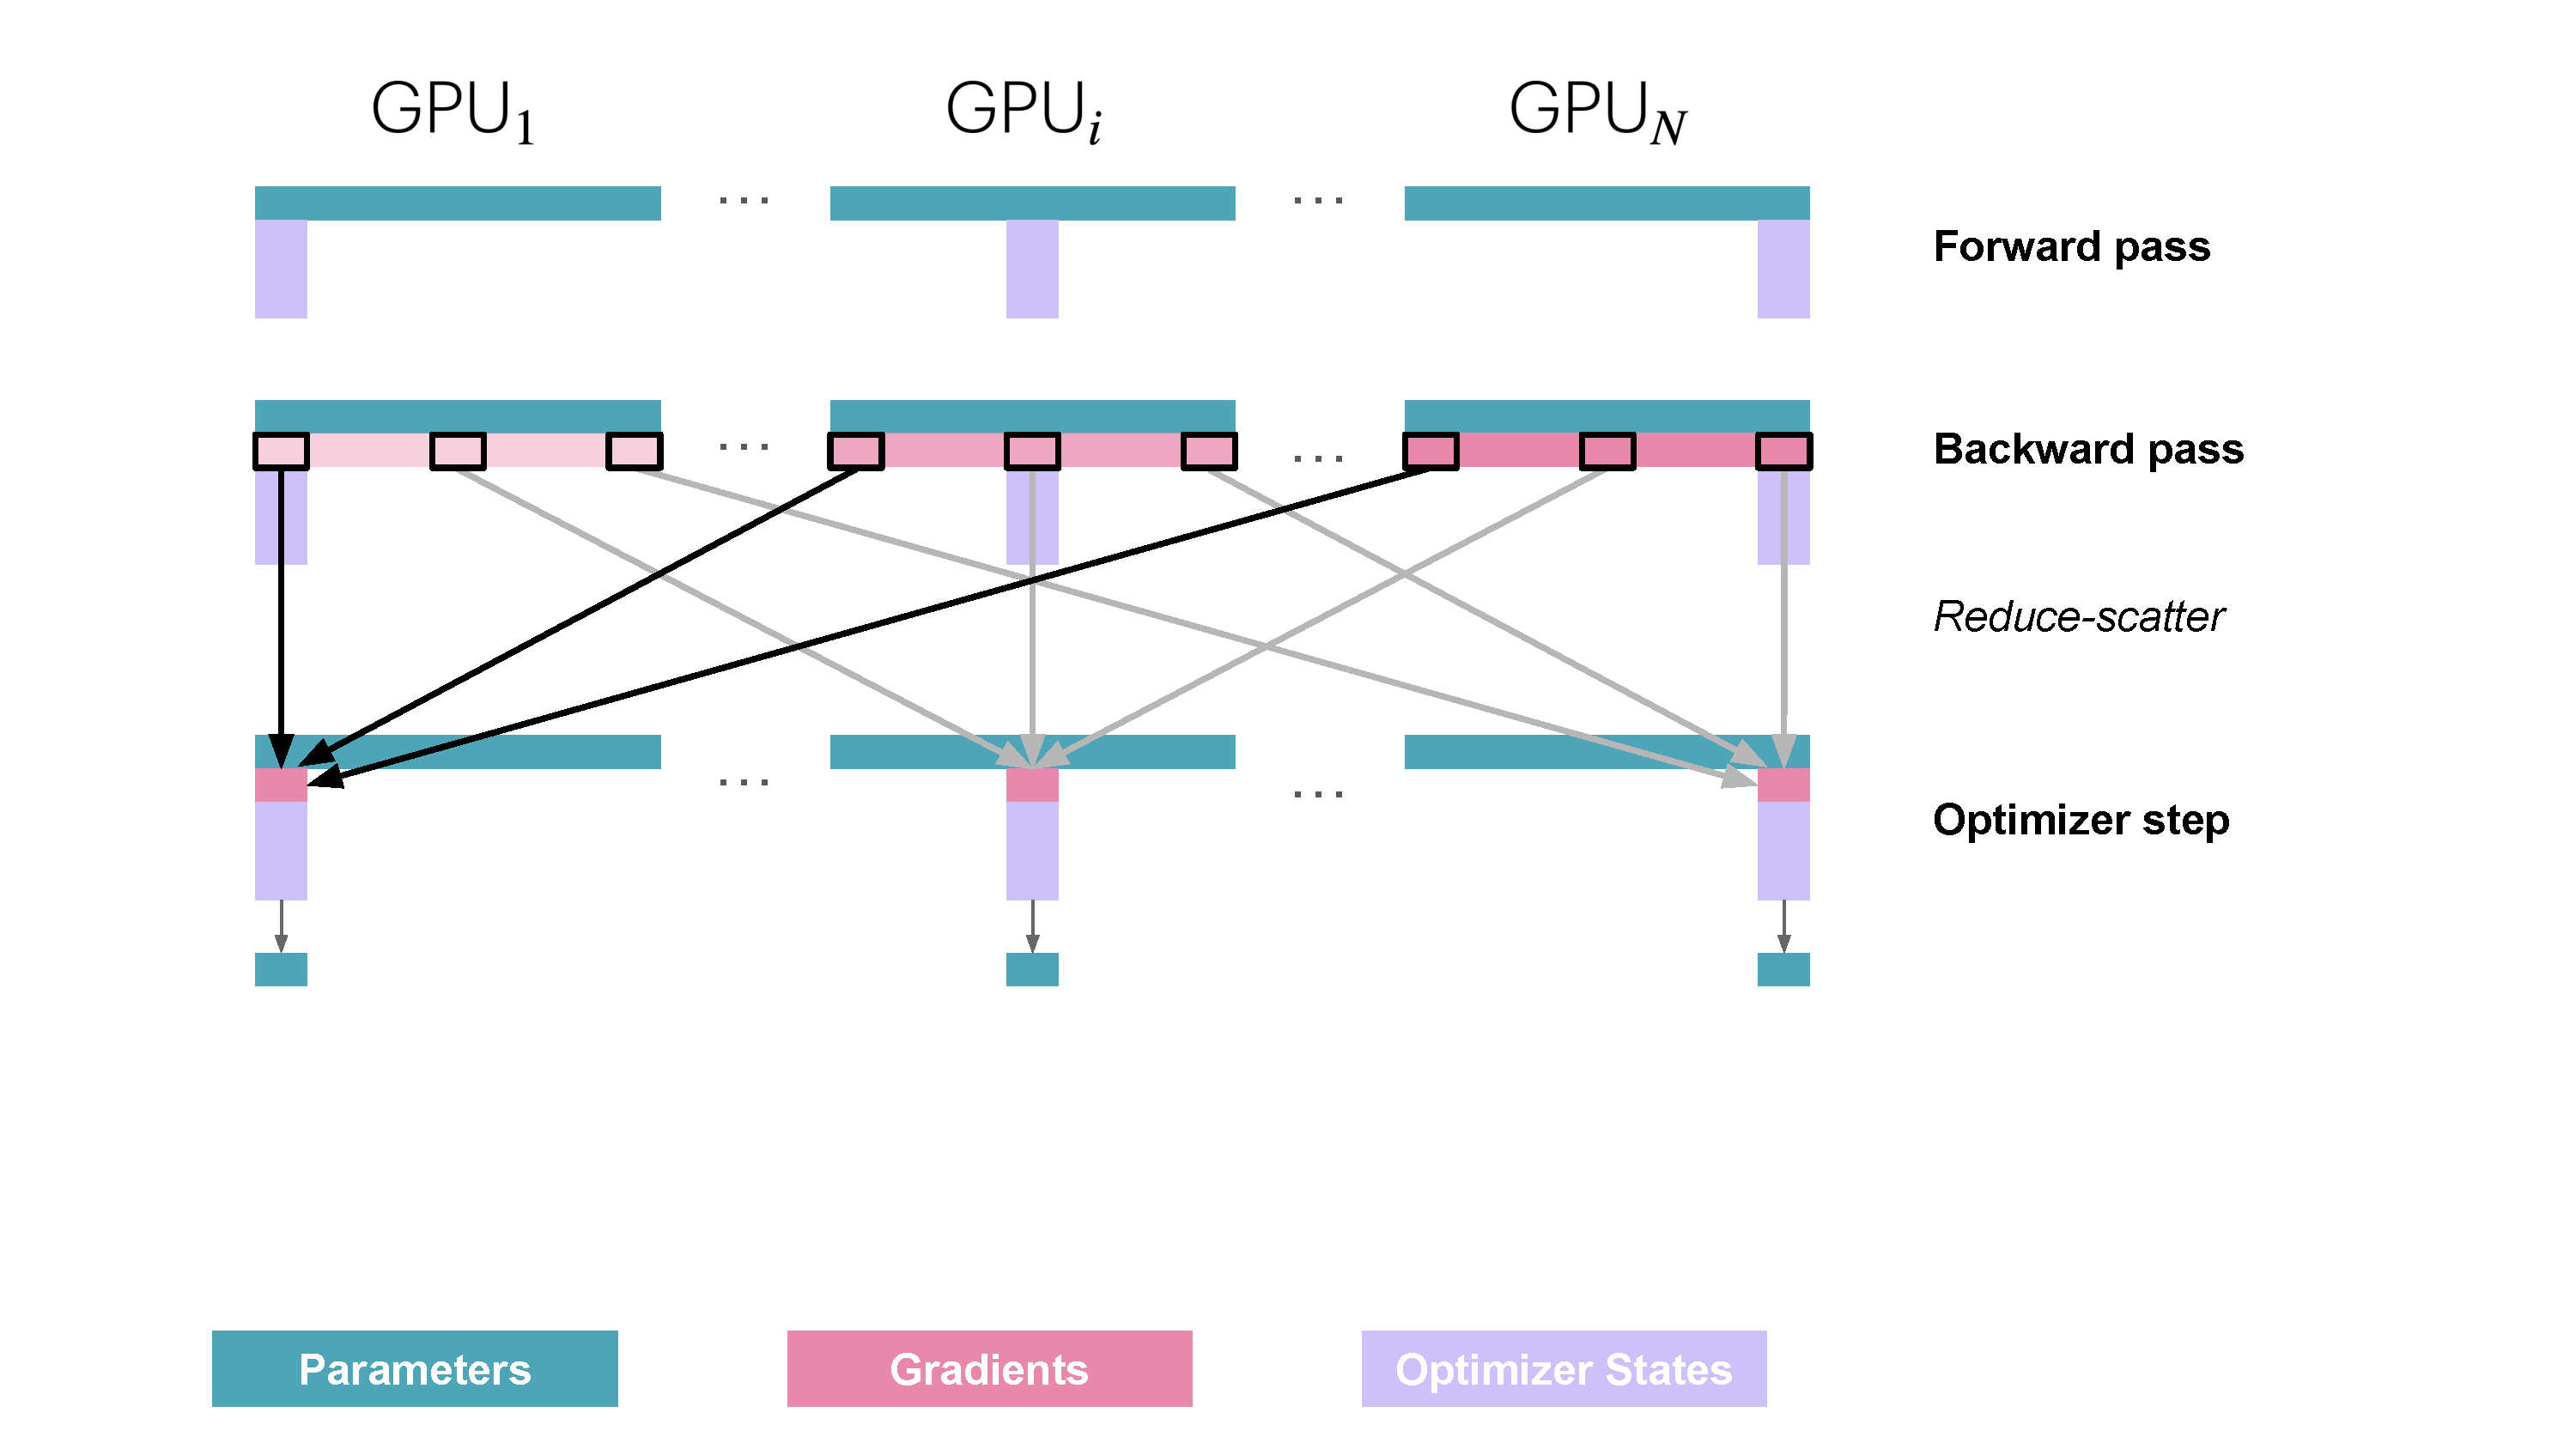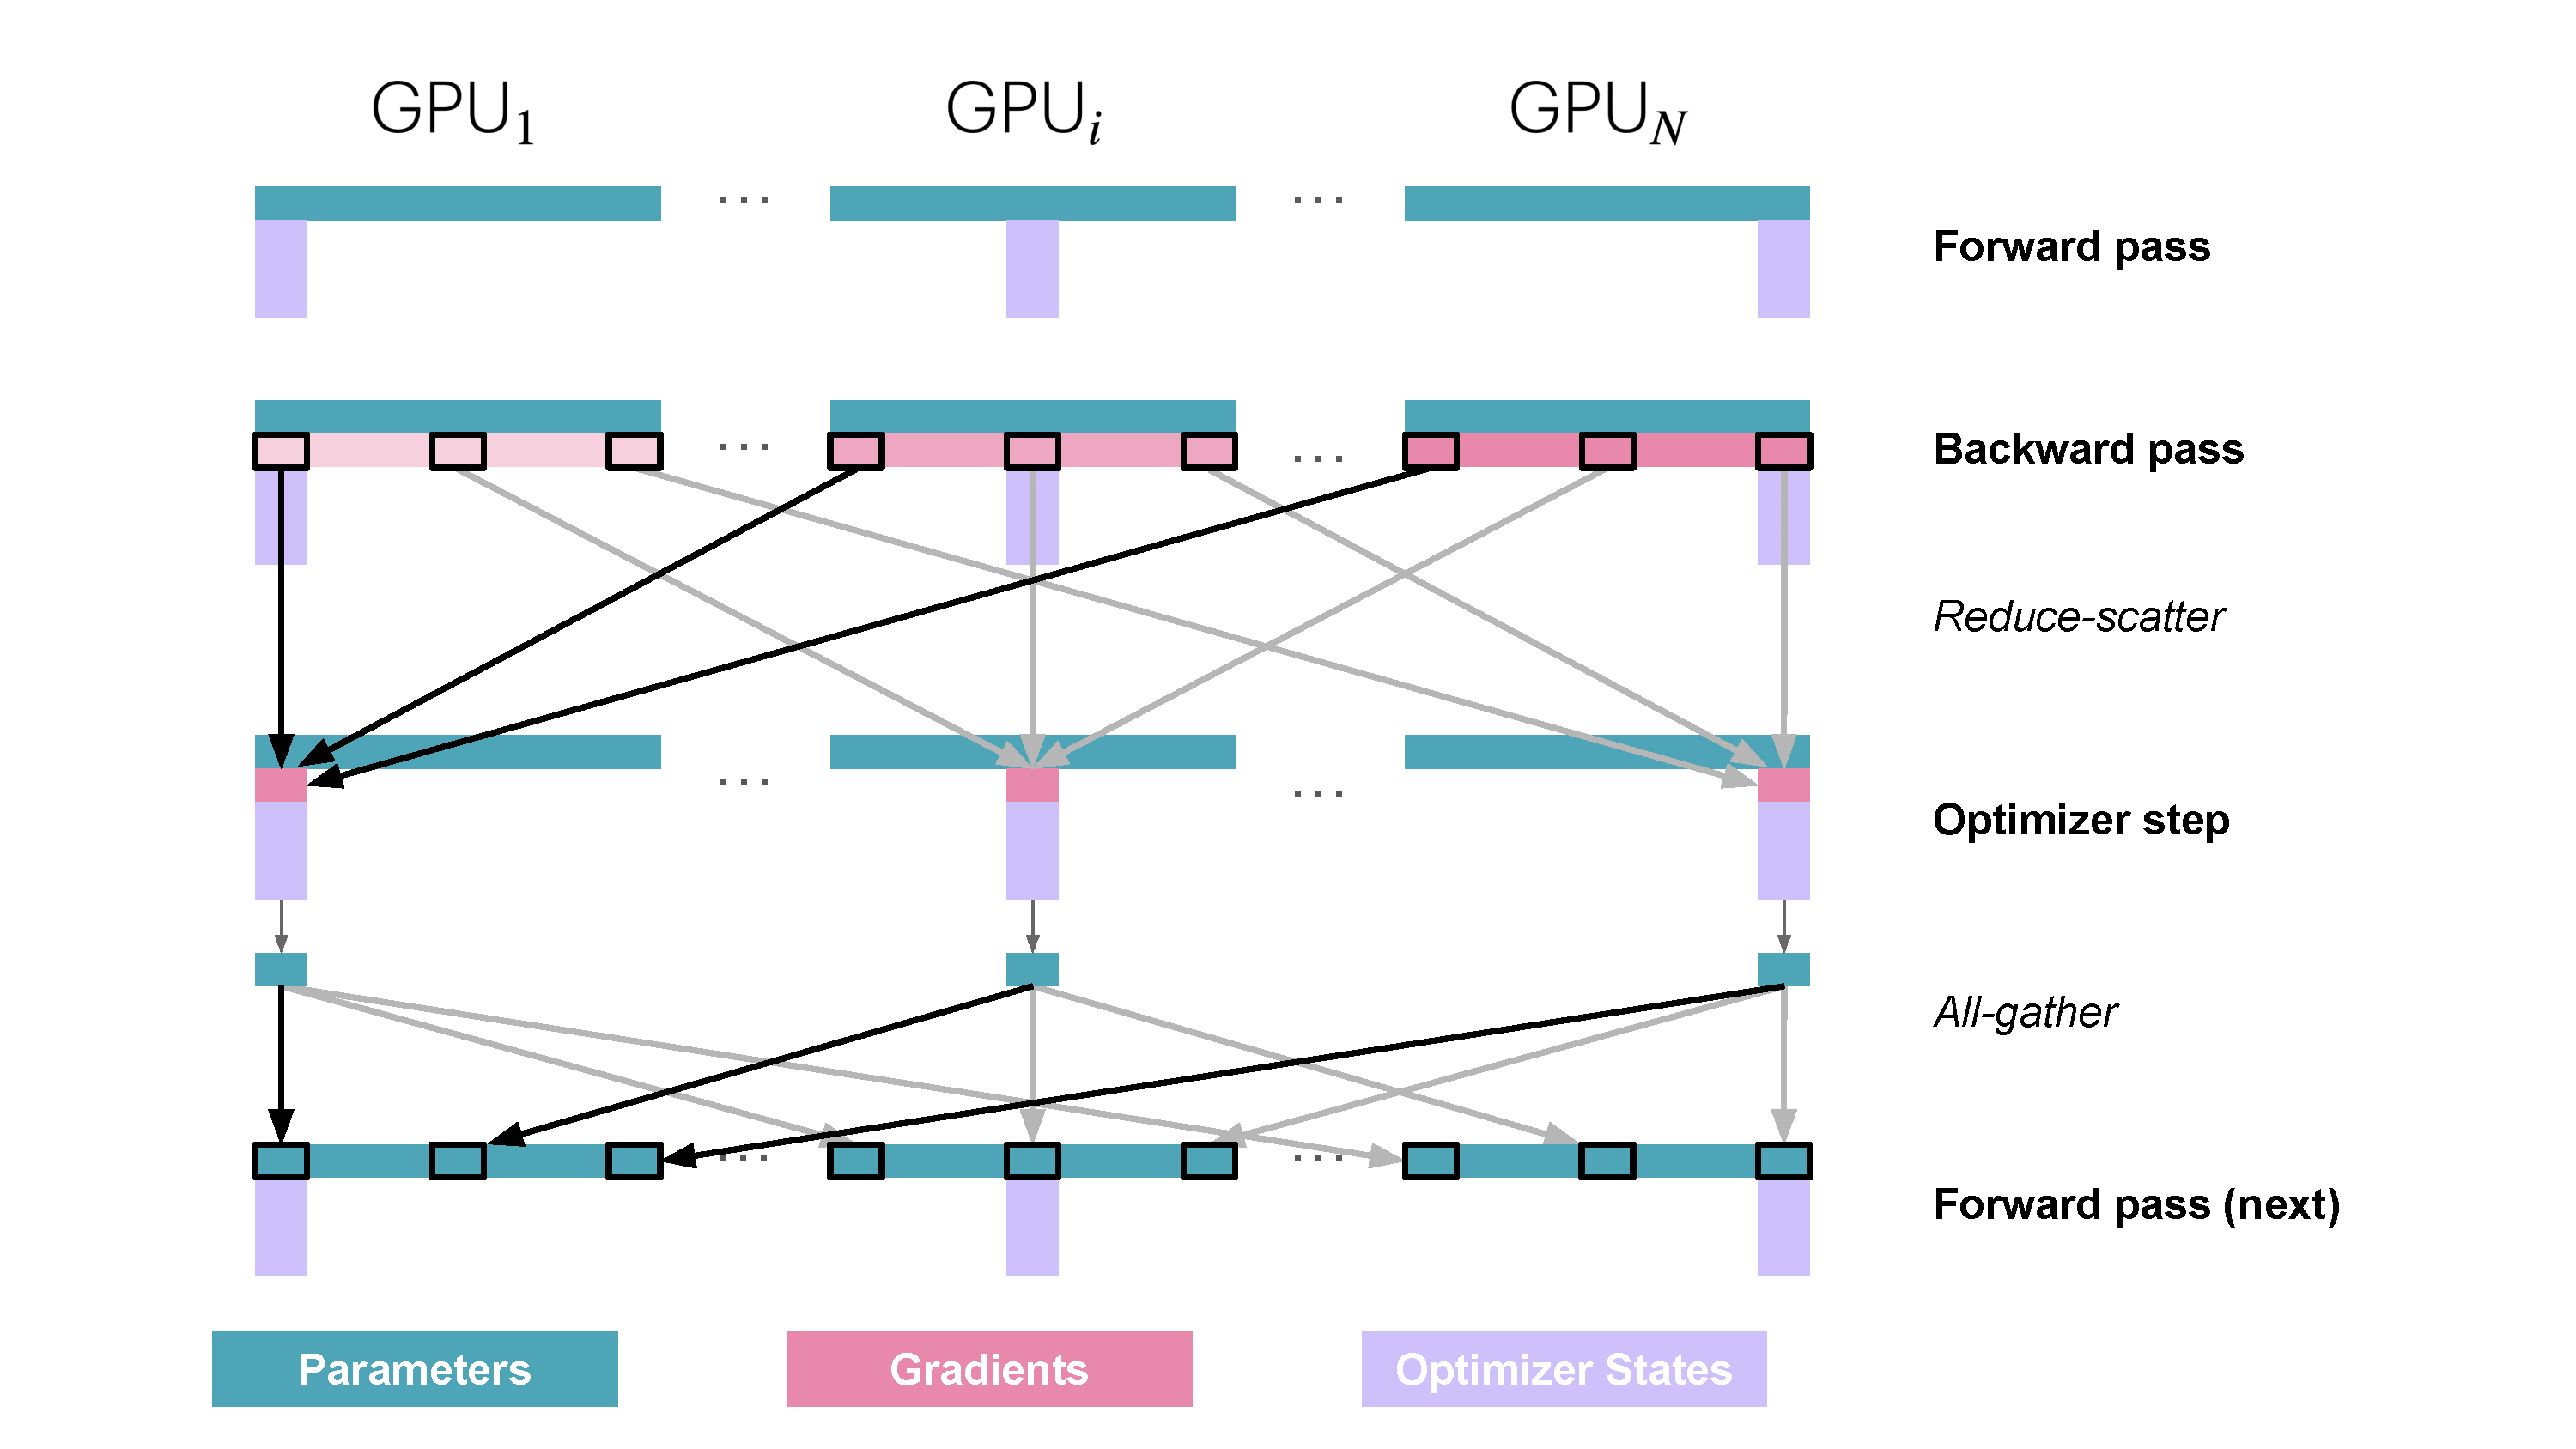
- 既然在每个 DP rank 上,只需要与其本地优化器状态分片对应的那部分梯度,那么也可以像切分优化器状态一样,把梯度本身也切分
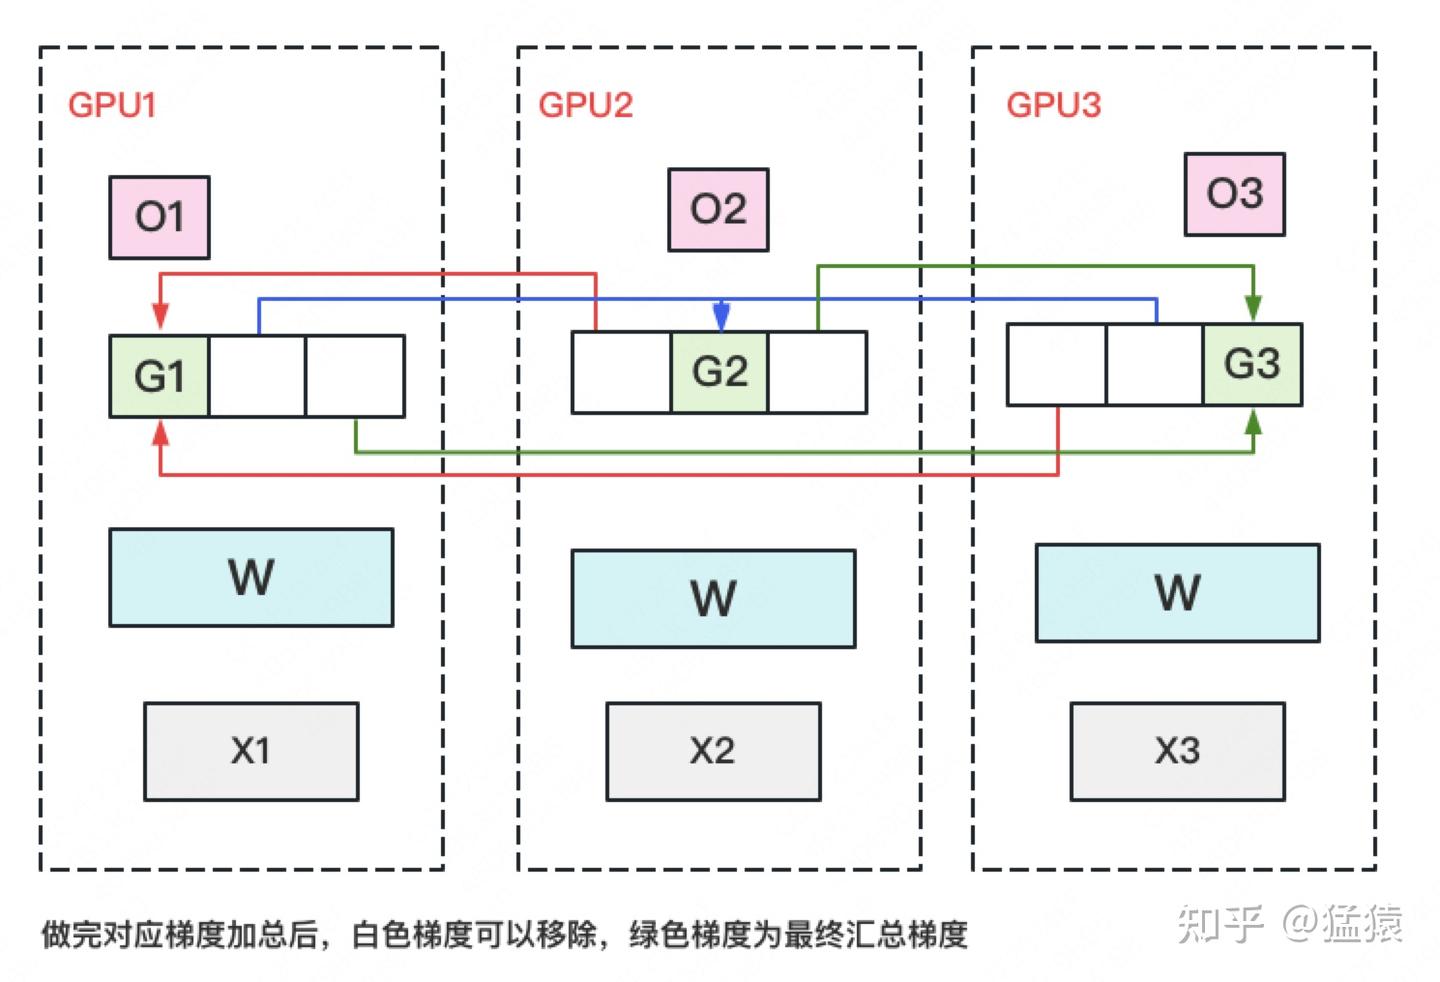
- 在 ZeRO-2 中,每个 rank 只保留 的梯度分片,因此反向传播时不再对梯度执行 all-reduce,而是直接执行 reduce-scatter,只需要保证每个 GPU 上所维持的那块梯度是聚合梯度
- 相比 all-reduce 的通信量为 ,reduce-scatter 的参数量仅为
- 与切分优化器状态时每张 GPU 只需要维护它自己的 FP32 参数分片,如果使用 FP32 梯度累积,那么每个 rank 只需要保留 的 FP32 梯度
- 这些 FP32 梯度来自 reduce-scatter 后的 BF16 梯度,只用于更新本地的优化器状态分片
- 在 optimizer step 中,这 的 FP32 梯度仅用于更新本 rank 持有的优化器状态和对应的参数分片
- 在进行梯度分片后,最终也需要对 W 做一次 all-gather,来保证 W 是完整更新后的
-
显存和通信量分析
方法 显存公式 显存(单位 GB) 单卡通讯量 朴素 DP 120GB 31.4GB 16.6GB -
通信时机
阶段 通讯操作 通讯量 核心目的 反向传播后(梯度计算完成) reduce-scatter梯度把完整梯度拆分成 分片,每张卡只留自己负责的分片 优化器更新后 无额外通讯 0 用本地分片梯度更新本地分片 OS 参数同步 all-gather参数保证参数一致 -
优化器状态只需要分片对应的那部分梯度的数学推导
-
设参数向量 被切分为:
-
Adam / SGD 的更新是逐参数独立的:
-
因此,对于 rank ,只更新 ,只需要 ,只需要
-
-
与 ZeRO Stage 对比:
- 在通信层面,ZeRO-2 与 ZeRO-1 几乎完全一致,都包含 reduce-scatter(梯度)、all-gather(参数)
- 唯一的区别在于 ZeRO-2 会在通信完成后立即释放不再需要的梯度内存,梯度从 “逻辑切分” → “物理只存在一份”
- 因此可以说:在通信角度,ZeRO-2 等价于 vanilla DP / ZeRO-1,在显存角度,ZeRO-2 明显优于 ZeRO-1
- 除了实现复杂度更高之外,ZeRO-2 相比 ZeRO-1 几乎没有额外运行时开销,因此在实践中 ZeRO-2 通常是比 ZeRO-1 更优的选择
-
ZeRO-2 在梯度累积场景下的通信量
- 在没有梯度累积时,ZeRO-1 的通信量与 ZeRO-1 持平
- 但在梯度累积场景下
- ZeRO-1
- 每个 worker 本地持有完整梯度
- 每一步反向:直接在本地累加梯度(无任何通信)
- 累积 K 步后:只做 1 次 reduce-scatter(X) + 1 次 all-gather(X)
- 总通信量 = 2X(累积 K 步,通信量不增加)
- ZeRO-2
- 梯度累加的前提:必须保留每一步的梯度,但 Stage2 每个 worker 只存 1/N 梯度;
- 因此 ZeRO-2 中每一步反向后,都必须做一次 reduce-scatter
- 第 1 步反向:reduce-scatter(X)→ 累加 1/N 梯度,丢弃其余
- 第 2 步反向:reduce-scatter(X)→ 累加 1/N 梯度,丢弃其余
- ...
- 第 K 步反向:reduce-scatter(X)→ 累加完成
- 总通信量 = K×X(reduce-scatter) + X(all-gather)= (K+1) X
- ZeRO-1
-
通信与计算重叠
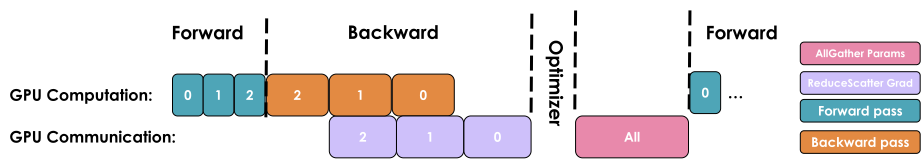
ZeRO Stage 3:切分参数
-
基本思想
- 在 Stage 3 中,将前面在 DP 副本之间分片优化器状态和梯度的做法,进一步扩展为对模型参数本身进行分片
- PyTorch 对这一阶段的原生实现称为 FSDP(Fully Sharded Data Parallelism)
-
基本流程
- 参数的初始化和切割
- 将 某一块参数 先传送到 rank0 上,并将这块参数从 rank0 广播到各个 GPU 上,此时每张 GPU 都拥有完整的 rank0
- 将 param 展平为 1D 张量,并进行 padding(防止参数数量不能被 dp_size 整除)
- 计算每一块 GPU 上所维护的 1D param 的范围(即 start_index, end_index),然后按照这个范围取出每块 GPU 上应该维护的 param chunk,接着释放不是自己所维护的 param chunk
- 每块 GPU 只保存部分参数,将一个 batch 的数据分为若干份,每个 GPU 处理一份
- 前向传播时,对 W 做一次 All-Gather,取回分布在其他 GPU 上的参数,得到一份完整参数,单卡通信量为 ,前向传播完成后立即抛弃不属于该 GPU 维护的参数
- 反向传播时,对 W 做一次 All-Gather,取回完整的 W,单卡通信量为 ,反向传播完成后立即抛弃不属于该 GPU 维护的参数
- 完成反向传播后,计算一份完整的梯度 G,进行 reduce-scatter,单卡通信量为
- 使用自己维护的 O 和 G 更新 W,由于只维护部分参数,因此不需要进行 all-gather 操作
- 参数的初始化和切割
-
参数的切分方式
- ZeRO-3 对每个参数张量(如 Linear.weight、LayerNorm.weight)独立做分片(按行 / 列 / 块切分到多卡),不是按层整体分配到某张卡
- 但在调度上,以模块(Layer)为单位做参数的按需 all-gather 与释放
- 对 2D 矩阵(如 Linear.weight):按行 / 列分片(默认按最后一维,即列)
- 对 1D 向量(如 bias、LayerNorm):按元素分片
- 对高维张量(如 Conv):按通道 / 空间维度分片
- 与此相对应地
- PP 是将模型按层进行切分,每张卡持有完整的部分层参数
- TP 是将矩阵按照行 / 列切分,通过矩阵乘法的原理来实现
- 通过这种方式,有三个好处
- 全局显存完美均衡,消除负载倾斜
- 按层整体切分,不同 Transformer 层参数量差异极大,Embedding、LMHead、FFN 等大层容易单卡 OOM,负载严重倾斜
- 而 ZeRO-3 中,每张卡只持有全局所有参数的 1/N,天然参数量全局平均,不受 “单层最大参数” 硬件限制
- 支持按需生命周期管理,能够更好地进行通信掩盖
- 进入模块前通过 all‑gather 聚合完整参数用于计算,模块执行完毕立刻释放完整副本,仅保留本地分片
- 传统按层切分无法做到这种细粒度即时回收,显存峰值居高不下
- 同时,通过预取等可以将下一层参数的 all-gather 掩盖在当前层的前向计算中
- 和 TP/PP 天然兼容,构建四维混合并行
- TP 负责横向切分,解决模型 Hidden、Attention/MLP 维度过宽的问题
- PP 负责纵向按层切分,解决模型深度过大、单卡放不下的问题
- ZeRO‑3 基于 DP 组,对参数、梯度、优化器状态做全局细粒度分片
- 全局显存完美均衡,消除负载倾斜
-
显存分析
训练策略 显存计算公式 实际显存占用(GB) 单卡通讯量 朴素 DP 120 31.4 16.6 1.9 -
通信时机
阶段 通讯操作 通讯量 核心目的 前向传播(每层计算前) all-gather参数临时聚合完整的当前层参数,计算后释放 反向传播(每层计算前) all-gather参数同上,聚合当前层参数用于梯度计算 反向传播后 reduce-scatter梯度拆分梯度到各卡 优化器更新后 无 无 无需再聚合参数,前向传播会进行 all-gather -
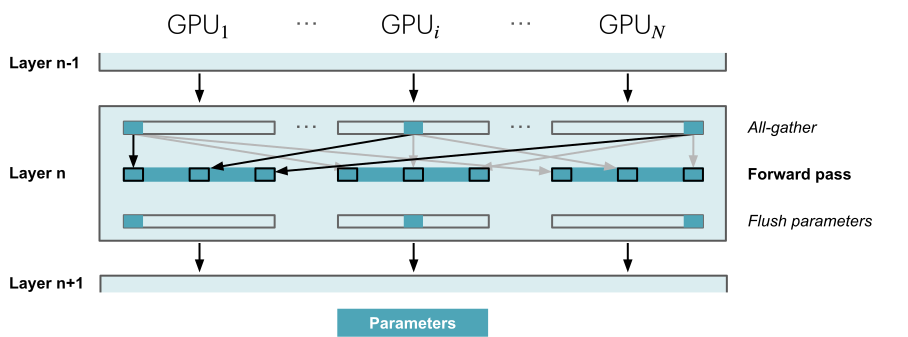
参数被分布式存储时,如何进行前向 / 反向传播?
- 在执行前向传播、按顺序遍历各层时,会按需 all-gather 取回该层所需的参数,并在使用完之后立即将其从显存中释放
-
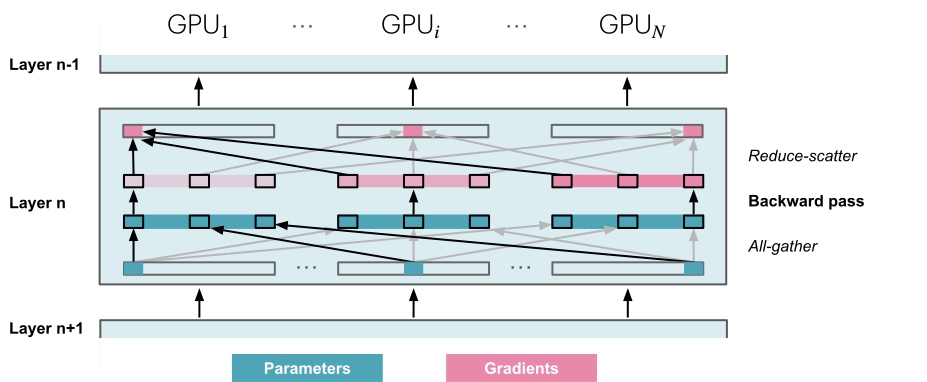
在反向传播中类似,只是流向相反
-
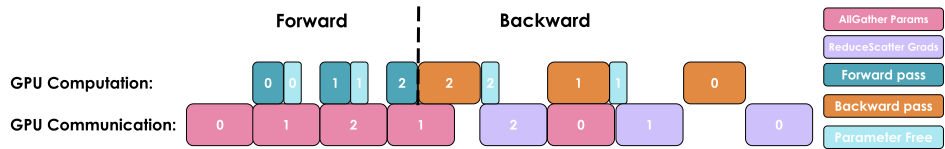
通信开销问题
- 通信代价分析
- 在一次训练 step 中,需要在 forward 和 backward 的过程中持续进行 all-gather 操作
- 相较于 ZeRO-2,这会在一次训练 step 中额外引入 次 all-gather 操作,每一次 all-gather 都带来一个小的基础通信延迟开销
- 在前向传播中,当某一层需要参数时,进行一次 all-gather,这会带来一次 级别的通信开销
- 由于在 forward 后立刻丢弃了该层参数,在反向传播时,还需要再次 all-gather 参数,又引入一次 的通信开销
- 最后梯度仍然需要像 ZeRO-2 一样进行 reduce-scatter,这同样需要 的通信开销
- 因此,ZeRO-3 的总通信代价为 ,而 ZeRO-2 的通信代价为
- 通信与计算重叠
- 这听起来似乎是非常大的通信开销,但实际上影响并不严重,因为可以通过通信与计算重叠来隐藏大部分通信时间,这种技术称为预取(prefetching)
- 在执行第 层的前向传播时,同时 all-gather 第 层的参数
- 在执行 第 层的反向传播时,同时 all-gather 第 层的参数
- 只要 DP 规模不要过大,这种重叠就可以有效发挥作用,从经验来看,DP 不应超过 512
- 通信代价分析
ZeRO-Offload
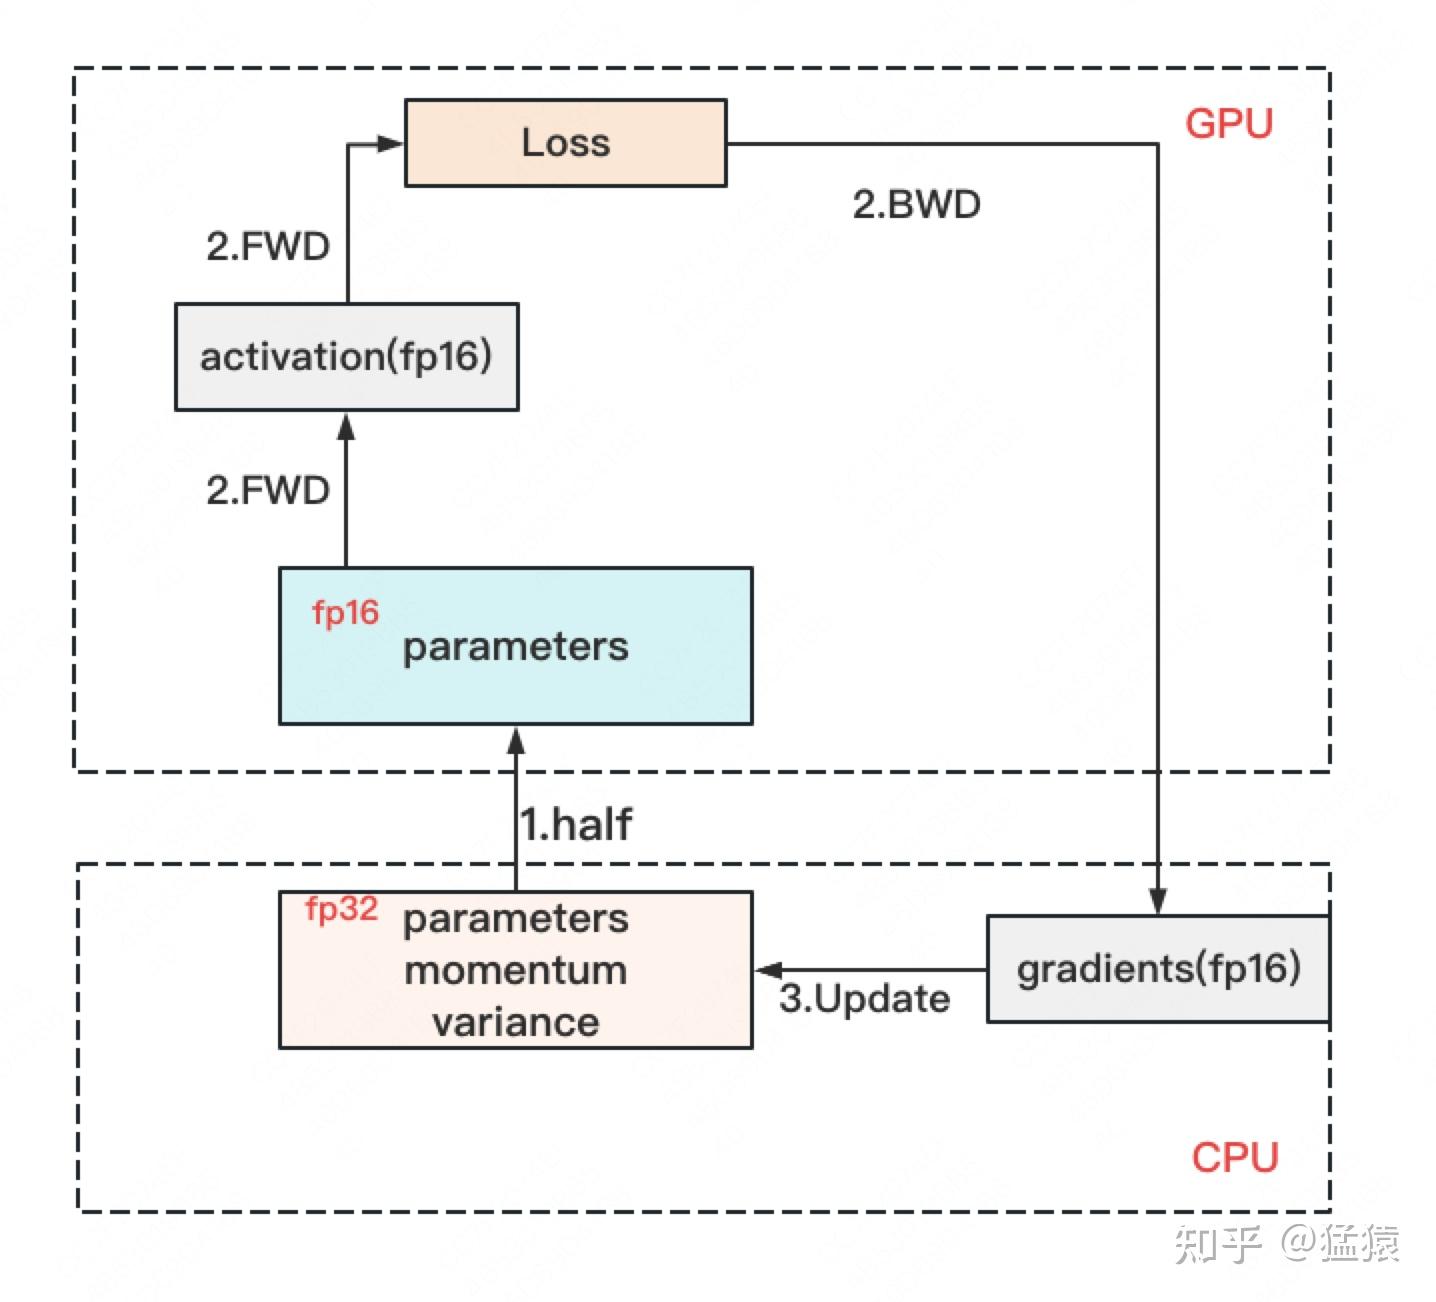
- 将一些数据卸载到 CPU 上,而把计算部分放在 GPU 上,相比起跨机通信,既能够降低显存,也能减少通讯压力
- 前向传播、反向传播
- 前向传播、反向传播是整个训练流程中算力消耗最高、访存最频繁的核心阶段
- 为了避免频繁数据拷贝拖慢计算速度,保障计算流水不中断,将该环节强依赖的数据全程驻留 GPU 显存
- 包含半精度权重 W (FP16)、网络层中间激活值 activation 等关键张量,保证前反向推理高速执行
- 参数更新
- 参数更新阶段运算逻辑简单、计算量极低,对低延迟访存的需求弱,是异构卸载的最优落地场景,因此将参数更新相关的低频访问张量统一卸载至 CPU 内存托管
- 涵盖备份的全精度主权重 W (FP32)、各类优化器状态(动量、方差等 FP32 精度参数)、反向传播产出的半精度梯度 gradients (FP16)
- 异步调度策略
- 反向计算完成后,异步将梯度搬运至 CPU,依托 CPU 完成优化器更新、权重高精度修正
- 更新结束后,仅按需同步必要的半精度权重回 GPU 用于下一轮迭代
- 既最大化释放 GPU 宝贵的高速显存,又利用 CPU 大容量内存兜底,规避跨机器集合通信的性能损耗,实现显存占用与训练吞吐的平衡
相关分析
- ZeRO 与模型并行
- ZeRO 是模型并行的形式,数据并行的实质
- 模型并行,是指在 forward 和 backward 的过程中,只需要用自己维护的那块 W 来计算即可,即同样的输入 X,每块 GPU 上各算模型的一部分,最后通过某些方式聚合结果
- 但对 ZeRO 来说,进行 forward 和 backward 的时候,是需要把各 GPU 上维护的 W 聚合起来,即本质上还是用完整的 W 进行计算,它是不同的输入 X,完整的参数 W,最终再做聚合
- 总的来说,ZeRO 聚合参数,不聚合分块的计算结果;而模型并行聚合计算结果,不聚合参数,每个 GPU 始终都拿着自己的那一部分参数,不需要考虑其他 GPU 上的参数,参数自始至终都是分片的
- 如何对 Residual States 的优化
- Partitioned Activation Checkpointing
- 对 activation 的存储是灵活的,因为它只是起到加速梯度计算的作用,因此在哪几层保存激活值,保存哪些激活值都是可以灵活设置的
- 同样也可以仿照以上切割方式,每个 GPU 只维护部分激活值,需要时再进行聚合即可,activation 对显存的占用一般会远高于模型本身,通讯量巨大,所以要灵活、有效地实验设计
- Constant Size Buffer
- 提升带宽利用率:当 GPU 数量上升,GPU 间的通讯次数也上升,每次的通讯量可能下降(但总通讯量不会变)。当数据切片变小后,就不能很好地利用带宽;所以这个 buffer 起到了累积数据的作用:等数据累积到一定大小,再进行通讯
- 使得存储大小可控:在每次通讯前,累积的存储大小是常量,是已知可控的,更方便使用者对训练中的存储消耗和通讯时间进行预估
- Memory Defragmentation
- 设置机制,对碎片化的存储空间进行重新整合,整理出连续的存储空间
- 防止出现总存储足够,但连续存储不够而引起的存储请求失败
- Partitioned Activation Checkpointing
- DP 和 ZeRO 的局限性
- 可以看到,激活值不能像参数、梯度、optimizer state 那样做 shard(分片),原因不是工程上 “没实现”,而是在数据并行中,激活值天生就不是冗余的
- 每个 GPU 拿到的是不同的 micro-batch,不同 GPU 上的激活值数值不同、语义不同,它们不是 “同一份数据的多份拷贝”,而 sharding 的前提是有重复
- 但是,激活值恰恰又会随着批次的增加而线性增长,这是迫切需要被解决的
- ZeRO Stage 3 的本质是复制计算,切分存储,每个 GPU 执行完整模型的 forward /backward,但只存自己负责的一小片参数 / 梯度 /optimizer state,因此 forward 需要 all-gather 参数,backward 需要 reduce-scatter 梯度,这也就导致 ZeRO-3 的核心成本不是计算,而是 “参数通信”
- 与 ZeRO 的核心思想不同,张量并行(Tensor Parallelism)的出发点是切分计算本身
- TP 不是 “减少冗余副本”,而是把一个 layer 的数学运算本身拆到多个 GPU 上做,每个 GPU 只计算模型的一部分,只持有这一部分对应的参数,激活值也只是一部分
配置说明
-
配置文件示例
{ "train_batch_size": 32, "gradient_accumulation_steps": 1, "steps_per_print": 200, "fp16": { "enabled": true, "loss_scale": 0, "initial_scale_power": 16 }, "zero_optimization": { "stage": 2, "offload_param": { "device": "cpu", "pin_memory": true }, "offload_optimizer": { "device": "cpu", "pin_memory": true }, }, "optimizer": { "type": "Adam", "params": { "lr": 3e-5, "betas": [0.9, 0.999], "eps": 1e-8, "weight_decay": 3e-7, }, }, "scheduler": { "type": "WarmupLR", "params": { "warmup_min_lr": 1e-7, "warmup_max_lr": 3e-5, "warmup_num_steps": 500, }, }, "wall_clock_breakdown": false, } -
参数说明
参数名称 可选值 / 类型 示例 含义 train_batch_size整数 32 每个训练步骤的批量大小 gradient_accumulation_steps整数 1 每隔多少步进行一次梯度更新(梯度累积) steps_per_print整数 200 每多少步打印一次日志信息 fp16.enabled布尔值 true 启用混合精度训练(FP16) fp16.loss_scale整数 0 动态损失缩放因子,通常设置为 0 表示自动选择 fp16.initial_scale_power整数 16 初始损失缩放的幂 zero_optimization.stage0, 1, 2, 3 2 Zero 优化阶段,0 表示没有优化,1 表示优化参数,2 表示优化梯度,3 表示优化参数和梯度 zero_optimization.offload_param.devicecpu,nvmecpu参数卸载到的设备类型,可以选择 cpu或nvmezero_optimization.offload_optimizer.devicecpu,nvmecpu优化器状态卸载到的设备类型 optimizer.type字符串(如 Adam,AdamW等)Adam使用的优化器类型 optimizer.params.lr浮动数值 3e-5 学习率 optimizer.params.betas数组 [0.9, 0.999] 优化器的 beta 参数 optimizer.params.eps浮动数值 1e-8 优化器的 eps 参数 scheduler.type字符串(如 WarmupLR,CosineAnnealingLR等)WarmupLR学习率调度器类型 scheduler.params.warmup_min_lr浮动数值 1e-7 学习率的最小值(用于预热阶段) scheduler.params.warmup_max_lr浮动数值 3e-5 学习率的最大值(用于预热阶段) scheduler.params.warmup_num_steps整数 500 预热阶段的步数 wall_clock_breakdown布尔值 false 是否打印每个阶段的壁钟时间分解