ZeroBubble
介绍 ZeroBubble 技术(包括 DualPipe)的基本原理及其在深度学习中的代码实现方法
Zero bubble
-
参考资料
-
以一个线性层(矩阵乘法)为例,其反向传播实际上包含两个相互独立的计算:
- 对输入的反向传播,记为 (backward w.r.t. activations)
- 对权重的反向传播,记为 (backward w.r.t. weights)
-
它们在依赖关系上并不对称:
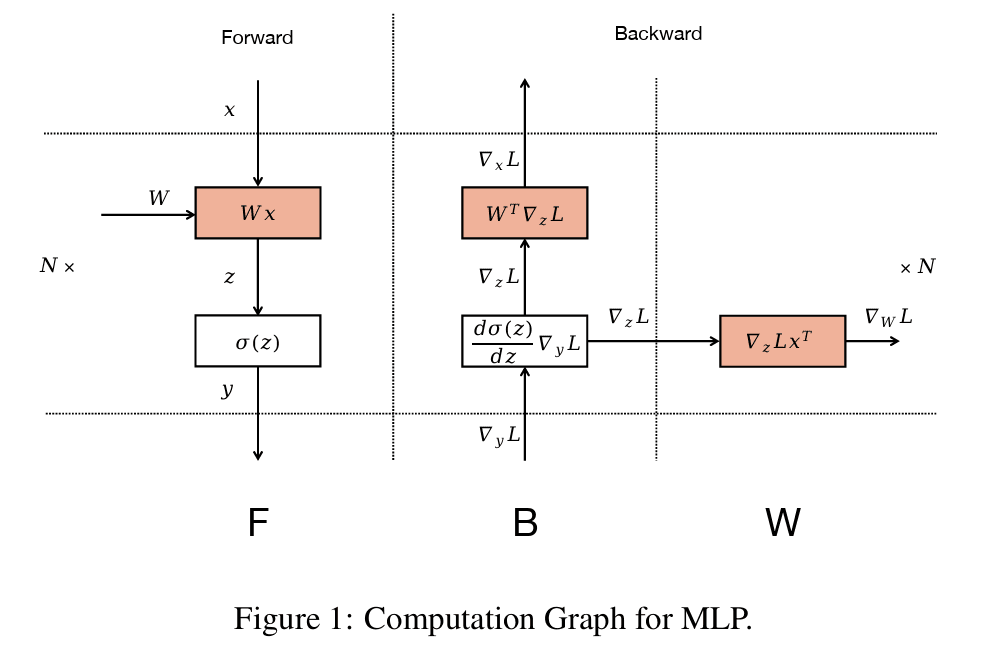
- 的输出(即对输入的梯度)是下一层反向传播所必需的
- 的输出(权重梯度)并不影响后续层的反向传播,只需要在 optimizer.step 之前完成即可
- 在计算图中有 “向前” 的依赖,而 没有
- 那么,只要同一 stage 的 已经完成,对应的 就可以被延后,在任意空闲时间执行
- 即用 去 “填 bubble”,在传统的 1F1B 或交错流水线中,bubble 产生的原因是某些 GPU 在等前面的 stage 或后面的 stage 完成计算,时间被浪费掉了
-
Zero Bubble 的关键思想是:
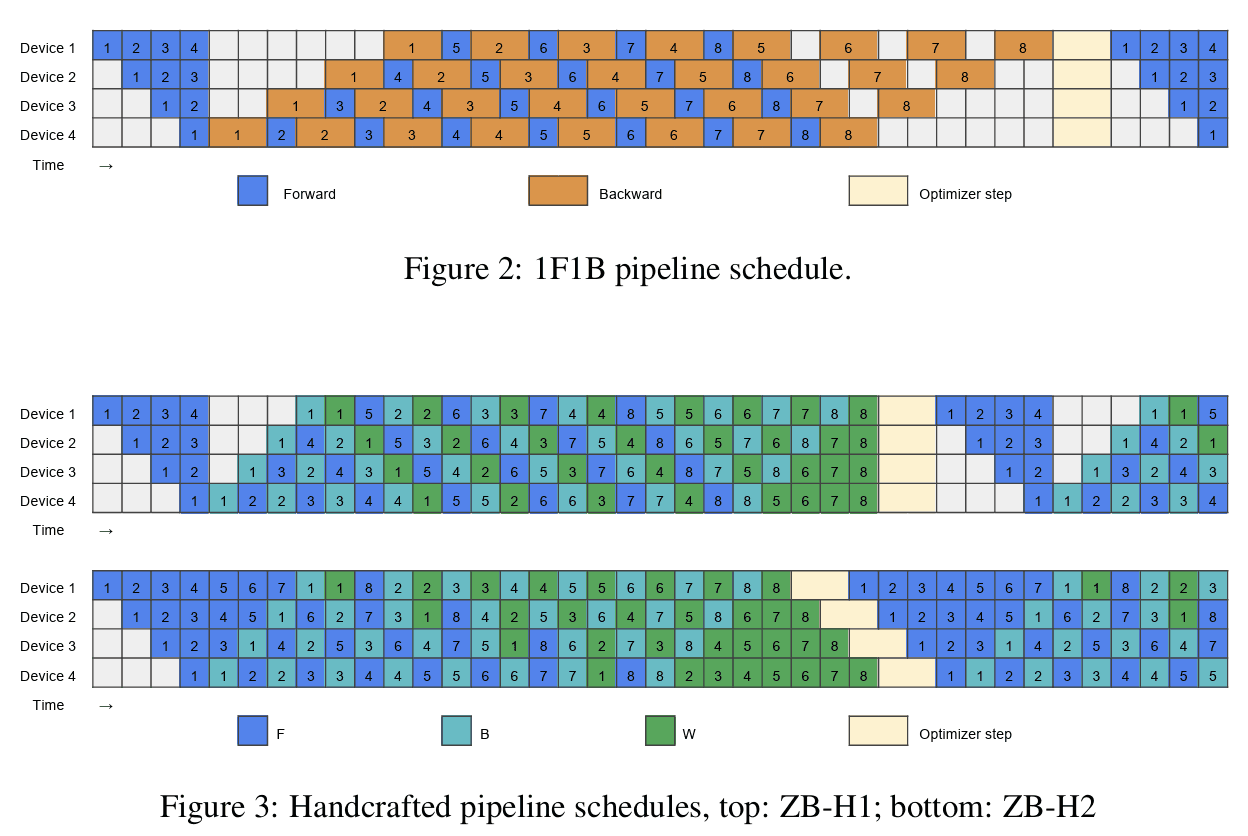
- 把 backward 从一个粗粒度操作拆成 和
- 保证 按依赖顺序尽快完成
- 把 插入到原本会空闲的时间片中执行,用来填补 bubble
-
Transformer 层各阶段的 FLOPs 与激活内存需求
阶段(Pass) FLOPs(浮点运算量) 所需激活内存(Activations Memory Required) F(前向传播) B(反向传播) W(权重更新) -
InterleavedZeroBubble(ZB1P)
- 峰值内存与 1F1B 一致,气泡缩小至 1F1B 的 1/3,稳态调度为 1F − 1B − 1W
- 调整 W 启动时机,用 W 填充尾部气泡,无额外内存开销
-
ZB2P
- 稳态调度依旧为 1F − 1B − 1W
- 加长预热阶段:前向 F 预热长度从 p 扩展到 p+1 或 2p,让后面 B、W 有足够空间填满气泡
- 尾部 W 重排:最后一批 microbatch 的 W 不再顺序执行,而是集中批量执行,完全填满尾部所有气泡
-
ZB1P 和 ZB2P 对比
调度方案(Schedule) Bubble size(气泡大小) 峰值激活内存(Peak activations memory) 1F1B ZB-H1 ZB-H2 -
绕过优化器同步
- 零气泡流水线的核心瓶颈,来自传统训练中优化器更新前必须执行全局梯度同步(AllReduce),这个强同步操作会强制所有 GPU 等待最慢节点,直接打断无缝的 1F-1B-1W 调度,让辛苦消除的流水线气泡重新出现
- 该优化的设计目标,就是在不破坏模型训练精度与收敛性的前提下,彻底移除同步操作对流水线调度的阻塞
- 它的核心设计逻辑是将同步操作异步化、后置化:放弃在当前迭代末尾等待全局梯度同步,而是直接使用各 GPU 本地计算得到的梯度完成参数更新,让训练流程无等待地立刻进入下一轮迭代,完整保留零气泡的连续执行状态
- 同步操作不再作为训练的必经阻塞点,而是被推迟到下一轮迭代的前向预热阶段后台静默完成,全程不占用关键执行路径、不产生空闲等待
- 为了保证训练数值正确性,方案通过后置校验机制兜底:在下一轮迭代中,用后台完成的全局同步梯度修正本地参数偏差
- 由于流水线并行下各 GPU 的梯度差异极小,参数偏差远小于学习率噪声,不会影响模型收敛。最终实现了两全其美:既维持了严格的同步语义与训练精度,又彻底消除了优化器同步带来的气泡,让零气泡流水线的性能收益完全落地
-
ZBVZeroBubble
- ZB2P 虽然能够实现 “近零 bubble”,但其峰值内存大约是 ZB1P 的两倍,且调度复杂度也更高
- ZB‑V 采用对称的 V 形执行布局
- 前半程依次推进前向计算 F,让流水线快速填满
- 中段集中执行输入梯度计算 B,利用 B 之间的强依赖关系紧密排布,直接填补传统流水线中出现的气泡空隙
- 后半程则将所有参数梯度计算 W 统一延后、收拢执行,形成 V 字右侧的下降段
- 这种前展后收的结构让计算阶段几乎连续运行,不再出现空闲等待
DualPipe
-
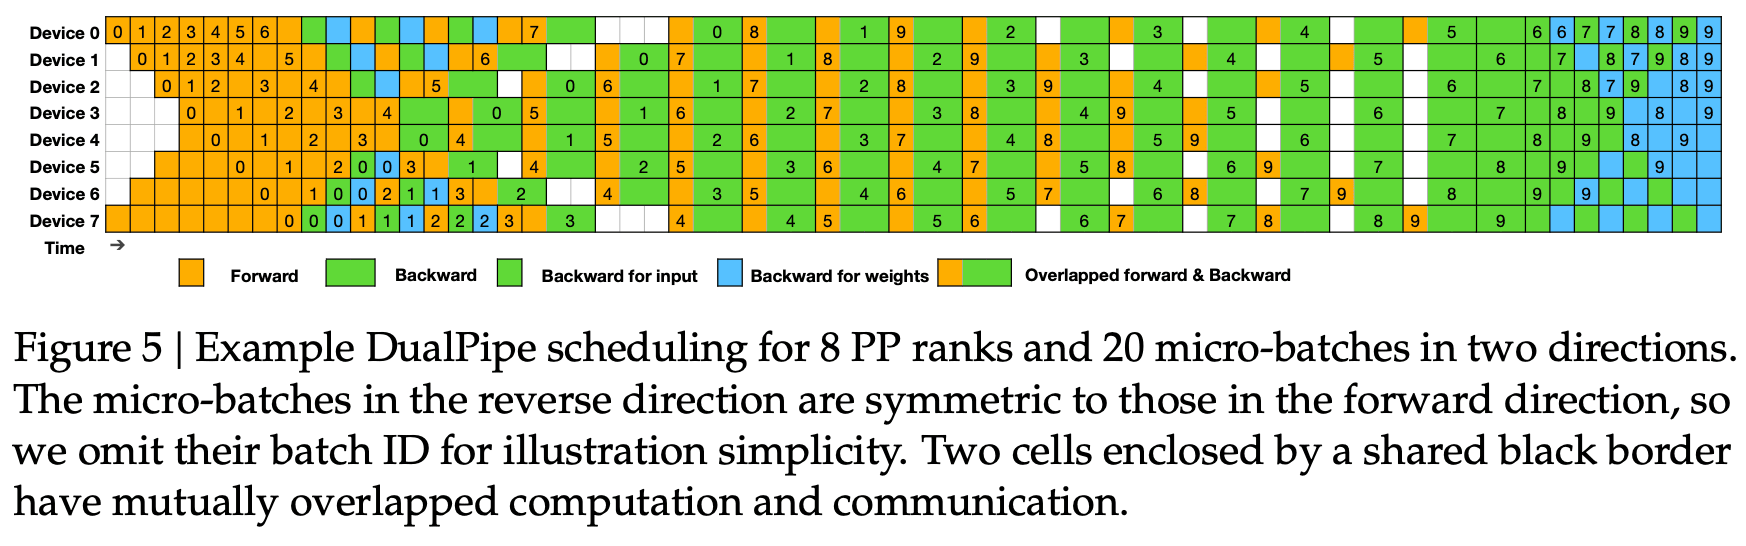
在 ZeroBubble 的基础上,即便拆解了 ,流水线首尾依然有气泡
- 设备 1(队首)在批次末尾有大段气泡(等反向传回来)
- 设备 (队尾)在批次开头有大段气泡(等前向传过来)
-
既然一头一尾必然空缺,DualPipe 极其精妙地安排了两组方向相反的微批次同时训练:
- 正向流水线:数据从 设备 1 设备
- 反向流水线:数据从 设备 设备 1
-
当设备 1 在等待正向流水线的反向传回时,它正好在全速执行反向流水线的前向计算,两套流水线的气泡和密集计算区实现了完美的物理互补
-
因为是从两端向中间逼近,流水线产生气泡的 “深度” 从 直接被折半为
-
MoE 模型的 All-to-All 通信 太大,单一的 或 掩盖不住
- 得益于 “双向流水线”,同一个 GPU 上同时存在正向流水线的前向任务(F)和反向流水线的反向任务(B)
- DualPipe 在稳定阶段(Steady State)故意将这两个反向的任务强行绑定在一起同时执行,将其耗时记作 ,此时 GPU 的连续计算窗口被拉长到了
- 在这更长、更密集的计算时间内,后台的 DMA 引擎有极其充足的时间去把极其庞大的 MoE All-to-All 通信()传输完毕
- 实现了 ,再次触发完美的通信掩盖
-
DeepSeek 的 DualPipe 可以看作是 Zero Bubble 思路的工程级扩展
- 在 Zero Bubble 中,只有一条从前到后的流水线,bubble 通过 的重排来填充
- 在 DualPipe 中,同时存在两条沿着 pipeline 维度传播的计算流,一条从前往后,一条从后往前,两条流在时间上进一步交错
- 这样做的效果是,即使某一方向暂时没有可执行的 ,另一方向的 或 也可能正好可以执行,GPU 的空闲时间被进一步压缩
- DualPipe 比前面的所有方案都复杂,但本质仍然是同一个逻辑:把依赖强的操作()尽量前推,把依赖弱的操作()用于填充气泡
-
三种策略的气泡时间(Bubble Time)对比:
-
传统 1F1B
-
ZB1P(单向零气泡流水线):
-
依然是单向,但通过把 塞进气泡,每个阶段省出了等效 的空白
-
DualPipe(DeepSeek V3/R1 SOTA):
-
-
这类 “近零 bubble” 方案在概念上很优美,但实现难度极高,原因主要有三点:
- backward 被拆成非常细粒度的操作,调度空间巨大
- 不同算子(attention、MLP、通信)的执行时间并不完全一致
- 要真正最小化 bubble,本质上是一个调度优化问题
-
在 Zero Bubble 论文中,作者提到需要:
- 精确测量各类细粒度操作的耗时
- 构建调度约束
- 通过整数线性规划(ILP)或启发式算法求解近似最优调度
这篇文档有帮助吗?