序列并行
介绍序列并行的基本概念、实现方法以及在 PyTorch 中的使用方法
基本思想
-
序列并行(Sequence Parallelism,SP)是对张量并行中存在的问题的自然扩展,是为了处理张量并行无法覆盖的操作,比如 Dropout 和 LayerNorm
-
与 TP 不同,SP 沿序列维度(sequence length)切分激活和计算,而不是沿隐藏维度,这样可以把原本依赖完整隐藏维度的操作(如 LayerNorm)所需的激活显存分摊到多张 GPU 上
-
序列并行和上下文并行的区别
- 这里的序列并行专门用于配合 TP,主要处理 Dropout 和 LayerNorm 操作
- 在处理超长序列时,注意力计算会成为瓶颈,需要使用 Ring Attention 等技术,这类方法有时也被叫作序列并行,但为了区分,称其为上下文并行在后文介绍
-
以 LayerNorm 为例解释为什么要沿序列维度处理
- 和 是沿隐藏维度 计算的均值和方差
- LayerNorm 需要访问完整的 hidden_dim 才能计算正确
- Dropout 也需要沿 sequence 保持 mask 的一致性或对应性
- 因此,即使这些操作计算量很小,它们的激活仍然占用大量显存
-
基本思想
- SP 通过沿序列维度切分激活来分摊显存压力
- 每个 GPU 只处理自己序列分片的 LayerNorm 或 Dropout
- 激活显存需求从 被切分到 , 是 SP 切分的 GPU 数
MLP 激活大小
-
示意图如下
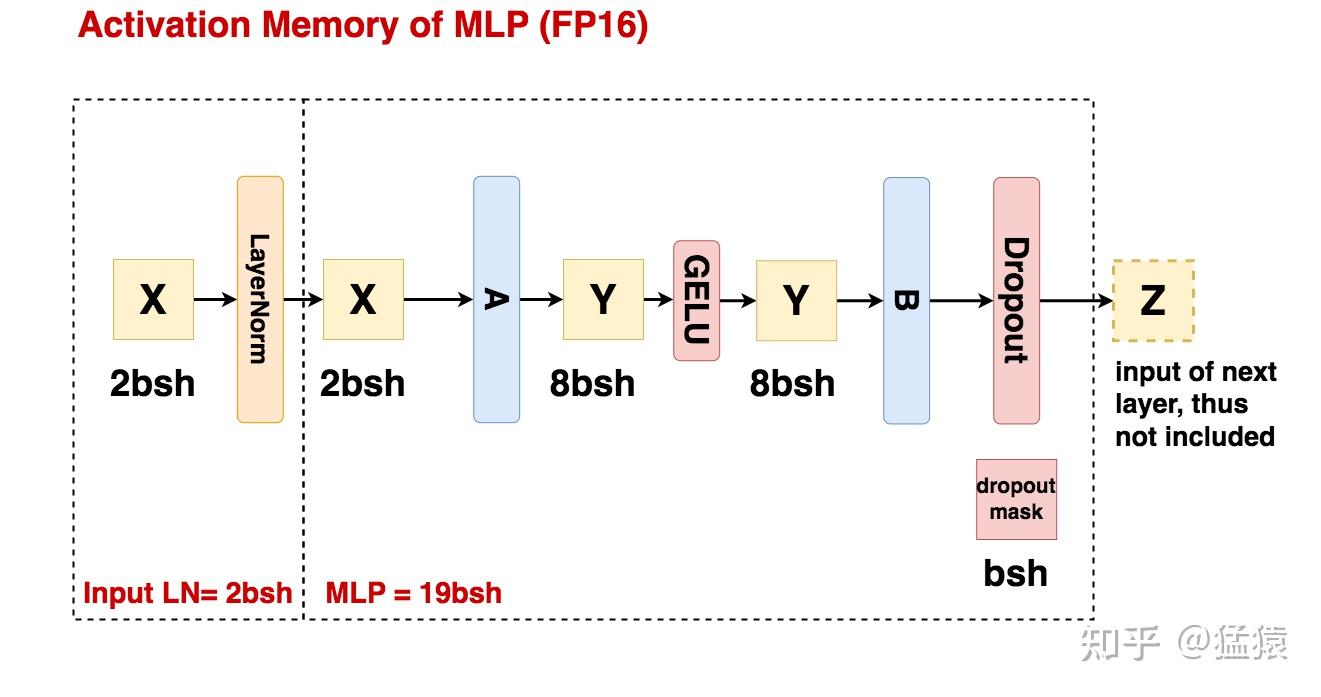
-
MLP 是 Transformer 中 “全连接层 + 激活函数 + dropout” 的核心模块,其流程为:
输入 → 线性层A (h→4h) → GELU → 线性层B (4h→h) → Dropout → 输出 -
线性矩阵 A (h → 4h) 的输入
- 输入张量的形状:(batch × 序列长度 × 隐藏维度)
- 元素总数:
- 存储大小:元素总数 × 每个元素字节数 =
-
线性矩阵 B (4h → h) 的输入
- 线性层 A 的输出是线性层 B 的输入,形状:(维度从 h 扩到 4h)。
- 元素总数:
- 存储大小:
-
GELU 函数的输入
- GELU 的输入就是线性层 A 的输出(和线性层 B 的输入是同一个张量),形状同样是
- 这里需要注意:GELU 的输入需要单独保存(反向传播时需要对 GELU 求导,依赖其输入),因此存储大小和线性层 B 的输入一致:
-
Dropout mask 矩阵
- Dropout mask 是作用在线性层 B 输出上的 0/1 矩阵,形状:(和线性层 B 的输出维度一致,即 h)
- 元素总数:,每个元素占 1 byte(0/1 无需浮点存储)
- 存储大小:
-
总的激活值大小为
-
为什么这里 dropout 的输入不计算激活值
-
设 dropout 输入为 ,输出为 ,损失值为
-
离 最近的带参矩阵为 ,那么我们可以通过求 的具体形式,来判断 在 bwd 中是否有用
-
在 fwd 的过程中,有:
- 表示 dropout_mask 矩阵, 表示 element-wise product
-
在 bwd 的过程中,有:
-
由此可知,在整个链式推导的过程中,不会用到 ,即不用保存 dropout 的输入
-
-
GELU 的输入为什么算作激活值?
-
设 GELU 输入为 (为了作区分,这里符号表达和图中稍许不同),输出为
-
离 最近的带参矩阵为 ,那么可以通过求 的具体形式,来判断 在 bwd 中是否有用
-
在 fwd 的过程中,有:
- ,其中 是 sigmoid 函数
- ,这里为了表达简练,直接把 到最后损失 的过程写成映射函数
-
在 bwd 的过程中,我们有:
-
其中和 相关的那一串,就是 GELU 函数反向传播时的 对 的偏导,本质上就是因为在链式传导到 GELU 这一项时需要用到 ,所以才将 作为激活值保存
-
-
如果把 GELU 替换成一个不带参的线性层,比如有 ,那还需要保存 吗?
- 在 fwd 的过程中,有:
- ,这里为了表达简练,直接把 到最后损失 的过程写成映射函数
- 在 bwd 过程中,有:
- 所以,此时不需要保存
- 在 fwd 的过程中,有:
-
决定一份数据是否能作为激活值保存下来的要点就在于它会不会在 bwd 的链式传导过程中被使用
-
可以计算纯 tp 下单张卡维护的激活值大小:
- 首先,对于
LayerNorm前、后的激活值 X,每张卡都是重复保存的,这里占存储 - 接着,进入 mlp 的 tp 计算,每张卡上单独计算一部分结果,这里激活值天然就是切开保存的,占存储
- 最终计算完毕,由于 tp 会对输出结果先做 all-reduce,让每张卡上拿到完整的输出 Z 后再做 dropout,所以 dropout mask 相关的激活值也是重复存储的,占大小
- 综上,纯 tp 情况下单卡的激活值大小为
- 所以,为了降低单卡的激活值大小,目标就是把这冗余的 切分到多卡上
- 首先,对于
Attention 激活大小
-
示意图
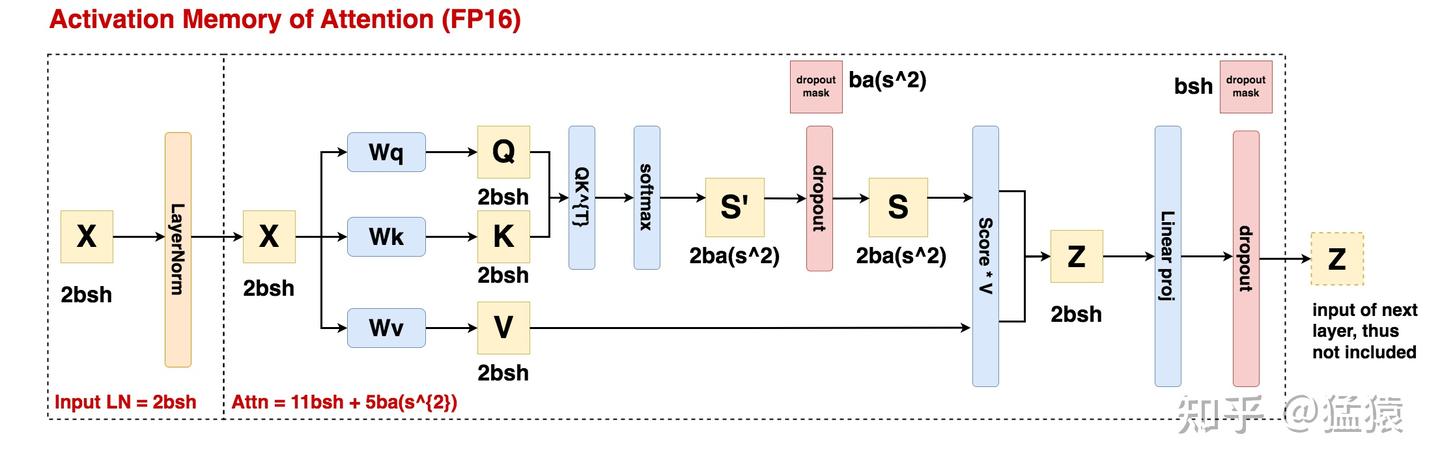
-
设
b=batch_size,s=seq_len,h=hidden_size,a = head_num -
Input LN:数据进过
LayerNorm前的结果将会被用在 bwd 的计算中,因此会被作为激活值存储下来,其占据的存储大小为 2bsh,单位为 bytes -
Attn 过程:
- 输入
X会被作为激活值保存,大小为2bsh X经过带参矩阵Wq, Wk, Wv后的结果Q, K, V会被作为激活值保存,大小为3 * 2bsh = 6bsh- 的结果会被作为激活值保存,大小为
- 的结果、dropout mask 矩阵会被作为激活值保存,大小分别为 ,
- Linear proj 的输入会被作为激活值保存,大小为
2bsh - 最后一个 dropout 操作的 mask 矩阵会被作为激活值保存,大小为
bsh - 总结来看,Attention 过程的激活值大小 =
- 输入
-
那么到底是该保存 的结果,还是该保存 的结果呢?从上图来看最终保存的是后者,可这是为什么呢?
-
还是沿用之前的思路解决这个问题:判断一份数据到底是不是激活值,不要靠想,要靠动手推,检查它是否在 bwd 的链式推导中起了作用
-
对于 fwd 过程,有:
- ,其中 是 dropout mask 矩阵
- , 是损失函数。这里为了表达简练,直接把 到最后损失 的过程写成映射函数
- 所以其实我们现在就是在讨论,是保留 ,还是保留 的问题
-
对于 bwd 过程,假设现在想去求 对带参矩阵 的偏导:
-
这里 一项,其实就是 softmax 的输出 () 对 softmax 的输入 () 求偏导的结果。通过上面的过程可以发现,真正有用的是 softmax 的输出,所以才选择保存
-
-
总的激活大小
- MLP 层的激活值大小为:
- Attention 层的激活值大小为:
- MLP 层和 Attention 层的输入数据都首先经过了
LayerNorm处理,和LayerNorm相关的激活值大小为 - 所以一个 Attention + MLP 组成的 block 中,总激活值大小为
Megatron SP
-
Megatron TPSP 实现示意图
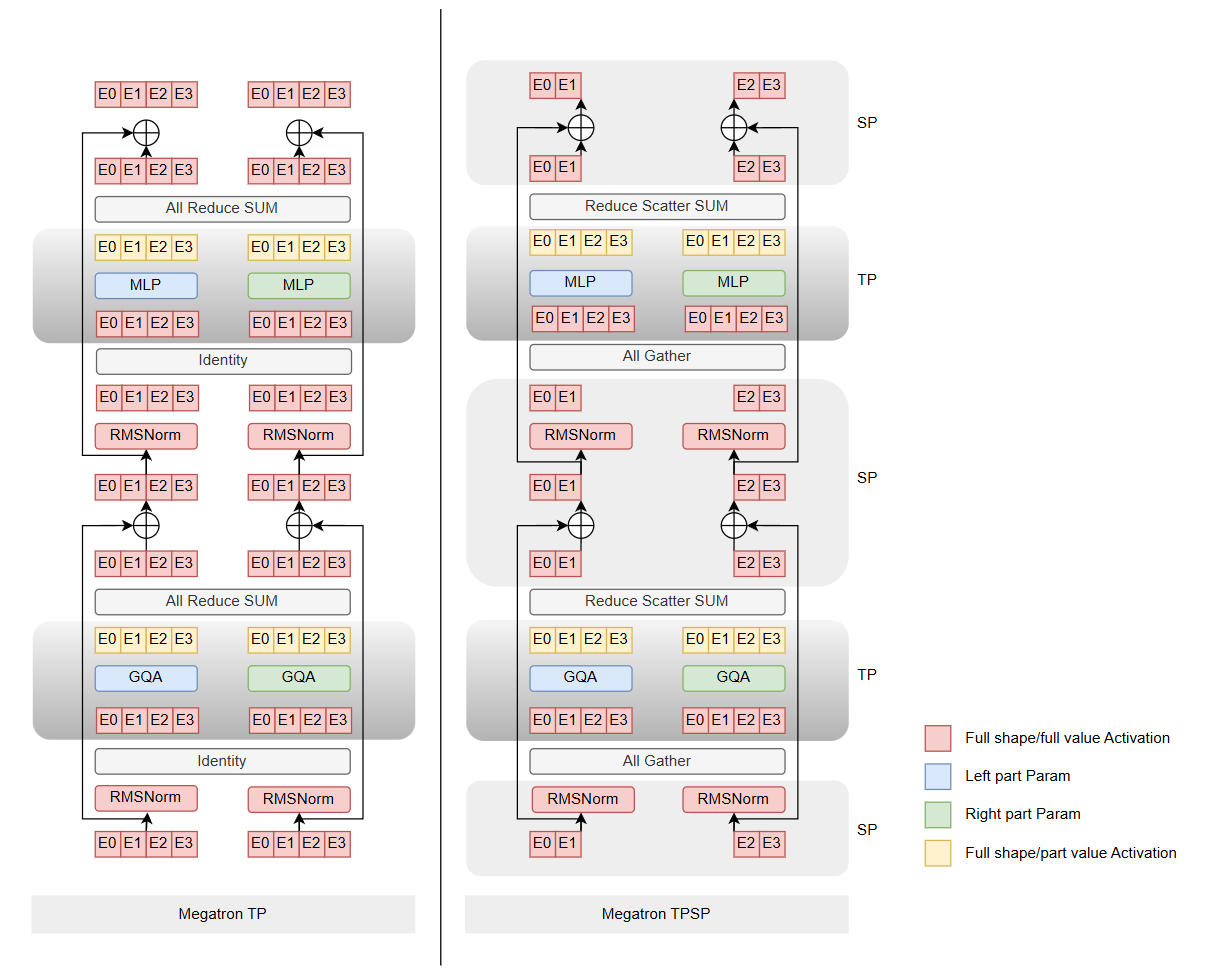
-
注意,TP 和 SP 两个并不是独立的并行组,而是共用一个并行组,
-
通过 seq 维度切分解决 LayerNorm 与 Dropout 的激活值冗余问题,配合
all-gather/reduce-scatter通信算子实现张量并行(TP)下的激活值高效存储与梯度传导,并用边算边通讯隐藏通信开销 -
设切分卡数为 ,核心优化围绕
LayerNorm前后的激活值与 Dropout Mask 展开:- LayerNorm 输入切分:将输入 按
seq维度切开为seq_chunk,每张卡仅维护部分序列 - 因
LayerNorm在token维度计算,切分不影响计算正确性,输入激活值由 降至 - LayerNorm 输出切分:输入切分后输出天然切开,激活值同步由 降至
- Dropout Mask 切分:每张卡仅维护自身
seq_chunk对应的 Mask,激活值由 降至 - 优化结果:纯 TP 下与输入输出相关的 冗余激活值被完全拆分
- LayerNorm 输入切分:将输入 按
-
前向传播(forward)流程与通信策略
步骤 操作 激活值规模 核心目的 g 的 forward 执行 all-gather,获取完整输入张量 - 满足 TP 计算对完整输入的要求 2. TP 核心计算 正常执行 TP 流程 按张量并行逻辑完成计算,输出 (尺寸均为 ) 3. 结果聚合 替换传统 allreduce,执行 reduce-scatter- 仅获取自身 seq_chunk对应的完整 (尺寸为 ),杜绝结果冗余4. 独立计算 每张卡对自身 执行 Dropout 基于切分 Mask 完成随机失活,无冗余存储 -
反向传播(backward)流程与通信优化
步骤 操作 核心作用 性能优化手段 1. 梯度准备 执行 all-gather,获取完整的 为梯度反向传导提供完整输入 - 2. 梯度传导至 LayerNorm 执行 all-gather 获取完整的 (LayerNorm 输出) 保证梯度顺利传导至 LayerNorm 层 边算边通讯:梯度未传导至此时提前启动通信,将通信开销覆盖在计算时间中 3. 梯度聚合 执行 reduce-scatter,获取自身 seq_chunk对应的完整为 LayerNorm 层的梯度计算提供正确输入 - -
最终的单卡维护的激活值大小由 降到了
-
Attention 层前后的处理逻辑类似,最终激活值优化结果如下
并行策略 单卡激活值大小公式 核心解读 无并行处理 基础基准,无任何张量 / 序列切分,激活值全量存储 纯 TP 处理 仅按张量维度切分, 10为 LayerNorm、Dropout 等非切分固定开销,是 SP 优化核心靶点TP+SP 联合处理 结合张量与序列维度双重切分,覆盖了 TP 遗留的固定开销,进一步降低单卡激活值占用
TP + SP 后的变化
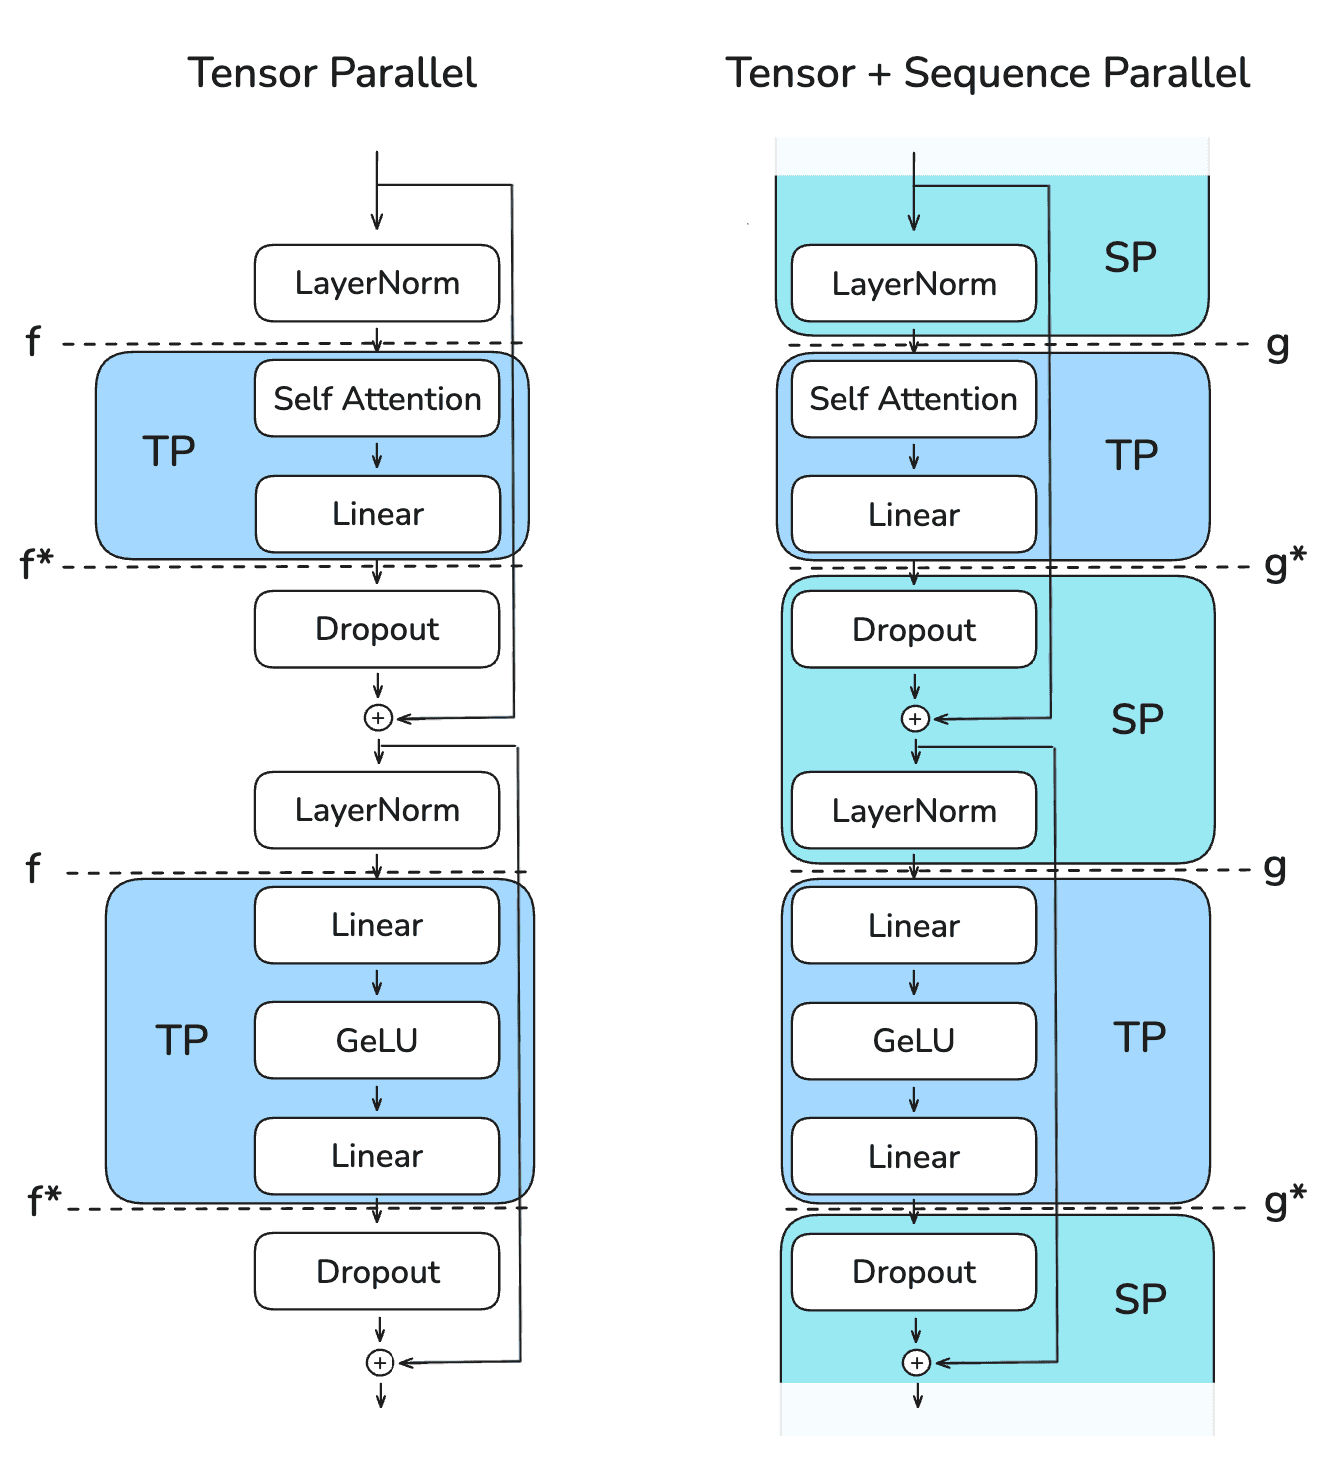
-
首先,TP 中引入了两个操作标记 f 和 f*,它们是一对共轭操作(conjugate pair)
Pass f f* Forward no-op(不做操作,因为激活已经在各个 TP rank 上重复) all-reduce(同步激活,保证计算正确) Backward all-reduce(同步梯度) no-op(梯度已重复) -
共轭对的含义:在每个传递中,当一个是 no-op,另一个是 all-reduce;在另一传递中刚好相反
-
SP 处理沿序列维度切分的操作(如 LayerNorm、Dropout):
- 在 SP 区域,避免使用 all-reduce,因为 all-reduce 需要收集完整的激活,增加峰值显存,这不是 SP 的目的
- g /g* 操作用于 TP ↔ SP 的转换:
操作 功能说明 g all-gather → 把沿序列切分的激活拼接回来,供 TP 层使用 g* reduce-scatter → 把 TP 输出切分回 SP 序列分片
TP+SP 的前向传播流程
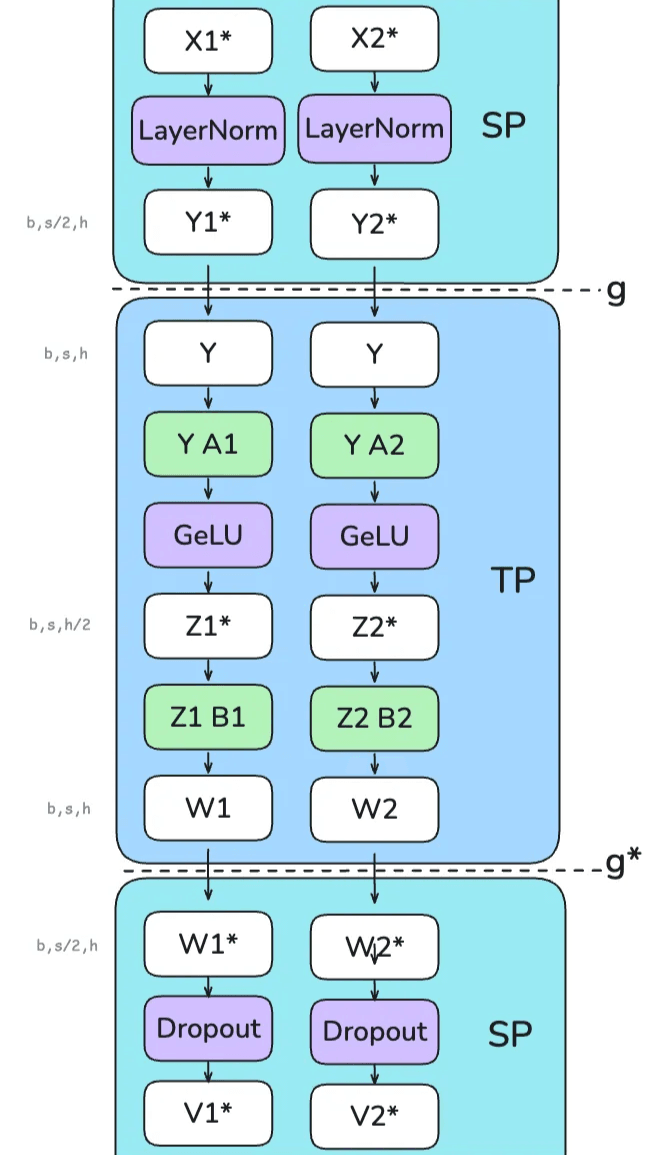
-
初始 LayerNorm(SP 区域)
- 输入 X1*, X2*,形状 ,已沿序列切分
- 每个 GPU 独立计算 LayerNorm → 得到 Y1*, Y2*
-
第一次转换(SP → TP)
- g 操作(all-gather) → 拼接 Y1* 和 Y2*
- 恢复完整序列长度 ,供列线性层(column-linear)使用
-
第一个线性层(TP 区域,列线性)
- 输入 Y 被切分隐藏维度
- 每个 GPU 独立做 GELU → 输出 Z1*, Z2*,形状
-
第二个线性层(TP 区域,行线性)
- 恢复隐藏维度
- 输出 W1, W2 需要在 GPU 之间累加
- 最终输出
-
第二次转换(TP → SP)
- g* 操作(reduce-scatter) → 切回序列维度
- 输出 W1*, W2*,形状 ,供下一个 SP 层使用
-
最大激活显存降低:
-
TP 单独使用:某些地方需要存储 的激活
-
TP + SP:每次激活只存部分序列或部分隐藏维度
-
显著减轻 GPU 显存压力
-
-
前向传播中隐藏状态在 TP 与 SP 的变化
-
TP-only
- 隐藏维度 h* 被切分,序列维度 s* 保持完整
- 在 row-linear 时,需要对隐藏维度做 all-reduce 以保证计算正确
- SP 区域因为没有 SP,所以仍然存储完整激活
Region 隐藏维度 h* 序列维度 s* 进入 TP(column-linear) h* 被切分 ( weight_out被切分)s* 完整 TP 区域 h* 被切分 s* 完整 退出 TP(row-linear) h* 恢复完整 ( weight_out全 + all-reduce 保证正确)s* 完整 SP 区域 h* 完整 s* 完整 -
TP + SP
- SP 作用在序列维度,沿 s* 切分激活
- 在 row-linear 时,由于不需要存储完整激活,因此只需要 reduce-scatter
- TP 区域中,列线性需要完整序列,因此先 all-gather;行线性输出后再 reduce-scatter 回 SP 分片
Region 隐藏维度 h* 序列维度 s* 进入 TP(column-linear) h* 被切分 ( weight_out被切分)s* all-gather 到完整长度 TP 区域 h* 被切分 s* 完整 退出 TP(row-linear) h* 恢复完整 ( weight_out全 + reduce-scatter 保证正确)s* reduce-scatter 回切分 SP 区域 h* 完整 s* 切分
-
相关分析
-
Embedding 层的情况
- Embedding 的输出在 TP-only 下仍然存储完整序列
- TP+SP 下序列被切分,减少显存使用
Region Vanilla TP TP + SP Embedding layer (row-linear,按词表切分) h*: 完整 ( weight_out全 + all-reduce)
s*: 完整h*: 完整 ( weight_out全 + reduce-scatter)
s*: reduce-scatter 切分 -
使用 TP+SP 是否会比普通 TP 带来更多的通信开销?
- 在使用普通 TP 的前向传播中,每个 Transformer block 需要两次 all-reduce 操作;而在使用 SP 时,每个 Transformer block 需要 两次 all-gather 和两次 reduce-scatter 操作
- 因此,从表面上看,SP 的通信操作次数是 TP 的两倍
- 但是,由 一次 all-reduce 操作可以分解为一次 all-gather 加一次 reduce-scatter,它们在通信成本上实际上是等价的
- 同样的推理也适用于反向传播,因为在反向传播中只是使用了每种操作的共轭形式(即 no-op ↔ all-reduce,以及 all-gather ↔ reduce-scatter)
-
通信与计算重叠问题
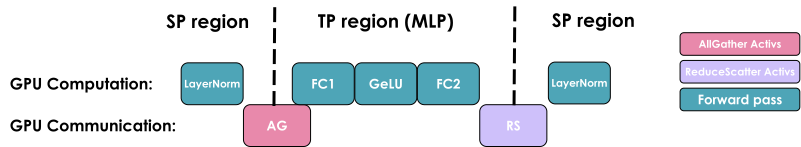
- 在每一层中共有四次通信操作(Attention 两次,MLP 两次)
- 和 vanilla TP 一样,TP+SP 也很难与计算进行有效重叠,这使得整体吞吐量高度依赖于通信带宽
- 因此和 vanilla TP 一样,TP+SP 通常只在单个节点内部使用
- TP 的通信在计算路径上,跨节点太贵
- 因此一般将 TP 的并行度限制在每个节点的 GPU 数量以内,例如 TP ≤ 8
- TP≤8:节点内通信(NVLink)
- 带宽极高(600GB/s 量级),延迟极低
- all-reduce /all-gather/reduce-scatter 相对 “便宜”
- TP / TP+SP 的通信还能勉强忍受
- TP>8:跨节点通信(EFA)
- 带宽骤降(~100–400Gbps),延迟显著上升
- TP 中的通信是在前向关键路径上的,无法像 ZeRO 那样大规模 overlap
- 结果:每一层的通信都直接拉长 forward /backward 的 critical path,于是 per-GPU throughput 急剧下降
-
LayerNorm 的 all-reduce 操作
- 在 SP 区域,每个 TP rank 只看到 不同的 sequence 子区间
- LayerNorm 的参数()是对整个 hidden 维度共享,对 sequence 不共享
- 因此 rank 0:用 算出来一组梯度,rank 1:用 算出来另一组梯度
- LayerNorm 的参数是逻辑上全模型共享,物理上每个 TP rank 各自一份
- 如果不做 all-reduce 操作,那么 ,参数会立刻发散
- 所以必须进行全量规约,即
- 由于 LayerNorm 参数量极少:只有 (),相比 QKV / MLP 的 ,可以忽略不计
-
TP+SP 仍然存在的问题
- 即便用了 SP,在 TP 区域(attention / MLP)仍然需要 的激活值,因为 是完整的
- 当 时,attention 激活(尤其是 QK /softmax)仍然爆炸
- 这也是 TP+SP 不能解决 “超长上下文” 的本质问题,为此引出上下文并行(Context Parallelism)解决上下文太长的问题
- 同时,由于 TP 的通信在 forward /backward 关键路径,当模型太大时,TP 不得不跨节点,延迟和带宽无法忍受,吞吐量会断崖式下降,为此引出流水线并行(Pipeline Parallelism)解决模型太大的问题
通信 - 计算掩盖
-
Megatron 对 TP 的通信优化示意图如下
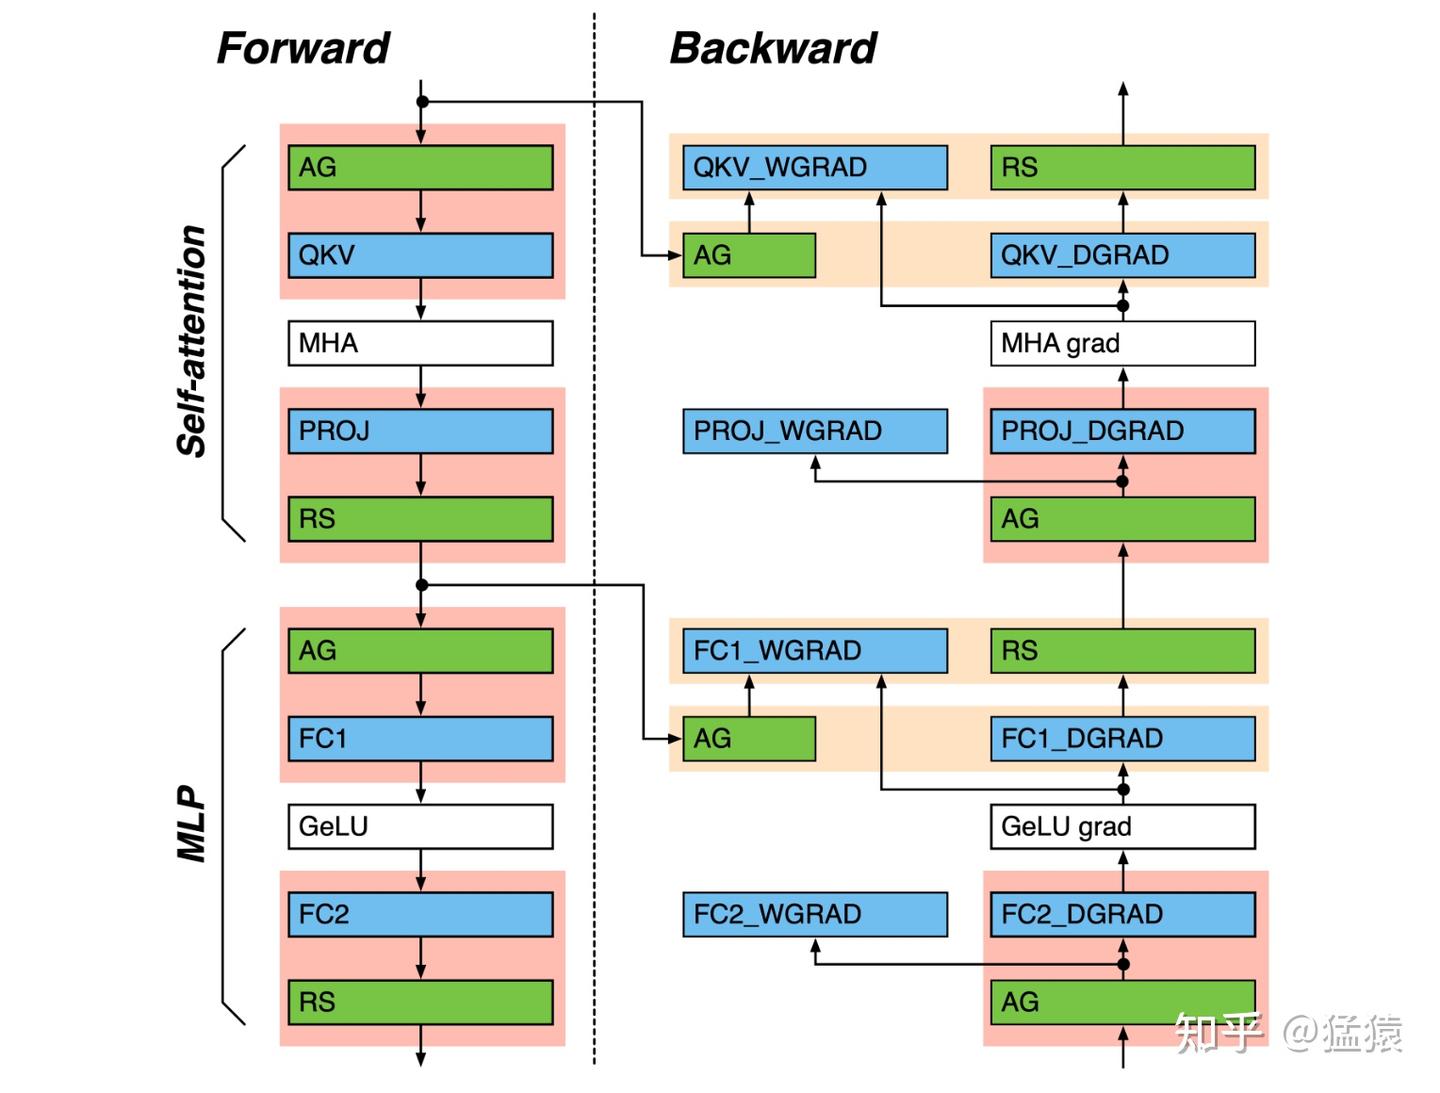
-
图中的红 / 黄框分别展示了计算与通信之间的依赖关系,具体说明如下:
- 红色框:通信操作与对应的计算操作存在依赖关系,默认需串行执行;但可通过优化手段实现计算与通信的重叠(Overlap)
- 黄色框:通信操作与对应的计算操作无依赖关系,可直接并行执行;其中
dgrad代表计算输入梯度(input grad),wgrad代表计算权重梯度(weight grad)
-
在 Megatron-LM 中,以下参数用于控制红 / 黄框中计算 - 通信重叠的开启状态:
tp_comm_overlap_ag:控制开启红色框中与 All-Gather(AG)相关的计算 - 通信重叠tp_comm_overlap_rs:控制开启红色框中与 Reduce-Scatter(RS)相关的计算 - 通信重叠tp_comm_bulk_dgrad:控制开启黄色框中 dgrad 与 AG 结合的批量重叠tp_comm_bulk_wgrad:控制开启黄色框中 wgrad 与 AG 结合的批量重叠tp_comm_overlap_rs_dgrad:控制黄色框中 dgrad 计算完成后,与 RS 通信的重叠。需注意:若该参数设为True,则tp_comm_bulk_dgrad和tp_comm_bulk_wgrad会被自动关闭,推测原因是同时开启会引发缓冲区资源竞争及管理复杂度提升,最终导致整体性能下降tp_comm_overlap:作为计算 - 通信重叠的总开关;仅当该参数为True时,上述 5 项参数才可根据需求按需生效;若为False,则 TP 维度的所有计算 - 通信重叠均不开启
-
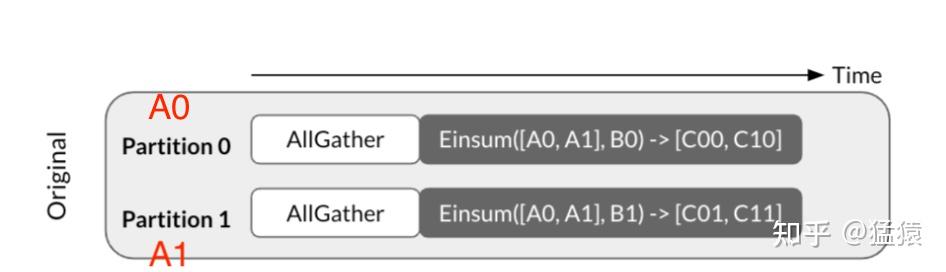
在输入 attn 或 MLP 层之前,都需要先进行 all-gather
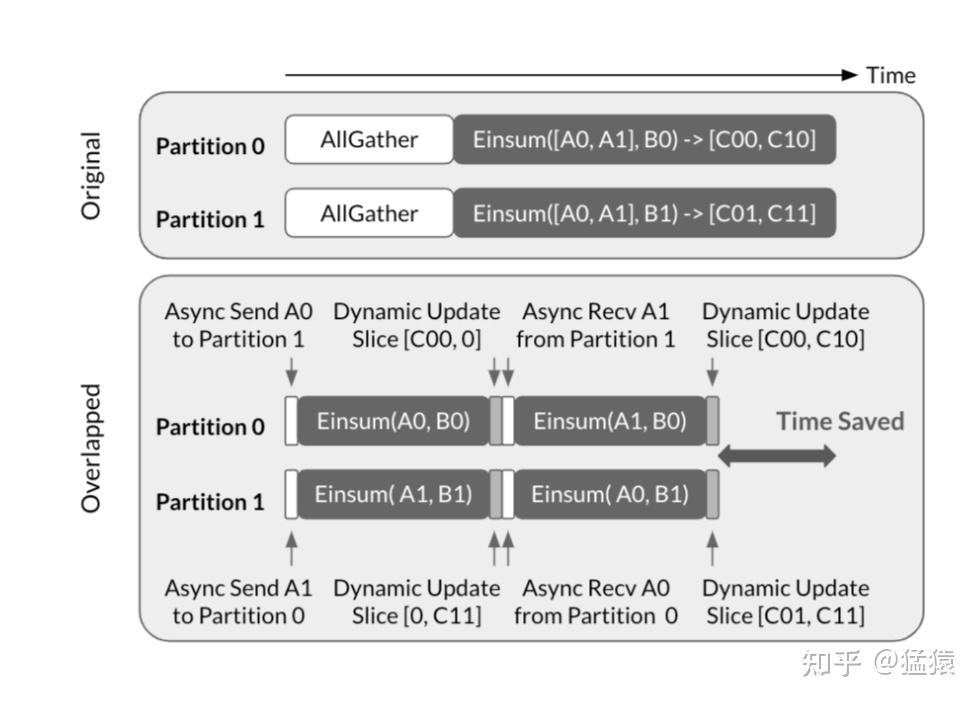
- 这里,需要等待 A0,A1 进行 all-gather 之后,才能开始计算,没有实现任何的计算通信 overlap
-
可以使用 all-gather overlap p2p 进行优化(tp_comm_overlap_ag)
- 在初始阶段,GPU0 上存放着输入块 和模型权重分块 ,GPU1 上存放着输入块 和模型权重分块
- Overlap 执行步骤如下:
- 在 GPU0 上,先将 发送至 GPU1,同时启动 GEMM 计算 得到 ,实现计算与通信的重叠
- 在 GPU1 上,先将 发送至 GPU0,同时启动 GEMM 计算 得到 ,实现计算与通信的重叠
- 待 GPU0 完成 的计算并收到 后,即可继续执行 得到 ;GPU1 同理,在完成 并收到 后,执行 得到
- 在 overlap 模式下,无需等待输入数据完成 All-Gather 后再启动计算,从而有效缩短了整体运行时间
-
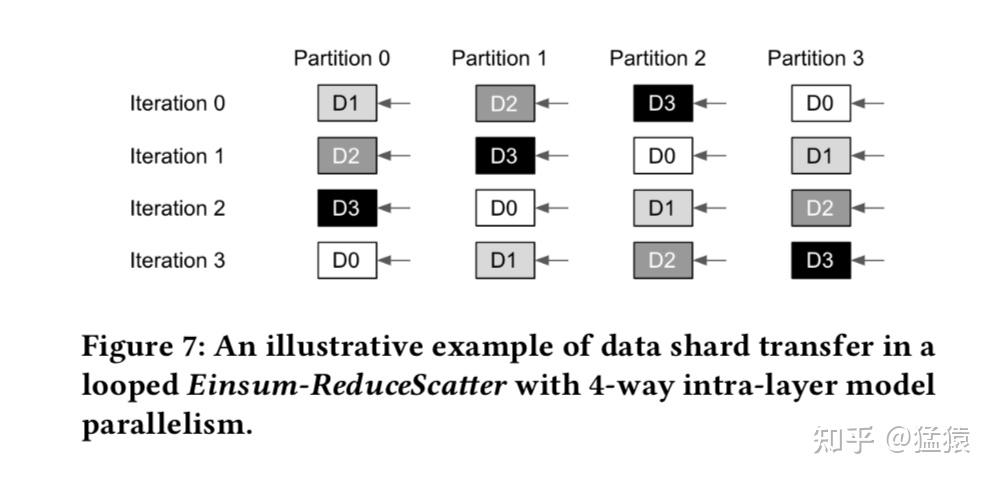
多卡下的 all-gather overlap
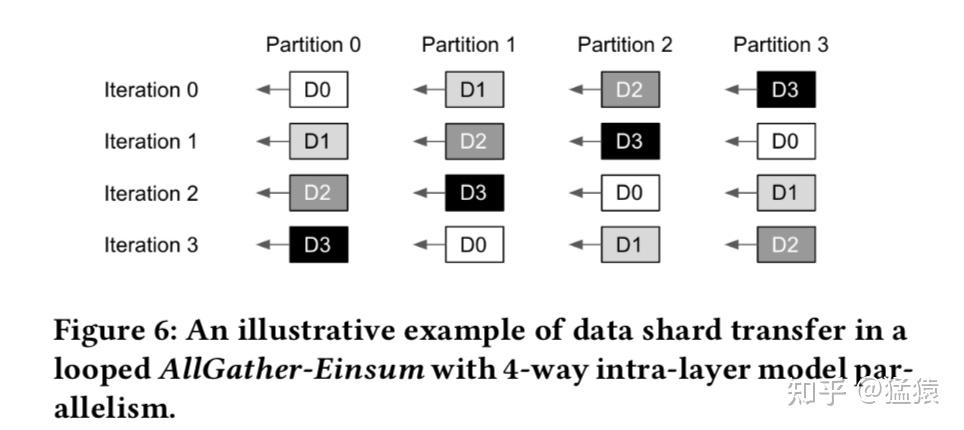
- partition:表示参与并行计算的 GPU 卡;iteration:表示每一轮迭代,每轮迭代内部都包含了计算与通信的 overlap
- 每个 partition 中的 :表示当前正在用于计算的输入数据块的索引,用于追踪数据在卡间的流动
- 从图中可以看出,这里采用了 p2p ring exchange(环形点对点交换) 的数据传输方式,即每张卡仅与自己相邻的两张卡进行数据的收发操作,从而形成一个闭环的通信环
- 在 iteration 0 时:
- 每张卡都使用自身维护的输入数据块进行计算,因此 的下标与 partition 的下标 是一一对应的
- 同时,每张卡会与相邻的两张卡进行数据收发。例如,partition 2 会将自己的数据 发送给 partition 1,并从 partition 3 接收数据
- 在 iteration 1 时:
- partition 2 会使用上一轮从 partition 3 收到的数据 进行计算
- 同时,它会将 发送给 partition 1,并从 partition 3 接收新的数据
- 后续迭代以此类推,数据块在环形拓扑中持续轮转,每张卡依次使用不同的数据块完成计算,同时与相邻卡进行数据交换,实现计算与通信的 overlap
-
接下来,如何进行 reduce-scatter 的通信覆盖?
-
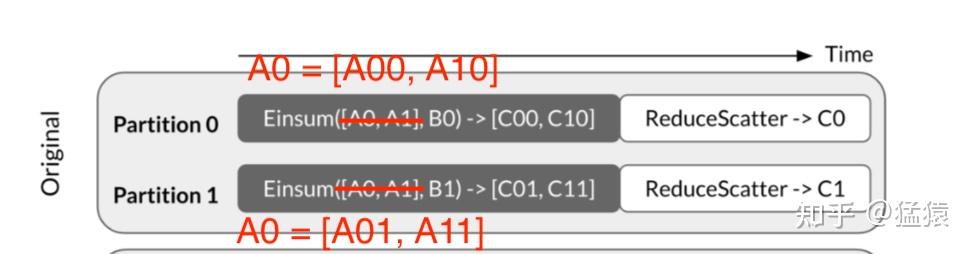
朴素的 reduce-scatter 如下
- 假设部署了 2 张 GPU(TP 并行维度
tp_size = 2):- 和 为 FC2 层按行切分的模型权重分块,分别存储在 GPU0 和 GPU1 上
- 和 为 FC2 层的输入数据块,其中 (GPU0 持有)、(GPU1 持有)
- FC2 层输出结果需要执行 Reduce-Scatter 操作:
- GPU0 本地计算得到输出 ,GPU1 本地计算得到输出
- 完成 Reduce-Scatter 后,最终结果为:
- GPU0 上保留
- GPU1 上保留
- 朴素 Reduce-Scatter 模式的问题:需等待 GPU0 完整计算出 、GPU1 完整计算出 后,才能启动 Reduce-Scatter 通信,计算与通信无法重叠,整体耗时较长
- 原始图片中输入标注为 ,此处针对性修改是因为在 TP 并行的 MLP 模块 FC2 层中,不同 GPU 卡上的输入数据块本身存在差异,需贴合该场景的实际数据分布特征
- 假设部署了 2 张 GPU(TP 并行维度
-
reduce-scatter overlap p2p(tp_comm_overlap_rs)
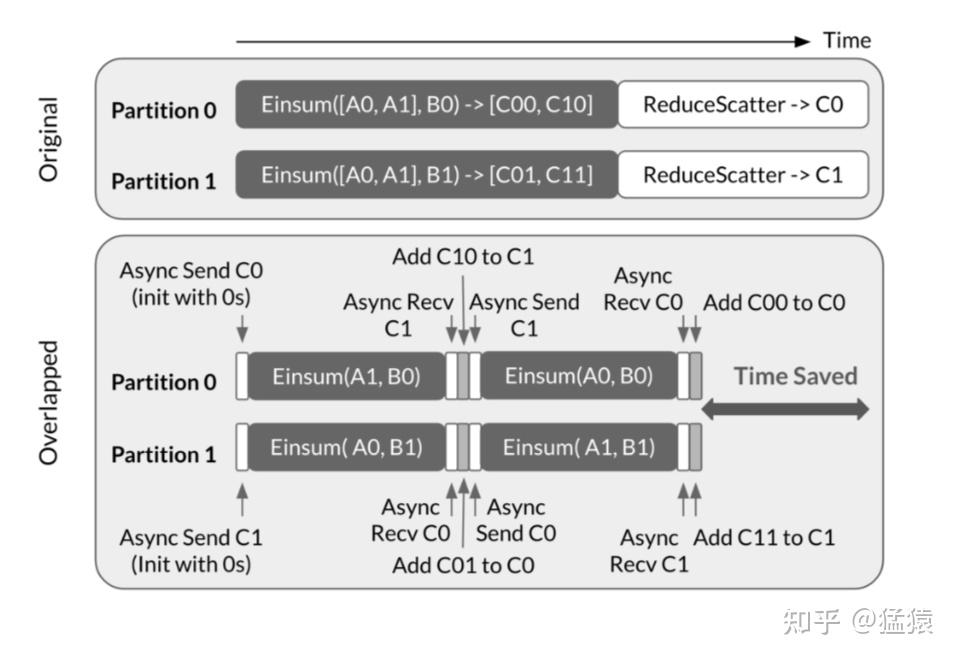
- 与 All-Gather 重叠优化的思路一致,这里同样采用 P2P Ring Exchange(环形点对点交换) 的通信方式
- 在初始阶段,每个 GPUᵢ 都会向外发送一个 “缓冲区 Cᵢ”
- 这个缓冲区 Cᵢ 的含义是:请把与我(GPUᵢ)相关的计算结果存入这个缓冲区
- 接下来,哪个 GPU 接收到了缓冲区 Cᵢ,就由它负责计算与 Cᵢ 对应的结果,并将结果写入 Cᵢ 中进行更新
- 假设总共有 n 块 GPU,那么经过 n−1 轮 环形交换后,缓冲区 Cᵢ 会重新流转回到 GPUᵢ 手中
- 此时由 GPUᵢ 完成最后一轮与 Cᵢ 相关的计算,计算结束后,Cᵢ 中就存放了最终的聚合结果
-
多卡情况如下
- 在 iteration0 中,受 P2P ring exchange 机制影响:
- 对于 partition0,它会接收到来自 partition1 的缓冲区 C1,因此只能执行与 C1 相关的计算,即使用 D1 完成计算,并将结果更新到 C1 中
- 其余 partition 的执行逻辑与此相同
- 在 iteration1 中:
- 对于 partition0,此时接收到的是来自 partition1 的缓冲区 C2(因为上一轮迭代中,partition1 已经接收了来自 partition2 的 C2,并继续以击鼓传花的方式在环上传递)
- 因此 partition0 只能执行与 C2 相关的计算,即使用 D2 完成计算
- 其余 partition 的执行逻辑与此相同
- 在 iteration3 中:
- 对于 partition0,它最终接收到了自己在 iteration0 中发送出去的缓冲区 C0
- 此时 C0 中已经汇聚了其他所有 partition 上与 partition0 相关的计算结果
- 只需 partition0 将自身对应的结果再更新到 C0 中,即可得到最终的聚合结果
- 在 iteration0 中,受 P2P ring exchange 机制影响:
-
另一种并行方式:reduce-scatter overlap pipeline chunk
- 传统流程中,需完成完整的
gemm(A, B)计算后,再对整体结果执行 Reduce-Scatter 操作 - 优化后可将矩阵(如输入矩阵 A)拆分为若干个 Chunk(分块),每完成一个分块的计算
gemm(chunk_i, B),立即将该分块的计算结果发送出去执行 Reduce-Scatter 通信,同时并行启动下一个分块chunk_{i+1}的计算,以此实现计算与通信的重叠(Overlap) - Chunk 的拆分数量并非越多越好(即不能将矩阵切分得过小):过多的 Chunk 会引入额外的通信调度开销和计算碎片化问题,反而导致整体性能下降
- 在代码实现中,默认将 Chunk 数量设置为 4(对应参数
_num_splits = 4),以此平衡重叠收益与拆分开销
- 传统流程中,需完成完整的
-
tp_comm_bulk_ag 和 tp_comm_bulk_rs
fc1_dgrad仅依赖上层梯度与本地fc1_weight,与当前进程的All-Gather(AG)通信操作无数据依赖,因此二者可并行执行,通过计算 / 通信重叠降低整体耗时fc1_wgrad需基于AG聚合后的完整输入激活(input activation)计算,存在强数据依赖,必须等待AG通信完成后串行计算fc1_dgrad计算完成后,经RS(Reduce-Scatter)通信拆分梯度,向下层传递fc1_wgrad计算完成后,直接用于本地fc1_weight的参数更新
-
dgrad 与 wgrad
- dgrad(data gradient /input gradient)
- 全称:
∂Loss / ∂Input(损失对输入 / 激活的梯度) - 含义:反向传播时,从上层传回的梯度,用于计算本层权重梯度,也会继续向前一层传播
- 根据反向传播,上层梯度对输入的梯度的系数应该就是本层的权重,因此可以直接进行计算
- 在计算完毕后,由于上层回传的梯度是经过 TP+SP 合并后的完整梯度,因此当前卡计算出来的 dgrad 是全局合并后的 dgrad,单下一层每张 GPU 只负责自己那一段 seq_len 的梯度,不能接收全局完整 dgrad,因此需要按序列维度拆分规约分发到下一层,也即 reduce-scatter
- 全称:
- wgrad(weight gradient)
- 全称:
∂Loss / ∂Weight(损失对权重 / 参数的梯度) - 含义:本层权重的梯度,用于后续参数更新(SGD/Adam 等)
- 根据反向传播,上层梯度对权重的梯度的系数应该是本层的输入,因此需要等待 all-gather 收集来自各个 GPU 上的输入 / 激活
- 在计算完毕后,直接用于更新本层的参数,无需进行传递
- 全称:
- dgrad(data gradient /input gradient)